

Williams en het dividend discount model
1Overzicht
Wat is een aandeel waard? Volgens Williams, in 1938, is dat de contante waarde van alle dividenden die het ooit uitkeert, verdisconteerd tegen een vaste discontovoet. In die vorm houdt het antwoord geen stand, want in de data beweegt niet de verwachting van de dividenden maar de discontovoet. In dit college:
leiden we uit de definitie van rendement een boekhoudkundige identiteit af. Die kan niet fout zijn, net zo min als “bezit is schuld plus eigen vermogen”;
voegen we de aanname van Williams toe, een constante discontovoet . Dat model van Williams kan wel fout zijn;
werken we het uit tot het Gordon-groeimodel , en laten we met de PVGO zien wanneer groei waarde toevoegt;
simuleren we hoe breed een waardering uitvalt als uit historische data wordt geschat;
toetsen we op Shillers data waar het model toetsbaar is: bij constante moet op een hoge prijs-dividend-ratio snelle dividendgroei volgen.
In 1938 publiceerde John Burr Williams The Theory of Investment Value Williams (1938), een proefschrift dat hij bij Schumpeter in Harvard verdedigde. De kern past in één zin, namelijk dat een investering de contante waarde waard is van de uitkeringen die ze ooit zal doen. In de praktijk vermenigvuldigde men de winst toen met een getal dat uit gewoonte was ontstaan. Williams verving dat getal door een som, zodat wie het oneens was voortaan moest zeggen waarover. Gordon en Shapiro brachten het idee in de jaren vijftig met een gesloten formule de praktijk in Gordon & Shapiro (1956)Gordon (1959). Omdat een prijs met Williams voor het eerst uit een model volgt en niet uit een gewoonte, begint de moderne waarderingstheorie bij hem.
2Intuïtie: waarom zou dit waar zijn?
Een aandeel is een stuk papier dat geen nut geeft, niet stukgaat en waar niemand in kan wonen. Het keert alleen af en toe geld uit. Alles wat een aandeel waard is, moet dus uit die uitkeringen komen, of uit de prijs waarvoor de eigenaar het later verkoopt.
Maar de koper van later staat voor dezelfde vraag, want ook hij kan alleen rekenen op uitkeringen en op een nóg latere verkoopprijs. Als we die redenering doortrekken, schuift de verkoopprijs steeds verder de toekomst in, tot hij verdwijnt en alleen de stroom dividenden overblijft.
De kracht van die gedachte zit in wat ze uitsluit. Een aandeel ontleent geen waarde aan het feit dat anderen het willen hebben, en een koers is niet hoog omdat hij de laatste jaren hoog was. Williams gebruikte zelf het beeld van een boomgaard, die de appels waard is die eraan komen, zodat wat een ander ooit voor die boomgaard betaalde, er in zijn redenering niet toe doet.
Om er een getal van te maken, zijn twee dingen nodig: een verwachting over de dividenden en een tarief dat een euro van volgend jaar omrekent naar een euro van vandaag. Dat tarief heet de discontovoet. Williams werkte de dividenden in honderden bladzijden uit, met tabellen die hij met de hand uitrekende, maar de discontovoet nam hij in zijn waarderingen als gegeven. Een theorie die zegt welk tarief bij welk risico hoort, kwam pas een kwarteeuw later, met het CAPM.
Zonder zo’n theorie zegt de som op zichzelf weinig, want uit dividendverwachtingen en discontovoet volgt de prijs, maar uit prijs en dividendverwachtingen volgt net zo goed de discontovoet. Pas zodra de discontovoet vastligt, doet de gedachte een voorspelling. Een aandeel kan dan alleen duur zijn ten opzichte van zijn dividend omdat de markt snelle dividendgroei verwacht.
We verwachten dus dat op een hoge prijs-dividend-ratio (de prijs gedeeld door het dividend) snel stijgende dividenden volgen. De theorie leidt die voorspelling af, en de replicatie toetst ze op Shillers data.
3Toy-voorbeeld: drie jaar dividenden, met de hand verdisconteerd
Het kleinste voorbeeld van Williams’ som is één aandeel met twee groeifasen. Voordat we gaan rekenen, laden we de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Een bedrijf heeft zojuist een dividend van per aandeel uitgekeerd. De discontovoet is .
| periode | groei van het dividend | discontovoet |
|---|---|---|
| jaar 1 tot en met 3 | 10% per jaar | 10% |
| vanaf jaar 4, voor altijd | 5% per jaar | 10% |
Het recept. De prijs is de som van de verdisconteerde dividenden. Voor het deel dat voor altijd met groeit, gebruiken we één formule die de theorie straks afleidt, namelijk dat een stroom die volgend jaar uitkeert en daarna met groeit, vandaag waard is.
Stap 1. De eerste drie dividenden zijn , en .
Stap 2. Verdisconteren gaat per jaar met een factor . Omdat de groei in deze fase gelijk is aan de discontovoet, is elke term één: . Samen zijn de eerste drie dividenden waard.
Stap 3. Vanaf jaar 4 groeit het dividend met 5%, te beginnen bij .
Stap 4. Volgens het recept is die stroom op waard . Die waarde heet de eindwaarde, de verwachte verkoopprijs van het aandeel op .
Stap 5. Terugrekenen naar vandaag met geeft . Die deling gaat precies op, want .
Stap 6. De prijs is , en de prijs-dividend-ratio is .
In Python lopen we dezelfde zes stappen door en zetten we de handberekening ernaast.
d0, r, g_early, g_late, n = 1.00, 0.10, 0.10, 0.05, 3

years = np.arange(1, n + 1)
dividends = d0 * (1 + g_early) ** years          # d_1, d_2, d_3
discounted = dividends / (1 + r) ** years       # contante waarde per jaar

d_next = dividends[-1] * (1 + g_late)           # d_4
terminal = d_next / (r - g_late)                # eindwaarde op t = 3 (het recept)
terminal_pv = terminal / (1 + r) ** n           # eindwaarde teruggerekend naar t = 0
price = discounted.sum() + terminal_pv

hand = pd.Series({
    "d_1": 1.10, "d_2": 1.21, "d_3": 1.331,
    "contante waarde d_1 t/m d_3": 3.00,
    "d_4": 1.39755,
    "eindwaarde op t=3": 27.951,
    "eindwaarde op t=0": 21.00,
    "prijs p_0": 24.00,
    "aandeel eindwaarde": 0.875,
})
code = pd.Series({
    "d_1": dividends[0], "d_2": dividends[1], "d_3": dividends[2],
    "contante waarde d_1 t/m d_3": discounted.sum(),
    "d_4": d_next,
    "eindwaarde op t=3": terminal,
    "eindwaarde op t=0": terminal_pv,
    "prijs p_0": price,
    "aandeel eindwaarde": terminal_pv / price,
})
pd.DataFrame({"met de hand": hand, "code": code}).round(5)Omdat de twee kolommen gelijk zijn, doet de code wat de handberekening doet. Van de prijs van komt , ofwel 87,5%, uit alles na jaar 3.
De prijs komt dus vooral uit de eindwaarde, en die eindwaarde ontstaat door te delen door een klein getal, procentpunt. Een waardering is daardoor vooral een uitspraak over een verre toekomst waarover niemand iets weet.
4Theorie
De afleiding begint bij de boekhoudkundige identiteit, die uit de definitie van rendement volgt, en maakt daar met één aanname, een constante discontovoet, het model van Williams van. De transversaliteitsvoorwaarde maakt van dat model een oneindige som, en die som is de kern van dit college. Daarna volgen het Gordon-model, de gesloten vorm die het toy-voorbeeld als recept gebruikte, en de PVGO, die zegt wanneer groei waarde toevoegt. Ten slotte laten we zien dat het model pas in de prijs-dividend-ratio toetsbaar wordt.
4.1Opzet en aannames
We leggen eerst vast wat een rendement is en welke aanname Williams daaraan toevoegt. Er is één aandeel dat op elk tijdstip een dividend uitkeert, en de prijs is eindig. De prijs is ex dividend, zodat een koper die op voor koopt, krijgt en niet . Het bruto rendement van naar is dan
Het rendement is dus wat de koper morgen terugkrijgt, dividend plus verkoopprijs, gedeeld door wat hij vandaag betaalde. Omdat dat een definitie is en geen aanname, kan de vergelijking niet fout zijn.
Williams neemt aan dat er een getal bestaat zodat voor elke periode , met de verwachting op grond van wat op bekend is. Constant is alleen het verwachte rendement, niet het gerealiseerde. In dit model is de discontovoet hetzelfde als het verwachte netto rendement, en we noemen hem verder alleen de discontovoet.
Voor Amerikaanse aandelen is de discontovoet reëel ongeveer 6,8% per jaar als gemiddeld logrendement in Shillers data, waarop de simulatie kalibreert, en ongeveer 8,4% als gewoon gemiddelde, dat een halve variantie hoger ligt (de simulatie rekent beide uit). Het toy-voorbeeld rekent met het ronde getal 10%.
De notatie is die van Opzet, data en conventies: is bruto, netto en simpel, en en zijn niveaus in euro. Daarmee wijken we af van Regnault, Bachelier en de random walk, waar kleine letters logs waren, omdat de som van Williams bedragen optelt en geen logs. Logs komen pas in de replicatie terug, en daar staat er steeds bij dat het om logs gaat.
4.2Van de definitie van rendement naar de contante waarde
De prijs van vandaag is de contante waarde van de dividenden tot een horizon , plus de verdisconteerde verkoopprijs op . Dat volgt eerst uit de definitie van rendement alleen, en daarna, met verwachte waarden, uit het model van Williams.
Een koper betaalt vandaag een prijs en krijgt daarvoor morgen een dividend en een verkoopprijs, zodat zijn prijs van vandaag gelijk is aan de opbrengst van morgen, gedeeld door het rendement. De koper van morgen doet hetzelfde met de opbrengst van overmorgen. Zo schuift de verkoopprijs steeds verder weg, en blijven de dividenden over. Hoe hoger de dividenden, hoe hoger de prijs, en hoe hoger het rendement waarmee ze verdisconteerd worden, hoe lager de prijs.
De boekhoudkundige identiteit. We schrijven (1) als en vullen dezelfde gelijkheid in voor , , enzovoort. Na stappen staat er
De prijs is dus de som van de dividenden tot en de verkoopprijs op , verdisconteerd met de rendementen die werkelijk worden behaald. Omdat de identiteit niets aanneemt, kan geen enkele dataset ermee in strijd zijn, maar met het model van Williams wel. Om dat onderscheid draait het hele college, want de replicatie toetst het model en niet de identiteit.
Het model van Williams. We nemen de verwachting op van (1) en gebruiken :
De prijs is de verwachte opbrengst van morgen, één periode verdisconteerd. Omdat deze vergelijking op elk tijdstip geldt, dus ook op , substitueren we en gebruiken we de wet van iteratieve verwachtingen, . Die wet zegt dat onze verwachting van vandaag over wat we morgen zullen verwachten, gelijk is aan wat we vandaag al verwachten. Na stappen volgt de eindige versie van het model:
Volgens deze vergelijking bestaat de prijs uit de contante waarde van de verwachte dividenden tot , plus de verdisconteerde verwachte verkoopprijs op , de eindwaarde. Het toy-voorbeeld is het geval , met aan dividenden en aan verdisconteerde eindwaarde.
4.3Het kernresultaat: transversaliteit en het dividend discount model
Wat gebeurt er met de prijs als we de horizon naar oneindig laten gaan? Als de verdisconteerde eindwaarde dan verdwijnt, is de prijs de som van alle verwachte dividenden.
Waarom zou dit waar zijn? Een koper die een aandeel over jaar doorverkoopt, betaalt vandaag ook voor de verdisconteerde eindwaarde. Groeit de verwachte verkoopprijs trager dan , zoals in het toy-voorbeeld met 5% tegen 10%, dan krimpt dat deel naarmate groeit, en blijven alleen de dividenden over. De transversaliteitsvoorwaarde legt precies dat krimpen vast. Verwacht een koper daarentegen dat de prijs zelf in het tempo blijft stijgen, dan krimpt het deel niet, en betaalt hij meer dan de dividenden rechtvaardigen.
Volgens (5) gaat de verdisconteerde eindwaarde in de verre toekomst naar nul. Met die voorwaarde krijgt het model van Williams in (6) zijn definitieve vorm, waarin de prijs de som is van alle verwachte dividenden, elk verdisconteerd met . De voorwaarde hoort bij het model, terwijl we de identiteit alleen met een eindige horizon gebruiken, zodat die niets aanneemt.
Wat gebeurt er als (5) niet geldt? We noemen de som (6) de fundamentele waarde en bekijken met
Zo’n heet een rationele bel (rational bubble, een deel van de prijs dat geen enkele uitkering vertegenwoordigt, maar toch de discontovoet als rendement oplevert). Ook voldoet aan , want de bel groeit in verwachting met en betaalt zo zijn eigen rendement. Er is niets irrationeels aan, want iedereen verdient wat hij eist. Alleen staat er geen dividend tegenover de bel, en het aandeel van de bel in de prijs groeit zonder grens. Bij verdubbelt de bel in ruim zeven jaar (), een dividend dat met 5% groeit pas in veertien ().
Williams liet de bel weg door hem niet te noemen, en dat is verdedigbaar, omdat bij elke een andere prijs hoort die aan dezelfde vergelijking voldoet. Zonder de voorwaarde legt het model de prijs dus niet vast, maar het weglaten van de bel blijft een keuze.
Een belegger die in 1999 zei dat internetaandelen te duur waren, beweerde eigenlijk dat er een in de prijs zat. Een belegger die ze juist goed gewaardeerd vond, beweerde dat enorm was. Zonder verdere aannames zijn die twee lezingen in de data niet van elkaar te onderscheiden.
4.4Wat het voorspelt: het Gordon-groeimodel
Groeit het dividend in verwachting met een vaste , dan wordt de oneindige som één breuk. Daarin staat het dividend van volgend jaar in de teller en het verschil in de noemer.
In de praktijk is de oneindige som onbruikbaar zolang een analist voor elk toekomstig jaar een apart getal moet verzinnen. Gordon en Shapiro vervingen al die getallen door één, door aan te nemen dat het dividend elk jaar met hetzelfde percentage groeit. De analist kiest dan nog maar twee getallen, en , en hoe dichter hij bij legt, hoe minder elk volgend dividend door het verdisconteren wegvalt en hoe hoger de prijs die hij uitrekent.
In woorden: de prijs is het dividend van volgend jaar, gedeeld door het verschil tussen discontovoet en groei, en dat is precies het recept uit het toy-voorbeeld. De rechterkant zegt hetzelfde, maar dan omgeschreven naar , namelijk dat het verwachte rendement gelijk is aan het dividendrendement (dividend gedeeld door prijs) plus de dividendgroei. Het bewijs berust erop dat bij constante groei elke term in de som gelijk is aan de vorige maal , en een meetkundige reeks met die reden telt op tot de breuk.
De voorwaarde is geen randgeval, want groeit een dividend voor altijd sneller dan de discontovoet, dan is de contante waarde oneindig. Geen bedrijf groeit voor altijd sneller dan de economie waarin het werkt, zodat op lange termijn begrensd is door de groei van het bruto binnenlands product. Een waardering met dicht bij negeert die grens.
De gevoeligheid die alles bepaalt. Neem de eindwaarde uit het toy-voorbeeld als zelfstandig aandeel: , groei voor altijd en . Dan is . In de tabel verschuift telkens één parameter één procentpunt:
| verandering | berekening | PD | ten opzichte van 21 |
|---|---|---|---|
| geen (, ) | 21,00 | ||
| 26,25 | +25% | ||
| 26,50 | +26,2% | ||
| 17,50 | −16,7% |
Een lagere of een hogere maakt het aandeel duurder en een hogere maakt het goedkoper, omdat de prijs vrijwel alleen afhangt van het verschil , en dat verschil is klein. Een fout van één procentpunt in of is daardoor een fout van twintig procent in dat verschil, en de prijs is er ongeveer omgekeerd evenredig mee. Waarderen met dit model komt dus neer op delen door een klein getal dat niemand kent. Het rooster hieronder geeft de prijs voor alle negen combinaties van en .
def gordon(d0, r, g):
    """Gordon growth price of a claim on a dividend growing at g forever."""
    return d0 * (1 + g) / (r - g)


r_values = [0.09, 0.10, 0.11]
g_values = [0.04, 0.05, 0.06]
grid = pd.DataFrame(
    index=pd.Index(r_values, name="discontovoet r"),
    columns=pd.Index(g_values, name="groeivoet g"),
    dtype=float,
)
for r_val in r_values:
    for g_val in g_values:
        grid.loc[r_val, g_val] = gordon(1.00, r_val, g_val)

grid.round(2)Langs de diagonaal, waar steeds 5 procentpunt is, verandert de prijs nauwelijks, van 20,80 naar 21,20, terwijl hij daarbuiten van 14,86 tot 35,33 loopt. Het rooster bevat ook de getallen uit de tabel hierboven.
4.5PVGO: wat groei toevoegt en wat het kost
Groei verhoogt de prijs alleen als het bedrijf op ingehouden winst meer verdient dan de discontovoet. Het Gordon-model neemt als gegeven, maar hier laten we zien waar vandaan komt en waarom een hoge niet vanzelf een hoge prijs betekent.
Een bedrijf dat al zijn winst uitkeert, groeit niet, en is met een winst per aandeel volgend jaar evenveel waard als een eeuwigdurende obligatie, . Wil het groeien, dan moet het winst inhouden, en die euro’s gaan niet naar de aandeelhouder. Verdient het bedrijf op een ingehouden euro meer dan de discontovoet, dan stijgt de prijs door de groei. Verdient het minder, dan daalt de prijs juist.
Schrijf voor de winst per aandeel, voor het inhoudingspercentage (retention ratio, het deel van de winst dat het bedrijf niet uitkeert) en voor het rendement op nieuw geïnvesteerd vermogen. Houdt het bedrijf elk jaar hetzelfde deel in, verdient het daarop steeds hetzelfde en geeft het geen nieuwe aandelen uit, dan is en groeit de winst met . Invullen in (8) geeft
De prijs bestaat dus uit de waarde zonder groei plus de waarde van wat het bedrijf met ingehouden winst nog gaat doen. Dat tweede deel heet (present value of growth opportunities, de contante waarde van de groeimogelijkheden). Als we de waarde zonder groei aftrekken en alles op één noemer brengen, krijgen we
Het teken van is dus het teken van . Een bedrijf dat investeert tegen minder dan de discontovoet, vernietigt waarde door te groeien, hoe hard het ook groeit. Neem als voorbeeld , , en . Dan is , en , tegen zonder groei: . Bij is en , dus .
e1, r_pvgo, b = 3.00, 0.10, 1 / 3
no_growth = e1 / r_pvgo                          # waarde zonder groei, e_1/r

pvgo_code = {}
for roe in (0.15, 0.08):
    g_impl = b * roe
    d1 = (1 - b) * e1
    p_pvgo = d1 / (r_pvgo - g_impl)
    pvgo_code[roe] = [g_impl, d1, p_pvgo, no_growth, p_pvgo - no_growth]

labels = ["g = b ROE", "d_1 = (1-b) e_1", "prijs", "waarde zonder groei", "PVGO"]
pd.DataFrame(
    {
        "ROE 15%, met de hand": [0.05, 2.00, 40.00, 30.00, 10.00],
        "ROE 15%, code": pvgo_code[0.15],
        "ROE 8%, met de hand": [0.0267, 2.00, 27.27, 30.00, -2.73],
        "ROE 8%, code": pvgo_code[0.08],
    },
    index=labels,
).round(4)Hand en code komen op twee decimalen overeen. Bij een van 15% zit een kwart van de prijs in wat het bedrijf nog gaat doen, terwijl hetzelfde bedrijf bij 8% dezelfde groei-inspanning levert en de aandeelhouder er slechter van wordt.
4.6Hoe het getoetst wordt: de prijs-dividend-ratio
Het model wordt toetsbaar in de prijs-dividend-ratio, omdat bij constante op een hoge ratio snelle dividendgroei moet volgen. Om dat te zien, delen we (6) door :
De prijs-dividend-ratio is dus de verwachte groei van het dividend over alle toekomstige jaren, verdisconteerd met . Links staat een grootheid die we observeren en die enorm beweegt, in Shillers decemberreeks van 9,9 in 1917 tot 86,2 in 2025 (de replicatie berekent beide). Rechts staan de verwachte dividendgroei en de discontovoet, twee grootheden die we niet observeren.
Een belegger betaalt veel per euro dividend alleen als hij verwacht dat dat dividend hard gaat groeien, of als hij genoegen neemt met een laag rendement. Ligt vast, dan valt de tweede reden weg, zodat op een hoge ratio snelle dividendgroei moet volgen, precies wat we aan het begin van het college verwachtten.
Die uitspraak is falsifieerbaar, en de replicatie toetst ze. Wat er moet gelden als de dividendgroei uitblijft, volgt uit de boekhoudkundige identiteit. Daarvoor delen we de identiteit door en schrijven we :
Op een hoge prijs-dividend-ratio volgt dus snelle dividendgroei, of volgen lage rendementen, of blijft de ratio over jaar hoog, want de groei staat in de tellers en de rendementen in de noemers. Omdat de identiteit geldt voor elk pad dat werkelijk komt, geldt ze ook gemiddeld. Komt de groei niet, dan zijn de rendementen voorspelbaar laag, en is de discontovoet geen constante maar een tijdreeks. Blijft de ratio voor altijd hoog, dan zit er een bel in de prijs.
Campbell en Shiller Campbell & Shiller (1988) maakten hiervan een variantiedecompositie, die meet welk deel van de schommelingen in de log-prijs-dividend-ratio uit verwachte dividendgroei komt en welk deel uit verwachte rendementen. De afleiding volgt in Voorspelbaarheid van rendementen.
5Simulatie: hoe de schatting van de waardering overneemt
Zelfs in een wereld waarin het Gordon-model exact klopt, valt een waardering met een geschatte veel breder uit dan de standaardfout van die schatting doet vermoeden. In die wereld groeien dividenden in verwachting met een vaste en is de discontovoet bekend. Er is dus één ware prijs-dividend-ratio, en we meten hoe breed de verdeling van de waardering is als een analist schat uit jaar data.
Die breedte is van belang voor het hoofdargument, want een onderzoeker die vindt dat de prijs-dividend-ratio niet bij de dividenden past, moet eerst weten hoeveel ruis er al zit in een waardering waarin alleen onbekend is. Hier komt de standaardfout van 2% terug, want bij een volatiliteit van 20% per jaar is het gemiddelde van een eeuw jaarrendementen maar op procentpunt nauwkeurig, zoals Rendementen en hun statistiek afleidde. Voor de dividendgroei hieronder is die standaardfout 0,93 procentpunt, en de simulatie laat zien wat zo’n onnauwkeurigheid doet zodra ze in de kleine noemer terechtkomt.
We kalibreren op Shillers jaarreeks en berekenen daarvoor het gemiddelde, de standaarddeviatie en de standaardfout van de reële log-dividendgroei en het reële log-rendement.
shiller_raw = hap_data.shiller()
annual = shiller_raw[shiller_raw.index.month == 12]

log_dgrowth = np.log(annual["real_dividend"]).diff().dropna()
log_return = np.log(annual["real_total_return_price"]).diff().dropna()

calibration = pd.DataFrame(
    {
        "gemiddelde": [log_dgrowth.mean(), log_return.mean()],
        "standaarddeviatie": [log_dgrowth.std(ddof=1), log_return.std(ddof=1)],
        "standaardfout gemiddelde": [
            log_dgrowth.std(ddof=1) / np.sqrt(len(log_dgrowth)),
            log_return.std(ddof=1) / np.sqrt(len(log_return)),
        ],
        "n": [len(log_dgrowth), len(log_return)],
    },
    index=["reële dividendgroei (log)", "reëel totaalrendement (log)"],
).round(4)

calibrationOver 154 jaarwaarnemingen groeit het reële dividend gemiddeld 1,61% per jaar, met een standaarddeviatie van 11,5% en een standaardfout van 0,93 procentpunt. Het gemiddelde reële logrendement is 6,82% (standaardfout 1,42 procentpunt), en dat getal nemen we als . Omdat in de simulatie bekend is, onderschat ze de werkelijke onzekerheid van een analist.
In het ware model geldt dus Gordon met en . Het verschil is 5,2 procentpunt, bijna de 5 procentpunt van het toy-voorbeeld. De ware prijs-dividend-ratio is .
Strikt genomen vraagt de Gordon-formule gewone gemiddelden, die een halve variantie boven de log-gemiddelden liggen: voor en voor . De ware ratio wordt dan ongeveer 17, maar voor de breedte van de verdeling maakt dat weinig uit.
Een analist ziet jaar dividendgroei, schat als het steekproefgemiddelde en vult dat met de juiste in het Gordon-model in. We laten dat 20 000 analisten doen, voor gelijk aan 20, 50 en 100 jaar.
g_true, sigma_g, r_true = 0.0161, 0.115, 0.0682
n_sim = 20_000

pd_true = (1 + g_true) / (r_true - g_true)
rows = []
pd_hat_by_T = {}                                 # bewaard voor de figuur
for T in (20, 50, 100):
    growth = rng.normal(g_true, sigma_g, size=(n_sim, T))
    g_hat = growth.mean(axis=1)
    finite = g_hat < r_true                      # anders: oneindige prijs
    pd_hat = np.where(finite, (1 + g_hat) / (r_true - g_hat), np.nan)
    pd_hat_by_T[T] = pd_hat
    rows.append(
        {
            "T (jaren)": T,
            "standaardfout geschatte g": sigma_g / np.sqrt(T),
            "PD 5e percentiel": np.nanpercentile(pd_hat, 5),
            "PD mediaan": np.nanpercentile(pd_hat, 50),
            "PD 95e percentiel": np.nanpercentile(pd_hat, 95),
            "aandeel geschatte g > r": 1 - finite.mean(),
        }
    )

print(f"ware prijs-dividend-ratio: {pd_true:.2f}")
pd.DataFrame(rows).set_index("T (jaren)").round(4)
ware prijs-dividend-ratio: 19.50
De waardering valt veel breder uit dan de standaardfout van doet vermoeden. Bij is die standaardfout 1,6 procentpunt, een keurig getal. Toch loopt het interval tussen het 5e en het 95e percentiel van 12,5 tot 40,8, rond een waarheid van 19,5. Een analist die niets fout doet, zit er dan naar boven tot een factor twee naast (). Met een eeuw data loopt het interval nog van 14,1 tot 30,8.
De verdeling is ook scheef, omdat convex is in . Bij ligt het 5e percentiel 36% onder de waarheid en het 95e percentiel 109% erboven, zodat de fout naar boven ongeveer drie keer zo groot is. In een klein deel van de steekproeven komt zelfs boven uit (de laatste kolom). De prijs is dan oneindig, een teken dat het model buiten zijn geldigheidsgebied wordt gebruikt.
De figuur zet de verdeling bij , dezelfde 20 000 steekproeven als in de tabel, naast de hyperbool die de vorm ervan verklaart. Links gaat het om de lange staart naar rechts, en rechts om hoe steil de hyperbool wordt vlak voor . Het rechterpaneel toont drie waarden van , en omdat de asymptoot met meeschuift, doet een onzekere hetzelfde als een onzekere .
Source
T_plot = 50
pd_hat = pd_hat_by_T[T_plot]                     # dezelfde steekproeven als in de tabel

fig, axes = plt.subplots(1, 2, figsize=(10, 3.6))

axes[0].hist(pd_hat[np.isfinite(pd_hat) & (pd_hat < 120)], bins=60, edgecolor="white")
axes[0].axvline(pd_true, color="black", lw=1.4)
axes[0].set_xlabel("Geïmpliceerde prijs-dividend-ratio")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].set_title(f"Waardering uit $\\hat g$ over {T_plot} jaar")

g_grid = np.linspace(-0.02, 0.06, 400)
for r_val, label in [(0.06, "$r = 6\\%$"), (0.0682, "$r = 6{,}82\\%$"), (0.08, "$r = 8\\%$")]:
    visible = g_grid < r_val - 0.002
    ratio = np.full_like(g_grid, np.nan)
    ratio[visible] = (1 + g_grid[visible]) / (r_val - g_grid[visible])
    axes[1].plot(g_grid * 100, ratio, lw=1.6, label=label)
axes[1].axvline(g_true * 100, color="black", lw=1.0, ls="--")
axes[1].set_ylim(0, 120)
axes[1].set_xlabel("Groeivoet $g$ (procent per jaar)")
axes[1].set_ylabel("Prijs-dividend-ratio")
axes[1].set_title("De hyperbool $ (1+g)/(r-g) $")
axes[1].legend()

plt.show()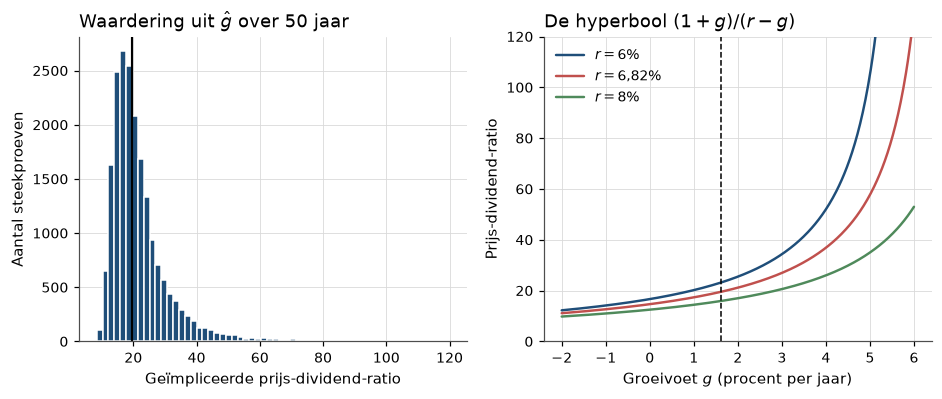
Figure 1:Links staat de verdeling van de prijs-dividend-ratio die volgt uit een op vijftig jaar geschatte groeivoet, met de ware waarde als verticale lijn. De verdeling is scheef naar rechts. Rechts staat de verklaring, want de prijs-dividend-ratio is een hyperbool in met een verticale asymptoot op . De gestreepte lijn is de ware groeivoet. Ver van de asymptoot is de hyperbool vlak en doet een kleine schattingsfout weinig, vlak ervoor schiet hij omhoog.
De simulatie hield vast en liet onzeker. In de replicatie gaat het om het omgekeerde, want daar is de vraag of zelf beweegt.
6Replicatie op echte data
De eerste cel bouwt het panel met de log-prijs-dividend-ratio en de gemiddelde jaarlijkse dividendgroei en rendementen over de tien jaar erna. Ze meldt ook de uitersten van de prijs-dividend-ratio en de autocorrelatie van de regressor.
# real_price, real_dividend (voortschrijdend twaalfmaands dividend, gedefleerd) en
# real_total_return_price (cum-dividend reële totaalrendementsindex), december.
horizon = 10

pd_ratio = (annual["real_price"] / annual["real_dividend"]).rename("PD")
log_pd = np.log(pd_ratio).rename("log_pd")

future_growth = (
    np.log(annual["real_dividend"].shift(-horizon) / annual["real_dividend"]) / horizon
).rename("dividendgroei")
future_return = (
    np.log(
        annual["real_total_return_price"].shift(-horizon)
        / annual["real_total_return_price"]
    )
    / horizon
).rename("rendement")

panel = pd.concat([log_pd, future_growth, future_return], axis=1).dropna()
print(f"steekproef: {panel.index[0]:%Y} t/m {panel.index[-1]:%Y}, "
      f"{len(panel)} overlappende jaarwaarnemingen")
print(f"PD hele reeks: laagst {pd_ratio.min():.1f} ({pd_ratio.idxmin():%Y}), "
      f"hoogst {pd_ratio.max():.1f} ({pd_ratio.idxmax():%Y})")
print(f"autocorrelatie log PD in het panel: {panel['log_pd'].autocorr():.3f}")
panel.describe().round(4)
steekproef: 1871 t/m 2015, 145 overlappende jaarwaarnemingen
PD hele reeks: laagst 9.9 (1917), hoogst 86.2 (2025)
autocorrelatie log PD in het panel: 0.885
Het panel heeft 145 waarnemingen, van 1871 tot en met 2015. Twee opeenvolgende
tienjaarsperioden delen negen jaar, zodat hun residuen samenhangen. De regressies
gebruiken daarom Newey-West-standaardfouten (hap.newey_west), die voor zulke
samenhang corrigeren, met negen lags, één per gedeeld jaar. De helling is de
parameter van de regressor, log_pd.
fits = {
    column: hap.newey_west(panel[column], panel["log_pd"], lags=horizon - 1)
    for column in ("dividendgroei", "rendement")
}

results = pd.DataFrame(
    {
        "coëfficiënt": [fit.params["log_pd"] for fit in fits.values()],
        "standaardfout": [fit.bse["log_pd"] for fit in fits.values()],
        "t-waarde": [fit.tvalues["log_pd"] for fit in fits.values()],
        "R2": [fit.rsquared for fit in fits.values()],
    },
    index=["reële dividendgroei, 10 jaar vooruit", "reëel totaalrendement, 10 jaar vooruit"],
)
results.round(4)De tabel laat zien dat de prijs-dividend-ratio het rendement voorspelt en de dividendgroei niet. De figuur toont beide regressies als puntenwolk, en daarin gaat het om het verschil in helling tussen het linker- en het rechterpaneel.
Source
fig, axes = plt.subplots(1, 2, figsize=(10, 3.8), sharex=True)

for ax, column, title in [
    (axes[0], "dividendgroei", "Reële dividendgroei"),
    (axes[1], "rendement", "Reëel totaalrendement"),
]:
    ax.scatter(panel["log_pd"], panel[column] * 100, s=14, alpha=0.6)
    slope, intercept = np.polyfit(panel["log_pd"], panel[column] * 100, 1)
    grid_x = np.linspace(panel["log_pd"].min(), panel["log_pd"].max(), 50)
    ax.plot(grid_x, intercept + slope * grid_x, color="black", lw=1.4)
    ax.axhline(0, color="grey", lw=0.8)
    ax.set_xlabel("log prijs-dividend-ratio")
    ax.set_ylabel("Procent per jaar")
    ax.set_title(f"{title}, 10 jaar vooruit")

plt.show()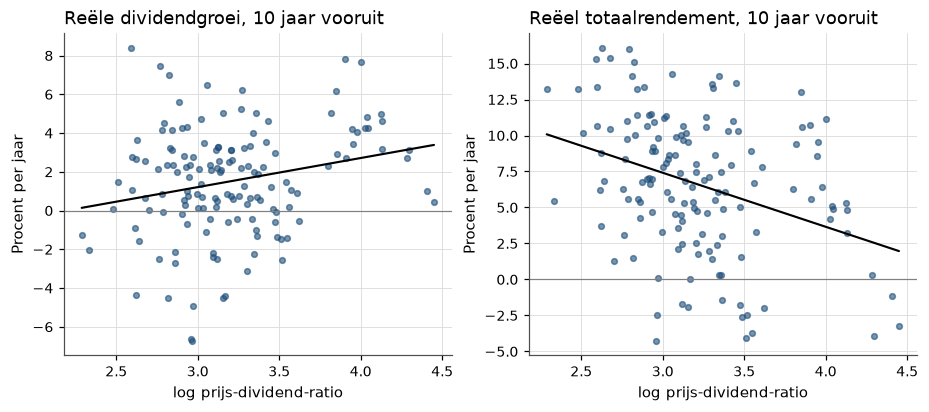
Figure 2:Elk punt is één decemberwaarneming tussen 1871 en 2015. Links de gerealiseerde reële dividendgroei over de volgende tien jaar, rechts het gerealiseerde reële totaalrendement, beide tegen de log-prijs-dividend-ratio van dat moment. Links stijgt de lijn zwak en niet significant, rechts daalt ze duidelijk. Als Williams’ aanname klopte, zouden de twee panelen andersom liggen.
De figuur bevestigt de tabel. De rendementswolk helt naar beneden, terwijl de dividendwolk nauwelijks helt.
Shiller werkte dezelfde gedachte uit tot een eigen maatstaf: de cyclically adjusted price-earnings ratio (CAPE, de koers gedeeld door de gemiddelde reële winst over tien jaar) Shiller (2000). Winst is een betere noemer dan dividend, omdat ze niet van het uitkeringsbeleid afhangt, en middelen over tien jaar voorkomt dat één slecht jaar de noemer bepaalt. Herhalen we de rendementsregressie met log CAPE als regressor, dan verwachten we dezelfde richting, een negatieve helling, en een hogere , omdat de noemer minder ruis bevat.
cape_panel = pd.concat(
    [np.log(annual["cape"]).rename("log_cape"), future_return], axis=1
).dropna()
fit_cape = hap.newey_west(cape_panel["rendement"], cape_panel["log_cape"], lags=horizon - 1)

pd.DataFrame(
    {
        "coëfficiënt": [fit_cape.params["log_cape"]],
        "t-waarde": [fit_cape.tvalues["log_cape"]],
        "R2": [fit_cape.rsquared],
        "n": [int(fit_cape.nobs)],
    },
    index=["log CAPE → reëel rendement, 10 jaar vooruit"],
).round(4)Die verwachting komt uit, want de helling is negatief en de is twee keer zo hoog. De steekproef begint pas in 1881, omdat CAPE tien jaar winst nodig heeft. Toch bewijst het sterkere verband weinig, want CAPE is met kennis van de hele reeks als voorspeller gekozen.
Wat betekent één log-punt? Het is het verschil tussen een prijs-dividend-ratio van 54 en een van 20 (). De identiteit in logs zegt waar dat log-punt heen moet. Bij benadering is de log-ratio van vandaag de som van tien jaar log-dividendgroei, min de som van tien jaar log-rendementen, plus de log-ratio over tien jaar. Regresseren we elk van die drie op de log-ratio van vandaag, dan tellen de hellingen op tot ongeveer één. De tabel rekent de jaarhellingen om naar tien jaar.
| deel van het log-punt | berekening | log-punt |
|---|---|---|
| snellere dividendgroei | 0,15 | |
| lager rendement | 0,38 | |
| hogere ratio over tien jaar (rest) | 0,47 | |
| totaal | 1 |
Het rendement verklaart ruim twee keer zoveel als de dividendgroei, en de ratio blijft lang hoog. De optelling is bij benadering, want de exacte log-vorm van Campbell en Shiller weegt latere jaren met een factor iets onder één en bevat een kleine term voor het dividendrendement. De 0,47 is dus een orde van grootte.
De laatste cel zet de uitkomst voor de prijs-dividend-ratio naast wat er volgens Williams’ lezing zou moeten gelden en wat we vooraf verwachtten.
growth_fit, return_fit = results.iloc[0], results.iloc[1]
pd.DataFrame(
    {
        "Williams (constante r)": ["positief, significant", "groot", "nul", "nul"],
        "verwacht": ["niet significant", "klein", "negatief, significant", "rond 10%"],
        "hier": [
            f"{growth_fit['coëfficiënt']:.3f} (t = {growth_fit['t-waarde']:.2f})",
            f"{growth_fit['R2']:.2f}",
            f"{return_fit['coëfficiënt']:.3f} (t = {return_fit['t-waarde']:.2f})",
            f"{return_fit['R2']:.2f}",
        ],
    },
    index=["dividendgroei: coëfficiënt", "dividendgroei: R2",
           "rendement: coëfficiënt", "rendement: R2"],
)Geslaagd. Alle drie de verwachtingen komen uit, want de dividendcoëfficiënt is niet significant, de rendementscoëfficiënt is negatief en significant, en de ligt rond tien procent (tabel hierboven). Alleen het teken van de dividendcoëfficiënt past bij Williams, en toch is de uitkomst voor zijn model een verwerping, omdat geen constante blijkt maar een tijdreeks.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Het dividend discount model verklaart veel. Het rust op een identiteit die niet breekt, en legt vast dat een prijs alleen beweegt als verwachte uitkeringen of discontovoeten bewegen, zodat elke waarderingsdiscussie een discussie wordt over welke van de twee het is. Het Gordon-model gaf de praktijk een werkbare vuistregel, namelijk dat het verwachte rendement gelijk is aan dividendrendement plus groei, en de PVGO liet zien dat groei en waarde niet hetzelfde zijn.
Waar het breekt. Het model breekt niet in de boekhoudkundige identiteit, maar in de aanname van Williams dat constant is. De prijs-dividend-ratio voorspelt de tienjaarsgroei van dividenden nauwelijks () en het tienjaarsrendement wel (). Volgens (13) beweegt dus. Ruis in de schatting van verklaart dat niet. De simulatie liet waarderingen zien die tot een factor twee naast zitten, terwijl de ratio van 10 tot 86 liep, en de beweging van die ratio voorspelt rendementen en geen dividenden. De discontovoet , het enige getal dat Williams als gegeven nam, verklaart ruim twee keer zoveel van de beweging als de dividendgroei.
Risico of vergissing? Beide lezingen passen bij dezelfde tabel. In de Chicago-lezing is de vergoeding voor aandelenrisico, hoog als mensen arm en bang zijn en laag als ze rijk zijn, zodat voorspelbare rendementen passen bij een goed werkende markt. In de Yale-lezing extrapoleren mensen de laatste jaren, betalen ze te veel na goede jaren en te weinig na slechte, en is de voorspelbaarheid de trage correctie van die vergissing. Omdat beide dezelfde negatieve helling voorspellen, kan pas een theorie over ze scheiden. In 2013, toen Fama en Shiller samen de Nobelprijs kregen, was het vak daar nog niet uit (Fama, Shiller en “Discount Rates”).
Theorie of feit? Bij elke bijdrage vragen we of ze een theorie levert die getoetst kan worden, of een feit dat nog op een verklaring wacht. Bachelier leverde een feit, koersen als random walk, terwijl Williams een identiteit leverde die waar is zonder iets uit te sluiten, en een model met een constante dat toetsbaar is. Dat model werd pas decennia later zo getoetst en verworpen, na het CAPM, dat in Opzet, data en conventies het eerste getoetste model van het vak heet.
Wat er daarna kwam. Williams had geen theorie van , maar wel het inzicht dat er een nodig is. Markowitz verplaatste de vraag van wat één aandeel waard is naar welke portefeuille een belegger moet houden en welk risico daarbij telt, in Markowitz, Roy en Tobin.
8Oefeningen
Solution to Exercise 1
(1) De eindwaarde op is . Terugrekenen met laat die factor wegvallen: . De prijs is , en de eindwaarde is daarvan 85,2%.
g_late_alt = 0.04
terminal_instap = dividends[-1] * (1 + g_late_alt) / (r - g_late_alt)
terminal_pv_instap = terminal_instap / (1 + r) ** n
price_instap = discounted.sum() + terminal_pv_instap

pd.Series({
    "eindwaarde op t=0": terminal_pv_instap,
    "prijs p_0": price_instap,
    "aandeel eindwaarde": terminal_pv_instap / price_instap,
    "verandering prijs": price_instap / price - 1,
}).round(4)
eindwaarde op t=0 17.3333
prijs p_0 20.3333
aandeel eindwaarde 0.8525
verandering prijs -0.1528
dtype: float64(2) De prijs daalt met ruim 15%, van 24,00 naar 20,33. De eindwaarde daalt 17,5%, van 21,00 naar 17,33, omdat één procentpunt minder groei een vijfde groter maakt en iets kleiner. Omdat de eindwaarde het grootste deel van de prijs is, werkt die daling bijna volledig door. De waardering hangt dus vooral af van de groei in de verre toekomst, en juist daarover weet niemand iets.
:::{exercise}
:label: ex-williams-ddm-1

**De bel die het model toestaat.** Neem $r = 8\%$, $d_0 = 2{,}00$ en constante
dividendgroei $g = 3\%$.

1. Bereken de fundamentele waarde $p^{f}_0$ en de fundamentele
   prijs-dividend-ratio.
2. Laat zien dat $p_t = p^{f}_t + B_t$ met $\E_t[B_{t+1}] = (1+r) B_t$ voldoet
   aan $p_t = \E_t[d_{t+1}+p_{t+1}]/(1+r)$.
3. Stel dat $p_0 = p^{f}_0 + 10$ en dat de bel exact zijn verwachte pad volgt.
   Bereken de prijs-dividend-ratio na 10, 25 en 50 jaar. Vanaf welk jaar is meer
   dan de helft van de prijs bel?
Solution to ex-williams-ddm-1
(1) . Gedeeld door het dividend van vandaag geeft dat .
(2) Vul in: , omdat per constructie aan de vergelijking voldoet. De bel is een tweede, even geldige oplossing van dezelfde differentievergelijking.
(3) We volgen fundament en bel jaar voor jaar en zoeken het eerste jaar waarin de bel groter is.
r_ex, d0_ex, g_ex, b0 = 0.08, 2.00, 0.03, 10.0

t_grid = np.array([0, 10, 25, 50])
d_t = d0_ex * (1 + g_ex) ** t_grid
p_f = d_t * (1 + g_ex) / (r_ex - g_ex)
b_t = b0 * (1 + r_ex) ** t_grid

bubble = pd.DataFrame(
    {
        "jaar": t_grid,
        "fundamenteel": p_f,
        "bel": b_t,
        "prijs": p_f + b_t,
        "PD-ratio": (p_f + b_t) / d_t,
        "aandeel bel": b_t / (p_f + b_t),
    }
).set_index("jaar").round(3)

crossing_year = None
for year in range(200):
    bubble_value = b0 * (1 + r_ex) ** year
    fundamental_value = d0_ex * (1 + g_ex) ** (year + 1) / (r_ex - g_ex)
    if bubble_value > fundamental_value:           # bel groter dan fundament
        crossing_year = year
        break

print(f"de bel is meer dan de helft van de prijs vanaf jaar {crossing_year}")
bubble
de bel is meer dan de helft van de prijs vanaf jaar 30
De prijs-dividend-ratio loopt van 25,6 via 28,6 en 37,0 naar 74,1 na vijftig jaar, en vanaf jaar 30 is meer dan de helft van de prijs bel. De bel groeit met 8% per jaar en het fundament met 3%, zodat het aandeel van de bel naar één loopt. De transversaliteitsvoorwaarde is daarmee de aanname die uitsluit dat de prijs-dividend-ratio voor altijd blijft stijgen, en dat is een aanname over gedrag, niet over wiskunde.
:::{exercise}
:label: ex-williams-ddm-2

**Groei die waarde vernietigt.** Een bedrijf verwacht volgend jaar een winst per
aandeel van $e_1 = 5{,}00$. De discontovoet is $r = 9\%$.

1. Bereken de prijs en de PVGO voor $\mathrm{ROE} \in \{6\%, 9\%, 12\%\}$ bij een
   inhoudingspercentage $b = 0{,}5$.
2. Het bedrijf verhoogt $b$ naar $0{,}6$. Voor welke $\mathrm{ROE}$ stijgt de
   prijs, en waarom?
Solution to ex-williams-ddm-2
We passen (11) toe bij beide inhoudingspercentages.
e1_ex, r_ex2 = 5.00, 0.09

rows_pvgo = []
for roe in (0.06, 0.09, 0.12):
    price_half = (1 - 0.5) * e1_ex / (r_ex2 - 0.5 * roe)
    price_more = (1 - 0.6) * e1_ex / (r_ex2 - 0.6 * roe)
    rows_pvgo.append(
        {
            "ROE": roe,
            "prijs bij b = 0,5": price_half,
            "PVGO bij b = 0,5": price_half - e1_ex / r_ex2,
            "prijs bij b = 0,6": price_more,
        }
    )

pd.DataFrame(rows_pvgo).set_index("ROE").round(4)(1) Zonder groei is het bedrijf waard. Bij is de prijs en de PVGO ; bij 9% is de prijs en de PVGO nul; bij 12% is de prijs en de PVGO .
(2) Meer inhouden verhoogt de prijs alleen bij (naar 111,11) en verlaagt hem bij 6% (naar 37,04). Bij maakt niets uit, want een investering tegen de discontovoet heeft een netto contante waarde van nul. Dat lijkt op de stelling van Miller en Modigliani Miller & Modigliani (1961) (bij gegeven investeringen raakt het uitkeringsbeleid de waarde niet), maar het is niet hetzelfde, omdat hier juist de investering verandert. Groei is in dit model dus geen aparte bron van waarde, maar een herverpakking van .
:::{exercise}
:label: ex-williams-ddm-3

**De replicatie op een andere steekproef.** Herhaal de twee regressies uit de
replicatie op de naoorlogse steekproef (waarnemingen vanaf december 1945) en op
een horizon van vijf jaar in plaats van tien. Rapporteer coëfficiënt,
$t$-waarde en $R^2$ voor beide afhankelijke variabelen. Verandert de conclusie
over welk van de twee kanalen beweegt?
Solution to ex-williams-ddm-3
Voor vier combinaties van steekproef en horizon herhalen we de twee regressies.
def horizon_panel(frame, h, start=None):
    """Overlapping h-year forward growth and return, against log PD."""
    sub = frame if start is None else frame.loc[start:]
    lpd = np.log(sub["real_price"] / sub["real_dividend"]).rename("log_pd")
    growth_h = (np.log(sub["real_dividend"].shift(-h) / sub["real_dividend"]) / h).rename(
        "dividendgroei"
    )
    return_h = (
        np.log(sub["real_total_return_price"].shift(-h) / sub["real_total_return_price"])
        / h
    ).rename("rendement")
    return pd.concat([lpd, growth_h, return_h], axis=1).dropna()


rows_ex = []
for label, h, start in [
    ("1871–, h=10", 10, None),
    ("1945–, h=10", 10, "1945"),
    ("1871–, h=5", 5, None),
    ("1945–, h=5", 5, "1945"),
]:
    sample = horizon_panel(annual, h, start)
    for column in ("dividendgroei", "rendement"):
        fit = hap.newey_west(sample[column], sample["log_pd"], lags=h - 1)
        rows_ex.append(
            {
                "steekproef": label,
                "variabele": column,
                "coëfficiënt": fit.params.iloc[1],
                "t-waarde": fit.tvalues.iloc[1],
                "R2": fit.rsquared,
                "n": int(fit.nobs),
            }
        )

pd.DataFrame(rows_ex).set_index(["steekproef", "variabele"]).round(4)De rendementscoëfficiënt is in alle vier de varianten negatief, en naoorlogs sterker: met op tien jaar. De dividendcoëfficiënt is overal klein en alleen over de volle steekproef op vijf jaar net significant (, ). Ook dan reageert de dividendgroei over vijf jaar met log-punt op één log-punt prijs-dividend-ratio, tegen voor het rendement. De conclusie verandert niet.
De -waarden schommelen wel sterk, want 71 naoorlogse waarnemingen op tien jaar zijn nog geen acht onafhankelijke perioden. Wat dit leert: de richting van het resultaat is robuust en de sterkte niet, omdat een helling met zo weinig onafhankelijke perioden net zo slecht te meten is als een gemiddeld rendement.
- Williams, J. B. (1938). The Theory of Investment Value. Harvard University Press.
- Gordon, M. J., & Shapiro, E. (1956). Capital Equipment Analysis: The Required Rate of Profit. Management Science, 3(1), 102–110. 10.1287/mnsc.3.1.102
- Gordon, M. J. (1959). Dividends, Earnings, and Stock Prices. The Review of Economics and Statistics, 41(2), 99–105. 10.2307/1927792
- Campbell, J. Y., & Shiller, R. J. (1988). The Dividend-Price Ratio and Expectations of Future Dividends and Discount Factors. Review of Financial Studies, 1(3), 195–228. 10.1093/rfs/1.3.195
- Shiller, R. J. (2000). Irrational Exuberance. Princeton University Press.
- Stambaugh, R. F. (1999). Predictive Regressions. Journal of Financial Economics, 54(3), 375–421. 10.1016/S0304-405X(99)00041-0
- Miller, M. H., & Modigliani, F. (1961). Dividend Policy, Growth, and the Valuation of Shares. The Journal of Business, 34(4), 411–433. 10.1086/294442
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD