

De factor zoo
1Overzicht
Hoeveel van de honderden gepubliceerde voorspellers van rendementen, in dit college signalen, zijn echt, en waarom verzwakken ze na publicatie? De meeste doorstaan een strengere drempel en zijn in de oorspronkelijke constructie te repliceren. Na publicatie verliezen ze echter meer dan de helft van hun rendement, veel meer dan publicatieselectie alleen kan verklaren. Dit college gaat in vier stappen.
We leiden de procedures voor meervoudig toetsen af, van Bonferroni en Holm tot Benjamini-Hochberg-Yekutieli, en zien waarom de drempel met het aantal geprobeerde signalen stijgt.
We laten zien dat selectie op de gepubliceerde rendementen opblaast, en hoeveel daling na publicatie daaruit volgt als functie van de ware sterkte van een signaal.
We simuleren een vakgebied zonder één echte anomalie, waarin de gepubliceerde signalen na publicatie al hun rendement verliezen.
We repliceren de verzwakking na publicatie, de strengere drempels en de alpha’s ten opzichte van vijf factoren plus momentum op 212 signalen.
In zijn presidentiële rede voor de American Finance Association zei John Cochrane in 2011 dat de cross-sectie vroeger uit het CAPM leek te komen. Nu hebben we volgens hem een dierentuin van nieuwe factoren Cochrane (2011). Die factor zoo (de honderden gepubliceerde kenmerken die rendementen voorspellen) telde bij Harvey et al. (2016) al 316 soorten. Zij eisten daarom een -waarde boven 3. McLean & Pontiff (2016) vonden dat rendementen na publicatie ruim de helft lager liggen, en Hou et al. (2020) dat de meeste van 452 anomalieën verdwijnen als kleine aandelen weinig gewicht krijgen. Daarop volgde een tegenreactie van Chen & Zimmermann (2022) en Jensen et al. (2023), die de meeste signalen wel konden repliceren. Waarom ze verzwakken, staat bij Santa-Clara (2026) nog op de lijst van open vragen. Zo verschuift het werk in de cross-sectie van het toetsen van één theorie naar het tellen van feiten die op een verklaring wachten.
2Intuïtie: waarom zou dit waar zijn?
Denk aan een vakgebied met driehonderd onderzoekers. Elk van hen heeft een database en een idee, en elk idee laat zich op tien manieren uitwerken, bijvoorbeeld met een andere definitie van winst of een andere weging. Stel verder dat geen enkel idee iets voorspelt. Toch haalt ongeveer een op de veertig uitwerkingen door toeval een -waarde boven twee. Tijdschriften publiceren die resultaten en de rest verdwijnt in een la, zodat de literatuur vol significante signalen staat.
Na publicatie komt het toeval dat zo’n signaal in de steekproef significant maakte niet terug, en zijn gemiddelde rendement zakt naar nul. Voor een lezer lijkt de anomalie dan verdwenen, terwijl er nooit iets was. Dat heet de winner’s curse (de vloek van de winnaar): wie selecteert op een hoge schatting, selecteert ook op een gunstige meetfout.
Er zijn twee andere redenen waarom een rendement na publicatie kan zakken. Is het signaal een patroon dat beleggers over het hoofd zagen, dan lezen hedgefondsen het artikel en handelen erop tot het niet meer loont. Is het een beloning voor risico, dan kan de premie dalen omdat meer beleggers dat risico willen dragen. McLean en Pontiff zagen dat de kalender deze verhalen deels scheidt. Tussen het einde van de steekproef en de publicatie is het toeval uit de steekproef al weg, terwijl de markt het resultaat nog niet kent. Een daling in die tussenperiode is dus statistiek, en een extra daling na publicatie is leren.
Daarom vraagt een grote factor zoo om een hogere drempel en om shrinkage (krimpen: een schatting naar een gemeenschappelijk gemiddelde trekken, harder naarmate ze ruisiger is). Een gemeten rendement van 1% per maand is dan waarschijnlijk een kleinere echte premie met een gunstige meetfout. We verwachten dus dat een toevalstreffer na publicatie al zijn rendement verliest en een sterk signaal bijna niets. De daling in de tussenperiode zou kleiner moeten zijn dan die na publicatie.
3Toy-voorbeeld: tien kandidaat-signalen en zes procedures
Een onderzoeker toetst tien signalen, A tot en met J. Van elk signaal kent hij de -waarde van het gemiddelde long-short-rendement. Alleen A heeft een echte premie, en de andere negen zijn ruis, maar dat weet hij niet. Bij onafhankelijke toetsen haalt een nulsignaal met kans 0,028 (de p-waarde van E hieronder), zodat gemiddeld van de negen zo ver komen, geen vier. Bij varianten van één idee, die samen hoog of laag uitvallen, zijn vier treffers wel goed mogelijk.
De tweezijdige p-waarde is , met de standaardnormale verdelingsfunctie uit een normale tabel. De tabel sorteert de p-waarden van klein naar groot, met rang , en geeft per rang de grens van vier procedures bij 5%. Bonferroni verdeelt de 5% over de tien toetsen en Holm maakt die grens na elke verwerping ruimer, zodat beide tegen ook maar één onterechte ontdekking beschermen. BH en BHY bewaken het aandeel onterechte ontdekkingen, zodat hun grens met de rang meegroeit, en BHY is strenger om ook bij samenhangende signalen te gelden. De Theorie leidt de grenzen af.
| rang | signaal | Bonferroni | Holm | BH | BHY | ||
|---|---|---|---|---|---|---|---|
| 1 | A | 4,10 | 0,00004 | 0,00500 | 0,00500 | 0,005 | 0,00171 |
| 2 | B | 2,79 | 0,00527 | 0,00500 | 0,00556 | 0,010 | 0,00341 |
| 3 | C | 2,70 | 0,00693 | 0,00500 | 0,00625 | 0,015 | 0,00512 |
| 4 | D | 2,45 | 0,01429 | 0,00500 | 0,00714 | 0,020 | 0,00683 |
| 5 | E | 2,20 | 0,02781 | 0,00500 | 0,00833 | 0,025 | 0,00854 |
| 6 | F | 1,60 | 0,10960 | 0,00500 | 0,01000 | 0,030 | 0,01024 |
| 7 | J | −1,30 | 0,19360 | 0,00500 | 0,01250 | 0,035 | 0,01195 |
| 8 | G | 1,10 | 0,27133 | 0,00500 | 0,01667 | 0,040 | 0,01366 |
| 9 | H | 0,80 | 0,42371 | 0,00500 | 0,02500 | 0,045 | 0,01537 |
| 10 | I | −0,50 | 0,61708 | 0,00500 | 0,05000 | 0,050 | 0,01707 |
Uit de tabel volgen zes antwoorden, die alleen in de grens verschillen.
Naïef (, dus ) vindt A tot en met E, vijf ontdekkingen waarvan vier onterecht.
vindt alleen A.
Bonferroni vergelijkt elke met , wat overeenkomt met , en vindt alleen A, omdat B met net boven de grens blijft.
Holm loopt van boven naar beneden en stopt bij de eerste mislukking. A haalt en B haalt , maar C mist , zodat A en B overblijven.
Benjamini-Hochberg (BH) zoekt de grootste rang met . Bij D geldt , en geen hogere rang haalt zijn grens, dus BH vindt A tot en met D.
BHY deelt de grenzen van BH door . Alleen A haalt dan zijn grens. Bij rang 2 is BHY met 0,00341 zelfs strenger dan Bonferroni met 0,005, zodat de prijs van robuustheid bij tien signalen al zichtbaar is.
Eén functie voert de zes procedures uit op een rij -waarden, zodat we haar later op echte data kunnen gebruiken. Een tweede cel zet de ontdekkingen naast die van de hand.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import optimize, stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
def multiple_testing(t, q=0.05):
"""Two-sided rejections of H0: mean = 0 for a vector of t-statistics (normal p-values).
Columns: naive (p <= q), |t| > 3, Bonferroni, Holm (step-down),
Benjamini-Hochberg and Benjamini-Hochberg-Yekutieli (step-up).
"""
# TODO: naar hap.stats (multiple testing corrections)
t = np.asarray(t, dtype=float)
M = t.size
p = 2 * stats.norm.sf(np.abs(t))
order = np.argsort(p) # indices from smallest to largest p
ranks = np.arange(1, M + 1)
p_sorted = p[order]
def step_up(thresholds):
passed = np.nonzero(p_sorted <= thresholds)[0]
k = passed.max() + 1 if passed.size else 0
reject = np.zeros(M, dtype=bool)
reject[order[:k]] = True
return reject
holm = np.zeros(M, dtype=bool)
for j, idx in enumerate(order): # step down: stop at the first failure
if p[idx] > q / (M - j):
break
holm[idx] = True
c_M = np.sum(1.0 / ranks)
return pd.DataFrame({
"naief": p <= q,
"|t| > 3": np.abs(t) > 3,
"Bonferroni": p <= q / M,
"Holm": holm,
"BH": step_up(q * ranks / M),
"BHY": step_up(q * ranks / (M * c_M)),
})t_toy = pd.Series([4.10, 2.79, 2.70, 2.45, 2.20, 1.60, 1.10, 0.80, -0.50, -1.30],
index=list("ABCDEFGHIJ"))
p_hand = pd.Series([0.00004, 0.00527, 0.00693, 0.01429, 0.02781,
0.10960, 0.27133, 0.42371, 0.61708, 0.19360], index=t_toy.index)
p_code = pd.Series(2 * stats.norm.sf(t_toy.abs()), index=t_toy.index)
toy_tests = multiple_testing(t_toy).set_index(t_toy.index)
discoveries = {col: "".join(toy_tests.index[toy_tests[col]]) for col in toy_tests}
by_hand = {"naief": "ABCDE", "|t| > 3": "A", "Bonferroni": "A",
"Holm": "AB", "BH": "ABCD", "BHY": "A"}
print("p-waarden gelijk aan de tabel (5 decimalen):", np.allclose(p_code, p_hand, atol=5e-6))
print("Bonferroni-drempel |t| >", round(stats.norm.isf(0.025 / 10), 3),
"; c(10) =", round(np.sum(1 / np.arange(1, 11)), 3))
assert discoveries == by_hand
pd.DataFrame({"met de hand": by_hand, "code": discoveries}).rename_axis("procedure")p-waarden gelijk aan de tabel (5 decimalen): True
Bonferroni-drempel |t| > 2.807 ; c(10) = 2.929
Code en hand vinden dezelfde signalen. Benjamini-Hochberg accepteert hier drie nulsignalen, omdat het alleen hun aandeel beperkt. Met één lijstje -waarden vindt de onderzoeker dus één tot vijf signalen, afhankelijk van de vergissing die hij wil vermijden.
4Theorie
De theorie beantwoordt de twee helften van de vraag. Voor de vraag hoeveel signalen echt zijn, leiden we de procedures uit het toy-voorbeeld af en daarna de Bayesiaanse shrinkage van gemeten rendementen. Voor de verzwakking berekenen we hoeveel selectie een gepubliceerd rendement opblaast en hoe McLean en Pontiff selectie en arbitrage scheiden. Tot slot bekijken we de modellen die de factor zoo met een handvol factoren willen samenvatten.
4.1Opzet en notatie
Er zijn signalen (in de literatuur ook anomalieën of factoren), , bijvoorbeeld de 316 van Harvey, Liu en Zhu. Signaal is een long-short-portefeuille met maandrendement en ware premie , het gemiddelde rendement, of de alpha als er een factormodel bij staat. Over maanden schatten we met standaardfout , en . In grote steekproeven is , waarin de verwachte -waarde is. Een premie van 0,5% per maand met een standaardfout van 0,2% heeft bijvoorbeeld . De nulhypothese is , en de ware nulhypothesen vormen de verzameling .
Een procedure verwerpt een aantal hypothesen. Met het aantal onterechte en het totale aantal verwerpingen definiëren we
De family-wise error rate (FWER) is dus de kans op minstens één onterechte ontdekking, en de false discovery rate (FDR) het verwachte aandeel onterechte ontdekkingen. Omdat nooit groter is dan , geldt , zodat een procedure die de FWER onder houdt dat ook met de FDR doet. Het niveau is meestal 5%.
4.2Bonferroni en Holm: de kans op één vergissing
Een onderzoeker die elk signaal op niveau toetst, houdt de kans op zelfs één onterechte ontdekking onder , hoe de signalen ook samenhangen. De kans dat minstens één van de ware nulhypothesen wordt verworpen, is namelijk nooit groter dan de som van de afzonderlijke kansen. Holm merkte op dat die som alleen over de ware nulhypothesen hoeft te lopen. Zolang na verwerpingen nog geen ware nulhypothese is verworpen, zijn er hoogstens ware nulhypothesen over, zodat de grens bij elke volgende rang ruimer mag worden.
Voor Bonferroni is het bewijs één regel, namelijk . Voor Holm volstaat het naar de kleinste p-waarde onder de ware nulhypothesen te kijken.
Proof 1
Holm houdt de FWER onder . Laat de ware nulhypothese met de kleinste p-waarde zijn, met rang in de geordende rij. Vóór staan hoogstens p-waarden, dus . Een onterechte verwerping betekent dat Holm tot minstens rang komt, zodat . Daarom is . Holm verwerpt alles wat Bonferroni verwerpt. Omdat , haalt elke Bonferroni-verwerping ook de Holm-grens, en alle kleinere p-waarden halen dan hun lagere Holm-grens eveneens.
4.3Benjamini-Hochberg-Yekutieli: het aandeel vergissingen onder afhankelijkheid
Benjamini en Hochberg beperken het aandeel onterechte ontdekkingen tot door de p-waarden stapsgewijs met te vergelijken. Het bewijs in De industrie als financier: indexfondsen, DFA, AQR (Theorem 2) gebruikte echter onafhankelijke p-waarden. Twintig varianten van value worden echter tegelijk significant of niet, en zo’n klont nulsignalen kan de stapsgewijze procedure over een grens duwen. Benjamini en Yekutieli lieten zien dat het ergste geval te beheersen is door te delen door een logaritmische factor.
Het bewijs neemt één ware nulhypothese en BH op niveau , en schrijft als de telescopische som . Omdat ook geeft voor elke , is de verwachte bijdrage van hoogstens . Die grens hangt niet meer van af, en daarmee ook niet van de afhankelijkheid tussen de p-waarden. Opgeteld over de ware nulhypothesen en met geeft dat de stelling.
Die robuustheid heeft een hoge prijs. Bij is , zodat BHY bij een niveau van 5% in feite met ongeveer 0,8% werkt. Harvey, Liu en Zhu catalogiseerden 316 factoren en berekenden voor elk jaar sinds 1967 welke drempel de procedures zouden hebben opgelegd. In hun figuur 3 stijgt de Bonferroni-drempel van 1,96 naar 3,78 in 2012, terwijl BHY bij 5% op 2,78 uitkomt. Hun vuistregel van ongeveer 2,8 ronden ze in de samenvatting af tot een -waarde boven 3 Harvey et al. (2016). Omdat ongepubliceerde toetsen in hun telling ontbreken, zijn die drempels ondergrenzen.
4.4Publicatieselectie: hoeveel een gepubliceerde is opgeblazen
Een tijdschrift ziet niet alle -waarden maar alleen de waarden boven twee. Een gepubliceerde is daarom een trekking uit een afgeknotte verdeling, en het gemiddelde van die afgeknotte verdeling ligt boven het ware gemiddelde. Het verschil is de meetfout die de selectie heeft binnengehaald, en omdat die meetfout buiten de steekproef niet terugkomt, daalt het rendement na publicatie.
De verwachte gepubliceerde is dus de ware plus een opslag , en die opslag is groot als het signaal zwak is. Voor geeft een normale tabel en , zodat een gepubliceerde nulfactor gemiddeld heeft en buiten de steekproef 100% van zijn rendement verliest. Voor echte signalen daalt snel, naar 28,5% bij en 1,4% bij . Een toevalstreffer verliest dus alles en een sterk signaal bijna niets, zoals we bij de intuïtie al vermoedden. Een daling van een kwart past bij rond twee, wat de tweede oefening narekent.
De nulsignalen B tot en met E uit het toy-voorbeeld laten die opslag zien. Hun gemiddelde van ligt dicht bij , terwijl hun ware nul is en hun na publicatie dus rond nul hoort te liggen.
4.5De decompositie van McLean en Pontiff
Selectie werkt op de steekproef en arbitrage op de kalender. Een model met die twee elementen voorspelt drie niveaus van het gemiddelde rendement, en de verschillen daartussen meten de twee oorzaken apart.
Het ware gemiddelde rendement van signaal is tot publicatie en daarna, met het deel dat door handel op het artikel verdwijnt. Met Theorem 3 is dan
Van de steekproef naar de tussenperiode verdwijnt dus alleen de selectieopslag, en van de tussenperiode naar na publicatie alleen het deel . McLean en Pontiff schatten die verschillen met één gepoolde regressie op twee dummies en een vast effect per signaal,
waarin één is in de tussenperiode en na publicatie. Gedeeld door het gemiddelde rendement in de steekproef meet het aandeel statistische bias en het aandeel arbitrage. Volgens McLean en Pontiff lag het rendement in de tussenperiode 26% lager en na publicatie 58%, zodat 32% toe te schrijven is aan handel op het artikel McLean & Pontiff (2016). De 26% noemen ze een bovengrens voor datamining, omdat werkdocumenten al vóór publicatie circuleren en de tussenperiode dus ook arbitrage bevat.
4.6Bayesiaanse shrinkage van gemeten rendementen
Een geschatte premie is de som van een echte premie en een meetfout. Hoe groter de meetfout ten opzichte van de spreiding in echte premies, hoe meer van een extreme schatting meetfout is en hoe harder we haar terugtrekken. Die spreiding volgt uit de factor zoo zelf, want de variantie van de schattingen is die van de premies plus die van de meetfouten.
De krimpfactor ligt tussen nul en één. Hij stijgt met de spreiding van echte premies, omdat een extreme schatting dan vaker een extreme premie is. Hij daalt met de standaardfout , omdat een ruisige schatting minder zegt. Neem een artikel dat een rendement van per maand rapporteert met , dus met standaardfout . Zijn de premies van alle geprobeerde signalen verdeeld met en , dan geldt
Het verwachte rendement na publicatie is de helft van het gepubliceerde, en de kans dat de premie positief is, is . Het signaal is dus waarschijnlijk echt, maar half zo sterk. Met wordt de krimpfactor , zodat er 0,2% overblijft. De code rekent beide gevallen na.
alpha_pub, t_pub = 0.01, 2.5
s_pub = alpha_pub / t_pub
rows = {}
for tau in (0.004, 0.002):
    shrink = tau**2 / (tau**2 + s_pub**2)
    post_mean = shrink * alpha_pub
    post_sd = np.sqrt(shrink) * s_pub
    rows[f"tau = {tau:.1%}"] = {"krimpfactor": shrink, "E[alpha | schatting] (%)": 100 * post_mean,
                                "SD posterior (%)": 100 * post_sd, "P(alpha > 0)": stats.norm.cdf(post_mean / post_sd)}
toy_bayes = pd.DataFrame(rows).T
assert np.allclose(toy_bayes.loc["tau = 0.4%", ["krimpfactor", "E[alpha | schatting] (%)"]], [0.5, 0.5])
assert np.isclose(toy_bayes.loc["tau = 0.2%", "E[alpha | schatting] (%)"], 0.2)
toy_bayes.round(4)De tabel bevestigt de handberekening, en ze laat zien dat het antwoord afhangt van wat de rest van de factor zoo over zegt. In de berekening komt de publicatieselectie niet voor, en het volgende gevolg zegt waarom dat mag.
De winner’s curse verdwijnt dus niet, maar hij zit in de krimpfactor, mits de prior de verdeling van alle geprobeerde signalen beschrijft. Een prior die alleen uit gepubliceerde signalen is geschat, is zelf geselecteerd en daardoor te optimistisch. Harvey, Liu en Zhu antwoorden op de factor zoo frequentistisch, met een hogere drempel, en Jensen, Kelly en Pedersen Bayesiaans, met een prior. Empirical Bayes schat de prior uit de data zelf, met het laatste deel van de stelling, . Bij Jensen et al. (2023) delen factoren binnen elk van hun 13 thema’s een themagemiddelde, dat zelf naar nul wordt getrokken. Meer factoren per thema maken dat gemiddelde preciezer, zodat een grote factor zoo het bewijs voor afzonderlijke factoren juist kan versterken.
4.7FF5 en q-factoren als keuzes voor de stochastische discontofactor
Als driehonderd signalen maar een handvol onafhankelijke bronnen van verwacht rendement hebben, moet een klein aantal factoren de rest verklaren. Twee groepen zochten ze in de boekhouding, de een via de waardering en de ander via de investeringsbeslissing, en kwamen ongeveer bij dezelfde factoren uit. Vanaf hier zijn , en marktwaarde, boekwaarde en bruto rendement, en niet de tellingen en of de krimpfactor van hierboven.
Fama & French (2015) herschreven het dividendkortingsmodel uit Williams en het dividend discount model met clean surplus (het dividend is de winst min de groei van het eigen vermogen) en deelden door de boekwaarde . Met de interne discontovoet geldt
Houden we de rest vast, dan gaan een lagere en een hogere verwachte winst samen met een hogere . Een hogere groei van het eigen vermogen gaat samen met een lagere . Dat zijn value, winstgevendheid en investeringen. Zo kwamen naast markt, SMB en HML de factoren RMW (robust minus weak, winstgevendheid) en CMA (conservative minus aggressive, investeringen) in het model. Ze zijn gebouwd zoals SMB en HML in (2), en Novy-Marx (2013) had de winstgevendheidsfactor al voorbereid. Hou et al. (2015) redeneerden vanuit de investeringsbeslissing, wat een tweeperiodemodel zichtbaar maakt.
Proof 5
De eerste-ordevoorwaarde naar is . De waarde na dividend is en de payoff is , zodat . Dat volgt dan uit de eerste-ordevoorwaarde.
Bij gegeven risico daalt het verwachte rendement dus met de investeringsgraad en stijgt het met de verwachte winstgevendheid. Een onderneming met lage kapitaalkosten investeert veel, en een die een hoge winst verwacht maar weinig investeert, moet hoge kapitaalkosten hebben. Het q-model heeft daarom vier factoren: markt, size, investeringen (I/A) en winstgevendheid (ROE). Beide modellen zijn keuzes voor de stochastische discontofactor , lineair in een paar factorrendementen zoals in Cochrane: p = E[mx]. Ze verklaren een anomalie alleen in de zin dat de alpha ten opzichte van die klein is. Of RMW en CMA risico meten of een vergissing, zegt (8) niet, want de identiteit geldt voor elke discontovoet.
Of een nieuwe factor iets toevoegt, is een vraag over zijn gewicht in gegeven de andere factoren (Proposition 1). Zo zeggen Fama en French dat HML in hun steekproef overbodig wordt, dus dat nul is. Met een dubbele LASSO voor de controlefactoren vinden Feng et al. (2020) de meeste nieuwe factoren overbodig, op enkele na. Volgens Novy-Marx & Velikov (2016) blijven na transactiekosten vooral strategieën met weinig omzet over. Intussen verpakten fondsen value, momentum en kwaliteit als smart beta (regelgebaseerde portefeuilles die naar factoren kantelen). Eind 2019 bezaten indexfondsen iets meer van de Amerikaanse beurs dan actieve aandelenfondsen Investment Company Institute (2020). Is de daling na publicatie arbitrage, dan holt elke dollar in zulke fondsen de premie verder uit.
5Simulatie: een vakgebied zonder anomalieën
Hoeveel verliest een gepubliceerd signaal na publicatie als er alleen selectie werkt en niemand arbitreert? We simuleren 300 onderzoekers die elk 20 signalen toetsen op een markt waarin geen enkel signaal een premie heeft. Elk signaal is een long-short-portefeuille met een volatiliteit van 3% per maand, gemeten over 20 jaar. Alleen signalen met worden gepubliceerd, en daarna volgen 5 jaar tussenperiode en 20 jaar na publicatie. De cel simuleert maandrendementen en vat per periode de gepubliceerde signalen samen.
n_researchers, n_per_researcher = 300, 20
periods = {"in-sample": 240, "oos": 60, "post": 240}
PERIOD_NAMES = {"in-sample": "in de steekproef", "oos": "tussenperiode", "post": "na publicatie"}
sigma_ls, c_pub = 0.03, 2.0


def simulate_field(alpha, rng):
    """Mean, standard error and t of every signal in each period; alpha is the true monthly premium."""
    out = {}
    for name, T in periods.items():
        r = alpha + sigma_ls * rng.standard_normal((T, alpha.size))
        mean, se = r.mean(axis=0), r.std(axis=0, ddof=1) / np.sqrt(T)
        out[name] = pd.DataFrame({"mean": mean, "se": se, "t": mean / se})
    return out


null_field = simulate_field(np.zeros(n_researchers * n_per_researcher), rng)
published = null_field["in-sample"]["t"] > c_pub
mills = stats.norm.pdf(c_pub) / stats.norm.sf(c_pub)

null_summary = pd.DataFrame({
    "gem. rendement (% p.m.)": [100 * null_field[k]["mean"][published].mean() for k in periods],
    "SE van dat gemiddelde": [100 * null_field[k]["mean"][published].std(ddof=1) / np.sqrt(published.sum())
                              for k in periods],
    "gem. t": [null_field[k]["t"][published].mean() for k in periods],
}, index=list(periods))
print(f"{published.sum()} van {published.size} signalen gepubliceerd "
      f"(verwacht {published.size * stats.norm.sf(c_pub):.0f}); "
      f"theorie E[t | t > 2] = {mills:.3f}")
null_summary.rename(index=PERIOD_NAMES).round(3)
142 van 6000 signalen gepubliceerd (verwacht 137); theorie E[t | t > 2] = 2.373
Van de 6000 nulsignalen worden er 142 gepubliceerd, tegen 137 verwacht. Hun gemiddelde van 2,33 ligt dicht bij de 2,37 uit (2), en het kleine verschil komt van de geschatte standaardfout en de beperkte steekproef van 142 signalen. In de steekproef verdienen de gepubliceerde signalen 0,44% per maand, maar in de tussenperiode en na publicatie liggen hun gemiddelden binnen twee standaardfouten van nul. Ze verliezen dus hun hele rendement, zonder dat iemand iets heeft gearbitreerd, net als de nulsignalen B tot en met E in het toy-voorbeeld.
Signalen met een echte premie verliezen minder. Omdat alleen de schatting telt, trekken we voor elke ware sterkte de -waarden in en buiten de steekproef direct uit en vergelijken we de gesimuleerde daling met (3).
def inverse_mills(x):
    return stats.norm.pdf(x) / stats.norm.sf(x)


def decline_formula(delta, c=c_pub):
    return inverse_mills(c - delta) / (delta + inverse_mills(c - delta))


deltas = np.linspace(0.25, 5.0, 20)
simulated_decline = []
for delta in deltas:
    t_in = delta + rng.standard_normal(200_000)
    t_out = delta + rng.standard_normal(200_000)            # same standard error out of sample
    keep = t_in > c_pub
    simulated_decline.append(1 - t_out[keep].mean() / t_in[keep].mean())
simulated_decline = np.array(simulated_decline)

delta_26 = optimize.brentq(lambda d: decline_formula(d) - 0.26, 0.5, 5.0)
print(f"grootste afwijking simulatie - formule: {np.max(np.abs(simulated_decline - decline_formula(deltas))):.4f}")
print(f"daling van 26% bij een ware verwachte t van {delta_26:.2f}")
grootste afwijking simulatie - formule: 0.0049
daling van 26% bij een ware verwachte t van 2.10
Simulatie en formule verschillen nergens meer dan een half procentpunt. Bij een ware verwachte van 2,10 hoort een daling van 26%. Links in de figuur is de vraag of het histogram de afgeknotte kromme volgt, rechts waar de lijnen van 26% en 58% de formule snijden.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
t_pub = null_field["in-sample"]["t"][published]
axes[0].hist(t_pub, bins=np.linspace(2, 4.5, 26), density=True, alpha=0.6, label="gepubliceerde t, in de steekproef")
axes[0].hist(null_field["post"]["t"][published], bins=np.linspace(-4, 4.5, 43), density=True,
             histtype="step", lw=1.6, color="black", label="dezelfde signalen, na publicatie")
grid = np.linspace(2, 4.5, 200)
axes[0].plot(grid, stats.norm.pdf(grid) / stats.norm.sf(c_pub), color=hap.plotting.COLORS[1],
             label="afgeknotte normale, t > 2")
axes[0].set_title("(a) 6000 nulsignalen, alleen t > 2 gepubliceerd")
axes[0].set_xlabel("t-waarde")
axes[0].set_ylabel("Dichtheid")
axes[0].legend()

fine = np.linspace(0.05, 5, 200)
axes[1].plot(fine, 100 * decline_formula(fine), label="formule D(δ)")
axes[1].plot(deltas, 100 * simulated_decline, "o", ms=4, label="simulatie")
for level, text in ((26, "McLean-Pontiff tussenperiode: 26%"), (58, "McLean-Pontiff na publicatie: 58%")):
    axes[1].axhline(level, color="black", lw=0.8, ls="--")
    axes[1].text(3.0, level + 2, text, fontsize=8)
axes[1].set_title("(b) Daling die alleen uit selectie volgt")
axes[1].set_xlabel("Ware verwachte t-waarde δ")
axes[1].set_ylabel("Verwachte daling van het rendement (%)")
axes[1].legend(loc="upper right")
fig.tight_layout()
plt.show()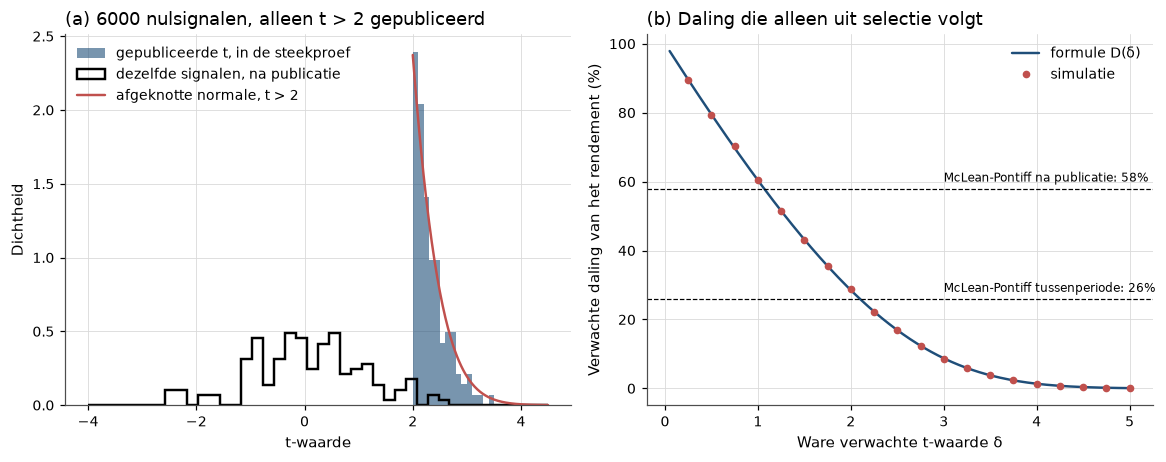
Figure 1:Links volgen de gepubliceerde -waarden in een markt zonder anomalieën de afgeknotte normale verdeling, terwijl dezelfde signalen na publicatie weer rond nul liggen. Rechts staat de daling die puur uit de selectie volgt, als functie van de ware sterkte van het signaal. De 26% van McLean en Pontiff past bij een ware verwachte rond 2,1. Hun 58% zou signalen rond één vereisen, die de drempel meestal niet eens halen.
Selectie verklaart de daling in de tussenperiode dus alleen bij zwakke signalen. Hoe sterk de echte signalen zijn, moet de replicatie laten zien.
6Replicatie op echte data
6.1De verzwakking na publicatie
De eerste vraag is of de volgorde van McLean en Pontiff terugkomt. De cel koppelt elke signaalmaand aan een periode en berekent per periode het gemiddelde rendement over de signalen.
osap = hap_data.osap("portfolios")
doc = hap_data.osap("signaldoc")
doc = doc[doc["Cat.Signal"] == "Predictor"].set_index("signal")
for column in ["Year", "SampleStartYear", "SampleEndYear", "T-Stat"]:
    doc[column] = pd.to_numeric(doc[column], errors="coerce")

long = (osap.rename_axis(columns="signal").melt(ignore_index=False, value_name="r")
        .dropna().reset_index().join(doc[["SampleStartYear", "SampleEndYear", "Year"]], on="signal"))
year = long["date"].dt.year
long["periode"] = np.select(
    [year < long["SampleStartYear"], year <= long["SampleEndYear"], year <= long["Year"]],
    ["voor", "in-sample", "oos"], default="post")
long = long[long["periode"] != "voor"].reset_index(drop=True)

per_signal = long.groupby(["signal", "periode"])["r"].agg(["mean", "std", "count"]).unstack("periode")
means = per_signal["mean"][["in-sample", "oos", "post"]]
se_means = (per_signal["std"] / np.sqrt(per_signal["count"]))[["in-sample", "oos", "post"]]

period_table = pd.DataFrame({
    "signalen": means.notna().sum(),
    "gem. maanden": per_signal["count"][["in-sample", "oos", "post"]].mean(),
    "gem. rendement (% p.m.)": 100 * means.mean(),
    "SE (over signalen)": 100 * means.std(ddof=1) / np.sqrt(means.notna().sum()),
    "gem. SE per signaal": 100 * se_means.mean(),
    "t.o.v. steekproef": means.mean() / means["in-sample"].mean() - 1,
})
print(f"{osap.shape[1]} signalen, {len(long)} signaal-maanden; publicatiejaren "
      f"{int(doc['Year'].min())}-{int(doc['Year'].max())}")
period_table.rename(index=PERIOD_NAMES).round(3)
212 signalen, 136338 signaal-maanden; publicatiejaren 1973-2016
De volgorde komt terug. Gemiddeld over alle signalen verdient een long-short-portefeuille in de steekproef 0,69% per maand, in de tussenperiode 40% minder en na publicatie 57% minder, maar nog steeds duidelijk meer dan nul.
Een enkel signaal is nauwelijks te volgen, want over een tussenperiode van gemiddeld 55 maanden is zijn standaardfout 0,48% per maand, groter dan het rendement zelf. Pas het gemiddelde over alle signalen maakt de daling meetbaar. De volgende cel schat (5) met vaste effecten per signaal en standaardfouten die per maand geclusterd zijn.
def within(x, groups):
    """Demean a series within groups (the fixed-effects transformation)."""
    return x - x.groupby(groups).transform("mean")


def mp_regression(frame, extra=None):
    """Pooled OLS of returns (% p.m.) on OOS and POST dummies with signal fixed effects.

    Standard errors are clustered by month. `extra` adds further dummy columns.
    """
    # TODO: naar hap.stats (panel regression with fixed effects and clustered errors)
    y = within(100 * frame["r"], frame["signal"])
    X = pd.get_dummies(frame["periode"])[["oos", "post"]].astype(float)
    if extra is not None:
        X = X.join(extra)
    X = X.apply(within, groups=frame["signal"])
    coef, *_ = np.linalg.lstsq(X.to_numpy(), y.to_numpy(), rcond=None)
    resid = y.to_numpy() - X.to_numpy() @ coef
    bread = np.linalg.inv(X.T.to_numpy() @ X.to_numpy())
    scores = pd.DataFrame(X.to_numpy() * resid[:, None]).groupby(frame["date"].to_numpy()).sum().to_numpy()
    se = np.sqrt(np.diag(bread @ scores.T @ scores @ bread))
    return pd.DataFrame({"coef (% p.m.)": coef, "SE (cluster maand)": se, "t": coef / se}, index=X.columns)


mp = mp_regression(long).loc[["oos", "post"]]
in_sample_mean = 100 * means["in-sample"].mean()
mp["t.o.v. gem. steekproef"] = mp["coef (% p.m.)"] / in_sample_mean
publication_effect = mp.loc["post", "coef (% p.m.)"] - mp.loc["oos", "coef (% p.m.)"]
mp.loc["publicatie-effect (verschil)"] = [publication_effect, np.nan, np.nan, publication_effect / in_sample_mean]
mp.rename(index=PERIOD_NAMES).round(3)Volgens de regressie ligt het rendement in de tussenperiode 36% en na publicatie 54% onder het gemiddelde in de steekproef, beide ruim significant, zodat het publicatie-effect 18% is. Omdat de regressie signalen naar hun aantal maanden weegt, wijkt ze iets af van de gewone gemiddelden. De daling na publicatie is vergelijkbaar met die van McLean en Pontiff, maar bij ons ligt meer ervan al vóór publicatie.
6.2De verdeling van -waarden en de drempels van Harvey, Liu en Zhu
Hoeveel signalen halen de strengere drempels? De cel past de zes procedures uit het toy-voorbeeld toe op onze -waarden in de steekproef en na publicatie, en vergelijkt die met de -waarden in de artikelen.
t_values = (means / se_means)
tests = {period: multiple_testing(t_values[period].dropna()).sum()
         for period in ["in-sample", "post"]}
threshold_table = pd.DataFrame(tests).rename(index={"naief": "naief |t| > 1.96"})
threshold_table.loc["aantal signalen"] = [t_values[p].notna().sum() for p in ["in-sample", "post"]]

M = int(t_values["in-sample"].notna().sum())
print(f"Bonferroni-drempel bij M = {M}: |t| > {stats.norm.isf(0.025 / M):.2f}; "
      f"c(M) = {np.sum(1 / np.arange(1, M + 1)):.2f}")

reported = doc["T-Stat"].reindex(t_values.index)
both = reported.notna()
t_ours = t_values.loc[both, "in-sample"]
rank_corr = stats.spearmanr(reported[both], t_ours)[0]
print(f"gerapporteerde t in het artikel beschikbaar voor {both.sum()} signalen; "
      f"rangcorrelatie met onze t in de steekproef: {rank_corr:.2f}; "
      f"aandeel van onze t in de steekproef > 1.96 onder deze signalen: {np.mean(t_ours > 1.96):.2f}")
threshold_table.rename(columns=PERIOD_NAMES)
Bonferroni-drempel bij M = 212: |t| > 3.68; c(M) = 5.94
gerapporteerde t in het artikel beschikbaar voor 188 signalen; rangcorrelatie met onze t in de steekproef: 0.62; aandeel van onze t in de steekproef > 1.96 onder deze signalen: 0.88
In de steekproef halen 186 van de 212 signalen , dus 88%. Voor de 188 signalen met een gerapporteerde is de rangcorrelatie met onze 0,62, zodat de replicatie in de oorspronkelijke constructie grotendeels werkt. De 65% mislukkingen van Hou, Xue en Zhang zijn daarmee niet in tegenspraak, omdat zij naar marktwaarde wogen met NYSE-breekpunten. De drempels van Harvey, Liu en Zhu schrappen wel een flink deel. Bij vallen 64 van de 186 significante signalen af, en Bonferroni, met bij , houdt er 85 over. In de figuur is links te zien hoe de verdeling langs de drempels verschuift. Rechts gaat het om de helling van de puntenwolk, die onder één ligt als sterke signalen meer verliezen.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
bins = np.linspace(-4, 15, 58)
axes[0].hist(t_values["in-sample"], bins=bins, alpha=0.6, label="in de steekproef")
axes[0].hist(t_values["post"], bins=bins, alpha=0.6, label="na publicatie")
for value, style, text in ((1.96, ":", "1,96"), (3.0, "--", "3,0"), (stats.norm.isf(0.025 / M), "-", "Bonferroni")):
    axes[0].axvline(value, color="black", lw=0.9, ls=style, label=f"drempel {text}")
axes[0].set_title("(a) t-waarden van 212 gepubliceerde signalen")
axes[0].set_xlabel("t-waarde van het gemiddelde long-short-rendement")
axes[0].set_ylabel("Aantal signalen")
axes[0].legend()

ok = means[["in-sample", "post"]].dropna()
axes[1].scatter(100 * ok["in-sample"], 100 * ok["post"], s=12, alpha=0.7)
lims = np.array([-0.5, 3.0])
axes[1].plot(lims, lims, color="black", lw=0.8, label="45 graden: geen verzwakking")
slope, intercept = np.polyfit(100 * ok["in-sample"], 100 * ok["post"], 1)
axes[1].plot(lims, intercept + slope * lims, color=hap.plotting.COLORS[1],
             label=f"OLS: helling {slope:.2f}".replace(".", ","))
axes[1].axhline(0, color="grey", lw=0.6)
axes[1].set_title("(b) Rendement per signaal, in de steekproef en na publicatie")
axes[1].set_xlabel("Gemiddelde in de steekproef (% per maand)")
axes[1].set_ylabel("Gemiddelde na publicatie (% per maand)")
axes[1].legend()
fig.tight_layout()
plt.show()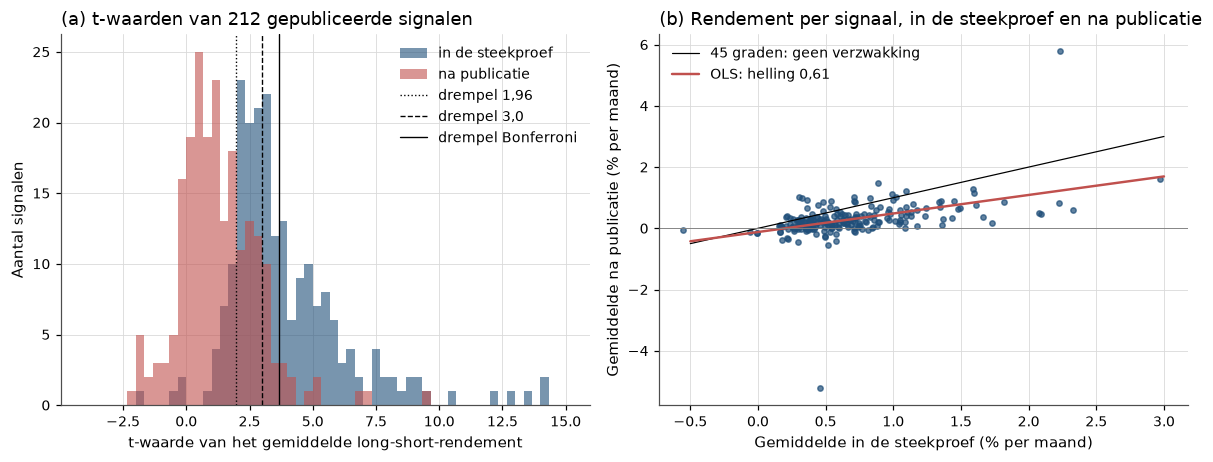
Figure 2:Links liggen de -waarden in de steekproef ver rechts van elke drempel. Na publicatie is de verdeling naar links geschoven en haalt nog maar een klein deel de Bonferroni-drempel. Rechts blijven signalen die in de steekproef sterk waren gemiddeld de sterkste, maar met een helling van 0,61 verliezen ze meer naarmate hun rendement in de steekproef hoger was. De puntenwolk ligt gemiddeld ruim onder de 45-gradenlijn.
Na publicatie halen nog 66 van de 212 signalen en 11 de Bonferroni-drempel. Die daling komt deels doordat de periode na publicatie korter is dan de steekproef, zodat dezelfde premie een kleinere geeft.
6.3Shrinkage: hoeveel van de daling is statistiek?
Shrinkage voorspelt hooguit 7 tot 9% van de daling in de tussenperiode, tegen 40% waargenomen, zoals de twee schattingen hieronder laten zien. De eerste trekt de gemiddelden in de steekproef terug met een prior gecentreerd op nul, zoals bij Jensen, Kelly en Pedersen. Een willekeurig signaal levert dan gemiddeld niets op, en de factor zoo bepaalt hoe breed de premies verdeeld zijn.
def empirical_bayes(estimate, se, zero_mean=False):
    """Normal-normal empirical Bayes: posterior means and sds with the prior estimated by moments."""
    # TODO: naar hap.stats (empirical Bayes shrinkage)
    mu = 0.0 if zero_mean else float(np.mean(estimate))
    tau2 = max(float(np.mean((estimate - mu) ** 2) - np.mean(se**2)), 0.0)
    weight = tau2 / (tau2 + se**2)
    return mu + weight * (estimate - mu), np.sqrt(weight) * se, mu, np.sqrt(tau2)


est, se_in = means["in-sample"].to_numpy(), se_means["in-sample"].to_numpy()
post_mean, post_sd, _, tau_hat = empirical_bayes(est, se_in, zero_mean=True)
shrink = pd.DataFrame({"ruw": est, "EB": post_mean, "SE ruw": se_in, "SD posterior": post_sd,
                       "na publicatie": means["post"].to_numpy()}, index=means.index)

survive = pd.Series({
    "tau (% p.m.)": 100 * tau_hat,
    "gem. krimpfactor": np.mean(tau_hat**2 / (tau_hat**2 + se_in**2)),
    "ruw: t > 1.96": np.sum(est / se_in > 1.96),
    "EB: posterior gem./SD > 1.96": np.sum(post_mean / post_sd > 1.96),
    "voorspelde daling door shrinkage": 1 - post_mean.mean() / est.mean(),
    "helling na publicatie op ruw": np.polyfit(shrink["ruw"], shrink["na publicatie"], 1)[0],
    "helling na publicatie op EB": np.polyfit(shrink["EB"], shrink["na publicatie"], 1)[0],
})
survive.round(3)
tau (% p.m.) 0.799
gem. krimpfactor 0.935
ruw: t > 1.96 186.000
EB: posterior gem./SD > 1.96 181.000
voorspelde daling door shrinkage 0.089
helling na publicatie op ruw 0.605
helling na publicatie op EB 0.609
dtype: float64De geschatte spreiding van premies is per maand, tegen een gemiddelde standaardfout van 0,19%. De krimpfactor is daardoor gemiddeld 0,94, en het gemiddelde rendement over alle signalen krimpt met 9%. Van de 186 significante signalen blijven er 181 over. Deze prior is echter op gepubliceerde signalen geschat en daardoor te optimistisch (Corollary 1). Een tweede schatting neemt de selectie expliciet mee. Stel dat de ware verwachte -waarden verdeeld zijn als en dat alleen werd gepubliceerd. Omdat met onafhankelijke standaardnormale ruis , is de gerapporteerde dan afgeknot normaal met variantie . Zo kunnen we met maximale aannemelijkheid schatten, en Theorem 4 geeft de verwachte .
c_hurdle = 1.96
t_reported = doc["T-Stat"].dropna()
t_reported = t_reported[t_reported > c_hurdle]


def negative_loglik(params):
    """Truncated-normal likelihood of published t-statistics, t ~ N(mu, 1 + omega^2) given t > c."""
    mu, log_omega = params
    scale = np.sqrt(1 + np.exp(2 * log_omega))
    return -np.sum(stats.norm.logpdf(t_reported, mu, scale) - stats.norm.logsf(c_hurdle, mu, scale))


fit = optimize.minimize(negative_loglik, x0=[2.0, 0.0], method="Nelder-Mead")
mu_delta, omega = fit.x[0], np.exp(fit.x[1])
expected_delta = (mu_delta + omega**2 * t_reported) / (1 + omega**2)

truncation = pd.Series({
    "signalen met gerapporteerde t > 1.96": len(t_reported),
    "gem. gerapporteerde t": t_reported.mean(),
    "mu_delta": mu_delta, "omega": omega,
    "gem. E[delta | t]": expected_delta.mean(),
    "voorspelde daling door selectie": 1 - expected_delta.mean() / t_reported.mean(),
    "waargenomen daling tussenperiode": -period_table.loc["oos", "t.o.v. steekproef"],
    "waargenomen daling na publicatie": -period_table.loc["post", "t.o.v. steekproef"],
    "convergentie": fit.success,
})
truncation.round(3)
signalen met gerapporteerde t > 1.96 183
gem. gerapporteerde t 4.685
mu_delta -7.355
omega 6.131
gem. E[delta | t] 4.373
voorspelde daling door selectie 0.067
waargenomen daling tussenperiode 0.405
waargenomen daling na publicatie 0.571
convergentie 1
dtype: objectDe 183 gerapporteerde -waarden boven 1,96 liggen gemiddeld op 4,69, en de geschatte verdeling van ware -waarden heeft en . Een willekeurig geprobeerd signaal zou daarmee met kans een negatieve premie hebben. Dat is ongeloofwaardig, want onderzoekers kiezen het teken zelf en zouden zo’n signaal omdraaien. Deze uitkomst laat vooral zien hoe weinig een afgeknotte steekproef over de ligging van de verdeling zegt. Voor de posterior telt het gewicht , zodat de verwachte ware gemiddeld 4,37 is en selectie een daling van 7% voorspelt. Bij gelijke standaardfout daalt het gemiddelde rendement relatief even veel als , zodat die 7% met de waargenomen dalingen te vergelijken is.
Beide benaderingen blijven dus ver onder de 40%, terwijl de intuïtie die daling juist aan statistiek toeschreef. Volgens de simulatie vereist al de 26% van McLean en Pontiff ware -waarden rond 2,1, en de 40% hier nog zwakkere, maar de echte signalen zijn veel sterker. Er blijven drie verklaringen over.
De gerapporteerde -waarden zijn sterker opgeblazen dan afknotting beschrijft, omdat onderzoekers ook varianten probeerden die ze nooit publiceerden.
De tussenperiode bevat al arbitrage op werkdocumenten.
Anomalierendementen dalen in het algemeen door de tijd, wat de derde oefening onderzoekt.
6.4Alpha’s ten opzichte van FF5 plus momentum
Als een handvol factoren de factor zoo samenvat, moeten de alpha’s van de signalen ten opzichte van FF5 plus momentum klein zijn, ook na publicatie. De cel regresseert elk signaal op FF5 plus momentum, over 1963–2024 en alleen na publicatie, en telt de significante alpha’s per procedure.
factors = hap_data.french("F-F_Research_Data_5_Factors_2x3").join(hap_data.french("F-F_Momentum_Factor"))
factor_cols = ["Mkt-RF", "SMB", "HML", "RMW", "CMA", "Mom"]
sample = osap.index.intersection(factors.dropna().index)
R_ls, F_six = osap.loc[sample], factors.loc[sample, factor_cols].to_numpy()


def alpha_tstat(y, F):
    """OLS intercept and homoskedastic t-statistic of y on F, dropping missing months of y."""
    ok = ~np.isnan(y)
    X = np.column_stack([np.ones(ok.sum()), F[ok]])
    coef, *_ = np.linalg.lstsq(X, y[ok], rcond=None)
    resid = y[ok] - X @ coef
    se = np.sqrt(resid @ resid / (ok.sum() - X.shape[1]) * np.linalg.inv(X.T @ X)[0, 0])
    return coef[0], coef[0] / se


pub_year = doc.loc[R_ls.columns, "Year"].to_numpy()
# True where the month (row) lies after the publication year of the signal (column)
after_pub = pd.DataFrame(sample.year.to_numpy()[:, None] > pub_year[None, :],
                         index=sample, columns=R_ls.columns)
alphas = {}
for name, frame in {"1963-2024": R_ls, "na publicatie": R_ls.where(after_pub)}.items():
    values = np.array([alpha_tstat(frame[s].to_numpy(dtype=float), F_six) for s in frame.columns])
    alphas[name] = pd.DataFrame(values, index=frame.columns, columns=["alpha", "t"])

alpha_tests = {}
for name, a in alphas.items():
    rejected = multiple_testing(a["t"]).set_index(a.index)
    alpha_tests[name] = rejected.sum()
    alpha_tests[f"{name}, alpha > 0"] = rejected[a["alpha"] > 0].sum()
alpha_table = pd.DataFrame(alpha_tests)
alpha_table.loc["gem. alpha (% p.m.)"] = [100 * alphas[k.split(",")[0]]["alpha"].mean() for k in alpha_table.columns]
alpha_table.round(3)Over 1963–2024 hebben 167 van de 212 signalen een significante alpha, bijna allemaal positief, met een gemiddelde van 0,42% per maand. Na correctie blijft bij Bonferroni minder dan de helft over, maar bij BHY en BH houdt een meerderheid een significante alpha, anders dan we vooraf verwachtten. Daarvoor zijn drie redenen.
De periode 1963–2024 bevat de jaren in de steekproef waarop de signalen zijn geselecteerd.
Veel portefeuilles zijn gelijkgewogen en leunen op kleine aandelen, die de waardegewogen factoren slecht bereiken.
B/M, winstgevendheid en momentum zitten zelf in de factor zoo.
Na publicatie blijft bij elke correctie een minderheid over, van 10 bij Bonferroni tot 62 bij BH, tegen 90 zonder correctie. De gemiddelde alpha na publicatie is met 0,30% per maand gelijk aan het ruwe rendement, zodat de zes factoren niet verklaren wat er na publicatie over is.
6.5Oordeel
De tabel zet de gepubliceerde getallen naast de onze. De daling na publicatie komt bijna precies terug, maar bij ons valt meer ervan in de tussenperiode en mislukken veel minder signalen dan bij Hou, Xue en Zhang.
| grootheid | origineel | hier |
|---|---|---|
| daling in de tussenperiode | 26% | 40% (regressie 36%) |
| daling na publicatie | 58% | 57% (regressie 54%) |
| publicatie-effect | 32% | 18% |
| aandeel zonder | 65% van 452 (Hou, Xue en Zhang) | 12% van 212 |
| Bonferroni-drempel | 3,78 bij 316 factoren | 3,68 bij 212 signalen |
De replicatie is gedeeltelijk geslaagd. De volgorde van hoog naar laag komt terug, met een positief rendement na publicatie, maar het publicatie-effect is kleiner. Over de hele periode houdt bij BH en BHY een meerderheid een significante alpha. Pas na publicatie krimpt het aantal signalen met een alpha tot de verwachte minderheid.
7Wat er brak, en wat daarna kwam
Wat het kader verklaart. Na meervoudig toetsen, publicatieselectie en shrinkage hangt het antwoord op de vraag of een signaal significant is af van het aantal pogingen. Dat antwoord is streng maar niet vernietigend, want 88% van de 212 signalen haalt in de oorspronkelijke constructie en BHY houdt er 137 over. De replicatiecrisis is dus grotendeels een verschil in weging en drempels, zoals Chen en Zimmermann en Jensen, Kelly en Pedersen betoogden. Vijf of zes factoren uit de boekhouding van de onderneming verklaren daarnaast een deel van de cross-sectie, al houden de meeste signalen tegen die factoren een alpha.
Waar het breekt. Het kader breekt bij de verzwakking. In onze replicatie ligt het rendement na publicatie 57% onder dat in de steekproef, en halen nog 11 van de 212 signalen de Bonferroni-drempel. Beide shrinkage-benaderingen schrijven hoogstens 7 tot 9 van die 57 procentpunten aan publicatieselectie toe, en de zes factoren verklaren het rendement na publicatie niet. Het kader zegt hoeveel we moeten wantrouwen, maar niet waarom de premies kleiner worden.
Risico of vergissing? McLean en Pontiff concludeerden zelf dat beleggers uit wetenschappelijke publicaties over mispricing leren McLean & Pontiff (2016). Dat is de Yale-lezing, maar even goed past de Chicago-lezing, waarin kenmerken blootstelling aan risico meten. Zodra meer kapitaal via factorfondsen dat risico wil dragen, daalt de prijs ervan, zodat een lagere premie betere risicodeling betekent. De derde lezing is datamining, waarin er nooit iets was. Een daling die precies op de publicatiedatum valt, zou de lezingen kunnen scheiden. In onze data is die echter niet te onderscheiden van een algemene daling door de tijd, die zelf arbitrage of risicodeling kan zijn. Een belegger die in 2015 een factorfonds kocht, betaalde dus voor risico of voor een vermeend inzicht, en de data zeggen niet waarvoor. Santa-Clara vat het samen in het motto uit Opzet, data en conventies.
Everything I made that lasted came from bearing risk that was priced. Everything I lost came from thinking I knew something the price did not. Santa-Clara (2026)
Wat er daarna kwam. Bevatten honderden ruisige signalen elk wat informatie, dan ligt het voor de hand ze door een machine te laten combineren, zoals in Machine learning in de cross-sectie.
8Oefeningen
Solution to Exercise 1
(1) De grens wordt , wat overeenkomt met , zodat alleen A overblijft. (2) Holm vergelijkt B met en stopt, dus ook Holm vindt alleen A. Benjamini-Hochberg vergelijkt rang met . C haalt , maar D mist en geen hogere rang haalt zijn grens, zodat A, B en C overblijven. De code rekent het na.
extra_nulls = pd.Series(np.linspace(-0.9, 0.9, 10), index=[f"N{k}" for k in range(1, 11)])
t_twenty = pd.concat([t_toy, extra_nulls])
twenty_tests = multiple_testing(t_twenty).set_index(t_twenty.index)
found_twenty = {col: "".join(twenty_tests.index[twenty_tests[col]]) for col in twenty_tests}
print(f"Bonferroni-drempel bij M = 20: |t| > {stats.norm.isf(0.025 / 20):.3f}")
pd.DataFrame({"M = 10": discoveries, "M = 20": found_twenty}).rename_axis("procedure")
Bonferroni-drempel bij M = 20: |t| > 3.023
Tien extra pogingen zonder enige inhoud kosten B de Holm-ontdekking en D de BH-ontdekking, terwijl de naïeve toets niets merkt. Elke mislukte poging maakt de overgebleven ontdekkingen dus minder waard, ook als niemand die poging publiceert.
Solution to Exercise 2
(1) Zie het bewijs van Theorem 3. Dat volgt uit , want een verwachting over een verzameling waarop ligt strikt boven .
(2) en (3) De code lost en op.
delta_58 = optimize.brentq(lambda d: decline_formula(d) - 0.58, 0.01, 5.0)
print(f"daling 26%: delta = {delta_26:.3f};  daling 58%: delta = {delta_58:.3f}")
print(f"daling bij delta = 4: {decline_formula(4.0):.3%};  lambda(x) > x op [-3, 3]: "
      f"{np.all(inverse_mills(np.linspace(-3, 3, 61)) > np.linspace(-3, 3, 61))}")
daling 26%: delta = 2.097; daling 58%: delta = 1.066
daling bij delta = 4: 1.362%; lambda(x) > x op [-3, 3]: True
Een daling van 26% vereist ware verwachte -waarden rond 2,1, en 58% waarden rond 1. Bij voorspelt selectie een daling van 1,4%. De 26% van McLean en Pontiff is dus alleen statistiek als de gerapporteerde -waarden flink zijn opgeblazen, door varianten en specificatiekeuzes die de drempel niet vangt.
Solution to Exercise 3
De cel voegt een dummy per vijfjaarsperiode toe, op één na.
five_year = pd.get_dummies((long["date"].dt.year // 5) * 5, prefix="periode", dtype=float)
with_time = mp_regression(long, extra=five_year.iloc[:, 1:]).loc[["oos", "post"]]
with_time.assign(**{"t.o.v. gem. steekproef": with_time["coef (% p.m.)"] / in_sample_mean}).rename(
index=PERIOD_NAMES).round(3)Met vaste effecten voor vijfjaarsperioden is de daling in de tussenperiode 42% van het gemiddelde in de steekproef en na publicatie 41%, zodat het publicatie-effect van 18% verdwijnt. De coëfficiënten worden nu alleen geïdentificeerd doordat signalen in dezelfde vijf jaar in verschillende fasen zitten. De decompositie van McLean en Pontiff blijkt dus gevoelig voor wat kalendertijd mag verklaren, en in onze data overschaduwt een algemene daling van anomalierendementen de publicatiedatum.
Solution to Exercise 4
(1) Met jaar is . Voor is jaar, en voor is jaar.
(2) en (3) De code keert de Bonferroni-grens om.
p_378 = 2 * stats.norm.sf(3.78)
print(f"tweezijdige p bij t = 3.78: {p_378:.2e}; impliciete M = 0.05 / p = {0.05 / p_378:.0f}")
print(f"jaren voor t = 1.96, 3.00, 3.78: {[round((t / 0.5)**2, 1) for t in (1.96, 3.0, 3.78)]}")
tweezijdige p bij t = 3.78: 1.57e-04; impliciete M = 0.05 / p = 319
jaren voor t = 1.96, 3.00, 3.78: [15.4, 36.0, 57.2]
Een drempel van 3,78 komt overeen met ruim 300 toetsen, in lijn met de catalogus van 316 factoren. Een signaal met een respectabele Sharpe-ratio van 0,5 heeft dan 57 jaar data nodig om de drempel naar verwachting te halen, bijna even lang als de Amerikaanse boekhouddata sinds 1963 bestaan. Een factor zoo en een slecht gemeten gemiddeld rendement zijn zo twee kanten van hetzelfde probleem, want een strengere drempel beschermt tegen toeval maar maakt veel echte premies onmeetbaar.
- Cochrane, J. H. (2011). Presidential Address: Discount Rates. Journal of Finance, 66(4), 1047–1108. 10.1111/j.1540-6261.2011.01671.x
- Harvey, C. R., Liu, Y., & Zhu, H. (2016). \ldots and the Cross-Section of Expected Returns. The Review of Financial Studies, 29(1), 5–68. 10.1093/rfs/hhv059
- McLean, R. D., & Pontiff, J. (2016). Does Academic Research Destroy Stock Return Predictability? The Journal of Finance, 71(1), 5–32. 10.1111/jofi.12365
- Hou, K., Xue, C., & Zhang, L. (2020). Replicating Anomalies. The Review of Financial Studies, 33(5), 2019–2133. 10.1093/rfs/hhy131
- Chen, A. Y., & Zimmermann, T. (2022). Open Source Cross-Sectional Asset Pricing. Critical Finance Review, 11(2), 207–264. 10.1561/104.00000112
- Jensen, T. I., Kelly, B., & Pedersen, L. H. (2023). Is There a Replication Crisis in Finance? The Journal of Finance, 78(5), 2465–2518. 10.1111/jofi.13249
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Holm, S. (1979). A Simple Sequentially Rejective Multiple Test Procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Benjamini, Y., & Yekutieli, D. (2001). The Control of the False Discovery Rate in Multiple Testing under Dependency. The Annals of Statistics, 29(4), 1165–1188. 10.1214/aos/1013699998
- Fama, E. F., & French, K. R. (2015). A Five-Factor Asset Pricing Model. Journal of Financial Economics, 116(1), 1–22. 10.1016/j.jfineco.2014.10.010
- Novy-Marx, R. (2013). The Other Side of Value: The Gross Profitability Premium. Journal of Financial Economics, 108(1), 1–28. 10.1016/j.jfineco.2013.01.003
- Hou, K., Xue, C., & Zhang, L. (2015). Digesting Anomalies: An Investment Approach. The Review of Financial Studies, 28(3), 650–705. 10.1093/rfs/hhu068
- Feng, G., Giglio, S., & Xiu, D. (2020). Taming the Factor Zoo: A Test of New Factors. The Journal of Finance, 75(3), 1327–1370. 10.1111/jofi.12883
- Novy-Marx, R., & Velikov, M. (2016). A Taxonomy of Anomalies and Their Trading Costs. The Review of Financial Studies, 29(1), 104–147. 10.1093/rfs/hhv063
- Investment Company Institute. (2020). 2020 Investment Company Fact Book. 60th edition. https://www.ici.org/system/files/attachments/pdf/2020_factbook.pdf
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD