

Machine learning in de cross-sectie
1Overzicht
Blijft er voorspelbaarheid over als een machine alle bekende kenmerken van aandelen tegelijk gebruikt en we de voorspellingen streng buiten de steekproef beoordelen? Ja, er blijft een kleine maar echte hoeveelheid over, vooral uit niet-lineaire verbanden. Zo’n voorspelling meet verwachte rendementen echter zonder ze te verklaren, en na kosten en na 2005 wordt de winst snel kleiner.
We leiden af waarom een regressie met honderden voorspellers buiten de steekproef slechter doet dan de voorspelling nul, en hoe krimp dat herstelt.
We schatten de stochastische discontofactor als krimpprobleem met een economische prior.
We simuleren welke methoden de ware voorspelbaarheid terugvinden, en waarom een markt die optimaal leert toch voorspelbaar lijkt.
We passen de methoden toe op 212 signaalportefeuilles van Chen en Zimmermann.
Het werk van Gu, Kelly en Xiu Gu et al. (2020), hierna GKX, zette deze onderzoekslijn in gang. Ze voerden bijna honderd kenmerken van tienduizenden Amerikaanse aandelen aan een reeks voorspelmethoden, van OLS tot netwerken met vijf verborgen lagen. Elke methode werd getoetst op dertig jaar data die bij het schatten niet waren gebruikt. In sommige gevallen verdubbelde een strategie op hun voorspellingen de prestatie van de beste regressiestrategieën. Die winst kwam volgens GKX uit niet-lineaire interacties tussen voorspellers, niet uit een nieuwe variabele. De vraag was daarmee niet langer welk kenmerk een risicopremie heeft, maar hoeveel voorspelbaarheid een gedisciplineerde machine uit alle kenmerken samen haalt.
Hier staat de meting het verst van de theorie af, want een voorspelling zonder model meet verwachte rendementen maar verklaart ze niet. Drie tegenbewegingen brachten structuur terug. Kelly, Pruitt en Su lazen kenmerken als bèta’s Kelly et al. (2019). Kozak, Nagel en Santosh schatten de SDF met een Bayesiaanse prior Kozak et al. (2020), en Martin en Nagel lieten zien dat voorspelbaarheid in de steekproef ook bij rationele beleggers te verwachten is Martin & Nagel (2022). Overzichten staan in Nagel (2021) en Kelly & Xiu (2023). De toepassing aan het eind is geen replicatie van GKX, omdat gegevens over losse aandelen niet gratis zijn.
2Intuïtie: waarom zou dit waar zijn?
Denk aan een analist die tweehonderd kenmerken van elk aandeel kent. Het ware verwachte rendement verschilt tussen aandelen misschien een paar procent per jaar, terwijl het gerealiseerde rendement tien procent per maand schommelt. Schat de analist tweehonderd regressiegewichten, dan past hij vooral die schommelingen aan, omdat elk gewicht wat ruis oppikt. Samen is die ruis groter dan het signaal, en daarom voorspelt de gewone regressie buiten de steekproef slechter dan de voorspelling nul.
Machine learning is in de eerste plaats een verzameling manieren om die ruis te temmen. Krimp (shrinkage, de gewichten systematisch naar nul trekken) ruilt een kleine, bekende vertekening in voor een grote daling van de variantie. Selectie zet de meeste gewichten precies op nul.
Pas daarna komt flexibiliteit aan bod. Een regressieboom splitst de aandelen herhaaldelijk in twee groepen en neemt per groep het gemiddelde, en een neuraal netwerk is een gelaagde, niet-lineaire functie. Beide vinden interacties die een lineair model mist, bijvoorbeeld dat momentum bij kleine aandelen anders werkt dan bij grote. Dat loont alleen met discipline, zoals middelen, vroeg stoppen en elke keuze toetsen op data die bij het schatten niet zijn gebruikt.
Blijft er voorspelbaarheid over, dan moet nog blijken wat ze betekent. Santa-Clara vraagt of de voorspellingen van GKX ook werken na publicatie, op grote schaal, na kosten en als de machines tegen elkaar handelen, en de geschiedenis van eerdere anomalieën belooft weinig goeds Santa-Clara (2026). Martin en Nagel waarschuwen subtieler. Beleggers die zelf moeten leren hoe tweehonderd kenmerken met kasstromen samenhangen, zitten er elke periode een beetje naast, zodat rendementen achteraf voorspelbaar lijken terwijl er vooraf niets te verdienen viel.
We verwachten dus dat krimp de gewone regressie verslaat zodra er veel voorspellers zijn. Bomen en netwerken winnen alleen als de wereld echte interacties bevat, en een markt die leert, lijkt in de steekproef voorspelbaarder dan erbuiten.
3Toy-voorbeeld: vijf aandelen, twee kenmerken, één maand
De cel hieronder laadt de pakketten die alle code van dit college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats
from sklearn.ensemble import HistGradientBoostingRegressor, RandomForestRegressor
from sklearn.linear_model import ElasticNet, Lasso, LinearRegression, Ridge
from sklearn.neural_network import MLPRegressor
from sklearn.tree import DecisionTreeRegressor

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Vijf aandelen hebben twee gestandaardiseerde kenmerken en en een rendement in de maand erna, in procenten en min het cross-sectionele gemiddelde. Het voorbeeld laat zien wat krimp en selectie met twee regressiegewichten doen.
| aandeel | |||
|---|---|---|---|
| 1 | -2 | 1 | -3 |
| 2 | -1 | -2 | -2 |
| 3 | 0 | 0 | 1 |
| 4 | 1 | 2 | 0 |
| 5 | 2 | -1 | 4 |
De kolommen hebben gemiddelde nul en staan loodrecht op elkaar, zodat . Daardoor valt elke methode uiteen in twee losse problemen, één per kenmerk. Voor elk probleem geldt het recept uit (5),
met een straf op de absolute waarde van de gewichten en een straf op hun kwadraat.
Stap 1. en .
Stap 2, OLS (). en . De residuen , -1, 1, -1 en geven een kwadratensom van 3,5 tegen een totaal van 30, dus een in de steekproef van 88%.
Stap 3, ridge (). en , beide precies gehalveerd.
Stap 4, LASSO (). , en omdat kleiner is dan 5, is .
Stap 5, elastic net (, ). en .
De codecel rekent dezelfde gewichten uit met scikit-learn en schat daarnaast een regressieboom met één split, het bouwblok van de flexibele methoden uit de Theorie.
X_toy = np.array([[-2, 1], [-1, -2], [0, 0], [1, 2], [2, -1]], dtype=float)
r_toy = np.array([-3.0, -2.0, 1.0, 0.0, 4.0])

b_hand = pd.DataFrame({"OLS": [1.6, -0.3], "ridge (lambda=10)": [0.8, -0.15],
                       "LASSO (lambda=5)": [1.1, 0.0], "elastic net (5, 10)": [0.55, 0.0]},
                      index=["b1", "b2"]).T
# Lasso and ElasticNet scale the squared loss by 1/(2n), so alpha = lambda / n; Ridge does not
b_code = pd.DataFrame({
    "OLS": LinearRegression(fit_intercept=False).fit(X_toy, r_toy).coef_,
    "ridge (lambda=10)": Ridge(alpha=10, fit_intercept=False).fit(X_toy, r_toy).coef_,
    "LASSO (lambda=5)": Lasso(alpha=5 / 5, fit_intercept=False).fit(X_toy, r_toy).coef_,
    "elastic net (5, 10)": ElasticNet(alpha=3.0, l1_ratio=1 / 3,
                                      fit_intercept=False).fit(X_toy, r_toy).coef_,
}, index=["b1", "b2"]).T + 0.0                                    # + 0.0 turns -0.0 into 0.0
tree = DecisionTreeRegressor(max_depth=1).fit(X_toy, r_toy)

assert np.allclose(b_hand, b_code, atol=1e-8)
assert tree.tree_.feature[0] == 0 and np.isclose(tree.tree_.threshold[0], -0.5)
print(f"boom: split op x{tree.tree_.feature[0] + 1} <= {tree.tree_.threshold[0]:.1f}, "
      f"voorspellingen {np.round(tree.predict(X_toy), 2).tolist()}")
pd.concat({"met de hand": b_hand, "scikit-learn": b_code}, axis=1).round(3)
boom: split op x1 <= -0.5, voorspellingen [-2.5, -2.5, 1.67, 1.67, 1.67]
De gewichten met de hand en uit scikit-learn zijn gelijk, al deelt Lasso de kwadratensom
door , zodat bij overeenkomt met alpha=1. De boom splitst op
en voorspelt het groepsgemiddelde, voor aandelen 1
en 2 en voor de rest. Hij negeert en legt een trap waar OLS
een lijn legt.
Ridge trekt de voorspellingen dus evenredig naar het gemiddelde en laat de rangorde intact, terwijl LASSO het zwakke kenmerk weggooit en het sterke met een vast bedrag krimpt. Welke van de twee beter voorspelt, kan dit voorbeeld niet zeggen, omdat we de ware gewichten niet kennen. Ook de van 88% zegt het niet, want met twee gewichten op vijf waarnemingen meet die vooral hoe goed OLS zich aan juist deze vijf rendementen aanpast.
4Theorie
Voorspellen met honderden kenmerken is een schattingsprobleem, en de theorie volgt dat probleem in drie stappen. Eerst splitsen we de voorspelfout in ruis, bias en variantie, wat laat zien waarom de gewone regressie faalt. Daarna leiden we het recept van krimp af, samen met de maatstaf waarmee GKX methoden vergelijken. Ten slotte brengen drie modellen structuur terug, van kenmerken als bèta’s via een gekrompen SDF tot beleggers die moeten leren. De kern is dat krimp de prijs is van een zwak signaal in veel ruis.
4.1Opzet: voorspellen is schatten
Een voorspelfout heeft drie bronnen, en bij rendementen weegt de schattingsfout het zwaarst. Ruis kan niemand voorspellen, een te stijf model mist een deel van de ware functie, en een onderzoeker die veel gewichten schat, pikt met elk gewicht ook ruis op. Een flexibeler model verkleint de tweede bron en vergroot de derde, en bij rendementen is die derde bijna altijd de grootste.
We schrijven het overrendement van aandeel , hier kortweg , als . Daarin zijn de voorspellers op , bijvoorbeeld grootte en momentum, en is het ware verwachte overrendement. GKX gebruiken precies deze opzet, met één functie voor alle aandelen en maanden. Voor een geschatte functie en een nieuwe waarneming geldt
met de verwachting over trainingssteekproeven. De verwachte kwadratische fout is dus de ruis, plus het kwadraat van de gemiddelde misser, plus de spreiding van de schatting. Voor OLS met onafhankelijke voorspellers en waarnemingen is de bias nul en de variantieterm gemiddeld , zodat de buiten de steekproef ongeveer
bedraagt. Hier is de van de ware functie en het effectieve aantal onafhankelijke waarnemingen. In een panel is dat veel minder dan het aantal aandeel-maanden, omdat aandelen in dezelfde maand samen bewegen, en daarom vergelijken GKX met het aantal maanden.
Bij een van 0,5% per maand hoeft maar 0,5% te zijn om alle voorspelbaarheid op te eten, en met de 920 voorspellers van GKX gebeurt dat bij ongeveer 184.000 effectieve waarnemingen. Het panel van GKX telt miljoenen aandeel-maanden, terwijl zestig jaar data samen maar 720 maanden zijn. Ligt in de buurt van dat laatste getal, dan is groter dan één en blijft er van de voorspelbaarheid niets over. Zo keert de standaardfout van 2% terug in de cross-sectie, want verwachte rendementen zijn slecht gemeten, zodat elke vrije parameter voorspelkracht kost. Zo vergaat het ook de analist met tweehonderd kenmerken, en krimp is het antwoord.
4.2Krimp en selectie: ridge, LASSO en elastic net
Krimp trekt de gewichten naar nul, en bij orthogonale voorspellers heeft dat een gesloten vorm. Een onderzoeker die weet dat bijna alle ware gewichten klein zijn, doet er goed aan een ruisgevoelige OLS-schatting richting nul bij te stellen. Een straf op het kwadraat van de gewichten drukt uit dat ze allemaal klein zijn, een straf op hun absolute waarde dat de meeste nul zijn. De drie schatters minimaliseren
met ridge Hoerl & Kennard (1970) als , LASSO Tibshirani (1996) als en elastic net Zou & Hastie (2005) als beide positief zijn. Hoe groter een straf, hoe duurder een groot gewicht.
Proof 1
Met is , dus het doel is een som van losse functies . Elke is strikt convex. Voor geeft de eerste-ordevoorwaarde , wat alleen positief is als , en voor analoog als . Is , dan bevat het subdifferentiaal in het getal nul, en is het minimum.
Ridge vermenigvuldigt elk OLS-gewicht dus met , en LASSO zet elk gewicht met op nul en schuift de rest richting nul. In het toy-voorbeeld is , zodat ridge met elk gewicht halveert. Ridge is ook de posterior-verwachting onder een normale prior .
Bij één voorspeller met waar gewicht is de beste ridge-straf (oefening 3). Hoe zwakker het signaal ten opzichte van de ruis, hoe harder dus de krimp. Bij rendementen is die verhouding groot, bijvoorbeeld 100 als de ruis 3 is en het gewicht 0,3 bedraagt. Regressie op de eerste hoofdcomponenten (PCR) is een harde variant, want in de richting van een hoofdcomponent met variantie krimpt ridge met en PCR met 1 of 0.
In de praktijk kiezen GKX op een validatieblok (1975–1986) dat na het trainingsblok ligt, en toetsen ze daarna op 1987–2016. Willekeurige cross-validatie vermijden ze, omdat die de volgorde in de tijd breekt.
4.3Flexibiliteit: bomen en netwerken
Bomen en netwerken vangen interacties die een lineair model mist, maar betalen daarvoor met variantie. Een lineair model telt de effecten van “klein” en “recent verliezer” op. Een boom die eerst op grootte splitst en daarna binnen de kleine aandelen op het rendement van vorig jaar, laat het ene effect van het andere afhangen. Hij voorspelt het gemiddelde rendement van het blad waarin een aandeel valt en kiest elke split gretig, zoals in het toy-voorbeeld.
Een iets andere steekproef geeft een heel andere boom, en daarom middelen random forests Breiman (2001) veel diepe bomen op bootstrapsteekproeven. Heeft elke boom variantie en onderlinge correlatie , dan heeft het gemiddelde van bomen variantie . Bij blijft dus minstens de helft van de variantie over, hoeveel bomen er ook zijn. Boosting Friedman (2001) telt juist veel ondiepe bomen op, elk geschat op de residuen van de vorige en gekrompen met een factor tussen nul en één.
Een neuraal netwerk stapelt lagen van lineaire combinaties met een knik, . Het netwerk met drie verborgen lagen van GKX (NN3) heeft ruim 30.000 parameters en wordt onder meer getemd met early stopping, stoppen zodra de fout op het validatieblok stijgt. Ook dat is krimp, want de gewichten beginnen dicht bij nul en krijgen weinig tijd om weg te lopen. De van GKX piekt bij drie lagen, omdat maandrendementen weinig signaal bieden voor veel parameters.
4.4Hoe het getoetst wordt: de buiten de steekproef
GKX vergelijken voorspellingen met nul in plaats van met het historische gemiddelde, en die keuze maakt de toets strenger. In (14) was de maatstaf de kwadratische fout van de voorspeller ten opzichte van die van het historische gemiddelde, wat bij de markt redelijk is omdat de aandelenpremie positief is. Voor losse aandelen doet dat gemiddelde door ruis slechter dan nul, want één uitschieter van 50% tilt een gemiddelde over vijf jaar al bijna een procentpunt per maand op. Een zwakke maatstaf laat bovendien elk model goed lijken. GKX gebruiken daarom
gepoold over alle aandelen en maanden van het testblok . Een positieve waarde betekent dat het model beter doet dan niets voorspellen. Twee methoden vergelijken GKX met een Diebold-Mariano-toets op het maandelijkse verschil in kwadratische fout, met een Newey-West-standaardfout. De tabel geeft hun belangrijkste uitkomsten.
| methode (GKX, 1987–2016) | per maand (%) | Sharpe-ratio long-short, waardegewogen |
|---|---|---|
| OLS, alle voorspellers | – | |
| OLS-3 (grootte, boekwaarde-marktwaarde, momentum) | 0,16 | 0,61 |
| elastic net | 0,11 | – |
| PCR | 0,26 | – |
| random forest | 0,33 | – |
| boosting | 0,34 | – |
| netwerk NN3 | 0,40 | – |
| netwerk NN4 | 0,39 | 1,35 |
OLS met alle voorspellers doet slechter dan nul, terwijl het beste netwerk 0,40% van de maandelijkse variantie van losse aandelen voorspelt. De long-short-portefeuille op de voorspellingen van NN4 haalt ruim twee keer de Sharpe-ratio van OLS-3. Of de netwerken winnen doordat de wereld interacties bevat, laat de tabel niet zien, en die vraag beantwoordt de simulatie.
4.5Kenmerken als bèta’s: IPCA
Een kenmerk dat rendementen voorspelt, meet een bèta op een factor met een risicopremie of een fout in de prijs. Een model dat bèta’s uit kenmerken opbouwt, kan die lezingen tegen elkaar toetsen. Kelly, Pruitt en Su Kelly et al. (2019) schrijven
met de kenmerken inclusief een constante, een handvol latente factoren en de matrix die kenmerken in bèta’s vertaalt. Een element van zegt bijvoorbeeld hoeveel de bèta van een aandeel op de eerste factor stijgt als het bedrijf één standaarddeviatie kleiner is. Dit model heet instrumented PCA (IPCA), een analyse van hoofdcomponenten met bèta’s die lineair in waarneembare kenmerken zijn. De toets vraagt of kenmerken nog iets voorspellen naast hun rol in de bèta’s. Volgens de auteurs verklaren een paar IPCA-factoren de cross-sectie beter dan bestaande factormodellen en zijn de alpha’s van anomalieën klein en insignificant, zodat kenmerken vooral covarianties lijken te meten.
4.6De SDF krimpen: Kozak, Nagel en Santosh
Ook de stochastische discontofactor is te schatten als krimpprobleem, en een economische prior zegt waar de krimp moet vallen. De tangentportefeuille bepaalt de SDF (Cochrane: p = E[mx]). Een onderzoeker die de tangentportefeuille uit honderden factoren schat, neemt grote posities in richtingen met weinig variantie, omdat daar de meetfout in uitvergroot. Zonder bijna-arbitrage kan een portefeuille met weinig variantie echter geen grote premie hebben. Kozak, Nagel en Santosh, hierna KNS, krimpen die richtingen daarom het hardst.
We nemen factoren, hier long-short signaalportefeuilles, met overrendementen , verwachting en covariantie , en de lineaire SDF . Omdat een overrendement niets kost, moet , dus , de relatie tussen premie en covariantie uit (11).
Proof 2
Voor normale prior en likelihood is met . Dus . Invullen van geeft . Voor (9) hieronder is de eerste-ordevoorwaarde , dus .
Het ongekrompen gewicht van component is , en de krimpfactor is klein voor componenten met weinig variantie, net als bij ridge. Onder de prior is de verwachte gekwadrateerde Sharpe-ratio van component gelijk aan , zodat grote premies bij grote bronnen van variantie horen. Opgeteld over alle componenten is , zodat de maximale Sharpe-ratio per periode meet die de onderzoeker vooraf verwacht, in de replicatie hieronder ongeveer 0,13 per maand. Hoe groter , hoe kleiner en hoe minder de schatter krimpt, omdat de prior dan grotere premies toelaat. Dezelfde minimaliseert
een ridge op de prijsfouten . Met een extra straf op de absolute waarde van ontstaat een elastic net die een SDF met weinig factoren zoekt.
Zo vinden KNS dat een SDF met een handvol kenmerkfactoren de gemiddelde rendementen slecht verklaart en een SDF met een paar hoofdcomponenten goed. Hun maatstaf is de cross-sectionele buiten de steekproef, , met prijsfouten uit de momenten van het testblok, zodat een waarde van 0,4 betekent dat de prijsfouten nog 60% van de gekwadrateerde gemiddelden overlaten.
4.7Wat voorspelbaarheid betekent: Martin en Nagel
Voorspelbaarheid in de steekproef bewijst geen inefficiëntie als beleggers de parameters zelf moeten leren. Een belegger die moet leren hoe honderden kenmerken met kasstromen samenhangen, schat de waarde van een aandeel elke periode een beetje verkeerd. Achteraf lijken die fouten systematisch, hoewel ze vooraf niet te voorspellen waren.
In een gestileerde versie van hun model hebben activa elk kenmerken in de vaste matrix , en betalen ze per periode , met . Beleggers zijn risiconeutraal, de rente is nul en hun prior is , zodat het totale kasstroomsignaal niet van afhangt. Na perioden is hun posterior-verwachting een ridge-schatter,
De prijs is en het rendement, payoff min prijs, is . Omdat de beleggers risiconeutraal zijn en de rente nul is, geldt met hun informatie , zodat de markt efficiënt is. Een econometrist die als vast getal behandelt, ziet echter
met . De breuk is het deel van het signaal dat de beleggers nog niet hebben geleerd. Met en is dat bij en bij . Het ongeleerde deel is dus groot zodra het aantal kenmerken in de buurt van het aantal activa komt.
Een regressie achteraf vindt dan een significante helling die geen winstkans is, omdat ze alleen bestaat in het licht van een die niemand kende. Toetsen in de steekproef verwerpen daardoor vaak de nulhypothese van geen voorspelbaarheid, terwijl toetsen buiten de steekproef hun economische betekenis houden Martin & Nagel (2022). Een lerende markt lijkt dus in de steekproef voorspelbaarder dan erbuiten, en dat komt door leren, niet door een risicopremie of een fout.
5Simulatie: wat een eindige steekproef van voorspelbaarheid ziet
De simulatie vraagt wat een onderzoeker met een eindige steekproef ziet van voorspelbaarheid die wel of juist niet te benutten is. Het eerste deel meet hoeveel van de ware voorspelbaarheid elke methode terugvindt, het tweede hoe vaak een toets voorspelbaarheid ziet in een markt die rationeel leert.
5.1Hoeveel van de ware voorspelbaarheid vinden de methoden terug?
GKX simuleren in hun internetappendix een wereld waarin de voorspellers lineair binnenkomen en een wereld met niet-lineaire termen en interacties. Onze verkleinde variant heeft een signaal van 2% en idiosyncratische ruis van 10% per maand, zodat hier 25 is, minder extreem dan bij de getallen van de Theorie.
Er zijn 500 aandelen, 180 maanden, 20 persistente kenmerken die elke maand een rang tussen -1 en 1 krijgen, en één persistente macrovariabele . De voorspellers zijn de kenmerken en hun producten met , dus .
In de lineaire wereld is een gewogen som van , en , in de niet-lineaire van , en , met elke term geschaald op eenheidsvariantie. Maar drie van de twintig kenmerken tellen, en de andere zeventien zijn zuivere ruis die een methode moet leren negeren.
Maanden 1–108 zijn training, 109–144 validatie en 145–180 test.
Het netwerk heeft de lagen van NN3 (32, 16 en 8 neuronen), met early stopping maar zonder middeling over startwaarden. De eerste cel bouwt het panel, zet de modellen met hun validatie klaar en draait twee lineaire panels.
def simulate_gkx(rng, nonlinear, n_stocks=500, n_months=180, n_char=20):
    """Panel in the spirit of GKX's simulation: features z_{i,t}, returns r_{i,t+1}, E_t r_{i,t+1}."""
    rho = rng.uniform(0.9, 1.0, n_char)
    latent = rng.normal(size=(n_stocks, n_char))
    x = np.empty(n_months)
    C = np.empty((n_months, n_stocks, n_char), dtype=np.float32)
    for t in range(n_months):
        if t == 0:
            x[t] = rng.normal()
        else:
            latent = rho * latent + np.sqrt(1 - rho**2) * rng.normal(size=(n_stocks, n_char))
            x[t] = 0.95 * x[t - 1] + np.sqrt(1 - 0.95**2) * rng.normal()
        C[t] = 2 * (latent.argsort(0).argsort(0) + 1) / (n_stocks + 1) - 1   # ranks in [-1, 1]
    c1, c2, c3, xt = C[..., 0], C[..., 1], C[..., 2], x[:, None]
    if nonlinear:
        terms = [(c1**2 - 1 / 3) / np.sqrt(4 / 45), 3 * c1 * c2, np.sign(c3 * xt)]
    else:
        terms = [np.sqrt(3) * c1, np.sqrt(3) * c2, np.sqrt(3) * c3 * xt]
    g = 0.02 / np.sqrt(3) * sum(terms)                    # each term has unit variance
    shocks = (0.05 * c1 * rng.normal(size=(n_months, 1))
              + 0.10 * np.sqrt(3 / 5) * rng.standard_t(5, size=(n_months, n_stocks)))
    Z = np.concatenate([C, C * xt[..., None].astype(np.float32)], axis=2)   # z = c (x) (1, x_t)
    return Z.reshape(n_months * n_stocks, -1), (g + shocks).ravel(), g.ravel()


def oos_r2(y, f):
    """GKX out-of-sample R^2, eq. (machine-learning-oos): benchmark is a zero forecast."""
    return 1 - np.sum((y - f) ** 2) / np.sum(y**2)


SIM_MODELS = {   # name: (constructor of hyperparameter h, validation grid)
    "OLS": (lambda h: LinearRegression(), [None]),
    "ridge": (lambda h: Ridge(alpha=h), [1e2, 1e3, 1e4, 1e5]),
    "LASSO": (lambda h: Lasso(alpha=h), [1e-4, 3e-4, 1e-3, 3e-3]),
    "elastic net": (lambda h: ElasticNet(alpha=h, l1_ratio=0.5), [2e-4, 6e-4, 2e-3, 6e-3]),
    "random forest": (lambda h: RandomForestRegressor(
        n_estimators=30, max_depth=h, max_features=0.3, max_samples=0.2,
        min_samples_leaf=100, n_jobs=1, random_state=0), [6]),
    "boosting": (lambda h: HistGradientBoostingRegressor(
        max_depth=h, learning_rate=0.1, max_iter=80, min_samples_leaf=200,
        random_state=0), [1, 3]),
    "NN (32-16-8)": (lambda h: MLPRegressor(
        hidden_layer_sizes=(32, 16, 8), alpha=h, early_stopping=True, n_iter_no_change=3,
        max_iter=200, batch_size=2048, learning_rate_init=3e-3, random_state=0), [0.1]),
}


def fit_validate(models, Z, y, train, valid, test):
    """Pick each model's hyperparameter on the validation block; return test-block R^2."""
    out = {}
    for name, (make, grid) in models.items():
        fits = [make(h).fit(Z[train], y[train]) for h in grid]
        best = max(fits, key=lambda m: oos_r2(y[valid], m.predict(Z[valid])))
        out[name] = oos_r2(y[test], best.predict(Z[test]))
    return out


def run_replication(nonlinear, n_stocks=500, n_months=180):
    """One simulated panel: population R^2 and test-block R^2 of every model, in percent."""
    month = np.repeat(np.arange(n_months), n_stocks)
    train, valid, test = month < 108, (month >= 108) & (month < 144), month >= 144
    Z, y, g = simulate_gkx(rng, nonlinear, n_stocks, n_months)
    row = {"populatie": oos_r2(y[test], g[test])}
    row.update(fit_validate(SIM_MODELS, Z, y, train, valid, test))
    return {k: 100 * v for k, v in row.items()}


runs_linear = [run_replication(nonlinear=False) for _ in range(2)]   # split over two cells (< 60 s each)
Met een derde replicatie erbij geeft de tabel per replicatie de populatie- en die van elke methode, in procenten. De populatie- is die van de ware zelf, en daarmee de maat waartegen elke methode zich meet.
runs_linear.append(run_replication(nonlinear=False))
sim_linear = pd.DataFrame(runs_linear).rename_axis("replicatie")
sim_linear.round(2)De lineaire methoden liggen hier dicht bij de populatiewaarde, en de volgende twee cellen herhalen de proef in de niet-lineaire wereld.
runs_nonlinear = [run_replication(nonlinear=True) for _ in range(2)]De tweede cel voegt de derde niet-lineaire replicatie toe en zet de uitkomsten in dezelfde tabel als in de lineaire wereld.
runs_nonlinear.append(run_replication(nonlinear=True))
sim_nonlinear = pd.DataFrame(runs_nonlinear).rename_axis("replicatie")
sim_nonlinear.round(2)Nu blijven de lineaire methoden ver onder de populatiewaarde. De figuur zet beide werelden naast elkaar, met de populatiewaarde als gestippelde lijn.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.5), sharey=True)
for ax, (title, res) in zip(axes, [("Lineaire wereld", sim_linear),
                                   ("Niet-lineaire wereld", sim_nonlinear)]):
    models = [c for c in res.columns if c != "populatie"]
    pos = np.arange(len(models))
    for rep in res.index:
        ax.scatter(pos, res.loc[rep, models], color=hap.plotting.COLORS[0], alpha=0.5, s=25,
                   label="replicatie" if rep == 0 else None)
    ax.scatter(pos, res[models].mean(), color=hap.plotting.COLORS[1], marker="_", s=400,
               lw=2, label="gemiddelde")
    ax.axhline(res["populatie"].mean(), color="black", ls="--", lw=1,
               label="populatie-$R^2$ (ware $g^\\star$)")
    ax.axhline(0, color="grey", lw=0.8)
    ax.set_xticks(pos, models, rotation=40, ha="right")
    ax.set_title(title)
    ax.set_xlabel("Methode")
axes[0].set_ylabel("$R^2$ buiten de steekproef (%, per maand)")
axes[0].legend(loc="lower left")
plt.show()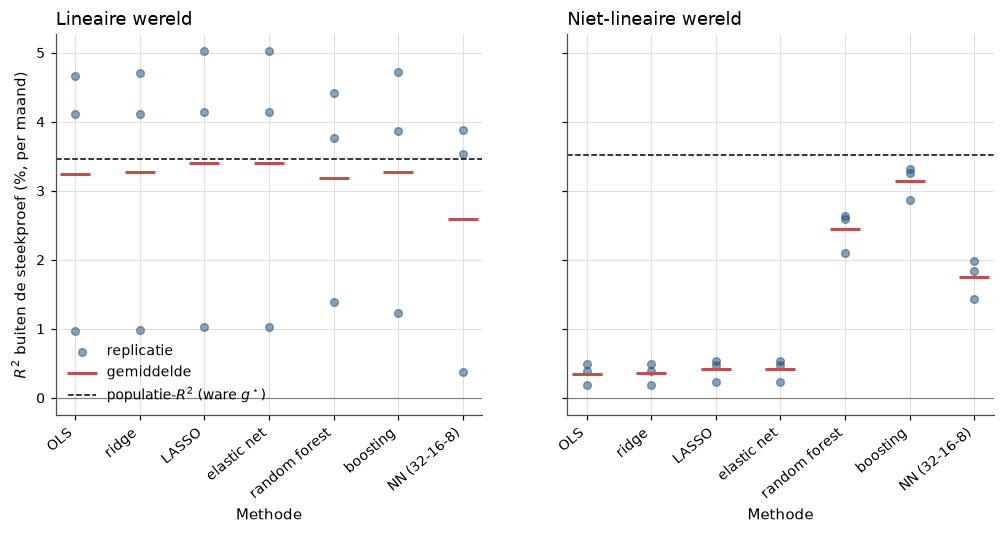
Figure 1:De buiten de steekproef in drie gesimuleerde panels per wereld. In de lineaire wereld halen de lineaire methoden bijna de populatiewaarde en voegen bomen en netwerk niets toe. In de niet-lineaire wereld vinden boosting, random forest en het netwerk een groot deel van de voorspelbaarheid, en de lineaire methoden niet.
Figuur 1 laat het patroon van GKX zien. In de lineaire wereld liggen de lineaire methoden binnen een half procentpunt van de populatiewaarde, terwijl de bomen tot 0,6 en het netwerk tot 1,1 procentpunt verliezen. In de niet-lineaire wereld halen de lineaire methoden rond een half procent tegen een populatiewaarde van 3,3 tot 3,7%, en vindt boosting het meeste terug. Flexibiliteit loont dus alleen als de wereld interacties bevat, en anders kost ze alleen variantie.
OLS faalt hier niet zoals bij GKX en blijft binnen enkele honderdsten van een procentpunt van ridge, omdat 40 voorspellers tegen 54.000 trainingswaarnemingen te weinig zijn om de variantieterm te laten tellen. Dat krimp OLS verslaat, toont deze simulatie dus niet. In oefening 4 groeit , en daar stort OLS in één van drie replicaties wel in.
De populatie- zelf loopt tussen de lineaire replicaties uiteen van 1,4% tot 5,0%, alleen door ruis in 36 testmaanden. Zelfs de ware voorspelbaarheid is in drie jaar testdata dus slecht gemeten, slechter dan de verschillen tussen de goede methoden.
5.2Wanneer lijkt een lerende markt voorspelbaar?
We simuleren (10) met activa, en een oplopend aantal kenmerken , telkens voor 100 economieën. De beleggers zien één periode kasstromen voordat de vijf perioden van de econometrist beginnen. Per economie berekenen we de -toets van een gepoolde regressie van rendementen op in de steekproef. Daarnaast schatten twee econometristen elke periode opnieuw op de rendementen tot dan toe, de een met OLS en de ander met de ridge van de beleggers. Van beiden meten we de buiten de steekproef.
def martin_nagel_economy(rng, n_assets, n_char, n_periods=5, burn_in=1, g=1.0, sigma=1.0):
    """One economy: in-sample F-test p-value, IS R^2, real-time OOS R^2 (OLS and ridge)."""
    X = rng.normal(size=(n_assets, n_char))
    theta = rng.normal(scale=np.sqrt(g / n_char), size=n_char)
    Y = X @ theta + sigma * rng.normal(size=(burn_in + n_periods, n_assets))
    lam = sigma**2 * n_char / g
    w, V = np.linalg.eigh(X.T @ X)                     # diagonalise X'X once
    XV = X @ V
    R, cum = np.empty_like(Y), np.zeros(n_char)
    for t in range(burn_in + n_periods):
        R[t] = Y[t] - XV @ (cum / (t * w + lam))       # payoff minus price, eq. (mn)
        cum += XV.T @ Y[t]
    R = R[burn_in:]
    coef = XV.T @ R.mean(axis=0) / w                    # pooled OLS
    rss1, rss0 = np.sum((R - XV @ coef) ** 2), np.sum(R**2)
    dof = n_assets * n_periods - n_char
    p_value = stats.f.sf(((rss0 - rss1) / n_char) / (rss1 / dof), n_char, dof)
    sse_ols = sse_ridge = sst = 0.0
    cum_r = np.zeros(n_char)
    for t in range(n_periods):
        if t >= 1:
            sse_ols += np.sum((R[t] - XV @ (cum_r / (t * w))) ** 2)
            sse_ridge += np.sum((R[t] - XV @ (cum_r / (t * w + lam))) ** 2)
            sst += np.sum(R[t] ** 2)
        cum_r += XV.T @ R[t]
    return p_value, 1 - rss1 / rss0, 1 - sse_ols / sst, 1 - sse_ridge / sst


n_assets, n_economies = 500, 100
mn_rows = []
for n_char in [10, 25, 50, 100, 200, 300, 400]:
    draws = np.array([martin_nagel_economy(rng, n_assets, n_char) for _ in range(n_economies)])
    mn_rows.append({
        "J/N": n_char / n_assets,
        "ongeleerd deel (1e periode)": 1 / (1 + n_assets / n_char),
        "verwerping F-toets (5%)": np.mean(draws[:, 0] < 0.05),
        "IS R2 min nul-R2 (%)": 100 * (draws[:, 1].mean() - n_char / (n_assets * 5)),
        "OOS R2 OLS (%, mediaan)": 100 * np.median(draws[:, 2]),
        "OOS R2 ridge (%, mediaan)": 100 * np.median(draws[:, 3]),
        "fractie OOS R2 ridge > 0": np.mean(draws[:, 3] > 0),
    })
mn_table = pd.DataFrame(mn_rows).set_index("J/N")
mn_table.round(3)De tabel geeft per waarde van het ongeleerde deel, hoe vaak de toets verwerpt en de mediane buiten de steekproef. Een aparte kolom zegt hoeveel de in de steekproef boven die van zuivere ruis ligt. De figuur zet de toets in de steekproef links tegenover de voorspellingen erbuiten rechts.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))
axes[0].plot(mn_table.index, mn_table["verwerping F-toets (5%)"], marker="o",
             label="$F$-toets in de steekproef verwerpt")
axes[0].axhline(0.05, color="black", ls="--", lw=0.8, label="nominaal niveau (5%)")
axes[0].set_xlabel("Karakteristieken per activum $J/N$")
axes[0].set_ylabel("Fractie van 100 economieën")
axes[0].set_title("In de steekproef: de markt lijkt inefficiënt")
axes[0].legend()
axes[1].plot(mn_table.index, mn_table["OOS R2 OLS (%, mediaan)"], marker="o", label="OLS")
axes[1].plot(mn_table.index, mn_table["OOS R2 ridge (%, mediaan)"], marker="s",
             label="ridge met de prior van de beleggers")
axes[1].axhline(0, color="black", lw=0.8)
axes[1].set_xlabel("Karakteristieken per activum $J/N$")
axes[1].set_ylabel("Mediane real-time $R^2_{OOS}$ (%)")
axes[1].set_title("Buiten de steekproef: geen enkele econometrist verdient")
axes[1].legend()
plt.show()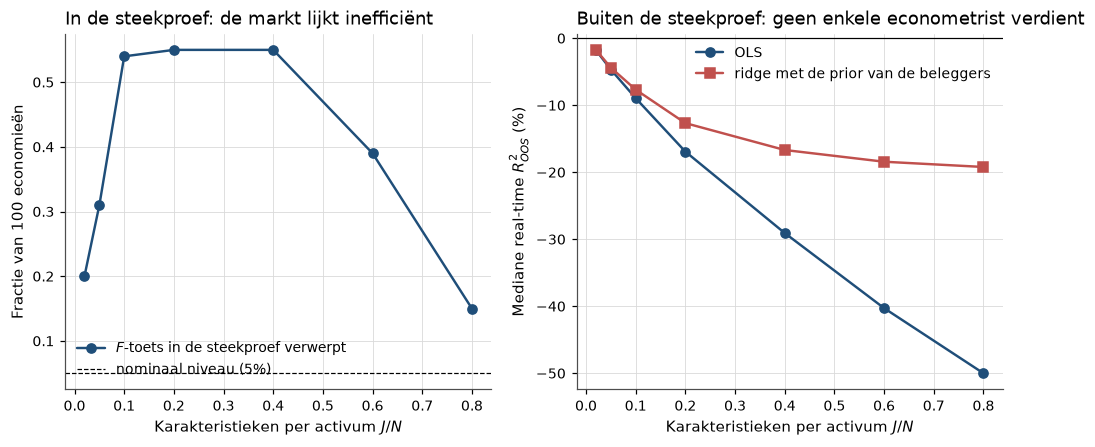
Figure 2:Beleggers die optimaal leren, waarderen in elke gesimuleerde economie rationeel. Toch verwerpt de -toets in de steekproef veel vaker dan in 5% van de gevallen, terwijl geen voorspeller die alleen het verleden kent, ook niet één met de juiste prior, erbuiten een positieve haalt.
Links groeit het ongeleerde deel van 2% bij tot 44% bij , en verwerpt de -toets tussen en in rond 55% van de economieën. Bij zakt dat weer naar 15%, omdat de toets dan vrijheidsgraden moet betalen, een eigenschap van onze toets en niet van het mechanisme. De in de steekproef ligt bij elke boven die van zuivere ruis, het verst (1,5 procentpunt) bij .
Rechts is het beeld eenduidig. De mediane zakt voor de OLS-econometrist van naar en voor de ridge-econometrist tot , en in geen van de 700 economieën is de ridge- positief. Ook een econometrist die de prior kent, verliest, omdat de beleggers bijleren en de schijnbare fout van gisteren niet die van vandaag is. Daarom rapporteren GKX, KNS en de replicatie hieronder alleen resultaten buiten de steekproef.
6Replicatie op echte data
6.1(1) Welk signaal doet het volgende maand goed?
Per signaal en maand zijn er zes voorspellers. Vier zijn eigen grootheden, namelijk het rendement van deze maand, het gemiddelde over de elf maanden ervoor en over de twee jaar daarvoor, en de volatiliteit over twaalf maanden. Twee zijn gemeenschappelijk, namelijk het gelijkgewogen rendement van alle signalen deze maand en over de elf maanden ervoor. De eerste cel bouwt dit panel.
osap = hap_data.osap().loc["1963":].astype("float64")
ew = osap.mean(axis=1)


def broadcast(series):
    return pd.DataFrame(np.repeat(series.to_numpy()[:, None], osap.shape[1], axis=1),
                        index=osap.index, columns=osap.columns)


features = {
    "r_t": osap,
    "r_t-11:t-1": osap.shift(1).rolling(11, min_periods=9).mean(),
    "r_t-35:t-12": osap.shift(12).rolling(24, min_periods=18).mean(),
    "vol_12m": osap.rolling(12, min_periods=9).std(),
    "ew_t": broadcast(ew),
    "ew_t-11:t-1": broadcast(ew.shift(1).rolling(11).mean()),
}
panel = pd.concat({k: v.stack() for k, v in features.items()}, axis=1)
panel["y"] = osap.shift(-1).stack()
panel = panel.dropna().rename_axis(["date", "signal"])
feature_names = list(features)
print(f"{len(panel):,} signaal-maanden, {panel.index.get_level_values('signal').nunique()} signalen, "
      f"{panel.index.get_level_values('date').min():%Y-%m} t/m {panel.index.get_level_values('date').max():%Y-%m}")
134,518 signaal-maanden, 212 signalen, 1965-06 t/m 2024-11
Het panel telt ruim 134.000 signaal-maanden. We schatten om de vijf jaar opnieuw, met de vijf jaar ervoor als validatie, alles daarvoor als training en de vijf jaar erna als test.
REAL_MODELS = {
    "OLS": (lambda h: LinearRegression(), [None]),
    "ridge": (lambda h: Ridge(alpha=h), [1e-1, 1e1, 1e3]),
    "LASSO": (lambda h: Lasso(alpha=h), [1e-5, 1e-4, 1e-3]),
    "random forest": (lambda h: RandomForestRegressor(
        n_estimators=50, max_depth=h, max_features=0.5, max_samples=0.3,
        min_samples_leaf=200, n_jobs=1, random_state=0), [2, 4]),
    "boosting": (lambda h: HistGradientBoostingRegressor(
        max_depth=h, learning_rate=0.05, max_iter=100, min_samples_leaf=500,
        random_state=0), [1, 2]),
}
dates = panel.index.get_level_values("date")
y_all = panel["y"].to_numpy()
forecasts = []
for start in range(1990, 2025, 5):
    train = dates < pd.Timestamp(start - 5, 1, 1)
    valid = (dates >= pd.Timestamp(start - 5, 1, 1)) & (dates < pd.Timestamp(start, 1, 1))
    test = (dates >= pd.Timestamp(start, 1, 1)) & (dates < pd.Timestamp(start + 5, 1, 1))
    raw = panel[feature_names].to_numpy()
    Z = (raw - raw[train].mean(axis=0)) / raw[train].std(axis=0)   # training moments only
    block = panel.loc[test, ["y"]].copy()
    for name, (make, grid) in REAL_MODELS.items():
        fits = [make(h).fit(Z[train], y_all[train]) for h in grid]
        best = max(fits, key=lambda m: oos_r2(y_all[valid], m.predict(Z[valid])))
        block[name] = best.predict(Z[test])
    past_mean = panel.loc[train | valid].groupby(level="signal")["y"].mean()
    block["historisch gemiddelde"] = (past_mean.reindex(block.index.get_level_values("signal"))
                                      .fillna(0.0).to_numpy())
    forecasts.append(block)
forecasts = pd.concat(forecasts)
forecast_names = list(REAL_MODELS) + ["historisch gemiddelde"]
print(f"{len(forecasts):,} voorspellingen buiten de steekproef, "
      f"{forecasts.index.get_level_values('date').min():%Y-%m} t/m "
      f"{forecasts.index.get_level_values('date').max():%Y-%m}")
86,000 voorspellingen buiten de steekproef, 1990-01 t/m 2024-11
De voorspellingen lopen van januari 1990 tot november 2024. Per methode berekent de volgende cel vier maatstaven:
de van GKX,
de tegen het historische gemiddelde per signaal ((14)),
de Diebold-Mariano- tegen OLS,
de Sharpe-ratio van een portefeuille die elke maand de 20% signalen met de hoogste voorspelling koopt en de 20% met de laagste verkoopt.
De standaardfout van die Sharpe-ratio is , met de maandelijkse waarde.
def long_short(block, name, q=0.2):
    rank = block[name].groupby(level="date").rank(pct=True)
    y = block["y"]
    return (y[rank > 1 - q].groupby(level="date").mean()
            - y[rank <= q].groupby(level="date").mean())


def evaluate(block):
    rows = {}
    err_ols = (block["y"] - block["OLS"]) ** 2
    err_hist = (block["y"] - block["historisch gemiddelde"]) ** 2
    for name in forecast_names:
        err = (block["y"] - block[name]) ** 2
        d = (err_ols - err).groupby(level="date").mean()                 # GKX eq. (20)
        dm = hap.newey_west(d, pd.DataFrame(index=d.index), lags=6)
        ls = long_short(block, name)
        sr_m = ls.mean() / ls.std()
        rows[name] = {
            "R2 GKX (%)": 100 * oos_r2(block["y"], block[name]),
            "R2 t.o.v. hist. gem. (%)": 100 * (1 - err.sum() / err_hist.sum()),
            "DM-t tegen OLS": np.nan if name == "OLS" else dm.tvalues.iloc[0],
            "Sharpe L-S": hap.sharpe(ls),
            "SE Sharpe": np.sqrt((1 + sr_m**2 / 2) / len(ls)) * np.sqrt(12),
        }
    return pd.DataFrame(rows).T


periods = {"1990-2024": ("1990", "2024"), "1990-2004": ("1990", "2004"), "2005-2024": ("2005", "2024")}
real1 = pd.concat({label: evaluate(forecasts.loc[a:b]) for label, (a, b) in periods.items()})
equal_weight = {label: hap.sharpe(forecasts.loc[a:b, "y"].groupby(level="date").mean())
                for label, (a, b) in periods.items()}
print("Sharpe van alle signalen gelijkgewogen:", {k: round(v, 2) for k, v in equal_weight.items()})
real1.round(3)
Sharpe van alle signalen gelijkgewogen: {'1990-2024': np.float64(1.89), '1990-2004': np.float64(2.4), '2005-2024': np.float64(1.55)}
De tabel laat zien dat de bomen OLS verslaan, zoals verwacht, maar met weinig. De belangrijkste getallen staan hieronder naast die van GKX.
| GKX (aandelen, 1987–2016) | hier (signalen, 1990–2024) | |
|---|---|---|
| lineair (%) | 0,16 (OLS-3) | 2,00 (OLS) |
| beste boom (%) | 0,34 (boosting) | 2,36 (random forest) |
| Sharpe long-short, lineair | 0,61 (OLS-3) | 0,78 (OLS) |
| Sharpe long-short, beste niet-lineair | 1,35 (NN4) | 0,78 (random forest) |
Geslaagd. Random forest en boosting verslaan OLS met ruim een derde procentpunt, maar met een Diebold-Mariano- van 0,7 is dat verschil niet van nul te onderscheiden. De winst zit bovendien helemaal vóór 2005, want daarna vallen beide bomen onder OLS. De ligt hier veel hoger dan bij GKX, omdat de signalen gemiddeld een positieve premie hebben en een portefeuille van honderden aandelen veel minder idiosyncratische ruis draagt dan een los aandeel.
Economisch is het beeld nog soberder. Elke methode geeft een long-short Sharpe-ratio rond 0,78, met een standaardfout van 0,17, terwijl sorteren op het historische gemiddelde 1,32 oplevert. Timing binnen de factor zoo voegt dus weinig toe aan het dragen van de gemiddelde anomaliepremie. Dat weerlegt GKX niet, maar past bij Avramov, Cheng en Metzker Avramov et al. (2023), volgens wie de extra voorspelbaarheid klein is waar de handel goedkoop is. Na 2005 dalen de van GKX en alle Sharpe-ratio’s, ook die van alle signalen gelijkgewogen, wat past bij het publicatieverval uit De factor zoo. Alleen de tegen het historische gemiddelde stijgt, omdat dat gemiddelde na 2005 zelf slecht voorspelt.
6.2(2) Een gekrompen SDF op 158 signalen
We delen de 158 signalen met een volledige reeks door hun standaarddeviatie over 1975–2004 en schatten uit (8) op dat blok, met gekozen door drievoudige cross-validatie over blokken van tien jaar. De eerste cel vergelijkt de gekrompen SDF met de ongekrompen tangentportefeuille en met alle signalen gelijkgewogen.
signals = hap_data.osap().loc["1975":"2024"].astype("float64")
signals = signals.loc[:, signals.notna().all()]
scale = signals.loc[:"2004"].std()
F_est, F_test = (signals.loc[:"2004"] / scale).to_numpy(), (signals.loc["2005":] / scale).to_numpy()
T_est, H = F_est.shape
print(f"{H} signalen met een volledige reeks, {T_est} maanden in 1975-2004")


def moments(F):
    return F.mean(axis=0), np.atleast_2d(np.cov(F, rowvar=False))


def cs_r2(b, F):
    """KNS cross-sectional R^2 of the SDF b on the moments of F."""
    mu, S = moments(F)
    e = mu - S @ b
    return 1 - e @ e / (mu @ mu)


def l2_sdf(F, kappa):
    mu, S = moments(F)
    gamma = np.trace(S) / (kappa**2 * len(F))
    return np.linalg.solve(S + gamma * np.eye(S.shape[0]), mu), gamma


kappas = np.logspace(-2, 1, 25)
folds = np.array_split(np.arange(T_est), 3)
cv = []
for kappa in kappas:
    scores = []
    for fold in folds:
        keep = np.ones(T_est, dtype=bool)
        keep[fold] = False
        scores.append(cs_r2(l2_sdf(F_est[keep], kappa)[0], F_est[fold]))
    cv.append(np.mean(scores))
kappa_star = kappas[int(np.argmax(cv))]
b_l2, gamma_star = l2_sdf(F_est, kappa_star)
mu_est, S_est = moments(F_est)

ols_sdf = np.linalg.solve(S_est, mu_est)
kns_table = pd.DataFrame({
    "cs-R2 1975-2004": [cs_r2(ols_sdf, F_est), cs_r2(b_l2, F_est), np.nan],
    "cs-R2 2005-2024": [cs_r2(ols_sdf, F_test), cs_r2(b_l2, F_test), np.nan],
    "Sharpe 1975-2004": [hap.sharpe(pd.Series(F_est @ ols_sdf)), hap.sharpe(pd.Series(F_est @ b_l2)),
                         hap.sharpe(pd.Series(F_est.mean(axis=1)))],
    "Sharpe 2005-2024": [hap.sharpe(pd.Series(F_test @ ols_sdf)), hap.sharpe(pd.Series(F_test @ b_l2)),
                   hap.sharpe(pd.Series(F_test.mean(axis=1)))],
}, index=["ongekrompen tangentportefeuille", f"L2-SDF (kappa = {kappa_star:.3f})",
          "alle signalen gelijkgewogen"])
kns_table.round(3)
158 signalen met een volledige reeks, 360 maanden in 1975-2004
De gekrompen SDF, met een door cross-validatie gekozen , verwacht vooraf een maximale Sharpe-ratio van ongeveer 0,46 per jaar. Ze verklaart na 2005 evenveel van de cross-sectie van gemiddelden als in de schattingsperiode, terwijl de ongekrompen tangentportefeuille in de schattingsperiode per constructie alles verklaart en daarna minder dan niets. De prijsfouten van die portefeuille zijn na 2005 ruim dertien keer zo lang als de vector van gemiddelde rendementen, en zo ziet de schattingsfout in eruit.
In Sharpe-ratio’s blijft de ongekrompen portefeuille wel voorop, ook na 2005, al komt die voorsprong in de schattingsperiode vooral uit ruis waarop de gewichten zijn afgestemd. Het verschil na 2005 is met 0,25 van dezelfde orde als de standaardfout van één Sharpe-ratio over 240 maanden, ongeveer 0,24 volgens de formule bij (1), terwijl de daling na de schattingsperiode vele malen groter is. Die daling mengt overfitting en publicatieverval, en met één splitsing zijn die twee niet te scheiden.
Daarna vergelijken we twee sparse SDF’s, met weinig gewichten ongelijk aan nul en
dezelfde straf . De eerste geeft alleen de eerste hoofdcomponenten een gewicht
, zoals in Proposition 2. De tweede
is de elastic net op (9) met een oplopende straf op de
absolute waarde, en die is een gewone LASSO op aangevulde gegevens. Met
gelijk aan boven
nullen en gelijk aan boven
is
precies (9), zodat de straf van Lasso alleen de absolute
waarde toevoegt.
lam, Q = np.linalg.eigh(S_est)
order = np.argsort(lam)[::-1]
lam, Q = lam[order], Q[:, order]
mu_pc = Q.T @ mu_est

sparse_rows = []
for K in range(1, H + 1):                                        # sparse in PCs
    b_pc = np.zeros(H)
    b_pc[:K] = mu_pc[:K] / (lam[:K] + gamma_star)
    b = Q @ b_pc
    sparse_rows.append(("hoofdcomponenten", K, cs_r2(b, F_test), hap.sharpe(pd.Series(F_test @ b))))

w_eig, V_eig = np.linalg.eigh(S_est)                             # sparse in signals
S_half = V_eig @ np.diag(np.sqrt(w_eig)) @ V_eig.T
S_minus_half = V_eig @ np.diag(1 / np.sqrt(w_eig)) @ V_eig.T
X_aug = np.vstack([S_half, np.sqrt(gamma_star) * np.eye(H)])
y_aug = np.concatenate([S_minus_half @ mu_est, np.zeros(H)])
alpha_max = np.max(np.abs(X_aug.T @ y_aug)) / len(y_aug)
for alpha in alpha_max * np.logspace(-3, -0.01, 60):
    b = Lasso(alpha=alpha, fit_intercept=False, max_iter=20_000, tol=1e-6).fit(X_aug, y_aug).coef_
    if np.any(b != 0):
        sparse_rows.append(("signalen", int(np.sum(b != 0)), cs_r2(b, F_test),
                            hap.sharpe(pd.Series(F_test @ b))))
sparse = (pd.DataFrame(sparse_rows, columns=["ruimte", "K", "cs-R2 OOS", "Sharpe OOS"])
          .drop_duplicates(["ruimte", "K"]).sort_values(["ruimte", "K"]))
by_signal = sparse[sparse["ruimte"] == "signalen"].drop(columns="ruimte").set_index("K")
by_pc = sparse[sparse["ruimte"] == "hoofdcomponenten"].drop(columns="ruimte").set_index("K")
by_signal.join(by_pc, lsuffix=" (signalen)", rsuffix=" (PC's)").round(3) # same K in both spacesDe tabel zet beide varianten naast elkaar bij hetzelfde aantal variabelen , en de figuur laat zien hoe ver de twee lijnen bij kleine uiteenliggen.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))
for i, (space, label) in enumerate([("hoofdcomponenten", "sparse in hoofdcomponenten"),
                                    ("signalen", "sparse in signalen (elastic net)")]):
    part = sparse[sparse["ruimte"] == space]
    axes[0].plot(part["K"], part["cs-R2 OOS"], marker="o" if i else None, ms=4,
                 color=hap.plotting.COLORS[i], label=label)
    axes[1].plot(part["K"], part["Sharpe OOS"], marker="o" if i else None, ms=4,
                 color=hap.plotting.COLORS[i], label=label)
for ax in axes:
    ax.set_xscale("log")
    ax.set_xlabel("Aantal variabelen met een gewicht $K$ (log-schaal)")
axes[0].set_ylabel("Cross-sectionele $R^2$, 2005-2024")
axes[0].set_title("Verklaarde cross-sectie (KNS-maatstaf)")
axes[1].set_ylabel("Sharpe-ratio SDF-portefeuille, 2005-2024")
axes[1].set_title("Sharpe-ratio van de SDF-portefeuille")
axes[0].legend()
plt.show()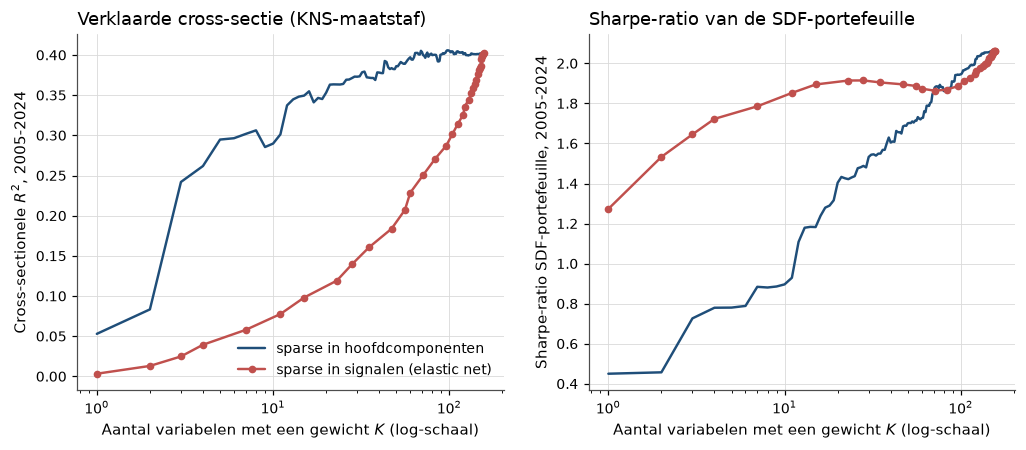
Figure 3:Sparse SDF’s, geschat op 1975–2004 en getoetst op 2005–2024. Links verklaart een SDF met een handvol hoofdcomponenten een groot deel van de 158 gemiddelden, en een SDF met even weinig signalen veel minder. Rechts, in de Sharpe-ratio, draait de rangorde bij weinig variabelen om.
De tabel zet de uitkomsten na 2005 naast de bevindingen van KNS. Voor KNS staan er woorden in plaats van getallen, omdat hun data en toetsperiode van de onze verschillen.
| maatstaf, 2005–2024 | KNS (eigen anomalieportefeuilles) | hier (158 signalen; als fractie) |
|---|---|---|
| cs-, volledige gekrompen SDF | positief | 0,40 |
| cs-, ongekrompen tangentportefeuille | negatief | -170 |
| cs-, vier hoofdcomponenten | dicht bij de volledige SDF | 0,26 |
| cs-, vier signalen | ver daaronder | 0,04 |
| Sharpe, ongekrompen / gekrompen | – | 2,32 / 2,07 |
| Sharpe, vier signalen / vier hoofdcomponenten | – | 1,72 / 0,78 |
Geslaagd. In de maatstaf van KNS verslaan de hoofdcomponenten de signalen, zoals verwacht. Vier hoofdcomponenten halen bijna twee derde van de volledige SDF, terwijl vier signalen op een tiende daarvan blijven steken.
In de Sharpe-ratio draait de rangorde om, want vier signalen geven ruim twee keer de Sharpe-ratio van vier hoofdcomponenten. De elastic net kiest de signalen met de hoogste premie per eenheid risico, en die blijven na 2005 goed renderen maar verklaren de andere signalen niet. Een belegger die één portefeuille zoekt, krijgt dus een ander antwoord dan een onderzoeker die de SDF zoekt.
7Wat er brak, en wat daarna kwam
Wat machine learning verklaart. Machine learning maakte van de factor zoo een meetprobleem met een oplossing. Honderden kenmerken, in De factor zoo nog een bron van valse ontdekkingen, worden met krimp en validatie één voorspelling die buiten de steekproef standhoudt. Bij GKX is dat een maandelijkse van 0,40% tegen voor OLS met alle voorspellers. KNS beschreven de SDF achter al die anomalieën met een paar hoofdcomponenten, en Kelly, Pruitt en Su lazen kenmerken als bèta’s.
Waar het breekt. Het model breekt niet in de voorspelling maar in de vertaling naar winst en betekenis. Volgens Avramov, Cheng en Metzker halen strategieën op machine-learningvoorspellingen hun winst vooral uit moeilijk verhandelbare aandelen, en wordt die winst kleiner zodra de kleinste aandelen eruit gaan. In onze replicatie is de winst van de bomen klein en na 2005 verdwenen. Martin en Nagel wijzen op de diepste zwakke plek, want zelfs perfect gemeten voorspelbaarheid in de steekproef zegt niets over efficiëntie als beleggers moeten leren.
Risico of vergissing? Volgens de Chicago-lezing, waarin verwachte rendementen risicopremies zijn, meet een netwerk die premies beter omdat bèta’s niet-lineair van kenmerken afhangen, zoals IPCA en de prior van KNS suggereren. Volgens de Yale-lezing, waarin beleggers zich vergissen en arbitrageurs dat maar deels herstellen, zijn de sterkste voorspellers bij GKX niet toevallig kortetermijnomkering, momentum, liquiditeit en volatiliteit. Daar laten limits of arbitrage (de kosten en risico’s die arbitrageurs afremmen) sporen na, en daar eten handelskosten de alpha op. Martin en Nagel voegen met leren een derde lezing toe. Scheiden kan alleen met voorspelbaarheid na publicatie, op schaal en na kosten, en die data bestaan nog niet. Voor een belegger blijft de vraag van Santa-Clara of een netwerkvoorspelling een risicopremie is of een vermeend inzicht.
Wat er daarna kwam. Waarom prijzen bewegen, is ook te onderzoeken door te kijken wie de aandelen koopt en hoe gevoelig die kopers voor de prijs zijn, in demand systems en inelastische markten.
8Oefeningen
Solution to Exercise 1
Ridge deelt door 40, dus en . LASSO trekt 2 af van en deelt door 10, dus en . Verder valt weg zodra , en zodra . De cel controleert de gewichten.
ridge_30 = Ridge(alpha=30, fit_intercept=False).fit(X_toy, r_toy).coef_
lasso_2 = Lasso(alpha=2 / 5, fit_intercept=False).fit(X_toy, r_toy).coef_   # alpha = lambda / n
pd.DataFrame({"met de hand": [0.4, -0.075, 1.4, -0.1],
              "scikit-learn": np.concatenate([ridge_30, lasso_2])},
index=["ridge b1", "ridge b2", "LASSO b1", "LASSO b2"]).round(4)Een grotere absolute straf laat meer kenmerken wegvallen, de zwakste eerst, terwijl ridge alle gewichten met dezelfde factor krimpt.
Solution to Exercise 2
De cel schat beide regressies voor twaalf waarden van in 50 herhalingen.
n_pred, t_train, t_test, n_true, p_max, n_rep_kmz = 15, 120, 1000, 4000, 1200, 50
w_true = rng.normal(size=(n_true, n_pred))
b_true = rng.normal(size=n_true)


def premium(x):
    return np.sin(2 * x @ w_true.T / np.sqrt(n_pred)) @ b_true / np.sqrt(n_true)


x_test = rng.normal(size=(t_test, n_pred))
mu_test = premium(x_test)
noise_sd = mu_test.std() * np.sqrt(0.95 / 0.05)                 # population R^2 = 5%
complexity = np.array([0.1, 0.25, 0.5, 0.75, 0.9, 1.0, 1.1, 1.5, 2, 3, 5, 10])
kmz = {k: np.zeros((n_rep_kmz, len(complexity))) for k in
       ["R2 ridgeless", "R2 ridge", "SR ridgeless", "SR ridge"]}
for rep in range(n_rep_kmz):
    W = rng.normal(size=(p_max, n_pred))
    x_train = rng.normal(size=(t_train, n_pred))
    y_train = premium(x_train) + noise_sd * rng.normal(size=t_train)
    y_test = mu_test + noise_sd * rng.normal(size=t_test)
    S_train = np.sin(2 * x_train @ W.T / np.sqrt(n_pred))
    S_test = np.sin(2 * x_test @ W.T / np.sqrt(n_pred))
    for k, c in enumerate(complexity):
        P = int(round(c * t_train))
        A, B = S_train[:, :P] / np.sqrt(P), S_test[:, :P] / np.sqrt(P)
        betas = {"ridgeless": np.linalg.lstsq(A, y_train, rcond=None)[0],       # min-norm
                 "ridge": A.T @ np.linalg.solve(A @ A.T + 0.1 * t_train * np.eye(t_train), y_train)}
        for name, beta in betas.items():
            forecast = B @ beta
            kmz[f"R2 {name}"][rep, k] = oos_r2(y_test, forecast)
            kmz[f"SR {name}"][rep, k] = hap.sharpe(pd.Series(forecast * y_test))

kmz_table = pd.DataFrame({"P/T": complexity,
                          "R2 ridgeless (mediaan, %)": 100 * np.median(kmz["R2 ridgeless"], 0),
                          "R2 ridge (mediaan, %)": 100 * np.median(kmz["R2 ridge"], 0),
                          "Sharpe ridgeless": kmz["SR ridgeless"].mean(0),
                          "Sharpe ridge": kmz["SR ridge"].mean(0)}).set_index("P/T")
kmz_table.round(3)De mediane ridgeless zakt bij tot ruim en herstelt tot bij . Met ridge blijft de rond nul, terwijl de Sharpe-ratio van de timingstrategie stijgt van 0,06 bij tot 0,13 bij . Dat is geen tegenspraak, want de straft de schaal van de voorspelling en de Sharpe-ratio beloont het teken. Volgens (16) is een kleine veel waard als de Sharpe-ratio zonder voorspeller klein is. De krimp, en niet het aantal parameters, bepaalt of een complex model de ruis naloopt.
Solution to Exercise 3
(1) met . Dus , met bias en variantie . De afgeleide van de som naar is , die nul is bij , negatief daaronder en positief daarboven.
(2) en (3) De cel rekent beide fouten analytisch en met Monte Carlo uit.
d, sigma, beta = 10.0, 3.0, 0.3
lam_star = sigma**2 / beta**2
mse = lambda lam: (lam * beta / (d + lam)) ** 2 + sigma**2 * d / (d + lam) ** 2
z_draws = d * beta + sigma * np.sqrt(d) * rng.normal(size=100_000)
mc = {lam: np.mean((z_draws / (d + lam) - beta) ** 2) for lam in (0.0, lam_star)}
print(f"lambda* = {lam_star:.0f}, krimpfactor d/(d+lambda*) = {d / (d + lam_star):.3f}")
print(f"MSE OLS   : analytisch {mse(0):.4f}, Monte Carlo {mc[0.0]:.4f}")
print(f"MSE ridge : analytisch {mse(lam_star):.4f}, Monte Carlo {mc[lam_star]:.4f}")
print(f"verhouding ridge/OLS = {mse(lam_star) / mse(0):.3f}")
lambda* = 100, krimpfactor d/(d+lambda*) = 0.091
MSE OLS : analytisch 0.9000, Monte Carlo 0.8972
MSE ridge : analytisch 0.0818, Monte Carlo 0.0818
verhouding ridge/OLS = 0.091
Bij is de optimale krimpfactor , zodat ridge maar 9% van de OLS-schatting overhoudt en de verwachte kwadratische fout daalt van 0,90 naar 0,08. De toy-keuze , die met de helft krimpt, is naar deze maatstaf nog voorzichtig. Bij de signaal-ruisverhouding van rendementen is harde krimp de kern van de schatter.
Solution to Exercise 4
simulate_gkx met n_char=80 levert voorspellers, waarvan alleen de eerste drie kenmerken meetellen in .
linear_models = {k: SIM_MODELS[k] for k in ["OLS", "ridge", "LASSO"]}
month = np.repeat(np.arange(48), 500)
train, valid, test = month < 30, (month >= 30) & (month < 39), month >= 39
rows = []
for rep in range(3):
    Z, y, g = simulate_gkx(rng, nonlinear=False, n_stocks=500, n_months=48, n_char=80)
    row = {"populatie": oos_r2(y[test], g[test])}
    row.update(fit_validate(linear_models, Z, y, train, valid, test))
    rows.append(row)
(100 * pd.DataFrame(rows).rename_axis("replicatie")).round(2)Met 15.000 trainingswaarnemingen lijkt klein, maar de gemeenschappelijke schok en de persistentie van de kenmerken maken veel kleiner. In de eerste replicatie zakt OLS naar bij een populatie- van 5,4%, terwijl ridge haalt en LASSO . In de andere twee blijft OLS rond nul en haalt LASSO 2,2% en 1,2%. LASSO wint omdat maar drie van de 80 kenmerken tellen. OLS faalt dus niet door een eigenschap van rendementen, maar door de verhouding tussen parameters en effectieve informatie, hetzelfde mechanisme als bij GKX.
- Gu, S., Kelly, B., & Xiu, D. (2020). Empirical Asset Pricing via Machine Learning. The Review of Financial Studies, 33(5), 2223–2273. 10.1093/rfs/hhaa009
- Kelly, B. T., Pruitt, S., & Su, Y. (2019). Characteristics Are Covariances: A Unified Model of Risk and Return. Journal of Financial Economics, 134(3), 501–524. 10.1016/j.jfineco.2019.05.001
- Kozak, S., Nagel, S., & Santosh, S. (2020). Shrinking the Cross-Section. Journal of Financial Economics, 135(2), 271–292. 10.1016/j.jfineco.2019.06.008
- Martin, I. W. R., & Nagel, S. (2022). Market Efficiency in the Age of Big Data. Journal of Financial Economics, 145(1), 154–177. 10.1016/j.jfineco.2021.10.006
- Nagel, S. (2021). Machine Learning in Asset Pricing. Princeton University Press. 10.23943/princeton/9780691218700.001.0001
- Kelly, B., & Xiu, D. (2023). Financial Machine Learning. Foundations and Trends in Finance, 13(3–4), 205–363. 10.1561/0500000064
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics, 12(1), 55–67. 10.1080/00401706.1970.10488634
- Tibshirani, R. (1996). Regression Shrinkage and Selection via the Lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. 10.1111/j.2517-6161.1996.tb02080.x
- Zou, H., & Hastie, T. (2005). Regularization and Variable Selection via the Elastic Net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. 10.1111/j.1467-9868.2005.00503.x
- Breiman, L. (2001). Random Forests. Machine Learning, 45(1), 5–32. 10.1023/A:1010933404324
- Friedman, J. H. (2001). Greedy Function Approximation: A Gradient Boosting Machine. The Annals of Statistics, 29(5), 1189–1232. 10.1214/aos/1013203451
- Chen, A. Y., & Zimmermann, T. (2022). Open Source Cross-Sectional Asset Pricing. Critical Finance Review, 11(2), 207–264. 10.1561/104.00000112
- Ehsani, S., & Linnainmaa, J. T. (2022). Factor Momentum and the Momentum Factor. The Journal of Finance, 77(3), 1877–1919. 10.1111/jofi.13131
- Avramov, D., Cheng, S., & Metzker, L. (2023). Machine Learning vs. Economic Restrictions: Evidence from Stock Return Predictability. Management Science, 69(5), 2587–2619. 10.1287/mnsc.2022.4449
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD