

Habit, long-run risk en rampen
1Overzicht
Welke consumptie-SDF verklaart de aandelenpremie? Drie modellen doen het elk, met een gewoonte, met langetermijnrisico of met zeldzame rampen. Elk leunt echter op een parameter die honderd jaar data niet vastleggen, zodat die data er niet tussen kunnen kiezen. In dit college:
leiden we voor elk model de SDF, de premie en de rente af, en de reden dat de prijs-dividendratio beweegt,
laten we zien dat Epstein-Zin-voorkeuren de rente van de premie loskoppelen, maar pas een premie opleveren als de groei voorspelbaar is,
simuleren we elk model duizend keer over honderd jaar en kijken we welke steekproefmomenten de modellen nog onderscheiden,
repliceren we kerngetallen van Wachter Wachter (2005), Beeler en Campbell Beeler & Campbell (2012) en Barro Barro (2009), en leggen we de Amerikaanse data over 1930–2025 in de simulatiebanden.
Rond de eeuwwisseling kreeg de puzzel van de aandelenpremie drie antwoorden. Campbell en Cochrane Campbell & Cochrane (1999) gaven beleggers een gewoonte, en Bansal en Yaron Bansal & Yaron (2004) combineerden de voorkeuren van Epstein en Zin Epstein & Zin (1989) met een kleine, persistente groeicomponent. Barro Barro (2006) maakte, voortbouwend op Rietz Rietz (1988), van de premie een vergoeding voor zeldzame rampen. Santa-Clara Santa-Clara (2026) ziet in die drie antwoorden het moment waarop de aandelenpremie van een getoetste theorie een feit met concurrerende theorieën werd, omdat ze op de beschikbare data niet te onderscheiden zijn. Chen, Dou en Kogan Chen et al. (2024) gaven in 2024 een maat voor hoe zwaar een model op zulke parameters leunt, de dark matter (donkere materie) van het model.
2Intuïtie: waarom zou dit waar zijn?
De puzzel uit Mehra-Prescott en Hansen-Jagannathan heeft twee helften. Consumptie schommelt te weinig voor een grote premie, tenzij beleggers extreem risicomijdend zijn, en zulke beleggers willen bij groeiende consumptie niet sparen, zodat de rente hoog zou moeten zijn. Een antwoord moet de discontofactor dus in slechte toestanden veel groter maken zonder hem gemiddeld te verlagen, en de drie modellen doen dat elk op een andere plaats.
Gewoonte. Een huishouden dat 100 besteedt en aan 95 gewend is, verliest bij een daling met 2 bijna de helft van zijn marge boven de gewoonte. Hoe dichter het bij die gewoonte zit, hoe risicomijdender het wordt, zodat de premie hoog is in slechte tijden en een lage prijs hoge rendementen voorspelt. Omdat zo’n huishouden dan ook meer uit voorzorg spaart, kan de rente constant blijven.
Langetermijnrisico. Stel dat consumptiegroei een kleine component heeft die jaren aanhoudt, bijvoorbeeld een tiende procentpunt meer groei, tien jaar lang. In jaardata verdwijnt die component in de ruis, maar een aandeel is een claim op alle toekomstige dividenden, en een blijvend lagere groei treft ze allemaal. Met Epstein-Zin-voorkeuren betalen beleggers veel voor bescherming tegen zulk nieuws, omdat die voorkeuren de risicoaversie loskoppelen van de bereidheid om consumptie door de tijd te verschuiven.
Rampen. Stel dat de economie elk jaar een kleine kans heeft op een oorlog of depressie waarin consumptie met een kwart of meer daalt. Aandelen storten dan in terwijl obligaties gewoon uitbetalen, en een euro is enorm veel waard. Een kans van anderhalf procent per jaar volstaat voor een premie van een paar procent, en omdat iedereen zich tegen de ramp wil indekken, is de rente laag. In honderd jaar Amerikaanse data zit zo’n ramp niet, zodat de premie te groot lijkt voor het risico dat we zagen.
Alle drie de verhalen passen dus op dezelfde getallen: de gemiddelde premie, de volatiliteit, de lage rente en de beweeglijke prijs-dividendratio. We verwachten daarom dat die getallen de modellen niet scheiden. Het verschil zit dan in wat slecht te meten is, namelijk de snelheid van een gewoonte, de persistentie van een onzichtbare groeicomponent en de frequentie van rampen die in de steekproef ontbraken. Als een gemiddeld rendement na een eeuw al de standaardfout van 2% heeft, zijn zulke grootheden nog veel slechter gemeten.
3Toy-voorbeeld: een ramp met de hand
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import optimize

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
We rekenen een Lucas-boom met twee toestanden door, zoals Rietz en Barro dat doen. Consumptie is het dividend en groeit elk jaar met 2,5%, of krimpt in een ramp met 40%, onafhankelijk door de tijd. Volgens Barro geeft bij een vaste daling van ongeveer 40% dezelfde premie als de gemeten verdeling van rampgroottes. De rampkans is zijn frequentie van 60 rampen in 35 landen in een eeuw Barro (2009).
| normaal jaar | rampjaar | |
|---|---|---|
| kans | ||
| bruto consumptiegroei | ||
| voorkeuren | CRRA, , | idem |
Het recept komt uit Lucas, Breeden en de SDF. De SDF is en het bruto risicovrije rendement , met zoals overal in dit college de netto rente. Bij onafhankelijke groei is de prijs-dividendratio met .
De SDF. Met is , en met is . In een ramp is een euro dus achtenhalf keer zoveel waard.
Zonder ramp. Bij is , een rente van 13,8% en precies de rentepuzzel van (7). Met is de prijs-dividendratio 9,07, en omdat er geen risico is, is de premie nul.
Met ramp. Nu is , dus en een rente van 0,9%. Met is voor het aandeel , zodat de ratio stijgt naar 25,16.
De premie. Het verwachte bruto rendement is , dus de premie is procentpunt.
Een eeuw zonder ramp. In een jaar zonder ramp verdient het aandeel , 5,67 procentpunt boven de rente en meer dan de ware premie. Honderd jaar zonder ramp hebben kans . Een steekproef zonder ramp toont dan een hoog rendement zonder het risico waarvoor dat rendement een vergoeding is, en dat heet het peso-probleem.
De codecel rekent dezelfde getallen na, met in de laatste kolom de wereld zonder ramp.
beta_a, gamma_a, g_n, b_toy, p_toy = 0.97, 4.0, 1.025, 0.40, 0.017
growth_toy = np.array([g_n, 1 - b_toy])

def rietz_toy(p):
    """Two-state iid Lucas tree: SDF, gross risk-free return, P/D, expected return and premium."""
    prob = np.array([1 - p, p])
    m = beta_a * growth_toy ** -gamma_a
    k = beta_a * prob @ growth_toy ** (1 - gamma_a)
    rf = 1 / (prob @ m)
    er = (prob @ growth_toy) / k
    return {"m_n": m[0], "m_d": m[1], "1+R^f": rf, "P/D": k / (1 - k), "E[R]": er,
            "premie (%)": 100 * (er - rf), "R zonder ramp": g_n / k}

hand = {"m_n": 0.878770, "m_d": 7.484568, "1+R^f": 1.00901, "P/D": 25.16, "E[R]": 1.05823,
        "premie (%)": 4.92, "R zonder ramp": 1.06574, "kans op 100 jaar zonder ramp": 0.18}
code = {**rietz_toy(p_toy), "kans op 100 jaar zonder ramp": (1 - p_toy) ** 100}
pd.DataFrame({"met de hand": hand, "code": code, "zonder ramp (p = 0)": rietz_toy(0.0)}).round(5)Code en handberekening komen overeen. Bij dezelfde risicoaversie maakt een kleine rampkans van een wereld zonder premie en met een rente van 13,8% een wereld met een premie van bijna 5% en een rente onder 1%. De verwachte consumptiegroei daalt daarbij maar van 2,5% naar 1,8%, omdat de ramp zelden komt.
4Theorie
De drie modellen zijn drie stochastische discontofactoren. Voor de gewoonte, Epstein-Zin met langetermijnrisico en de rampen halen we uit de SDF de premie, de rente en de toestandsvariabele die de prijs-dividendratio beweegt. Omdat elk model de premie haalt met één slecht meetbare parameter, maakt de laatste subsectie daar een toetsbare definitie van.
4.1Drie uitwegen uit de grens van Hansen en Jagannathan
Een consumptie-SDF kan de grens van Hansen en Jagannathan op drie manieren halen, en elk model kiest er één. Volgens (5) moet minstens de Sharpe-ratio van de markt zijn, ongeveer 0,4, terwijl CRRA geeft bij een consumptie die maar een paar procent schommelt. Een model kan dus de vermenigvuldiger van in slechte tijden vergroten (gewoonte). Het kan ook laten reageren op nieuws over alle toekomstige jaren (langetermijnrisico), of een staart geven die de steekproef niet toont (rampen).
| SDF | prijs van risico | vrije, moeilijk meetbare parameter | |
|---|---|---|---|
| Campbell-Cochrane | persistentie van de gewoonte | ||
| Bansal-Yaron | , , | persistentie van | |
| Rietz-Barro | met sprongen | plus sprongterm | rampkans en -grootte |
We schrijven voor bruto consumptiegroei, en , met de netto risicovrije rente. Barro schrijft voor de tijdsvoorkeur, met , terwijl bij Bansal-Yaron de persistentie van is.
4.2Campbell-Cochrane: de surplusratio
Een gewoonte maakt beleggers risicomijdender naarmate hun consumptie dichter bij die gewoonte komt, zonder dat groot hoeft te zijn. Neem aan dat nut afhangt van , met een gewoonte die door de consumptie van anderen wordt bepaald (external habit, externe gewoonte). Dan is de kromming ten opzichte van gelijk aan . Bij de marge van 5% uit de intuïtie is dat twintig keer .
Met de surplus consumption ratio (surplusratio) en is marginaal nut , want de gewoonte is extern. De SDF is dan
en die is hoog als het surplus daalt, ook als consumptie nauwelijks beweegt. De lokale risicoaversie is . Consumptiegroei is met , en het log surplus volgt
Het surplus keert dus met snelheid terug naar , en een consumptieschok werkt erop in met gewicht , de sensitivity function (gevoeligheidsfunctie). Campbell en Cochrane kozen die functie zo dat de rente constant is en onder blijft.
Proof 1
Een laag surplus zal naar verwachting herstellen, zodat beleggers willen lenen en de rente zou stijgen, maar tegelijk is de SDF dan volatiel en willen ze uit voorzorg sparen. De functie (3) laat die twee effecten precies tegen elkaar wegvallen. De maximale Sharpe-ratio is bij het gemiddelde surplus , in jaartermen , en in recessies nog hoger.
Campbell en Cochrane simuleerden maandelijks met de jaarparameters in de tabel, die we overnemen uit tabel 1 van Wachter Wachter (2005). De persistentie draagt de kalibratie, want ze is gekozen om de persistentie van de prijs-dividendratio na te bootsen en niet gemeten aan hoe snel gewoontes zich aanpassen.
| parameter | waarde | betekenis |
|---|---|---|
| 1,89% | gemiddelde consumptiegroei per jaar | |
| 1,50% | volatiliteit van consumptiegroei per jaar | |
| 0,94% | constante log risicovrije rente | |
| 0,87 | persistentie van het surplus per jaar | |
| 2 | kromming van het nut in |
Omdat de enige toestandsvariabele is, hangt de prijs-consumptieratio alleen van het surplus af. Die functie lost de Euler-vergelijking op:
De prijs van vandaag is dus de verdisconteerde waarde van het dividend en de prijs van morgen. Er is geen gesloten vorm, en Wachter Wachter (2005) liet zien dat de numerieke oplossing gevoelig is voor het rooster. Omdat (6) lineair is in , lossen we hem op een rooster in één keer op als lineair stelsel , met de kwadratuur- en interpolatiegewichten. Rij van hoort bij roosterpunt en verdeelt de verdisconteerde groei van elk kwadratuurpunt over de twee roosterpunten rond het bijbehorende .
De cel doet dat voor de consumptieclaim en voor een dividendclaim met een volatiliteit van 11,2% en een correlatie van 0,2 met consumptie, die we in de simulatie gebruiken.
CC = dict(g=0.0189, sig=0.015, gamma=2.0, phi=0.87, rf=0.0094, sig_w=0.112, rho_w=0.2)   # annual

def cc_solve(g, sig, gamma, phi, rf, sig_w=0.0, rho_w=0.0, n_nodes=20, lower=80.0, n_low=400, n_high=600):
    """Campbell-Cochrane price-dividend function on a grid in s, solved as one linear system (monthly model)."""
    gm, sm, phim, rfm, swm = g / 12, sig / np.sqrt(12), phi ** (1 / 12), rf / 12, sig_w / np.sqrt(12)
    S_bar = sm * np.sqrt(gamma / (1 - phim))
    s_bar = np.log(S_bar)
    s_max = s_bar + 0.5 * (1 - S_bar**2)
    log_beta = gamma * gm - 0.5 * gamma * (1 - phim) - rfm                 # eq. cc-rf solved for beta
    lam = lambda s: np.where(s <= s_max, np.sqrt(np.maximum(1 - 2 * (s - s_bar), 0.0)) / S_bar - 1, 0.0)
    s = np.concatenate([np.linspace(s_bar - lower, s_bar - 1.5, n_low, endpoint=False),
                        np.linspace(s_bar - 1.5, s_max, n_high)])
    nodes, weights = np.polynomial.hermite_e.hermegauss(n_nodes)
    v = sm * nodes
    L = lam(s)[:, None]
    s_next = np.clip((1 - phim) * s_bar + phim * s[:, None] + L * v, s[0], s_max)
    base = log_beta - gamma * gm - gamma * (1 - phim) * (s_bar - s)[:, None]
    # dividend growth gm + w, w = rho_w (swm/sm) v + sqrt(1 - rho_w^2) swm eps, eps integrated out analytically
    load = rho_w * swm / sm if sig_w > 0 else 1.0
    extra = 0.5 * (1 - rho_w**2) * swm**2 if sig_w > 0 else 0.0
    # step 1: kernel K[i, q] = quadrature weight x m x dividend growth, from grid point s_i at node q
    K = weights / weights.sum() * np.exp(base + gm + extra + (load - gamma * (1 + L)) * v)
    rf_check = -np.log((weights / weights.sum() * np.exp(base - gamma * (1 + L) * v)).sum(axis=1))
    # step 2: split each K[i, q] over the two grid points around s_next[i, q] (linear interpolation) -> row i of M
    n = len(s)
    j = np.clip(np.searchsorted(s, s_next) - 1, 0, n - 2)
    w_hi = (s_next - s[j]) / (s[j + 1] - s[j])
    M = np.zeros((n, n))
    rows = np.broadcast_to(np.arange(n)[:, None], j.shape)
    np.add.at(M, (rows, j), K * (1 - w_hi))
    np.add.at(M, (rows, j + 1), K * w_hi)
    pd_grid = np.linalg.solve(np.eye(n) - M, K.sum(axis=1))
    return dict(s=s, pd=pd_grid, s_bar=s_bar, s_max=s_max, S_bar=S_bar, beta=np.exp(12 * log_beta), lam=lam,
                gm=gm, sm=sm, phim=phim, rfm=rfm, swm=swm, rho_w=rho_w,
                rf_check=12 * rf_check[s <= s_max])

cc_cons = cc_solve(**{**CC, "sig_w": 0.0, "rho_w": 0.0})
cc_div = cc_solve(**CC)
print(f"S-bar = {cc_div['S_bar']:.4f}, S_max = {np.exp(cc_div['s_max']):.4f}, beta (jaar) = {cc_div['beta']:.4f}")
print(f"r^f op het rooster: {cc_div['rf_check'].min():.5f} tot {cc_div['rf_check'].max():.5f}  (doel 0.0094)")
S-bar = 0.0570, S_max = 0.0938, beta (jaar) = 0.8958
r^f op het rooster: 0.00940 tot 0.00940 (doel 0.0094)
De code geeft , en per jaar, wat Wachter tot 0,90 afrondt. De rente is op het hele rooster 0,94%, zoals Proposition 1 belooft.
4.3Epstein-Zin en de SDF
Epstein-Zin-voorkeuren scheiden de afkeer van risico van de afkeer van schommelingen door de tijd, en daardoor telt in de SDF naast consumptie ook het rendement op vermogen. Epstein en Zin Epstein & Zin (1989) en Weil Weil (1989) definieerden het nut recursief, met een risicoaversie en een intertemporele substitutie-elasticiteit (EIS) als aparte parameters:
Het nut van vandaag middelt dus consumptie nu en het zekerheidsequivalent van het nut morgen. Daarbij bepaalt hoe zwaar risico telt en hoe gemakkelijk consumptie door de tijd verschuift.
Proof 2
Schets. Homogeniteit geeft , en de eerste-ordevoorwaarde met de envelopstelling geeft , met het zekerheidsequivalent van het vervolgnut. De Euler-vergelijking voor het vermogensrendement geeft Epstein & Zin (1989)Weil (1989). Verheffen tot de macht en invullen geeft (8).
In logs is . Bij en is en dus , zodat een slecht rendement op vermogen de SDF verhoogt. Zo krijgt nieuws over de hele toekomstige consumptiestroom een prijs, ook als het de consumptie van dit jaar niet raakt.
Bij onafhankelijke lognormale groei, , is de verhouding van vermogen tot consumptie constant en . De helling van op is dan , en uitwerken (oefening 2) geeft
Met , en komt daar het volgende uit:
bij is , een rente van 3,0%;
bij , het CRRA-geval, is , een rente van 20%;
in beide gevallen is de premie procentpunt.
De cel rekent dezelfde formules uit, ook voor , en controleert met een Monte-Carlo-steekproef dat de SDF de claim op consumptie op één waardeert.
def ez_iid(beta, mu, sigma, gamma, psi):
    """Log risk-free rate and log premium on the wealth claim, iid lognormal growth."""
    log_rf = -np.log(beta) + mu / psi - 0.5 * sigma**2 * gamma * (1 + 1 / psi) + 0.5 * sigma**2 / psi
    return log_rf, gamma * sigma**2

toy_b = {}
for gamma_b, psi_b in [(10, 1.5), (10, 0.1), (5, 1.5), (5, 0.2)]:
    log_rf, prem = ez_iid(0.98, 0.02, 0.02, gamma_b, psi_b)
    toy_b[f"gamma = {gamma_b}, psi = {psi_b}"] = {"log(1+R^f)": log_rf, "log premie": prem}

# check the closed form against a brute-force Euler equation with the SDF above
theta = (1 - 10) / (1 - 1 / 1.5)
z = rng.standard_normal(2_000_000)
dc = 0.02 + 0.02 * z
kappa = -np.log(0.98) - ((1 - 10) * 0.02 + 0.5 * (1 - 10) ** 2 * 0.02**2) / theta
log_m = theta * np.log(0.98) - theta / 1.5 * dc + (theta - 1) * (dc + kappa)
print(f"E[m R_w] = {np.mean(np.exp(log_m + dc + kappa)):.4f}  (moet 1 zijn)")
print(f"log(1+R^f) uit simulatie = {-np.log(np.mean(np.exp(log_m))):.4f}  (met de hand: 0.0303)")
pd.DataFrame(toy_b).T.round(6)
E[m R_w] = 1.0002 (moet 1 zijn)
log(1+R^f) uit simulatie = 0.0301 (met de hand: 0.0303)
De eerste twee rijen geven de handgetallen, en bij halveert de premie terwijl de rente vooral met beweegt. Een hogere verlaagt de rente, omdat beleggers dan minder vergoeding vragen om consumptiegroei af te wachten, maar de premie blijft , even klein als bij CRRA. Pas als groei voorspelbaar is, krijgt invloed op de premie, en dat is de bijdrage van Bansal en Yaron.
4.4Bansal-Yaron: langetermijnrisico
Een kleine, persistente groeicomponent maakt de SDF hoog wanneer het vermogen daalt door slecht nieuws over de verre toekomst, mits . Een schok in die per maand met factor uitdooft, weegt in de waarde van een claim op alle toekomstige consumptie ongeveer keer, bij bijna vijftig keer. Bij wint het groei-effect van het rente-effect, zodat het vermogensrendement daalt als de vooruitzichten verslechteren. Omdat is, stijgt de SDF dan, en daarom betalen beleggers, zoals de intuïtie al zei, veel voor bescherming tegen slecht groeinieuws.
Bansal en Yaron schrijven, per maand,
met onafhankelijke standaardnormale schokken, zodat consumptie- en dividendgroei een trage component delen, waarop dividenden keer zo sterk reageren. De volatiliteit beweegt zelf langzaam, en de kalibratie komt uit tabel I van Beeler en Campbell Beeler & Campbell (2012), die de parameters van Bansal en Yaron overnemen.
| parameter | waarde | betekenis |
|---|---|---|
| , , | 0,998 / 10 / 1,5 | discontofactor per maand, risicoaversie, EIS |
| 0,0015 | gemiddelde groei per maand | |
| , | 0,979 / 0,044 | persistentie en schokgrootte van |
| , , | 0,0078 / 0,987 / 0,0000023 | niveau, persistentie en schok van de volatiliteit |
| , | 3 / 4,5 | hefboom en eigen volatiliteit van dividenden |
De halfwaardetijd van is maanden, en zijn standaarddeviatie per maand is in jaardata onzichtbaar klein. Voor de oplossing gebruiken we de Campbell-Shiller-benadering (3) uit Voorspelbaarheid van rendementen, nu voor de claim op consumptie, en vanaf hier zijn kleine letters logs. Dan is , met de log prijs-consumptieratio en net onder één, de van dat college. De constante hoort erbij, en beide hangen af van de gemiddelde ratio , die de oplossing zelf bepaalt. De oplossing heeft twee kanalen, groeinieuws via en onzekerheidsnieuws via . Het tweede kanaal, waarin een volatiliteitsschok de prijs verlaagt, levert bij deze kalibratie maar 0,2 van de ruim 5 procentpunt premie, omdat zo klein is. Vooral en doen er dus toe.
Het bewijs zet de proefoplossing in de Euler-vergelijking en eist dat de coëfficiënten van en afzonderlijk nul zijn Bansal & Yaron (2004). De premie (13) is dan een vergoeding voor nieuws over de groei plus een vergoeding voor nieuws over de onzekerheid. Drie gevolgen zijn voor de rest van het college van belang.
vereist . Alleen dan stijgt de vermogensprijs bij goed groeinieuws, zodat het vermogen juist bij slecht nieuws verliest en een slechte verzekering is. De prijs van langetermijnrisico, , is positief zodra en is bij deze kalibratie 17,9. Bij draait dus niet om maar de reactie van de vermogensprijs, en de premie krimpt omdat kleiner wordt. Die hoge EIS ligt boven de meeste macro-econometrische schattingen, die Bansal en Yaron als vertekend door tijdvariërende volatiliteit beschouwen.
De premie is groot, omdat een factor bevat en dividenden met drie keer zo sterk op reageren als consumptie.
De persistentie bepaalt vrijwel alles, terwijl honderd jaar jaardata die persistentie nauwelijks vastleggen, omdat niet waarneembaar is.
De cel lost het model op en splitst de premie in de twee kanalen.
BY = dict(beta=0.998, gamma=10.0, psi=1.5, mu=0.0015, rho=0.979, phi_e=0.044, sig=0.0078, nu1=0.987,
          sig_w=0.0000023, mu_d=0.0015, phi=3.0, phi_d=4.5)          # monthly, Beeler-Campbell (2012) Table I

def by_solve(p):
    """Log-linear solution of Bansal-Yaron (2004) with endogenous linearisation constants."""
    beta, gamma, psi, mu, rho = p["beta"], p["gamma"], p["psi"], p["mu"], p["rho"]
    pe, s2, nu, sw = p["phi_e"], p["sig"] ** 2, p["nu1"], p["sig_w"]
    theta = (1 - gamma) / (1 - 1 / psi)
    # Campbell-Shiller constants at mean log ratio z: kappa_0 = log(1 + e^z) - kappa_1 z, kappa_1 = e^z / (1 + e^z)
    kappas = lambda z: (np.log1p(np.exp(z)) - np.exp(z) / (1 + np.exp(z)) * z, np.exp(z) / (1 + np.exp(z)))

    def wealth(z):
        k0, k1 = kappas(z)
        A1 = (1 - 1 / psi) / (1 - k1 * rho)
        A2 = 0.5 * ((1 - gamma) ** 2 + (theta * k1 * A1 * pe) ** 2) / (theta * (1 - k1 * nu))
        A0 = (np.log(beta) + k0 + k1 * A2 * s2 * (1 - nu) + (1 - 1 / psi) * mu + 0.5 * theta * (k1 * A2 * sw) ** 2) / (1 - k1)
        return k0, k1, A0, A1, A2

    z = optimize.brentq(lambda z: wealth(z)[2] + wealth(z)[4] * s2 - z, 0.5, 15)
    k0, k1, A0, A1, A2 = wealth(z)
    lam_e, lam_w = (1 - theta) * k1 * A1 * pe, (1 - theta) * k1 * A2
    m0 = theta * np.log(beta) - theta / psi * mu + (theta - 1) * (k0 + k1 * A0 + k1 * A2 * s2 * (1 - nu) - A0 + mu)
    ms = (theta - 1) * A2 * (k1 * nu - 1)

    def market(z):
        k0m, k1m = kappas(z)
        A1m = (p["phi"] - 1 / psi) / (1 - k1m * rho)
        A2m = (ms + 0.5 * (gamma**2 + p["phi_d"] ** 2 + (k1m * A1m * pe - lam_e) ** 2)) / (1 - k1m * nu)
        A0m = (m0 + k0m + k1m * A2m * s2 * (1 - nu) + p["mu_d"] + 0.5 * sw**2 * (k1m * A2m - lam_w) ** 2) / (1 - k1m)
        return k0m, k1m, A0m, A1m, A2m

    zm = optimize.brentq(lambda z: market(z)[2] + market(z)[4] * s2 - z, 0.5, 15)
    k0m, k1m, A0m, A1m, A2m = market(zm)
    return dict(p=p, theta=theta, A1=A1, A2=A2, k1=k1, A0m=A0m, A1m=A1m, A2m=A2m, k0m=k0m, k1m=k1m,
                lam_e=lam_e, lam_w=lam_w, m0=m0, mx=-1 / psi, ms=ms)

by = by_solve(BY)
prem_lrr = by["lam_e"] * by["k1m"] * by["A1m"] * BY["phi_e"] * BY["sig"] ** 2
prem_vol = by["lam_w"] * by["k1m"] * by["A2m"] * BY["sig_w"] ** 2
pd.Series({"theta": by["theta"], "A_1": by["A1"], "A_1,m": by["A1m"], "kappa_1,m": by["k1m"],
           "lambda_e": by["lam_e"], "premie via x_t (%/jaar)": 1200 * prem_lrr,
           "premie via sigma_t (%/jaar)": 1200 * prem_vol}).round(3)
theta -27.000
A_1 14.555
A_1,m 93.218
kappa_1,m 0.996
lambda_e 17.897
premie via x_t (%/jaar) 5.337
premie via sigma_t (%/jaar) 0.199
dtype: float64Bij deze kalibratie is , zodat de SDF sterk op het vermogensrendement reageert, en , zodat een stijging van met één standaarddeviatie de log prijs-dividendratio met 0,16 verhoogt. Vrijwel de hele premie van ruim 5% per jaar komt uit het langetermijnkanaal, want het volatiliteitskanaal levert minder dan een tiende daarvan.
4.5Rietz-Barro: CRRA met sprongen
Met rampen is de premie een verzekeringspremie, het product van de kans, het verlies en de waarde van een euro in de ramp. Een aandeel verliest in een ramp een fractie van zijn waarde en een obligatie niets, zodat een aandeelhouder rampbescherming verkoopt en daarvoor betaald wil worden. De rente daalt, omdat de wens om zich te verzekeren de vraag naar veilige activa opdrijft, zoals in het toy-voorbeeld, waar ze van 13,8% naar 0,9% zakte.
Barro Barro (2006)Barro (2009) schrijft , met en rampkans per jaar. Met CRRA en een dividend gelijk aan consumptie volgt, zoals in Lucas, Breeden en de SDF maar met de ramp als extra toestand, de volgende propositie.
Proof 3
Met en , waarbij met kans , is . De log van het bruto risicovrije rendement is , en met volgt de eerste regel. Voor de boom geeft (8) een constante ratio met , dus , de derde regel. Het verwachte rendement is met , en aftrekken van de rente geeft de tweede regel.
De premie is dus de CRRA-term uit (4) plus een rampterm. Die rampterm is het product van een kans die in één land nauwelijks te meten is en een gewogen verlies dat door de grootste rampen wordt bepaald. Een hogere rampkans verlaagt de rente en verhoogt de premie, in de richting die het rampverhaal in de intuïtie verwachtte.
Barro telde 60 dalingen van het BBP per hoofd van minstens 15% in 35 landen over de twintigste eeuw, wat een rampkans van 1,7% per jaar geeft, dezelfde als in het toy-voorbeeld. Bij geven die dalingen en Barro (2009). De cel zet de drie regels van (14), met , en , naast tabel 3 van Barro (2009).
gamma_b, g_b, sigma_b, p_b, rho_b = 4.0, 0.025, 0.02, 0.017, 0.027
EB_g, EB_1g, E_b = 7.69, 4.05, 0.29                         # Barro (2009), footnote 10

rf_barro = rho_b + gamma_b * g_b - 0.5 * gamma_b**2 * sigma_b**2 - p_b * (EB_g - 1)
prem_barro = gamma_b * sigma_b**2 + p_b * (EB_g - EB_1g - E_b)
pd_barro = 1 / (rho_b + (gamma_b - 1) * g_b - 0.5 * (gamma_b - 1) ** 2 * sigma_b**2 - p_b * (EB_1g - 1))
pd.DataFrame(
    {"hier": [rf_barro, rf_barro + prem_barro, prem_barro, pd_barro],
     "Barro (2009), tabel 3": [0.010, 0.069, np.nan, 20.7],
     "zonder rampen (p = 0)": [rho_b + gamma_b * g_b - 0.5 * gamma_b**2 * sigma_b**2, np.nan, gamma_b * sigma_b**2,
                               1 / (rho_b + (gamma_b - 1) * g_b - 0.5 * (gamma_b - 1) ** 2 * sigma_b**2)]},
    index=["r^f", "r^e", "premie", "P/D"],
).round(4)De formules reproduceren de rij van Barro (2009) op drie decimalen, met een prijs-dividendratio van 20,7, een rente van 1,0% en een verwacht rendement van 6,9%. Zonder rampen zou de rente 12,4% zijn en de premie 0,16 procentpunt, en dan is de puzzel van Mehra en Prescott terug.
4.6Waarom de prijs-dividendratio beweegt
Elk model laat de prijs-dividendratio bewegen via een langzame toestandsvariabele, maar alleen in het habit-model loopt die beweging volledig via de premie, terwijl ze in Bansal-Yaron vooral en in de Gabaix-variant deels via verwachte dividendgroei loopt. Volgens (4) beweegt alleen als verwachte rendementen of verwachte dividendgroei bewegen, zodat een model dat rendementsvoorspelbaarheid wil verklaren een trage toestandsvariabele nodig heeft die de premie verschuift.
Habit. De toestand is , en de voorwaardelijke Sharpe-ratio daalt in . Na een reeks slechte jaren is de premie hoog en de prijs laag, en volgen hoge rendementen. Omdat de rente constant is, is alle beweging in beweging in de premie, en dividendgroei is niet voorspelbaar, precies de hond die niet blafte uit Voorspelbaarheid van rendementen.
Langetermijnrisico. De premie (13) hangt alleen van af, terwijl de ratio via verwachte dividendgroei beweegt. Omdat de volatiliteitscomponent weinig variantie draagt, voorspelt het model zwakke rendementsvoorspelbaarheid en sterke dividendgroeivoorspelbaarheid, het omgekeerde van wat Voorspelbaarheid van rendementen in de data vond.
Rampen. Met een constante en onafhankelijke is constant. Gabaix Gabaix (2012) laat daarom variëren hoeveel het dividend in een ramp daalt, zodat de ratio beweegt met de premie én met de verwachte dividendgroei. Wachter Wachter (2013) laat de rampkans zelf variëren, met Epstein-Zin-nut en .
4.7Observationele equivalentie
Drie modellen die elk één moeilijk meetbare parameter op hetzelfde handvol momenten afstellen, reproduceren die momenten per constructie en verschillen pas in momenten die we slecht meten. Een kalibratie kiest de vrije parameters immers zo dat de gemiddelde premie, de volatiliteit, de rente en de persistentie van de prijs-dividendratio kloppen.
Gewoon gezegd passen de data bij beide modellen, en onderscheidt geen toets met jaar ze beter dan toeval. Die equivalentie hangt dus af van , want met duizend jaar data zijn de modellen te scheiden en met honderd niet. Ze hangt ook af van de momenten in , en twee soorten momenten zouden de modellen kunnen scheiden.
Consumptievoorspelbaarheid op lange horizon. Volgens Bansal-Yaron is consumptiegroei op veel lags positief autogecorreleerd, volgens habit en rampen niet. Beeler en Campbell vonden naoorlogs geen autocorrelatie boven wat tijdsaggregatie al oplevert. Ze concludeerden dat het bewijs voor een persistente component staat of valt met de data uit de Grote Depressie Beeler & Campbell (2012).
Optieprijzen. Rampen zitten in de linkerstaart, die in honderd jaar rendementen onzichtbaar is maar wel in de prijs van putopties ver uit het geld zit. Santa-Clara en Yan Santa-Clara & Yan (2010) haalden uit S&P 500-opties de sprongrisico’s die beleggers vrezen, en Opties en crashrisico werkt dat programma uit.
5Simulatie: honderd jaar, duizend keer, vier modellen
Houden steekproeven van honderd jaar de modellen uit elkaar? We simuleren elk model duizend keer over honderd jaar en berekenen per steekproef, jaarlijks en reëel, dezelfde momenten als in de data:
het gemiddelde overrendement en de volatiliteit van het marktrendement,
gemiddelde en volatiliteit van de reële rente,
de gemiddelde prijs-dividendratio en de volatiliteit van de log-ratio,
de van één- en vijfjaarsvoorspellingen met die ratio, zoals in Voorspelbaarheid van rendementen,
de autocorrelatie van jaarlijkse consumptiegroei.
De modellen zijn Campbell-Cochrane met de dividendclaim uit de theorie, Bansal-Yaron, Barro met onafhankelijke rampen, en een variant in de geest van Gabaix. In die variant wordt het dividend in een ramp met vermenigvuldigd. Het regime blijft elk jaar met kans 0,9 bestaan en de dividendvolatiliteit is 11%. Die getallen kozen we zelf voor een realistische rendementsvolatiliteit, zodat ook deze variant op een ongemeten parameter leunt.
De eerste cel zet maandreeksen om in jaarcijfers en berekent de momenten, voor simulatie en data op dezelfde manier.
def annualize(r, dc, dd, lpd, rf):
    """Monthly (T x N) log series -> annual real simple returns, log P/D at year end, annual consumption growth."""
    T, N = r.shape
    Y = T // 12
    by_year = lambda a: a[: Y * 12].reshape(Y, 12, N)
    cum_c = np.cumsum(dc, axis=0)
    cum_d = np.cumsum(dd, axis=0)
    cons = by_year(np.exp(cum_c - cum_c[0])).sum(axis=1)                # time-aggregated annual consumption
    divs = by_year(np.exp(cum_d - cum_d[0]))
    lpd_a = by_year(lpd)[:, -1, :] + np.log(divs[:, -1, :]) - np.log(divs.sum(axis=1))  # December price / annual dividends
    return dict(rm=np.expm1(by_year(r).sum(axis=1))[1:], rf=np.expm1(by_year(rf).sum(axis=1))[1:],
                lpd=lpd_a[1:], dc=np.diff(np.log(cons), axis=0))

def colcorr(a, b):
    """Column-wise correlation; zero where either column is constant."""
    a, b = a - a.mean(axis=0), b - b.mean(axis=0)
    denom = np.sqrt((a * a).sum(axis=0) * (b * b).sum(axis=0))
    return np.divide((a * b).sum(axis=0), denom, out=np.zeros(a.shape[1]), where=denom > 1e-14)

def sample_moments(rm, rf, lpd, dc):
    """Moments per simulated sample (columns) or for the data (one column)."""
    lex = np.log1p(rm) - np.log1p(rf)
    cum = np.vstack([np.zeros((1, lex.shape[1])), np.cumsum(lex, axis=0)])
    out = {"E[R^e]": (rm - rf).mean(axis=0), "sd(R)": rm.std(axis=0, ddof=1),
           "E[R^f]": rf.mean(axis=0), "sd(R^f)": rf.std(axis=0, ddof=1),
           "E[P/D]": np.exp(lpd).mean(axis=0), "sd(log P/D)": lpd.std(axis=0, ddof=1)}
    for h in (1, 5):
        future = cum[1 + h:] - cum[1:-h]                                # sum of log excess returns t+1..t+h
        out[f"R2 {h} jaar"] = colcorr(lpd[: len(future)], future) ** 2
    out["AC1(dc)"] = colcorr(dc[1:], dc[:-1])
    return out
Data en simulatie krijgen zo precies dezelfde bewerking, ook de optelling van maandconsumptie tot jaarconsumptie. De volgende cel loopt maand voor maand door de modellen van Campbell-Cochrane en Bansal-Yaron.
def cc_simulate(sol, n_years, n_paths, burn=50):
    """Simulate the monthly Campbell-Cochrane economy on the solved grid; returns annual series via annualize."""
    s = np.full(n_paths, sol["s_bar"])
    T = (n_years + burn + 1) * 12
    out = {k: np.empty((T, n_paths)) for k in ("r", "dc", "dd", "lpd")}
    pd_old = np.interp(s, sol["s"], sol["pd"])
    for t in range(T):
        v = sol["sm"] * rng.standard_normal(n_paths)
        eps = rng.standard_normal(n_paths)
        s = np.clip((1 - sol["phim"]) * sol["s_bar"] + sol["phim"] * s + sol["lam"](s) * v, sol["s"][0], sol["s_max"])
        pd_new = np.interp(s, sol["s"], sol["pd"])
        w = v if sol["swm"] == 0 else sol["rho_w"] * sol["swm"] / sol["sm"] * v + np.sqrt(1 - sol["rho_w"] ** 2) * sol["swm"] * eps
        out["dc"][t], out["dd"][t] = sol["gm"] + v, sol["gm"] + w
        out["r"][t] = np.log((1 + pd_new) / pd_old) + out["dd"][t]
        out["lpd"][t], pd_old = np.log(pd_new), pd_new
    keep = slice(burn * 12, None)
    return annualize(out["r"][keep], out["dc"][keep], out["dd"][keep], out["lpd"][keep],
                     np.full((T - burn * 12, n_paths), sol["rfm"]))

def by_simulate(sol, n_years, n_paths, burn=20):
    """Simulate the monthly Bansal-Yaron economy with the log-linear solution; returns annual series via annualize."""
    p = sol["p"]
    T = (n_years + burn + 1) * 12
    x, var = np.zeros(n_paths), np.full(n_paths, p["sig"] ** 2)
    zm = sol["A0m"] + sol["A1m"] * x + sol["A2m"] * var
    out = {k: np.empty((T, n_paths)) for k in ("r", "dc", "dd", "lpd", "rf")}
    for t in range(T):
        e, eta, u, w = rng.standard_normal((4, n_paths))
        sd = np.sqrt(var)
        out["rf"][t] = -(sol["m0"] + sol["mx"] * x + sol["ms"] * var) - 0.5 * (
            (p["gamma"] ** 2 + sol["lam_e"] ** 2) * var + sol["lam_w"] ** 2 * p["sig_w"] ** 2)
        out["dc"][t] = p["mu"] + x + sd * eta
        out["dd"][t] = p["mu_d"] + p["phi"] * x + p["phi_d"] * sd * u
        x = p["rho"] * x + p["phi_e"] * sd * e
        var = np.maximum(p["sig"] ** 2 + p["nu1"] * (var - p["sig"] ** 2) + p["sig_w"] * w, 1e-12)   # as in BY
        zm_new = sol["A0m"] + sol["A1m"] * x + sol["A2m"] * var
        out["r"][t] = sol["k0m"] + sol["k1m"] * zm_new - zm + out["dd"][t]
        out["lpd"][t], zm = zm_new, zm_new
    keep = slice(burn * 12, None)
    return annualize(*(out[k][keep] for k in ("r", "dc", "dd", "lpd", "rf")))
De rampeconomie simuleren we per jaar, met een rampgrootte op vier punten tussen 15% en 64% die de momenten van Barro reproduceert, inclusief zijn gemiddelde daling van 29%. De cel drukt de kansen af en de exacte rente en ratio van die verdeling.
b_support = np.array([0.15, 0.30, 0.45, 0.64])          # Barro's range 15%-64%
b_moments = np.vstack([np.ones(4), b_support, (1 - b_support) ** -4.0, (1 - b_support) ** -3.0])
b_prob = np.linalg.solve(b_moments, [1.0, 0.29, 7.69, 4.05])
beta_d = np.exp(-rho_b)
EBg_d, EB1g_d = b_prob @ (1 - b_support) ** -gamma_b, b_prob @ (1 - b_support) ** (1 - gamma_b)
Rf_d = 1 / (beta_d * np.exp(-gamma_b * g_b + 0.5 * gamma_b**2 * sigma_b**2) * (1 - p_b + p_b * EBg_d))
k_d = beta_d * np.exp((1 - gamma_b) * g_b + 0.5 * (1 - gamma_b) ** 2 * sigma_b**2) * (1 - p_b + p_b * EB1g_d)
GABAIX = dict(F=np.array([0.2, 0.9]), P=np.array([[0.9, 0.1], [0.1, 0.9]]), sig_d=0.11)
print("kansen op b = 15/30/45/64%:", b_prob.round(4), f"| discreet exact: R^f = {Rf_d - 1:.4f}, P/D = {k_d / (1 - k_d):.2f}")

def disaster_simulate(n_years, n_paths, variant=None, burn=20):
    """Annual Barro economy; variant=GABAIX lets the dividend recovery F in a disaster follow a Markov regime."""
    T = n_years + burn
    u = sigma_b * rng.standard_normal((T, n_paths))
    hit = rng.random((T, n_paths)) < p_b
    b = b_support[rng.choice(4, size=(T, n_paths), p=b_prob)]
    dc = g_b + u + np.where(hit, np.log1p(-b), 0.0)
    if variant is None:
        pd_path = np.full((T, n_paths), k_d / (1 - k_d))
        r = dc + np.log((1 + pd_path) / pd_path)
    else:
        F, P = variant["F"], variant["P"]
        a = beta_d * np.exp((1 - gamma_b) * g_b + 0.5 * (1 - gamma_b) ** 2 * sigma_b**2) * (1 - p_b + p_b * EBg_d * F)
        pd_states = np.linalg.solve(np.eye(len(F)) - a[:, None] * P, (a[:, None] * P).sum(axis=1))
        regime = np.zeros((T + 1, n_paths), dtype=int)
        regime[0] = rng.integers(0, len(F), n_paths)
        draws = rng.random((T, n_paths))
        for t in range(T):
            regime[t + 1] = (draws[t][:, None] > np.cumsum(P, axis=1)[regime[t]]).sum(axis=1)
        eps = variant["sig_d"] * rng.standard_normal((T, n_paths)) - 0.5 * variant["sig_d"] ** 2
        dd = g_b + u + eps + np.where(hit, np.log(F[regime[:-1]]), 0.0)
        pd_path = pd_states[regime[1:]]
        r = dd + np.log((1 + pd_path) / pd_states[regime[:-1]])
    keep = slice(burn, None)
    return dict(rm=np.expm1(r[keep]), rf=np.full((n_years, n_paths), Rf_d - 1), lpd=np.log(pd_path[keep]), dc=dc[keep])
kansen op b = 15/30/45/64%: [0.3888 0.3594 0.1964 0.0555] | discreet exact: R^f = 0.0162, P/D = 19.65
De kansen zijn positief, en de exacte rente van 1,6% en ratio van 19,65 wijken iets af van de benadering in de theorie, omdat hier geen termen wegvallen. De volgende cel draait de vier modellen elk duizend keer en geeft per moment de mediaan, met tussen haken het 2,5e en het 97,5e percentiel.
N_YEARS, N_SAMPLES = 100, 1000
simulated = {
    "Campbell-Cochrane": sample_moments(**cc_simulate(cc_div, N_YEARS, N_SAMPLES)),
    "Bansal-Yaron": sample_moments(**by_simulate(by, N_YEARS, N_SAMPLES)),
    "Barro (iid)": sample_moments(**disaster_simulate(N_YEARS, N_SAMPLES)),
    "Barro-Gabaix (variabel)": sample_moments(**disaster_simulate(N_YEARS, N_SAMPLES, GABAIX)),
}
MOMENTS = list(simulated["Bansal-Yaron"])

def band(values):
    lo, med, hi = np.percentile(values, [2.5, 50, 97.5])
    return f"{med:.3f} [{lo:.3f}, {hi:.3f}]"

sim_table = pd.DataFrame({model: {k: band(v) for k, v in mom.items()} for model, mom in simulated.items()})
sim_tableDe tabel laat vooral voor de gemiddelde premie brede banden zien. De figuur toont zes van deze verdelingen als dozen, en het paneel linksboven, waar de dozen van de premie over elkaar heen liggen, is het belangrijkste.
Source
SHOW = {"E[R^e]": "Gemiddeld overrendement", "sd(R)": "Volatiliteit van het rendement",
        "sd(log P/D)": "Volatiliteit van log P/D", "R2 5 jaar": "$R^2$ vijfjaarsvoorspelling",
        "E[R^f]": "Gemiddelde reële rente", "AC1(dc)": "Autocorrelatie consumptiegroei"}

def plot_bands(data=None):
    """Box plots of simulated 100-year sample moments per model; optional data values as vertical lines."""
    names = list(simulated)
    fig, axes = plt.subplots(2, 3, figsize=(12, 6.5))
    for i, (ax, (key, title)) in enumerate(zip(axes.flat, SHOW.items())):
        ax.boxplot([simulated[name][key] for name in names], whis=(2.5, 97.5), showfliers=False,
                   orientation="horizontal", widths=0.6)
        ax.set_yticks(range(1, len(names) + 1))
        ax.set_yticklabels(names if i % 3 == 0 else [""] * len(names))
        if data is not None:
            ax.axvline(data[key], color=hap.plotting.COLORS[1], lw=1.6, label="VS 1930–2025")
        ax.set_title(title)
        ax.set_xlabel("waarde in een steekproef van 100 jaar")
        ax.set_ylabel("model" if i % 3 == 0 else "")
    if data is not None:
        axes[0, 0].legend(loc="lower right")
    plt.tight_layout()
    plt.show()

plot_bands()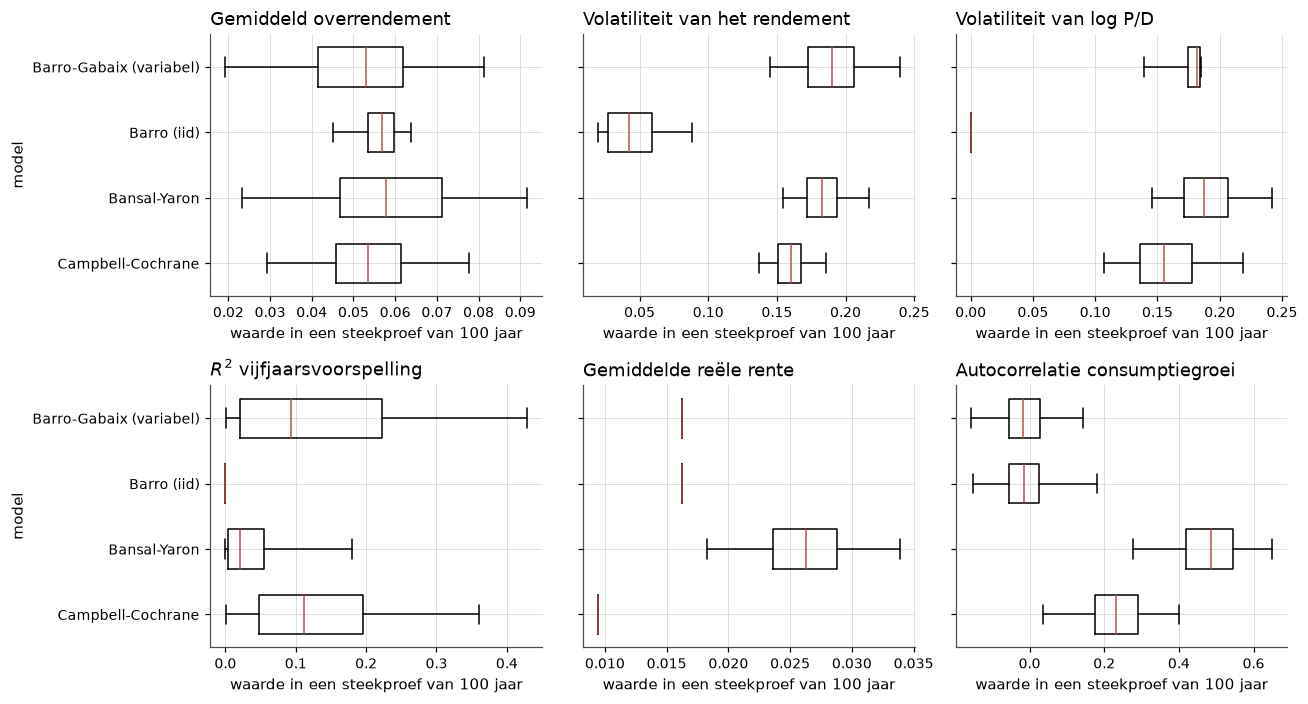
Figure 1:Verdeling van zes momenten over duizend gesimuleerde steekproeven van honderd jaar (doos: 25e–75e percentiel, snorharen: 2,5e–97,5e percentiel). De gemiddelde premie van de vier modellen overlapt breed, en de scheiding zit in momenten die de modellen verschillend voorspellen maar die in de data slecht meetbaar zijn.
Uit tabel en figuur volgen drie conclusies, in volgorde van belang.
De premie scheidt niets. De medianen liggen tussen 5,3 en 5,8%, en de 95%-banden van de drie modellen met een realistische volatiliteit zijn vijf tot zeven procentpunt breed. Alleen Barro met onafhankelijke rampen heeft een smalle band, omdat zijn dividend gelijk is aan consumptie en het rendement daardoor maar rond 4% per jaar schommelt. Bij een rendementsvolatiliteit van 16 tot 19% heeft een honderdjarig gemiddelde een standaardfout van 1,6 tot 1,9 procentpunt, meer dan de verschillen tussen de modellen. Zo ziet de standaardfout van 2% er hier uit.
Tweede momenten scheiden op kenmerken die in de bouw zitten. De rente is constant behalve in Bansal-Yaron. Consumptiegroei is in de maandmodellen autogecorreleerd, ongeveer 0,25 door tijdsaggregatie en 0,5 in Bansal-Yaron, tegen rond nul in de jaarlijkse rampenmodellen. Barro met onafhankelijke rampen heeft een prijs-dividendratio die niet beweegt.
Voorspelbaarheid scheidt zwak. De band van de vijfjaars- begint bij nul en loopt tot 0,18 bij Bansal-Yaron en tot 0,36 en 0,43 bij de andere twee. De medianen verschillen wel, 0,02 tegen 0,11 en 0,09, omdat de ratio in Bansal-Yaron vooral door verwachte dividendgroei beweegt. Toch verwerpt een van 0,1 in honderd jaar data geen van de drie.
6Replicatie op echte data
6.1Campbell-Cochrane en Bansal-Yaron naast hun bronnen
De cel simuleert beide modellen over 2000 jaar maal 50 paden en zet de momenten naast de gepubliceerde waarden.
pop_cc = cc_simulate(cc_cons, 2000, 50)
lex_cc = np.log1p(pop_cc["rm"]) - np.log1p(pop_cc["rf"])
pop_by = by_simulate(by, 2000, 50)
z_month = by["A0m"] + by["A1m"] * 0 + by["A2m"] * BY["sig"] ** 2
sd_z = np.sqrt(by["A1m"] ** 2 * (BY["phi_e"] * BY["sig"]) ** 2 / (1 - BY["rho"] ** 2)
               + by["A2m"] ** 2 * BY["sig_w"] ** 2 / (1 - BY["nu1"] ** 2))

replication = pd.DataFrame(
    {
        "hier": [100 * (pop_cc["rm"] - pop_cc["rf"]).mean(), 100 * (pop_cc["rm"] - pop_cc["rf"]).std(),
                 np.exp(pop_cc["lpd"].mean()), pop_cc["lpd"].std(),
                 100 * np.log1p(pop_by["rm"]).mean(), 100 * np.log1p(pop_by["rm"]).std(),
                 100 * np.log1p(pop_by["rf"]).mean(), 100 * np.log1p(pop_by["rf"]).std(),
                 z_month - np.log(12), sd_z, 100 * pop_by["dc"].std(),
                 sample_moments(**pop_by)["AC1(dc)"].mean()],
        "bron": [3.90, 8.25, 34.52, 0.13, 6.62, 16.88, 2.56, 1.30, 3.00, 0.16, 2.92, 0.51],
    },
    index=pd.MultiIndex.from_tuples(
        [("CC consumptieclaim (Wachter 2005, tabel 2)", m) for m in ("E[R^e] %", "sd(R^e) %", "exp E[p-d]", "sd(p-d)")]
        + [("BY (Beeler-Campbell 2012, tabel II)", m) for m in
           ("E[r] %", "sd(r) %", "E[r^f] %", "sd(r^f) %", "E[p-d]", "sd(p-d), maandratio", "sd(dc) %", "AC1(dc)")]),
)
replication.round(3)Geslaagd. De consumptieclaim van Campbell-Cochrane geeft een premie van 4,20% met een volatiliteit van 8,40%, binnen de verwachte band en dicht bij Wachters fijnste rooster. Dat we drie tiende procentpunt boven dat rooster uitkomen, valt binnen wat een roosterkeuze doet, want oefening 3 laat zien dat de ondergrens van het rooster de premie met meer dan een procentpunt verschuift. Voor Bansal-Yaron liggen de vijf beloofde momenten binnen 0,05 van tabel II. Alleen het gemiddelde log rendement ligt met 6,76% iets boven hun 6,62%, wat we toeschrijven aan het optellen van gelineariseerde maandrendementen.
6.2De Amerikaanse data in de banden
De volgende cel bouwt de reële jaarreeksen en plaatst elk datamoment in de verdeling van elk model, zodat de modelkolommen percentielen zijn.
def fred_annual(code):
    series = hap_data.fred(code)[code]
    series.index = series.index.year
    return series

real_cons = (fred_annual("PCNDA") / fred_annual("DNDGRG3A086NBEA")
             + fred_annual("PCESVA") / fred_annual("DSERRG3A086NBEA")) / fred_annual("B230RC0A052NBEA")
gw = hap_data.goyal_welch("annual")
gw.index = gw.index.year
data_real = pd.DataFrame(
    {
        "rm": (1 + gw["CRSP_SPvw"]) / (1 + gw["infl"]) - 1,
        "rf": (1 + gw["Rfree"]) / (1 + gw["infl"]) - 1,
        "lpd": np.log(gw["Index"] / gw["D12"]),
        "dc": np.log(real_cons).diff(),
    }
).loc[1930:2025].dropna()
data_moments = {k: float(v[0]) for k, v in sample_moments(*(data_real[c].to_numpy()[:, None]
                                                              for c in ("rm", "rf", "lpd", "dc"))).items()}
T_data = len(data_real)
se_premium = (data_real["rm"] - data_real["rf"]).std() / np.sqrt(T_data)
print(f"{data_real.index[0]}-{data_real.index[-1]}, {T_data} jaar; SE van het gemiddelde overrendement = {se_premium:.3f}")

placement = pd.DataFrame(
    {model: {k: np.mean(mom[k] <= data_moments[k]) for k in MOMENTS} for model, mom in simulated.items()}
)
placement.insert(0, "data 1930-2025", pd.Series(data_moments))
placement.round(3)
1930-2025, 96 jaar; SE van het gemiddelde overrendement = 0.020
Het gemiddelde overrendement over 1930–2025 is 8,3% met een standaardfout van 2,0 procentpunt. De figuur legt de datawaarden als verticale lijn over de banden, en het gaat vooral om de panelen van de premie en van de volatiliteit van log P/D.
Source
plot_bands(data_moments)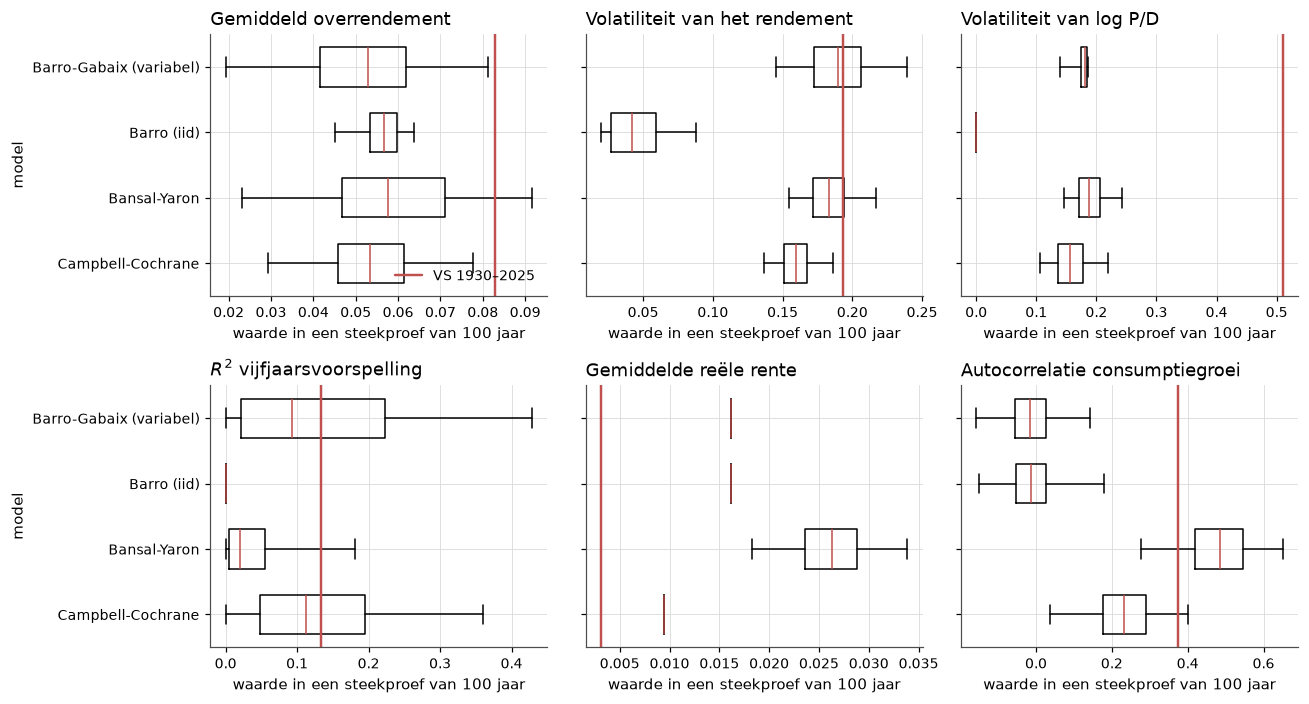
Gedeeltelijk geslaagd. De volatiliteit van de prijs-dividendratio ligt zoals verwacht boven alle banden, maar de premie ligt binnen de band van één model in plaats van drie. Dat de premie maar in één band valt, komt door een hoge Amerikaanse premie en niet door een codefout, want de modellen reproduceren hun bronnen. De percentielen staan in de tabel, en per moment ziet het beeld er zo uit.
Premie. Het gemiddelde overrendement valt binnen de band van Bansal-Yaron en net boven die van Campbell-Cochrane en de Gabaix-variant. Twee standaardfouten rond 8,3% bevatten de mediaan van elk model, zodat de onzekerheid in twee richtingen werkt. Voor Barro is een hoog Amerikaans gemiddelde zelfs een voorspelling, want zonder ramp ligt het gerealiseerde rendement boven de ware premie, in het toy-voorbeeld 5,67 tegen 4,92 procentpunt.
Prijs-dividendratio. De volatiliteit van de log-ratio is in de data 0,51, ver boven de band van elk model, die hoogstens tot 0,24 loopt. De modellen verklaren dus dat de ratio beweegt, maar geen van de drie hoeveel, en oefening 4 laat zien dat dat ook tot 1998 geldt.
Voorspelbaarheid en volatiliteit. De vijfjaars- ligt midden in de banden van Campbell-Cochrane en de Gabaix-variant en aan de bovenkant van die van Bansal-Yaron, en de rendementsvolatiliteit valt binnen de banden van Bansal-Yaron en de Gabaix-variant. Op deze momenten zijn de modellen observationeel equivalent in de zin van Definition 1.
Consumptie. De autocorrelatie van consumptiegroei ligt aan de onderkant van de band van Bansal-Yaron en aan de bovenkant van die van Campbell-Cochrane, zodat beide modellen die waarde toelaten. De jaarlijks gesimuleerde rampenmodellen missen de tijdsaggregatie die al ongeveer 0,25 oplevert, en oefening 4 laat zien hoe sterk dit moment van de steekproef afhangt.
7Wat er brak, en wat daarna kwam
Wat de modellen verklaren. Twintig jaar na Mehra en Prescott lieten drie modellen zien dat een consumptie-SDF een premie van ruim 5% kan dragen. Ze combineerden die met een rendementsvolatiliteit van 16 tot 19%, een lage rente en een prijs-dividendratio die rendementen voorspelt. De puzzel verschoof daarmee van onmogelijk met redelijke voorkeuren naar mogelijk met één extra parameter.
Waar het breekt. Geen van de drie haalt de volatiliteit van de log prijs-dividendratio, die in de data 0,51 is, tegen hoogstens 0,24 in de modellen. Omgekeerd halen ze de momenten die ze wel halen allemaal tegelijk, zodat honderd jaar data ze niet scheiden. De parameters die dat wel zouden doen (, , ) zijn met dezelfde data niet te meten. Zelfs één model is kwetsbaar, want dezelfde kalibratie van Campbell-Cochrane geeft 6,6% of 3,9% premie, afhankelijk van het rooster Wachter (2005).
Risico of vergissing? In de Chicago-lezing zeggen de drie modellen hetzelfde, elk via een ander mechanisme. De premie is dan een beloning voor risico dat een prijs heeft, en wie in een crisis aandelen koopt, verkoopt verzekering aan beleggers die er op dat moment het hardst behoefte aan hebben. In de Yale-lezing voegt een model met een niet te controleren parameter niets toe, want een gedragsmodel met extrapolerende of angstige beleggers verklaart dezelfde feiten. Het deel van de prijsbeweging dat geen van de drie verklaart, is dan de vergissing. De data die de lezingen zouden scheiden, bestaan wel maar zijn schaars: prijzen van verzekering tegen de staart en directe metingen van wat beleggers verwachten.
Wat er daarna kwam. De aandelenpremie is sindsdien een feit met concurrerende theorieën. De volgende stap zocht de scheiding in activa waarvan de looptijd vastligt, in de termijnstructuur van rentes en de risicopremies op obligaties, in Fama-Bliss, Cochrane-Piazzesi en het string-model.
8Oefeningen
Solution to Exercise 1
(1) Nu is , dus . Verder is , wat een prijs-dividendratio van 14,78 geeft, en , zodat de premie procentpunt is.
pd.Series(rietz_toy(0.01)).round(5)m_n 0.87877
m_d 7.48457
1+R^f 1.05839
P/D 14.78318
E[R] 1.08980
premie (%) 3.14067
R zonder ramp 1.09434
dtype: float64(2) Een grotere rampkans verlaagt de rente en verhoogt de premie. Beleggers willen zich sterker verzekeren, zodat ze meer betalen voor de obligatie en een hogere vergoeding vragen voor het aandeel, dat in de ramp instort. Beide getallen reageren dus sterk op een kans die in één land nauwelijks te meten is.
Solution to Exercise 2
(1) Met is , met coëfficiënt . De Euler-vergelijking geeft , dus . De constante in is dan , en werkt uit tot de formule in de tekst. Voor de premie geldt .
(2) en (3)
psi_rows = {}
for psi in (1.25, 1.5, 2.0):
    sol_psi = by_solve({**BY, "psi": psi})
    log_rf_iid, prem_iid = ez_iid(BY["beta"] ** 12, 12 * BY["mu"], np.sqrt(12) * BY["sig"], BY["gamma"], psi)
    psi_rows[psi] = {
        "iid: log(1+R^f)": log_rf_iid,
        "iid: log premie": prem_iid,
        "BY: A_1,m": sol_psi["A1m"],
        "BY: premie via x_t (%/jaar)": 1200 * sol_psi["lam_e"] * sol_psi["k1m"] * sol_psi["A1m"] * BY["phi_e"] * BY["sig"] ** 2,
    }
pd.DataFrame(psi_rows).T.rename_axis("psi").round(4)Bij onafhankelijke groei verschuift alleen de rente, en de premie is voor elke gelijk aan . In Bansal-Yaron bepaalt via hoe sterk de prijs op nieuws over reageert. Via en bepaalt hoe zwaar dat nieuws in de SDF weegt, zodat een hogere EIS beide vergroot. De ontkoppeling van Epstein en Zin lost dus de rentepuzzel op, maar de premie komt pas als de toekomst voorspelbaar is, en daarmee hangt het model af van .
Solution to Exercise 3
De cel lost de consumptieclaim op vier roosters op en zet Wachters twee roosters eronder.
grid_variants = {
    "tot s-bar - 8": dict(lower=8.0),
    "tot s-bar - 20": dict(lower=20.0),
    "tot s-bar - 80 (hoofdtekst)": dict(lower=80.0),
    "grof: 30 punten tot s-bar - 8": dict(lower=8.0, n_low=10, n_high=20),
}
grid_rows = {}
for label, kw in grid_variants.items():
    sim = cc_simulate(cc_solve(**{**CC, "sig_w": 0.0, "rho_w": 0.0}, **kw), 2000, 50)
    excess = sim["rm"] - sim["rf"]
    grid_rows[label] = {"E[R^e] %": 100 * excess.mean(), "sd(R^e) %": 100 * excess.std(),
                        "exp E[p-d]": np.exp(sim["lpd"].mean()), "sd(p-d)": sim["lpd"].std()}
grid_rows["Wachter (2005), fijnste rooster"] = {"E[R^e] %": 3.90, "sd(R^e) %": 8.25, "exp E[p-d]": 34.52, "sd(p-d)": 0.13}
grid_rows["Wachter (2005), grofste rooster"] = {"E[R^e] %": 6.59, "sd(R^e) %": 15.05, "exp E[p-d]": 18.62, "sd(p-d)": 0.27}
pd.DataFrame(grid_rows).T.round(3)Hoe verder het rooster naar lage waarden van het surplus doorloopt, hoe hoger de premie (2,8%, 3,6% en 4,2%) en de volatiliteit. Een rooster dat afkapt, knipt juist de slechtste toestanden weg die in dit model de premie dragen. Het aantal punten doet er minder toe dan de ondergrens. Wachters grofste rooster gaf met 6,6% zelfs een hogere premie, wat erop wijst dat haar roosters de staart anders behandelden dan de onze. Als de premie uit zeldzame, extreme toestanden komt, is ook de numerieke oplossing een parameter die niemand in de data kan controleren.
Solution to Exercise 4
De functie herhaalt de plaatsing voor een deelsteekproef, met simulaties van dezelfde lengte.
def placement_for(first, last, n_samples=300):
    """Data moments for first..last and their percentile in simulations of the same length."""
    sub = data_real.loc[first:last]
    T = len(sub)
    data_m = {k: float(v[0]) for k, v in sample_moments(*(sub[c].to_numpy()[:, None]
                                                         for c in ("rm", "rf", "lpd", "dc"))).items()}
    sims = {"Campbell-Cochrane": sample_moments(**cc_simulate(cc_div, T, n_samples)),
            "Bansal-Yaron": sample_moments(**by_simulate(by, T, n_samples)),
            "Barro-Gabaix (variabel)": sample_moments(**disaster_simulate(T, n_samples, GABAIX))}
    keys = ["E[R^e]", "sd(log P/D)", "R2 5 jaar", "AC1(dc)"]
    rows = {"data": {k: data_m[k] for k in keys}}
    rows.update({name: {k: np.mean(mom[k] <= data_m[k]) for k in keys} for name, mom in sims.items()})
    return pd.DataFrame(rows)

pd.concat({"1947-2025": placement_for(1947, 2025), "1930-1998": placement_for(1930, 1998)},
names=["steekproef", "moment"]).round(3)De volatiliteit van log PD ligt in beide steekproeven boven alle banden (0,47 en 0,37). De premie ligt naoorlogs alleen binnen de band van Bansal-Yaron, terwijl ze tot 1998 ook net binnen die van de Gabaix-variant valt.
De consumptieconclusie draait wel om. Naoorlogs is de autocorrelatie van consumptiegroei 0,17, op het 0,3e percentiel van Bansal-Yaron, zodat het model op deze steekproef wordt verworpen. Tot 1998 is ze 0,49, op de mediaan van Bansal-Yaron en boven de band van Campbell-Cochrane. Het moment dat de modellen het scherpst scheidt, hangt dus af van een handvol jaren uit de Depressie, zoals Beeler en Campbell al zagen. Daarom blijven de modellen op de volledige steekproef observationeel equivalent.
- Wachter, J. A. (2005). Solving Models with External Habit. Finance Research Letters, 2(4), 210–226. 10.1016/j.frl.2005.08.001
- Beeler, J., & Campbell, J. Y. (2012). The Long-Run Risks Model and Aggregate Asset Prices: An Empirical Assessment. Critical Finance Review, 1(1), 141–182. 10.1561/104.00000004
- Barro, R. J. (2009). Rare Disasters, Asset Prices, and Welfare Costs. American Economic Review, 99(1), 243–264. 10.1257/aer.99.1.243
- Campbell, J. Y., & Cochrane, J. H. (1999). By Force of Habit: A Consumption-Based Explanation of Aggregate Stock Market Behavior. Journal of Political Economy, 107(2), 205–251. 10.1086/250059
- Bansal, R., & Yaron, A. (2004). Risks for the Long Run: A Potential Resolution of Asset Pricing Puzzles. Journal of Finance, 59(4), 1481–1509. 10.1111/j.1540-6261.2004.00670.x
- Epstein, L. G., & Zin, S. E. (1989). Substitution, Risk Aversion, and the Temporal Behavior of Consumption and Asset Returns: A Theoretical Framework. Econometrica, 57(4), 937–969. 10.2307/1913778
- Barro, R. J. (2006). Rare Disasters and Asset Markets in the Twentieth Century. Quarterly Journal of Economics, 121(3), 823–866. 10.1162/qjec.121.3.823
- Rietz, T. A. (1988). The Equity Risk Premium: A Solution. Journal of Monetary Economics, 22(1), 117–131. 10.1016/0304-3932(88)90172-9
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Chen, H., Dou, W. W., & Kogan, L. (2024). Measuring “Dark Matter” in Asset Pricing Models. Journal of Finance, 79(2), 843–902. 10.1111/jofi.13317
- Weil, P. (1989). The Equity Premium Puzzle and the Risk-Free Rate Puzzle. Journal of Monetary Economics, 24(3), 401–421. 10.1016/0304-3932(89)90028-7
- Gabaix, X. (2012). Variable Rare Disasters: An Exactly Solved Framework for Ten Puzzles in Macro-Finance. Quarterly Journal of Economics, 127(2), 645–700. 10.1093/qje/qjs001
- Wachter, J. A. (2013). Can Time-Varying Risk of Rare Disasters Explain Aggregate Stock Market Volatility? Journal of Finance, 68(3), 987–1035. 10.1111/jofi.12018
- Santa-Clara, P., & Yan, S. (2010). Crashes, Volatility, and the Equity Premium: Lessons from S&P 500 Options. The Review of Economics and Statistics, 92(2), 435–451. 10.1162/rest.2010.11549
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD