

Het CAPM
1Overzicht
Welk verwacht rendement hoort bij welk aandeel, als alle beleggers dezelfde tangentportefeuille houden? Omdat alle beleggers samen de hele markt bezitten, is die portefeuille de markt, en dan is het verwachte overrendement (het rendement boven de risicovrije rente) van elk aandeel evenredig met één getal, zijn bèta met de markt. In dit college:
leiden we die lineaire relatie, de security market line (SML), af uit marktclearing en de efficiënte grens van Markowitz;
laten we zien hoe het CAPM getoetst wordt, met een tijdreeksregressie per portefeuille en met de maandelijkse cross-sectie van Fama en MacBeth;
simuleren we wat die toetsen vinden in een wereld waar het CAPM exact geldt, met geschatte in plaats van ware bèta’s;
repliceren we het centrale feit van het tijdvak, een SML die vlakker is dan voorspeld, in de stijl van Black, Jensen en Scholes en van Fama en MacBeth.
Tussen 1961 en 1966 schreven vier mensen los van elkaar hetzelfde model op: Jack Treynor Treynor (1961)Treynor (2012), William Sharpe Sharpe (1964), John Lintner Lintner (1965) en Jan Mossin Mossin (1966). Het Capital Asset Pricing Model is de eerste evenwichtstheorie van verwachte rendementen in deze reeks, een theorie die niet zegt wat een belegger moet doen, maar welk rendement de markt aan elk activum geeft. In de vraag die de hele reeks doorloopt, theorie of feit, staat het CAPM aan de kant van de theorie, want eerst kwam het model en pas daarna de toets. Die toetsen kwamen snel Jensen (1968)Black et al. (1972)Fama & MacBeth (1973), en daarmee ook de eerste zwakke plek, want de lijn bleek te vlak.
2Intuïtie: waarom zou dit waar zijn?
Markowitz en Tobin lieten zien dat een belegger die alleen om verwachting en risico geeft, zijn risicovolle geld in één mandje stopt. De voorzichtige belegger houdt er weinig van en leent de rest uit, terwijl de agressieve belegger bijleent en er meer dan zijn vermogen van houdt. Het mandje zelf is voor beiden hetzelfde.
Het CAPM voegt daar één stap aan toe, en die stap is niet meer dan boekhouding. Als iedereen hetzelfde mandje houdt, houden alle beleggers samen ook dat mandje, en omdat alle beleggers samen alles houden wat er te koop is, moet het mandje de samenstelling van de hele markt hebben. Wil iedereen meer van een aandeel dan er bestaat, dan stijgt zijn prijs en daalt zijn verwachte rendement, tot de vraag weer gelijk is aan het aanbod.
In het optimale mandje levert elk aandeel per eenheid toegevoegd risico hetzelfde extra rendement op, want anders zou de belegger er meer of minder van kopen. Het risico dat een aandeel toevoegt, hangt af van hoe sterk het meebeweegt met het mandje, en dat mandje is de markt. Die meebeweging, geschaald zodat de markt zelf op één uitkomt, heet de bèta.
Wat verwachten we dus? Een aandeel met een hogere bèta heeft een hoger verwacht rendement, en de relatie is een rechte lijn door de risicovrije rente en door de markt bij bèta één. Bedrijfsspecifiek risico levert niets op, hoe groot het ook is, want wie het draagt, had het gratis kunnen wegdiversifiëren. Ten slotte is er één prijs van risico voor alle aandelen, de marktpremie.
3Toy-voorbeeld: drie activa, twee beleggers
We nemen de drie activa uit het toy-voorbeeld van Markowitz, Roy en Tobin, aandelen, kleine aandelen en obligaties, hier kort A, B en C, maar we draaien de redenering om. Daar waren de verwachte rendementen gegeven en zochten we de beste portefeuille, terwijl hier het aanbod en de beleggers gegeven zijn en we de verwachte rendementen zoeken waarbij vraag en aanbod gelijk zijn. De eerste cel laadt de pakketten die we in het hele college gebruiken.
from dataclasses import dataclass

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import statsmodels.api as sm
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. De risicovrije rente is en het risicovrije activum is in nul netto aanbod, want wat de een uitleent, leent de ander. De covariantie tussen A en B is 0,02, en C is met beide ongecorreleerd.
| Activum | marktwaarde | marktgewicht | |
|---|---|---|---|
| A (aandelen) | 300 | 1/3 | 20% |
| B (kleine aandelen) | 200 | 2/9 | 30% |
| C (obligaties) | 400 | 4/9 | 10% |
| Belegger | vermogen | risicoaversie |
|---|---|---|
| 1 (agressief) | 150 | 2 |
| 2 (voorzichtig) | 750 | 6 |
Het recept. Een mean-variance-belegger met risicoaversie stopt de fracties van zijn vermogen in de drie activa. Hier is de vector van verwachte overrendementen en de covariantiematrix. Een hogere betekent een kleinere risicovolle positie, want bij houdt de belegger de helft van , bij 6 een zesde. We schrijven en niet , omdat en hierna de coëfficiënten van Fama en MacBeth zijn. De theorie leidt dit recept als eerste af.
Stap 1: marktclearing. De vraag in geld is . Die moet gelijk zijn aan het aanbod , dus .
Stap 2: de premies. Vermenigvuldigen we de matrix met de marktgewichten, dan krijgen we , dus . Met de risicovrije rente erbij zijn dat de rendementen van 10%, 14% en 4% die Markowitz, Roy en Tobin als gegeven aannam.
Stap 3: wie houdt wat. Het recept vraagt om , de vector met . De rij van C geeft , en de rijen van A en B, en , geven en . Belegger 1 houdt daarvan, de fracties . Samen is dat 2,25 maal zijn vermogen, of , zodat hij moet lenen. Belegger 2 houdt een zesde maal 750, , en leent 187,5 uit. Opgeteld houden ze , precies de markt.
Stap 4: bèta’s. De marktvariantie is , dus de marktpremie is . De bèta’s zijn , en , en bèta maal 6,22% geeft precies 8%, 12% en 2%.
Stap 5: wat niet beloond wordt. Van de variantie van C is maar systematisch, en de rest, 86%, is eigen risico. Toch ligt C precies op de lijn, net als A en B, al is de Sharpe-ratio van C met 0,20 maar half zo hoog als die van A en B (0,40).
De volgende cel herhaalt de vijf stappen in Python, met de getallen van hierboven in een eigen kolom.
Sigma = np.array([[0.04, 0.02, 0.00],
                  [0.02, 0.09, 0.00],
                  [0.00, 0.00, 0.01]])
supply = np.array([300.0, 200.0, 400.0])
wealth = np.array([150.0, 750.0])
theta = np.array([2.0, 6.0])

w_m = supply / supply.sum()
theta_m = supply.sum() / (wealth / theta).sum()      # aggregate risk aversion
mu_e = theta_m * Sigma @ w_m                          # market clearing
fractions = np.outer(1 / theta, np.linalg.solve(Sigma, mu_e))
lending = wealth - (fractions * wealth[:, None]).sum(axis=1)
var_m = w_m @ Sigma @ w_m
beta = Sigma @ w_m / var_m
idio_share_C = 1 - beta[2] ** 2 * var_m / Sigma[2, 2]

hand = [4.5, 0.08, 0.12, 0.02, -187.5, 0.013827, 0.062222, 9 / 7, 27 / 14, 9 / 28, 0.857143]
code = [theta_m, *mu_e, lending[0], var_m, w_m @ mu_e, *beta, idio_share_C]
pd.DataFrame(
    {"met de hand": hand, "code": code},
    index=["theta_m", "premie A", "premie B", "premie C", "risicovrij belegger 1",
           "marktvariantie", "marktpremie", "bèta A", "bèta B", "bèta C",
           "eigen risico C (aandeel)"],
).round(6)De twee kolommen zijn gelijk, ook in de rij voor belegger 1, waar het minteken betekent dat hij 187,5 leent. Beide beleggers houden dus de markt en verschillen alleen in de omvang van hun positie, en de verwachte rendementen waarbij vraag en aanbod gelijk zijn, liggen precies op een lijn in bèta.
4Theorie
We leiden eerst de vraag van één belegger af, het recept uit het toy-voorbeeld. Daaruit volgt dat de markt in evenwicht de tangentportefeuille is, en dus de security market line (2), de kern van het college. Daarna lezen we die lijn als een uitspraak over de efficiëntie van de markt en kijken we wat er overblijft zonder vrij lenen. Ten slotte bespreken we de twee toetsen en de valkuil die bij allebei speelt, namelijk dat de bèta geschat is en niet bekend.
4.1Opzet en aannames
Er is één periode, van naar . Er zijn risicovolle activa met netto rendementen en een risicovrije rente (2% is 0,02), zoals in Opzet, data en conventies; de overrendementen zijn . Het subscript staat hier voor de marktportefeuille, niet voor de SDF.
De verwachte overrendementen zijn , in het toy-voorbeeld 2% tot 12% per jaar, en de covariantiematrix is positief definiet. Het aanbod ligt vast, met marktgewichten , en het risicovrije activum is in nul netto aanbod. Belegger heeft vermogen , en het totale vermogen is . We veronderstellen vier dingen:
Mean-variance. Elke belegger geeft alleen om de verwachting en de variantie van zijn vermogen op .
Homogene verwachtingen. Alle beleggers kennen dezelfde en .
Vrij lenen en uitlenen tegen , zonder limiet.
Geen frictie. Er zijn geen belastingen, kosten of short-restricties, en beleggers zijn prijsnemers.
4.2Het kernresultaat: de markt is de tangentportefeuille
Elke belegger koopt een aandeel tot het laatste beetje evenveel extra rendement per extra risico oplevert, en met dezelfde verwachtingen komt iedereen op dezelfde mix uit. Wil iedereen samen meer van een aandeel dan er is, dan stijgt de prijs en daalt het verwachte rendement tot vraag en aanbod weer gelijk zijn. Een aandeel dat sterk met de markt meebeweegt, voegt veel risico toe aan wat iedereen al heeft, en moet daarom meer opleveren.
We beginnen met de vraag van één belegger. Met fracties in de risicovolle activa maximeert belegger volgens aanname 1 de verwachting min een straf op variantie, . Het restant belegt of leent hij tegen (aanname 3). De eerste-ordevoorwaarde geeft
Elke belegger houdt dus dezelfde mix , en alleen de schaal hangt af van zijn risicoaversie. Dat is de separatiestelling uit Markowitz, Roy en Tobin: iedereen houdt de tangentportefeuille en leent daarnaast geld of zet het uit tegen de risicovrije rente. In het toy-voorbeeld is de schaal 1/2 voor belegger 1 en 1/6 voor belegger 2.
Het verwachte overrendement van een activum is dus zijn bèta maal de marktpremie , en verder niets. De verwachting uit de intuïtie komt uit, want de lijn is recht, gaat door de risicovrije rente, en eigen risico telt niet mee. Het bewijs berust op twee stappen. Marktclearing maakt de markt gelijk aan de tangentportefeuille, en de eerste-ordevoorwaarde van die portefeuille zegt dat evenredig is met .
Proof 1
Stap 1: iedereen houdt dezelfde tangentportefeuille. Volgens de separatiestelling (Corollary 1) houdt belegger een fractie van zijn vermogen in ((13)) en de rest risicovrij (aanname 3). Die is voor iedereen gelijk, omdat iedereen dezelfde en ziet (aanname 2).
Stap 2: marktclearing maakt de markt tot de tangentportefeuille. De vraag in geld is , het aanbod is . Gelijkstellen geeft . Beide vectoren tellen op tot één, dus .
Stap 3: de covarianties zijn evenredig met de premies. Uit de vorm van volgt met . De -de rij van is , dus voor elke .
Stap 4: de constante vastleggen. Als we links met vermenigvuldigen, krijgen we . Invullen in stap 3 geeft .
De marktpremie zelf is geen vrije parameter. Als we de vraag (1) over beleggers optellen en gelijkstellen aan het aanbod, krijgen we , met
De marktpremie is dus de geaggregeerde risicoaversie maal de hoeveelheid risico in de markt, waarbij het vermogensgewogen harmonische gemiddelde van de individuele is (het omgekeerde van het gemiddelde van de omgekeerden). In het toy-voorbeeld is en de premie . Met de kalibratie van de simulatie hierna, een premie van 0,6% en een volatiliteit van 4,5% per maand (15,6% per jaar), is .
Worden beleggers risicoaverser, dan stijgt . Ze willen dan tegen de oude prijzen minder aandelen, zodat de prijzen dalen en de premie stijgt. Wordt de markt riskanter bij gelijke , dan stijgt de premie ook, en omgekeerd daalt de premie als een van beide daalt.
4.3Wat het voorspelt: de markt ligt op de efficiënte grens
Als de SML geldt, kan geen belegger de index nog verbeteren. Een belegger die de index houdt en er een klein beetje bij koopt van een aandeel boven de lijn, ziet zijn Sharpe-ratio stijgen. Ligt elk aandeel op de lijn, dan lukt dat met geen enkel aandeel, en is de index al de beste mix van risico en rendement. De SML toetsen komt dus neer op toetsen of de index die beste mix is.
Een toets van (2) is dus een toets van één uitspraak, namelijk dat de marktportefeuille mean-variance-efficiënt is. In de theorie is de markt alles wat risicovol is, inclusief vastgoed en menselijk kapitaal, maar in de toetsen is ze een aandelenindex. Wat dat voor de toetsbaarheid betekent, bespreken we in Roll: de kritiek en de R², en hier nemen we de index als de markt.
4.4Zonder vrij lenen: het zero-beta-CAPM
Aanname 3 is de zwakste, want bijna niemand leent onbeperkt tegen de schatkistrente. Een belegger die meer risico wil dan de markt, koopt dan geen markt met geleend geld, maar aandelen met een hoge bèta. Die vraag drijft hun prijzen op en hun verwachte rendement omlaag, zodat de SML vlakker wordt en het intercept boven de risicovrije rente komt te liggen. Black Black (1972) werkte deze redenering exact uit en liet zien dat ze zelfs zonder risicovrij activum opgaat.
Het resultaat is dezelfde rechte lijn in bèta, maar met het verwachte rendement van de zero-beta-portefeuille als intercept in plaats van . Het bewijs steunt erop dat een gemiddelde van grensportefeuilles zelf op de efficiënte grens ligt. Bovendien geeft elke portefeuille op de minimum-variantierand, ook onder de minimum-variantieportefeuille, een lineair verband tussen covariantie en verwacht rendement.
Proof 3
Stap 1: de markt ligt op de efficiënte grens. De markt is het vermogensgewogen gemiddelde van grensportefeuilles. Volgens de twee-fondsenstelling (Theorem 1) ligt ook zo’n combinatie op de minimum-variantierand. Omdat de gewichten positief zijn, is haar verwachte rendement een gemiddelde van rendementen boven dat van de minimum-variantieportefeuille, zodat ze op de efficiënte grens ligt.
Stap 2: covariantie is lineair in verwacht rendement. Omdat op de efficiënte grens ligt, voldoet ze aan de eerste-ordevoorwaarde van de minimum-variantierand, (6): . Hier is de vector verwachte rendementen, en zijn en de schaduwprijzen van de rendements- en de budgeteis (niet de prijs van risico). Voor elke portefeuille geldt dus . Omdat niet de minimum-variantieportefeuille is, is .
Stap 3: de zero-beta-portefeuille bestaat. Kies op de minimum-variantierand de portefeuille met . Dan is , en zo’n bestaat omdat de minimum-variantierand elk verwacht rendement haalt. Omdat de markt op het doelmatige deel ligt, heeft een lager verwacht rendement dan de minimum-variantieportefeuille en ligt ze op het ondoelmatige deel.
Stap 4: de lijn. Aftrekken geeft , en voor is . Delen geeft , wat (4) is.
Hoe verhoudt zich tot ? Stel dat iedereen tegen kan uitlenen, maar alleen duurder kan lenen. Dan ligt tussen de uitleen- en de leenrente Black (1972), dus boven . In de regressie (7) hierna betekent dat een intercept en een helling . Hoe strenger de leenbeperking, hoe hoger het intercept en hoe vlakker de lijn. Kan iedereen vrij lenen tegen , dan is de markt de tangentportefeuille, en in ex-markowitz-1 bleek dat de zero-beta-portefeuille daarvan precies de risicovrije rente oplevert. Voor Black, Jensen en Scholes was een te vlakke lijn daarom geen verwerping van het CAPM, maar een schatting van .
4.5Hoe het getoetst wordt: de tijdreeks en GRS
De eerste toets vraagt of er na de beloning voor bèta nog iets te verdienen overblijft. Een onderzoeker regresseert daarvoor het overrendement van een fonds op dat van de markt, zodat de helling de bèta schat en het intercept meet wat het fonds verdient bovenop de beloning voor zijn bèta. Volgens het CAPM is dat intercept nul, en een positief intercept wijst dan op vakmanschap of op een fout in de theorie.
Het overrendement van activum bestaat dus uit een vast deel , bèta maal het overrendement van de markt, en ruis die niet met de markt meebeweegt. Als we verwachtingen nemen, krijgen we , zodat het CAPM equivalent is met . Jensens alpha is de verticale afstand tot de SML. De regressie is het marktmodel uit De event study, hier in overrendementen, en het CAPM voegt daar één restrictie op het intercept aan toe, die in de ruwe rendementen van het marktmodel luidt. Jensen, wiens regressie Fama en de efficiënte markt al op hedendaagse fondsen toepaste, paste de toets toe op 115 beleggingsfondsen en vond een gemiddelde alpha van −1,1% per jaar na kosten Jensen (1968).
Voor portefeuilles tegelijk is het niet genoeg om losse -waarden te bekijken, want hun residuen zijn sterk gecorreleerd, en daarom gaven Gibbons et al. (1989) een gezamenlijke toets.
GRS meet dus hoeveel de beste portefeuille van de testactiva de Sharpe-ratio van de markt verslaat, geschaald met de ruis. In een lange reeks volstaat een -toets op alle alpha’s samen, maar de -verdeling geeft de grens die bij normale residuen ook in een korte reeks precies klopt. Bij 25 portefeuilles en ruim 750 maanden ligt de 5%-grens bij 1,52, terwijl de replicatie 4,20 vindt. Een verwerping betekent niet dat bèta er niet toe doet, maar dat een combinatie van deze activa de markt verslaat, zodat de markt niet op hun efficiënte grens ligt (Proposition 1). Het bewijs kiest een basis waarin markt en residuen ongecorreleerd zijn, zodat de gekwadrateerde Sharpe-ratio’s optellen.
Proof 4
We bewijzen de tweede gelijkheid. Voor de -verdeling verwijzen we naar Gibbons et al. (1989).
Stap 1: een andere basis verandert de efficiënte grens niet. Vervang elk door . Omdat dat een inverteerbare lineaire transformatie van is, blijft de verzameling haalbare portefeuilles gelijk, en daarmee ook de maximale Sharpe-ratio.
Stap 2: in de nieuwe basis is de covariantie blokdiagonaal. In de steekproef heeft gemiddelde en is het door OLS ongecorreleerd met . De covariantiematrix van is .
Stap 3: de kwadraten tellen op. De maximale gekwadrateerde Sharpe-ratio is ((13)). Met een blokdiagonale valt die uiteen in .
4.6Hoe het getoetst wordt: Fama en MacBeth
De tijdreekstoets kijkt naar intercepten en niet naar de beloning per eenheid bèta, en daarom regresseerden Fama en MacBeth elke maand de rendementen van alle portefeuilles op hun bèta. De helling van die maand is de beloning voor bèta in die maand, het gemiddelde over de maanden schat de premie, en de spreiding over de maanden geeft de standaardfout.
Eerst schatten we de bèta’s met (5). Dan draaien we voor elke maand de cross-sectionele regressie
Binnen één maand verklaren we zo de verschillen in rendement tussen activa met hun bèta, en is wat een eenheid bèta die maand opleverde. De schatters zijn de gemiddelden over maanden, met de gewone standaardfout van een gemiddelde:
Het CAPM voorspelt en . Fama en MacBeth gebruikten rendementen in plaats van overrendementen en toetsten daarom .
Waarom klopt die standaardfout, terwijl aandelen in dezelfde maand sterk samenbewegen? Ze klopt omdat een gewogen som is van de rendementen van maand . De gewichten, de tweede rij van met , tellen op tot nul en geven een bèta van één. is dus het rendement van een portefeuille met bèta één en kosten nul. De correlatie tussen aandelen zit automatisch in de maandelijkse spreiding van dat rendement.
Hoe groot is die standaardfout? Omdat die portefeuille bèta één heeft, is ze minstens zo onzeker als het gemiddelde marktrendement zelf. Met een marktvolatiliteit van 4,5% per maand en 480 maanden is dat per maand, 2,5% per jaar. Dat geschat is, maakt de variantie van die schatting maar te klein Shanken (1992), waarbij de maandelijkse Sharpe-ratio van de markt is. Fama en MacBeth voegden ook en de residuele volatiliteit toe als regressoren, en volgens het CAPM verklaren die geen van beide iets.
4.7Geschatte bèta’s: waarom de lijn te vlak lijkt
Een onderzoeker die gemiddelde rendementen op geschatte bèta’s regresseert, vindt ook bij een geldig CAPM een te vlakke lijn. Een geschatte bèta is de ware bèta plus ruis, en omdat ruis geen rendement verklaart, daalt de helling in de richting van nul. Omdat de lijn door het gemiddelde punt blijft gaan, stijgt het intercept. Een te vlakke lijn met een te hoog intercept kan dus uit de econometrie komen in plaats van uit de economie.
De factor is het deel van de spreiding in geschatte bèta’s dat echt is. De helling krimpt met die factor, en wat de helling verliest, komt bij het intercept terug. Een OLS-bèta uit maanden heeft meetfoutvariantie , met de idiosyncratische volatiliteit. Met 10% idiosyncratische en 4,5% marktvolatiliteit per maand en 60 maanden is .
Bij een spreiding in ware bèta’s van 0,30 is dan , zodat de helling ongeveer halveert. Met en een premie van 0,6% per maand staat het intercept 0,29% per maand te hoog, 3,4% per jaar, terwijl er aan het CAPM niets mis is. Miller en Scholes lieten zien Miller & Scholes (1972) dat de eerste toetsen op individuele aandelen zo’n te vlakke lijn met een te hoog intercept konden voortbrengen.
De remedie is groeperen, en daarom werken empirische toetsen van prijsmodellen nog altijd met portefeuilles. In een portefeuille van aandelen heeft de meetfout variantie ongeveer , omdat de eigen schokken wegdiversifiëren. Bij is . Maar willekeurig groeperen gooit ook de spreiding in ware bèta’s weg. Black, Jensen en Scholes sorteerden daarom op geschatte bèta, zodat de portefeuilles veel verschillen in ware bèta en weinig in ruis.
Er blijft één valkuil over. Wie sorteert op bèta’s uit dezelfde periode als de toets, zet aandelen met toevallig een grote in de hoogste groep. Daarom sorteerden BJS op bèta’s uit de voorgaande vijf jaar, de pre-ranking bèta’s (bèta’s van vóór de indeling). Fama en MacBeth scheidden drie vensters: portefeuilles vormen op zeven jaar, bèta’s schatten op de vijf jaar daarna, toetsen op de vier jaar daarna.
5Simulatie: Fama-MacBeth in een wereld waar het CAPM exact geldt
Als het CAPM exact geldt en alleen de bèta’s geschat zijn, vindt Fama-MacBeth op aandelen een te vlakke lijn en op portefeuilles een zuivere maar brede schatting. We bouwen zo’n wereld, net als het toy-voorbeeld maar met duizend aandelen, en toetsen alsof we de waarheid niet kennen. De marktpremie van 0,6% per maand is 7,2% per jaar, iets boven de 6,22% van het toy-voorbeeld. Omdat het rendement is, geldt en is de marktpremie.
| parameter | waarde |
|---|---|
| aandelen; portefeuilles | 1000; 20 van 50 aandelen |
| ware bèta’s | normaal, gemiddelde 1, standaarddeviatie 0,30 |
| overrendement van de markt per maand | gemiddelde 0,6%, standaarddeviatie 4,5% |
| idiosyncratische volatiliteit per maand | 10% |
| vensters (maanden) | 60 sorteren, 60 bèta’s schatten, 480 toetsen |
De eerste cel legt de wereld vast en definieert de twee stappen van Fama-MacBeth, waarvan de tweede een lus over de maanden is, zoals in (7).
@dataclass
class CapmWorld:
    n_stocks: int = 1000
    n_port: int = 20
    T_form: int = 60
    T_est: int = 60
    T_test: int = 480
    mu_m: float = 0.006
    sd_m: float = 0.045
    sd_eps: float = 0.10
    sd_beta: float = 0.30


world = CapmWorld()
beta_true = 1.0 + world.sd_beta * rng.standard_normal(world.n_stocks)


def ts_betas(R, f):
    """Stage 1: OLS slope of every column of R on the single factor f."""
    f_dev = f - f.mean()
    return f_dev @ (R - R.mean(axis=0)) / (f_dev @ f_dev)


def fama_macbeth_gammas(R, betas):
    """Stage 2: one cross-sectional OLS of R_t on [1, beta] per month; returns T x 2."""
    X = np.column_stack([np.ones(len(betas)), betas])
    weights = np.linalg.solve(X.T @ X, X.T)     # row j: portfolio weights behind gamma_j
    gammas = np.empty((len(R), 2))
    for t in range(len(R)):
        gammas[t] = weights @ R[t]
    return gammas
Nu de procedure vastligt, trekt de volgende cel één steekproef, sorteert ze op de pre-ranking bèta en draait ze Fama-MacBeth op aandelen en op portefeuilles.
def one_capm_sample(world, beta_true):
    """Simulate one CAPM world and run Fama-MacBeth on stocks and on beta-sorted portfolios."""
    T = world.T_form + world.T_est + world.T_test
    f = world.mu_m + world.sd_m * rng.standard_normal(T)
    R = np.outer(f, beta_true) + world.sd_eps * rng.standard_normal((T, world.n_stocks))
    form = slice(0, world.T_form)
    est = slice(world.T_form, world.T_form + world.T_est)
    test = slice(world.T_form + world.T_est, T)

    groups = np.array_split(np.argsort(ts_betas(R[form], f[form])), world.n_port)
    P = np.column_stack([R[:, g].mean(axis=1) for g in groups])   # lowest beta first

    b_stock, b_port = ts_betas(R[est], f[est]), ts_betas(P[est], f[est])
    g_stock = fama_macbeth_gammas(R[test], b_stock)
    g_port = fama_macbeth_gammas(P[test], b_port)
    estimates = {
        "g0 aandelen": g_stock[:, 0].mean(), "g1 aandelen": g_stock[:, 1].mean(),
        "g0 portefeuilles": g_port[:, 0].mean(), "g1 portefeuilles": g_port[:, 1].mean(),
        "se FM": g_port[:, 1].std(ddof=1) / np.sqrt(world.T_test),
        "sd ware bèta portefeuilles": np.std([beta_true[g].mean() for g in groups]),
    }
    return estimates, (R[test].mean(axis=0), b_stock, P[test].mean(axis=0), b_port)


example = one_capm_sample(world, beta_true)[1]
sims = pd.DataFrame([one_capm_sample(world, beta_true)[0] for _ in range(300)])
Met één voorbeeldsteekproef en 300 herhalingen zetten we in de eerste tabel de gemiddelde schattingen naast de waarheid en naast de voorspelling van (9), in procenten per maand.
sigma_u2 = world.sd_eps**2 / (world.T_est * world.sd_m**2)
kappa_stock = beta_true.var() / (beta_true.var() + sigma_u2)
columns = ["g0 aandelen", "g1 aandelen", "g0 portefeuilles", "g1 portefeuilles"]
summary = pd.DataFrame(
    {
        "waarheid": [0.0, world.mu_m, 0.0, world.mu_m],
        "gemiddelde schatting": sims[columns].mean().to_numpy(),
        "sd over steekproeven": sims[columns].std().to_numpy(),
        "theorie (attenuatie)": [(1 - kappa_stock) * world.mu_m * beta_true.mean(),
                                 kappa_stock * world.mu_m, np.nan, np.nan],
    },
    index=["γ0, aandelen", "γ1, aandelen", "γ0, portefeuilles", "γ1, portefeuilles"],
)
(100 * summary).round(3)Op aandelen is de lijn te vlak en te hoog, zoals (9) voorspelde, met een helling van 0,32% in plaats van 0,6% en een intercept van 0,30% per maand, waar de formule 0,32% en 0,29% gaf. Dat intercept komt neer op ruim 3,5% per jaar aan schijnbare alpha. Op twintig portefeuilles is de helling 0,59% en het intercept 0,02%, zodat de bias verdwijnt. Een te vlakke lijn kan dus volledig econometrisch zijn, maar alleen op individuele aandelen.
Zuiver is niet hetzelfde als precies. De tweede tabel meet hoe breed de schatting van de premie op portefeuilles is.
premium_sd = sims["g1 portefeuilles"].std()
error = sims["g1 portefeuilles"] - world.mu_m
precision = pd.Series(
    {
        "sd geschatte premie (% per maand)": 100 * premium_sd,
        "sd geschatte premie (% per jaar)": 1200 * premium_sd,
        "σ_m / √T (% per jaar)": 1200 * world.sd_m / np.sqrt(world.T_test),
        "aandeel steekproeven met t < 2": np.mean(sims["g1 portefeuilles"] < 2 * sims["se FM"]),
        "dekking 95%-interval": np.mean(np.abs(error) < 1.96 * sims["se FM"]),
        "sd ware bèta, portefeuilles": sims["sd ware bèta portefeuilles"].mean(),
        "sd ware bèta, aandelen": beta_true.std(),
    }
)
precision.round(3)
sd geschatte premie (% per maand) 0.205
sd geschatte premie (% per jaar) 2.465
σ_m / √T (% per jaar) 2.465
aandeel steekproeven met t < 2 0.183
dekking 95%-interval 0.957
sd ware bèta, portefeuilles 0.219
sd ware bèta, aandelen 0.305
dtype: float64Na veertig jaar data heeft de geschatte premie een standaarddeviatie van 2,5% per jaar, gelijk aan . In Rendementen en hun statistiek heette dat de standaardfout van 2%, omdat een gemiddeld rendement over een eeuw bij 20% volatiliteit een standaardfout van 2 procentpunt heeft. In de cross-sectie geldt hetzelfde, want de premie per eenheid bèta is nooit scherper te meten dan het gemiddelde marktrendement. Bij een ware premie van 7,2% per jaar haalt bijna een op de vijf steekproeven geen -waarde van twee, al dekken de Fama-MacBeth-intervallen wel ongeveer 95%. Sorteren heeft ook een prijs, want de spreiding in ware bèta daalt van 0,30 over aandelen naar 0,22 over portefeuilles.
De figuur laat beide effecten zien, links in de gestreepte lijn door de aandelen en rechts in de ligging van de twee histogrammen ten opzichte van de zwarte lijn.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
mean_stock, b_stock, mean_port, b_port = example
grid = np.linspace(-0.2, 2.2, 50)

ax = axes[0]
ax.scatter(b_stock, 100 * mean_stock, s=6, alpha=0.35, color=hap.plotting.COLORS[7],
           label="aandelen")
ax.scatter(b_port, 100 * mean_port, s=28, zorder=3, color=hap.plotting.COLORS[0],
           label="20 bèta-portefeuilles")
ax.plot(grid, 100 * world.mu_m * grid, color=hap.plotting.COLORS[1], lw=1.4, label="ware SML")
fit = np.polyfit(b_stock, mean_stock, 1)
ax.plot(grid, 100 * np.polyval(fit, grid), color=hap.plotting.COLORS[3], ls="--",
        lw=1.4, label="OLS op aandelen")
ax.set_ylim(-1.5, 2.5)
ax.set_xlabel("Geschatte bèta")
ax.set_ylabel("Gemiddeld overrendement (% per maand)")
ax.set_title("Eén steekproef van 40 jaar")
ax.legend()

ax = axes[1]
bins = np.linspace(-0.2, 1.4, 50)
ax.hist(100 * sims["g1 aandelen"], bins=bins, alpha=0.65, label="op aandelen")
ax.hist(100 * sims["g1 portefeuilles"], bins=bins, alpha=0.65, label="op portefeuilles")
ax.axvline(100 * world.mu_m, color="black", lw=1.4, label="ware premie")
ax.set_xlabel("Geschatte premie per eenheid bèta (% per maand)")
ax.set_ylabel("Aantal steekproeven")
ax.set_title("300 steekproeven: de verdeling van Fama-MacBeth")
ax.legend()
plt.show()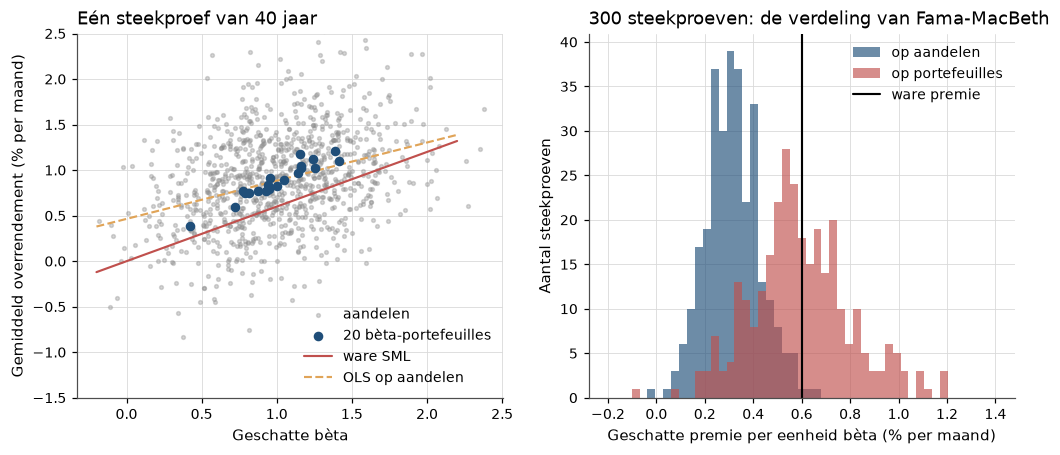
Figure 1:Links: in één gesimuleerde CAPM-wereld is de lijn door de aandelen te vlak (gestreept), terwijl de twintig bèta-portefeuilles dicht bij de ware lijn liggen. Rechts: over 300 steekproeven ligt de verdeling op aandelen links van de ware premie, die op portefeuilles eromheen. Die laatste blijft breed, want de breedte ervan is de standaardfout van het gemiddelde marktrendement.
6Replicatie op echte data
De eerste cel bouwt de portefeuilles in de stijl van BJS. Elke december schatten we per basisactivum een bèta op de voorgaande 60 maanden. We rangschikken de activa van hoge naar lage bèta, knippen de rangorde in tien even grote groepen (P1 de hoogste bèta) en houden elke groep een jaar gelijkgewogen vast.
def pre_ranking_betas(history, market_excess):
    """OLS beta of every column of `history` on the market, over the same months."""
    m_dev = market_excess.loc[history.index] - market_excess.loc[history.index].mean()
    return history.sub(history.mean()).mul(m_dev, axis=0).mean() / (m_dev**2).mean()


def beta_sorted_portfolios(assets, market_excess, n_groups=10, window=5, min_obs=48):
    """BJS-style portfolios: sort each December on pre-ranking beta, hold for a year."""
    labels = [f"P{k}" for k in range(1, n_groups + 1)]
    yearly = []
    for year in range(assets.index.year.min() + window - 1, assets.index.year.max()):
        history = assets.loc[f"{year - window + 1}":f"{year}"]
        history = history.loc[:, history.notna().sum() >= min_obs]
        pre_beta = pre_ranking_betas(history, market_excess)
        rank = pre_beta.rank(ascending=False, method="first")    # 1 = highest beta
        group = pd.qcut(rank, n_groups, labels=labels)           # ten equal-size groups
        next_year = assets.loc[f"{year + 1}"]
        returns = {p: next_year[group.index[group == p]].mean(axis=1) for p in labels}
        yearly.append(pd.DataFrame(returns))
    return pd.concat(yearly)
Nu de sortering vastligt, laadt de volgende cel de data en bouwt ze de drie verzamelingen testportefeuilles. Omdat French’ data in 1926-07 beginnen, berust de eerste sortering op 54 maanden.
market = hap_data.market_monthly()
rf_month, mkt_excess = market["RF"], market["Mkt-RF"]

base = pd.concat(
    {"sbm": hap_data.french("100_Portfolios_10x10"),
     "ind": hap_data.french("49_Industry_Portfolios")},
    axis=1,
)
base_excess = base.sub(rf_month, axis=0)

bjs = beta_sorted_portfolios(base_excess, mkt_excess)
french_beta = (hap_data.french("Portfolios_Formed_on_BETA")
               .filter(regex="Lo 10|Dec|Hi 10").sub(rf_month, axis=0).dropna())
ff25 = hap_data.french("25_Portfolios_5x5").loc["1963-07":].sub(rf_month, axis=0).dropna()

pd.DataFrame(
    {"portefeuilles": [bjs.shape[1], french_beta.shape[1], ff25.shape[1]],
     "start": [p.index[0].strftime("%Y-%m") for p in (bjs, french_beta, ff25)],
     "eind": [p.index[-1].strftime("%Y-%m") for p in (bjs, french_beta, ff25)]},
    index=["BJS-stijl (eigen constructie)", "French bèta-decielen", "25 size/BM"],
)De tabel toont tien BJS-portefeuilles vanaf 1931, en French’ tien bèta-decielen en 25 size/BM-portefeuilles vanaf 1963-07, het begin van French’ reeksen. We beginnen met de tijdreeksregressies (5) per portefeuille over 1931–1965.
def capm_time_series(excess, market_excess):
    """Time-series CAPM regression per portfolio: beta, alpha, mean and its SE."""
    X = sm.add_constant(market_excess.loc[excess.index].rename("markt"))
    rows = {}
    for name, series in excess.items():
        fit = sm.OLS(series, X).fit()
        rows[name] = {
            "bèta": fit.params["markt"],
            "alpha (% p.m.)": 100 * fit.params["const"],
            "t(alpha)": fit.tvalues["const"],
            "gem. overrendement (% p.m.)": 100 * series.mean(),
            "SE gem. (% p.m.)": 100 * series.std() / np.sqrt(len(series)),
            "R2": fit.rsquared,
        }
    return pd.DataFrame(rows).T


capm_time_series(bjs.loc["1931":"1965"], mkt_excess).round(3)De bèta’s lopen van 1,69 naar 0,91, en geen enkele alpha is significant. De standaardfout van elk gemiddelde is 0,3 tot 0,6% per maand, even groot als de verschillen tussen de portefeuilles, zodat een gemiddeld rendement ook over 35 jaar slecht meetbaar is, net als in de simulatie.
Daarna volgen de cross-sectie en GRS. De hoofdsteekproef is die na BJS, omdat de reeks daar het langst en de spreiding in bèta het grootst is. De functie hieronder schat per steekproef de bèta’s over de hele periode, draait Fama-MacBeth en GRS, en schat de alpha van de portefeuille met de laagste bèta. Alle rendementen zijn in procenten per maand.
def sml_test(excess, market_excess):
    """Fama-MacBeth with full-period betas, the GRS test, and the alpha of the lowest-beta portfolio."""
    f = market_excess.loc[excess.index]
    betas = excess.apply(lambda col: col.cov(f) / f.var())
    fm = hap.stats.fama_macbeth(excess, {"beta": betas.to_frame().T}, lags=0)
    grs = hap.stats.grs_test(excess, f.to_frame())
    lowest = sm.OLS(excess[betas.idxmin()], sm.add_constant(f)).fit()
    n_assets, n_months = excess.shape[1], len(excess)
    return pd.Series({
        "bèta min": betas.min(), "bèta max": betas.max(),
        "γ0": 100 * fm.loc["const", "estimate"], "t(γ0)": fm.loc["const", "tstat"],
        "γ1": 100 * fm.loc["beta", "estimate"], "t(γ1)": fm.loc["beta", "tstat"],
        "premie": 100 * f.mean(), "SE premie": 100 * f.std() / np.sqrt(n_months),
        "γ1 / premie": fm.loc["beta", "estimate"] / f.mean(),
        "alpha laagste bèta": 100 * lowest.params["const"],
        "t(alpha laagste bèta)": lowest.tvalues["const"],
        "GRS": grs["grs"], "p(GRS)": grs["pvalue"],
        "GRS-grens 5%": stats.f.ppf(0.95, n_assets, n_months - n_assets - 1),
    })
We passen de functie eerst toe op de periode van BJS en Fama en MacBeth, en de tabel zet onze getallen naast de gepubliceerde. Het gaat vooral om de kolommen , want het CAPM voorspelt een helling gelijk aan de premie.
samples = {
    "BJS 1931-1965": (bjs, "1931-01", "1965-12"),
    "  1931-01 - 1939-09": (bjs, "1931-01", "1939-09"),
    "  1939-10 - 1948-06": (bjs, "1939-10", "1948-06"),
    "  1948-07 - 1957-03": (bjs, "1948-07", "1957-03"),
    "  1957-04 - 1965-12": (bjs, "1957-04", "1965-12"),
    "FM 1935-1968": (bjs, "1935-01", "1968-06"),
}
early = pd.DataFrame({label: sml_test(panel.loc[a:b], mkt_excess)
                      for label, (panel, a, b) in samples.items()}).T
comparison = pd.DataFrame({
    "γ0 origineel": [0.359, -0.80, 0.44, 0.78, 1.02, 0.48], "γ0 hier": early["γ0"],
    "t(γ0) hier": early["t(γ0)"],
    "γ1 origineel": [1.08, 3.04, 1.07, 0.33, -0.12, 0.85], "γ1 hier": early["γ1"],
    "premie origineel": [1.42, 2.20, np.nan, np.nan, np.nan, 1.30],
    "premie hier": early["premie"], "SE premie hier": early["SE premie"],
}, index=early.index)
comparison.round(3)Tot en met 1965 is het beeld gemengd, want de helling ligt soms boven en soms onder de premie. Voor de jaren na BJS bekijken we drie verzamelingen, de twee reeksen van French vanaf 1963 en onze eigen reeks vanaf 1966, het jaar na de steekproef van BJS.
late_samples = {
    "BJS-stijl 1966-heden": bjs.loc["1966-01":],
    "French bèta-decielen 1963-heden": french_beta,
    "25 size/BM 1963-heden": ff25,
}
late = pd.DataFrame({label: sml_test(panel, mkt_excess)
                     for label, panel in late_samples.items()}).T
late[["γ0", "t(γ0)", "γ1", "t(γ1)", "premie", "alpha laagste bèta",
"t(alpha laagste bèta)", "GRS", "GRS-grens 5%", "p(GRS)"]].round(3)Na BJS is de lijn op alle drie vlakker dan de premie, en geen helling is significant positief. GRS verwerpt het CAPM bovendien op 5%, zodat de markt niet op de efficiënte grens van deze portefeuilles ligt.
Gedeeltelijk geslaagd. De tabel zet per periode naast elkaar wat we verwachtten, een helling onder de premie en een intercept boven nul, en wat we vinden (in % per maand).
| periode | verwacht | hier | oordeel |
|---|---|---|---|
| na BJS (hoofdsteekproef) | vlakker, | French-decielen 0,28 bij premie 0,60; alpha laagste deciel 0,21 (); GRS 2,025 > 1,843 () | geslaagd |
| 1948–1965 | als BJS | helling daalt, intercept stijgt; 1957–1965 −0,76 (BJS −0,12) | geslaagd |
| 1939–1948 | als BJS | −0,39 (BJS +0,44), lijn steiler dan premie | niet geslaagd |
| 1931–1939, 1931–1965 | zwakker | 1,06 bij premie 0,93 over 1931–1965 | niet geslaagd |
| Fama-MacBeth 1935–1968 | als FM | 0,78 bij premie 0,96; 0,27 (FM 0,48, bij hen al ) | gedeeltelijk |
In de jaren dertig belonen hoge bèta’s ruim, ook bij BJS. Bij ons weegt dat zwaarder, omdat in onze op grootte gesorteerde basisactiva hoge bèta en kleine ondernemingen dan samenvallen. De premie ligt overal lager dan bij BJS, zoals bij een waardegewogen index te verwachten was.
De figuur zet de twee tijdvakken naast elkaar, en het gaat daarbij om de afstand tussen de doorgetrokken lijn van het CAPM en de gestreepte geschatte lijn.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.5), sharey=True)
panels = [(bjs.loc["1931":"1965"], "BJS-stijl, 1931-1965"),
          (french_beta, f"French bèta-decielen, 1963-07 - {french_beta.index[-1]:%Y-%m}")]
for ax, (panel, title) in zip(axes, panels):
    table = capm_time_series(panel, mkt_excess)
    premium = 100 * mkt_excess.loc[panel.index].mean()
    grid = np.linspace(0, 1.9, 20)
    slope, intercept = np.polyfit(table["bèta"], table["gem. overrendement (% p.m.)"], 1)
    ax.errorbar(table["bèta"], table["gem. overrendement (% p.m.)"],
                yerr=2 * table["SE gem. (% p.m.)"], fmt="o", capsize=2,
                color=hap.plotting.COLORS[0], label="portefeuilles ($\\pm$2 SE)")
    ax.plot(grid, premium * grid, color=hap.plotting.COLORS[1], lw=1.5,
            label="CAPM: door 0 en de markt")
    ax.plot(grid, intercept + slope * grid, color=hap.plotting.COLORS[3], ls="--", lw=1.5,
            label="geschatte SML")
    ax.scatter([1.0], [premium], marker="D", zorder=3, color=hap.plotting.COLORS[1])
    ax.set_title(title)
    ax.set_xlabel("Bèta (volle periode)")
axes[0].set_ylabel("Gemiddeld overrendement (% per maand)")
axes[0].legend(loc="upper left")
plt.show()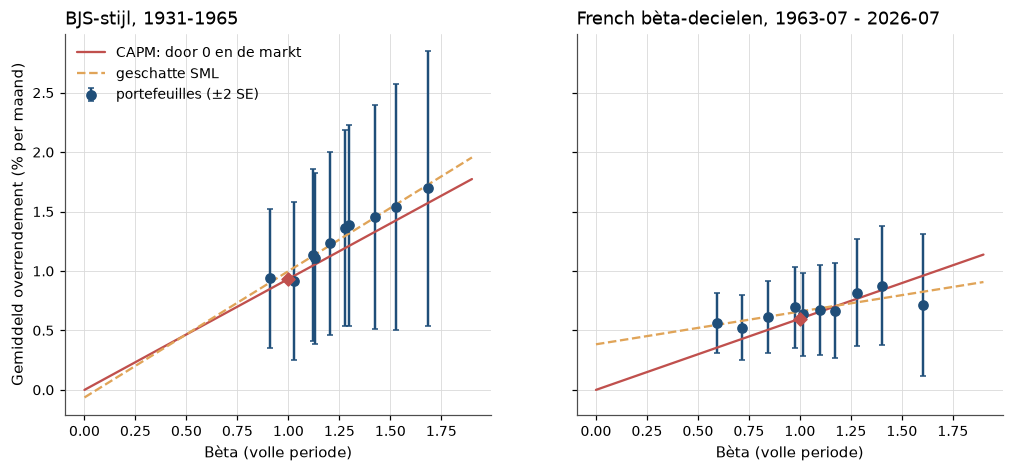
Figure 2:Links, 1931–1965 in onze eigen BJS-constructie: de portefeuilles liggen rond de CAPM-lijn, maar de spreiding in bèta is te klein en de onzekerheid per punt te groot om veel te onderscheiden. Rechts, French’ bèta-decielen na 1963: de geschatte lijn is ongeveer half zo steil als de CAPM-lijn, met de laagste bèta erboven en de hoogste eronder.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Het CAPM gaf het vak een taal die het nooit meer kwijtraakte. Het scheidde risico dat beloond wordt van risico dat niet beloond wordt, en gaf dat onderscheid een getal: de bèta. Het maakte van de markt de natuurlijke maatstaf, en van het indexfonds de natuurlijke belegging. Bèta verklaart ook veel van de schommelingen in rendement, want de van onze BJS-portefeuilles ligt tussen 0,81 en 0,93. Voor het gemiddelde rendement geldt dat niet.
Waar het breekt. De security market line is te vlak, want op de bèta-decielen van French levert een eenheid bèta sinds 1963 0,28% per maand op, tegen de 0,60% die het CAPM voorspelt. BJS zagen het begin daarvan al in hun laatste subperiode, en na hun steekproef is op geen van onze drie verzamelingen een significante beloning voor bèta over. Uit de simulatie bleek dat een te vlakke lijn op portefeuilles geen artefact van geschatte bèta’s kan zijn.
Risico of vergissing? Hier gaat de vraag erom of de vlakke lijn een correcte evenwichtsprijs is of een prijs die ernaast zit. In de risicolezing geldt het zero-beta-model van Black (1972). Beleggers die niet kunnen lenen, betalen dan bewust meer voor hoge bèta, zoals voor elke andere dienst, en wie wel kan lenen, verdient die meerprijs door lage-bèta-aandelen met hefboom te kopen en hoge-bèta-aandelen short te verkopen Frazzini & Pedersen (2014). In de vergissingslezing betalen beleggers te veel voor hoge bèta omdat ze het rendement overschatten, of omdat beheerders met een index als maatstaf lage bèta mijden. De prijs is dan fout, en arbitrageurs corrigeren die fout niet, omdat hun hefboom beperkt is. Beide lezingen voorspellen een vlakke lijn, en uit de data valt niet op te maken welke van de twee klopt.
Wat er daarna kwam. Het CAPM werd ook een rekeninstrument, want Black en Scholes gebruikten het in een van hun afleidingen van de prijs van een optie, het onderwerp van Black-Scholes-Merton en de CBOE. Dat een CAPM-toets eigenlijk de gekozen index toetst, liet Roll zien, in Roll: de kritiek en de R².
8Oefeningen
Solution to Exercise 1
(1) De vraag in geld is , dus . De marktpremie is . De premies zijn . De bèta’s hangen alleen van en af en blijven , en .
(2) telt op tot 4. Belegger 1 zet dus maal zijn vermogen risicovol, 300, en leent 150. Belegger 2 zet maal 750 risicovol, 600, en leent 150 uit.
theta_alt = np.array([2.0, 5.0])
theta_m_alt = supply.sum() / (wealth / theta_alt).sum()
mu_e_alt = theta_m_alt * Sigma @ w_m
risky_share = np.linalg.solve(Sigma, mu_e_alt).sum() / theta_alt
pd.Series(
    {"theta_m": theta_m_alt, "marktpremie": w_m @ mu_e_alt,
     "premie A": mu_e_alt[0], "premie B": mu_e_alt[1], "premie C": mu_e_alt[2],
     "bèta A": (Sigma @ w_m / var_m)[0],
     "risicovrij belegger 1": wealth[0] * (1 - risky_share[0]),
     "risicovrij belegger 2": wealth[1] * (1 - risky_share[1])}
).round(4)
theta_m 4.0000
marktpremie 0.0553
premie A 0.0711
premie B 0.1067
premie C 0.0178
bèta A 1.2857
risicovrij belegger 1 -150.0000
risicovrij belegger 2 150.0000
dtype: float64(3) De premie daalt van 6,22% naar 5,53%. Omdat de markt als geheel minder risicoavers is, willen beleggers tegen de oude prijzen meer aandelen dan er zijn, en daardoor stijgen de prijzen tot de premie laag genoeg is. Bèta’s blijken een eigenschap van de activa te zijn, en de premie een eigenschap van de beleggers.
:::{exercise}
:label: ex-capm-2

**Afleiding: hoe groot is de attenuatie?** Neem de kalibratie van de simulatie.

1. Leid af dat de OLS-bèta uit $T$ maanden, gegeven de marktrendementen $f_t$,
   een meetfout heeft met variantie
   $\sigma^2_\varepsilon/\sum_t (f_t - \bar f)^2 \approx \sigma^2_\varepsilon/(T\sigma_m^2)$.
   Bereken $\kappa$, de verwachte helling en de bias in het intercept uit
   [](#eq-capm-eiv).
2. Hoeveel aandelen $n$ moet een portefeuille minstens bevatten voor
   $\kappa \geq 0{,}95$, bij een spreiding in ware bèta's van 0,30? En bij 0,22,
   de spreiding over portefeuilles in de simulatie?
Solution to ex-capm-2
(1) Met is . Gegeven de is dat een gewogen som van onafhankelijke ’s, met de genoemde variantie. Met wordt en . De verwachte helling is en de intercept-bias per maand.
(2) Met meetfoutvariantie betekent dat , wat neerkomt op 18 aandelen bij spreiding 0,30 en 33 bij spreiding 0,22.
eiv = {}
for label, sd_beta in [("spreiding 0,30", 0.30), ("spreiding 0,22", 0.22)]:
    kappa = sd_beta**2 / (sd_beta**2 + sigma_u2)
    eiv[label] = {
        "sigma_u^2": sigma_u2,
        "kappa (n = 1)": kappa,
        "helling (% p.m.)": 100 * kappa * world.mu_m,
        "intercept-bias (% p.m.)": 100 * (1 - kappa) * world.mu_m,
        "minimale n": int(np.ceil(19 * sigma_u2 / sd_beta**2)),
    }
pd.DataFrame(eiv).T.round(3)De simulatie gaf 0,316% en 0,298%, dicht bij de formule. Een paar dozijn aandelen per portefeuille werkt de meetfout dus vrijwel weg, terwijl de onzekerheid over de premie zelf daarna alleen nog met krimpt en niet met .
:::{exercise}
:label: ex-capm-3

**Uitbreiding: de keuze van basisactiva.** Herhaal de BJS-replicatie over
1931–1965 en de vier subperiodes met alleen de 49 industrieportefeuilles als
basisactiva (`base_excess["ind"]`).

1. Rapporteer de bèta-spreiding, $\gamma_0$, $\gamma_1$ en $\gamma_1$ gedeeld door
   de marktpremie.
2. Is de lijn over 1931–1965 nu vlakker dan het CAPM voorspelt?
3. Wat leert dit over replicaties waarin de onderzoeker de basisactiva kiest?
Solution to ex-capm-3
bjs_industries = beta_sorted_portfolios(base_excess["ind"], mkt_excess)
bjs_periods = list(samples.items())[:5]
industries = pd.DataFrame({label: sml_test(bjs_industries.loc[a:b], mkt_excess)
                           for label, (_, a, b) in bjs_periods}).T
industries[["bèta min", "bèta max", "γ0", "t(γ0)", "γ1", "t(γ1)", "premie", "γ1 / premie"]].round(3)(1) en (2) De laagste bèta daalt van 0,91 naar 0,74, en de lijn over 1931–1965 is nu wél vlakker dan voorspeld, met . Het intercept is positief, 0,29% per maand, het teken van BJS, al is het met niet significant. In 1931–1939 blijft de lijn te steil.
(3) Dezelfde methode op dezelfde maanden geeft een ander antwoord, afhankelijk van de vraag of de basisactiva op grootte zijn gesorteerd. Zodra bèta en een ander kenmerk samenvallen, meet een sortering op bèta beide. Fama en French sorteerden daarom later eerst op grootte en daarbinnen op bèta, zie Fama-French 1992/1993. Een replicatie toetst dus ook de keuze van de testactiva.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Treynor, J. L. (1961). Market Value, Time, and Risk. Unpublished manuscript, dated August 8, 1961; posted on SSRN 2015. 10.2139/ssrn.2600356
- Treynor, J. L. (2012). Toward a Theory of Market Value of Risky Assets. In Treynor on Institutional Investing (pp. 49–59). John Wiley & Sons. 10.1002/9781119196679.ch6
- Sharpe, W. F. (1964). Capital Asset Prices: A Theory of Market Equilibrium under Conditions of Risk. The Journal of Finance, 19(3), 425–442. 10.1111/j.1540-6261.1964.tb02865.x
- Lintner, J. (1965). The Valuation of Risk Assets and the Selection of Risky Investments in Stock Portfolios and Capital Budgets. The Review of Economics and Statistics, 47(1), 13–37. 10.2307/1924119
- Mossin, J. (1966). Equilibrium in a Capital Asset Market. Econometrica, 34(4), 768–783. 10.2307/1910098
- Jensen, M. C. (1968). The Performance of Mutual Funds in the Period 1945–1964. The Journal of Finance, 23(2), 389–416. 10.1111/j.1540-6261.1968.tb00815.x
- Black, F., Jensen, M. C., & Scholes, M. (1972). The Capital Asset Pricing Model: Some Empirical Tests. In M. C. Jensen (Ed.), Studies in the Theory of Capital Markets (pp. 79–121). Praeger.
- Fama, E. F., & MacBeth, J. D. (1973). Risk, Return, and Equilibrium: Empirical Tests. Journal of Political Economy, 81(3), 607–636. 10.1086/260061
- Black, F. (1972). Capital Market Equilibrium with Restricted Borrowing. The Journal of Business, 45(3), 444–455. 10.1086/295472
- Gibbons, M. R., Ross, S. A., & Shanken, J. (1989). A Test of the Efficiency of a Given Portfolio. Econometrica, 57(5), 1121–1152. 10.2307/1913625
- Shanken, J. (1992). On the Estimation of Beta-Pricing Models. The Review of Financial Studies, 5(1), 1–33. 10.1093/rfs/5.1.1
- Miller, M. H., & Scholes, M. (1972). Rates of Return in Relation to Risk: A Re-examination of Some Recent Findings. In M. C. Jensen (Ed.), Studies in the Theory of Capital Markets (pp. 47–78). Praeger.
- Frazzini, A., & Pedersen, L. H. (2014). Betting Against Beta. Journal of Financial Economics, 111(1), 1–25. 10.1016/j.jfineco.2013.10.005
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD