

Voorspelbaarheid van rendementen
1Overzicht
Zijn rendementen op de aandelenmarkt voorspelbaar? Ja, want de dividend-prijsratio beweegt vrijwel alleen doordat verwachte rendementen bewegen, en niet doordat verwachte dividendgroei beweegt. Toch verklaart die voorspelling per jaar maar een paar procent van de variantie, zodat een belegger die de helling zelf moet schatten, er buiten de steekproef zelden het historische gemiddelde mee verslaat. In de termen van theorie of feit gaat dit college over een feit, want dat de ratio door verwachte rendementen beweegt, volgt uit een boekhoudidentiteit en de data. De theorieën die dat feit verklaren, komen pas later.
We leiden uit de Campbell-Shiller-identiteit de identiteit van Cochrane af, die de voorspelling van rendement, dividendgroei en de ratio zelf aan elkaar koppelt;
We laten zien waarom de met de horizon groeit, en waarom overlap en de Stambaugh-bias de rendementsregressie te gunstig maken;
We simuleren 78 jaar data, eerst met onvoorspelbare rendementen en daarna met de voorspelbaarheid die Cochrane schat;
We repliceren op
hap.data.goyal_welch()de tabellen van Fama en French, van Cochrane, van Goyal en Welch en van Ferreira en Santa-Clara.
In 1988 lieten Eugene Fama en Kenneth French zien dat de dividend-prijsratio maandrendementen nauwelijks voorspelt, maar rendementen over twee tot vier jaar des te beter Fama & French (1988). In hetzelfde jaar gaven John Campbell en Robert Shiller het kader om zo’n uitkomst te lezen Campbell & Shiller (1988). Hun loglineaire contante-waardeformule verdeelt de variantie van de ratio over verwachte rendementen en verwachte dividendgroei. Daarna volgden twintig jaar bezwaren, want de helling bleek in kleine steekproeven omhoog vertekend Stambaugh (1999), de -waarden van overlappende regressies te hoog Hodrick (1992)Valkanov (2003), en buiten de steekproef versloeg vrijwel geen voorspeller het gemiddelde Welch & Goyal (2008). Cochrane sloot het tijdvak af met het argument dat juist de onvoorspelbaarheid van dividenden het bewijs levert Cochrane (2008)Cochrane (2011). Campbell en Thompson Campbell & Thompson (2008) en Ferreira en Santa-Clara Ferreira & Santa-Clara (2011) lieten daarnaast zien dat een kleine veel waard kan zijn.
2Intuïtie: waarom zou dit waar zijn?
Een aandeel is om twee redenen duur ten opzichte van zijn dividend. Ofwel verwachten beleggers dat het dividend hard gaat groeien, ofwel nemen ze genoegen met een laag rendement. Een derde reden bestaat niet, afgezien van een zeepbel die eeuwig blijft groeien, want het rendement bestaat per definitie uit koerswinst en dividend. Een hoge of lage dividend-prijsratio moet dus iets voorspellen, namelijk dividendgroei, rendementen of een mengsel van beide.
Kijk nu naar de Amerikaanse data. Sinds 1926 schommelt de dividend-prijsratio tussen ruwweg 1% en 8%. Hij keert zo traag terug naar zijn gemiddelde dat een afwijking na tien jaar nog voor ruim de helft bestaat. Als die schommelingen over dividenden gingen, zou na dure jaren snelle dividendgroei volgen, maar die groei blijft uit. Dan blijft er maar één kanaal over, namelijk dat na dure jaren lage rendementen volgen. Cochrane noemde die ontbrekende dividendgroei de hond die niet blafte, naar het verhaal van Sherlock Holmes waarin de hond die 's nachts níet blafte de beslissende aanwijzing was.
Toch is die voorspelbaarheid moeilijk te zien, omdat het verwachte rendement weinig beweegt vergeleken met het rendement zelf. Als het verwachte jaarrendement schommelt met een standaarddeviatie van vier procentpunt en het gerealiseerde rendement met twintig, dan verklaart de voorspeller per jaar hooguit van de variantie. Die vier procentpunt houden echter jaren aan. Een belegger die vanuit een dure markt tien jaar belegt, krijgt die hele periode een iets lager verwacht rendement, en die kleine verschillen tellen op, terwijl de ruis uitmiddelt. Daarom groeit de met de horizon, en daarom zochten Fama en French het bewijs bij rendementen over meerdere jaren.
Dezelfde traagheid maakt de statistiek verraderlijk. Een voorspeller die bijna een random walk is, maakt in een eeuw maar een handvol onafhankelijke schommelingen. Daardoor is de geschatte helling vertekend en vallen de -waarden te gunstig uit. Bovendien had een belegger destijds zijn helling moeten schatten op de data van dat moment. We verwachten daarom dat een hoge ratio hoge rendementen voorspelt en geen lage dividendgroei, en dat de voorspelling buiten de steekproef zwak is, ook al bewegen verwachte rendementen wel degelijk.
3Toy-voorbeeld: vier jaar data en de identiteit van Cochrane
De eerste cel laadt de pakketten die het hele college gebruikt en legt het startpunt van de toevalsgenerator vast.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import statsmodels.api as sm
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Het kleinste voorbeeld van het mechanisme heeft vier jaar data en drie regressies op één regressor. We meten alles als afwijking van het langjarige gemiddelde, zodat de constanten wegvallen. Vanaf hier zijn kleine letters logs, zoals in Shiller en LeRoy-Porter: excess volatility. Zo zijn en de log van prijs en dividend, is de log dividend-prijsratio en is het logrendement.
Eén formule nemen we hier als recept en leiden we in de theorie af, de Campbell-Shiller-benadering met . Volgens dat recept is het rendement hoog als het aandeel goedkoop was (hoge ), als de koers daarna stijgt (dalende ) en als het dividend groeit. De tabel geeft de ratio en de dividendgroei in de vier jaren.
| jaar | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| log dividend-prijsratio | −0,10 | 0,00 | 0,10 | 0,16 |
| log dividendgroei | 0,02 | 0,06 | 0,01 |
Stap 1, de rendementen. Zonder de constante geeft het recept rendementen als afwijking van hun langjarige gemiddelde, zodat een negatief rendement hier “onder het gemiddelde” betekent en geen verlies. Dat ze in deze vier jaren alle drie onder dat gemiddelde liggen, komt doordat de markt steeds goedkoper werd, want stijgt elk jaar. Het recept geeft voor de drie jaren
Stap 2, drie hellingen. De regressor is , met gemiddelde nul en . Omdat , is elke OLS-helling gewoon , zonder dat we eerst het gemiddelde van aftrekken.
Stap 3, de identiteit. De drie hellingen hangen aan elkaar, want , en dat is precies . Wie er twee kent, kent dus ook de derde.
Stap 4, de verdeling. Delen door geeft en , en het verschil van die twee is precies één. In dit verzonnen voorbeeld komt 78% van de beweging in dus uit verwachte rendementen en 22% uit verwachte dividendgroei.
De codecel rekent de vier stappen na en zet de uitkomsten naast de handberekening.
rho_toy = 0.96
dp_toy = np.array([-0.10, 0.00, 0.10, 0.16])   # dp_0, ..., dp_3
dd_toy = np.array([0.02, 0.06, 0.01])          # dividend growth in years 1, 2, 3
ell_toy = dp_toy[:-1] - rho_toy * dp_toy[1:] + dd_toy   # step 1: Campbell-Shiller returns


def ols_slope(y, x):
    """OLS slope of y on x with an intercept."""
    x_dev = x - x.mean()
    return float((x_dev * (y - y.mean())).sum() / (x_dev**2).sum())


x_toy = dp_toy[:-1]
phi_toy = ols_slope(dp_toy[1:], x_toy)   # step 2: persistence of dp
bd_toy = ols_slope(dd_toy, x_toy)        # step 2: dividend-growth slope
br_toy = ols_slope(ell_toy, x_toy)       # step 2: return slope
denom_toy = 1 - rho_toy * phi_toy        # step 4: 1 - rho * phi

pd.DataFrame(
    {
        "met de hand": [-0.0800, -0.0360, -0.0436, 0.8000, -0.0500, 0.1820, 0.1820,
                        0.7845, -0.2155],
        "code": [*ell_toy, phi_toy, bd_toy, br_toy, denom_toy + bd_toy,
                 br_toy / denom_toy, bd_toy / denom_toy],
    },
    index=["rendement jaar 1", "rendement jaar 2", "rendement jaar 3", "helling phi",
           "helling b_d", "helling b_r", "1 - rho*phi + b_d", "b_r^lr", "b_d^lr"],
).round(4)Code en hand geven dezelfde getallen. De identiteit uit stap 3 geldt in elke steekproef exact zodra de rendementen uit de benadering komen, en in echte data op een paar duizendsten na. In dit voorbeeld voorspelt een goedkope markt dus vooral een hoog rendement, en slechts voor een klein deel lage dividendgroei.
4Theorie
De theorie heeft één kern. Het rendement bestaat per definitie uit de ratio van vandaag, die van morgen en de dividendgroei. Daardoor zijn de voorspellende regressies van rendement, dividendgroei en ratio aan elkaar gekoppeld, en is een ontbrekende dividendvoorspelling bewijs voor een rendementsvoorspelling. We herhalen eerst de Campbell-Shiller-identiteit, leiden daaruit de koppeling van Cochrane af en laten zien wat die voor de lange horizon voorspelt. Daarna volgen de drie toetsproblemen van dit tijdvak, namelijk overlappende waarnemingen, de Stambaugh-bias en de toets buiten de steekproef.
4.1Opzet: de Campbell-Shiller-identiteit
De ratio van vandaag is gelijk aan verdisconteerde toekomstige rendementen min verdisconteerde toekomstige dividendgroei. Een belegger die een goedkope markt koopt, met een hoge , verdient dus later een hoog rendement of ziet het dividend dalen. Een derde uitweg is er niet. Shiller en LeRoy-Porter: excess volatility leidde die identiteit af voor , in (8). Wij volgen de tekenconventie van Cochrane, , zodat een hoge een goedkope markt betekent en de hellingen positief uitkomen.
Het bewijs staat bij (8). Het logrendement is een gladde functie van de prijs-dividendratio van morgen, en omdat die ratio rond een stabiel gemiddelde schommelt, vervangen we de functie door de raaklijn. Zo ontstaat (3), en vooruit oplossen geeft (4).
is geen voorkeursparameter maar een getal uit de data. Bij een gemiddelde prijs-dividendratio van 25 is , de waarde uit het toy-voorbeeld. De benaderingsfout is klein, want bij een afwijking van 0,5 in de log-ratio is de tweede-ordeterm .
4.2Het kernresultaat: de identiteit van Cochrane
De voorspellende regressies van rendement, dividendgroei en ratio zijn niet onafhankelijk. Regresseren we elke term van (3) op , dan is de helling van de som de som van de hellingen. De rendementshelling ligt dus vast zodra de andere twee bekend zijn. Cochrane schrijft het systeem als een vectorautoregressie (VAR), drie regressies op de ratio van vorig jaar, en we houden zijn namen en voor de hellingen:
Hier is de persistentie van de ratio, ongeveer 0,94 per jaar. De schokken , en zijn het onvoorspelbare deel.
Proof 1
OLS is lineair in de afhankelijke variabele, zodat de helling van op de som van de hellingen is. Pas dat toe op . De helling van op zichzelf is 1, die van is en die van is , dus . Hetzelfde argument op de residuen geeft , want zelf heeft geen residu. In het VAR voorspelt het rendement in jaar met helling , zodat , en hetzelfde geldt voor .
De lange-termijncoëfficiënten verdelen de variantie van de ratio. Vermenigvuldigen we (4) met en nemen we verwachtingen, dan volgt net als bij (9)
Na deling door worden de covarianties regressiecoëfficiënten:
met de helling van op . is het deel van de variantie van de ratio dat verwachte rendementen verklaren, en het deel dat verwachte dividendgroei verklaart. In het toy-voorbeeld kwam 78% van de beweging van rendementen en 22% van dividendgroei. Omdat de decompositie niet orthogonaal is, hoeven de delen niet tussen nul en één te liggen. Als dividendgroei de verkeerde kant op voorspeld wordt, is groter dan één. De tabel zet de schattingen van Cochrane over 1926–2004 naast wat de nulhypothese van onvoorspelbare rendementen eist.
| Cochrane (2008), tabel 1, 2 en 4 | 0,097 ( = 1,92) | 0,008 ( = 0,18) | 0,941 (SE 0,047) | 1,09 (SE 0,44) |
| nulhypothese | 0 | −0,093 | 0,941 | 0 |
Met en is . Zijn rendementen onvoorspelbaar, dan moet dividendgroei dus voorspelbaar zijn met helling , zodat een dure markt (lage ) snelle dividendgroei voorspelt. De rendementsregressie alleen is net niet significant, maar de dividendhelling ligt ruim twee standaardfouten boven wat de nulhypothese eist. Het bewijs komt dus niet uit de rendementsregressie, maar uit een dividendregressie die nul geeft. Het teken dat de intuïtie verwachtte, klopt, en zegt zelfs dat de variantie van de ratio vrijwel volledig uit verwachte rendementen komt.
Een nulhypothese die ook vrijlaat, kan aan dit argument ontsnappen. Bij dicht bij is klein, zodat de vereiste ook bijna nul is. Cochrane antwoordt dat zo’n wereld er zelf vreemd uitziet, omdat een ratio met een eenheidswortel betekent en een explosieve prijs. Een zinvolle nulhypothese heeft daarom een bovengrens op , en onder die grens wordt ze verworpen.
4.3Wat het voorspelt: een die met de horizon groeit
Uit de identiteit en de traagheid van de ratio volgt dat de helling en de met de horizon groeien, zonder dat er informatie bijkomt. Een belegger die een goedkope markt koopt en vijf jaar vasthoudt, verdient vijf jaar lang een iets hoger verwacht rendement, terwijl de onverwachte schokken elkaar deels opheffen. In het VAR voorspelt het rendement in jaar met helling , zodat de helling op het cumulatieve rendement een meetkundige som is:
Met de afgeronde en is en , oplopend naar op oneindige horizon. Verdisconteren we met , dan wordt de oneindige som . Een log-punt hogere voorspelt dus ongeveer een log-punt hoger verdisconteerd rendement, en dat getal is de uit (8).
Ook de groeit. De populatiewaarde is
en als rendementen niet autogecorreleerd waren, gold en dus . Bij en geeft dat 15,7% op vijf jaar en 23,7% op tien jaar. Fama en French wezen op een tweede effect dat de nog verder opdrijft. Een schok die het verwachte rendement verhoogt, verlaagt de prijs vandaag, omdat een hogere discontovoet toekomstige kasstromen minder waard maakt. Daardoor zijn onverwachte rendementen en latere verwachte rendementen negatief gecorreleerd, en groeit langzamer dan .
In hun artikel verklaart de dividend-prijsratio maar een klein deel van de variantie van maand- en kwartaalrendementen, maar van rendementen over twee tot vier jaar vaak meer dan 25% Fama & French (1988). Die stijgende is echter geen nieuw bewijs, want alles wat de lange-horizonregressie weet, zit al in en , en de horizon herschikt die informatie alleen.
4.4Hoe het getoetst wordt: overlap en de Stambaugh-bias
Twee eigenschappen van de data maken de gewone -waarde te gunstig, namelijk de overlap tussen lange-horizonrendementen en de traagheid van de regressor. Opeenvolgende vijfjaarsrendementen delen vier jaar, zodat de residuen een MA(4)-proces vormen, waarin elk residu een gewogen som is van de laatste vijf jaarschokken. Een gewone standaardfout telt elke waarneming dan alsof hij nieuw is. Fama en French corrigeerden met de schatter van Hansen en Hodrick, die de autocovarianties van de overlappende residuen schat, maar met een trage regressor vallen die schattingen in kleine steekproeven te klein uit, zodat de toets te vaak verwerpt.
Hodrick Hodrick (1992) draaide daarom de som om. Op randtermen na is de teller van de lange-horizonhelling ook te schrijven als een éénjaarsrendement maal een achterwaartse som van de regressor:
Onder de nulhypothese zijn éénjaarsresiduen niet autogecorreleerd, zodat de variantie te schatten is zonder correctie voor overlap:
met en het éénjaarsrendement min zijn gemiddelde. Deze standaardfout, Hodricks variant “1B”, hoeft geen autocovarianties te schatten en heeft daardoor ook in kleine steekproeven ongeveer het juiste niveau, en ermee zakken de -waarden voor lange horizonnen fors. Valkanov Valkanov (2003) liet bovendien zien dat de gewone -waarde divergeert als de horizon met de steekproef meegroeit.
De traagheid van de regressor werkt subtieler. Een koersstijging verhoogt het rendement en verlaagt tegelijk, zodat de schokken in rendement en ratio sterk negatief gecorreleerd zijn. De OLS-schatter van is in kleine steekproeven naar beneden vertekend, zoals Kendall liet zien. Een steekproef waarin te laag uitvalt, is dus een steekproef waarin de ratio te snel terugkeerde, en via de negatieve correlatie lijkt het rendement dan achteraf voorspelbaar. Merton: continue tijd en het ICAPM liet dat al zien in Figuur 2. Schrijf en en projecteer op , zodat met ongecorreleerd met . De term in is gemiddeld nul, en er blijft over
met voor een AR(1) met constante Stambaugh (1999). De bias is groter naarmate de schokken sterker negatief gecorreleerd zijn, de ratio trager is en de steekproef korter. Met de getallen van Cochrane, , en , is de bias , bijna de helft van de geschatte .
De eenvoudigste correctie trekt die term af, met in plaats van .
4.5Hoe het getoetst wordt: buiten de steekproef
Een regressie op de hele steekproef kiest de helling met kennis van de toekomst, terwijl een belegger in 1965 alleen de data tot 1965 kende. De eerlijke toets schat daarom elk jaar opnieuw op wat toen bekend was en vergelijkt de voorspelling met het historische gemiddelde tot dat moment. Noem de voorspelling uit een regressie die tot is geschat en het gemiddelde tot , met het rendement of het overrendement. De buiten de steekproef is dan
Een positieve betekent dat de regressie het gemiddelde verslaat. Goyal en Welch vonden voor vrijwel alle voorspellers een negatieve waarde. Ze concludeerden dat deze modellen al dertig jaar slecht voorspellen, in en buiten de steekproef, en bovendien instabiel zijn Welch & Goyal (2008).
Een negatieve is echter te verwachten, ook als de voorspeller echt werkt, omdat de regressie de schattingsfout van twee parameters draagt en het gemiddelde die van één. Bij een kleine ware weegt die extra ruis zwaarder dan de winst. Omdat het gemiddelde de regressie met helling nul is, zijn de modellen bovendien genest, zodat de gewone toets op gelijke voorspelfouten niet standaardnormaal is. Clark en West Clark & West (2007) tellen daarom de verwachte extra ruis van het grote model bij zijn fout op:
Daarna toetsen ze eenzijdig, met een gewone -waarde, of het gemiddelde van positief is.
Campbell en Thompson Campbell & Thompson (2008) merkten op dat geen belegger een helling met het verkeerde teken of een negatieve verwachte premie gebruikt. Met die twee restricties verslaan veel voorspellers het gemiddelde alsnog, zij het nipt. Ze lieten met een eenvoudige mean-variance-rekensom ook zien dat een kleine veel waard kan zijn. Laat het overrendement zijn, met een voorspeller met gemiddelde nul, bijvoorbeeld de helling maal de afwijking van de dividend-prijsratio van zijn gemiddelde. Een mean-variance-belegger met risicoaversie kiest zonder het gewicht en verdient gemiddeld , met de Sharpe-ratio van rond de 0,1 per maand. Met kiest hij en verdient hij , zodat het verwachte portefeuillerendement proportioneel stijgt met een factor waaruit is weggevallen,
Hoe kleiner de Sharpe-ratio zonder voorspeller, hoe meer een gegeven waard is, omdat de voorspeller dan een groter deel van de haalbare winst levert. In hun werkpaperversie (NBER 11468, 2005) is de maandelijkse Sharpe-ratio sinds 1871 gelijk aan 0,108, dus . Zelfs een maandelijkse van 0,25% verhoogt het verwachte rendement dan al met .
Hier keert de standaardfout van 2% terug in een nieuwe vorm, want een klein effect vraagt een lange steekproef. De standaardfout van is ongeveer . Met , een onvoorwaardelijke en een ware zijn jaren nodig om gemiddeld een -waarde van twee te zien. Zo lang is ongeveer de steekproef van Cochrane. Omgekeerd zou een grote te winstgevend zijn om te geloven, zodat een die klein genoeg is om aan te twijfelen, precies past bij een evenwicht met wisselende premies.
5Simulatie: wat 78 jaar data kunnen laten zien
De simulatie vraagt wat een onderzoeker met 78 jaar jaardata te zien krijgt. We kijken eerst naar een wereld met onvoorspelbare rendementen en daarna naar de wereld die Cochrane schat.
5.1Onder de nulhypothese: welke helling verraadt de wereld?
We simuleren de nulhypothese zoals Cochrane die opschrijft, met , en , zodat . Dat is dezelfde van ongeveer 0,96 als in het toy-voorbeeld, nu met meer decimalen.
De schokken in en in dividendgroei hebben de standaarddeviaties uit zijn tabel 2, 15,3% en 14,0%, met een correlatie van 7,5%. Het rendement volgt uit de identiteit als , en per steekproef van 78 jaar, zoals 1927–2004, schatten we de drie regressies.
RHO_C, PHI_C, T_C = 0.9638, 0.941, 78
SD_DP, SD_D, CORR_D_DP = 0.153, 0.140, 0.075
SAMPLE_C = {"b_r": 0.097, "b_d": 0.008, "phi": 0.941, "b_lr": 1.09}

cov_shocks = np.array([[SD_DP**2, CORR_D_DP * SD_DP * SD_D],
                       [CORR_D_DP * SD_DP * SD_D, SD_D**2]])
chol_shocks = np.linalg.cholesky(cov_shocks)


def simulate_var(n_samples, n_years, b_r, phi=PHI_C, rho=RHO_C):
    """Simulate the Cochrane VAR: dp is AR(1), dividend growth from b_d, returns from the identity.

    Returns arrays of shape (n_samples, n_years + 1) for dp and (n_samples, n_years)
    for dividend growth and returns; dp[:, t] is known when r[:, t] is earned.
    """
    b_d = b_r + rho * phi - 1
    shocks = rng.standard_normal((n_samples, n_years + 1, 2)) @ chol_shocks.T
    dp = np.empty((n_samples, n_years + 1))
    dp[:, 0] = rng.normal(0.0, SD_DP / np.sqrt(1 - phi**2), n_samples)
    for t in range(n_years):
        dp[:, t + 1] = phi * dp[:, t] + shocks[:, t + 1, 0]
    growth = b_d * dp[:, :-1] + shocks[:, 1:, 1]
    returns = b_r * dp[:, :-1] + shocks[:, 1:, 1] - rho * shocks[:, 1:, 0]
    return dp, growth, returns


def slopes(y, x):
    """Row-wise OLS slopes of y on x (each row one sample)."""
    xd = x - x.mean(axis=1, keepdims=True)
    return (xd * (y - y.mean(axis=1, keepdims=True))).sum(axis=1) / (xd**2).sum(axis=1)


n_null = 50_000
dp_sim, dd_sim, r_sim = simulate_var(n_null, T_C, b_r=0.0)
br_null = slopes(r_sim, dp_sim[:, :-1])
bd_null = slopes(dd_sim, dp_sim[:, :-1])
phi_null = slopes(dp_sim[:, 1:], dp_sim[:, :-1])
blr_null = br_null / (1 - RHO_C * phi_null)

pd.DataFrame(
    {
        "hier (simulatie)": [np.mean(br_null > SAMPLE_C["b_r"]), np.mean(bd_null > SAMPLE_C["b_d"]),
                             np.mean(blr_null > SAMPLE_C["b_lr"])],
        "Cochrane (2008), tabel 3 en 4": [0.223, 0.0177, "0.0139-0.0183"],
    },
    index=["kans op b_r-dak > 0.097", "kans op b_d-dak > 0.008", "kans op b_r^lr-dak > 1.09"],
).round(4)De simulatie reproduceert de kansen van Cochrane. Onder de nulhypothese heeft een op de vijf steekproeven een grotere rendementshelling dan de data, maar een dividendhelling boven de 0,008 uit de data halen er nog geen twee op de honderd. De lange-termijncoëfficiënt vat hetzelfde bewijs samen in één getal, want minder dan 2% van de steekproeven haalt .
In de linkerhelft van de figuur gaat het om de hoek rechtsboven, waar de steekproeven liggen die zowel de rendementshelling als de dividendhelling van de data halen.
Source
show = slice(0, 3000)
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
ax = axes[0]
ax.scatter(br_null[show], bd_null[show], s=4, alpha=0.35,
           label="steekproeven onder de nulhypothese")
ax.scatter([0.0], [RHO_C * PHI_C - 1], marker="^", s=90, color="black", label="nulhypothese")
ax.scatter([SAMPLE_C["b_r"]], [SAMPLE_C["b_d"]], s=90, color=hap.plotting.COLORS[1],
           label="Cochrane 1927-2004")
ax.axvline(SAMPLE_C["b_r"], color=hap.plotting.COLORS[1], lw=0.9, ls="--")
ax.axhline(SAMPLE_C["b_d"], color=hap.plotting.COLORS[1], lw=0.9, ls="--")
ax.set_xlabel("Geschatte $b_r$ (rendement op $dp$)")
ax.set_ylabel("Geschatte $b_d$ (dividendgroei op $dp$)")
ax.set_title("Onvoorspelbare rendementen: de gezamenlijke verdeling")
ax.legend(loc="lower right")

ax = axes[1]
ax.hist(blr_null, bins=np.linspace(-1.5, 2.0, 71), edgecolor="white")
ax.axvline(SAMPLE_C["b_lr"], color=hap.plotting.COLORS[1], lw=1.6, label="Cochrane: 1,09")
ax.set_xlabel("Geschatte $b_r^{lr} = b_r/(1-\\rho\\phi)$")
ax.set_ylabel("Aantal steekproeven")
ax.set_title("Lange-termijncoëfficiënt onder de nulhypothese")
ax.legend()
plt.show()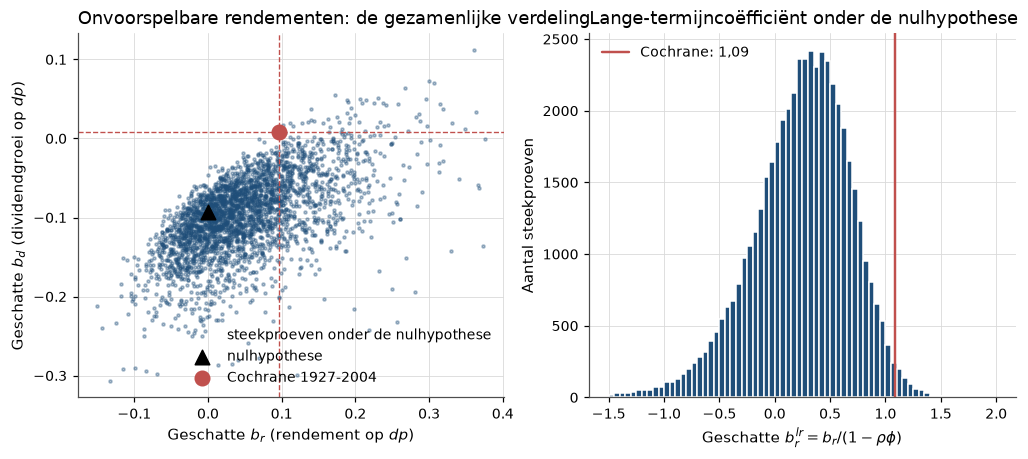
Figure 1:Links: 3000 van de 50 000 gesimuleerde steekproeven van 78 jaar met onvoorspelbare rendementen. Rechts van de verticale lijn liggen veel steekproeven, boven de horizontale vrijwel geen. Rechts: de lange-termijncoëfficiënt vat en samen in één getal, en is daarom een krachtigere toets dan de rendementshelling alleen.
De wolk ligt schuin, omdat dezelfde dividendschok via in het rendement en in de dividendgroei terechtkomt, zodat een steekproef met een toevallig hoge ook een hoge heeft. Een te lage verschuift de wolk alleen naar rechts, want volgens drijft hij op en laat hij vrijwel ongemoeid. Daardoor ligt het zwaartepunt niet op , en die verschuiving is de Stambaugh-bias, die de volgende cel naast (13) legt.
sigma_uv = cov_shocks[0, 1] - RHO_C * SD_DP**2        # Cov(eps_r, eps_dp) from the identity
stambaugh = -(sigma_uv / SD_DP**2) * (1 + 3 * PHI_C) / T_C
pd.DataFrame(
    {"waarde": [br_null.mean(), stambaugh, phi_null.mean() - PHI_C, -(1 + 3 * PHI_C) / T_C]},
    index=["gemiddelde b_r-dak onder b_r = 0", "Stambaugh-formule",
           "gemiddelde phi-dak - phi", "Kendall: -(1 + 3 phi)/T"],
).round(4)De simulatie geeft een bias van ongeveer 0,05, en de formule voorspelt 0,044, iets minder. Het verschil komt van de benadering voor de bias in , die bij dicht bij één de werkelijke bias onderschat.
5.2Met echte voorspelbaarheid: hoe vaak wint het gemiddelde?
Neem nu aan dat Cochrane gelijk heeft, met en dus , dicht bij de data. De ware éénjaars- is dan 5%, iets meer dan de 4% die de intuïtie en de theorie met ronde getallen aannamen. Een belegger begint na 20 jaar data, schat elk jaar opnieuw op alle data tot dan (een expanding window) en voorspelt het volgende jaar. We tellen hoe vaak hij na jaar een negatieve heeft, met een geschatte en met de ware helling.
def oos_r2_sim(n_samples, n_years, b_r=0.10, burn_in=20):
    """OOS R^2 of expanding-window OLS forecasts vs the expanding mean, per simulated sample."""
    dp, _, r = simulate_var(n_samples, n_years, b_r=b_r)
    x = dp[:, :-1]
    n_obs = np.arange(1, n_years + 1)[burn_in - 1:-1]   # years of data at each forecast date

    def mean_up_to_t(a):
        """Mean of a over years 1..t, for every forecast date t at once (expanding window)."""
        return np.cumsum(a, axis=1)[:, burn_in - 1:-1] / n_obs

    mx, my = mean_up_to_t(x), mean_up_to_t(r)
    beta = (mean_up_to_t(x * r) - mx * my) / (mean_up_to_t(x * x) - mx**2)   # OLS slope on data up to t
    alpha = my - beta * mx                                                  # OLS intercept on data up to t
    target, x_now = r[:, burn_in:], x[:, burn_in:]   # the return to forecast and dp at t
    sse_mean = ((target - my) ** 2).sum(axis=1)
    r2_est = 1 - ((target - alpha - beta * x_now) ** 2).sum(axis=1) / sse_mean
    r2_known = 1 - ((target - b_r * x_now) ** 2).sum(axis=1) / sse_mean
    return r2_est, r2_known


var_dp = SD_DP**2 / (1 - PHI_C**2)
var_eps_r = SD_D**2 + RHO_C**2 * SD_DP**2 - 2 * RHO_C * cov_shocks[0, 1]
print(f"ware een-jaars R^2: {0.10**2 * var_dp / (0.10**2 * var_dp + var_eps_r):.2%}")

horizons_T = [40, 60, 80, 100, 150, 200, 300]
oos_rows, r2_draws = [], {}
for T_years in horizons_T:
    r2_est, r2_known = oos_r2_sim(10_000, T_years)
    r2_draws[T_years] = r2_est
    oos_rows.append({"T (jaren)": T_years, "P(OOS R2 < 0), geschat": np.mean(r2_est < 0),
                     "P(OOS R2 < 0), ware helling": np.mean(r2_known < 0),
                     "mediaan OOS R2": np.median(r2_est)})
oos_table = pd.DataFrame(oos_rows).set_index("T (jaren)").round(3)
oos_table
ware een-jaars R^2: 5.07%
Met een geschatte helling verliest de voorspeller na 60 tot 80 jaar in ongeveer de helft van de steekproeven van het gemiddelde. Met de ware helling gebeurt dat maar in 5 tot 8% van de steekproeven. De figuur toont links de verdeling van na 60 en na 150 jaar en rechts hoe de kans op verlies daalt met de lengte van de steekproef.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))
for T_years, colour in [(60, hap.plotting.COLORS[0]), (150, hap.plotting.COLORS[2])]:
    axes[0].hist(100 * r2_draws[T_years], bins=np.linspace(-30, 25, 56), histtype="step",
                 lw=1.6, color=colour, label=f"T = {T_years} jaar")
axes[0].axvline(0, color="black", lw=1.0)
axes[0].set_xlabel("$R^2$ buiten de steekproef (procent)")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].set_title("Echte voorspelbaarheid, gemeten buiten de steekproef")
axes[0].legend()

axes[1].plot(oos_table.index, oos_table["P(OOS R2 < 0), geschat"], marker="o",
             label="helling geschat (expanding window)")
axes[1].plot(oos_table.index, oos_table["P(OOS R2 < 0), ware helling"], marker="s",
             label="ware helling bekend")
axes[1].axhline(0.5, color="grey", lw=0.8, ls=":")
axes[1].set_xlabel("Lengte van de steekproef (jaren, eerste 20 om te schatten)")
axes[1].set_ylabel("Kans op negatieve $R^2$ buiten de steekproef")
axes[1].set_title("Hoeveel data er nodig zijn")
axes[1].legend()
plt.show()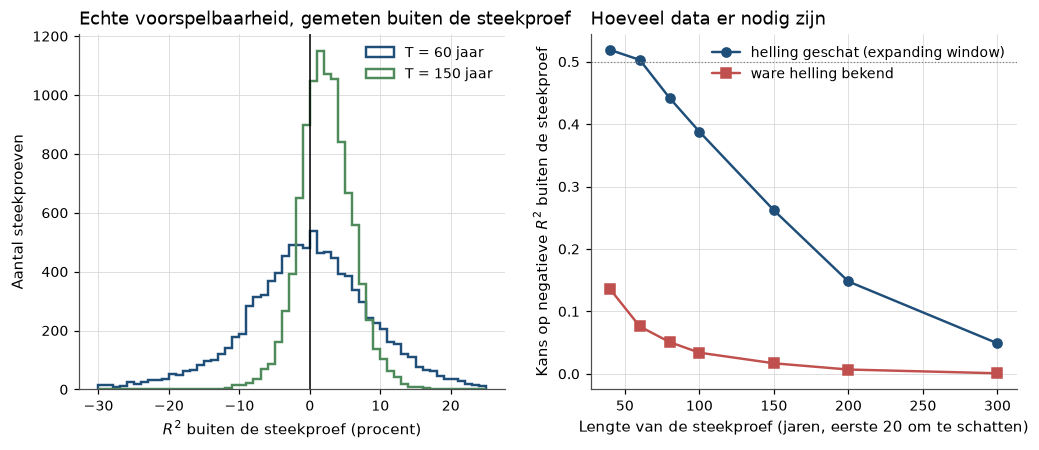
Figure 2:Een wereld waarin de dividend-prijsratio per constructie 5% van het éénjaarsrendement voorspelt. Links de buiten de steekproef na 60 en na 150 jaar, rechts de kans dat de voorspeller het gemiddelde niet verslaat. Met 60 tot 80 jaar data is dat kruis of munt, en na twee eeuwen nog een op de zeven.
De voorspeller is echt, maar met 60 tot 80 jaar data kost het schatten van zijn helling meer dan hij oplevert. Een negatieve is dus nauwelijks bewijs tegen voorspelbaarheid, en ook Cochrane vond in zijn simulaties dat een even slechte prestatie buiten de steekproef als in de data geen uitzondering is.
6Replicatie op echte data
6.1De data
De replicaties gebruiken twee reeksen. De eerste, voor Fama en French en voor Goyal en Welch, is het logrendement van de S&P 500 inclusief dividend, met daarnaast het overrendement boven de rente, ook in logs. De tweede volgt Cochrane, die de dividend-prijsratio afleidt uit het rendement met en zonder dividend, en maakt alles reëel.
gw_a = hap_data.goyal_welch("annual")
gw_a.index = gw_a.index.year
gw_m = hap_data.goyal_welch("monthly")

# total S&P return: CRSP from 1926, Shiller index + dividends before (as Goyal-Welch do)
ret_a = gw_a["CRSP_SPvw"].fillna((gw_a["Index"] + gw_a["D12"]) / gw_a["Index"].shift(1) - 1)
log_ret_a = np.log1p(ret_a)
eq_prem_a = log_ret_a - np.log1p(gw_a["Rfree"])

# Cochrane (2008), footnote 5: dividends from returns with and without dividends
div_yield = (1 + gw_a["CRSP_SPvw"]) / (1 + gw_a["CRSP_SPvwx"]) - 1
price_idx = (1 + gw_a["CRSP_SPvwx"]).cumprod()
cochrane = pd.DataFrame(
    {
        "r": np.log1p(gw_a["CRSP_SPvw"]) - np.log1p(gw_a["infl"]),
        "dd": np.log(div_yield * price_idx).diff() - np.log1p(gw_a["infl"]),
        "dp": np.log(div_yield),
        "rex": np.log1p(gw_a["CRSP_SPvw"]) - np.log1p(gw_a["Rfree"]),
    }
)
cochrane.loc[1926:].describe().round(4)Het reële logrendement heeft over 1926–2025 een gemiddelde van 7% en een standaarddeviatie van 19%, en de log dividend-prijsratio schommelt met een standaarddeviatie van 0,47 rond zijn gemiddelde. Beide liggen dicht bij de orden van grootte waarmee de simulatie is gekalibreerd.
6.2Fama en French: de stijgt met de horizon
Ook in onze data stijgt de met de horizon als we het logrendement over één tot vier jaar regresseren op de dividend-prijsratio van het jaar ervoor. De tabel toont beide -waarden en de uit tabel 3 van Fama en French.
def hodrick_tstat(r, x, h):
    """Hodrick (1992) 1B t-statistic for the slope of sum_{j=1..h} r_{t+j} on x_t.

    ``r`` and ``x`` are annual Series on the same integer index, already cut to the
    sample (returns for the years in the sample, predictor one year earlier).
    """  # TODO: naar hap.stats
    frame = pd.concat([r.rename("r"), x.rename("x")], axis=1)
    frame["y"] = frame["r"].rolling(h).sum().shift(-h)
    frame["x_sum"] = frame["x"].rolling(h).sum()
    frame["r_next"] = frame["r"].shift(-1)
    long = frame.dropna(subset=["y", "x"])
    X = np.column_stack([np.ones(len(long)), long["x"]])
    beta = np.linalg.lstsq(X, long["y"].to_numpy(), rcond=None)[0]
    one = frame.dropna(subset=["x_sum", "r_next"])
    u = (one["r_next"] - one["r_next"].mean()).to_numpy()
    Z = np.column_stack([np.full(len(one), float(h)), one["x_sum"]])
    xtx_inv = np.linalg.inv(X.T @ X)
    cov = xtx_inv @ ((Z * u[:, None] ** 2).T @ Z) @ xtx_inv
    return beta[1] / np.sqrt(cov[1, 1])


def ff_table(first, last, horizons=(1, 2, 3, 4)):
    """Fama-French (1988) style regressions of h-year log returns on D/P, one row per horizon."""
    r = log_ret_a.loc[first - 1:last]           # the first-1 return is never a target
    x = (gw_a["D12"] / gw_a["Index"]).loc[first - 1:last - 1]
    table = hap.long_horizon_regression(r, x, horizons=list(horizons))
    table["t (Hodrick 1B)"] = [hodrick_tstat(r, x, h) for h in horizons]
    return table.rename(columns={"beta": "helling", "tstat": "t (Hansen-Hodrick)"})


ff_1941 = ff_table(1941, 1986)
ff_1941["R2 Fama-French"] = [0.14, 0.35, 0.51, 0.64]
ff_1941[["helling", "t (Hansen-Hodrick)", "t (Hodrick 1B)", "r2", "R2 Fama-French", "nobs"]].round(3)Geslaagd, want over 1941–1986 stijgt de met de horizon tot 0,64 op vier jaar, ruim boven de 0,5 die we vooraf verwachtten, en ligt hij bij elke horizon dicht bij die van Fama en French.
De twee -waarden vertellen wel een ander verhaal. De van Hansen en Hodrick verdubbelt met de horizon tot 6,1, maar de Hodrick-1B- daalt licht, van 2,8 naar 2,4 op vier jaar. Het extra bewijs van de lange horizon is dus overlap, en de informatie zat al in het eerste jaar.
Dezelfde regressies over langere steekproeven laten zien hoe stabiel het patroon is.
pd.concat(
    {f"{a}-{b}": ff_table(a, b)[["helling", "t (Hansen-Hodrick)", "t (Hodrick 1B)", "r2"]]
     for a, b in [(1927, 1986), (1927, 2025), (1950, 2025)]},
    names=["steekproef", "horizon (jaren)"],
).round(3)Over de volle steekproef tot 2025 blijft er weinig van over, want de zakt naar 0,06 en de Hodrick- naar 1,3 bij een horizon van vier jaar. Na de oorlog is het patroon er nog, maar zwakker, en de Hodrick- zakt vanaf drie jaar onder de twee. De identiteit geldt nog steeds, maar de dividend-prijsratio ligt sinds 1990 op een lager niveau, omdat bedrijven dividend vervangen door de inkoop van eigen aandelen. Een regressie op niveaus ziet dat als een grote afwijking die nooit wordt gecorrigeerd.
6.3Cochrane: rendementen, dividenden en de identiteit
Ook op onze data voorspelt de ratio het rendement en niet de dividendgroei. De functie hieronder schat de drie regressies van Cochrane en de afgeleide grootheden over een gekozen steekproef, eerst over 1927–2004.
def predictive_ols(y, x):
    """OLS of y_{t+1} on x_t with heteroskedasticity-robust (HC0) t-statistics."""
    frame = pd.concat([y.shift(-1).rename("y"), x.rename("x")], axis=1).dropna()
    fit = sm.OLS(frame["y"], sm.add_constant(frame["x"])).fit(cov_type="HC0")
    return fit


def cochrane_table(first, last):
    """Cochrane (2008) Table 1/2: forecasts over first..last on dp from the year before."""
    sub = cochrane.loc[first - 1:last]
    x = sub["dp"].loc[: last - 1]
    fits = {name: predictive_ols(sub[col], x) for name, col in
            [("r", "r"), ("dd", "dd"), ("dp", "dp"), ("excess r", "rex")]}
    rho = np.exp(-sub["dp"].mean()) / (1 + np.exp(-sub["dp"].mean()))
    rows = {name: {"b": f.params["x"], "t": f.tvalues["x"], "R2 (%)": 100 * f.rsquared,
                   "n": int(f.nobs)} for name, f in fits.items()}
    table = pd.DataFrame(rows).T
    b_r, b_d, phi = table.loc["r", "b"], table.loc["dd", "b"], table.loc["dp", "b"]
    resid = pd.concat([fits["r"].resid, fits["dp"].resid], axis=1)
    s_uv = np.cov(resid.T)[0, 1] / np.var(fits["dp"].resid, ddof=1)
    extra = pd.Series(
        {"rho": rho, "1 - rho*phi + b_d": 1 - rho * phi + b_d,
         "b_r^lr": b_r / (1 - rho * phi), "b_d^lr": b_d / (1 - rho * phi),
         "b_r Stambaugh-gecorrigeerd": b_r + s_uv * (1 + 3 * phi) / table.loc["r", "n"]}
    )
    return table, extra


tab_2004, extra_2004 = cochrane_table(1927, 2004)
tab_2004["Cochrane b"] = [0.097, 0.008, 0.941, np.nan]
tab_2004["Cochrane t"] = [1.92, 0.18, np.nan, np.nan]
tab_2004.round(3)Geslaagd, want op de steekproef van Cochrane liggen onze hellingen binnen een vijfde standaardfout van de zijne, ruim binnen de marges die we vooraf stelden, en ook hier is de dividendhelling nul. De tweede cel zet de afgeleide grootheden naast die van Cochrane en herhaalt alles tot 2025.
tab_2025, extra_2025 = cochrane_table(1927, 2025)


def summary_column(table, extra):
    """Stack slopes, the return t-statistic and the derived quantities into one column."""
    return pd.concat([table["b"].rename(lambda s: f"b ({s})"),
                      pd.Series({"t (r)": table.loc["r", "t"], "t (dd)": table.loc["dd", "t"]}),
                      extra])


pd.DataFrame(
    {"1927-2004": summary_column(tab_2004, extra_2004),
     "Cochrane (2008)": pd.Series({"b (r)": 0.097, "b (dd)": 0.008, "b (dp)": 0.941,
                                   "t (r)": 1.92, "t (dd)": 0.18,
                                   "rho": 0.9638, "b_r^lr": 1.09, "b_d^lr": 0.09}),
     "1927-2025": summary_column(tab_2025, extra_2025)}
).round(3)De identiteit sluit tot op 0,004, en zegt dat de variantie van de ratio vrijwel volledig uit verwachte rendementen komt. De nulhypothese vroeg om , en de data geven nul.
De Stambaugh-correctie haalt ruim 0,04 van af, bijna de helft, zoals (13) voorspelde. Op de dividendhelling is de correctie verwaarloosbaar, omdat dividendschokken bijna ongecorreleerd zijn met schokken in . Met de getallen van Cochrane is , zodat de bias is. Ook daarom levert de dividendregressie het sterkere bewijs, want ze is vrijwel niet vertekend.
Tot 2025 verzwakt de rendementsregressie (, ) en stijgt naar 0,96, omdat de ratio sinds het midden van de jaren negentig laag is gebleven. De dividendhelling blijft nul, zodat de beweging in nog steeds niet van dividenden komt. Wel vergroot een dichter bij de ruimte voor een samenhangende nulhypothese, en dat is de zwakke plek die Cochrane zelf aanwees.
6.4Goyal en Welch: buiten de steekproef tegen het gemiddelde
Ook in onze data verslaat vrijwel geen voorspeller buiten de steekproef het gemiddelde. Voor zestien voorspellers uit de data van Goyal en Welch schatten we vanaf 1965 elk jaar opnieuw een regressie van het overrendement in logs op de voorspeller van vorig jaar. Daarna vergelijken we de buiten de steekproef met hun tabel 1.
PREDICTORS = ["dp", "dy", "ep", "de", "svar", "b/m", "ntis", "eqis",
              "tbl", "lty", "ltr", "tms", "dfy", "dfr", "infl", "ik"]
GW_PUBLISHED = {"dp": -3.69, "dy": -6.68, "ep": -1.10, "de": -4.99, "svar": -2.44,
                "b/m": -12.71, "ntis": -6.79, "eqis": -1.00, "tbl": -4.90, "lty": -12.57,
                "ltr": -18.38, "tms": -2.96, "dfy": -4.15, "dfr": -2.82, "infl": -3.56,
                "ik": -1.77}


def oos_forecasts(y, x, first, last, sign=None):
    """Expanding-window OLS forecasts of y_t from x_{t-1} and the expanding mean benchmark.

    With ``sign`` set, apply Campbell-Thompson: slope with the wrong sign -> use the
    mean; negative forecasts (and negative means) -> zero.
    """
    data = pd.concat([y.rename("y"), x.shift(1).rename("x")], axis=1).dropna()
    rows = []
    for year in data.loc[first:last].index:
        train = data.loc[: year - 1]
        slope, intercept = np.polyfit(train["x"], train["y"], 1)
        forecast, mean = intercept + slope * data.loc[year, "x"], train["y"].mean()
        if sign is not None:
            forecast = mean if np.sign(slope) != sign else forecast
            forecast, mean = max(forecast, 0.0), max(mean, 0.0)
        rows.append((year, data.loc[year, "y"], forecast, mean))
    return pd.DataFrame(rows, columns=["year", "y", "model", "mean"]).set_index("year")


def oos_stats(fc):
    """OOS R^2 (eq. oos) and the one-sided Clark-West t-statistic (eq. cw)."""
    err_model, err_mean = fc["y"] - fc["model"], fc["y"] - fc["mean"]
    r2 = 1 - (err_model**2).sum() / (err_mean**2).sum()
    f = err_mean**2 - (err_model**2 - (fc["mean"] - fc["model"]) ** 2)
    return r2, f.mean() / (f.std(ddof=1) / np.sqrt(len(f)))


gw_rows = {}
for name in PREDICTORS:
    r2_05, _ = oos_stats(oos_forecasts(eq_prem_a, gw_a[name], 1965, 2005))
    r2_25, cw_25 = oos_stats(oos_forecasts(eq_prem_a, gw_a[name], 1965, 2025))
    gw_rows[name] = {
        "OOS R2 1965-2005": 100 * r2_05,
        "OOS R2 1965-2005, gecorrigeerd": 100 * (1 - (1 - r2_05) * (41 - 1) / (41 - 2)),
        "Goyal-Welch, gecorrigeerd": GW_PUBLISHED[name],
        "OOS R2 1965-2025": 100 * r2_25,
        "Clark-West t": cw_25,
    }
gw_table = pd.DataFrame(gw_rows).T
same_sign = np.mean(np.sign(gw_table["OOS R2 1965-2005, gecorrigeerd"]) == np.sign(gw_table["Goyal-Welch, gecorrigeerd"]))
print(f"zelfde teken als Goyal-Welch: {same_sign:.0%} van de voorspellers")
gw_table.round(2)
zelfde teken als Goyal-Welch: 94% van de voorspellers
Goyal en Welch rapporteren een die, net als de gewone gecorrigeerde , is
gecorrigeerd voor de twee geschatte parameters, en de tabel doet hetzelfde. Geslaagd, want
over 1965–2005 is die gecorrigeerde waarde bij 15 van de 16 voorspellers negatief, zoals
we vooraf verwachtten, en in dezelfde orde als bij hen. De enige uitzondering is de
verhouding van investeringen tot kapitaal (ik), die in de bijgewerkte data positief
uitkomt, terwijl Goyal en Welch een negatieve waarde rapporteren.
Twintig jaar extra data veranderen het beeld nauwelijks. Ook over 1965–2025 verliest de
dividend-prijsratio van het gemiddelde, en alleen ik en, nipt, svar halen een
Clark-West- boven 1,65, de kritieke waarde van een eenzijdige toets.
De restricties van Campbell en Thompson passen we toe op vier van de voorspellers.
ct_rows = {}
for name in ["dp", "ep", "b/m", "tms"]:
    plain = oos_stats(oos_forecasts(eq_prem_a, gw_a[name], 1965, 2025))
    restricted = oos_stats(oos_forecasts(eq_prem_a, gw_a[name], 1965, 2025, sign=1))
    ct_rows[name] = {"OOS R2 zonder restricties": 100 * plain[0],
                     "OOS R2 met Campbell-Thompson": 100 * restricted[0],
                     "Clark-West t, met restricties": restricted[1]}
pd.DataFrame(ct_rows).T.round(2)De restricties helpen, want voor e/p halveert het verlies en voor b/m slinkt het, maar geen van de vier verslaat het gemiddelde. De volgende figuur laat zien in welke jaren de voorspellers hun voorsprong winnen en verliezen, en een stijgende lijn betekent dat het model beter voorspelde dan het gemiddelde.
Source
fig, ax = plt.subplots(figsize=(10, 4.4))
for name, colour in zip(["dp", "ep", "b/m", "tms", "ik"], hap.plotting.COLORS):
    fc = oos_forecasts(eq_prem_a, gw_a[name], 1965, 2025)
    delta = ((fc["y"] - fc["mean"]) ** 2 - (fc["y"] - fc["model"]) ** 2).cumsum()
    ax.plot(delta.index, delta, color=colour, label=name)
ax.axhline(0, color="black", lw=0.8)
ax.axvspan(1973, 1975, color="grey", alpha=0.2, lw=0)
ax.set_xlabel("Jaar")
ax.set_ylabel("Cumulatief SSE(gemiddelde) - SSE(model)")
ax.set_title("Goyal-Welch: stijgt de lijn, dan voorspelt het model beter")
ax.legend(ncol=5)
plt.show()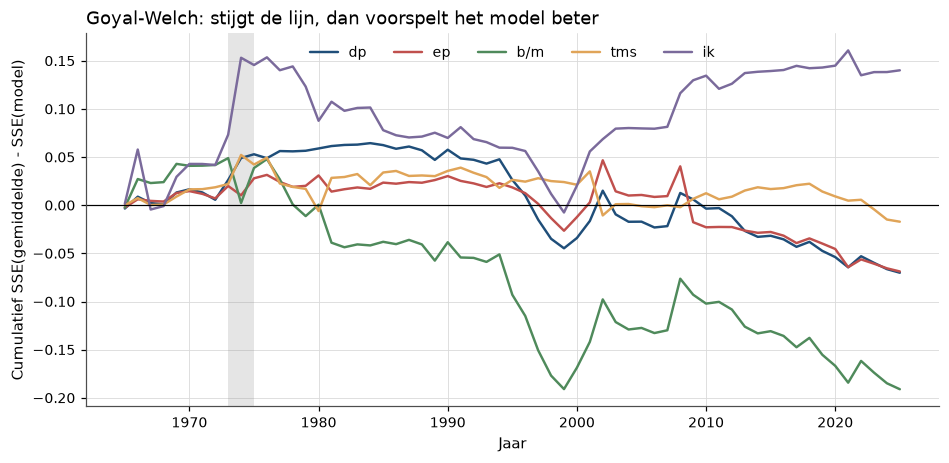
Figure 3:Cumulatief verschil in gekwadrateerde voorspelfouten tussen het historische gemiddelde en vijf voorspellende regressies voor het overrendement in logs. De regressies zijn vanaf 1965 geschat met een expanding window, en de grijze band markeert de oliecrisis van 1973–1975.
De dividend-prijsratio wint zijn voorsprong grotendeels in de oliecrisis en verliest hem in de hausse van de late jaren negentig. Lage ratio’s voorspelden toen een lage premie, die pas rond 2000–2002 kwam. Na 2008 zakken d/p en e/p opnieuw weg. De prestaties zitten dus in een paar jaren, en dat zijn niet steeds dezelfde, wat Goyal en Welch instabiliteit noemden.
6.5Ferreira en Santa-Clara: de som van de delen
Een voorspelling zonder geschatte helling heeft geen last van de schattingsfout waardoor de regressie in de simulatie zo vaak verloor. Het logrendement inclusief dividend is exact de som van de groei van de koers-winstverhouding, de groei van de winst en Ferreira & Santa-Clara (2011). Het eerste deel heeft een verwachting van ongeveer nul en het tweede benaderen we met een gemiddelde over twintig jaar. Het derde is zo traag dat de huidige waarde volstaat.
De voorspelling voor jaar is dus , met de gemiddelde log winstgroei over de laatste twintig jaar. In maanddata nemen we beide termen per maand. De te voorspellen grootheid is het logrendement inclusief dividend, en de voorspellingen beginnen in 1948.
def sop_oos(y, forecast, first, last, mean_from):
    """OOS R^2 and Clark-West t of a given forecast series (known at t-1) vs the expanding mean."""
    frame = pd.DataFrame({"y": y, "model": forecast.shift(1),
                          "mean": y.loc[mean_from:].expanding().mean().shift(1)})
    return oos_stats(frame.loc[first:last].dropna())


sop_annual = np.log(gw_a["E12"]).diff().rolling(20).mean() + np.log1p(gw_a["D12"] / gw_a["Index"])
sop_monthly = ((np.log(gw_m["E12"]) - np.log(gw_m["E12"].shift(240))) / 240
               + np.log1p(gw_m["D12"] / gw_m["Index"] / 12))
log_ret_m = np.log1p(gw_m["CRSP_SPvw"])

sop_rows = {}
for label, (first, last) in {"1948-2007": (1948, 2007), "1948-2025": (1948, 2025)}.items():
    r2_a, cw_a = sop_oos(log_ret_a, sop_annual, first, last, 1927)
    r2_m, cw_m = sop_oos(log_ret_m, sop_monthly, f"{first}-01", f"{last}-12", "1927-12")
    dp_reg = oos_stats(oos_forecasts(log_ret_a.loc[1927:], gw_a["dp"], first, last))
    sop_rows[label] = {"som van de delen, maand: OOS R2 (%)": 100 * r2_m, "som van de delen, maand: Clark-West t": cw_m,
                       "som van de delen, jaar: OOS R2 (%)": 100 * r2_a, "som van de delen, jaar: Clark-West t": cw_a,
                       "regressie op dp, jaar: OOS R2 (%)": 100 * dp_reg[0]}
sop_table = pd.DataFrame(sop_rows)
sop_table["Ferreira-Santa-Clara (1948-2007)"] = [1.32, np.nan, 13.43, np.nan, np.nan]
sop_table.round(2)Geslaagd, want over 1948–2007 geeft de som van de delen in maanddata dezelfde als Ferreira en Santa-Clara en in jaardata iets minder, en beide zijn positief, zoals we vooraf verwachtten. De Clark-West--waarden liggen ruim boven de kritieke waarde. Dezelfde dividend-prijsratio als regressor met een geschatte helling verliest over dezelfde jaren van het gemiddelde, zodat het verschil niet in de informatie zit maar in wat er geschat moet worden.
Tot 2025 halveert de ongeveer, zoals de auteurs al in de tweede helft van hun steekproef zagen, maar hij blijft positief en significant. Volgens (16) verdubbelt de maandelijkse uit de tabel, bij , ongeveer het verwachte portefeuillerendement.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. De Campbell-Shiller-identiteit maakte van de oude vraag of rendementen voorspelbaar zijn, een boekhoudkundige vraag met een scherp antwoord. De variantie van de dividend-prijsratio moet ergens vandaan komen, en de data wijzen één bron aan. Onze replicatie over 1927–2004 geeft een dividendhelling van nul en een rendementshelling van 0,10. Onder de nulhypothese van Cochrane komt minder dan 2% van de gesimuleerde steekproeven zo ver. Hetzelfde feit verwierp in Williams en het dividend discount model de constante discontovoet en verscheen in Shiller en LeRoy-Porter: excess volatility als overmatige volatiliteit.
Waar het breekt. Het model breekt in het gebruik. Over 1965–2025 heeft de dividend-prijsratio buiten de steekproef een van ongeveer −4%, en het lange-horizonpatroon van Fama en French verdwijnt zodra de steekproef tot 2025 doorloopt. De echte toets schat vanaf het begin van de reeks in de jaren 1870 en heeft dus ongeveer 150 jaar data, en ook bij die lengte verliest in de simulatie een echte voorspeller nog in een kwart van de steekproeven. Het verlies van de ratio past dus bij echte voorspelbaarheid, maar een methode die in een op de vier steekproeven van het gemiddelde verliest, is geen basis voor een pensioen. Alleen methoden die bijna niets schatten, zoals de som van de delen, winnen stabiel. Dat de discontovoet beweegt, is dus uitstekend gemeten, maar de helling waarmee de ratio het rendement voorspelt niet.
Risico of vergissing? De identiteit zegt dat de discontovoet beweegt, maar niet waarom, en twee lezingen verklaren dezelfde tabel. Volgens Fama en Cochrane is de verwachte premie hoog als beleggers arm zijn en risico slecht verdragen, dus in en na recessies. Een belegger die dan koopt, ontvangt een risicopremie. Volgens Shiller extrapoleren beleggers goede jaren, zodat prijzen doorschieten, en is de voorspelbaarheid de langzame correctie van die vergissing. Alleen een onafhankelijke meting kan de twee scheiden, bijvoorbeeld of hoge verwachte rendementen samengaan met hoog marginaal nut of met aantoonbaar foute verwachtingen. Cochrane maakte van de eerste lezing het programma van zijn rede Cochrane (2011), en het debat komt terug in Fama, Shiller en “Discount Rates”.
Wat er daarna kwam. Het eerste moment van rendementen is moeilijk te voorspellen. Het tweede moment is daarentegen persistent, goed gemeten en goed voorspelbaar, en daarover gaat ARCH, GARCH, realized volatility en de VIX.
8Oefeningen
Solution to Exercise 1
(1) Het nieuwe rendement is , terwijl , en niet veranderen. De dividendhelling wordt en de rendementshelling . De identiteit klopt, want .
(2) Delen door geeft en , met een verschil van één. De code rekent het na.
dd_alt = np.array([0.02, 0.06, -0.03])
ell_alt = dp_toy[:-1] - rho_toy * dp_toy[1:] + dd_alt
bd_alt, br_alt = ols_slope(dd_alt, x_toy), ols_slope(ell_alt, x_toy)
pd.Series({"rendement jaar 3": ell_alt[-1], "helling b_d": bd_alt, "helling b_r": br_alt,
           "b_r^lr": br_alt / denom_toy, "b_d^lr": bd_alt / denom_toy}).round(4)
rendement jaar 3 -0.0836
helling b_d -0.2500
helling b_r -0.0180
b_r^lr -0.0776
b_d^lr -1.0776
dtype: float64Zodra een goedkope markt lage dividendgroei voorspelt, verklaart dividendgroei meer dan alle beweging in de ratio, en voorspelt de ratio het rendement zelfs licht de verkeerde kant op. In de echte data geldt juist het omgekeerde.
:::{exercise}
:label: ex-voorspelbaarheid-2

**De $R^2$ op lange horizon in het VAR.** Neem het VAR [](#eq-voorspelbaarheid-var) met
$b_r = 0{,}10$, $\phi = 0{,}941$, $\rho = 0{,}9638$ en de schokken uit tabel 2 van
Cochrane.

1. Leid af dat $\Cov(\ell_{t+1}, \ell_{t+1+j}) = b_r\phi^{j-1}\Cov(dp_{t+1}, \ell_{t+1})$
   voor $j \ge 1$, en schrijf daarmee $\Var(\ell^{(k)}_t)$ als functie van $b_r$, $\phi$,
   $\Var(dp)$, $\Cov(\varepsilon^r, \varepsilon^{dp})$ en $\Var(\varepsilon^r)$.
2. Bereken de populatie-$R^2(k)$ uit [](#eq-voorspelbaarheid-r2k) voor
   $k = 1, 2, 5, 10$, en vergelijk met de naïeve formule
   $R^2(1)[(1-\phi^k)/(1-\phi)]^2/k$.
3. Controleer (2) met een simulatie van één lang pad van 200 000 jaar.
Solution to ex-voorspelbaarheid-2
(1) Voor is , en de laatste schok is onafhankelijk van . Dus . Uit de AR(1) volgt , zodat , met
Tel de covarianties op over alle paren binnen het venster van jaar: , met . Omdat sterk negatief is, is , zodat rendementen negatief autogecorreleerd zijn, het discontovoeteffect van Fama en French.
(2) en (3) De cel rekent de formule uit en vergelijkt de uitkomst met de naïeve versie en met één lang gesimuleerd pad.
b_ex = 0.10
var_dp_ex = SD_DP**2 / (1 - PHI_C**2)
s_r_dp = cov_shocks[0, 1] - RHO_C * SD_DP**2
var_r_ex = b_ex**2 * var_dp_ex + var_eps_r
cov_dp1_r1 = PHI_C * b_ex * var_dp_ex + s_r_dp


def r2_horizon(k):
    """Population R^2 of k-year returns on dp in the VAR."""
    var_k = k * var_r_ex + 2 * sum((k - j) * b_ex * PHI_C ** (j - 1) * cov_dp1_r1 for j in range(1, k))
    return (b_ex * (1 - PHI_C**k) / (1 - PHI_C)) ** 2 * var_dp_ex / var_k


dp_long, _, r_long = simulate_var(1, 200_000, b_r=b_ex)
dp_long, r_long = pd.Series(dp_long[0, :-1]), pd.Series(r_long[0])
rows_ex1 = {}
for k in (1, 2, 5, 10):
    cum_r = r_long.rolling(k).sum().shift(-(k - 1))
    ok = cum_r.notna()
    rows_ex1[k] = {"R2 formule": r2_horizon(k),
                   "R2 naief": r2_horizon(1) * ((1 - PHI_C**k) / (1 - PHI_C)) ** 2 / k,
                   "R2 simulatie": np.corrcoef(dp_long[ok], cum_r[ok])[0, 1] ** 2}
pd.DataFrame(rows_ex1).T.rename_axis("horizon k").round(4)De formule en de simulatie liggen binnen enkele tienden van een procentpunt van elkaar, en de formule ligt boven de naïeve berekening, omdat de negatieve autocorrelatie die uit volgt de groei van remt. De stijgende volgt dus volledig uit , en de correlatie van de schokken, en de lange horizon voegt geen informatie toe.
:::{exercise}
:label: ex-voorspelbaarheid-3

**Overrendementen en de naoorlogse steekproef.** Herhaal de tabel van Cochrane voor
1947–2025 en rapporteer $\hat b_r$ voor reële rendementen en voor overrendementen,
$\hat b_d$, $\hat\phi$, de Stambaugh-gecorrigeerde $\hat b_r$ en $\hat b_r^{lr}$.
Simuleer daarna de nulhypothese van Cochrane met de $\hat\phi$ en de lengte van deze
steekproef, en rapporteer $P(\hat b_d > \text{schatting})$. Blijft de dividendhelling ook
na de oorlog uit?
Solution to ex-voorspelbaarheid-3
tab_post, extra_post = cochrane_table(1947, 2025)
n_post = int(tab_post.loc["r", "n"])
phi_post = tab_post.loc["dp", "b"]

dp_p, dd_p, r_p = simulate_var(20_000, n_post, b_r=0.0, phi=phi_post)
bd_sim_post = slopes(dd_p, dp_p[:, :-1])
br_sim_post = slopes(r_p, dp_p[:, :-1])

print(f"n = {n_post}, phi-dak = {phi_post:.3f}, "
      f"b_d onder de nulhypothese = {RHO_C * phi_post - 1:.3f}")
print(f"P(b_r-dak > schatting) onder de nulhypothese: "
      f"{np.mean(br_sim_post > tab_post.loc['r', 'b']):.3f}")
print(f"P(b_d-dak > schatting) onder de nulhypothese: "
      f"{np.mean(bd_sim_post > tab_post.loc['dd', 'b']):.3f}")
pd.concat([tab_post[["b", "t", "R2 (%)"]], extra_post.to_frame("b")]).round(3)
n = 79, phi-dak = 0.978, b_d onder de nulhypothese = -0.057
P(b_r-dak > schatting) onder de nulhypothese: 0.307
P(b_d-dak > schatting) onder de nulhypothese: 0.024
Na de oorlog is , zodat de nulhypothese maar eist. De rendementsregressie is net niet significant (, ) en halveert na de Stambaugh-correctie. De dividendhelling is licht positief, wat onder de nulhypothese in ongeveer 2% van de steekproeven voorkomt, zodat ook na de oorlog de dividendvoorspelling uitblijft. Bij worden en allebei groot, terwijl hun verschil één blijft. Hoe dichter bij ligt, hoe kleiner de dividendhelling die de nulhypothese eist, en hoe zwakker het argument van Cochrane dus wordt.
- Fama, E. F., & French, K. R. (1988). Dividend Yields and Expected Stock Returns. Journal of Financial Economics, 22(1), 3–25. 10.1016/0304-405X(88)90020-7
- Campbell, J. Y., & Shiller, R. J. (1988). The Dividend-Price Ratio and Expectations of Future Dividends and Discount Factors. Review of Financial Studies, 1(3), 195–228. 10.1093/rfs/1.3.195
- Stambaugh, R. F. (1999). Predictive Regressions. Journal of Financial Economics, 54(3), 375–421. 10.1016/S0304-405X(99)00041-0
- Hodrick, R. J. (1992). Dividend Yields and Expected Stock Returns: Alternative Procedures for Inference and Measurement. Review of Financial Studies, 5(3), 357–386. 10.1093/rfs/5.3.351
- Valkanov, R. (2003). Long-Horizon Regressions: Theoretical Results and Applications. Journal of Financial Economics, 68(2), 201–232. 10.1016/S0304-405X(03)00065-5
- Welch, I., & Goyal, A. (2008). A Comprehensive Look at the Empirical Performance of Equity Premium Prediction. Review of Financial Studies, 21(4), 1455–1508. 10.1093/rfs/hhm014
- Cochrane, J. H. (2008). The Dog That Did Not Bark: A Defense of Return Predictability. Review of Financial Studies, 21(4), 1533–1575. 10.1093/rfs/hhm046
- Cochrane, J. H. (2011). Presidential Address: Discount Rates. Journal of Finance, 66(4), 1047–1108. 10.1111/j.1540-6261.2011.01671.x
- Campbell, J. Y., & Thompson, S. B. (2008). Predicting Excess Stock Returns Out of Sample: Can Anything Beat the Historical Average? Review of Financial Studies, 21(4), 1509–1531. 10.1093/rfs/hhm055
- Ferreira, M. A., & Santa-Clara, P. (2011). Forecasting Stock Market Returns: The Sum of the Parts Is More Than the Whole. Journal of Financial Economics, 100(3), 514–537. 10.1016/j.jfineco.2011.02.003
- Clark, T. E., & West, K. D. (2007). Approximately Normal Tests for Equal Predictive Accuracy in Nested Models. Journal of Econometrics, 138(1), 291–311. 10.1016/j.jeconom.2006.05.023
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD