

Kyle, Glosten-Milgrom en liquiditeit
1Overzicht
Dit college vraagt hoe private informatie via de handel in de prijs komt, en of beleggers betaald krijgen voor de kosten die dat meebrengt. Een market maker die weet dat een deel van zijn klanten meer weet, moet een spread en een prijsimpact rekenen, zodat de prijs de informatie geleidelijk opneemt. Illiquiditeit gaat samen met hogere verwachte en lagere gelijktijdige rendementen, maar de premie op liquiditeitsrisico is na publicatie niet meer te zien.
We leiden de spread van Glosten en Milgrom af en het evenwicht van Kyle, met één en met vele handelsronden.
We vertalen die theorie met de maten van Roll en Amihud naar dagkoersen, en volgen hoe liquiditeit als niveau en als risico in verwachte rendementen komt.
We simuleren hoe vaak de Roll-maat in een kwartaal of een jaar niet te berekenen is.
We repliceren op vijftig grote Amerikaanse aandelen dat illiquiditeit piekt in 2008 en maart 2020 en samengaat met lage marktrendementen Amihud (2002), en op de reeks van Pástor en Stambaugh dat liquiditeit in crisismaanden instort.
Tot het midden van de jaren tachtig was de prijs in de theorie een getal dat “de markt” zette, zonder bied- of laatkoers en zonder een handelaar die hem noteerde. Glosten en Milgrom Glosten & Milgrom (1985) lieten in 1985 zien dat een concurrerende market maker (een handelaar die altijd bereid is te kopen en te verkopen) toch een spread moet rekenen. De reden is dat een deel van zijn tegenpartijen beter geïnformeerd is. Kyle Kyle (1985) liet in hetzelfde jaar zien hoe een insider zijn informatie verstopt achter ongeïnformeerde order flow (de som van alle koop- en verkooporders). Beide modellen zijn theorieën met toetsbare voorspellingen, maar de empirie die volgde, van Roll Roll (1984) tot Pástor en Stambaugh Pástor & Stambaugh (2003), maakte van liquiditeit een risicofactor en daarmee een feit dat nog op een verklaring wacht. Santa-Clara zet dat feit in zijn lijst van wat we weten zo neer Santa-Clara (2026):
Liquidity is priced, and it disappears when you need it.
2Intuïtie: waarom zou dit waar zijn?
Denk aan een handelaar die iedereen bedient die wil kopen of verkopen. De meeste klanten handelen om redenen die niets met de waarde van het aandeel te maken hebben, zoals een pensioenfonds dat geld nodig heeft. Een klein deel weet iets, en de handelaar kan de groepen niet uit elkaar houden. Verkoopt hij aan elke koper tegen de gemiddelde waarde, dan verliest hij stelselmatig aan de geïnformeerde kopers, want die kopen juist als het aandeel meer waard is.
Hij verkoopt daarom tegen de waarde gegeven dat iemand wil kopen, en koopt tegen de waarde gegeven dat iemand wil verkopen. Het verschil is geen winstmarge, maar een premie die de ongeïnformeerde klanten betalen voor wat de handelaar aan de geïnformeerde verliest. Na een reeks kooporders gelooft hij in goed nieuws, zodat zijn koersen omhoog schuiven en de spread kleiner wordt naarmate hij zekerder is.
Kyle voegde de strategie van de insider toe. Een insider die de waarde kent, wil veel kopen, maar elke extra order drijft de koers op en verraadt hem. Hij verstopt zijn orders daarom tussen die van de ongeïnformeerde handelaren, en hoe meer ruis er is, hoe meer hij kan kopen zonder op te vallen. Zijn winst komt uit de zak van de ongeïnformeerde handelaren.
Als handelen zo geld kost, vragen beleggers voor illiquide aandelen een hoger rendement. Liquiditeit verdwijnt bovendien voor iedereen tegelijk, zoals in 1987, bij de val van LTCM in 1998 (VaR, RiskMetrics en LTCM), in 2008 en in maart 2020, en dus precies wanneer beleggers moeten verkopen. We verwachten daarom dat de spread het grootst is bij de grootste onzekerheid en met elke order krimpt. Verder verwachten we dat illiquide aandelen gemiddeld meer opleveren en dat koersen dalen in een maand waarin de liquiditeit onverwacht opdroogt.
3Toy-voorbeeld: één market maker, één order, één insider
De eerste codecel laadt de pakketten die het hele college gebruikt.
import io

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import requests
from scipy import stats

import hap
from hap import cache as hap_cache
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)3.1Glosten-Milgrom met één transactie
| grootheid | waarde |
|---|---|
| waarde van het aandeel morgen | of euro, elk met kans |
| geïnformeerde handelaren | fractie , kopen bij en verkopen bij |
| ongeïnformeerde handelaren | kopen of verkopen met kans |
| market maker | risiconeutraal, zonder kosten, verdient door concurrentie verwacht niets |
Omdat de market maker verwacht niets verdient, is zijn laatkoers de verwachte waarde gegeven een kooporder en zijn biedkoers de verwachte waarde gegeven een verkooporder. Met de regel van Bayes volgen die koersen in vijf stappen.
De kans op een koop is als de waarde hoog is en als ze laag is, zodat .
Dan is en .
De laatkoers is en de biedkoers , dus de spread is .
Na een koop is het oordeel , zodat een volgende koop kans heeft, waarvan bij een hoge waarde. De laatkoers wordt dan en de biedkoers .
De verwachte volgende transactieprijs is , gelijk aan de huidige.
De spread krimpt dus van 0,80 naar 0,77 euro zodra de market maker iets heeft geleerd, en de prijs die we na één koop verwachten, is de prijs van nu. Die tweede eigenschap heet de martingaaleigenschap.
3.2Kyle met één handelsronde
| grootheid | waarde |
|---|---|
| liquidatiewaarde | normaal, verwachting euro, standaarddeviatie euro |
| order van de noise traders | normaal, verwachting nul, standaarddeviatie aandelen |
| insider | kent en kiest zijn order |
| market maker | ziet alleen de totale order flow en zet één prijs |
Het evenwicht van Kyle nemen we hier over zonder afleiding, want de afleiding volgt pas in de theorie. De insider koopt aandelen per euro dat de waarde boven ligt, en de prijs stijgt euro per aandeel order flow.
Hier is en , zodat een order van 10.000 aandelen de prijs 2 euro verschuift.
Bij en koopt de insider aandelen, is de order flow 3500 en wordt de prijs .
De insider verdient euro. De noise traders verkochten per saldo 4000 aandelen en verliezen 9200 euro, en de market maker verkocht er 3500 en verliest 8050 euro.
De som is nul, en dat de market maker hier verliest, is toeval, want gemiddeld speelt hij quitte. De codecel rekent beide markten na en zet handberekening en code naast elkaar.
def gm_quotes(pi, mu, v_high, v_low):
    """Bid and ask of a zero-profit Glosten-Milgrom market maker with belief pi = P(V = v_high)."""
    buy_h, buy_l = mu + (1 - mu) / 2, (1 - mu) / 2
    post_buy = pi * buy_h / (pi * buy_h + (1 - pi) * buy_l)
    post_sell = pi * (1 - buy_h) / (pi * (1 - buy_h) + (1 - pi) * (1 - buy_l))
    return v_low + (v_high - v_low) * post_sell, v_low + (v_high - v_low) * post_buy

V_H, V_L, MU = 102.0, 98.0, 0.2
bid0, ask0 = gm_quotes(0.5, MU, V_H, V_L)
pi1 = 0.5 * 0.6 / 0.5                                  # belief after one buy order
bid1, ask1 = gm_quotes(pi1, MU, V_H, V_L)
p_buy_next = pi1 * 0.6 + (1 - pi1) * 0.4
next_price = p_buy_next * ask1 + (1 - p_buy_next) * bid1

sigma_v, sigma_u, p0 = 4.0, 10_000.0, 50.0
beta_k = sigma_u / sigma_v
lam_k = sigma_v / (2 * sigma_u)
v, u = 53.0, -4_000.0
theta = beta_k * (v - p0)                              # insider order
y = theta + u                                          # total order flow
p1 = p0 + lam_k * y
pnl = {"insider": theta * (v - p1), "noise traders": u * (v - p1), "market maker": -y * (v - p1)}

hand_vs_code = pd.DataFrame(
    {
        "met de hand": [99.60, 100.40, 0.80, 100.77, 100.00, 100.40,
                        2500, 0.0002, 50.70, 17_250, -9_200, -8_050, 0],
        "code": [bid0, ask0, ask0 - bid0, ask1, bid1, next_price,
                 beta_k, lam_k, p1, pnl["insider"], pnl["noise traders"], pnl["market maker"],
                 sum(pnl.values())],
    },
    index=[
        "GM: biedkoers", "GM: laatkoers", "GM: spread",
        "GM: laatkoers na een koop", "GM: biedkoers na een koop", "GM: verwachte volgende prijs",
        "Kyle: beta (aandelen per euro)", "Kyle: lambda (euro per aandeel)", "Kyle: prijs",
        "Kyle: winst insider", "Kyle: winst noise traders", "Kyle: winst market maker", "Kyle: som",
    ],
)
assert np.allclose(hand_vs_code["met de hand"], hand_vs_code["code"], atol=0.005)
hand_vs_code.round(4)Code en handberekening komen overeen, op de afronding van de laatkoers na een koop na. De spread van 0,80 euro is wat een ongeïnformeerde klant voor een aan- en verkoop betaalt, alleen omdat een op de vijf handelaren de waarde kent. De prijsimpact is voor de insider een kost van dezelfde soort. Elk aandeel dat hij koopt, drijft zijn eigen koopprijs op, zodat hij bij een voordeel van 3 euro niet onbeperkt koopt.
4Theorie
De theorie gaat in drie stappen van de handelsvloer naar verwachte rendementen en sluit af met het marktontwerp van vandaag. Eerst leiden we de spread van Glosten en Milgrom en het evenwicht van Kyle af. Daarna halen we met de maten van Roll en Amihud dezelfde grootheden uit dagkoersen, en tot slot volgen we liquiditeit als niveau en als risico. De kern is dat spread en prijsimpact geen kosten van de market maker zijn, maar de prijs van informatie.
4.1Opzet en notatie
We gebruiken de symbolen van Kyle, zodat de prijsimpact van order flow is en de handelsintensiteit van de insider, en niet de prijs van risico of de subjectieve discontofactor. De prijs van marktrisico heet daarom . De liquidatiewaarde van het aandeel is (de payoff), de order van de insider , de order van de noise traders en de totale order flow . Alle handelaren zijn risiconeutraal en de rente is nul.
Bij Glosten en Milgrom komen handelaren één voor één met één aandeel, en zet de market maker vooraf een bied- en een laatkoers. Bij Kyle dienen alle handelaren tegelijk een marktorder in, een order zonder limietprijs, en zet de market maker één prijs op basis van de som. Het eerste model levert dus spreads en het tweede prijsimpact, maar in beide dwingt concurrentie de prijs naar de verwachte waarde van gegeven de order flow.
4.2Glosten-Milgrom: de spread als adverse selectie
De spread van Glosten en Milgrom bestaat alleen omdat een order iets verraadt over de waarde. Een market maker die alle orders tegen dezelfde prijs uitvoert, verliest aan geïnformeerde handelaren en wint niets terug van de rest. Omdat een koop op goed nieuws wijst en een verkoop op slecht nieuws, speelt hij alleen quitte als zijn laatkoers boven zijn biedkoers ligt.
Proof 1
Het bewijs past de regel van Bayes toe op beide koersen en trekt ze van elkaar af. Bij en geeft (1) de spread van 0,80 euro uit het toy-voorbeeld. Na één koop is , zodat de noemer wordt en de spread . De spread is dus het grootst bij de grootste onzekerheid en krimpt naarmate de prijs de informatie opneemt, terwijl een hogere hem breder maakt omdat elke order dan meer verraadt.
Zo’n spread bestaat zonder voorraadkosten of risicoaversie en is dus zuiver adverse selection (het verlies aan beter geïnformeerde tegenpartijen), het uitgangspunt van het leerboek van O’Hara O'Hara (1995). De martingaaleigenschap geldt alleen ten opzichte van de publieke informatie, want voor iemand die kent, loopt de prijs voorspelbaar op of af. Het model maakt zo de stelling van Samuelson uit Fama en de efficiënte markt precies, want een prijs die een verwachte waarde is, verandert alleen onvoorspelbaar voor wie alleen de orderhistorie kent.
4.3Kyle: het evenwicht met één handelsronde
In de markt van Kyle neemt de prijs na één ronde precies de helft van de onzekerheid over weg, gemeten als variantie, hoeveel ruis er ook is. De insider weet dat zijn eigen order de prijs opdrijft. Daarom koopt hij, zoals een monopolist de helft van de concurrerende hoeveelheid levert, de helft van de positie waarbij de prijs tot zou stijgen. De market maker zet de prijs op de regressie van op . Handelt de insider agressiever, dan wordt informatiever en stijgt , en een hogere maakt de insider weer voorzichtiger, zodat het evenwicht ligt waar die twee reacties elkaar vinden.
Proof 3
Stap 1: de beste order van de insider bij gegeven . Neem aan dat de market maker zet met . Voor gegeven is de verwachte winst , omdat . Die is strikt concaaf in zodra , en de eerste-ordevoorwaarde geeft , dus .
Stap 2: de prijsregel van de market maker bij gegeven . Met zijn en gezamenlijk normaal. Volgens Lemma 1 is met
Stap 3: het vaste punt geeft en . Substitueer , zodat , oftewel . De tweede-ordevoorwaarde kiest de positieve wortel , en dan is . Elk lineair evenwicht moet aan stap 1 tot en met 3 voldoen, dus het is uniek.
Stap 4: de restvariantie en de winsten. Volgens het lemma is , en met is dat . De verwachte winst van de insider is . Die van de noise traders is , en de market maker verdient , omdat ongecorreleerd is met .
In het bewijs neemt de insider als gegeven en koopt hij , de helft van de positie waarbij de prijs tot zou stijgen. De market maker neemt als gegeven en haalt uit het projectietheorema. Met de getallen uit het toy-voorbeeld verdient de insider gemiddeld euro en daalt de variantie van van 16 naar 8.
De diepte van de markt, , stijgt met de ruis en daalt met de private informatie. Verdubbelt , dan handelt de insider twee keer zoveel en verdient hij twee keer zoveel, maar blijft de helft van de variantie over, zoals het beeld van de verstopte insider deed verwachten. Meer noise traders maken de markt dus dieper en de insider rijker, maar de prijs niet dommer. Zo ontsnapt het model aan de paradox van Grossman en Stiglitz, omdat de verliezen van de noise traders het verzamelen van informatie betalen.
4.4Kyle met vele handelsronden
Mag de insider over vele ronden handelen, dan komt zijn informatie in een constant tempo in de prijs. Wat hij nu verraadt, kan hij later niet meer uitbuiten, dus houdt hij informatie achter tot hij onverschillig is tussen nu en later handelen.
Kyle deelt de handelsperiode op in ronden met , waarin de noise traders per ronde een order inleggen Kyle (1985). De insider handelt , de prijs wordt , en is de onzekerheid over die na ronde over is. De coëfficiënt , geen alpha in de gewone betekenis, meet wat een resterend prijsverschil de insider later oplevert. Een grote maakt hem in ronde dus terughoudender.
Kyle (1985, stelling 2 en 3) bewijst dit door te veronderstellen dat de resterende winst kwadratisch is in en die veronderstelling achteruit te bevestigen vanaf . In de limiet verdient de insider twee keer zoveel als in één ronde, omdat hij zijn informatie over de tijd kan spreiden.
4.5Numerieke oplossing van Kyles recursie
Al bij tien ronden ligt het evenwicht dicht bij de continue limiet uit de propositie, met een constante prijsimpact en een lineair dalende onzekerheid. Per ronde geven de eerste twee vergelijkingen samen een derdegraadsvergelijking in . We kiezen de positieve wortel met , omdat alleen die een positieve en de tweede-ordevoorwaarde geeft. Omdat het stelsel homogeen is in , lossen we achteruit op vanaf . Aan het eind vermenigvuldigen we alle met één factor , met en met . Dat doen we voor 1, 4, 10 en 50 ronden met .
def kyle_recursion(n_auctions, sigma_v=1.0, sigma_u=1.0):
    """Kyle (1985) N-auction linear equilibrium, solved backwards from Sigma_N = 1 and rescaled.

    Returns a DataFrame indexed by auction n = 1..N with lambda_n, beta_n and Sigma_n
    (posterior variance after auction n). ``attrs`` holds Sigma_0 and the insider's
    total expected profit alpha_0 Sigma_0 + delta_0.
    """
    dt, s2 = 1.0 / n_auctions, sigma_u**2
    lam, beta = np.empty(n_auctions), np.empty(n_auctions)
    sigma = np.empty(n_auctions + 1)
    sigma[-1], alpha, delta = 1.0, 0.0, 0.0
    for n in range(n_auctions - 1, -1, -1):
        # lambda solves -2 a s2 dt L^3 + 2 s2 dt L^2 + 2 a S L - S = 0 (from the first two equations)
        roots = np.roots([-2 * alpha * s2 * dt, 2 * s2 * dt, 2 * alpha * sigma[n + 1], -sigma[n + 1]])
        roots = roots[np.abs(roots.imag) < 1e-10].real
        L = roots[(roots > 0) & (alpha * roots < 0.5)].min()
        lam[n], beta[n] = L, L * s2 / sigma[n + 1]
        sigma[n] = sigma[n + 1] / (1 - beta[n] * L * dt)
        delta += alpha * L**2 * s2 * dt
        alpha = 1.0 / (4 * L * (1 - alpha * L))
    k = sigma_v**2 / sigma[0]            # homogeneity: Sigma*k, lambda*sqrt(k), beta/sqrt(k)
    out = pd.DataFrame(
        {"lambda": lam * np.sqrt(k), "beta": beta / np.sqrt(k), "Sigma": sigma[1:] * k},
        index=pd.RangeIndex(1, n_auctions + 1, name="ronde"),
    )
    out.attrs = {"Sigma_0": sigma[0] * k, "profit": alpha / np.sqrt(k) * sigma_v**2 + delta * np.sqrt(k)}
    return out

solutions = {n: kyle_recursion(n) for n in (1, 4, 10, 50)}
pd.DataFrame(
    {
        "lambda eerste ronde": [s["lambda"].iloc[0] for s in solutions.values()],
        "lambda laatste ronde": [s["lambda"].iloc[-1] for s in solutions.values()],
        "Sigma_N / Sigma_0": [s["Sigma"].iloc[-1] / s.attrs["Sigma_0"] for s in solutions.values()],
        "verwachte winst insider": [s.attrs["profit"] for s in solutions.values()],
    },
    index=pd.Index(list(solutions), name="rondes N"),
).round(4)Bij geeft de recursie het evenwicht van Theorem 2 terug, met en de helft van de variantie over. Naarmate groeit, gaat naar 1 en de restvariantie naar nul, terwijl de verwachte winst bij 50 ronden 0,95 is. Om te zien of de prijs zich ook in steekproeven zo gedraagt, simuleren we 20.000 markten met 50 ronden.
kyle50 = solutions[50]
n_paths, N = 20_000, 50
dt = 1.0 / N
v_true = rng.normal(0.0, 1.0, n_paths)
price = np.zeros(n_paths)
profit = np.zeros(n_paths)
price_changes = np.empty((N, n_paths))
resid_var = np.empty(N)
for n in range(N):
    order = kyle50["beta"].iloc[n] * (v_true - price) * dt
    noise = rng.normal(0.0, np.sqrt(dt), n_paths)
    new_price = price + kyle50["lambda"].iloc[n] * (order + noise)
    profit += order * (v_true - new_price)
    price_changes[n] = new_price - price
    price = new_price
    resid_var[n] = np.var(v_true - price)

autocorr = np.corrcoef(price_changes[1:].ravel(), price_changes[:-1].ravel())[0, 1]
print(f"restvariantie na ronde 25: simulatie {resid_var[24]:.3f}, theorie {kyle50['Sigma'].iloc[24]:.3f}")
print(f"restvariantie na ronde 50: simulatie {resid_var[-1]:.3f}, theorie {kyle50['Sigma'].iloc[-1]:.3f}")
print(f"autocorrelatie opeenvolgende prijsveranderingen: {autocorr:+.4f}")
print(f"gemiddelde prijsverandering: {price_changes.mean():+.5f}")
print(f"insiderwinst per markt: gemiddelde {profit.mean():.3f} (theorie {kyle50.attrs['profit']:.3f}), "
      f"standaarddeviatie {profit.std():.3f}")
restvariantie na ronde 25: simulatie 0.528, theorie 0.531
restvariantie na ronde 50: simulatie 0.027, theorie 0.027
autocorrelatie opeenvolgende prijsveranderingen: +0.0003
gemiddelde prijsverandering: +0.00011
insiderwinst per markt: gemiddelde 0.950 (theorie 0.951), standaarddeviatie 1.024
De gesimuleerde restvariantie is na 25 ronden 0,528 tegen 0,531 in theorie, en opeenvolgende prijsveranderingen zijn ongecorreleerd. De prijs is dus een martingaal ten opzichte van de order flow, ook al handelt er iemand die de uitkomst kent. De linker figuur legt de punten van de simulatie naast de rechte lijn van de continue limiet.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.5))
for n, sol in solutions.items():
    if n == 1:
        continue
    t = np.r_[0, sol.index / n]
    axes[0].plot(t, np.r_[1.0, sol["Sigma"] / sol.attrs["Sigma_0"]], marker="o" if n == 4 else None, label=f"theorie, N = {n}")
    axes[1].plot(sol.index / n, sol["lambda"], marker="o" if n == 4 else None, label=f"N = {n}")
axes[0].plot(np.arange(1, N + 1) / N, resid_var, "k.", ms=4, label="simulatie, N = 50")
axes[0].plot([0, 1], [1, 0], color="grey", ls="--", lw=1, label="continue limiet $1-t$")
axes[0].set_title("Restonzekerheid $\\Sigma_n/\\Sigma_0$ neemt vrijwel lineair af")
axes[0].set_xlabel("Tijd binnen de handelsperiode $t = n/N$")
axes[0].set_ylabel("$\\Sigma_n / \\Sigma_0$")
axes[0].legend()
axes[1].axhline(1.0, color="grey", ls="--", lw=1, label="continue limiet $\\sigma_v/\\sigma_u$")
axes[1].set_title("Prijsimpact $\\lambda_n$ per ronde")
axes[1].set_xlabel("Tijd binnen de handelsperiode $t = n/N$")
axes[1].set_ylabel("$\\lambda_n$")
axes[1].legend()
plt.show()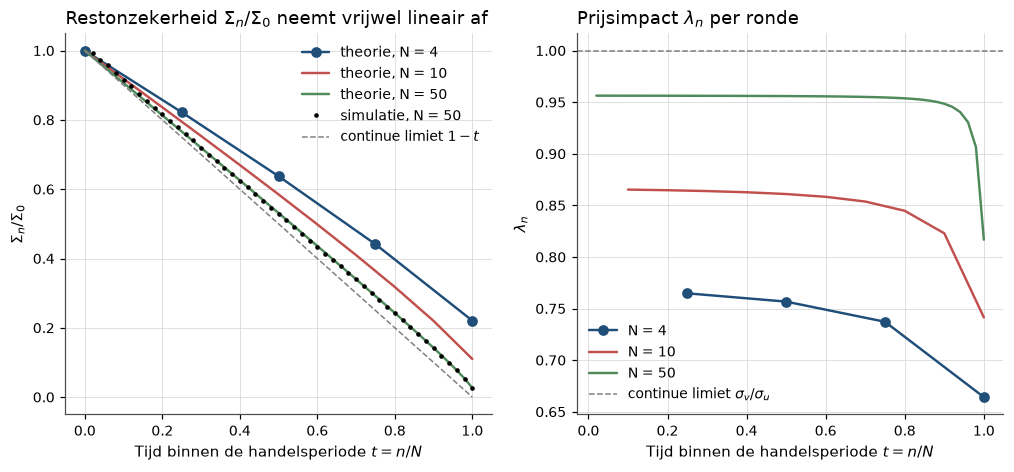
Figure 1:Links volgt de restvariantie al bij tien ronden bijna de rechte lijn , en de gesimuleerde punten vallen op het theoretische pad, zodat de informatie in een constant tempo in de prijs komt. Rechts is de prijsimpact vrijwel constant, behalve in de laatste ronden.
De figuur toont gemiddelden, maar de winst van één insider spreidt ruim, en over die spreiding zegt de propositie niets. De standaarddeviatie van de insiderwinst per markt is 1,024, iets meer dan het gemiddelde van 0,950, zodat een insider met perfecte informatie na twintig handelsdagen een -waarde van ongeveer haalt. Een handelaar met een klein voordeel heeft daar jaren voor nodig. Het probleem van de standaardfout van 2% bestaat dus ook op de handelsvloer, want ook iemand met echte informatie kan zijn voordeel moeilijk bewijzen.
Een Glosten-Milgrom-sessie: een martingaal voor wie de waarde niet kent
In de markt van het toy-voorbeeld simuleren we 5000 handelsdagen van elk 60 orders, waarbij de market maker na elke order zijn oordeel bijwerkt.
n_sessions, n_trades = 5_000, 60
q_high, q_low = MU + (1 - MU) / 2, (1 - MU) / 2
is_high = rng.random(n_sessions) < 0.5
belief = np.full(n_sessions, 0.5)
spreads = np.empty((n_sessions, n_trades))
beliefs = np.empty((n_sessions, n_trades + 1))
beliefs[:, 0] = belief
for n in range(n_trades):
    bid, ask = gm_quotes(belief, MU, V_H, V_L)
    spreads[:, n] = ask - bid
    informed = rng.random(n_sessions) < MU
    buy = np.where(informed, is_high, rng.random(n_sessions) < 0.5)
    like_high = np.where(buy, q_high, 1 - q_high)
    like_low = np.where(buy, q_low, 1 - q_low)
    belief = belief * like_high / (belief * like_high + (1 - belief) * like_low)
    beliefs[:, n + 1] = belief

value_path = V_L + (V_H - V_L) * beliefs
increments = np.diff(value_path, axis=1)
pd.DataFrame(
    {
        "gemiddelde prijsverandering": [increments.mean(), increments[is_high].mean(), increments[~is_high].mean()],
        "autocorrelatie prijsveranderingen": [
            np.corrcoef(increments[:, 1:].ravel(), increments[:, :-1].ravel())[0, 1],
            np.nan,
            np.nan,
        ],
    },
    index=["alle sessies (publieke informatie)", "sessies met V = V_H", "sessies met V = V_L"],
).round(4)Over alle dagen samen is de gemiddelde prijsverandering nul, maar op dagen met een hoge waarde loopt de prijs voorspelbaar op. Beide uitspraken zijn waar, omdat de martingaaleigenschap bij een informatieverzameling hoort en niet bij een prijspad. De figuur toont links de krimpende spread en rechts het pad van de verwachte waarde in zes sessies. De brede band links laat zien hoe toevallig het tempo van prijsontdekking op één dag is.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.5))
trade_no = np.arange(1, n_trades + 1)
axes[0].fill_between(trade_no, np.percentile(spreads, 10, axis=0), np.percentile(spreads, 90, axis=0),
                     alpha=0.25, label="10e–90e percentiel")
axes[0].plot(trade_no, spreads.mean(axis=0), label="gemiddelde")
axes[0].plot(trade_no, np.median(spreads, axis=0), ls="--", label="mediaan")
axes[0].set_title("De spread krimpt naarmate informatie in de prijs komt")
axes[0].set_xlabel("Ordernummer binnen de sessie")
axes[0].set_ylabel("Spread (euro)")
axes[0].legend()
for s in range(6):
    axes[1].plot(np.arange(n_trades + 1), value_path[s], lw=1.2, color="C0" if is_high[s] else "C1")
axes[1].axhline(V_H, color="grey", ls=":", lw=1)
axes[1].axhline(V_L, color="grey", ls=":", lw=1)
axes[1].set_title("Verwachte waarde in zes sessies (blauw: $V_H$, rood: $V_L$)")
axes[1].set_xlabel("Ordernummer binnen de sessie")
axes[1].set_ylabel("Verwachte waarde na de order (euro)")
plt.show()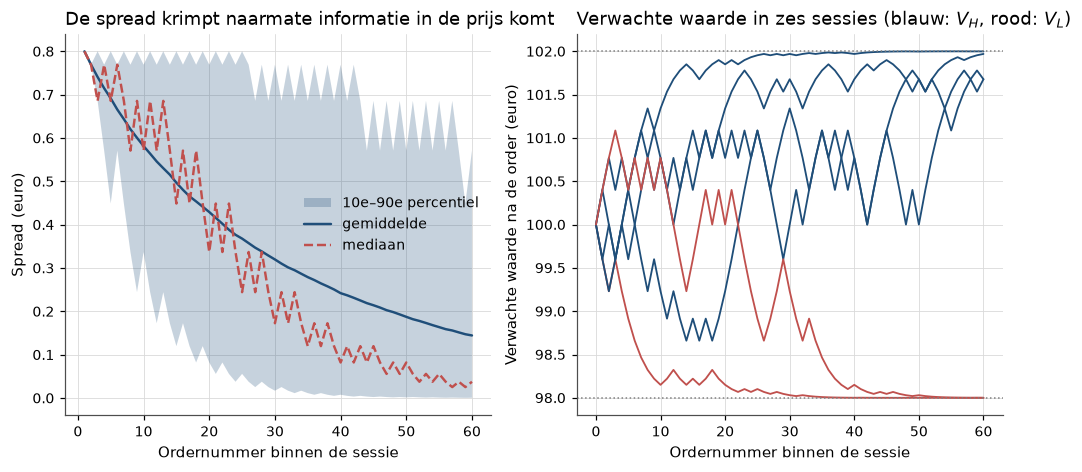
4.6Roll: de spread uit de autocovariantie
Uit gewone transactiekoersen is de spread terug te rekenen, omdat de sprong tussen bied en laat een negatieve autocovariantie achterlaat. De fundamentele waarde verandert onvoorspelbaar, maar transacties vinden afwisselend tegen de biedkoers en de laatkoers plaats. Na een transactie tegen de laatkoers volgt daarom vaker een daling dan een stijging, en dat heen en weer springen, de bid-ask bounce, maakt opeenvolgende koersveranderingen negatief gecorreleerd.
Een spread van 0,80 euro, zoals in het toy-voorbeeld, laat volgens (6) een autocovariantie van achter. Op rendementen geeft dezelfde formule de relatieve spread. Het model laat geen ruimte voor andere autocorrelatie, zodat een positieve autocovariantie de wortel ongedefinieerd maakt en een negatieve door overreactie als spread wordt gelezen. Het signaal is bovendien klein, want bij een spread van één basispunt en een dagvolatiliteit van 1,5% is van de orde 10-5.
4.7Amihud: prijsimpact uit dagdata
Ook zonder transactiedata is Kyles bij benadering te meten, als koersbeweging per dollar omzet. Grote koersbewegingen bij weinig omzet wijzen op een ondiepe markt, en Amihud Amihud (2002) definieerde daarom voor aandeel met handelsdagen in een jaar
met het dagrendement en de omzet in dollars. Een aandeel dat op een dag met 10 miljoen dollar omzet 1% beweegt, heeft die dag een ILLIQ van 0,1% per miljoen dollar.
In echte markten komt er ook publiek nieuws in de prijs en is de omzet groter dan de netto order flow, zodat ILLIQ alleen een ruisend signaal van is. Het signaal is wel bruikbaar, omdat de ruis over een jaar dagdata grotendeels uitmiddelt en de rangorde van aandelen naar diepte blijft staan.
4.8Liquiditeit in de prijs: het niveau
Illiquide aandelen moeten meer opleveren, maar minder dan evenredig met hun spread. Een belegger die een aandeel na jaar verkoopt, betaalt de spread één keer, dus per jaar. Aandelen met hoge spreads belanden daardoor bij beleggers met een lange horizon. Voor hen weegt de spread het minst, zodat het vereiste rendement minder hard stijgt dan de spread. Amihud en Mendelson Amihud & Mendelson (1986) vonden precies dat het verwachte rendement met de spread stijgt, maar steeds minder snel.
Amihud bracht de vraag later naar de tijdreeks, met een regressie van het overrendement van de markt op de illiquiditeit van de markt,
waarin de onverwachte illiquiditeit is, de schok uit een AR(1). Verwachte illiquiditeit verhoogt het verwachte overrendement, dus . Onverwachte illiquiditeit verlaagt het rendement in dezelfde periode, dus , omdat een blijvende schok het vereiste rendement voor de toekomst verhoogt en de prijs vandaag laat dalen. Op jaardata voor NYSE-aandelen over 1964–1997 vond Amihud beide tekens.
4.9Liquiditeit als risico: Pástor-Stambaugh en Acharya-Pedersen
Omdat marktliquiditeit in de tijd varieert en alle aandelen tegelijk raakt, is ze ook een risico. Ze is een toestandsvariabele zoals in het ICAPM (Merton: continue tijd en het ICAPM), waar een activum dat slecht rendeert als de toestand verslechtert, meer moet opleveren. Een aandeel dat daalt wanneer de markt illiquide wordt, verliest dus waarde op het moment dat beleggers geld het hardst nodig hebben.
Pástor en Stambaugh Pástor & Stambaugh (2003) maten de liquiditeit van aandeel in maand als de coëfficiënt in de regressie op dagdata
met het rendement boven de markt, hier de dollaromzet en en gewone regressiecoëfficiënten. Getekende omzet benadert de order flow, en in een illiquide markt wordt een koersbeweging die door orders komt deels teruggedraaid, zodat negatief is. Het gemiddelde over aandelen, min het voorspelbare deel, levert innovaties , en de liquiditeitsbèta is de helling daarop naast de drie Fama-French-factoren. Aandelen met een hoge voorspelde liquiditeitsbèta leverden na correctie voor vier factoren ongeveer 7,5% per jaar meer op dan aandelen met een lage.
Acharya en Pedersen Acharya & Pedersen (2005) leidden in een economie met wisselende handelskosten een CAPM af voor rendementen na kosten. In bruto rendementen en in onze notatie geeft dat
met de prijs van marktrisico na kosten (de verwachte marktpremie min de handelskosten van de markt, enkele procenten per jaar) en de gewone marktbèta. De andere drie bèta’s belonen een aandeel dat illiquide wordt als de markt illiquide wordt (), dat slecht rendeert als de markt illiquide wordt (), en dat illiquide wordt als de markt daalt (). Met ILLIQ als maat voor schatten ze over 1963–1999 dat liquiditeitsrisico ongeveer 1,1% per jaar bijdraagt aan het verschil tussen de meest en de minst illiquide aandelen. De drie bèta’s zijn wel sterk gecorreleerd, zodat de verdeling over de kanalen onzeker is.
4.10Marktontwerp: van specialist naar batchveiling
De modellen van 1985 beschrijven een specialist, maar vandaag voeren algoritmen de orders uit in een doorlopend orderboek. Budish, Cramton en Shim Budish et al. (2015) lieten zien dat de correlatie tussen een indexfuture en een indexfonds op de schaal van milliseconden wegvalt. Dat levert mechanische arbitragekansen op, en concurrentie verkleint die niet maar drijft alleen de vereiste snelheid op. Een handelaar met een staande koers wordt na elk publiek signaal door de snelste handelaar uitgebuit, net als de market maker van Glosten en Milgrom, en dat verlies zit in de spread. De auteurs stelden daarom frequent batch auctions voor, veilingen die alle orders van bijvoorbeeld een tiende seconde tegen één prijs uitvoeren.
5Simulatie: de Roll-schatter in eindige steekproeven
Hoe vaak is de Roll-maat in een steekproef van gewone lengte niet te berekenen? Tweede momenten zijn meestal goed meetbaar, maar het signaal is klein naast de variantie van de koersveranderingen. De standaardfout van een steekproefautocovariantie is bij een i.i.d.-benadering ongeveer , zodat voor de kans op een positieve en dus onbruikbare schatting geldt
Voor de spread van 0,80 euro uit het toy-voorbeeld bij een dagvolatiliteit van 1 euro is . Over een kwartaal van 60 dagen is de kans dan , maar bij is ze bijna een half. We simuleren het model voor 22 verhoudingen tussen 0,01 en 3, met en dagen en 4000 steekproeven per punt.
def roll_positive_share(spread_ratio, n_days, n_samples=4_000):
    """Share of samples in which the Roll autocovariance is positive (sigma_e = 1)."""
    e = rng.normal(0.0, 1.0, (n_samples, n_days))
    q = rng.choice([-1.0, 1.0], (n_samples, n_days + 1))
    dp = e + spread_ratio / 2 * np.diff(q, axis=1)
    dp = dp - dp.mean(axis=1, keepdims=True)
    cov = (dp[:, 1:] * dp[:, :-1]).sum(axis=1) / (n_days - 1)
    return (cov > 0).mean()

ratios = np.geomspace(0.01, 3.0, 22)
roll_sim = pd.DataFrame(
    {T: [roll_positive_share(r, T) for r in ratios] for T in (60, 250)}, index=pd.Index(ratios, name="s / sigma")
)
roll_theory = pd.DataFrame(
    {T: stats.norm.cdf(np.sqrt(T) * -(ratios**2 / 4) / (1 + ratios**2 / 2)) for T in (60, 250)}, index=ratios
)
roll_sim.iloc[[0, 5, 10, 14, 17, 21]].round(3)Bij is de autocovariantie in 46% van de kwartalen en 48% van de jaren positief, en pas bij een verhouding rond 1 bestaat de maat bijna altijd. De figuur zet simulatie en benadering naast elkaar, met de grote liquide aandelen in het grijze gebied.
Source
fig, ax = plt.subplots()
for i, T in enumerate((60, 250)):
    ax.plot(ratios, roll_sim[T], "o", color=f"C{i}", label=f"simulatie, T = {T} dagen")
    ax.plot(ratios, roll_theory[T], "-", color=f"C{i}", lw=1, label=f"benadering, T = {T} dagen")
ax.axvspan(0.003, 0.1, color="grey", alpha=0.15, label="grote liquide aandelen")
ax.set_xscale("log")
ax.set_xlim(0.008, 3.5)
ax.set_title("Hoe vaak is de Roll-maat ongedefinieerd?")
ax.set_xlabel("Spread gedeeld door volatiliteit van de efficiënte prijs, $s/\\sigma_e$ (log-schaal)")
ax.set_ylabel("Fractie steekproeven met positieve autocovariantie")
ax.legend()
plt.show()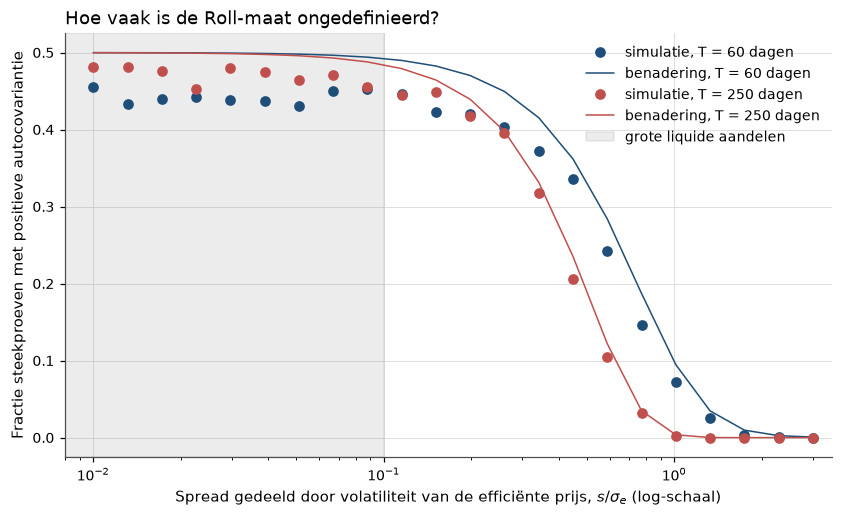
Figure 2:Voor grote liquide aandelen (grijs gebied) is de Roll-maat in bijna de helft van de steekproeven ongedefinieerd, ook als het model precies klopt. Een langere steekproef helpt maar met een factor . In het grijze gebied verschuift de curve van een kwartaal naar een jaar daardoor nauwelijks, en pas bij grotere spreads daalt ze zichtbaar.
Benadering en simulatie liggen vrijwel op elkaar. Beide laten zien dat een variantie goed meetbaar is, tenzij het deel dat we zoeken een honderdduizendste van het totaal is. De ruis is bovendien niet symmetrisch, want wie de Roll-maat alleen middelt over de jaren waarin ze bestaat, overschat de spread stelselmatig.
6Replicatie op echte data
6.1Amihud en Roll per aandeel
ILLIQ zet de vijftig aandelen in een plausibele volgorde, terwijl de Roll-maat vooral ruis meet. De codecel berekent per aandeel de dagelijkse ILLIQ in basispunten per miljoen dollar omzet en per jaar de Roll-spread uit de autocovariantie van de dagrendementen.
TICKERS = [
    "AAPL", "ADBE", "AMZN", "ANET", "APH", "AVGO", "BAC", "BRK-B", "CMG", "CPRT",
    "CRM", "CSX", "CTAS", "CVX", "DE", "DHR", "DXCM", "EW", "FAST", "FTNT",
    "GILD", "GOOGL", "IDXX", "ISRG", "KO", "LRCX", "MA", "MNST", "NFLX", "NKE",
    "NOW", "NVDA", "ODFL", "ORLY", "PANW", "PG", "QCOM", "ROST", "SBUX", "SHW",
    "SMCI", "TJX", "TSCO", "TSLA", "UNH", "UNP", "V", "WFC", "WMT", "WRB",
]
prices = hap_data.yahoo(TICKERS, start="2002-01-01", end="2026-08-01")
volume = hap_data.yahoo(TICKERS, start="2002-01-01", end="2026-08-01", field="Volume")

returns = prices.pct_change(fill_method=None).loc["2002-01-03":]
dollar_volume_mln = (prices * volume).where(volume > 0).loc[returns.index] / 1e6
illiq_daily = returns.abs() / dollar_volume_mln * 1e4       # basis points per million dollars

def first_autocov(series, min_obs=100):
    """First-order autocovariance of a return series; NaN if fewer than min_obs observations."""
    x = series.dropna().to_numpy()
    return np.cov(x[1:], x[:-1])[0, 1] if len(x) > min_obs else np.nan

autocov_year = returns.groupby(returns.index.year).agg(first_autocov)
roll_year_bp = 2 * np.sqrt(-autocov_year.where(autocov_year < 0)) * 1e4

per_stock = pd.DataFrame(
    {
        "ILLIQ 2021–2026 (bp per $ mln)": illiq_daily.loc["2021":].mean(),
        "Roll-spread 2021–2026 (bp)": roll_year_bp.loc[2021:].median(),
        "fractie jaren Roll ongedefinieerd": (autocov_year >= 0).sum() / autocov_year.notna().sum(),
    }
).sort_values("ILLIQ 2021–2026 (bp per $ mln)")
print(f"aandeel-jaren met positieve autocovariantie: {(autocov_year >= 0).sum().sum()} van "
      f"{autocov_year.notna().sum().sum()} ({(autocov_year >= 0).sum().sum() / autocov_year.notna().sum().sum():.1%})")
per_stock.iloc[[0, 1, 2, 3, 4, -5, -4, -3, -2, -1]].round(3)
aandeel-jaren met positieve autocovariantie: 427 van 1168 (36.6%)
De tabel toont de vijf meest en de vijf minst liquide namen. Apple, Tesla en Amazon zijn het diepst en Super Micro het ondiepst, met ruim twee ordes van grootte ertussen. De Roll-maat is in 427 van de 1168 aandeel-jaren ongedefinieerd, ruim een derde, wat past bij de simulatie. Waar ze bestaat, geeft ze spreads van 60 tot 170 basispunten. Zulke waarden ontstaan omdat Rolls formule alle negatieve autocorrelatie in dagrendementen meet en niet alleen de bid-ask bounce. Bovendien tellen alleen de jaren met een negatieve schatting mee, het selectie-effect uit de simulatie. Per jaar bekijken we daarna de mediane Roll-spread en de mediane ILLIQ.
by_year = pd.DataFrame(
    {
        "mediane Roll-spread (bp)": roll_year_bp.median(axis=1),
        "fractie ongedefinieerd": (autocov_year >= 0).sum(axis=1) / autocov_year.notna().sum(axis=1),
        "mediane ILLIQ (bp per $ mln)": illiq_daily.groupby(illiq_daily.index.year).mean().median(axis=1),
    }
)
by_year.round(3)De Roll-maat pikt de crises wel op, met de hoogste mediane spread in 2020 en 2008, vooral omdat volatiliteit en omkeringen dan toenemen. De mediane ILLIQ daalt met ongeveer een factor dertig, omdat deze vijftig aandelen zo sterk zijn gegroeid, zodat we die trend eerst uit een marktbrede reeks moeten halen.
6.2Marktbrede illiquiditeit en het marktrendement
Marktbrede illiquiditeit piekt in 2008 en maart 2020 en gaat samen met lage gelijktijdige marktrendementen. We nemen per aandeel per maand de logaritme van de gemiddelde ILLIQ, trekken per aandeel het gemiddelde af en middelen over aandelen. Daarna schatten we de maandelijkse versie van Amihuds tijdreeksregressie met Newey-West-standaardfouten.
days = illiq_daily.resample("ME").count()
log_illiq = np.log(illiq_daily.resample("ME").mean().where(days >= 15))
market_illiq = log_illiq.sub(log_illiq.mean()).mean(axis=1).rename("illiq")
deviation = (market_illiq - market_illiq.rolling(12).mean().shift(1)).rename("afwijking")

ar1 = hap.stats.newey_west(market_illiq, market_illiq.shift(1).rename("vertraagd"), lags=0)
innovation = (market_illiq - ar1.params["const"] - ar1.params["vertraagd"] * market_illiq.shift(1)).rename("innovatie")

ff3 = hap_data.market_monthly()
design = pd.concat([market_illiq.shift(1).rename("illiq vertraagd"), innovation], axis=1, sort=True)
amihud_fit = hap.stats.newey_west(ff3["Mkt-RF"].reindex(design.index), design, lags=3)

print(f"AR(1)-helling marktilliquiditeit: {ar1.params['vertraagd']:.3f}")
print("Hoogste afwijkingen van het voorgaande jaargemiddelde (log-punten):")
print(deviation.nlargest(6).round(2).to_string())
pd.DataFrame(
    {"coëfficiënt": amihud_fit.params, "NW-standaardfout": amihud_fit.bse, "t-waarde": amihud_fit.tvalues}
).round(4)
AR(1)-helling marktilliquiditeit: 0.986
Hoogste afwijkingen van het voorgaande jaargemiddelde (log-punten):
date
2020-03-31 0.93
2008-11-30 0.87
2008-10-31 0.80
2008-12-31 0.73
2020-04-30 0.51
2009-01-31 0.48
Het teken van is gerepliceerd, want een onverwachte stijging van de marktilliquiditeit gaat samen met een fors en zeer significant lager overrendement in dezelfde maand. Een deel daarvan zit mechanisch in de constructie, omdat een koersdaling verhoogt en de dollaromzet verlaagt. De coëfficiënt op de vertraagde illiquiditeit is klein, negatief en niet significant. Om een voorspellend verband voor het marktrendement aan te tonen, zijn echter decennia nodig (Voorspelbaarheid van rendementen), en 24 jaar van vijftig overlevenden is daarvoor te kort. De figuur laat onder de maanden zien waarin de illiquiditeit boven het gemiddelde van het voorgaande jaar uitschiet.
Source
fig, axes = plt.subplots(2, 1, figsize=(10, 6.5), sharex=True)
axes[0].plot(market_illiq.index, market_illiq, label="log-illiquiditeit (gemiddeld over aandelen)")
axes[0].set_title("Marktbrede Amihud-illiquiditeit van vijftig grote aandelen")
axes[0].set_ylabel("Log-ILLIQ t.o.v. aandeelgemiddelde")
axes[0].legend(loc="upper right")
axes[1].bar(deviation.index, deviation, width=25, color=np.where(deviation > 0, "C1", "C0"))
for date, text in [("2008-11-30", "okt.–nov. 2008"), ("2020-03-31", "maart 2020")]:
    axes[1].annotate(text, (pd.Timestamp(date), deviation.loc[date]), xytext=(10, 5), textcoords="offset points")
axes[1].set_title("Afwijking van het gemiddelde van de voorgaande twaalf maanden")
axes[1].set_ylabel("Log-punten")
hap.plotting.timeline_axis(axes[1], every=2)
axes[1].set_xlabel("Jaar")
plt.show()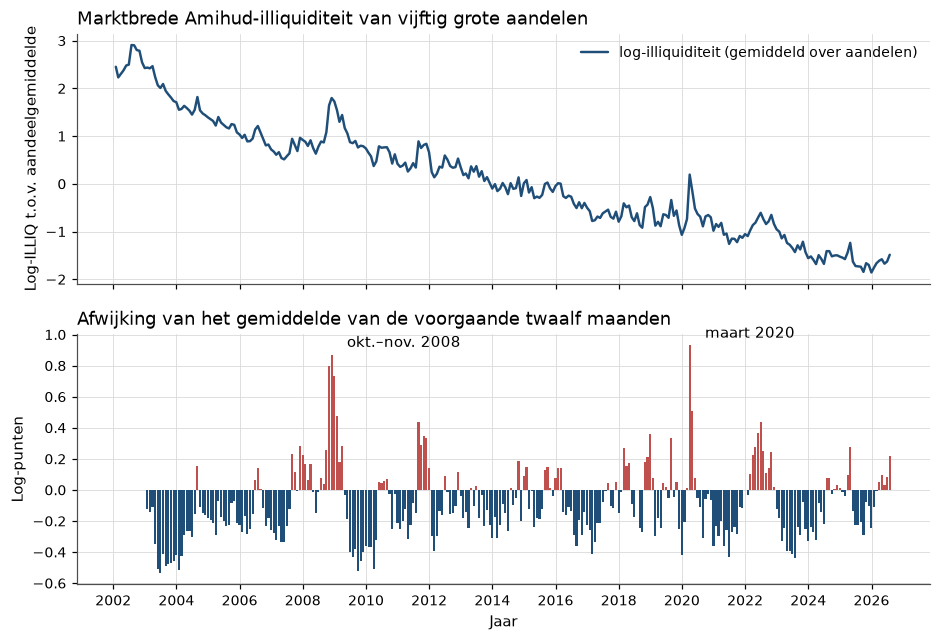
Figure 3:Boven daalt de illiquiditeit van deze vijftig aandelen sterk, omdat ze zo gegroeid zijn. Onder zijn maart 2020 en oktober tot december 2008 de grootste uitschieters, precies de maanden waarin veel beleggers moesten verkopen.
6.3Pástor-Stambaugh
De reeks van Pástor en Stambaugh laat zien dat liquiditeit in crises instort. Omdat
hap.data geen loader voor deze reeks heeft, haalt de functie hieronder het bestand van
Stambaughs Wharton-pagina één keer op en bewaart het in de cache.
PS_URL = "https://finance.wharton.upenn.edu/~stambaug/liq_data_1962_2025.txt"

def pastor_stambaugh_liquidity():
    """Pastor-Stambaugh (2003) monthly liquidity series, cached as a parquet snapshot.

    Columns: agg_liq (level, their Figure 1), innov_liq (innovation L_t, eq. 8) and
    traded_liq (cap-weighted 10-1 portfolio on historical liquidity betas), decimals.
    """
    # TODO: naar hap.data (loader voor Stambaugh's Wharton-pagina)
    def build():
        text = requests.get(PS_URL, timeout=60).text
        rows = [line for line in text.splitlines() if line.strip() and not line.lstrip().startswith("%")]
        frame = pd.read_csv(io.StringIO("\n".join(rows)), sep=r"\s+", header=None,
                            names=["month", "agg_liq", "innov_liq", "traded_liq"])
        frame.index = pd.DatetimeIndex(
            pd.to_datetime(frame.pop("month").astype(str), format="%Y%m") + pd.offsets.MonthEnd(0), name="date"
        )
        return frame.mask(frame <= -99)

    return hap_cache.load_cached("pastor_stambaugh__liq_1962_2025", build)

ps = pastor_stambaugh_liquidity()
ps_market = pd.concat([ps, ff3["Mkt-RF"]], axis=1, sort=True).dropna(subset=["innov_liq", "Mkt-RF"])
print(f"reeks: {ps.index[0]:%Y-%m} t/m {ps.index[-1]:%Y-%m}")
print(f"correlatie L_t met Mkt-RF, 1966–1999: {ps_market.loc['1966':'1999', ['innov_liq', 'Mkt-RF']].corr().iloc[0, 1]:.2f}"
      f" (werkdocument: 0.36)")
print(f"correlatie L_t met Mkt-RF, 1962–2025: {ps_market[['innov_liq', 'Mkt-RF']].corr().iloc[0, 1]:.2f}")
both = pd.concat([ps["innov_liq"], innovation], axis=1, sort=True).dropna()
print(f"correlatie L_t met onze Amihud-innovatie, {both.index[0]:%Y}–{both.index[-1]:%Y}: {both.corr().iloc[0, 1]:.2f}")
ps["agg_liq"].nsmallest(6).rename("laagste liquiditeitsniveau").round(3).to_frame()
reeks: 1962-08 t/m 2025-12
correlatie L_t met Mkt-RF, 1966–1999: 0.35 (werkdocument: 0.36)
correlatie L_t met Mkt-RF, 1962–2025: 0.30
correlatie L_t met onze Amihud-innovatie, 2002–2025: -0.23
De drie diepste maanden uit het artikel staan ook in de bijgewerkte reeks bij de laagste. De correlatie met het marktrendement ligt vrijwel op de gepubliceerde waarde, al gebruiken we de French-marktfactor in plaats van de NYSE-AMEX-index. Onze Amihud-innovatie correleert negatief met hun liquiditeitsinnovatie, zoals het hoort bij een maat voor illiquiditeit, maar zwak, omdat de twee maten verschillende kanten van liquiditeit meten. In de figuur vallen de diepe, korte uitschieters naar beneden op.
Source
fig, ax = plt.subplots(figsize=(10, 4.5))
ax.plot(ps.index, ps["agg_liq"], lw=1)
for date in ps["agg_liq"].nsmallest(5).index:
    ax.annotate(f"{date:%Y-%m}", (date, ps.loc[date, "agg_liq"]), xytext=(4, -10), textcoords="offset points", fontsize=8)
ax.axhline(0, color="grey", lw=0.8)
ax.set_title("Marktbrede liquiditeit volgens Pástor en Stambaugh, 1962–2025")
ax.set_xlabel("Jaar")
ax.set_ylabel("Geschaalde gemiddelde $\\hat\\gamma_t$")
hap.plotting.timeline_axis(ax, every=5)
plt.show()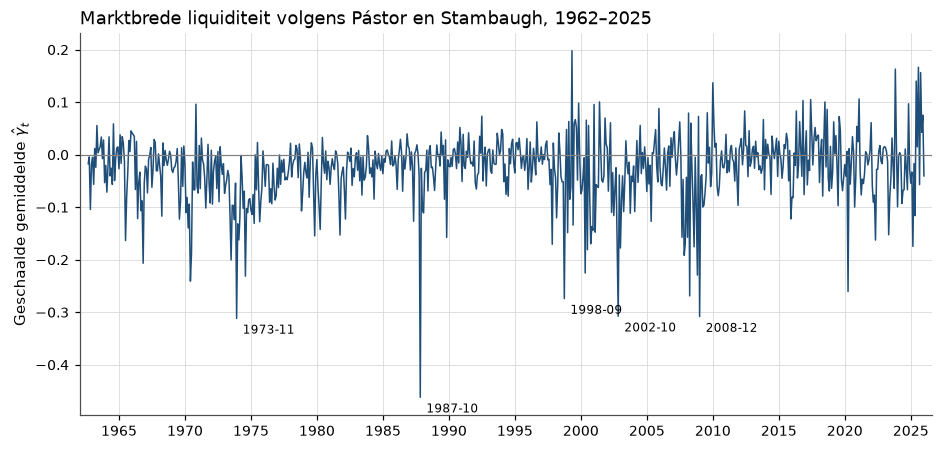
Figure 4:De liquiditeit is meestal rustig en stort af en toe diep in, bijna altijd in een bekende crisismaand. Die asymmetrie maakt van liquiditeit een risico en niet alleen een kost.
Tot slot schatten we de vierfactor-alpha van de verhandelbare factor over de hele periode en over de jaren voor en na publicatie.
momentum = hap_data.french("F-F_Momentum_Factor")
factors4 = pd.concat([hap_data.french("F-F_Research_Data_Factors")[["Mkt-RF", "SMB", "HML"]], momentum],
                     axis=1, sort=True)
rows = {}
for start, end in [("1968", "2025"), ("1968", "2003"), ("2004", "2025")]:
    y = ps["traded_liq"].loc[start:end].dropna()
    fit = hap.stats.newey_west(y, factors4.reindex(y.index), lags=6)
    rows[f"{start}–{end}"] = {
        "maanden": len(y),
        "gemiddeld rendement (% p.j.)": 1200 * y.mean(),
        "vierfactor-alpha (% p.j.)": 1200 * fit.params["const"],
        "standaardfout alpha (% p.j.)": 1200 * fit.bse["const"],
        "t-waarde": fit.tvalues["const"],
    }
pd.DataFrame(rows).T.round(2)De alpha over de hele periode is net significant, maar rust volledig op de jaren tot en met 2003, het jaar van publicatie. Daarna is de alpha licht negatief, en de standaardfout is zo groot dat 22 jaar data een premie als die van vóór 2003 aantonen noch uitsluiten. De tabel hieronder zet de drie perioden naast het origineel.
6.4Origineel en hier
| grootheid | origineel | hier |
|---|---|---|
| , onverwachte illiquiditeit | negatief (jaren 1964–1997) | , (maanden 2002–2026) |
| , verwachte illiquiditeit | positief | , |
| persistentie van illiquiditeit | hoog, jaarlijkse AR(1) | 0,986 per maand, per jaar |
| Roll-maat ongedefinieerd | voor een deel van de aandelen | 36,6% van de aandeel-jaren |
| diepste liquiditeitsmaanden | okt. 1987, nov. 1973, sep. 1998 | plaats 1, 2 en 5 |
| correlatie met marktrendement, 1966–1999 | 0,36 | 0,35 |
| alpha liquiditeitsfactor (% per jaar) | 7,5 (voorspelde bèta’s, 1966–1999) | 3,6, (1968–2025) |
| alpha vóór publicatie (% per jaar) | 5,4, (1968–2003) | |
| alpha na publicatie (% per jaar) | — | , standaardfout 3,03, (2004–2025) |
Gedeeltelijk geslaagd. Het teken van , de crisismaanden en de correlatie met het marktrendement komen uit zoals verwacht, en de Roll-maat is in ruim een derde van de aandeel-jaren ongedefinieerd. Dat niet uitkomt en de premie kleiner is dan gepubliceerd, lag binnen de verwachting. Dat de premie na 2003 niet meer te zien is, hadden we niet voorzien.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. De microstructuurtheorie verklaart waarom er een spread is zonder dat iemand kosten maakt en waarom grote orders de prijs bewegen. Ze verklaart ook waarom prijzen voor het publiek een martingaal zijn terwijl insiders winst maken, en ze zegt hoeveel private informatie in de prijs komt, de helft in één ronde en alles bij doorlopende handel. Daarmee kreeg de efficiënte markt een mechanisme, en via Amihud en Pástor-Stambaugh raakte de handelsvloer verbonden met verwachte rendementen. Dat illiquiditeit in crises piekt en samengaat met lage gelijktijdige rendementen, is robuust.
Waar het breekt. Het model breekt niet in zijn logica, maar bij de meting. De Roll-maat is in ruim een derde van de aandeel-jaren ongedefinieerd en elders opgeblazen, omdat ze alle negatieve autocorrelatie als spread leest en alleen negatieve schattingen meetellen. ILLIQ meet Kyles bovendien alleen met veel ruis. De premie op liquiditeitsrisico is in de twee decennia na publicatie in de eigen factor van Pástor en Stambaugh niet meer te zien, en de standaardfout is daar te groot om iets uit te sluiten.
Risico of vergissing? In de Chicago-lezing is illiquiditeit een kost die rationele beleggers in de prijs verwerken, en liquiditeitsrisico een toestandsvariabele die in slechte tijden toeslaat. Houders van illiquide activa verzekeren in die lezing de markt en worden daarvoor betaald, zodat het risico na 2003 kleiner was of we alleen ruis zien. In de Yale-lezing is illiquiditeit een vorm van de limits of arbitrage uit Behavioral finance en limits of arbitrage. Prijzen wijken af omdat arbitrageurs de posities niet kunnen volhouden, en de premie verdwijnt zodra genoeg kapitaal de kans ziet, zoals McLean en Pontiff voor gepubliceerde anomalieën vonden (De factor zoo).
Een risicopremie vergoedt verliezen in crises en een vergissing verdwijnt na publicatie, maar onze replicatie laat beide zien en beslist de vraag dus niet. Santa-Clara’s praktijkles past op beide lezingen, want wie illiquide activa houdt, kan ze volgens hem niet zomaar verkopen tegen de prijs uit de laatste waardering Santa-Clara (2026).
Wat er daarna kwam. De volgende vraag is wie die handelskosten betaalt en wie eraan verdient. De industrie als financier: indexfondsen, DFA, AQR zoekt het antwoord in de beleggingsindustrie, van actieve fondsen die hun informatievoordeel moeten terugverdienen tot indexfondsen die zo weinig mogelijk handelen.
8Oefeningen
Solution to Exercise 1
(1) Met is en de spread . Die daalt in omdat , dus het maximum ligt bij , met spread , dus en .
(2) Bij is de likelihoodratio van een koop , zodat de odds van 1 naar 3, 9 en 27 gaan en .
belief_path, rows = 0.5, []
for k in range(1, 4):
    b, a = gm_quotes(belief_path, 0.5, V_H, V_L)
    belief_path = belief_path * 0.75 / (belief_path * 0.75 + (1 - belief_path) * 0.25)
    rows.append({"order": k, "bid vóór order": b, "ask vóór order": a, "oordeel na koop": belief_path})
print(pd.DataFrame(rows).round(4).to_string(index=False))

belief_path, n_buys = 0.5, 0
bid, ask = gm_quotes(belief_path, 0.2, V_H, V_L)
while ask - bid >= 0.10:
    belief_path = belief_path * 0.6 / (belief_path * 0.6 + (1 - belief_path) * 0.4)
    n_buys += 1
    bid, ask = gm_quotes(belief_path, 0.2, V_H, V_L)
print(f"\n(3) bij mu = 0.2: spread onder 0.10 na {n_buys} kooporders op rij (oordeel {belief_path:.4f})")
order bid vóór order ask vóór order oordeel na koop
1 99.0 101.0000 0.7500
2 100.0 101.6000 0.9000
3 101.0 101.8571 0.9643
(3) bij mu = 0.2: spread onder 0.10 na 9 kooporders op rij (oordeel 0.9746)
(3) Elke koop vermenigvuldigt de odds met , en na negen kooporders op rij is de spread onder . Het tempo van prijsontdekking hangt dus af van de informatieve waarde van één order, de likelihoodratio .
Solution to Exercise 2
(1) De winst en zijn evenredig met , is er omgekeerd evenredig mee en hangt er niet van af. Bij is dus , , de verwachte winst en . De simulatie hieronder controleert dat.
n_markets = 200_000
rows = {}
for s_u in (10_000.0, 20_000.0):
    b_k, l_k = s_u / 4.0, 4.0 / (2 * s_u)
    v_sim = rng.normal(0.0, 4.0, n_markets)
    u_sim = rng.normal(0.0, s_u, n_markets)
    y_sim = b_k * v_sim + u_sim
    p_sim = l_k * y_sim
    gain = b_k * v_sim * (v_sim - p_sim)
    slope = np.cov(v_sim, y_sim)[0, 1] / np.var(y_sim)
    rows[f"sigma_u = {s_u:,.0f}"] = {
        "lambda (regressie v op y)": slope,
        "gemiddelde winst insider": gain.mean(),
        "Var(v | p)": np.var(v_sim - p_sim),
        "t-waarde na 20 dagen": np.sqrt(20) * gain.mean() / gain.std(),
    }
pd.DataFrame(rows).round(5)De winst en de standaarddeviatie daarvan schalen allebei met , zodat de -waarde na twintig dagen, ongeveer 2,6, niet van afhangt. Ze ligt onder de 4,1 bij vijftig ronden, omdat de insider daar zijn informatie over de tijd spreidt en per eenheid risico meer verdient. Een insider in een drukke markt verdient meer, maar valt statistisch niet meer op.
Solution to Exercise 3
traded = ps["traded_liq"].dropna()
window_rows = []
for end in range(120, len(traded) + 1, 12):
    y = traded.iloc[end - 120:end]
    fit = hap.stats.newey_west(y, factors4.reindex(y.index), lags=6)
    alpha_ann, se_ann = 1200 * fit.params["const"], 1200 * fit.bse["const"]
    window_rows.append({"venster eindigt": f"{y.index[-1]:%Y-%m}", "alpha (% p.j.)": alpha_ann,
                        "ondergrens 95%": alpha_ann - 1.96 * se_ann, "bovengrens 95%": alpha_ann + 1.96 * se_ann})
windows = pd.DataFrame(window_rows).set_index("venster eindigt")

full_fit = hap.stats.newey_west(traded, factors4.reindex(traded.index), lags=6)
resid_vol_ann = np.sqrt(12) * full_fit.resid.std()
years_needed = (2 * resid_vol_ann / 0.03) ** 2
print(f"fractie vensters met ondergrens > 0: {(windows['ondergrens 95%'] > 0).mean():.0%}")
print(f"residuele volatiliteit: {resid_vol_ann:.1%} per jaar; jaren nodig voor t = 2 bij alpha = 3%: {years_needed:.0f}")
windows.iloc[::5].round(2)
fractie vensters met ondergrens > 0: 20%
residuele volatiliteit: 12.6% per jaar; jaren nodig voor t = 2 bij alpha = 3%: 71
De intervallen van tien jaar zijn ongeveer vijftien procentpunt breed, en slechts een vijfde van de vensters ligt volledig boven nul. Met een residuele volatiliteit van 12,6% per jaar is ruim zeventig jaar data nodig om een premie van 3% met te zien. De premie rust dus op het gemiddelde van een halve eeuw, en geen enkel decennium kan die op zich bevestigen of weerleggen.
- Amihud, Y. (2002). Illiquidity and Stock Returns: Cross-Section and Time-Series Effects. Journal of Financial Markets, 5(1), 31–56. 10.1016/S1386-4181(01)00024-6
- Glosten, L. R., & Milgrom, P. R. (1985). Bid, Ask and Transaction Prices in a Specialist Market with Heterogeneously Informed Traders. Journal of Financial Economics, 14(1), 71–100. 10.1016/0304-405X(85)90044-3
- Kyle, A. S. (1985). Continuous Auctions and Insider Trading. Econometrica, 53(6), 1315–1335. 10.2307/1913210
- Roll, R. (1984). A Simple Implicit Measure of the Effective Bid-Ask Spread in an Efficient Market. The Journal of Finance, 39(4), 1127–1139. 10.1111/j.1540-6261.1984.tb03897.x
- Pástor, Ľ., & Stambaugh, R. F. (2003). Liquidity Risk and Expected Stock Returns. Journal of Political Economy, 111(3), 642–685. 10.1086/374184
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- O’Hara, M. (1995). Market Microstructure Theory. Blackwell. 10.1093/rfs/8.4.1235
- Amihud, Y., & Mendelson, H. (1986). Asset Pricing and the Bid-Ask Spread. Journal of Financial Economics, 17(2), 223–249. 10.1016/0304-405X(86)90065-6
- Acharya, V. V., & Pedersen, L. H. (2005). Asset Pricing with Liquidity Risk. Journal of Financial Economics, 77(2), 375–410. 10.1016/j.jfineco.2004.06.007
- Budish, E., Cramton, P., & Shim, J. (2015). The High-Frequency Trading Arms Race: Frequent Batch Auctions as a Market Design Response. Quarterly Journal of Economics, 130(4), 1547–1621. 10.1093/qje/qjv027
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD