

Template: titel van de lecture
1Overzicht¶
De eerste twee zinnen geven de vraag en het antwoord van deze lecture. Daarna volgt een lijst van wat we doen, en pas dan de geschiedenis. Bijvoorbeeld:
Waarom kost een claim op onzekere toekomstige betalingen wat hij kost? Omdat een euro meer waard is in slechte tijden dan in goede, en de prijs die weging optelt. In deze lecture:
leiden we de waarderingsvergelijking af uit één eerste-ordevoorwaarde;
laten we zien dat verwachte rendementen daaruit een bèta-vorm krijgen;
simuleren we hoe vaak een activum zonder enige alpha toch significant lijkt;
repliceren we tabel 3 van Lucas Lucas (1978) op French-data.
Lucas publiceerde het model in 1978 Lucas (1978). Het definieert dit tijdvak omdat het de discontovoet voor het eerst uit een optimalisatieprobleem laat volgen. Deze alinea is de enige plek voor geschiedenis en citaties in het Overzicht; de imports-cel staat niet hier maar bij het toy-voorbeeld.
2Intuïtie: waarom zou dit waar zijn?¶
Voordat er één symbool op papier komt: leg het mechanisme uit in gewone taal. Een lezer die alleen deze sectie leest, moet het resultaat kunnen navertellen. Korte zinnen, één beeld per alinea, geen u-vorm en geen je-vorm.
Een historische anekdote mag, mits die het argument dient. Dat Bachelier zijn proefschrift bij Poincaré verdedigde en een matige beoordeling kreeg, is aardig. Het wordt relevant zodra duidelijk is dat de wiskunde van 1900 nog geen taal had voor wat hij deed.
3Toy-voorbeeld: twee toestanden, drie activa¶
Het kleinste voorbeeld waarin het mechanisme al zichtbaar is, met getallen die op papier na te rekenen zijn. Eerst met de hand, dan in code, en de code moet dezelfde getallen geven. Het toy-voorbeeld mag hoogstens één formule gebruiken die nog niet is afgeleid; hier is dat , en de theorie leidt die formule als eerste af.
De imports-cel staat hier, aan het begin van de eerste sectie met code. Dit is de enige imports-cel van de lecture.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Er zijn twee toestanden op , “goed” en “slecht”, elk met kans , en drie activa:
| Activum | payoff goed | payoff slecht | prijs |
|---|---|---|---|
| obligatie | 1{,}00 | 1{,}00 | 0{,}95 |
| aandeel | 1{,}40 | 0{,}70 | 0{,}95 |
| put | 0{,}00 | 0{,}30 | ? |
Het recept. De prijs van elk activum is de kansgewogen som van zijn payoffs, elk vermenigvuldigd met een gewicht dat van de toestand afhangt: . Dat gewicht is de stochastic discount factor. Twee verhandelde activa geven twee vergelijkingen in twee onbekenden.
Stap 1. Uit de obligatie: , dus .
Stap 2. Uit het aandeel: . Vul in: , dus en .
Stap 3. De put volgt zonder verdere aannames: . De risicovrije rente is .
De SDF is hoog in de slechte toestand, zoals de intuïtie voorspelde: een euro is meer waard voor wie arm is. Nu dezelfde getallen in code.
prob = np.array([0.5, 0.5])
payoffs = np.array([[1.00, 1.00],    # obligatie
                    [1.40, 0.70]])   # aandeel
prices = np.array([0.95, 0.95])

m = np.linalg.solve(payoffs * prob, prices)      # p = E[m x] als lineair stelsel
put = float((prob * m) @ np.array([0.00, 0.30]))
rf = 1 / (prob @ m)

hand = pd.Series({"m_goed": 0.8143, "m_slecht": 1.0857, "R^f": 1.0526, "put": 0.1629})
code = pd.Series({"m_goed": m[0], "m_slecht": m[1], "R^f": rf, "put": put})
pd.DataFrame({"met de hand": hand, "code": code}).round(4)De twee kolommen zijn gelijk. Dat is de controle waarmee de rest van de code in deze lecture te vertrouwen is.
4Theorie¶
We leiden drie dingen af. Eerst de waarderingsvergelijking uit één eerste-ordevoorwaarde; dat is de kern. Daarna de bèta-representatie, die zegt hoe verwachte rendementen uit die vergelijking volgen. Ten slotte de standaardfout van het gemiddelde rendement, die bepaalt hoe goed dit alles te meten is. Deze routekaart staat aan het begin van elke theorie-sectie.
4.1Opzet en aannames¶
Beschrijf de economie: wie handelt, welke informatie er is, en de tijdsindexering. Prijs op is , payoff op is , bruto rendement . Notatie volgens §3 van STYLE.md.
4.2Het kernresultaat: de waarderingsvergelijking¶
Waarom zou dit waar zijn? Een belegger die vandaag een euro minder consumeert en die belegt, geeft vandaag nut op en krijgt morgen nut terug. Hoeveel nut een euro morgen oplevert, hangt af van hoe rijk hij dan is. In een optimum houden verlies en winst elkaar in evenwicht. Meer zegt de afleiding niet; de rest is boekhouding.
De belegger maximeert
onder de budgetrestrictie en , met het aantal aangehouden eenheden. De eerste-ordevoorwaarde naar geeft, na herschikken,
In woorden: de prijs is de verwachte payoff, gewogen met hoe hard een euro morgen nodig is ten opzichte van vandaag. Die lees-zin hoort bij elke genummerde vergelijking.
Vergelijking (2) is de stochastic discount factor-representatie (SDF, stochastische disconteringsfactor). Elk waarderingsmodel in deze reeks is een uitspraak over , niet over . Delen door geeft
en voor een risicovrije claim dus .
4.3Wat het voorspelt: de bèta-representatie¶
Waarom zou dit waar zijn? Een activum dat veel uitbetaalt als laag is, dus in goede tijden, is weinig waard en moet een hoog rendement bieden. Hoe sterk het rendement met meebeweegt, bepaalt de premie.
In woorden: verwachte rendementen verschillen alleen door de hoeveelheid risico ; de prijs van risico is voor alle activa gelijk. Het bewijsidee: splits in plus een covariantie en deel door . Het volledige bewijs staat ingeklapt.
Proof 1
4.4Hoe het getoetst wordt: de standaardfout van 2%¶
Waarom zou dit waar zijn? Een gemiddelde over jaren wordt nauwkeuriger met de wortel van , niet met zelf. Bij een volatiliteit van 20% blijft er na een eeuw dus een onzekerheid van twee procentpunt over.
Met jaarlijkse observaties en jaarvolatiliteit is de standaardfout van het gemiddelde . Voor Amerikaanse aandelen is ; met een eeuw data is . Dit is de standaardfout van 2% die in elke lecture terugkomt: gemiddelden zijn slecht meetbaar, tweede momenten goed. We rekenen het uit.
sigma, T = 0.20, 100
se_mean = sigma / np.sqrt(T)
se_var = np.sqrt(2 / T) * sigma**2  # asymptotisch, onder normaliteit

pd.Series({
    "SE van het gemiddelde (per jaar)": se_mean,
    "SE van de variantie": se_var,
    "SE variantie / variantie": se_var / sigma**2,
}).round(4)
SE van het gemiddelde (per jaar) 0.0200
SE van de variantie 0.0057
SE variantie / variantie 0.1414
dtype: float64De standaardfout van het gemiddelde is een kwart van het gemiddelde zelf; die van de variantie is een zevende van de variantie.
5Simulatie: hetzelfde model op schaal¶
We bouwen een wereld met 200 activa waarvan de ware alpha nul is, geschat op 600 maanden. Per constructie is er niets te vinden. De vraag over steekproeven: hoe vaak vindt een gewone -toets toch een significante alpha, en hoe groot is de grootste? Eén simulatie, één vraag.
n_assets, T = 200, 600
resid = rng.normal(0.0, 0.05, size=(T, n_assets))   # 5% maandelijkse ruis, alpha = 0
sample_alpha = resid.mean(axis=0)
t_stats = sample_alpha / (resid.std(axis=0, ddof=1) / np.sqrt(T))

pd.Series({
    "aandeel |t| > 1.96": np.mean(np.abs(t_stats) > 1.96),
    "aandeel |t| > 3.00": np.mean(np.abs(t_stats) > 3.00),
    "hoogste |t|": np.max(np.abs(t_stats)),
}).round(3)
aandeel |t| > 1.96 0.040
aandeel |t| > 3.00 0.000
hoogste |t| 2.861
dtype: float64Rond de 5% van de activa haalt , zoals het hoort onder de nulhypothese. Daarom is die drempel waardeloos zodra iemand 200 kandidaten heeft geprobeerd en er één rapporteert. De figuur laat de hele verdeling zien.
Source
fig, ax = plt.subplots()
ax.hist(t_stats, bins=30, edgecolor="white")
for c, style in [(1.96, "--"), (3.0, "-")]:
    ax.axvline(c, color="black", ls=style, lw=1)
    ax.axvline(-c, color="black", ls=style, lw=1)
ax.set_xlabel("$t$-waarde van de geschatte alpha")
ax.set_ylabel("Aantal activa")
ax.set_title("200 activa zonder enige alpha: de verdeling van de $t$-waarden")
plt.show()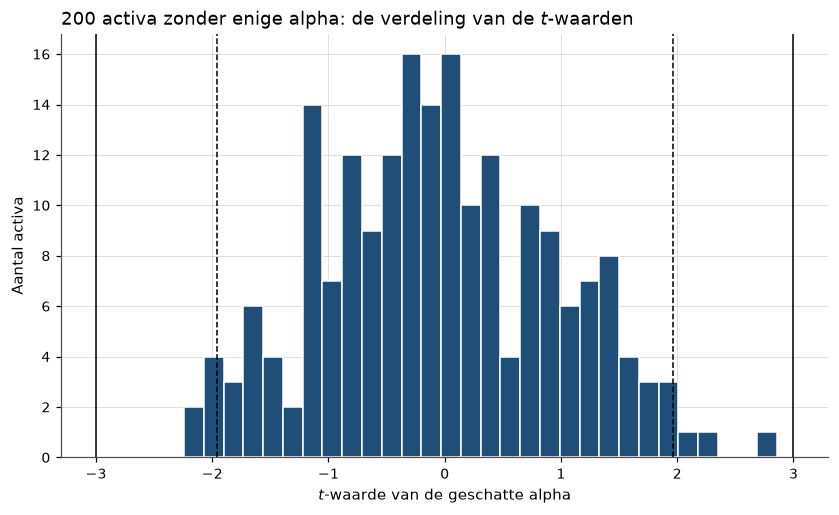
Figure 1:De -waarden van 200 activa zonder alpha. De gestreepte lijnen markeren 1,96, de doorgetrokken lijnen 3,0. Een handvol activa ligt buiten de eerste grens door toeval alleen; dat is de drempel van Harvey, Liu en Zhu in één figuur.
6Replicatie op echte data¶
Het blok is hoogstens 250 woorden; reekscodes en datumdetails staan in de
codecel. De data komen altijd uit hap.data. We laden de reeks en berekenen de
samenvattende statistiek.
# Voorbeeldberekening op gesimuleerde data (in een echte lecture: hap.data.*).
n_years = 100
returns = pd.Series(
    rng.normal(0.08, 0.20, n_years),
    index=pd.period_range("1926", periods=n_years, freq="Y"),
    name="market",
)
se = returns.std(ddof=1) / np.sqrt(n_years)

pd.DataFrame(
    {"origineel": [0.085, 0.20, np.nan],
     "hier": [returns.mean(), returns.std(ddof=1), se]},
    index=["gemiddelde", "standaarddeviatie", "SE gemiddelde"],
).round(4)Geslaagd. Het gemiddelde ligt binnen één standaardfout van de gepubliceerde waarde en de standaarddeviatie binnen 10%, zoals het replicatieblok voorspelde. Het oordeel begint altijd met “Geslaagd”, “Gedeeltelijk geslaagd” of “Niet geslaagd” en staat onder een tabel origineel/hier. De figuur laat de cumulatieve waarde zien.
Source
fig, ax = plt.subplots()
ax.plot(returns.index.year, (1 + returns).cumprod(), lw=1.6)
ax.set_yscale("log")
ax.set_xlabel("Jaar")
ax.set_ylabel("Cumulatieve waarde van 1 euro (log-schaal)")
ax.set_title("Cumulatief rendement van de markt")
plt.show()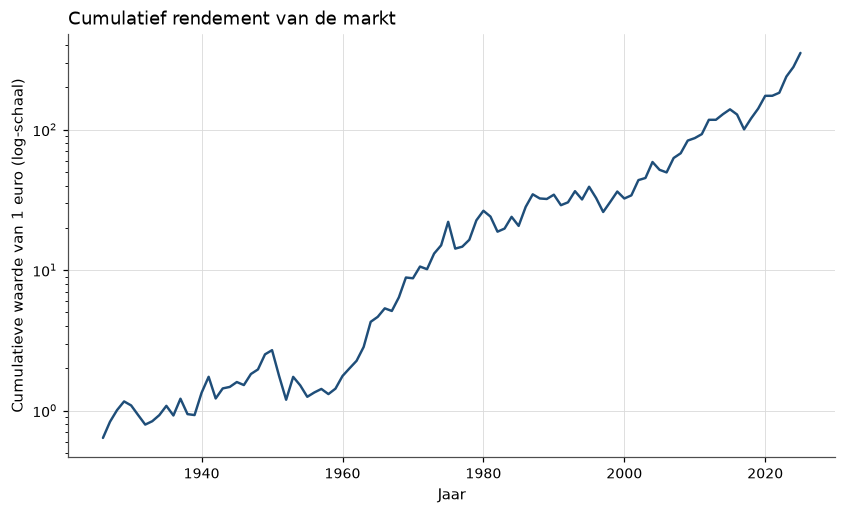
Figure 2:Cumulatieve waarde van één euro, belegd in de markt. De log-schaal maakt gelijke procentuele bewegingen even groot; op een lineaire schaal ziet de recente periode er misleidend dramatisch uit.
7Wat er brak, en wat daarna kwam¶
Twee tot vier alinea’s, elk hoogstens 120 woorden. Benoem expliciet:
Wat het model verklaart. Wees genereus; het model heeft niet voor niets een tijdvak gedomineerd.
Waar het breekt. Eén concreet, meetbaar feit dat het model niet aankan. Liefst het feit dat hierboven is gerepliceerd.
Risico of vergissing? Geef beide lezingen: de Chicago-lezing (de discontovoet varieert) en de Yale-lezing (de prijs zit ernaast). Kies niet voor de lezer.
Wat er daarna kwam. Eén zin die de volgende lecture aankondigt, met een cross-ref: zie Template: titel van de lecture.
8Oefeningen¶
Solution to Exercise 1
(1) Obligatie: . Aandeel: . Uit de eerste ; invullen geeft en . Put: .
prob_2 = np.array([0.6, 0.4])
m_2 = np.linalg.solve(payoffs * prob_2, prices)
put_2 = float((prob_2 * m_2) @ np.array([0.00, 0.30]))
pd.Series({"m_goed": m_2[0], "m_slecht": m_2[1], "put": put_2}).round(4)
m_goed 0.6786
m_slecht 1.3571
put 0.1629
dtype: float64(2) De put wordt goedkoper: de slechte toestand is minder waarschijnlijk, dus de verzekering ertegen is minder waard. Wat dit leert: de prijs van een claim hangt af van de kans op de toestand én van hoe hard een euro daar nodig is.
:::{exercise}
:label: ex-template-2

**Afleiding en simulatie.** Gebruik [](#eq-template-euler).

1. Leid af dat $R^{f} = 1/\E[m]$.
2. Simuleer 10 000 steekproeven van 100 jaarlijkse rendementen met
   $\mu = 8\%$ en $\sigma = 20\%$. Welke fractie van de steekproeven geeft een
   gemiddeld rendement dat meer dan 4 procentpunt naast de waarheid ligt?
3. Herhaal (2) voor de standaarddeviatie. Vergelijk.
Solution to ex-template-2
(1) Neem (een risicovrije claim met payoff 1). Dan geeft (2) , en .
(2) en (3)
n_sim, n_obs, mu, sigma = 10_000, 100, 0.08, 0.20
sims = rng.normal(mu, sigma, size=(n_sim, n_obs))

pd.Series({
    "gemiddelde meer dan 4pp ernaast": np.mean(np.abs(sims.mean(axis=1) - mu) > 0.04),
    "std.dev. meer dan 4pp ernaast": np.mean(np.abs(sims.std(axis=1, ddof=1) - sigma) > 0.04),
}).round(3)
gemiddelde meer dan 4pp ernaast 0.044
std.dev. meer dan 4pp ernaast 0.005
dtype: float64Vier procentpunt is twee standaardfouten van het gemiddelde (), dus ongeveer 4,5% van de steekproeven valt erbuiten. Voor de standaarddeviatie is de standaardfout procentpunt; vier procentpunt is dan bijna drie standaardfouten en komt in ongeveer 0,5% van de gevallen voor.
De schaal is het echte verschil. Vier procentpunt naast een gemiddelde van 8% is een fout van de helft. Vier procentpunt naast een volatiliteit van 20% is een fout van een vijfde en verandert geen enkele conclusie. Wat dit leert: de standaardfout van 2% is groot ten opzichte van wat we willen weten, en klein ten opzichte van wat we goed kunnen meten.
:::{exercise}
:label: ex-template-3

**Uitbreiding van de replicatie.** Herhaal het resultaat uit de replicatie op
een andere steekproefperiode, een andere sortering, of met een robuuste
standaardfout, en interpreteer het verschil.
Solution to ex-template-3
Uitwerking met code en interpretatie. Sluit af met één zin die begint met “Wat dit leert:”.
- Lucas, Jr., Robert E. (1978). Asset Prices in an Exchange Economy. Econometrica, 46(6), 1429–1445. 10.2307/1913837
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD