

Mehra-Prescott en Hansen-Jagannathan
1Overzicht
Hoeveel aandelenpremie (het gemiddelde rendement van aandelen boven de risicovrije rente, hierna kortweg de premie) kan een economie met redelijke risicoaversie opleveren als consumptie zo glad groeit als de Amerikaanse? Hooguit 0,35 procentpunt, tegen 6,18 gemeten over 1889–1978 Mehra & Prescott (1985), want consumptie schommelt te weinig om aandelen riskant te maken. In dit college:
rekenen we een economie met twee toestanden met de hand door, en vinden een premie van 0,26 procentpunt;
leiden we de oplossing van Mehra en Prescott af, rekenen hun maximum van 0,35 procentpunt na, en laten zien waarom de premie ongeveer maal de variantie van consumptiegroei is;
leiden we de grens van Hansen en Jagannathan af, die hetzelfde zegt zonder voorkeuren, en de risicovrije-rentepuzzel van Weil;
simuleren we hoe zeker de puzzel is, gegeven de standaardfout van de premie;
repliceren we tabel 1 van Mehra en Prescott op Shillers data, en de grens van Hansen en Jagannathan op French-data tot 2025.
Mehra en Prescott schreven het artikel in 1979 en publiceerden het in 1985 Mehra & Prescott (1985). Het schat geen parameters, maar kalibreert een Lucas-economie op de Amerikaanse consumptie en vraagt welke paren van rente en premie ze kan voortbrengen. Daarmee verschoof de vraag van “past dit model?” naar “welk model zou dit ooit kunnen passen?”. Weil gaf de tweelingpuzzel over de rente een naam Weil (1989), en Hansen en Jagannathan maakten er een grens van die voor elke stochastische discontofactor geldt Hansen & Jagannathan (1991).
Voor de vraag theorie of feit is dit artikel het kantelpunt. Het consumptie-CAPM was een theorie die met een toets werd verworpen, terwijl de premie sindsdien een feit is dat op een verklaring wacht. Elk later model wordt eraan gemeten.
2Intuïtie: waarom zou dit waar zijn?
Een aandeel is riskant als het slecht rendeert wanneer het de economie slecht gaat, dus wanneer consumptie tegenvalt en een extra euro het meest waard is. Beleggers eisen voor dat risico een premie. Die hangt af van twee dingen: hoe ver consumptie in slechte jaren terugvalt, en hoe erg beleggers dat vinden.
Het eerste is gemeten, en het is klein. Amerikaanse consumptie per hoofd groeide over 1889–1978 gemiddeld 1,83% per jaar, met een standaarddeviatie van 3,57 procentpunt Mehra & Prescott (1985). Een slecht jaar is een jaar met iets minder groei, geen jaar waarin het eten op is. Een verzekering tegen zo’n schommeling is goedkoop, tenzij beleggers er extreem afkerig van zijn.
Neem aan dat die extreme afkeer er is. De standaardvoorkeuren koppelen afkeer van schommelingen tussen goede en slechte jaren aan afkeer van schommelingen door de tijd. Omdat consumptie groeit, wil zo’n belegger toekomstige rijkdom naar vandaag halen door te lenen. Als iedereen wil lenen en niemand wil uitlenen, stijgt de rente tot niemand meer wil lenen. De premie is dan alleen te redden door de rente op te drijven. Toch was de reële rente over dezelfde periode gemiddeld maar 0,80%.
Hansen en Jagannathan zagen dat dit argument geen voorkeuren nodig heeft, omdat elk prijsmodel een uitspraak is over de stochastische discontofactor. Leveren aandelen per eenheid risico veel meer op dan de risicovrije belegging, dan moet de stochastische discontofactor hevig schommelen, relatief minstens zoveel als die opbrengst per eenheid risico. In de data van Mehra en Prescott is die opbrengst per eenheid risico de premie gedeeld door de standaarddeviatie van de premie, per jaar, en dat is de Sharpe-ratio van de markt. Een stochastische discontofactor die uit consumptie is gebouwd, haalt dat alleen met een zeer hoge risicoaversie.
De puzzel draait om één getal, de gemiddelde premie, en juist dat getal is slecht gemeten. De 6,18 heeft een standaardfout van 1,76 Mehra & Prescott (1985). Daarin komt de standaardfout van 2% uit Rendementen en hun statistiek terug, want over negentig jaar ligt een gemiddeld rendement maar op twee procentpunt na vast. De ware premie kan dus ook de helft zijn.
We verwachten daarom dat de premie in het model klein is, ongeveer de risicoaversie maal de variantie van consumptiegroei. Een hogere risicoaversie geeft een hogere premie, maar tegelijk een hogere rente. De meetonzekerheid maakt de kloof kleiner, maar niet klein genoeg om te verdwijnen.
3Toy-voorbeeld: twee toestanden, een premie van een kwart procentpunt
We rekenen de kleinste versie van de economie van Mehra en Prescott met de hand door. We beginnen met de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Consumptie groeit elk jaar met 5,4% of met , met gelijke kans en onafhankelijk van vorig jaar. Dit is de kalibratie van Mehra en Prescott, met de gemiddelde groei plus of min Mehra & Prescott (1985) (p. 154). Het aandeel is een claim op consumptie, want het dividend is de consumptie zelf.
Voor de voorkeuren nemen we en . Naast de groei staat in de tabel daarom de kolom , die we voor nodig hebben, en de kolom voor in stap 3.
| toestand | kans | groei | ||
|---|---|---|---|---|
| hoog | 0,5 | 1,054 | 0,9488 | 0,9002 |
| laag | 0,5 | 0,982 | 1,0183 | 1,0370 |
Het recept. De Euler-vergelijking uit Lucas, Breeden en de SDF is , met en de bruto consumptiegroei. Als controle gebruiken we één formule die de theorie als eerste afleidt, namelijk dat de premie gelijk is aan maal de covariantie van met het rendement .
Stap 1: de stochastische discontofactor. en . Een euro in het lage jaar is 15% meer waard.
Stap 2: de rente. Een obligatie die 1 betaalt, kost . Dus , een rente van 4,29%.
Stap 3: de prijs-dividendratio. Omdat groei niet van vorig jaar afhangt, is de ratio in beide toestanden gelijk. De Euler-vergelijking, gedeeld door het dividend van vandaag, wordt met . Dus .
Stap 4: het rendement. , dus en . Het gemiddelde is .
Stap 5: de premie. , dus 0,26 procentpunt. Controle via de covariantie: bij twee even waarschijnlijke toestanden is , en .
De code volgt dezelfde vijf stappen en zet de uitkomst naast de handberekening.
def iid_economy(beta, gamma, growth):
    """Lucas tree with equally likely iid growth states; the dividend is consumption."""
    prob = np.full(len(growth), 1 / len(growth))
    m = beta * growth ** (-gamma)                   # step 1
    rf = 1 / (prob @ m) - 1                         # step 2: 1 / (1 + R^f) = E[m]
    k = prob @ (m * growth)                         # step 3: PD = k (1 + PD)
    R = growth / k                                  # step 4: R = g (1 + PD) / PD = g / k
    premium = prob @ R - (1 + rf)                   # step 5
    cov_mR = prob @ (m * R) - (prob @ m) * (prob @ R)
    return {"m hoog": m[0], "m laag": m[1], "R^f": rf, "k": k, "R hoog": R[0], "R laag": R[1],
            "E[R]": prob @ R, "premie": premium, "premie via covariantie": -(1 + rf) * cov_mR}


growth_mp = np.array([1.054, 0.982])               # 1.018 +/- 0.036, Mehra-Prescott (1985, p. 154)
hand = {"m hoog": 0.8912, "m laag": 1.0266, "R^f": 0.0429, "k": 0.9737, "R hoog": 1.0825,
        "R laag": 1.0085, "E[R]": 1.0455, "premie": 0.0026, "premie via covariantie": 0.0026}
pd.DataFrame({"met de hand": hand, "code": iid_economy(0.99, 2, growth_mp)}).round(4)De twee kolommen zijn gelijk, en ze laten zien waar de kleine premie vandaan komt. De stochastische discontofactor verschilt maar 0,14 tussen de toestanden en het rendement maar 7,4 procentpunt, zodat de covariantie, een kwart van dat product, klein blijft.
4Theorie
We leiden vijf dingen af. Eerst schrijven we de premie als covariantie met de stochastische discontofactor, de controle uit stap 5. Daarna volgt de kern, de oplossing van Mehra en Prescott met hun maximum van 0,35 procentpunt. Vervolgens laten we zien waarom dat getal klein is, want in een lognormale economie is de premie maal de variantie van consumptiegroei. Ten slotte laat de grens van Hansen en Jagannathan zien dat de premie ook zonder het hele model te klein is, en laat de rente zien waarom een hoge geen uitweg biedt.
4.1Opzet: de premie als covariantie
Waarom zou dit waar zijn? Een belegger die een aandeel koopt in plaats van de obligatie, ruilt een zekere euro in voor een onzekere. Valt het aandeel tegen wanneer de stochastische discontofactor hoog is, dan levert het het minst op wanneer een euro het meest waard is. Zo’n aandeel wil niemand tegen de obligatieprijs hebben, zodat de prijs daalt tot het gemiddelde rendement hoger ligt. Hoe sterker rendement en stochastische discontofactor tegen elkaar in bewegen, hoe hoger de premie.
We splitsen de Euler-vergelijking voor een rendement in een verwachtingsdeel en een covariantie. Uit en volgt, na vermenigvuldigen met ,
Een aandeel dat hoog rendeert als laag is, heeft dus een negatieve covariantie en een positieve premie. In het toy-voorbeeld is de covariantie en de premie 0,26 procentpunt.
Mehra en Prescott vullen in met consumptie. Groei neemt de waarden aan volgens een Markov-keten met overgangskansen en stationaire verdeling (de kansen op elke toestand op lange termijn). Het dividend is consumptie, en de prijs in toestand is . Mehra en Prescott schrijven , en waar wij , en schrijven.
Ze kalibreerden twee toestanden op hun tabel 1, met groei en een kans om in dezelfde toestand te blijven. De autocorrelatie van groei is dan , zoals in de data. Het toy-voorbeeld is dezelfde keten met kans . We schrijven en niet de van Mehra en Prescott, omdat in Lucas, Breeden en de SDF de hefboom is. Mehra en Prescott stonden toe, op grond van micro- en macrobewijs, en . De toelaatbare regio (admissible region: alle paren van gemiddelde rente en premie die zulke voorkeuren voortbrengen, bij een rente tussen nul en vier procent) staat in figuur 4 van hun artikel.
4.2Het kernresultaat: de toelaatbare regio
Er is een gesloten oplossing, omdat een belegger met CRRA-nut een schommeling van een procent even erg vindt, hoe rijk hij ook is. Hij betaalt voor de boom dus een vast veelvoud van het dividend van vandaag, en dat veelvoud hangt alleen van de toestand af. Er blijft per toestand één prijs-dividendratio over, met een lineair stelsel van evenveel vergelijkingen als toestanden.
De ratio is de verdisconteerde som van alle toekomstige dividendgroei. Voor het bewijs vullen we in de Euler-vergelijking in en delen door . Rendement en rente volgen daarna direct:
Het rendement is groei maal de verhouding van prijs plus dividend morgen tot de prijs vandaag, beide per eenheid dividend. De rente is het omgekeerde van de verwachte stochastische discontofactor. De gemiddelden en zijn gewogen met .
Proof 1
Invullen van en in en delen door geeft , ofwel . Bij een spectraalstraal kleiner dan één is niet-negatief, en de oplossing uniek en positief. Dit is de voorwaarde van Mehra en Prescott (p. 151), de eindige versie van Theorem 1. Het rendement volgt uit met , de rente uit . Ergodiciteit maakt tijdgemiddelden gelijk aan gemiddelden onder .
We lossen de keten van Mehra en Prescott op voor en , met zoals in het toy-voorbeeld.
def stationary(trans):
    """Stationary distribution: the eigenvector of trans' with eigenvalue 1, scaled to sum to 1."""
    vals, vecs = np.linalg.eig(trans.T)
    pi = np.real(vecs[:, np.argmax(np.real(vals))])
    return pi / pi.sum()


def mp_economy(gamma, beta, growth, trans, pi):
    """Mehra-Prescott Markov economy with dividend = consumption, for one (gamma, beta).

    Returns the P/D ratio per state, the stationary means of the gross return and the
    net risk-free rate under the stationary distribution pi, and whether the
    equilibrium exists (spectral radius of A < 1).
    """
    n = len(growth)
    A = beta * trans * growth ** (1 - gamma)                # a_ij = beta P_ij g_j^(1-gamma)
    exists = np.max(np.abs(np.linalg.eigvals(A))) < 1
    pd_ratio = np.linalg.solve(np.eye(n) - A, A @ np.ones(n))
    R = np.empty((n, n))
    for i in range(n):
        for j in range(n):
            R[i, j] = growth[j] * (1 + pd_ratio[j]) / pd_ratio[i]
    expected_R = (trans * R).sum(axis=1)                    # E_i[R], per state today
    gross_rf = 1 / (beta * trans * growth ** (-gamma)).sum(axis=1)
    return {"PD": pd_ratio, "ER": expected_R @ pi, "ERf": gross_rf @ pi - 1, "exists": exists}
De functie volgt de propositie stap voor stap. De stationaire verdeling is de eigenvector van de getransponeerde overgangsmatrix bij eigenwaarde één. We rekenen hem één keer uit en vullen de kalibratie van Mehra en Prescott in.
trans_mp = np.array([[0.43, 0.57],
                     [0.57, 0.43]])
pi_mp = stationary(trans_mp)
chain = {}
for gamma_val in (2, 10):
    eco = mp_economy(gamma_val, 0.99, growth_mp, trans_mp, pi_mp)
    chain[f"gamma = {gamma_val}"] = {
        "PD hoog": eco["PD"][0], "PD laag": eco["PD"][1], "E[R]": eco["ER"],
        "rente (%)": 100 * eco["ERf"], "premie (%)": 100 * (eco["ER"] - 1 - eco["ERf"]),
    }
pd.DataFrame(chain).T.round(4)Bij is de premie 0,29 procentpunt bij een rente van 4,3%, vrijwel het toy-voorbeeld, omdat de negatieve autocorrelatie weinig verandert. Bij stijgt de premie naar 2,7 procentpunt, maar de rente naar 13,1%. Meer risicoaversie tilt premie en rente dus samen op, zoals we in de intuïtie al verwachtten.
De toelaatbare regio volgt door hetzelfde stelsel op te lossen voor 400 waarden van maal 400 waarden van . Daarvan houden we de paren met een rente tussen nul en vier procent, en onder die paren zoeken we de grootste premie.
rows = []
for gamma_val in np.linspace(0.05, 10, 400):
    for beta_val in np.linspace(0.05, 0.999, 400):
        eco = mp_economy(gamma_val, beta_val, growth_mp, trans_mp, pi_mp)
        rows.append({"gamma": gamma_val, "beta": beta_val, "exists": eco["exists"],
                     "rf": eco["ERf"], "premium": eco["ER"] - 1 - eco["ERf"]})
grid = pd.DataFrame(rows)
rf_grid, prem_grid = grid["rf"].to_numpy(), grid["premium"].to_numpy()
admissible = grid["exists"].to_numpy() & (rf_grid >= 0) & (rf_grid <= 0.04)

i_max = np.argmax(np.where(admissible, prem_grid, -np.inf))
pd.Series({
    "bestaande evenwichten (% van rooster)": 100 * grid["exists"].mean(),
    "grootste premie (%)": 100 * prem_grid[i_max],
    "bij gamma": grid["gamma"][i_max],
    "bij beta": grid["beta"][i_max],
    "bij rente (%)": 100 * rf_grid[i_max],
    "Mehra-Prescott (1985, p. 156), premie (%)": 0.35,
}).round(3)
bestaande evenwichten (% van rooster) 99.913
grootste premie (%) 0.362
bij gamma 2.419
bij beta 0.999
bij rente (%) 3.990
Mehra-Prescott (1985, p. 156), premie (%) 0.350
dtype: float64Het rooster geeft een grootste premie van 0,362%, tegen 0,35% bij Mehra en Prescott. Dat maximum ligt aan de rand, met vlak bij één en een rente van vier procent. Het verschil van een honderdste procentpunt doet voor de conclusie niet ter zake. Let in de figuur hieronder op de schaal, want links staat de regio zelf en rechts dezelfde regio naast de gemeten premie met twee standaardfouten.
Source
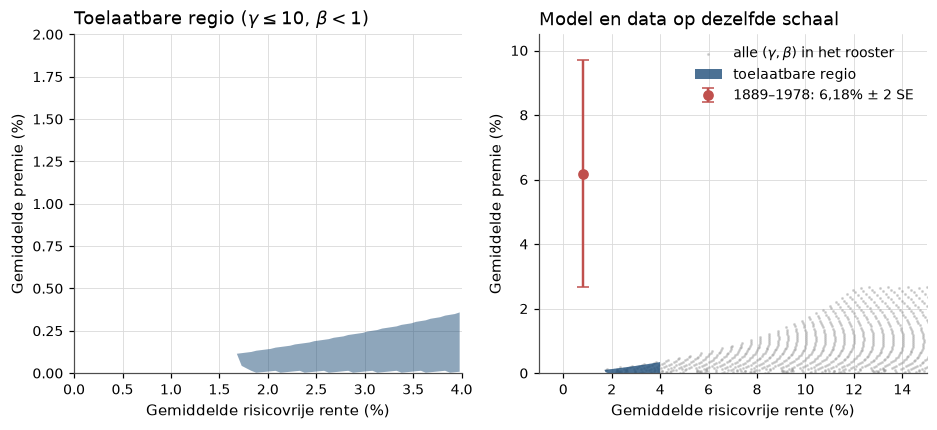
Figure 1:Links: de toelaatbare regio van Mehra en Prescott, nagerekend. Met een rente tussen nul en vier procent komt de premie nergens boven 0,36 procentpunt. Rechts: alle evenwichten met . De premie groeit alleen samen met de rente. Ook de onderkant van het 95%-interval rond de historische premie, , ligt ruim een factor zeven boven de regio.
Rechts liggen alle evenwichten op een smalle band van linksonder naar rechtsboven. Geen combinatie van voorkeuren tilt de premie op zonder de rente mee te nemen. De laatste subsectie van de theorie werkt die band uit als de risicovrije-rentepuzzel.
4.3Wat het voorspelt: waarom de premie klein is
Waarom zou dit waar zijn? Een belegger in de boom verliest in slechte jaren evenveel als consumptie daalt, want het dividend is consumptie. De covariantie van zijn rendement met consumptiegroei is dus de variantie van consumptiegroei, en die is klein. Meer risicoaversie maakt de premie evenredig groter, terwijl gladdere consumptie de premie met het kwadraat kleiner maakt.
Vanaf hier zijn en logs. Neem iid lognormale groei, . (8) gaf voor die groei en een dividend dat met een hefboom op consumptie reageert de rente en de premie in gesloten vorm. We schrijven hier en voor de en van (8), om ze te onderscheiden van de momenten van rendementen in dit college. Met hefboom één, dus met het dividend gelijk aan consumptie, geeft die vergelijking exact
De premie is dus risicoaversie maal de covariantie van rendement en consumptiegroei, en in de boom is die covariantie de variantie van consumptiegroei. De rente stijgt met verwachte groei, omdat lenen dan aantrekkelijk is, en daalt met de variantie, omdat beleggers uit voorzorg sparen.
Mehra zet de momenten van 1889–1978 om naar een variantie Mehra (2003) (p. 13–15). De premie is dus klein, zoals verwacht, omdat ze de variantie van een gladde consumptiereeks maal is. Bij komt ze op 0,25 procentpunt, vrijwel de 0,26 van het toy-voorbeeld, en zelfs bij op niet meer dan 1,25 procentpunt.
Voor het gemeten gemiddelde rendement van 6,98% bij een rente van 0,80% is nodig, en oefening 2 rekent dat na. Een echt aandeel beweegt niet perfect met consumptie mee, maar is wel veel volatieler. Of de benodigde lager of hoger uitvalt, hangt ervan af welke van de twee wint, en dat rekent de simulatie uit.
4.4Hoe het getoetst wordt: de Hansen-Jagannathan-grens
De grens volgt uit een positie die niets kost. Een belegger die aandelen koopt met geld dat hij tegen de obligatierente leent, betaalt vandaag niets. De stochastische discontofactor moet die positie dus op nul waarderen. Heeft de positie een positief gemiddelde, dan lukt dat alleen als ze slecht betaalt wanneer de stochastische discontofactor hoog is. Hoe hoger het gemiddelde per eenheid risico, hoe harder de stochastische discontofactor moet schommelen.
De relatieve schommeling van de stochastische discontofactor is dus minstens de Sharpe-ratio (gemiddeld overrendement gedeeld door zijn standaarddeviatie) van elk overrendement. Het overrendement met de hoogste Sharpe-ratio stelt daarom de strengste eis.
Met moet de standaarddeviatie van minstens de Sharpe-ratio van de markt zijn, 0,37 in de data van Mehra en Prescott. In de lognormale economie is . Bij haalt dus pas de grens. We controleren dat in de economie van het toy-voorbeeld.
sharpe_mp = 6.18 / 16.67                            # Mehra-Prescott (1985), table 1
sdf_rows = {}
for gamma_val in (2, 10, 25):
    m_values = 0.99 * growth_mp ** (-gamma_val)     # two equally likely states, as in the toy
    sdf_rows[gamma_val] = {"E[m]": m_values.mean(), "sigma(m)": m_values.std(),
                           "sigma(m)/E[m]": m_values.std() / m_values.mean(),
                           "Sharpe-ratio Mehra-Prescott": sharpe_mp, "rente (%)": 100 * (1 / m_values.mean() - 1)}
pd.DataFrame(sdf_rows).T.rename_axis("gamma").round(4)Bij schommelt de stochastische discontofactor 7%, een vijfde van wat de grens eist. Het gemiddelde 0,9589 is de obligatieprijs uit stap 2 van het toy-voorbeeld. Bij komt de verhouding met 0,34 dicht bij 0,37, maar de rente is dan 12,8%. Bij is de grens ruim gehaald, met 0,71, maar de rente is nog 9,6%. De grens is noodzakelijk, niet voldoende.
Tot hier ging het om één overrendement. Met meerdere activa wordt de eis strenger, en daarvoor is een tweede stelling nodig. Een belegger die meer activa kan combineren, vindt namelijk een hogere Sharpe-ratio, en elk overrendement is een extra eis aan de stochastische discontofactor. Zonder risicovrij activum ligt niet vast. Bij elke kandidaatwaarde hoort dan een minimale schommeling, en de stochastische discontofactor met die minimale schommeling is een lineaire combinatie van de rendementen, net als de minimum-variantieportefeuille van Markowitz, Roy en Tobin. Laat een vector van bruto rendementen zijn met gemiddelde en niet-singuliere covariantiematrix .
Bij elk gemiddelde van de stochastische discontofactor hoort dus een minimale variantie. De grens wordt gehaald door een stochastische discontofactor die lineair is in de rendementen, . Economisch is de prijs van een zekere euro. Een echt risicovrij activum zou singulier maken, maar de reële T-bill in is bijna risicovrij en legt daardoor bijna vast op . Daar valt de grens ongeveer samen met de Sharpe-grens, in de data van Mehra en Prescott . Bij elke andere waardeert de T-bill verkeerd, en de grens wordt een smalle V rond . Het bewijs rust erop dat elke toegestane dezelfde covariantie met heeft, terwijl de kleinste variabele met die covariantie is.
Proof 3
Uit en volgt , voor elke toegestane dezelfde vector. Voor is en , zodat is toegestaan. Schrijf . Dan is en . Omdat lineair is in , is ook , en dus . Invullen geeft de kwadratische vorm voor .
Hansen en Jagannathan eisten in een tweede stap ook dat positief is, wat de
grens aanscherpt. De replicatie gebruikt de versie zonder die eis,
hap.stats.hansen_jagannathan_bound, en dus een ondergrens op een ondergrens.
4.5Waarom de rente de uitweg afsluit
Met CRRA-nut meet zowel de afkeer van schommelingen tussen toestanden als die van schommelingen door de tijd. Een belegger met een hoge wil de groei van zijn consumptie naar vandaag halen en dus lenen. Om hem tevreden te laten sparen, moet de rente stijgen, tenzij zijn geduld onwaarschijnlijk groot is.
We beginnen zonder onzekerheid, omdat de rente dan alleen van geduld en groei afhangt. Bij constante groei geeft de Euler-vergelijking , dus
Eén procentpunt meer rente verhoogt de gewenste consumptiegroei dus met procentpunt. Die heet de elasticity of intertemporal substitution (EIS, intertemporele substitutie-elasticiteit: hoe sterk consumptiegroei op de rente reageert). Bij is , zodat een belegger zijn consumptie nauwelijks verschuift.
Met onzekerheid komt de voorzorgsterm uit (4) erbij. Die wint pas bij een zeer grote van de leenwens . We zetten de rente gelijk aan de gemeten 0,80% en lossen op naar de die daarvoor nodig is.
mean_g, sd_g, gross_rf_obs = 1.018, 0.036, 1.008       # Mehra-Prescott 1889-1978 (Mehra 2003, table 4)
var_c = np.log(1 + sd_g**2 / mean_g**2)
mu_c = np.log(mean_g) - var_c / 2

gammas_rf = np.array([0.5, 1, 2, 5, 10, 13.8, 20, 27.1, 30, 40, 47.6])
beta_needed = np.exp(-np.log(gross_rf_obs) + gammas_rf * mu_c - 0.5 * gammas_rf**2 * var_c)
roots = (mu_c + np.array([-1, 1]) * np.sqrt(mu_c**2 - 2 * var_c * np.log(gross_rf_obs))) / var_c

print(f"sigma_c^2 = {var_c:.5f}, mu_c = {mu_c:.4f}")
print(f"beta < 1 alleen voor gamma < {roots[0]:.2f} of gamma > {roots[1]:.1f}")
pd.DataFrame({"gamma": gammas_rf, "benodigde beta": beta_needed}).set_index("gamma").T.round(3)
sigma_c^2 = 0.00125, mu_c = 0.0172
beta < 1 alleen voor gamma < 0.47 of gamma > 27.1
De twee waarden van waarbij de benodigde precies één is, volgen door in te vullen: is een kwadratische vergelijking in , met de wortels 0,47 en 27,1 uit de cel. De benodigde is het grootst bij , daarom staat die waarde in de tabel. Lucas, Breeden en de SDF komt met 1,8% en 3,5% voor dezelfde uitdrukking op 14,7, en dat verschil komt uit de kalibratie.
Voor elke tussen ongeveer een half en 27 is een groter dan één nodig, zodat beleggers de toekomst zwaarder moeten wegen dan het heden. Pas boven drukt het voorzorgssparen de rente weer omlaag. Bij hoort , de combinatie waarmee Mehra 1889–1978 exact reproduceert Mehra (2003). Die oplossing ligt op het scherp van de snede: één eenheid meer of minder verschuift de rente ruim vier procentpunt (oefening 2).
Weil schreef dit op in voorkeuren waarin en los van elkaar worden gekozen Weil (1989)Epstein & Zin (1989). Het losmaken lost de premie niet op, en legt een tweede puzzel bloot. Waarom is de rente zo laag, als beleggers hun consumptie zo weinig over de tijd willen verschuiven? Kocherlakota concludeerde in 1996 dat de lage rente plausibele verklaringen heeft, maar de hoge premie grotendeels een raadsel blijft Kocherlakota (1996).
5Simulatie: hoe zeker is de puzzel?
De historische premie heeft een standaardfout van 1,76 procentpunt, dicht bij de twee procentpunt die Rendementen en hun statistiek voor een gemiddeld rendement over een eeuw vond. Welke risicoaversie zou een onderzoeker met negentig jaar data dan schatten, als de ware premie 6% is, of maar 3%?
We trekken 10.000 steekproeven van negentig jaar uit een wereld met bivariaat normale consumptiegroei en overrendementen. De standaarddeviaties komen uit tabel 1 van Mehra en Prescott, en die van consumptie is vrijwel de van het toy-voorbeeld. Per steekproef schatten we , de van (4) met de gemeten covariantie.
Voor de correlatie nemen we 0,37, die van consumptiegroei met het totale aandelenrendement in tabel 1 van Kocherlakota Kocherlakota (1996). Ze volgt uit de covariantie en de twee varianties in die tabel,
Met het overrendement is ze uit dezelfde tabel ongeveer 0,33. Een lagere correlatie maakt de geschatte alleen groter, dus 0,37 is de voorzichtige keuze.
Die is niet de 47,6 van de boom, want een echt aandeel is keer zo volatiel als consumptie. De covariantie is daardoor groter dan . De ware bij 6% premie is 0,06 gedeeld door die covariantie, 27,2 in de simulatietabel hieronder. De tabel aan het eind van de replicatie zet deze maatstaf naast de andere.
n_sim, n_years = 10_000, 90
sd_c, sd_e, corr_ce = 0.0357, 0.1667, 0.37
cov_true = corr_ce * sd_c * sd_e

sim_rows, gamma_draws = {}, {}
for premium_true in (0.03, 0.06):
    z_c = rng.standard_normal((n_sim, n_years))
    z_e = corr_ce * z_c + np.sqrt(1 - corr_ce**2) * rng.standard_normal((n_sim, n_years))
    dc = 0.0183 + sd_c * z_c
    excess = premium_true + sd_e * z_e
    premium_hat = excess.mean(axis=1)
    cov_hat = ((dc - dc.mean(axis=1, keepdims=True)) * (excess - premium_hat[:, None])).sum(axis=1) / (n_years - 1)
    gamma_hat = premium_hat / cov_hat
    gamma_draws[premium_true] = gamma_hat
    q = np.percentile(gamma_hat, [2.5, 50, 97.5])
    sim_rows[f"ware premie {premium_true:.0%}"] = {
        "ware gamma": premium_true / cov_true,
        "premie 2.5%": 100 * np.percentile(premium_hat, 2.5),
        "premie 97.5%": 100 * np.percentile(premium_hat, 97.5),
        "geschatte gamma 2.5%": q[0], "geschatte gamma mediaan": q[1], "geschatte gamma 97.5%": q[2],
        "kans geschatte gamma <= 10": np.mean(gamma_hat <= 10),
        "relatieve spreiding premie": premium_hat.std() / premium_true,
        "relatieve spreiding covariantie": cov_hat.std() / cov_true,
    }
pd.DataFrame(sim_rows).T.round(3)In een wereld met 6% premie loopt het 95%-interval van de geschatte premie van 2,6 tot 9,5 procent. De geschatte ligt dan tussen ongeveer tien en ruim zeventig. Let in de figuur op de gestreepte lijn bij , en op hoeveel van elke verdeling rechts ervan ligt.
Source
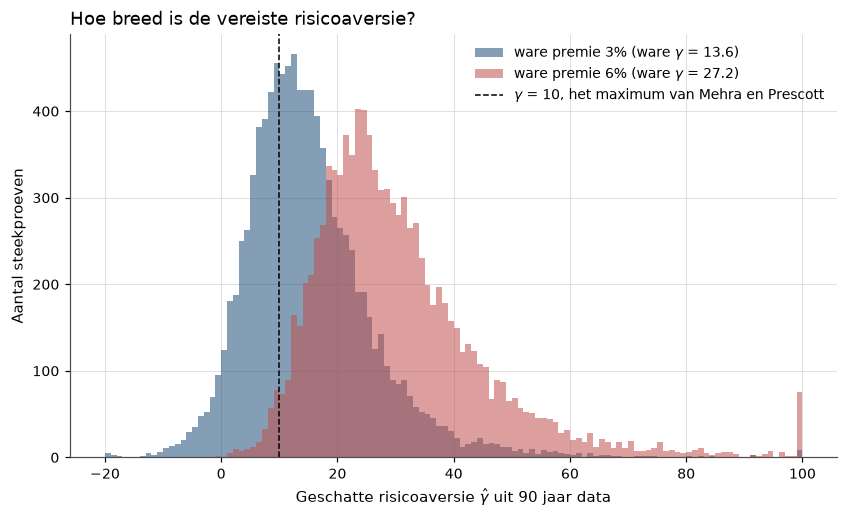
Figure 2:De risicoaversie die een onderzoeker uit negentig jaar data zou afleiden, in een wereld waarin de ware premie 3% respectievelijk 6% is. De verdelingen overlappen sterk, zodat dezelfde steekproef past bij een ware rond de dertien en rond de zevenentwintig. Maar ook in de wereld met 3% premie ligt het grootste deel van de massa boven de tien.
De simulatie trekt twee conclusies, in tegengestelde richting. De eerste is bescheidenheid, want bij een ware van 27,2 kan negentig jaar data alles tussen tien en zeventig opleveren. Welk geschat moment die spreiding veroorzaakt, hangt af van de ware premie.
Bij de hoge premie dragen gemiddelde en covariantie evenveel bij, elk met een relatieve spreiding van ongeveer 30%. Bij de lage premie domineert het gemiddelde met bijna 60%, omdat dezelfde absolute fout zwaarder weegt naarmate de premie kleiner is. Dat verschil is de standaardfout van 2% in relatieve termen.
De tweede conclusie is dat de puzzel ondanks die onzekerheid overeind blijft. Ook als de ware premie 3% is, de helft van de gemeten premie, valt in twee derde van de steekproeven boven de tien. De ware is dan 13,6, nog steeds boven wat Mehra en Prescott toelieten.
6Replicatie op echte data
6.1Tabel 1 van Mehra en Prescott
Mehra en Prescott berekenden het jaarrendement uit jaargemiddelde prijzen (p. 148). Shillers dividendkolom is een voortschrijdende twaalfmaandssom. Het jaargemiddelde ervan meet de dividenden die tussen twee gemiddelde prijsdata zijn uitgekeerd. We zetten de drie reeksen naast hun tabel 1.
shiller = hap_data.shiller()
year = shiller.index.year
price = shiller["price"].groupby(year).mean()            # annual average price (MP series P)
cpi = shiller["cpi"].groupby(year).mean()
dividend = shiller["dividend"].groupby(year).mean()      # trailing 12m dividends, averaged over the year
rfree = hap_data.goyal_welch("annual")["Rfree"]
rfree.index = rfree.index.year

inflation = cpi.shift(-1) / cpi
mp_annual = pd.DataFrame(
    {
        "S&P reëel": (price.shift(-1) + dividend.shift(-1)) / price / inflation - 1,
        "risicovrij reëel": (1 + rfree) / inflation - 1,
    }
).loc[1889:2024].dropna()
mp_annual["premie"] = mp_annual["S&P reëel"] - mp_annual["risicovrij reëel"]


def moments(frame):
    n = len(frame)
    return pd.DataFrame({"gemiddelde": frame.mean(), "standaarddeviatie": frame.std(),
                         "SE": frame.std() / np.sqrt(n)}) * 100


published = pd.DataFrame(
    {"gemiddelde": [0.80, 6.18, 6.98], "standaarddeviatie": [5.67, 16.67, 16.54], "SE": [0.60, 1.76, 1.74]},
    index=["risicovrij reëel", "premie", "S&P reëel"],
)
table1 = pd.concat(
    {
        "Mehra-Prescott 1985, 1889-1978": published,
        "hier, 1889-1978": moments(mp_annual.loc[1889:1978]),
        f"hier, 1889-{mp_annual.index[-1]}": moments(mp_annual),
    },
    axis=1,
).loc[["risicovrij reëel", "premie", "S&P reëel"]]
table1.round(2)Geslaagd. Premie en reële rente liggen ruim binnen de verwachte afwijking, want de premie ligt op vier honderdste procentpunt van 6,18 en de rente op vijf honderdste van 0,80%. Ook de standaardfouten liggen op een honderdste van 1,76 en 0,60.
Tot 2024 is de premie groter, 6,92%, en de standaardfout gezakt van 1,77 naar 1,34. Dat gaat langzaam, zoals voorspelt, en een halve eeuw nieuwe data heeft de puzzel verscherpt. De 8,3% van Opzet, data en conventies meet iets anders, namelijk de French-marktfactor sinds 1926, berekend uit maandrendementen.
6.2Consumptie en de vereiste risicoaversie
Het mechanisme van de theorie is gladde consumptie. We meten de consumptiemomenten op FRED-data vanaf 1929, en schatten de vereiste risicoaversie op twee manieren. De eerste deelt de premie door de gemeten covariantie, zoals in de simulatie. De tweede neemt een correlatie van één, en deelt door het product van de twee standaarddeviaties. Campbell noemt ze RRA(1) en RRA(2) Campbell (1999).
def fred_series(code):
    series = hap_data.fred(code)[code]
    series.index = series.index.year
    return series

# real per-capita nondurables + services (units irrelevant: only growth is used)
real_cons = (fred_series("PCNDA") / fred_series("DNDGRG3A086NBEA")
             + fred_series("PCESVA") / fred_series("DSERRG3A086NBEA")) / fred_series("B230RC0A052NBEA")

# MP timing: the return from average price t to t+1 is paired with growth c_{t+1} / c_t
cons_growth = (real_cons.shift(-1) / real_cons - 1).rename("consumptiegroei")
joint = mp_annual.join(cons_growth, how="inner").dropna()

rows_c = {}
for label, frame in {"1929-1978": joint.loc[:1978], f"1929-{joint.index[-1]}": joint}.items():
    dc, ex = frame["consumptiegroei"], frame["premie"]
    cov = np.cov(dc, ex)[0, 1]
    rows_c[label] = {
        "jaren": len(frame),
        "gemiddelde groei (%)": 100 * dc.mean(), "standaarddeviatie groei (%)": 100 * dc.std(),
        "autocorrelatie groei": dc.autocorr(), "correlatie groei en premie": dc.corr(ex),
        "RRA(1) = premie/cov": ex.mean() / cov,
        "RRA(2) = premie/(sd sd)": ex.mean() / (dc.std() * ex.std()),
    }
rows_c["Mehra-Prescott 1985, 1889-1978"] = {"jaren": 90, "gemiddelde groei (%)": 1.83,
                                           "standaarddeviatie groei (%)": 3.57,
                                           "autocorrelatie groei": -0.14}
pd.DataFrame(rows_c).T.round(3)Geslaagd. De uitkomst valt in beide delen binnen de verwachte afwijking. De momenten wijken af zoals voorzien, want in de tabel is onze consumptie gladder dan die van Mehra en Prescott, en door de Depressie en de oorlog positief in plaats van negatief geautocorreleerd. De risicoaversie ligt boven tien, met over 1929–1978 een RRA(1) van 22,0 en een RRA(2) van 13,0.
Op de momenten van Mehra en Prescott, met de correlatie van 0,37 uit de simulatie, is RRA(1) de 27,2 van de simulatie. RRA(2) is daar , zodat onze RRA(2) hoger ligt, omdat gladdere consumptie de noemer verkleint. Onze RRA(1) ligt lager, omdat de correlatie hier 0,59 is en die hogere correlatie de gladdere consumptie meer dan compenseert. Tot 2024 wordt de consumptie nog gladder.
6.3De Hansen-Jagannathan-grens
We gebruiken kalenderjaarrendementen van French, gedefleerd met de decemberwaarde van de CPI en gekoppeld aan consumptiegroei in hetzelfde jaar. De eerste cel laadt de data en berekent de Sharpe-ratio van de markt.
ff3 = hap_data.french("F-F_Research_Data_Factors")
ff25 = hap_data.french("25_Portfolios_5x5")


def calendar_year(frame):
    return (1 + frame).groupby(frame.index.year).prod()


dec_cpi = shiller["cpi"][shiller.index.month == 12]
dec_cpi.index = dec_cpi.index.year
hj_data = pd.concat(
    [
        (real_cons / real_cons.shift(1)).rename("gc"),
        (dec_cpi / dec_cpi.shift(1)).rename("infl"),
        calendar_year(ff3[["RF"]]),
        calendar_year((ff3["Mkt-RF"] + ff3["RF"]).rename("Mkt")),
        calendar_year(ff25),
    ],
    axis=1,
).loc[1930:].dropna()

real_gross = hj_data.drop(columns=["gc", "infl"]).div(hj_data["infl"], axis=0)   # gross real returns
market_bill = real_gross[["Mkt", "RF"]]
ff25_bill = real_gross.drop(columns="Mkt")
excess_mkt = real_gross["Mkt"] - real_gross["RF"]
sharpe_mkt = excess_mkt.mean() / excess_mkt.std()
print(f"{hj_data.index[0]}-{hj_data.index[-1]}, {len(hj_data)} jaar; Sharpe-ratio markt = {sharpe_mkt:.3f}, "
      f"gem. reële T-bill = {100 * (real_gross['RF'].mean() - 1):.2f}%")
1930-2025, 96 jaar; Sharpe-ratio markt = 0.430, gem. reële T-bill = 0.23%
Over 1930–2025 is de Sharpe-ratio 0,43, iets hoger dan de 0,37 van Mehra en Prescott. De kandidaten zijn met , de waarde van Hansen en Jagannathan. De Sharpe-grens hangt niet van af, want niet. Voor de grenzen met de T-bill bepaalt wel waar ligt, en daarom nemen we hun waarde. We vergelijken de kandidaten met drie grenzen: de Sharpe-grens (5) van het overrendement van de markt, en de grens met meerdere activa (6) voor markt plus T-bill en voor de 25 portefeuilles plus T-bill.
beta_hj = 0.95
gamma_hj = np.arange(1, 51)
sdf = np.array([beta_hj * hj_data["gc"] ** (-g) for g in gamma_hj])
mean_m, sd_m = sdf.mean(axis=1), sdf.std(axis=1, ddof=1)
bound_mkt = hap.stats.hansen_jagannathan_bound(market_bill, mean_m)["sigma_m_min"].to_numpy()
bound_25 = hap.stats.hansen_jagannathan_bound(ff25_bill, mean_m)["sigma_m_min"].to_numpy()

sdf_table = pd.DataFrame(
    {"E[m]": mean_m, "sigma(m)/E[m]": sd_m / mean_m, "impliciete rente (%)": 100 * (1 / mean_m - 1),
     "binnen Sharpe-grens": sd_m / mean_m >= sharpe_mkt,
     "grens markt en T-bill": bound_mkt, "binnen grens markt en T-bill": sd_m >= bound_mkt,
     "grens 25 en T-bill": bound_25, "binnen grens 25 en T-bill": sd_m >= bound_25},
    index=pd.Index(gamma_hj, name="gamma"),
)
first_sharpe = gamma_hj[sdf_table["binnen Sharpe-grens"].to_numpy()].min()
first_mkt = gamma_hj[sdf_table["binnen grens markt en T-bill"].to_numpy()].min()
first_25 = gamma_hj[sdf_table["binnen grens 25 en T-bill"].to_numpy()].min()
print(f"eerste gamma binnen de grens: Sharpe {first_sharpe}, markt + T-bill {first_mkt}, "
      f"25 portefeuilles + T-bill {first_25}")
sdf_table.loc[[1, 5, 10, 15, 20, 30, 40, 42, 43, 45, 50], ["E[m]", "sigma(m)/E[m]", "impliciete rente (%)"]].round(3)
eerste gamma binnen de grens: Sharpe 15, markt + T-bill 42, 25 portefeuilles + T-bill 43
Geslaagd. Geen consumptie-SDF met ligt binnen een grens, zoals verwacht. De Sharpe-grens wordt pas gehaald bij , met een impliciete reële rente van dertig procent, en in die combinatie zit de puzzel van de aandelenpremie. De grenzen die ook de T-bill correct moeten waarderen, eisen bovendien een gemiddelde van vlak bij . Dat gemiddelde haalt de consumptie-SDF pas bij en 43, en dat is de risicovrije-rentepuzzel in de termen van Hansen en Jagannathan.
| grootheid | origineel of verwacht | hier, 1930–2025 |
|---|---|---|
| Sharpe-ratio van de markt | 0,37 (Mehra en Prescott, 1889–1978) | 0,43 |
| eerste binnen de Sharpe-grens | boven 10 (lognormaal, correlatie één) | 15 |
| eerste binnen de grens met T-bill | strenger dan de Sharpe-grens | 42 |
| eerste binnen de grens met 25 portefeuilles | strenger dan met de markt | 43 |
Hansen en Jagannathan rapporteren geen enkele drempelwaarde. Hun figuur 1 laat de consumptie-SDF pas bij een grote binnen de grens komen, en dat zien we hier ook. Let in de figuur op de gekleurde punten, de consumptie-SDF bij oplopende , en op waar ze de drie grenzen kruisen.
Source
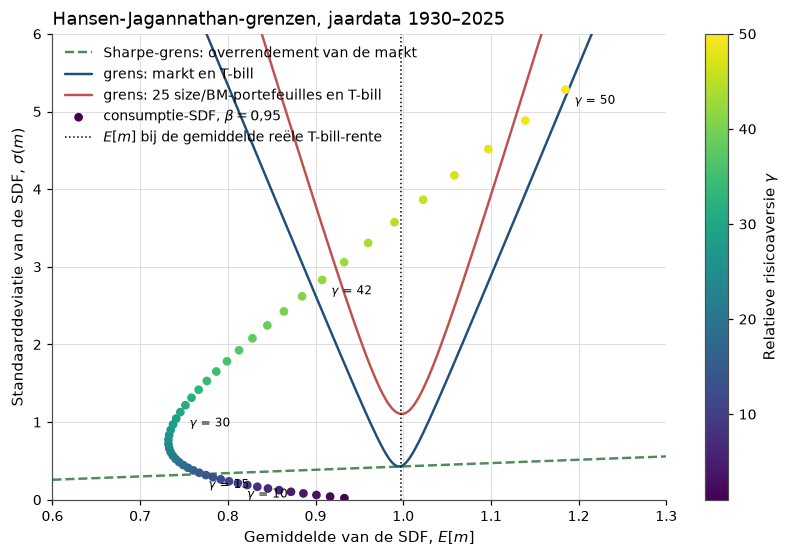
Figure 3:Elke SDF die de activa correct waardeert, ligt boven de grens. De consumptie-SDF schuift bij toenemende eerst vooral naar links, omdat meer risicoaversie het gemiddelde van verlaagt en dus de rente verhoogt, zonder veel volatiliteit toe te voegen. De Sharpe-grens wordt gehaald waar de rente rond de dertig procent ligt. De grenzen met de T-bill zijn smalle V’s rond de stippellijn. De consumptie-SDF haalt ze pas als de jaren met consumptiedalingen uit de Depressie het gemiddelde van weer omhoog trekken.
De curve keert rond om, waar de impliciete rente piekt op ongeveer 35%. Tussen en 50 slaat die rente om van ruim vijftien naar min vijftien procent. Die omslag is geen oplossing, maar een eigenschap van de steekproef. Bij zulke bepalen een paar Depressiejaren het gemiddelde van . Hansen en Jagannathan zagen hetzelfde (p. 250) en wezen erop dat een steekproef zonder grote rampen de schommeling van sterk kan onderschatten. Rietz bouwde daar zijn verklaring op Rietz (1988).
6.4Alle maatstaven voor de vereiste risicoaversie
De vereiste hangt af van de maatstaf. De tabel zet die van theorie, simulatie en replicatie naast die uit het vorige college.
| maatstaf | periode | vereiste | waar |
|---|---|---|---|
| lognormale boom: premie gedeeld door | 1889–1978 | 47,6 | Theorie |
| premie gedeeld door de ware covariantie | simulatie, 6% | 27,2 | Simulatie |
| RRA(1): premie gedeeld door de gemeten covariantie | 1929–1978 | 22,0 | Replicatie |
| Sharpe-grens van Hansen en Jagannathan | 1930–2025 | 15 | Replicatie |
| grens die ook de T-bill waardeert | 1930–2025 | 42 | Replicatie |
| premie alleen: gewogen overrendement nul | 1959–1978 | ongeveer 75 | Lucas, Breeden en de SDF |
Alle maatstaven liggen boven de tien van Mehra en Prescott. Ze verschillen omdat ze een ander activum en een andere eis gebruiken.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Kwalitatief verklaart het model alles wat het moest verklaren. Aandelen renderen meer dan obligaties omdat ze slecht betalen als consumptie tegenvalt, de rente is hoger als groei verwacht wordt, en de stochastische discontofactor is groot in slechte tijden. De puzzel blijft overeind bij andere groeiprocessen, een hefboom op dividenden, een halve eeuw extra data en andere landen Campbell (1999)Campbell (2003). Siegel en Thaler vonden de puzzel in veel landen en perioden, en zagen geen verklaring in survivorship bias (vertekening doordat alleen markten die overleefden in de data zitten) Siegel & Thaler (1997).
Waar het breekt. Het model breekt op getallen die we zelf hebben nagerekend. Met en een rente tussen nul en vier procent is de grootste premie 0,36 procentpunt, tegen 6,22 zoals hier gerepliceerd over 1889–1978 (6,18 bij Mehra en Prescott zelf). De Hansen-Jagannathan-grens zegt zonder model hetzelfde, want de consumptie-SDF haalt de Sharpe-ratio van de markt pas bij een rente van dertig procent. De simulatie laat zien dat de standaardfout van de premie de omvang van de puzzel onzeker maakt, maar de puzzel niet opheft.
Risico of vergissing? In de Chicago-lezing is de premie een echte risicopremie, maar zit het risico in een deel van de verdeling dat negentig jaar data nauwelijks laten zien. Rietz stelde voor dat een kleine kans op een zeer grote consumptiedaling de premie draagt Rietz (1988). Mehra merkte op dat de rente dan tegen die kans in zou moeten bewegen, en zag dat niet terug Mehra (2003). In de Yale-lezing zijn beleggers niet de consumptie-afvlakkers van het model, maar beleggers met verliesaversie die te vaak naar hun portefeuille kijken. Siegel en Thaler vonden de premie moeilijk te verklaren zonder enige irrationaliteit Siegel & Thaler (1997). De kans op rampen, die de twee lezingen zou kunnen scheiden, is met een eeuw data niet te meten.
Wat er daarna kwam. De grens van Hansen en Jagannathan hangt af van welke activa erin gaan, dus van wat “de markt” is. Dat die keuze een theorie ontoetsbaar kan maken, liet Roll in 1977 zien, in Roll: de kritiek en de R². De grote antwoorden op de puzzel, rampen, gewoontes en langetermijnrisico, komen terug in Habit, long-run risk en rampen.
8Oefeningen
Solution to Exercise 1
(1) is 0,8417 en 1,1174, dus en . Uit volgt . Met gelijk aan 0,9174 en 1,0571 is . Dan , en . De premie is .
rough = iid_economy(0.99, 2, np.array([1.090, 0.946]))
base = iid_economy(0.99, 2, growth_mp)
pd.Series({"R^f": rough["R^f"], "k": rough["k"], "premie": rough["premie"],
           "premie / premie toy": rough["premie"] / base["premie"]}).round(4)
R^f 0.0312
k 0.9774
premie 0.0104
premie / premie toy 3.9701
dtype: float64(2) De premie wordt 1,04 procentpunt, bijna vier keer zo groot als de 0,26 van het toy-voorbeeld. Dat voorspelt de lognormale formule , want als verdubbelt, verviervoudigt de premie. De rente daalt, omdat het voorzorgssparen toeneemt. De oefening laat zien dat de premie kwadratisch is in de volatiliteit van consumptie. Om 6,18 procentpunt te halen met zou consumptie bijna vijf keer zo volatiel moeten zijn, want .
:::{exercise}
:label: ex-equity-premium-puzzle-2

**Op het scherp van de snede.** Gebruik de lognormale iid-economie met hefboom één en de
momenten $\E[g] = 1{,}018$, $\sigma(g) = 0{,}036$, $1 + R^f = 1{,}008$ en
$\E[R] = 1{,}0698$ (Mehra 2003, tabel 4).

1. Leid uit [](#eq-equity-premium-puzzle-lognormaal) af welke $\gamma$ en $\beta$
   de rente en het aandelenrendement exact reproduceren.
2. Laat zien dat $\partial \log(1 + R^f) / \partial \gamma = \mu_c - \gamma\sigma_c^2$,
   en bereken hoeveel de rente verandert als $\gamma$ één eenheid hoger of lager is
   bij vaste $\beta$.
3. Leg uit waarom deze oplossing op het scherp van de snede ligt.
Solution to ex-equity-premium-puzzle-2
(1) De eerste vergelijking geeft . De tweede geeft daarna . (2) Differentiëren van de rentevergelijking naar , bij vaste , geeft per eenheid .
mean_R_obs = 1.0698
gamma_edge = (np.log(mean_R_obs) - np.log(gross_rf_obs)) / var_c
log_beta_edge = -np.log(gross_rf_obs) + gamma_edge * mu_c - 0.5 * gamma_edge**2 * var_c
print(f"gamma = {gamma_edge:.1f}, beta = {np.exp(log_beta_edge):.3f}   (Mehra 2003: 47.6 en 0.55)")
edge = pd.DataFrame({"gamma": gamma_edge + np.array([-1.0, 0.0, 1.0])})
edge["rente (%)"] = 100 * (np.exp(-log_beta_edge + edge["gamma"] * mu_c - 0.5 * edge["gamma"] ** 2 * var_c) - 1)
edge.round(2)
gamma = 47.6, beta = 0.546 (Mehra 2003: 47.6 en 0.55)
(3) Eén eenheid verschuift de reële rente met ruim vier procentpunt. De data zijn dus met één punt in de parameterruimte te reproduceren, en dat punt vereist : beleggers die volgend jaar half zo belangrijk vinden als dit jaar. Zo blijkt dat een hoge de premie alleen oplost door de rente over te laten aan een voorzorgsterm die kwadratisch is in , en een model dat zo precies moet worden afgesteld, verklaart niets.
:::{exercise}
:label: ex-equity-premium-puzzle-3

**De grens in deelperioden en met bootstrap.** Gebruik de jaardata van de
replicatie (`hj_data`).

1. Bereken voor 1930–1977 en 1978–2025 de Sharpe-ratio van de markt, en de kleinste
   $\gamma \in \{1, \dots, 60\}$ waarvoor de consumptie-SDF
   [](#eq-equity-premium-puzzle-hj) haalt.
2. Trek voor de volledige steekproef 2000 bootstrapsteekproeven van jaren (paren van
   consumptiegroei en overrendement). Rapporteer het 90%-interval van de
   Sharpe-ratio en van de kleinste $\gamma$.
Solution to ex-equity-premium-puzzle-3
gamma_ex3 = np.arange(1, 61)


def first_gamma(gc, sharpe_ratio):
    """Smallest gamma with sd(g^-gamma)/mean(g^-gamma) >= Sharpe ratio (rows = samples)."""
    powered = gc[..., None] ** (-gamma_ex3)
    ratio = powered.std(axis=-2, ddof=1) / powered.mean(axis=-2)
    hit = ratio >= np.asarray(sharpe_ratio)[..., None]
    return np.where(hit.any(axis=-1), gamma_ex3[hit.argmax(axis=-1)], np.nan)


gc_all = hj_data["gc"].to_numpy()
ex_all = excess_mkt.to_numpy()
rows_ex3 = {}
for label, sel in {"1930-1977": hj_data.index <= 1977, "1978-2025": hj_data.index >= 1978,
                   "1930-2025": np.ones(len(hj_data), bool)}.items():
    sr = ex_all[sel].mean() / ex_all[sel].std(ddof=1)
    rows_ex3[label] = {"Sharpe-ratio": sr, "kleinste gamma": first_gamma(gc_all[sel], sr)}

draws = rng.integers(0, len(gc_all), size=(2000, len(gc_all)))
sr_boot = ex_all[draws].mean(axis=1) / ex_all[draws].std(axis=1, ddof=1)
gamma_boot = first_gamma(gc_all[draws], sr_boot)
rows_ex3["bootstrap 5%"] = {"Sharpe-ratio": np.percentile(sr_boot, 5),
                            "kleinste gamma": np.nanpercentile(gamma_boot, 5)}
rows_ex3["bootstrap 95%"] = {"Sharpe-ratio": np.percentile(sr_boot, 95),
                             "kleinste gamma": np.nanpercentile(gamma_boot, 95)}
pd.DataFrame(rows_ex3).T.astype(float).round(2)De tweede helft heeft een hogere Sharpe-ratio en veel gladdere consumptie. Ze vraagt daardoor , tegen 11 in de eerste helft, waarin de Depressie de consumptie-SDF volatiel maakt. Het bootstrapinterval van de Sharpe-ratio loopt van 0,25 tot 0,64, zodat dezelfde meetonzekerheid als bij gemiddelde rendementen in Rendementen en hun statistiek nu de Sharpe-ratio treft. Het interval van de vereiste is naar verhouding even breed, want ook daar is de bovenkant ruim twee keer de onderkant, maar zelfs die onderkant ligt op het maximum van tien dat Mehra en Prescott toelieten. Hoe groot de puzzel is, hangt dus sterk af van de periode, maar dat hij bestaat, hangt er niet van af.
- Mehra, R., & Prescott, E. C. (1985). The Equity Premium: A Puzzle. Journal of Monetary Economics, 15(2), 145–161. 10.1016/0304-3932(85)90061-3
- Weil, P. (1989). The Equity Premium Puzzle and the Risk-Free Rate Puzzle. Journal of Monetary Economics, 24(3), 401–421. 10.1016/0304-3932(89)90028-7
- Hansen, L. P., & Jagannathan, R. (1991). Implications of Security Market Data for Models of Dynamic Economies. Journal of Political Economy, 99(2), 225–262. 10.1086/261749
- Mehra, R. (2003). The Equity Premium: Why Is It a Puzzle? Financial Analysts Journal, 59(1), 54–69. 10.2469/faj.v59.n1.2503
- Epstein, L. G., & Zin, S. E. (1989). Substitution, Risk Aversion, and the Temporal Behavior of Consumption and Asset Returns: A Theoretical Framework. Econometrica, 57(4), 937–969. 10.2307/1913778
- Kocherlakota, N. R. (1996). The Equity Premium: It’s Still a Puzzle. Journal of Economic Literature, 34(1), 42–71. https://econpapers.repec.org/RePEc:aea:jeclit:v:34:y:1996:i:1:p:42-71
- Campbell, J. Y. (1999). Asset Prices, Consumption, and the Business Cycle. In J. B. Taylor & M. Woodford (Eds.), Handbook of Macroeconomics (Vol. 1, pp. 1231–1303). Elsevier. 10.1016/S1574-0048(99)10032-6
- Rietz, T. A. (1988). The Equity Risk Premium: A Solution. Journal of Monetary Economics, 22(1), 117–131. 10.1016/0304-3932(88)90172-9
- Campbell, J. Y. (2003). Consumption-Based Asset Pricing. In G. M. Constantinides, M. Harris, & R. M. Stulz (Eds.), Handbook of the Economics of Finance (Vol. 1, pp. 803–887). Elsevier. 10.1016/S1574-0102(03)01022-7
- Siegel, J. J., & Thaler, R. H. (1997). Anomalies: The Equity Premium Puzzle. Journal of Economic Perspectives, 11(1), 191–200. 10.1257/jep.11.1.191
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD