

De CRSP-tape: data als machine
1Overzicht
Hoe meten we het gemiddelde rendement van alle aandelen, als een deel van die aandelen onderweg verdwijnt? Alleen door de verdwenen bedrijven mee te tellen, tot en met hun laatste verlies, want wie ze weglaat, meet een te hoog gemiddelde, vooral bij kleine aandelen. Meer data helpen niet, want de fout door ontbrekende laatste rendementen blijft elk jaar even groot, en de fout door alleen overlevenden te tellen krimpt niet sneller dan de ruis. In dit college:
rekenen we met de hand na wat één faillissement met een marktgemiddelde doet;
leiden we af hoe groot de fout is als de database het laatste rendement van geschrapte aandelen mist, en als ze alleen overlevenden bevat;
simuleren we een universum zonder size-premie en meten er toch een;
repliceren we wat de weging met een eeuw marktrendement doet, en toetsen we de gepubliceerde correcties van Shumway aan de formule.
Eind jaren vijftig wist niemand hoeveel een belegger op lange termijn verdiende met een willekeurig NYSE-aandeel, omdat de data niet bestonden. Vanaf 1960 bouwde het Center for Research in Security Prices in Chicago, met geld van Merrill Lynch, die data op. James Lorie en Lawrence Fisher lieten maandprijzen, dividenden en kapitaalmutaties van alle gewone NYSE-aandelen vanaf januari 1926 verzamelen en op magneetband zetten. De resultaten verschenen in 1964 Fisher & Lorie (1964), het jaaroverzicht tot 1965 in 1968 Fisher & Lorie (1968).
Met dat werk begint een tijdvak, want de event study en de toetsen van het CAPM draaiden op deze data. In de vraag theorie of feit hoort de tape bij geen van beide, omdat ze geen theorie toetst en geen feit verklaart, maar meet. Toch geeft elke meetbeslissing een fout met een voorspelbaar teken, en die fout kan groter zijn dan de standaardfout van 2%, de onzekerheid die een eeuw jaarrendementen met 20% volatiliteit in een gemiddelde laat.
2Intuïtie: waarom zou dit waar zijn?
De vraag lijkt eenvoudig, want het volstaat schijnbaar om alle aandelen van 1926 tot nu te volgen en te tellen. Wie dat probeert, stuit echter op drie vragen.
De eerste vraag is wat het rendement van een aandeel is. Een koers die op de dag van een dividend daalt, is geen verlies, want het geld is naar de aandeelhouder gegaan. Een koers die bij een split halveert, is evenmin een verlies, omdat de houder nu twee stukken heeft.
De tweede vraag is welke aandelen meetellen. Een bedrijf dat failliet gaat, verdwijnt van de beurs. Een onderzoeker die vandaag de lijst van genoteerde bedrijven opvraagt en terugrekent tot 1926, meet daardoor alleen de overlevenden, en dat zijn per definitie de bedrijven die nooit zo diep daalden dat ze werden geschrapt.
De derde vraag is subtieler. Ook als de verdwenen bedrijven in de database staan, ontbreekt vaak de delisting return (het rendement tussen de laatste beurskoers en wat de houder na schrapping nog krijgt). Bij een faillissement is dat rendement groot en negatief, en juist dan ontbreekt het het vaakst.
Geen van die keuzes voegt ruis toe, maar elke keuze voegt een vertekening met een voorspelbaar teken toe. We verwachten dus dat het gemeten gemiddelde te hoog uitvalt, het meest bij kleine aandelen, omdat die het vaakst failliet gaan. Ook verwachten we dat een langere steekproef weinig helpt. Een ontbrekend laatste rendement vertekent elk jaar opnieuw, en de selectie op overleven wordt niet sneller kleiner dan de ruis.
3Toy-voorbeeld: vijf aandelen, vier perioden
De eerste cel laadt de pakketten die het hele college gebruikt.
import copy

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Er zijn vijf aandelen met prijzen op , zonder dividenden of splits. Aandeel C wordt in periode 3 geschrapt, met 6 als laatste beurskoers, en daarna is het aandeel onderhands nog 1,50 waard.
| aandeel | gebeurtenis | |||||
|---|---|---|---|---|---|---|
| A | 40 | 44 | 44 | 44 | 48,40 | — |
| B | 60 | 60 | 66 | 66 | 59,40 | — |
| C | 10 | 8 | 6 | (1,50) | — | geschrapt in periode 3 |
| D | 50 | 50 | 55 | 55 | 60,50 | — |
| E | 25 | 30 | 30 | 30 | 27 | — |
Het recept. Het rendement is de waarde aan het eind van de periode gedeeld door de prijs aan het begin, min één. Voor een geschrapt aandeel is de waarde aan het eind de waarde na schrapping.
Stap 1. Het rendement van C in periode 3 is , en dat is de delisting return. De overige rendementen volgen direct uit de prijzen:
| periode | A | B | C | D | E |
|---|---|---|---|---|---|
| 1 | +10% | 0% | −20% | 0% | +20% |
| 2 | 0% | +10% | −25% | +10% | 0% |
| 3 | 0% | 0% | −75% | 0% | 0% |
| 4 | +10% | −10% | — | +10% | −10% |
Stap 2. We berekenen het gelijkgewogen (equal-weighted, EW) marktrendement op drie manieren. De correcte berekening telt alle aandelen die aan het begin van de periode bestaan. Zonder delisting return ontbreekt C in periode 3, en bij alleen overlevenden ontbreekt C in alle perioden, want de lijst van kent C niet meer.
Correct: , , en ; gemiddeld .
Zonder delisting return: periode 3 wordt ; gemiddeld .
Alleen overlevenden: , , en ; gemiddeld .
Stap 3. Voor het cumulatieve rendement vermenigvuldigen we de bruto rendementen. De correcte reeks geeft , ofwel . Zonder delisting return wordt het , ofwel , en met alleen overlevenden , ofwel .
De code bouwt dezelfde rendementen uit prijzen en de waarde na schrapping, zoals een database dat doet.
prices = pd.DataFrame(
    {"A": [40, 44, 44, 44, 48.4], "B": [60, 60, 66, 66, 59.4],
     "C": [10, 8, 6, np.nan, np.nan], "D": [50, 50, 55, 55, 60.5],
     "E": [25, 30, 30, 30, 27]},
    dtype=float,
)
delisting_value = {"C": (3, 1.50)}    # value after delisting, realised in period 3


def total_returns(prices, delisting_value):
    """Holding-period returns, with the delisting return for delisted stocks."""
    returns = prices / prices.shift(1) - 1
    for stock, (period, value) in delisting_value.items():
        returns.loc[period, stock] = value / prices.loc[period - 1, stock] - 1
    return returns.loc[1:]


correct = total_returns(prices, delisting_value)
no_delisting = correct.copy()
no_delisting.loc[3, "C"] = np.nan         # the database misses C's last return
survivors = correct.drop(columns="C")     # C is not on the list at t = 4

markets = pd.DataFrame({"correct": correct.mean(axis=1),
                        "zonder delisting return": no_delisting.mean(axis=1),
                        "alleen overlevenden": survivors.mean(axis=1)})
pd.DataFrame({
    "gemiddeld, hand": [-0.035, 0.0025, 0.03125],
    "gemiddeld, code": markets.mean(),
    "cumulatief, hand": [-0.14167, 0.0098, 0.12875],
    "cumulatief, code": (1 + markets).prod() - 1,
}).round(5)Code en hand geven dezelfde getallen. Met dezelfde vijf aandelen verloor de markt 14% of won hij 13%, afhankelijk van één beslissing over wat er met het verdwenen aandeel gebeurt. Beide fouten bestaan uit ontbrekende waarnemingen, zodat ze onzichtbaar zijn, en allebei maken ze de markt beter dan hij was.
4Theorie
We leiden vier dingen af. Eerst definiëren we het rendement in een database, als het recept uit het toy-voorbeeld uitgebreid met dividend en split. Daarna volgt de kern, namelijk hoe groot de fout is als de database het laatste rendement van geschrapte aandelen mist. Survivorship, de extreme vorm van dezelfde selectie, komt als derde aan bod, en tot slot laten we zien wat de weging doet met een gemiddelde waarin kleine aandelen meetellen.
4.1Opzet: het rendement in een database
Een rendement meet wat er gebeurt met het vermogen van een houder die niets doet. Die houder ontvangt het dividend in contanten en krijgt bij een split extra stukken, zodat een berekening die een van die twee vergeet, een verlies laat zien dat er niet is.
Naast de prijs en het dividend is er een aanpassingsfactor , het aantal aandelen op per aandeel op . Een 2:1-split heeft , een stockdividend van 5% heeft , en in een gewone maand is .
De teller is wat de houder op heeft, de noemer wat hij op betaalde. Een aandeel van 44 dat 2 dividend uitkeert en daarna 42 noteert, heeft , niet . Een aandeel van 60 dat 2:1 splitst en daarna 33 noteert, heeft , niet . CRSP slaat precies deze bouwstenen op, namelijk de ruwe prijs, de uitkeringen en een cumulatieve factor. Het herbeleggen van dividenden is een keuze, en die keuze scheidt de 9,0% van Fisher en Lorie, met herbelegde dividenden, van hun 6,9% zonder herbelegging in Rendementen en hun statistiek.
4.2Het kernresultaat: de ontbrekende delisting return
Mist de database het laatste rendement van geschrapte aandelen, dan valt het gemiddelde te hoog uit, en wel met de schrappingskans maal het gemiste verlies. We beginnen bij het rendement van een geschrapt aandeel. Stel dat een aandeel in de loop van periode wordt geschrapt, met laatste beurskoers . Daarna krijgt de houder nog een waarde , zoals een overnameprijs, een liquidatie-uitkering of een onderhandse koers. Het rendement over de periode is dan
Het rendement tot de laatste handelsdag, , wordt dus vermenigvuldigd met het rendement daarna, de delisting return . CRSP bewaart als apart veld, en Shumway (1997) liet zien dat dat veld in zijn steekproef, die in 1962 begint, leeg was voor de meeste schrappingen om slechte prestaties. Hieronder is het netto rendement van een geschrapt aandeel over de hele periode, ofwel (2) min één. In het toy-voorbeeld valt samen met de delisting return, omdat de laatste koers daar ook de beginkoers van de periode is.
Waarom zou dit waar zijn? Een onderzoeker middelt de rendementen die in de database staan, maar juist de laagste rendementen van de maand, die van net failliete bedrijven, staan er niet in. Het gemeten gemiddelde stijgt daardoor, met de kans op zo’n schrapping maal de afstand tussen het ontbrekende rendement en de rest.
Hier is de kanslimiet, de waarde waar het gemiddelde naartoe gaat bij veel aandelen. De fout is dus de schrappingskans maal hoe ver het ontbrekende rendement onder het gewone rendement ligt. Het bewijs berust erop dat het ware gemiddelde naar gaat en het databasegemiddelde naar .
Proof 1
Het ware gemiddelde is en convergeert naar . Het databasegemiddelde loopt over de niet-geschrapte aandelen. Omdat schrapping en onafhankelijk zijn, hebben hun rendementen nog steeds verwachting , zodat het gemiddelde naar convergeert. Het verschil is .
Het toy-voorbeeld is het kleinste geval van de stelling. In periode 3 is , en , zodat de fout procentpunt is, precies het verschil tussen en .
In echte data is ongeveer 1% per maand en ligt tussen en , zodat de fout vrijwel is. In de kleinste Nasdaq-aandelen was ongeveer 3% per maand en 3,8% Shumway & Warther (1999). Met is de fout dan procentpunt per maand. De fout zit dus waar groot is, bij kleine aandelen, en is daarom een fout in de size-premie en niet alleen in het niveau. Voor een waardegewogen (value-weighted, VW) portefeuille vervangt het marktwaardegewogen gemiddelde van de de kans , en dat gemiddelde is klein, omdat grote bedrijven zelden failliet gaan.
4.3Wat het voorspelt: overlevenden en look-ahead
Survivorship bias is de extreme vorm van dezelfde selectie. Nu ontbreekt immers niet alleen het laatste rendement, maar de hele geschiedenis van elk bedrijf dat vóór het einde van de steekproef verdween.
Waarom zou dit waar zijn? Een bedrijf wordt geschrapt als zijn waarde onder een drempel zakt. Een bedrijf dat overleeft, is die drempel nooit tegengekomen, en dat zegt iets over zijn rendementen, want die waren hoger dan gemiddeld. Hoe dichter bij de drempel en hoe volatieler het aandeel, hoe strenger de selectie, zodat een steekproef van overlevenden kleine aandelen mooier maakt dan grote.
In het eenvoudigste model waarin dat exact uit te rekenen is, is de log-afstand tot de schrappingsdrempel, met een standaard Brownse beweging en . Het bedrijf wordt geschrapt zodra , bijvoorbeeld als de koers onder de noteringseis van de beurs zakt. Omdat er geen drift is, is het ware verwachte logrendement nul. Volgens het reflectieprincipe eindigt een pad dat de drempel raakt, daarna even vaak boven als onder de drempel, en daaruit volgt de kans om tot te overleven
met het moment van schrappen en de standaardnormale verdelingsfunctie. De overleefkans daalt naarmate de drempel dichterbij ligt ( klein) of het aandeel volatieler is.
Voor de overlevenden is de fout dus de beginafstand per jaar, , maal de kans op schrappen gedeeld door de kans op overleven, en ze stijgt als de overleefkans daalt. Het bewijs berust erop dat een proces zonder drift gemiddeld zijn beginwaarde houdt, terwijl de geschrapte paden op nul staan. Daarom zit alle beginwaarde in de overlevenden.
Proof 2
Zonder drift is een martingaal, en is een begrensde stoptijd. Volgens de optional-stopping-stelling is . Op is , zodat
waarna delen door , aftrekken en door delen het resultaat geeft.
Denk aan een klein bedrijf met (een koers van 2,7 keer de drempel) en per jaar. Het overleeft twintig jaar met kans . De overlevenden hebben een gemiddeld logrendement van per jaar, terwijl het ware rendement nul is. Een groot bedrijf met en overleeft vrijwel zeker, en zijn fout is een honderdste procentpunt. Een steekproef van overlevenden maakt dus uit het niets een size-premie van ruim negen procentpunt. De cel rekent beide gevallen na.
def survivor_bias(x0, sigma, horizon):
    """Survival probability and survivors' mean log return per year (driftless, barrier at 0)."""
    p_survive = 2 * stats.norm.cdf(x0 / (sigma * np.sqrt(horizon))) - 1
    return p_survive, x0 / horizon * (1 / p_survive - 1)


pd.DataFrame(
    [survivor_bias(1.0, 0.50, 20), survivor_bias(3.0, 0.20, 20), survivor_bias(1.0, 0.50, 100)],
    index=["klein: z0 = 1, sigma = 50%", "groot: z0 = 3, sigma = 20%", "klein, na een eeuw"],
    columns=["overleefkans", "fout in gemiddeld logrendement per jaar"],
).round(5)De tabel bevestigt de handberekening: 9,5% voor het kleine bedrijf, 0,012% voor het grote. De derde rij komt zo meteen aan bod. Teken en plaats van de fout kloppen met wat de intuïtie liet verwachten, want de fout is positief en het grootst bij kleine, volatiele aandelen.
Meer jaren helpen, maar niet ten opzichte van de ruis. Voor grote gaat de fout in (5) naar , ongeveer 1,25 keer de standaardfout van het gemiddelde van één aandeel. Na een eeuw geeft de exacte formule voor het kleine bedrijf nog en een fout van per jaar, zoals de derde rij van de tabel laat zien. Meer aandelen helpen evenmin, want het middelen over overlevenden deelt de standaardfout door , maar laat de fout staan.
Hetzelfde mechanisme werkt buiten aandelen. Brown et al. (1992) lieten zien dat fondsen die na slechte jaren verdwijnen, de prestaties van de overlevenden persistent laten lijken, en die selectie kon het toenmalige bewijs voor voorspelbare fondsprestaties verklaren. In boekhouddata heet het verschijnsel backfill. Als Compustat een bedrijf toevoegt, voegt het vaak ook eerdere jaren toe, maar alleen voor bedrijven die dan nog bestaan. Kothari et al. (1995) vermoedden dat een deel van de waardepremie daardoor komt.
Eén fout werkt de andere kant op: look-ahead bias (vertekening doordat een strategie informatie gebruikt die op het beslismoment nog niet bestond). Wie aandelen sorteert op hun marktwaarde aan het einde van de maand, stopt de crashes van die maand in de kleinste portefeuille. Kleine aandelen lijken dan slechter dan ze zijn, terwijl een uitvoerbare strategie alleen sorteert op wat op het beslismoment openbaar was. Daarom koppelen Fama en French een jaarrekening pas een half jaar na het einde van het boekjaar aan rendementen Fama & French (1992).
4.4Weging: gelijkgewogen tegenover waardegewogen
Waarom maakt de weging zoveel uit? Een waardegewogen portefeuille houdt elk aandeel naar zijn marktwaarde en hoeft niets te doen, want een stijgend aandeel krijgt vanzelf meer gewicht. Een gelijkgewogen portefeuille verkoopt daarentegen elke maand winnaars en koopt verliezers bij, tot alle gewichten weer zijn, zodat kleine aandelen daarin even zwaar wegen als grote. Daarom duwen de fouten van kleine aandelen het gelijkgewogen gemiddelde vol omhoog en het waardegewogen nauwelijks.
Met gewichten van de waardegewogen portefeuille en is het verschil tussen de twee rendementen
met de covariantie over de aandelen in één periode. Het rekenkundige verschil is dus positief als kleine aandelen in die periode beter deden, zodat het verschil tussen de wegingen zelf een size-premie is.
Twee effecten komen daar nog bij. Het eerste is de winst uit herbalanceren Booth & Fama (1992), want een portefeuille die naar vaste gewichten wordt teruggezet, groeit meetkundig sneller dan het gewogen gemiddelde van de eigen onderdelen. Met , de meetkundige groei een halve variantie onder de rekenkundige, geldt bij benadering:
Deze winst is de helft van het variantieverlies door spreiding. Hier is de meetkundige groeivoet, de volatiliteit van aandeel en die van de portefeuille. Bij veel aandelen met en onderlinge correlatie 0,2 is de winst per jaar. Het verwachte rendement stijgt daardoor niet, maar een gelijkgewogen index toont over een eeuw wel veel meer eindvermogen.
Het tweede effect is de bid-ask bias, want een slotkoers ligt op de bied- of de laatkoers en niet op de ware prijs. Met een relatieve afwijking met gemiddelde nul en variantie is het gemeten bruto rendement gemiddeld ongeveer , omdat . Bij een spread van 10% van de koers is en per maand, ofwel drie procentpunt per jaar. Een gelijkgewogen portefeuille erft die fout elke maand, een buy-and-hold-portefeuille alleen aan begin en eind. Blume & Stambaugh (1983) vonden zo een jaarlijks size-effect dat half zo groot was als eerder gerapporteerd.
5Simulatie: een universum met faillissementen
In een universum zonder size-premie meet een database zonder delisting returns een premie van vijfenhalf procentpunt per jaar, en een database van overlevenden een van veertienenhalf, terwijl de steekproefruis maar ongeveer één procentpunt is. De simulatie brengt de fouten uit de theorie samen in één universum en vergelijkt ze met die ruis.
Het model. Er zijn 1000 aandelen, 30 jaar maanddata en 100 onafhankelijke steekproeven. Elk aandeel heeft een log-marktwaarde . De kans op schrapping in maand hangt af van hoe klein het aandeel is ten opzichte van het gemiddelde,
zodat de kleinste aandelen tot 2% per maand kans op schrapping hebben. Een geschrapt aandeel heeft over de maand rendement , de gemiddelde delisting return die Shumway (1997) voor NYSE en AMEX reconstrueerde, en een nieuwe, kleine notering neemt zijn plaats in. De overige aandelen krijgen een marktschok ( per maand) en een eigen schok ( per maand).
De cruciale keuze. Het ware verwachte rendement is voor elk aandeel 1% per maand, inclusief de kans op schrapping: . Een klein aandeel krijgt dus een hogere drift , die precies het verwachte verlies bij schrapping goedmaakt. Er is per constructie geen size-premie. Wat we toch meten, komt uit de database.
We meten tien size-decielen op vier manieren. De eerste is correct, de tweede mist de delisting returns, de derde bevat alleen de aandelen die na dertig jaar nog genoteerd zijn, en de vierde sorteert met look-ahead, op de marktwaarde aan het einde van de maand.
De eerste cel bevat drie hulpfuncties. De functie size_deciles rangschikt de aandelen in
een
steekproef per maand naar grootte en deelt de rang door een tiende van het aantal.
De functie decile_mean middelt een grootheid per deciel, met een lus over de tien
decielen,
en hazard berekent de schrappingskans van hierboven.
def size_deciles(size, in_sample):
    """Size decile (0 = smallest) of every stock among the stocks in `in_sample`, per row."""
    size_in_sample = np.where(in_sample, size, np.inf)   # stocks outside the sample rank last, never in a decile
    rank = stats.rankdata(size_in_sample, axis=1, method="ordinal").astype(int) - 1   # 0 = smallest
    n_in_sample = in_sample.sum(axis=1, keepdims=True)
    return np.minimum(rank * 10 // np.maximum(n_in_sample, 1), 9)


def decile_mean(values, decile, in_sample):
    """Equal-weighted mean of `values` per size decile among `in_sample`, per row."""
    means = np.zeros((values.shape[0], 10))
    for d in range(10):
        members = in_sample & (decile == d)
        means[:, d] = (values * members).sum(axis=1) / np.maximum(members.sum(axis=1), 1)
    return means


def hazard(x, h_max):
    """Monthly delisting probability, high for stocks far below the average size."""
    relative = x - x.mean(axis=1, keepdims=True)
    return h_max / (1 + np.exp((relative + 2.0) / 0.5))
De tweede cel maakt het universum, los van elke meting. De functie draw_universe geeft
maand na
maand de log-marktwaarde aan het begin, het ware rendement en wie er wordt geschrapt.
De functie last_delisting loopt één keer door het universum en onthoudt per positie de
maand van
de laatste schrapping, omdat een steekproef van overlevenden die kennis van het einde
nodig heeft.
def draw_universe(gen, n_sims, n_stocks, n_months, h_max=0.02, m=0.01,
                  sigma_m=0.045, sigma_i=0.12, delist_ret=-0.30):
    """Yield, month by month: log size at the start, true return, delisted or not."""
    x = gen.normal(0.0, 1.5, size=(n_sims, n_stocks))
    for t in range(n_months):
        h = hazard(x, h_max)
        mu = (m - h * delist_ret) / (1 - h)            # true expected return is m for every stock
        f = gen.normal(0.0, sigma_m, size=(n_sims, 1))                 # market shock
        eps = gen.normal(0.0, sigma_i, size=(n_sims, n_stocks))        # own shock
        r = (1 + mu) * np.exp(f + eps - (sigma_m**2 + sigma_i**2) / 2) - 1
        delisted = gen.random((n_sims, n_stocks)) < h
        true_return = np.where(delisted, delist_ret, r)
        yield t, x, true_return, delisted
        entrant_x = gen.normal(-1.0, 1.0, size=(n_sims, n_stocks)) + x.mean(axis=1, keepdims=True)
        x = np.where(delisted, entrant_x, x + np.log1p(r))   # a new small listing takes the slot


def last_delisting(universe):
    """Month of the last delisting per slot; -1 if the slot was never delisted."""
    last = None
    for t, x, true_return, delisted in universe:
        if last is None:
            last = np.full(delisted.shape, -1)
        last = np.where(delisted, t, last)
    return last
De derde cel doet de metingen. Elke maand rekent decile_returns de decielrendementen
op de vier manieren uit en market_returns het marktrendement, gelijk- en waardegewogen,
waarna measure de maanden op elkaar stapelt.
def decile_returns(x, true_return, delisted, listed, recorded, survivor):
    """Decile returns of one month, measured the four ways of the text, plus the delisting rate."""
    by_size = size_deciles(x, listed)
    by_end_size = size_deciles(x + np.log1p(true_return), listed)   # look-ahead
    return {"correct": decile_mean(true_return, by_size, listed),
            "missing": decile_mean(true_return, by_size, recorded),
            "survivors": decile_mean(true_return, size_deciles(x, survivor), survivor),
            "lookahead": decile_mean(true_return, by_end_size, listed),
            "delist_rate": decile_mean(delisted.astype(float), by_size, listed)}


def market_returns(x, true_return, recorded, survivor):
    """Equal- and value-weighted market return of one month, with and without missing returns."""
    cap = np.exp(x)
    return {"EW correct": true_return.mean(axis=1),
            "EW zonder delisting": (true_return * recorded).sum(axis=1) / recorded.sum(axis=1),
            "EW overlevenden": (true_return * survivor).sum(axis=1) / np.maximum(survivor.sum(axis=1), 1),
            "VW correct": (cap * true_return).sum(axis=1) / cap.sum(axis=1),
            "VW zonder delisting": (cap * true_return * recorded).sum(axis=1) / (cap * recorded).sum(axis=1)}


def measure(universe, last_delist):
    """Decile and market returns for every month, stacked along axis 1."""
    deciles, market = [], []
    for t, x, true_return, delisted in universe:
        listed = np.ones_like(delisted)
        recorded = ~delisted                                  # database without delisting returns
        survivor = (t > last_delist) & recorded               # still listed at the end
        deciles.append(decile_returns(x, true_return, delisted, listed, recorded, survivor))
        market.append(market_returns(x, true_return, recorded, survivor))
    return ({k: np.stack([d[k] for d in deciles], axis=1) for k in deciles[0]},
            {k: np.stack([m[k] for m in market], axis=1) for k in market[0]})
We trekken het universum twee keer uit dezelfde toestand van de generator. Een kopie
zoekt eerst de laatste schrappingen en daarna meet rng zelf, zodat beide doorgangen
precies hetzelfde universum zien.
n_sims, n_stocks, n_months, delist_ret = 100, 1000, 360, -0.30

twin = copy.deepcopy(rng)                                  # same state, same universe
last_delist = last_delisting(draw_universe(twin, n_sims, n_stocks, n_months, delist_ret=delist_ret))
sim_deciles, sim_market = measure(draw_universe(rng, n_sims, n_stocks, n_months, delist_ret=delist_ret),
                                  last_delist)
pd.Series({
    "posities zonder schrapping in 30 jaar": np.mean(last_delist == -1),
    "schrappingen per jaar (universum)": 12 * sim_deciles["delist_rate"].mean(),
}).round(4)
posities zonder schrapping in 30 jaar 0.4758
schrappingen per jaar (universum) 0.0324
dtype: float64Het universum verliest 3,2% van zijn noteringen per jaar, wat tussen de 1,2% voor NYSE en AMEX en de 5,6% voor Nasdaq ligt die Shumway & Warther (1999) rapporteren. De volgende cel toont de gemeten rendementen van het kleinste en het grootste deciel, per jaar en gemiddeld over de honderd steekproeven.
labels = {"correct": "correct", "missing": "zonder delisting return",
          "survivors": "alleen overlevenden", "lookahead": "look-ahead sortering"}
annual = {k: 12 * sim_deciles[k].mean(axis=1) for k in labels}   # (n_sims, 10), per sample

sim_table = pd.DataFrame(
    {labels[k]: {
        "kleinste deciel": v[:, 0].mean(),
        "grootste deciel": v[:, 9].mean(),
        "size-premie (klein - groot)": (v[:, 0] - v[:, 9]).mean(),
        "SD premie over steekproeven": (v[:, 0] - v[:, 9]).std(ddof=1),
    } for k, v in annual.items()}
).T
sim_table.round(4)Correct gemeten is de premie nul, want 0,05 procentpunt valt weg tegen een spreiding over de steekproeven van één procentpunt. Zonder delisting returns wordt ze 5,5 procentpunt, ruim vijf standaarddeviaties, en met alleen overlevenden 14,5 procentpunt. Look-ahead draait het teken om, want de kleinste aandelen aan het einde van de maand zijn vooral de aandelen die die maand instortten.
De volgende tabel toetst (3) per deciel. In de simulatie is , zodat de voorspelde fout per maand is.
delist_rate = sim_deciles["delist_rate"].mean(axis=(0, 1))
predicted = 12 * delist_rate / (1 - delist_rate) * (0.01 - delist_ret)
measured = annual["missing"].mean(axis=0) - annual["correct"].mean(axis=0)

check = pd.DataFrame(
    {"schrappingskans per maand": delist_rate,
     "bias gemeten (per jaar)": measured,
     "bias volgens stelling (per jaar)": predicted},
    index=pd.Index(range(1, 11), name="size-deciel"),
)
check.round(4)De stelling en de simulatie komen overeen tot op 0,01 procentpunt. In het kleinste deciel is de schrappingskans 1,44% per maand en de fout 5,43 procentpunt per jaar. Vanaf het vijfde deciel is de fout kleiner dan 0,3 procentpunt, want ze zit aan de rand van het universum, precies waar een size-sortering kijkt. Ten slotte kijken we naar het marktrendement zelf.
market_table = pd.DataFrame(
    {"gemiddeld jaarrendement": {k: 12 * v.mean() for k, v in sim_market.items()},
     "SD over steekproeven": {k: 12 * v.mean(axis=1).std(ddof=1) for k, v in sim_market.items()}}
)
market_table.round(4)Gelijkgewogen ligt het marktrendement zonder delisting returns een procentpunt te hoog, en met alleen overlevenden bijna vijf. Waardegewogen verandert het nauwelijks, van 11,97% naar 12,00%, zoals de theorie voorspelde. In de figuur lopen de vier metingen per deciel uit elkaar. Links gaat het om het kleine eind van de lijnen, rechts om de afstand tussen de drie verdelingen.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))
deciles_axis = np.arange(1, 11)
for (key, label), color in zip(labels.items(), hap.plotting.COLORS):
    mean = annual[key].mean(axis=0) * 100
    spread = annual[key].std(axis=0, ddof=1) * 100
    axes[0].plot(deciles_axis, mean, marker="o", color=color, label=label)
    axes[0].fill_between(deciles_axis, mean - 2 * spread, mean + 2 * spread, color=color, alpha=0.15)
axes[0].axhline(12, color="black", lw=1, ls="--")
axes[0].set_title("Gemeten rendement per size-deciel")
axes[0].set_xlabel("Size-deciel (1 = kleinste)")
axes[0].set_ylabel("Gemiddeld rendement (% per jaar)")
axes[0].set_xticks(deciles_axis)
axes[0].legend()

for (key, label), color in zip(list(labels.items())[:3], hap.plotting.COLORS):
    premium = (annual[key][:, 0] - annual[key][:, 9]) * 100
    axes[1].hist(premium, bins=20, color=color, alpha=0.6, label=label, edgecolor="white")
axes[1].axvline(0, color="black", lw=1)
axes[1].set_title("Geschatte size-premie in 100 steekproeven")
axes[1].set_xlabel("Klein minus groot (% per jaar)")
axes[1].set_ylabel("Aantal steekproeven")
axes[1].legend()
fig.tight_layout()
plt.show()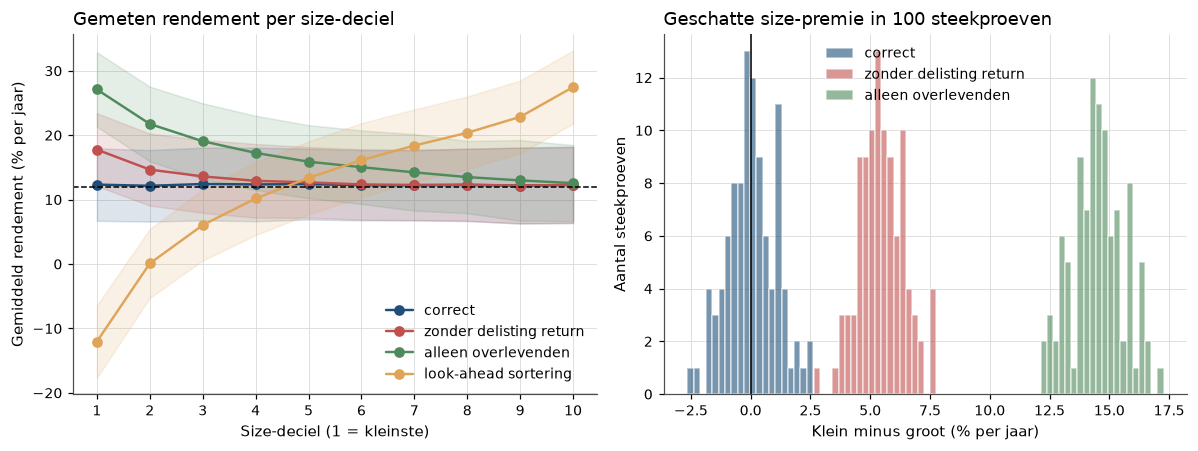
Figure 1:Een universum zonder size-premie is hier vier keer gemeten. Links is het correct gemeten rendement in elk deciel 12% (stippellijn). Zonder delisting returns en met alleen overlevenden stijgt het naar het kleine eind, met look-ahead daalt het. De banden zijn twee standaarddeviaties over de steekproeven. Rechts overlappen de drie verdelingen van de geschatte premie niet, zodat een -toets op de verkeerde database de nulhypothese van geen size-premie in elke steekproef verwerpt.
De ruis is hier kleiner dan in echte data, omdat het model geen gemeenschappelijke size-factor heeft. In de French-data hieronder is de standaardfout van de size-premie twee tot zes procentpunt. Een fout van vijf procentpunt valt daar dus niet op, en meer jaren data halen die fout niet weg.
6Replicatie op echte data
6.1Wat weging met een eeuw doet
We laden de decielen en wegen ze met het aantal bedrijven (gelijkgewogen) of de totale marktwaarde (waardegewogen) van de vorige maand.
deciles = ["Lo 10", "2-Dec", "3-Dec", "4-Dec", "5-Dec", "6-Dec", "7-Dec", "8-Dec", "9-Dec", "Hi 10"]
size_vw = hap_data.french("Portfolios_Formed_on_ME", "monthly")[deciles]
size_ew = hap_data.french("Portfolios_Formed_on_ME", "monthly", table="Equal-Weight")[deciles]
n_firms = hap_data.french("Portfolios_Formed_on_ME", "monthly", table=4)[deciles]
avg_size = hap_data.french("Portfolios_Formed_on_ME", "monthly", table=5)[deciles]
market = hap_data.market_monthly()["Mkt"]

lagged_n = n_firms.shift(1)
lagged_cap = (n_firms * avg_size).shift(1)
ew_all = ((lagged_n * size_ew).sum(axis=1) / lagged_n.sum(axis=1)).dropna()
vw_rebuilt = ((lagged_cap * size_vw).sum(axis=1) / lagged_cap.sum(axis=1)).dropna()

weighting = pd.concat(
    {"VW markt (Mkt)": market, "VW uit decielen": vw_rebuilt, "EW alle bedrijven": ew_all},
    axis=1,
).dropna()
Per reeks berekenen we het rekenkundige en meetkundige gemiddelde, de standaardfout en de eindwaarde van één dollar.
def describe(r):
    """Annualised arithmetic and geometric mean, volatility, SE and terminal wealth."""
    years = len(r) / 12
    vol = r.std(ddof=1) * np.sqrt(12)
    return pd.Series({"rekenkundig": 12 * r.mean(), "meetkundig": (1 + r).prod() ** (1 / years) - 1,
                      "volatiliteit": vol, "SE gemiddelde": vol / np.sqrt(years),
                      "eindwaarde van 1 dollar": (1 + r).prod()})


weighting.apply(describe).T.round(4)De reconstructie klopt, met 11,63% per jaar uit decielen tegen 11,55% voor de marktreeks. Gelijkgewogen ligt het rendement rekenkundig 3,1 procentpunt hoger. Meetkundig is het verschil kleiner, 12,30% tegen 10,33%, omdat de volatielere gelijkgewogen reeks meer aan variantie verliest, ondanks de herbalanceringswinst. Toch groeit één dollar gelijkgewogen tot zes keer zoveel als waardegewogen, terwijl geen enkel aandeel anders is gemeten.
De volgende cel zet het getal van Fisher en Lorie naast beide wegingen, over hun jaren tot en met 1960.
fisher_lorie = pd.DataFrame({"origineel": 0.090,
                             "hier": weighting.loc[:"1960-12"].apply(describe).loc["meetkundig"]})
fisher_lorie["verschil"] = fisher_lorie["hier"] - fisher_lorie["origineel"]
fisher_lorie.round(4)De waardegewogen markt ligt vier tienden van een procentpunt boven de 9,0%, de gelijkgewogen bijna vier procentpunt. Fisher en Lorie belegden een gelijk bedrag in elk NYSE-aandeel en herbalanceerden niet, zodat hun gewichten naar marktwaarde afdreven, en de kleinste AMEX- en Nasdaq-aandelen ontbraken bij hen. Hun getal hoort daarom bij de waardegewogen reeks. De cel hierna zoekt deciel voor deciel waar het verschil tussen de wegingen zit.
gap = weighting["EW alle bedrijven"] - weighting["VW markt (Mkt)"]
decile_gap = size_ew - size_vw
gap_table = pd.DataFrame(
    {"EW - VW (per jaar)": 12 * decile_gap.mean(),
     "SE": 12 * decile_gap.std(ddof=1) / np.sqrt(len(decile_gap))}
)
gap_table.loc["markt: EW alle - VW"] = [12 * gap.mean(), 12 * gap.std(ddof=1) / np.sqrt(len(gap))]
gap_table["t-waarde"] = gap_table.iloc[:, 0] / gap_table["SE"]
gap_table.round(4)Geslaagd. Ook het weegverschil zit waar we het verwachtten. In het kleinste deciel doet gelijkgewogen weging het 3,77 procentpunt per jaar beter (), terwijl het verschil vanaf het derde deciel niet van nul te onderscheiden is.
Het marktverschil van 3,1 procentpunt heeft twee bronnen. Gelijkgewogen weging geeft het kleinste deciel veel gewicht, omdat daar de meeste bedrijven zitten, terwijl waardegewogen weging het weinig geeft. Binnen dat deciel doet de gelijkgewogen portefeuille het bovendien nog eens beter.
Volgens (7) is dat verschil binnen het deciel zelf een size-premie, en de bid-ask bias en ontbrekende delisting returns kunnen eraan bijdragen. Deze data kunnen niet scheiden welk deel waarvan komt, maar zolang de size-premie en de bid-ask bias niet negatief zijn, kunnen ontbrekende delisting returns in dit deciel hoogstens 3,77 procentpunt van het weegverschil verklaren.
Omdat het kleinste deciel gelijkgewogen zoveel gewicht krijgt en daarbinnen ook nog beter doet, is het gelijkgewogen marktrendement vooral een uitspraak over dat deciel, waar de fouten uit de theorie het grootst zijn. In de figuur met de hele eeuw gaat het om de afstand tussen de twee lijnen van het kleinste deciel.
Source
wealth = pd.DataFrame({
    "waardegewogen markt": (1 + weighting["VW markt (Mkt)"]).cumprod(),
    "gelijkgewogen, alle bedrijven": (1 + weighting["EW alle bedrijven"]).cumprod(),
    "kleinste deciel, gelijkgewogen": (1 + size_ew["Lo 10"].loc[weighting.index]).cumprod(),
    "kleinste deciel, waardegewogen": (1 + size_vw["Lo 10"].loc[weighting.index]).cumprod(),
})

fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), gridspec_kw={"width_ratios": [3, 2]})
for column, color in zip(wealth.columns, hap.plotting.COLORS):
    axes[0].plot(wealth.index, wealth[column], color=color, label=column)
axes[0].set_yscale("log")
axes[0].set_title("Eén dollar in 1926, vier wegingen")
axes[0].set_xlabel("Jaar")
axes[0].set_ylabel("Waarde (log-schaal)")
axes[0].legend()
hap.plotting.timeline_axis(axes[0])

axes[1].plot(n_firms.index, n_firms.sum(axis=1), color=hap.plotting.COLORS[0])
axes[1].set_title("Aantal bedrijven in de size-portefeuilles")
axes[1].set_xlabel("Jaar")
axes[1].set_ylabel("Aantal bedrijven")
hap.plotting.timeline_axis(axes[1])
fig.tight_layout()
plt.show()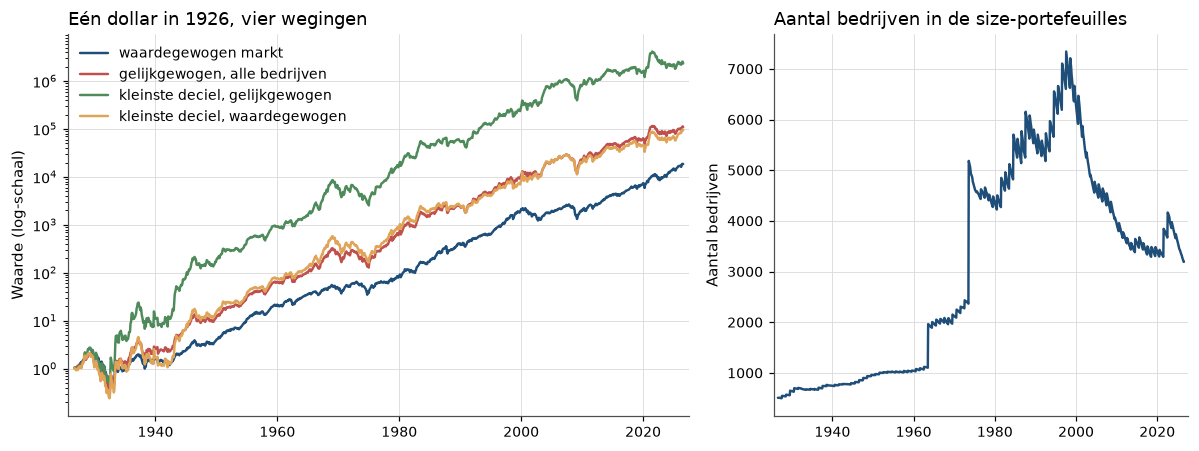
Figure 2:Links staat dezelfde eeuw, vier keer gewogen. Gelijkgewogen eindigt het kleinste deciel ruim een orde van grootte boven hetzelfde deciel waardegewogen, hoewel het om dezelfde aandelen gaat en alleen de weging binnen het deciel en het maandelijks herbalanceren verschillen. Rechts is te zien dat het universum zelf geen constante is, want het groeide tot eind jaren negentig en kromp daarna. Elke daling is een verzameling schrappingen, en elke schrapping is een rendement dat wel of niet in de database staat.
6.2Shumway: de delisting return en de size-premie
De cel vergelijkt de gepubliceerde correcties met de stelling . De Nasdaq-rij is een onafhankelijke toets, terwijl de tweede rij uit dezelfde tabel haalt en dus alleen toetst of de fout lineair is in .
Voor Nasdaq rapporteren Shumway en Warther zelf, 2,95% per maand, bij een gemiddeld rendement van 3,79% per maand. Shumways tabel VII geeft daarentegen jaarrendementen. Zetten we elk ontbrekend rendement op , dan daalt het kleinste deciel met 5,21 procentpunt per jaar. Volgens de stelling is dat , met per maand. Daaruit volgt per jaar, en die gaat met opnieuw de stelling in.
# Shumway & Warther (1999), table IV, smallest Nasdaq portfolio, % per month:
# 3.79 with CRSP data, 1.97 with missing delisting returns set to -55%; 2.95% delisted per month.
# Shumway (1997), table VII, smallest decile, % per year: 21.28 with CRSP data,
# 19.83 with over-the-counter delisting returns (mean -30%), 16.07 with -100%.
mu_nasdaq = 0.0379                    # monthly mean return, smallest Nasdaq portfolio
h_nasdaq = 0.0295                     # share delisted per month
mu_small = 0.2128 / 12                # monthly mean return, smallest decile (table VII)
h_small_year = (0.2128 - 0.1607) / (1 + mu_small)   # 12 h, from h (mu_a - r_s) with r_s = -100%

published = pd.DataFrame(
    {"origineel": [3.79 - 1.97, 21.28 - 19.83],
     "hier: h (mu_a - r_s)": [100 * h_nasdaq * (mu_nasdaq + 0.55), 100 * h_small_year * (mu_small + 0.30)]},
    index=["Nasdaq, kleinste portefeuille, r_s = -55% (pp per maand)",
           "kleinste deciel, r_s = -30% (pp per jaar)"],
)
published["verschil"] = published["hier: h (mu_a - r_s)"] - published["origineel"]
published.round(3)Geslaagd. Beide correcties liggen binnen de aangekondigde 0,2 procentpunt van de stelling, met 1,73 tegen 1,82 per maand op Nasdaq en 1,63 tegen 1,45 per jaar bij Shumway. De hele fout door ontbrekende delisting returns zit dus in twee getallen, de schrappingskans en het ontbrekende verlies. De volgende cel meet de size-premie per deelperiode, met 1981 als grens.
subperiods = {"1926-07 / 1962-12": ("1926-07", "1962-12"),
              "1963-01 / 1981-12": ("1963-01", "1981-12"),
              "1982-01 / 2026-07": ("1982-01", "2026-07"),
              "1926-07 / 2026-07": ("1926-07", "2026-07")}


def premium_stats(panel, start, end):
    """Annualised small-minus-big premium, its standard error and t-statistic."""
    p = (panel["Lo 10"] - panel["Hi 10"]).loc[start:end]
    se = p.std(ddof=1) / np.sqrt(len(p))
    return 12 * p.mean(), 12 * se, p.mean() / se


rows = {}
for name, (start, end) in subperiods.items():
    ew_mean, ew_se, ew_t = premium_stats(size_ew, start, end)
    vw_mean, vw_se, vw_t = premium_stats(size_vw, start, end)
    weighting_gap = ((size_ew["Lo 10"] - size_ew["Hi 10"]) - (size_vw["Lo 10"] - size_vw["Hi 10"])).loc[start:end]
    rows[name] = {"EW premie": ew_mean, "EW SE": ew_se, "EW t": ew_t,
                  "VW premie": vw_mean, "VW SE": vw_se, "VW t": vw_t,
                  "EW - VW": 12 * weighting_gap.mean(),
                  "SE EW - VW": 12 * weighting_gap.std(ddof=1) / np.sqrt(len(weighting_gap))}
size_premium = pd.DataFrame(rows).T
size_premium.round(4)Geslaagd. Vóór 1982 is de gelijkgewogen premie groter dan de waardegewogen, tot 1962 bijna twee keer zo groot, met 18,6 tegen 10,3 procentpunt per jaar. Na 1981 is de premie in beide wegingen niet meer van nul te onderscheiden, en over de volle eeuw is het verschil tussen de wegingen ruim vijf standaardfouten groot, zoals de laatste twee kolommen tonen.
Hoe kwetsbaar is die premie? De laatste cel rekent terug welke schrappingskans zonder geregistreerd laatste rendement de gelijkgewogen premie sinds 1963 volledig zou verklaren.
monthly_premium = (size_ew["Lo 10"] - size_ew["Hi 10"]).loc["1963-01":"2026-07"].mean()
break_even = pd.DataFrame(
    {"schrappingskans per maand": {f"r_s = {d:.0%}": monthly_premium / -d for d in (-0.30, -0.55, -1.00)},
     "schrappingskans per jaar": {f"r_s = {d:.0%}": 12 * monthly_premium / -d for d in (-0.30, -0.55, -1.00)}}
)
break_even.round(4)In de rij is de kans gelijk aan de premie zelf, 0,31% per maand, omdat de cel rekent. De premie is weg als elke maand 0,57% van het kleinste deciel van de beurs gaat met een ontbrekend rendement van . Shumway en Warther vonden in de kleinste Nasdaq-portefeuille 2,95% per maand, zodat zo’n kans allerminst exotisch is.
French sorteert op NYSE-breekpunten. De decielgrenzen komen dus alleen uit NYSE-aandelen, zodat de vele kleine AMEX- en Nasdaq-aandelen in het kleinste deciel belanden. De cel toont welk deel van de bedrijven in dat deciel valt.
share_small = n_firms["Lo 10"] / n_firms.sum(axis=1)
share_small.loc[["1956-07-31", "1976-07-31", "2026-07-31"]].rename("aandeel in kleinste deciel").round(3)
date
1956-07-31 0.100
1976-07-31 0.536
2026-07-31 0.386
Name: aandeel in kleinste deciel, dtype: float64In 1956 viel 10% van de bedrijven in het kleinste deciel, in 1976 ruim de helft en nu nog bijna 40%. Of de huidige French-data de delisting returns van die kleine aandelen bevatten, is zonder CRSP niet vast te stellen. Het teken en de omvang van de size-premie hangen dus af van een veld dat de gebruiker zelden opent.
7Wat er brak, en wat daarna kwam
Wat de tape verklaart. Vóór 1964 was er over het rendement op aandelen een mening, daarna een getal met een definitie. Binnen tien jaar draaiden de eerste event study en de toetsen van het CAPM op dezelfde band. De keuzes van Fisher en Lorie, namelijk totaalrendementen met herbelegde dividenden, vanaf 1926 en voor alle genoteerde aandelen, zijn nog altijd de standaard. Dat ze ook de verdwenen bedrijven meenamen, bleek achteraf de belangrijkste keuze.
Waar het breekt. De tape breekt in de velden die leeg bleven en in de keuzes van de gebruiker. De weging alleen verschuift het marktrendement van een eeuw met 3,1 procentpunt per jaar, bijna geheel via het kleinste deciel. Shumway en Warther Shumway & Warther (1999) lieten zien dat het size-effect op Nasdaq verdwijnt zodra de ontbrekende delisting returns zijn ingevuld, en de -toets op gelijke gemiddelden zakt dan van 3,52 naar 0,58.
De bouw van de database is voor de cross-sectie een grotere bron van onzekerheid dan de standaardfout van 2%, de ruis die een eeuw data in een gemiddelde laat, en een langere reeks verandert daar weinig aan.
Risico of vergissing? Is de size-premie een beloning of een meetfout? De Chicago-lezing ziet prijzen als juist, zodat kleine aandelen zolang ze bestaan meer moeten opbrengen om het verlies bij faillissement goed te maken. Onze simulatie is zo gebouwd, en correct gemeten is de premie daar nul. Een premie die in schone data overblijft, zou dan een beloning voor risico zijn. De Yale-lezing laat toe dat prijzen ernaast zitten, en dan was een premie die verdwijnt na correctie en na publicatie nooit een risicopremie. Shumway & Warther (1999) vinden hun resultaten slecht te rijmen met risicoverklaringen. Scheiden kan alleen met een onafhankelijke maat voor faillissementsrisico plus volledige delisting returns, en die gegevens ontbreken in deze reeks. Wel laat de simulatie zien hoe groot een premie kan worden die de database zelf maakt.
Wat er daarna kwam. De tape leverde de rendementen, maar geen argument voor wat die rendementen zouden moeten doen. Dat argument gaf Fama met de hypothese van efficiënte markten, het onderwerp van Fama en de efficiënte markt.
8Oefeningen
Solution to Exercise 1
(1) De delisting return is . Het correcte marktrendement is .
(2) De database zonder delisting return meet , een fout van 20 procentpunt, en de formule geeft . De cel rekent het na met de functie uit het toy-voorbeeld.
worthless = total_returns(prices, {"C": (3, 0.0)})
pd.Series({"correct, periode 3": worthless.loc[3].mean(),
           "zonder delisting return, periode 3": worthless.loc[3].drop("C").mean(),
           "formule h (mu_a - r_s)": 0.2 * (0.0 - (-1.0))}).round(4)
correct, periode 3 -0.2
zonder delisting return, periode 3 0.0
formule h (mu_a - r_s) 0.2
dtype: float64De fout groeit dus lineair met het ontbrekende verlies. Een database die faillissementen zonder restwaarde mist, overschat het gemiddelde daardoor met de volle schrappingskans.
:::{exercise}
:label: ex-crsp-tape-2

**Afleiding: survivorship bij drift en bij maandelijkse waarneming.** Neem het model van
[](#thm-crsp-tape-survivorship). Kies $z_0 = 1$, $\sigma = 50\%$ per jaar en $T = 20$ jaar.

1. Laat zien dat [](#eq-crsp-tape-survivorship) niet geldt als $Z_t$ een drift
   $\nu \neq 0$ heeft. Waar gaat het bewijs mis, en welk proces is dan wel een
   martingaal?
2. Simuleer 20 000 paden met maandelijkse stappen en schrap zodra $Z_t \le 0$ op een
   maandeinde. Vergelijk overleefkans en fout met de formules, en verklaar het teken
   van het verschil.
Solution to ex-crsp-tape-2
(1) Het bewijs gebruikt dat een martingaal is, zodat . Met drift is , en die verwachte stoptijd hangt zelf van de drempel af. De martingaal is dan . De eenvoudige formule geldt alleen zonder drift. Bij positieve drift raken minder paden de drempel, zodat de fout positief blijft maar kleiner wordt.
(2)
n_paths, steps_per_year, horizon, x0, sigma = 20_000, 12, 20, 1.0, 0.50
increments = rng.normal(0.0, sigma / np.sqrt(steps_per_year), size=(n_paths, steps_per_year * horizon))
paths = x0 + increments.cumsum(axis=1)
alive = (paths > 0).all(axis=1)

p_formula, bias_formula = survivor_bias(x0, sigma, horizon)
pd.DataFrame(
    {"simulatie (maandelijks)": [alive.mean(), (paths[alive, -1].mean() - x0) / horizon],
     "formule (continu)": [p_formula, bias_formula]},
    index=["overleefkans", "gem. logrendement overlevenden per jaar"],
).round(4)De gesimuleerde overleefkans (0,368) ligt boven de formule (0,345), en de fout (9,3%) eronder (9,5%). Dat teken is te verwachten, want een pad dat tussen twee maandeinden kort onder de drempel duikt, wordt bij maandelijkse waarneming niet geschrapt, zodat de selectie iets milder is.
Survivorship bias is dus geen eigenschap van één model maar van selectie op een drempel. Hoe strenger die selectie, hoe groter de fout.
:::{exercise}
:label: ex-crsp-tape-3

**Uitbreiding van de replicatie: waar en wanneer zit het weegverschil?** De reeksen
`size_ew`, `size_vw` en `ew_all` staan klaar uit de replicatie. Gebruik ze voor de drie deelvragen.

1. Bereken voor 1926–1962, 1963–1981 en 1982–2026 het verschil tussen gelijk- en
   waardegewogen in het kleinste en het grootste deciel, met standaardfouten.
2. Bereken voor dezelfde perioden het verschil in meetkundig gemiddelde tussen `ew_all`
   en de waardegewogen markt. Is het groter of kleiner dan het rekenkundige verschil?
3. Is het weegverschil in het kleinste deciel na 1981 verdwenen, zoals de size-premie?
Solution to ex-crsp-tape-3
rows = {}
vw_market = weighting["VW markt (Mkt)"]
for name, (start, end) in list(subperiods.items())[:3]:
    small = (size_ew["Lo 10"] - size_vw["Lo 10"]).loc[start:end]
    large = (size_ew["Hi 10"] - size_vw["Hi 10"]).loc[start:end]
    ew_part, vw_part = ew_all.loc[start:end], vw_market.loc[start:end]
    years = len(ew_part) / 12
    rows[name] = {
        "Lo 10: EW-VW": 12 * small.mean(), "Lo 10: SE": 12 * small.std(ddof=1) / np.sqrt(len(small)),
        "Hi 10: EW-VW": 12 * large.mean(), "Hi 10: SE": 12 * large.std(ddof=1) / np.sqrt(len(large)),
        "markt rekenk. EW-VW": 12 * (ew_part.mean() - vw_part.mean()),
        "markt meetk. EW-VW": (1 + ew_part).prod() ** (1 / years) - (1 + vw_part).prod() ** (1 / years),
    }
pd.DataFrame(rows).T.round(4)(1) en (3) Binnen het kleinste deciel krimpt het verschil van 8,0 procentpunt per jaar vóór 1963 via 3,1 tot 0,6 na 1981, met een standaardfout van 1,1. Het is na 1981 dus niet meer van nul te onderscheiden. In het grootste deciel ligt het in alle perioden binnen drie tienden van een procentpunt. Krimpende spreads en vollediger delisting returns passen bij dit patroon, maar een verdwijnende premie binnen het deciel ook.
(2) Het meetkundige verschil is in elke periode kleiner dan het rekenkundige, omdat de volatielere gelijkgewogen markt meer aan variantie verliest. De winst uit (8) geldt ten opzichte van de eigen onderdelen, niet ten opzichte van een andere portefeuille.
Deze oefening laat zien dat “het” marktrendement niet bestaat. Elke uitspraak erover gaat immers over een periode en een weging.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Fisher, L., & Lorie, J. H. (1964). Rates of Return on Investments in Common Stocks. The Journal of Business, 37(1), 1–21. 10.1086/294647
- Fisher, L., & Lorie, J. H. (1968). Rates of Return on Investments in Common Stock: The Year-by-Year Record, 1926–65. The Journal of Business, 41(3), 291–316. 10.1086/295107
- Shumway, T. (1997). The Delisting Bias in CRSP Data. The Journal of Finance, 52(1), 327–340. 10.1111/j.1540-6261.1997.tb03818.x
- Shumway, T., & Warther, V. A. (1999). The Delisting Bias in CRSP’s Nasdaq Data and Its Implications for the Size Effect. The Journal of Finance, 54(6), 2361–2379. 10.1111/0022-1082.00192
- Brown, S. J., Goetzmann, W., Ibbotson, R. G., & Ross, S. A. (1992). Survivorship Bias in Performance Studies. Review of Financial Studies, 5(4), 553–580. 10.1093/rfs/5.4.553
- Kothari, S. P., Shanken, J., & Sloan, R. G. (1995). Another Look at the Cross-Section of Expected Stock Returns. The Journal of Finance, 50(1), 185–224. 10.1111/j.1540-6261.1995.tb05171.x
- Fama, E. F., & French, K. R. (1992). The Cross-Section of Expected Stock Returns. The Journal of Finance, 47(2), 427–465. 10.2307/2329112
- Booth, D. G., & Fama, E. F. (1992). Diversification Returns and Asset Contributions. Financial Analysts Journal, 48(3), 26–32. 10.2469/faj.v48.n3.26
- Blume, M. E., & Stambaugh, R. F. (1983). Biases in Computed Returns: An Application to the Size Effect. Journal of Financial Economics, 12(3), 387–404. 10.1016/0304-405X(83)90056-9
- Banz, R. W. (1981). The Relationship between Return and Market Value of Common Stocks. Journal of Financial Economics, 9(1), 3–18. 10.1016/0304-405X(81)90018-0
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD