

Parametrische portefeuilles en idiosyncratisch risico
1Overzicht
Hoe zet een belegger een handvol slecht gemeten feiten om in portefeuillegewichten? Hij schat niet de verwachte rendementen van duizenden aandelen, maar een paar coëfficiënten die de gewichten rechtstreeks aan kenmerken en voorspellers koppelen. Dat dempt de schattingsfout van Markowitz, al kan zo’n regel niet zien of de premie van gisteren morgen nog bestaat. Welk risico de markt beloont, blijft open, want het resultaat dat de gemiddelde variantie van aandelen het marktrendement voorspelt, bleef later niet overeind. In dit college doen we vier dingen:
we laten met de hand zien dat een regel die op een voorspeller reageert, een vaste mix van twee rendementsreeksen is;
we leiden af dat de coëfficiënten met GMM te schatten zijn en dat hun ruis groeit met het aantal kenmerken, niet met het aantal aandelen;
we simuleren 500 aandelen met kleine premies en vergelijken de regel met 1/N en met Markowitz;
we repliceren de parametrische portefeuille van Brandt, Santa-Clara en Valkanov op 100 size/BM-portefeuilles, en de regressie van Goyal en Santa-Clara op 49 industrieportefeuilles.
Rond 2000 vroeg de portefeuilletheorie om de verwachte rendementen van alle activa, terwijl de empirie zei dat die rendementen met een paar kenmerken samenhangen. Brandt & Santa-Clara (2006) maakten van een dynamisch probleem een statisch probleem door geschaalde rendementsreeksen als extra activa toe te voegen. Brandt et al. (2009) deden hetzelfde in de cross-sectie, met drie coëfficiënten voor duizenden aandelen. Santa-Clara noemt dat achteraf een poging om portefeuillekeuze te bevrijden van de vloek van de dimensionaliteit Santa-Clara (2026). Het tweede spoor begon toen Goyal & Santa-Clara (2003) vonden dat de gemiddelde variantie van aandelen het marktrendement voorspelt. De marktvariantie deed dat niet, in strijd met Het CAPM, maar ook dat resultaat hield geen stand Bali et al. (2005)Wei & Zhang (2005). Idiosyncratische volatiliteit bleef intussen een raadsel Campbell et al. (2001)Ang et al. (2006)Herskovic et al. (2016). Op de vraag theorie of feit geeft dit college dus feiten als antwoord. De regel gebruikt kenmerken zonder ze te verklaren, en voor de volatiliteitsfeiten zijn er meer theorieën dan data om ze te scheiden.
2Intuïtie: waarom zou dit waar zijn?
Denk aan een belegger die gelooft dat kleine, goedkope aandelen met een goed afgelopen jaar beter renderen. Markowitz vraagt hem een verwacht rendement voor elk van duizenden aandelen en een covariantiematrix met een miljoen elementen, en de optimalisator zoekt daarin juist de slechtst geschatte richtingen op. Brandt, Santa-Clara en Valkanov vragen alleen hoeveel hij van de markt wil afwijken per eenheid “klein”, “goedkoop” en “goed jaar”. Dat zijn drie getallen, en omdat hij ze uit alle aandelen tegelijk schat, middelt de bedrijfsspecifieke ruis grotendeels weg.
Afwijken van de markt in verhouding tot een kenmerk komt neer op de markt houden plus een portefeuille die aandelen met een hoog kenmerk koopt en met een laag kenmerk verkoopt. De belegger kiest dus tussen een paar portefeuilles en niet tussen duizenden aandelen. In de tijd werkt het net zo. Wie meer aandelen houdt als de dividendopbrengst hoog is, bezit naast de markt een vaste positie in de markt geschaald met de dividendopbrengst, en die positie is gewoon een activum met een eigen rendementsreeks. Zo wordt het dynamische probleem van Merton een statisch probleem van Markowitz.
De regel helpt tegen schattingsfout, omdat twee aandelen met dezelfde kenmerken hetzelfde gewicht krijgen, wat hun historische gemiddelde ook was. Om dezelfde reden wint 1/N van mean-variance, en de parametrische portefeuille zit tussen die twee in.
Goyal en Santa-Clara vroegen welk risico de markt beloont. Voor een gediversifieerde belegger is dat alleen marktrisico, maar de meeste huishoudens bezitten een handvol aandelen, en voor hen is bedrijfsspecifiek risico gewoon risico. Stijgt de onzekerheid over individuele bedrijven, dan eisen ze misschien een hogere premie op de hele markt.
We verwachten daarom dat de parametrische regel de markt verslaat zodra de steekproef lang genoeg is om de premies te zien. Van schattingsfout zou hij veel minder last moeten hebben dan Markowitz. Als het argument over huishoudens klopt, gaat bovendien een hoge gemiddelde variantie van aandelen vooraf aan een hoog marktrendement, terwijl de marktvariantie weinig zegt.
3Toy-voorbeeld: een voorspeller met twee waarden, drie aandelen met één kenmerk
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import optimize, signal

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Het voorbeeld heeft twee delen, één in de tijd en één in de cross-sectie, en beide keren blijkt de regel een vaste mix van een paar rendementsreeksen.
3.1(a) Dynamisch wordt statisch
Hier stuurt een voorspeller de positie in de tijd. Eén risicovol activum heeft overrendement , en een voorspeller neemt met gelijke kans de waarden -1 (laag) en +1 (hoog) aan. De belegger maximaliseert kwadratisch nut met risicoaversiecoëfficiënt . De tabel bevat alles wat hij nodig heeft, met het tweede moment.
| laag, | hoog, | |
|---|---|---|
| kans | 1/2 | 1/2 |
| verwacht overrendement | 2% | 10% |
| conditionele variantie | 0,04 | 0,04 |
| tweede moment | 0,0404 | 0,05 |
We hebben één formule nodig, de optimale positie bij kwadratisch nut, , of in matrixvorm . De theorie leidt die formule straks als eerste af.
Per toestand is en .
Als tweede activum nemen we , een strategie die in de hoge toestand één eenheid koopt en in de lage toestand één eenheid verkoopt. Voor de twee betalingen geldt, omdat ,
met en . 3. De determinant is , zodat de vaste mix gelijk is aan
De regel die daarbij hoort, is , dus in de lage en in de hoge toestand.
Het verwachte nut is met de voorspeller . Zonder voorspeller is de beste vaste positie , met verwacht nut .
De cel rekent dezelfde stappen na en zet hand en code naast elkaar.
gamma = 5.0
prob = np.array([0.5, 0.5])
mu_state = np.array([0.02, 0.10])            # E[r | low], E[r | high]
x_state = np.array([-1.0, 1.0])
s_state = 0.04 + mu_state**2                 # E[r^2 | x]

# conditional optimum, state by state
w_conditional = mu_state / (gamma * s_state)

# static optimum over the two payoffs (r, x r)
payoff = np.column_stack([np.ones(2), x_state])          # (r, x r) = payoff * r
mean_managed = (prob * mu_state) @ payoff
second_moment = (payoff.T * (prob * s_state)) @ payoff
theta_managed = np.linalg.solve(second_moment, mean_managed) / gamma
w_static = theta_managed[0] + theta_managed[1] * x_state

utility_timing = prob @ (mu_state**2 / (2 * gamma * s_state))
utility_fixed = (prob @ mu_state) ** 2 / (2 * gamma * (prob @ s_state))

pd.DataFrame(
    {"met de hand": [0.09901, 0.40, 0.24950, 0.15050, 0.09901, 0.40, 0.010495, 0.007965],
     "code": [*w_conditional, *theta_managed, *w_static, utility_timing, utility_fixed]},
    index=["w laag, per toestand", "w hoog, per toestand", "theta0", "theta1",
           "w laag = theta0 - theta1", "w hoog = theta0 + theta1",
           "verwacht nut met voorspeller", "verwacht nut zonder voorspeller"],
).round(6)Code en hand geven dezelfde getallen. Een vaste mix van twee rendementsreeksen doet dus precies wat de belegger doet die per toestand opnieuw optimaliseert, en ongeveer een kwart van zijn verwachte nut komt van de voorspeller.
3.2(b) Een parametrische regel met drie aandelen
Drie aandelen hebben marktgewichten en één kenmerk, het momentum van het afgelopen jaar. Over de cross-sectie is het gemiddelde momentum 5% en de standaarddeviatie 15%, zodat het gestandaardiseerde kenmerk de waarden -1, 0 en 1 krijgt. De regel van Brandt, Santa-Clara en Valkanov tilt elk marktgewicht op in verhouding tot het kenmerk,
| aandeel | marktgewicht | momentum | rendement periode 1 | rendement periode 2 | |
|---|---|---|---|---|---|
| 1 | 0,5 | −10% | −1 | −3% | 4% |
| 2 | 0,3 | 5% | 0 | 1% | 1% |
| 3 | 0,2 | 20% | 1 | 6% | −5% |
Omdat de optellen tot nul, tellen de gewichten altijd op tot één. Bij zijn ze , bij zijn ze .
In periode 1 rendeert de portefeuille bij precies en bij precies .
Met CRRA-nut en , het nut dat Brandt, Santa-Clara en Valkanov zelf gebruiken, is het gerealiseerde nut en .
Het portefeuillerendement is , met het rendement van een kenmerkportefeuille die aandeel 3 koopt en aandeel 1 verkoopt. Bij één periode stijgt het nut daarom met elke extra eenheid zolang , al blijft het onder nul, zodat één periode geen optimum oplevert.
In periode 2 is en . Het gemiddelde nut is maximaal waar de twee brutorendementen gelijk zijn, bij .
De cel berekent de gewichten, het nut en het optimum over twee perioden.
w_bar = np.array([0.5, 0.3, 0.2])
momentum_raw = np.array([-0.10, 0.05, 0.20])
x_hat = (momentum_raw - momentum_raw.mean()) / momentum_raw.std(ddof=1)
returns_1 = np.array([-0.03, 0.01, 0.06])
returns_2 = np.array([0.04, 0.01, -0.05])

def toy_policy(theta):
    """BSV weights for the three-stock example."""
    return w_bar + theta * x_hat / len(x_hat)

def crra(R, g=5.0):
    return R ** (1 - g) / (1 - g)

def mean_utility(theta):
    """Average realised CRRA utility over the two periods."""
    return (crra(1 + toy_policy(theta) @ returns_1) + crra(1 + toy_policy(theta) @ returns_2)) / 2

theta_star = optimize.minimize_scalar(lambda th: -mean_utility(th), bounds=(-5, 5), method="bounded").x
pd.DataFrame(
    {"met de hand": [1.0, 0.7, 1.045, -0.25, -0.20964, 0.03, 0.013 / 0.06],
     "code": [x_hat[2], toy_policy(1.5)[2], 1 + toy_policy(1.5) @ returns_1,
              crra(1 + toy_policy(0.0) @ returns_1), crra(1 + toy_policy(1.5) @ returns_1),
              x_hat @ returns_1 / 3, theta_star]},
    index=["x_hat aandeel 3", "w3 bij theta = 1,5", "R_p bij theta = 1,5", "nut bij theta = 0",
           "nut bij theta = 1,5", "r^x in periode 1", "theta* over twee perioden"],
).round(4)Ook hier geven code en hand dezelfde getallen. Omdat de kenmerkportefeuille in de ene periode wint en in de andere verliest, kiest de belegger een kleine positieve . Het gewicht op aandeel 3 stijgt daardoor met , ruim zeven procentpunt, en dat op aandeel 1 zakt evenveel.
4Theorie
De theorie volgt twee sporen. Het eerste laat zien dat een conditionele portefeuilleregel een statische keuze is tussen managed portfolios, rendementsreeksen die met een signaal zijn geschaald, eerst in de tijd en dan in de cross-sectie. Daaruit volgt waarom de regel de schattingsfout van Markowitz indamt, want zijn ruis groeit met het aantal kenmerken en niet met het aantal aandelen . Het tweede spoor splitst de gemiddelde variantie van aandelen in een markt- en een afwijkingsdeel en formuleert zo de toets van Goyal en Santa-Clara.
4.1Brandt en Santa-Clara: een conditionele regel als vaste mix
Een belegger die zijn positie lineair aanpast aan wat hij ziet, verdient elke periode een vaste combinatie van producten van signaal en rendement. Zo’n product is een rendementsreeks met schatbare momenten, net als een aandeel. Een vaste mix van vaste reeksen kiezen is precies het probleem van Markowitz, en zolang de regel elke toestand apart kan behandelen, kost die omweg de belegger niets.
Stel dat er risicovolle activa zijn met overrendementen . Daarnaast zijn er conditioneringsvariabelen die op bekend zijn, met een constante als eerste element en bijvoorbeeld de dividendopbrengst als tweede. Een lineaire regel is , met een -matrix van coëfficiënten. Het rendement van de portefeuille is dan
Het rendement van de regel is dus een vaste combinatie van managed portfolios , waarin activum met variabele is geschaald. Brandt & Santa-Clara (2006) werken met een mean-variance-benadering van het nut. Wij nemen kwadratisch nut in het tweede moment, omdat de gelijkwaardigheid dan exact is.
Proof 1
(1) Gegeven is het doel , strikt concaaf, met eerste-ordevoorwaarde . (2) Neem eerst . Dan is in toestand , met het -de blok van . Met de wet van de herhaalde verwachtingen is het doel , een som van problemen die elk alleen van hun eigen blok afhangen en elk door (1) worden opgelost. Tegelijk is blokdiagonaal met blokken , en heeft blokken , zodat (5) blok voor blok geeft.
Voor algemene is . De verzameling bereikbare rendementen is dezelfde, en dus ook het optimale rendement en de regel, met . Uniciteit volgt uit de positieve definietheid van . (3) Elke affiene regel is van de vorm en het doel is strikt concaaf in , zodat (5) de eerste-ordevoorwaarde is.
Het bewijs werkt, omdat een indicator voor de toestand het statische probleem opknipt in losse problemen, één per toestand. Een inverteerbare transformatie van die indicatoren verandert de bereikbare rendementen niet. In het toy-voorbeeld is , zodat het gemiddelde en het halve verschil van de twee conditionele posities is.
Vergelijking (5) is de coëfficiënt van een regressie van de constante 1 op zonder intercept Britten-Jones (1999), zodat een gewone regressie de gewichten al oplevert. Gratis is de truc toch niet, want met activa en variabelen is het statische probleem een Markowitz-probleem in activa, met alle schattingsfout van dien.
4.2Brandt, Santa-Clara en Valkanov: de cross-sectie in drie parameters
In de cross-sectie verschilt de conditioneringsvariabele niet tussen perioden maar tussen aandelen, en dan volstaan coëfficiënten voor duizenden aandelen. Verschillen verwachte rendementen alleen via kenmerken, dan hangt ook de optimale afwijking van de markt alleen van die kenmerken af. Neemt de belegger die afwijking lineair, met dezelfde coëfficiënten voor elk aandeel, dan heeft het probleem evenveel onbekenden als er kenmerken zijn.
Op elk tijdstip zijn er aandelen, in het artikel gemiddeld 3.680 per maand Brandt et al. (2009), met marktgewichten als benchmark. Elk aandeel heeft kenmerken, bijvoorbeeld de log marktwaarde, en die worden per maand over de cross-sectie gestandaardiseerd tot gemiddelde nul en standaarddeviatie één, . De regel is
De deling door houdt de totale afwijking van de markt gelijk als het aantal aandelen groeit, en door de standaardisatie blijft over de tijd vergelijkbaar. Omdat , tellen de gewichten op tot één, en het portefeuillerendement is
Hier is het brutorendement van de markt. De vector bevat de rendementen van kenmerkportefeuilles die niets kosten, omdat ze aandelen met een hoog kenmerk kopen en met een laag kenmerk verkopen. In het toy-voorbeeld was in de eerste periode 3%, en de regel is dus de cross-sectionele versie van (4), een statische keuze tussen de markt en managed portfolios.
Brandt et al. (2009) schatten met CRRA-nut en , zoals in het toy-voorbeeld. Er komt geen verwacht rendement en geen covariantiematrix aan te pas, en omdat het nut de hele verdeling ziet, tellen ook scheefheid en dikke staarten mee. De schatter maximaliseert het gemiddelde gerealiseerde nut in de steekproef,
Proof 2
(1) Het doel in (8) is glad en strikt concaaf in zolang , want , en de gradiënt is . Het maximum ligt dus waar die gradiënt nul is. Consistentie volgt uit de uniforme wet van de grote aantallen voor het doel en de identificatievoorwaarde (een uniek maximum).
(2) Een middelwaardestelling rond geeft , met tussen en en . De haakjesterm convergeert naar , en convergeert naar door een centrale limietstelling voor martingaalverschillen. Vermenigvuldigen met geeft (10). Bij autocorrelatie vervangt een Newey-West-schatter .
De schatter is dus een exact geïdentificeerde GMM-schatter Hansen (1982), en de sandwichformule (10) levert de standaardfouten die we in de replicatie gebruiken. De voorwaarde (9) heeft bovendien een economische lezing. Met staat er , zodat het marginale nut van de belegger zelf de kenmerkportefeuilles een prijs van nul geeft. Dat is de waarderingsvergelijking uit Cochrane: p = E[mx], toegepast op betalingen die niets kosten.
4.3Wat het voorspelt: ruis van orde in plaats van 
De parametrische regel schat getallen, elk voor een portefeuille die over alle aandelen middelt. Markowitz laat daarentegen slecht geschatte gemiddelden door uitvergroten. Twee berekeningen maken dat verschil concreet. Laat het overrendement van aandeel gelijk zijn aan , met marktfactor , premies per eenheid kenmerk en onafhankelijke idiosyncratische ruis met variantie . Dan is
De laatste term heeft variantie per kenmerk. Bij ruis van 12% per maand en 500 aandelen, zoals in de simulatie, is de standaarddeviatie van die term per maand in plaats van 12%. Het gemiddelde van een kenmerkportefeuille is dus veel beter te schatten dan dat van één aandeel. Ook de opwaartse vertekening van de Sharpe-ratio in de steekproef groeit met in plaats van de uit Markowitz, Roy en Tobin Jobson & Korkie (1980), omdat de optimalisator maar richtingen heeft om ruis in te vinden. Bij duizend aandelen en drie kenmerken scheelt dat een factor van ruim driehonderd.
De schatter wordt dus stabieler naarmate hij over meer aandelen middelt, al betaalt de belegger daarvoor met de aanname dat alleen lineaire verschillen in tellen. Of de regel de markt ook verslaat, hangt af van de premies ten opzichte van de resterende ruis. In de simulatie staat 0,03% per maand tegen 0,54%, en daar blijkt hoe lang de belegger moet wachten.
Met mean-variance in plaats van CRRA-nut wordt het verband met Markowitz exact. Maximaliseren we , dan is
De regel vraagt dus naar kenmerkportefeuilles zoals Markowitz naar activa vraagt, plus een hedgeterm voor de benchmark. De matrix die de regel inverteert, is maar en bevat rendementen waaruit de ruis grotendeels is weggemiddeld, terwijl Markowitz de -matrix van Markowitz, Roy en Tobin inverteert. Stijgt , dan krimpt de speculatieve term en blijft de belegger dichter bij de markt. Oefening 2 leidt de formule af.
De afleiding negeert short-beperkingen en kosten, en daarom krijgt de regel in de praktijk twee aanpassingen. De lineaire regel kan negatieve gewichten geven, vooral voor kleine aandelen met een klein marktgewicht, en een long-only-versie kapt die af en normaliseert:
Omdat het doel met afgekapte gewichten niet meer glad is, schatten we dan met een zoekmethode zonder afgeleiden. Transactiekosten komen in het doel als , met het gewicht na de koersbeweging. Met de kosten in het doel kiest de schatter van Brandt et al. (2009) vanzelf een regel met minder omzet. Hij maximaliseert dan het certainty equivalent na kosten, het zekere rendement dat de belegger even hoog waardeert als de strategie.
4.4Goyal en Santa-Clara: welk risico voorspelt de markt?
Goyal en Santa-Clara toetsen of de gemiddelde variantie van individuele aandelen het marktrendement voorspelt, naast of in plaats van de marktvariantie. Volgens het CAPM zou alleen de marktvariantie dat doen, maar voor de onvolledig gespreide huishoudens uit de intuïtie telt juist het bedrijfsspecifieke risico.
De variantie van aandeel in maand meten we met dagrendementen, , en voor de markt op dezelfde manier. De toets van Goyal & Santa-Clara (2003) is
met het overrendement van de markt en de gelijkgewogen gemiddelde variantie van de aandelen. Volgens de hypothese is positief en hooguit klein. Dat grotendeels idiosyncratisch is, volgt uit een identiteit.
De gemiddelde variantie van aandelen is dus de marktvariantie plus de gemiddelde variantie van hun afwijkingen van de markt. Alleen die tweede term kan idiosyncratisch zijn. Campbell et al. (2001) gebruikten deze decompositie en vonden dat de bedrijfsspecifieke component tussen 1962 en 1997 meer dan verdubbelde, en veel sterker steeg dan de markt- en de industriecomponent. Voor individuele aandelen domineert de tweede term, want Goyal en Santa-Clara schatten in een gestileerde kalibratie dat idiosyncratisch risico bijna 85% van de gemiddelde aandeelvariantie is.
Voor de replicatie is een gevolg van belang. Vervangen we aandelen door portefeuilles van elk aandelen met idiosyncratische variantie , dan bevat de afwijking nog maar aan idiosyncratische variantie, zodat een replicatie met portefeuilles vooral marktvariantie meet. Over het oorspronkelijke resultaat vond de latere literatuur drie dingen:
Bali et al. (2005) lieten zien dat het vooral uit kleine Nasdaq-aandelen kwam en verdween als de steekproef tot eind 2001 liep, en Wei & Zhang (2005) dat het op de jaren negentig rustte;
Ang et al. (2006) vonden in de cross-sectie het omgekeerde van een premie, want aandelen met hoge idiosyncratische volatiliteit renderen zeer slecht, met een verschil in FF3-alpha van −1,31% per maand tussen het hoogste en het laagste kwintiel;
Herskovic et al. (2016) vonden een sterke gemeenschappelijke factor in idiosyncratische volatiliteit die met het inkomensrisico van huishoudens samenhangt, en aandelen met de laagste bèta op die factor verdienen 5,4% per jaar meer dan die met de hoogste.
5Simulatie: drie parameters tegen vijfhonderd gemiddelden
Hoe lang moet de steekproef zijn voordat drie kleine premies de parametrische regel van 1/N laten winnen? En hoe slecht doet Markowitz het met 500 geschatte gemiddelden? We simuleren een wereld met 500 aandelen en drie kenmerken, size, value en momentum, die per aandeel een AR(1) volgen en in de cross-sectie standaardnormaal zijn. Het overrendement is
| parameter | waarde |
|---|---|
| aantal aandelen | 500 |
| persistentie van size, value en momentum | 0,99; 0,97; 0,90 per maand |
| premie per standaarddeviatie kenmerk | −0,03%; 0,03%; 0,03% per maand |
| marktfactor | gemiddeld 0,5%, volatiliteit 4,5% per maand |
| bèta’s | normaal, gemiddelde 1, standaarddeviatie 0,3 |
| idiosyncratische ruis | 12% per maand |
| beleggingsperiode na de schatting | 240 maanden |
| relatieve risicoaversie | 5, zoals in het toy-voorbeeld |
De premies zijn klein, want één standaarddeviatie in een kenmerk is 0,36% per jaar waard tegen 42% idiosyncratische volatiliteit per jaar. Een belegger schat op maanden en belegt daarna met 1/N, dat in deze wereld de rol van de markt speelt, met de parametrische regel of met mean-variance op de 500 steekproefgemiddelden.
Omdat de steekproefcovariantie bij niet inverteerbaar is, gebruikt Markowitz een geschat éénfactormodel, , met de factorvariantie , de bèta’s en de restvarianties . De inverse van zo’n matrix staat met de Woodbury-formule in gesloten vorm op papier, zodat de cel geen -matrix hoeft te inverteren. De cel zet het model op en simuleert 80 werelden voor vensters van 120 en 240 maanden.
N_STOCKS, K_CHAR, RF_M, T_TEST, GAMMA = 500, 3, 0.003, 240, 5.0
LAMBDA = np.array([-0.0003, 0.0003, 0.0003])
RHO_X = np.array([0.99, 0.97, 0.90])
SIG_EPS, MU_F, SIG_F = 0.12, 0.005, 0.045

def simulate_stocks(n_months):
    """Persistent characteristics X[t] and excess returns R[t] earned over month t+1."""
    x0 = rng.standard_normal((N_STOCKS, K_CHAR))
    noise = rng.standard_normal((n_months, N_STOCKS, K_CHAR))
    X = np.empty_like(noise)
    for k in range(K_CHAR):  # AR(1): X[t] = rho X[t-1] + sqrt(1 - rho^2) noise[t], started from x0
        X[:, :, k] = signal.lfilter([np.sqrt(1 - RHO_X[k] ** 2)], [1, -RHO_X[k]], noise[:, :, k],
                                    axis=0, zi=RHO_X[k] * x0[None, :, k])[0]
    beta = 1 + 0.3 * rng.standard_normal(N_STOCKS)
    f = MU_F + SIG_F * rng.standard_normal(n_months)
    R = np.outer(f, beta) + X @ LAMBDA + SIG_EPS * rng.standard_normal((n_months, N_STOCKS))
    return X, R

def fit_theta(rbar, rx, gamma=GAMMA):
    """Maximise average CRRA utility of rbar + rx @ theta (gross returns) over theta."""
    def neg_utility(theta):
        Rp = rbar + rx @ theta
        return 1e6 if np.any(Rp <= 0) else -np.mean(Rp ** (1 - gamma)) / (1 - gamma)

    def gradient(theta):
        Rp = np.maximum(rbar + rx @ theta, 1e-6)
        return -(Rp ** (-gamma)) @ rx / len(Rp)

    return optimize.minimize(neg_utility, np.zeros(rx.shape[1]), jac=gradient, method="BFGS").x

def sharpe_ce(excess, rf=RF_M, gamma=GAMMA):
    """Annualised Sharpe ratio and CRRA certainty-equivalent excess return."""
    Rp = np.maximum(1 + rf + excess, 1e-4)
    ce = np.mean(Rp ** (1 - gamma)) ** (1 / (1 - gamma)) - 1 - rf
    return np.sqrt(12) * excess.mean() / excess.std(), 12 * ce

def one_world(T):
    """Estimate on T months, evaluate the next T_TEST months."""
    X, R = simulate_stocks(T + T_TEST)
    Xs = (X - X.mean(axis=1, keepdims=True)) / X.std(axis=1, keepdims=True)
    rx = np.einsum("tnk,tn->tk", Xs, R) / N_STOCKS
    bench = R.mean(axis=1)
    theta = fit_theta(1 + RF_M + bench[:T], rx[:T])

    train = R[:T]
    m_hat, fm = train.mean(axis=0), bench[:T] - bench[:T].mean()
    b = (train - m_hat).T @ fm / (fm @ fm)
    s2, vf = (train - m_hat - np.outer(fm, b)).var(axis=0), fm.var()
    Dm, Db = m_hat / s2, b / s2                       # Woodbury inverse of vf*bb' + diag(s2)
    w_mv = (Dm - Db * (b @ Dm) * vf / (1 + vf * (b @ Db))) / GAMMA
    return [*sharpe_ce(bench[T:]), *sharpe_ce(bench[T:] + rx[T:] @ theta),
            *sharpe_ce(R[T:] @ w_mv), *theta]

COLUMNS = ["SR 1/N", "CE 1/N", "SR BSV", "CE BSV", "SR MV", "CE MV", "theta size", "theta waarde", "theta mom"]
N_WORLDS = 80
sim_rows = [[T, *one_world(T)] for T in (120, 240) for _ in range(N_WORLDS)]
De tweede cel voegt vensters van 360 en 600 maanden toe. Per venster staan in de tabel de mediaan van Sharpe-ratio (SR) en certainty equivalent (CE), de kans dat de regel 1/N verslaat en de spreiding van voor size.
sim_rows += [[T, *one_world(T)] for T in (360, 600) for _ in range(N_WORLDS)]
sim = pd.DataFrame(sim_rows, columns=["T", *COLUMNS])
summary = sim.groupby("T").median()[COLUMNS[:6]]
summary["P(SR BSV > SR 1/N)"] = sim.assign(w=sim["SR BSV"] > sim["SR 1/N"]).groupby("T")["w"].mean()
summary["SD theta size"] = sim.groupby("T")["theta size"].std()
summary.round(3)Mean-variance op 500 gemiddelden is kansloos. De mediane Sharpe-ratio blijft tussen 0,09 en 0,15, en het certainty equivalent zakt ver onder nul, omdat de CRRA-belegger in vrijwel elke wereld ergens zijn vermogen verliest. Dat is het probleem van Markowitz, Roy en Tobin op grote schaal, met tussen 0,8 en 4.
De figuur toont links hoe ver de parametrische regel van 1/N wegloopt, en rechts hoe de verdeling van voor size smaller wordt als het venster groeit.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
for col, label, colour in [("SR 1/N", "1/N", hap.plotting.COLORS[3]),
                           ("SR BSV", "parametrisch (K = 3)", hap.plotting.COLORS[0]),
                           ("SR MV", "mean-variance (N = 500)", hap.plotting.COLORS[1])]:
    q = sim.groupby("T")[col].quantile([0.25, 0.5, 0.75]).unstack()
    axes[0].plot(q.index, q[0.5], marker="o", color=colour, label=label)
    axes[0].fill_between(q.index, q[0.25], q[0.75], color=colour, alpha=0.15)
axes[0].set_xlabel("Schattingsvenster T (maanden)")
axes[0].set_ylabel("Sharpe-ratio buiten de steekproef (per jaar)")
axes[0].set_title("(a) Sharpe-ratio over 240 maanden erna")
axes[0].legend()
for T, colour in zip((120, 600), (hap.plotting.COLORS[5], hap.plotting.COLORS[0])):
    axes[1].hist(sim.loc[sim["T"] == T, "theta size"], bins=20, alpha=0.55, color=colour, label=f"T = {T}")
axes[1].set_xlabel("Geschatte theta voor size")
axes[1].set_ylabel("Aantal gesimuleerde werelden")
axes[1].set_title("(b) Verdeling van de schatter")
axes[1].legend()
fig.tight_layout()
plt.show()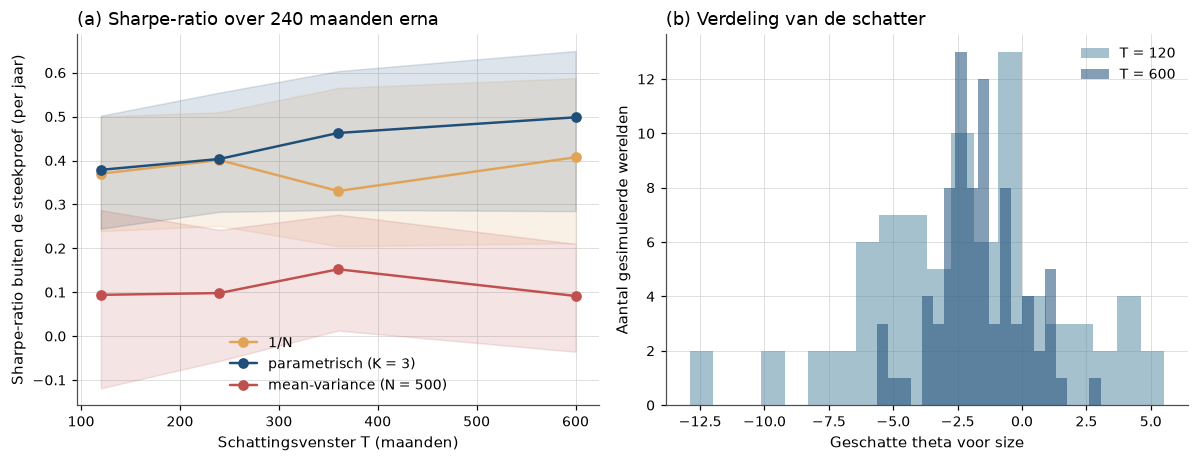
Figure 1:Links de mediaan en de interkwartielafstand van de Sharpe-ratio buiten de steekproef, over 80 werelden per venster. De parametrische regel loopt pas van 1/N weg als het venster lang genoeg is om drie kleine premies te zien. Rechts de schatter van voor size, waarvan de verdeling bij tien jaar data ruim aan beide kanten van nul ligt en bij vijftig jaar veel smaller is.
De parametrische regel wint niet vanzelf. Bij tien jaar data verslaat hij 1/N in iets meer dan de helft van de werelden, en zijn certainty equivalent is lager. De standaarddeviatie van is dan nog 3,7, en bij vijftig jaar is die gezakt tot 1,7 en verslaat de regel 1/N in beide maten. De regel verslaat de markt van deze wereld dus, zoals de intuïtie verwachtte, maar pas bij een steekproef die langer is dan de meeste beleggers hebben.
6Replicatie op echte data
De eerste cel laadt beide sets portefeuilles en zet ze om in een paneel met gestandaardiseerde kenmerken, marktgewichten en het rendement van de maand erna.
rf_monthly = hap_data.market_monthly()["RF"]

def load_size_bm():
    """100 size/BM portfolios: returns, total market cap and three characteristics."""
    R = hap_data.french("100_Portfolios_10x10")
    firms = hap_data.french("100_Portfolios_10x10", table=4)
    avg_cap = hap_data.french("100_Portfolios_10x10", table=5)
    bm = hap_data.french("100_Portfolios_10x10", table=6, percent=False)
    chars = {"log ME": np.log(avg_cap.where(avg_cap > 0)),
             "log B/M": np.log(bm.where(bm > 0)),
             "momentum": np.log1p(R).shift(1).rolling(11).sum()}
    return R, firms * avg_cap, chars

def load_size_momentum():
    """25 size/momentum portfolios: returns, total market cap and two characteristics."""
    R = hap_data.french("25_Portfolios_ME_Prior_12_2")
    firms = hap_data.french("25_Portfolios_ME_Prior_12_2", table=4)
    avg_cap = hap_data.french("25_Portfolios_ME_Prior_12_2", table=5)
    prior = hap_data.french("25_Portfolios_ME_Prior_12_2", table=7)
    return R, firms * avg_cap, {"log ME": np.log(avg_cap.where(avg_cap > 0)), "momentum": prior}

def characteristic_panel(R, size, chars, min_assets=10):
    """Month-t characteristics and weights with month-(t+1) returns, standardised per month."""
    nxt = R.shift(-1)
    valid = nxt.notna() & (size > 0)
    for c in chars.values():
        valid &= c.notna()
    n_t = valid.sum(axis=1).to_numpy()
    keep = (n_t >= min_assets) & rf_monthly.reindex(R.index).shift(-1).notna().to_numpy()
    mask = valid.to_numpy()[keep]
    n = n_t[keep].astype(float)

    Z = np.stack([c.to_numpy()[keep] for c in chars.values()], axis=-1)
    Z = np.where(mask[..., None], Z, 0.0)
    mean = Z.sum(axis=1) / n[:, None]
    sd = np.sqrt((np.where(mask[..., None], Z - mean[:, None, :], 0.0) ** 2).sum(axis=1) / (n[:, None] - 1))
    Xs = np.where(mask[..., None], (Z - mean[:, None, :]) / sd[:, None, :], 0.0)

    cap = np.where(mask, size.to_numpy()[keep], 0.0)
    r = np.where(mask, nxt.to_numpy()[keep], 0.0)
    return {"date": pd.DatetimeIndex(R.index.to_series().shift(-1).to_numpy()[keep]),
            "X": Xs, "wbar": cap / cap.sum(axis=1, keepdims=True), "r": r, "n": n,
            "rf": rf_monthly.reindex(R.index).shift(-1).to_numpy()[keep], "names": list(chars)}

def policy_returns(panel):
    """Gross benchmark return and the K characteristic-portfolio returns (eq. rp)."""
    rbar = 1 + (panel["wbar"] * panel["r"]).sum(axis=1)
    rx = np.einsum("tnk,tn->tk", panel["X"], panel["r"]) / panel["n"][:, None]
    return rbar, rx

size_bm = characteristic_panel(*load_size_bm())
size_mom = characteristic_panel(*load_size_momentum())
{name: (p["date"][0].strftime("%Y-%m"), p["date"][-1].strftime("%Y-%m"), round(p["n"].mean(), 1))
 for name, p in [("100 size/BM", size_bm), ("25 size/momentum", size_mom)]}
{'100 size/BM': ('1927-07', '2026-07', np.float64(98.1)),
'25 size/momentum': ('1927-02', '2026-07', np.float64(25.0))}De functie characteristic_panel standaardiseert elk kenmerk per maand over de
portefeuilles die in die maand bestaan, zoals (6) vraagt. Omdat
niet elke size/BM-combinatie elke maand aandelen bevat, zijn gemiddeld 98 van de 100
size/BM-portefeuilles per maand bruikbaar, en de 25 size-momentumportefeuilles zijn altijd
compleet. Daarna
schatten we op 1964–2002, met standaardfouten uit (10).
def theta_standard_errors(theta, rbar, rx, gamma=GAMMA):
    """Sandwich standard errors G^-1 V G^-1 / T from the proposition."""
    Rp = rbar + rx @ theta
    h = (Rp ** (-gamma))[:, None] * rx
    G = np.einsum("t,tk,tl->kl", -gamma * Rp ** (-gamma - 1), rx, rx) / len(Rp)
    V = h.T @ h / len(Rp)
    G_inv = np.linalg.inv(G)
    return np.sqrt(np.diag(G_inv @ V @ G_inv.T / len(Rp)))

def month_end(month):
    """'2002-12' -> Timestamp('2002-12-31'), so that end months are inclusive."""
    return pd.Timestamp(month) + pd.offsets.MonthEnd(0)

def subset(panel, start, end):
    idx = (panel["date"] >= pd.Timestamp(start)) & (panel["date"] <= month_end(end))
    return {k: (v[idx] if isinstance(v, (np.ndarray, pd.DatetimeIndex)) else v) for k, v in panel.items()}

IN_START, IN_END = "1964-01", "2002-12"
theta_rows = {}
for name, panel in [("100 size/BM", size_bm), ("25 size/momentum", size_mom)]:
    ins = subset(panel, IN_START, IN_END)
    rbar, rx = policy_returns(ins)
    theta = fit_theta(rbar, rx)
    se = theta_standard_errors(theta, rbar, rx)
    for k, char in enumerate(panel["names"]):
        theta_rows[(name, char)] = {"theta": theta[k], "standaardfout": se[k], "t": theta[k] / se[k]}
theta_table = pd.DataFrame(theta_rows).T
theta_table.round(3)De tekens zijn die van het artikel. Size ligt dicht bij de gepubliceerde waarde, momentum ongeveer een halve standaardfout erboven en B/M 1,6 standaardfout erboven. Size is na 39 jaar data met niet op 5% significant, wat de simulatie al liet verwachten, en op de size-momentumportefeuilles verdwijnt size terwijl momentum blijft.
Vervolgens evalueren we de regel, de long-only-versie en de benchmark over 1974–2002, de periode waarover het artikel rapporteert.
def weights(panel, theta):
    return panel["wbar"] + np.einsum("tnk,k->tn", panel["X"], theta) / panel["n"][:, None]

def long_only(W):
    W = np.maximum(W, 0.0)
    return W / W.sum(axis=1, keepdims=True)

def fit_theta_long_only(panel, start_theta, gamma=GAMMA):
    """Re-estimate theta with truncated weights (non-smooth, so Nelder-Mead)."""
    def neg_utility(theta):
        Rp = 1 + (long_only(weights(panel, theta)) * panel["r"]).sum(axis=1)
        return -np.mean(Rp ** (1 - gamma)) / (1 - gamma)
    return optimize.minimize(neg_utility, start_theta, method="Nelder-Mead",
                             options={"xatol": 1e-3, "fatol": 1e-8, "maxiter": 2000}).x

def turnover(W, r):
    """Average sum |w_{t+1} - drifted w_t| per month."""
    grown = W[:-1] * (1 + r[:-1])
    drift = grown / grown.sum(axis=1, keepdims=True)
    return np.abs(W[1:] - drift).sum(axis=1).mean()

def evaluate(gross, rf, gamma=GAMMA):
    excess = gross - 1 - rf
    ce = np.mean(gross ** (1 - gamma)) ** (1 / (1 - gamma)) - 1
    return {"gem. overrendement (% p.j.)": 1200 * excess.mean(), "vol (% p.j.)": 100 * np.sqrt(12) * excess.std(ddof=1),
            "Sharpe (p.j.)": np.sqrt(12) * excess.mean() / excess.std(ddof=1),
            "CE (% p.j.)": 1200 * ce, "SE Sharpe": np.sqrt(12 / len(gross))}

ins = subset(size_bm, IN_START, IN_END)
rbar_in, rx_in = policy_returns(ins)
theta_in = theta_table.loc["100 size/BM", "theta"].to_numpy()
theta_lo = fit_theta_long_only(ins, theta_in)

REPORT_START = "1974-01"                      # BSV report their statistics for 1974-2002
rep = subset(size_bm, REPORT_START, IN_END)
rbar_rep, rx_rep = policy_returns(rep)
W_rep, W_lo_rep = weights(rep, theta_in), long_only(weights(rep, theta_lo))

def weight_stats(W, r):
    return {"som negatieve w": np.minimum(W, 0).sum(axis=1).mean(), "fractie w < 0": (W < 0).mean(),
            "omzet (p.j.)": 12 * turnover(W, r)}

in_sample = pd.DataFrame({
    "VW-benchmark": {**evaluate(rbar_rep, rep["rf"]), **weight_stats(rep["wbar"], rep["r"])},
    "parametrisch": {**evaluate(rbar_rep + rx_rep @ theta_in, rep["rf"]), **weight_stats(W_rep, rep["r"])},
    "parametrisch, long-only": {**evaluate(1 + (W_lo_rep * rep["r"]).sum(axis=1), rep["rf"]),
                                **weight_stats(W_lo_rep, rep["r"])},
}).T
print("theta long-only (1964-2002):", theta_lo.round(3))
in_sample.round(3)
theta long-only (1964-2002): [ 2.381 19.243 5.306]
De regel haalt in de steekproef bijna drie keer de Sharpe-ratio van de benchmark. De positie is wel extreem, met gemiddeld 180% van het vermogen short en een omzet van negen keer het vermogen per jaar. Die omzet komt uit de momentumterm, omdat het momentum van een portefeuille elke maand verschuift terwijl size en B/M nauwelijks bewegen.
De long-only-versie haalt het grootste deel van de omzet weg. De schatting van die versie
uit de print is en lijkt niet op die van de
lineaire regel, want size wisselt van teken en B/M is bijna vier keer zo groot. Toch liggen
Sharpe-ratio en certainty equivalent dicht bij het artikel, omdat afkappen en normaliseren
de schaal van niet meer vastleggen.
Buiten de steekproef herschatten we elk januari op alle data vanaf 1964 en beleggen we het jaar erna met die schatting. De cel toont de schattingen in vijf jaren.
def expanding_oos(panel, start="1974-01", long_only_too=False):
    """Re-estimate theta every January on all data from IN_START until then; return OOS gross returns."""
    rbar, rx = policy_returns(panel)
    out = subset(panel, start, "2100-12")
    years = sorted(set(out["date"].year))
    gross, gross_lo, path = [], [], {}
    for year in years:
        past = (panel["date"] >= pd.Timestamp(IN_START)) & (panel["date"] < pd.Timestamp(f"{year}-01-01"))
        now = panel["date"].year == year
        theta = fit_theta(rbar[past], rx[past])
        path[year] = theta
        gross.append(rbar[now] + rx[now] @ theta)
        if long_only_too:
            sub_past, sub_now = subset(panel, IN_START, f"{year - 1}-12"), subset(panel, f"{year}-01", f"{year}-12")
            th_lo = fit_theta_long_only(sub_past, theta)
            gross_lo.append(1 + (long_only(weights(sub_now, th_lo)) * sub_now["r"]).sum(axis=1))
    result = {"date": out["date"], "policy": np.concatenate(gross), "bench": rbar[panel["date"] >= pd.Timestamp(start)],
              "rf": out["rf"], "theta": pd.DataFrame(path, index=panel["names"]).T}
    if long_only_too:
        result["long_only"] = np.concatenate(gross_lo)
    return result

oos_bm = expanding_oos(size_bm, long_only_too=True)
oos_bm["theta"].iloc[[0, 8, 16, 29, -1]].round(2)Tot 2003 houden de drie coëfficiënten hun teken en blijft size ongeveer gelijk, terwijl B/M eerst stijgt en momentum wat zakt. Daarna kruipt size naar nul en zakt B/M. De volgende cel vat de prestaties buiten de steekproef samen, apart voor 1974–2002 en voor de jaren na het artikel.
oos_mom = expanding_oos(size_mom)
oos_parts = {}
for label, (s, e) in {"1974-2002": ("1974-01", "2002-12"), "2003-eind": ("2003-01", "2100-12")}.items():
    for name, res, series in [("100 size/BM", oos_bm, ["bench", "policy", "long_only"]),
                              ("25 size/momentum", oos_mom, ["bench", "policy"])]:
        idx = (res["date"] >= pd.Timestamp(s)) & (res["date"] <= month_end(e))
        for key in series:
            oos_parts[(label, name, {"bench": "VW-benchmark", "policy": "parametrisch",
                                     "long_only": "parametrisch, long-only"}[key])] = evaluate(res[key][idx], res["rf"][idx])
print(f"buiten de steekproef: {oos_bm['date'][0]:%Y-%m} t/m {oos_bm['date'][-1]:%Y-%m}, {len(oos_bm['date'])} maanden")
pd.DataFrame(oos_parts).T.round(3)
buiten de steekproef: 1974-01 t/m 2026-07, 631 maanden
Over 1974–2002 verslaat de regel ook buiten de steekproef de benchmark ruim, op beide sets portefeuilles, maar na 2002 blijft hij overal achter. Links in de figuur is de knik bij 2003 in de lijn van de regel te zien, rechts de lijn van size, die daarna naar nul kruipt.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
wealth = pd.DataFrame({key: np.log(oos_bm[col]).cumsum() for key, col in
                       [("VW-benchmark", "bench"), ("parametrisch", "policy"), ("parametrisch, long-only", "long_only")]},
                      index=oos_bm["date"])
wealth.plot(ax=axes[0], color=[hap.plotting.COLORS[3], hap.plotting.COLORS[0], hap.plotting.COLORS[2]])
axes[0].axvline(pd.Timestamp("2003-01-01"), color="black", lw=0.8, ls="--")
axes[0].set_xlabel("Jaar")
axes[0].set_ylabel("Cumulatief log brutorendement")
axes[0].set_title("(a) Buiten de steekproef vanaf 1974, 100 size/BM")
oos_bm["theta"].plot(ax=axes[1], marker=".")
axes[1].axhline(0, color="black", lw=0.8)
axes[1].set_xlabel("Jaar van belegging (theta geschat op alle eerdere data)")
axes[1].set_ylabel("Geschatte theta")
axes[1].set_title("(b) Jaarlijks herschatte theta, 100 size/BM")
fig.tight_layout()
plt.show()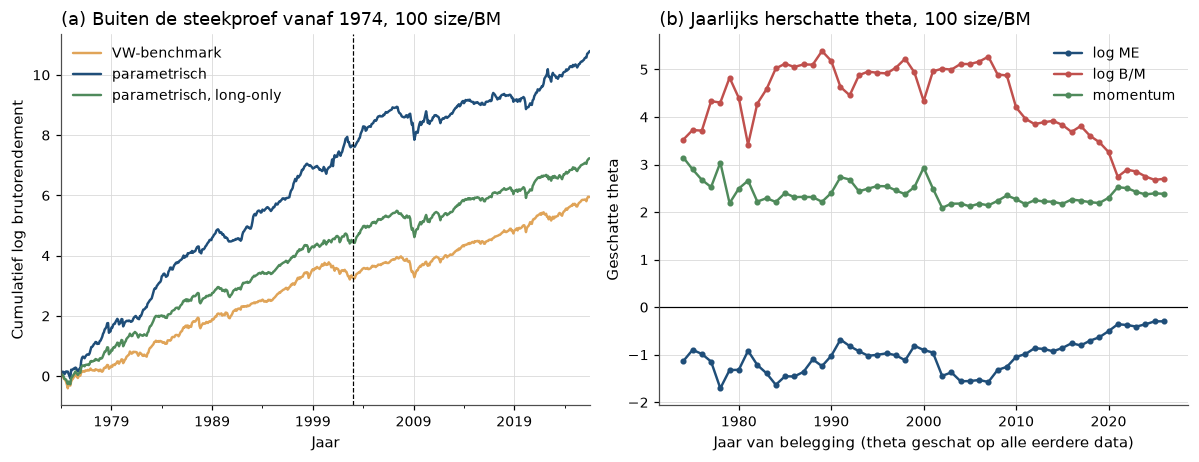
Figure 2:Links het cumulatieve log brutorendement vanaf 1974 van de benchmark, de parametrische regel en de long-only-versie. Tot 2003 (stippellijn) loopt de regel duidelijk weg, daarna niet meer. Rechts de jaarlijks herschatte . In de vijf jaren die de cel erboven toont, ligt size tot 2003 tussen −1,0 en −1,4 en in 2026 op −0,30. B/M stijgt van 3,5 tot 5,2 en zakt daarna tot 2,7, terwijl momentum tussen 2,2 en 3,2 blijft.
De tabel zet over 1974–2002 de belangrijkste getallen uit tabel 1 en 3 van het artikel naast die uit de cellen hierboven.
| grootheid | origineel | hier |
|---|---|---|
| (standaardfout) | −1,451 (0,548) | −1,37 (0,76) |
| (standaardfout) | 3,606 (0,921) | 5,00 (0,86) |
| (standaardfout) | 1,772 (0,743) | 2,18 (0,75) |
| Sharpe-ratio regel / benchmark, in de steekproef | 1,048 / 0,438 | 1,11 / 0,39 |
| certainty equivalent regel / benchmark (% per jaar) | 17,5 / 6,4 | 19,0 / 5,7 |
| gemiddelde som van negatieve gewichten | −128% | −180% |
| fractie negatieve gewichten | 47% | 39% |
| omzet per jaar | 0,99 | 9,0 (long-only 1,37) |
| long-only: Sharpe-ratio / certainty equivalent (%) | 0,690 / 10,3 | 0,68 / 10,0 |
| buiten de steekproef: Sharpe-ratio / certainty equivalent (%) | 0,941 / 11,8 | 1,02 / 16,3 |
| 2003–2026: Sharpe-ratio regel / benchmark | – | 0,62 / 0,72 |
| 2003–2026: certainty equivalent regel / benchmark (%) | – | 0,9 / 6,6 |
| 2003–2026: overrendement / volatiliteit regel (%) | – | 14 / 23 |
| 2003–2026: long-only, Sharpe-ratio / CE (%) | – | 0,64 / 4,3 |
| 2003–2026: 25 size/momentum, Sharpe-ratio regel / benchmark | – | 0,65 / 0,74 |
Gedeeltelijk geslaagd. De tekens en de orde van grootte van kloppen, en ook verslaat de regel de benchmark in en buiten de steekproef over 1974–2002. De posities en vooral de omzet wijken af, omdat portefeuilles andere kenmerken hebben dan aandelen.
Na 2002, buiten elke steekproef die het artikel kon zien, verslaat de benchmark juist de regel, en dat geldt ook voor de long-only-versie en de size-momentumregel. Het certainty equivalent van de regel zakt het diepst, omdat hij veel meer volatiliteit neemt voor een iets hoger overrendement. Met een standaardfout van ongeveer 0,21 is geen van die verschillen van nul te onderscheiden, maar de richting is overal dezelfde, zodat het verwachte kleine voordeel een klein nadeel werd.
6.1Gemiddelde variantie en het marktrendement
We berekenen de maandvariantie uit gekwadrateerde dagrendementen en schatten de drie regressies uit het artikel over drie perioden.
industries_daily = hap_data.french("49_Industry_Portfolios", "daily")
market_daily = hap_data.market_daily()["Mkt"]

def monthly_realised_variance(daily):
    """Sum of squared daily returns per calendar month (at least 15 trading days)."""
    month = daily.index.to_period("M")
    variance = (daily**2).groupby(month).sum(min_count=15)
    return variance.set_axis(variance.index.to_timestamp(how="end").normalize())

ind_var = monthly_realised_variance(industries_daily)
ew_index = industries_daily.mean(axis=1)
deviation = monthly_realised_variance(industries_daily.sub(ew_index, axis=0)).mean(axis=1)
gsc = pd.DataFrame({
    "V": ind_var.mean(axis=1),
    "markt": monthly_realised_variance(market_daily),
    "EW-index": monthly_realised_variance(ew_index),
    "afwijking": deviation,
})
gsc["R_e volgende maand"] = hap_data.market_monthly()["Mkt-RF"].shift(-1).reindex(gsc.index)
gsc = gsc.dropna()

periods = {"1963-08 t/m 1999-12": ("1963-08", "1999-12"), "1963-08 t/m 2025-12": ("1963-08", "2025-12"),
           "2000-01 t/m 2025-12": ("2000-01", "2025-12")}
rows = {}
for label, (s, e) in periods.items():
    d = gsc.loc[s:e]
    for spec in (["V"], ["markt"], ["V", "markt"]):
        fit = hap.stats.newey_west(d["R_e volgende maand"], d[spec])
        rows[(label, " + ".join(spec))] = {
            "b (V)": fit.params.get("V", np.nan), "t (V)": fit.tvalues.get("V", np.nan),
            "c (markt)": fit.params.get("markt", np.nan), "t (markt)": fit.tvalues.get("markt", np.nan),
            "R2 (%)": 100 * fit.rsquared, "maanden": int(fit.nobs)}
pd.DataFrame(rows).T.round(3)In geen van de drie perioden is een helling significant, en over de hele steekproef en over 2000–2025 blijven alle -waarden in absolute waarde onder één. De volgende cel meet hoeveel van uit de afwijkingsterm komt en hoe persistent is.
d = gsc.loc["1963-08":"2025-12"]
log_v = np.log(d["V"])
share = (d["afwijking"] / d["V"])
pd.Series({
    "gem. aandeel afwijkingsterm in V, 1963-1999": share.loc[:"1999-12"].mean(),
    "gem. aandeel afwijkingsterm in V, 2000-2025": share.loc["2000-01":].mean(),
    "AR(1) van log V": log_v.autocorr(),
    "SD innovatie log V": (log_v - log_v.autocorr() * log_v.shift(1)).std(),
    "corr(R_e,t , innovatie log V_t)": hap_data.market_monthly()["Mkt-RF"].reindex(d.index).corr(log_v.diff()),
}).round(3)
gem. aandeel afwijkingsterm in V, 1963-1999 0.589
gem. aandeel afwijkingsterm in V, 2000-2025 0.546
AR(1) van log V 0.741
SD innovatie log V 0.468
corr(R_e,t , innovatie log V_t) -0.309
dtype: float64De afwijkingsterm is over 1963–1999 gemiddeld 59% van , en heeft een autocorrelatie van 0,74 met schokken die negatief met het marktrendement samenhangen. De figuur laat zien hoe dicht de drie reeksen bij elkaar liggen.
Source
fig, ax = plt.subplots()
annual = lambda s: np.sqrt(12 * s.rolling(12).mean()) * 100
ax.plot(gsc.index, annual(gsc["V"]), label="gemiddelde variantie, 49 industrieën")
ax.plot(gsc.index, annual(gsc["markt"]), label="marktvariantie", color=hap.plotting.COLORS[1])
ax.plot(gsc.index, annual(gsc["afwijking"]), label="afwijkingsterm (industrie-specifiek)", color=hap.plotting.COLORS[2])
hap.plotting.timeline_axis(ax)
hap.plotting.recession_shading(ax)
ax.set_xlabel("Jaar")
ax.set_ylabel("Volatiliteit (% per jaar, 12-maands gemiddelde)")
ax.set_title("Gemiddelde, markt- en industrie-specifieke variantie")
ax.legend()
plt.show()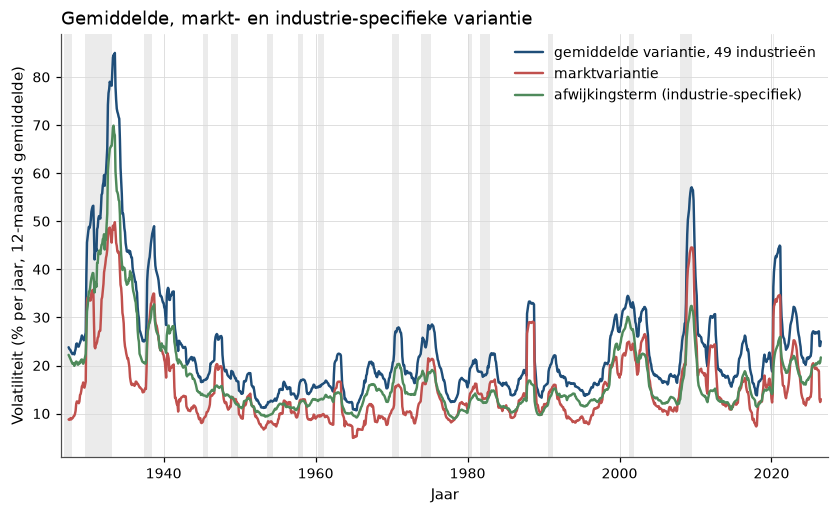
Figure 3:Volatiliteit op jaarbasis, als twaalfmaands voortschrijdend gemiddelde van de maandvariantie uit dagrendementen, met NBER-recessies in grijs. De gemiddelde variantie van de 49 industrieën ligt steeds boven die van de markt, en de afwijkingsterm is het industriespecifieke deel uit (15). De drie reeksen bewegen grotendeels samen, zodat het idiosyncratische deel bij industrieportefeuilles voor een groot deel een schaduw van het marktrisico is.
De tabel zet de regressies over 1963–1999 naast die uit tabel II van het artikel, met de helling en tussen haakjes de -waarde. In de laatste regel komt het idiosyncratische deel bij Goyal en Santa-Clara uit een kalibratie en bij ons uit de afwijkingsterm.
| regressie | origineel | hier |
|---|---|---|
| alleen | 0,336 (2,57) | −0,25 (−0,33) |
| alleen marktvariantie | −0,597 (−1,07) | −0,46 (−0,52) |
| samen, helling op | 0,478 (3,86) | 1,39 (0,52) |
| samen, helling op marktvariantie | −1,449 (−2,70) | −2,16 (−0,63) |
| idiosyncratisch deel van | bijna 85% | 59% |
Niet geslaagd, en dat hadden we vooraf ook verwacht. Met industrieportefeuilles is van het resultaat niets over, al hebben de hellingen in de gezamenlijke regressie wel de tekens uit het artikel. Dat bewijst weinig in beide richtingen, want het ging Goyal en Santa-Clara om bedrijfsspecifieke variantie, en die hebben wij grotendeels weggemiddeld. De replicatie laat wel zien dat de gemiddelde variantie van industrieën het marktrendement niet voorspelt, en oefening 4 laat zien hoe gemakkelijk dezelfde data met overlappende horizonnen toch “significant” worden.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. De parametrische regel is geen evenwichtstheorie maar een beslisregel, en juist daarin slaagt hij waar Markowitz faalde. Hij zet een handvol feiten om in gewichten zonder dat de schattingsfout van duizenden gemiddelden de portefeuille overneemt. Op honderd portefeuilles gaf hij de tekens en de orde van grootte van de coëfficiënten uit het artikel, en tot 2002 ook buiten de steekproef een ruime voorsprong op de markt. Santa-Clara vindt de regel dichter bij wat kwantitatieve vermogensbeheerders werkelijk doen dan enig model uit de literatuur Santa-Clara (2026).
Waar het breekt. Een parametrische regel is zo goed als de premies die hij uitbuit, en die zijn slecht gemeten en niet stabiel. Na 2002 blijft de regel op beide sets portefeuilles achter bij de benchmark. Het tweede spoor brak harder, want het resultaat van Goyal en Santa-Clara hield in latere steekproeven geen stand, en op onze industriedata is er zelfs in hun eigen periode niets van te zien.
Risico of vergissing? Beide feiten laten beide lezingen toe. In de Chicago-lezing belonen size, value en momentum risico’s die het CAPM mist, en is de krimp na 2002 pech of een lagere prijs van risico. In de Yale-lezing meten de kenmerken vergissingen, en kochten arbitrageurs de premie na publicatie weg. Bij idiosyncratische volatiliteit eisen onvolledig gediversifieerde huishoudens een premie, of worden volatiele aandelen als loten overgewaardeerd. Scheiden kan alleen door te meten of de rendementen samenhangen met het marginale nut in slechte tijden, en dat lukt met portefeuilledata niet. Zo blijft open of een belegger met zo’n regel risico met een premie draagt, of alleen denkt iets te weten wat de prijs niet weet.
Wat er daarna kwam. In 2008 bleek dat de hefboom waarmee zulke strategieën worden uitgevoerd, van intermediairs komt. Hun balans is zelf een factor met een risicopremie, en dat is het onderwerp van 2008 en intermediary asset pricing.
8Oefeningen
Solution to Exercise 1
(1) De lage toestand verandert niet, dus . In de hoge toestand is en .
(2) Omdat , is het gemiddelde en het halve verschil van de twee posities, dus en . De code lost het statische probleem wel op en vindt hetzelfde.
mu_weak = np.array([0.02, 0.06])
s_weak = 0.04 + mu_weak**2
w_weak = mu_weak / (gamma * s_weak)
theta_weak = np.linalg.solve((payoff.T * (prob * s_weak)) @ payoff, (prob * mu_weak) @ payoff) / gamma
pd.DataFrame({"met de hand": [0.09901, 0.27523, 0.18712, 0.08811], "code": [*w_weak, *theta_weak]},
index=["w laag", "w hoog", "theta0", "theta1"]).round(5)Van 0,15050 naar 0,08811 is de coëfficiënt op het managed activum ruim gehalveerd. Het gewicht op een voorspeller schaalt dus mee met hoeveel die voorspeller over het verwachte rendement zegt.
Solution to Exercise 2
(1) Er geldt en . De afgeleide naar is , en die nul stellen geeft (12).
(2) Nu is en . De afgeleide naar is , en die nul stellen geeft de oplossing. Met is de benchmark de risicovrije rente, in overrendementen nul, en valt de middelste term weg.
(3) De cel berekent beide schattingen op dezelfde data.
Sigma_x = np.cov(rx_in, rowvar=False)
cov_bench = np.array([np.cov(rx_in[:, k], rbar_in)[0, 1] for k in range(rx_in.shape[1])])
theta_mv = np.linalg.solve(Sigma_x, rx_in.mean(axis=0) / GAMMA - cov_bench)
pd.DataFrame({"CRRA": theta_in, "mean-variance": theta_mv}, index=size_bm["names"]).round(3)De mean-variance-benadering geeft tegen met CRRA-nut, dus dezelfde tekens en orde van grootte. Het verschil komt uit de hogere momenten die CRRA-nut wel ziet. De kenmerkportefeuilles zijn scheef en hebben dikke staarten, en een belegger met straft een linkerstaart zwaarder af dan de variantie doet. Momentum kent de forse crashes uit Jegadeesh-Titman, Carhart en momentum crashes en krijgt daarom bij CRRA een kleiner gewicht. In de kern is de parametrische regel dus een Markowitz-probleem in drie activa, met een correctie voor staartrisico.
Solution to Exercise 3
De cel berekent de omzet, trekt de kosten af en zoekt het kostenniveau waarbij de voorsprong in Sharpe-ratio verdwijnt.
def turnover_series(W, r):
    grown = W[:-1] * (1 + r[:-1])
    return np.r_[0.0, np.abs(W[1:] - grown / grown.sum(axis=1, keepdims=True)).sum(axis=1)]

def net_of_costs(panel, theta, cost):
    W = weights(panel, theta)
    gross = 1 + (W * panel["r"]).sum(axis=1)
    bench = 1 + (panel["wbar"] * panel["r"]).sum(axis=1)
    return (gross - cost * turnover_series(W, panel["r"]),
            bench - cost * turnover_series(panel["wbar"], panel["r"]))

oos_panel = subset(size_bm, "1974-01", "2100-12")
theta_oos_path = oos_bm["theta"].reindex(oos_panel["date"].year).to_numpy()
W_oos = oos_panel["wbar"] + np.einsum("tnk,tk->tn", oos_panel["X"], theta_oos_path) / oos_panel["n"][:, None]
turn_policy = turnover_series(W_oos, oos_panel["r"])
turn_bench = turnover_series(oos_panel["wbar"], oos_panel["r"])

def oos_sharpe_gap(c):
    """OOS Sharpe ratio of the policy minus that of the benchmark, both net of costs c."""
    net = 1 + (W_oos * oos_panel["r"]).sum(axis=1) - c * turn_policy
    bench = 1 + (oos_panel["wbar"] * oos_panel["r"]).sum(axis=1) - c * turn_bench
    return evaluate(net, oos_panel["rf"])["Sharpe (p.j.)"] - evaluate(bench, oos_panel["rf"])["Sharpe (p.j.)"]

cost_rows = {}
for c in (0.0, 0.0025, 0.005, 0.01):
    gross_in, bench_in = net_of_costs(ins, theta_in, c)
    net_oos = 1 + (W_oos * oos_panel["r"]).sum(axis=1) - c * turnover_series(W_oos, oos_panel["r"])
    cost_rows[f"c = {100 * c:.2f}%"] = {
        "Sharpe in-sample policy": evaluate(gross_in, ins["rf"])["Sharpe (p.j.)"],
        "Sharpe in-sample benchmark": evaluate(bench_in, ins["rf"])["Sharpe (p.j.)"],
        "Sharpe OOS policy": evaluate(net_oos, oos_panel["rf"])["Sharpe (p.j.)"],
        "Sharpe OOS benchmark": evaluate(net_oos, oos_panel["rf"])["Sharpe (p.j.)"] - oos_sharpe_gap(c),
        "CE OOS policy (% p.j.)": evaluate(net_oos, oos_panel["rf"])["CE (% p.j.)"]}
print(f"gem. omzet per maand: policy {turn_policy.mean():.3f}, benchmark {turn_bench.mean():.3f}")
print(f"break-evenkosten out-of-sample: {100 * optimize.brentq(oos_sharpe_gap, 0.0, 0.05):.2f}% per eenheid omzet")
pd.DataFrame(cost_rows).T.round(3)
gem. omzet per maand: policy 0.810, benchmark 0.048
break-evenkosten out-of-sample: 0.79% per eenheid omzet
De benchmark zet gemiddeld 0,048 van het vermogen per maand om en de regel 0,81, zodat vrijwel alle omzet van de kenmerkposities komt. In de steekproef (1964–2002) blijft de regel bij elke kostenpost ruim boven de benchmark, met bij 1% per eenheid omzet nog een Sharpe-ratio van 0,67 tegen 0,29. Buiten de steekproef is de voorsprong zonder kosten 0,84 tegen 0,53, maar hij verdwijnt bij 0,79% per eenheid omzet, en bij 1% is het certainty equivalent negatief. Een schatter die kosten negeert, kiest alsof omzet gratis is, en daarom nemen Brandt, Santa-Clara en Valkanov de kosten op in het doel zelf.
Solution to Exercise 4
(1) De cel simuleert de wereld zonder voorspelbaarheid en telt de onterechte verwerpingen.
T_GSC, N_GSC = 437, 5000
PHI_V, SD_V, CORR_RV, MU_M, SD_M = 0.74, 0.50, -0.31, 0.006, 0.045
HORIZONS_GSC = (1, 3, 6, 12)

def simulate_gsc(n_samples, n_months, burn=100):
    """Unpredictable market returns and a persistent log average variance with leverage-type correlation."""
    total = burn + n_months + max(HORIZONS_GSC)
    eps = rng.standard_normal((n_samples, total))
    eta = CORR_RV * eps + np.sqrt(1 - CORR_RV**2) * rng.standard_normal((n_samples, total))
    log_v = signal.lfilter([SD_V], [1, -PHI_V], eta, axis=1)[:, burn:]
    return np.exp(log_v), (MU_M + SD_M * eps)[:, burn:]

def slope_tstats(y, x, lags):
    """Row-wise slope t-values of y on x: OLS and Newey-West with `lags` lags."""  # TODO: naar hap.stats
    xd = x - x.mean(axis=1, keepdims=True)
    sxx = (xd**2).sum(axis=1)
    beta = (xd * y).sum(axis=1) / sxx
    u = y - y.mean(axis=1, keepdims=True) - beta[:, None] * xd
    se_ols = np.sqrt((u**2).sum(axis=1) / (x.shape[1] - 2) / sxx)
    g = xd * u
    s = (g**2).sum(axis=1)
    for j in range(1, lags + 1):
        s += 2 * (1 - j / (lags + 1)) * (g[:, j:] * g[:, :-j]).sum(axis=1)
    return beta / se_ols, beta / (np.sqrt(s) / sxx)

V_sim, r_sim = simulate_gsc(N_GSC, T_GSC)
t_ols, t_nw = {}, {}
for h in HORIZONS_GSC:
    y = np.stack([r_sim[:, t + 1:t + 1 + h].sum(axis=1) for t in range(T_GSC)], axis=1)
    t_ols[h], t_nw[h] = slope_tstats(y, V_sim[:, :T_GSC], lags=h)

reject = pd.DataFrame(
    {"OLS": {h: np.mean(t_ols[h] > 1.96) for h in HORIZONS_GSC},
     "Newey-West (h lags)": {h: np.mean(t_nw[h] > 1.96) for h in HORIZONS_GSC}}
).rename_axis("horizon h (maanden)")
search = np.mean(np.max(np.stack(list(t_ols.values())), axis=0) > 1.96)
print(f"minstens één van de vier OLS-horizonnen 'significant' positief: {search:.1%}")
reject.round(3)
minstens één van de vier OLS-horizonnen 'significant' positief: 25.8%
Bij één maand verwerpt de toets in 2,8% (OLS) en 3,6% (Newey-West) van de steekproeven, dicht bij de nominale 2,5%. Met overlappende twaalfmaandsrendementen vindt 18,8% met OLS een significant positieve helling, met Newey-West nog 6,7%. Wie de beste van vier horizonnen rapporteert, vindt in 25,8% van de werelden iets.
(2) De tweede cel doet dezelfde regressies op de echte data en zet de verhouding van de -waarden naast de mediaan uit de simulatie.
d = gsc.loc["1963-08":"1999-12"]
r_next = hap_data.market_monthly()["Mkt-RF"]
overlap_rows = {}
for h in HORIZONS_GSC:
    cumulative = r_next.rolling(h).sum().shift(-h).reindex(d.index)
    frame = pd.concat([cumulative.rename("y"), d["V"]], axis=1).dropna()
    t_o, t_n = slope_tstats(frame["y"].to_numpy()[None, :], frame["V"].to_numpy()[None, :], lags=h)
    overlap_rows[h] = {"t OLS": float(t_o[0]), "t Newey-West": float(t_n[0]),
                       "verhouding": float(t_o[0] / t_n[0])}
sim_ratio = {h: np.median(np.abs(t_ols[h]) / np.abs(t_nw[h])) for h in HORIZONS_GSC}
pd.DataFrame(overlap_rows).T.assign(**{"verhouding in simulatie (mediaan)": pd.Series(sim_ratio)}).round(3)Bij één maand is er niets te zien, maar bij drie en zes maanden geeft OLS -waarden van 2,44 en 2,70, terwijl Newey-West op 1,60 en 1,53 blijft. De verhouding tussen de twee (1,5 tot 1,8 bij ) ligt in de buurt van de mediaan uit de simulatie voor dezelfde horizonnen.
(3) Een onderzoeker die in 2003 alleen de twaalfmaandsregressie met OLS had gerapporteerd, had gevonden. Volgens de simulatie bewijst die waarde niets, omdat overlap en persistentie samen een variabele zonder informatie vaak genoeg zo’n -waarde geven.
- Brandt, M. W., & Santa-Clara, P. (2006). Dynamic Portfolio Selection by Augmenting the Asset Space. The Journal of Finance, 61(5), 2187–2217. 10.1111/j.1540-6261.2006.01055.x
- Brandt, M. W., Santa-Clara, P., & Valkanov, R. (2009). Parametric Portfolio Policies: Exploiting Characteristics in the Cross-Section of Equity Returns. The Review of Financial Studies, 22(9), 3411–3447. 10.1093/rfs/hhp003
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Goyal, A., & Santa-Clara, P. (2003). Idiosyncratic Risk Matters! The Journal of Finance, 58(3), 975–1007. 10.1111/1540-6261.00555
- Bali, T. G., Cakici, N., Yan, X. (Sterling), & Zhang, Z. (2005). Does Idiosyncratic Risk Really Matter? The Journal of Finance, 60(2), 905–929. 10.1111/j.1540-6261.2005.00750.x
- Wei, S. X., & Zhang, C. (2005). Idiosyncratic Risk Does Not Matter: A Re-Examination of the Relationship between Average Returns and Average Volatilities. Journal of Banking & Finance, 29(3), 603–621. 10.1016/S0378-4266(04)00050-0
- Campbell, J. Y., Lettau, M., Malkiel, B. G., & Xu, Y. (2001). Have Individual Stocks Become More Volatile? An Empirical Exploration of Idiosyncratic Risk. The Journal of Finance, 56(1), 1–43. 10.1111/0022-1082.00318
- Ang, A., Hodrick, R. J., Xing, Y., & Zhang, X. (2006). The Cross-Section of Volatility and Expected Returns. The Journal of Finance, 61(1), 259–299. 10.1111/j.1540-6261.2006.00836.x
- Herskovic, B., Kelly, B., Lustig, H., & Van Nieuwerburgh, S. (2016). The Common Factor in Idiosyncratic Volatility: Quantitative Asset Pricing Implications. Journal of Financial Economics, 119(2), 249–283. 10.1016/j.jfineco.2015.09.010
- Britten-Jones, M. (1999). The Sampling Error in Estimates of Mean-Variance Efficient Portfolio Weights. The Journal of Finance, 54(2), 655–671. 10.1111/0022-1082.00120
- Hansen, L. P. (1982). Large Sample Properties of Generalized Method of Moments Estimators. Econometrica, 50(4), 1029–1054. 10.2307/1912775
- Jobson, J. D., & Korkie, B. (1980). Estimation for Markowitz Efficient Portfolios. Journal of the American Statistical Association, 75(371), 544–554. 10.1080/01621459.1980.10477507
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD