

LLM’s, advies en efficiëntie
1Overzicht
Santa-Clara sluit zijn geschiedenis af met twee vragen over het taalmodel Santa-Clara (2026). Krijgen particulieren beter advies nu een machine het werk van een adviseur bijna gratis doet, en worden markten efficiënter nu machines elke jaarrekening in seconden lezen? Hij verwacht een betere mediaan met een slechtere staart voor advies, en efficiëntere relatieve prijzen bij een marktniveau dat niet efficiënter wordt. Dat brengt hij zelf als verwachting, niet als bevinding.
In dit college:
leiden we met Grossman & Stiglitz (1980) af hoeveel beleggers zich laten informeren als informatie goedkoper wordt, en waarom de prijs toch nooit volledig informatief wordt
laten we zien dat fouten die veel beleggers delen niet wegmiddelen, zodat relatieve prijzen wel en het marktniveau niet efficiënter worden
rekenen we uit wat spreiding en weinig handelen een particulier over dertig jaar opleveren, en zetten we dat naast het werk over robo-advies en Robinhood
simuleren we wat één jaar data laat zien van goedkopere informatie en van een gedeeld model
repliceren we een event study rond de lancering van ChatGPT Eisfeldt et al. (2023), het ene moment waarop de kosten van informatie in één keer daalden, en meten we hoe snel prijzen sinds 1930 nieuws verwerken
In 1980 lieten Grossman en Stiglitz zien dat een volledig efficiënte markt onmogelijk is als informatie geld kost, want dan betaalt niemand meer om informatie te verzamelen. De kosten van informatie daalden daarna geleidelijk, met elektronische jaarverslagen en internet, en met ChatGPT eind 2022 in één sprong. Sindsdien volgde empirisch werk over ChatGPT als nieuwslezer Lopez-Lira & Tang (2023) en over bedrijven die voor machines schrijven Cao et al. (2023).
Tot nu toe toetsten we theorieën aan feiten of zochten we een verklaring bij een feit (theorie of feit). Hier staat alleen de stelling van Grossman en Stiglitz vast, en is gemeten dat prijzen nieuws sneller verwerken. Wat taalmodellen met advies en crashes doen, is nog een vermoeden waarvoor de feiten ontbreken.
2Intuïtie: waarom zou dit waar zijn?
Het standaardadvies van het vak past op een bierviltje: spreid, houd de kosten laag, handel weinig en verkoop niet in paniek. Het ontbrak nooit aan kennis, maar aan iemand die het advies herhaalt op het moment dat de klant in de verleiding komt. Zo’n adviseur kost een vaste vergoeding, en die is voor een klein vermogen te hoog. Volgens Santa-Clara kost zulk advies, waarvoor vroeger een mens nodig was, per extra klant nu vrijwel niets meer Santa-Clara (2026). Omdat de mediane particulier te weinig spreidt en te veel handelt (Behavioral finance en limits of arbitrage), helpt zelfs een middelmatige digitale adviseur. Een app die een klant kan afremmen, kan hem echter ook tot handel aanzetten, en een platform dat per transactie verdient, heeft daar belang bij.
Informatie komt in prijzen doordat beleggers ervoor betalen en dat terugverdienen met hun handel. Als lezen goedkoper wordt, doen meer beleggers het, en dan bevat de prijs meer informatie. Toch merkt het marktniveau daar om twee redenen weinig van. Ten eerste lijken machines op elkaar. Tien analisten met elk hun eigen fouten middelen die fouten weg, maar tien algoritmen die op dezelfde data zijn getraind, maken dezelfde fout tegelijk. Ten tweede kan een arbitrageur een relatieve fout verhandelen door het goedkope aandeel te kopen en het dure te verkopen, terwijl tegenover een gok op het marktniveau geen hedge staat.
We verwachten daarom dat goedkopere informatie het aandeel geïnformeerde beleggers doet stijgen en de prijs informatiever maakt, maar niet volledig informatief. Een fout die veel beleggers delen, blijft in het gemiddelde staan, hoeveel beleggers er ook meedoen. Van goedkoop advies verwachten we dat de mediane particulier erop vooruitgaat, terwijl de slechtste uitkomsten slechter kunnen worden.
3Toy-voorbeeld: meer geïnformeerden als informatie goedkoper wordt
We laden eerst de pakketten en leggen het toeval vast, zodat elke uitvoering dezelfde getallen geeft.
import itertools

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Een risicovol activum betaalt , de som van een signaal en ruis . Een fractie van de beleggers betaalt en ziet het signaal, terwijl de rest alleen de prijs ziet. Omdat het aanbod van het activum ruist, verraadt de prijs het signaal maar gedeeltelijk. We willen weten hoe groot wordt als informatie goedkoper wordt, bij deze getallen:
| grootheid | symbool | waarde |
|---|---|---|
| absolute risicoaversie | 2 | |
| variantie van het signaal | 1 | |
| variantie van de ruis in de payoff | 1 | |
| variantie van het aanbod | 0,04 | |
| informatiekosten, duur of goedkoop | of |
De theorie hieronder leidt het volgende recept af.
Hierin meet de aanbodruis ten opzichte van het signaal. De factor is in evenwicht de restvariantie van een ongeïnformeerde gedeeld door die van een geïnformeerde, en zet de kosten zo om naar de schaal van de varianties. Bij dit aandeel geïnformeerden is het kwadraat van de correlatie tussen signaal en prijs, de informativiteit, gelijk aan . Met de hand gaat de berekening in vijf stappen.
De ruisparameter is .
Bij dure informatie is , dus .
Dan is en .
Bij goedkope informatie is , dus .
Dan is en .
De codecel lost hetzelfde evenwicht op met een functie die we in de simulatie opnieuw gebruiken, en zet de uitkomst naast de handberekening.
def gs_equilibrium(c, a, var_s, var_e, var_z):
    """Grossman-Stiglitz (1980) CARA-normal equilibrium.

    Returns the fraction of informed traders lam, price informativeness
    rho2 = Corr^2(s, p) and the gross certainty-equivalent value of the signal.
    """
    nu = a**2 * var_e**2 * var_z / var_s
    k = var_e / var_s * np.expm1(2 * a * c)
    if k >= 1:
        lam = 0.0
    elif k <= 0:
        lam = 1.0
    else:
        lam = min(1.0, np.sqrt(nu * (1 - k) / k))
    rho2 = lam**2 / (lam**2 + nu)
    value = np.log1p(var_s * (1 - rho2) / var_e) / (2 * a)
    return lam, rho2, value


a, var_s, var_e, var_z = 2.0, 1.0, 1.0, 0.04
cases = {"dure informatie": (np.log(1.5) / 4, 0.4, 0.5),
         "goedkope informatie": (np.log(1.2) / 4, 0.8, 0.8)}
rows = {}
for case, (c, lam_hand, rho2_hand) in cases.items():
    lam, rho2, value = gs_equilibrium(c, a, var_s, var_e, var_z)
    rows[case] = {"c": c,
                  "lambda met de hand": lam_hand, "lambda code": lam,
                  "rho2 met de hand": rho2_hand, "rho2 code": rho2,
                  "waarde signaal (code)": value}
toy_gs = pd.DataFrame(rows).T

assert np.allclose(toy_gs["lambda code"], toy_gs["lambda met de hand"])
assert np.allclose(toy_gs["rho2 code"], toy_gs["rho2 met de hand"])
assert np.allclose(toy_gs["waarde signaal (code)"], toy_gs["c"])
toy_gs.round(4)Code en hand komen overeen, en de laatste kolom laat zien dat het signaal in beide evenwichten precies zijn kosten waard is. Informatie die ruim de helft goedkoper wordt, verdubbelt dus het aandeel geïnformeerde beleggers. De prijs verklaart dan 80% van de variantie van het signaal in plaats van 50%, maar geen van beide evenwichten komt bij 100%.
4Theorie
De theorie gaat in drie stappen van het toy-voorbeeld naar de tweedeling van Santa-Clara. Eerst leiden we het evenwicht van Grossman en Stiglitz af. Goedkopere informatie maakt de prijs daarin informatiever, tot een grens die door risicoaversie wordt gezet en niet door kosten. Daarna laten we zien dat gedeelde modelfouten niet wegmiddelen, zodat relatieve prijzen wel en het marktniveau niet efficiënter worden. Tot slot meten we snelheid met de halfwaardetijd van informatie en rekenen we uit wat advies een particulier oplevert.
4.1Opzet en aannames
We volgen Grossman & Stiglitz (1980), maar schrijven voor het signaal en voor het aanbod, waar zij en gebruiken. Het model rust op vier aannames.
Er is één periode, een risicovrij activum met rente nul en een risicovol activum met payoff , met en onafhankelijk.
Alle beleggers hebben nut met absolute risicoaversie (CARA).
Het aanbod per belegger is , onafhankelijk van en , bijvoorbeeld aandelen die liquiditeitshandelaren (noise traders) om persoonlijke redenen verkopen.
Een fractie betaalt en ziet , de rest ziet alleen de prijs .
Zonder de ruis van aanname 3 zou de prijs het signaal volledig verraden, zodat niemand voor informatie zou betalen en er geen evenwicht bestond. Een CARA-belegger met een normaal verdeelde payoff vraagt stuks, en dus meer naarmate de verwachte winst per stuk groter en het risico kleiner is. Voor een geïnformeerde is de informatie , zodat , en voor een ongeïnformeerde is ze .
Omdat geïnformeerden op handelen en het aanbod ruist, blijkt de prijs een lineaire functie te zijn van , het signaal vervuild met aanbodruis. De informativiteit van de prijs is het kwadraat van de correlatie tussen en :
Hoe meer geïnformeerden er zijn, hoe kleiner de ruis per eenheid signaal in , en hoe dichter de informativiteit bij 1 komt. In het toy-voorbeeld is , zodat een informativiteit van 0,5 geeft.
4.2Het kernresultaat: het evenwicht
Steeds meer beleggers kopen het signaal, tot het precies zijn kosten waard is. Een belegger die ervoor betaalt, koopt meer als het signaal goed is, zodat de prijs met het signaal stijgt en er een spoor van draagt. Omdat het aanbod ruist, weet een ongeïnformeerde niet of een hoge prijs goed nieuws of weinig aanbod betekent. Naarmate meer beleggers betalen, wordt het spoor duidelijker en daalt de waarde van het signaal, tot die de kosten net dekt.
Het bewijs vergelijkt het verwachte nut van beide typen beleggers bij een gegeven prijs. Die verhouding blijkt niet van de prijs af te hangen, zodat onverschilligheid betekent dat de restvariantie van een ongeïnformeerde, , precies keer die van een geïnformeerde is. In het toy-voorbeeld is die restvariantie 1,5 bij dure en 1,2 bij goedkope informatie, tegen 1 voor een geïnformeerde. Invullen in (2) geeft .
Proof 1
Stap 1: de prijs is lineair in . Neem als proefoplossing met , zodat uit te berekenen is en omgekeerd. Omdat en , is . De normale projectie geeft en . In evenwicht is de vraag gelijk aan het aanbod, . Met wordt dat
lineair in met , zodat de proefoplossing klopt.
Stap 2: de nutsverhouding hangt niet van af. Een geïnformeerde met beginvermogen en optimale vraag heeft conditioneel op nut . We nemen de verwachting over gegeven , met . Voor is , en de ongeïnformeerde heeft hetzelfde nut zonder de factor en zonder de wortel. De verhouding is dus
Stap 3: onverschilligheid legt vast. Beide nutten zijn negatief, dus een verhouding boven 1 betekent dat de geïnformeerde slechter af is. Een inwendig evenwicht vraagt verhouding 1, dus en . Invullen in (2) geeft . Is dat groter dan 1, dan loont informatie ook als iedereen geïnformeerd is en is . Is , dan is ze zelfs bij een oninformatieve prijs de kosten niet waard en is .
4.3Wat het voorspelt: goedkopere informatie
Goedkopere informatie maakt de prijs informatiever, zoals we verwachtten. Omdat met stijgt, dalen en allebei als informatie duurder wordt, en stijgen ze als ze goedkoper wordt. Het model voegt daar twee dingen aan toe.
Ten eerste bepaalt de aanbodruis hoeveel beleggers meedoen, maar niet hoe informatief de prijs wordt. In een inwendig evenwicht is , en bevat niet. Meer ruis trekt daarom meer geïnformeerden aan ( is evenredig met ), en hun extra handel compenseert de extra ruis precies. De liquiditeitshandelaren van aanname 3 zijn in dit model dus geen vijand van efficiëntie maar de voorwaarde ervoor.
Ten tweede is er een grens. Als naar nul gaat, gaat naar 1, maar dan is nog altijd , in het toy-voorbeeld . Zelfs een belegger die kent, handelt voorzichtig omdat onzeker blijft, zodat de aanbodruis zichtbaar blijft in de prijs. Een taalmodel verlaagt , maar niet de risicoaversie of de fundamentele onzekerheid , en juist die twee zetten de grens.
4.4Gedeelde modelfouten
Grossman en Stiglitz nemen aan dat alle geïnformeerden hetzelfde ware signaal zien, terwijl in werkelijkheid elke belegger een eigen schatting maakt met een eigen model. Als de modellen verschillen, middelen hun fouten weg, en als ze op elkaar lijken, gebeurt dat niet. Goedkopere informatie verkleint de eigen fout van elk model, maar niet de gedeelde, en die kan door een handvol dominante taalmodellen juist groeien.
Als groot wordt, blijft over, zodat meer arbitrageurs alleen tegen de eigen fouten helpen. Met vier arbitrageurs is dat met de hand na te gaan. Elk maakt een fout van +1 of -1 met kans , zodat ze individueel even nauwkeurig zijn. Met eigen modellen zijn er even waarschijnlijke combinaties, waarvan er één een gemiddelde van -1 geeft, vier , zes 0, vier en één +1. Delen twee van de vier een model, dan is het gemiddelde , en vraagt de grootste daling . Gebruiken alle vier hetzelfde model, dan is het gemiddelde met kans .
| modellen | variantie met de hand | kans op de grootste daling | |
|---|---|---|---|
| vier eigen | 0 | ||
| twee delen er een | |||
| één gedeeld | 1 | 1 |
De formule geeft met , en 1 dezelfde varianties. De code telt alle combinaties af en zet ze naast de handberekening.
def average_error_distribution(n, n_shared):
    """Exact distribution of the mean of n +-1 errors when n_shared traders share one draw."""
    n_draws = n - n_shared + (1 if n_shared else 0)
    dist = {}
    for draws in itertools.product([-1, 1], repeat=n_draws):
        if n_shared:
            total = n_shared * draws[0] + sum(draws[1:])
        else:
            total = sum(draws)
        dist[total / n] = dist.get(total / n, 0.0) + 0.5**n_draws
    return pd.Series(dist).sort_index()


by_hand = {"vier eigen": (0, 1 / 4, 1 / 16),
           "twee delen er een": (2, 3 / 8, 1 / 8),
           "één gedeeld": (4, 1.0, 1 / 2)}
rows = {}
for label, (n_shared, var_hand, p_hand) in by_hand.items():
    dist = average_error_distribution(4, n_shared)
    omega = n_shared / 4
    rows[label] = {"variantie met de hand": var_hand,
                   "variantie code": (dist * dist.index.to_numpy() ** 2).sum(),
                   "formule omega^2 + (1-omega)/N": omega**2 + (1 - omega) / 4,
                   "P(grootste daling) met de hand": p_hand,
                   "P(grootste daling) code": dist.loc[-1.0]}
toy_mono = pd.DataFrame(rows).T

assert np.allclose(toy_mono["variantie code"], toy_mono["variantie met de hand"])
assert np.allclose(toy_mono["P(grootste daling) code"], toy_mono["P(grootste daling) met de hand"])
toy_mono.round(4)Elke arbitrageur is in alle drie de gevallen even nauwkeurig. Toch stijgt de kans op de grootste daling van 1/16 naar 1/2, omdat alleen de samenhang van de fouten verandert.
Dezelfde redenering werkt over aandelen. Schrijf de fout van een model in aandeel als . Hier is een fout die alle aandelen raakt, zoals een te optimistische kijk op de conjunctuur, en een fout in één aandeel. De fout is wat aandelen gemeen hebben, en bepaalt of die fout over arbitrageurs uitmiddelt. Een portefeuille die ondergewaardeerde aandelen koopt en overgewaardeerde verkoopt, met gewichten die optellen tot nul en samen bèta nul hebben, heeft fout , en die diversifieert weg. De marktportefeuille heeft een gemiddelde bèta van ongeveer 1 en houdt fout , zoals de tweede oefening laat uitrekenen.
Santa-Clara vat de tweedeling in twee zinnen samen:
Machines make relative prices more efficient, because relative mispricing is what a well-funded arbitrageur can trade. Nothing about machines makes the aggregate market more efficient, because the aggregate is set by flows meeting inelastic supply. Santa-Clara (2026)
De eerste zin volgt uit de alinea hierboven, want een portefeuille met bèta nul houdt alleen de fouten per aandeel over, en die middelen weg. De tweede sluit aan bij het vorige college, dat aannemelijk maakte dat een dollar instroom de waarde van de markt met twee tot acht dollar verhoogt, met vijf als midden Gabaix & Koijen (2021)Koijen & Yogo (2019). Als dat klopt, hangt het niveau sterk van stromen af. Passieve stromen, en adviseurs die klanten in dezelfde modelportefeuilles leiden, kunnen het deel van de vraag vergroten dat niet op de prijs reageert, zodat het marktniveau gevoeliger wordt voor stromen dan voor nieuws.
Een gedeelde fout wordt pas een crash als iedereen tegelijk moet verkopen. Volgens Stein (2009) gebeurt dat als arbitrageurs niet weten hoeveel anderen dezelfde positie hebben (crowding) en die positie met geleend geld financieren. Gedwongen verkopen versterken elkaar dan. Het best gedocumenteerde voorbeeld ligt vóór de taalmodellen. In de week van 6 augustus 2007 leden kwantitatieve aandelenfondsen met dezelfde waarderingsfactoren grote verliezen, wat volgens Khandani & Lo (2011) past bij een gelijktijdige afbouw van hun posities. Een monocultuur van taalmodellen zou dat mechanisme versterken.
4.5Hoe het gemeten wordt: de halfwaardetijd van informatie
Hoe snel een prijs nieuws verwerkt, is af te lezen aan de correlatie tussen het rendement van vandaag en dat van gisteren. Als een prijs elke dag maar een deel van de afstand tot de nieuwe waarde overbrugt, loopt de reactie op nieuws door in het rendement van morgen. Hoe trager de aanpassing, hoe sterker die correlatie. Vanaf hier zijn kleine letters logs.
Proof 3
Schrijf voor de afstand tot de waarde. Uit de aanpassingsregel volgt , dus . Dan is , een AR(1) met coëfficiënt . Na perioden is een fractie van een schok verwerkt, en die is bij .
De autocorrelatie van het rendement is dus de fractie van de afstand die de prijs elke dag laat liggen. Met per dag is de halfwaardetijd dag, ongeveer drie handelsuren, zodat nieuws dat in minuten wordt verwerkt een dagelijkse autocorrelatie van vrijwel nul geeft. De maat is wel indirect, want in een index van veel aandelen geeft ook niet-synchrone handel positieve autocorrelatie. Dun verhandelde aandelen hebben vaak een slotkoers van eerder op de dag, zodat de index een deel van het nieuws van vandaag pas morgen toont, zonder dat iemand traag reageert.
Santa-Clara vat de meetgeschiedenis samen als halfwaardetijden die in 1969 dagen waren, in 2000 uren, en nu seconden Santa-Clara (2026). Met maanddata konden Fama et al. (1969) niet eens zien of het dagen waren. Later zagen Busse & Green (2002) koersen binnen minuten reageren op aandelen die live op CNBC werden besproken (De event study).
Dat taalmodellen nieuws in koersen brengen, is inmiddels ook direct gemeten. In het werk van Lopez-Lira & Tang (2023) zei ChatGPT per krantenkop of het bericht goed, slecht of irrelevant was voor de koers. In hun eerste versie voorspelt die score het rendement van de volgende dag met een coëfficiënt van 0,231 procentpunt (). Voor kleine aandelen is het effect bijna driemaal zo sterk, terwijl oudere taalmodellen als GPT-2 en BERT niets voorspelden. In de gepubliceerde versie Lopez-Lira & Tang (2026) dalen de rendementen van de strategie naarmate meer beleggers taalmodellen gebruiken. Goedkopere informatie trekt dus geïnformeerden aan tot het voordeel verdwijnt, zoals (3) voorspelt.
De terugkoppeling loopt ook de andere kant op. Volgens Cao et al. (2023) schrijven bedrijven met veel machinale lezers hun jaarverslagen zo dat machines ze gemakkelijk verwerken, en vermijden ze woorden die algoritmen negatief opvatten. Een signaal waar iedereen naar kijkt, wordt dus door de afzender gestuurd, en zo’n gedeelde vertekening middelt volgens (6) niet weg.
4.6Advies als portefeuillekeuze
Te weinig spreiding en te veel handel kosten een particulier samen ongeveer drie procentpunt groei per jaar, en aan beide kan een adviseur iets doen. Ze drukken allebei de mediane uitkomst, die bij samengestelde groei van het log rendement afhangt. Te weinig spreiding kost daarin rendement via de variantie, en handel via spread en commissie. Stel dat een belegger aandelen in gelijke gewichten houdt, elk met marktbèta 1 en idiosyncratische volatiliteit . Hij handelt met omloopsnelheid per jaar tegen kosten per eenheid omloop en betaalt een vergoeding . Zijn log-vermogen groeit dan verwacht met .
Hier is de netto risicovrije rente, de verwachte aandelenpremie en de volatiliteit van de markt. De groei daalt met elke kostenterm en stijgt met het aantal aandelen, omdat spreiden volgens Markowitz hetzelfde verwachte rendement met minder variantie geeft. Met en kost te weinig spreiding procentpunt per jaar.
De term is de rekenkunde van actief beheer op het niveau van een huishouden. Bij Barber & Odean (2000) hadden huishoudens een gemiddelde omloop van 75% per jaar. Met kosten van 2% per eenheid omloop, voor spread en commissie, kost de gemiddelde omloop 1,5 procentpunt per jaar. Samen is dat drie procentpunt groei per jaar, en na dertig jaar een factor op het mediane eindvermogen.
Het bewijs over robo-advies is minder eenduidig dan dit rekensommetje. Na de invoering van een robo-adviseur hielden slecht gespreide beleggers meer aandelen, met minder volatiliteit en betere rendementen D'Acunto et al. (2019). Ze verkochten ook minder vaak winnaars te vroeg en joegen minder trends na. Beleggers die al goed gespreid waren, gingen daarentegen meer handelen, en alle gebruikers logden vaker in. Advies maakt de portefeuille dus beter, maar niet vanzelf rustiger.
De andere kant laat Barber et al. (2022) zien. Gebruikers van Robinhood handelen meer op aandacht dan andere particulieren, en dat komt deels door de app zelf, want als die uitvalt, daalt vooral de handel in aandelen met veel aandacht. De aandelen die deze gebruikers op een dag het meest kopen, hebben over de volgende twintig dagen een gemiddeld abnormaal rendement van .
Een adviseur die per transactie verdient, duwt de omloop van zijn klant boven wat de klant zelf zou kiezen. Omdat het nut van de klant rond zijn optimum vlak is, groeit het verlies met het kwadraat van de duw, zodat een kleine duw bijna niets kost en een grote veel. Een platform dat de omloop van het gemiddelde naar 300% per jaar duwt, kost de klant bij dezelfde kosten per eenheid omloop 4,5 procentpunt groei per jaar extra, drie keer wat te weinig spreiding kost. De mediane klant van een goedkope adviseur wint dus aan spreiding, terwijl de klant die het platform tot veel handel verleidt het meeste verliest, en in die klanten zit de slechtere staart.
5Simulatie: wat één jaar data laat zien
Hoeveel ziet een onderzoeker in één jaar data van goedkopere informatie en van een gedeeld model? We simuleren telkens 2000 jaren van 250 perioden. Eerst doen we dat in de economie van Grossman en Stiglitz met de parameters van het toy-voorbeeld, daarna in een markt van vijftig arbitrageurs met een gedeeld model.
5.1Informatiekosten en handelswinst
Voor vijf waarden van simuleren we de economie uit Proposition 1 met . Per jaar schatten we de informativiteit van de prijs en meten we de handelswinst van een geïnformeerde min die van een ongeïnformeerde, na aftrek van , omdat een onderzoeker in data die winst ziet en niet het nut.
def gs_price(lam, rho2, a, var_s, var_e, mu_s, z_bar):
    """Coefficients of the linear equilibrium price p = p0 + p1 * w (lam > 0) and Var(x | p)."""
    V = var_e + var_s * (1 - rho2)
    A = lam / (a * var_e) + (1 - lam) / (a * V)
    # p0 and p1 solve the market-clearing equation in step 1 of the proof
    p0 = (-z_bar + (1 - lam) * mu_s * (1 - rho2) / (a * V)) / A
    p1 = (lam / (a * var_e) + (1 - lam) * rho2 / (a * V)) / A
    return p0, p1, V


def simulate_gs(c, n_years=2000, T=250, mu_s=1.0, z_bar=1.0):
    """Simulate the Grossman-Stiglitz economy; per 'year' estimate rho2 and the informed trading gain."""
    lam, rho2, value = gs_equilibrium(c, a, var_s, var_e, var_z)
    s = mu_s + np.sqrt(var_s) * rng.standard_normal((n_years, T))
    x = s + np.sqrt(var_e) * rng.standard_normal((n_years, T))
    z = z_bar + np.sqrt(var_z) * rng.standard_normal((n_years, T))
    w = s - a * var_e / lam * (z - z_bar)
    p0, p1, V = gs_price(lam, rho2, a, var_s, var_e, mu_s, z_bar)
    p = p0 + p1 * w
    d_inf = (s - p) / (a * var_e)
    d_uninf = (mu_s + rho2 * (w - mu_s) - p) / (a * V)
    assert np.allclose(lam * d_inf + (1 - lam) * d_uninf, z)       # demand equals supply
    gain = (d_inf - d_uninf) * (x - p) - c
    s_dev = s - s.mean(1, keepdims=True)
    p_dev = p - p.mean(1, keepdims=True)
    rho2_hat = (s_dev * p_dev).sum(1) ** 2 / ((s_dev**2).sum(1) * (p_dev**2).sum(1))
    year_gain = gain.mean(1)
    return {"c": c,
            "aandeel geïnformeerd": lam,
            "informativiteit theorie": rho2,
            "informativiteit geschat, gemiddelde": rho2_hat.mean(),
            "informativiteit geschat, sd over jaren": rho2_hat.std(),
            "handelswinst na c, gemiddelde": year_gain.mean(),
            "handelswinst na c, sd over jaren": year_gain.std(),
            "aandeel jaren met verlies": (year_gain < 0).mean()}


sim_gs = pd.DataFrame([simulate_gs(c) for c in [0.01, 0.03, 0.06, 0.10, 0.15]]).set_index("c")
sim_gs.round(4)De geschatte informativiteit ligt gemiddeld binnen 0,003 van de theoretische waarde, met een spreiding over jaren van 0,016 tot 0,045. Eén jaar data volstaat dus om de informativiteit te meten. Bij en is iedereen geïnformeerd en staat de informativiteit op de grens van 0,86 uit de theorie. De figuur toont links de drempel waaronder iedereen geïnformeerd is, en rechts het teken van de handelswinst.
Source
c_grid = np.linspace(0.001, 0.2, 400)
curves = pd.DataFrame([gs_equilibrium(c, a, var_s, var_e, var_z) for c in c_grid],
                      index=c_grid, columns=["lambda", "rho2", "value"])

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].plot(c_grid, curves["lambda"], label="aandeel geïnformeerd $\\lambda^*$")
axes[0].plot(c_grid, curves["rho2"], label="informativiteit prijs $\\rho^2$")
axes[0].plot(c_grid, curves["value"] / c_grid, label="bruto waarde signaal / $c$")
axes[0].set_ylim(0, 3)
axes[0].set_xlabel("Informatiekosten $c$")
axes[0].set_ylabel("Niveau")
axes[0].set_title("Evenwicht als functie van de informatiekosten")
axes[0].legend()
axes[1].errorbar(sim_gs.index, sim_gs["handelswinst na c, gemiddelde"],
                 yerr=1.96 * sim_gs["handelswinst na c, sd over jaren"],
                 fmt="o", capsize=4, label="gemiddelde en 95% van de jaren")
axes[1].axhline(0, color="black", lw=0.8)
axes[1].set_xlabel("Informatiekosten $c$")
axes[1].set_ylabel("Handelswinst geïnformeerd − ongeïnformeerd, na $c$")
axes[1].set_title("Gemeten handelswinst is geen informatierente")
axes[1].legend()
plt.show()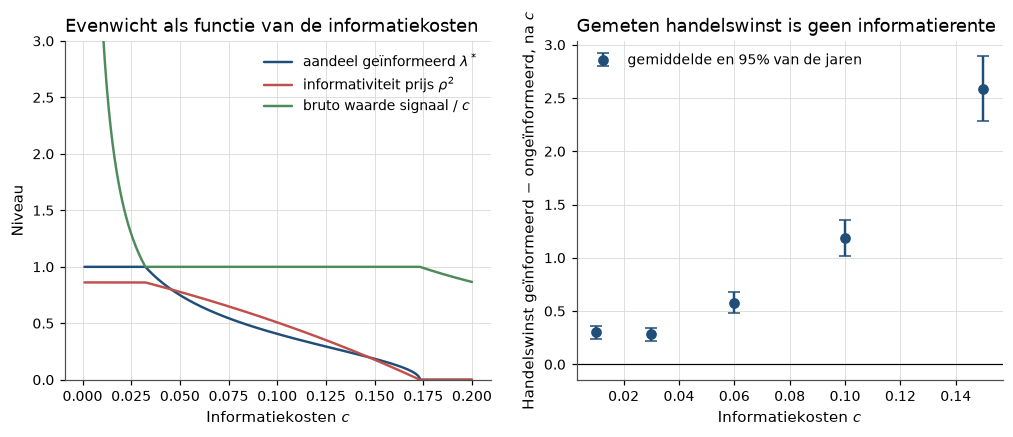
Figure 1:Links staat het evenwicht. Onder een drempel van is iedereen geïnformeerd en is informatie meer waard dan ze kost, en daarboven is de bruto waarde van het signaal precies . Rechts verdienen geïnformeerden na aftrek van elk jaar meer, vanaf meer naarmate informatie duurder is, ook waar ze in nut niet beter af zijn.
De handelswinst is geen informatierente. In alle 2000 jaren verdient een geïnformeerde na aftrek van meer dan een ongeïnformeerde, en vanaf groeit dat voordeel met de kosten, tot 2,59 per periode bij . Toch is in een inwendig evenwicht niemand in nut beter af, omdat de geïnformeerde grotere posities neemt en meer risico draagt. Een onderzoeker die in de winst van professionele beleggers een informatierente ziet, meet dus een vergoeding voor kosten en risico. Een voordeel dat krimpt als informatie goedkoper wordt, is dan een kenmerk van het evenwicht en geen verdwenen ontdekking.
5.2Een gedeeld model onder vijftig arbitrageurs
Nu schalen we Proposition 2 op. Vijftig arbitrageurs schatten elke dag de waarde van een activum, elk met een fout met variantie 1. De fouten hebben dikke staarten (een Student--verdeling met vier vrijheidsgraden), en de prijsfout is hun gemiddelde. Een fractie deelt één model en dus één fout per dag. We kijken naar de dagelijkse prijsfout en naar de slechtste dag van elk jaar, omdat een risicomanager precies dat in één jaar data ziet.
def t_unit(size, df=4):
    """Unit-variance Student-t draws."""
    return rng.standard_t(df, size) * np.sqrt((df - 2) / df)


N_ARB, N_DAYS, N_YEARS = 50, 250, 2000
mono_rows, mono_errors = [], {}
for share in [0.0, 0.1, 0.3, 0.6, 1.0]:
    n_shared = int(round(share * N_ARB))
    err = n_shared * t_unit((N_YEARS, N_DAYS))
    for start in range(0, N_YEARS, 250):                          # chunks keep memory small
        stop = min(start + 250, N_YEARS)
        err[start:stop] += t_unit((stop - start, N_DAYS, N_ARB - n_shared)).sum(-1)
    err /= N_ARB
    worst = err.min(axis=1)
    mono_errors[share] = err
    mono_rows.append({"fractie gedeeld": share,
                      "sd theorie": np.sqrt(share**2 + (1 - share) / N_ARB),
                      "sd simulatie": err.std(),
                      "0,1%-kwantiel": np.quantile(err, 0.001),
                      "slechtste dag (mediaan jaar)": np.median(worst),
                      "slechtste dag (1 op 20 jaar)": np.quantile(worst, 0.05),
                      "kurtosis": stats.kurtosis(err, axis=None)})
mono = pd.DataFrame(mono_rows).set_index("fractie gedeeld")
mono.round(3)De standaarddeviatie volgt (6) op hoogstens 0,006 na, van 0,14 zonder gedeeld model tot 0,61 bij 60% gedeeld. De staart groeit sneller. De kurtosis is het hoogst in een gemengde markt, omdat de onafhankelijke fouten daar meestal wegmiddelen en het gedeelde model af en toe een uitschieter maakt. Rechts laat de figuur zien hoe snel de slechtste dag van een jaar daalt als het gedeelde deel groeit.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
bins = np.linspace(-4, 4, 161)
for share, err in mono_errors.items():
    axes[0].hist(err.ravel(), bins=bins, density=True, histtype="step", lw=1.4,
                 label=f"gedeeld = {share:.0%}")
axes[0].set_yscale("log")
axes[0].set_xlabel("Dagelijkse prijsfout (in sd van één arbitrageur)")
axes[0].set_ylabel("Dichtheid (log-schaal)")
axes[0].set_title("Verdeling van de prijsfout")
axes[0].legend()
axes[1].plot(mono.index, mono["slechtste dag (mediaan jaar)"], marker="o", label="mediaan jaar")
axes[1].plot(mono.index, mono["slechtste dag (1 op 20 jaar)"], marker="o", label="1 op 20 jaar")
axes[1].plot(mono.index, -3 * mono["sd theorie"], color="black", ls="--", lw=1, label="$-3 \\times$ sd theorie")
axes[1].set_xlabel("Fractie arbitrageurs met hetzelfde model $\\omega$")
axes[1].set_ylabel("Slechtste dagelijkse prijsfout in een jaar")
axes[1].set_title("De staart groeit met het gedeelde model")
axes[1].legend()
plt.show()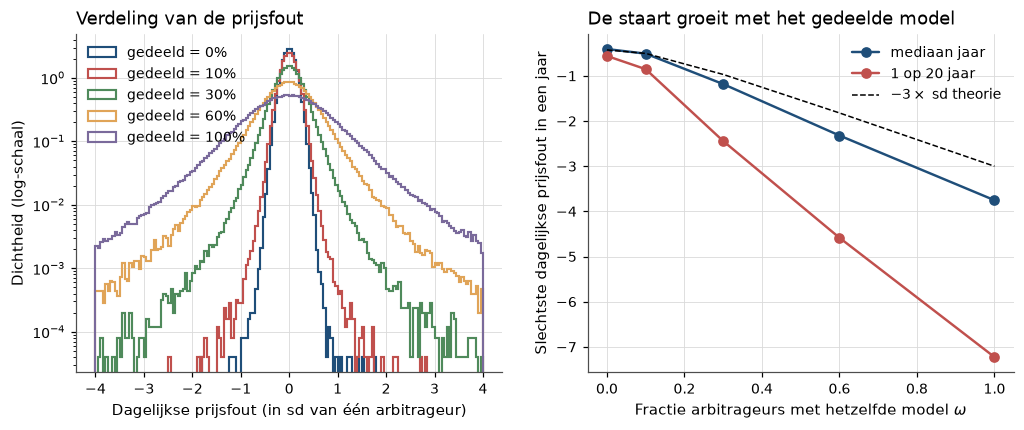
Figure 2:Elke arbitrageur is in alle scenario’s even nauwkeurig, maar hoe groter het gedeelde deel, hoe breder de verdeling van de prijsfout en hoe dikker de staarten. De slechtste dag van een jaar volgt de gedeelde fout.
Het verraderlijke zit in de mediaan. De slechtste dag van een gewoon jaar zakt bij 10% gedeeld maar van naar . De slechtste dag die eens in twintig jaar voorkomt, ligt bij 30% gedeeld daarentegen op , ruim vier keer zo diep als zonder gedeeld model. Een beginnende monocultuur is in één jaar data dus meestal niet te zien, en wanneer ze wel zichtbaar wordt, gebeurt dat in een zeldzaam jaar. Een zeldzame uitkomst laat zich met weinig jaren niet meten, en daarmee keert de standaardfout van 2% hier terug.
6Replicatie op echte data
6.1De lancering van ChatGPT als event
De lancering van ChatGPT is het ene moment waarop de kosten van informatie in één keer zichtbaar daalden, en de event study vraagt of de markt dat meteen in de koersen van blootgestelde bedrijven verwerkte. Een markt die nieuws in uren verwerkt, zou die herwaardering binnen elf handelsdagen moeten tonen. De eerste cel laadt de koersen en bouwt gelijkgewogen portefeuilles, met een eigen groep voor chips en hardware, omdat hun blootstelling via het product loopt en niet via het personeel.
GROUPS = {
    "hoog": ["ADBE", "CRM", "NOW", "PANW", "FTNT", "GOOGL", "MA", "V"],
    "hardware": ["AAPL", "ANET", "APH", "AVGO", "LRCX", "NVDA", "QCOM", "SMCI"],
    "laag": ["CMG", "CPRT", "CSX", "CTAS", "CVX", "DE", "FAST", "KO", "MNST", "NKE",
             "ODFL", "ORLY", "PG", "ROST", "SBUX", "SHW", "TJX", "TSCO", "UNP", "WMT"],
}
OTHER = ["AMZN", "BAC", "BRK-B", "DHR", "DXCM", "EW", "GILD", "IDXX", "ISRG", "NFLX",
         "TSLA", "UNH", "WFC", "WRB"]                              # not classifiable
TICKERS = sorted(OTHER + [t for group in GROUPS.values() for t in group])
assert len(TICKERS) == 50

prices = hap_data.yahoo(TICKERS, start="2002-01-01", end="2026-08-01")
market = hap_data.market_daily()["Mkt"]
rets = prices.pct_change(fill_method=None).loc["2010-01-01":]
dates = rets.index.intersection(market.index)
rets, mkt = rets.loc[dates], market.loc[dates]

port = pd.DataFrame({g: rets[t].mean(axis=1) for g, t in GROUPS.items()})
port["hoog - laag"] = port["hoog"] - port["laag"]
EVENT = dates.searchsorted(pd.Timestamp("2022-11-30"))
print(f"dag 0 = {dates[EVENT]:%Y-%m-%d}; {len(dates)} handelsdagen {dates[0]:%Y-%m-%d} t/m {dates[-1]:%Y-%m-%d}")
dag 0 = 2022-11-30; 4169 handelsdagen 2010-01-04 t/m 2026-07-31
Voor elke portefeuille schatten we een marktmodel op de dagen -280 tot -31, met 30 november 2022 als dag 0. Daarna tellen we de abnormale rendementen op over dag 0 tot en met 10.
def market_model_car(y, m, i0, lo=0, hi=10, est=(-280, -31)):  # TODO: naar hap.stats
    """CAR over [i0+lo, i0+hi] from a market model estimated on [i0+est0, i0+est1].

    The variance includes estimation error in alpha and beta (MacKinlay 1997).
    Returns CAR, its standard error, beta and the abnormal returns from est0 onwards.
    """
    e = np.arange(i0 + est[0], i0 + est[1] + 1)
    X = np.column_stack([np.ones(len(e)), m[e]])
    xtx_inv = np.linalg.inv(X.T @ X)
    coef = xtx_inv @ X.T @ y[e]
    resid = y[e] - X @ coef
    s2 = resid @ resid / (len(e) - 2)
    win = np.arange(i0 + lo, i0 + hi + 1)
    g = np.array([len(win), m[win].sum()])
    car = (y[win] - coef[0] - coef[1] * m[win]).sum()
    path = y[i0 + est[0]:] - coef[0] - coef[1] * m[i0 + est[0]:]
    return car, np.sqrt(s2 * (len(win) + g @ xtx_inv @ g)), coef[1], path


m_arr = mkt.to_numpy()
event_rows = {}
for col in port.columns:
    car, se, beta, _ = market_model_car(port[col].to_numpy(), m_arr, EVENT)
    event_rows[col] = {"CAR[0,+10]": car, "SE": se, "t": car / se, "beta": beta}
event_table = pd.DataFrame(event_rows).T
event_table.round(4)Het cumulatieve abnormale rendement van hoog min laag is 0,15%, met een standaardfout van 4,1 procentpunt. Met één eventdatum klopt die standaardfout alleen als het schattingsvenster representatief is. Daarom vergelijken we het event ook met alle niet-overlappende vensters van elf dagen sinds 2011, elk met een eigen marktmodel.
y_ls = port["hoog - laag"].to_numpy()
first = dates.searchsorted(pd.Timestamp("2011-03-01"))
placebo_days = [i for i in range(first, EVENT - 11, 11) if np.isfinite(y_ls[i - 280:i + 11]).all()]
placebo = np.array([market_model_car(y_ls, m_arr, i)[0] for i in placebo_days])
car_event = event_table.loc["hoog - laag", "CAR[0,+10]"]
pd.Series({
    "aantal placebovensters": len(placebo),
    "sd placebo-CAR": placebo.std(ddof=1),
    "SE uit marktmodel (event)": event_table.loc["hoog - laag", "SE"],
    "CAR event / sd placebo": car_event / placebo.std(ddof=1),
    "percentiel van event in placebo": (placebo < car_event).mean(),
    "CAR[-20,-1], vóór het event": market_model_car(y_ls, m_arr, EVENT, -20, -1)[0],
}).round(4)
aantal placebovensters 268.0000
sd placebo-CAR 0.0339
SE uit marktmodel (event) 0.0411
CAR event / sd placebo 0.0446
percentiel van event in placebo 0.5112
CAR[-20,-1], vóór het event -0.0847
dtype: float64Het event valt op het 51e percentiel van 268 placebovensters met een spreiding van 3,4 procentpunt. In de vier weken vóór de lancering had hoog min laag bovendien al 8,5% abnormaal verloren. De vraag bij de figuur is of de lijn na dag 0 de band verlaat.
Source
_, _, _, path = market_model_car(y_ls, m_arr, EVENT)
tau = np.arange(-280, len(path) - 280)
keep = (tau >= -20) & (tau <= 40)
cum = np.cumsum(path[keep]) - np.cumsum(path[keep])[tau[keep] == -1]      # zero at day -1
sd_day = placebo.std(ddof=1) / np.sqrt(11)
band = 1.96 * sd_day * np.sqrt(np.clip(tau[keep] + 1, 0, None))

fig, ax = plt.subplots()
ax.fill_between(tau[keep], cum - band, cum + band, alpha=0.2, label="95%-band vanaf dag 0 (placebo-spreiding)")
ax.plot(tau[keep], cum, label="cumulatief abnormaal rendement hoog − laag, nul op dag −1")
ax.axvline(0, color="black", lw=0.8)
ax.axvline(10, color="black", lw=0.8, ls="--")
ax.axhline(0, color="grey", lw=0.8)
ax.yaxis.set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:.0%}"))
ax.set_xlabel("Handelsdagen ten opzichte van 30 november 2022")
ax.set_ylabel("Cumulatief abnormaal rendement")
ax.set_title("Software en data versus fysiek werk rond de lancering van ChatGPT")
ax.legend(loc="upper left")
plt.show()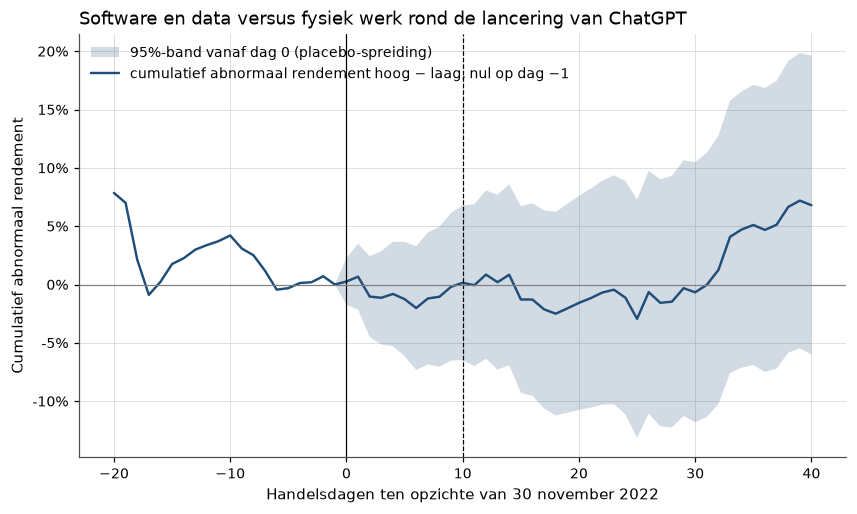
Figure 3:Cumulatief abnormaal rendement van acht software-, platform- en betalingsbedrijven minus twintig bedrijven met overwegend fysiek werk, nul op de dag vóór de lancering van ChatGPT. De band groeit met de wortel van de horizon en is geschaald op de spreiding van de placebovensters. De gestreepte lijn markeert dag 10.
De lijn blijft binnen de band, zodat ook de figuur geen koerseffect laat zien. De tabel zet het resultaat naast het origineel.
| grootheid | origineel | hier |
|---|---|---|
| cumulatief meerrendement hoog − laag, dag 0 t/m 10 | ruim 4% (0,4% per dag uit de samenvatting) | 0,15% |
| -waarde | niet vermeld voor dit venster | 0,04 |
| teken over dag 0 t/m 5 en dag 0 t/m 20 | positief | negatief |
Niet geslaagd, want over het afgesproken venster is het teken wel positief, maar met 0,15% en haalt de omvang de enkele procenten bij lange na niet. Het teken wisselt bovendien met het venster en met de hardwareaandelen, zoals de derde oefening laat zien. Met een ruis van 3,4 procentpunt over elf dagen zou zelfs een effect van 4% een -waarde van ruim 1 geven, en dat is de standaardfout van 2% in eventtijd. Daarnaast meten Eisfeldt, Schubert en Zhang blootstelling per bedrijf, met grote verschillen binnen sectoren. De replicatie zegt dus niet dat hun effect niet bestaat, maar wel dat het met gratis data van 50 aandelen niet te zien is.
6.2Snellere prijzen: autocorrelatie per decennium
Voor elk decennium sinds 1930 berekenen we de autocorrelatie van het dagelijkse log marktrendement en de variance ratio over vijf dagen met een robuuste -waarde. Daarnaast berekenen we de volatiliteit en de halfwaardetijd die (7) bij die autocorrelatie geeft, met 6,5 handelsuur per dag.
r_daily = np.log1p(hap_data.market_daily()["Mkt"])
decade_rows = []
for start in range(1930, 2030, 10):
    x = r_daily.loc[f"{start}-01-01":f"{start + 9}-12-31"]
    rho1 = x.autocorr(1)
    vr = hap.stats.variance_ratio(x, 5)
    decade_rows.append({
        "decennium": f"{start}s", "dagen": len(x), "rho1": rho1, "SE": 1 / np.sqrt(len(x)),
        "VR(5)": vr["vr"], "z VR(5) robuust": vr["z2"],
        "vol (jaar)": x.std() * np.sqrt(252),
        "halfwaardetijd (uur)": 6.5 * np.log(2) / -np.log(rho1) if rho1 > 0 else np.nan,
    })
decades = pd.DataFrame(decade_rows).set_index("decennium")
decades.round(3)De autocorrelatie is in de eerste zeven decennia positief en significant en piekt in de jaren zeventig op 0,29. Daarna daalt ze, tot onder nul in deze eeuw. De figuur laat zien welke decennia na 1990 buiten hun interval rond nul vallen.
Source
fig, ax = plt.subplots(figsize=(9, 4))
ax.bar(decades.index, decades["rho1"], yerr=1.96 * decades["SE"], capsize=3, color=hap.plotting.COLORS[0])
ax.axhline(0, color="black", lw=0.8)
ax.set_xlabel("Decennium")
ax.set_ylabel("Eerste-orde-autocorrelatie, dagrendement")
ax.set_title("De dagelijkse autocorrelatie van de Amerikaanse markt, 1930–2026")
plt.show()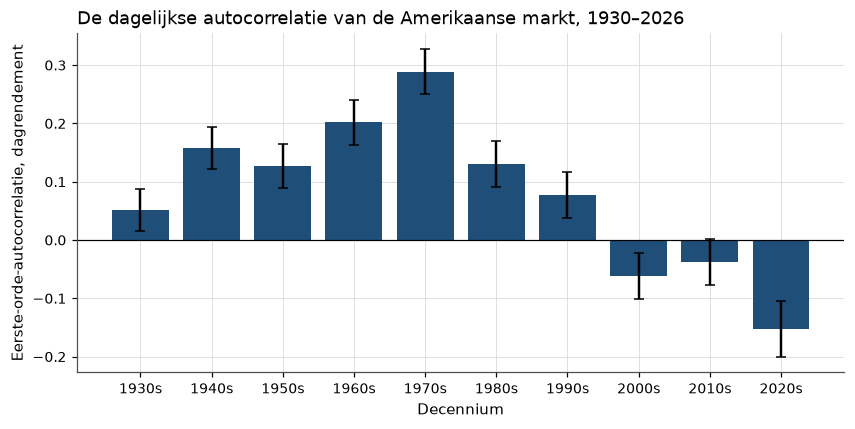
Figure 4:Eerste-orde-autocorrelatie van het dagelijkse log marktrendement (French, CRSP, waardegewogen) per decennium, met een 95%-interval onder de nulhypothese van onafhankelijkheid. Alleen de jaren 2020 liggen meer dan 0,1 onder nul, en de jaren 2000 vallen net buiten het interval.
De balk van de jaren 2020 ligt als enige meer dan 0,1 onder nul, en de volgende cel zet 2020 apart om te zien waar dat vandaan komt.
r_2020s = r_daily.loc["2020-01-01":].to_numpy()
pd.Series({
    "rho1, alleen 2020": r_daily.loc["2020-01-01":"2020-12-31"].autocorr(1),
    "rho1, 2021 t/m 2026-07": r_daily.loc["2021-01-01":].autocorr(1),
    "rangcorrelatie rho1, jaren 2020": stats.spearmanr(r_2020s[1:], r_2020s[:-1]).statistic,
}).round(3)
rho1, alleen 2020 -0.336
rho1, 2021 t/m 2026-07 -0.019
rangcorrelatie rho1, jaren 2020 -0.042
dtype: float64De negatieve autocorrelatie van de jaren 2020 komt vrijwel geheel uit de coronacrash, want 2020 alleen geeft en de jaren daarna . De tabel zet de meting naast de samenvatting van Santa-Clara.
| grootheid | origineel (Santa-Clara) | hier |
|---|---|---|
| halfwaardetijd rond 1970 | dagen | 3,6 handelsuur (jaren zeventig) |
| halfwaardetijd rond 2000 | uren | 1,8 handelsuur (jaren negentig) |
| autocorrelatie jaren 2020 | – | , zonder 2020 |
Gedeeltelijk geslaagd, want het maximum ligt vóór 1990, zoals verwacht, maar de jaren 2020 liggen met verder dan 0,1 van nul, al vindt de robuuste variance-ratiotoets daar geen significante afwijking (). Santa-Clara bedoelt bovendien de verwerking van nieuws per aandeel, terwijl onze maat voor de hele markt geldt, zodat de tabel alleen de richting vergelijkt. Onze halfwaardetijden zijn een bovengrens voor traagheid, omdat niet-synchrone handel in de oude index precies dit patroon geeft, en de daling valt samen met de komst van indexfutures (vanaf 1982) en ETF’s (vanaf 1993). Het resultaat is dus verenigbaar met snellere informatieverwerking, maar bewijst die niet.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Grossman en Stiglitz lossen de paradox uit het college over efficiënte markten op. Goedkopere informatie trekt meer geïnformeerden aan, maakt prijzen informatiever en laat het gemeten voordeel krimpen, zoals Lopez-Lira en Tang later rapporteerden. De dagelijkse autocorrelatie van de markt daalde van 0,29 in de jaren zeventig naar onder nul in deze eeuw, in lijn met snellere prijzen, en robo-advies leverde beter gespreide portefeuilles en minder gedragsvertekening op.
Waar het breekt. Het model breekt bij het marktniveau en bij de meting. Ook met snellere prijzen werd de markt niet rustiger. De jaarvolatiliteit van het dagrendement was 10% in de jaren vijftig en zestig, tegen 22% in het eerste decennium van deze eeuw, een decennium dat 2008 bevat. Grossman en Stiglitz zeggen hoe dicht een prijs bij het signaal ligt, maar niets over stromen die het niveau verplaatsen. Op het ene moment waarop we precies weten wanneer de nieuwe machine kwam, meten we met 50 aandelen geen koerseffect. Als beleggers ten slotte zelf uit honderden voorspellers leren en het ware model niet kennen, verliest het begrip efficiëntie zijn houvast, want dat begrip veronderstelt prijzen die verwachtingen zijn onder het ware model Martin & Nagel (2022).
Risico of vergissing? In de Chicago-lezing, waarin de markt rationeel waardeert, is de koersreactie op ChatGPT een herwaardering van kasstromen en discontovoeten. Het voordeel van geïnformeerden is dan een vergoeding voor kosten en risico, zoals in de simulatie, en het crashrisico van gedeelde modellen is risico met een premie. In de Yale-lezing, waarin beleggers zich vergissen, is dezelfde reactie aandacht en geldstroom Barber et al. (2022), en is de monocultuur de crowding van Stein (2009), een vergissing die niemand ziet. De posities en modellen van AI-gedreven fondsen zouden de lezingen kunnen scheiden, net als de kasstromen van blootgestelde bedrijven sinds de lancering. De eerste zijn echter niet openbaar, en de tweede reeks is nog te kort. Santa-Clara vat zijn loopbaan samen in het motto uit Opzet, data en conventies: wat hij blijvend verdiende, kwam uit het dragen van risico met een premie, en wat hij verloor, uit de gedachte iets te weten wat de prijs niet wist. Voor taalmodellen volgt daaruit dat een model dat krantenkoppen leest, vertelt wat de prijs al weet zodra veel beleggers dezelfde score gebruiken.
Wat er daarna kwam. Hier eindigt de geschiedenis en begint de balans. Welke uitspraken na anderhalve eeuw overeind staan, en hoe zeker we van elk ervan zijn, onderzoekt Wat we weten.
8Oefeningen
Solution to Exercise 1
(1) Nu is en nog steeds , dus blijft gelijk en . Meer ruis maakt informatie aantrekkelijker, en er treden beleggers toe tot de informativiteit weer op het niveau staat waar informatie precies waard is.
(2) zodra , dus zodra . Met geeft dat , en voor is .
print("sigma_z^2 = 0.08:", np.round(gs_equilibrium(np.log(1.5) / 4, a, var_s, var_e, 0.08)[:2], 4))
nu_toy = a**2 * var_e**2 * var_z / var_s
c_star = np.log1p(var_s / var_e * nu_toy / (1 + nu_toy)) / (2 * a)
lam_around = [round(float(gs_equilibrium(c, a, var_s, var_e, var_z)[0]), 4) for c in (c_star * 0.99, c_star * 1.01)]
print(f"c* = {c_star:.4f}; lambda net onder en boven c*: {lam_around}")
sigma_z^2 = 0.08: [0.5657 0.5 ]
c* = 0.0323; lambda net onder en boven c*: [1.0, 0.9939]
De oefening laat zien waarom goedkope informatie de prijs maar tot een grens informatiever maakt. Onder doet iedereen al mee, en wat de prijs dan nog tegenhoudt, is risicoaversie en geen kostprijs.
Solution to Exercise 2
(1) De marktportefeuille heeft fout met variantie . In de tweede portefeuille valt weg, en de fout is het verschil van twee gemiddelden van onafhankelijke ’s, met variantie .
(2) De simulatie volgt beide formules.
rows = []
for K in [2, 10, 100, 1000]:
    g = rng.standard_normal((20_000, 1))
    eta = rng.standard_normal((20_000, K))
    e = g + eta
    long_short = e[:, :K // 2].mean(1) - e[:, K // 2:].mean(1)
    rows.append({"K": K, "markt, simulatie": e.mean(1).var(), "markt, theorie": 1 + 1 / K,
                 "koop-verkoop, simulatie": long_short.var(), "koop-verkoop, theorie": 4 / K})
pd.DataFrame(rows).set_index("K").round(3)(3) De relatieve fout gaat met naar nul, terwijl de geaggregeerde fout blijft. Een beter model verkleint , maar geen aantal aandelen of arbitrageurs haalt weg. Het marktniveau wordt dus alleen efficiënter als de modellen verschillender worden, niet als ze beter worden.
Solution to Exercise 3
def placebo_sd(y, length):
    days = [i for i in range(first, EVENT - length, length) if np.isfinite(y[i - 280:i + length]).all()]
    return np.std([market_model_car(y, m_arr, i, 0, length - 1)[0] for i in days], ddof=1)


hoog_plus = rets[GROUPS["hoog"] + GROUPS["hardware"]].mean(axis=1) - port["laag"]
windows = [("hoog - laag", y_ls, lo, hi) for lo, hi in [(-5, -1), (0, 5), (0, 10), (0, 20)]]
windows.append(("hoog+hardware - laag", hoog_plus.to_numpy(), 0, 10))
rows = []
for name, y, lo, hi in windows:
    car, se, _, _ = market_model_car(y, m_arr, EVENT, lo, hi)
    rows.append({"portefeuille": name, "venster": f"[{lo},{hi}]", "CAR": car, "SE model": se,
                 "sd placebo": placebo_sd(y, hi - lo + 1)})
sens = pd.DataFrame(rows)
sens["CAR / sd placebo"] = sens["CAR"] / sens["sd placebo"]
sens.round(4)Geen variant komt verder dan ruim een halve placebo-standaarddeviatie van nul. Het teken wisselt met het venster, de hardwareaandelen maken het , en de placebo vóór het event () is niet te onderscheiden van de echte vensters. Bij alle keuzes blijft alleen de omvang van de ruis staan, ruim drie procentpunt over elf dagen. Een event study met één datum en een paar dozijn aandelen kan een effect van de gepubliceerde omvang dus bevestigen noch verwerpen.
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Grossman, S. J., & Stiglitz, J. E. (1980). On the Impossibility of Informationally Efficient Markets. American Economic Review, 70(3), 393–408.
- Eisfeldt, A. L., Schubert, G., & Zhang, M. B. (2023). Generative AI and Firm Values (NBER Working Paper No. 31222). National Bureau of Economic Research. 10.3386/w31222
- Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT Forecast Stock Price Movements? Return Predictability and Large Language Models. Working paper, SSRN. 10.2139/ssrn.4412788
- Cao, S., Jiang, W., Yang, B., & Zhang, A. L. (2023). How to Talk When a Machine Is Listening: Corporate Disclosure in the Age of AI. The Review of Financial Studies, 36(9), 3603–3642. 10.1093/rfs/hhad021
- Gabaix, X., & Koijen, R. S. J. (2021). In Search of the Origins of Financial Fluctuations: The Inelastic Markets Hypothesis (NBER Working Paper No. 28967). National Bureau of Economic Research. 10.3386/w28967
- Koijen, R. S. J., & Yogo, M. (2019). A Demand System Approach to Asset Pricing. Journal of Political Economy, 127(4), 1475–1515. 10.1086/701683
- Stein, J. C. (2009). Presidential Address: Sophisticated Investors and Market Efficiency. The Journal of Finance, 64(4), 1517–1548. 10.1111/j.1540-6261.2009.01472.x
- Khandani, A. E., & Lo, A. W. (2011). What Happened to the Quants in August 2007? Evidence from Factors and Transactions Data. Journal of Financial Markets, 14(1), 1–46. 10.1016/j.finmar.2010.07.005
- Fama, E. F., Fisher, L., Jensen, M. C., & Roll, R. (1969). The Adjustment of Stock Prices to New Information. International Economic Review, 10(1), 1–21. 10.2307/2525569
- Busse, J. A., & Green, T. C. (2002). Market Efficiency in Real Time. Journal of Financial Economics, 65(3), 415–437. 10.1016/S0304-405X(02)00148-4
- Lopez-Lira, A., & Tang, Y. (2026). Can ChatGPT Forecast Stock Price Movements? Return Predictability and Large Language Models. Journal of Financial Economics, 184, 104335. 10.1016/j.jfineco.2026.104335
- Barber, B. M., & Odean, T. (2000). Trading Is Hazardous to Your Wealth: The Common Stock Investment Performance of Individual Investors. The Journal of Finance, 55(2), 773–806. 10.1111/0022-1082.00226
- D’Acunto, F., Prabhala, N., & Rossi, A. G. (2019). The Promises and Pitfalls of Robo-Advising. The Review of Financial Studies, 32(5), 1983–2020. 10.1093/rfs/hhz014
- Barber, B. M., Huang, X., Odean, T., & Schwarz, C. (2022). Attention-Induced Trading and Returns: Evidence from Robinhood Users. The Journal of Finance, 77(6), 3141–3190. 10.1111/jofi.13183
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD