

Brennan-Schwartz, Vasicek, CIR en Longstaff-Schwartz
1Overzicht
Hoe krijgt een obligatie een prijs als de korte rente niet te koop is? We hedgen de obligatie met andere obligaties die van dezelfde renteschok afhangen, zodat alle obligaties dezelfde vergoeding per eenheid risico moeten bieden. Met één bron van onzekerheid bewegen alle rentes echter samen, terwijl de curve in de data drie factoren heeft. Met hetzelfde argument bepalen we ook de waarde van een mijn die mag sluiten en van een Amerikaanse optie. In dit college:
rekenen we een obligatie in een renteboom uit;
leiden we af dat één marktprijs van risico de prijs van alle obligaties bepaalt, met de formules van Vasicek en CIR, en passen we hetzelfde argument kort toe op een mijn en op Amerikaanse opties;
simuleren we hoe goed veertig jaar maanddata de rentedynamiek vastleggen;
zetten we Vasicek en CIR, geschat op de driemaandsrente, naast de waargenomen curve, en repliceren we Litterman en Scheinkman Litterman & Scheinkman (1991) en tabel 1 van Longstaff en Schwartz Longstaff & Schwartz (2001).
In 1977 liet Vasicek (1977) met een arbitrageargument zien dat alle obligaties dezelfde vergoeding per eenheid renterisico bieden, en hij gaf een formule voor de hele curve. Acht jaar later leidden Cox et al. (1985) een positieve rente af uit een evenwicht. Daartussen voegden Brennan & Schwartz (1979) de lange yield als tweede factor toe, maar hun model is alleen numeriek op te lossen. In 1992 bouwden Longstaff & Schwartz (1992) een tweefactormodel dat wel gesloten formules heeft. In 1996 lieten Duffie & Kan (1996) zien wat Vasicek, CIR en Longstaff-Schwartz delen, namelijk dat ze affien zijn (de log-prijs van een obligatie is lineair in de factoren). Toegepast op een grondstof werd dezelfde wiskunde de theorie van real options (opties in een project, zoals wachten, sluiten of opgeven) Brennan & Schwartz (1985)McDonald & Siegel (1986). De lijn eindigt bij least-squares Monte Carlo (LSM, dat de waarde van doorgaan schat met een regressie op gesimuleerde paden). Zo werd Black-Scholes een methode voor alles wat van een onzekere toestand afhangt. Santa-Clara noemt dit de UCLA-lijn, naar zijn mentoren Brennan en Schwartz Santa-Clara (2026).
Op de vraag theorie of feit is het antwoord dat deze modellen, net als Black-Scholes, relatieve waarderingsregels zijn. Ze zeggen wat een obligatie waard is gegeven het renteproces en één marktprijs van risico. Daarom toetsen we ze op de correlatie tussen rentes en op de vorm van de curve.
2Intuïtie: waarom zou dit waar zijn?
De korte rente is een prijs en geen activum, zodat niemand de rente kan kopen om een obligatie na te maken. Vasiceks uitweg was dat alle obligaties met dezelfde renteschok bewegen. Een handelaar die een lange obligatie koopt en in de juiste verhouding een kortere verkoopt, heft die schok op en moet dan de korte rente verdienen. Daarom bieden beide obligaties hetzelfde extra rendement per eenheid risico. Die ene verhouding, de marktprijs van risico, is alles wat de markt over voorkeuren hoeft te vertellen.
Trekt de rente terug naar een gemiddelde, dan hangt de vorm van de curve af van waar de rente nu staat. Onzekerheid duwt lange yields omlaag, omdat een verre euro bij een rentedaling meer in waarde wint dan hij bij een even grote stijging verliest. Een beloning voor renterisico duwt ze juist omhoog.
Een kopermijn is een reeks opties op koper, want de eigenaar delft als de prijs de kosten dekt en sluit als dat niet zo is. Een netto contante waarde met de verwachte koperprijs rekent alsof de mijn in verliesjaren doorwerkt, en onderschat daardoor de waarde van de mijn. Wie vandaag investeert, geeft bovendien de keuze op om te wachten.
Een Amerikaanse optie wordt uitgeoefend zodra dat meer oplevert dan doorgaan. Longstaff en Schwartz schatten de waarde van doorgaan met een regressie op gesimuleerde paden, maar een geschatte uitoefenregel is nooit beter dan de beste regel.
Voor de curve volgen daaruit twee verwachtingen, en die toetst de replicatie. Lange yields liggen onder de verwachte korte rente als alleen onzekerheid telt, maar erboven als beleggers een beloning voor renterisico vragen. Met één bron van onzekerheid bewegen bovendien alle rentes perfect samen. De mijn en de Amerikaanse optie werken we daarna kort uit, als toepassingen van hetzelfde argument.
3Toy-voorbeeld: een renteboom van drie perioden
Alle bibliotheken die dit college gebruikt, laden we hier in één keer.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import statsmodels.api as sm
from scipy import optimize, stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. De korte rente per periode heet , want is in de reeks het netto simpele rendement. In de renteboom, naar Ho & Lee (1986), begint op 5% en gaat ze elke periode met risiconeutrale kans drie procentpunt omhoog of omlaag. We zoeken de prijs van een obligatie die op één euro uitkeert.
| 5% | 8% / 2% | 11% / 5% / -1% |
Het recept. We rekenen van achteren naar voren, want een claim is op de verwachte waarde in de volgende knopen waard, gedeeld door . De theorie leidt die regel af als (1).
Stap 1: de obligatie op . Eén periode voor de vervaldag is de obligatie , of waard. Dat is de euro van , verdisconteerd tegen de rente van de knoop waarin we staan.
Stap 2: de obligatie op . We middelen de twee waarden erna en verdisconteren tegen de rente van de knoop. In de hoge knoop geeft dat , in de lage .
Stap 3: de obligatie vandaag. . Op dezelfde manier is .
Stap 4: de yields. De yield is het rendement per jaar tot de vervaldag, bij een looptijd van jaar. Op één, twee en drie jaar is dat 5,000%, 4,957% en 4,886%. De curve daalt dus, terwijl de verwachte korte rente overal 5% is. Dat komt doordat bol is in , en dat heet het convexiteitseffect.
De code loopt de boom van achteren naar voren door en zet de handberekening ernaast.
i_tree = [np.array([0.05]), np.array([0.08, 0.02]), np.array([0.11, 0.05, -0.01])]
q_rate = 0.5


def roll_back(values, rates):
    """Discount next-period node values one step back in a recombining rate tree."""
    return q_rate * (values[:-1] + values[1:]) / (1 + rates)


bond_t2 = 1 / (1 + i_tree[2])                      # zero paying 1 at t = 3, valued at t = 2
bond_t1 = roll_back(bond_t2, i_tree[1])
bond_t0 = roll_back(bond_t1, i_tree[0])[0]
bond2_t0 = roll_back(1 / (1 + i_tree[1]), i_tree[0])[0]   # zero paying 1 at t = 2
zero_prices = [1 / (1 + i_tree[0][0]), bond2_t0, bond_t0]
yields_toy = [(1 / p) ** (1 / n) - 1 for n, p in zip([1, 2, 3], zero_prices)]

hand = {"p op t=1, hoge knoop": 0.858001, "p op t=1, lage knoop": 0.962001,
        "p(0,2)": 0.907771, "p(0,3)": 0.866668, "yield 2 jaar (%)": 4.957,
        "yield 3 jaar (%)": 4.886}
code = {"p op t=1, hoge knoop": bond_t1[0], "p op t=1, lage knoop": bond_t1[1],
        "p(0,2)": bond2_t0, "p(0,3)": bond_t0, "yield 2 jaar (%)": round(100 * yields_toy[1], 3),
        "yield 3 jaar (%)": round(100 * yields_toy[2], 3)}
pd.DataFrame({"met de hand": hand, "code": code}).round(6)De tabel laat het mechanisme in het klein zien. Omdat onzekerheid over de rente een verre euro duurder maakt dan de verwachte rente zegt, ligt de driejaarsyield 0,114 procentpunt onder de verwachte korte rente. Oefening 4 rekent met dezelfde methode de waarde uit van een mijn die mag sluiten.
4Theorie
Het college draait om de termijnstructuur. We leiden eerst af dat één renteschok alle obligaties dezelfde marktprijs van risico geeft, zodat elke prijs aan één partiële differentiaalvergelijking voldoet. Daarna volgt de affiene oplossing, met Vasicek en CIR, en wat die modellen over de curve voorspellen, want dat toetsen simulatie en replicatie. Ten slotte passen we hetzelfde argument kort toe op een mijn en op Amerikaanse opties (LSM).
4.1Opzet en notatie
Vanaf hier is de instantane korte rente: de continu samengestelde rente op een oneindig korte lening, bijvoorbeeld 5% per jaar. Een constante rente, bij de mijn en bij LSM, heet ook . is de prijs op van een nulcouponobligatie (één euro op , verder niets), de looptijd en de yield van die obligatie. Partiële afgeleiden schrijven we als , en . Vasiceks , en (geen risiconeutrale kans) heten hier , en . De aannames:
de korte rente is de enige toestandsvariabele, en volgt onder de werkelijke kansen ;
obligaties van elke looptijd worden continu verhandeld, zonder transactiekosten, en verkopen zonder ze te bezitten (short gaan) mag;
er is geen arbitrage.
4.2Obligatieprijzen als risiconeutrale verwachting
Waarom maakt onzekerheid over de rente een obligatie duurder? Een obligatie kost de verwachte discontering van één euro, en omdat die discontering bol is in de rente, verhogen renteschommelingen die verwachting. Dat de prijs een verwachting is, volgt uit een vergelijking met een belegger die zijn geld elke dag tegen de korte rente uitzet. Hij weet vooraf niet wat hij over tien jaar heeft, terwijl een obligatie een vast bedrag belooft, maar onder risiconeutrale kansen leveren beide gemiddeld hetzelfde op.
Volgens de fundamentele stelling, (5), is elke arbitragevrije prijs een verdisconteerde verwachting onder een martingaalmaat. Met een payoff van één euro en continue discontering wordt dat
De obligatie kost dus de risiconeutrale verwachting van de disconteringsfactor over de looptijd, met de risiconeutrale maat uit Black-Scholes-Merton en de CBOE. Met de stochastische discontofactor (SDF) (het gewicht van een euro in elke toekomstige toestand) is die prijs de verwachte .
Omdat bol is, geldt (Jensens ongelijkheid), zodat onzekerheid de prijs verhoogt en de yield verlaagt. In de boom scheelde dat procentpunt op drie jaar. Uit (1) volgt ook dat een termijnstructuurmodel niets anders is dan een keuze voor het proces van onder .
4.3Het kernresultaat: één marktprijs van risico
Waarom zou dit waar zijn? Een handelaar koopt een tienjaarsobligatie en verkoopt een tweejaarsobligatie. Stijgt de rente, dan verliest hij op de eerste en wint hij op de tweede, en in de juiste verhouding heffen winst en verlies elkaar op. De positie is dan zonder risico en moet de korte rente opleveren. Biedt de tienjaarsobligatie per eenheid risico meer, dan koopt iedereen die obligatie, zodat de prijs stijgt tot het verschil weg is.
Om die positie door te rekenen, hebben we het verwachte rendement en de volatiliteit van een obligatie nodig. Het lemma van Itô uit Theorem 1, de kettingregel plus kromming maal variantie, geeft voor
Hier is het verwachte rendement van de obligatie en de volatiliteit. Omdat een obligatie daalt als de rente stijgt (), is positief.
In woorden: het extra rendement per eenheid volatiliteit is voor elke looptijd hetzelfde. Het bewijs is niets anders dan de positie van de handelaar.
Proof 1
Neem twee looptijden en houd euro in obligatie 1 en in obligatie 2 (aanname 2). De positie verandert met . Met verdwijnt de enige schok (aanname 1), en moet de positie verdienen (aanname 3): . Invullen van geeft . Omdat en willekeurig waren, hangt deze verhouding niet van de looptijd af.
De stelling legt een voorwaarde op de afgeleiden van de obligatieprijs. Invullen van en in geeft namelijk de termijnstructuur-PDE:
Tijdsverval, drift en kromming maal variantie leveren samen dus de korte rente op. In (4) verdween de drift, omdat het aandeel zelf in de hedge zat. De rente is geen activum, en daarom blijft hier de risiconeutrale drift staan. Volgens Feynman-Kac (Proposition 1) is de oplossing een verdisconteerde verwachting: (1).
Het verwachte extra rendement van een obligatie is . Een positieve geeft dus een termijnpremie (term premium), omdat een lange obligatie naar verwachting meer verdient dan een reeks korte. Bij en 5% volatiliteit is die premie in het verwachte rendement procentpunt per jaar. Eén getal vertelt dus alles wat de markt over voorkeuren hoeft te zeggen, precies zoals de handelaar uit de intuïtie liet zien. Vasicek nam constant.
4.4De affiene klasse: Duffie en Kan
Wanneer is de log-prijs van een obligatie lineair in de rente? Denk aan een belegger die een obligatie houdt terwijl de rente één procentpunt stijgt. Stijgen drift en variantie van de rente onder lineair met de rente, dan verliest hij daarbij op elk renteniveau hetzelfde percentage, zodat de log-prijs lineair in de rente daalt.
De functie is de gevoeligheid van de log-prijs voor de korte rente, dus een soort duration (de procentuele prijsdaling per procentpunt rentestijging), terwijl het verwachte pad van de rente en het convexiteitseffect vangt. De yield is dus affien (lineair plus een constante) in . De vergelijking voor is een Riccati-vergelijking (met een kwadratische term), en als bekend is, is die voor een gewone integraal.
Proof 2
Duffie & Kan (1996) bewezen de stelling voor een vector factoren , bijvoorbeeld de korte rente en de volatiliteit van die rente, en dan is . Vasicek, CIR en Longstaff-Schwartz zijn speciale gevallen. Met maar één factor volgt er echter een scherpe voorspelling.
Elke yield beweegt dus met een vast veelvoud van dezelfde schok, en daarmee klopt de verwachting dat alle rentes perfect samen bewegen. De replicatie zet die voorspelling tegen de data.
4.5Vasicek: een terugtrekkende rente met normale schokken
Het eenvoudigste affiene model is een rente die als een veer terugtrekt en schokken van vaste grootte krijgt. Staat de rente boven het gemiddelde, dan trekt de drift de rente omlaag. Omdat de schokken normaal zijn, is ook de som van de rentes over de looptijd normaal, en voor een normale is bekend.
Vasicek nam en een constante . Hier is de snelheid van terugtrekken, bijvoorbeeld 0,15 per jaar (halfwaardetijd jaar), het gemiddelde, bijvoorbeeld 5%, en de volatiliteit, bijvoorbeeld 1,5% per jaar. Onder is de drift , met . In Theorem 2 is dus , , en .
Proof 3
De lange yield is het gemiddelde , plus de termijnpremie in de lange yield , min het convexiteitseffect . Met de getallen hierboven en komt dat uit op . Zonder beloning () ligt de lange yield dus onder en met beloning erboven, zoals de intuïtie verwachtte.
Die premie in de lange yield is iets anders dan de premie in het verwachte rendement van 1,5 procentpunt hierboven, die gold voor een obligatie met 5% volatiliteit. Een oneindig lange obligatie heeft volatiliteit , en dan vallen de twee premies samen, want . Stijgt , dan stijgt de premie lineair en het convexiteitseffect kwadratisch. Stijgt , dan krimpen beide, omdat verre rentes minder onzeker zijn. Op de korte rente reageert de lange yield niet.
De rente is stationair normaal verdeeld, met standaarddeviatie , hier 2,7%, en kan dus negatief worden. In 1977 gold dat als een schoonheidsfout, maar na 2014, toen Duitse en Zwitserse staatsobligaties een negatieve rente hadden, werd het een eigenschap.
4.6Cox, Ingersoll en Ross: de vierkantswortel
Cox, Ingersoll en Ross maken de variantie evenredig met de rente. Bij is de schok dan nul, terwijl de drift de rente omhoog duwt, zodat de rente niet onder nul zakt.
Cox et al. (1985) namen . De rente raakt nul nooit als , de Feller-voorwaarde. Het model valt in Theorem 2 met en . Met een marktprijs van risico is de risiconeutrale drift , met , en
De vorm is dezelfde als bij Vasicek, maar hangt ook van de volatiliteit af, via de hulpgrootheid (0,16 bij de simulatiegetallen hieronder), die bepaalt hoe snel naar zijn limiet loopt. De oneindig lange yield is . Bij ligt het risiconeutrale gemiddelde boven , wat een positieve termijnpremie betekent. Bij ligt het eronder, en dan is de premie negatief.
De code zet de yieldformules van beide modellen om in twee functies.
def vasicek_yield(i_now, tau, kappa, theta, sigma, lam):
    """Continuously compounded Vasicek zero yield; lam > 0 means a positive term premium."""
    theta_q = theta + lam * sigma / kappa
    B = (1 - np.exp(-kappa * tau)) / kappa
    A = (theta_q - sigma**2 / (2 * kappa**2)) * (B - tau) - sigma**2 * B**2 / (4 * kappa)
    return (B * i_now - A) / tau


def cir_yield(i_now, tau, kappa, theta, sigma, kappa_q):
    """Continuously compounded CIR zero yield with risk-neutral mean reversion kappa_q."""
    h = np.sqrt(kappa_q**2 + 2 * sigma**2)
    denom = (h + kappa_q) * (np.exp(h * tau) - 1) + 2 * h
    B = 2 * (np.exp(h * tau) - 1) / denom
    A = (2 * kappa * theta / sigma**2) * np.log(2 * h * np.exp((kappa_q + h) * tau / 2) / denom)
    return (B * i_now - A) / tau
Beide functies geven een continu samengestelde yield. Ze werken ook op arrays van looptijden en rentes, zodat één aanroep een hele curve oplevert.
4.7Wat het voorspelt: paden en curves
Vasicek laat de rente onder nul zakken en CIR niet, en in beide modellen lopen alle curves naar dezelfde lange yield. Een exacte simulatie laat beide eigenschappen zien. We nemen , (de startrente van de boom) en . Vasicek krijgt en CIR dezelfde volatiliteit bij . Daarmee simuleren we 5000 paden van dertig jaar vanaf 2%.
vas = dict(kappa=0.15, theta=0.05, sigma=0.015, lam=0.3)    # parameters from the theory
sigma_cir = vas["sigma"] / np.sqrt(vas["theta"])              # same volatility at i = theta


def simulate_vasicek(i0, kappa, theta, sigma, dt, n_steps, n_paths, rng):
    """Exact simulation of an Ornstein-Uhlenbeck short rate."""
    a = np.exp(-kappa * dt)
    sd = sigma * np.sqrt((1 - a**2) / (2 * kappa))
    rate = np.empty((n_paths, n_steps + 1))
    rate[:, 0] = i0
    for t in range(n_steps):
        rate[:, t + 1] = theta + a * (rate[:, t] - theta) + sd * rng.standard_normal(n_paths)
    return rate


def simulate_cir(i0, kappa, theta, sigma, dt, n_steps, n_paths, rng):
    """Exact simulation of a CIR short rate via the noncentral chi-square transition."""
    c = sigma**2 * (1 - np.exp(-kappa * dt)) / (4 * kappa)
    df = 4 * kappa * theta / sigma**2
    rate = np.empty((n_paths, n_steps + 1))
    rate[:, 0] = i0
    for t in range(n_steps):
        rate[:, t + 1] = c * rng.noncentral_chisquare(df, rate[:, t] * np.exp(-kappa * dt) / c)
    return rate
De tweede cel simuleert en vat de paden samen, met voor CIR.
dt_m, years = 1 / 12, 30
paths_vas = simulate_vasicek(0.02, vas["kappa"], vas["theta"], vas["sigma"], dt_m, 12 * years, 5000, rng)
paths_cir = simulate_cir(0.02, vas["kappa"], vas["theta"], sigma_cir, dt_m, 12 * years, 5000, rng)
kappa_q_cir = vas["kappa"] - vas["lam"] * sigma_cir
h_cir = np.sqrt(kappa_q_cir**2 + 2 * sigma_cir**2)
term_premium = vas["lam"] * vas["sigma"] / vas["kappa"]
convexity = vas["sigma"]**2 / (2 * vas["kappa"]**2)
long_yield = {"Vasicek": vas["theta"] + term_premium - convexity,
              "CIR": 2 * vas["kappa"] * vas["theta"] / (h_cir + kappa_q_cir)}

pd.DataFrame(
    {
        name: [np.mean(paths.min(axis=1) < 0), np.mean(paths < 0), paths.min(), long_yield[name]]
        for name, paths in [("Vasicek", paths_vas), ("CIR", paths_cir)]
    },
    index=["fractie paden ooit negatief", "fractie maanden negatief", "laagste rente",
           "oneindig lange yield"],
).round(4)Ruim de helft van de Vasicek-paden (58%) zakt minstens één maand onder nul, en de laagste rente in de tabel is . Geen enkel CIR-pad komt daarentegen onder nul.
De oneindig lange yield ligt bij CIR met 5,2% ruim onder de 7,5% van Vasicek, vooral omdat de prijs van risico bij CIR is en niet . Bij is dat maar .
Let in de figuur rechts op waar de curves van één model heen lopen.
Source
tau_grid = np.linspace(0.25, 30, 120)
fig, axes = plt.subplots(1, 2, figsize=(11, 4.5))
months = np.arange(paths_vas.shape[1]) / 12
for k in range(15):
    axes[0].plot(months, 100 * paths_vas[k], color=hap.plotting.COLORS[0], lw=0.7, alpha=0.7)
    axes[0].plot(months, 100 * paths_cir[k], color=hap.plotting.COLORS[1], lw=0.7, alpha=0.7)
axes[0].axhline(0, color="black", lw=0.8)
axes[0].plot([], [], color=hap.plotting.COLORS[0], label="Vasicek")
axes[0].plot([], [], color=hap.plotting.COLORS[1], label="CIR")
axes[0].set_title("Vijftien paden van de korte rente, start op 2%")
axes[0].set_xlabel("Jaren")
axes[0].set_ylabel("Korte rente (%)")
axes[0].legend()

for i0, ls in [(0.01, "-"), (0.05, "--"), (0.09, ":")]:
    axes[1].plot(tau_grid, 100 * vasicek_yield(i0, tau_grid, vas["kappa"], vas["theta"], vas["sigma"], vas["lam"]),
                 color=hap.plotting.COLORS[0], ls=ls, label=f"Vasicek, i = {i0:.0%}")
    axes[1].plot(tau_grid, 100 * cir_yield(i0, tau_grid, vas["kappa"], vas["theta"], sigma_cir, kappa_q_cir),
                 color=hap.plotting.COLORS[1], ls=ls, label=f"CIR, i = {i0:.0%}")
axes[1].set_title("Modelcurves bij drie korte rentes")
axes[1].set_xlabel("Looptijd (jaren)")
axes[1].set_ylabel("Yield (%)")
axes[1].legend(ncol=2)
plt.show()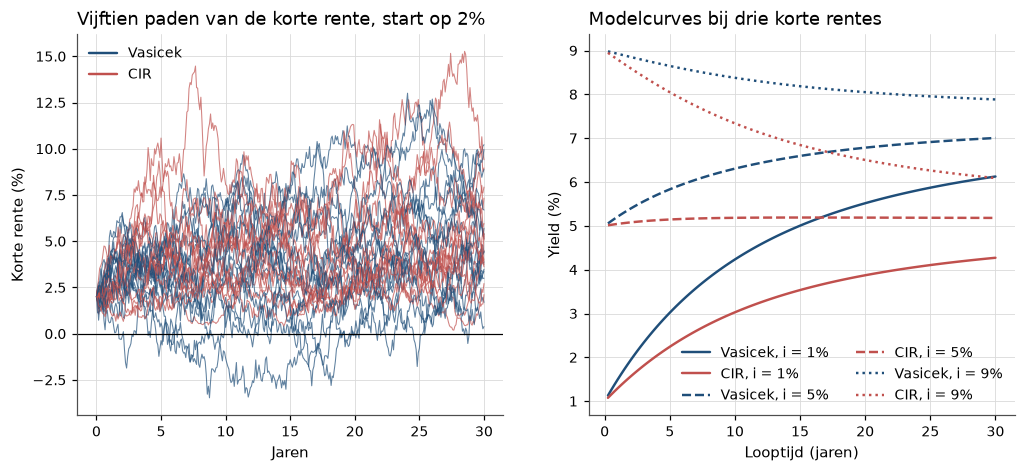
Figure 1:Links zakken Vasicek-paden onder nul en CIR-paden niet. Rechts bepaalt de korte rente de vorm, maar alle curves van één model lopen naar dezelfde lange yield.
4.8Hetzelfde argument voor een mijn: real options
Het arbitrageargument werkt ook voor een mijn. Een mijneigenaar die termijncontracten op koper verkoopt, hedget zijn koperrisico, zodat de gehedgede mijn de rente moet verdienen, zoals bij Black en Scholes. Wie koper in voorraad heeft, geniet wel de convenience yield (het voordeel van het fysiek bezitten van de grondstof), en die verlaagt de risiconeutrale groei van de koperprijs, net als een dividend.
Laat , met de convenience yield, bijvoorbeeld 1% per jaar. Brennan en Schwartz noemen de convenience yield , maar die letter is hier de snelheid van terugtrekken. Onder groeit de koperprijs met . Een open mijn produceert pond per jaar tegen kosten per pond (niet de en van de affiene stelling). Zonder vaste kosten, belastingen en uitputting voldoet de waarde van de mijn aan
In woorden: dit is de PDE van Black en Scholes met groei en een dividend per jaar, dat een gesloten mijn mist. Waar de eigenaar opent of sluit, verschillen de waarden van open en gesloten mijn precies de wisselkosten (value matching) en zijn ze even steil (smooth pasting). De keuze om te sluiten maakt de mijn meer waard dan de netto contante waarde zegt, in de koperboom van oefening 4 bijna twee keer zoveel.
De getallen van Brennan en Schwartz, en de drempel van McDonald en Siegel
Brennan & Schwartz (1985) losten het volledige model numeriek op. De tabel vat de invoer en de uitkomsten uit hun tabellen 1 en 2 samen.
| grootheid | Brennan en Schwartz |
|---|---|
| voorraad, productie, variabele kosten | 15 jaar, 10 miljoen pond per jaar, 50 dollarcent per pond |
| convenience yield, variantie koperprijs, rente | 1%, 8%, 10% per jaar |
| openen / sluiten / opgeven bij een koperprijs van | 76 / 44 / 20 dollarcent |
| waarde van de keuze om te sluiten, bij 50 cent | 0,89 miljoen dollar, 12% van een mijn die altijd produceert |
Een investering vandaag geeft ook de keuze op om later, met meer informatie, te beslissen. Voor een project met waarde (een nieuwe , niet de mijnwaarde) die onder met groeit en volatiliteit heeft, en onomkeerbare kosten , vonden McDonald & Siegel (1986) de drempel
Voor het bewijs schrijven we de optie om te investeren als , met de positieve wortel van . Value matching () en smooth pasting () geven samen . is de elasticiteit van de optiewaarde naar . Bij en is , dus , terwijl de netto contante waarde zegt. Meer onzekerheid verhoogt de drempel, omdat wachten dan meer oplevert, en een hogere verlaagt de drempel, omdat wachten dan meer gemiste opbrengst kost.
4.9Hetzelfde argument voor een Amerikaanse optie: LSM
De houder van een Amerikaanse put kiest op elk moment tussen uitoefenen en doorgaan. Doorgaan is de verwachte waarde van zijn latere kasstromen waard, en een regressie op gesimuleerde paden schat die verwachting. Voorspelt de regressie slecht, dan oefent hij soms verkeerd uit, zodat de waarde daalt.
Laat de put met uitoefenprijs uitoefenbaar zijn op momenten . Doorgaan is op waard (vergelijking 1 van Longstaff & Schwartz (2001)):
met de kasstroom op onder de optimale strategie en de informatie op . LSM schat op , dan , enzovoort, met een regressie van de verdisconteerde latere kasstroom op basisfuncties van . Alleen paden in het geld gaan de regressie in, en een pad wordt uitgeoefend waar de geschatte overtreft.
Met veel paden en vaste coëfficiënten benadert LSM de optiewaarde dus van onderen, omdat een geschatte uitoefenregel nooit beter is dan de beste (Proposition 1 in hetzelfde artikel). De replicatie toetst die ondergrens met één tabel.
5Simulatie: hoe goed is de rentedynamiek te schatten?
Veertig jaar maanddata leggen de volatiliteit van de rente tot op enkele procenten vast, maar de snelheid van terugtrekken niet eens tot op een factor twee. De replicatie heeft met 55 jaar iets meer data, maar dat de drift ook dan slecht gemeten blijft, laat de -waarde van daar zien. Hoe goed kan de replicatie de parameters schatten, als het model klopt?
Per maand is de Vasicek-rente een AR(1)-proces: de rente van volgende maand is een constante plus maal de rente van nu, plus een normale schok, met bij . Omdat die schok normaal is en voor elke maand even groot, is kleinste kwadraten precies maximum likelihood. We trekken 2000 steekproeven van 40 jaar uit het model van de theorie en schatten het model op elke steekproef.
def fit_vasicek(rate, dt):
    """Exact-discretisation (AR(1) OLS) Vasicek estimates; works on the last axis."""
    x, y = rate[..., :-1], rate[..., 1:]
    xm, ym = x.mean(-1, keepdims=True), y.mean(-1, keepdims=True)
    b = ((x - xm) * (y - ym)).sum(-1) / ((x - xm) ** 2).sum(-1)
    c = ym[..., 0] - b * xm[..., 0]
    resid_sd = (y - c[..., None] - b[..., None] * x).std(-1)
    kappa = -np.log(b) / dt
    return kappa, c / (1 - b), resid_sd * np.sqrt(2 * kappa / (1 - b**2))


samples = simulate_vasicek(vas["theta"], vas["kappa"], vas["theta"], vas["sigma"], dt_m, 480, 2000, rng)
k_hat, th_hat, s_hat = fit_vasicek(samples, dt_m)
yinf_hat = th_hat + vas["lam"] * s_hat / k_hat - s_hat**2 / (2 * k_hat**2)
yinf_true = long_yield["Vasicek"]

estimates_sim = np.array([k_hat, th_hat, s_hat, yinf_hat])
pd.DataFrame(
    {
        "waar": [vas["kappa"], vas["theta"], vas["sigma"], yinf_true],
        "5%-kwantiel": np.percentile(estimates_sim, 5, axis=1),
        "mediaan": np.percentile(estimates_sim, 50, axis=1),
        "95%-kwantiel": np.percentile(estimates_sim, 95, axis=1),
    },
    index=["kappa", "theta", "sigma", "lange yield"],
).round(4)Tussen het 5%- en het 95%-kwantiel is bijna drie keer zo breed verspreid als de ware waarde groot is, terwijl daar maar een tiende van zijn ware waarde beslaat. De lange yield erft de onzekerheid van de drift, en zijn interval beslaat bijna zes procentpunt.
Let in de figuur links op de breedte en de lange rechterstaart, rechts op hoe smal de verdeling is.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].hist(k_hat, bins=60, range=(0, 1), color=hap.plotting.COLORS[0], edgecolor="white")
axes[0].axvline(vas["kappa"], color="black", lw=1.2, label="ware waarde")
axes[0].axvline(np.median(k_hat), color=hap.plotting.COLORS[1], ls="--", lw=1.2, label="mediaan schatting")
axes[0].set_title("Snelheid van terugtrekken $\\hat\\kappa$, 40 jaar maanddata")
axes[0].set_xlabel("$\\hat\\kappa$ (per jaar)")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].legend()
axes[1].hist(100 * s_hat, bins=60, color=hap.plotting.COLORS[2], edgecolor="white")
axes[1].axvline(100 * vas["sigma"], color="black", lw=1.2, label="ware waarde")
axes[1].set_title("Volatiliteit $\\hat\\sigma$, dezelfde steekproeven")
axes[1].set_xlabel("$\\hat\\sigma$ (% per jaar)")
axes[1].set_ylabel("Aantal steekproeven")
axes[1].legend()
plt.show()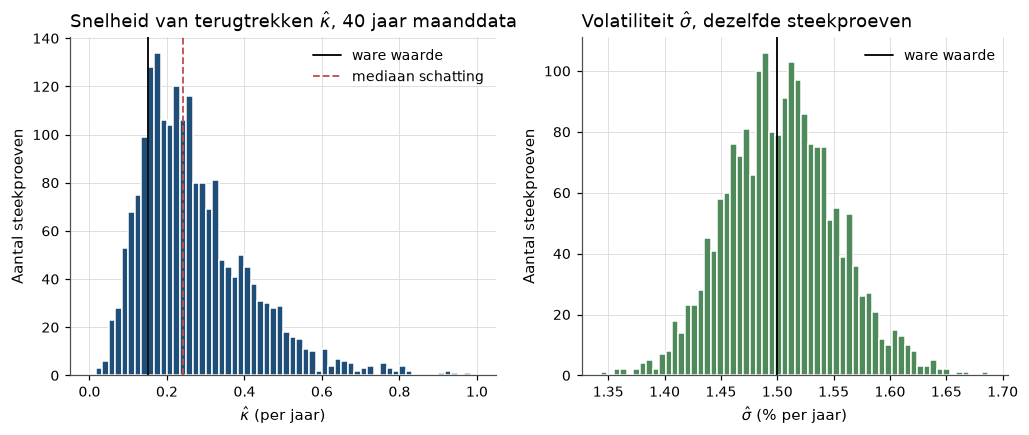
Figure 2:De verdeling links is breed en scheef, rond een te hoge mediaan. De verdeling rechts is smal en ligt rond de ware waarde.
Hetzelfde patroon zagen we in Rendementen en hun statistiek, waar een gemiddeld aandelenrendement na een eeuw maar op twee procentpunt vastligt, terwijl de variantie scherp gemeten is. Ook hier wordt de drift alleen beter gemeten met een langere periode, maar de volatiliteit met elke extra maand.
De mediaan van ligt met 0,24 ruim boven de ware waarde van 0,15, omdat een geschatte AR(1)-coëfficiënt in een korte steekproef naar beneden vertekend is. Een lagere geeft een hogere , zodat een persistente rente sneller lijkt terug te trekken dan ze in werkelijkheid doet.
6Replicatie op echte data
6.1Vasicek en CIR op de driemaandsrente
We schatten Vasicek als AR(1), met standaardfouten via de deltamethode (de standaardfout van een functie van geschatte parameters, berekend via de afgeleiden van die functie). CIR schatten we met maximum likelihood op de niet-centrale -dichtheid van de overgang.
short = (hap_data.fred("TB3MS")["TB3MS"] / 100).loc["1971-08":]   # 3-month T-bill, monthly average
short.index = short.index + pd.offsets.MonthEnd(0)
dt_m = 1 / 12

# Vasicek: exact AR(1) with delta-method standard errors
ols = sm.OLS(short.values[1:], sm.add_constant(short.values[:-1])).fit()
c_hat, b_hat = ols.params
cov_cb = ols.cov_params()
kappa_v = -np.log(b_hat) / dt_m
theta_v = c_hat / (1 - b_hat)
sigma_v = np.std(ols.resid, ddof=2) * np.sqrt(2 * kappa_v / (1 - b_hat**2))
grad_kappa = np.array([0.0, -1 / (b_hat * dt_m)])
grad_theta = np.array([1 / (1 - b_hat), c_hat / (1 - b_hat) ** 2])
se_kappa_v = np.sqrt(grad_kappa @ cov_cb @ grad_kappa)
se_theta_v = np.sqrt(grad_theta @ cov_cb @ grad_theta)


# CIR: maximum likelihood with the noncentral chi-square transition density
def cir_negloglik(log_params, x, dt):
    kappa, theta, sigma = np.exp(log_params)
    c = 2 * kappa / (sigma**2 * (1 - np.exp(-kappa * dt)))
    df = 4 * kappa * theta / sigma**2
    nonc = 2 * c * x[:-1] * np.exp(-kappa * dt)
    return -np.sum(np.log(2 * c) + stats.ncx2.logpdf(2 * c * x[1:], df, nonc))


fit_cir = optimize.minimize(cir_negloglik, np.log([0.2, 0.04, 0.08]), args=(short.values, dt_m),
                            method="Nelder-Mead", options={"maxiter": 4000, "xatol": 1e-8, "fatol": 1e-8})
kappa_c, theta_c, sigma_c = np.exp(fit_cir.x)

pd.DataFrame(
    {
        "Vasicek": [kappa_v, theta_v, sigma_v, se_kappa_v, se_theta_v, np.nan],
        "CIR": [kappa_c, theta_c, sigma_c, np.nan, np.nan, 2 * kappa_c * theta_c / sigma_c**2],
    },
    index=["kappa", "theta", "sigma", "SE kappa", "SE theta", "Feller 2*kappa*theta/sigma^2"],
).round(4)De tabel bevestigt de simulatie, want de volatiliteit ligt scherp vast en de drift niet. De snelheid van terugtrekken heeft bij Vasicek een -waarde van maar , en het gemiddelde heeft een standaardfout van twee procentpunt. Ook bij de rente stuiten we dus op de standaardfout van 2%, want na 55 jaar data is het gemiddelde nog nauwelijks bekend. De Feller-verhouding van CIR ligt net boven één, omdat de rente jarenlang bij nul lag.
6.2De modelcurve naast de waargenomen curve
De marktprijs van risico is alleen uit de curve af te lezen. Daarom kiezen we per model één constante (voor CIR één ) die de kwadratische afstand tot de GSW-yields van 1 tot 10 jaar over alle maanden minimaliseert.
gsw_month = hap_data.gsw().resample("ME").last()
maturities = np.arange(1, 31)
yield_cols = [f"SVENY{m:02d}" for m in maturities]
curves = gsw_month[yield_cols].loc["1971-08":]
common = curves.index.intersection(short.index)
fit_block = curves.loc[common, yield_cols[:10]]
mask = fit_block.notna().to_numpy()
i_now = short.loc[common].to_numpy()[:, None]
tau10 = maturities[None, :10].astype(float)


def mse_vasicek(lam):
    model = vasicek_yield(i_now, tau10, kappa_v, theta_v, sigma_v, lam)
    return np.mean((model - fit_block.to_numpy())[mask] ** 2)


def mse_cir(kappa_q):
    model = cir_yield(i_now, tau10, kappa_c, theta_c, sigma_c, kappa_q)
    return np.mean((model - fit_block.to_numpy())[mask] ** 2)


lam_v = optimize.minimize_scalar(mse_vasicek, bounds=(-5, 5), method="bounded")
kq_c = optimize.minimize_scalar(mse_cir, bounds=(-0.5, 1.0), method="bounded")

dates = ["1981-09-30", "2000-06-30", "2008-12-31", "2021-06-30", str(common[-1].date())]
rows = []
for date in dates:
    i_date = short.loc[date]
    for m in (1, 5, 10):
        rows.append({
            "datum": date[:7], "looptijd": m,
            "GSW": curves.loc[date, f"SVENY{m:02d}"],
            "Vasicek": vasicek_yield(i_date, m, kappa_v, theta_v, sigma_v, lam_v.x),
            "CIR": cir_yield(i_date, m, kappa_c, theta_c, sigma_c, kq_c.x),
        })
fit_table = pd.DataFrame(rows).set_index(["datum", "looptijd"])
fit_table["fout Vasicek"] = fit_table["Vasicek"] - fit_table["GSW"]
fit_table["fout CIR"] = fit_table["CIR"] - fit_table["GSW"]
print(f"Vasicek: lambda = {lam_v.x:.3f}, RMSE = {1e4 * np.sqrt(lam_v.fun):.0f} bp, "
      f"lange yield = {vasicek_yield(0.0, 1e4, kappa_v, theta_v, sigma_v, lam_v.x):.2%}")
print(f"CIR: kappa* = {kq_c.x:.3f}, RMSE = {1e4 * np.sqrt(kq_c.fun):.0f} bp")
(100 * fit_table).round(2)
Vasicek: lambda = 0.351, RMSE = 115 bp, lange yield = 8.31%
CIR: kappa* = -0.021, RMSE = 124 bp
De tabel geeft yields in procenten. Beide modellen zitten gemiddeld ruim een procentpunt naast de curve. Hun grootste fouten liggen aan de lange kant, in 1981, 2008 en 2021. In de figuur gaat het daarom om de afstand tussen de zwarte lijn en de modellen aan de lange kant.
Source
fig, axes = plt.subplots(2, 3, figsize=(12, 7.5))
tau_fine = np.linspace(0.25, 30, 120)
for ax, date in zip(axes.flat, dates):
    obs = curves.loc[date].dropna()
    i_date = short.loc[date]
    ax.plot(maturities[: len(obs)], 100 * obs.to_numpy(), color="black", lw=2, label="GSW")
    ax.plot(tau_fine, 100 * vasicek_yield(i_date, tau_fine, kappa_v, theta_v, sigma_v, lam_v.x),
            color=hap.plotting.COLORS[0], label="Vasicek")
    ax.plot(tau_fine, 100 * cir_yield(i_date, tau_fine, kappa_c, theta_c, sigma_c, kq_c.x),
            color=hap.plotting.COLORS[1], ls="--", label="CIR")
    ax.scatter([0.25], [100 * i_date], color=hap.plotting.COLORS[3], zorder=3, label="3-mnd rente")
    ax.set_title(date[:7])
    ax.set_xlabel("Looptijd (jaren)")
    ax.set_ylabel("Yield (%)")
axes.flat[0].legend()

ax = axes.flat[5]
ten = curves.loc[common, "SVENY10"]
ax.plot(ten.index, 100 * ten, color="black", lw=1.2, label="GSW 10 jaar")
ax.plot(common, 100 * vasicek_yield(short.loc[common].to_numpy(), 10.0, kappa_v, theta_v, sigma_v, lam_v.x),
        color=hap.plotting.COLORS[0], lw=1, label="Vasicek 10 jaar")
ax.set_title("10-jaarsyield door de tijd")
ax.set_xlabel("Jaar")
ax.set_ylabel("Yield (%)")
ax.legend()
fig.suptitle("Eenfactormodellen met constante marktprijs van risico naast de GSW-curve")
plt.tight_layout()
plt.show()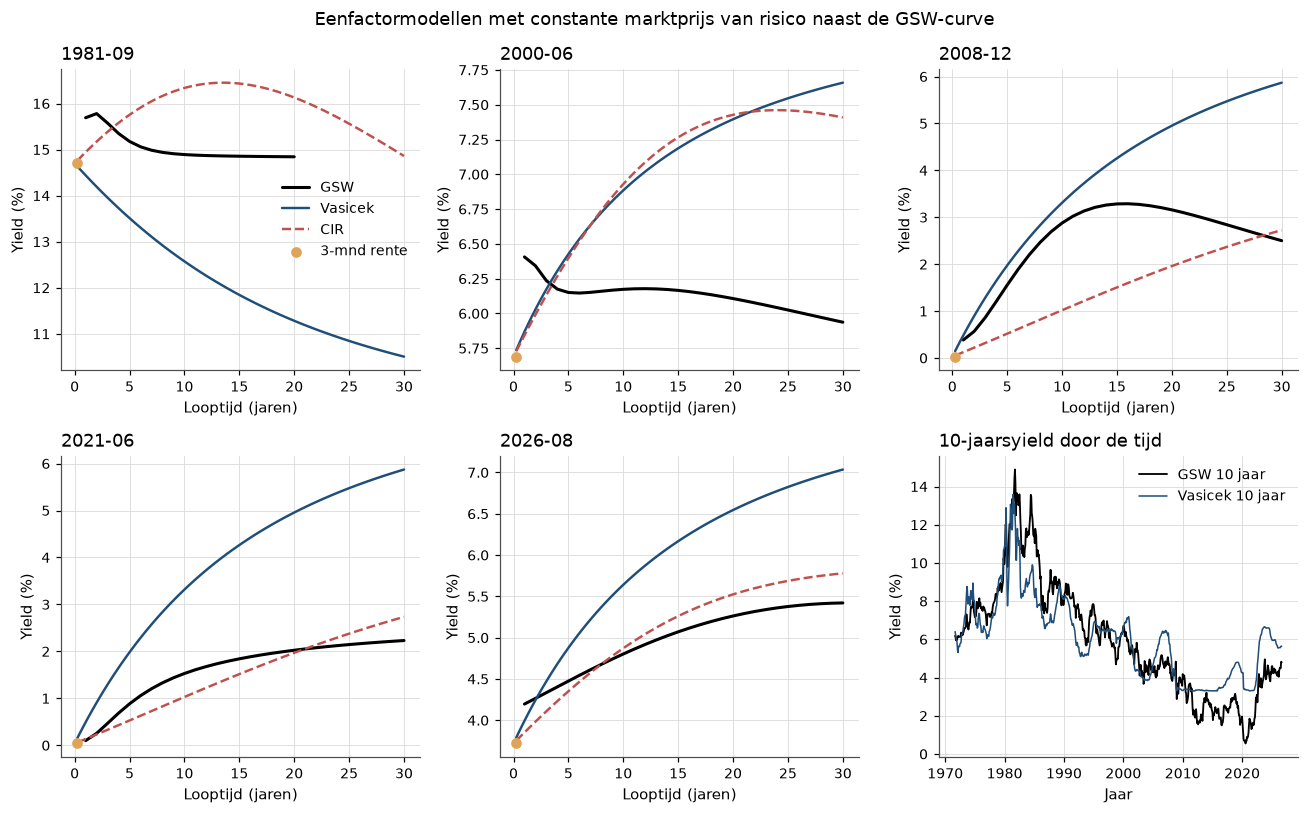
Figure 3:De panelen zetten Vasicek en CIR op vijf datums naast de GSW-curve. Rechtsonder: de 10-jaarsyield van het model volgt de korte rente, de waargenomen 10-jaarsyield beweegt trager en zelfstandig.
Vasicek zet de lange yield vast op één getal, hier 8,3%. Daardoor kan het model een hoge lange yield niet verklaren samen met een hoge korte rente (1981), en evenmin een lage lange yield samen met een korte rente van nul (2021).
CIR maakt de omgekeerde fout. Bij een hoge rente stijgt de curve te steil (1981), en bij een rente van nul schakelt de vierkantswortel de volatiliteit uit, zodat de curve te vlak blijft (2008). Beide fouten volgen uit Corollary 1, want met één factor kan de lange kant niet los van de korte bewegen.
6.3Drie factoren: level, slope en curvature
Drijft één factor de curve, dan vindt een principale-componentenanalyse op yieldveranderingen één component. We voeren die analyse uit op maandelijkse veranderingen van 1 tot 10 en van 1 tot 30 jaar, en vinden er drie, die Litterman en Scheinkman level, slope en curvature noemden (niveau, helling en kromming).
pca_cols = yield_cols[:10]
changes = curves[pca_cols].dropna().diff().dropna()
eigval, eigvec = np.linalg.eigh(np.cov(changes.to_numpy().T))
order = np.argsort(eigval)[::-1]
eigval, eigvec = eigval[order], eigvec[:, order]
sign_at_10y = np.sign(eigvec[-1])        # eigenvectors have arbitrary sign
eigvec = eigvec * sign_at_10y            # orient: positive loading at 10 years

long_changes = curves[yield_cols].dropna().diff().dropna()
eigval_30 = np.sort(np.linalg.eigvalsh(np.cov(long_changes.to_numpy().T)))[::-1]

pca_table = pd.DataFrame(
    {
        "Litterman-Scheinkman 1991": [89.5, 8.5, 2.0, 98.4],
        f"hier, 1-10 jaar, {changes.index[0]:%Y-%m}–{changes.index[-1]:%Y-%m}":
            np.append(100 * eigval[:3] / eigval.sum(), 100 * eigval[:3].sum() / eigval.sum()),
        f"hier, 1-30 jaar, {long_changes.index[0]:%Y-%m}–{long_changes.index[-1]:%Y-%m}":
            np.append(100 * eigval_30[:3] / eigval_30.sum(), 100 * eigval_30[:3].sum() / eigval_30.sum()),
    },
    index=["factor 1 (level)", "factor 2 (slope)", "factor 3 (curvature)", "totaal drie factoren"],
).round(1)
corr_1_10 = changes["SVENY01"].corr(changes["SVENY10"])
print(f"correlatie van maandelijkse veranderingen 1 en 10 jaar: {corr_1_10:.2f} (eenfactormodel: 1)")
pca_table
correlatie van maandelijkse veranderingen 1 en 10 jaar: 0.69 (eenfactormodel: 1)
De verdeling tot 30 jaar is bijna die van Litterman en Scheinkman. De iets hogere totalen komen deels door de Svensson-curve van GSW (een gladde functie met zes parameters, per dag door de waargenomen yields gelegd), die ruis uit de kleine componenten filtert. De correlatie tussen 1- en 10-jaarsveranderingen is 0,69 en dus ver van één. In de figuur gaat het erom hoe vaak elke lijn van teken wisselt.
Source
fig, ax = plt.subplots()
labels = ["level", "slope", "curvature"]
for j in range(3):
    ax.plot(np.arange(1, 11), eigvec[:, j], marker="o", label=f"component {j + 1} ({labels[j]})")
ax.axhline(0, color="black", lw=0.8)
ax.set_title("Ladingen van de eerste drie principale componenten van yieldveranderingen")
ax.set_xlabel("Looptijd (jaren)")
ax.set_ylabel("Lading")
ax.legend()
plt.show()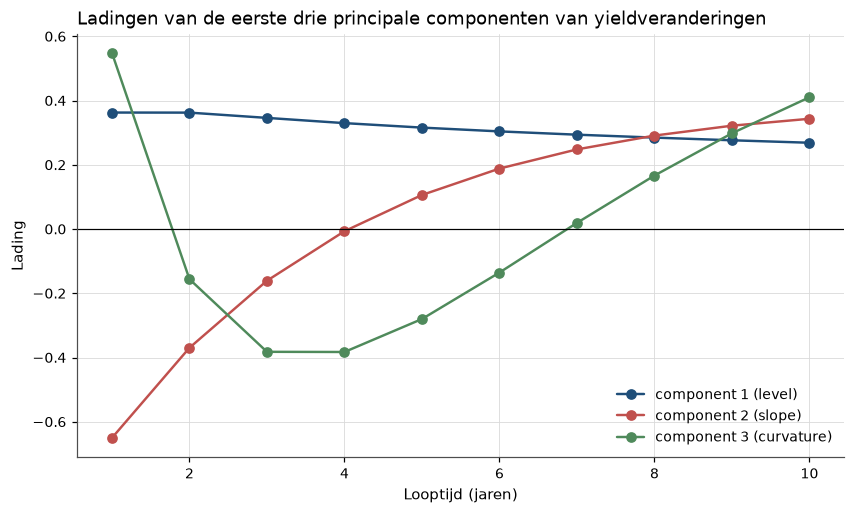
Figure 4:De eerste component heeft positieve ladingen op alle looptijden, licht aflopend: een bijna parallelle verschuiving (level). De tweede verandert tussen vier en vijf jaar van teken, zodat kort en lang tegengesteld bewegen (slope). De derde is positief aan beide uiteinden en negatief in het midden (curvature). Het zijn dezelfde drie vormen als in figuur 2 van Litterman en Scheinkman.
De tabel zet de uitkomsten naast wat we vooraf verwachtten.
first_pc_one_sign = bool(np.all(eigvec[:, 0] > 0))
second_pc_sign_changes = int(np.sum(np.diff(np.sign(eigvec[:, 1])) != 0))
error_1981 = fit_table.loc[("1981-09", 10), "fout Vasicek"]
error_2021 = fit_table.loc[("2021-06", 10), "fout Vasicek"]
pd.DataFrame(
    {
        "verwacht": ["> 95", "> 95", "ja", "1", "duidelijk < 1", "> 1", "> 1", "ja"],
        "hier": [pca_table.iloc[3, 1], pca_table.iloc[3, 2], "ja" if first_pc_one_sign else "nee",
                 second_pc_sign_changes, round(corr_1_10, 2), round(100 * abs(error_1981), 2),
                 round(100 * abs(error_2021), 2), "ja" if error_1981 * error_2021 < 0 else "nee"],
    },
    index=["drie componenten, 1-10 jaar (%)", "drie componenten, 1-30 jaar (%)",
           "component 1: één teken", "component 2: tekenwisselingen", "correlatie 1 en 10 jaar",
           "|fout Vasicek| 10 jaar, 1981 (pp)", "|fout Vasicek| 10 jaar, 2021 (pp)",
           "fouten tegengesteld van teken"],
)Geslaagd. Alles wat we vooraf verwachtten komt uit, want drie componenten verklaren 99,9% en 98,9%, de correlatie ligt ver onder één, en Vasicek zit in 1981 en 2021 ruim een procentpunt naast de curve, in tegengestelde richting. Omdat de eerste component negen tiende verklaart, was Vasicek toch een bruikbare benadering.
6.4LSM tegen een binomiale boom
De put uit tabel 1 van Longstaff en Schwartz heeft , , , en , en is vijftig keer per jaar uitoefenbaar. Als maatstaf dient een binomiale boom van 5000 stappen waarin elke honderdste stap uitoefenbaar is. LSM gebruikt 100.000 paden, waarvan de helft antithetisch is (elk pad met zijn spiegelbeeld). De regressoren zijn een constante en nul tot drie gewogen Laguerre-polynomen van : veeltermen in , vermenigvuldigd met , zodat de regressie goed geconditioneerd blijft.
def binomial_put(S0, K, rate, sigma, T, n_steps, exercise_every=1):
    """CRR binomial American/Bermudan put; exercise allowed every `exercise_every` steps."""
    dt = T / n_steps
    up = np.exp(sigma * np.sqrt(dt))
    q = (np.exp(rate * dt) - 1 / up) / (up - 1 / up)
    disc = np.exp(-rate * dt)
    S = S0 * up ** np.arange(n_steps, -n_steps - 1, -2)
    V = np.maximum(K - S, 0.0)
    for step in range(n_steps - 1, -1, -1):
        S = S[:-1] / up
        V = disc * (q * V[:-1] + (1 - q) * V[1:])
        if step % exercise_every == 0:
            V = np.maximum(V, K - S)
    return V[0]


def lsm_put(S0, K, rate, sigma, T, n_exercise, n_paths, n_laguerre, rng):
    """Longstaff-Schwartz LSM value of a Bermudan put with antithetic paths.

    Regressors: a constant plus the first `n_laguerre` weighted Laguerre polynomials
    of S/K (the scaling keeps the regression well conditioned).
    """
    dt = T / n_exercise
    z = rng.standard_normal((n_paths // 2, n_exercise))
    z = np.vstack([z, -z])
    S = S0 * np.exp(np.cumsum((rate - 0.5 * sigma**2) * dt + sigma * np.sqrt(dt) * z, axis=1))
    cash = np.maximum(K - S[:, -1], 0.0)
    when = np.full(len(S), n_exercise)
    for k in range(n_exercise - 1, 0, -1):
        payoff = K - S[:, k - 1]
        itm = payoff > 0
        x = S[itm, k - 1] / K
        y = cash[itm] * np.exp(-rate * dt * (when[itm] - k))
        w = np.exp(-x / 2)
        basis = np.column_stack([np.ones_like(x), w, w * (1 - x), w * (1 - 2 * x + x**2 / 2)])
        design = basis[:, : n_laguerre + 1]
        coef, *_ = np.linalg.lstsq(design, y, rcond=None)
        exercise_now = payoff[itm] > design @ coef           # exercise beats continuation
        idx = np.flatnonzero(itm)[exercise_now]              # paths that exercise at step k
        cash[idx], when[idx] = payoff[idx], k
    pv = cash * np.exp(-rate * dt * when)
    return pv.mean(), pv.std(ddof=1) / np.sqrt(len(pv))
De tweede cel rekent boom, Black-Scholes-put en LSM uit en zet ze naast het artikel.
bermudan_tree = binomial_put(36, 40, 0.06, 0.20, 1.0, 5000, exercise_every=100)
d1 = (np.log(36 / 40) + (0.06 + 0.02) * 1.0) / 0.20
european_bs = 40 * np.exp(-0.06) * stats.norm.cdf(-(d1 - 0.20)) - 36 * stats.norm.cdf(-d1)

lsm = {}
for n_lag in range(4):
    lsm[n_lag] = lsm_put(36, 40, 0.06, 0.20, 1.0, 50, 100_000, n_lag, rng)

pd.DataFrame(
    {
        "origineel": [4.478, 3.844, np.nan, np.nan, np.nan, 4.472, 0.010],
        "hier": [bermudan_tree, european_bs] + [lsm[n][0] for n in range(4)] + [lsm[3][1]],
    },
    index=["Bermuda-put: eindige differenties / boom", "Europese put",
           "LSM, constante", "LSM, constante + 1 Laguerre", "LSM, constante + 2 Laguerre",
           "LSM, constante + 3 Laguerre", "standaardfout LSM (3 Laguerre)"],
).round(4)Geslaagd. Boom en Europese put vallen samen met het artikel. LSM met drie polynomen ligt 0,005 boven de boom, binnen één standaardfout, en dat botst niet met Proposition 3. De stelling geldt voor vaste coëfficiënten, terwijl LSM de coëfficiënten schat op dezelfde paden waarop het ze toepast, zodat de regel een beetje vooruitkijkt en de waarde licht naar boven vertekent. Met minder basisfuncties ligt LSM duidelijk onder de boom, met alleen een constante zelfs bijna vijftien cent.
7Wat er brak, en wat daarna kwam
Wat de modellen verklaren. De modellen verklaren veel, en dat is zo gebleven. Eén arbitrageargument geeft elke obligatie en obligatieoptie een consistente prijs, en sinds Duffie en Kan is elk later model een keuze van factoren. Dezelfde PDE maakte van investeringen opties, en LSM maakte Amerikaanse opties op veel factoren rekenbaar. De eerste principale component verklaart 89% van de variantie.
Waar het breekt. Eén factor met een constante marktprijs van risico past niet tegelijk op kort en lang, want Vasicek zit met de 10-jaarsyield in 1981 2,3 procentpunt te laag en in 2021 1,8 te hoog. Bovendien correleren veranderingen in de 1- en 10-jaarsyield 0,69 en niet één. Daaronder ligt de standaardfout van 2% in rentevorm, want de drift is na ruim vijftig jaar nauwelijks gemeten ( voor ).
Risico of vergissing? De Chicago-lezing (prijzen belonen risico dat door de tijd varieert) zegt dat de marktprijs van risico niet constant is. Na tien jaar inflatie eisten beleggers in 1981 een hoge vergoeding voor renterisico, in 2021 een lage, en de fout is een gemeten risicopremie. De Yale-lezing (prijzen wijken af door vergissingen en beperkte arbitrage) zegt dat beleggers recente inflatie extrapoleren, of dat pensioenfondsen en centrale banken kopen ongeacht de prijs. Om beide lezingen te scheiden, is de stochastische discontofactor in crises als 1979–1981, 2008 en 2022 nodig, maar zulke crises zijn te schaars. Wie in 1981 een lange obligatie tegen 15% kocht, kreeg volgens Santa-Clara een vergoeding voor risico, of zag iets wat de markt over het hoofd zag. Uit de data valt niet op te maken welke van de twee het was.
Wat er daarna kwam. De termijnpremie wordt later een eigen onderwerp van onderzoek (Fama-Bliss, Cochrane-Piazzesi en het string-model). Eerst keert het vak echter terug naar de cross-sectie, waar Fama en French de anomalieën van Basu, Banz en Rosenberg in één regressie samenbrachten: Fama-French 1992/1993.
8Oefeningen
Solution to Exercise 1
(1) Op ligt de obligatie overal boven 0,87. Op levert uitoefenen in de hoge knoop , en doorgaan niets. Op levert uitoefenen , en wachten . Omdat wachten meer oplevert, wacht de houder, en de put is waard.
(2) Nul, om dezelfde reden als op hierboven. De code rekent beide na.
K_put = 0.87
put_t2 = np.maximum(K_put - bond_t2, 0.0)
continue_t1 = roll_back(put_t2, i_tree[1])
put_t1 = np.maximum(K_put - bond_t1, continue_t1)
continue_t0 = roll_back(put_t1, i_tree[0])[0]
pd.Series({
    "uitoefenen op t=1, hoge knoop": K_put - bond_t1[0],
    "direct uitoefenen op t=0": K_put - bond_t0,
    "wachten op t=0": continue_t0,
    "Amerikaanse put": max(K_put - bond_t0, continue_t0),
    "Europese put, expiratie t=2": roll_back(continue_t1, i_tree[0])[0],
}).round(6).to_frame("waarde")Een obligatie trekt dus naar de nominale waarde, zodat het renterisico met de tijd krimpt, en een obligatieoptie vraagt daarom een model van de hele curve. Dezelfde keuze tussen uitoefenen en doorgaan neemt LSM met een regressie.
:::{exercise}
:label: ex-termijnstructuur-real-options-2

**Afleiding: Vasicek zonder Riccati.** Neem onder $\mathbb{Q}$
$\mathrm{d}i = \kappa(\theta^{*} - i)\,\mathrm{d}t + \sigma\,\mathrm{d}W^{\mathbb{Q}}$.

1. Laat zien dat $X = \int_t^T i_s\,\mathrm{d}s$ normaal verdeeld is met gemiddelde
   $\theta^{*}\tau + (i_t - \theta^{*})B(\tau)$ en variantie
   $\sigma^2\big[(\tau - B)/\kappa^2 - B^2/(2\kappa)\big]$. Leid daaruit
   [](#eq-termijnstructuur-real-options-vasicek) af.
2. Controleer het met Monte Carlo: 20.000 paden met dagelijkse stappen, $\kappa = 0{,}15$,
   $\theta = 5\%$, $\sigma = 1{,}5\%$, $\lambda = 0{,}3$, $i_0 = 2\%$ en $\tau = 5$.
3. Hoeveel verlaagt het convexiteitseffect de 30-jaarsyield en de oneindig lange yield?
Solution to ex-termijnstructuur-real-options-2
(1) De oplossing van de Ornstein-Uhlenbeck-vergelijking is . Integreren en de integratievolgorde verwisselen geeft . Dat is normaal, met variantie uit het bewijs van Proposition 1. Met volgt
(2) en (3) De code simuleert de rente onder en integreert die met de trapeziumregel.
kappa, theta, sigma, lam, i0, tau = 0.15, 0.05, 0.015, 0.3, 0.02, 5.0
theta_q = theta + lam * sigma / kappa
n_paths, n_steps = 20_000, 252 * 5
step = tau / n_steps
a = np.exp(-kappa * step)
sd = sigma * np.sqrt((1 - a**2) / (2 * kappa))
rate = np.full(n_paths, i0)
integral = np.zeros(n_paths)
for _ in range(n_steps):
    rate_next = theta_q + a * (rate - theta_q) + sd * rng.standard_normal(n_paths)
    integral += 0.5 * (rate + rate_next) * step
    rate = rate_next
discount = np.exp(-integral)
closed = np.exp(-tau * vasicek_yield(i0, tau, kappa, theta, sigma, lam))
print(f"Monte Carlo: {discount.mean():.5f} (s.e. {discount.std(ddof=1) / np.sqrt(n_paths):.5f}), "
      f"gesloten vorm: {closed:.5f}")

B30 = (1 - np.exp(-kappa * 30)) / kappa
convexity_30 = sigma**2 / (2 * kappa**2) * (1 - B30 / 30) - sigma**2 * B30**2 / (4 * kappa * 30)
print(f"convexiteit 30 jaar: {convexity_30:.2%};  oneindig lang: {sigma**2 / (2 * kappa**2):.2%}")
Monte Carlo: 0.82983 (s.e. 0.00043), gesloten vorm: 0.83013
convexiteit 30 jaar: 0.34%; oneindig lang: 0.50%
De Monte-Carloprijs 0,82983 ligt 0,7 standaardfout (0,00043) onder de gesloten vorm 0,83013. Het convexiteitseffect verlaagt de 30-jaarsyield met 0,34 en de oneindig lange yield met 0,50 procentpunt, klein naast de termijnpremie in de lange yield van 3 procentpunt. De affiene formule is dus Jensens ongelijkheid uit het toy-voorbeeld, toegepast op een normale integraal van de rente.
:::{exercise}
:label: ex-termijnstructuur-real-options-3

**Twee deelsteekproeven.** Herhaal de replicatie op 1971-08 t/m 1999-12 en op 2000-01 t/m
2026-08.

1. Schat Vasicek in beide perioden, met standaardfouten voor $\hat\kappa$ en
   $\hat\theta$.
2. Bereken per periode de correlatie tussen 1- en 10-jaarsveranderingen en het aandeel van
   de eerste principale component (1–10 jaar).
3. Welke parameter verschilt het meest? Past één eenfactormodel op beide perioden?
Solution to ex-termijnstructuur-real-options-3
def vasicek_with_se(x, dt=1 / 12):
    """Vasicek AR(1) estimates with delta-method standard errors."""
    fit = sm.OLS(x[1:], sm.add_constant(x[:-1])).fit()
    c, b = fit.params
    cov = fit.cov_params()
    kappa = -np.log(b) / dt
    g_kappa = np.array([0.0, -1 / (b * dt)])
    g_theta = np.array([1 / (1 - b), c / (1 - b) ** 2])
    return {
        "kappa": kappa, "SE kappa": np.sqrt(g_kappa @ cov @ g_kappa),
        "theta": c / (1 - b), "SE theta": np.sqrt(g_theta @ cov @ g_theta),
        "sigma": np.std(fit.resid, ddof=2) * np.sqrt(2 * kappa / (1 - b**2)),
    }


periods = {"1971-1999": ("1971-08", "1999-12"), "2000-2026": ("2000-01", "2026-08")}
rows_sub = {}
for label, (start, end) in periods.items():
    est = vasicek_with_se(short.loc[start:end].to_numpy())
    block = changes.loc[start:end]
    ev = np.sort(np.linalg.eigvalsh(np.cov(block.to_numpy().T)))[::-1]
    est["corr 1j-10j"] = block["SVENY01"].corr(block["SVENY10"])
    est["aandeel PC1"] = ev[0] / ev.sum()
    rows_sub[label] = est
subsamples = pd.DataFrame(rows_sub)
for name in ("kappa", "theta"):
    diff = subsamples.loc[name].diff().iloc[-1]
    se = np.sqrt((subsamples.loc[f"SE {name}"] ** 2).sum())
    print(f"verschil in {name}: {diff:.4f}, in standaardfouten: {diff / se:.2f}")
subsamples.round(4)
verschil in kappa: -0.1799, in standaardfouten: -1.15
verschil in theta: -0.0543, in standaardfouten: -2.86
Het gemiddelde verschilt het meest, want daalt van 6,8% vóór 2000 naar 1,3% daarna, bijna drie standaardfouten. De snelheid van terugtrekken daalt ook, maar dat verschil is met ruim één standaardfout niet significant.
De correlatie tussen 1- en 10-jaarsveranderingen daalt van 0,76 naar 0,56, en de volatiliteit van 2,0% naar 0,65%. Alleen het aandeel van de eerste component blijft bijna gelijk. Eén eenfactormodel met vaste parameters past dus niet op beide perioden, en de breuk is het scherpst in de tweede momenten, die goed meetbaar zijn.
:::{exercise}
:label: ex-termijnstructuur-real-options-4

**Een mijn met de keuze om te sluiten.** Een mijn produceert één pond koper op $t = 1$ en
één op $t = 2$, tegen kosten $a = 1{,}00$ per pond. De koperprijs is $S_0 = 1{,}00$ en
gaat per periode met factor $u = 1{,}2$ omhoog of $d = 0{,}8$ omlaag ($d$ is hier de
daalfactor, niet het dividend). De risicovrije rente is $R^{f} = 5\%$ per periode; koper
is een verhandeld activum zonder convenience yield.

1. Bereken de risiconeutrale kans $q$ en de netto contante waarde als de mijn altijd
   produceert.
2. Bereken de waarde als de eigenaar in elke knoop mag sluiten. Wat is de keuze waard?
3. Openen kost 0,20. Wat zeggen beide waarderingen?
Solution to ex-termijnstructuur-real-options-4
(1) , zoals in Ross, APT en de fundamentele stelling. Onder is de verwachte koperprijs op en op , zodat de netto contante waarde is.
(2) Op levert de mijn : , 0 of 0. Op levert doorwerken in de hoge knoop ; in de lage knoop , zodat de mijn daar dichtgaat. Vandaag is ze waard, en de keuze (op onafgeronde getallen).
(3) Volgens de netto contante waarde (0,14) is het project de openingskosten niet waard, maar volgens de waardering met de keuze (0,27) wel. De code rekent het na.
mine = dict(S0=1.00, u=1.2, d=0.8, R_f=0.05, cost=1.00)
q_mine = (1 + mine["R_f"] - mine["d"]) / (mine["u"] - mine["d"])
S1 = mine["S0"] * np.array([mine["u"], mine["d"]])
S2 = mine["S0"] * np.array([mine["u"] ** 2, mine["u"] * mine["d"], mine["d"] ** 2])
value_t2 = np.maximum(S2 - mine["cost"], 0.0)
continuation_t1 = (q_mine * value_t2[:-1] + (1 - q_mine) * value_t2[1:]) / (1 + mine["R_f"])
value_t1 = np.maximum(S1 - mine["cost"] + continuation_t1, 0.0)      # close the mine if negative
value_flexible = (q_mine * value_t1[0] + (1 - q_mine) * value_t1[1]) / (1 + mine["R_f"])
npv_rigid = sum((mine["S0"] * (1 + mine["R_f"]) ** t - mine["cost"]) / (1 + mine["R_f"]) ** t
                for t in (1, 2))
pd.DataFrame({
    "met de hand": {"q": 0.625, "NCW zonder keuze": 0.140590,
                    "mijn met keuze om te sluiten": 0.274943, "waarde van de keuze": 0.134354},
    "code": {"q": q_mine, "NCW zonder keuze": npv_rigid,
             "mijn met keuze om te sluiten": value_flexible,
             "waarde van de keuze": value_flexible - npv_rigid},
}).round(6)De keuze om te sluiten verdubbelt dus bijna de waarde van de mijn. Een netto contante waarde met de verwachte koperprijs rekent immers alsof de mijn in verliesjaren doorwerkt.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Litterman, R., & Scheinkman, J. (1991). Common Factors Affecting Bond Returns. The Journal of Fixed Income, 1(1), 54–61. 10.3905/jfi.1991.692347
- Longstaff, F. A., & Schwartz, E. S. (2001). Valuing American Options by Simulation: A Simple Least-Squares Approach. The Review of Financial Studies, 14(1), 113–147. 10.1093/rfs/14.1.113
- Vasicek, O. (1977). An Equilibrium Characterization of the Term Structure. Journal of Financial Economics, 5(2), 177–188. 10.1016/0304-405X(77)90016-2
- Cox, J. C., Ingersoll, Jr., Jonathan E., & Ross, S. A. (1985). A Theory of the Term Structure of Interest Rates. Econometrica, 53(2), 385–407. 10.2307/1911242
- Brennan, M. J., & Schwartz, E. S. (1979). A Continuous Time Approach to the Pricing of Bonds. Journal of Banking & Finance, 3(2), 133–155. 10.1016/0378-4266(79)90011-6
- Longstaff, F. A., & Schwartz, E. S. (1992). Interest Rate Volatility and the Term Structure: A Two-Factor General Equilibrium Model. The Journal of Finance, 47(4), 1259–1282. 10.1111/j.1540-6261.1992.tb04657.x
- Duffie, D., & Kan, R. (1996). A Yield-Factor Model of Interest Rates. Mathematical Finance, 6(4), 379–406. 10.1111/j.1467-9965.1996.tb00123.x
- Brennan, M. J., & Schwartz, E. S. (1985). Evaluating Natural Resource Investments. The Journal of Business, 58(2), 135–157. 10.1086/296288
- McDonald, R., & Siegel, D. (1986). The Value of Waiting to Invest. The Quarterly Journal of Economics, 101(4), 707–727. 10.2307/1884175
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Ho, T. S. Y., & Lee, S.-B. (1986). Term Structure Movements and Pricing Interest Rate Contingent Claims. The Journal of Finance, 41(5), 1011–1029. 10.1111/j.1540-6261.1986.tb02528.x
- Gürkaynak, R. S., Sack, B., & Wright, J. H. (2007). The U.S. Treasury Yield Curve: 1961 to the Present. Journal of Monetary Economics, 54(8), 2291–2304. 10.1016/j.jmoneco.2007.06.029
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD