

Merton: continue tijd en het ICAPM
1Overzicht
Belegt een langetermijnbelegger anders, en verandert dat de prijzen? Dat gebeurt alleen als de beleggingskansen in de tijd veranderen. Dan houdt hij naast de marktportefeuille een hedgeportefeuille tegen slechter wordende kansen, en beloont het verwachte rendement naast de marktbèta ook de bèta op de variabelen die die kansen beschrijven. In dit college:
rekenen we in een model van twee perioden uit dat een voorspelbaar rendement de vraag naar aandelen verhoogt, en een onvoorspelbaar rendement niet;
leiden we af dat de horizon bij onafhankelijke rendementen niet uitmaakt, wat de optimale portefeuille in continue tijd is, en hoe de hedgevraag en de prijsvergelijking van het ICAPM daaruit volgen;
simuleren we hoe goed een eeuw data de hedgevraag meet;
repliceren we het VAR van Barberis (2000), de horizonallocaties in de geest van Campbell & Viceira (1999) en het effect van parameteronzekerheid.
In 1969 verschenen twee artikelen over hetzelfde probleem: hoe verdeelt iemand die een leven lang belegt zijn vermogen over een veilig en een risicovol activum? Samuelson loste het op in discrete tijd Samuelson (1969), zijn student Merton in continue tijd Merton (1969). Bij onafhankelijke rendementen deed de horizon er in beide gevallen niet toe. In 1973 liet Merton de beleggingskansen zelf bewegen en leidde hij het intertemporal CAPM (ICAPM) af Merton (1973). Met dat werk begon een nieuw tijdvak, omdat het asset pricing dynamisch maakte. Toen de dividendopbrengst rendementen bleek te voorspellen, rekenden Kim & Omberg (1996) en Campbell & Viceira (1999) de hedgevraag uit.
Is het ICAPM theorie of feit? Het is een theorie met een open plek, want het zegt welke vorm een prijsvergelijking heeft, maar niet welke variabelen erin horen. Daardoor laat het elk meerfactormodel toe waarvan de factoren iets over de toekomst voorspellen. De empirie van dit college toetst daarom de vraagkant, de hedgevraag, en niet de prijsvergelijking zelf.
2Intuïtie: waarom zou dit waar zijn?
Een oude volkswijsheid zegt dat wie jong is meer in aandelen moet beleggen, omdat slechte jaren over een lange periode uitmiddelen. Samuelson vond dat een drogreden. Komen de rendementen elk jaar uit dezelfde verdeling, dan staat een belegger elk jaar voor hetzelfde probleem. Vindt hij bovendien een verlies van tien procent even erg, of hij nu rijk of arm is, dan verandert alleen de schaal van dat probleem. Daarom kiest hij elk jaar hetzelfde percentage, hoeveel jaren er ook nog komen.
Merton keek naar wat er gebeurt als rendementen voorspelbaar zijn. Na een koersstijging zijn aandelen duur, is de dividendopbrengst laag en is het verwachte rendement voor de komende jaren lager, terwijl het na een crash omgekeerd is. Een aandeel is dan twee dingen tegelijk. Het is een gok met een positieve verwachting, zoals bij Markowitz, maar ook een verzekering, want het levert veel op in de toestand waarin elke euro daarna weinig kan verdienen.
Een belegger die slechte uitkomsten zwaar weegt, waardeert die verzekering, en daarom koopt hij meer aandelen dan de som voor één periode voorschrijft, de myopische vraag (bijziend: alsof alleen de volgende periode telt). Het extra deel heet de hedgevraag (hedging demand: het deel van de portefeuille dat vermogen levert wanneer de beleggingskansen, kortweg de kansen, verslechteren). Hoe langer de toekomst waartegen hij zich wil indekken, hoe groter de hedgevraag. Een belegger met logaritmisch nut let daarentegen alleen op het groeitempo van zijn vermogen en dekt zich niet in.
Die extra vraag werkt door in de prijzen. Als alle beleggers aandelen extra waarderen omdat ze ermee hedgen, betalen ze er meer voor, zodat het verwachte rendement daalt. Een activum zonder marktrisico dat een goede hedge is, verdient dan minder dan de risicovrije rente, terwijl een activum zonder marktrisico dat juist verliest wanneer de kansen verslechteren, meer verdient. Merton schreef het in zijn abstract: verwachte rendementen kunnen van de rente afwijken, ook zonder enig marktrisico Merton (1973).
We verwachten dus drie dingen. Bij onafhankelijke rendementen is de aandelenfractie gelijk voor elke horizon. Als rendementen dalen na een stijging, stijgt de fractie met de horizon, voor een belegger die risicomijdender is dan iemand met logaritmisch nut. En in evenwicht krijgt een activum een lagere premie naarmate het een betere hedge is tegen slechtere kansen.
3Toy-voorbeeld: twee perioden en een voorspelbaar rendement
Het kleinste geval waarin een hedgevraag kan bestaan, heeft twee perioden, want dan is er één volgende periode waartegen de belegger zich kan indekken. Eerst laden we de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Het vermogen na een periode met fractie in aandelen is , met het overrendement. De tabel geeft de getallen van het voorbeeld.
| grootheid | waarde |
|---|---|
| beginvermogen | 1 |
| nut over het eindvermogen | met , dus |
| risicovrije rente | 0 |
| overrendement in periode 1 | of , elk met kans |
| periode 2, geval A (onafhankelijk) | weer of |
| periode 2, geval B, na (“duur”) | of , geen premie |
| periode 2, geval B, na (“goedkoop”) | weer of |
Periode 1 heeft een verwacht overrendement van 10% en een standaarddeviatie van 26%. In geval B hangen de schok in het rendement en de schok in het verwachte rendement negatief samen, zoals bij aandelen en de dividendopbrengst.
Het recept. Wie in periode 2 optimaal belegt, heeft op de waarde , met bij de optimale (Theorie leidt die vorm af). Een lagere betekent een betere toekomst. In de eerste-ordevoorwaarde van periode 1 weegt elke uitkomst (stap 4 schrijft die voorwaarde uit).
Stap 1, myopisch. De eerste-ordevoorwaarde geeft . Daaruit volgt .
Stap 2, de waarde van de toekomst. Met is . Dat is minder dan 1, omdat een toekomst met premie beter is dan een toekomst zonder premie.
Stap 3, geval A. Omdat de toekomst in beide toestanden dezelfde geeft, valt weg uit de eerste-ordevoorwaarde, zodat .
Stap 4, geval B. Omdat er in de dure toestand geen premie is, houdt de belegger daar , zodat . In de goedkope toestand is . De voorwaarde wordt , dus en .
Stap 5, omgekeerd. Laat een stijging de markt goedkoop maken en een daling duur (geval B’). Dan is en .
In geval B houdt de belegger meer in aandelen, ruim vijf procent meer dan de myopische fractie, bij dezelfde verdeling van het rendement in periode 1. Dat verschil is de hedgevraag. Ze ontstaat doordat het aandeel 36% oplevert in de toestand waarin het vermogen daarna niets meer kan verdienen, en daar is een euro het meest waard. De code rekent hetzelfde uit, ook voor log-nut.
def continuation(up, down, w, gamma):
    """q = E[(1 + w R^e)^(1-gamma)] for two equally likely excess returns."""
    return 0.5 * (1 + w * up) ** (1 - gamma) + 0.5 * (1 + w * down) ** (1 - gamma)


def two_state_weight(up, down, q_up=1.0, q_down=1.0, gamma=2.0):
    """Optimal risky share with a zero interest rate, two equally likely excess returns and CRRA.

    q_up and q_down scale the marginal value of wealth in the state that
    follows each outcome; with q_up = q_down the problem is myopic.
    """
    k = (-up * q_up / (down * q_down)) ** (1 / gamma)
    return (k - 1) / (up - k * down)


def toy_table(gamma):
    w_good = two_state_weight(0.36, -0.16, gamma=gamma)
    q_good = continuation(0.36, -0.16, w_good, gamma)
    q_dear = continuation(0.20, -0.20, two_state_weight(0.20, -0.20, gamma=gamma), gamma)
    return {
        "myopisch (een periode)": w_good,
        "A: onafhankelijk": two_state_weight(0.36, -0.16, q_good, q_good, gamma),
        "B: stijging -> duur": two_state_weight(0.36, -0.16, q_dear, q_good, gamma),
        "B': stijging -> goedkoop": two_state_weight(0.36, -0.16, q_good, q_dear, gamma),
        "q goedkoop": q_good,
        "q duur": q_dear,
    }


hand = pd.Series({"myopisch (een periode)": 0.8333, "A: onafhankelijk": 0.8333,
                  "B: stijging -> duur": 0.8759, "B': stijging -> goedkoop": 0.7909,
                  "q goedkoop": 0.9615, "q duur": 1.0})
pd.DataFrame({"met de hand": hand, "code, gamma = 2": toy_table(2.0),
"code, gamma = 1 (log)": toy_table(1.0)}).round(4)De code geeft tot op vier decimalen de handberekening. In de kolom voor logaritmisch nut is in elke toestand, en zijn alle vier de allocaties gelijk aan de myopische 1,7361. Een voorspelbaar rendement verschuift dus de vraag naar aandelen, maar het teken hangt af van hoe rendement en kansen samen bewegen, en bij log-nut verschuift er niets.
4Theorie
We leiden vijf resultaten af. Eerst de stelling van Samuelson: bij onafhankelijke rendementen maakt de horizon niet uit. Daarna volgen de optimale portefeuille in continue tijd en de hedgevraag die erbij komt als de beleggingskansen bewegen. De kern is de vierde stap, waarin het ICAPM volgt zodra we de vraag van alle beleggers optellen. Tot slot rekenen we de hedgevraag uit in een markt met een voorspelbaar rendement.
4.1Opzet en aannames
De belegger maximeert het verwachte nut van zijn eindvermogen op horizon , met nut . Dat is CRRA-nut (constante relatieve risicoaversie): hij vindt een procentueel verlies even erg bij elk vermogen, en is bijvoorbeeld 2, zoals in het toy-voorbeeld. Consumptie laten we weg, omdat ze bij constante beleggingskansen de Merton-portefeuille niet verandert Merton (1969). Bij bewegende kansen maakt tussentijdse consumptie van de hedgevraag een gewogen gemiddelde over horizonnen, zodat haar teken blijft en alleen haar grootte verandert. In discrete tijd groeit het vermogen met .
In continue tijd is de continu samengestelde rente, zoals in Black-Scholes-Merton en de CBOE. Het risicovolle activum volgt
Het aandeel groeit gemiddeld met per jaar en schommelt met volatiliteit , in het toy-voorbeeld een premie van 10% bij . De schok is een standaard Brownse beweging, die in Black-Scholes-Merton en de CBOE nog heette, maar hier staat voor het vermogen. Met fractie in aandelen beweegt het vermogen volgens
Het vermogen groeit met de rente plus de premie op het deel in aandelen, en schommelt met dat deel. Dit is de vermogensvergelijking van Merton (1969), in onze symbolen. De waardefunctie is het beste verwachte nut vanaf vermogen op tijdstip :
4.2Samuelson: wanneer de horizon er niet toe doet
Zolang de rendementen elk jaar uit dezelfde verdeling komen, maakt de horizon niet uit. Een belegger wiens vermogen verdubbelt, verdubbelt dan elke positie en kiest dezelfde procentuele gok, want het probleem van volgend jaar is een geschaalde kopie van dat van dit jaar. Alleen als sommige toestanden van morgen betere kansen bieden dan andere, kan de toekomst de keuze van vandaag verschuiven.
Het bewijs volgt het recept van het toy-voorbeeld en werkt achterwaarts. Op elk tijdstip is de waardefunctie , met een getal. Omdat een constante factor het maximum niet verandert, vindt de belegger elke periode . In geval A was in beide toestanden, en daarom bleef de fractie daar gelijk aan de myopische, precies zoals Samuelson tegen de volkswijsheid inbracht.
Proof 1
Noem de waardefunctie in discrete tijd ; is verderop een afgeleide. Op is , dus . Stel met een getal. Dan is
De tweede gelijkheid gebruikt dat geen toevalsvariabele is, en dat de verdeling van niet van eerdere uitkomsten afhangt (de aanname van onafhankelijkheid). Het maximum ligt dus in , los van en , en .
Het bewijs laat ook zien waar het misgaat. Hangt af van een toestand die met samenhangt, dan mag niet buiten de verwachting en weegt het de uitkomsten, zoals in geval B van het toy-voorbeeld.
4.3De Merton-portefeuille
In continue tijd volgt de optimale fractie uit een afweging over één ogenblik. Een belegger die elk ogenblik mag bijsturen, kijkt namelijk steeds maar een ogenblik vooruit, en over zo’n kort interval tellen alleen de verwachting en de variantie van het rendement. Hij koopt aandelen tot de extra premie niet meer opweegt tegen de extra variantie. Hoe risicomijdender hij is of hoe wilder het aandeel beweegt, hoe minder hij koopt.
Het principe van Bellman zegt dat een optimaal plan ook vanaf elk later moment optimaal is: . Als we aan beide kanten aftrekken, staat er . Het lemma van Itô uit Black-Scholes-Merton en de CBOE schrijft uit, met , en de partiële afgeleiden:
Omdat , valt de term met in de verwachting weg. Zo ontstaat de Hamilton-Jacobi-Bellman-vergelijking (HJB-vergelijking: de Bellman-vergelijking in continue tijd)
Bij de beste keuze verandert de waarde gemiddeld niet, want wat rente en premie toevoegen, haalt de variantie via de kromming weer weg. De uitdrukking is kwadratisch in , en de eerste-ordevoorwaarde is
De belegger koopt de premie per eenheid variantie, maal de risicotolerantie van zijn waardefunctie. Die tolerantie kan verschillen van die van zijn nut, en in dat verschil zitten alle horizoneffecten.
Voor het bewijs proberen we een waardefunctie van dezelfde vorm als het nut, maal een functie van de tijd. Die heeft dezelfde relatieve risicoaversie , zodat (7) dan (8) geeft. Daarna gaan we na dat die proefoplossing de HJB-vergelijking oplost.
Proof 2
Met de getallen van het toy-voorbeeld is . In de wereld met twee uitkomsten was het 0,8333, omdat die uitkomsten scheef verdeeld zijn. Een hogere premie verhoogt , terwijl een hogere of hem verlaagt. Houdt één representatieve belegger de hele markt (), dan zegt (8) dat . De marktpremie is dan risicoaversie maal variantie, 8% bij en .
Met risicovolle activa, verwachte rendementen en covariantiematrix wordt het . Dat is de separatiestelling uit Markowitz, Roy en Tobin: iedereen houdt twee fondsen, de risicovrije rente en dezelfde tangentportefeuille, in een verhouding die van afhangt. Markowitz had daarvoor normaliteit of kwadratisch nut nodig, terwijl het in continue tijd voor elk CRRA-nut volgt.
4.4De hedgevraag
Zodra de beleggingskansen bewegen, krijgt de vraag naar aandelen een tweede deel. Laat het verwachte rendement afhangen van een toestandsvariabele , bijvoorbeeld de dividendopbrengst, zodat de waarde van de toekomst afhangt van vermogen én beleggingskansen. Een belegger die slechte kansen vreest, koopt dan extra van een activum dat stijgt wanneer de kansen verslechteren. Stijgen aandelen juist op dat moment, dan gaat zijn aandelenfractie omhoog.
De premie hangt dus van de toestand af, en de toestand volgt een eigen proces. Laat en
De toestand heeft een eigen drift en volatiliteit , en de schokken in hangen met correlatie samen met die van het aandeel. Voor de dividendopbrengst is sterk negatief, want een koersstijging verlaagt de opbrengst. De waardefunctie is nu , en de HJB-vergelijking krijgt drie termen erbij:
De eerste twee nieuwe termen beschrijven hoe de kansen zelf bewegen, en ze hangen niet van af. De laatste wel, want die bevat de covariantie tussen vermogen en kansen, gewogen met hoe de waarde van een euro verandert als de kansen veranderen ().
De eerste term is de Merton-portefeuille, en de tweede bestaat uit twee factoren. De factor is de regressiecoëfficiënt van op het rendement, dus hoeveel de kansen bewegen per procent koersbeweging. De factor zegt hoeveel gewicht de belegger daaraan hecht. Bij CRRA-nut is met , en wordt die factor . Bij log-nut is , dus en is er geen hedgevraag.
Het teken klopt met de intuïtie, maar alleen voor een belegger die risicomijdender is dan iemand met log-nut. Neem dus en laat een hogere betere kansen betekenen. Omdat , vraagt een hogere dan een lagere , zodat . Bij is de hedgevraag positief, zoals in geval B van het toy-voorbeeld. Wisselt van teken, dan wordt ze negatief, zoals in geval B’ (0,7909 onder 0,8333). Ook bij draait het teken om (oefening 1).
4.5Het kernresultaat: het intertemporele CAPM
Waarom zou dit waar zijn? Elke belegger houdt de twee fondsen van Markowitz plus een hedgeportefeuille, en in evenwicht moet de som van al die portefeuilles gelijk zijn aan de marktportefeuille. Een activum dat een goede hedge is, is daarom gewild. Wat gewild is, wordt duur, en wat duur is, heeft een laag verwacht rendement.
Laat er risicovolle activa zijn en één toestandsvariabele , met . Uitgebreid naar activa kiest belegger met vermogen
Elke belegger houdt de tangentportefeuille, geschaald met zijn risicotolerantie , en de hedgeportefeuille , geschaald met zijn hedgebehoefte . De hedgeportefeuille is de portefeuille die zo sterk mogelijk met meebeweegt. Merton noemde dit de drie-fondsenstelling: risicovrije rente, markt en hedgeportefeuille. Met toestandsvariabelen zijn het fondsen. is hier de risicotolerantie, niet de horizon .
Het verwachte overrendement is de marktbèta maal de marktpremie plus de toestandsbèta maal de prijs van toestandsrisico. De index staat hier voor de markt, zoals in Het CAPM. Het bewijsidee: in evenwicht is de som van alle vragen (13) gelijk aan de markt. Als we die gelijkheid met vermenigvuldigen, blijken de verwachte overrendementen een combinatie van twee covarianties, die met de markt en die met . In bèta’s herschreven geeft dat (14).
Proof 4
Laat en de marktgewichten. Omdat vraag en aanbod gelijk zijn, geldt . We vullen (13) in en vermenigvuldigen met :
is de vector van covarianties met het marktrendement, . Met de vermogensgewogen gemiddelden en volgt
Met en is dat . Schrijf , met in de rijen van de meervoudige bèta’s (niet te verwarren met hieronder). Dan is met , voor alle activa gelijk. Toegepast op de markt (, ) geeft dit .
De covariantiepremie uit het bewijs heeft een vast teken. Laat een hogere betere kansen betekenen en laat de beleggers hebben. Dan is , en krijgt een positieve covariantie met een positieve premie. Een activum dat stijgt wanneer de kansen verbeteren, levert vermogen wanneer de belegger dat het minst nodig heeft, en moet daarom meer opleveren. Een activum dat stijgt wanneer de kansen verslechteren, zoals het aandeel uit het toy-voorbeeld, is een verzekering en brengt minder op, wat de intuïtie aan het begin al verwachtte. De prijs van risico mengt met de covariantie tussen en de markt, zodat bij het teken van niet vastligt.
Merton nam de rente als toestandsvariabele en een lange obligatie als hedgeportefeuille. In het algemeen zegt het ICAPM niet welke het zijn, alleen dat variabelen die de beleggingskansen voorspellen, factoren met een risicopremie opleveren. Breeden (1979) voegde alle toestandsvariabelen samen tot één, de consumptiegroei. Of die ene factor de prijzen verklaart, komt aan bod in Lucas, Breeden en de SDF.
4.6Wat het voorspelt: een mean-reverting Sharpe-ratio
Waarom zou de hedgevraag met de horizon groeien? Stel dat de Sharpe-ratio van de markt terugkeert naar een vast gemiddelde. Na een slechte periode worden de kansen beter, maar niet voor altijd. Hoe langer de horizon, hoe meer toekomstige kansen er zijn waartegen de belegger zich wil indekken, tot de horizon ruim voorbij de terugkeertijd ligt. De hedgevraag stijgt dus met de horizon en vlakt dan af.
Schrijf , met de Sharpe-ratio (premie per eenheid volatiliteit). Kim en Omberg schrijven , maar in dit boek staat die letter voor een prijs van risico. Neem aan dat
De Sharpe-ratio keert met snelheid terug naar het gemiddelde en schommelt met . Bij een jaarlijkse persistentie van 0,92 is , een halfwaardetijd van jaar. Met noteren we de resterende horizon.
De eerste term van (18) is de myopische vraag, de tweede de hedgevraag. De som meet hoe sterk de waarde van de toekomst meebeweegt met de Sharpe-ratio. en volgen uit Riccati-vergelijkingen (kwadratisch in de onbekende), die Kim & Omberg (1996) in gesloten vorm oplosten. Bij blijven en nul, maar bij en worden ze negatief, zodat de hedgevraag positief is zodra . Omdat en bij nul beginnen en in absolute waarde naar een grens groeien, groeit de hedgevraag met de horizon en vlakt ze daarna af.
Proof 5
Schrijf . Met , en geeft Theorem 3 . Vul in (11) in en deel door . Probeer , zodat . De vergelijking wordt een kwadratisch polynoom in dat voor elke nul is. De coëfficiënten van en geven (19), die van bepaalt , dat niet in de portefeuille voorkomt. De randvoorwaarde geeft .
Het teken: bij is , en in is steeds , dus blijft negatief. Zolang is , dus ook wordt negatief en blijft dat.
4.7Numerieke oplossing
We kalibreren op een jaarlijks VAR (vector autoregression, een regressie van elke variabele op de vorige waarden van alle variabelen). Vanaf hier zijn kleine letters logs: is de log dividendopbrengst min het gemiddelde, en het log overrendement.
Een hoge dividendopbrengst voorspelt een hoog rendement (), en een koersstijging verlaagt de dividendopbrengst (), zodat het VAR dezelfde structuur heeft als geval B. De illustratieve parameters in de tabel liggen niet ver van de data.
| log risicovrije rente | ||||||
|---|---|---|---|---|---|---|
| 4,5% | 0,08 | 0,92 | 18% | 15% | −0,9 | 2% |
Om Theorem 5 te gebruiken, vertalen we naar continue tijd. Het verwachte simpele overrendement is het verwachte log-rendement plus (want bij een normaal ), dus met . Verder is , en . Zo heeft het continue proces dezelfde stationaire variantie als het jaarlijkse: . Met de tabel is en . De cel lost (19) op met Runge-Kutta van orde vier, voor vier waarden van .
def var_to_continuous(a, b, phi, s1, s2, rho):
    """Map the annual VAR (log excess return on demeaned log D/P) to Kim-Omberg inputs."""
    kappa = -np.log(phi)
    sigma_z = s2 * np.sqrt(2 * kappa / (1 - phi**2))
    return {"sigma": s1, "kappa": kappa, "theta": (a + 0.5 * s1**2) / s1,
            "sig_l": b * sigma_z / s1, "rho": rho}


def kim_omberg(gamma, horizons, sigma, kappa, theta, sig_l, rho, lam=None, dt=0.02):
    """Myopic and hedging demand from the Kim-Omberg Riccati system (RK4).

    Parameters are floats, or arrays of equal length with one entry per parameter
    set. Returns (myopic, hedge), one row per horizon, evaluated at the Sharpe
    ratio `lam` (default: the long-run mean theta).
    """
    lam = theta if lam is None else lam
    delta = (1 - gamma) / gamma
    B = np.zeros(np.shape(theta))   # one B and one C per parameter set
    C = np.zeros(np.shape(theta))

    def rhs(B, C):
        dB = (delta * rho * sig_l * B * (1 + rho * sig_l * C)
              + kappa * theta * C - kappa * B + sig_l**2 * B * C)
        dC = delta * (1 + rho * sig_l * C) ** 2 - 2 * kappa * C + sig_l**2 * C**2
        return dB, dC

    steps = np.rint(np.asarray(horizons) / dt).astype(int)
    out, step = [], 0
    for target in steps:
        while step < target:
            k1 = rhs(B, C)
            k2 = rhs(B + dt / 2 * k1[0], C + dt / 2 * k1[1])
            k3 = rhs(B + dt / 2 * k2[0], C + dt / 2 * k2[1])
            k4 = rhs(B + dt * k3[0], C + dt * k3[1])
            B = B + dt / 6 * (k1[0] + 2 * k2[0] + 2 * k3[0] + k4[0])
            C = C + dt / 6 * (k1[1] + 2 * k2[1] + 2 * k3[1] + k4[1])
            step += 1
        out.append(rho * sig_l * (B + C * lam) / (gamma * sigma))
    myopic = lam / (gamma * sigma)  # the same at every horizon
    return np.array([myopic] * len(out)), np.array(out)


illustrative = dict(a=0.045, b=0.08, phi=0.92, s1=0.18, s2=0.15, rho=-0.9)
ko_params = var_to_continuous(**illustrative)

horizons = [1, 5, 10, 20, 50]
rows = {}
for gamma in [1, 2, 5, 10]:
    myopic, hedge = kim_omberg(gamma, horizons, **ko_params)
    rows[f"gamma = {gamma}: myopische vraag"] = myopic
    rows[f"gamma = {gamma}: hedgevraag"] = hedge
pd.DataFrame(rows, index=[f"H = {h} jaar" for h in horizons]).T.round(3)Bij is de hedgevraag op elke horizon nul, zoals onder de stelling vastgesteld. Bij is de myopische vraag 0,378 en de hedgevraag op twintig jaar 0,339, zodat de totale vraag bijna verdubbelt. Bij is de hedgevraag op vijftig jaar groter dan de myopische vraag zelf. Campbell & Viceira (1999) vonden dezelfde orde van grootte, want ook bij hen kan de hedgevraag de vraag naar aandelen verdubbelen.
De hedgevraag van 0,339 bij op twintig jaar bepaalt ook hoe groot het ICAPM-effect is. Houdt één representatieve belegger de hele markt, dan zegt (13) met één activum , met de hedgefractie. Daaruit volgt . Met , en is dat in plaats van , bij een vaste . Het verzekeringsmotief drukt de marktpremie dan met een derde.
In de figuur is de hedgevraag de afstand tussen de getrokken en de gestreepte lijn van dezelfde kleur. De getrokken lijn stijgt met de horizon, en daarmee komt ook de tweede verwachting uit de intuïtie uit.
Source
horizon_grid = np.arange(0.5, 50.01, 0.5)
fig, ax = plt.subplots()
for colour, gamma in zip(hap.plotting.COLORS, [2, 5, 10]):
    myopic, hedge = kim_omberg(gamma, horizon_grid, **ko_params)
    ax.plot(horizon_grid, myopic + hedge, color=colour, label=f"totaal, $\\gamma$ = {gamma}")
    ax.plot(horizon_grid, myopic, color=colour, ls="--", lw=1.1,
            label=f"myopisch, $\\gamma$ = {gamma}")
ax.set_xlabel("Horizon (jaren)")
ax.set_ylabel("Fractie van het vermogen in aandelen")
ax.set_title("Kim-Omberg: de hedgevraag groeit met de horizon")
ax.legend(ncol=3)
plt.show()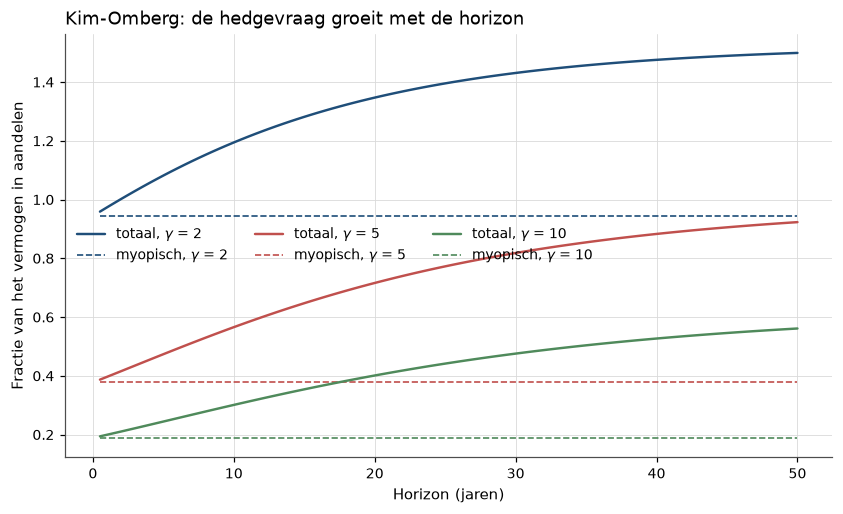
Figure 1:Optimale aandelenfractie bij de gemiddelde Sharpe-ratio. De gestreepte lijnen zijn de myopische vraag, die niet van de horizon afhangt. Het verschil met de getrokken lijn is de hedgevraag. Die begint bij nul en groeit over de eerste twintig jaar bijna rechtlijnig. Daarna vlakt ze af, maar op vijftig jaar ligt ze nog onder de grens voor een oneindige horizon (oefening 2).
Ter controle lossen we het jaarlijkse probleem ook direct op, want de vertaling naar continue tijd is een benadering, en hetzelfde rooster gebruiken we later voor de replicatie met parameteronzekerheid. Net als Barberis (2000) werken we daarbij achterwaarts op een rooster van 21 punten voor :
Dat is de recursie uit het bewijs van Theorem 1 met een die van de toestand afhangt.
def solve_rebalancing(gamma, n_years, draw, sd_z, rf=0.02, z0=(0.0,), n_grid=21, n_bisect=20):
    """Backward induction for an annually rebalancing CRRA investor.

    `draw(grid)` returns arrays (log excess return, next state), both of shape
    (n_grid, n_draws), conditional on each grid point. Returns the optimal
    stock share at the states `z0` for horizons 1, ..., n_years.
    """
    grid = np.linspace(-3 * sd_z, 3 * sd_z, n_grid)
    log_excess, z_next = draw(grid)
    gross_excess = np.exp(log_excess)
    Q, shares = np.ones(n_grid), []
    for _ in range(n_years):
        Q_next = np.interp(z_next, grid, Q)
        lo, hi = np.zeros(n_grid), np.full(n_grid, 0.99)
        for _ in range(n_bisect):
            mid = (lo + hi) / 2
            growth = 1 - mid[:, None] + mid[:, None] * gross_excess
            slope = (growth ** (-gamma) * (gross_excess - 1) * Q_next).mean(axis=1)
            lo, hi = np.where(slope > 0, mid, lo), np.where(slope > 0, hi, mid)
        w = (lo + hi) / 2
        growth = np.exp(rf) * (1 - w[:, None] + w[:, None] * gross_excess)
        Q = (growth ** (1 - gamma) * Q_next).mean(axis=1)
        shares.append(np.interp(z0, grid, w))
    return np.array(shares)


def normal_shocks(s1, s2, rho, n_draws):
    cov = np.array([[s1**2, rho * s1 * s2], [rho * s1 * s2, s2**2]])
    return rng.standard_normal((n_draws, 2)) @ np.linalg.cholesky(cov).T
De controlecel trekt 5000 schokken uit het illustratieve VAR, gebruikt ze op elk roosterpunt en zet de roosteroplossing naast Kim-Omberg voor en 10.
p = illustrative
shocks = normal_shocks(p["s1"], p["s2"], p["rho"], 5000)
sd_z = p["s2"] / np.sqrt(1 - p["phi"] ** 2)


def known(grid):
    """Log excess returns and next states at each grid point, parameters known."""
    return (p["a"] + p["b"] * grid[:, None] + shocks[:, 0],
            p["phi"] * grid[:, None] + shocks[:, 1])


check_horizons = [1, 2, 5, 10, 20]
check = {}
for gamma in [5, 10]:
    grid_share = solve_rebalancing(gamma, 20, known, sd_z)[:, 0]
    myopic, hedge = kim_omberg(gamma, check_horizons, **ko_params)
    check[f"rooster, gamma = {gamma}"] = grid_share[np.array(check_horizons) - 1]
    check[f"Kim-Omberg, gamma = {gamma}"] = myopic + hedge
pd.DataFrame(check, index=[f"H = {h}" for h in check_horizons]).T.round(3)Het grootste verschil tussen de twee methoden is 1,6 procentpunt, bij op twintig jaar. De tabel laat weg, omdat de allocatie daar tegen de grens van 0,99 aanloopt.
5Simulatie: wat een eeuw data over de hedgevraag zegt
Alles hierboven veronderstelde dat de belegger , en kent. Hoe goed meet hij zijn hedgevraag met een eeuw jaarcijfers, als de voorspelbaarheid echt is? We trekken 1000 steekproeven van 100 jaar uit het illustratieve VAR en schatten telkens de parameters met OLS. Daarmee rekenen we de hedgevraag uit voor en twintig jaar, alsof de schatting de waarheid is.
# TODO: naar hap.stats
def ols_var(r_next, z):
    """OLS of the two-equation VAR; columns of the inputs are independent samples.

    z has length n (the state at t = 0, ..., n-1); r_next has length n-1 and
    r_next[t] is the return earned between t and t+1. Returns intercepts,
    slopes, residual std devs, residual correlation and the standard error of
    the return slope.
    """
    x, y1, y2 = z[:-1], r_next, z[1:]
    xd = x - x.mean(axis=0)
    sxx = (xd**2).sum(axis=0)
    b = (xd * (y1 - y1.mean(axis=0))).sum(axis=0) / sxx
    phi = (xd * (y2 - y2.mean(axis=0))).sum(axis=0) / sxx
    e1 = y1 - y1.mean(axis=0) - b * xd
    e2 = y2 - y2.mean(axis=0) - phi * xd
    n = len(x)
    s1, s2 = np.sqrt((e1**2).sum(axis=0) / (n - 2)), np.sqrt((e2**2).sum(axis=0) / (n - 2))
    rho = (e1 * e2).sum(axis=0) / ((n - 2) * s1 * s2)
    a = y1.mean(axis=0) - b * x.mean(axis=0)
    c = y2.mean(axis=0) - phi * x.mean(axis=0)
    return {"a": a, "b": b, "c": c, "phi": phi, "s1": s1, "s2": s2, "rho": rho,
            "se_b": s1 / np.sqrt(sxx)}
De steekproeven starten na 200 jaar aanloop, zodat uit zijn stationaire verdeling begint.
n_samples, n_years, burn = 1000, 100, 200
z = np.zeros(n_samples)
z_path, r_path = [], []
for t in range(burn + n_years + 1):
    eps = normal_shocks(p["s1"], p["s2"], p["rho"], n_samples)
    r_next = p["a"] + p["b"] * z + eps[:, 0]
    if t >= burn:
        z_path.append(z)
        r_path.append(r_next)
    z = p["phi"] * z + eps[:, 1]
z_path, r_path = np.array(z_path), np.array(r_path)

est = ols_var(r_path[:-1], z_path)
est_cont = var_to_continuous(est["a"] + est["b"] * z_path[:-1].mean(axis=0), est["b"],
                             np.minimum(est["phi"], 0.995), est["s1"], est["s2"], est["rho"])
myopic_hat, hedge_hat = kim_omberg(5, [20], **est_cont)
myopic_true, hedge_true = kim_omberg(5, [20], **ko_params)
Elke steekproef levert nu een eigen hedgevraag op. De tabel vat de 1000 schattingen samen.
pd.DataFrame(
    {
        "waarheid": [p["b"], p["phi"], float(hedge_true[0]), float(myopic_true[0])],
        "gemiddelde schatting": [est["b"].mean(), est["phi"].mean(),
                                 hedge_hat[0].mean(), myopic_hat[0].mean()],
        "5%-kwantiel": [np.quantile(est["b"], 0.05), np.quantile(est["phi"], 0.05),
                        np.quantile(hedge_hat[0], 0.05), np.quantile(myopic_hat[0], 0.05)],
        "95%-kwantiel": [np.quantile(est["b"], 0.95), np.quantile(est["phi"], 0.95),
                         np.quantile(hedge_hat[0], 0.95), np.quantile(myopic_hat[0], 0.95)],
    },
    index=["b", "phi", "hedgevraag (H = 20, gamma = 5)", "myopische vraag (gamma = 5)"],
).round(3)De geschatte hedgevraag is zowel onzeker als vertekend. De ware waarde is 0,339, maar in 90% van de steekproeven ligt de schatting ergens tussen 0,143 en 0,850. Gemiddeld komt de schatting uit op 0,450, en dat is te hoog. De volgende cel telt hoe vaak de helling significant is en hoe vaak de hedgevraag een verkeerd teken krijgt.
pd.Series({
    "fractie steekproeven met t(b) > 1,96": np.mean(est["b"] / est["se_b"] > 1.96),
    "fractie steekproeven met hedgevraag < 0": np.mean(hedge_hat[0] < 0),
}).round(3)
fractie steekproeven met t(b) > 1,96 0.555
fractie steekproeven met hedgevraag < 0 0.001
dtype: float64De helling is in maar 55,5% van de steekproeven significant, terwijl de voorspelbaarheid per constructie echt is. Een negatieve hedgevraag komt daarentegen vrijwel niet voor, zodat het teken goed te leren is en de grootte niet. Let in het linkerpaneel op de gestreepte lijn, die rechts van de zwarte ligt, en rechts op de breedte van de verdeling.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))
axes[0].hist(est["b"], bins=40, edgecolor="white")
axes[0].axvline(p["b"], color="black", lw=1.6, label="ware $b$")
axes[0].axvline(est["b"].mean(), color=hap.plotting.COLORS[1], ls="--", lw=1.6,
                label="gemiddelde schatting")
axes[0].set_xlabel("Geschatte $b$ (helling van rendement op log D/P)")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].set_title("Stambaugh-bias in 100 jaar data")
axes[0].legend()
axes[1].hist(hedge_hat[0], bins=40, edgecolor="white")
axes[1].axvline(float(hedge_true[0]), color="black", lw=1.6, label="ware hedgevraag")
axes[1].set_xlabel("Geschatte hedgevraag ($\\gamma$ = 5, horizon 20 jaar)")
axes[1].set_ylabel("Aantal steekproeven")
axes[1].set_title("Waartegen de belegger denkt zich te moeten indekken")
axes[1].legend()
plt.show()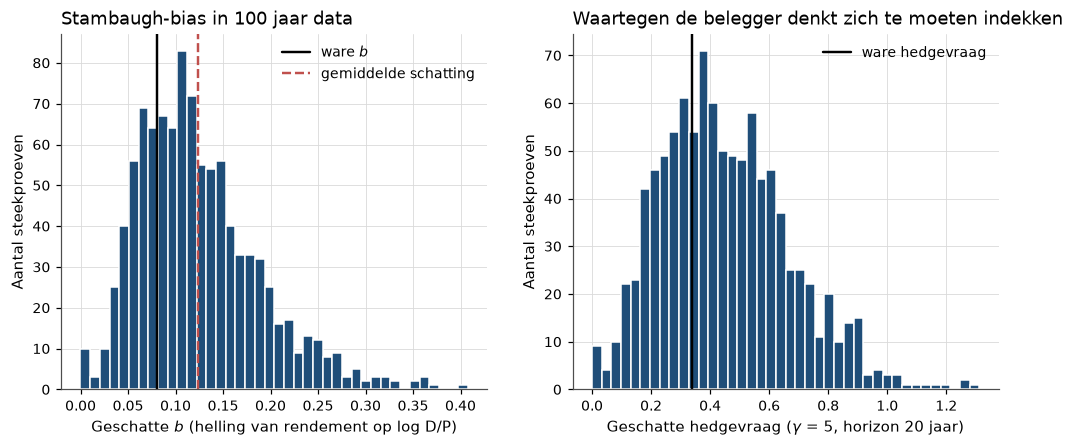
Figure 2:Links: de OLS-schatter van over 1000 steekproeven van 100 jaar. Het gemiddelde ligt boven de ware 0,08. De schatter van valt te laag uit, en via de sterk negatieve correlatie tussen de schokken duwt die fout omhoog: de bias van Stambaugh (1999). Rechts: de hedgevraag die een belegger uit zijn eigen steekproef afleidt, van minder dan de helft tot tweeënhalf keer de ware waarde.
Hier keert de standaardfout van 2% terug in dynamische vorm, want ook een eeuw data meet een verwacht rendement maar grof. De spreiding komt van de grootheden die over verwachte rendementen gaan: voor de hedgevraag en voor de myopische vraag. Volatiliteiten en zijn over een eeuw daarentegen goed bepaald.
6Replicatie op echte data
6.1Barberis’ VAR
We schatten het maandelijkse VAR met OLS. Met de vlakke prior van Barberis valt het posterior gemiddelde samen met OLS, zodat de twee kolommen vergelijkbaar zijn.
gw_monthly = hap_data.goyal_welch("monthly")
monthly = pd.DataFrame(
    {
        "excess": np.log1p(gw_monthly["CRSP_SPvw"]) - np.log1p(gw_monthly["Rfree"]),
        "dy": gw_monthly["D12"] / gw_monthly["Index"],
    }
).loc["1952-06":"1995-12"]

# z[t] is the dividend yield at the end of month t, r_next[t] the return over month t+1
mon = ols_var(monthly["excess"].to_numpy()[1:, None], monthly["dy"].to_numpy()[:, None])
mon = {k: float(v[0]) for k, v in mon.items()}
dy_lag = monthly["dy"].to_numpy()[:-1]
se_phi = mon["s2"] / np.sqrt(((dy_lag - dy_lag.mean()) ** 2).sum())

pd.DataFrame(
    {
        "Barberis (2000), tabel II": [0.5118, 0.2129, 0.9774, 0.0091, 0.0017, -0.9351],
        "hier (OLS)": [mon["b"], mon["se_b"], mon["phi"], se_phi, mon["s1"] ** 2, mon["rho"]],
    },
    index=["helling rendement op D/P", "  standaardfout", "phi (D/P op D/P)", "  standaardfout",
           "residuvariantie rendement", "correlatie schokken"],
).round(4)Geslaagd. Alle tekens en ordes van grootte kloppen met wat we vooraf verwachtten. Onze helling ligt standaardfout onder die van Barberis, bij een andere index. Dat is weinig, want ook in zijn eigen steekproef is de -waarde van de helling maar .
6.2Horizonallocaties op een eeuw jaarcijfers
Nu schatten we het jaarlijkse VAR over 1927–2025, de invoer voor de horizonallocaties.
gw_annual = hap_data.goyal_welch("annual").loc["1926":"2025"]
log_dp = gw_annual["dp"].to_numpy()
excess_next = (np.log1p(gw_annual["CRSP_SPvw"]) - np.log1p(gw_annual["Rfree"])).to_numpy()[1:]
dp_mean = log_dp[:-1].mean()
z_annual = log_dp - dp_mean

ann = ols_var(excess_next[:, None], z_annual[:, None])
ann = {k: float(v[0]) for k, v in ann.items()}
rf_annual = float(np.log1p(gw_annual["Rfree"]).mean())
ann_cont = var_to_continuous(ann["a"], ann["b"], ann["phi"], ann["s1"], ann["s2"], ann["rho"])

pd.DataFrame(
    {"schatting": [ann["a"], ann["b"], ann["se_b"], ann["b"] / ann["se_b"], ann["phi"],
                   ann["s1"], ann["s2"], ann["rho"], rf_annual, z_annual[-1]]},
    index=["a (gem. log overrendement)", "b", "  standaardfout", "  t-waarde", "phi",
           "sd rendementsschok", "sd D/P-schok", "correlatie schokken",
           "gem. log risicovrije rente", "log D/P eind 2025 min gemiddelde"],
).round(4)Over de hele eeuw voorspelt de dividendopbrengst maar zwak, met een -waarde van 1,07 voor de helling. De persistentie (0,924) en de negatieve correlatie tussen de schokken (−0,856) zijn er toch nog. Net als in de simulatie zijn de tweede momenten dus goed bepaald en het verwachte rendement niet. We vullen deze schattingen in Kim-Omberg in, voor drie risicoaversies.
horizons = [1, 5, 10, 20, 50]
cv_table = {}
for gamma in [2, 5, 10]:
    myopic, hedge = kim_omberg(gamma, horizons, **ann_cont)
    cv_table[(f"gamma = {gamma}", "myopische vraag")] = myopic
    cv_table[(f"gamma = {gamma}", "hedgevraag")] = hedge
    cv_table[(f"gamma = {gamma}", "totaal / myopisch")] = (myopic + hedge) / myopic
pd.DataFrame(cv_table, index=[f"H = {h}" for h in horizons]).T.round(3)De volgende tabel vergelijkt de verhouding tussen totale en myopische vraag met de verdubbeling van Campbell en Viceira.
pd.DataFrame(
    {"origineel (Campbell-Viceira)": ["tot 2"],
     "hier": [cv_table[("gamma = 10", "totaal / myopisch")][4]]},
    index=["totaal / myopisch, gamma = 10, H = 50"],
).round(3)Geslaagd. De hedgevraag is positief, groeit met de horizon en blijft bij realistische horizonnen onder de verdubbeling, zoals we vooraf verwachtten. Pas bij vijftig jaar en komt de verdubbeling in zicht.
Dat een zo zwakke helling toch zo’n hedgevraag geeft, komt door twee dingen: de correlatie van en een halfwaardetijd van jaar. Een klein maar persistent effect telt over een lange horizon namelijk op.
6.3Parameteronzekerheid volgens Barberis
Barberis (2000) liet de belegger het verwachte nut middelen over de posterior verdeling van alle parameters, in plaats van de puntschatting te gebruiken. Met een vlakke prior heeft de posterior een standaardvorm, want de covariantiematrix van de schokken is invers-Wishart (de verdeling van de inverse van een steekproefcovariantiematrix), en de coëfficiënten zijn normaal rond de OLS-schatting. Per trekking is de coëfficiëntenmatrix , met standaardnormaal en de Cholesky-factoren. We trekken 5000 parametersets met elk één schok, en net als bij Barberis leert de belegger onderweg niets bij.
def posterior_predictive(r_next, z, n_draws):
    """Draws of (a, b, c, phi) and one VAR shock per draw under a flat prior (Barberis 2000)."""
    X = np.column_stack([np.ones(len(z) - 1), z[:-1]])
    Y = np.column_stack([r_next, z[1:]])
    C_hat = np.linalg.solve(X.T @ X, X.T @ Y)
    resid = Y - X @ C_hat
    Sigma = stats.invwishart(df=len(Y) - 3, scale=resid.T @ resid).rvs(n_draws, random_state=rng)
    L_sigma = np.linalg.cholesky(Sigma)
    L_x = np.linalg.cholesky(np.linalg.inv(X.T @ X))
    Z = rng.standard_normal((n_draws, 2, 2))
    L_sigma_t = np.transpose(L_sigma, axes=(0, 2, 1))  # L_Sigma' for each draw
    C = C_hat + L_x @ Z @ L_sigma_t                    # matrix-normal around OLS
    e = rng.standard_normal((n_draws, 2))
    eps = (L_sigma @ e[:, :, None])[:, :, 0]          # one VAR shock per draw
    return C, eps


C_draws, eps_draws = posterior_predictive(excess_next, z_annual, 5000)
pd.DataFrame(
    {"gemiddelde": [C_draws[:, 1, 0].mean(), C_draws[:, 1, 1].mean()],
     "standaarddeviatie": [C_draws[:, 1, 0].std(), C_draws[:, 1, 1].std()],
     "kans < 0": [np.mean(C_draws[:, 1, 0] < 0), np.mean(C_draws[:, 1, 1] < 0)],
     "kans > 1": [np.mean(C_draws[:, 1, 0] > 1), np.mean(C_draws[:, 1, 1] > 1)]},
    index=["b (posterior)", "phi (posterior)"],
).round(3)De posterior van heeft een standaarddeviatie zo groot als het gemiddelde. In 14,1% van de trekkingen is de helling negatief, en voorspelt een hoge dividendopbrengst dus lage rendementen. In 4,2% is , en keert de dividendopbrengst niet terug. De volgende cel lost het probleem op met de parameters vast en met de posterior, vanaf een gemiddelde dividendopbrengst en vanaf die van eind 2025.
shocks_ann = normal_shocks(ann["s1"], ann["s2"], ann["rho"], 5000)
sd_z_ann = ann["s2"] / np.sqrt(1 - ann["phi"] ** 2)
start_states = (0.0, z_annual[-1])

def point(grid):
    """Draws with the VAR parameters fixed at their OLS estimates."""
    return (ann["a"] + ann["b"] * grid[:, None] + shocks_ann[:, 0],
            ann["c"] + ann["phi"] * grid[:, None] + shocks_ann[:, 1])


def predictive(grid):
    """Draws from the posterior predictive: one parameter set and one shock per draw."""
    return (C_draws[:, 0, 0] + C_draws[:, 1, 0] * grid[:, None] + eps_draws[:, 0],
            C_draws[:, 0, 1] + C_draws[:, 1, 1] * grid[:, None] + eps_draws[:, 1])


share_point = solve_rebalancing(5, 20, point, sd_z_ann, rf=rf_annual, z0=start_states)
share_bayes = solve_rebalancing(5, 20, predictive, sd_z_ann, rf=rf_annual, z0=start_states)

show = np.array([1, 2, 5, 10, 15, 20])
pd.DataFrame(
    {
        ("D/P op gemiddelde", "parameters bekend"): share_point[show - 1, 0],
        ("D/P op gemiddelde", "parameteronzekerheid"): share_bayes[show - 1, 0],
        ("D/P zoals eind 2025", "parameters bekend"): share_point[show - 1, 1],
        ("D/P zoals eind 2025", "parameteronzekerheid"): share_bayes[show - 1, 1],
    },
    index=[f"H = {h}" for h in show],
).round(3)Met parameteronzekerheid ligt de allocatie op elke horizon lager. De figuur zet de vier kolommen uit, en de afstand tussen de getrokken en de gestreepte lijn van dezelfde kleur is het effect van parameteronzekerheid.
Source
years = np.arange(1, 21)
fig, ax = plt.subplots()
for j, (label, colour) in enumerate([("D/P op gemiddelde", hap.plotting.COLORS[0]),
                                     ("D/P zoals eind 2025", hap.plotting.COLORS[1])]):
    ax.plot(years, share_point[:, j], color=colour, label=f"{label}, parameters bekend")
    ax.plot(years, share_bayes[:, j], color=colour, ls="--",
            label=f"{label}, parameteronzekerheid")
ax.set_xlabel("Horizon (jaren), jaarlijkse herbalancering")
ax.set_ylabel("Fractie van het vermogen in aandelen")
ax.set_title("Horizonallocaties, $\\gamma$ = 5, VAR op 1927–2025")
ax.legend()
plt.show()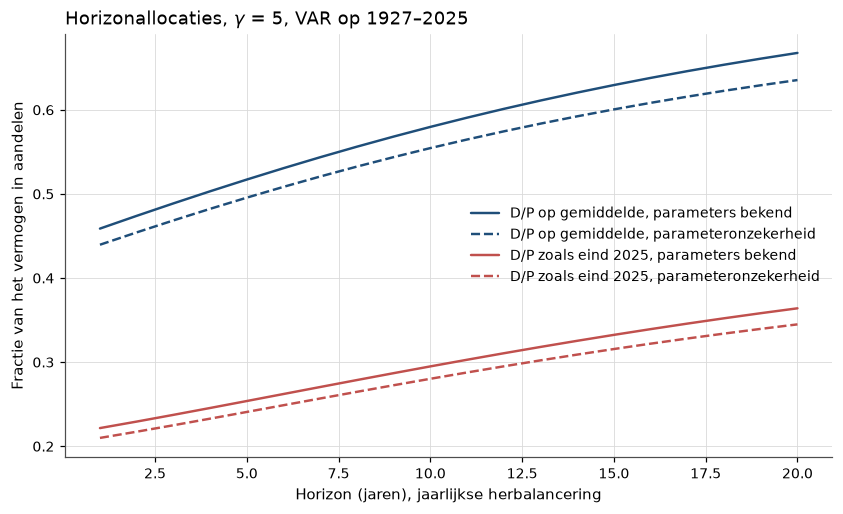
Figure 3:Optimale aandelenfractie bij jaarlijkse herbalancering, met de parameters vast (getrokken) of met de posterior verdeling (gestreept), vanaf een gemiddelde dividendopbrengst (blauw) of vanaf de lage dividendopbrengst van eind 2025 (rood). In alle vier de gevallen stijgt de lijn met de horizon. Parameteronzekerheid verlaagt de allocatie en haalt een klein deel van de stijging weg.
De eerste tabel vat de verschillen per beginstand samen, over alle twintig horizonnen.
gap = share_point - share_bayes  # parameters fixed minus parameter uncertainty
pd.DataFrame(
    {"kleinste verschil": gap.min(axis=0), "grootste verschil": gap.max(axis=0),
     "fractie H = 1, parameters bekend": share_point[0],
     "D/P in standaarddeviaties": [0.0, z_annual[-1] / sd_z_ann]},
    index=["D/P op gemiddelde", "D/P zoals eind 2025"],
).round(3)Het verschil is vanaf een gemiddelde dividendopbrengst twee à drie procentpunt en vanaf eind 2025 ruim één à twee. De tweede tabel zet de overallocatie op tien jaar naast die van Barberis.
pd.DataFrame(
    {"origineel (Barberis)": ["> 30%"],
     "hier": [share_point[9, 0] / share_bayes[9, 0] - 1]},
    index=["H = 10: overallocatie zonder onzekerheid (relatief)"],
).round(3)Gedeeltelijk geslaagd. Teken en ordening zijn zoals verwacht, maar de veel vlakkere lijnen van Barberis zien we niet. Zijn overallocatie van meer dan dertig procent voor een buy-and-hold-belegger met risicoaversie 10 (Barberis (2000), p. 246) is hier 4,5%. Die 4,5% geldt wel voor met jaarlijkse herbalancering, zodat de vergelijking alleen een orde van grootte geeft.
Ook dit verschil volgt uit de standaardfout van 2%, want hoe korter de steekproef, hoe breder de posterior. Barberis’ dynamische figuur 5 gebruikt de tienjaarssteekproef 1986–1995, en zijn buy-and-hold-getal komt uit 44 jaar maanddata, terwijl wij honderd jaar hebben en daarmee een smallere posterior. Op dertig jaar data is het effect wel groot, zoals oefening 3 laat zien.
Vanaf de lage dividendopbrengst van eind 2025, bijna twee standaarddeviaties onder het gemiddelde, is de allocatie op één jaar ongeveer half zo groot. Een lage dividendopbrengst voorspelt immers een laag verwacht rendement, zodat de myopische vraag kleiner is.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Merton maakte van portefeuillekeuze een dynamisch probleem en van asset pricing een theorie met meer dan één bron van risico. Uit Theorem 1 volgt dat jong zijn op zich geen reden is voor meer aandelen. Uit Theorem 3 volgt wat wel een reden is, namelijk zich indekken tegen veranderende beleggingskansen. Het ICAPM gaf elk later meerfactormodel een theoretische grond, want volgens het ICAPM krijgt een factor een risicopremie als hij de beleggingskansen voorspelt.
Waar het breekt. Het model breekt niet in de wiskunde, maar in de invoer. De hedgevraag hangt af van de helling van het rendement op een voorspeller, een uitspraak over een verwacht rendement. Over 1927–2025 heeft die helling een -waarde van 1,07, en toch zegt de theorie dat een belegger met op twintig jaar 0,223 extra in aandelen houdt. De simulatie liet zien hoe ver een eeuw data ernaast kan zitten. Een verwacht rendement is alleen te leren uit een lange kalenderperiode, hoe vaak er ook gemeten wordt Merton (1980). Daarnaast noemt het ICAPM zijn toestandsvariabelen niet, en een model dat elke voorspeller als factor toelaat, is moeilijk te verwerpen.
Risico of vergissing? De hele hedgevraag berust op het feit dat de dividendopbrengst rendementen voorspelt, en dat feit laat twee lezingen toe. Volgens de Chicago-lezing (de prijs is juist en beloont risico) varieert de prijs van risico. Na een crash zijn beleggers armer en risicomijdender en eisen ze een hogere premie. De langetermijnbelegger die dan bijkoopt, draagt risico waarvoor hij een premie krijgt, en zijn hedgevraag is Mertons verzekering. Volgens de Yale-lezing (de prijs zit ernaast) schieten prijzen door, en voorspelt de dividendopbrengst omdat de vergissing zich herstelt. Dan is dezelfde extra positie een weddenschap dat de belegger meer weet dan de prijs. Het VAR scheidt de twee niet, want beide geven en . Om ze te scheiden, moeten we weten of verwachte rendementen meebewegen met consumptie en recessies, en dat valt met de data van dit college niet te beslissen.
Wat er daarna kwam. Merton liet open welke factoren het zijn, en Ross liet in 1976 zien dat een factormodel ook zonder voorkeuren volgt, alleen uit de eis dat er geen arbitrage bestaat (zie Ross, APT en de fundamentele stelling).
8Oefeningen
Solution to Exercise 1
(1) De voorwaarde geeft , dus . Bij is in elke toestand, zodat wegvalt en gelijk is aan de myopische fractie.
(2)
records = []
for gamma in [0.5, 1.0, 2.0, 5.0, 10.0]:
    row = toy_table(gamma)
    records.append({
        "gamma": gamma,
        "myopisch": row["myopisch (een periode)"],
        "w0 voorspelbaar": row["B: stijging -> duur"],
        "hedgevraag": row["B: stijging -> duur"] - row["myopisch (een periode)"],
        "hedge / myopisch": row["B: stijging -> duur"] / row["myopisch (een periode)"] - 1,
        "q goedkoop": row["q goedkoop"],
        "q duur": row["q duur"],
    })
pd.DataFrame(records).set_index("gamma").round(4)Bij is de hedgevraag negatief, want dan is en betekent een betere toekomst een hogere : . Het marginale nut van vermogen is dan het hoogst in de goedkope toestand. Omdat het aandeel daar weinig oplevert, houdt de belegger er minder van. Bij is het teken positief, en ten opzichte van de myopische vraag groeit de hedgevraag met . De hedgevraag is dus geen eigenschap van het activum alleen, maar van het activum samen met de manier waarop de belegger zijn toekomst weegt.
:::{exercise}
:label: ex-merton-icapm-2

**Afleiding: de lange horizon in gesloten vorm.** Neem [](#eq-merton-icapm-riccati).

1. Laat zien dat de stationaire waarde $C_\infty = \lim_{\tau\to\infty} C(\tau)$ een
   wortel is van
   $\sigma_\eta^2(1 + \delta\rho^2)\,C^2 + 2(\delta\rho\sigma_\eta - \kappa)\,C + \delta = 0$,
   en leid $B_\infty$ af in termen van $C_\infty$.
2. Welke wortel is de limiet voor $\gamma > 1$?
3. Bereken de hedgevraag op oneindige horizon voor de illustratieve parameters en
   $\gamma = 5$, en vergelijk met Runge-Kutta bij $\tau = 200$ jaar.
Solution to ex-merton-icapm-2
(1) Stel en groepeer naar machten van . Stel en los op:
(2) Bij is , zodat het product van de wortels negatief is zolang . Er is dan één negatieve en één positieve wortel. Omdat in nul begint en negatief blijft, is de limiet de negatieve wortel.
(3)
gamma = 5
delta = (1 - gamma) / gamma
kp = ko_params
quad_a = kp["sig_l"] ** 2 * (1 + delta * kp["rho"] ** 2)
quad_b = 2 * (delta * kp["rho"] * kp["sig_l"] - kp["kappa"])
C_inf = (-quad_b - np.sqrt(quad_b**2 - 4 * quad_a * delta)) / (2 * quad_a)
B_inf = kp["kappa"] * kp["theta"] * C_inf / (
    kp["kappa"] - kp["sig_l"] ** 2 * C_inf
    - delta * kp["rho"] * kp["sig_l"] * (1 + kp["rho"] * kp["sig_l"] * C_inf))
hedge_inf = kp["rho"] * kp["sig_l"] * (B_inf + C_inf * kp["theta"]) / (gamma * kp["sigma"])
myopic_200, hedge_200 = kim_omberg(gamma, [200], **kp)

pd.DataFrame(
    {"waarde": [C_inf, B_inf, hedge_inf, float(hedge_200[0]), float(myopic_200[0])]},
    index=["C oneindig", "B oneindig", "hedgevraag, oneindige horizon",
           "hedgevraag, Runge-Kutta bij 200 jaar", "myopische vraag"],
).round(4)Op oneindige horizon is de hedgevraag groter dan de myopische vraag, maar ze blijft eindig. Het horizoneffect is dus begrensd, en de grens hangt af van en , twee grootheden over verwachte rendementen.
:::{exercise}
:label: ex-merton-icapm-3

**Uitbreiding van de replicatie: een kortere steekproef.** Herhaal de replicatie op
de jaarlijkse Goyal-Welch-data met rendementen over 1996–2025, met $\gamma = 10$ (bij
$\gamma = 5$ loopt de allocatie hier tegen de grens van 0,99).

1. Schat het VAR en rapporteer $\hat b$, zijn $t$-waarde en $\hat\phi$.
2. Bereken de aandelenfractie bij een gemiddelde dividendopbrengst op 1, 5 en 10
   jaar, met parameters vast en met parameteronzekerheid, voor deze steekproef en
   voor 1927–2025.
Solution to ex-merton-icapm-3
recent = hap_data.goyal_welch("annual").loc["1995":"2025"]
dp_recent = recent["dp"].to_numpy()
z_recent = dp_recent - dp_recent[:-1].mean()
excess_recent = (np.log1p(recent["CRSP_SPvw"]) - np.log1p(recent["Rfree"])).to_numpy()[1:]

rec = {k: float(v[0]) for k, v in ols_var(excess_recent[:, None], z_recent[:, None]).items()}
shocks_rec = normal_shocks(rec["s1"], rec["s2"], rec["rho"], 5000)
sd_z_rec = rec["s2"] / np.sqrt(1 - min(rec["phi"], 0.995) ** 2)
rf_recent = float(np.log1p(recent["Rfree"]).mean())

def point_rec(grid):
    return (rec["a"] + rec["b"] * grid[:, None] + shocks_rec[:, 0],
            rec["c"] + rec["phi"] * grid[:, None] + shocks_rec[:, 1])


C_rec, eps_rec = posterior_predictive(excess_recent, z_recent, 5000)

def bayes_rec(grid):
    return (C_rec[:, 0, 0] + C_rec[:, 1, 0] * grid[:, None] + eps_rec[:, 0],
            C_rec[:, 0, 1] + C_rec[:, 1, 1] * grid[:, None] + eps_rec[:, 1])


h = np.array([1, 5, 10])
short = {
    "1996-2025, parameters bekend": solve_rebalancing(10, 10, point_rec, sd_z_rec, rf=rf_recent)[h - 1, 0],
    "1996-2025, parameteronzekerheid": solve_rebalancing(10, 10, bayes_rec, sd_z_rec, rf=rf_recent)[h - 1, 0],
    "1927-2025, parameters bekend": solve_rebalancing(10, 10, point, sd_z_ann, rf=rf_annual)[h - 1, 0],
    "1927-2025, parameteronzekerheid": solve_rebalancing(10, 10, predictive, sd_z_ann, rf=rf_annual)[h - 1, 0],
}
print(f"1996-2025: b = {rec['b']:.3f}, t = {rec['b'] / rec['se_b']:.2f}, phi = {rec['phi']:.3f}")
pd.DataFrame(short, index=[f"H = {k}" for k in h]).T.round(3)
1996-2025: b = 0.358, t = 2.60, phi = 0.647
De laatste dertig jaar lijken voorspelbaarder: met een -waarde van 2,60, maar een veel minder persistente dividendopbrengst (). Dat is geen tegenspraak met onze verwachting vooraf, want die ging over de helling over de hele eeuw. Op tien jaar loopt de belegger met de puntschatting tegen de grens van 0,99 aan.
Op vijf jaar houdt de belegger met parameteronzekerheid zeventien procentpunt minder dan de belegger die de puntschatting gelooft (0,649 tegen 0,817). Op de eeuwsteekproef is dat verschil ruim één procentpunt, want met honderd waarnemingen is de posterior veel smaller. Hoe korter de geschiedenis, hoe groter dus het deel van het horizoneffect dat een illusie van de puntschatting is.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Barberis, N. (2000). Investing for the Long Run when Returns Are Predictable. The Journal of Finance, 55(1), 225–264. 10.1111/0022-1082.00205
- Campbell, J. Y., & Viceira, L. M. (1999). Consumption and Portfolio Decisions when Expected Returns are Time Varying. The Quarterly Journal of Economics, 114(2), 433–495. 10.1162/003355399556043
- Samuelson, P. A. (1969). Lifetime Portfolio Selection by Dynamic Stochastic Programming. The Review of Economics and Statistics, 51(3), 239–246. 10.2307/1926559
- Merton, R. C. (1969). Lifetime Portfolio Selection under Uncertainty: The Continuous-Time Case. The Review of Economics and Statistics, 51(3), 247–257. 10.2307/1926560
- Merton, R. C. (1973). An Intertemporal Capital Asset Pricing Model. Econometrica, 41(5), 867–887. 10.2307/1913811
- Kim, T. S., & Omberg, E. (1996). Dynamic Nonmyopic Portfolio Behavior. Review of Financial Studies, 9(1), 141–161. 10.1093/rfs/9.1.141
- Breeden, D. T. (1979). An Intertemporal Asset Pricing Model with Stochastic Consumption and Investment Opportunities. Journal of Financial Economics, 7(3), 265–296. 10.1016/0304-405X(79)90016-3
- Stambaugh, R. F. (1999). Predictive Regressions. Journal of Financial Economics, 54(3), 375–421. 10.1016/S0304-405X(99)00041-0
- Merton, R. C. (1980). On Estimating the Expected Return on the Market: An Exploratory Investigation. Journal of Financial Economics, 8(4), 323–361. 10.1016/0304-405X(80)90007-0
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD