

Regnault, Bachelier en de random walk
1Overzicht
Hoe beweegt een koers als niemand de volgende stap kan voorspellen? Dan beweegt hij als een random walk (een som van ongecorreleerde schokken), waarvan de spreiding groeit met de wortel van de tijd, zodat een optie te waarderen is op grond van die spreiding alleen. Over het niveau van de koers zegt het model niets. In dit college:
tellen we in een wandeling van vier stappen na dat de variantie lineair groeit en de spreiding met de wortel van het aantal stappen,
leiden we af dat een random walk in de limiet een Brownse beweging wordt, met twee gevolgen: de kans om een niveau te raken en Bacheliers optieprijs,
schrijven we de -wet op als toets, de variance ratio,
simuleren we hoeveel jaren data nodig zijn om een kleine autocorrelatie te zien,
repliceren we Regnaults wet op Shillers maandreeks vanaf 1871, en de autocorrelaties en variance ratios van Kendall en van Lo en MacKinlay Lo & MacKinlay (1988) op French-data.
In 1863 schreef Jules Regnault, beambte aan de Parijse beurs, dat de gemiddelde absolute afwijking van de koers evenredig is met de wortel van de verstreken tijd Regnault (1863). Louis Bachelier maakte er in 1900 een model van: de Brownse beweging als limiet van een random walk Bachelier (1900). Hij leidde er de eerste optieformule mee af, vijf jaar voordat Einstein dezelfde wiskunde voor zwevende deeltjes gebruikte. Zonder Bachelier was Regnaults regel een meting gebleven, want hij gaf als enige een model waaruit de regel volgt. Zijn proefschrift bleef toch een halve eeuw ongelezen, ook omdat de kansrekening pas in 1933 een formele taal voor stochastische processen kreeg. Daarna waren de empirici aan zet. Cowles liet zien dat beroepsvoorspellers de markt niet versloegen Cowles (1933), Working stelde de random walk voor als nulhypothese Working (1934), en Kendall vond in wekelijkse prijsreeksen een samenhang die te zwak was om mee te voorspellen Kendall (1953).
Bij elk model in deze reeks stellen we de vraag theorie of feit: is dit een theorie die getoetst wordt, of een feit dat op een verklaring wacht? De random walk is een feit met een statistisch model, maar zonder economische verklaring. Waarom goed werkende markten zulke prijzen moeten opleveren, bewees Samuelson pas in 1965 Samuelson (1965).
2Intuïtie: waarom zou dit waar zijn?
Denk aan iemand die elke dag een munt opgooit. Bij kop zet hij een stap naar rechts, bij munt een stap naar links. Na honderd dagen staat hij gemiddeld op zijn beginpunt, want de stappen heffen elkaar op. Toch staat hij er vrijwel zeker niet. Hoe ver is hij er doorgaans vandaan?
De afstand kan niet evenredig met het aantal dagen groeien, want dan liep hij altijd dezelfde kant op. Hij kan ook niet gelijk blijven, want dan kwam hij nooit ver. Zijn de stappen onafhankelijk, dan tellen hun varianties op, en groeit de afstand met de wortel van de tijd. Twee keer zo lang wachten geeft 1,41 keer zo veel spreiding, vier keer zo lang wachten het dubbele.
Meer zegt Regnaults wet niet. Regnault drukte de wet in hoofdletters af, en in het Nederlands zegt ze dat de gemiddelde absolute afwijking van de koers evenredig is met de wortel van de tijd.
l’écart des cours est en raison directe de la racine carrée des temps
Regnault schreef over de Franse 3%-rente, maar het mechanisme is dat van de muntworp, omdat een koersverandering vandaag niets zegt over die van morgen. Het economische argument kwam pas later. Als iedereen wist dat de koers morgen stijgt, wilde vandaag niemand verkopen, zodat de koers vandaag al steeg.
Bachelier maakte de schokken oneindig klein en oneindig frequent. Daaruit ontstaat de Brownse beweging, waarmee meer uit te rekenen valt dan alleen de spreiding, en zo komen we tot drie verwachtingen.
De spreiding en de gemiddelde absolute afwijking van koersveranderingen groeien met de wortel van de horizon.
Een optie op het geld (uitoefenprijs gelijk aan de huidige koers) betaalt alleen bij uitschieters naar boven. Zo’n optie is daardoor meer waard naarmate de koers op de vervaldag meer spreidt, zodat een vier keer zo lange looptijd het dubbele kost.
Elke autocorrelatie van koersveranderingen is nul.
3Toy-voorbeeld: een random walk van vier stappen
De -wet is al zichtbaar in een wandeling van vier stappen. Eerst laden we de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from itertools import product
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Op elk tijdstip zet de wandelaar een stap van +1 of -1, elk met kans , onafhankelijk van de andere. Zijn positie is , met . Er zijn even waarschijnlijke paden.
| -4 | -2 | 0 | 2 | 4 | |
|---|---|---|---|---|---|
| aantal paden | 1 | 4 | 6 | 4 | 1 |
| kans |
Stap 1: de variantie. De verwachting is nul, want de verdeling is symmetrisch. De variantie is het kansgewogen kwadraat van de eindpositie:
Stap 2: de regel achter het getal. Elke stap heeft variantie 1 en de stappen zijn ongecorreleerd, dus en de standaarddeviatie is . Daarmee hebben we Regnaults wet al, zonder limiet en zonder normale verdeling.
Stap 3: de gemiddelde absolute afwijking. Regnault mat niet de standaarddeviatie maar de écart, de gemiddelde absolute afwijking . In dit college heet steeds zo, en met “spreiding” bedoelen we de standaarddeviatie.
Na één stap is . Na twee stappen staat de wandelaar op -2, 0 of 2 met kansen , , , zodat , omdat de helft van de paden terugkeert naar nul. Na drie stappen is .
Stap 4: de verhouding tot de wortel. loopt van via en naar . De verhouding schommelt nog, want de wandeling is grof.
Het recept. Voor lange wandelingen nadert die verhouding , en dat getal leidt de theorie als eerste af. De variantie is dus meteen gelijk aan , terwijl de absolute afwijking pas op den duur met meegroeit.
De code telt alle zestien paden na en zet de getallen die we met de hand vonden ernaast.
paths = np.array(list(product([-1, 1], repeat=4)))   # 16 paden van 4 stappen
positions = paths.cumsum(axis=1)                     # kolom n-1 bevat S_n
final = positions[:, -1]                             # eindpositie S_4

n = np.arange(1, 5)
var_by_code = positions.var(axis=0)
mean_abs_by_code = np.abs(positions).mean(axis=0)

toy = pd.DataFrame(
    {
        "Var(S_n) met de hand": [1, 2, 3, 4],
        "Var(S_n) code": var_by_code,
        "E|S_n| met de hand": [1.0, 1.0, 1.5, 1.5],
        "E|S_n| code": mean_abs_by_code,
        "E|S_n| / sqrt(n) met de hand": [1.0, 0.7071, 0.8660, 0.75],
        "E|S_n| / sqrt(n) code": mean_abs_by_code / np.sqrt(n),
    },
    index=pd.Index(n, name="n"),
)
toy.round(4)De kolommen met de hand en uit de code zijn gelijk. Al bij vier stappen groeit de variantie van een som van ongecorreleerde stappen dus lineair, en daardoor groeit de spreiding met de wortel van het aantal stappen.
4Theorie
We leiden vier dingen af. De kern is dat een random walk in de limiet een Brownse beweging wordt, waarvan de gemiddelde absolute afwijking met de wortel van de horizon groeit, met de factor uit het toy-voorbeeld. Daaruit volgen de kans om een niveau te raken, die laat zien dat de limiet over het hele pad gaat en niet alleen over de eindpositie, en Bacheliers optieprijs. Ten slotte komt de variance ratio, de toets waar simulatie en replicatie om draaien. De replicatie toetst de -wet en een variance ratio van één, maar de raakkans en de optieprijs toetsen we niet op data.
4.1Opzet en aannames
De nulhypothese is de random walk in log-prijzen. Vanaf hier zijn kleine letters logs: , met de prijs, en het log-rendement. Onder de nulhypothese zijn de onderling ongecorreleerd, met verwachting en variantie . Voor Amerikaanse maandrendementen is ongeveer 1% en ongeveer 5%. De toetsen gebruiken alleen varianties en autocorrelaties, dus speelt verder geen rol. In de notatie van Opzet, data en conventies is het simpele rendement, maar in dit college is het een logrendement.
Bachelier werkte niet met logs maar met het prijsniveau . Zijn proces heet nu aritmetische Brownse beweging, en daarin zijn de absolute prijsveranderingen normaal verdeeld. Zijn volatiliteit noemen we , een bedrag in euro per , bij een aandeel van 100 met 20% volatiliteit ongeveer 20 euro. In dit college houden drie symbolen steeds dezelfde betekenis. is de standaarddeviatie van één stap of één rendement, de positie van een wandeling, en het aantal waarnemingen. In Rendementen en hun statistiek heette dat aantal nog en stond voor het aantal jaren.
4.2Het kernresultaat: van random walk naar Brownse beweging
Worden de stappen kleiner en talrijker, dan wordt de wandeling een Brownse beweging, welke verdeling de stappen ook hebben. Deze stelling, van Donsker, is de kern van het college.
Het nieuwe aan de stelling is dat ze over het hele pad gaat. Neem een belegger die een verkooporder boven de koers heeft liggen. Of die order binnen een maand wordt uitgevoerd, hangt af van het hoogste punt dat de koers in die maand bereikt, niet van de slotkoers. De centrale limietstelling maakt alleen het maandrendement, de som van twintig dagrendementen, bij benadering normaal, terwijl de stelling van Donsker ook de verdeling van dat hoogste punt vastlegt. Van de zestien paden in het toy-voorbeeld raken er zes het niveau 2, terwijl er maar vijf op of boven dat niveau eindigen.
We herschalen de wandeling in de ruimte met en in de tijd met , met de standaarddeviatie van één stap. We willen uitkomen bij een standaard Brownse beweging , een continu proces met en onafhankelijke aangroeiingen .
Hier is de positie na een fractie van de stappen, gemeten in standaarddeviaties van de hele wandeling. Bij is het de eindpositie gedeeld door .
Bij veel kleine stappen is de herschaalde wandeling dus niet van een Brownse beweging te onderscheiden, ook niet in het hoogste punt van het pad, dat we hieronder voor de raakkans nodig hebben. De stelling vraagt wel meer dan de nulhypothese, namelijk onafhankelijke stappen met verwachting nul, en daarom trekt de replicatie eerst het gemiddelde af. Het volledige bewijs gaf Donsker in 1951, en de schets hieronder behandelt alleen de verdeling op vaste tijdstippen.
Proof 1
Schets voor de eindig-dimensionale verdelingen. Voor één tijdstip geldt
door de centrale limietstelling, en dus . Voor twee tijdstippen zijn en sommen over disjuncte blokken en dus onafhankelijk. In de limiet is dat precies wat een Brownse beweging definieert, namelijk onafhankelijke, normaal verdeelde aangroeiingen met .
Daarmee is Regnaults wet geen meting meer, maar een stelling. Voor de spreiding en de gemiddelde absolute afwijking over een horizon geldt
De tweede formule volgt uit de eerste, want met standaardnormaal, en , met de standaardnormale dichtheid. De gemiddelde absolute afwijking groeit dus met de wortel van de horizon, zoals we bij de intuïtie verwachtten. Bij geeft de tweede formule , tegen in het toy-voorbeeld, zodat vier stappen nog 6% onder de limiet zitten.
De figuur hieronder toont veertig herschaalde wandelingen van 2000 stappen, en het gaat daarin om de bundel, niet om één pad.
Source
n_steps, n_shown = 2000, 40
steps = rng.choice([-1.0, 1.0], size=(n_shown, n_steps)) / np.sqrt(n_steps)
walks = steps.cumsum(axis=1)
grid = np.arange(1, n_steps + 1) / n_steps

fig, ax = plt.subplots()
ax.plot(grid, walks.T, lw=0.7, color=hap.plotting.COLORS[0], alpha=0.35)
for sign in (-1, 1):
    ax.plot(grid, sign * np.sqrt(grid), color=hap.plotting.COLORS[1], lw=1.8,
            label=r"$\pm\sqrt{u}$" if sign == 1 else None)
ax.set_title("Veertig herschaalde random walks van 2000 stappen")
ax.set_xlabel("Herschaalde tijd $u$")
ax.set_ylabel("Positie $W^{(n)}(u)$")
ax.legend()
plt.show()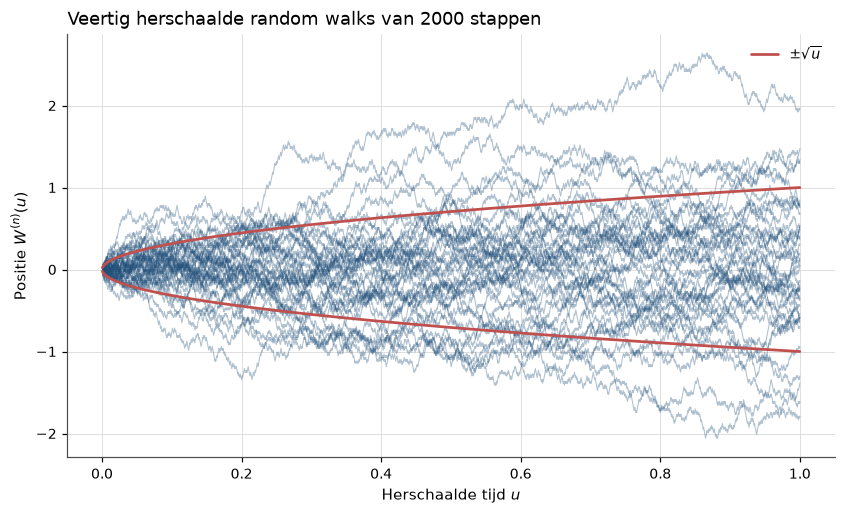
4.3Wat het voorspelt: de kans om een niveau te raken
De kans dat de koers vóór een datum ooit een niveau raakt, is ongeveer twee keer de kans dat hij op die datum boven staat. Die raakkans hangt af van de verdeling van het hele pad en niet alleen van de eindpositie, en daarom hadden we de stelling van Donsker nodig.
Waarom twee keer? Denk aan een belegger die een verkooporder neerlegt op een niveau boven de koers. Zodra de koers voor het eerst raakt, is een stap omhoog even waarschijnlijk als een stap omlaag. Voor elk pad dat daarna terugzakt, is er dus een even waarschijnlijk pad dat boven eindigt, zodat de order twee keer zo vaak wordt uitgevoerd als de eindkoers doet vermoeden.
De kans om ooit te raken is dus de kans om er precies op te eindigen, plus twee keer de kans om erboven te eindigen. Een hoger niveau verkleint de raakkans, en een langere horizon vergroot hem. Het bewijs spiegelt elk pad dat raakt en daarna onder eindigt, vanaf de eerste aanraking, in het niveau . Zo ontstaat een even waarschijnlijk pad dat boven eindigt, en elk pad boven ontstaat zo precies één keer.
In de Brownse limiet is de kans om exact op te eindigen nul, en blijft over. Neem als voorbeeld, zonder drift, een verkooporder 10 euro boven de koers bij een volatiliteit van 20 euro per . De order ligt dan een halve standaarddeviatie boven de koers. Na een jaar eindigt de koers in van de gevallen boven de order, zodat de order in 62% van de gevallen wordt uitgevoerd.
In het toy-voorbeeld is en . De stelling geeft . De code controleert dat door de zestien paden na te tellen.
touches_two = positions.max(axis=1) >= 2             # raakt het pad ooit +2?
by_counting = touches_two.mean()
by_reflection = (np.sum(final == 2) + 2 * np.sum(final > 2)) / 16

pd.Series(
    {"met de hand": 0.375, "geteld over 16 paden": by_counting,
     "reflectieprincipe": by_reflection},
    name="P(max S_k >= 2)",
).round(4)
met de hand 0.375
geteld over 16 paden 0.375
reflectieprincipe 0.375
Name: P(max S_k >= 2), dtype: float64Tellen en spiegelen geven allebei , zes van de zestien paden. Het reflectieprincipe klopt dus al bij vier stappen, zonder limiet.
4.4Wat het voorspelt: Bacheliers optieprijs
Volgt de koers een aritmetische Brownse beweging, dan is een calloptie evenveel waard als de verwachte uitbetaling. Op het geld is dat ongeveer .
Bachelier redeneerde vanuit de aanname dat de speculant gemiddeld niets wint (l’espérance mathématique du spéculateur est nulle). Wij noemen dat de martingaalconditie, en die zegt dat de verwachte koers op de vervaldag gelijk is aan de koers van vandaag, , zoals in een eerlijk kansspel. Een koper die meer betaalt dan de verwachte uitbetaling, verliest dan gemiddeld, en een verkoper die minder vraagt ook. De optieprijs is dus de verwachte uitbetaling. Hoe breder de verdeling van de koers op de vervaldag, hoe meer de optie waard is, omdat ze aan uitschieters naar boven verdient en aan uitschieters naar beneden niets verliest.
De optie is dus de intrinsieke waarde waard, gewogen met , de kans dat de optie in het geld eindigt, plus een term die groeit met de spreiding van de koers op de vervaldag. Diep in het geld (uitoefenprijs ver onder de koers) nadert de waarde , ver uit het geld nadert ze nul. Het bewijs integreert de uitbetaling over de normale dichtheid.
Proof 2
Het eenvoudigste geval is een optie op het geld (, dus ). Dan valt de eerste term weg en blijft over
Een optie op het geld is dus vier tiende van de spreiding van de koers op de vervaldag waard. Bij euro en een looptijd van een jaar is dat 7,98 euro. De prijs is evenredig met , zoals de intuïtie voorspelde, zodat een koper die de looptijd verviervoudigt het dubbele betaalt. Risicoaversie en verwacht rendement ontbreken in de formule, maar alleen omdat we de martingaalconditie hebben aangenomen. Black en Scholes lieten later zien waarom die aanname mag, want een optie die met aandeel en kas na te maken is, kost wat die portefeuille kost, welk verwacht rendement beleggers ook aannemen. Bachelier verdisconteerde niet, omdat hij met termijnkoersen werkte, prijzen die nu worden afgesproken en later betaald.
Black en Scholes Black & Scholes (1973) lieten de relatieve prijsverandering normaal verdeeld zijn in plaats van de absolute, en daarover gaat Black-Scholes-Merton en de CBOE. Bij korte looptijden en rond het geld vallen de twee prijzen vrijwel samen, met . De cel rekent beide prijzen uit voor een aandeel van 100 met een Black-Scholes-volatiliteit van 20% per jaar, voor drie looptijden en drie uitoefenprijzen.
def bachelier_call(S, K, sigma_abs, tau):
    """Bachelier (1900) call price under arithmetic Brownian motion, zero rate."""
    s = sigma_abs * np.sqrt(tau)
    d = (S - K) / s
    return (S - K) * stats.norm.cdf(d) + s * stats.norm.pdf(d)


def bs_call(S, K, sigma, tau):
    """Black-Scholes (1973) call price, zero rate."""
    d1 = (np.log(S / K) + 0.5 * sigma**2 * tau) / (sigma * np.sqrt(tau))
    d2 = d1 - sigma * np.sqrt(tau)
    return S * stats.norm.cdf(d1) - K * stats.norm.cdf(d2)


S0, sigma_bs = 100.0, 0.20
rows = []
for tau in (1 / 12, 0.5, 1.0):
    for K in (90.0, 100.0, 110.0):
        rows.append(
            {
                "looptijd (jaar)": tau,
                "K": K,
                "Bachelier": bachelier_call(S0, K, sigma_bs * S0, tau),
                "Black-Scholes": bs_call(S0, K, sigma_bs, tau),
            }
        )
table = pd.DataFrame(rows)
table["verschil"] = table["Bachelier"] - table["Black-Scholes"]
table.round(4)Bij een looptijd van een maand verschillen de twee prijzen hooguit drie cent. Bij een jaar en tien procent uit het geld is het verschil 0,34 euro, op een optie van ongeveer vier euro. Op het geld geeft de tabel bij een jaar 7,98, precies wat (10) voorspelt. Dat de Bachelier-koers negatief kan worden, is voor een aandeel onzin, maar voor een termijncontract juist gewenst. Toen de termijnprijs van ruwe olie in april 2020 negatief werd, kwam de formule daarom weer in gebruik.
De optieformule zelf toetsen we hier niet, want historische optieprijzen zijn niet gratis. Wel toetsen we de aanname eronder, namelijk dat koersveranderingen onvoorspelbaar zijn.
4.5Hoe het getoetst wordt: de variance ratio
De hoofdtoets is de variance ratio, omdat die veel kleine autocorrelaties bundelt en alleen varianties gebruikt, die goed meetbaar zijn. Net als de autocorrelatie kijkt de variance ratio naar koersveranderingen en niet naar het niveau. De koers van morgen ligt dicht bij die van vandaag en is daardoor met een kleine fout te voorspellen, maar voor de koersverandering van morgen lukt dat niet.
Autocorrelatie. Onder de nulhypothese is voor elke . De steekproefautocorrelatie heeft dan bij benadering standaardfout , met het aantal waarnemingen, en dat is bij een eeuw maanddata. Kendall rekende deze grootheid uit.
Variance ratio. De tweede toets vat de -wet samen in één getal. Voor een horizon van perioden is dat
De teller is de variantie van een rendement over perioden, de noemer keer de variantie over één periode. Onder de random walk is voor elke , want de variantie groeit lineair, zoals in het toy-voorbeeld. Een waarde boven één wijst op positieve autocorrelatie, een waarde onder één op negatieve.
Een variance ratio is dus één plus een gewogen som van de eerste autocorrelaties, met lineair aflopende gewichten. Is alleen , dan is . Voor volgt precies .
Proof 3
De variance ratio is om twee redenen de hoofdtoets. De eerste reden is dat ze bundelt. Als de afhankelijkheid over veel lags is uitgesmeerd, verdwijnt elke apart in de ruis, maar hun gewogen som niet. De tweede reden is dat ze alleen varianties gebruikt en zo de standaardfout van 2% uit Rendementen en hun statistiek omzeilt. Het gemiddelde jaarrendement is na een eeuw data nog maar op twee procentpunt nauwkeurig, terwijl een variantie over dezelfde eeuw veel nauwkeuriger bekend is. Een toets die alleen varianties vergelijkt, is daardoor scherp.
Onder de nulhypothese en bij constante variantie is de standaardfout van
gelijk aan Lo & MacKinlay (1988). Voor
is dat . Bij de 1216 weken van Lo en MacKinlay is ze
, , en voor , zodat de
toets bij lange horizonnen minder scherp is. De functie hap.variance_ratio geeft
(sleutel vr) en de toetsgrootheid (sleutel z2), die robuust is
voor clusterende volatiliteit. Omdat rustige en woelige perioden elkaar
afwisselen, zou de gewone de ruis onderschatten en een afwijking te vaak
significant noemen. Lo en MacKinlay noemen de
robuuste grootheid .
5Simulatie: hoeveel data om een afwijking te zien?
Een kleine autocorrelatie is pas na tientallen jaren data te zien. Om dat te laten zien, bouwen we een wereld van weekrendementen met 2% volatiliteit per week, eerst zonder afhankelijkheid en daarna met eerste autocorrelatie . Als maatstaf nemen we de steekproef van Lo en MacKinlay: weken, ruim drieëntwintig jaar. De eerste cel trekt 2000 paden zonder afhankelijkheid en vergelijkt de spreiding van met .
n_paths, T_lm = 2000, 1216
iid_paths = rng.normal(0.0, 0.02, size=(n_paths, T_lm))
vr_null = np.array([hap.variance_ratio(pd.Series(p), 2)["vr"] for p in iid_paths])

pd.DataFrame(
    {
        "waarde": [
            vr_null.mean(),
            vr_null.std(ddof=1),
            1 / np.sqrt(T_lm),
            np.mean(np.abs(vr_null - 1) > 1.96 / np.sqrt(T_lm)),
        ]
    },
    index=["gemiddelde VR(2)", "std.dev. van VR(2)", "asymptotische SE",
           "verwerpingsfractie bij 5%"],
).round(4)Onder de nulhypothese werkt de toets zoals bedoeld. Het gemiddelde is vrijwel één en de spreiding van ligt dicht bij , terwijl de toets in 4,3% van de steekproeven verwerpt, iets onder de nominale 5%.
Als alternatief nemen we een AR(1) in log-rendementen, . Daarvoor is en dus volgens (12). De cel simuleert voor drie waarden van en drie steekproeflengtes elk 1000 paden en telt hoe vaak de toets verwerpt.
def ar1_paths(rho, n_paths, T, sigma=0.02, burn=200):
    """Simulate AR(1) log-return paths, discarding a burn-in."""
    e = rng.normal(0.0, sigma, size=(n_paths, T + burn))
    x = np.empty_like(e)
    x[:, 0] = e[:, 0]
    for t in range(1, T + burn):
        x[:, t] = rho * x[:, t - 1] + e[:, t]
    return x[:, burn:]


rows = []
for rho in (0.05, 0.10, 0.20):
    for T in (260, 1040, 4160):
        results = [hap.variance_ratio(pd.Series(p), 2) for p in ar1_paths(rho, 1000, T)]
        vr_estimates = np.array([r["vr"] for r in results])
        rejected = np.array([abs(r["z2"]) > 1.96 for r in results])
        expected_z = rho * np.sqrt(T)            # (VR(2) - 1) / SE = rho * sqrt(T)
        analytic_power = stats.norm.sf(1.96 - expected_z) + stats.norm.cdf(-1.96 - expected_z)
        rows.append({"rho": rho, "jaren weekdata": T // 52,
                     "gemiddelde VR(2)": vr_estimates.mean(),
                     "onderscheidend vermogen": rejected.mean(),
                     "analytisch": analytic_power})
power = pd.DataFrame(rows)
power.round(3)De geschatte is in alle negen gevallen vrijwel , zodat de schatter nagenoeg zuiver is. Het onderscheidend vermogen, de kans dat de toets de foute nulhypothese verwerpt, hangt sterk af van de lengte van de steekproef. Omdat en de standaardfout ongeveer is, is de verwachte -waarde . Een verwachte van 1,96 vraagt dan
waarnemingen. Halveert de autocorrelatie, dan wordt de benodigde steekproef dus vier keer zo lang. Zelfs bij verwerpt de toets maar in de helft van de steekproeven, omdat de geschatte dan even vaak onder als boven de kritieke waarde ligt.
| (weken) | jaren | |
|---|---|---|
| 0,20 | 96 | 1,8 |
| 0,05 | 1537 | 30 |
| 0,02 | 9604 | 185 |
Een autocorrelatie van 0,02 vraagt 185 jaar weekdata, langer dan de 155 jaar van Shillers maandreeks, de langste reeks in dit college. Vanaf twintig jaar data volgt de simulatie de formule, maar bij vijf jaar wijkt ze tot drie procentpunt af, omdat de benadering daar nog grof is. De figuur zet het onderscheidend vermogen uit tegen de lengte van de steekproef. Let op waar de lijnen de verticale lijn van Lo en MacKinlay kruisen.
Source
T_grid = np.arange(52, 10_400, 52)
lm_years = T_lm / 52                                  # 1216 weken = 23,4 jaar

fig, ax = plt.subplots()
for i, rho in enumerate((0.02, 0.05, 0.10, 0.20)):
    z = rho * np.sqrt(T_grid)
    ax.plot(T_grid / 52, stats.norm.sf(1.96 - z) + stats.norm.cdf(-1.96 - z),
            color=hap.plotting.COLORS[i], label=rf"$\rho = {rho:.2f}$")
ax.scatter(power["jaren weekdata"], power["onderscheidend vermogen"],
           color="black", s=18, zorder=3, label="simulatie")
ax.axhline(0.5, color="black", ls="--", lw=0.9)
ax.axvline(lm_years, color=hap.plotting.COLORS[7], lw=1.2)
ax.text(lm_years * 1.05, 0.05, "Lo-MacKinlay (23 jaar)", fontsize=9)
ax.set_xscale("log")
ax.set_title("Kans om een afwijking van de random walk te verwerpen")
ax.set_xlabel("Jaren weekdata (log-schaal)")
ax.set_ylabel("Onderscheidend vermogen bij 5%")
ax.legend()
plt.show()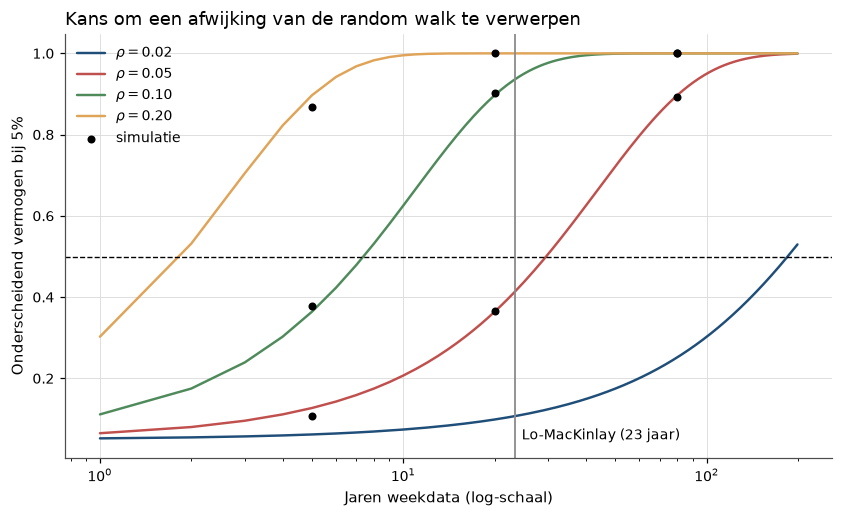
Figure 2:Het onderscheidend vermogen van de variance-ratio-toets tegen een AR(1), als functie van de lengte van de steekproef. De zwarte punten zijn de gesimuleerde waarden uit de tabel. Bij de drieëntwintig jaar weekdata van Lo en MacKinlay is een autocorrelatie van 0,20 zo goed als zeker zichtbaar, en een van 0,02 zo goed als onzichtbaar. Wie beweert dat een markt efficiënt is, bedoelt dus altijd dat ze efficiënt is voor zover de beschikbare data dat kunnen laten zien.
6Replicatie op echte data
De functie hieronder berekent per horizon de gemiddelde absolute afwijking en de standaarddeviatie van de verandering in de log-prijs, na aftrek van het gemiddelde. De kolom “Regnault” doet wat hij deed en vermenigvuldigt de gemiddelde absolute afwijking over één maand met .
# Shiller loopt hier van 1871-01 t/m 2026-09, French vanaf 1926-07.
MAD, SD, REGNAULT = "gem. abs. afwijking", "standaarddeviatie", "Regnault: maand x sqrt(h)"


def deviation_scaling(log_level, horizons=(1, 3, 12, 60)):
    """Mean absolute and standard deviation of h-period changes, demeaned."""
    rows = []
    for h in horizons:
        dev = (log_level.shift(-h) - log_level).dropna()
        dev = dev - dev.mean()
        rows.append({"h": h, "waarnemingen": len(dev), MAD: dev.abs().mean(),
                     SD: dev.std(ddof=1)})
    out = pd.DataFrame(rows).set_index("h")
    out[REGNAULT] = out[MAD].iloc[0] * np.sqrt(out.index)
    out["gem. abs. afw. / sqrt(h)"] = out[MAD] / np.sqrt(out.index)
    out["gem. abs. afw. / SD"] = out[MAD] / out[SD]
    return out


shiller = hap_data.shiller()
p_shiller = np.log(shiller["real_price"].dropna())
p_french = np.log1p(hap_data.market_monthly()["Mkt"]).cumsum()

regnault = pd.concat(
    {"Shiller 1871-2026": deviation_scaling(p_shiller),
     "French 1926-2026": deviation_scaling(p_french)},
    names=["reeks"],
)
regnault.round(4)Beide reeksen groeien veel trager dan lineair, want de kolom met in de noemer blijft voor French tussen 0,037 en 0,042 over een factor zestig in horizon. De volgende cel schat de helling en zet de uitkomst naast Regnaults eigen toets.
slopes = {}
for name, block in regnault.groupby(level="reeks"):
    log_h = np.log(block.index.get_level_values("h"))
    slopes[name] = np.polyfit(log_h, np.log(block[MAD]), 1)[0]


def predicted_over_observed(block, h):
    """One-month deviation times sqrt(h) (Regnault), divided by the observed one."""
    return block.loc[h, REGNAULT] / block.loc[h, MAD]


french_block = regnault.loc["French 1926-2026"]
shiller_block = regnault.loc["Shiller 1871-2026"]
pd.DataFrame(
    {
        "origineel (Regnault)": [0.5, 2.73 * np.sqrt(3) / 4.74, 2.73 * np.sqrt(12) / 9.50],
        "hier: French": [slopes["French 1926-2026"],
                         predicted_over_observed(french_block, 3),
                         predicted_over_observed(french_block, 12)],
        "hier: Shiller": [slopes["Shiller 1871-2026"],
                          predicted_over_observed(shiller_block, 3),
                          predicted_over_observed(shiller_block, 12)],
    },
    index=["helling b", "kwartaal: voorspeld / waargenomen",
           "jaar: voorspeld / waargenomen"],
).round(3)Geslaagd op de helling, gedeeltelijk geslaagd op Regnaults eigen toets. De French-helling van 0,511 ligt binnen de verwachte marge rond een half, en de falsifieerbare eis (factor twee) is ruim gehaald. De Shiller-helling ligt hoger, zoals verwacht, omdat de maandmiddeling de kortste horizon drukt. Regnaults overeenstemming van een half procent halen we niet, want voor French valt de voorspelde jaarwaarde ruim tien procent te laag uit, zoals de onderste regel van de tabel laat zien. Ongeveer twee derde daarvan komt doordat de standaarddeviatie sneller groeit dan , door de positieve maandautocorrelatie.
De rest komt van dikke staarten. Door wisselende volatiliteit is de gemiddelde absolute afwijking van maandveranderingen klein ten opzichte van hun spreiding, zodat de laatste kolom van de eerste tabel bij één maand verder onder de 0,80 van een normale verdeling ligt dan bij twaalf maanden. Regnault neemt die lage maandverhouding mee naar de jaarhorizon, waar ze hoger ligt.
De figuur zet beide reeksen op dubbellogaritmische schaal naast een lijn met helling een half. Het gaat erom dat beide reeksen evenwijdig aan die lijn lopen.
Source
fig, ax = plt.subplots()
for i, (name, block) in enumerate(regnault.groupby(level="reeks")):
    h = block.index.get_level_values("h").to_numpy(float)
    ax.plot(h, block[MAD], "o-", color=hap.plotting.COLORS[i], label=name)
reference = regnault.loc["French 1926-2026", MAD].iloc[0] * np.sqrt([1, 3, 12, 60])
ax.plot([1, 3, 12, 60], reference, ls="--", color="black", lw=1.2,
        label=r"referentie $\propto\sqrt{h}$")
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_title("Regnaults wet: gemiddelde absolute koersafwijking per horizon")
ax.set_xlabel("Horizon $h$ (maanden, log-schaal)")
ax.set_ylabel("$E|p_{t+h} - p_t|$ (log-schaal)")
ax.legend()
plt.show()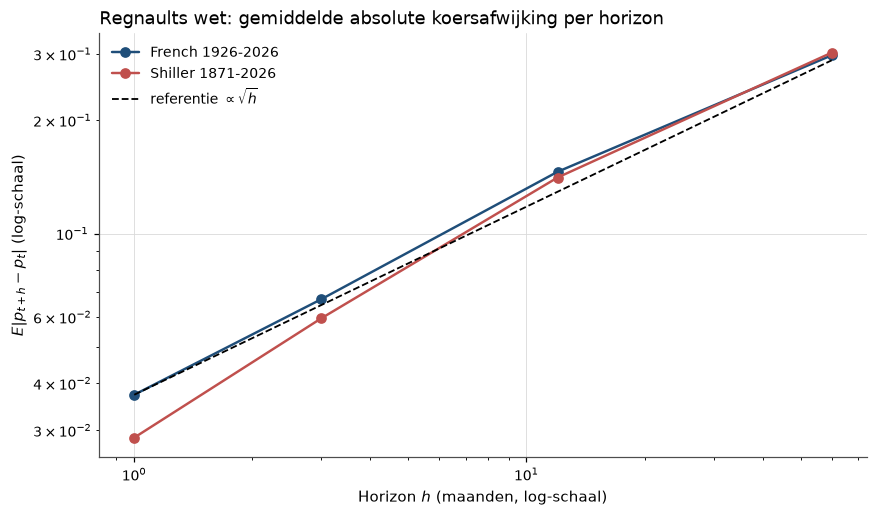
Figure 3:Op dubbellogaritmische schaal is Regnaults wet een rechte lijn met helling . Beide reeksen volgen die lijn van één maand tot vijf jaar. De lichte knik bij de kortste horizon in de Shiller-reeks komt van de maandmiddeling in zijn prijsreeks, niet van de markt.
De eerste cel berekent, zoals Kendall, de eerste vijf autocorrelaties, nu voor dag-, week- en maandrendementen van de Amerikaanse markt.
daily = np.log1p(hap_data.market_daily()["Mkt"])
weekly = daily.resample("W-FRI").sum()               # vrijdag op vrijdag
monthly = np.log1p(hap_data.market_monthly()["Mkt"])
frequencies = {"dagelijks": daily, "wekelijks": weekly, "maandelijks": monthly}

kendall_rows = {}
for name, s in frequencies.items():
    row = {"waarnemingen": len(s), "standaardfout bij random walk": 1 / np.sqrt(len(s))}
    for k in range(1, 6):
        row[f"ρ({k})"] = s.autocorr(k)
    kendall_rows[name] = row
kendall = pd.DataFrame(kendall_rows).T
kendall.round(4)Kendalls resultaat houdt in orde van grootte stand. Onze eerste weekautocorrelatie ligt ver onder de ongeveer die Kendall gemiddeld vond Kendall (1953), omdat zijn reeksen indices van dun verhandelde Britse aandelen waren, en zulke indices zijn sterker positief gecorreleerd. Het idee dat Kendall nulcorrelaties vond, is een misverstand, want hij vond positieve waarden die te zwak waren om mee te voorspellen.
De grootste autocorrelatie hier is die van maandrendementen, . Ze is significant, maar verklaart maar 0,7% () van de variantie van het volgende maandrendement. We verwachtten autocorrelaties van nul, en dat klopt bijna. Ze zijn niet precies nul, maar te klein om mee te voorspellen.
De variance ratios berekenen we op drie steekproeven: die van Lo en MacKinlay, de periode na hun steekproef, en het interbellum van 1928 tot 1938, ongeveer de tijd van Kendalls reeksen Kendall (1953).
def vr_table(series, horizons=(2, 4, 8, 16)):
    """Variance ratios with heteroskedasticity-robust z-statistics."""
    out = {"waarnemingen": len(series)}
    for q in horizons:
        result = hap.variance_ratio(series, q)
        out[f"VR({q})"] = result["vr"]
        out[f"z({q})"] = result["z2"]
    return out


# Lo en MacKinlay: 6 september 1962 t/m 26 december 1985, CRSP, woensdag op woensdag.
# French publiceert geen gelijkgewogen dagreeks; wij hebben alleen de waardegewogen markt.
samples = {
    "1962-09 t/m 1985-12": weekly.loc["1962-09-06":"1985-12-26"],
    "1986-01 t/m heden": weekly.loc["1986-01-01":],
    "interbellum 1928-1938": weekly.loc["1928":"1938"],
}
vr_samples = pd.DataFrame({k: vr_table(v) for k, v in samples.items()}).T
vr_samples.round(3)Op de steekproef van Lo en MacKinlay, 1216 weken zoals bij hen, liggen alle vier de ratio’s boven één. In de veertig jaar na hun steekproef liggen ze alle vier onder één, maar geen enkele is significant. De afwijking is dus verdwenen, zonder dat een omgekeerd teken is aangetoond. In het interbellum, met elf jaar data, is de afwijking het grootst.
Dezelfde berekening per kwintiel op marktwaarde, over 1962–1985, toetst de rangorde.
size = hap_data.french("Portfolios_Formed_on_ME", "monthly").loc["1962-09":"1985-12"]
quintiles = ["Lo 20", "Qnt 2", "Qnt 3", "Qnt 4", "Hi 20"]

size_table = pd.DataFrame(
    {q: vr_table(np.log1p(size[q].dropna()), horizons=(2, 4, 8)) for q in quintiles}
).T
size_table.index = ["1 (kleinst)", "2", "3", "4", "5 (grootst)"]
size_table.round(3)daalt monotoon van 1,205 bij het kleinste naar 1,016 bij het grootste kwintiel, en hetzelfde patroon staat in de kolommen voor en . De tabel hieronder zet onze waarden naast die van Kendall en van Lo en MacKinlay.
lm_sample = vr_samples.loc["1962-09 t/m 1985-12"]


def compare(original, here, z_original=np.nan, z_here=np.nan):
    """One row of the original-versus-here table."""
    return {"origineel": original, "hier": here, "z origineel": z_original, "z hier": z_here}


# Originelen: Kendall (1953), ongeveer; Lo en MacKinlay tabel 1a en 2.
q1, q3, q5 = "1 (kleinst)", "3", "5 (grootst)"
comparison_lm = pd.DataFrame.from_dict(
    {
        "Kendall: rho(1) week (gemiddelde)": compare(0.13, kendall.loc["wekelijks", "ρ(1)"]),
        "markt: VR(2)": compare(1.08, lm_sample["VR(2)"], 2.33, lm_sample["z(2)"]),
        "markt: VR(4)": compare(1.16, lm_sample["VR(4)"], 2.31, lm_sample["z(4)"]),
        "markt: VR(8)": compare(1.22, lm_sample["VR(8)"], 2.07, lm_sample["z(8)"]),
        "markt: VR(16)": compare(1.22, lm_sample["VR(16)"], 1.38, lm_sample["z(16)"]),
        "kwintiel 1 (kleinst): VR(2)": compare(1.42, size_table.loc[q1, "VR(2)"], 8.81, size_table.loc[q1, "z(2)"]),
        "kwintiel 3: VR(2)": compare(1.28, size_table.loc[q3, "VR(2)"], 7.38, size_table.loc[q3, "z(2)"]),
        "kwintiel 5 (grootst): VR(2)": compare(1.14, size_table.loc[q5, "VR(2)"], 3.82, size_table.loc[q5, "z(2)"]),
    },
    orient="index",
)
comparison_lm.round(3)Geslaagd voor de puntschattingen en de rangorde, gedeeltelijk geslaagd voor de -waarden. Voor de marktindex liggen alle vier de schattingen binnen 0,02 van de gepubliceerde waarden, met hetzelfde patroon over . De -waarden liggen met 1,2 tot 2,0 iets onder de verwachte twee, net als bij hen het laagst bij . De rangorde over de kwintielen, de falsifieerbare eis, is die van Lo en MacKinlay. De kwintielniveaus liggen tot 0,2 lager, omdat onze reeksen maandelijks en waardegewogen zijn, wat de afhankelijkheid wegmiddelt. Kendalls autocorrelatie komt, zoals verwacht, lager uit, al verklaart zelfs zijn 0,13 nog geen 2% () van de variantie van het volgende weekrendement.
De figuur vat beide tabellen samen. Let links op de ligging ten opzichte van één vóór en na 1985, en rechts op de daling van klein naar groot.
Source
fig, axes = plt.subplots(1, 2, figsize=(10.5, 4.2))

for i, (name, series) in enumerate(list(samples.items())[:2]):
    qs = np.array([2, 4, 8, 16])
    vrs = [hap.variance_ratio(series, q)["vr"] for q in qs]
    axes[0].plot(qs, vrs, "o-", color=hap.plotting.COLORS[i], label=name)
axes[0].axhline(1.0, color="black", lw=1.0, ls="--")
axes[0].set_title("Variance ratio van weekrendementen")
axes[0].set_xlabel("Horizon $q$ (weken)")
axes[0].set_ylabel("$VR(q)$")
axes[0].legend()

axes[1].bar(range(5), size_table["VR(2)"], color=hap.plotting.COLORS[0])
axes[1].axhline(1.0, color="black", lw=1.0, ls="--")
axes[1].set_xticks(range(5), size_table.index)
axes[1].set_title("$VR(2)$ per grootte-kwintiel, 1962-1985")
axes[1].set_xlabel("Kwintiel op marktwaarde")
axes[1].set_ylabel("$VR(2)$")
plt.show()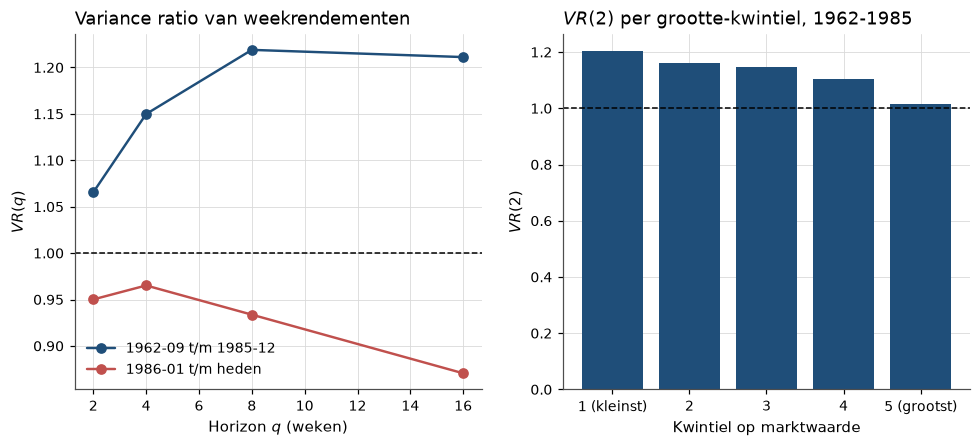
Figure 4:Links liggen de variance ratios op de steekproef van Lo en MacKinlay boven één, en ze lopen op tot . Na 1985 liggen ze onder één, zonder dat een ervan significant is. Rechts is te zien dat de afwijking van de random walk groter is naarmate de onderneming kleiner is. Beide panelen laten open of het om een prijsfout ging of om een eigenschap van de handel in kleine aandelen.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Uit de aanname dat opeenvolgende koersveranderingen ongecorreleerd zijn, volgen de -wet (helling 0,51 op French-data), de Brownse beweging als limiet, de kans om een niveau te raken, en een optieformule die voor korte looptijden nauwelijks van Black-Scholes verschilt. Het model verklaart ook waarom beroepsvoorspellers als groep falen, en Cowles vond in 1933 al dat adviesdiensten het gemiddeld slechter deden dan de markt Cowles (1933).
Waar het breekt. De zwaarste breuk is dat de random walk iets zegt over veranderingen en niets over het niveau. Het is een theorie van de ruis, niet van de waarde. De tweede breuk is empirisch, want de variance ratios liggen boven één en dalen met de grootte van de onderneming. Volgens (14) is de afwijking van het kleinste kwintiel al na ongeveer acht jaar maanddata zichtbaar, terwijl de week- van de hele markt zo’n 4270 weken vraagt. Onze 5223 weken liggen daar maar net boven, zodat de toets die kleine autocorrelatie iets vaker wel dan niet zou vinden. Technisch laat de aritmetische Brownse beweging negatieve prijzen toe, en daarom verplaatste Osborne het model in 1959 naar de log-prijs Osborne (1959).
Risico of vergissing? De variance ratios boven één, hoger bij kleinere ondernemingen, laten beide lezingen toe. Volgens de Chicago-lezing (Fama, voor wie prijzen kloppen) worden kleine aandelen niet elke dag verhandeld, zodat hun laatste koers achterloopt en indexrendementen vanzelf positief gecorreleerd raken. Volgens de Yale-lezing (Shiller, voor wie prijzen ernaast kunnen zitten) past de prijs zich in weinig gevolgde aandelen te traag aan. Dat de afwijking na 1985 verdween, past bij beide lezingen, want er wordt vaker gehandeld en er zijn meer analisten. Om de lezingen te scheiden, is de handelsfrequentie per aandeel vóór 1985 nodig, en die zit in de betaalde CRSP-databank, niet in de gratis bronnen van deze reeks.
Wat er daarna kwam. Voordat iemand kon zeggen of een prijs fout was, moest er een theorie zijn van wat een prijs hoort te zijn. John Burr Williams schreef die in 1938 op, in Williams en het dividend discount model.
8Oefeningen
Solution to Exercise 1
(1) Eén stap heeft verwachting en variantie . Omdat de stappen onafhankelijk zijn, tellen beide op: en . De code weegt de zestien paden van het toy-voorbeeld met hun nieuwe kansen.
prob_up = 0.6
path_prob = np.prod(np.where(paths == 1, prob_up, 1 - prob_up), axis=1)   # kans per pad
mean_skewed = path_prob @ final
var_skewed = path_prob @ (final - mean_skewed) ** 2

pd.DataFrame(
    {"met de hand": [0.8, 3.84], "code": [mean_skewed, var_skewed]},
    index=["E[S_4]", "Var(S_4)"],
).round(4)(2) De variantie groeit nog steeds lineair, als , dus de spreiding rond het verwachte pad groeit met . Het verwachte pad zelf loopt lineair weg, als . Vanaf ongeveer 24 stappen is de drift groter dan de spreiding (). Zonder aftrek van het gemiddelde trekt de drift de geschatte helling naar één.
De -wet gaat dus over de spreiding rond de drift. Een toets van de wet moet de drift daarom eerst verwijderen.
:::{exercise}
:label: ex-bachelier-1

**De variance ratio van een AR(1).** Laat $r_t = \rho\,r_{t-1} + e_t$ met
$|\rho| < 1$ en $e_t$ witte ruis. Dat is het proces waarmee de simulatie de
afwijking van de random walk maakte.

1. Toon aan dat $\rho_j = \rho^{\,j}$ en leid met [](#eq-bachelier-vr-rho) een
   gesloten uitdrukking af voor $VR(q)$.
2. Bereken $VR(2)$, $VR(4)$, $VR(8)$ en $VR(16)$ voor $\rho = 0{,}10$, en bepaal
   $\lim_{q \to \infty} VR(q)$.
3. Schat de vier ratio's op één gesimuleerd pad van 1216 weken. Bij welke $q$ is
   de $z$-waarde het grootst, en waarom?
Solution to ex-bachelier-1
rho_ex = 0.10


def vr_ar1(rho, q):
    """Population variance ratio of an AR(1) at horizon q."""
    j = np.arange(1, q)
    return 1 + 2 * np.sum((1 - j / q) * rho**j)


path = pd.Series(ar1_paths(rho_ex, 1, 1216)[0])
rows = []
for q in (2, 4, 8, 16):
    result = hap.variance_ratio(path, q)
    rows.append({"q": q, "VR theoretisch": vr_ar1(rho_ex, q),
                 "VR geschat": result["vr"], "z": result["z2"]})

pd.DataFrame(rows).set_index("q").round(4)De theoretische waarden stijgen met sterk afnemende opbrengst naar 1,222. In dit ene pad (een andere startwaarde van de toevalsgenerator geeft andere getallen) liggen de schattingen erboven, tot 1,42 bij . De grootste -waarde valt bij de kleinste horizon: 4,51 bij tegen 3,29 bij . De standaardfout van groeit ongeveer met , terwijl na nauwelijks nog toeneemt.
Tegen een AR(1) is de kortste horizon dus de scherpste toets. Daar is het signaal al vrijwel volledig, terwijl de ruis er het kleinst is.
:::{exercise}
:label: ex-bachelier-3

**De replicatie uitgebreid: is de afwijking verdwenen?** Lo en MacKinlay
publiceerden in 1988 op data tot eind 1985. Sindsdien is er ruim veertig jaar
data bijgekomen.

1. Herhaal de variance-ratio-tabel voor de grootte-kwintielen op de periode
   1986-01 tot heden. Blijft de rangorde bestaan?
2. Bereken per kwintiel het verschil in $VR(2)$ tussen de twee periodes. Hoe
   groot is dat verschil vergeleken met de standaardfout?
3. Ofwel is de anomalie weggearbitreerd, ofwel is de handel zelf veranderd. Welke meting
   zou de twee verklaringen kunnen scheiden, en hebben wij die?
Solution to ex-bachelier-3
(1) De cel herhaalt de kwintieltabel vanaf 1986.
size_late = hap_data.french("Portfolios_Formed_on_ME", "monthly").loc["1986-01":]
late_table = pd.DataFrame(
    {q: vr_table(np.log1p(size_late[q].dropna()), horizons=(2, 4, 8))
     for q in quintiles}
).T
late_table.index = size_table.index
late_table.round(3)De rangorde blijft bestaan, van 1,143 bij het kleinste naar 1,017 bij het grootste kwintiel, maar het profiel is naar beneden geschoven. Alleen het kleinste kwintiel is met nog significant, en bij is het patroon verdwenen.
(2) De volgende cel zet de twee periodes naast elkaar, met de standaardfout per periode.
comparison = pd.DataFrame(
    {
        "VR(2) 1962-1985": size_table["VR(2)"],
        "VR(2) 1986-heden": late_table["VR(2)"],
        "SE 1962-1985": 1 / np.sqrt(size_table["waarnemingen"].astype(float)),
        "SE 1986-heden": 1 / np.sqrt(late_table["waarnemingen"].astype(float)),
    }
)
comparison["verschil"] = comparison["VR(2) 1962-1985"] - comparison["VR(2) 1986-heden"]
comparison["t van het verschil"] = comparison["verschil"] / np.sqrt(
    comparison["SE 1962-1985"] ** 2 + comparison["SE 1986-heden"] ** 2
)
comparison.round(3)Geen van de vijf verschillen haalt twee standaardfouten, zoals de laatste kolom laat zien. De standaardfout van het verschil is ongeveer , van dezelfde orde als de verschuivingen van 0,06 tot 0,10 in de vier kleinste kwintielen. Zo’n kleine verschuiving vraagt volgens (14) veel langere periodes dan de twee die we hebben. De afwijking lijkt dus verdwenen, terwijl het verschil statistisch niet van nul te onderscheiden is.
(3) Beide verklaringen voorspellen dat de afwijking sinds 1985 kleiner werd, zoals in “Risico of vergissing?”. De meting die ze scheidt, de handelsfrequentie per aandeel vóór 1985, zit in CRSP (de betaalde databank met Amerikaanse aandelenkoersen sinds 1926), en die hebben wij niet.
Dat een anomalie na publicatie verdwijnt, is met één reeks dus niet te bewijzen. Waarom ze verdween, is met de gratis data evenmin vast te stellen.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Lo, A. W., & MacKinlay, A. C. (1988). Stock Market Prices Do Not Follow Random Walks: Evidence from a Simple Specification Test. Review of Financial Studies, 1(1), 41–66. 10.1093/rfs/1.1.41
- Regnault, J. (1863). Calcul des chances et philosophie de la bourse. Mallet-Bachelier et Castel.
- Bachelier, L. (1900). Théorie de la spéculation. Annales Scientifiques de l’École Normale Supérieure, 17, 21–86. 10.24033/asens.476
- Cowles, A. (1933). Can Stock Market Forecasters Forecast? Econometrica, 1(3), 309–324. 10.2307/1907042
- Working, H. (1934). A Random-Difference Series for Use in the Analysis of Time Series. Journal of the American Statistical Association, 29(185), 11–24. 10.1080/01621459.1934.10502683
- Kendall, M. G. (1953). The Analysis of Economic Time-Series—Part I: Prices. Journal of the Royal Statistical Society. Series A (General), 116(1), 11–34. 10.2307/2980947
- Samuelson, P. A. (1965). Proof That Properly Anticipated Prices Fluctuate Randomly. Industrial Management Review, 6(2), 41–49.
- Black, F., & Scholes, M. (1973). The Pricing of Options and Corporate Liabilities. Journal of Political Economy, 81(3), 637–654. 10.1086/260062
- Osborne, M. F. M. (1959). Brownian Motion in the Stock Market. Operations Research, 7(2), 145–173. 10.1287/opre.7.2.145
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD