

Markowitz, Roy en Tobin
1Overzicht
Welke portefeuille hoort een belegger te houden, en hoe riskant is één activum daarin? Markowitz antwoordt dat een activum zo riskant is als zijn covariantie met de portefeuille, en dat de beste portefeuilles precies volgen uit de verwachte rendementen en de covariantiematrix . Maar is zo slecht te schatten dat de geschatte optimale portefeuille in de praktijk verliest van gewoon gelijk spreiden, en nog duidelijker van de minimum-variantieportefeuille, die niet gebruikt.
In dit college
leiden we de efficiënte grens af en laten we zien dat alle efficiënte portefeuilles mengsels zijn van twee fondsen;
voegen we met Tobin een risicovrij activum toe, waarna iedereen dezelfde tangentportefeuille houdt;
laten we zien waarom in een grote portefeuille alleen covariantie overblijft;
simuleren we hoeveel van de optimale Sharpe-ratio overblijft als en geschat moeten worden;
repliceren we DeMiguel et al. (2009) op French-data, waarin de gelijkgewogen portefeuille (hierna 1/N) de mean-variance-portefeuille, de tangentportefeuille uit geschatte momenten, verslaat.
Markowitz publiceerde zijn artikel in maart 1952 Markowitz (1952). Het stond haaks op Williams, want als alleen verwachte dividenden tellen, stopt een belegger alles in één aandeel, en dat doet niemand. In juli van hetzelfde jaar kwam A. D. Roy in Econometrica bij bijna dezelfde meetkunde uit Roy (1952). Tobin voegde in 1958 het risicovrije activum toe Tobin (1958), en in 1959 volgde het boek van Markowitz Markowitz (1959). Met dit werk verschoof de vraag van wat een aandeel waard is naar welke portefeuille een belegger wil houden. Markowitz levert daarmee een theorie van keuze, die zegt wat een belegger hoort te kiezen en niet wat prijzen doen, en een toetsbare uitspraak over prijzen komt pas met het CAPM.
2Intuïtie: waarom zou dit waar zijn?
Neem een belegger met één aandeel die een tweede overweegt. Vóór 1952 was de vraag hoe riskant dat tweede aandeel is, maar Markowitz vroeg hoe riskant de portefeuille wordt.
Denk aan twee aandelen die even hard op en neer gaan, maar nooit tegelijk. Elk apart is riskant, terwijl de portefeuille half om half veel rustiger is, want waar de een verliest, wint de ander vaak. Nemen we daarentegen twee aandelen die even hard bewegen en dat altijd tegelijk doen, dan zijn ze samen even riskant als elk apart.
Wie alleen de afzonderlijke aandelen bekijkt, ziet tussen die twee gevallen geen verschil, want dat zit in hoe ze samen bewegen. Anders gezegd, diversificatie is het beheer van covariantie. Honderd bankaandelen die op elkaar lijken, zijn niet gespreid, terwijl drie activa die niets met elkaar te maken hebben dat wel zijn.
In een goed gespreide portefeuille hangt het risico van een extra aandeel dus alleen af van zijn covariantie met wat er al is. Zijn idiosyncratische risico (het eigen risico, dat met de rest niets te maken heeft) verdwijnt in de massa, en voor risico dat verdwijnt, hoeft niemand betaald te worden.
Omdat een belegger op twee grootheden let, verwacht rendement en variantie, ontstaat er een afruil. De portefeuilles met de laagste variantie bij elk verwacht rendement vormen samen de minimum-variantierand. Het bovenste deel daarvan is niet te verslaan en heet de efficiënte grens (efficient frontier). Roys belegger wil vooral een ramp vermijden, maar komt bij dezelfde portefeuilles uit.
Toen Tobin schatkistpapier toevoegde, viel de keuze in twee stappen uiteen. Een belegger kiest eerst de risicovolle portefeuille met de beste verhouding tussen premie en risico, en beslist daarna pas hoeveel geld erin gaat. Wie voorzichtig is, houdt meer schatkistpapier en wie durft, leent bij, maar de risicovolle portefeuille is voor beiden dezelfde.
We verwachten dus twee dingen. Een mengsel van activa kan veiliger zijn dan het veiligste activum, omdat de delen niet samen bewegen. Daarnaast krijgt een activum dat met de rest meebeweegt weinig gewicht, ook als het veel oplevert.
3Toy-voorbeeld: de minimum-variantieportefeuille van drie activa
Het kleinste voorbeeld heeft drie activa met jaarcijfers: aandelen, kleine aandelen en obligaties. Met de hand volgen we één mechanisme, namelijk dat een mengsel van riskante activa veiliger kan zijn dan het veiligste activum. De eerste cel laadt de pakketten voor het hele college.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Nu de pakketten geladen zijn, leggen we de drie activa vast. De tabel geeft per activum het verwachte rendement, de standaarddeviatie en de correlaties, alle per jaar.
| Activum | met aandelen | met kleine aandelen | met obligaties | ||
|---|---|---|---|---|---|
| aandelen | 10,0% | 20,0% | 1 | 1/3 | 0 |
| kleine aandelen | 14,0% | 30,0% | 1/3 | 1 | 0 |
| obligaties | 4,0% | 10,0% | 0 | 0 | 1 |
Obligaties zijn het veiligst en de twee soorten aandelen bewegen deels samen. Alle rendementen zijn netto, zodat 10% staat voor 0,10.
Het recept. De minimum-variantieportefeuille (de portefeuille met de laagste variantie) heeft gewichten evenredig met , dat wil zeggen de inverse covariantiematrix maal een vector van enen, daarna geschaald zodat de gewichten optellen tot één. Dit recept is het eerste wat de theorie afleidt.
Stap 1: de covariantiematrix. Elke covariantie is . Voor aandelen en kleine aandelen is dat , en daarmee liggen de verwachte rendementen en de covariantiematrix vast:
Stap 2: de inverse. Omdat obligaties met niets correleren, valt uiteen in een -blok en een los getal. Het blok heeft determinant . Een -matrix keren we om door de diagonaal te wisselen, het teken van de andere twee elementen om te draaien en alles door de determinant te delen, zodat en . Voor obligaties is het , en samen geeft dat
Het negatieve getal buiten de diagonaal betekent dat een portefeuille met meer aandelen minder kleine aandelen nodig heeft. Twee activa die samen bewegen, kunnen elkaar namelijk vervangen.
Stap 3: de rijsommen. We tellen per rij de elementen van op. Dat geeft , met som .
Stap 4: de gewichten. We delen elke rijsom door die som, zodat de gewichten optellen tot één. Dat geeft .
Stap 5: het risico. Elke rij van is de covariantie van een activum met de portefeuille, en die is voor alle drie gelijk: . Omdat de gewichten optellen tot één, is , dus .
Obligaties alleen hebben een standaarddeviatie van 10,0%, terwijl het mengsel met 22% in aandelen op 8,83% uitkomt. De codecel rekent dezelfde getallen na.
mu = np.array([0.10, 0.14, 0.04])
sd = np.array([0.20, 0.30, 0.10])
corr = np.array([[1.0, 1 / 3, 0.0],
                 [1 / 3, 1.0, 0.0],
                 [0.0, 0.0, 1.0]])
Sigma = corr * np.outer(sd, sd)
ones = np.ones(3)

Sinv_1 = np.linalg.solve(Sigma, ones)        # Sigma^{-1} 1, stap 3
w_mv = Sinv_1 / Sinv_1.sum()                 # stap 4
sigma_mv = np.sqrt(w_mv @ Sigma @ w_mv)      # stap 5

pd.DataFrame(
    {"met de hand": [0.1707, 0.0488, 0.7805, 0.0883],
     "code": [w_mv[0], w_mv[1], w_mv[2], sigma_mv]},
    index=["gewicht aandelen", "gewicht kleine aandelen", "gewicht obligaties",
           "standaarddeviatie"],
).round(4)De handberekening en de code geven dezelfde getallen. Door riskante aandelen toe te voegen wordt het geheel dus rustiger dan obligaties alleen, omdat die aandelen niet met obligaties meebewegen.
4Theorie
We beginnen bij de eerste-ordevoorwaarde, met als eerste gevolg het recept uit het toy-voorbeeld. Daaruit volgt de kern van het college, namelijk dat de minimum-variantierand een parabool is en dat elke portefeuille erop een mengsel is van twee vaste fondsen. Daarna voegen we een risicovrij activum toe (Tobin, met Roy als variant) en laten we zien waarom in een grote portefeuille alleen covariantie overblijft. We eindigen bij de reden waarom de theorie in de praktijk strandt, de schatting van .
4.1Opzet en aannames
We werken met netto rendementen in de notatie van Opzet, data en conventies, waarin netto is (10% is 0,10), bruto en de risicovrije rente netto (2% is 0,02). Er zijn risicovolle activa met rendementen , verwachting en covariantiematrix . Een portefeuille is een gewichtsvector met , met
De variantie van de portefeuille is een gewogen som van alle covarianties, waarbij de varianties het geval zijn. Met risico bedoelen we in dit college de standaarddeviatie. We maken vier aannames.
Alleen en tellen. Een belegger wil meer verwachting en minder variantie, en geeft om niets anders.
is positief definiet. Geen activum is een exacte combinatie van de andere, dus bestaat.
Short verkopen mag. Gewichten mogen negatief zijn, zodat de optimalisatie geen ongelijkheden kent.
Lenen en uitlenen tegen mag onbeperkt. Deze aanname is pas nodig vanaf Tobin.
Aanname 1 is de zwakste. Ze geldt bij normaal verdeelde rendementen of kwadratisch nut. In andere gevallen is ze een tweede-ordebenadering van elk nut, die volstaat zolang de verdeling niet te scheef is en geen dikke staarten heeft.
4.2Het kernresultaat: de efficiënte grens
Elke belegger die alleen op verwachting en variantie let (aanname 1), kiest een portefeuille op de efficiënte grens, en elke portefeuille op die grens is een mengsel van twee vaste fondsen. Denk aan een belegger die een portefeuille ziet met hetzelfde verwachte rendement en minder variantie. Hij ruilt om, en bij elke ruil daalt zijn variantie terwijl zijn verwachte rendement gelijk blijft. Hij stopt pas als zo’n ruil niet meer bestaat, dus op de minimum-variantierand, en alleen welk punt van de efficiënte grens hij kiest, hangt van zijn smaak af.
Formeel zoeken we de gewichten met de kleinste variantie, onder de eis dat het verwachte rendement is en de gewichten optellen tot één. Het probleem is
De factor maakt de afgeleide eenvoudiger. Omdat short verkopen mag (aanname 3), zijn er geen ongelijkheden en volstaat een Lagrangiaan:
Hier is de schaduwprijs van de rendementseis en die van de budgeteis. Deze is dus een Lagrange-multiplicator en niet de prijs van risico uit de notatie van de reeks. De eerste-ordevoorwaarde is . Omdat inverteerbaar is (aanname 2), volgt
De -de rij van is , zodat in het optimum de covariantie van elk activum met de portefeuille een vaste lineaire functie is van zijn verwachte rendement, . De eigen variantie van activum telt alleen mee via die covariantie. Stijgt het verwachte rendement van één activum, dan krijgt het meer gewicht tot zijn covariantie met de portefeuille weer in verhouding is, en daalt het, dan gebeurt het omgekeerde.
Het eerste gevolg is het recept uit het toy-voorbeeld. Zonder rendementseis is , en (6) geeft na normaliseren . Er staat geen in, en om dat feit draait de tweede helft van dit college. In het toy-voorbeeld is deze portefeuille met 8,83% veiliger dan het veiligste activum (10%), en dat bevestigt de eerste verwachting uit de intuïtie.
Om de minimum-variantierand te tekenen, moeten en voor elk vereist rendement vastliggen. Daarvoor zijn vier getallen nodig:
De getallen , en zijn de drie manieren om en met te combineren. meet hoe sterk de verwachte rendementen uiteenlopen en zou nul zijn als alle activa hetzelfde verwachte rendement hadden. In het toy-voorbeeld is , de som uit stap 3. Omdat , ligt altijd tussen nul en , en hier is tegen , bijna een kwart van het maximum.
Invullen van (6) in de twee restricties geeft het stelsel en . Met de regel van Cramer volgt
Hoe hoger het vereiste rendement, hoe zwaarder dus de richting weegt en hoe lichter de richting van de minimum-variantieportefeuille. In het toy-voorbeeld wijst die laatste vooral naar obligaties, , en de eerste relatief meer naar aandelen, . Bij is en .
De variantie van de oplossing volgt nu snel. Uit (6) is (in het toy-voorbeeld bij 10%: ), dus
De laagste haalbare variantie is dus een parabool in het vereiste verwachte rendement, met het minimum bij en variantie . In het toy-voorbeeld ligt dat minimum bij 5,51% verwacht rendement en 8,83% standaarddeviatie, precies de portefeuille die we met de hand vonden. Een hoger vereist rendement kost variantie, want bij geeft de formule , al is dat nog altijd minder dan de 20% risico waarmee aandelen alleen hetzelfde verwachte rendement leveren. De codecel rekent deze getallen na.
Sinv_mu = np.linalg.solve(Sigma, mu)
A = ones @ Sinv_1
B = ones @ Sinv_mu
C = mu @ Sinv_mu
D = A * C - B**2
sigma_at_10 = np.sqrt((A * 0.10**2 - 2 * B * 0.10 + C) / D)   # eq-markowitz-frontier

pd.DataFrame(
    {"met de hand": [128.125, 7.0625, 0.51125, 15.625, 0.0551, 0.0883, 0.1559],
     "code": [A, B, C, D, B / A, np.sqrt(1 / A), sigma_at_10]},
    index=["A", "B", "C", "D", "verwacht rendement minimum-variantie",
           "standaarddeviatie minimum-variantie", "standaarddeviatie op de grens bij 10%"],
).round(4)De code bevestigt de handberekening. Vooral de laatste regel is van belang, want de efficiënte portefeuille met 10% verwacht rendement heeft ruim een vijfde minder risico dan aandelen alleen.
Waarom zijn twee fondsen genoeg? Denk aan een fondsaanbieder met klanten die verschillende rendementen eisen. Een klant die een procentpunt meer eist, krijgt minder obligaties en meer aandelen, en elk volgend procentpunt vraagt dezelfde verschuiving. Een klant met een eis tussen die van twee andere klanten krijgt dus een mengsel van hun portefeuilles, zodat twee fondsen volstaan voor iedereen.
Het idee van het bewijs is om en in (6) in te vullen. De gewichten worden dan een vaste vector plus maal een tweede vaste vector, een affiene functie van (lineair plus een constante). Een mengsel van twee punten op zo’n rechte ligt weer op die rechte. Welke twee portefeuilles van de minimum-variantierand als fondsen dienen, maakt niet uit, en een handig paar is de minimum-variantieportefeuille en , met verwacht rendement . In het toy-voorbeeld zijn dat en .
Proof 1
Stap 1: de gewichten zijn affien in . We vullen en in (6) in:
met en onafhankelijk van . Dan is , omdat , en dat is precies de bewering.
Stap 2: elk mengsel ligt op de minimum-variantierand. Het mengsel telt op tot één en heeft verwacht rendement . Volgens stap 1 is het gelijk aan de minimaliserende portefeuille bij dat rendement. Die is uniek omdat positief definiet is (aanname 2).
Zien alle beleggers dezelfde en (homogene verwachtingen, een aanname die Markowitz niet nodig heeft), dan houdt ook de markt als geheel een mengsel van dezelfde twee fondsen. Daarmee is de eerste stap naar een evenwichtsmodel gezet.
4.3Een risicovrij activum: Tobin en Roy
Met een risicovrij activum houdt iedereen dezelfde risicovolle portefeuille, en alleen de dosis verschilt. Waarom zou dit waar zijn? Een belegger verdeelt zijn geld over schatkistpapier, dat zeker oplevert, en een risicovolle portefeuille . Zet hij meer geld in , dan stijgen premie en standaarddeviatie in dezelfde verhouding. Ruilt hij in voor een portefeuille met meer premie per eenheid risico, dan krijgt hij bij elk risico meer rendement. Hij blijft dus ruilen tot er geen betere meer is, en dat eindpunt hangt af van , en , niet van zijn smaak.
Schrijf voor de premies (verwachte overrendementen boven de risicovrije rente). De belegger maximeert de Sharpe-ratio, de premie per eenheid standaarddeviatie. Sharpe gebruikte die maat in 1966 Sharpe (1966), en later kreeg ze zijn naam.
Deze verhouding hangt niet af van de schaal van . Als we de afgeleide gelijk aan nul stellen, vinden we , zodat de covariantie van elk activum met de portefeuille evenredig is met zijn premie. Omdat inverteerbaar is (aanname 2), volgt na normaliseren
In woorden: de tangentportefeuille weegt elk activum met zijn premie, gecorrigeerd voor hoe het met de andere activa meebeweegt. is de helling van de kapitaalmarktlijn (de rechte vanuit de risicovrije rente door de tangentportefeuille), de hoogste Sharpe-ratio die deze activa samen halen.
In het toy-voorbeeld, met een risicovrije rente van 2%, rekenen we dat met de hand na.
, dus de Sharpe-ratio’s per activum zijn , en .
.
De som is , dus .
, dus .
Het verwachte rendement is , een premie van procentpunt, en .
Met een Sharpe-ratio van 0,529 doet het mengsel het beter dan het beste afzonderlijke activum, dat op 0,40 blijft steken. Kleine aandelen hebben het hoogste verwachte rendement en krijgen toch maar 22%, minder dan de saaie obligaties, omdat ze met aandelen meebewegen en weinig toevoegen aan wat aandelen al leveren. Zo komt ook de tweede verwachting uit, want meebewegen kost gewicht, hoe hoog het rendement ook is.
Stijgt , dan bieden de veilige portefeuilles op de efficiënte grens te weinig premie en schuift de tangentportefeuille op naar riskantere portefeuilles, zolang onder het rendement van de minimum-variantieportefeuille blijft. Bij heeft ze een verwacht rendement van , bij 2% is dat 8,22%. Daalt , dan schuift ze naar de minimum-variantieportefeuille toe, maar die bereikt ze pas als naar min oneindig gaat. De codecel rekent de getallen na.
rf = 0.02
w_tan = (Sinv_mu - rf * Sinv_1) / (B - rf * A)            # eq-markowitz-tangent
sharpe_max = np.sqrt(C - 2 * rf * B + rf**2 * A)
mu_tan = w_tan @ mu
sigma_tan = np.sqrt(w_tan @ Sigma @ w_tan)
sharpe_assets = (mu - rf) / sd                            # Sharpe-ratio per activum

pd.DataFrame(
    {"met de hand": [0.3333, 0.2222, 0.4444, 0.0822, 0.1176, 0.5292, 0.40, 0.40, 0.20],
     "code": [w_tan[0], w_tan[1], w_tan[2], mu_tan, sigma_tan, sharpe_max,
              *sharpe_assets]},
    index=["gewicht aandelen", "gewicht kleine aandelen", "gewicht obligaties",
           "verwacht rendement", "standaarddeviatie", "maximale Sharpe-ratio",
           "Sharpe-ratio aandelen", "Sharpe-ratio kleine aandelen",
           "Sharpe-ratio obligaties"],
).round(4)Ook hier geeft de code dezelfde getallen. De figuur brengt het hele toy-voorbeeld samen, en daarin gaat het om de afstand tussen elk activum en de minimum-variantierand en om het punt waar de gestreepte lijn haar raakt.
Source
grid = np.linspace(0.02, 0.16, 400)
sigma_frontier = np.sqrt((A * grid**2 - 2 * B * grid + C) / D)
sigma_cml_end = 2 * sigma_tan                     # kapitaalmarktlijn tot 2x sigma_tan

fig, ax = plt.subplots()
ax.plot(sigma_frontier * 100, grid * 100, lw=1.8, label="minimum-variantierand")
ax.plot([0, sigma_cml_end * 100],
        [rf * 100, (rf + sharpe_max * sigma_cml_end) * 100],
        ls="--", lw=1.3, color=hap.plotting.COLORS[1],
        label="kapitaalmarktlijn")
ax.scatter(sd * 100, mu * 100, zorder=3, color=hap.plotting.COLORS[2])
for name, s, m in zip(["aandelen", "klein", "obligaties"], sd, mu):
    ax.annotate(name, (s * 100 + 0.5, m * 100 - 0.3))
ax.scatter([sigma_mv * 100], [B / A * 100], marker="s", zorder=3,
           color=hap.plotting.COLORS[3], label="minimum-variantie")
ax.scatter([sigma_tan * 100], [mu_tan * 100],
           marker="D", zorder=3, color=hap.plotting.COLORS[1], label="tangent")
ax.set_xlim(0, 32)
ax.set_ylim(0, 16)
ax.set_xlabel("Standaarddeviatie (procenten per jaar)")
ax.set_ylabel("Verwacht rendement (procenten per jaar)")
ax.set_title("De minimum-variantierand van drie activa")
ax.legend()
plt.show()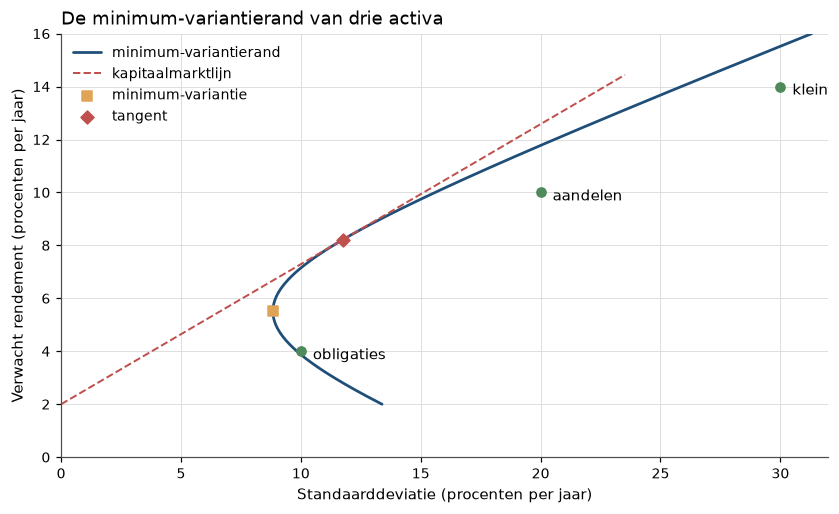
Figure 1:De drie activa (punten), de minimum-variantierand en de kapitaalmarktlijn vanaf de risicovrije rente van 2%. Elk activum ligt rechts van de minimum-variantierand, omdat er telkens een mengsel is met hetzelfde verwachte rendement en minder risico. De minimum-variantieportefeuille (vierkant) ligt met 8,83% links van het veiligste activum. De tangentportefeuille (ruit) is het enige punt van de minimum-variantierand op de kapitaalmarktlijn.
De kapitaalmarktlijn ligt overal boven de efficiënte grens, behalve in de tangentportefeuille. Een belegger die risico wil dragen, doet dat dus het best langs die lijn.
Roy komt langs een andere weg bij dezelfde portefeuille uit. Zijn belegger wil de kans klein maken dat zijn rendement onder een rampniveau zakt, zonder de verdeling te kennen. De ongelijkheid van Bienaymé-Tsjebysjev begrenst die kans voor :
De kans op een ramp is dus hoogstens één gedeeld door het kwadraat van het aantal standaarddeviaties tussen het verwachte rendement en de ramp. Die grens minimaliseren komt neer op het maximaliseren van , en dat is (12) met in de rol van . De belegger van Roy (safety first, veiligheid eerst) en die van Tobin kiezen dus dezelfde portefeuille zodra . Hoe ruim de grens is, laat de tangentportefeuille uit het toy-voorbeeld zien (8,22%, standaarddeviatie 11,76%), ook al kiest Roys belegger bij een ramp van een ander punt op de efficiënte grens. Die ramp ligt 2,4 standaarddeviaties onder het verwachte rendement, zodat de grens geeft, terwijl de kans onder normaliteit maar 0,8% is.
4.4Wat het voorspelt: alleen covariantie wordt beloond
In een grote portefeuille verdwijnt het idiosyncratische risico van elk activum, zodat er geen reden is om ervoor betaald te worden. Om te laten zien dat de markt er ook echt niet voor betaalt, is een evenwichtsmodel nodig, en dat heeft Markowitz niet.
Waarom verdwijnt dat risico? Denk aan een belegger die zijn geld gelijk verdeelt over activa met elk variantie en onderling covariantie . Koopt hij er een activum bij, dan krijgt elk activum een kleiner gewicht, zodat het totaal van de eigen varianties, , naar nul daalt. Het totaal van de covarianties, , stijgt daarentegen licht naar .
De eigen varianties verdwijnen dus, terwijl de gemiddelde covariantie blijft en de bodem van de diversificatie vormt. Om de orde van grootte te zien, nemen we een maandelijkse standaarddeviatie van 5,5% per aandeel en een gemiddelde correlatie van 0,25. De codecel rekent daarmee de jaarlijkse standaarddeviatie uit voor portefeuilles van 1 tot 100 aandelen.
vbar = 0.055**2                 # variantie per aandeel, per maand
cbar = 0.25 * 0.055**2          # gemiddelde covariantie, per maand
n_grid = np.arange(1, 101)
sd_ann = np.sqrt(vbar / n_grid + (1 - 1 / n_grid) * cbar) * np.sqrt(12)

shown = [1, 5, 10, 30, 100]
pd.DataFrame(
    {"aantal aandelen": shown,
     "standaarddeviatie (% per jaar)": sd_ann[np.array(shown) - 1] * 100,
     "ondergrens (% per jaar)": np.sqrt(cbar * 12) * 100},
).round(2)Eén aandeel heeft een standaarddeviatie van 19,0% per jaar en een oneindig grote 1/N-portefeuille 9,5%, en na dertig aandelen is het meeste al bereikt. In standaarddeviatie is de helft weg te diversifiëren, in variantie driekwart, want de bodem is van de variantie van één aandeel. Bij een hogere correlatie stijgt de bodem mee, en bij correlatie nul verdwijnt hij.
Het economische gevolg blijkt uit een regressie. We splitsen het rendement van activum in een deel dat met een grote gespreide portefeuille meebeweegt en een rest, met , en die splitsing is een definitie, geen aanname. De bijdrage van aan de variantie van de portefeuille is , met de bèta van ten opzichte van , rond 1 voor een gemiddeld aandeel. In die bijdrage komt niet voor.
Een belegger die draagt, draagt dus risico dat hij gratis had kunnen wegdiversifiëren. Geen belegger die kan spreiden, wil hem daarvoor betalen, en daarmee klopt ook wat de intuïtie zei over risico dat in de massa verdwijnt.
4.5Waar het strandt: de schattingsfout in de invoer
In de praktijk overschaduwt de schattingsfout in alles wat de theorie belooft. In het college over rendementen bleek dat het gemiddelde rendement bij 20% standaarddeviatie over honderd jaar een standaardfout van procentpunt heeft. Die standaardfout van 2% betekent hier dat de optimalisator de verwachte rendementen nauwelijks kent. Tweede momenten zijn wel scherp te meten, omdat een variantie nauwkeuriger wordt met meer waarnemingen per jaar, maar voor de optimalisator is het slecht gemeten gemiddelde om drie redenen fataal.
De fout is groot. Met waarnemingen en standaarddeviatie per waarneming is . Tien jaarwaarnemingen bij 20% geven procentpunt. De verschillen in verwachte rendementen tussen activa zijn een paar procentpunt, zodat de rangorde van vrijwel ruis is.
vergroot de ruis. De gewichten zijn evenredig met . In het toy-voorbeeld zet de in aandelen tegen kleine aandelen in, en hoe hoger hun correlatie, hoe groter dat getal in absolute waarde. Juist voor twee sterk gecorreleerde activa is het verschil tussen hun geschatte gemiddelden het slechtst bepaald. Een kleine verandering in één verwacht rendement kan de gewichten volledig omgooien Best & Grauer (1991).
De fout is eenzijdig. De geschatte maximale Sharpe-ratio is naar boven vertekend: . Elk geschat gemiddelde, gedeeld door zijn standaarddeviatie, heeft een steekproeffout met variantie ongeveer , en de optimalisator telt van die kwadraten op Jobson & Korkie (1980)Jobson & Korkie (1981). Bij tien activa en maandwaarnemingen is per maand, vier keer de ware van de simulatie hierna: per maand.
Chopra en Ziemba hebben ook gemeten hoe zwaar de drie soorten fouten wegen. In een van hun rekenvoorbeelden kosten fouten in de gemiddelden ongeveer elf keer zoveel als fouten in de varianties, en eenentwintig keer zoveel als fouten in de covarianties Chopra & Ziemba (1993).
5Simulatie: de optimale portefeuille zonder kennis van 
We bouwen een wereld met tien activa waarin we de ware momenten kennen, zodat de optimale portefeuille en de Sharpe-ratio daarvan bekend zijn. Hoeveel van die Sharpe-ratio haalt een belegger die dezelfde portefeuille bouwt uit maanden geschatte momenten?
De wereld lijkt op de tien industrieportefeuilles uit de replicatie, met een hoge onderlinge correlatie en weinig verschil in premies. We werken direct met overrendementen, zodat de risicovrije rente geen rol speelt.
| parameter | waarde |
|---|---|
| aantal activa | 10 |
| premie | oplopend van 0,40% tot 0,80% per maand (4,8% tot 9,6% per jaar) |
| standaarddeviatie | oplopend van 4,5% tot 6,5% per maand |
| correlatie tussen elk paar | 0,60 |
De eerste cel bouwt die wereld en meet de ware Sharpe-ratio van twee portefeuilles, het ware optimum (de tangentportefeuille bij de ware momenten) en 1/N. Omdat we de ware momenten kennen, meten we de Sharpe-ratio van elke gewichtsvector exact, zonder steekproef.
n_assets = 10
mu_true = np.linspace(0.0040, 0.0080, n_assets)
sd_true = np.linspace(0.045, 0.065, n_assets)
corr_true = np.full((n_assets, n_assets), 0.60)
np.fill_diagonal(corr_true, 1.0)
Sigma_true = corr_true * np.outer(sd_true, sd_true)

chol = np.linalg.cholesky(Sigma_true)       # om gecorreleerde rendementen te trekken
w_star = np.linalg.solve(Sigma_true, mu_true)
w_star /= w_star.sum()                      # ware tangentportefeuille
w_naive = np.full(n_assets, 1 / n_assets)   # 1/N


def sharpe_true(w):
    """Annualised Sharpe ratio of weights w under the TRUE moments."""
    return np.sqrt(12) * (w @ mu_true) / np.sqrt(w @ Sigma_true @ w)


pd.DataFrame(
    {"Sharpe (per jaar)": [sharpe_true(w_star), sharpe_true(w_naive)]},
    index=["ware optimale portefeuille", "1/N"],
).round(4)Het ware optimum haalt 0,50 per jaar, dicht bij de 0,529 van het toy-voorbeeld, en 1/N haalt 0,47. Meer dan dat kleine verschil kan optimaliseren in deze wereld niet opleveren.
Nu moet de belegger de momenten schatten. Per steekproef trekken we maanden, schatten we en , vormen we de portefeuille alsof die schattingen waar zijn, en meten we de Sharpe-ratio van die portefeuille onder de ware momenten. Om te zien waar de schade vandaan komt, schatten we daarnaast telkens maar één van de twee.
def one_sample(T):
    """Draw T months from the true world; return the sample mean and covariance."""
    sample = rng.standard_normal((T, n_assets)) @ chol.T + mu_true
    return sample.mean(axis=0), np.cov(sample, rowvar=False)


def tangency(mu_vec, Sigma_mat):
    """Fully invested maximum-Sharpe weights, Sigma^{-1} mu scaled to sum to one."""
    w = np.linalg.solve(Sigma_mat, mu_vec)
    return w / w.sum()


n_sim = 2000
records = []
for T in [60, 120, 240, 600]:
    both, cov_only, mean_only = [], [], []
    for _ in range(n_sim):
        mu_hat, Sigma_hat = one_sample(T)                                  # trekken en schatten
        both.append(sharpe_true(tangency(mu_hat, Sigma_hat)))             # optimaliseren
        cov_only.append(sharpe_true(tangency(mu_true, Sigma_hat)))
        mean_only.append(sharpe_true(tangency(mu_hat, Sigma_true)))
    records.append({
        "T (maanden)": T,
        "gemiddelden en covarianties geschat": np.median(both),
        "alleen covarianties geschat": np.median(cov_only),
        "alleen gemiddelden geschat": np.median(mean_only),
        "1/N": sharpe_true(w_naive),
        "ware optimum": sharpe_true(w_star),
    })

pd.DataFrame(records).set_index("T (maanden)").round(4)Uit de tabel blijkt dat schatten veel meer kost dan optimaliseren kan opleveren. De mean-variance-portefeuille uit geschatte momenten haalt een mediane Sharpe-ratio van 0,16 bij vijf jaar data en 0,39 bij vijftig jaar, en blijft over het hele bereik onder 1/N.
De kolommen met één geschatte invoer laten zien waar de schade zit. Wie kent en alleen schat, verliest bijna niets, maar wie kent en schat, verliest bijna alles. Net als bij Chopra & Ziemba (1993) zijn de gemiddelden dus de zwakke schakel.
De figuur vergelijkt voor wat de optimalisator in de steekproef belooft met wat hij buiten de steekproef levert. Het belangrijkste is de afstand tussen de twee verdelingen en de plaats van de zwarte lijn ten opzichte van beide.
Source
sr_oos, sr_ins = [], []
for _ in range(n_sim):
    mu_hat, Sigma_hat = one_sample(120)
    sr_oos.append(sharpe_true(tangency(mu_hat, Sigma_hat)))                 # geleverd
    sr_ins.append(np.sqrt(12 * mu_hat @ np.linalg.solve(Sigma_hat, mu_hat)))  # beloofd

fig, ax = plt.subplots()
ax.hist(sr_ins, bins=50, alpha=0.65, label="in de steekproef (beloofd)")
ax.hist(sr_oos, bins=50, alpha=0.65, label="buiten de steekproef (geleverd)")
ax.axvline(sharpe_true(w_star), color="black", lw=1.6,
           label="ware optimum")
ax.axvline(sharpe_true(w_naive), color=hap.plotting.COLORS[3], lw=1.6,
           ls="--", label="1/N")
ax.set_xlabel("Sharpe-ratio (per jaar)")
ax.set_ylabel("Aantal steekproeven")
ax.set_title("Beloofde en geleverde Sharpe-ratio, 2000 steekproeven van 120 maanden")
ax.legend()
plt.show()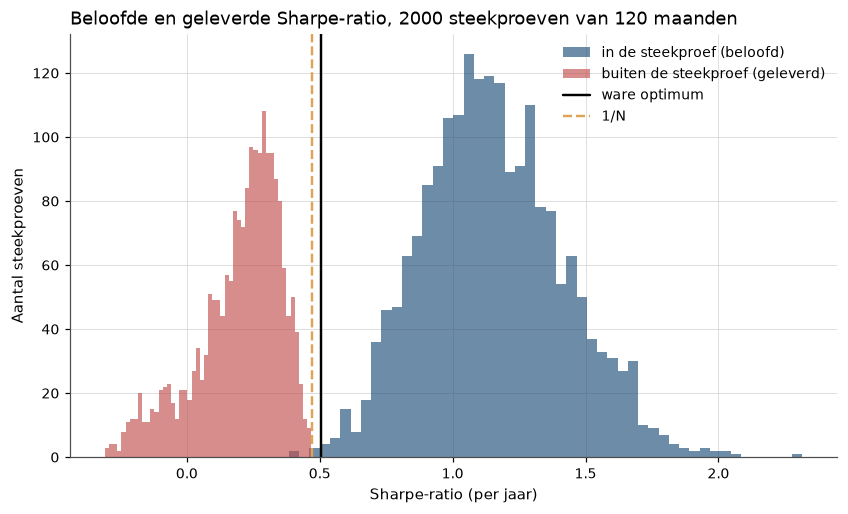
Figure 2:Twee verdelingen uit dezelfde 2000 steekproeven van tien jaar. De rechter toont wat de optimalisator belooft, de Sharpe-ratio in de steekproef, en die ligt ruim boven het ware optimum. De linker toont wat hij levert, dezelfde gewichten onder de ware momenten, en die liggen altijd onder het ware optimum en in deze figuur ook onder 1/N. De afstand tussen beide is bias, omdat de optimalisator de gewichten juist daar legt waar de schattingsfout het gemiddelde toevallig hoog maakte.
Omdat elk extra activum een extra kans is op een gemiddelde dat toevallig hoog uitvalt, groeit het probleem met het aantal activa. Een onderzoeker die honderd activa optimaliseert op tien jaar data ( tien keer zo groot als hier), rapporteert een Sharpe-ratio die vrijwel volledig uit schattingsfout bestaat.
6Replicatie op echte data
De eerste cel laadt beide panelen en trekt de risicovrije rente af.
rf_monthly = hap_data.market_monthly()["RF"]    # andere naam dan de rf = 0,02 uit de theorie


def excess_panel(name, start="1963-07"):
    """French portfolio returns in excess of the risk-free rate."""
    raw = hap_data.french(name, "monthly").loc[start:]
    return raw.sub(rf_monthly, axis=0).dropna()


industry = excess_panel("10_Industry_Portfolios")   # value-weighted, maandelijks
size_bm = excess_panel("25_Portfolios_5x5")          # 25 size/BM-portefeuilles

pd.DataFrame(
    {"N": [industry.shape[1], size_bm.shape[1]],
     "maanden": [len(industry), len(size_bm)],
     "start": [industry.index[0].strftime("%Y-%m"), size_bm.index[0].strftime("%Y-%m")],
     "eind": [industry.index[-1].strftime("%Y-%m"), size_bm.index[-1].strftime("%Y-%m")]},
    index=["10 industrieën", "25 size/BM"],
)Beide panelen lopen van juli 1963 tot juli 2026 en hebben 757 maanden. Daarop passen we het recept van DGU toe, waarin we in elke maand de schattingen en maken uit de voorgaande maanden, de gewichten vormen en het rendement van maand boeken. Zo komt er geen informatie uit de toekomst in de gewichten. De functie bewaart ook de mean-variance-gewichten, omdat we die later nodig hebben.
def rolling_oos(panel, window=120):
    """Out-of-sample returns of 1/N, mean-variance and minimum variance,
    plus the mean-variance weights of every month."""
    values = panel.to_numpy()
    n = panel.shape[1]
    ones = np.ones(n)
    returns = {"1/N": [], "mean-variance": [], "minimum-variantie": []}
    weights_mv = []

    for t in range(window, len(values)):
        past = values[t - window:t]                 # alleen maanden vóór t
        mu_hat = past.mean(axis=0)
        Sigma_hat = np.cov(past, rowvar=False)

        w_meanvar = np.linalg.solve(Sigma_hat, mu_hat)
        w_meanvar = w_meanvar / w_meanvar.sum()
        w_minvar = np.linalg.solve(Sigma_hat, ones)
        w_minvar = w_minvar / w_minvar.sum()

        returns["1/N"].append(values[t] @ ones / n)
        returns["mean-variance"].append(values[t] @ w_meanvar)
        returns["minimum-variantie"].append(values[t] @ w_minvar)
        weights_mv.append(w_meanvar)

    return pd.DataFrame(returns, index=panel.index[window:]), np.array(weights_mv)


oos_industry, weights_industry = rolling_oos(industry)
oos_size_bm, weights_size_bm = rolling_oos(size_bm)
pd.DataFrame(
    {"maanden buiten de steekproef": [len(oos_industry), len(oos_size_bm)],
     "eerste maand": [oos_industry.index[0].strftime("%Y-%m"),
                      oos_size_bm.index[0].strftime("%Y-%m")]},
    index=["10 industrieën", "25 size/BM"],
)Na het eerste venster blijven 637 maanden buiten de steekproef over. De volgende cel vat de drie reeksen samen, met de standaardfout van de Sharpe-ratio erbij (bij een kleine Sharpe-ratio is die ongeveer ). Alle Sharpe-ratio’s hierna zijn per maand, en om ze met de jaarcijfers uit de simulatie te vergelijken, vermenigvuldigen we ze met .
def sharpe_table(oos):
    """Mean, standard deviation and Sharpe ratio of each out-of-sample strategy."""
    summary = hap.summary_stats(oos, "monthly")
    return pd.DataFrame({
        "gemiddelde (% per maand)": summary["mean"] * 100,
        "standaarddeviatie (% per maand)": summary["std"] * 100,
        "Sharpe-ratio (per maand)": summary["mean"] / summary["std"],
        "SE van de Sharpe-ratio": 1 / np.sqrt(summary["nobs"].astype(float)),
    })


table = pd.concat({"10 industrieën": sharpe_table(oos_industry),
                   "25 size/BM": sharpe_table(oos_size_bm)})
table.astype(float).round(4)In beide datasets verliest mean-variance van 1/N, en haalt minimum-variantie de hoogste Sharpe-ratio. Mean-variance beweegt ook veel wilder, met bij de industrieën ruim drie keer de standaarddeviatie van 1/N. De laatste cel zet onze Sharpe-ratio’s naast de FF-vierfactorrij uit tabel 3 van DGU, met de Sharpe-ratio in de steekproef erbij.
def in_sample_sharpe(panel):
    """Monthly maximum Sharpe ratio attainable with full-sample moments."""
    mu_hat = panel.mean().to_numpy()
    Sigma_hat = panel.cov().to_numpy()
    return float(np.sqrt(mu_hat @ np.linalg.solve(Sigma_hat, mu_hat)))


sharpe_oos = table["Sharpe-ratio (per maand)"].unstack()
comparison = pd.DataFrame(
    {"1/N": [sharpe_oos.loc["10 industrieën", "1/N"], 0.1753,
             sharpe_oos.loc["25 size/BM", "1/N"]],
     "mean-variance in de steekproef": [in_sample_sharpe(industry), 0.5364,
                                        in_sample_sharpe(size_bm)],
     "mean-variance buiten de steekproef": [sharpe_oos.loc["10 industrieën", "mean-variance"],
                                            -0.0031,
                                            sharpe_oos.loc["25 size/BM", "mean-variance"]]},
    index=["hier: 10 industrieën (N = 10)", "origineel: FF-vierfactor (N = 24)",
           "hier: 25 size/BM (N = 25)"],
)                                                    # origineel: DGU (2009), tabel 3
comparison["verschil met 1/N buiten"] = (comparison["mean-variance buiten de steekproef"]
                                         - comparison["1/N"])
comparison["gat: in minus buiten"] = (comparison["mean-variance in de steekproef"]
                                      - comparison["mean-variance buiten de steekproef"])
comparison.round(4)Geslaagd. De ordening is dezelfde als bij DGU en als we vooraf verwachtten. In de steekproef belooft mean-variance meer dan 1/N (bij de industrieën net, bij de 25 portefeuilles ruim), maar erbuiten levert de portefeuille minder. Het gat tussen belofte en levering (laatste kolom) groeit met , van 0,10 naar 0,30, en is bij DGU nog groter. Hun niveau buiten de steekproef is negatief en het onze positief, maar over het niveau deden we vooraf geen uitspraak.
Er hoort wel een voorbehoud bij. Onze eigen verschillen met 1/N (voorlaatste kolom) zijn kleiner dan twee keer de standaardfout van één Sharpe-ratio, terwijl de DGU-rij daar wel boven ligt. Twee keer de standaardfout is bovendien een ruwe drempel, omdat de standaardfout van een verschil afhangt van hoe sterk de twee strategieën samen bewegen. De replicatie stelt dus een consistent teken vast over twee datasets, en geen significant verschil in één dataset.
De winnaar is dus niet 1/N maar de minimum-variantieportefeuille. De gewichten daarvan, , gebruiken niet, en dat is het enige verschil met mean-variance, die dezelfde gebruikt.
De figuur toont de cumulatieve overrendementen van de drie strategieën, en het gaat vooral om het verloop van de mean-variance-lijn naast dat van de andere twee.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), sharey=True)
for ax, (title, frame) in zip(axes, [("10 industrieën", oos_industry),
                                     ("25 size/BM-portefeuilles", oos_size_bm)]):
    for column in frame.columns:
        ax.plot(frame.index, (1 + frame[column]).cumprod(), label=column)
    ax.set_yscale("log")
    ax.set_title(title)
    ax.set_xlabel("Jaar")
    hap.plotting.timeline_axis(ax)
axes[0].set_ylabel("Waarde van 1 dollar overrendement (log-schaal)")
axes[0].legend()
plt.show()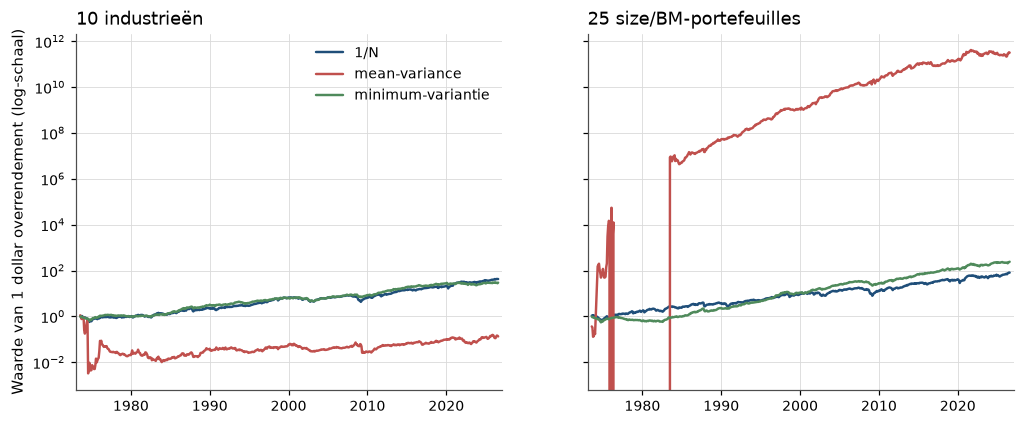
Figure 3:Cumulatief overrendement van de drie strategieën, gefinancierd tegen de risicovrije rente, met een rollend venster van 120 maanden. De mean-variance-portefeuille doet het slechter en is onrustiger, omdat de gewichten ervan elke maand meespringen met tien jaar geschatte gemiddelden.
Waarom is mean-variance zo slecht? De volgende cel meet uit de bewaarde gewichten welke posities de optimalisator in elk venster inneemt. De brutopositie is daarin de som van de absolute gewichten en de omzet de som van de absolute gewichtsveranderingen per maand.
position_stats = {}
for name, weights in [("10 industrieën", weights_industry),
                      ("25 size/BM", weights_size_bm)]:
    gross_position = np.abs(weights).sum(axis=1)                  # som van |w| per maand
    turnover = np.abs(np.diff(weights, axis=0)).sum(axis=1)       # omzet per maand
    position_stats[name] = {
        "grootste positieve gewicht": weights.max(),
        "grootste negatieve gewicht": weights.min(),
        "gemiddelde brutopositie (som van |w|)": gross_position.mean(),
        "gemiddelde omzet per maand": turnover.mean(),
    }

pd.DataFrame(position_stats).T.round(3)De optimalisator neemt enorme posities, met gewichten van meer dan twintig maal het vermogen bij de industrieën en een veelvoud daarvan bij de 25 portefeuilles. Hij behandelt een klein verschil in geschat gemiddelde tussen twee sterk gecorreleerde portefeuilles als een bijna risicoloze arbitrage, terwijl dat verschil ruis is. Er zit dus hefboom op een schattingsfout, omdat juist de ruis tussen gecorreleerde activa uitvergroot.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Het model is nooit weerlegd, want het is een stelling en geen hypothese. Het risico van een belegging is de covariantie ervan met de rest van de portefeuille. Een mengsel kan veiliger zijn dan het veiligste activum, twee fondsen bedienen iedere belegger, ook de voorzichtige van Roy, en idiosyncratisch risico is gratis weg te diversifiëren. De separatiestelling geeft indexbeleggen bovendien een theoretische grond naast het kostenargument.
Waar het breekt. Het model breekt niet in de wiskunde maar in de invoer. De replicatie laat zien dat de mean-variance-portefeuille, geschat op tien jaar maanddata, een lagere Sharpe-ratio haalt dan 1/N: bij de tien industrieën 0,081 tegen 0,158 per maand, terwijl de optimalisatie in de steekproef 0,185 beloofde. Volgens DGU zijn bij meer dan drieduizend maanden data nodig, ruim 250 jaar, voordat optimaliseren loont DeMiguel et al. (2009). De oorzaak is de schattingsfout in de gemiddelden, want is goed te schatten en niet.
Risico of vergissing? Waarom verliest mean-variance? In de Chicago-lezing zijn prijzen juist, zodat verwachte rendementen weinig verschillen en alleen door risico, en een belegger die op geschatte gemiddelden jaagt, jaagt dan op ruis. In de Yale-lezing zijn de verschillen echt en groot (waarde, momentum, kleine aandelen), maar zitten prijzen soms ernaast en tonen tien jaar gemiddelden dat niet. Dan faalt de schatter en niet het idee. Alleen een voorspeller die buiten de steekproef werkt, zou de twee lezingen kunnen scheiden (Voorspelbaarheid van rendementen). Santa-Clara (Opzet, data en conventies) verloor naar eigen zeggen geld als hij dacht iets te weten wat de prijs niet wist, en de mean-variance-portefeuille maakt die fout systematisch, omdat ze ervan uitgaat dat de geschatte gemiddelden meer weten dan de prijs.
Wat er daarna kwam. Markowitz beschrijft wat één belegger bij gegeven zou moeten doen, maar wat de markt werkelijk opleverde, was in 1959 nog niet gemeten. Die meting kwam er pas in 1964, met de CRSP-tape (De CRSP-tape: data als machine).
8Oefeningen
Solution to Exercise 1
(1) Nu is diagonaal, dus . Vermenigvuldigen met 9 geeft , met som 1225, zodat . De covariantie van elk activum met de portefeuille is weer gelijk: . Daarmee is en .
Sigma_uncorr = np.diag(sd**2)                     # correlatie tussen de aandelen op nul
Sinv_1_uncorr = np.linalg.solve(Sigma_uncorr, ones)
w_mv_uncorr = Sinv_1_uncorr / Sinv_1_uncorr.sum()
sigma_mv_uncorr = np.sqrt(w_mv_uncorr @ Sigma_uncorr @ w_mv_uncorr)

pd.DataFrame(
    {"met de hand": [0.1837, 0.0816, 0.7347, 0.0857],
     "code": [*w_mv_uncorr, sigma_mv_uncorr]},
    index=["gewicht aandelen", "gewicht kleine aandelen", "gewicht obligaties",
           "standaarddeviatie"],
).round(4)(2) De standaarddeviatie daalt van 8,83% naar 8,57%. Kleine aandelen bewegen niet meer met aandelen mee, zodat ze echte diversificatie toevoegen en 8,2% krijgen in plaats van 4,9%. De oefening laat zien dat minder covariantie de minimum-variantieportefeuille veiliger maakt, zonder dat een enkel activum minder riskant wordt.
:::{exercise}
:label: ex-markowitz-1

**De zero-beta-portefeuille.** Werk met het toy-voorbeeld en de getallen uit de
theorie ($A = 128{,}125$, $B = 7{,}0625$, $C = 0{,}51125$, $D = 15{,}625$).

1. Leid uit [](#eq-markowitz-foc) af dat de covariantie tussen twee
   portefeuilles op de minimum-variantierand met verwachte rendementen $\mu_1$ en $\mu_2$ gelijk is
   aan $\left(A\mu_1\mu_2 - B(\mu_1+\mu_2) + C\right)/D$.
2. Bepaal daaruit het verwachte rendement $\mu_z$ van de portefeuille op de
   minimum-variantierand die *ongecorreleerd* is met de tangentportefeuille
   ($\mu_{\mathrm{tan}} = 0{,}0822\overline{2}$). Reken het getal met de hand uit
   en controleer het in code.
3. Dat getal heet het zero-beta-rendement. Vergelijk het met de risicovrije rente
   van 2% waarmee de tangentportefeuille werd bepaald. Wat valt op, en waarom is
dat geen toeval?mu_z = (B * mu_tan - C) / (A * mu_tan - B)
w_z = (Sinv_mu * (A * mu_z - B) + Sinv_1 * (C - B * mu_z)) / D # w = g + mu_z h
pd.DataFrame(
{"waarde": [mu_tan, mu_z, float(w_z @ Sigma @ w_tan)]},
index=["mu van de tangentportefeuille", "zero-beta rendement",
"covariantie met de tangentportefeuille"],
).round(8)(3) Het zero-beta-rendement is exact 2%, gelijk aan de risicovrije rente waarmee we de tangentportefeuille bepaalden, en dat is geen toeval. Uit volgt voor elke portefeuille met dat . Nulcovariantie betekent dus . Op dit resultaat bouwt Black (1972), want ook zonder risicovrij activum bestaat er dan een portefeuille die de rol van speelt. Zo blijkt dat de risicovrije rente in de meetkunde van de minimum-variantierand het rendement is van de portefeuille die niet met de tangentportefeuille meebeweegt.
:::{exercise}
:label: ex-markowitz-3

**De replicatie uitbreiden: krimpen.** Herhaal de rollende analyse buiten de
steekproef op de 25 size/BM-portefeuilles, maar krimp $\hat{\boldsymbol{\mu}}$ in
elk venster naar het gemiddelde over alle portefeuilles:
$\tilde{\boldsymbol{\mu}} = \phi\,\hat{\boldsymbol{\mu}} +
(1-\phi)\,\bar{\hat\mu}\,\mathbf{1}$, met $\phi \in \{0; 0{,}25; 0{,}5; 0{,}75; 1\}$.

1. Bereken voor elke $\phi$ de Sharpe-ratio buiten de steekproef, de gemiddelde
   brutopositie en de gemiddelde omzet.
2. Vergelijk $\phi = 0$ met $\phi = 1$. Welke portefeuille is het bij $\phi = 0$?
3. Zit het probleem bij de optimalisatie of bij de invoer?
Solution to ex-markowitz-3
De functie herhaalt de rollende analyse, met in elk venster de gekrompen gemiddelden in plaats van .
def shrunk_oos(panel, phi, window=120):
    """Rolling OOS mean-variance with the mean vector shrunk towards its average."""
    values = panel.to_numpy()
    rets, paths = [], []
    for t in range(window, len(values)):
        past = values[t - window:t]
        mu_hat = past.mean(axis=0)
        mu_tilde = phi * mu_hat + (1 - phi) * mu_hat.mean()
        w = np.linalg.solve(np.cov(past, rowvar=False), mu_tilde)
        w = w / w.sum()
        rets.append(float(values[t] @ w))
        paths.append(w)
    rets, paths = np.array(rets), np.array(paths)
    return {
        "Sharpe-ratio (per maand)": rets.mean() / rets.std(ddof=1),
        "brutopositie": np.abs(paths).sum(axis=1).mean(),
        "omzet": np.abs(np.diff(paths, axis=0)).sum(axis=1).mean(),
    }


pd.DataFrame(
    {phi: shrunk_oos(size_bm, phi) for phi in [0.0, 0.25, 0.5, 0.75, 1.0]}
).T.rename_axis("phi").round(3)(1) en (2) wint met afstand, met een Sharpe-ratio van 0,239 tegen 0,104 bij en een brutopositie van 7,6 in plaats van 72. Bij is evenredig met , dus is de portefeuille exact de minimum-variantieportefeuille . De tussenwaarden doen het nog slechter dan , met een Sharpe-ratio van nul bij , omdat soms dicht bij nul komt en de normalisatie dan explodeert.
(3) Het probleem zit dus niet in de optimalisatie, want hetzelfde kwadratische programma levert met volledig weggekrompen het beste resultaat van dit college. Het nuttigste wat een belegger over kan weten, is hoeveel hij ervan niet moet geloven.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- DeMiguel, V., Garlappi, L., & Uppal, R. (2009). Optimal Versus Naive Diversification: How Inefficient Is the 1/N Portfolio Strategy? Review of Financial Studies, 22(5), 1915–1953. 10.1093/rfs/hhm075
- Markowitz, H. (1952). Portfolio Selection. The Journal of Finance, 7(1), 77–91. 10.1111/j.1540-6261.1952.tb01525.x
- Roy, A. D. (1952). Safety First and the Holding of Assets. Econometrica, 20(3), 431–449. 10.2307/1907413
- Tobin, J. (1958). Liquidity Preference as Behavior Towards Risk. The Review of Economic Studies, 25(2), 65–86. 10.2307/2296205
- Markowitz, H. M. (1959). Portfolio Selection: Efficient Diversification of Investments. John Wiley & Sons.
- Sharpe, W. F. (1966). Mutual Fund Performance. The Journal of Business, 39(1), 119–138. 10.1086/294846
- Best, M. J., & Grauer, R. R. (1991). On the Sensitivity of Mean-Variance-Efficient Portfolios to Changes in Asset Means: Some Analytical and Computational Results. The Review of Financial Studies, 4(2), 315–342. 10.1093/rfs/4.2.315
- Jobson, J. D., & Korkie, B. (1980). Estimation for Markowitz Efficient Portfolios. Journal of the American Statistical Association, 75(371), 544–554. 10.1080/01621459.1980.10477507
- Jobson, J. D., & Korkie, R. M. (1981). Putting Markowitz Theory to Work. The Journal of Portfolio Management, 7(4), 70–74. 10.3905/jpm.1981.408816
- Chopra, V. K., & Ziemba, W. T. (1993). The Effect of Errors in Means, Variances, and Covariances on Optimal Portfolio Choice. The Journal of Portfolio Management, 19(2), 6–11. 10.3905/jpm.1993.409440
- Black, F. (1972). Capital Market Equilibrium with Restricted Borrowing. The Journal of Business, 45(3), 444–455. 10.1086/295472
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD