

Rendementen en hun statistiek
1Overzicht
Met een gemiddeld rendement schatten we het verwachte rendement, en die schatting heeft na een eeuw data nog een standaardfout van twee procentpunt, terwijl de volatiliteit dan al vrijwel vastligt. In dit college:
leggen we het verschil vast tussen simpele rendementen en logrendementen, en leiden we af dat het meetkundig gemiddelde een halve variantie onder het rekenkundige ligt;
leiden we de standaardfout van het gemiddelde af, en daarmee de standaardfout van 2%, want bij 20% volatiliteit per jaar is het gemiddelde na een eeuw op twee procentpunt na bekend;
bewijzen we met de stelling van Merton dat vaker meten daar niets aan verandert, en simuleren we dat op tweeduizend eeuwen;
repliceren we het eerste gemeten gemiddelde rendement op aandelen, en zetten we er de standaardfout bij.
Het Center for Research in Security Prices (CRSP) zette in de jaren zestig de koersen van alle NYSE-aandelen vanaf 1926 op magneetband. Met die banden berekenden Lawrence Fisher en James Lorie in 1964 het gemiddelde rendement op Amerikaanse aandelen over 1926–1960 Fisher & Lorie (1964). Hun 9,0% per jaar was de eerste betrouwbare meting van die grootheid, maar er stond geen standaardfout bij. Zestien jaar later maakte Merton (1980) het probleem scherp, want hij liet zien dat de precisie van een geschat verwacht rendement alleen afhangt van de kalenderlengte van de steekproef. Door de hele reeks loopt de vraag of we met een theorie te maken hebben die we kunnen toetsen, of met een feit dat nog op een verklaring wacht. Dit college is daarop een uitzondering, omdat de stellingen erin wiskundig waar zijn en er dus niets te toetsen valt. Wel bepalen ze welke latere theorieën toetsbaar zijn, zoals de stelling van Merton bepaalt hoeveel de 9,0% van Fisher en Lorie waard is.
2Intuïtie: waarom zou dit waar zijn?
Denk aan een meteorologe die met een meetpaal wil weten hoe hard het gemiddeld waait. Ze kan twee dingen willen weten: hoeveel lucht er in totaal is langsgekomen, en hoe hard de wind schommelt.
Voor de eerste vraag maakt het niet uit hoe vaak ze meet. Als ze elke seconde meet in plaats van elk uur, krijgt ze 3600 keer zoveel getallen over dezelfde lucht, maar het totaal van het jaar ligt vast zodra het jaar voorbij is. Een beter gemiddelde vraagt dus meer jaren, niet meer metingen per jaar. Voor de tweede vraag ligt het omgekeerd, want elke extra meting zegt iets over hoe hard de wind schommelt.
Bij een aandeel werkt het net zo. De totale koersverandering hangt alleen af van begin- en eindkoers, en het gemiddelde rendement is die verandering gedeeld door de verstreken tijd. Dagelijks meten geeft ruim 250 keer zoveel getallen, maar geen extra informatie over het gemiddelde. De schatting van de volatiliteit (de standaarddeviatie van het rendement, per jaar) wordt daarentegen bij elke verfijning scherper.
Daar komt een tweede asymmetrie bij. Een verlies van 20% en een winst van 25% heffen elkaar in euro’s op, want . Toch is het rekenkundig gemiddelde , terwijl het vermogen gelijk bleef. Het vermogen groeit met het product van de rendementen terwijl het gemiddelde ze optelt, en het verschil tussen die twee groeit met de schommelingen. Bij 20% volatiliteit is het procentpunt per jaar.
Met de getallen uit de echte wereld gaan beide asymmetrieën knellen. De volatiliteit van aandelen is ongeveer 20% per jaar, en de equity premium (het extra rendement van aandelen boven de risicovrije rente, hierna de premie) ongeveer 6%. Die 6% is een kalibratie en geen meting, want Mehra & Prescott (1985) vonden 6,18% over 1889–1978, terwijl Opzet, data en conventies 8,3% meet op de French-data sinds 1926. Het verschil komt van de periode, en voor de standaardfout is het niet van belang, omdat die alleen van de volatiliteit afhangt. Met 20% tegen 6% is de ruis ruim drie keer zo groot als het signaal, zodat alleen verstrijkende tijd het signaal zichtbaar maakt.
We verwachten dus drie dingen. Vaker meten maakt de schatting van de volatiliteit scherper, maar die van het gemiddelde niet. Het meetkundig gemiddelde ligt onder het rekenkundige, en verder naarmate de schommelingen groter zijn. Omdat de ruis zo veel groter is dan het signaal, blijft het gemiddelde ten slotte ook na een eeuw onzeker, met een fout van enkele procentpunten.
3Toy-voorbeeld: drie jaar rendement, met de hand
Eerst laden we de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Een belegging maakt drie jaar mee, met de rendementen in de tabel. Het tweede jaar is een verliesjaar en de andere twee zijn winstjaren.
| jaar | netto rendement | bruto rendement |
|---|---|---|
| 1 | ||
| 2 | ||
| 3 |
Het voorbeeld draait om één ongelijkheid: het rekenkundig gemiddelde ligt boven het meetkundige. Hoeveel het scheelt, zegt het recept dat de theorie als eerste afleidt, en volgens dat recept is het meetkundig gemiddelde ongeveer het rekenkundige min een halve variantie.
Stap 1: het rekenkundig gemiddelde. We tellen de drie rendementen op en delen door drie:
Stap 2: het meetkundig gemiddelde. Het product van de bruto rendementen is , zodat één euro na drie jaar euro is geworden. Het meetkundig gemiddelde is dan
Het verschil met het rekenkundig gemiddelde is procentpunt, en dat is geen afrondingsfout. Over dertig jaar maakt het het verschil tussen en euro, zodat het rekenkundige bedrag twee derde hoger uitvalt.
Stap 3: de logrendementen. De drie logrendementen zijn , en . De eerste twee vallen tegen elkaar weg, en daarom is 20% verlies pas met 25% winst goedgemaakt. Hun gemiddelde is , en omdat , is het gemiddelde logrendement het meetkundig gemiddelde in een andere schrijfwijze.
Stap 4: het recept. De afwijkingen van zijn , en . Hun kwadraten tellen op tot , en gedeeld door drie geeft dat , dus en een halve variantie van . Het recept geeft , tegen de exacte , en zit er bij drie waarnemingen dus maar twee honderdste procentpunt naast.
De codecel rekent dezelfde getallen na en zet ze naast de handberekening.
r = np.array([0.25, -0.20, 0.10])
gross = 1 + r

arith = r.mean()
geom = gross.prod() ** (1 / len(r)) - 1
log_returns = np.log(gross)
geom_via_log = np.exp(log_returns.mean()) - 1
recipe = arith - r.var(ddof=0) / 2

rows = ["rekenkundig gemiddelde", "meetkundig gemiddelde",
        "via gemiddeld logrendement", "recept: gemiddelde - halve variantie",
        "verschil rekenkundig - meetkundig"]
by_hand = [0.05, 0.032280, 0.032280, 0.0325, 0.017720]
by_code = [arith, geom, geom_via_log, recipe, arith - geom]

pd.DataFrame({"met de hand": by_hand, "code": by_code}, index=rows).round(6)De twee kolommen zijn gelijk, en het recept zit er 0,00022 naast. Het meetkundig gemiddelde ligt dus ongeveer een halve variantie onder het rekenkundige, en bij drie jaren met zulke schommelingen scheelt dat al bijna twee procentpunt per jaar. Dezelfde drie jaren komen in de theorie terug, waar ze een eerste standaardfout opleveren.
4Theorie
We leiden drie resultaten af. Eerst bewijzen we het recept uit het toy-voorbeeld, dat zegt dat het meetkundig gemiddelde een halve variantie onder het rekenkundige ligt. Daarna volgt de kern van het college, de standaardfout van het gemiddelde, die na een eeuw data nog twee procentpunt is. Ten slotte laat de stelling van Merton zien waarom vaker meten die standaardfout niet verkleint, en aan het eind kijken we wat autocorrelatie en dikke staarten daaraan veranderen.
4.1Opzet: twee soorten rendement
Er zijn twee rendementen nodig, omdat een belegger op twee manieren optelt: over de tijd en over aandelen. Laat de prijs zijn en het dividend dat tussen en wordt uitgekeerd, beide als bedragen en niet als logs, zoals in de hele reeks. Het simpele netto rendement en het bruto rendement zijn
Het bruto rendement is dus wat een ingelegde euro na één periode waard is, koers en dividend samen. Zoals in Opzet, data en conventies is het netto simpele rendement, en krijgt het logrendement een eigen symbool:
Het logrendement is het groeitempo dat, continu doorgerekend, dezelfde euro oplevert, en bij kleine rendementen liggen en dicht bij elkaar. Voor de standaarddeviatie gebruiken we één symbool, zodat vanaf hier de volatiliteit van het logrendement is. Die van het simpele rendement ligt er dicht bij, met 18,34% tegen 18,32% per jaar voor de maandreeks over de hele eeuw (de tabel met maand- en dagdata in de replicatie). Geen conclusie in dit college hangt van dat verschil af.
Waarom zijn er twee soorten nodig? Een belegger die zijn vermogen twee jaar laat staan, krijgt het product van twee bruto rendementen, , en wie simpele rendementen over de tijd optelt, overschat dus wat hij overhoudt. Een belegger die zijn euro’s over aandelen verdeelt, krijgt daarentegen de gewogen som van hun simpele rendementen, omdat euro’s optellen. Middelt hij daar logrendementen, dan onderschat hij het portefeuillerendement.
Over de tijd tellen logrendementen op, omdat de logaritme van een product de som van de logaritmen is. Voor een horizon van perioden geldt dus
Het logrendement over perioden is de som van de logrendementen per periode, zodat horizonnen en annualiseren het natuurlijkst in logs gaan. Over de activa tellen juist simpele rendementen op, want een portefeuille met gewichten heeft rendement . Bèta’s en portefeuillekeuze op gemiddelde en variantie werken daarom het natuurlijkst met simpele rendementen.
4.2Meetkundig, rekenkundig en de variance drag
Het meetkundig gemiddelde ligt een halve variantie onder het rekenkundige. Dat verschil heet de variance drag (de rem die schommelingen op de groei van een vermogen zetten).
Waarom zou dit waar zijn? Een belegger die jaar na jaar zijn vermogen laat staan, verdient het product van zijn bruto rendementen. Na een daling van 50% heeft hij daardoor een stijging van 100% nodig om terug te zijn. Het rekenkundig gemiddelde ziet dat niet, omdat het en als een symmetrisch paar behandelt. Hoe groter de schommelingen, hoe verder wat de belegger overhoudt achterblijft bij wat hij gemiddeld verdient.
Volgens (6) ligt de verwachting van een lognormale variabele boven de exponent van het gemiddelde logrendement, en volgens (7) ligt het verwachte rendement daardoor een halve variantie boven het meetkundige groeitempo. Omdat het gemiddelde logrendement naar convergeert (de wet van de grote aantallen), groeit een lang pad met , niet met . Er staan vier symbolen voor twee grootheden, want en beschrijven allebei het groeitempo, terwijl het verwachte simpele rendement is, dat in de stelling over de standaardfout kortweg heet. Het bewijs gebruikt de momentgenererende functie van de normale verdeling en staat ingeklapt.
Proof 1
In het toy-voorbeeld gaf het recept al , tegen exact . Het gat is de halve variantie en groeit dus met de schommelingen, zodat een onrustige markt het groter maakt en een rustige het kleiner. Bij gaat het om 2 procentpunt per jaar, en over een eeuw om een factor in eindvermogen.
Welk van de twee gemiddelden is het juiste? Ze zijn allebei juist, maar elk voor een andere vraag. Het rekenkundig gemiddelde schat het verwachte rendement zuiver, en omdat een prijs een verwachte uitkering is, gebruikt elke waarderingsformule in deze reeks het rekenkundige. Het meetkundig gemiddelde zegt daarentegen wat een belegger na dertig jaar overhoudt.
4.3Annualisatie en de wortel--regel
Over perioden groeit het verwachte logrendement met en de standaarddeviatie met . Een belegger die jaar vasthoudt, ziet goede en slechte jaren elkaar immers deels opheffen, zodat zijn verwachte opbrengst met het aantal jaren groeit en zijn spreiding trager. Zijn de onafhankelijk en gelijk verdeeld met gemiddelde en variantie per periode, dan volgt uit (5)
Verwachting en variantie groeien dus met , terwijl de standaarddeviatie alleen met groeit. Met perioden per jaar ( voor maanddata) zijn de geannualiseerde grootheden daarom en .
Uit die asymmetrie tussen en volgt de rest van het college. De verhouding van verwacht rendement tot standaarddeviatie, het signaal per eenheid ruis, groeit daardoor met . Voor de markt is die verhouding per dag 0,04, zodat het signaal een vijfentwintigste van de ruis is. Per jaar, met ongeveer 263 handelsdagen, wordt ze , en de tabel met maand- en dagdata in de replicatie rekent beide uit. Voor de premie heet deze verhouding de Sharpe-ratio.
4.4Het kernresultaat: de standaardfout van 2%
Een gemiddeld rendement wordt nauwkeuriger met de wortel van het aantal jaren, niet met het aantal jaren zelf. Waarom zou dit waar zijn? Een onderzoeker die jaren middelt, laat toevallige goede en slechte jaren tegen elkaar wegvallen, maar dat gaat langzaam. In de financiële economie knelt dat, omdat de volatiliteit groot is, de premie klein en het aantal jaren begrensd door de geschiedenis.
De standaardfout van het gemiddelde is dus de volatiliteit gedeeld door de wortel van het aantal jaren. Die regel geldt voor elke reeks rendementen, simpel of log, premie of totaalrendement, en alleen verschilt.
Voor de drie jaren uit het toy-voorbeeld moeten we eerst schatten. Stap 4 deelde de kwadratensom door drie en beschreef zo de spreiding van de drie jaren zelf. Hier gaat het om het proces waaruit ze komen, en omdat ook het gemiddelde geschat is, delen we door . Dat geeft en , iets meer dan de uit stap 4. De standaardfout is dan procentpunt, ruim tweeënhalf keer het gemeten gemiddelde.
Met en jaar is procentpunt. Die onzekerheid komt in elk later college terug, want een eeuw data kent een gemiddeld jaarrendement maar op twee procentpunt na. Een 95%-interval reikt ongeveer twee standaardfouten naar weerszijden, zodat het rond een geschatte premie van 6% van 2% tot 10% loopt, van een markt die risico nauwelijks beloont tot een die dat royaal doet.
Hoeveel jaren zijn nodig om een verschil te zien? De -waarde van het gemiddelde is , en als we die gelijkstellen aan een gewenste -waarde , bijvoorbeeld 2, en oplossen naar , vinden we
Het aantal benodigde jaren groeit dus kwadratisch naarmate het te vinden verschil kleiner is. Om twee hypothesen te scheiden, vervangen we door .
Het antwoord heeft twee kanten. Om een premie van 6% met van nul te onderscheiden, zijn jaar nodig, en daarom betwijfelt vrijwel niemand dat er een premie is. Voorspellen twee verklaringen van de premie echter 4% en 6%, dan zijn er jaar nodig om ze te scheiden. De tabel rekent (10) uit voor vijf vragen, bij .
sigma = 0.20
targets = pd.DataFrame(
    {
        "vraag": [
            "premie van 6% onderscheiden van 0 (t=2)",
            "premie van 6% onderscheiden van 4% (t=2)",
            "premie van 6% onderscheiden van 5% (t=2)",
            "standaardfout van 1 procentpunt",
            "standaardfout van 0,5 procentpunt",
        ],
        "verschil (pp)": [6.0, 2.0, 1.0, np.nan, np.nan],
        "benodigde jaren": [
            (2 * sigma / 0.06) ** 2,
            (2 * sigma / 0.02) ** 2,
            (2 * sigma / 0.01) ** 2,
            (sigma / 0.01) ** 2,
            (sigma / 0.005) ** 2,
        ],
    }
).set_index("vraag")
targets.round(0)Alleen de eerste vraag past binnen een eeuw. Of er een premie is, valt dus te beantwoorden, maar hoe groot hij is, vraagt honderden tot duizenden jaren. Na een eeuw blijft het gemiddelde dus enkele procentpunten onzeker, zoals de verhouding van ruis tot signaal in de intuïtie al deed vermoeden.
4.5Merton (1980): waarom fijner meten niet helpt
Vaker kijken maakt de schatting van de variantie scherper, maar niet die van het verwachte rendement. Hoe kan dat? Een onderzoeker die het jaar opknipt in maanden of minuten, verdeelt hetzelfde totale logrendement over meer stukjes. Volgens (5) is de som van die stukjes het logrendement van begin tot eind, en die som verandert niet. De volatiliteit meet hij daarentegen met de som van de kwadraten van de stukjes, en meer kwadraten geven een nauwkeuriger schatting.
In de stelling is een standaard Brownse beweging, een random walk in continue tijd met . De drift is het verwachte logrendement per jaar, en is zoals afgesproken de volatiliteit van het logrendement. De maximum-likelihoodschatters zijn de parameterwaarden die de waargenomen stappen het waarschijnlijkst maken, en bij normale stappen zijn dat het gemiddelde en de variantie van de stappen.
De geschatte drift is dus het totale logrendement gedeeld door het aantal jaren. De variantie van die schatter hangt alleen van de kalenderlengte af, terwijl die van van het aantal waarnemingen afhangt. Het bewijs staat ingeklapt.
Proof 3
Met stapgrootte zijn de stappen , de logrendementen, onafhankelijk en . De ML-schatter van de drift is de gemiddelde stap gedeeld door :
want in de som vallen alle tussenliggende koersen tegen elkaar weg. De variantie is , onafhankelijk van .
Voor de variantie geldt . Omdat de stappen normaal zijn, is , met variantie . Dus .
De drift is een eigenschap van het pad als geheel, zodat honderd jaar dagkoersen daarover evenveel informatie bevatten als twee koersen, de eerste en de laatste. Alles daartussen zegt iets over de variantie. Bij 100 jaarwaarnemingen is de relatieve standaardfout van de variantie , bij dagwaarnemingen 0,9%. Net als bij de meetpaal verandert vaker meten dus niets aan het totaal en alles aan wat we over de schommeling weten.
4.6Wanneer de aannames niet gelden: autocorrelatie en dikke staarten
Ook zonder onafhankelijkheid en normaliteit verandert er weinig aan de standaardfout van 2%. Autocorrelatie maakt hem iets groter, terwijl dikke staarten hem ongemoeid laten.
Autocorrelatie. Volgt op een goede maand vaak weer een goede, dan versterken de schokken elkaar en wordt de spreiding over een jaar groter dan de wortel--regel zegt. Volgt op goed vaak slecht, dan wordt die spreiding juist kleiner. Laat de autocorrelatie bij lag zijn, dus de correlatie tussen een rendement en dat van perioden eerder. Voor de som van opeenvolgende logrendementen geldt dan
De variantie over perioden is dus keer de variantie per periode, maal een correctie. Die correctie tussen haken heet de variance ratio , en ze is één onder een random walk, groter dan één bij positieve en kleiner dan één bij negatieve autocorrelatie. De bijbehorende toets is van Lo & MacKinlay (1988).
De standaardfout van het gemiddelde krijgt dezelfde correctie. Met waarnemingen op één frequentie, en en op die frequentie, wordt ze . Een eeuw maandrendementen geeft , met een autocorrelatie bij lag 1 van 0,085 (zie de replicatie). Omdat de hogere lags elkaar grotendeels opheffen, nemen we alleen die ene autocorrelatie, en dan is , zodat de standaardfout met een factor groeit, van 2,0 naar ongeveer 2,2 procentpunt. Aan de conclusie verandert dat niets.
Dikke staarten. Mandelbrot (1963) en Fama (1965) lieten zien dat dagelijkse koersveranderingen veel te veel massa in de staarten hebben voor een normale verdeling. De maat daarvoor is de kurtosis , het vierde gestandaardiseerde moment, dat onder normaliteit drie is. Tabellen rapporteren meestal de excess kurtosis , en voor dagelijkse logrendementen van de markt is die ongeveer zeventien, zoals de replicatie laat zien, zodat .
De variantieschatter is een gemiddelde van gekwadrateerde afwijkingen, die we nog wel onafhankelijk nemen. Eén kwadraat heeft variantie , dus
Links staat het gemiddelde logrendement per jaar over jaar, met per jaar. Rechts staat de variantie per waarneming, geschat uit waarnemingen, met per waarneming. Bij staat er de van Merton.
De eerste formule bevat geen kurtosis, zodat dikke staarten de standaardfout van het gemiddelde ongemoeid laten zolang de variantie eindig is. De tweede formule bevat de kurtosis wel, en bij is de standaardfout van de variantieschatting keer zo groot als onder normaliteit. Dikke staarten kosten dus alleen precisie in de grootheid die we al goed kenden.
5Simulatie: de frequentie van waarnemen
Wat gebeurt er met de schatters van gemiddelde en variantie als we dezelfde honderd jaar steeds fijner bekijken? Om dat te zien bouwen we een wereld waarin de logprijs een Brownse beweging volgt met een drift van 8% en een volatiliteit van 20% per jaar. De 8% is de drift van het logrendement, dus een totaalrendement en geen premie. Voor de standaardfout maakt de drift niet uit, omdat de standaardfout volgens (9) alleen van de 20% afhangt.
We genereren tweeduizend paden van honderd jaar met 252 handelsdagen per jaar. Elk pad bekijken we jaarlijks, per kwartaal, per maand en per dag, door de logprijs af te lezen op momenten per jaar, dus elke -ste dagkoers, en daarvan de verschillen te nemen. Om geheugen te sparen werkt de cel in acht blokken van 250 paden.
n_paths, n_years, per_year = 2000, 100, 252
nu, sigma_true = 0.08, 0.20
freqs = {"jaarlijks": 1, "kwartaal": 4, "maandelijks": 12, "dagelijks": 252}

means = {name: [] for name in freqs}
variances = {name: [] for name in freqs}

for block in np.array_split(np.arange(n_paths), 8):
    daily_steps = rng.normal(
        nu / per_year, sigma_true / np.sqrt(per_year),
        size=(len(block), n_years * per_year),
    )
    start = np.zeros((len(block), 1))
    log_price = np.hstack([start, daily_steps.cumsum(axis=1)])
    for name, k in freqs.items():
        step = per_year // k                            # dagen tussen twee waarnemingen
        observed = log_price[:, ::step]                 # elke step-de dagkoers
        returns_k = np.diff(observed, axis=1)           # logrendement per periode
        means[name].append(returns_k.mean(axis=1) * k)
        variances[name].append(returns_k.var(axis=1, ddof=1) * k)

means = {name: np.concatenate(v) for name, v in means.items()}
variances = {name: np.concatenate(v) for name, v in variances.items()}
Per frequentie hebben we nu tweeduizend geschatte gemiddelden en varianties. De tabel zet hun spreiding naast de theorie.
frequency = pd.DataFrame(
    {
        "waarnemingen": [n_years * k for k in freqs.values()],
        "standaardfout gemiddelde (pp)": [means[n].std(ddof=1) * 100 for n in freqs],
        "theorie gemiddelde (pp)": [sigma_true / np.sqrt(n_years) * 100] * 4,
        "relatieve fout variantie": [
            variances[n].std(ddof=1) / sigma_true**2 for n in freqs
        ],
        "theorie variantie": [
            np.sqrt(2 / (n_years * k)) for k in freqs.values()
        ],
    },
    index=list(freqs),
)
frequency.round(4)Het aantal waarnemingen groeit met een factor 252, maar de standaardfout van het gemiddelde blijft precies 1,99 procentpunt. Dat komt doordat de schatter volgens (11) bij elke frequentie uitkomt op laatste min eerste logprijs, gedeeld door honderd. De relatieve fout van de variantie daalt intussen van 14% naar 0,9%, zoals voorspelt.
De figuur toont beide schatters bij jaarlijkse en dagelijkse waarneming, en het gaat vooral om de breedte van de histogrammen. Links is maar één histogram zichtbaar, omdat de twee precies samenvallen.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4), sharey=False)

axes[0].hist(means["jaarlijks"] * 100, bins=50, alpha=0.65,
             label="jaarlijks (100 obs.)", edgecolor="white")
axes[0].hist(means["dagelijks"] * 100, bins=50, alpha=0.65,
             label="dagelijks (25 200 obs.)", edgecolor="white")
axes[0].axvline(nu * 100, color="black", lw=1.4)
axes[0].set_title("Geschat gemiddelde")
axes[0].set_xlabel("Geschatte drift (procent per jaar)")
axes[0].set_ylabel("Aantal paden")
axes[0].legend()

axes[1].hist(np.sqrt(variances["jaarlijks"]) * 100, bins=50, alpha=0.65,
             label="jaarlijks (100 obs.)", edgecolor="white")
axes[1].hist(np.sqrt(variances["dagelijks"]) * 100, bins=50, alpha=0.65,
             label="dagelijks (25 200 obs.)", edgecolor="white")
axes[1].axvline(sigma_true * 100, color="black", lw=1.4)
axes[1].set_title("Geschatte volatiliteit")
axes[1].set_xlabel("Geschatte volatiliteit (procent per jaar)")
axes[1].set_ylabel("Aantal paden")
axes[1].legend()

fig.tight_layout()
plt.show()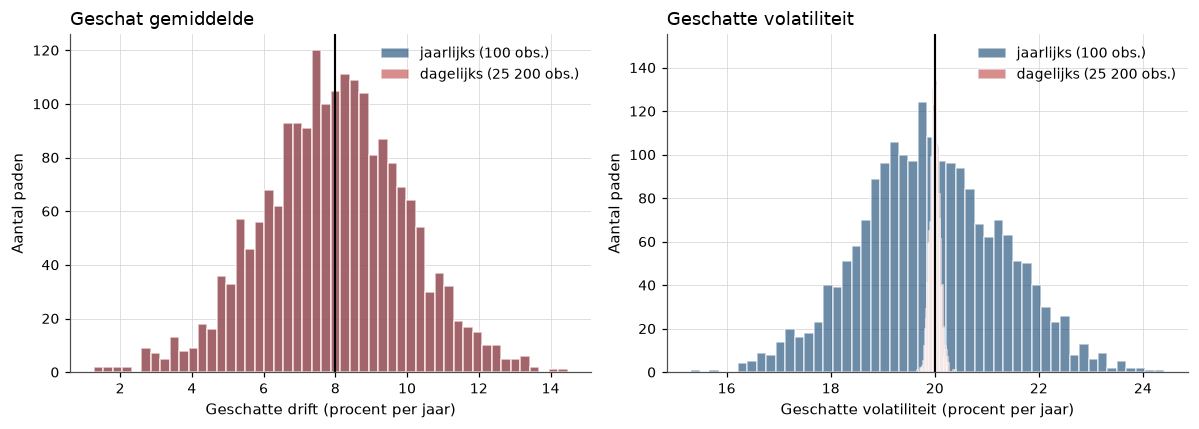
Figure 1:Elk van de tweeduizend gesimuleerde eeuwen is twee keer bekeken. Links heeft het geschatte gemiddelde bij jaarlijkse en dagelijkse waarneming dezelfde verdeling, want de twee histogrammen vallen samen. Rechts krimpt de geschatte volatiliteit bij dagelijkse waarneming tot een streep, zodat alle extra informatie naar de variantie gaat.
Om een verwacht rendement te kennen is dus geschiedenis nodig, en die komt op één snelheid binnen. Geen meetfrequentie kan dat tempo opvoeren.
6Replicatie op echte data
We laden de twee reeksen.
# Value-weighted markt: Mkt = Mkt-RF + RF uit de French-factoren (414 maanden).
# Equal-weighted: gemiddelde van de tien equal-weighted size-decielen.
deciles = ["Lo 10", "2-Dec", "3-Dec", "4-Dec", "5-Dec", "6-Dec",
           "7-Dec", "8-Dec", "9-Dec", "Hi 10"]
size_ew = hap_data.french("Portfolios_Formed_on_ME", "monthly", table="Equal-Weight")

sample = slice("1926-07", "1960-12")
value_weighted = hap_data.market_monthly()["Mkt"].loc[sample]
equal_weighted = size_ew[deciles].loc[sample].mean(axis=1)
Per reeks berekenen we het meetkundig en het rekenkundig gemiddelde per jaar, de volatiliteit en de standaardfout van het rekenkundig gemiddelde. Omdat de functie voor elke frequentie werkt, gebruiken we dezelfde functie straks ook voor dagdata.
def annual_summary(returns: pd.Series, per_year: float = 12) -> dict[str, float]:
    """Geometric and arithmetic annual return, volatility and standard error."""
    n_obs = len(returns)
    years = n_obs / per_year
    sd_ann = returns.std(ddof=1) * np.sqrt(per_year)
    return {
        "waarnemingen": n_obs,
        "meetkundig": (1 + returns).prod() ** (1 / years) - 1,
        "rekenkundig": per_year * returns.mean(),
        "volatiliteit": sd_ann,
        "standaardfout gemiddelde": sd_ann / np.sqrt(years),
    }


fisher_lorie = pd.DataFrame(
    {
        "waardegewogen markt": annual_summary(value_weighted),
        "gelijkgewogen (10 grootte-decielen)": annual_summary(equal_weighted),
    }
).T
fisher_lorie.round(4)De waardegewogen markt heeft een volatiliteit van 22,9%, dezelfde als de drie jaren van het toy-voorbeeld. Het rekenkundig gemiddelde ligt ruim twee procentpunt boven het meetkundige, in de orde van de halve variantie van procentpunt, want het recept is een benadering die bij een crash als 1929–1932 minder goed past. De volgende tabel zet het meetkundig gemiddelde naast het gepubliceerde getal.
published = 0.090    # Fisher en Lorie (1964), met herbelegde dividenden
replicated = fisher_lorie["meetkundig"]

se = fisher_lorie["standaardfout gemiddelde"]

pd.DataFrame(
    {"origineel": published, "hier": replicated, "verschil": replicated - published,
     "95%-interval, onder": replicated - 1.96 * se,
     "95%-interval, boven": replicated + 1.96 * se}
).round(4)Geslaagd. De waardegewogen markt ligt een half procentpunt boven de 9,0%, binnen het ene procentpunt dat we vooraf verwachtten. De gelijkgewogen variant ligt zoals verwacht hoger, maar in dat verschil zitten twee effecten die we niet kunnen scheiden. Kleine aandelen deden het beter, en bovendien springt bij kleine aandelen de slotkoers heen en weer tussen bied- en laatkoers (bid-ask bounce). Een portefeuille die elke maand herbalanceert, verkoopt na elke sprong omhoog en koopt na elke sprong omlaag, en boekt het heen-en-weer zo als rendement.
In 1964 werd de onzekerheid niet gerapporteerd. Het interval in de tabel gebruikt de standaardfout van het rekenkundig gemiddelde, 3,9 procentpunt. Het meetkundig gemiddelde ligt ongeveer een halve variantie lager, en omdat de variantie volgens Merton veel nauwkeuriger bekend is dan het gemiddelde, is het vrijwel even onzeker. Voor de waardegewogen markt loopt het interval van ongeveer 2% tot 17%, zodat het beroemde 9,0% weinig meer zei dan dat het rendement positief was.
De figuur toont het pad van één dollar. Van belang zijn vooral waar de lijnen eindigen ten opzichte van het groeipad van 9,0%, en de val van 1929–1932.
Source
cumulative = pd.DataFrame(
    {"waardegewogen": (1 + value_weighted).cumprod(),
     "gelijkgewogen": (1 + equal_weighted).cumprod()}
)
years_elapsed = np.arange(1, len(cumulative) + 1) / 12
path_9pct = 1.09 ** years_elapsed

fig, ax = plt.subplots()
for column, color in zip(cumulative.columns, hap.plotting.COLORS):
    ax.plot(cumulative.index, cumulative[column], label=column, color=color)
ax.plot(cumulative.index, path_9pct, color="black", ls="--", lw=1.0,
        label="Fisher-Lorie: 9,0% per jaar")
ax.set_yscale("log")
ax.set_title("Eén dollar in Amerikaanse aandelen, juli 1926 - december 1960")
ax.set_xlabel("Jaar")
ax.set_ylabel("Waarde (log-schaal)")
ax.legend()
hap.plotting.timeline_axis(ax)
plt.show()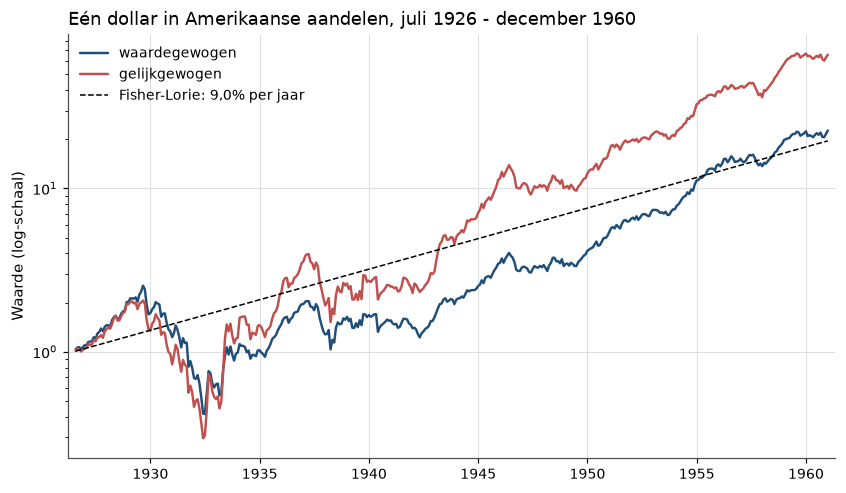
Figure 2:De figuur beslaat de periode die Fisher en Lorie bekeken. De stippellijn groeit met hun 9,0% per jaar, en de waardegewogen reeks eindigt er vlak boven, de gelijkgewogen reeks ver erboven. De crash van 1929–1932, een terugval van meer dan 80%, valt er volledig in. Daarom vonden tijdgenoten het resultaat opzienbarend: zelfs met de Grote Depressie erbij was het langetermijnrendement ruim positief.
6.1Dezelfde eeuw, maand- en dagdata
Deze subsectie en de volgende zijn geen replicatie maar illustraties van Theorem 3 op echte data. We verwachten dat dagdata de standaardfout van het gemiddelde nauwelijks verbeteren, en de schatting van volatiliteit en staarten sterk. Daarvoor nemen we de hele French-reeks van juli 1926 tot juli 2026, op maand- en op dagbasis. Omdat tot 1952 ook op zaterdag werd gehandeld, annualiseren we de dagreeks met het werkelijke aantal handelsdagen per jaar, en niet met 252.
market_monthly = hap_data.market_monthly()["Mkt"].dropna()
market_daily = hap_data.market_daily()["Mkt"].dropna()
calendar_years = len(market_monthly) / 12
days_per_year = len(market_daily) / calendar_years

def describe_frequency(returns: pd.Series, per_year: float) -> dict[str, float]:
    '''Annual summary plus log volatility, signal-to-noise ratios and log excess kurtosis.'''
    summary = annual_summary(returns, per_year)
    summary["volatiliteit logrendement"] = np.log1p(returns).std(ddof=1) * np.sqrt(per_year)
    summary["signaal/ruis per waarneming"] = returns.mean() / returns.std(ddof=1)
    summary["signaal/ruis per jaar"] = summary["rekenkundig"] / summary["volatiliteit"]
    summary["excess kurtosis (log)"] = np.log1p(returns).kurtosis()
    return summary


comparison = pd.DataFrame(
    {
        "maandelijks": describe_frequency(market_monthly, 12),
        "dagelijks": describe_frequency(market_daily, days_per_year),
    }
)
comparison.round(4)De tabel laat zien wat de stelling van Merton voorspelt. De dagreeks heeft ruim twintig keer zoveel waarnemingen, maar de standaardfout van het gemiddelde daalt alleen van 1,83 naar 1,75 procentpunt. Zelfs die kleine daling komt van een lagere volatiliteit, en niet van meer waarnemingen. Dat de maandwaarde iets onder de twee procentpunt uit de theorie ligt, komt doordat de gemeten volatiliteit lager is dan de ronde waarde die we daar namen.
Dat de volatiliteit op dagbasis lager uitvalt, volgt uit (13) met dagen binnen een maand. Dagrendementen zijn licht positief gecorreleerd (zie de tabel hierna), zodat een maand meer schommelt dan de dagen apart doen vermoeden. De excess kurtosis springt omhoog, want de dagreeks vertelt veel meer over de staarten, maar niets meer over het midden.
6.2Wat wél in de data zit: clustering van volatiliteit
Het rendement zelf heeft nauwelijks geheugen, maar de volatiliteit wel. De tabel toont de autocorrelatie van het logrendement en van het absolute logrendement, een maat voor de volatiliteit van die dag.
log_daily = np.log1p(market_daily)
log_monthly = np.log1p(market_monthly)

diagnostics = pd.DataFrame(
    {
        "autocorr. rendement (dag)": [log_daily.autocorr(k) for k in range(1, 7)],
        "autocorr. |rendement| (dag)": [log_daily.abs().autocorr(k) for k in range(1, 7)],
        "autocorr. rendement (maand)": [log_monthly.autocorr(k) for k in range(1, 7)],
    },
    index=pd.Index(range(1, 7), name="lag"),
)
diagnostics.round(3)De autocorrelatie van het rendement is bij elke lag kleiner dan 0,09 en bij de meeste kleiner dan 0,03. Die van het absolute rendement is ongeveer 0,30, bij lag 1 en nog steeds bij lag 6, zodat volatiliteit duidelijk klontert. Zo staat de asymmetrie nog één keer in de data, want de grootheid die we goed kunnen meten, is ook voorspelbaar, terwijl de grootheid die we slecht kunnen meten nauwelijks een patroon vertoont.
7Wat er brak, en wat daarna kwam
Wat de meetlat oplevert. Met (5), (8) en (9) wordt elke bewering over een gemiddeld rendement een uitspraak met een standaardfout erbij. Die vertaling vraagt geen model, geen aanname over voorkeuren en geen theorie, zodat van elke schatter de precisie bekend is. Dat kunnen weinig vakgebieden van hun meetlat zeggen.
Waar het breekt. Het instrument is scherp genoeg om zijn eigen grenzen te tonen. Het rekenkundig gemiddelde marktrendement was 11,7% over 1926–1960, met een standaardfout van 3,9 procentpunt, en 11,6% over de hele eeuw, met 1,8. Geen frequentie of methode verbetert dat, want volgens Theorem 3 zit de informatie over de drift alleen in de kalenderlengte. Het verwachte rendement in elke waarderingsvergelijking is dus niet nauwkeuriger bekend dan op een paar procentpunt.
Risico of vergissing? Stel dat de markt in 1932 goedkoop was. Volgens de Chicago-lezing (Fama: prijzen kloppen) eisten beleggers voor het risico van dat moment een hogere vergoeding. Volgens de Yale-lezing (Shiller: prijzen kunnen ernaast zitten) stond de prijs door paniek te laag. Beide lezingen voorspellen hoge rendementen na 1932, maar ze verschillen in welk deel daarvan vergoeding voor risico was, dus in het verschil tussen het verwachte rendement volgens een risicomodel en het rendement dat werkelijk volgde. Is dat verschil twee procentpunt per jaar, dan kost het volgens (10) vierhonderd jaar data om het te zien, terwijl een crisis hooguit een paar jaar bruikbare data oplevert. Uit de data valt dus niet te kiezen tussen de twee lezingen.
Wat er daarna kwam. De wortel--regel (8) komt niet uit een statistiekboek maar van een handelsvloer. In 1863, 37 jaar vóór Bachelier, schreef Jules Regnault, beambte aan de Parijse beurs, dat de koersuitslag met de wortel van de tijd groeit. Daarover gaat Regnault, Bachelier en de random walk, met de regel als empirisch feit, de Brownse beweging als model erachter en de eerste toetsen of koersen geheugenloos zijn.
8Oefeningen
Solution to Exercise 1
(1) Er verandert geen enkel getal. De som, het product en de variantie hangen immers niet af van de volgorde.
(2) Het rekenkundig gemiddelde is . Het product van de bruto rendementen is , dus het meetkundig gemiddelde is . De afwijkingen van het gemiddelde zijn , en , met een kwadratensom van . Gedeeld door drie is dat , en de halve variantie is . De cel rekent het na.
r_alt = np.array([0.25, -0.30, 0.10])
arith_alt = r_alt.mean()
geom_alt = (1 + r_alt).prod() ** (1 / len(r_alt)) - 1
half_var_alt = r_alt.var(ddof=0) / 2

pd.Series({
    "rekenkundig gemiddelde": arith_alt,
    "meetkundig gemiddelde": geom_alt,
    "halve variantie": half_var_alt,
    "verschil rekenkundig - meetkundig": arith_alt - geom_alt,
}).round(6)
rekenkundig gemiddelde 0.016667
meetkundig gemiddelde -0.012660
halve variantie 0.026944
verschil rekenkundig - meetkundig 0.029326
dtype: float64Het verschil groeit van 1,77 naar 2,93 procentpunt, omdat het grotere verlies de variantie vergroot. Het rekenkundig gemiddelde is nog positief, maar de belegger heeft geld verloren. Een positief gemiddeld rendement zegt dus nog niets over het vermogen aan het eind.
:::{exercise}
:label: ex-rendementen-1

**De twee standaardfouten, afgeleid en gesimuleerd.**

1. Leid [](#eq-rendementen-merton) af zonder continue tijd. Neem $N = nT$
   onafhankelijke stappen $\ell_i \sim N(\nu/n, \sigma^2/n)$ en toon aan dat de
   geannualiseerde schatter $\hat\nu = (n/N)\sum_i \ell_i$ variantie $\sigma^2/T$
   heeft, ongeacht $n$.
2. Een onderzoeker beweert dat de premie 6% is, een ander 4%. Hoeveel jaar data
   is nodig om die twee met $t = 2$ te scheiden, bij $\sigma = 20\%$? En bij
   $\sigma = 15\%$?
3. Simuleer 20 000 steekproeven van 100 jaarlijkse rendementen met
   $\mu = 6\%$ en $\sigma = 20\%$. In welke fractie is de geschatte premie
   negatief? In welke fractie haalt hij $t > 2$?
Solution to ex-rendementen-1
(1) De som heeft gemiddelde en variantie . Dus heeft en , zonder . Elke stap is keer kleiner en keer minder variabel, maar er zijn er keer zoveel.
(2) We gebruiken (10) met en . Dat geeft jaar bij en jaar bij .
(3) Analytisch is de standaardfout procentpunt. Een negatieve schatting vraagt dan een afwijking van drie standaardfouten, met kans . De cel rekent (2) na en simuleert (3).
n_sim, n_obs, mu_ex, sigma_ex = 20_000, 100, 0.06, 0.20
draws = rng.normal(mu_ex, sigma_ex, size=(n_sim, n_obs))
sample_mean = draws.mean(axis=1)
sample_t = sample_mean / (draws.std(axis=1, ddof=1) / np.sqrt(n_obs))

pd.DataFrame(
    {
        "waarde": [
            (2 * 0.20 / 0.02) ** 2,
            (2 * 0.15 / 0.02) ** 2,
            float(np.mean(sample_mean < 0)),
            float(np.mean(sample_t > 2)),
        ]
    },
    index=["jaren nodig bij sigma=20%", "jaren nodig bij sigma=15%",
           "fractie met negatieve geschatte premie", "fractie met t > 2"],
).round(4)In 0,16% van de gesimuleerde eeuwen concludeert een onderzoeker met een perfect gespecificeerd model dat aandelen minder opbrengen dan niets, dicht bij de analytische 0,13%. In ongeveer 84% haalt hij , zodat de toets of de premie nul is behoorlijk werkt. Met een eeuw data valt dus wel te beantwoorden óf er een premie is, maar niet hoe groot hij is.
:::{exercise}
:label: ex-rendementen-2

**Fisher-Lorie op andere steekproeven.** Herhaal de replicatie voor 1926-07 t/m
1960-12, 1961-01 t/m 1993-12 en 1994-01 t/m 2026-07.

1. Rapporteer per periode het meetkundig en het rekenkundig gemiddelde per jaar
   van het totaalrendement van de waardegewogen markt, de volatiliteit en de
   standaardfout van het gemiddelde.
2. Toets of het rekenkundig gemiddelde van de eerste periode verschilt van dat
   van de derde. Neem aan dat de perioden onafhankelijk zijn.
3. Hoe lang zou elke periode moeten duren om een verschil van twee procentpunt
   met $t = 2$ te zien?
Solution to ex-rendementen-2
Eerst maken we de samenvatting per periode.
periods = {
    "1926-07 / 1960-12": slice("1926-07", "1960-12"),
    "1961-01 / 1993-12": slice("1961-01", "1993-12"),
    "1994-01 / 2026-07": slice("1994-01", "2026-07"),
}
market = hap_data.market_monthly()["Mkt"]

by_period = pd.DataFrame(
    {name: annual_summary(market.loc[window]) for name, window in periods.items()}
).T
by_period.round(4)De rekenkundige gemiddelden liggen dicht bij elkaar, terwijl de meetkundige uiteenlopen. Daarna toetsen we het verschil tussen de eerste en de laatste periode. Voor twee onafhankelijke gemiddelden over elk jaar is de standaardfout van het verschil , zodat bij een verschil om jaar vraagt.
first, last = by_period.index[0], by_period.index[-1]
difference = by_period.loc[first, "rekenkundig"] - by_period.loc[last, "rekenkundig"]
se_difference = np.sqrt(
    by_period.loc[first, "standaardfout gemiddelde"] ** 2
    + by_period.loc[last, "standaardfout gemiddelde"] ** 2
)
vol_first = by_period.loc[first, "volatiliteit"]
vol_last = by_period.loc[last, "volatiliteit"]
years_for_2pp = 4 * (vol_first**2 + vol_last**2) / 0.02**2

pd.DataFrame(
    {"waarde": [difference, se_difference, difference / se_difference, years_for_2pp]},
    index=["verschil in rekenkundig gemiddelde", "standaardfout van het verschil",
           "t-waarde", "jaren per periode voor t=2 bij 2 pp verschil"],
).round(4)De rekenkundige gemiddelden van de drie perioden liggen binnen een kwart procentpunt van elkaar, met een -waarde van 0,01 tussen de eerste en de laatste. Het meetkundig gemiddelde stijgt wel, van 9,46% naar 10,92%. Dat volgt uit Theorem 1, want de volatiliteit daalde van 22,9% naar ruim 15%, en een kleinere halve variantie geeft meer groei bij hetzelfde verwachte rendement. Wie de twee gemiddelden door elkaar haalt, ziet dus een stijging die er niet is. Het gaat hier overigens om het totaalrendement en niet om de premie, want de risicovrije rente verschilde sterk per periode.
Om een verschil van twee procentpunt te zien, zou elke periode ruim zevenhonderd jaar moeten duren. Een veranderd meetkundig gemiddelde is dus nog geen veranderd verwacht rendement, en een echt veranderd verwacht rendement is met rendementsdata alleen niet te zien.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Fisher, L., & Lorie, J. H. (1964). Rates of Return on Investments in Common Stocks. The Journal of Business, 37(1), 1–21. 10.1086/294647
- Merton, R. C. (1980). On Estimating the Expected Return on the Market: An Exploratory Investigation. Journal of Financial Economics, 8(4), 323–361. 10.1016/0304-405X(80)90007-0
- Mehra, R., & Prescott, E. C. (1985). The Equity Premium: A Puzzle. Journal of Monetary Economics, 15(2), 145–161. 10.1016/0304-3932(85)90061-3
- Lo, A. W., & MacKinlay, A. C. (1988). Stock Market Prices Do Not Follow Random Walks: Evidence from a Simple Specification Test. Review of Financial Studies, 1(1), 41–66. 10.1093/rfs/1.1.41
- Mandelbrot, B. (1963). The Variation of Certain Speculative Prices. The Journal of Business, 36(4), 394–419. 10.1086/294632
- Fama, E. F. (1965). The Behavior of Stock-Market Prices. The Journal of Business, 38(1), 34–105. 10.1086/294743
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD