

Fama-French 1992/1993
1Overzicht
Welke kenmerken verklaren gemiddelde rendementen als ze het tegen elkaar en tegen bèta moeten opnemen? Grootte en de verhouding van boekwaarde tot marktwaarde blijven over. Een model met de markt en twee portefeuilles die op die kenmerken zijn gebouwd, brengt de prijsfouten van de 25 size/BM-portefeuilles terug van een kwart naar een tiende procent per maand. Die kleine alpha’s zeggen echter weinig over de vraag of beleggers voor risico of voor een kenmerk worden betaald. In dit college:
bouwen we de twee factoren met de hand uit zes aandelen;
laten we zien dat de tijdreekstoets een toets is op een lineaire stochastic discount factor (SDF, de toevallige weging waarmee toekomstige payoffs worden verdisconteerd);
bewijzen we dat een cross-sectionele regressie met vrije premies bijna elke factor die met grootte en B/M meebeweegt een hoge geeft, en dat een beloond kenmerk er op gesorteerde portefeuilles uitziet als een beloonde covariantie;
simuleren we beide zwaktes in steekproeven van vijftig jaar;
repliceren we tabel 9a van Fama en French (1993) en benaderen we tabel III van Fama en French (1992).
In juni 1992 publiceerden Eugene Fama en Kenneth French het artikel dat volgens Santa-Clara een einde maakte aan het CAPM als werkbaar empirisch model Fama & French (1992)Santa-Clara (2026). Twee eenvoudig te meten variabelen, de marktwaarde en de boekwaarde gedeeld door de marktwaarde (B/M), namen daarin het werk over van bèta. Een jaar later maakten ze er een model van Fama & French (1993). Naast de markt bevat het een portefeuille die kleine aandelen koopt en grote verkoopt (SMB, small minus big). De derde factor koopt aandelen met een hoge B/M en verkoopt aandelen met een lage (HML, high minus low).
Met die twee artikelen begon een tijdvak waarin het vak eerst de feiten had en er daarna een theorie bij zocht. Fama en French lazen SMB en HML als risicofactoren in de geest van het ICAPM en de APT, maar volgens Santa-Clara dankte het model zijn succes niet aan de stelling van Ross. Het won omdat het de gemiddelde rendementen goed beschreef Santa-Clara (2026).
2Intuïtie: waarom zou dit waar zijn?
Leg de drie bevindingen uit Basu, Banz en Rosenberg naast elkaar. Aandelen met een lage koers ten opzichte van winst of boekwaarde en aandelen van kleine bedrijven leveren meer op dan het CAPM toestaat. Vaak zijn het echter dezelfde aandelen, want een bedrijf dat slecht draait, heeft een lage koers, een lage marktwaarde en een hoge B/M. Fama en French vroegen welke kenmerken overblijven als ze het tegen elkaar moeten opnemen, en dat waren marktwaarde en B/M.
Dat juist kenmerken met de koers in de noemer winnen, ligt voor de hand zodra we bedenken wat een koers is. Een koers is de som van de verwachte kasstromen, verdisconteerd met het rendement dat beleggers eisen. Als beleggers een hoger rendement eisen, daalt de koers en stijgt de B/M, om welke reden ze dat ook eisen. Zo’n kenmerk werkt daardoor als een thermometer van het verwachte rendement.
In 1993 zetten Fama en French de volgende stap. Aandelen met een vergelijkbaar kenmerk bewegen samen, en een portefeuille die kleine aandelen koopt en grote verkoopt, vangt die gezamenlijke beweging. Als beleggers voor die meebeweging worden beloond, levert een aandeel dat sterker met HML meebeweegt evenredig meer op. Een regressie op de markt, SMB en HML verklaart het gemiddelde rendement dan volledig, en de intercepten zijn nul.
Toch zijn er twee complicaties. SMB en HML zijn gebouwd door op grootte en B/M te sorteren, en de portefeuilles die ze moeten verklaren ook, zodat een goede fit deels vanzelf ontstaat. Bovendien zegt een goede fit niet of het rendement betaald wordt voor de meebeweging of voor het kenmerk. Als beleggers waardeaandelen stelselmatig te laag waarderen en die aandelen toevallig samen bewegen, ontstaat dezelfde tabel.
We verwachten daarom dat de intercepten van de 25 size/BM-portefeuilles sterk krimpen zodra SMB en HML erbij komen. Alleen een portefeuille die de meebeweging loskoppelt van het kenmerk kan laten zien of risico of het kenmerk wordt beloond.
3Toy-voorbeeld: zes aandelen, één 2×3-sortering en een regressie met drie waarnemingen
Het toy-voorbeeld bouwt de twee factoren uit zes aandelen en schat daarna één regressie met drie waarnemingen. Eerst laden we de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Zes aandelen staan allemaal genoteerd aan de NYSE, zodat de breekpunten uit alle zes komen. Van elk aandeel kennen we de marktwaarde ME eind juni van jaar en het rendement in juli. De B/M is de boekwaarde over het boekjaar dat in eindigt, gedeeld door de marktwaarde van december . De risicovrije rente is die maand 0,20%.
| aandeel | ME | B/M | rendement juli |
|---|---|---|---|
| A | 20 | 0,3 | 2% |
| B | 20 | 0,8 | 3% |
| C | 10 | 1,6 | 5% |
| D | 500 | 0,4 | 1% |
| E | 300 | 0,7 | 2% |
| F | 150 | 1,2 | 3% |
Stap 1, de sortering. De mediaan van ME scheidt klein (A, B, C) van groot (D, E, F). Het 30e en het 70e percentiel van B/M liggen met lineaire interpolatie tussen de tweede en de derde en tussen de vierde en de vijfde waarde. Dat geeft en , zodat A en D laag zijn, B en E midden en C en F hoog. Elke doorsnede bevat één aandeel, en de waardegewogen rendementen zijn dus de rendementen zelf.
| L | M | H | |
|---|---|---|---|
| S | 2% (A) | 3% (B) | 5% (C) |
| B | 1% (D) | 2% (E) | 3% (F) |
Stap 2, de factoren. SMB is het gemiddelde van de drie kleine portefeuilles min dat van de drie grote. HML is het gemiddelde van de twee hoge min dat van de twee lage:
Stap 3, de markt. De markt is waardegewogen, , wat een overrendement van geeft. De drie kleine aandelen zijn samen 5% van de marktwaarde, maar ze krijgen in SMB de helft van het gewicht. Omdat SMB klein met groot vergelijkt binnen elke B/M-groep, valt het verschil in B/M er grotendeels uit.
Stap 4, de regressie. Stap 1 tot 3 leveren de factoren van één maand op, terwijl een regressie een tijdreeks nodig heeft. Stap 4 en 5 zijn daarom een los tweede voorbeeld, met drie verzonnen maanden factorrealisaties en het overrendement van één portefeuille, en ze laten alleen zien wat te weinig waarnemingen met een alpha doen.
| maand | SMB | HML | ||
|---|---|---|---|---|
| 1 | 2 | 1 | 0 | 3,0 |
| 2 | −1 | 0 | 1 | −0,5 |
| 3 | 1 | 2 | 1 | 3,5 |
Zonder intercept zijn dit drie vergelijkingen in de drie ladingen. Uit maand 1 volgt en uit maand 2 volgt . Invullen in maand 3 geeft , dus , en , met residuen nul.
Stap 5, de alpha. Het gemiddelde overrendement is . De gemiddelde factoren zijn , 1 en , zodat het model voorspelt. De alpha is dus precies nul, maar dat bewijst niets, want met evenveel waarnemingen als factoren past elke portefeuille perfect.
De codecel herhaalt de vijf stappen en zet de uitkomsten naast de handberekening.
toy = pd.DataFrame(
    {"ME": [20.0, 20.0, 10.0, 500.0, 300.0, 150.0],
     "BM": [0.3, 0.8, 1.6, 0.4, 0.7, 1.2],
     "R": [0.02, 0.03, 0.05, 0.01, 0.02, 0.03]},
    index=list("ABCDEF"),
)
rf_toy = 0.002

size_break = toy["ME"].median()
bm_low, bm_high = np.percentile(toy["BM"], [30, 70])      # linear interpolation, as in the hand calculation
toy["size"] = np.where(toy["ME"] <= size_break, "S", "B")
toy["bm"] = np.where(toy["BM"] <= bm_low, "L", np.where(toy["BM"] >= bm_high, "H", "M"))


def ff_factors(stocks, rf):
    """SMB, HML and the market excess return from the six value-weighted size/BM portfolios."""
    weighted = stocks["ME"] * stocks["R"]
    cell = [stocks["size"], stocks["bm"]]
    six = (weighted.groupby(cell).sum() / stocks["ME"].groupby(cell).sum()).unstack()
    smb = six.loc["S"].mean() - six.loc["B"].mean()
    hml = six["H"].mean() - six["L"].mean()
    market_excess = weighted.sum() / stocks["ME"].sum() - rf
    return smb, hml, market_excess


smb, hml, mkt_excess_toy = ff_factors(toy, rf_toy)

F_toy = np.array([[2.0, 1.0, 0.0], [-1.0, 0.0, 1.0], [1.0, 2.0, 1.0]])   # maanden x (markt, SMB, HML), %
r_toy = np.array([3.0, -0.5, 3.5])
loadings_toy = np.linalg.solve(F_toy, r_toy)
predicted_mean = loadings_toy @ F_toy.mean(axis=0)

pd.DataFrame(
    {"met de hand": [0.55, 1.00, 1.333, 2.5, 1.5, 1.0, 1.0, 0.5, 2.0, 2.0],
     "code": [bm_low, bm_high, 100 * smb, 100 * hml, 100 * mkt_excess_toy,
              *loadings_toy, r_toy.mean(), predicted_mean]},
    index=["breekpunt B/M 30%", "breekpunt B/M 70%", "SMB (%)", "HML (%)", "overrendement markt (%)",
           "lading markt", "lading SMB", "lading HML", "gemiddeld overrendement (%)", "voorspeld (%)"],
).round(3)De twee kolommen zijn gelijk, en het toy-voorbeeld leert twee dingen. De constructie weegt elke doorsnede even zwaar, zodat aandeel C met 1% van de marktwaarde een derde van de kleine kant van SMB bepaalt. Stap 5 laat daarnaast zien dat met evenveel maanden als factoren elke alpha nul is, zodat een alpha pas iets zegt in een steekproef die veel langer is dan het aantal factoren.
4Theorie
De theorie gaat van de bouw van de factoren naar de vraag wat een goede fit bewijst. De kern is dat een tijdreekstoets met verhandelbare factoren een toets is op een SDF die lineair is in die factoren. Daarna laten twee proposities zien waarom een goede fit weinig bewijst, en ze gaan over twee soorten fit. De eerste gaat over de cross-sectionele met vrije premies, die hoog uitvalt voor bijna elke factor die met de sorteringen meebeweegt. De tweede gaat over de tijdreeks-alpha met vaste premies, die GRS toetst. Op gesorteerde portefeuilles is die alpha klein, of beleggers nu voor de covariantie of voor het kenmerk worden betaald.
4.1De constructie van SMB en HML
SMB en HML zijn zo gebouwd dat elke factor één kenmerk meet en het andere buiten laat. Kleine aandelen hebben gemiddeld een hogere B/M, zodat klein min groot zonder meer deels waarde zou meten. Door binnen elke B/M-groep klein met groot te vergelijken, valt dat verschil weg, en voor HML geldt hetzelfde omgekeerd.
In juni van elk jaar bepalen Fama en French de NYSE-mediaan van de marktwaarde en de NYSE-percentielen 30 en 70 van B/M. Met die breekpunten verdelen ze alle aandelen van NYSE, Amex en Nasdaq over zes portefeuilles. Die worden waardegewogen gehouden van juli tot en met juni . Met S/L voor klein-laag, B/H voor groot-hoog enzovoort zijn de factoren
precies als in stap 2 van het toy-voorbeeld.
Elke keuze in deze constructie heeft een reden. In 1991 bevatte de kleine groep 3616 van de 4797 aandelen maar ongeveer 8% van de marktwaarde Fama & French (1993). Breekpunten uit alle aandelen zouden de grote groep dus vullen met bedrijven die naar NYSE-maatstaven klein zijn. Waardegewichten houden de kleinste aandelen klein, met hun bid-ask-bias en ontbrekende delisting returns uit De CRSP-tape: data als machine. In het toy-voorbeeld was aandeel C maar 1% van de marktwaarde, en toch een derde van de kleine kant van SMB. De vertraging van december tot juli zorgt ten slotte dat de boekwaarde bij de sortering al publiek was.
4.2Fama en French (1992): alles tegelijk in één regressie
Een regressie met alle kenmerken tegelijk kan zeggen welk van twee gecorreleerde kenmerken het werk doet. Volgens Proposition 1 is de Fama-MacBeth-helling van een kenmerk het rendement van een portefeuille die volledig aan dat kenmerk is blootgesteld en aan de andere kenmerken niet. Een significante helling op B/M naast grootte en bèta betekent dus dat een portefeuille zonder blootstelling aan grootte en bèta toch rendement verdient.
Fama en French draaiden van juli 1963 tot december 1990 elke maand een regressie op gemiddeld 2267 aandelen Fama & French (1992). Een aandeel krijgt de bèta van zijn portefeuille in een raster van groottegroepen, met daarbinnen groepen op de bèta van eerdere jaren. Zo varieert bèta ook binnen een groottegroep, terwijl bèta en grootte anders bijna samenvallen, zoals Het CAPM liet zien.
Voor het CAPM was de uitkomst vernietigend. In hun tabel III kreeg bèta alleen een helling die niet van nul te onderscheiden was (), terwijl B/M alleen een -waarde van 5,71 haalde Fama & French (1992). Grootte bleef in elke combinatie significant, en B/M was de sterkste variabele. Schuldgraad en E/P verloren hun kracht zodra grootte en B/M erbij kwamen. De volledige tabel III staat bij de replicatie.
De tabel zegt niet dat bèta onbelangrijk is, want in de tijdreeks verklaart de markt het grootste deel van de variantie van elke gespreide portefeuille. Ze zegt alleen dat bèta de spreiding in gemiddelde rendementen niet verklaart. Ook dat bleef betwist, want Kothari et al. (1995) vonden met bèta’s uit jaarrendementen wel een beloning voor bèta. Black (1993) hield grootte en waarde juist voor waarschijnlijke datamining.
4.3Het driefactormodel als bèta- en als SDF-model
De tijdreekstoets van Fama en French is precies een toets op een SDF die lineair is in de drie factoren. Waarom zou dit waar zijn? Een verhandelbare factor is zelf een overrendement, want een belegger kan hem kopen, en zijn premie is dus zijn gemiddelde rendement. Stel dat een testportefeuille meer oplevert dan de ladingen voorspellen. Dan verhoogt een belegger de Sharpe-ratio door die portefeuille te kopen en de factoren naar verhouding te verkopen. Een alpha van nul betekent dus dat niemand de factoren zo kan verbeteren.
Schrijf , met het overrendement van de markt. Voor elk activum draaien we de tijdreeksregressie
met en . Fama en French schrijven voor de hellingen, maar we houden de notatie van deze reeks aan. Als alle intercepten nul zijn, geven verwachtingen
zodat het verwachte overrendement de som is van de ladingen maal de gemiddelde rendementen van de factoren. De prijs van risico ligt daarmee vast op het gemiddelde rendement van factor . Een cross-sectionele toets schat daarentegen vrij.
Proof 1
De factoren. .
De activa. Vul (3) in: . Hier is , de middelste term is nul volgens de vorige stap, en .
De Sharpe-ratio. Dit is de meetkunde uit het bewijs van Theorem 3, met de markt vervangen door . Vervang door , een inverteerbare transformatie die de maximale Sharpe-ratio niet verandert. De vector heeft gemiddelde en blokdiagonale covariantiematrix , dus .
De SDF in (5) is laag in maanden waarin de combinatie boven haar gemiddelde uitkomt. De gewichten zijn die van de portefeuille met de hoogste Sharpe-ratio, zodat een factor zwaarder weegt naarmate zijn premie hoger is ten opzichte van zijn risico, na correctie voor zijn samenhang met de andere factoren. Het driefactormodel beweert dus dat de tangentportefeuille, de portefeuille met de hoogste Sharpe-ratio, een combinatie is van de markt, SMB en HML. Het CAPM beweerde dat van de markt alleen (Proposition 1). Waarom SMB en HML in de SDF horen, zegt de stelling niet, en het ICAPM van Merton: continue tijd en het ICAPM en de APT van Ross, APT en de fundamentele stelling laten zulke factoren toe zonder ze aan te wijzen.
In een steekproef toetst de GRS-toets uit Het CAPM of alle alpha’s nul zijn, nu met factoren,
met de ML-covariantiematrix van de factoren
(hap.stats.grs_test). De teller weegt de geschatte alpha’s met hun ruis. De noemer groeit
met de Sharpe-ratio van de factoren, omdat een hoge Sharpe-ratio de geschatte alpha’s
onnauwkeuriger maakt, en daardoor wordt de toets milder. Op de steekproef van Fama en French
komt de statistiek voor het driefactormodel uit op 1,43, met een -waarde van 0,086. De
intercepten krimpen dus zo ver dat de toets het model niet meer verwerpt.
4.4Wat een goede fit bewijst
Een cross-sectionele regressie met vrije premies past op de 25 portefeuilles bijna altijd goed, ook met factoren die maar zwak met de ware samenhangen. Die regressie, , schat de premies opnieuw en heeft een eigen intercept. Het driefactormodel voorspelt en . Toch gaf de regressie in Ross, APT en de fundamentele stelling een constante van ruim 1,1% per maand en een negatieve marktpremie, bij een redelijke fit.
De 25 portefeuilles verschillen in gemiddeld rendement vooral langs twee richtingen, grootte en B/M, en ze bewegen ook langs die richtingen samen. Elke factor die een beetje langs die richtingen beweegt, geeft bèta’s met dezelfde rangorde als de ware ladingen. De regressie schaalt die bèta’s dan op tot ze de gemiddelden passen. Een zwakke correlatie wordt zo opgevangen door een grote geschatte premie, en de merkt er niets van.
Elke set factoren met een inverteerbare covariantie met de ware factoren verklaart dus dezelfde verwachte rendementen, alleen met andere premies. Voor de 25 portefeuilles is een exacte factorstructuur bijna vervuld, want in de replicatie verklaren de drie factoren gemiddeld 93% van hun variantie. In het toy-voorbeeld was de structuur zelfs exact.
Lewellen et al. (2010) maakten van deze propositie een kritiek op een hele literatuur. Ze raadden onder meer aan om anders gesorteerde portefeuilles toe te voegen, bijvoorbeeld bedrijfstakken, en de geschatte premies naast de gemiddelden van de factoren te leggen. De tijdreekstoets met GRS doet dat laatste vanzelf, omdat hij de premies vastlegt. Bovendien is een size/BM-portefeuille ongeveer een combinatie van de zes bouwstenen van SMB en HML. Wat de factoren niet verklaren, zit daarom in richtingen die het raster niet opspant, zoals de hoek klein-groei.
4.5Kenmerken of covarianties: Daniel en Titman
Op portefeuilles die op een kenmerk zijn gesorteerd, lijkt een beloond kenmerk op een beloonde covariantie. Stel dat beleggers aandelen met een hoge B/M te laag waarderen, zodat het kenmerk wordt beloond. Zulke aandelen zijn vaak vergelijkbare bedrijven en bewegen daardoor samen, maar voor die meebeweging krijgen beleggers niets. In gesorteerde portefeuilles vallen kenmerk en lading samen, zodat deze wereld eruitziet als die van Fama en French. Alleen aandelen met hetzelfde kenmerk en een verschillende lading kunnen de werelden scheiden.
Laat het gestandaardiseerde kenmerk zijn, bijvoorbeeld de B/M van aandeel in standaarddeviaties boven het gemiddelde. De lading op een factor met gemiddelde nul is , en
met onafhankelijk van en gemiddeld nul. In beide werelden geldt hetzelfde rendementsproces . De parameter is de correlatie tussen kenmerk en lading, in de simulatie 0,7, en is de premie per eenheid. De covarianties zijn dus gelijk en alleen de bron van de premie verschilt, terwijl in beide werelden hetzelfde is.
Proof 3
Door de spreiding vallen de idiosyncratische termen weg, zodat en . De regressiehelling is , en de alpha is . In de factorwereld is en , dus de alpha is nul. In de kenmerkwereld is en , dus de alpha is . Voor (a) is , met verwachting nul en voor een gespreide portefeuille verwaarloosbare variantie. Voor (b) vullen we en in.
De alpha is dus nul in de factorwereld, en in de kenmerkwereld evenredig met het deel van de lading dat het kenmerk niet voorspelt. Alle op kenmerken gesorteerde portefeuilles vallen onder (a), zodat kleine alpha’s op de 25 sorteringen niet zeggen in welke wereld we leven. Daniel & Titman (1997) bouwden daarom portefeuilles volgens (b). Binnen groepen met dezelfde grootte en B/M sorteerden ze op de geschatte HML-lading, en ze vonden dat de kenmerken de cross-sectie verklaren en niet de meebeweging.
Davis et al. (2000) antwoordden met een steekproef die in 1929 begint. De waardepremie bleek vóór 1963 even sterk als daarna, en het driefactormodel verklaarde die premie beter dan het kenmerk. Het debat was moeilijk te beslechten, omdat de toets zijn kracht haalt uit in (9). Als dicht bij één ligt, is dat deel klein, en de geschatte lading bevat ook nog meetfout. Dat is het errors-in-variables-probleem uit Het CAPM in een nieuwe vorm.
De verwachting uit de intuïtie klopt dus, maar met een voorbehoud. Op gesorteerde portefeuilles krimpen de alpha’s in beide werelden, en alleen een portefeuille die de lading loskoppelt van het kenmerk laat een verschil zien.
5Simulatie: wat een goede fit op 25 sorteringen bewijst
De simulatie stelt één vraag: hoeveel bewijst een goede fit op 25 sorteringen in een steekproef van vijftig jaar? Eerst kijken we of de tijdreekstoets de factorwereld van de kenmerkwereld kan onderscheiden, en daarna hoe hoog de cross-sectionele wordt met factoren die maar zwak met de ware correleren.
5.1Twee werelden met dezelfde covarianties
We bouwen (8) met twee kenmerken, hoe klein een aandeel is en hoe hoog zijn B/M is, en met de kalibratie in de tabel. In de kenmerkwereld hebben de size- en de waardefactor geen premie, en is het verwachte rendement .
| parameter | waarde |
|---|---|
| aantal aandelen | 4000 |
| marktbèta | rond 1, standaarddeviatie 0,2 |
| correlatie tussen kenmerk en lading, | 0,7 |
| markt: volatiliteit en premie per maand | 4,5% en 0,5% |
| size- en waardefactor: volatiliteit per eenheid lading | 2% per maand |
| premie per eenheid lading in de factorwereld, size en waarde | 0,12% en 0,20% per maand |
| idiosyncratische volatiliteit | 15% per maand |
| aandelen zonder boekwaarde (wel in de markt, niet in de sorteringen) | 20% |
De onderzoeker in de simulatie werkt zoals Fama en French, dus hij weegt naar marktwaarde, maakt 25 portefeuilles op kwintielen en bouwt SMB en HML volgens (2). De Daniel-Titman-portefeuille koopt binnen elk vakje de helft met de hoogste geschatte waardelading en verkoopt de andere helft. Die schatting heeft de meetfout van een regressie over zestig maanden.
De eerste cel legt de kalibratie vast en trekt voor elk aandeel twee kenmerken, twee ladingen, een marktbèta en een marktwaarde.
n_stocks, n_months, n_samples = 4000, 600, 500
rho, sd_idio = 0.7, 0.15
lam_m, sd_m = 0.005, 0.045
lam_char = np.array([0.0012, 0.0020])      # premia per unit loading: size, value
sd_char = np.array([0.020, 0.020])         # factor volatility per unit loading

chars = rng.standard_normal((n_stocks, 2))                  # z: smallness and value
loadings = rho * chars + np.sqrt(1 - rho**2) * rng.standard_normal((n_stocks, 2))
beta_m = 1.0 + 0.2 * rng.standard_normal(n_stocks)
caps = np.exp(-chars[:, 0] + 0.5 * rng.standard_normal(n_stocks))
in_sorts = rng.random(n_stocks) > 0.2                        # stocks with book equity
loading_hat = loadings[:, 1] + sd_idio / (sd_char[1] * np.sqrt(60)) * rng.standard_normal(n_stocks)
Uit die aandelen bouwt de volgende cel de portefeuillegewichten . Omdat alle
portefeuilles combinaties van dezelfde aandelen zijn, simuleren we op portefeuilleniveau,
met idiosyncratische covariantiematrix . Een
matrixwortel van die matrix, noise_root, zet onafhankelijke trekkingen om in ruis met
precies die samenhang. De tabel toont de ladingen, kenmerken en verwachte rendementen van
de vier factorportefeuilles.
def vw(mask):
    """Value weights over the sortable stocks in `mask`."""
    w = np.where(mask & in_sorts, caps, 0.0)
    return w / w.sum()


def groups(x, cuts):
    """Group number of x relative to quantiles of the sortable stocks (the NYSE breakpoints)."""
    return np.searchsorted(np.quantile(x[in_sorts], cuts), x)


size_q = groups(chars[:, 0], [0.2, 0.4, 0.6, 0.8])        # quintiles of smallness
value_q = groups(chars[:, 1], [0.2, 0.4, 0.6, 0.8])       # quintiles of value
small = groups(chars[:, 0], [0.5]) == 1                    # smaller than the median
value_3 = groups(chars[:, 1], [0.3, 0.7])                  # 0 = low, 1 = middle, 2 = high B/M
six_w = {(s, v): vw((small == s) & (value_3 == v)) for s in (True, False) for v in range(3)}
smb_w = sum(six_w[(True, v)] - six_w[(False, v)] for v in range(3)) / 3
hml_w = (six_w[(True, 2)] + six_w[(False, 2)] - six_w[(True, 0)] - six_w[(False, 0)]) / 2
cells = [(size_q == i) & (value_q == j) for i in range(5) for j in range(5)]


def dt_long_short(cell):
    """Within a cell, buy the half with the highest estimated value loading and sell the rest."""
    high = cell & (loading_hat > np.median(loading_hat[cell & in_sorts]))
    return vw(high) - vw(cell & ~high)


dt_w = sum(dt_long_short(c) for c in cells) / 25

W = np.vstack([*[vw(c) for c in cells], caps / caps.sum(), smb_w, hml_w, dt_w])   # 29 x n_stocks
exposures = W @ np.column_stack([beta_m, loadings])
# matrix square root of sd_idio^2 W W': the 29 portfolios share stocks, so their noise is correlated
eigval, eigvec = np.linalg.eigh(sd_idio**2 * W @ W.T)
noise_root = eigvec * np.sqrt(np.clip(eigval, 0.0, None))
expected = {"factorwereld": W @ (beta_m * lam_m + loadings @ lam_char),
            "kenmerkwereld": W @ (beta_m * lam_m + chars @ (rho * lam_char))}


def simulate_portfolios(world):
    """T x 29 excess returns: 25 sorts, market, SMB, HML and the Daniel-Titman portfolio."""
    shocks = rng.standard_normal((n_months, 3)) * np.r_[sd_m, sd_char]
    return expected[world] + shocks @ exposures.T + rng.standard_normal((n_months, 29)) @ noise_root.T


pd.DataFrame(
    np.column_stack([exposures[25:], W[25:] @ chars,
                     100 * expected["factorwereld"][25:], 100 * expected["kenmerkwereld"][25:]]),
    index=["markt", "SMB", "HML", "Daniel-Titman"],
    columns=["lading markt", "lading size", "lading waarde", "kenmerk size", "kenmerk waarde",
             "E[R] factorwereld (%)", "E[R] kenmerkwereld (%)"],
).round(3)SMB en HML hebben een grote lading op hun eigen factor en weinig op de andere. De Daniel-Titman-portefeuille heeft een waardelading van 0,71 bij een waardekenmerk van 0,09. Ze is dus niet precies kenmerkneutraal, omdat een hogere geschatte lading samengaat met een iets hoger kenmerk.
Het verwachte rendement van die portefeuille is 0,13% per maand in de factorwereld en 0,01% in de kenmerkwereld. De volgende cel trekt per wereld 500 steekproeven van vijftig jaar en toetst in elke steekproef het CAPM en het driefactormodel.
def ts_regression(Y, F):
    """OLS of each column of Y (T x N) on a constant and F (T x K): alphas, t-statistics and R^2."""
    X = np.column_stack([np.ones(len(F)), F])
    coef = np.linalg.lstsq(X, Y, rcond=None)[0]
    resid = Y - X @ coef
    se = np.sqrt((resid**2).sum(axis=0) / (len(Y) - X.shape[1]) * np.linalg.inv(X.T @ X)[0, 0])
    return coef[0], coef[0] / se, 1 - resid.var(axis=0) / Y.var(axis=0)


test_names, factor_names = [f"P{k}" for k in range(25)], ["Mkt", "SMB", "HML"]
records = []
for world in expected:
    for _ in range(n_samples):
        P = simulate_portfolios(world)
        test = pd.DataFrame(P[:, :25], columns=test_names)
        fac = pd.DataFrame(P[:, 25:28], columns=factor_names)
        ff3, capm = hap.stats.grs_test(test, fac), hap.stats.grs_test(test, fac[["Mkt"]])
        alpha_dt, t_dt, _ = ts_regression(P[:, 28:], P[:, 25:28])
        records.append({"wereld": world, "GRS FF3": ff3["grs"], "p FF3": ff3["pvalue"],
                        "gem. |alpha| FF3": ff3["mean_abs_alpha"], "p CAPM": capm["pvalue"],
                        "gem. |alpha| CAPM": capm["mean_abs_alpha"],
                        "alpha DT": alpha_dt[0], "t DT": t_dt[0]})
sim_a = pd.DataFrame(records)

sim_a.groupby("wereld", sort=False).agg(
    **{"gem. |alpha| CAPM (% p.m.)": ("gem. |alpha| CAPM", lambda x: 100 * x.mean()),
       "verwerping CAPM (5%)": ("p CAPM", lambda x: (x < 0.05).mean()),
       "gem. |alpha| FF3 (% p.m.)": ("gem. |alpha| FF3", lambda x: 100 * x.mean()),
       "verwerping FF3 (5%)": ("p FF3", lambda x: (x < 0.05).mean()),
       "alpha DT (% p.m.)": ("alpha DT", lambda x: 100 * x.mean()),
       "gem. t DT": ("t DT", "mean"),
       "fractie t DT < -1.96": ("t DT", lambda x: (x < -1.96).mean())}
).round(3)In beide werelden laat het CAPM een gemiddelde absolute alpha van ongeveer 0,19% per maand over, en GRS verwerpt het in 38% van de steekproeven. Een prijsfout van ruim 2% per jaar blijft dus in bijna twee op de drie steekproeven onder de drempel. Dat is de standaardfout van 2% in de cross-sectie, want een gemiddelde over vijftig jaar is te onnauwkeurig om zo’n fout zeker te zien.
Het driefactormodel laat in beide werelden 0,05% per maand over, en GRS verwerpt het iets vaker dan de nominale 5%, omdat SMB en HML uit eindig veel aandelen bestaan. De toets doet dus wat hij moet doen, en juist daarom scheidt hij de werelden niet. In de figuur liggen links de GRS-statistieken van beide werelden over elkaar, terwijl rechts de -waarden van de Daniel-Titman-alpha ver uit elkaar liggen.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
bins = np.linspace(0, 3, 40)
for world, color in zip(expected, hap.plotting.COLORS):
    subset = sim_a[sim_a["wereld"] == world]
    axes[0].hist(subset["GRS FF3"], bins=bins, alpha=0.55, color=color, label=world)
    axes[1].hist(subset["t DT"], bins=np.linspace(-8, 4, 40), alpha=0.55, color=color, label=world)
axes[0].axvline(stats.f.ppf(0.95, 25, n_months - 28), color="black", lw=1, ls="--",
                label="5%-kritieke waarde")
axes[0].set_title("(a) GRS-toets van FF3 op 25 sorteringen")
axes[0].set_xlabel("GRS-statistiek (500 steekproeven van 50 jaar)")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].legend()
axes[1].axvline(-1.96, color="black", lw=1, ls="--")
axes[1].set_title("(b) FF3-alpha van de Daniel-Titman-portefeuille")
axes[1].set_xlabel("t-waarde van de alpha")
axes[1].set_ylabel("Aantal steekproeven")
axes[1].legend()
fig.tight_layout()
plt.show()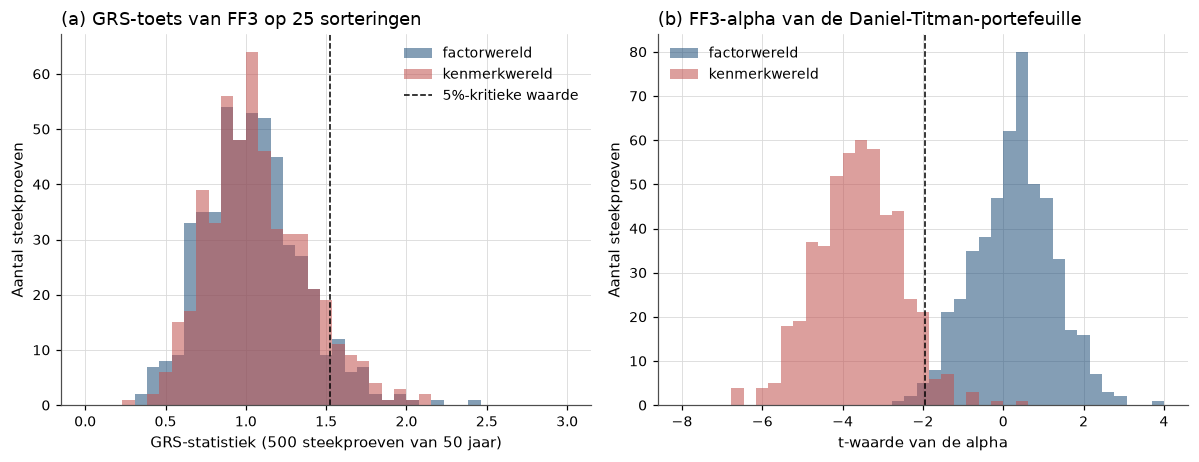
Figure 1:Links: de GRS-statistiek van het driefactormodel op 25 op kenmerken gesorteerde portefeuilles heeft in beide werelden vrijwel dezelfde verdeling. Rechts: de Daniel-Titman-portefeuille, die binnen de vakjes op geschatte lading sorteert, heeft in de factorwereld een alpha rond nul en in de kenmerkwereld een duidelijk negatieve, zoals Proposition 2 voorspelt.
De Daniel-Titman-portefeuille scheidt de werelden dus wel. De alpha is in de factorwereld gemiddeld nul en in de kenmerkwereld per maand, significant negatief in 95% van de steekproeven. (9) voorspelt , zoals oefening 2 narekent. Die kracht komt uit de opzet, want de ladingen spreiden sterk binnen elk vakje en veranderen niet in de tijd. In echte data is dat anders, en daarover ging het debat tussen Daniel en Titman en Davis, Fama en French.
5.2Willekeurige factoren en de cross-sectionele 
Het tweede deel toetst Proposition 1 in een steekproef uit de factorwereld. Volgens die propositie verklaren zwak gecorreleerde factoren dezelfde verwachte rendementen als de ware, alleen met een andere premie. We vervangen SMB en HML daarom door twee nepfactoren, elk een willekeurige combinatie van SMB en HML met een correlatie tussen 0,05 en 0,6, plus onafhankelijke ruis. Voor 1000 nepmodellen, steeds met de markt erbij, schatten we de cross-sectionele en de GRS-toets, die de premies vastlegt op de gemiddelden van de factoren.
sample_b = simulate_portfolios("factorwereld")
test_b = pd.DataFrame(sample_b[:, :25], columns=test_names)


def cross_sectional_r2(factors):
    """Full-sample betas, then OLS of mean returns on [1, betas]: R^2 and premia."""
    X = np.column_stack([np.ones(len(factors)), factors])
    betas = np.linalg.lstsq(X, test_b.to_numpy(), rcond=None)[0][1:].T
    Z = np.column_stack([np.ones(25), betas])
    means = test_b.mean().to_numpy()
    coef = np.linalg.lstsq(Z, means, rcond=None)[0]
    return 1 - (means - Z @ coef).var() / means.var(), coef[1:]


true_factors = sample_b[:, 25:28]
r2_true, premia_true = cross_sectional_r2(true_factors)
standardised = (sample_b[:, 26:28] - sample_b[:, 26:28].mean(axis=0)) / sample_b[:, 26:28].std(axis=0)

fakes = []
for _ in range(1000):
    c = rng.uniform(0.05, 0.6)
    base = standardised @ rng.standard_normal((2, 2)).T
    base /= base.std(axis=0)
    fake = 0.02 * (c * base + np.sqrt(1 - c**2) * rng.standard_normal((n_months, 2)))
    factors_fake = np.column_stack([true_factors[:, 0], fake])
    r2, premia = cross_sectional_r2(factors_fake)
    grs = hap.stats.grs_test(test_b, pd.DataFrame(factors_fake, columns=["Mkt", "nep1", "nep2"]))
    fakes.append({"correlatie": c, "R2": r2, "p GRS": grs["pvalue"],
                  "premie / gemiddelde": np.median(np.abs(premia[1:] / fake.mean(axis=0)))})
fakes = pd.DataFrame(fakes)

grs_true = hap.stats.grs_test(test_b, pd.DataFrame(true_factors, columns=factor_names))
pd.DataFrame(
    {"ware factoren": [r2_true, np.nan, np.nan, grs_true["pvalue"], float(grs_true["pvalue"] < 0.05)],
     "nepfactoren (mediaan)": [fakes["R2"].median(), (fakes["R2"] > 0.8).mean(),
                               fakes["premie / gemiddelde"].median(), fakes["p GRS"].median(),
                               (fakes["p GRS"] < 0.05).mean()]},
    index=["cross-sectionele R2", "fractie R2 > 0,8", "|premie| / |gemiddelde factor|", "p-waarde GRS",
           "fractie verworpen door GRS (5%)"],
).round(4)De nepfactoren doen in de bijna niet onder voor de ware. Met de ware factoren is de cross-sectionele 0,86 en verwerpt GRS het model niet (). De nepfactoren halen een mediane van 0,83.
Het verschil zit in de premies. De geschatte premies van de nepfactoren zijn in de mediaan ongeveer zestien keer hun gemiddelde rendement, en GRS verwerpt 98% van de nepmodellen. In de figuur gaat het om de afstand tussen de lijn van de ware factoren en de massa van de nepmodellen.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
axes[0].hist(fakes["R2"], bins=40, color=hap.plotting.COLORS[7], alpha=0.8, label="nepfactoren")
axes[0].axvline(r2_true, color=hap.plotting.COLORS[1], lw=1.8, label="ware factoren")
axes[0].set_title("(a) Cross-sectionele $R^2$ van 1000 nepmodellen")
axes[0].set_xlabel("$R^2$ van gemiddelde rendementen op bèta's")
axes[0].set_ylabel("Aantal modellen")
axes[0].legend(loc="upper left")
axes[1].scatter(fakes["correlatie"], fakes["R2"], s=7, alpha=0.5, color=hap.plotting.COLORS[0])
axes[1].axhline(r2_true, color=hap.plotting.COLORS[1], lw=1.4, label="ware factoren")
axes[1].set_title("(b) $R^2$ tegen de correlatie met SMB en HML")
axes[1].set_xlabel("Correlatie van de nepfactor met een combinatie van SMB en HML")
axes[1].set_ylabel("Cross-sectionele $R^2$")
axes[1].legend(loc="lower right")
fig.tight_layout()
plt.show()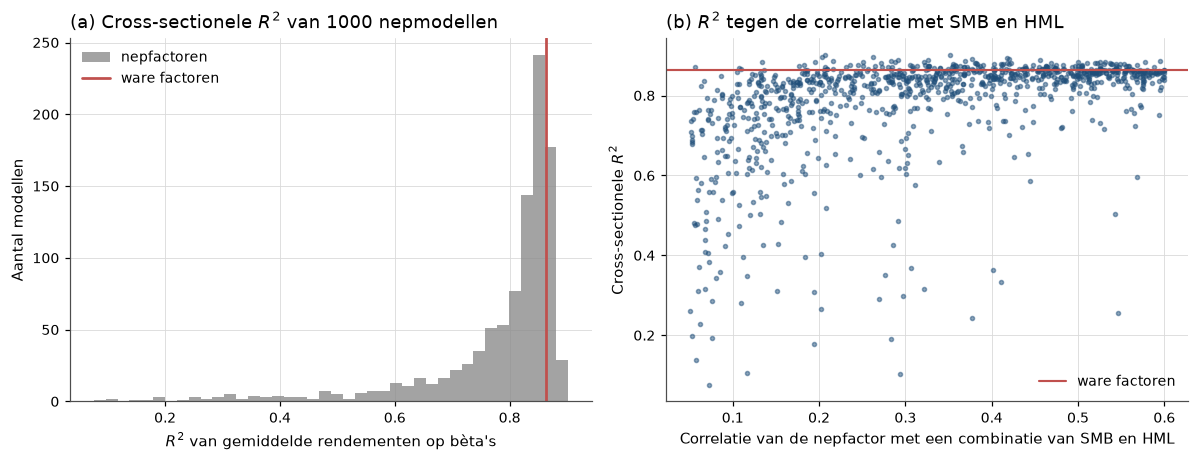
Figure 2:Links: factoren die grotendeels ruis zijn, geven op 25 portefeuilles met een sterke factorstructuur een cross-sectionele die vaak weinig onderdoet voor die van de ware factoren. Rechts: de stijgt met de correlatie, maar is ook bij lage correlatie vaak hoog. De GRS-toets, die de premies vastlegt, verwerpt vrijwel alle nepmodellen.
De meet dus hoe goed de bèta’s de richtingen van de 25 portefeuilles volgen, en niet of de premies kloppen. Roll gaf dezelfde les in één dimensie, want elke efficiënte index levert een perfecte lijn tussen bèta en gemiddeld rendement op. Hier geldt die les in meer dimensies.
6Replicatie op echte data
De eerste cel schat het CAPM en het driefactormodel op de 25 portefeuilles over drie periodes, met GRS en met de alpha’s van de twee groeihoeken.
ff = hap_data.french("F-F_Research_Data_Factors")
rf, factors = ff["RF"], ff[["Mkt-RF", "SMB", "HML"]]
ff25 = hap_data.french("25_Portfolios_5x5").sub(rf, axis=0).loc["1963-07":].dropna()

size_labels, bm_labels = ["Klein", "2", "3", "4", "Groot"], ["Laag", "2", "3", "4", "Hoog"]
models = {"CAPM": ["Mkt-RF"], "FF3": ["Mkt-RF", "SMB", "HML"]}
periods = {"1963-07 t/m 1991-12 (FF 1993)": ("1963-07", "1991-12"),
           "1963-07 t/m 2026-07": ("1963-07", "2026-07"),
           "1993-01 t/m 2026-07 (na publicatie)": ("1993-01", "2026-07")}


def model_summary(start, end, model):
    """Time-series fit of the 25 portfolios on one model: alphas, t-statistics, R^2 and GRS."""
    Y, F = ff25.loc[start:end], factors.loc[start:end, models[model]]
    alpha, t, r2 = ts_regression(Y.to_numpy(), F.to_numpy())
    grs = hap.stats.grs_test(Y, F)
    return alpha, t, r2, grs


rows = {}
for label, (start, end) in periods.items():
    for model in models:
        alpha, t, r2, grs = model_summary(start, end, model)
        rows[(label, model)] = {
            "maanden": len(ff25.loc[start:end]), "gem. |alpha| (% p.m.)": 100 * np.abs(alpha).mean(),
            "gem. R2": r2.mean(), "GRS": grs["grs"], "p GRS": grs["pvalue"],
            "alpha klein-groei": 100 * alpha[0], "t klein-groei": t[0],
            "alpha groot-groei": 100 * alpha[20], "t groot-groei": t[20]}
pd.DataFrame(rows).T.round(3)Op de steekproef van Fama en French doet het driefactormodel wat het belooft. De gemiddelde absolute alpha daalt van 0,26% per maand bij het CAPM naar 0,09%, en GRS verwerpt het model op de 25 aandelenportefeuilles niet op het niveau van 5%.
Over de hele periode tot 2026 blijft de gemiddelde alpha klein, maar nu verwerpt GRS het model wel. Klein-groei heeft een alpha van per maand, en omdat de standaardfout krimpt met de wortel van de steekproefomvang, is de -waarde nu . Een fout die in 1993 net zichtbaar was, is nu onmiskenbaar, en na publicatie doet klein-groei het slechter dan ooit.
Daarna leggen we de alpha’s uit de steekproef van Fama en French naast tabel 9a. De gepubliceerde waarden hebben we uit een scan van die tabel overgenomen.
published = {
    "CAPM gepubliceerd": [[-0.22, 0.15, 0.30, 0.42, 0.54], [-0.18, 0.17, 0.36, 0.39, 0.53],
                          [-0.16, 0.15, 0.23, 0.39, 0.50], [-0.05, -0.14, 0.12, 0.35, 0.57],
                          [-0.04, -0.07, -0.07, 0.20, 0.21]],
    "FF3 gepubliceerd": [[-0.34, -0.12, -0.05, 0.01, 0.00], [-0.11, -0.01, 0.08, 0.03, 0.02],
                         [-0.11, 0.04, -0.04, 0.05, 0.05], [0.09, -0.22, -0.08, 0.03, 0.13],
                         [0.21, -0.05, -0.13, -0.05, -0.16]],
}
ff_sample = {model: model_summary("1963-07", "1991-12", model) for model in models}


def grid(values):
    """Put 25 values in a 5x5 table: size in the rows, B/M in the columns."""
    return pd.DataFrame(np.asarray(values).reshape(5, 5), index=size_labels, columns=bm_labels)


table_9a = {
    "CAPM alpha (% p.m.)": grid(100 * ff_sample["CAPM"][0]),
    "CAPM gepubliceerd": grid(published["CAPM gepubliceerd"]),
    "FF3 alpha (% p.m.)": grid(100 * ff_sample["FF3"][0]),
    "FF3 gepubliceerd": grid(published["FF3 gepubliceerd"]),
    "FF3 t(alpha)": grid(ff_sample["FF3"][1]),
    "FF3 R2": grid(ff_sample["FF3"][2]),
}
diff_capm = (table_9a["CAPM alpha (% p.m.)"] - table_9a["CAPM gepubliceerd"]).abs()
diff_ff3 = (table_9a["FF3 alpha (% p.m.)"] - table_9a["FF3 gepubliceerd"]).abs()
print(f"gemiddeld |verschil| met tabel 9a: CAPM {diff_capm.to_numpy().mean():.3f}, "
      f"FF3 {diff_ff3.to_numpy().mean():.3f} procentpunt per maand; "
      f"maximaal {max(diff_capm.to_numpy().max(), diff_ff3.to_numpy().max()):.3f}")
pd.concat(table_9a, names=["grootheid", "size"]).round(2)
gemiddeld |verschil| met tabel 9a: CAPM 0.033, FF3 0.045 procentpunt per maand; maximaal 0.130
De uitvoer zet per portefeuille onze CAPM- en FF3-alpha’s naast die van tabel 9a, gevolgd door de -waarden en de van het driefactormodel. De tabel hieronder vat samen wat Fama en French in hun tekst en in tabel 9c noemen. Hun GRS-toets gebruikt ook zeven obligatieportefeuilles, zodat die getallen niet precies vergelijkbaar zijn.
| grootheid, 1963–1991 | origineel | hier |
|---|---|---|
| FF3-alpha klein-groei, % per maand () | −0,34 (−3,16) | −0,37 (−3,43) |
| FF3-alpha groot-groei, % per maand () | 0,21 (3,27) | 0,19 (2,86) |
| in de kleinste groottegroep | 0,94 tot 0,97 | 0,94 tot 0,97 |
| laagste (groot-hoog) | 0,83 | 0,84 |
| GRS driefactormodel | 1,56 (kansniveau 0,961) | 1,43 () |
| GRS alleen de markt | 1,91 (kansniveau 0,996) | 1,99 () |
De replicatie is geslaagd, want de alpha’s wijken gemiddeld 0,033 (CAPM) en 0,045 (FF3) procentpunt per maand af, binnen de verwachte 0,05, en de hoeken hebben hetzelfde teken. Ook de rangorde is bewaard. Bij het CAPM stijgen de alpha’s in bijna elke groottegroep met B/M, en bij het driefactormodel zitten de grootste fouten in de groeikolom.
Tabel III vraagt een andere toets. In plaats van één tijdreeksregressie per portefeuille draait de methode van Fama en MacBeth elke maand een cross-sectionele regressie van de rendementen op de kenmerken. We gebruiken de 100 portefeuilles, waarvan French elke maand de gemiddelde marktwaarde en B/M publiceert. Beide vertragen we een maand, zodat elke helling alleen informatie gebruikt die aan het begin van de maand bekend was.
p100 = hap_data.french("100_Portfolios_10x10").sub(rf, axis=0).loc["1963-07":]
avg_me = hap_data.french("100_Portfolios_10x10", table=5)
avg_bm = hap_data.french("100_Portfolios_10x10", table=6, percent=False)
log_me = np.log(avg_me.where(avg_me > 0)).shift(1)
log_bm = np.log(avg_bm.where(avg_bm > 0)).shift(1)
specs = [["bèta"], ["log ME"], ["log B/M"], ["bèta", "log ME"], ["log ME", "log B/M"],
         ["bèta", "log ME", "log B/M"]]


def fama_macbeth_fast(returns, chars_fm):
    """Fama-MacBeth without lags (as hap.stats.fama_macbeth), one least-squares regression per month."""
    # TODO: naar hap.stats (hap.stats.fama_macbeth kost hier ruim 5 s per specificatie)
    names, Y = list(chars_fm), returns.to_numpy()

    def as_panel(c):
        """Characteristic as a T x N array; a single row (the full-period beta) is repeated every month."""
        if len(c) == 1:
            return np.broadcast_to(c.reindex(columns=returns.columns).to_numpy(), Y.shape)
        return c.reindex(index=returns.index, columns=returns.columns).to_numpy()

    panels = [as_panel(c) for c in chars_fm.values()]
    gammas = []
    for t in range(len(Y)):
        X = np.column_stack([np.ones(Y.shape[1])] + [panel[t] for panel in panels])
        ok = np.isfinite(Y[t]) & np.isfinite(X).all(axis=1)
        if ok.sum() > len(names):
            gammas.append(np.linalg.lstsq(X[ok], Y[t, ok], rcond=None)[0])
    gammas = np.array(gammas)
    estimate = gammas.mean(axis=0)
    tstat = estimate / (gammas.std(axis=0) / np.sqrt(len(gammas)))   # divisor T, as the HAC estimator in hap
    return pd.DataFrame({"estimate": estimate, "tstat": tstat}, index=["const", *names])


def fama_macbeth_table(start, end):
    """Fama-MacBeth on the 100 size/BM portfolios, with full-period betas and lagged characteristics."""
    R = p100.loc[start:end]
    f = factors["Mkt-RF"].loc[R.index]
    chars_fm = {"bèta": (R.apply(lambda col: col.cov(f)) / f.var()).to_frame().T,
                "log ME": log_me.loc[start:end], "log B/M": log_bm.loc[start:end]}
    rows = {}
    for spec in specs:
        out = fama_macbeth_fast(R, {k: chars_fm[k] for k in spec})
        rows[" + ".join(spec)] = {**{(k, "coëf. (%)"): 100 * out.loc[k, "estimate"] for k in spec},
                                  **{(k, "t"): out.loc[k, "tstat"] for k in spec}}
    columns = [(k, s) for k in ["bèta", "log ME", "log B/M"] for s in ["coëf. (%)", "t"]]
    return pd.DataFrame(rows).T.reindex(columns=pd.MultiIndex.from_tuples(columns))


pd.concat({"1963-07 t/m 1990-12": fama_macbeth_table("1963-07", "1990-12"),
"1963-07 t/m 2026-07": fama_macbeth_table("1963-07", "2026-07")}).round(2)De uitvoer geeft over 1963–1990 en over de hele periode tot 2026 voor zes combinaties van regressoren de gemiddelde maandelijkse helling en de -waarde. De tabel hieronder zet de hellingen over 1963–1990 naast tabel III Fama & French (1992), in procenten per maand met -waarden tussen haakjes. De regressie met alle drie de regressoren staat niet in tabel III, maar het oordeel over bèta steunt erop.
| regressoren | helling op | origineel | hier |
|---|---|---|---|
| alleen bèta | bèta | 0,15 (0,46) | −0,37 (−0,80) |
| alleen log ME | log ME | −0,15 (−2,58) | −0,07 (−1,43) |
| alleen log B/M | log B/M | 0,50 (5,71) | 0,26 (2,86) |
| bèta en log ME | bèta | −0,37 (−1,21) | −1,08 (−2,49) |
| bèta en log ME | log ME | −0,17 (−3,41) | −0,13 (−2,83) |
| log ME en log B/M | log ME | −0,11 (−1,99) | −0,07 (−1,38) |
| log ME en log B/M | log B/M | 0,35 (4,44) | 0,25 (2,76) |
| bèta, log ME en log B/M | bèta | — | −0,11 (−0,30) |
| bèta, log ME en log B/M | log ME | — | −0,07 (−1,73) |
| bèta, log ME en log B/M | log B/M | — | 0,24 (2,74) |
De replicatie van tabel III is gedeeltelijk geslaagd. De tekens van grootte en B/M kloppen, en naast grootte en B/M is bèta insignificant (). B/M blijft significant positief, maar grootte is naast B/M niet meer significant (). De hellingen zijn ongeveer half zo groot, zoals verwacht, omdat honderd portefeuilles de extremen van individuele aandelen wegmiddelen.
Met alleen bèta en grootte wordt bèta significant negatief, maar dat is een gevolg van het ontwerp en geen negatieve beloning. In portefeuilles die op grootte zijn gesorteerd, zijn bèta en grootte sterk gecorreleerd, en juist daarom sorteerden Fama en French op bèta binnen groottegroepen. Tot 2026 blijft het patroon staan, met een zwakkere helling op B/M.
Tot slot volgen we SMB en HML zelf, per decennium en in drie periodes. Een premie van 0,3% per maand met een volatiliteit van 3% heeft over tien jaar een standaardfout van , zodat één decennium vrijwel niets zegt. Bij factorpremies komt de standaardfout van 2% dus terug als een standaardfout per decennium die ongeveer even groot is als de premie zelf.
def premium_row(frame):
    """Mean, standard error and t-statistic of SMB and HML (% per month)."""
    n = len(frame)
    out = {"maanden": n}
    for name in ["SMB", "HML"]:
        s = frame[name]
        out |= {f"{name} gem.": 100 * s.mean(), f"{name} SE": 100 * s.std() / np.sqrt(n),
                f"{name} t": s.mean() / (s.std() / np.sqrt(n))}
    return out


decades = {f"{d}-{min(d + 9, factors.index.year.max())}": premium_row(g)
           for d, g in factors.groupby((factors.index.year // 10) * 10)}
spans = {"1926-07 t/m 1963-06 (vóór FF)": ("1926-07", "1963-06"),
         "1963-07 t/m 1991-12 (FF 1993)": ("1963-07", "1991-12"),
         "1993-01 t/m 2026-07 (na publicatie)": ("1993-01", "2026-07")}
decade_table = pd.DataFrame(decades).T
span_table = pd.DataFrame({k: premium_row(factors.loc[a:b]) for k, (a, b) in spans.items()}).T
pd.concat({"per decennium": decade_table, "per periode": span_table}).round(3)Per decennium laat de tabel vooral ruis zien, want de meeste standaardfouten zijn ongeveer even groot als de gemiddelden. De figuur laat dat zien met foutbalken, die bij de meeste decennia nul bevatten.
Source
fig, ax = plt.subplots(figsize=(10, 4.3))
x = np.arange(len(decade_table))
for offset, name, color in [(-0.2, "SMB", hap.plotting.COLORS[0]), (0.2, "HML", hap.plotting.COLORS[1])]:
    ax.bar(x + offset, decade_table[f"{name} gem."], width=0.4, color=color, alpha=0.8, label=name)
    ax.errorbar(x + offset, decade_table[f"{name} gem."], yerr=2 * decade_table[f"{name} SE"],
                fmt="none", ecolor="black", capsize=2, lw=0.8)
ax.axhline(0, color="black", lw=0.8)
ax.set_xticks(x, decade_table.index, rotation=30)
ax.set_title("SMB en HML per decennium (gemiddelde ± 2 standaardfouten)")
ax.set_xlabel("Decennium")
ax.set_ylabel("Gemiddeld rendement (% per maand)")
ax.legend()
plt.show()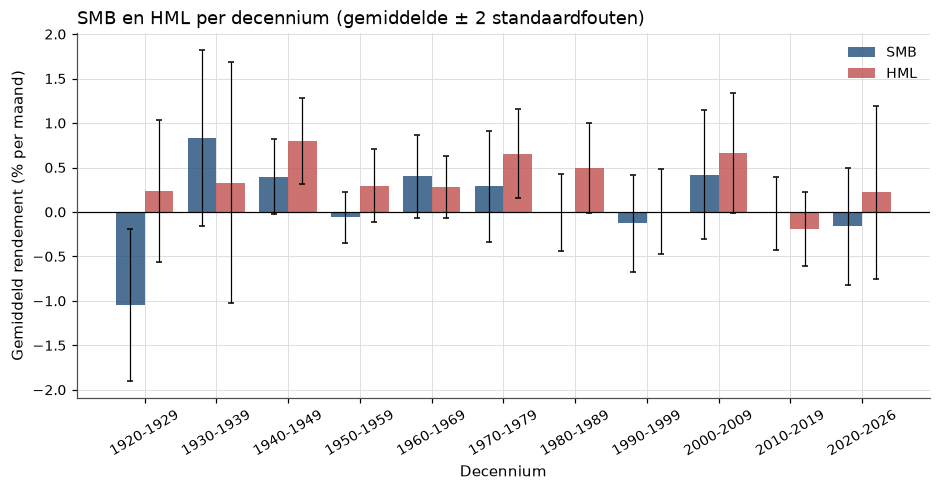
Figure 3:Gemiddelde maandrendementen van SMB en HML per decennium, met twee standaardfouten. HML is in elk decennium tot en met de jaren tachtig positief, ook vóór de steekproef van Fama en French, en in de jaren 2010 negatief. SMB wisselt van teken, van sterk negatief in de onvolledige jaren twintig (vanaf juli 1926) naar positief in de jaren dertig.
Vóór 1963 is HML met een -waarde van 2,17 duidelijk positief. De waardepremie bestond dus al voordat iemand ernaar zocht, zoals Davis et al. (2000) rapporteerden. Na publicatie is SMB met 0,04% per maand () niet van nul te onderscheiden.
Ook dit deel is dus geslaagd, want beide verwachtingen komen uit. Of SMB een verdwenen premie is of een slechte reeks trekkingen, kan geen -toets over ruim dertig jaar zeggen.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Met drie ladingen per aandeel komt het model ver. Op de 25 portefeuilles daalt de gemiddelde absolute prijsfout van een kwart naar minder dan een tiende procent per maand. De verklaarde variantie stijgt van ongeveer 80 naar meer dan 90%. Het model vangt ook de anomalieën rond E/P, kasstroom-koers en de omkering op lange termijn op Fama & French (1996). De alpha na correctie voor size en value werd de standaard bij het beoordelen van fondsen.
Waar het breekt. De hoek klein-groei heeft over 1963–2026 een alpha van per maand (), en GRS verwerpt het model met . Momentum, de anomalie die Fama en French in 1996 al niet konden verklaren, blijft buiten bereik (oefening 3). Ook is de premie van SMB sinds publicatie niet van nul te onderscheiden. Daaronder liggen de twee zwaktes uit de simulatie. Kleine alpha’s op 25 sorteringen passen even goed bij een beloond kenmerk als bij een beloonde covariantie, en een hoge cross-sectionele haalt bijna elke factor die met de sorteringen meebeweegt.
Risico of vergissing? Santa-Clara ziet hier het probleem van de gezamenlijke hypothese terug, dat nooit is beslecht Santa-Clara (2026). In de Chicago-lezing zijn kleine en waardeaandelen marginale bedrijven met veel schuld en zwakke winsten, die slecht presteren wanneer beleggers het geld het hardst nodig hebben Chan & Chen (1991)Fama & French (1995). In de Yale-lezing betalen beleggers die groei extrapoleren te veel voor glamour-aandelen met een sterk verleden van winstgroei. De premie is dan de langzame correctie van die vergissing Lakonishok et al. (1994).
Beide lezingen verklaren hetzelfde feit, de hogere gemiddelde opbrengst van kleine en waardeaandelen met zwakke winsten, maar ze zoeken de oorzaak op een andere plek. Een premie die de covariantie volgt en niet het kenmerk, zou de kampen scheiden, maar Daniel en Titman kwamen tot de tegenovergestelde conclusie van Davis, Fama en French. Een belegger die in 1993 een waardefonds kocht, werd betaald voor risico of profiteerde van de vergissing van anderen, en de data kunnen niet zeggen welk van de twee.
Wat er daarna kwam. Eén regelmaat bleef buiten het model. De voortzetting van rendementen over het afgelopen jaar werd een factor op zichzelf, het onderwerp van Jegadeesh-Titman, Carhart en momentum crashes.
8Oefeningen
Solution to Exercise 1
Met de hand wordt SMB gelijk aan en HML aan . Het marktrendement wordt , een overrendement van . De code geeft hetzelfde.
toy_c = toy.assign(R=[0.02, 0.03, 0.08, 0.01, 0.02, 0.03])
smb_c, hml_c, mkt_c = ff_factors(toy_c, rf_toy)
pd.DataFrame({"basis": [smb, hml, mkt_excess_toy], "C levert 8%": [smb_c, hml_c, mkt_c]},
index=["SMB (%)", "HML (%)", "overrendement markt (%)"]).mul(100).round(3)Aandeel C is 1% van de marktwaarde, maar een derde van de kleine kant van SMB en de helft van de hoge kant van HML. Drie procentpunt extra rendement verhoogt SMB daarom met één en HML met anderhalf procentpunt, terwijl de markt nauwelijks beweegt. De factoren wegen elke doorsnede even zwaar, en daarom zijn NYSE-breekpunten en waardegewichten nodig om te voorkomen dat een paar kleine aandelen de factoren bepalen.
:::{exercise}
:label: ex-fama-french-2

**De alpha van een kenmerkneutrale portefeuille.** Gebruik [](#eq-fama-french-dt) met twee
kenmerken en de simulatie van het eerste deel. Neem aan dat de ladingen van SMB en HML gelijk
zijn aan $\rho$ maal hun kenmerken.

1. Laat zien dat {prf:ref}`prop-fama-french-karakteristiek` met twee factoren en
   factorportefeuilles $\mathbf{H}$ de vorm
   $\alpha_w^{\text{kenmerk}} = -\boldsymbol{\lambda}'\left(\boldsymbol{\beta}_w - \rho\,\mathbf{z}_w\right)$
   krijgt.
2. Bereken met `exposures`, `W` en `chars` de voorspelde alpha van de
   Daniel-Titman-portefeuille en vergelijk die met de simulatie.
3. Hoe groot moet $\beta_w - \rho z_w$ zijn voor een verwachte $t$-waarde van $-2$ na
   vijftig jaar?
Solution to ex-fama-french-2
(1) Door de spreiding is en , met de -matrix van ladingen van SMB en HML. De rijen van en van hieronder zijn de twee factorportefeuilles, de kolommen de twee factoren en de twee kenmerken. De hellingen zijn en de alpha is . In de kenmerkwereld is en met . Daaruit volgt , en de alpha is . In de factorwereld is en , dus daar is de alpha nul.
(2) en (3) De cel rekent beide voorspellingen uit, en ook de lading die nodig is voor .
dt_loading, dt_char = exposures[28, 1:], W[28] @ chars
H_loadings, H_chars = exposures[26:28, 1:], W[26:28] @ chars
predicted = {
    "voorspeld, ideale factoren": -lam_char @ (dt_loading - rho * dt_char),
    "voorspeld, werkelijke SMB en HML": (expected["kenmerkwereld"][28]
                                         - dt_loading @ np.linalg.solve(H_loadings,
                                                                        expected["kenmerkwereld"][26:28])),
    "gesimuleerd (gemiddelde)": sim_a.loc[sim_a["wereld"] == "kenmerkwereld", "alpha DT"].mean(),
}
resid_sd = np.sqrt(noise_root[28] @ noise_root[28])
needed = 2 * resid_sd / np.sqrt(n_months) / lam_char[1]
print(f"residuele volatiliteit DT-portefeuille: {100 * resid_sd:.3f}% per maand")
print(f"benodigde beta_w - rho z_w (waarde) voor t = -2: {needed:.3f}; hier: {(dt_loading - rho * dt_char)[1]:.3f}")
(100 * pd.Series(predicted)).round(4)
residuele volatiliteit DT-portefeuille: 0.640% per maand
benodigde beta_w - rho z_w (waarde) voor t = -2: 0.261; hier: 0.647
voorspeld, ideale factoren         -0.1216
voorspeld, werkelijke SMB en HML   -0.1176
gesimuleerd (gemiddelde)           -0.1114
dtype: float64
De ideale formule geeft , de formule met de werkelijke ladingen ligt daar dicht bij, en de simulatie geeft . Het kleine verschil komt doordat SMB en HML uit eindig veel aandelen bestaan. Voor moet het deel van de lading dat het kenmerk niet verklaart minstens 0,26 zijn, tegen 0,65 in de simulatie. In echte data is zo’n spreiding schaars, en daarom kon één tabel het debat niet beslissen.
:::{exercise}
:label: ex-fama-french-3

**Wat Fama en French in 1996 niet konden verklaren.** Gebruik de zes portefeuilles op
grootte en rendement over $t-12$ tot $t-2$ (`"6_Portfolios_ME_Prior_12_2"`). Winnaars zijn
de aandelen met het hoogste rendement over die periode.

1. Bouw winnaars min verliezers als
   $\tfrac12(\text{klein-hoog} + \text{groot-hoog}) - \tfrac12(\text{klein-laag} + \text{groot-laag})$.
2. Schat de CAPM- en de driefactoralpha en de ladingen over 1963-07 t/m 1993-12 en over
   1963-07 t/m 2026-07.
3. Waarom maakt de HML-lading de driefactoralpha groter in plaats van kleiner?
Solution to ex-fama-french-3
De cel bouwt winnaars min verliezers en schat beide modellen in beide periodes.
mom = hap_data.french("6_Portfolios_ME_Prior_12_2")
wml = 0.5 * (mom["SMALL HiPRIOR"] + mom["BIG HiPRIOR"]) - 0.5 * (mom["SMALL LoPRIOR"] + mom["BIG LoPRIOR"])


def momentum_row(start, end, cols):
    """Mean, alpha, t-statistic, R^2 and loadings of winners minus losers on one model."""
    y, F = wml.loc[start:end], factors.loc[start:end, cols]
    X = np.column_stack([np.ones(len(F)), F.to_numpy()])
    coef = np.linalg.lstsq(X, y.to_numpy(), rcond=None)[0]
    alpha, t, r2 = ts_regression(y.to_numpy()[:, None], F.to_numpy())
    return {"gem. (% p.m.)": 100 * y.mean(), "alpha (% p.m.)": 100 * alpha[0], "t(alpha)": t[0], "R2": r2[0],
            **{f"lading {c}": b for c, b in zip(cols, coef[1:])}}


pd.DataFrame({(label, m): momentum_row(a, b, cols)
              for label, (a, b) in {"1963-07 t/m 1993-12": ("1963-07", "1993-12"),
                                    "1963-07 t/m 2026-07": ("1963-07", "2026-07")}.items()
for m, cols in models.items()}).T.round(3)Winnaars min verliezers verdient over 1963–1993 0,85% per maand, en de driefactoralpha is met 1,00% () groter dan het ruwe gemiddelde. Winnaars zijn aandelen waarvan de koers steeg, zodat hun B/M daalde en hun HML-lading negatief is (). Het model voorspelt daardoor een rendement onder nul, en elk positief rendement wordt alpha. Een model dat op waarde is gebouwd, kan een strategie die tegen waarde ingaat dus niet verklaren.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Fama, E. F., & French, K. R. (1992). The Cross-Section of Expected Stock Returns. The Journal of Finance, 47(2), 427–465. 10.2307/2329112
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Fama, E. F., & French, K. R. (1993). Common Risk Factors in the Returns on Stocks and Bonds. Journal of Financial Economics, 33(1), 3–56. 10.1016/0304-405X(93)90023-5
- Kothari, S. P., Shanken, J., & Sloan, R. G. (1995). Another Look at the Cross-Section of Expected Stock Returns. The Journal of Finance, 50(1), 185–224. 10.1111/j.1540-6261.1995.tb05171.x
- Black, F. (1993). Beta and Return. The Journal of Portfolio Management, 20(1), 8–18. 10.3905/jpm.1993.409462
- Lewellen, J., Nagel, S., & Shanken, J. (2010). A Skeptical Appraisal of Asset Pricing Tests. Journal of Financial Economics, 96(2), 175–194. 10.1016/j.jfineco.2009.09.001
- Daniel, K., & Titman, S. (1997). Evidence on the Characteristics of Cross Sectional Variation in Stock Returns. The Journal of Finance, 52(1), 1–33. 10.1111/j.1540-6261.1997.tb03806.x
- Davis, J. L., Fama, E. F., & French, K. R. (2000). Characteristics, Covariances, and Average Returns: 1929 to 1997. The Journal of Finance, 55(1), 389–406. 10.1111/0022-1082.00209
- Fama, E. F., & French, K. R. (1996). Multifactor Explanations of Asset Pricing Anomalies. The Journal of Finance, 51(1), 55–84. 10.1111/j.1540-6261.1996.tb05202.x
- Chan, K. C., & Chen, N.-F. (1991). Structural and Return Characteristics of Small and Large Firms. The Journal of Finance, 46(4), 1467–1484. 10.1111/j.1540-6261.1991.tb04626.x
- Fama, E. F., & French, K. R. (1995). Size and Book-to-Market Factors in Earnings and Returns. The Journal of Finance, 50(1), 131–155. 10.1111/j.1540-6261.1995.tb05169.x
- Lakonishok, J., Shleifer, A., & Vishny, R. W. (1994). Contrarian Investment, Extrapolation, and Risk. The Journal of Finance, 49(5), 1541–1578. 10.1111/j.1540-6261.1994.tb04772.x
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD