

De industrie als financier: indexfondsen, DFA, AQR
1Overzicht
Verliest actief beheer omdat niemand vaardig is? Nee, want dat de gemiddelde actieve dollar na kosten achterblijft, volgt al uit een optelsom. De vaardigheid die wel bestaat, komt in evenwicht bij de beheerder terecht en niet bij de belegger. Een deel van dat antwoord is bewezen en een deel gemeten, want de rekenkunde is een stelling, en dat factoren en kosten de persistentie van fondsrendementen verklaren, is een waarneming van Carhart. Of er daarnaast een restje vaardigheid overblijft, is een open vraag, want de data laten meer dan één verklaring toe. In dit college
laten we met drie beleggers en twee aandelen zien dat de actieve beleggers samen vóór kosten precies de markt halen;
bewijzen we die rekenkunde van Sharpe en leiden we het evenwicht van Berk en Green af, waarin een vaardige beheerder groeit tot de belegger niets extra’s meer overhoudt;
bespreken we hoe de standaardfout van alpha, de bootstrap van Fama en French en de false discovery rate vaardigheid van geluk proberen te scheiden;
simuleren we 2000 fondsen waarvan we de waarheid kennen, om te zien hoeveel vaardige fondsen die methoden terugvinden;
repliceren we op 50 Amerikaanse fondsen de gemiddelde alpha, de bootstrap van Fama en French en de persistentie van Carhart.
Jensen vond in 1968 dat beleggingsfondsen na kosten gemiddeld 1,1% per jaar achterbleven bij de markt Jensen (1968). Sharpe liet in 1991 in drie pagina’s zien waarom dat vóór kosten niet anders kan Sharpe (1991). Intussen bouwden dezelfde academische kringen de bijbehorende industrie. Wells Fargo begon in 1971 het eerste indexfonds voor institutionele beleggers en Vanguard in 1976 het eerste voor particulieren. Oud-studenten van Fama richtten Dimensional Fund Advisors (1981) en AQR (1998) op, die de factorpremies uit Fama-French 1992/1993 en Jegadeesh-Titman, Carhart en momentum crashes als product verkochten. Santa-Clara noemt het de eigenaardige sociologie van het vak dat juist de onderzoekers die aantoonden dat actief beheer faalt, zelf actieve beheerders oprichtten Santa-Clara (2026). Toch hadden ze in beide rollen gelijk. Berk en Green gaven Berk & Green (2004) die schijnbare tegenspraak een model, en Fama en French Fama & French (2010) en Barras, Scaillet en Wermers Barras et al. (2010) leverden de statistiek waarmee het college eindigt.
2Intuïtie: waarom zou dit waar zijn?
Elk aandeel is van iemand. Tellen we de portefeuilles van alle beleggers op, dan komt er precies de markt uit. Splitsen we de beleggers in twee groepen, zij die de markt kopen en niets doen en zij die iets anders doen, dan haalt de eerste groep het marktrendement. De tweede groep bezit samen dus de rest van de markt, en omdat die rest dezelfde samenstelling heeft, haalt ook die groep samen het marktrendement. Voor elke actieve belegger die de markt verslaat, blijft er dus een andere actieve belegger evenveel achter. Trekken we daarna de kosten af, die bij actief beheer hoger zijn, dan verliest de gemiddelde actieve dollar, zonder dat er een model van risico aan te pas komt. Beleggers namen die rekenkunde pas laat ter harte, want pas eind 2019 hielden indexfondsen en index-ETF’s (beursgenoteerde indexfondsen) samen 15% van de Amerikaanse beurswaarde, evenveel als actief beheerde aandelenfondsen Investment Company Institute (2020).
Dat oud-studenten van Fama toch actieve bedrijven oprichtten, is om drie redenen geen tegenspraak.
De rekenkunde gaat over alle actieve dollars, zodat fondsen samen kunnen winnen van particulieren, die volgens Santa-Clara te veel handelen en de verkeerde aandelen houden Santa-Clara (2026)Barber & Odean (2000).
DFA en AQR verkochten vooral goedkope blootstelling aan premies, en voor de rekenkunde maakt het niet uit of zo’n premie een vergoeding voor risico is of een vergissing van anderen.
Vaardigheid kan bestaan zonder dat beleggers er iets van merken.
Het derde punt vraagt om uitleg. Een goede beheerder trekt geld aan, en een groter fonds plaatst grotere orders, die de prijs tegen het fonds in bewegen zoals de Kyle- uit Kyle, Glosten-Milgrom en liquiditeit voorspelt. Het geld blijft stromen tot het rendement voor de belegger niet meer bijzonder is, zodat de beheerder de vergoeding krijgt en de belegger het marktrendement. We verwachten dus dat goede jaren een fonds groter maken zonder dat het daarna beter rendeert. Vaardigheid wordt dan eerder zichtbaar in de omvang van fondsen dan in hun rendementen. Bovendien is de standaardfout van een alpha na twintig jaar nog ruim één procentpunt per jaar, zodat ook duizenden fondsen zonder vaardigheid een staart van sterren opleveren. De vraag is dan niet of één fonds goed is, maar of er meer goede fondsen zijn dan toeval oplevert.
3Toy-voorbeeld: drie beleggers en twee aandelen
We laden eerst de pakketten die in het hele college nodig zijn.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
De markt bestaat uit twee aandelen, A met marktwaarde 60 en B met marktwaarde 40. Over het jaar rendeert A en B . Drie beleggers bezitten samen alles, en de passieve belegger P betaalt minder kosten dan de actieve beleggers X en Y.
| Belegger | in A | in B | vermogen | kosten |
|---|---|---|---|---|
| passief P | 30 | 20 | 50 | |
| actief X | 25 | 5 | 30 | |
| actief Y | 5 | 15 | 20 | |
| markt | 60 | 40 | 100 |
De markt rendeert , en P haalt dat ook, omdat hij A en B in de verhouding 60:40 houdt.
X zette zwaar in op A en haalt .
Y zat vooral in B en haalt .
X en Y bezitten samen 30 in A en 20 in B, weer 60:40, en halen samen .
Na kosten houden X en Y samen over, procentpunt minder dan P met zijn .
De code rekent dezelfde stappen na en zet ze naast de handberekening.
holdings = pd.DataFrame(
    {"A": [30.0, 25.0, 5.0], "B": [20.0, 5.0, 15.0]},
    index=["passief P", "actief X", "actief Y"],
)
stock_ret = pd.Series({"A": 0.10, "B": -0.05})
costs = pd.Series({"passief P": 0.001, "actief X": 0.010, "actief Y": 0.010})

wealth = holdings.sum(axis=1)
gross = holdings @ stock_ret / wealth
net = gross - costs
market = holdings.sum() @ stock_ret / wealth.sum()

active = ["actief X", "actief Y"]
active_gross = wealth[active] @ gross[active] / wealth[active].sum()
active_net = wealth[active] @ net[active] / wealth[active].sum()
cost_gap = net["passief P"] - active_net
assert np.isclose(active_gross, market) and np.isclose(active_net, 0.03)

pd.DataFrame({
    "met de hand (%)": [4.0, 7.5, -1.25, 4.0, 3.0, 0.9],
    "code (%)": 100 * np.array([market, gross["actief X"], gross["actief Y"],
                                active_gross, active_net, cost_gap]),
}, index=["marktrendement", "bruto X", "bruto Y", "X en Y samen, bruto",
"X en Y samen, netto", "P netto min X en Y netto"]).round(4)Hand en code komen op alle zes regels overeen. X versloeg de markt wel, maar Y betaalde daar precies voor, en na kosten verliezen de actieve beleggers samen 0,9 procentpunt op de passieve belegger.
4Theorie
De theorie beantwoordt de vraag uit het Overzicht in drie stappen. Eerst laten we zien dat de gemiddelde actieve dollar vóór kosten precies de markt haalt en na hogere kosten dus achterblijft, als identiteit en zonder model. Daarna volgt het model van Berk en Green, waarin vaardigheid bestaat maar de belegger in evenwicht niets extra’s oplevert. Dat model verschuift de vraag van “bestaat vaardigheid?” naar “hoe meten we die in duizenden fondsen?”. Daarom eindigen we met drie meetinstrumenten: de standaardfout van alpha, de bootstrap en de false discovery rate.
4.1Sharpes rekenkunde
Het gemiddelde rendement van de actieve beleggers is vóór kosten gelijk aan het marktrendement, in elke periode. Er zijn effecten met marktwaarden en rendementen tussen en , zodat het marktrendement is; het subscript staat hier voor de markt. Belegger houdt op voor dollar in effect , met vermogen en bruto rendement .
Sharpe noemt een belegger passief als hij van elk effect hetzelfde deel bezit, dus voor alle met een vaste Sharpe (1991). Elke andere belegger is actief, en de verzamelingen passieve en actieve beleggers heten en . De kosten zijn een fractie van het vermogen, bijvoorbeeld voor P en voor X en Y.
Het bewijs telt de posities op. De passieve beleggers bezitten samen een vast deel van elk effect. De actieve beleggers bezitten dus samen het deel van elk effect, en een evenredig stuk van de markt heeft het rendement van de markt. In het toy-voorbeeld is , want P bezit de helft van A en de helft van B, en dus bezitten X en Y samen ook van elk aandeel de helft.
Proof 1
Tel de posities van de actieve beleggers in effect op en gebruik dat alles gehouden wordt: , met omdat iets bezit. Het gezamenlijke vermogen van de actieve beleggers is dan , en hun gezamenlijke opbrengst in dollars is
Delen door het gezamenlijke vermogen geeft de eerste gelijkheid. Omdat de kosten per belegger een vaste aftrek zijn, is het gewogen gemiddelde na kosten . Een passieve belegger haalt .
De eerste gelijkheid in (1) zegt dat de actieve beleggers samen vóór kosten precies de markt halen, de tweede dat ze na kosten achterblijven zodra hun kosten gemiddeld hoger zijn dan die van passieve beleggers. Het bewijs gebruikt geen verwachtingen, zodat de uitspraak in élke periode geldt. Ze gaat wel over alle actieve dollars, en een echte indexbelegger moet bij indexwijzigingen en emissies handelen. Onder kosten vallen bovendien alle kosten, van vergoedingen en spreads tot de prijsimpact uit Kyle, Glosten-Milgrom en liquiditeit. French telde ze op voor de Amerikaanse beurs French (2008) en kwam over 1980–2006 uit op 0,67% van de marktwaarde per jaar. Omdat de bruto alpha’s samen nul zijn, is dat volgens hem ook wat de gemiddelde belegger per jaar had kunnen winnen door passief te beleggen.
4.2Het model van Berk en Green
Vaardigheid en een nettoalpha van nul gaan samen zodra kapitaal vrij naar een fonds kan stromen en een groter fonds per dollar meer handelskosten maakt. Biedt een fonds na kosten meer verwacht rendement dan de index, dan verplaatsen beleggers hun geld ernaartoe. Die instroom stopt pas wanneer het fonds zo groot is dat het extra rendement op is. In evenwicht voorspelt het verleden daarom niets over het rendement van de belegger, maar veel over de omvang van het fonds.
We volgen Berk & Green (2004), maar noemen hun vaardigheid om verwarring met de geschatte Jensen-alpha te voorkomen. De beheerder haalt op actief beheerd geld een risicogecorrigeerd overrendement vóór kosten , met onafhankelijke ruis en in de orde van per jaar. Niemand kent , ook de beheerder niet. De markt begint met de prior (de verdeling vóór de eerste waarneming) en schrijft en voor de precisies. Met de regel van Bayes is de verwachte vaardigheid na jaar
een gewogen gemiddelde van de prior en de waarnemingen, zodat elk goed jaar verhoogt.
De beheerder belegt actief en in de index, samen . Het actieve deel kost , met en stijgende marginale kosten (, ) die op den duur elk denkbaar rendement overtreffen (), zodat het fonds eindig groot blijft, en hij rekent een vergoeding per beheerde dollar. Het rendement voor de belegger boven de index is dan
Het eerste deel is de vaardigheid, verdund over het hele fonds, en het tweede deel zijn de handelskosten en de vergoeding per dollar. Beleggers leveren kapitaal zolang , en de beheerder maximaliseert zijn vergoeding onder die voorwaarde.
Proof 2
Stap 1: de voorwaarde van de belegger is bindend. De verwachting van (4) is . De doelfunctie stijgt in en de voorwaarde daalt erin, dus in het optimum geldt gelijkheid.
Stap 2: marginale kosten gelijk aan verwachte alpha. De beheerder kiest en , met de Lagrangiaan
waarin de schaduwprijs van de participatievoorwaarde is en die van . De eerste-ordevoorwaarde voor is , en die voor is . Heeft het fonds een indexdeel, dan bindt niet en is (complementariteit), zodat en . Invullen in de bindende voorwaarde geeft , en de oplossing is inwendig zolang . Anders is en , zodat en de vergelijking oplost.
Stap 3: het rendement is niet te voorspellen. De bindende voorwaarde is precies . Dan is en , dus de covariantie is nul.
Stap 4: de omvang stijgt met elk goed jaar. In het inwendige geval geeft de omhullende-stelling . In het randgeval is , en stijgt strikt omdat strikt convex is met . Ten slotte is .
Met getallen wordt het evenwicht tastbaar. Neem een verwachte vaardigheid van per jaar, kwadratische handelskosten met per miljard dollar, zodat de kosten per actieve dollar zijn, en een vergoeding .
Mag de beheerder geen index bijmengen, dan stroomt er geld toe tot , dus tot miljard, en verdient hij 40 miljoen per jaar.
Mag hij het surplus in de index beleggen, dan beheert hij actief tot , dus miljard, en brengen beleggers geld tot , dus miljard. De vergoeding van 45 miljoen is dan precies de waarde die hij toevoegt.
Schat de markt zijn verwachte vaardigheid na een goed jaar op , dan groeit het fonds naar miljard, 78% meer dan de 4,5 miljard hierboven.
Het fonds met indexdeel is groter en deels een closet indexer (een fonds dat voor actief beheer rekent maar grotendeels de index volgt). De code rekent de drie gevallen na.
phi, b, f = 0.03, 0.005, 0.01        # expected skill, cost per $bn, fee

q_all_active = (phi - f) / b
q_active = phi / (2 * b)
q_total = (phi * q_active - b * q_active**2) / f
investor_alpha = (phi * q_active - b * q_active**2 - f * q_total) / q_total
value_added = phi * q_active - b * q_active**2

phi_new = 0.04
q_active_new = phi_new / (2 * b)
q_total_new = (phi_new * q_active_new - b * q_active_new**2) / f

print(f"versie 1: q* = {q_all_active:.2f} mld, vergoeding = {1000 * f * q_all_active:.1f} mln")
print(f"versie 2: q_a = {q_active:.2f} mld, q = {q_total:.2f} mld, "
      f"vergoeding = {1000 * f * q_total:.1f} mln")
print(f"toegevoegde waarde = {1000 * value_added:.1f} mln, nettoalpha belegger = {investor_alpha:.4%}")
print(f"na herwaardering naar phi = 4%: q = {q_total_new:.2f} mld "
      f"(instroom {q_total_new / q_total - 1:.0%})")
assert np.isclose(q_all_active, 4) and np.isclose(q_total, 4.5) and np.isclose(q_total_new, 8)
versie 1: q* = 4.00 mld, vergoeding = 40.0 mln
versie 2: q_a = 3.00 mld, q = 4.50 mld, vergoeding = 45.0 mln
toegevoegde waarde = 45.0 mln, nettoalpha belegger = 0.0000%
na herwaardering naar phi = 4%: q = 8.00 mld (instroom 78%)
De belegger houdt in alle gevallen een nettoalpha van nul over, ondanks een beheerder met een verwachte vaardigheid van drie procent. Het goede jaar brengt instroom en geen beter rendement, en daarmee wordt vaardigheid zichtbaar in de omvang van het fonds, zoals we in de Intuïtie verwachtten.
Voor kwadratische kosten wordt alles expliciet, met en zolang . De omvang is kwadratisch in de verwachte vaardigheid, zodat een beheerder die twee keer zo goed wordt geacht, vier keer zoveel geld beheert. Hogere schaalkosten maken het fonds kleiner, en een hogere vergoeding ook, omdat de belegger dan al bij een kleiner fonds niets extra’s meer overhoudt. De vergoeding in dollars, , hangt echter niet van af, want een duurder fonds krijgt precies zoveel minder geld dat de beheerder evenveel verdient.
4.3Wat het model voorspelt: geen persistentie in rendementen
Als vaardigheid bestaat en langzaam verandert, zou een naïeve lezing verwachten dat de winnaars van vorig jaar ook dit jaar beter zijn. Carhart toetste dat Carhart (1997) op 1892 fondsen over 1962–1993, in een steekproef zonder survivorship bias (vertekening doordat alleen overlevende fondsen in de data zitten). Hij vond dat gemeenschappelijke factoren en kosten de persistentie vrijwel volledig verklaren. Het eerdere “hot hands”-resultaat kwam grotendeels van momentum (relatieve winnaars van het afgelopen jaar blijven een tijd winnen) in de aandelen van de fondsen Jegadeesh & Titman (1993). Alleen de slechtste fondsen bleven significant slecht. Carhart concludeerde dat zijn resultaten het bestaan van vaardige beheerders niet ondersteunen.
Volgens Theorem 1 is die conclusie te snel, omdat het ontbreken van persistentie in rendementen precies is wat het model ook bij vaardige beheerders voorspelt. Berk en Green kalibreerden hun model op kapitaalstromen en overlevingskansen en vonden dat ongeveer 80% van de actieve beheerders genoeg vaardigheid heeft om de eigen vergoeding terug te verdienen Berk & Green (2004). Vaardigheid moet dan in dollars worden gemeten. Berk en Van Binsbergen vermenigvuldigden daarom de bruto alpha ten opzichte van de goedkoopste indexfondsen met het beheerde vermogen Berk & Binsbergen (2015). Volgens de werkversie van dat onderzoek uit 2012 voegde de gemiddelde beheerder op die manier ongeveer 2 miljoen dollar per jaar toe, en die vaardigheid bleef over tien jaar bestaan Berk & Binsbergen (2012).
4.4Alpha meten en de standaardfout
Een fonds moet niet de markt verslaan, maar een mechanische portefeuille met dezelfde blootstellingen. Een fonds dat kleine waardeaandelen koopt en de markt verslaat, heeft immers niets gedaan wat DFA niet goedkoper verkoopt. Voor fonds met overrendement en factorrendementen is de prestatieregressie
Voor het CAPM is Jensen (1968) en voor het driefactormodel Fama & French (1993). Het vierfactormodel van Carhart Carhart (1997) voegt daar de momentumfactor UMD aan toe, zoals in (4). Omdat de factoren overrendementen van verhandelbare portefeuilles zijn, is het gemiddelde rendement van het fonds min dat van de replicerende portefeuille . De vraag is dan hoe lang we moeten kijken voordat iets zegt.
Proof 3
Met is en . Het -element van de inverse is volgens de formule voor gepartitioneerde matrices . Sherman-Morrison geeft met , dus het element is . Vermenigvuldig met .
De term tussen haakjes in (7) is één plus de gekwadrateerde maximale Sharpe-ratio van de factoren per periode. Bij een Sharpe-ratio van ongeveer 0,14 per maand is hij rond 1,02. Het probleem is daarom niet de formule maar de ruis, net als bij de standaardfout van 2% van een gemiddeld rendement. De tracking error (de standaarddeviatie van , het rendement dat de factoren niet verklaren) van een actief aandelenfonds is al gauw per jaar. Een beheerder met een werkelijke alpha van haalt na jaar dan een verwachte -waarde van . Voor zijn dan 100 jaar nodig, en bij een alpha van nog altijd 25 jaar. Omdat één fonds zo niet te beoordelen is, kijkt de literatuur naar de hele cross-sectie van fondsen.
4.5Geluk of vaardigheid: de bootstrap
Als geen enkel fonds vaardig is, volgen de geschatte -waarden van alpha de verdeling van de ruis, zodat alleen een staart die dikker is dan die van de ruis op vaardigheid wijst. Fondsrendementen zijn echter niet normaal, hebben verschillende volatiliteiten en zijn onderling sterk gecorreleerd, zodat een tabel van de -verdeling de verkeerde nulhypothese beschrijft. De bootstrap (herhaald trekken uit de eigen data) maakt die nulverdeling daarom uit de data zelf. Fama en French hielden ook de correlatie tussen fondsen vast door hele maanden te trekken Fama & French (2010).
Omdat alle fondsen dezelfde maanden krijgen, bevat de gesimuleerde cross-sectie ook de gemeenschappelijke schokken van de echte. Liggen de werkelijke staartpercentielen in bijna alle trekkingen buiten de simulaties, dan zijn er meer extreme fondsen dan geluk verklaart. Fama en French vonden dat weinig Amerikaanse aandelenfondsen genoeg verdienen om hun kosten te dekken. Vóór kosten zagen ze in beide staarten wel sporen van slechte en goede beheerders Fama & French (2010).
4.6Veel toetsen tegelijk: de false discovery rate
Wie 2000 fondsen toetst op een niveau van 5%, vindt zonder enige vaardigheid honderd “significante” fondsen. De vraag is daarom niet hoe vaak een fonds zonder vaardigheid ten onrechte wordt verworpen, maar welk deel van de verwerpingen onterecht is. Stel dat hypothesen met p-waarden zijn getoetst, waarvan waar. Met het aantal onterechte en het totale aantal verwerpingen is de false discovery rate (het verwachte aandeel onterechte ontdekkingen) .
Proof 4
Neem een ware nulhypothese en laat het aantal verwerpingen zijn als door 0 wordt vervangen, zodat alleen van de andere p-waarden afhangt. De procedure heeft de eigenschap dat , omdat een verworpen het aantal verwerpingen niet verandert als hij naar nul gaat. Dus
waarbij de tweede stap onafhankelijkheid en uniformiteit gebruikt en de derde dat zeker is, want wordt altijd verworpen.
Barras, Scaillet en Wermers gebruikten dezelfde uniformiteit Barras et al. (2010) om niet te beslissen welk fonds vaardig is, maar te schatten hoeveel fondsen dat zijn. Ze delen de fondsen in drie groepen: fondsen met een alpha na kosten van nul (aandeel ), onvaardige fondsen met een negatieve alpha () en vaardige fondsen met een positieve alpha ().
Het bewijs laat ook de zwakte zien: een vaardig fonds dat niet significant is, telt mee als nulfonds, zodat bij weinig data te laag uitvalt. Barras, Scaillet en Wermers vonden dat ongeveer driekwart van de fondsen na kosten een alpha van nul had, wat past bij het evenwicht van Berk en Green. Vóór 1996 zagen ze een flink aandeel vaardige fondsen, maar in 2006 vrijwel geen meer Barras et al. (2010).
5Simulatie: 2000 fondsen, waarvan een paar kunnen wat ze beloven
Welk deel van de vaardige fondsen vinden de -toets, de bootstrap en de false discovery rate terug als we de waarheid kennen? Dat hangt vermoedelijk af van de lengte van de steekproef, dus variëren we die ook. Er zijn fondsen en maanden. Van de fondsen heeft 70% een alpha na kosten van nul, 10% een alpha van per jaar en 20% een alpha van per jaar. Die laatste groep verliest twee keer de kosten van X en Y uit het toy-voorbeeld.
Elk fonds heeft een marktbèta tussen en en een tracking error van per maand, ongeveer per jaar zoals in de theorie. De marktpremie is per maand met een volatiliteit van . Voor een vaardig fonds is de verwachte -waarde , zodat zo’n fonds wel vaardig is, maar gemiddeld niet significant. De eerste cel schat voor elk fonds de CAPM-alpha en de -waarde ervan.
def alpha_tstats(Y, F):
    """OLS intercepts, t-statistics and slopes for every column of Y on factors F.

    Y is a (T, M) array of excess returns, F a (T, K) array of factors without a
    constant. Standard errors are homoskedastic.
    """
    # TODO: naar hap.stats (cross-sectional alpha regression)
    T = Y.shape[0]
    X = np.column_stack([np.ones(T), F])
    XtX_inv = np.linalg.inv(X.T @ X)
    coef = XtX_inv @ X.T @ Y
    resid = Y - X @ coef
    s2 = (resid**2).sum(axis=0) / (T - X.shape[1])
    se_alpha = np.sqrt(s2 * XtX_inv[0, 0])
    return coef[0], coef[0] / se_alpha, coef[1:]


def simulate_universe(n_months, rng, counts=(1400, 200, 400), alpha_ann=0.02,
                      sigma_eps=0.015):
    """Simulate fund excess returns: groups 0 = zero alpha, 1 = skilled, 2 = unskilled."""
    groups = np.repeat([0, 1, 2], counts)
    alpha = np.array([0.0, alpha_ann, -alpha_ann])[groups] / 12
    mkt = rng.normal(0.006, 0.045, n_months)
    beta = rng.uniform(0.8, 1.2, groups.size)
    eps = rng.normal(0.0, sigma_eps, (n_months, groups.size))
    return alpha + np.outer(mkt, beta) + eps, mkt[:, None], groups


Y_sim, F_sim, groups = simulate_universe(240, rng)
alpha_sim, t_sim, _ = alpha_tstats(Y_sim, F_sim)

group_names = ["nul-alpha", "vaardig", "onvaardig"]
pd.DataFrame({
    "aantal": [np.sum(groups == g) for g in range(3)],
    "gem. t(alpha)": [t_sim[groups == g].mean() for g in range(3)],
    "aandeel t > 2": [np.mean(t_sim[groups == g] > 2) for g in range(3)],
    "aandeel t < -2": [np.mean(t_sim[groups == g] < -2) for g in range(3)],
}, index=group_names).round(3)De tabel laat het probleem zien. Van de 1400 nulfondsen haalt 2,0% toch , en dat zijn 28 fondsen met geluk, terwijl van de 200 vaardige fondsen maar 36% die drempel haalt. Van de honderd fondsen met is daardoor iets meer dan een kwart niet vaardig, en bijna twee derde van de vaardige fondsen blijft onzichtbaar. In de figuur hieronder gaat het om de rechterstaart, waar de gestapelde balken van nulfondsen en vaardige fondsen door elkaar lopen.
Source
fig, ax = plt.subplots()
bins = np.linspace(-6, 6, 61)
ax.hist([t_sim[groups == g] for g in (2, 0, 1)], bins=bins, stacked=True,
        label=["onvaardig (20%)", "nul-alpha (70%)", "vaardig (10%)"], edgecolor="white")
grid = np.linspace(-6, 6, 400)
ax.plot(grid, stats.t.pdf(grid, 238) * t_sim.size * (bins[1] - bins[0]), color="black",
        lw=1.2, label="nulverdeling, alle fondsen")
for c in (-2, 2):
    ax.axvline(c, color="black", ls="--", lw=0.8)
ax.set_xlabel("$t$-waarde van de geschatte alpha")
ax.set_ylabel("Aantal fondsen")
ax.set_title("2000 gesimuleerde fondsen over twintig jaar")
ax.legend()
plt.show()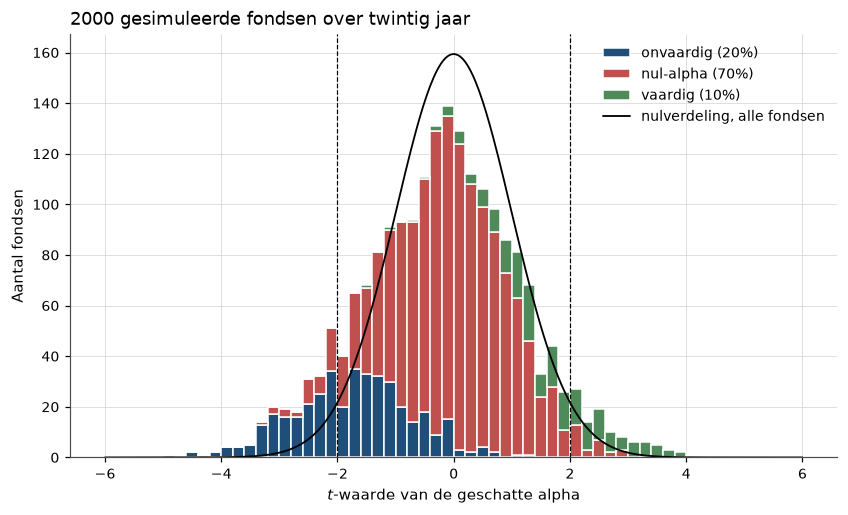
Figure 1:De cross-sectie van is een mengsel van drie verdelingen die elkaar grotendeels overlappen. De vaardige fondsen verschuiven de rechterstaart, maar veel van de fondsen met zijn nulfondsen met geluk, en de meeste vaardige fondsen halen de drempel niet.
Omdat de -toets per fonds zo weinig vaardige fondsen vindt, passen we nu de bootstrap toe alsof we de waarheid niet kenden, met 500 trekkingen. Fama en French schatten zelf geen aandeel vaardige fondsen. Om de methoden toch te vergelijken, nemen we het deel van de fondsen boven het 90e percentiel van de bootstrapverdeling, min de 10% die daar zonder vaardigheid verwacht wordt.
def bootstrap_t(Y, F, n_boot, rng):
    """Fama-French (2010) bootstrap: impose zero alpha, resample months jointly."""
    alpha, t_actual, _ = alpha_tstats(Y, F)
    Y_null = Y - alpha
    T = Y.shape[0]
    t_boot = np.empty((n_boot, Y.shape[1]))
    for b_i in range(n_boot):
        idx = rng.integers(0, T, T)
        t_boot[b_i] = alpha_tstats(Y_null[idx], F[idx])[1]
    return t_actual, t_boot


def compare_percentiles(t_actual, t_boot, pcts):
    """Actual cross-sectional percentiles against their bootstrap distribution."""
    actual = np.percentile(t_actual, pcts)
    simulated = np.percentile(t_boot, pcts, axis=1)          # (len(pcts), n_boot)
    return pd.DataFrame({
        "werkelijk": actual,
        "gem. simulatie": simulated.mean(axis=1),
        "% sim < werkelijk": 100 * (simulated < actual[:, None]).mean(axis=1),
    }, index=[f"p{p}" for p in pcts])


t_actual, t_boot = bootstrap_t(Y_sim, F_sim, 500, rng)
compare_percentiles(t_actual, t_boot, [1, 5, 10, 25, 50, 75, 90, 95, 99]).round(2)De bootstrap ziet dat er iets aan de hand is, want links liggen de werkelijke percentielen in alle simulaties lager en rechts vanaf het 90e percentiel hoger. Dat is het patroon dat Fama en French beschrijven. De volgende cel zet de bootstrap, de schatter van Barras, Scaillet en Wermers en de procedure van Benjamini en Hochberg naast de waarheid.
def fdr_proportions(t, df, lam=0.5, gamma=0.2):
    """Barras-Scaillet-Wermers (2010) proportions of zero, unskilled and skilled funds."""
    # TODO: naar hap.stats (false discovery rate)
    p = 2 * stats.t.sf(np.abs(t), df)
    pi0 = min(1.0, np.mean(p > lam) / (1 - lam))
    significant = p <= gamma
    pi_minus = np.mean(significant & (t < 0)) - pi0 * gamma / 2
    pi_plus = np.mean(significant & (t > 0)) - pi0 * gamma / 2
    return pi0, pi_minus, pi_plus


def benjamini_hochberg(p, q):
    """Boolean mask of hypotheses rejected by the Benjamini-Hochberg step-up rule."""
    order = np.argsort(p)
    below = p[order] <= q * np.arange(1, p.size + 1) / p.size
    k = below.nonzero()[0].max() + 1 if below.any() else 0
    reject = np.zeros(p.size, dtype=bool)
    reject[order[:k]] = True
    return reject


ff_cutoff = np.percentile(t_boot, 90)
ff_plus = np.mean(t_actual > ff_cutoff) - np.mean(t_boot > ff_cutoff)
pi0, pi_minus, pi_plus = fdr_proportions(t_sim, df=238)

bh = benjamini_hochberg(stats.t.sf(t_sim, 238), q=0.10)
realised_fdp = np.mean(groups[bh] != 1) if bh.any() else np.nan

pd.DataFrame({
    "waarheid": [0.70, 0.20, 0.10, 0.10, np.nan, np.nan],
    "schatting": [pi0, pi_minus, pi_plus, ff_plus, bh.sum(), realised_fdp],
}, index=["pi0 (BSW)", "pi- (BSW)", "pi+ (BSW)", "vaardig (FF-bootstrap)",
"BH-ontdekkingen, q = 10%", "gerealiseerd aandeel onterecht"]).round(3)Om vaardige fondsen te tellen is de bootstrap zwak, want vertaald naar een aandeel vindt hij 2% vaardige fondsen tegen 10% in werkelijkheid. De schatter van Barras, Scaillet en Wermers geeft en , ook te laag, omdat vaardige fondsen die niet significant zijn als nulfonds meetellen. Benjamini-Hochberg vindt 16 vaardige fondsen zonder één onterechte ontdekking, wat betrouwbaar is, maar het zijn er 16 van de 200.
Eén universum zegt weinig over een schatter. We herhalen de simulatie daarom tweehonderd keer, voor steekproeven van tien, twintig en veertig jaar, en kijken naar de verdeling van .
horizons = [120, 240, 480]
n_universes = 200
pi_plus_draws = {T: np.empty(n_universes) for T in horizons}
pi0_draws = {T: np.empty(n_universes) for T in horizons}
for T in horizons:
    for u in range(n_universes):
        Y_u, F_u, _ = simulate_universe(T, rng)
        t_u = alpha_tstats(Y_u, F_u)[1]
        pi0_draws[T][u], _, pi_plus_draws[T][u] = fdr_proportions(t_u, df=T - 2)

pd.DataFrame({
    "gem. pi0": [pi0_draws[T].mean() for T in horizons],
    "gem. pi+": [pi_plus_draws[T].mean() for T in horizons],
    "SD pi+": [pi_plus_draws[T].std(ddof=1) for T in horizons],
    "5e pct pi+": [np.percentile(pi_plus_draws[T], 5) for T in horizons],
    "95e pct pi+": [np.percentile(pi_plus_draws[T], 95) for T in horizons],
}, index=[f"{T // 12} jaar" for T in horizons]).round(3)Het geschatte aandeel vaardige fondsen groeit met de lengte van de steekproef, van gemiddeld 0,032 na tien jaar tot 0,085 na veertig jaar, terwijl de spreiding tussen universa klein blijft. In de figuur gaat het om de afstand tussen elk histogram en de verticale lijn bij het ware aandeel van 10%.
Source
fig, ax = plt.subplots()
for T in horizons:
    ax.hist(pi_plus_draws[T], bins=30, alpha=0.6, label=f"{T // 12} jaar")
ax.axvline(0.10, color="black", lw=1.2, label="ware aandeel vaardig")
ax.set_xlabel("geschat aandeel vaardige fondsen $\\hat\\pi_A^+$")
ax.set_ylabel("Aantal gesimuleerde universa")
ax.set_title("Het aandeel vaardige fondsen, geschat in 200 universa")
ax.legend()
plt.show()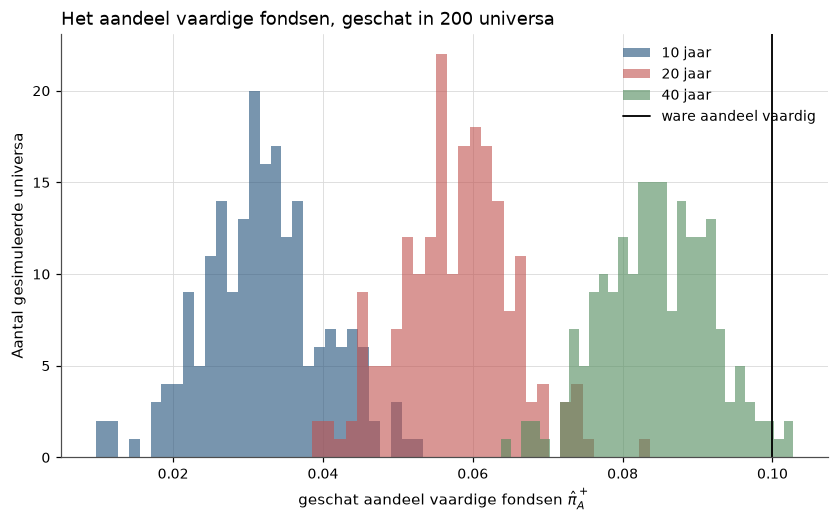
Figure 2:De schatter varieert weinig tussen universa, maar is sterk vertekend: met tien jaar data vindt hij gemiddeld een derde van de vaardige fondsen, met veertig jaar 85%. Het probleem is gebrek aan onderscheidend vermogen, niet ruis, zodat een laag geschat aandeel vaardige fondsen ook op te weinig data kan wijzen.
6Replicatie op echte data
De eerste cel haalt de koersen op, zet ze om naar maandelijkse overrendementen en houdt de fondsen met een volledige historie sinds 1996 over.
tickers = (
    "FDGRX FLPSX FEQIX FDVLX FBGRX FOCPX FTRNX FFIDX FDCAX FGRIX FMCSX FDSSX FMAGX FCNTX "
    "AGTHX AIVSX ANCFX AMCPX AWSHX AMRMX PRGFX PRNHX TRBCX PRFDX PRDGX RPMGX PRWAX TRVLX "
    "VWNDX VWNFX VWUSX VPMCX VEIPX VQNPX VEXPX VMRGX VHCOX DODGX TWCUX TWCGX JANSX SEQUX "
    "MUTHX FKGRX NYVTX OAKMX PENNX MPGFX NBGNX HACAX PRBLX LMVTX CGMFX "
    "VFINX VTSMX NAESX VIVAX VIGRX VEXMX"
).split()
index_funds = {
    "VFINX": "Vanguard 500 Index", "VTSMX": "Vanguard Total Stock Market Index",
    "NAESX": "Vanguard Small-Cap Index", "VIVAX": "Vanguard Value Index",
    "VIGRX": "Vanguard Growth Index", "VEXMX": "Vanguard Extended Market Index",
}

prices = hap_data.yahoo(tickers, "1985-01-01").resample("ME").last()
fund_ret = (prices / prices.shift(1) - 1).iloc[1:]
factors = hap_data.french("F-F_Research_Data_Factors").join(hap_data.french("F-F_Momentum_Factor"))

sample = fund_ret.index.intersection(factors.index)
sample = sample[sample >= "1996-01-01"]
excess = fund_ret.loc[sample].sub(factors.loc[sample, "RF"], axis=0).dropna(axis=1)
fac = factors.loc[sample]
active_cols = [c for c in excess.columns if c not in index_funds]

print(f"{sample[0]:%Y-%m} t/m {sample[-1]:%Y-%m}: {len(sample)} maanden, "
      f"{len(active_cols)} actieve fondsen, {excess.shape[1] - len(active_cols)} indexfondsen")
print("weggevallen (te korte historie):", sorted(set(tickers) - set(excess.columns)))
1996-01 t/m 2026-07: 367 maanden, 50 actieve fondsen, 6 indexfondsen
weggevallen (te korte historie): ['CGMFX', 'JANSX', 'VMRGX']
Er blijven 367 maanden over, van januari 1996 tot en met juli 2026, en drie fondsen vallen af omdat hun historie te kort is. De volgende cel schat de alpha van elk fonds tegen het CAPM, het driefactormodel en het model van Carhart.
models = {"CAPM": ["Mkt-RF"], "FF3": ["Mkt-RF", "SMB", "HML"],
          "Carhart": ["Mkt-RF", "SMB", "HML", "Mom"]}
Y_act = excess[active_cols].to_numpy()
ew_active = Y_act.mean(axis=1, keepdims=True)

rows = {}
for name, cols in models.items():
    F = fac[cols].to_numpy()
    a_act, t_act, _ = alpha_tstats(Y_act, F)
    a_ew, t_ew, _ = alpha_tstats(ew_active, F)
    a_idx, t_idx, _ = alpha_tstats(excess[list(index_funds)].to_numpy(), F)
    rows[name] = {
        "actief: gem. alpha (%/jr)": 1200 * a_act.mean(),
        "actief: mediaan t": np.median(t_act),
        "actief: aandeel t > 2": np.mean(t_act > 2),
        "actief: aandeel t < -2": np.mean(t_act < -2),
        "gelijkgewogen actief: alpha (%/jr)": 1200 * a_ew[0],
        "gelijkgewogen actief: t": t_ew[0],
        **{f"{index_funds[k]}: alpha (%/jr)": 1200 * v for k, v in zip(index_funds, a_idx)},
        "VFINX: t": t_idx[0],
    }
performance = pd.DataFrame(rows)
performance.round(2)Het totale-marktindexfonds VTSMX heeft de verwachte alpha van per jaar tegen het CAPM. De small-cap- en extended-marketfondsen blijven ruim één procent per jaar achter bij de factormodellen, terwijl het groei-indexfonds er juist boven ligt. Dat komt niet door slechte of goede beheerders, maar doordat SMB en HML papieren portefeuilles zonder kosten zijn die niemand kan kopen. Een fonds dat positief op die factoren laadt, lijkt daardoor achter te blijven, en een groeifonds met een negatieve HML-lading lijkt om dezelfde reden te winnen. Daarom meten Berk & Binsbergen (2015) vaardigheid tegen indexfondsen.
De 50 overlevende actieve fondsen doen het beter dan de fondsen van Jensen. Hun gelijkgewogen portefeuille heeft een Carhart-alpha van per jaar, niet significant, en 14% van de fondsen haalt (de tabel aan het eind zet de getallen naast de originelen). Dat ligt ruim anderhalf procentpunt boven de die Jensen na kosten vond, en zo groot kan het effect van selectie op overleven dus zijn. De bootstrap hieronder gebruikt 2000 trekkingen en percentielen tussen het 5e en het 95e, omdat 50 fondsen geen staart hebben.
F_c4 = fac[models["Carhart"]].to_numpy()
t_real, t_real_boot = bootstrap_t(Y_act, F_c4, 2000, rng)
compare_percentiles(t_real, t_real_boot, [5, 10, 25, 50, 75, 90, 95]).round(2)Vanaf het 25e percentiel liggen de werkelijke -waarden boven het gemiddelde van de simulaties, en de mediaan ligt hoger dan in 95% van de trekkingen. In de figuur gaat het om de zwarte lijn van de werkelijke fondsen, die als geheel rechts van het histogram zonder vaardigheid ligt.
Source
fig, ax = plt.subplots()
bins = np.linspace(-5, 5, 41)
ax.hist(t_real_boot.ravel(), bins=bins, density=True, alpha=0.5,
        label="bootstrap, alle alpha's nul")
ax.hist(t_real, bins=bins, density=True, histtype="step", lw=2, color="black",
        label=f"werkelijk, {len(active_cols)} actieve fondsen")
ax.set_xlabel("$t$-waarde van de Carhart-alpha")
ax.set_ylabel("Dichtheid")
ax.set_title("Overlevende actieve fondsen tegen een bootstrap zonder vaardigheid, 1996-2026")
ax.legend()
plt.show()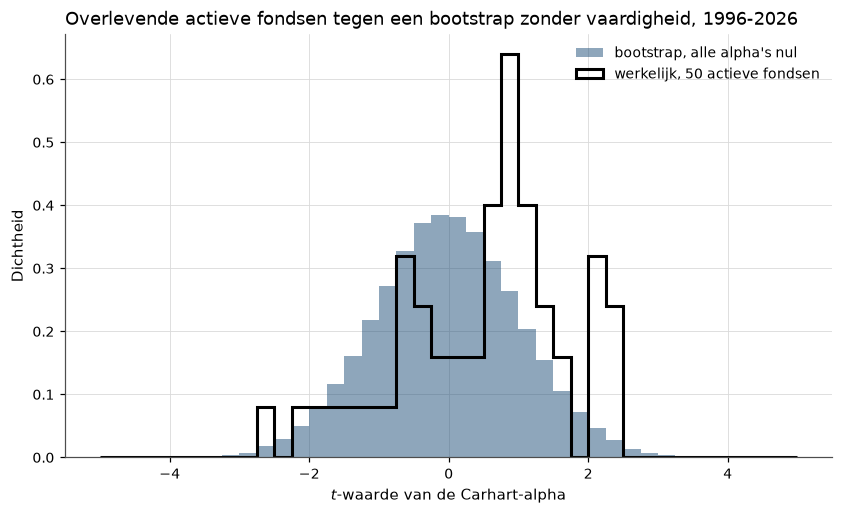
Figure 3:De hele verdeling van werkelijke -waarden ligt rechts van de bootstrap zonder vaardigheid, met een mediaan van tegen in de simulaties. Zo ziet een steekproef eruit die op succes is geselecteerd, en dat hoeft geen vaardigheid te zijn.
Voor de persistentie schatten we elk jaar van 1999 tot en met 2025 de Carhart-alpha van elk actief fonds over de voorgaande 36 maanden. Daarna delen we de fondsen in drie groepen. Het abnormale rendement in het jaar erna meten we met de bèta’s uit de vormingsperiode, zodat er in de evaluatie niets wordt geschat.
years = range(1999, 2026)
spread, top_alpha, bottom_alpha, rank_corr_real = [], [], [], []
for year in years:
    form = (excess.index >= f"{year - 3}-01-01") & (excess.index < f"{year}-01-01")
    evaluate = (excess.index >= f"{year}-01-01") & (excess.index < f"{year + 1}-01-01")
    a_form, _, betas = alpha_tstats(Y_act[form], F_c4[form])
    abnormal = 12 * (Y_act[evaluate] - F_c4[evaluate] @ betas).mean(axis=0)
    ranks = pd.qcut(a_form, 3, labels=False)
    top_alpha.append(abnormal[ranks == 2].mean())
    bottom_alpha.append(abnormal[ranks == 0].mean())
    spread.append(top_alpha[-1] - bottom_alpha[-1])
    rank_corr_real.append(stats.spearmanr(a_form, abnormal)[0])

spread = np.array(spread)
pd.DataFrame({
    "gemiddelde": [100 * np.mean(top_alpha), 100 * np.mean(bottom_alpha), 100 * spread.mean(),
                   np.mean(rank_corr_real)],
    "SE": [100 * np.std(top_alpha, ddof=1) / np.sqrt(len(spread)),
           100 * np.std(bottom_alpha, ddof=1) / np.sqrt(len(spread)),
           100 * spread.std(ddof=1) / np.sqrt(len(spread)),
           np.std(rank_corr_real, ddof=1) / np.sqrt(len(spread))],
}, index=["hoogste terciel: alpha volgend jaar (%)", "laagste terciel: alpha volgend jaar (%)",
          "verschil hoog - laag (%)", "rangcorrelatie vorming-evaluatie"]).assign(
t=lambda d: d["gemiddelde"] / d["SE"]).round(2)Het beste derde van de fondsen haalt het jaar daarna gemiddeld alpha en het slechtste derde . Het verschil van procentpunt heeft over 27 jaar een standaardfout van (), zodat er geen persistentie te zien is. Dat bewijst niet dat ze ontbreekt, want bij deze spreiding zou een verschil van een half procent per jaar pas na ongeveer 145 jaar een -waarde van 2 halen.
| grootheid | origineel | hier |
|---|---|---|
| gemiddelde nettoalpha actieve fondsen | per jaar (Jensen) | , |
| alpha totale-marktindexfonds | klein en negatief (verwachting) | |
| mediaan tegen bootstrap | weinig fondsen dekken hun kosten (Fama en French) | tegen |
| persistentie, hoogste min laagste groep | alleen de slechtste fondsen (Carhart) | procentpunt, |
Gedeeltelijk geslaagd. Het indexfonds en de persistentie gedragen zich zoals verwacht. Het niveau van de alpha en de verschuiving in de bootstrap wijken af van de originelen, maar in de richting die de selectie op overleven meebrengt. Juist daardoor kunnen deze data de conclusie van Fama en French niet toetsen, want een steekproef van overlevenden laat geen fondsen zien die hun kosten niet terugverdienden.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Sharpes rekenkunde en het model van Berk en Green verklaren samen drie hardnekkige feiten over de beleggingsindustrie. De gemiddelde actieve dollar blijft na kosten achter, winnaars blijven geen winnaars, en toch stroomt geld achter winnaars aan. Ze verklaren ook de sociologie, want de oprichters van DFA en AQR hoefden de rekenkunde niet te weerleggen om een bedrijf te bouwen. De rekenkunde zegt immers niets over wie wint, maar alles over wat het kost.
Waar het breekt. Het breekt bij het meten van vaardigheid zelf. In onze simulatie met 10% vaardige fondsen vond de beste schatter met twintig jaar data er gemiddeld 6%. Onze echte steekproef levert een bootstrap die op vaardigheid lijkt, maar door de selectie op overleven valt die uitkomst niet te interpreteren. Barras, Scaillet en Wermers zagen het aandeel vaardige fondsen tussen 1996 en 2006 naar bijna nul dalen. Of de vaardigheid verdween of de toets zijn onderscheidend vermogen verloor, laten de data niet zien.
Risico of vergissing? In de Chicago-lezing is kapitaal net zo concurrerend als informatie. Vaardigheid bestaat dan en wordt beloond in vergoedingen, en DFA en AQR verkopen een vergoeding voor risico. In de Yale-lezing jagen beleggers rendementen na die ze niet kunnen beoordelen. Dan zijn de premies achter DFA en AQR vergissingen van anderen, en overleven dure fondsen omdat hun klanten de rekenkunde niet kennen. Data over de redenen waarom beleggers hun geld verplaatsen, zouden de lezingen kunnen scheiden, maar die data zijn omstreden. Santa-Clara’s praktijkles past op beide: wie een indexfonds koopt, draagt risico met een premie, en wie een actief fonds koopt, denkt iets te weten wat de prijs niet weet.
Wat er daarna kwam. Elke alpha in dit college is gemeten tegen een factormodel, en de keuze van dat model bepaalde het antwoord. Het volgende college, Cochrane: p = E[mx], laat zien dat elk zulk model een uitspraak is over één stochastische discontofactor (SDF, de factor waarmee alle payoffs worden verdisconteerd).
8Oefeningen
Solution to Exercise 1
Pas Proposition 1 toe op de actieve beleggers samen. Hun vermogensgewogen alpha is nul, dus en . Na kosten haalt de fondsbelegger boven de markt, tegen voor de indexbelegger, een voorsprong van procentpunt. Worden de particulieren passief, dan bestaat alleen uit fondsen, en zegt de propositie dat hun gewogen bruto alpha nul is.
w_index, w_funds, w_retail = 0.30, 0.30, 0.40
alpha_retail = -0.02
alpha_funds = -w_retail * alpha_retail / w_funds
print(f"bruto alpha fondsen          : {alpha_funds:.4%}")
print(f"netto voorsprong op de index : {(alpha_funds - 0.01) - (-0.001):.4%}")
bruto alpha fondsen : 2.6667%
netto voorsprong op de index : 1.7667%
De rekenkunde verbiedt dus niet dat fondsen winnen, maar zegt wie er dan verliest. Dat het in de data meestal de fondsbeleggers zijn, is een empirisch feit en geen stelling.
Solution to Exercise 2
(1) Uit volgt . De bindende voorwaarde van de belegger geeft . De indexpositie is niet negatief als en slechts als .
(2) Met en is .
b_bg, f_bg, phi0, eta, sigma, R1 = 0.005, 0.01, 0.03, 0.01, 0.05, 0.08
gamma_p, omega_p = 1 / eta**2, 1 / sigma**2
phi1 = (gamma_p * phi0 + omega_p * R1) / (gamma_p + omega_p)
q0, q1 = phi0**2 / (4 * b_bg * f_bg), phi1**2 / (4 * b_bg * f_bg)
print(f"phi_1 = {phi1:.4%}, q_0 = {q0:.3f} mld, q_1 = {q1:.3f} mld, instroom = {q1 / q0 - 1:.1%}")
phi_1 = 3.1923%, q_0 = 4.500 mld, q_1 = 5.095 mld, instroom = 13.2%
(3) Het verwachte rendement is nul, omdat de instroom de omvang precies zo zet dat . Een rendement van vijf procentpunt boven de verwachting verhoogt de geschatte vaardigheid met 0,19 procentpunt, en het fonds groeit van 4,5 naar 5,1 miljard dollar. Daarna is het fonds weer gewoon. Geld dat rendementen najaagt, kan dus rationeel zijn en toch niets opleveren.
Solution to Exercise 3
df_real = len(sample) - 5
pi0_r, pim_r, pip_r = fdr_proportions(t_real, df=df_real)
bh_real = benjamini_hochberg(stats.t.sf(t_real, df_real), q=0.10)
se_2000 = pi_plus_draws[480].std(ddof=1)
print(f"pi0 = {pi0_r:.2f}, pi- = {pim_r:.2f}, pi+ = {pip_r:.2f}")
print(f"BH-ontdekkingen (q = 10%): {bh_real.sum()} van {len(t_real)}")
print(f"SE pi+ bij 2000 fondsen (40 jaar): {se_2000:.3f}; "
      f"geschaald naar {len(t_real)} fondsen: {se_2000 * np.sqrt(2000 / len(t_real)):.3f}")
pi0 = 0.60, pi- = 0.02, pi+ = 0.18
BH-ontdekkingen (q = 10%): 0 van 50
SE pi+ bij 2000 fondsen (40 jaar): 0.007; geschaald naar 50 fondsen: 0.046
Op de overlevenden geeft de schatter en , maar Benjamini-Hochberg vindt geen enkel vaardig fonds. De standaardfout van is bij 50 fondsen ongeveer , zes keer zo groot als bij 2000 fondsen, en de steekproef is bovendien op succes geselecteerd. Een geschat aandeel vaardige fondsen betekent daarom alleen iets in een groot universum zonder survivorship bias, en juist die data ontbreken hier.
- Jensen, M. C. (1968). The Performance of Mutual Funds in the Period 1945–1964. The Journal of Finance, 23(2), 389–416. 10.1111/j.1540-6261.1968.tb00815.x
- Sharpe, W. F. (1991). The Arithmetic of Active Management. Financial Analysts Journal, 47(1), 7–9. 10.2469/faj.v47.n1.7
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Berk, J. B., & Green, R. C. (2004). Mutual Fund Flows and Performance in Rational Markets. Journal of Political Economy, 112(6), 1269–1295. 10.1086/424739
- Fama, E. F., & French, K. R. (2010). Luck versus Skill in the Cross-Section of Mutual Fund Returns. Journal of Finance, 65(5), 1915–1947. 10.1111/j.1540-6261.2010.01598.x
- Barras, L., Scaillet, O., & Wermers, R. (2010). False Discoveries in Mutual Fund Performance: Measuring Luck in Estimated Alphas. The Journal of Finance, 65(1), 179–216. 10.1111/j.1540-6261.2009.01527.x
- Investment Company Institute. (2020). 2020 Investment Company Fact Book. 60th edition. https://www.ici.org/system/files/attachments/pdf/2020_factbook.pdf
- Barber, B. M., & Odean, T. (2000). Trading Is Hazardous to Your Wealth: The Common Stock Investment Performance of Individual Investors. The Journal of Finance, 55(2), 773–806. 10.1111/0022-1082.00226
- French, K. R. (2008). Presidential Address: The Cost of Active Investing. The Journal of Finance, 63(4), 1537–1573. 10.1111/j.1540-6261.2008.01368.x
- Carhart, M. M. (1997). On Persistence in Mutual Fund Performance. The Journal of Finance, 52(1), 57–82. 10.1111/j.1540-6261.1997.tb03808.x
- Jegadeesh, N., & Titman, S. (1993). Returns to Buying Winners and Selling Losers: Implications for Stock Market Efficiency. The Journal of Finance, 48(1), 65–91. 10.1111/j.1540-6261.1993.tb04702.x
- Berk, J. B., & van Binsbergen, J. H. (2015). Measuring Skill in the Mutual Fund Industry. Journal of Financial Economics, 118(1), 1–20. 10.1016/j.jfineco.2015.05.002
- Berk, J. B., & van Binsbergen, J. H. (2012). Measuring Managerial Skill in the Mutual Fund Industry (NBER Working Paper No. 18184). National Bureau of Economic Research. https://www.nber.org/papers/w18184
- Fama, E. F., & French, K. R. (1993). Common Risk Factors in the Returns on Stocks and Bonds. Journal of Financial Economics, 33(1), 3–56. 10.1016/0304-405X(93)90023-5
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the False Discovery Rate: A Practical and Powerful Approach to Multiple Testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. 10.1111/j.2517-6161.1995.tb02031.x
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD