

Cochrane: p = E[mx]
1Overzicht
Zijn het CAPM, het consumptie-CAPM, de APT en het driefactormodel verschillende theorieën? Nee, want elk model is een keuze voor de stochastische discontofactor in (SDF, stochastische discontofactor: de willekeurige variabele waarmee een toekomstige payoff wordt verdisconteerd). Daardoor zijn alle modellen met één meetlat te vergelijken. In dit college:
rekenen we in een economie met drie toestanden de unieke SDF in de payoff-ruimte met de hand uit;
bewijzen we dat die SDF, de mean-variance-frontier en een bèta-representatie hetzelfde zeggen, en dat een lineair factormodel een bèta-model is;
leiden we de Hansen-Jagannathan-afstand af, een maat voor hoe fout een model is;
simuleren we hoe vaak een overbodige factor een significante premie krijgt terwijl zijn gewicht in nul is;
schatten we met GMM (de gegeneraliseerde momentenmethode) de SDF van het CAPM, FF3 en FF3 plus momentum op 35 portefeuilles, naast de consumptie-SDF.
Dat zo’n bestaat, wisten we al uit de fundamentele stelling van Ross, APT en de fundamentele stelling. Hansen en Richard bewezen in 1987 dat een SDF, een rendement op de frontier en een bèta-representatie drie vormen van hetzelfde zijn Hansen & Richard (1987). Tien jaar later maakten Hansen en Jagannathan er een maat van voor modellen die niet alle portefeuilles goed waarderen Hansen & Jagannathan (1997). Cochrane ordende in zijn handboek van 2001 het hele vak rond Cochrane (2005), en daarmee begon een tijdvak waarin het vak modellen meet in plaats van toetst. Voor de vraag theorie of feit is die verschuiving het scharnier, want niemand vraagt dan nog welk model waar is, alleen hoe ver elk model ernaast zit. Kan, Robotti en Shanken lieten in 2013 zien dat zelfs grote verschillen in fit tussen modellen vaak niet significant zijn Kan et al. (2013).
2Intuïtie: waarom zou dit waar zijn?
Stel dat de prijzen op een markt onderling consistent zijn, zodat dezelfde uitkering hetzelfde kost en een dubbele uitkering het dubbele. Dan is de prijs een lineaire functie van de uitkering, en zo’n functie is altijd een gewogen som over de toestanden. Die gewichten vormen een discontofactor. Er is geen nutsfunctie en geen evenwicht voor nodig, alleen de wet van één prijs.
Meestal zijn er veel van zulke discontofactoren, omdat de gewichten kunnen verschuiven in richtingen die bij geen enkel verhandeld activum de prijs veranderen. Precies één ervan is zelf na te maken met de verhandelde activa, en dat is de kleinste. Elke andere is dezelfde plus ruis die geen prijs verandert. Omdat die kleinste discontofactor een portefeuille is, ligt het rendement ervan op de frontier van Markowitz.
Daarna volgt de stap die het vak veranderde. Verwachte rendementen die lineair zijn in een paar bèta’s, komen neer op een discontofactor die lineair is in een paar factoren. Het CAPM, het consumptie-CAPM en Fama-French verschillen dan alleen in de variabelen die in de discontofactor mogen staan.
Daaruit volgen twee verwachtingen. Ten eerste is de kleinste discontofactor laag in toestanden waarin de activa veel uitkeren, omdat een extra euro daar het minst waard is. Ten tweede krijgt een factor die meebeweegt met een van de factoren in de discontofactor een premie, ook als hij zelf niets toevoegt. Hoe sterker hij meebeweegt, hoe hoger die premie, terwijl zijn eigen gewicht nul blijft, zodat significante premies weinig zeggen over hoeveel factoren nodig zijn.
3Toy-voorbeeld: drie toestanden, twee activa
We nemen drie toestanden met kansen en twee verhandelde activa. Prijzen gelden op en payoffs op , maar de tijdsindex laten we weg. De eerste codecel laadt de pakketten voor het hele college.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)| Activum | payoff in 1 | payoff in 2 | payoff in 3 | prijs |
|---|---|---|---|---|
| obligatie | 1{,}00 | 1{,}00 | 1{,}00 | 0{,}95 |
| aandeel | 1{,}50 | 1{,}00 | 0{,}50 | 0{,}90 |
Er zijn drie toestanden en maar twee prijzen, dus de markt is incompleet. Volgens Theorem 2 is de SDF alleen in een complete markt uniek, zodat er hier veel SDF’s bestaan.
Het recept. De payoffs van alle portefeuilles vormen de payoff-ruimte , met de payoff van het aandeel. We zoeken het element daarvan waarmee elke prijs een verwachting wordt, . Met de matrix van tweede momenten en de prijzen is met . Die formule leidt de theorie straks als eerste af.
Stap 1: de tweede momenten. Het aandeel heeft en . De matrix van tweede momenten en de inverse ervan zijn dan
Stap 2: de gewichten. De gewichten zijn . Daaruit volgt .
Stap 3: de controle. is de prijs van de obligatie, en is die van het aandeel. De risicovrije rente is dan (in dit college staat kortheidshalve voor het bruto risicovrije rendement, in de notatie van de setup).
Stap 4: alle andere SDF’s. De vector heeft en . Daarom waardeert beide activa goed, en die is strikt positief zolang .
Stap 5: de kleinste volatiliteit. Omdat , is , met en . Van alle SDF’s heeft dus de kleinste volatiliteit, met , en dat getal blijkt in de theorie de Hansen-Jagannathan-grens van deze economie.
De codecel rekent dezelfde stappen na en zet hand en code naast elkaar. Ze bewaart ook het rendement en de bèta van het aandeel, die de theorie als voorbeeld gebruikt.
prob = np.array([0.25, 0.50, 0.25])
X = np.array([[1.0, 1.5],        # state 1: bond, stock
              [1.0, 1.0],        # state 2
              [1.0, 0.5]])       # state 3
p = np.array([0.95, 0.90])
eps = np.array([1.0, -1.0, 1.0])


def E(v):
    return prob @ v


def cov(a, b):
    return E((a - E(a)) * (b - E(b)))


G = X.T @ (prob[:, None] * X)                 # second-moment matrix E[x x']
c = np.linalg.solve(G, p)                     # x* = X c
x_star = X @ c
R_f = 1 / E(x_star)
R_star = x_star / E(x_star**2)                # p(x*) = E[x*^2]
R_a = X[:, 1] / p[1]
beta_a = cov(R_a, R_star) / cov(R_star, R_star)
assert np.allclose(X.T @ (prob * eps), 0) and np.isclose(beta_a * (E(R_star) - R_f), E(R_a) - R_f)

hand = {"c_1": 1.35, "c_2": -0.40, "x* in toestand 1": 0.75, "x* in toestand 3": 1.15,
        "E[x*] (prijs obligatie)": 0.95, "E[x* x_a] (prijs aandeel)": 0.90, "R^f": 1.0526,
        "Var(x*)": 0.02, "sigma(x*)/E[x*]": 0.1489}
code = [c[0], c[1], x_star[0], x_star[2], E(x_star), E(x_star * X[:, 1]), R_f,
        cov(x_star, x_star), np.sqrt(cov(x_star, x_star)) / E(x_star)]
pd.DataFrame({"met de hand": list(hand.values()), "code": code}, index=list(hand)).round(4)De twee kolommen zijn gelijk, en de SDF is laag in toestand 1, waar het aandeel veel uitkeert, en hoog in toestand 3, waar een extra euro het meest waard is. Welke de markt gebruikt, volgt niet uit de prijzen. Een optie die alleen in toestand 3 uitkeert, krijgt daardoor voor elke een andere prijs, zoals de eerste oefening laat zien.
4Theorie
De afleiding gaat van één prijsfunctie naar één meetlat. De kern is dat de wet van één prijs precies één SDF in de payoff-ruimte oplevert, de uit het toy-voorbeeld. Daaruit volgen de frontier en de bèta-representatie, en een lineair factormodel blijkt een bèta-model met een vaste sleutel tussen gewichten en premies . Tot slot schatten we zulke modellen met GMM en meten we met de Hansen-Jagannathan-afstand hoe fout ze zijn.
4.1Opzet: payoffs als Hilbertruimte
We werken met één periode zonder tijdsindex, zoals in Ross, APT en de fundamentele stelling. Met in plaats van geldt alles voorwaardelijk. Payoffs zijn stochastische variabelen met een eindig tweede moment, en samen vormen ze de ruimte . Het inproduct is en de norm . Deze meetkundige taal komt van Hansen & Richard (1987), en Cochrane (2005) neemt ze over.
De payoff-ruimte bevat de payoffs van alle portefeuilles van verhandelde activa. We nemen aan dat die ruimte gesloten is (aanname A1) en dat de wet van één prijs geldt, zodat de prijsfunctie op lineair is (aanname A2). Die tweede aanname is zwakker dan de afwezigheid van arbitrage, want ze zegt niets over positieve prijzen. Een rendement heeft prijs één, , en een overrendement prijs nul, .
4.2Stelling 1: er is precies één SDF in de payoff-ruimte
Ook zonder rekenwerk is te zien dat er maar één zo’n SDF bestaat. Een handelaar die de prijs van elke portefeuille kent, zoekt per toestand een gewicht zodat elke prijs de gewogen verwachting van de payoff wordt. Omdat prijzen lineair zijn, lukt dat altijd met een gewicht dat zelf een portefeuille is. Als er een tweede zo’n portefeuille bestond, zou het verschil elke portefeuille de prijs nul geven. Dat geldt ook voor het verschil zelf, en een payoff met tweede moment nul is gelijk aan nul.
Vergelijking (2) zegt dat de portefeuille met gewichten is, in het toy-voorbeeld .
Proof 1
Bestaan: lost een lineair stelsel op. In eindige dimensie stellen we en eisen we voor elke basisvector. Dat is , dus , wat (2) geeft. Lineariteit van (A2) brengt de gelijkheid van de basis over op heel . In oneindige dimensie is dit de representatiestelling van Riesz voor de Hilbertruimte , die gesloten is (A1).
Uniciteit: het verschil heeft norm nul. Als en in allebei werken, is voor alle , ook voor . Dan is .
Karakterisering: de rest staat loodrecht op de payoffs. Als een SDF is, is orthogonaal aan omdat . Omgekeerd waardeert met zo’n alles goed. Omdat , is de projectie van en geldt . Als , is , zodat en hetzelfde gemiddelde hebben en ook de varianties optellen.
De fundamentele stelling (Theorem 1) zegt dat er een positieve bestaat zodra arbitrage onmogelijk is. Deze stelling voegt toe dat er altijd één kanonieke is. De keuzevrijheid uit Theorem 2 is precies de ruimte loodrecht op alle payoffs, in het toy-voorbeeld de veelvouden van . De minimum-variantie-SDF achter de Hansen-Jagannathan-grens (Theorem 2) is punt 3, toegepast op de constante en de rendementen. Positief hoeft niet te zijn, en in de replicatie wordt de geschatte SDF af en toe negatief.
4.3Stelling 2: ligt op de frontier
Het rendement van ligt op de mean-variance-frontier (de minimum-variantierand, met bij elk gemiddelde de kleinste variantie). Omdat het kortste element is dat alle prijzen goed geeft, heeft het rendement ervan het kleinste tweede moment van alle rendementen. Elk rendement kost namelijk één, zodat en Cauchy-Schwarz geeft, precies de norm van . Een belegger die een hoger gemiddelde wil, schuift van dat punt af langs de enige richting die het gemiddelde verandert. We definiëren
met de ruimte van overrendementen. Zo is de SDF geschaald tot prijs één, en is het overrendement dat het dichtst bij de constante één ligt. Omdat een projectie van de constante is, geldt voor elk overrendement.
Proof 2
Stap 1: drie richtingen staan loodrecht op elkaar. (a) staat loodrecht op elk overrendement, want . In het bijzonder is . (b) Voor elk overrendement geldt , omdat loodrecht op de hele ruimte staat.
Stap 2: elk rendement valt zo uiteen. kost en is dus een overrendement. Kies en . Dan is een overrendement met . Uit de projectie-eigenschap volgt , en uit (a) volgt .
Stap 3: de frontier is . Uit (4) en de orthogonaliteiten volgt . Voor het tweede moment geldt
Rendementen met hetzelfde gemiddelde hebben dezelfde , dus minimale variantie precies als . Met en is dat , het kleinste tweede moment.
Volgens (4) bestaat elk rendement uit , een hoeveelheid van de richting die het gemiddelde verhoogt, en ruis die alleen variantie kost. De frontier is daarom de lijn . Zo keert de twee-fondsenstelling van Markowitz, Roy en Tobin terug, want elke portefeuille op de frontier mengt twee vaste fondsen, zelf en het rendement , dat de richting die het gemiddelde verhoogt bij optelt. De bèta-representatie volgt nu zonder evenwicht.
Proof 3
Stap 1: de bèta-vorm. Uit en volgt voor elk rendement. Schrijf het linkerlid als , dan volgt . Voor geeft dit , en de eerste gedeeld door de tweede geeft (6).
Stap 2: de constante is de rente. Met is . Daaruit volgt .
Stap 3: de omkering. Een bèta-representatie op zegt dat affien is in . Kies zodat voor twee rendementen met verschillende bèta, en lineariteit geeft het voor alle.
Het verwachte rendement daalt dus met de bèta op , omdat een verzekering is die het meest uitkeert in de toestand waarin het aandeel het minst oplevert, en daarom minder verdient dan de rente. In het toy-voorbeeld is , zodat
minder dan de risicovrije rente van 1,0526. Het aandeel heeft en dus een overrendement van 0,0585. Omdat lineair is in met helling , is , en daarmee
Dat is precies het overrendement van het aandeel, en ook is gelijk aan . Omdat het aandeel het enige risicovolle activum is, ligt het zelf op de frontier. De Sharpe-ratio ervan haalt de Hansen-Jagannathan-grens daarom precies, want .
De bèta-vorm van het CAPM (Proposition 1) en de SDF van Fama en French (Theorem 1) zijn speciale gevallen. Het CAPM zegt namelijk alleen dat de marktportefeuille voor een zekere gelijk is aan .
4.4Stelling 3: lineaire factormodellen zijn bèta-modellen
Een SDF die lineair is in een paar factoren, is hetzelfde als een bèta-model op die factoren. Een overrendement kost niets, dus moet gelden, en die verwachting valt uiteen in het product van de gemiddelden plus een covariantie. Is lineair in factoren, dan zijn die covarianties, op een schaal na, gelijk aan bèta’s. Een activum dat verliest wanneer hoog is, moet daardoor een hoger gemiddeld rendement bieden.
Volgens (9) is de premie van een factor een gewogen som van alle gewichten in , met als weging de covariantie van die factor met elk van de andere. Het minteken staat er omdat een hoge slechte tijden aangeeft. Met alleen overrendementen ligt de schaal van niet vast, dus normaliseren we tot , zoals in Theorem 1. Dan wordt de vertaalsleutel
Vergelijking (10) vertaalt gewichten in premies met de covariantiematrix van de factoren. Voor een verhandelde factor is de premie gelijk aan zijn gemiddelde overrendement, zodat . In de simulatie geeft dat voor markt, SMB en HML gewichten van ongeveer 3,5, 0,65 en 4,9.
Daarmee past de hele eerste helft van dit boek in één tabel. Het subscript bij staat daarin voor de markt, niet voor de SDF.
| Model | factoren in | wat de theorie over zegt | college |
|---|---|---|---|
| CAPM | ; de markt is | Het CAPM | |
| consumptie-CAPM | (lineair benaderd) | is de risicoaversie , volgt uit de tijdsvoorkeur en | Lucas, Breeden en de SDF |
| ICAPM | en toestandsvariabelen | gewichten uit hedgebehoeften; welke zegt de theorie niet | Merton: continue tijd en het ICAPM |
| APT | dominante covariantierichtingen | vrij; alleen klein | Ross, APT en de fundamentele stelling |
| FF3 | , SMB, HML | want verhandeld | Fama-French 1992/1993 |
De derde kolom zegt van boven naar beneden steeds minder over , want het consumptie-CAPM legt vast met een voorkeursparameter, terwijl voor FF3 alleen de eis overblijft dat een verhandelde factor zichzelf goed waardeert. De modellen worden zo steeds minder een theorie die iets verbiedt, en steeds meer een beschrijving van feiten.
4.5De prijs van risico tegenover de premie 
Premie en gewicht meten iets anders, wat zichtbaar wordt als een onderzoeker een factor toevoegt die sterk met HML meebeweegt. Die factor krijgt een premie, omdat hij in dezelfde slechte tijden verliest als HML. De premie is de beloning per eenheid bèta en is niet nul zodra de factor met de SDF samenhangt, ook via een andere factor. Het gewicht meet de eigen bijdrage van factor , gegeven alle andere. Zit alleen HML in , dan heeft de nieuwe factor een grote en een van nul.
De tweede verwachting uit de intuïtie komt dus uit, want hoe sterker een overbodige factor met een factor uit correleert, hoe groter zijn premie, terwijl zijn gewicht nul blijft. Cochrane concludeert daarom dat een onderzoeker die wil weten of een factor nodig is, toetst en niet Cochrane (2005). De simulatie bouwt dat voorbeeld na.
4.6GMM voor lineaire SDF-modellen
Omdat lineair is in , wordt GMM een gewogen regressie van gemiddelde overrendementen op hun covarianties met de factoren, zonder intercept, en die schatter levert straks de simulatie en tabel (1) van de replicatie. Het is dezelfde soort momentvoorwaarde als de Euler-vergelijking van Lucas, Breeden en de SDF. Neem waarnemingen, testactiva, bijvoorbeeld 25 size/BM-portefeuilles, en het steekproefgemiddelde van de factoren. De momenten zijn dan
De prijsfout is dus het gemiddelde overrendement min het deel dat de covarianties verklaren. Minimaliseren van geeft
een gewogen regressie van op de kolommen van . De eerste stap neemt en de tweede , met de geschatte covariantiematrix van de momenten uit Theorem 3. Onder het model is dan -verdeeld.
Ook is geschat, en de afgeleide van het moment naar is . Daarom bouwen we uit
waarin de tweede term corrigeert voor de geschatte factorgemiddelden. Die correctie is klein, omdat klein is ten opzichte van de rendementen zelf. De variantie van de schatter is . De premies zijn , waarbij we als bekend behandelen. Dat mag, omdat een covariantiematrix na een paar honderd maanden veel nauwkeuriger gemeten is dan een gemiddelde.
4.7Stelling 4: de Hansen-Jagannathan-afstand
De Hansen-Jagannathan-afstand meet hoe ver de SDF van een model van de dichtstbijzijnde geldige SDF ligt. Die afstand is tegelijk de grootste prijsfout van het model op een portefeuille met norm één. Met genoeg data verwerpt elk model, dus is de bruikbare vraag hoe fout een model is. Anders dan bij is de weegmatrix voor alle modellen dezelfde, zodat een model zijn afstand niet kan verkleinen door ruisiger momenten.
Proof 6
Stap 1: de afstand is de lengte van het deel in de payoff-ruimte. Door Theorem 1 is . Schrijf met en . Voor met is , minimaal bij , met waarde . Nu is met , dus .
Stap 2: dezelfde waarde is de grootste prijsfout. Een payoff heeft prijsfout en norm . Cauchy-Schwarz in het -inproduct geeft , met gelijkheid voor .
Volgens (15) volgt de afstand alleen uit de prijsfouten en de tweede momenten van de payoffs. Met overrendementen is en . Een afstand van 0,3 in maanddata betekent een prijsfout van 30% per maand op een portefeuille met , dus 1,5% per maand bij een volatiliteit van 5%. Een model kan verlagen door op te blazen, maar niet, omdat de afstand een ruisige kandidaat niet beloont Hansen & Jagannathan (1997).
In een steekproef is ook voor het ware model groter dan nul, dus moeten we weten hoe groot die ruisbodem is voordat we een geschatte afstand beoordelen. Onder een juist model is met . Daardoor is een gewogen som van -variabelen, met als gewichten de eigenwaarden van , zodat we de -waarde door simulatie vinden. De ruisbodem ligt ongeveer bij , voor 35 portefeuilles en 757 maanden dus rond 0,2. Zolang dicht bij ligt, zijn de gewichten namelijk ongeveer één, zodat .
Conditionele modellen zijn ook factormodellen
Vermenigvuldig met een signaal dat op bekend is, bijvoorbeeld de dividend-prijsratio. Onvoorwaardelijke verwachtingen geven dan , zodat een conditioneel model een onvoorwaardelijk model op een grotere payoff-ruimte is Hansen & Richard (1987). Een CAPM met en lineair in wordt zo een model met factoren , en . Jagannathan en Wang Jagannathan & Wang (1996) verklaarden op die manier, met menselijk kapitaal erbij, een groot deel van de spreiding in gemiddelde rendementen. De tweede oefening schat zo’n model.
5Simulatie: een overbodige factor met een significante premie
Hoe vaak lijkt een overbodige factor nodig als een onderzoeker naar de premie van die factor kijkt, en hoe vaak als hij naar het gewicht kijkt? We bouwen een economie waarin FF3 de ware SDF geeft, met correlaties van 0,3 tussen markt en SMB en van tussen markt en HML. De overige kalibratie staat in de tabel en volgt de orde van grootte van echte maanddata, want drie toestanden zijn te weinig voor een GMM-schatting.
| per maand | markt | SMB | HML |
|---|---|---|---|
| gemiddelde | 0,60% | 0,20% | 0,35% |
| volatiliteit | 4,5% | 3,0% | 3,0% |
| ladingen van de 25 testactiva | rond 1 | van 1,2 tot −0,2 | van −0,4 tot 0,8 |
De testactiva hebben precies . Ze laden bovendien met op een schok zonder premie, met een volatiliteit van 3%, zoals een contrast tussen bedrijfstakken. Die schok speelt de rol van uit het toy-voorbeeld, want hij beweegt rendementen zonder een prijs te veranderen. De onderzoeker krijgt een vierde, verhandelde factor aangeboden, . Die is overbodig (), maar correleert met HML en heeft daardoor een premie per maand.
We schatten het vierfactormodel op 1000 steekproeven van vijftig jaar, met tweestaps-GMM en met Fama-MacBeth zonder intercept. De eerste cel definieert de schatters volgens (13) en (15).
# TODO: naar hap.stats (GMM for linear SDF models, HJ distance, Fama-MacBeth without intercept)
CHI2_DRAWS = rng.chisquare(1, (4000, 50))          # shared draws for weighted chi-square p-values


def linear_sdf_gmm(Re, F, weight="efficient"):
    """GMM for m = 1 - b'(f - E f) on excess returns Re (T x N) and factors F (T x K).

    weight = "efficient": two-step GMM, J test.  weight = "hj": W = E[Re Re']^-1,
    Hansen-Jagannathan distance with a simulated p-value.  Standard errors account for
    the estimated factor means; lambda = Sigma_f b treats Sigma_f as known.
    """
    T, N = Re.shape
    Fc = F - F.mean(axis=0)
    ebar = Re.mean(axis=0)
    C = Re.T @ Fc / T                                      # Cov(R^e, f'), N x K

    def estimate(W):
        return np.linalg.solve(C.T @ W @ C, C.T @ W @ ebar)

    def spectral(b):
        h = Re * (1 - Fc @ b)[:, None] + np.outer(Fc @ b, ebar)
        return h.T @ h / T

    if weight == "hj":
        W = np.linalg.inv(Re.T @ Re / T)
    else:
        W = np.linalg.inv(spectral(estimate(np.eye(N))))
    b = estimate(W)
    S = spectral(b)
    V = np.linalg.inv(C.T @ W @ C)
    cov_b = V @ C.T @ W @ S @ W @ C @ V / T
    Sigma_f = Fc.T @ Fc / T
    g = ebar - C @ b
    out = {"b": b, "se_b": np.sqrt(np.diag(cov_b)), "lam": Sigma_f @ b,
           "se_lam": np.sqrt(np.diag(Sigma_f @ cov_b @ Sigma_f)), "g": g,
           "sd_m": np.sqrt(b @ Sigma_f @ b)}
    if weight == "hj":
        P = np.eye(N) - C @ V @ C.T @ W
        root = np.linalg.cholesky(W)
        weights = np.clip(np.linalg.eigvalsh(root.T @ P @ S @ P.T @ root), 0.0, None)
        out["hj"] = np.sqrt(g @ W @ g)
        # p-value: simulated weighted sum of chi2(1) draws, weights = eigenvalues above
        out["p_hj"] = np.mean(CHI2_DRAWS[:, :N] @ weights >= T * g @ W @ g)
    else:
        out["J"] = T * g @ W @ g
        out["p_J"] = stats.chi2.sf(out["J"], N - F.shape[1])
    return out


def fama_macbeth_no_const(Re, F):
    """Full-sample multiple-regression betas, then monthly cross-sections without intercept."""
    T = len(Re)
    betas = np.linalg.lstsq(np.column_stack([np.ones(T), F]), Re, rcond=None)[0][1:].T
    lam_t = np.linalg.lstsq(betas, Re.T, rcond=None)[0].T
    return lam_t.mean(axis=0), lam_t.std(axis=0, ddof=1) / np.sqrt(T)
De functie linear_sdf_gmm geeft , de premies en ofwel ofwel de
HJ-afstand terug. De volgende cel bouwt de economie en trekt de 1000 steekproeven.
mu_f = np.array([0.006, 0.002, 0.0035])
sd_f = np.array([0.045, 0.030, 0.030])
Sigma_f_true = np.array([[1.0, 0.3, -0.2], [0.3, 1.0, 0.0], [-0.2, 0.0, 1.0]]) * np.outer(sd_f, sd_f)
chol_f = np.linalg.cholesky(Sigma_f_true)
B_true = np.column_stack([1 + 0.1 * rng.standard_normal(25),
                          np.repeat(np.linspace(1.2, -0.2, 5), 5),
                          np.tile(np.linspace(-0.4, 0.8, 5), 5)])
gamma_u = 0.5 * rng.standard_normal(25)
sd_u, sd_eps = 0.03, 0.015
mu_R = B_true @ mu_f
b_ff3 = np.linalg.solve(Sigma_f_true, mu_f)


def draw_economy(T, unpriced_shock=True):
    """T months of FF3 factors, the unpriced shock u, and 25 test assets priced by FF3."""
    f = mu_f + rng.standard_normal((T, 3)) @ chol_f.T
    u = sd_u * rng.standard_normal(T)
    R = mu_R + (f - mu_f) @ B_true.T + sd_eps * rng.standard_normal((T, 25))
    if unpriced_shock:
        R = R + np.outer(u, gamma_u)
    return R, f, u


rows_a = []
for _ in range(1000):
    R, f, u = draw_economy(600)
    F4 = np.column_stack([f, f[:, 2] + u])                # Mkt, SMB, HML, g = HML + u
    est = linear_sdf_gmm(R, F4)
    lam_fm, se_fm = fama_macbeth_no_const(R, F4)
    rows_a.append({"t(b_HML)": est["b"][2] / est["se_b"][2], "t(b_g)": est["b"][3] / est["se_b"][3],
                   "t(lambda_g) GMM": est["lam"][3] / est["se_lam"][3], "t(lambda_g) FM": lam_fm[3] / se_fm[3],
                   "b_g": est["b"][3], "lambda_g FM (%)": 100 * lam_fm[3], "p_J": est["p_J"]})
sim_a = pd.DataFrame(rows_a)

print(f"ware b (FF3) = {b_ff3.round(2)}, ware b_g = 0, ware lambda_g = {100 * mu_f[2]:.2f}% per maand")
print(f"J verwerpt het ware model (5%) in {(sim_a['p_J'] < 0.05).mean():.1%} van de steekproeven")
t_cols = sim_a.filter(like="t(")
pd.DataFrame({"mediaan t": t_cols.median(), "fractie |t| > 1.96": (t_cols.abs() > 1.96).mean()}).round(3)
ware b (FF3) = [3.49 0.65 4.94], ware b_g = 0, ware lambda_g = 0.35% per maand
J verwerpt het ware model (5%) in 4.4% van de steekproeven
De tabel geeft per toets de mediane -waarde en hoe vaak . De toets op verwerpt in ongeveer 6% van de steekproeven, dicht bij de 5% van de nulhypothese. De premie is met beide methoden in ongeveer de helft van de steekproeven significant. verwerpt het ware model in 4,4% van de gevallen en heeft dus het juiste niveau. De figuur hieronder zet de twee verdelingen van -waarden naast de gestreepte grenzen bij .
Source
fig, ax = plt.subplots()
bins = np.linspace(-5, 7, 61)
ax.hist(sim_a["t(b_g)"], bins=bins, alpha=0.6, label="$t$ van $b_g$ (GMM)")
ax.hist(sim_a["t(lambda_g) FM"], bins=bins, alpha=0.6, label="$t$ van $\\lambda_g$ (Fama-MacBeth)")
for c in (-1.96, 1.96):
    ax.axvline(c, color="black", ls="--", lw=1)
ax.set_xlabel("$t$-waarde voor de overbodige factor $g$")
ax.set_ylabel("Aantal steekproeven")
ax.set_title("Een overbodige factor: premie vaak significant, gewicht in $m$ niet")
ax.legend()
plt.show()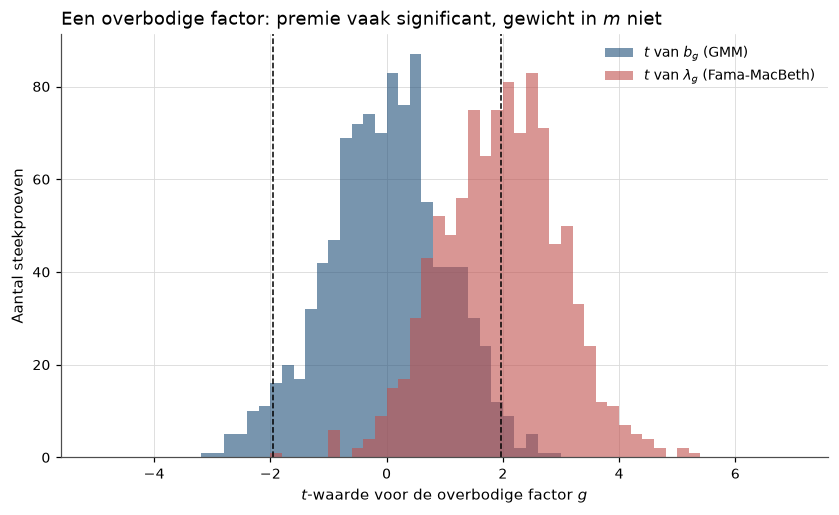
Figure 1:De factor voegt niets toe aan de ware SDF, maar correleert met HML. Zijn gewicht is zelden significant, zoals onder de nulhypothese hoort, maar zijn premie in de helft van de steekproeven, omdat hij terecht de premie van HML erft.
De -waarden van liggen rond nul en die van rond twee. De premie is niet fout geschat, want 0,35% per maand is de ware waarde, maar ze beantwoordt een andere vraag dan het gewicht. Dat ze maar in de helft van de steekproeven significant is, volgt uit de rekensom achter de standaardfout van 2%, want bij een factorvolatiliteit van 4,2% is de standaardfout na vijftig jaar per maand, de helft van de premie.
Hoe groot is een HJ-afstand door toeval alleen?
Dezelfde economie zonder laat zien hoe groot een geschatte HJ-afstand wordt als het model juist is. We schatten FF3 (waar) en het CAPM (fout) op 1000 steekproeven van twintig en van vijftig jaar.
Sigma_R = B_true @ Sigma_f_true @ B_true.T + sd_eps**2 * np.eye(25)
W_pop = np.linalg.inv(Sigma_R + np.outer(mu_R, mu_R))


def population_hj(columns):
    """Population HJ distance of the linear SDF in the selected true factors."""
    C = (B_true @ Sigma_f_true)[:, columns]
    b = np.linalg.solve(C.T @ W_pop @ C, C.T @ W_pop @ mu_R)
    g = mu_R - C @ b
    return np.sqrt(max(g @ W_pop @ g, 0.0))


rows_b = []
for T in (240, 600):
    for _ in range(1000):
        R, f, _ = draw_economy(T, unpriced_shock=False)
        ff3_fit, capm_fit = linear_sdf_gmm(R, f, "hj"), linear_sdf_gmm(R, f[:, :1], "hj")
        rows_b.append({"T": T, "HJ FF3": ff3_fit["hj"], "HJ CAPM": capm_fit["hj"],
                       "p FF3": ff3_fit["p_hj"], "p CAPM": capm_fit["p_hj"]})
sim_b = pd.DataFrame(rows_b)

print(f"populatie: HJ FF3 = {population_hj([0, 1, 2]):.3f}, HJ CAPM = {population_hj([0]):.3f}")
sim_b.assign(reject_ff3=sim_b["p FF3"] < 0.05, reject_capm=sim_b["p CAPM"] < 0.05).groupby("T").agg(**{
    "mediaan HJ FF3 (waar)": ("HJ FF3", "median"), "mediaan HJ CAPM (fout)": ("HJ CAPM", "median"),
    "verwerpt FF3 (5%)": ("reject_ff3", "mean"), "verwerpt CAPM (5%)": ("reject_capm", "mean"),
}).round(3)
populatie: HJ FF3 = 0.000, HJ CAPM = 0.142
In de populatie is de afstand van het CAPM 0,14, bij 5% volatiliteit een alpha van 0,7% per maand. Toch heeft het ware model na twintig jaar een mediane afstand van 0,31, dicht bij de ruisbodem, en verwerpt de toets het CAPM dan maar in een op de zes steekproeven. Een geschatte HJ-afstand hoort daarom naast de ruisbodem te staan, niet naast nul.
6Replicatie op echte data
We laden de portefeuilles en de factoren en kijken eerst naar het gemiddelde overrendement van de uiterste momentumdecielen.
ff5 = hap_data.french("F-F_Research_Data_5_Factors_2x3")
umd = hap_data.french("F-F_Momentum_Factor")["Mom"].rename("UMD")
rf = ff5["RF"]
size_bm = hap_data.french("25_Portfolios_5x5").sub(rf, axis=0)
momentum = hap_data.french("10_Portfolios_Prior_12_2").sub(rf, axis=0)
momentum.columns = [f"MOM {c}" for c in momentum.columns]

panel = (size_bm.join(momentum, how="inner")
         .join(ff5.drop(columns="RF"), how="inner").join(umd, how="inner")
         .loc["1963-07":"2026-07"])
assert panel.notna().all().all()
test_25, test_10 = list(size_bm.columns), list(momentum.columns)
test_35 = test_25 + test_10
models = {"CAPM": ["Mkt-RF"], "FF3": ["Mkt-RF", "SMB", "HML"], "FF3+UMD": ["Mkt-RF", "SMB", "HML", "UMD"]}
T_obs = len(panel)

mom_stats = hap.stats.summary_stats(panel[[test_10[0], test_10[-1]]])[["mean", "se_mean"]].astype(float) * 100
print(f"{panel.index[0]:%Y-%m} t/m {panel.index[-1]:%Y-%m}: T = {T_obs}, N = {len(test_35)}; "
      f"ruisbodem sqrt((N-K)/T) = {np.sqrt((35 - 1) / T_obs):.3f} (K = 1) tot {np.sqrt((35 - 4) / T_obs):.3f} (K = 4)")
mom_stats.rename(columns={"mean": "gem. overrendement (% p.m.)", "se_mean": "SE (% p.m.)"}).round(3)
1963-07 t/m 2026-07: T = 757, N = 35; ruisbodem sqrt((N-K)/T) = 0.212 (K = 1) tot 0.202 (K = 4)
De verliezers- en winnaarsdecielen verschillen ruim een procentpunt per maand, met standaardfouten van een kwart tot een derde procentpunt. Het momentumverschil is daarmee een van de weinige gemiddelden in de cross-sectie die de meetonzekerheid overleven. De ruisbodem ligt voor deze 35 portefeuilles tussen 0,20 en 0,21, afhankelijk van het aantal factoren.
6.1(1) SDF-schattingen, -toets en HJ-afstand
De eerste tabel schat elk model op de 25 size/BM-portefeuilles alleen en op alle 35, met , de HJ-afstand en de gemiddelde absolute prijsfout.
fits, summary_rows = {}, {}
for tests_label, tests in {"25 size/BM": test_25, "25 size/BM + 10 momentum": test_35}.items():
    Re = panel[tests].to_numpy()
    for name, cols in models.items():
        F = panel[cols].to_numpy()
        eff, hj = linear_sdf_gmm(Re, F), linear_sdf_gmm(Re, F, "hj")
        fits[(tests_label, name)] = eff
        row = {"J": eff["J"], "df": len(tests) - len(cols), "p(J)": eff["p_J"],
               "HJ-afstand": hj["hj"], "p(HJ)": hj["p_hj"],
               "gem. |fout| 25 (% p.m.)": 100 * np.abs(hj["g"][:25]).mean()}
        if len(tests) == 35:
            row["gem. |fout| 10 mom. (% p.m.)"] = 100 * np.abs(hj["g"][25:]).mean()
        summary_rows[(tests_label, name)] = row
pd.DataFrame(summary_rows).T.round(3)Op alle 35 portefeuilles verwerpt elk model, en de HJ-afstanden dalen maar van 0,41 naar 0,36, zodat ze dicht bij elkaar en ruim boven de ruisbodem liggen. Op de 25 portefeuilles alleen laat FF3+UMD nog met door, omdat de tien momentumportefeuilles de toets strenger maken. Dat ook FF3 op de 25 portefeuilles alleen verwerpt, komt door de fout in de hoek klein-groei uit Fama-French 1992/1993.
FF3 brengt de prijsfout op de 25 size/BM-portefeuilles terug tot ruim een tiende procentpunt per maand. Op de momentumportefeuilles is de fout ruim twee keer zo groot, en zelfs groter dan onder het CAPM. Winnaars hebben namelijk een negatieve HML-lading, zoals de derde oefening van Fama-French 1992/1993 laat zien, zodat HML hun voorspelde rendement verlaagt. De tweede tabel geeft per model de gewichten , de premies en het gemiddelde van elke factor.
b_rows = {}
for name, cols in models.items():
    est = fits[("25 size/BM + 10 momentum", name)]
    for j, col in enumerate(cols):
        b_rows[(name, col)] = {"b": est["b"][j], "t(b)": est["b"][j] / est["se_b"][j],
                               "lambda (% p.m.)": 100 * est["lam"][j], "t(lambda)": est["lam"][j] / est["se_lam"][j],
                               "gem. factor (% p.m.)": 100 * panel[col].mean()}
pd.DataFrame(b_rows).T.round(2)UMD halveert de prijsfout op de momentumportefeuilles, met een -waarde van 4,6 voor zijn . De premies liggen meestal dicht bij het gemiddelde van de factor, zoals uit Theorem 1 volgt voor verhandelde factoren. SMB in FF3+UMD is de uitzondering, met een premie van 0,32% tegen een gemiddelde van 0,19% per maand.
6.2(2) De geschatte SDF en de Hansen-Jagannathan-grens
De geschatte SDF is een portefeuille van de factoren. Als het model de gemiddelden van verhandelde factoren precies waardeert, is , de tangentgewichten uit (13). Dan is de maximale Sharpe-ratio van de factoren, en haalt de SDF de Hansen-Jagannathan-grens met gelijkheid. Omdat GMM ook de testactiva moet waarderen, geldt dat hier maar bij benadering, en de tabel zet alle maten met op jaarbasis.
mkt = panel["Mkt-RF"]
all_returns = panel[test_35 + models["FF3+UMD"]].to_numpy()
mean_all = all_returns.mean(axis=0)
sr_max_35 = np.sqrt(12 * mean_all @ np.linalg.solve(np.cov(all_returns, rowvar=False, bias=True), mean_all))

bound_rows = {}
for name, cols in models.items():
    F = panel[cols].to_numpy()
    mu = F.mean(axis=0)
    bound_rows[f"factor-SDF {name}"] = {
        "sigma(m)/E[m] per jaar": np.sqrt(12) * fits[("25 size/BM + 10 momentum", name)]["sd_m"],
        "max. Sharpe van de factoren per jaar": np.sqrt(12 * mu @ np.linalg.solve(np.cov(F, rowvar=False, bias=True).reshape(len(cols), len(cols)), mu)),
    }
bound_rows["Sharpe-ratio markt"] = {"sigma(m)/E[m] per jaar": np.nan,
                                    "max. Sharpe van de factoren per jaar": np.sqrt(12) * mkt.mean() / mkt.std(ddof=0)}
sd_m_consumption = 10 * 0.036                          # gamma * sigma(dc), see 03_13
bound_rows["consumptie-SDF, gamma = 10, sigma(dc) = 3,6%"] = {"sigma(m)/E[m] per jaar": sd_m_consumption,
                                                              "max. Sharpe van de factoren per jaar": np.nan}
bound_rows["HJ-grens, 35 portefeuilles + 4 factoren"] = {
    "sigma(m)/E[m] per jaar": np.nan, "max. Sharpe van de factoren per jaar": sr_max_35}
b_umd = fits[("25 size/BM + 10 momentum", "FF3+UMD")]["b"]
F_umd = panel[models["FF3+UMD"]]
m_hat = 1 - (F_umd - F_umd.mean()) @ b_umd
print(f"maanden met m-dak < 0 (FF3+UMD): {(m_hat < 0).mean():.1%}; min = {m_hat.min():.2f} in {m_hat.idxmin():%Y-%m}, "
      f"max = {m_hat.max():.2f} in {m_hat.idxmax():%Y-%m}")
pd.DataFrame(bound_rows).T.round(3)
maanden met m-dak < 0 (FF3+UMD): 0.3%; min = -0.40 in 1976-01, max = 2.47 in 2001-01
De tabel zet de volatiliteit van elke factor-SDF naast de maximale Sharpe-ratio van dezelfde factoren, en de twee kolommen liggen dicht bij elkaar. De FF3+UMD-SDF schommelt met 1,04 per jaar ongeveer honderd procent. De consumptie-SDF met haalt met 0,36 niet eens de Sharpe-ratio van de markt. Links in de figuur staan de balken naast de gestreepte grens, en rechts volgt de geschatte SDF door de tijd, met zijn pieken en de maanden onder nul.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3), gridspec_kw={"width_ratios": [1, 1.6]})
labels = ["consumptie\n$\\gamma = 10$", "markt\n(Sharpe)", "SDF\nCAPM", "SDF\nFF3", "SDF\nFF3+UMD"]
values = [sd_m_consumption, np.sqrt(12) * mkt.mean() / mkt.std(ddof=0)] + [
    np.sqrt(12) * fits[("25 size/BM + 10 momentum", n)]["sd_m"] for n in models]
axes[0].bar(labels, values, color=[hap.plotting.COLORS[7]] * 2 + [hap.plotting.COLORS[0]] * 3)
axes[0].axhline(sr_max_35, color=hap.plotting.COLORS[1], ls="--", lw=1.4,
                label="HJ-grens, 35 portefeuilles (binnen de steekproef)")
axes[0].set_ylabel("$\\sigma(m)/E[m]$ of Sharpe-ratio, per jaar")
axes[0].set_xlabel("Kandidaat")
axes[0].set_title("Hoe volatiel moet $m$ zijn?")
axes[0].legend(loc="upper left")

axes[1].plot(m_hat.index, m_hat, lw=0.8, color=hap.plotting.COLORS[0])
axes[1].axhline(0, color="black", lw=0.8)
hap.plotting.recession_shading(axes[1])
axes[1].set_xlabel("Jaar")
axes[1].set_ylabel("$\\hat m_t$")
axes[1].set_title("De geschatte SDF van FF3+UMD, met NBER-recessies")
fig.tight_layout()
plt.show()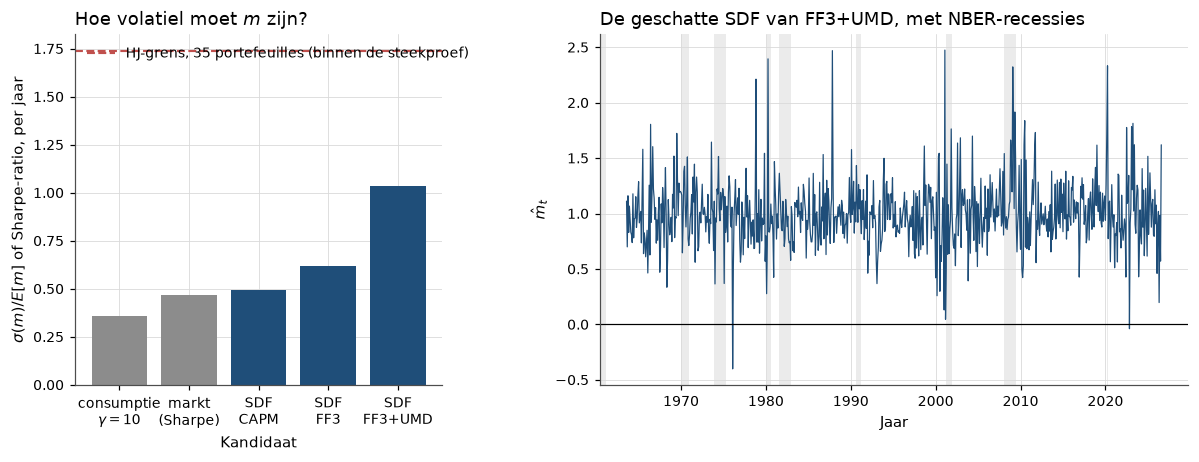
Figure 2:Links haalt de consumptie-SDF met de Sharpe-ratio van de markt niet (Mehra-Prescott en Hansen-Jagannathan), terwijl de factor-SDF’s die halen, FF3 en FF3+UMD ruim. Ze blijven onder de grens van de 35 portefeuilles, die door overfitting overschat is. Rechts piekt de geschatte SDF in maanden waarin de markt valt of momentum crasht, en is ze een enkele keer negatief.
Het contrast met de consumptie-SDF is groot, want die haalde de Sharpe-grens van de markt pas bij , met een rente van dertig procent (Mehra-Prescott en Hansen-Jagannathan). Een SDF uit vier factorportefeuilles haalt die grens moeiteloos, maar niemand kan zeggen welk risico of welke voorkeur erachter zit. Het maximum valt in januari 2001, bij een momentumcrash, en in januari 1976 is de SDF negatief. Een negatieve SDF waardeert de testactiva goed, maar geeft sommige opties op de factoren een negatieve prijs (Remark 1).
6.3(3) tegenover : is HML overbodig?
De laatste tabel voegt RMW en CMA toe en zet het gewicht van elke factor naast zijn premie volgens GMM en volgens Fama-MacBeth.
Re35 = panel[test_35].to_numpy()
lambda_rows = {}
for name, cols in {"FF3+UMD": models["FF3+UMD"],
                   "FF5+UMD": ["Mkt-RF", "SMB", "HML", "RMW", "CMA", "UMD"]}.items():
    F = panel[cols].to_numpy()
    est = linear_sdf_gmm(Re35, F)
    lam_fm, se_fm = fama_macbeth_no_const(Re35, F)
    for j, col in enumerate(cols):
        lambda_rows[(name, col)] = {"b": est["b"][j], "t(b)": est["b"][j] / est["se_b"][j],
                                    "lambda GMM (% p.m.)": 100 * est["lam"][j],
                                    "t(lambda) GMM": est["lam"][j] / est["se_lam"][j],
                                    "lambda FM (% p.m.)": 100 * lam_fm[j], "t(lambda) FM": lam_fm[j] / se_fm[j]}
    lambda_rows[(name, "J (p)")] = {"b": est["J"], "t(b)": est["p_J"]}
pd.DataFrame(lambda_rows).T.round(2)In FF3+UMD hebben markt, HML en UMD een significante én , terwijl SMB geen significante heeft. Met RMW en CMA erbij gebeurt met HML wat Proposition 1 voorspelt. De premie blijft significant met GMM en met Fama-MacBeth, maar het gewicht niet.
HML hangt dus samen met de SDF, maar voegt gegeven RMW en CMA weinig toe, en dat is de overbodigheid van Fama en French uitgedrukt in . Het gewicht verschuift naar RMW () en, onnauwkeurig, naar CMA. Een onderzoeker die alleen de Fama-MacBeth-kolom las, zou het omgekeerde concluderen, namelijk dat HML nodig is en CMA met een premie van nul overbodig. De tabel hieronder zet de verwachtingen uit het replicatieblok naast de uitkomsten.
| verwachting | hier |
|---|---|
| verwerpt het CAPM, | op 25 en op 35 portefeuilles |
| UMD halveert de FF3-fout op momentum, | van 0,264 naar 0,124% per maand, |
| HJ-afstand daalt en blijft boven de ruisbodem van 0,2 | 0,410, 0,394 en 0,361 |
| SDF-volatiliteit FF3+UMD boven 0,8 en onder de grens | 1,036 per jaar, grens 1,738 |
| FF5+UMD: significant, niet | en , |
Geslaagd. Alle vijf verwachtingen uit het replicatieblok komen uit, en geen teken draait om. De replicatie bevestigt de rangorde van de modellen en laat ook zien hoe dicht hun afstanden bij elkaar liggen.
7Wat er brak, en wat daarna kwam
Wat het raamwerk verklaart. Alles wat in dit boek tot hier gebeurde, past in één taal. CAPM, consumptie-SDF, APT en Fama-French zijn uitspraken over . Frontier, bèta en SDF zijn drie vormen van dezelfde meetkunde, en GRS, Fama-MacBeth en de Euler-GMM zijn momentvoorwaarden met een andere weging. Het raamwerk leverde gereedschap dat bleef, namelijk de HJ-grens voor economische modellen, de HJ-afstand om foute modellen te rangschikken, en tegenover om te bepalen welke factor nodig is.
Waar het breekt. Het raamwerk zegt niet welke de juiste is. Op onze 35 portefeuilles verwerpt zelfs FF3+UMD, en de HJ-afstanden van drie heel verschillende modellen liggen dicht bij elkaar en ruim boven de ruisbodem. De factor-SDF die de activa het best waardeert, schommelt ongeveer honderd procent per jaar en heeft geen economische interpretatie. De consumptie-SDF heeft die interpretatie wel, maar haalt de grens niet. Prijzen verklaren en prijzen begrijpen zijn zo twee verschillende projecten geworden.
Risico of vergissing? De SDF-taal is neutraal, en daarin zit zowel de kracht als de beperking ervan. In de Chicago-lezing is hoog in recessies en crashes, zodat markt, value en momentum beloningen zijn voor risico in slechte tijden. In de Yale-lezing is een SDF niets meer dan een gewichtenvector die de gemeten gemiddelden reproduceert. Als beleggers systematisch dezelfde vergissing maken over groei, bestaat er ook een lineaire die de activa dan even goed waardeert, met dezelfde covarianties met de factoren. Beide lezingen voorspellen dezelfde en HJ-afstand, en alleen een onafhankelijke meting van de marginale waarde van geld zou ze scheiden. Voor een belegger blijft de vraag die Pedro Santa-Clara in zijn terugblik stelt (Opzet, data en conventies): draagt de koper van de tangentportefeuille een risico met een premie, of denkt hij iets te weten wat de prijs niet weet?
Wat er daarna kwam. Drie onderzoeksprogramma’s probeerden een economische te bouwen die volatiel genoeg is om de Hansen-Jagannathan-grens te halen zonder de rente te laten ontsporen: gewoontevorming, langetermijnrisico en rampen, in Habit, long-run risk en rampen.
8Oefeningen
Solution to Exercise 1
(1) De put keert alleen in toestand 3 uit, dus . Bij is dat , en voor ligt de prijs tussen en .
(2) Met één risicovol activum is de lijn door . De projectie van de constante daarop is .
put = np.array([0.0, 0.0, 0.5])
k_bounds = np.array([-0.75, 0.95])
Re_a = R_a - R_f
Re_star = E(Re_a) / E(Re_a**2) * Re_a
put_bounds = [E((x_star + k * eps) * put) for k in k_bounds]
print(f"prijs put met x*: {E(x_star * put):.5f}; interval bij positieve m: ({put_bounds[0]:.4f}, {put_bounds[1]:.4f})")
print(f"E[R^e] = {E(Re_a):.5f}, E[R^e* R^e] = {E(Re_star * Re_a):.5f}")
prijs put met x*: 0.14375; interval bij positieve m: (0.0500, 0.2625)
E[R^e] = 0.05848, E[R^e* R^e] = 0.05848
De code bevestigt beide antwoorden. De prijzen leggen en de frontier vast, maar de prijs van alles buiten de payoff-ruimte hangt af van een keuze van die de data niet maken. Een prijsmodel is precies zo’n keuze.
Solution to Exercise 2
(1) Uitschrijven geeft , een lineair model met factoren , en . Met de geschaalde payoffs als testactiva komen de momenten uit de note erbij, maar de code hieronder houdt de 35 portefeuilles als testactiva.
dp = hap_data.goyal_welch("monthly")["dp"]
z = dp.shift(1).reindex(panel.index).loc[:"2025-12"]
z = (z - z.mean()) / z.std()
sub = panel.loc[z.index]
cond_factors = pd.DataFrame({"Mkt-RF": sub["Mkt-RF"], "z": z, "z x Mkt-RF": z * sub["Mkt-RF"]})
candidates = {"CAPM": sub[["Mkt-RF"]], "conditioneel CAPM": cond_factors, "FF3": sub[models["FF3"]]}
rows_ex2 = {}
for name, frame in candidates.items():
    eff, hj = linear_sdf_gmm(sub[test_35].to_numpy(), frame.to_numpy()), linear_sdf_gmm(sub[test_35].to_numpy(), frame.to_numpy(), "hj")
    rows_ex2[name] = {"J": eff["J"], "p(J)": eff["p_J"], "HJ": hj["hj"], "gem. |fout| (% p.m.)": 100 * np.abs(hj["g"]).mean(),
                      "t(b) laatste factor": eff["b"][-1] / eff["se_b"][-1]}
pd.DataFrame(rows_ex2).T.round(3)(2) Het conditionele CAPM verlaagt de gemiddelde prijsfout nauwelijks en blijft ver boven FF3, terwijl het nog steeds verwerpt. Leerzaam is het contrast tussen de twee maten, want daalt van 127 naar 55, terwijl de HJ-afstand maar een paar procent daalt. Extra ruisige factoren blazen op en verlagen zo , maar niet . (3) Ja, heeft een -waarde van . Een conditioneel model is in de SDF-taal dus een onvoorwaardelijk model met meer factoren, en hoort met dezelfde meetlat te worden beoordeeld als elk ander factormodel.
Solution to Exercise 3
def cs_r2(Re, F):
    """Cross-sectional OLS R^2 of mean excess returns on full-sample betas, with intercept."""
    T = len(Re)
    betas = np.linalg.lstsq(np.column_stack([np.ones(T), F]), Re, rcond=None)[0][1:].T
    Z = np.column_stack([np.ones(Re.shape[1]), betas])
    means = Re.mean(axis=0)
    resid = means - Z @ np.linalg.lstsq(Z, means, rcond=None)[0]
    return 1 - resid.var() / means.var()


factor_arrays = {name: panel[cols].to_numpy() for name, cols in models.items()}
point = {name: cs_r2(Re35, F) for name, F in factor_arrays.items()}
boot = []
for _ in range(500):
    idx = rng.integers(0, T_obs, T_obs)
    boot.append({name: cs_r2(Re35[idx], F[idx]) for name, F in factor_arrays.items()})
boot = pd.DataFrame(boot)
diffs = {"FF3+UMD - FF3": boot["FF3+UMD"] - boot["FF3"], "FF3 - CAPM": boot["FF3"] - boot["CAPM"]}
print("R2:", {k: round(v, 3) for k, v in point.items()})
pd.DataFrame({k: v.quantile([0.05, 0.5, 0.95]) for k, v in diffs.items()}).T.round(3)
R2: {'CAPM': np.float64(0.11), 'FF3': np.float64(0.496), 'FF3+UMD': np.float64(0.758)}
De bootstrap schat de bèta’s per steekproef opnieuw, als ruwe versie van de inferentie van Kan, Robotti en Shanken. De stijgt van 0,11 via 0,50 naar 0,76, en beide verschillen zijn in meer dan 95% van de steekproeven positief. Het interval is wel breed, zodat de 26 procentpunt die UMD in de puntschatting toevoegt, verenigbaar is met acht en met ruim veertig.
De HJ-afstanden gaven dezelfde rangorde, maar lagen dicht bij elkaar. Een hoge met vrij intercept kan bovendien samengaan met verkeerde premies (Proposition 1). Een rangorde van modellen is dus pas een resultaat als ze de steekproefonzekerheid overleeft.
- Hansen, L. P., & Richard, S. F. (1987). The Role of Conditioning Information in Deducing Testable Restrictions Implied by Dynamic Asset Pricing Models. Econometrica, 55(3). 10.2307/1913601
- Hansen, L. P., & Jagannathan, R. (1997). Assessing Specification Errors in Stochastic Discount Factor Models. The Journal of Finance, 52(2), 557–590. 10.1111/j.1540-6261.1997.tb04813.x
- Cochrane, J. H. (2005). Asset Pricing (Revised). Princeton University Press.
- Kan, R., Robotti, C., & Shanken, J. (2013). Pricing Model Performance and the Two-Pass Cross-Sectional Regression Methodology. The Journal of Finance, 68(6), 2617–2649. 10.1111/jofi.12035
- Jagannathan, R., & Wang, Z. (1996). The Conditional CAPM and the Cross-Section of Expected Returns. The Journal of Finance, 51(1), 3–53. 10.1111/j.1540-6261.1996.tb05201.x
- Fama, E. F., & French, K. R. (2015). A Five-Factor Asset Pricing Model. Journal of Financial Economics, 116(1), 1–22. 10.1016/j.jfineco.2014.10.010
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD