

Fama en de efficiënte markt
1Overzicht
Een prijs weerspiegelt alle informatie als niemand met die informatie een hoger rendement kan verwachten dan beleggers voor wachten en risico eisen. Omdat dat vereiste rendement nergens vastligt, is efficiëntie alleen te toetsen samen met een model ervan. Dat werken we in dit college in vijf stappen uit:
we rekenen met de hand een markt door waarin de prijs onder risiconeutraliteit onvoorspelbaar is en onder risicoaversie niet, zonder dat iemand zich vergist;
we bewijzen de stelling van Samuelson en laten zien dat elk patroon van voorspelbaarheid een rationele verklaring heeft;
we delen de toetsen in naar de drie vormen van Fama, de zwakke, de semi-sterke en de sterke;
we simuleren een rationele economie waarin een onderzoeker met het verkeerde model toch inefficiëntie vindt;
we repliceren de filterregels van Fama en Blume en, kort, de fondsalpha’s van Jensen.
In 1965 verscheen het proefschrift van Eugene Fama in zijn geheel in het januarinummer van de Journal of Business, tweeënzeventig pagina’s over de dagrendementen van de dertig Dow Jones-aandelen Fama (1965). In hetzelfde voorjaar bewees Paul Samuelson dat goed voorziene prijzen willekeurig bewegen Samuelson (1965). Fama leverde zo de metingen en het woord, en Samuelson het bewijs dat onvoorspelbaarheid een eigenschap is van goed gevormde verwachtingen en niet van de natuur. In 1970 bracht Fama beide samen in een overzichtsartikel Fama (1970), waarmee het tijdvak dat in 1965 begon, werd afgesloten. Dat artikel maakte van de random walk een hypothese over markten en informatie, met drie vormen waarin twintig jaar empirisch werk werd ingedeeld.
Ook de vraag theorie of feit krijgt hier een ongewoon antwoord. De efficiënte-markthypothese is wel een theorie die op toetsing wacht, maar ze verbiedt pas iets als er een model van risico naast staat.
2Intuïtie: waarom zou dit waar zijn?
Fama beschreef een efficiënte markt eerst in woorden Fama (1965). Veel rationele beleggers concurreren om de toekomstige waarde van aandelen te voorspellen, en belangrijke informatie is voor iedereen bijna gratis. Ziet zo’n belegger een voorspelbare winst, dan koopt hij tot die winst weg is. De prijsbeweging die daarna overblijft, komt door nieuws, en omdat nieuws is wat nog niemand wist, is die beweging onvoorspelbaar.
Maar winst ten opzichte van wat? Niemand houdt een aandeel voor een verwacht rendement van nul, want beleggers eisen een vergoeding voor wachten en voor risico, en die vergoeding mag in de tijd bewegen. Stel dat beleggers in een recessie minder risico kunnen dragen. Dan daalt de koers, tot het verwachte rendement hoog genoeg is om iemand het aandeel te laten houden.
Na een daling is het verwachte rendement dan hoger dan na een stijging, zodat het rendement voorspelbaar is terwijl niemand zich vergist. Of een patroon een inefficiëntie is, hangt dus af van het vereiste rendement, het verwachte rendement dat het evenwicht voor het risico voorschrijft. Verwerpen de data “efficiëntie plus mijn model van risico”, dan weet niemand welk van de twee faalt.
Er zit ook een paradox in het mechanisme. Als prijzen alle informatie perfect weerspiegelen, verdient niemand iets aan het verzamelen ervan, zodat niemand de informatie nog verzamelt en de prijs ze ook niet kan weerspiegelen Grossman & Stiglitz (1980). Samen leveren deze argumenten drie verwachtingen op, die we in de theorie een voor een nagaan:
Een prijs die de verwachting van een latere uitbetaling is, verandert onvoorspelbaar, ook als die uitbetaling zelf voorspelbaar is.
Met risicoaversie is het verwachte rendement wel voorspelbaar, en hoger na slecht nieuws, zonder dat iemand een fout maakt.
Als informatie geld kost, is een markt bruto nooit helemaal efficiënt, alleen na aftrek van kosten.
3Toy-voorbeeld: één aandeel, twee perioden, één stuk nieuws
Hetzelfde aandeel is een martingaal onder risiconeutraliteit en geen martingaal onder risicoaversie. Voordat we dat nagaan, laden we de pakketten voor het hele college.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Er zijn drie tijdstippen, . Het aandeel betaalt alleen op een dividend . Op komt publiek nieuws, goed of slecht, elk met kans . Het nieuws bepaalt welke twee dividenden daarna mogelijk zijn, elk weer met kans . De rente is nul, dus het bruto risicovrije rendement is . Anders dan in Opzet, data en conventies is in dit college bruto.
| nieuws op | als het meezit | als het tegenzit | |
|---|---|---|---|
| goed | 140 | 100 | 120 |
| slecht | 100 | 60 | 80 |
Het recept. De prijs is de kansgewogen som van de payoffs, elk vermenigvuldigd met een gewicht dat van de toestand afhangt, zodat . Dat gewicht heet de stochastic discount factor (SDF, stochastische disconteringsfactor: hoeveel een euro in die toestand waard is). De payoff is op en op .
Stap 1, risiconeutraal (). Dan is , en . Omdat , is de prijs een martingaal en is elk verwacht rendement nul.
Stap 2, risicoavers. Nu is in de gunstige uitkomst van elke periode (goed nieuws op , meezitten op ) en in de ongunstige, zodat een euro meer waard is als het tegenzit. Omdat , blijft de rente nul. We rekenen achterwaarts terug:
Stap 3, verwachte rendementen. Nu is , zodat het verwachte rendement over de eerste periode is. Na goed nieuws is het , na slecht nieuws .
Vooruitblik. Met gewichten en in plaats van is . In de theorie heten die gewichten de risiconeutrale kansen.
Het verwachte rendement is dus hoger na een koersdaling. Een onderzoeker die een constant verwacht rendement aanneemt, ziet daarin een patroon, namelijk dat kopen na een daling loont. Toch vergist niemand zich, want de risicocorrectie is na goed en na slecht nieuws gelijk, . Alleen weegt 4 op een prijs van 76 relatief zwaarder dan op 116. De code rekent beide economieën door.
prob = 0.5
dividends = {"goed": (140.0, 100.0), "slecht": (100.0, 60.0)}  # (meezitten, tegenzitten)


def price(payoff_up, payoff_down, m=(1.0, 1.0)):
    """One-period price p = E[m x] with two equally likely states."""
    return prob * m[0] * payoff_up + prob * m[1] * payoff_down


def toy_economy(m):
    """Prices and expected returns in the two-period toy economy for SDF values m."""
    p1 = {news: price(*dividends[news], m=m) for news in dividends}
    p0 = price(p1["goed"], p1["slecht"], m=m)
    expected_p1 = prob * (p1["goed"] + p1["slecht"])
    q_up = prob * m[0] / (prob * m[0] + prob * m[1])       # risk-neutral probability
    return {
        "prijs op t=1, goed nieuws": p1["goed"],
        "prijs op t=1, slecht nieuws": p1["slecht"],
        "prijs op t=0": p0,
        "verwachte prijs op t=1": expected_p1,
        "verwacht rendement t=0 naar 1": expected_p1 / p0 - 1,
        "verwacht rendement na goed nieuws": np.mean(dividends["goed"]) / p1["goed"] - 1,
        "verwacht rendement na slecht nieuws": np.mean(dividends["slecht"]) / p1["slecht"] - 1,
        "verwachte prijs op t=1 onder q": q_up * p1["goed"] + (1 - q_up) * p1["slecht"],
    }


hand = {
    "prijs op t=1, goed nieuws": 116,
    "prijs op t=1, slecht nieuws": 76,
    "prijs op t=0": 92,
    "verwachte prijs op t=1": 96,
    "verwacht rendement t=0 naar 1": 0.0435,
    "verwacht rendement na goed nieuws": 0.0345,
    "verwacht rendement na slecht nieuws": 0.0526,
    "verwachte prijs op t=1 onder q": 92,
}
pd.DataFrame({
    "risiconeutraal, code": toy_economy((1.0, 1.0)),
    "risicoavers, met de hand": hand,
    "risicoavers, code": toy_economy((0.8, 1.2)),
}).round(4)De handberekening en de code geven dezelfde getallen, en in de risiconeutrale kolom vallen alle martingaalvarianten samen. Of “de prijs is een martingaal” waar is, hangt dus af van het model van risico dat erbij hoort. Die afhankelijkheid heet de joint hypothesis (gezamenlijke hypothese), en ze betekent dat elke toets van efficiëntie tegelijk een model van het vereiste rendement toetst.
4Theorie
We leiden vijf dingen af. Eerst geven we drie woorden voor onvoorspelbaar een scherpe betekenis. Dan volgt de kern, de stelling van Samuelson, die zegt dat een prijs die een voorwaardelijke verwachting is, onvoorspelbaar verandert. Voor aandelen geldt die onvoorspelbaarheid pas na weging met de SDF, en omdat die SDF vrij te kiezen is, past vervolgens elk patroon van voorspelbaarheid bij een SDF. Ten slotte bekijken we hoe efficiëntie getoetst wordt, met de drie vormen van Fama, de filterregel en de kosten van informatie.
4.1Opzet: drie woorden voor onvoorspelbaar
De vroege literatuur gebruikte drie woorden voor onvoorspelbaar door elkaar, hoewel ze niet hetzelfde betekenen Fama (1970). Laat de informatie zijn die op publiek is, bijvoorbeeld alle koersen tot en met vandaag, en . Fama schrijft waar wij schrijven.
Van random walk naar fair game zeggen de drie woorden steeds minder over wat een handelaar uit het verleden kan voorspellen. Bij een random walk helpt het verleden hem nergens bij, ook niet bij het voorspellen van de spreiding. Bij een fair game kan hij met het verleden alleen de afwijking van het vereiste rendement niet voorspellen, de spreiding bijvoorbeeld wel. Hoe zwakker de uitspraak, hoe meer van de werkelijkheid erin past.
Proof 1
(i) Onafhankelijkheid geeft . (ii) Met herhaalde verwachtingen is en . Kies voor de autocorrelatie van orde . (iii) Neem met i.i.d. standaardnormaal en met . Dan is , maar hangt van af.
Het tegenvoorbeeld in (iii) beschrijft de werkelijkheid, want volatiliteit clustert. De toetsen uit Regnault, Bachelier en de random walk meten eerste en tweede momenten, want een autocorrelatie vergelijkt het rendement met dat van eerder, en een variance ratio de variantie over meerdere perioden met die over één periode. Ze toetsen dus een gevolg van de fair game, namelijk de ongecorreleerdheid met de koersgeschiedenis uit deel (ii), maar geen onafhankelijkheid. Fama noemde onafhankelijkheid in 1970 dan ook overbodig voor de theorie Fama (1970).
4.2Het kernresultaat: de stelling van Samuelson
Een prijs die gelijk is aan de voorwaardelijke verwachting van een latere uitbetaling, verandert onvoorspelbaar, wat het onderliggende proces ook doet. Denk aan een handelaar in termijncontracten op tarwe. De termijnprijs is de beste schatting die de markt vandaag heeft van de spotprijs op de leverdatum. Verwacht de handelaar dat die schatting morgen stijgt, dan koopt hij vandaag, zodat de termijnprijs al vandaag stijgt. Alleen wat morgen nieuw is, kan de schatting dan nog verplaatsen.
Samuelson formuleerde de stelling voor een contract dat op de spotprijs uitbetaalt, bij een rente van nul en zonder risicopremie Samuelson (1965). Door die laatste aanname is de termijnprijs een verwachting onder de werkelijke kansen, net als in de risiconeutrale kolom van het toy-voorbeeld, waar was.
De verwachte verandering van de termijnprijs is dus nul, en geen functie van de informatie van vandaag kan die verandering voorspellen. Over de spotprijs is niets aangenomen, zodat die wel voorspelbaar mag zijn. Neem een spotprijs die naar zijn gemiddelde terugkeert, , met persistentie (hier 0,5) en een schok met variantie 1. Dan is en
De termijnprijs beweegt dus alleen met de schok van vandaag, en niet met de voorspelbare terugkeer van de spotprijs. De verandering van de spotprijs zelf heeft op wel een helling van . De cel simuleert 20 000 paden van twaalf perioden en schat beide hellingen.
phi, horizon, n_paths = 0.5, 12, 20_000
spot = np.empty((n_paths, horizon + 1))
spot[:, 0] = rng.normal(0.0, 1.0 / np.sqrt(1 - phi**2), n_paths)  # stationary start
for t in range(1, horizon + 1):
    spot[:, t] = phi * spot[:, t - 1] + rng.normal(0.0, 1.0, n_paths)
futures = phi ** (horizon - np.arange(horizon + 1)) * spot       # F_t = E_t[S_T]


def pooled_slope(y, x):
    """Pooled OLS slope of y on x after demeaning both."""
    x, y = x.ravel() - x.mean(), y.ravel() - y.mean()
    return float(x @ y / (x @ x))


pd.DataFrame(
    {
        "helling op spotprijs (simulatie)": [
            pooled_slope(np.diff(spot, axis=1), spot[:, :-1]),
            pooled_slope(np.diff(futures, axis=1), spot[:, :-1]),
        ],
        "helling op spotprijs (theorie)": [phi - 1, 0.0],
    },
    index=["verandering spotprijs", "verandering termijnprijs"],
).round(3)De spotprijsverandering heeft de voorspelde helling van en de termijnprijsverandering een helling van nul. Daarmee klopt de eerste verwachting uit de intuïtie, want de termijnprijs is onvoorspelbaar, ook al is de spotprijs die hij voorspelt dat niet. Wel loopt de variantie van de termijnprijsverandering op naarmate de leverdatum nadert (oefening 2).
4.3Wat het voorspelt: een martingaal na weging met de SDF
Voor aandelen geldt de stelling van Samuelson niet voor de prijs zelf, maar voor de prijs na weging met de SDF. Een belegger die een aandeel koopt, legt vandaag geld neer en draagt risico, en eist daarvoor een vergoeding. Die vergoeding is het hoogst in toestanden waarin een euro schaars is, dus waarin de SDF hoog is. Als we de payoffs met de SDF wegen, valt de vergoeding weg, en wat er dan overblijft, moet weer onvoorspelbaar zijn.
We gebruiken daarvoor het recept uit het toy-voorbeeld opnieuw. Nu komt er een dividend bij, en de risicovrije rente volgt uit de verwachte SDF:
In woorden: de prijs vandaag is de met de SDF gewogen verwachting van prijs plus dividend morgen, en de risicovrije rente is één gedeeld door de verwachte SDF. In het toy-voorbeeld was en dus .
Proof 3
. Omdat op bekend is, is de conditionele verwachting nul door (4). Voor : is positief met , dus een kansdichtheid, en .
Omdat in het toy-voorbeeld is, is de dichtheid daar zelf, zodat goed nieuws onder het gewicht krijgt, de uit de vooruitblik. De maat is de voorloper van de stelling van Harrison en Kreps, die zegt dat zo’n bestaat als er geen arbitrage is Harrison & Kreps (1979).
Wat betekent dit voor het verwachte rendement onder de werkelijke kansen? We delen (4) door en schrijven de verwachting van een product als product van verwachtingen plus covariantie, zodat . Na vermenigvuldiging met volgt
Een aandeel dat weinig oplevert als de SDF hoog is, dus in slechte tijden, heeft daarom een hoog verwacht overrendement. In het toy-voorbeeld is op de covariantie , een premie van 4,35%. Beweegt de covariantie in de tijd, dan beweegt het verwachte rendement mee, en dat is precies de voorspelbaarheid zonder vergissing die we in de intuïtie verwachtten.
4.4Wat het niet verbiedt: elk patroon heeft een SDF
Elk patroon van voorspelbaarheid zonder arbitrage is te rijmen met een SDF die het als risicopremie verklaart. Stel dat een onderzoeker ziet dat het rendement hoger is na een hoog dividendrendement. Een verdediger van efficiëntie kan dan zeggen dat beleggers in die maanden meer risico vrezen, en hij hoeft alleen een SDF te kiezen die in die maanden sterker tegen het rendement in beweegt. Dat lukt zolang de SDF positief blijft, want een negatieve SDF zou een positieve payoff een negatieve prijs geven, en dat is arbitrage.
De SDF is dus laag als het rendement boven zijn verwachting uitkomt, en dat effect is sterker naarmate de premie per eenheid variantie, , groter is. Met de maandgetallen uit de simulatie hierna, en , is de conditionele Sharpe-ratio , zodat de SDF maar 13% per maand hoeft te schommelen.
In deze propositie staat de joint hypothesis in de scherpste vorm. Of het verwachte rendement nu afhangt van het dividendrendement, van het rendement van vorige maand of van het weer in New York, er is altijd een SDF die dat als rationele risicopremie verklaart. Zonder model verbiedt efficiëntie dus alleen arbitrage. Fama kwam in 1991 tot dezelfde slotsom en schreef dat efficiëntie op zich niet toetsbaar is, alleen samen met een evenwichtsmodel.
Market efficiency per se is not testable. It must be tested jointly with some model of equilibrium, an asset-pricing model. Fama (1991)
Toetsbaar wordt efficiëntie pas als er iets over wordt gezegd. Een onderzoeker kan bijvoorbeeld eisen dat de SDF hoog is in slechte tijden, of dat de volatiliteit ervan geloofwaardig is Hansen & Jagannathan (1991).
4.5Hoe het getoetst wordt: drie vormen, de filterregel en kosten
Fama deelde de toetsen in naar de informatie waartegen de prijs efficiënt moet zijn Fama (1970), omdat “alle informatie” te vaag is om te toetsen. Het onderscheid in drie vormen schreef hij in een voetnoot toe aan Harry Roberts.
| vorm | informatie | typische toets | in deze reeks |
|---|---|---|---|
| zwak | de koersgeschiedenis | autocorrelaties, variance ratios, filterregels | Regnault, Bachelier en de random walk, hier |
| semi-sterk | alle publieke informatie | event studies | De event study |
| sterk | ook informatie waar maar enkelen bij kunnen | fondsen, insiders | hier kort, De industrie als financier: indexfondsen, DFA, AQR |
Zijn conclusie in 1970 was dat tegen de zwakke en de semi-sterke vorm geen belangrijk bewijs was gevonden, en tegen de sterke vorm alleen beperkt bewijs Fama (1970). Voor de zwakke vorm is de filterregel een aantrekkelijke toets, omdat een filter de joint hypothesis grotendeels omzeilt.
Een handelaar springt in en uit een aandeel op grond van de koersgeschiedenis. Uitstappen levert hem alleen iets op als het verwachte overrendement op dat moment negatief is. Is het nooit negatief, dan laat hij bij elke uitstap een premie liggen, zodat hij gemiddeld minder haalt dan een belegger die het aandeel vasthoudt.
Geen regel die alleen de koersgeschiedenis gebruikt, verslaat dus buy-and-hold in verwacht rendement, en dat is Fama’s submartingaalvoorwaarde Fama (1970). De aanname is zelf een klein model, maar wel veel zwakker dan een constant verwacht rendement. Verslaat een filter buy-and-hold, dan zegt dat daarom meer dan een significante voorspellende regressie.
Een filter verslaat buy-and-hold alleen als het verleden de richting van morgen voorspelt. Bij een positieve eerste autocorrelatie loopt een stijging van vandaag gemiddeld morgen door, en een klein filter stapt na een stijging direct in. Een handelaar die steeds de richting van gisteren volgt, verdient per dag ongeveer , met de dagvolatiliteit (de standaarddeviatie van één dagrendement). Die uitdrukking is de verwachting van het teken van gisteren maal het rendement van vandaag, voor twee normale variabelen met correlatie .
In het venster van Fama en Blume, 1957–1962, is en . De handelaar verdient dan per dag, bijna 24% per jaar. Zijn voorsprong op buy-and-hold is die 24% min het gemiddelde rendement van de index, en die voorsprong rekent de replicatie na. Zulke autocorrelatie kan in een index zitten zonder dat iemand zich vergist, want door niet-synchrone handel (slotkoersen van weinig verhandelde aandelen lopen achter op het nieuws) erft een index een autocorrelatie die niemand kan verhandelen.
Jensen definieerde efficiëntie in 1978 na kosten Jensen (1978). Volgens hem is een markt efficiënt ten opzichte van een informatieverzameling als handelen op die informatie niets oplevert na correctie voor risico en na aftrek van alle kosten. Een patroon dat alleen bruto bestaat, is in deze zin dus geen bewijs tegen efficiëntie, en daarom rapporteert de replicatie de filterregels voor en na kosten.
Grossman en Stiglitz maakten van de paradox uit de intuïtie een evenwicht Grossman & Stiglitz (1980). Een deel van de beleggers koopt tegen kosten een signaal over de waarde van het aandeel, terwijl ruis in het aanbod voorkomt dat de prijs het signaal volledig verraadt. Beleggers blijven zich informeren tot geïnformeerd beleggen na aftrek van niet meer oplevert dan ongeïnformeerd beleggen, zodat bij hogere kosten minder beleggers het signaal kopen en de prijs minder verraadt.
Zolang , is de prijs dus nooit volledig informatief, want bruto verdienen de geïnformeerden iets en netto niet. Zo komt ook de derde verwachting uit, dat een markt alleen na aftrek van kosten efficiënt is.
5Simulatie: een rationele economie en een onderzoeker met het verkeerde model
Hoe lang moet een onderzoeker met het constante model (een constant verwacht rendement) kijken voordat hij in een volledig rationele economie inefficiëntie vindt? Na een eeuw maanddata vindt hij ze in zes van de tien economieën, terwijl er alleen risico wordt beloond. Het maandelijkse overrendement is
met deze kalibratie:
| symbool | betekenis | waarde per maand |
|---|---|---|
| gemiddeld verwacht overrendement | 0,6% | |
| afwijking van het verwachte rendement, bekend op | standaarddeviatie 0,3% | |
| persistentie van | 0,98 | |
| volatiliteit van de onvoorspelbare schok | 4,5% |
Op jaarbasis schommelt het verwachte rendement dus met ongeveer 3,6 procentpunt rond 7,2%. Net als in het toy-voorbeeld, waar het tussen 3,45% en 5,26% lag, beweegt de premie met de toestand. De schokken en zijn onafhankelijk, zodat de toets alleen het effect van het model meet en niet de bias die ontstaat als de schok van een persistente voorspeller met het rendement samenhangt Stambaugh (1999).
De economie is rationeel, want de SDF uit (6), met , waardeert het rendement in elke maand exact, en een hoge is een hoge prijs van risico. De onderzoeker observeert , bijvoorbeeld het dividendrendement, en toetst met de regressie of het verwachte rendement constant is. Een tweede onderzoeker kent het juiste model en regresseert het abnormale rendement op dezelfde . De cel bouwt 2000 economieën van 150 jaar en controleert de SDF.
months, n_sim = 1800, 2000             # 150 jaar maanddata, 2000 economieën
mu, sigma, phi_s, sd_s = 0.006, 0.045, 0.98, 0.003

state = np.empty((n_sim, months))
state[:, 0] = rng.normal(0.0, sd_s, n_sim)
eta = rng.normal(0.0, sd_s * np.sqrt(1 - phi_s**2), (n_sim, months))
for t in range(1, months):
    state[:, t] = phi_s * state[:, t - 1] + eta[:, t]
expected = mu + state                                      # E_t[R^e_{t+1}]
excess = expected + rng.normal(0.0, sigma, (n_sim, months))  # column t: earned t -> t+1
sdf = 1.0 - (expected / sigma**2) * (excess - expected)     # proposition, R^f = 1

r2_population = sd_s**2 / (sd_s**2 + sigma**2)
pd.Series(
    {
        "gemiddelde m * R^e (moet 0 zijn)": np.mean(sdf * excess),
        "gemiddelde m (moet 1 zijn)": sdf.mean(),
        "fractie m < 0": np.mean(sdf < 0),
        "populatie-R^2 van de voorspelregressie": r2_population,
        "SD van E_t[R^e] op jaarbasis": 12 * expected.std(),
    }
).round(5)
gemiddelde m * R^e (moet 0 zijn) -0.00002
gemiddelde m (moet 1 zijn) 1.00008
fractie m < 0 0.00001
populatie-R^2 van de voorspelregressie 0.00442
SD van E_t[R^e] op jaarbasis 0.03598
dtype: float64De SDF waardeert het rendement tot op de simulatieruis correct en is gemiddeld één, maar hij is negatief in één op de honderdduizend maanden. Bij de gemiddelde premie vraagt een negatieve SDF een schok van standaarddeviaties, wat vrijwel nooit voorkomt. De negatieve maanden vallen daarom in toestanden met een hoge premie, want bij is de drempel standaarddeviaties. Strikt genomen is dat arbitrage, maar het komt te zelden voor om de toets te raken. De populatie- van de voorspelregressie is , en dat getal bepaalt alles wat volgt.
We schatten beide regressies op de eerste 10 tot 150 jaar van elke economie en tellen hoe vaak . De kolom “analytisch” is de benadering die hieronder wordt uitgelegd.
def slope_tstats(y, x):
    """Row-wise OLS slope t-statistics of y on x (homoskedastic standard errors)."""
    T = y.shape[1]
    xd = x - x.mean(axis=1, keepdims=True)
    yd = y - y.mean(axis=1, keepdims=True)
    sxx = (xd**2).sum(axis=1)
    slope = (xd * yd).sum(axis=1) / sxx
    resid = yd - slope[:, None] * xd
    return slope / np.sqrt((resid**2).sum(axis=1) / (T - 2) / sxx)


rows, t_at_100 = [], {}
for years in (10, 25, 50, 75, 100, 150):
    T = 12 * years
    t_const = slope_tstats(excess[:, :T], state[:, :T])
    t_true = slope_tstats(excess[:, :T] - expected[:, :T], state[:, :T])
    drift = np.sqrt(T * r2_population / (1 - r2_population))
    rows.append(
        {
            "jaren": years,
            "verwerpt constant model": np.mean(np.abs(t_const) > 1.96),
            "analytisch": stats.norm.sf(1.96 - drift) + stats.norm.cdf(-1.96 - drift),
            "verwerpt juiste model": np.mean(np.abs(t_true) > 1.96),
        }
    )
    if years == 100:
        t_at_100 = {"constant model": t_const, "juiste model": t_true}
power = pd.DataFrame(rows).set_index("jaren")
power.round(3)De onderzoeker met het constante model verwerpt zijn model steeds vaker naarmate de steekproef groeit, terwijl de onderzoeker met het juiste model rond het nominale niveau van 5% blijft.
Let in de figuur links op de afstand tussen de twee soorten punten, en rechts op de verschuiving van de verdeling onder het constante model.
Source
fig, axes = plt.subplots(1, 2, figsize=(10.5, 4.2))

grid = np.linspace(5, 200, 200)
drift = np.sqrt(12 * grid * r2_population / (1 - r2_population))
axes[0].plot(grid, stats.norm.sf(1.96 - drift) + stats.norm.cdf(-1.96 - drift),
             color=hap.plotting.COLORS[0], label="analytisch, constant model")
axes[0].scatter(power.index, power["verwerpt constant model"],
                color=hap.plotting.COLORS[0], zorder=3, label="simulatie, constant model")
axes[0].scatter(power.index, power["verwerpt juiste model"],
                color=hap.plotting.COLORS[1], marker="s", zorder=3,
                label="simulatie, juiste model")
axes[0].axhline(0.05, color="black", lw=0.9, ls="--")
axes[0].set_title("Hoe vaak wordt 'efficiëntie' verworpen?")
axes[0].set_xlabel("Lengte van de steekproef (jaren maanddata)")
axes[0].set_ylabel("Verwerpingsfractie bij 5%")
axes[0].legend()

bins = np.linspace(-5, 7, 49)
for i, (name, tvals) in enumerate(t_at_100.items()):
    axes[1].hist(tvals, bins=bins, alpha=0.6, color=hap.plotting.COLORS[i], label=name)
for c in (-1.96, 1.96):
    axes[1].axvline(c, color="black", lw=0.9, ls="--")
axes[1].set_title("Dezelfde 100 jaar data, twee modellen")
axes[1].set_xlabel("$t$-waarde van de helling op $s_t$")
axes[1].set_ylabel("Aantal economieën")
axes[1].legend()
plt.show()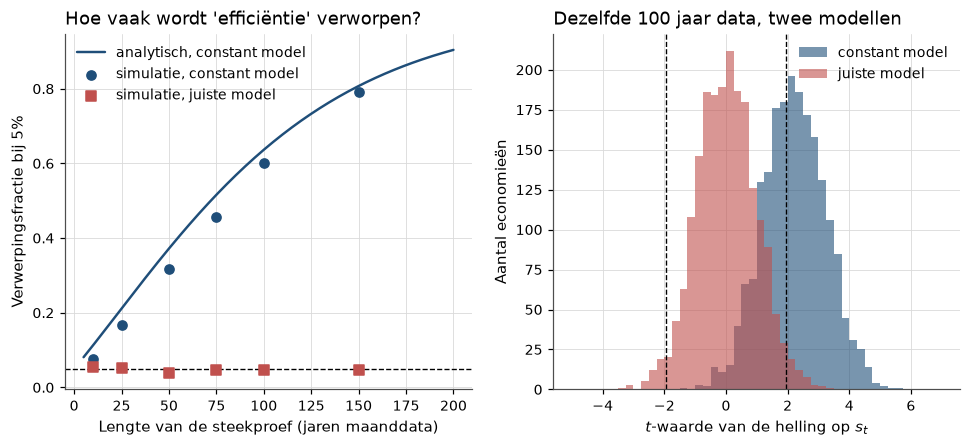
Figure 1:Links: hoe vaak een onderzoeker het constante model verwerpt in een volledig rationele economie. Na een eeuw maanddata lukt dat in ongeveer zes van de tien steekproeven. Een onderzoeker die het juiste model kent, verwerpt het in ongeveer 5% van de gevallen, het nominale significantieniveau. Rechts: bij dezelfde honderd jaar data ligt de -waarde onder het constante model naar rechts verschoven, onder het juiste model rond nul. De data zijn gelijk, alleen het model verschilt.
In de figuur is de vraag risico of vergissing te beantwoorden, omdat we in deze wereld weten dat het patroon een risicopremie is. Na honderd jaar vindt de onderzoeker met het constante model in 60% van de economieën inefficiëntie, terwijl er per constructie alleen risico wordt beloond. De onderzoeker met het juiste model ziet in dezelfde data een fair game, zodat hun meningsverschil niet over de data gaat, maar over .
Waarom duurt het zo lang? Met een kleine is de verwachte -waarde na maanden ongeveer , dezelfde rekensom als in (14). Voor een verwachte van 1,96 zijn dan
nodig, ruim tweeënzeventig jaar. De benodigde steekproef is dus omgekeerd evenredig met de voorspelbare fractie van de variantie. Bij is de toets gemiddeld net significant, zodat hij in ongeveer de helft van de economieën verwerpt. Voor 80% kans zijn maanden nodig, bijna honderdvijftig jaar, waarbij 0,84 het 80%-kwantiel van de standaardnormale verdeling is.
Dat is dezelfde onnauwkeurigheid als bij de standaardfout van 2% uit Rendementen en hun statistiek, waar een gemiddeld jaarrendement bij 20% volatiliteit na een eeuw maar op 2 procentpunt nauwkeurig is. Hier geldt ze voor een gemiddelde dat in de tijd beweegt, zodat een schommeling van 3,6 procentpunt per jaar in het verwachte rendement economisch groot is en toch statistisch bijna onzichtbaar.
De simulatie ligt enkele procentpunten onder de formule, omdat een persistente in een eindige steekproef minder rond zijn steekproefgemiddelde spreidt dan in de populatie en daardoor minder informatie bevat. Het verschil is het grootst rond 75 jaar, zes punten, en krimpt tot minder dan twee bij 150 jaar. De simulatie heeft dus ongeveer tachtig jaar nodig voor een halve kans op verwerping.
6Replicatie op echte data
We repliceren niet de voorspelregressie uit de simulatie maar het filter, omdat het filter de joint hypothesis bijna omzeilt. In de vorm van Fama en Blume werkt de regel van Alexander zo. Stijgt de slotkoers procent boven een eerder dal, dan gaat de belegger lang, en daalt de koers procent onder een eerdere top, dan verkoopt hij en gaat hij short. We rekenen met de totaalrendementsindex, zodat de lange positie dividend ontvangt en de korte het betaalt. Rendementen zijn gemiddelde log-rendementen maal 252, en de tabel zet onze index naast hun gepubliceerde waarden.
def filter_positions(level, x):
    """Alexander filter as in Fama-Blume: +1 long, -1 short, 0 before the first signal."""
    level = np.asarray(level, float)
    positions = np.zeros(len(level))
    state, start, peak, trough = 0, level[0], level[0], level[0]
    for t, p in enumerate(level):
        if state == 0:
            if p >= start * (1 + x):
                state, peak = 1, p
            elif p <= start * (1 - x):
                state, trough = -1, p
        elif state == 1:
            peak = max(peak, p)
            if p <= peak * (1 - x):
                state, trough = -1, p
        else:
            trough = min(trough, p)
            if p >= trough * (1 + x):
                state, peak = 1, p
        positions[t] = state
    return positions


def filter_performance(returns, x, cost=0.001, periods=252):
    """Annualised log return of an x-filter, before and after a cost per transaction."""
    held = pd.Series(filter_positions((1 + returns).cumprod(), x), index=returns.index)
    held = held.shift(1).fillna(0.0)                   # position at close t earns t+1
    first_signal = held.ne(0).idxmax()                 # first day with a position
    held, r = held.loc[first_signal:], returns.loc[first_signal:]
    gross = np.log1p(held * r)
    switches = held.diff().fillna(0.0).ne(0)
    return {
        "filter": x,
        "voor kosten": periods * gross.mean(),
        "na 0,1% per transactie": periods * (gross - cost * switches).mean(),
        "buy-and-hold": periods * np.log1p(r).mean(),
        "transacties per jaar": switches.sum() / (len(r) / periods),
    }


market = hap_data.market_daily()["Mkt"]
filters = (0.005, 0.01, 0.015, 0.02, 0.03, 0.05, 0.10, 0.20)
fama_blume_window = market.loc["1957-12":"1962-09-26"]
ours = pd.DataFrame([filter_performance(fama_blume_window, x) for x in filters]).set_index("filter")

published = pd.DataFrame(
    {
        "origineel: voor commissies": [0.1152, 0.0547, 0.0277, 0.0023, -0.0169, -0.0188, 0.0298, 0.0428],
        "origineel: na volle commissies (niet vergelijkbaar)": [-1.0359, -0.7494, -0.5614, -0.4515, -0.3049, -0.1662, -0.0143, 0.0298],
    },
    index=pd.Index(filters, name="filter"),
)
pd.concat([ours.add_prefix("hier: "), published], axis=1).round(4)De kolom buy-and-hold verschilt per filter, omdat elk filter pas telt vanaf zijn eerste signaal. Hun kolom na volle commissies rekent met de commissie van een gewone belegger en is daarom niet te vergelijken met onze kolom na 0,1%. De volgende cel rekent voor het venster de voorspelde voorsprong van criterium 1 uit.
def predicted_lead(returns, periods=252):
    """Annual lead over buy-and-hold of following yesterday's sign: rho_1 * sigma * sqrt(2/pi) - mu."""
    r = np.log1p(returns)
    return periods * (r.autocorr(1) * r.std() * np.sqrt(2 / np.pi) - r.mean())


window_log = np.log1p(fama_blume_window)
pd.Series({
    "eerste autocorrelatie": window_log.autocorr(1),
    "dagvolatiliteit": window_log.std(),
    "voorspelde voorsprong per jaar": predicted_lead(fama_blume_window),
    "gemeten voorsprong, 0,5%-filter voor kosten": ours.loc[0.005, "voor kosten"] - ours.loc[0.005, "buy-and-hold"],
}).round(4)
eerste autocorrelatie 0.1752
dagvolatiliteit 0.0068
voorspelde voorsprong per jaar 0.1392
gemeten voorsprong, 0,5%-filter voor kosten 0.1286
dtype: float64Geslaagd op criterium 1, want het 0,5%-filter verslaat buy-and-hold voor kosten met 12,9 procentpunt per jaar, tegen een voorspelde voorsprong van 13,9 (de bijna 24% uit de theorie min het gemiddelde rendement van de index) en 1,7 bij Fama en Blume. Na 0,1% per transactie blijft er ruim acht procentpunt over.
Met Fama en Blume delen we alleen de uitkomst dat het kleinste filter het meest verdient. Bij hen is de voorsprong vanaf 1% weg, terwijl ze op de index vanaf 3% grillig wordt. De kosten geven de doorslag, omdat kleine filters vaak handelen, 48 keer per jaar op de index en 84 keer per aandeel bij Fama en Blume. Bij volle commissies verdiende volgens hen vooral de makelaar.
Let in de figuur op de afstand tussen de ronde punten en de vierkanten bij de kleinste filters.
Source
fig, ax = plt.subplots()
ax.plot(ours.index, ours["voor kosten"], "o-", color=hap.plotting.COLORS[0],
        label="index 1957-1962, voor kosten")
ax.plot(ours.index, ours["na 0,1% per transactie"], "o--", color=hap.plotting.COLORS[0],
        label="index 1957-1962, na 0,1% per transactie")
ax.plot(published.index, published["origineel: voor commissies"], "s-", color=hap.plotting.COLORS[1],
        label="Fama-Blume, 30 aandelen, voor commissies")
ax.axhline(252 * np.log1p(fama_blume_window).mean(), color="black", lw=1.0, label="buy-and-hold index")
ax.axhline(0.0986, color=hap.plotting.COLORS[1], lw=1.0, ls=":",
           label="buy-and-hold Fama-Blume (0,0986)")
ax.set_xscale("log")
ax.set_title("Filterregels op individuele aandelen en op de index, 1957-1962")
ax.set_xlabel("Filtergrootte $\\delta$ (log-schaal)")
ax.set_ylabel("Rendement per jaar")
ax.legend()
plt.show()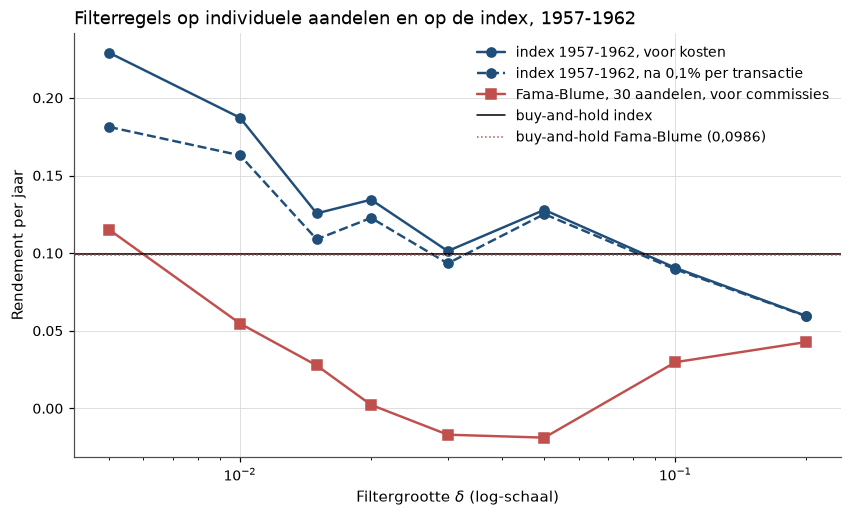
Figure 2:Filterregels in het venster van Fama en Blume. De vierkanten zijn hun gepubliceerde gemiddelden over dertig aandelen (tabel 3, kolom 1), de ronde punten dezelfde regel op de marktindex. Beide zijn het hoogst bij het kleinste filter. Boven 1% ligt de reeks van Fama en Blume ver onder buy-and-hold. Het verschil bij de kleinste filters komt door de extra autocorrelatie van de index bij niet-synchrone handel, en die zit in de meting, niet in iets wat te kopen was.
Fama en Blume schreven die extra autocorrelatie, naar Lawrence Fisher, toe aan niet-synchrone handel. Met criteria 2 en 3 toetsen we die verklaring, door het 0,5%-filter te herhalen in vier deelperiodes en op SPY, met de eerste autocorrelatie van de dagrendementen ernaast. De cel haalt SPY uit dezelfde download van vijf ETF’s als Opzet, data en conventies en gebruikt alleen die ene reeks, omdat de offline cache alleen die gezamenlijke download bevat en een losse SPY-aanvraag daarin ontbreekt.
periods_daily = {
    "1926-07 t/m 1956": market.loc[:"1956"],
    "1957-12 t/m 1962-09 (FB)": fama_blume_window,
    "1963 t/m 1989": market.loc["1963":"1989"],
    "1990 t/m 2026": market.loc["1990":],
}
etfs = hap_data.yahoo(["SPY", "TLT", "GLD", "QQQ", "IWM"], "1993-01-01")  # same cached download as the setup
spy = etfs["SPY"]
spy_returns = (spy / spy.shift(1) - 1).dropna()
periods_daily["French, zelfde dagen als SPY"] = market.loc[spy_returns.index[0]:spy_returns.index[-1]]
periods_daily["SPY 1993 t/m 2026 (verhandelbaar)"] = spy_returns

rows = {}
for name, r in periods_daily.items():
    perf = filter_performance(r, 0.005)
    rows[name] = {
        "eerste autocorrelatie dagrendement": np.log1p(r).autocorr(1),
        "0,5%-filter voor kosten": perf["voor kosten"],
        "na 0,1% per transactie": perf["na 0,1% per transactie"],
        "buy-and-hold": perf["buy-and-hold"],
        "voorsprong voor kosten": perf["voor kosten"] - perf["buy-and-hold"],
    }
subperiods = pd.DataFrame(rows).T
subperiods.round(4)Geslaagd op criteria 2 en 3, want in de tabel stijgt de voorsprong van het filter met de eerste autocorrelatie, en na 1990, bij een negatieve autocorrelatie, wordt ze een verlies. Op de verhandelbare SPY verliest het filter het meest, nog voor kosten. Ook de slotkoersen van een moderne index lopen dus iets achter op die van een fonds dat werkelijk wordt verhandeld.
De cel schat per fonds de alpha, de bèta en de -waarde met heteroskedasticiteitsrobuuste standaardfouten, op maanddata.
fund_names = {
    "FMAGX": "Fidelity Magellan", "AGTHX": "Growth Fund of America",
    "FCNTX": "Fidelity Contrafund", "PRGFX": "T. Rowe Price Growth Stock",
    "VWNDX": "Vanguard Windsor", "DODGX": "Dodge & Cox Stock",
    "TWCUX": "American Century Ultra", "VFINX": "Vanguard 500 Index (controle)",
}
fund_prices = hap_data.yahoo(list(fund_names), "1980-01-01").resample("ME").last()
fund_returns = (fund_prices / fund_prices.shift(1) - 1).loc["1982":]
factors = hap_data.market_monthly()

rows = {}
for ticker, name in fund_names.items():
    y = (fund_returns[ticker] - factors["RF"].reindex(fund_returns.index)).dropna()
    X = factors["Mkt-RF"].reindex(y.index)
    fit = hap.stats.newey_west(y, X, lags=0)
    rows[name] = {
        "alpha per jaar": 12 * fit.params.iloc[0],
        "t(alpha)": fit.tvalues.iloc[0],
        "bèta": fit.params.iloc[1],
        "maanden": int(fit.nobs),
    }
jensen = pd.DataFrame(rows).T
active = jensen.drop(index="Vanguard 500 Index (controle)")
jensen.loc["gemiddelde actieve fondsen"] = active.mean()
jensen.round(3)De regressie is het CAPM, waarin het verwachte overrendement van een fonds evenredig is met zijn bèta op de markt. De alpha meet dan wat een beheerder daarboven verdient, en is daarmee een toets van de sterke vorm uit de tabel van Fama. Het indexfonds heeft een alpha van per jaar met , wat overeenkomt met de kosten plus het kleine verschil tussen de S&P 500 en de totale markt. De tabel hieronder zet de actieve fondsen naast de getallen van Jensen.
jensen_1968 = {"aantal fondsen": 115, "gemiddelde alpha per jaar": -0.011,
               "gemiddelde bèta": 0.840, "fondsen met t(alpha) < -2": 14}
here = {"aantal fondsen": len(active), "gemiddelde alpha per jaar": active["alpha per jaar"].mean(),
        "gemiddelde bèta": active["bèta"].mean(),
        "fondsen met t(alpha) < -2": (active["t(alpha)"] < -2).sum()}
pd.DataFrame({"origineel": jensen_1968, "hier": here}).round(3)Geslaagd. Geen van de zeven actieve fondsen haalt een boven 2, en hun gemiddelde alpha, per jaar, ligt binnen één procentpunt van nul. De hoogste alpha, 1,4% voor Fidelity Contrafund, is niet significant, en T. Rowe Price Growth Stock blijft significant achter. Onze bèta’s liggen rond 1,01 en die van Jensen rond 0,84, waarschijnlijk omdat zijn fondsen meer kas aanhielden.
De standaardfout van een alpha is na 44 jaar maanddata nog ongeveer één procentpunt per jaar, want voor Contrafund is dat 1,4% gedeeld door . Een beheerder die werkelijk één procent per jaar toevoegt, is daardoor na een loopbaan niet van geluk te onderscheiden. Bij de sterke vorm stuiten we zo opnieuw op de standaardfout van 2% uit Rendementen en hun statistiek, omdat vaardigheid van deze omvang binnen één loopbaan niet te meten is.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Het model verklaart veel met één kleine aanname, namelijk dat concurrentie om informatie voorspelbare winst na kosten onmogelijk maakt. Daaruit volgen de bijna-nulautocorrelaties van Regnault, Bachelier en de random walk. Het verklaart ook waarom filterregels falen zodra dividenden en kosten meetellen, want op de verhandelbare SPY verloor het filter al voor kosten. Ten slotte verklaart het waarom fondsen de markt niet verslaan, van Jensens tot gemiddeld voor onze zeven actieve overlevenden. De praktische les, dat een goedkoop indexfonds moeilijk te verslaan is, werd een industrie.
Waar het breekt. Het model breekt op een eigenschap die we zelf hebben bewezen, namelijk dat elk patroon van voorspelbaarheid een SDF heeft die het rationeel maakt (Proposition 2). Efficiëntie zonder model verbiedt dus bijna niets. Het meetbare feit is dat het 0,5%-filter op de index tussen 1957 en 1962 bijna 13 procentpunt per jaar meer verdiende dan buy-and-hold, en na clearingkosten nog ruim acht. Zonder model van risico valt niet te zeggen of dat een inefficiëntie is of een meetfout. Bovendien vraagt een rationele schommeling in het verwachte rendement volgens de formule zeventig en volgens de simulatie tachtig jaar data voor een halve kans op detectie.
Risico of vergissing? Volgens de Chicago-lezing is het filterfeit een meetfout door niet-synchrone handel, die verdwijnt bij een verhandelbaar instrument. Voor zover rendementen wel voorspelbaar zijn, gaat het om een wisselende prijs van risico, zoals na slecht nieuws in het toy-voorbeeld.
Volgens de Yale-lezing past niet alleen de gemeten slotkoers zich traag aan, maar ook de werkelijke prijs van weinig verhandelde aandelen. Dan was er echte winst te halen, en waren de kosten de limits of arbitrage (grenzen aan wat arbitrageurs kunnen wegwerken, omdat handelen geld en risico kost) die de vergissing tot na 1990 lieten bestaan. Op de index is het filterfeit dus een meetfout, maar of er in de jaren zestig daarnaast iets verhandelbaars was, blijft open. De twee lezingen zijn te scheiden met data over wie wanneer tegen welke prijs kon handelen, en met een onafhankelijk gemeten . Het eerste ontbreekt voor de jaren zestig, het tweede nog altijd.
Wat er daarna kwam. Na de koersgeschiedenis kwam het publieke nieuws aan de beurt, met de vraag hoe snel een prijs een aandelensplitsing of een winstcijfer verwerkt. Daarvoor ontwikkelden Fama, Fisher, Jensen en Roll in 1969 de event study Fama et al. (1969), die we in De event study bespreken.
8Oefeningen
Solution to Exercise 1
(1) , en evenzo . De risicocorrectie is in beide gevallen , omdat de spreiding in beide 40 is. Uit volgt .
k = 4 / 11
pd.Series(toy_economy((1 - k, 1 + k))).round(4)
prijs op t=1, goed nieuws 112.7273
prijs op t=1, slecht nieuws 72.7273
prijs op t=0 85.4545
verwachte prijs op t=1 92.7273
verwacht rendement t=0 naar 1 0.0851
verwacht rendement na goed nieuws 0.0645
verwacht rendement na slecht nieuws 0.1000
verwachte prijs op t=1 onder q 85.4545
dtype: float64Na goed nieuws is het verwachte rendement 6,45%, op 8,51%. De SDF heeft dan een standaarddeviatie van 36% per periode, want , de verhouding uit Proposition 2.
(2) Bij is als het meezit, zodat een claim die alleen dan uitbetaalt niets kost, en dat is arbitrage. Voor gaat naar 60 en het verwachte rendement na slecht nieuws naar . De joint hypothesis staat dus elk patroon toe, maar alleen zonder arbitrage, en hoe sterker het patroon, hoe volatieler en minder geloofwaardig de SDF die het moet verklaren.
:::{exercise}
:label: ex-efficiente-markten-2

**Afleiding: het Samuelson-effect.** Laat de spotprijs een AR(1) rond $\bar S$
volgen: $S_{t+1} - \bar S = \phi(S_t - \bar S) + \nu_{t+1}$, met
$0 < \phi < 1$ en $\Var(\nu) = \sigma_S^2$.

1. Leid $F_t = \E_t[S_T]$ af en toon aan dat
   $\Var(F_{t+1} - F_t) = \phi^{2(T-t-1)}\sigma_S^2$.
2. Bereken voor $\phi = 0{,}5$ en $T = 12$ de verhouding tussen de variantie van
   de termijnprijsverandering in de laatste en in de eerste periode, en controleer
   die met de simulatie uit de theorie.
Solution to ex-efficiente-markten-2
(1) Herhaald substitueren geeft , dus en . Omdat onafhankelijk is van , is . Het gemiddelde valt weg, omdat het al in de prijs zit.
(2) De verhouding is . De cel vergelijkt dat met de paden uit de theoriesectie.
changes = np.diff(futures, axis=1)
pd.Series({
    "Var laatste / Var eerste, theorie": phi ** (-2 * (horizon - 1)),
    "Var laatste / Var eerste, simulatie": changes[:, -1].var() / changes[:, 0].var(),
}).round(0)
Var laatste / Var eerste, theorie 4194304.0
Var laatste / Var eerste, simulatie 4208815.0
dtype: float64De theorie geeft ongeveer 4,2 miljoen, en de simulatie wijkt enkele promille af. Wat dit leert: de stelling van Samuelson zegt niet alleen dat termijnprijzen onvoorspelbaar zijn, maar voorspelt ook toetsbaar hoe hun onzekerheid in de tijd verloopt.
:::{exercise}
:label: ex-efficiente-markten-3

**Uitbreiding van de replicatie: break-even kosten.**

1. Bereken voor het 0,5%-filter op de index de break-even kosten $c^{*}$ per
   transactie, waarbij het filter na kosten evenveel oplevert als buy-and-hold,
   voor 1957–1962, 1963–1989 en 1990–2026.
2. Herhaal met een filter dat alleen lang gaat en anders de risicovrije rente van
   French verdient.
3. Was dit filter ooit door een belegger te incasseren?
Solution to ex-efficiente-markten-3
Omdat de kosten lineair zijn in het aantal transacties, geldt .
def long_only_performance(returns, rf, x, periods=252):
    """Long when the filter says long, otherwise earn the risk-free rate."""
    held = pd.Series(filter_positions((1 + returns).cumprod(), x), index=returns.index)
    held = held.shift(1).fillna(0.0)
    first_signal = held.ne(0).idxmax()                 # first day with a position
    long = held.loc[first_signal:].eq(1).astype(float)
    r, f = returns.loc[first_signal:], rf.reindex(returns.index).loc[first_signal:]
    switches = long.diff().fillna(0.0).ne(0).sum() / (len(r) / periods)
    return periods * np.log1p(long * r + (1 - long) * f).mean(), switches


rf_daily = hap_data.market_daily()["RF"]
rows = {}
for name in ["1957-12 t/m 1962-09 (FB)", "1963 t/m 1989", "1990 t/m 2026"]:
    r = periods_daily[name]
    perf = filter_performance(r, 0.005)
    long_return, long_switches = long_only_performance(r, rf_daily, 0.005)
    rows[name] = {
        "c* lang/short": (perf["voor kosten"] - perf["buy-and-hold"]) / perf["transacties per jaar"],
        "c* alleen lang": (long_return - perf["buy-and-hold"]) / long_switches,
        "lang/short voor kosten": perf["voor kosten"],
        "alleen lang voor kosten": long_return,
        "buy-and-hold": perf["buy-and-hold"],
    }
pd.DataFrame(rows).T.round(4)Tot 1990 ligt de break-even tussen 0,27% en 0,41% per transactie, dus boven de 0,1% van een handelaar op de beursvloer en onder de commissie van een gewone belegger. Na 1990 is negatief, want het filter verliest al voor kosten. Alleen lang gaan geeft een lagere , 0,16% en 0,27% in de twee perioden tot 1990, en na 1990 blijft ook die variant met 6,8% onder de 10,4% van buy-and-hold.
(3) Toen de kosten hoog waren, bestond de trend alleen in een index die niet te kopen was, en toen die index te koop was, bestond de trend niet meer. Daarom is “na alle kosten” in de definitie van Jensen geen voetnoot, maar de helft van het argument.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Fama, E. F. (1965). The Behavior of Stock-Market Prices. The Journal of Business, 38(1), 34–105. 10.1086/294743
- Samuelson, P. A. (1965). Proof That Properly Anticipated Prices Fluctuate Randomly. Industrial Management Review, 6(2), 41–49.
- Fama, E. F. (1970). Efficient Capital Markets: A Review of Theory and Empirical Work. The Journal of Finance, 25(2), 383–417. 10.1111/j.1540-6261.1970.tb00518.x
- Fama, E. F. (1965). Random Walks in Stock Market Prices. Financial Analysts Journal, 21(5), 55–59. 10.2469/faj.v21.n5.55
- Grossman, S. J., & Stiglitz, J. E. (1980). On the Impossibility of Informationally Efficient Markets. American Economic Review, 70(3), 393–408.
- Harrison, J. M., & Kreps, D. M. (1979). Martingales and Arbitrage in Multiperiod Securities Markets. Journal of Economic Theory, 20(3), 381–408. 10.1016/0022-0531(79)90043-7
- Fama, E. F. (1991). Efficient Capital Markets: II. The Journal of Finance, 46(5), 1575–1617. 10.1111/j.1540-6261.1991.tb04636.x
- Hansen, L. P., & Jagannathan, R. (1991). Implications of Security Market Data for Models of Dynamic Economies. Journal of Political Economy, 99(2), 225–262. 10.1086/261749
- Jensen, M. C. (1978). Some Anomalous Evidence Regarding Market Efficiency. Journal of Financial Economics, 6(2–3), 95–101. 10.1016/0304-405X(78)90025-9
- Stambaugh, R. F. (1999). Predictive Regressions. Journal of Financial Economics, 54(3), 375–421. 10.1016/S0304-405X(99)00041-0
- Fama, E. F., & Blume, M. E. (1966). Filter Rules and Stock-Market Trading. The Journal of Business, 39(1), 226–241. 10.1086/294849
- Alexander, S. S. (1961). Price Movements in Speculative Markets: Trends or Random Walks. Industrial Management Review, 2(2), 7–26.
- Jensen, M. C. (1968). The Performance of Mutual Funds in the Period 1945–1964. The Journal of Finance, 23(2), 389–416. 10.1111/j.1540-6261.1968.tb00815.x
- Fama, E. F., Fisher, L., Jensen, M. C., & Roll, R. (1969). The Adjustment of Stock Prices to New Information. International Economic Review, 10(1), 1–21. 10.2307/2525569
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD