

VaR, RiskMetrics en LTCM
1Overzicht¶
Kan een bank met een voorspelbare volatiliteit meten en begrenzen hoeveel ze op een slechte dag verliest? Voor een gewone slechte dag wel, maar het getal dat daarvoor werd bedacht zegt niets over verliezen voorbij de grens, is met een jaar data nauwelijks te toetsen en mist de spiraal van hefboom en onderpand. In dit college:
definiëren we Value-at-Risk en Expected Shortfall en bewijzen we dat alleen de tweede spreiding altijd beloont
schatten we het kwantiel met een voorspelbare volatiliteit en leiden we de backtests van Kupiec en Christoffersen af
simuleren we hoe weinig een backtest van één jaar ziet, en hoe vaak dezelfde convergence trade bij een hogere hefboom failliet gaat
backtesten we vier VaR-modellen op de Amerikaanse aandelenmarkt van 1990 tot 2026 en bekijken we de spreads van 1998.
In oktober 1994 publiceerde J.P. Morgan RiskMetrics, een methode met gratis data J.P. Morgan/Reuters (1996). Daarmee kon elke handelaar de Value-at-Risk van zijn portefeuille uitrekenen (VaR, het verlies dat met een gegeven kans, zeg 99%, over een gegeven horizon niet wordt overschreden). In 1996 maakte het Bazelse Comité VaR tot grondslag van het kapitaal tegen marktrisico, met een regel om de modellen achteraf te toetsen Basle Committee on Banking Supervision (1996)Basle Committee on Banking Supervision (1996). De toetsen kwamen van Kupiec (1995) en Christoffersen (1998). Nadat Artzner et al. (1999) hadden laten zien dat VaR spreiding kan bestraffen, stapte het Comité in 2016 over op Expected Shortfall (ES, het gemiddelde verlies voorbij het kwantiel) Basel Committee on Banking Supervision (2016). Zo werd risicobeheer een eigen vak, met een eigen leerboek Jorion (2006) en met eigen afdelingen bij banken en toezichthouders Santa-Clara (2026). Toch ging in september 1998 Long-Term Capital Management (LTCM) bijna failliet, een fonds met Robert Merton en Myron Scholes onder zijn partners dat alles had wat het vak voorschreef Lowenstein (2000).
Al die regels en toetsen gaan over een meetinstrument en niet over een theorie van prijzen, zodat VaR buiten de tegenstelling theorie of feit valt. Een backtest toetst daarom geen evenwicht, maar alleen of een voorspeld kwantiel zo vaak wordt overschreden als het belooft.
2Intuïtie: waarom zou dit waar zijn?¶
Een bank met honderden posities wil na elke handelsdag één getal dat zegt hoeveel ze morgen kan verliezen. Een 99%-VaR van 40 miljoen betekent dat het verlies op één dag op de honderd groter mag zijn. Dat getal telt obligaties, valuta en aandelen op in één munt en beloont posities die elkaar opheffen. Omdat het verwachte rendement over één dag verwaarloosbaar is, vraagt het alleen de volatiliteit van morgen. Het slecht meetbare verwachte rendement telt dus niet mee, en alleen de goed meetbare volatiliteit blijft over.
Toch heeft het getal drie zwakke plekken. De eerste is dat VaR niets zegt over de dagen die de grens overschrijden, terwijl juist die dagen tellen. Artzner et al. (1999) maakten dat punt al, en Pedro Santa-Clara herhaalt het in de terugblik op zijn loopbaan die deze reeks volgt Santa-Clara (2026). De tweede is dat een kans van 1% slecht te controleren is, want een jaar van 250 handelsdagen geeft gemiddeld 2,5 overschrijdingen, en een model dat maar 98% dekt, geeft er vaak niet meer dan vijf. De derde is dat VaR twee obligaties samen riskanter kan noemen dan elk apart.
LTCM kocht effecten die net iets goedkoper waren dan vrijwel identieke andere en verkocht de duurdere, vooral staatsobligaties van de G-7-landen. Zo’n convergence trade (een positie die winst maakt als twee prijzen naar elkaar toe bewegen) verdient een fractie van een procent, zodat er pas met geleend geld iets aan te verdienen valt. Op 31 augustus 1998 stond er meer dan 125 miljard dollar op de balans, tegen 4,8 miljard eigen vermogen begin dat jaar, een hefboom van meer dan 25 President's Working Group on Financial Markets (1999).
Verbreden de spreads, dan ziet het fonds dat dagelijks in zijn waardering (mark-to-market). Tegenpartijen vragen dan extra onderpand, en het fonds moet verkopen voordat de prijzen convergeren. Is het fonds groot, of hebben veel fondsen dezelfde positie, dan drukt die verkoop de prijs verder de verkeerde kant op, zodat het verlies de volgende verkoop afdwingt. Santa-Clara noemt hefboom, dagelijkse waardering en een termijn samen het recept voor ruïne Santa-Clara (2026).
Uit dit beeld volgen drie verwachtingen. Een backtest van één jaar laat een verkeerd model vaak passeren, omdat een kans van 1% in 250 dagen te weinig uitkomsten geeft. De VaR van twee posities met een kleine kans op een groot verlies komt hoger uit dan de som van de losse VaR’s, maar een maat die de staart middelt, doet dat niet. Ten slotte gaat dezelfde trade bij een hogere hefboom vaker failliet, en nog vaker als de eigen verkopen de prijs bewegen.
3Toy-voorbeeld: twee posities, twee obligaties en een convergence trade¶
Het toy-voorbeeld bestaat uit drie kleine rekensommen die samen het college dragen. Deel (a) laat zien waarom VaR bij normale verliezen werkt, deel (b) hoe ze spreiding kan bestraffen en deel (c) hoe hefboom en eigen verkopen een fonds tot stoppen dwingen. Eerst laden we de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from arch import arch_model
from scipy import stats
from scipy.special import xlogy

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
We gebruiken één recept dat de theorie pas daarna afleidt, namelijk dat de VaR van een normaal verlies met verwachting nul gelijk is aan maal de standaarddeviatie, met . De tabel geeft de opzet van de drie delen.
| deel | opzet | wat we berekenen |
|---|---|---|
| (a) twee posities | 100 miljoen in A (dagvolatiliteit 1,5%) en 50 miljoen in B (1,0%), correlatie 0,4, verwacht rendement nul | 99%-VaR samen en apart |
| (b) twee obligaties | elk levert 2 op, of verliest 100 bij faillissement (kans 4%), onafhankelijk | 95%-VaR en 95%-ES van één en van twee |
| (c) convergence trade | eigen vermogen 100, positie 2500 (hefboom 25), spread duration 5, haircut 2% | drempels in basispunten en de verliesspiraal |
(a) Twee posities. De posities hebben standaarddeviaties van 1,5 en 0,5 miljoen, zodat
en de 99%-VaR is miljoen. Apart tellen de VaR’s op tot 4,653 miljoen, zodat spreiding 0,557 miljoen scheelt. Bazel liet in 1996 de VaR van één dag met de wortel uit de tijd opschalen naar tien dagen Basle Committee on Banking Supervision (1996), en dan wordt ze .
(b) Twee obligaties. Bij 95% is de VaR het kleinste verlies waarvoor de kans op een groter verlies hoogstens 5% is. Voor één obligatie is , dus de VaR is -2, een winst. Twee onafhankelijke obligaties verliezen -4 met kans , 98 met kans en 200 met kans . Omdat nu , springt de VaR naar 98, ver boven de som van de losse VaR’s. De Expected Shortfall op 95% middelt over de slechtste 5%,
en omdat 101,26 kleiner is dan , ziet ES het voordeel van spreiden wel.
(c) Een convergence trade. Het fonds neemt met eigen vermogen 100 een positie van 2500 in een spread met spread duration 5, zodat het verlies 5 maal de verbreding maal de positie is. De tegenpartij eist een haircut (het deel van de positie dat met eigen geld gefinancierd moet zijn) van 2%, dus het vermogen moet minstens 50 blijven. Elk basispunt kost . De margin call (de eis om onderpand bij te storten of te verkopen) komt daardoor na 40 basispunten, en na 80 is het vermogen op. Bij hefboom 10 komen margin call en ruïne pas na 160 en 200 basispunten.
Stel nu dat elke verkoop van 100 de spread met 1 basispunt verbreedt, en dat het fonds op de grens van 50 nog 10 basispunten tegenwind krijgt. Het verliest dan 12,5, zodat de positie nog mag zijn en er 625 verkocht moet worden. Die verkoop verbreedt de spread met 6,25 basispunten en kost op de resterende positie . Daarna moet er nog 293 verkocht worden, wat 2,32 kost. Omdat elke ronde minder dan de helft van de vorige kost, voegen de resterende rondes samen nog 1,3 toe. Zo komt het proces uit op een verlies van 22,0 in plaats van 12,5, bij een verbreding van 21,0 basispunten waarvan het fonds de helft zelf veroorzaakte.
De codecel rekent de drie delen na en zet de uitkomsten naast de handberekening.
# (a) parametric VaR of two positions (millions)
w = np.array([100.0, 50.0])
sig = np.array([0.015, 0.010])
rho = 0.4
cov = np.array([[sig[0]**2, rho * sig[0] * sig[1]],
                [rho * sig[0] * sig[1], sig[1]**2]])
z99 = stats.norm.ppf(0.99)
sd_p = np.sqrt(w @ cov @ w)
var_p = z99 * sd_p
var_each = z99 * w * sig


def var_es_discrete(losses, probs, alpha):
    """VaR and Expected Shortfall at level alpha of a discrete loss distribution."""
    order = np.argsort(losses)
    loss, p = np.asarray(losses, float)[order], np.asarray(probs, float)[order]
    cdf = np.cumsum(p)
    var = loss[np.searchsorted(cdf, alpha - 1e-12)]
    # probability mass of each loss that lies beyond the alpha-quantile
    tail_mass = np.clip(cdf - np.maximum(cdf - p, alpha), 0.0, None)
    return var, (tail_mass * loss).sum() / (1 - alpha)


# (b) two bonds with 4% default probability
var_1, es_1 = var_es_discrete([-2.0, 100.0], [0.96, 0.04], 0.95)
var_2, es_2 = var_es_discrete([-4.0, 98.0, 200.0], [0.96**2, 2 * 0.96 * 0.04, 0.04**2], 0.95)

# (c) levered convergence trade: thresholds in bp, then a fire-sale spiral
E0, D, H, KAPPA = 100.0, 5.0, 0.02, 1e-6       # kappa: spread widening per unit sold
call_25, ruin_25 = 1e4 * (1 - H * 25) / (25 * D), 1e4 / (25 * D)
call_10, ruin_10 = 1e4 * (1 - H * 10) / (10 * D), 1e4 / (10 * D)

X, E = 2500.0, 50.0 - 2500.0 * D * 0.0010       # at the margin limit, then a 10bp shock
spread_move, round_losses = 10.0, []
while True:
    X_new = max(E, 0.0) / H
    sold = X - X_new
    if sold < 1e-9:
        break
    widening = KAPPA * sold
    loss_round = X_new * D * widening
    E -= loss_round
    spread_move += 1e4 * widening
    round_losses.append(loss_round)
    X = X_new

hand = {"sigma portefeuille": 1.7607, "VaR 99% samen": 4.096, "som losse VaR's": 4.653,
        "VaR 99% over tien dagen": 12.95, "VaR 95% één obligatie": -2.0,
        "ES 95% één obligatie": 79.6, "VaR 95% twee obligaties": 98.0,
        "ES 95% twee obligaties": 101.26, "margin call bij L = 25 (bp)": 40.0,
        "ruïne bij L = 25 (bp)": 80.0, "margin call bij L = 10 (bp)": 160.0,
        "ruïne bij L = 10 (bp)": 200.0, "spiraal, verlies ronde 1": 5.86,
        "spiraal, verlies ronde 2": 2.32, "spiraal, totaal verlies": 22.0,
        "spiraal, verbreding (bp)": 21.0}
code = [sd_p, var_p, var_each.sum(), var_p * np.sqrt(10), var_1, es_1, var_2, es_2,
        call_25, ruin_25, call_10, ruin_10, round_losses[0], round_losses[1], 50 - E, spread_move]
pd.DataFrame({"met de hand": list(hand.values()), "code": code}, index=list(hand)).round(4)De twee kolommen zijn gelijk, op de afronding van de spiraal na. VaR beloont spreiding dus zolang verliezen normaal verdeeld zijn, maar draait dat om bij een kleine kans op een groot verlies. Deel (c) laat bovendien zien dat de hefboom, niet de trade, bepaalt na hoeveel basispunten het fonds moet stoppen.
4Theorie¶
We definiëren eerst VaR en Expected Shortfall en rekenen ze uit voor een normaal verlies, zodat ook het recept uit het toy-voorbeeld is afgeleid. Daarna volgt de kern, namelijk dat VaR niet subadditief is en ES wel. Vervolgens schatten we het kwantiel met een voorspelbare volatiliteit en toetsen we het achteraf, met weinig kracht per jaar. Tot slot leiden we af na hoeveel spreadverbreding een gehefboomde arbitrageur moet stoppen, en hoe zijn eigen verkopen dat versnellen.
4.1Opzet: VaR en Expected Shortfall¶
Beide maten vatten het verlies van morgen samen in één getal, maar ze gebruiken de staart verschillend. Laat de waarde van een portefeuille zijn en het verlies, met kansen conditioneel op de informatie op .
De VaR is dus het kleinste verlies dat hoogstens met kans wordt overschreden, waarbij een van 0,95 of 0,99 gebruikelijk is. De ES middelt alle VaR’s boven en is daarmee het gemiddelde verlies op de slechtste fractie van de dagen. De integraalvorm werkt ook bij atomen, zoals bij de obligaties uit het toy-voorbeeld. Voor een normaal verlies liggen beide maten een vast aantal standaarddeviaties boven het gemiddelde, de ES verder dan de VaR.
Bij is de VaR-factor 2,326, het getal uit het toy-voorbeeld, en de ES-factor . Bij is de ES-factor 2,338, bijna de VaR-factor bij 99%. Daarom koos het Comité in 2016 een ES op 97,5% (paragraaf 181(b) van Basel Committee on Banking Supervision (2016)). Onder een normale verdeling blijft het kapitaal dan gelijk, en alleen dikke staarten kosten meer.
4.2Het kernresultaat: VaR is niet coherent, ES wel¶
Waarom zou dit waar zijn? Een risicomaat zegt hoeveel kapitaal een bank naast een positie moet aanhouden. Een positie die altijd slechter uitpakt, vraagt meer kapitaal. Twee keer dezelfde positie vraagt twee keer zoveel, en een euro contant verlaagt het vereiste kapitaal met een euro. Twee posities samen mogen niet meer vragen dan apart, want anders daalt het vereiste kapitaal als een bank zich in afdelingen opsplitst, en worden limieten per afdeling zinloos.
Het origineel formuleert de axioma’s voor toekomstige nettowaarden, en omdat wij met verliezen werken, draaien de tekens om. Het bewijsidee is dat een kwantiel van een som niet begrensd wordt door de losse kwantielen. ES is daarentegen een supremum van verwachtingen, en een supremum van een som is hoogstens de som van de suprema.
Proof 2
VaR. (1), (3) en (4) volgen omdat kwantielen behouden blijven onder stijgende transformaties. Toy-voorbeeld (b) is een tegenvoorbeeld voor (2), want .
ES. (1), (3) en (4) erft ES via (4). Voor (2) gebruiken we de duale vorm Acerbi & Tasche (2002)
Het supremum wordt bereikt door maximaal te maken op de slechtste fractie van de uitkomsten, fractioneel op een atoom op de grens, wat het gemiddelde van de bovenste kwantielen geeft. Een supremum van een som is hoogstens de som van de suprema, dus , bij de twee obligaties 101,26 tegen .
Normaal. Nu is met . Omdat voor , is dat hoogstens de som van de losse VaR’s.
De stelling bewijst dus wat we bij twee obligaties verwachtten, want samen krijgen ze een VaR van 98 in plaats van -4, terwijl hun ES van 159,2 naar 101,26 daalt. Het normale geval verklaart waarom de praktijk het probleem lang niet zag, want bij aandelen en valuta gedraagt VaR zich netjes. Het gaat pas mis bij een kleine kans op een groot verlies, zoals bij kredietrisico, verkochte opties en convergence trades.
4.3Wat het voorspelt: het kwantiel uit een voorspelbare volatiliteit¶
Met een voorspelbare volatiliteit is het kwantiel van morgen op drie manieren te schatten, die verschillen in waar de vorm van de staart vandaan komt. Met posities in dollar, covariantiematrix en verwachte rendementen nul is de parametrische VaR
het recept van toy-deel (a) voor een hele portefeuille. De drie manieren zijn:
parametrisch, met (7). Zo werkte RiskMetrics, dat het verwachte dagrendement op nul zette (p. 92–93 van J.P. Morgan/Reuters (1996)) en met 95% rekende, terwijl Bazel 99% eiste.
historische simulatie, die de rendementen van de afgelopen dagen op de huidige posities toepast en het empirische kwantiel afleest. Dat vraagt geen verdelingsaanname, maar een crash telt dagen mee en valt er dan in één keer uit.
filtered historical simulation Hull & White (1998)Barone-Adesi et al. (1999), die de staart haalt uit historische rendementen gedeeld door de volatiliteit van toen, en het niveau uit de volatiliteit van morgen.
RiskMetrics zocht voor 480 reeksen één volatiliteitsschatter die snel op schokken reageert en geen parameters per reeks vraagt. Het koos de exponentially weighted moving average (EWMA),
waarin elke dag ouder een factor minder weegt. Een hogere maakt de schatting dus trager. RiskMetrics koos voor dagdata, de waarde die de voorspelfout over alle reeksen minimaliseert (§5.3.2.2 van J.P. Morgan/Reuters (1996)). Dan dragen de laatste dagen 99% van het gewicht, zodat een crash na een kwartaal vrijwel vergeten is.
Vergelijk dat met GARCH(1,1) uit het vorige college Engle (1982)Bollerslev (1986),
met en in plaats van en , die hier al bezet zijn. EWMA is het geval , en . Dan is , het integrated GARCH-model van Engle & Bollerslev (1986), waarin een schok nooit uitdooft. Voor één dag vooruit maakt dat weinig uit, omdat dan vooral telt hoe snel het model op een schok reageert.
4.4Hoe het getoetst wordt: Kupiec en Christoffersen¶
Een VaR-model wordt achteraf getoetst door te tellen hoe vaak het verlies de VaR overschreed, en of die overschrijdingen clusteren. Geeft een model elke dag het juiste kwantiel, dan is de kans op een overschrijding elke dag , wat er eerder ook gebeurde. De reeks overschrijdingen (hit sequence) bestaat dan uit onafhankelijke muntworpen.
Kupiec (1995) toetste het aantal. Met overschrijdingen in dagen en fractie vergelijkt de proportion-of-failures-toets de kans op de waargenomen reeks onder met die onder ,
en hoe verder van ligt, hoe groter de statistiek. Boven 3,84 verwerpt de toets op 5%. Christoffersen (1998) toetste ook het patroon. Laat tellen hoe vaak werd gevolgd door , met , en de totale fractie. Tegen een Markov-keten als alternatief is
De eerste statistiek wordt groot als een overschrijding vaker op een overschrijding volgt dan op een rustige dag. De tweede toetst aantal en patroon samen (conditional coverage), zodat een statisch model met het juiste totaal toch kan falen.
Bazel telt alleen het aantal. Over 250 dagen staat het verkeerslicht op groen bij 0 tot 4 overschrijdingen, op geel bij 5 tot 9 en op rood bij 10 of meer. In het gele gebied stijgt de vermenigvuldigingsfactor op het kapitaal, die minimaal 3 is, en in het rode gebied met 1 Basle Committee on Banking Supervision (1996)Basle Committee on Banking Supervision (1996). Het Comité schreef zelf dat zulke toetsen een goed model maar beperkt van een slecht model kunnen onderscheiden (p. 5 van Basle Committee on Banking Supervision (1996)). De cel hieronder programmeert beide toetsen en zet de zones naast de binomiale kansen.
def kupiec_lr(hits, p=0.01):
    """Kupiec (1995) proportion-of-failures LR statistic; hits along the last axis."""
    # TODO: naar hap.stats
    hits = np.asarray(hits, float)
    T, x = hits.shape[-1], hits.sum(axis=-1)
    pi_hat = x / T
    return -2 * ((xlogy(T - x, 1 - p) + xlogy(x, p)) - (xlogy(T - x, 1 - pi_hat) + xlogy(x, pi_hat)))


def christoffersen_lr(hits, p=0.01):
    """Christoffersen (1998) independence and conditional-coverage LR statistics."""
    # TODO: naar hap.stats
    hits = np.asarray(hits, float)
    h0, h1 = hits[..., :-1], hits[..., 1:]
    n00, n01 = ((1 - h0) * (1 - h1)).sum(-1), ((1 - h0) * h1).sum(-1)
    n10, n11 = (h0 * (1 - h1)).sum(-1), (h0 * h1).sum(-1)
    pi01, pi11 = n01 / np.maximum(n00 + n01, 1), n11 / np.maximum(n10 + n11, 1)
    pi = (n01 + n11) / (n00 + n01 + n10 + n11)
    lr_ind = -2 * ((xlogy(n00 + n10, 1 - pi) + xlogy(n01 + n11, pi))
                   - (xlogy(n00, 1 - pi01) + xlogy(n01, pi01) + xlogy(n10, 1 - pi11) + xlogy(n11, pi11)))
    return lr_ind, kupiec_lr(hits, p) + lr_ind


k = np.arange(11)
basel = pd.DataFrame({"overschrijdingen": k,
                      "P(X <= k), p = 1%": stats.binom.cdf(k, 250, 0.01),
                      "P(X >= k), p = 2%": stats.binom.sf(k - 1, 250, 0.02),
                      "LR_pof": kupiec_lr(np.array([np.r_[np.ones(i), np.zeros(250 - i)] for i in k]))})
basel["zone"] = pd.cut(basel["overschrijdingen"], [-1, 4, 9, 250], labels=["groen", "geel", "rood"])
basel.round(4)De tweede kolom reproduceert tabel 2 van het Bazelse kader, met 95,88% bij vijf en 99,99% bij tien overschrijdingen, en daar liggen de grenzen van geel en rood. De derde kolom laat het probleem zien, want een model dat maar 98% dekt, blijft met kans 44% groen. Kupiec verwerpt op 5% alleen bij nul of bij zeven en meer overschrijdingen.
Het probleem is hetzelfde als bij de standaardfout van 2%, maar dan in de staart. Een kans van 1% geschat uit 250 dagen heeft een standaardfout van procentpunt bij , 63% van de kans zelf, en die standaardfout daalt alleen met de wortel van het aantal dagen . Zoals een gemiddeld rendement een eeuw data vraagt, is één jaar veel te kort om een VaR-model te beoordelen.
4.5De gehefboomde arbitrageur¶
Waarom zou dit waar zijn? Een arbitrageur met een positieve verwachte opbrengst kan failliet gaan zonder ongelijk te hebben. Door de hefboom is een kleine prijsbeweging een groot deel van zijn vermogen. Door de dagelijkse waardering is die beweging meteen een verlies, en door het onderpand volgt meteen een gedwongen verkoop. Duwt die verkoop de prijs verder weg, dan groeit het verlies vanzelf.
Vanaf hier staat voor de hefboom en niet meer voor het verlies. Laat het eigen vermogen zijn, de positie met hefboom , en het rendement per eenheid, met carry (de opbrengst als er niets gebeurt), spread duration en spreadverbreding . Dan is
en de tegenpartij eist met haircut . Bij hefboom 25 en duration 5 kost elk basispunt zo 1,25% van het vermogen, zoals in het toy-voorbeeld.
Met de toy-getallen geeft dat 40 en 80 basispunten. De Sharpe-ratio hangt daarentegen niet van af, want de hefboom schaalt teller en noemer even hard. Ze zegt dus niets over de kans om te overleven, zodat een hogere hefboom het fonds al kwetsbaarder maakt voordat zijn eigen verkopen meetellen. Om die verkopen mee te nemen, laten we een verkoop van eenheden de spread met verbreden, terwijl het fonds precies op de grens staat.
Het verlies wordt dus met vergroot, en stijgt met de positie en de prijsimpact en daalt met de haircut. In het toy-voorbeeld is , zodat de lineaire benadering geeft. Dat is meer dan de werkelijke 22,0, omdat daalt naarmate de positie krimpt.
In het klein is dit het mechanisme van Shleifer & Vishny (1997). Arbitrageurs verliezen financiering als de prijs tegen hen beweegt, zodat ze een mispricing niet kunnen corrigeren wanneer die het grootst is. Brunnermeier & Pedersen (2009) lieten daarnaast de haircut met de volatiliteit stijgen, wat de spiraal versterkt.
5Simulatie: wat een korte steekproef over de staart zegt¶
Hoeveel ziet een korte steekproef van een risico dat in de staart zit? We beantwoorden die vraag eerst voor de toezichthouder, die één jaar overschrijdingen heeft om een VaR-model te beoordelen, en daarna voor een fonds met vier goede jaren.
5.1Een jaar backtest¶
We simuleren 2000 paden uit GARCH(1,1) met en , een onvoorwaardelijke volatiliteit van 16% per jaar en Student--schokken met zes vrijheidsgraden. Vier modellen voorspellen de 99%-VaR:
het ware conditionele kwantiel
een statisch normaal model met de perfect gekende onvoorwaardelijke volatiliteit
historische simulatie over 250 dagen
EWMA met en het normale kwantiel.
Daarna tellen we hoe vaak Kupiec en Christoffersen op 5% verwerpen na 250, 500 en 1000 dagen. Ook tellen we hoe vaak een model na een jaar rood is.
A_GARCH, B_GARCH = 0.08, 0.91   # daily GARCH(1,1), persistence 0.99
N_PATHS, BURN, WINDOW, T_MAX = 2000, 500, 250, 1000
NU, VOL_ANN = 6.0, 0.16
var_bar = VOL_ANN**2 / 252
n_days = BURN + WINDOW + T_MAX

z_t = rng.standard_t(NU, size=(n_days, N_PATHS)) * np.sqrt((NU - 2) / NU)
sigma2, r_sim = np.empty((n_days, N_PATHS)), np.empty((n_days, N_PATHS))
ewma2 = np.empty((n_days, N_PATHS))
sigma2[0] = ewma2[0] = var_bar
for t in range(n_days):
    r_sim[t] = np.sqrt(sigma2[t]) * z_t[t]
    if t + 1 < n_days:
        sigma2[t + 1] = var_bar * (1 - A_GARCH - B_GARCH) + A_GARCH * r_sim[t]**2 + B_GARCH * sigma2[t]
        ewma2[t + 1] = 0.94 * ewma2[t] + 0.06 * r_sim[t]**2

start = BURN + WINDOW
q_t = stats.t.ppf(0.99, NU) * np.sqrt((NU - 2) / NU)
var_models = {
    "waar": np.sqrt(sigma2[start:]) * q_t,
    "normaal, constant": np.full((T_MAX, N_PATHS), z99 * np.sqrt(var_bar)),
    "historisch 250d": np.array([-np.quantile(r_sim[t - WINDOW:t], 0.01, axis=0) for t in range(start, n_days)]),
    "EWMA 0,94": z99 * np.sqrt(ewma2[start:]),
}
hits_sim = {name: (-r_sim[start:] > v).T.astype(float) for name, v in var_models.items()}

rows = {}
for name, hits in hits_sim.items():
    for T in (250, 500, 1000):
        lr_ind, lr_cc = christoffersen_lr(hits[:, :T])
        rows[(name, T)] = {"fractie overschrijdingen": hits[:, :T].mean(),
                           "Kupiec verwerpt": (kupiec_lr(hits[:, :T]) > stats.chi2.ppf(0.95, 1)).mean(),
                           "Christoffersen verwerpt": (lr_cc > stats.chi2.ppf(0.95, 2)).mean(),
                           "rood na een jaar": (hits[:, :250].sum(axis=1) >= 10).mean()}
sim_table = pd.DataFrame(rows).T
sim_table.index.names = ["model", "T"]
sim_table.round(3)Alleen het ware model komt op 1% overschrijdingen uit, en na een jaar laten beide toetsen elk fout model vaker door dan dat ze het verwerpen. Wat in de figuur telt, is de hoogte van de lijnen bij de stippellijn van één jaar, links gesimuleerd en rechts exact berekend.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
for i, name in enumerate(hits_sim):
    rej = sim_table.loc[name, "Kupiec verwerpt"]
    axes[0].plot(rej.index, rej.values, "o-", color=hap.plotting.COLORS[i], label=name)
axes[0].axhline(0.05, color="black", lw=0.8, ls="--")
axes[0].set_title("(a) Verwerpingskans Kupiec (5%) in GARCH-t-wereld")
axes[0].set_xlabel("Lengte backtest (dagen)")
axes[0].set_ylabel("Fractie paden verworpen")
axes[0].legend()

T_grid = np.unique(np.geomspace(100, 10_000, 60).astype(int))
for i, coverage in enumerate([0.99, 0.985, 0.98, 0.97]):
    power = []
    for T in T_grid:
        x = np.arange(T + 1)
        pi_hat = x / T
        # Kupiec LR for every possible count x (kupiec_lr takes a hit series)
        lr = -2 * ((xlogy(T - x, 0.99) + xlogy(x, 0.01)) - (xlogy(T - x, 1 - pi_hat) + xlogy(x, pi_hat)))
        power.append(stats.binom.pmf(x, T, 1 - coverage)[lr > stats.chi2.ppf(0.95, 1)].sum())
    axes[1].plot(T_grid, power, color=hap.plotting.COLORS[i], label=f"ware dekking {coverage:.1%}")
axes[1].axvline(250, color="black", lw=0.8, ls=":")
axes[1].set_xscale("log")
axes[1].set_title("(b) Kracht van Kupiec tegen de ware dekking")
axes[1].set_xlabel("Lengte backtest (dagen, log-schaal)")
axes[1].set_ylabel("Verwerpingskans")
axes[1].legend()
fig.tight_layout()
plt.show()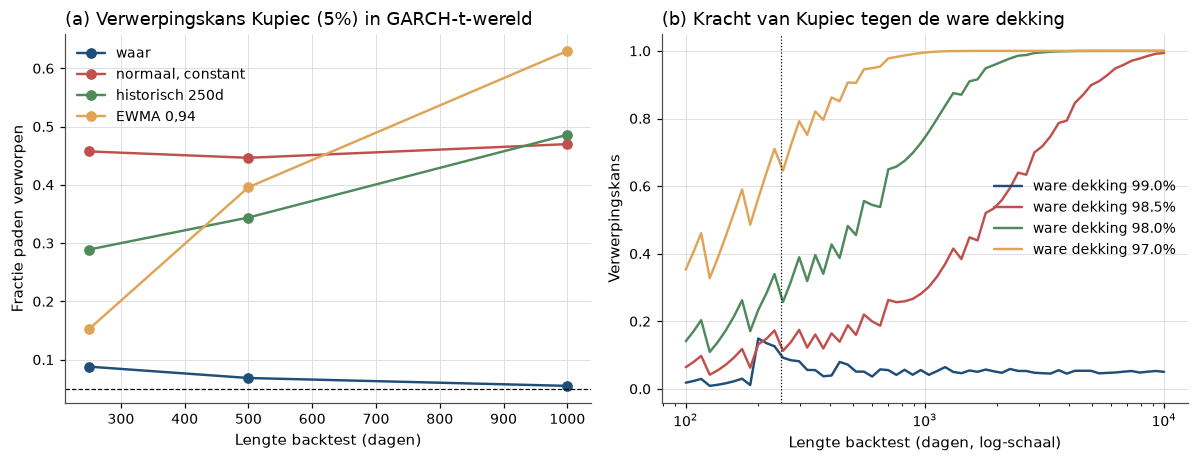
Figure 1:Links: een statisch model met perfect gekende onvoorwaardelijke volatiliteit wordt na een jaar in minder dan de helft van de paden verworpen, en EWMA met normale staarten in een op de zeven. Rechts, exact binomiaal: om een model dat 98% in plaats van 99% dekt met kans 80% te betrappen, zijn enkele jaren dagdata nodig. De stippellijn is het jaar van Bazel.
Zelfs het ware model wordt na 250 dagen in 8,8% van de paden verworpen in plaats van 5%, omdat de -benadering bij 2,5 verwachte overschrijdingen grof is. Het statische model wordt op 1,5% van de dagen overschreden en na een jaar in 46% van de paden verworpen. Dat stijgt nauwelijks met de lengte van de backtest, want de overschrijdingen clusteren, zodat een periode zonder volatiliteitsgolf het goede aantal geeft.
EWMA wordt door zijn normale staart op 1,8% van de dagen overschreden, wat Kupiec na een jaar in 15% van de paden ziet. Het rechterpaneel maakt de les algemeen. Een model met 98% dekking wordt na 250 dagen maar met kans 24% verworpen, de 0,236 voor zeven of meer overschrijdingen uit de Bazelse tabel plus 0,006 voor nul. Een backtest van één jaar laat een fout model dus, zoals verwacht, meestal passeren, om dezelfde reden als bij een gemiddeld rendement, want de standaardfout is groot naast de grootheid zelf.
5.2Vier goede jaren van een convergence trade¶
Nu zetten we Proposition 4 op schaal, met duration 5 en haircut 2% uit het toy-voorbeeld. Een spreadafwijking in basispunten volgt . De dagschok is normaal met een standaarddeviatie van 1,5 basispunt. Gemiddeld eens in de drie jaar komt daar een exponentieel verdeelde sprong van gemiddeld 30 basispunten bij, en het gemiddelde daarvan wordt afgetrokken.
De positie levert een carry van 1% per jaar. Het fonds begint met vermogen 1, zet de positie elke maand terug op maal het vermogen, en moet verkopen zodra . We simuleren 4000 paden van 1260 handelsdagen, met dezelfde schokken voor elke hefboom. Eerst kijken we wat het fonds uit zijn eigen rendementen over de trade kan leren.
N_FUND, T_FUND = 4000, 1260
PHI, SIG_BP, P_JUMP, MU_JUMP, CARRY, KAPPA_FS = 0.99, 1.5, 1 / 750, 30.0, 0.01, 2.0

jump = (rng.random((T_FUND, N_FUND)) < P_JUMP) * rng.exponential(MU_JUMP, (T_FUND, N_FUND))
eta = SIG_BP * rng.standard_normal((T_FUND, N_FUND)) + jump - P_JUMP * MU_JUMP
x_spread = np.zeros((T_FUND + 1, N_FUND))
for t in range(T_FUND):
    x_spread[t + 1] = PHI * x_spread[t] + eta[t]
dx_spread = np.diff(x_spread, axis=0)
r_trade = CARRY / 252 - D * dx_spread / 1e4

sr_true = np.sqrt(252) * r_trade.mean() / r_trade.std()
sr_4y = np.sqrt(252) * r_trade[:1008].mean(axis=0) / r_trade[:1008].std(axis=0)
no_jump_4y = jump[:1008].sum(axis=0) == 0
pd.Series({"Sharpe-ratio (populatie, alle paden)": sr_true,
           "volatiliteit per jaar": np.sqrt(252) * r_trade.std(),
           "scheefheid dagrendement": stats.skew(r_trade.ravel()),
           "fractie 4-jaarsrecords zonder sprong": no_jump_4y.mean(),
           "mediane Sharpe over 4 jaar, zonder sprong": np.median(sr_4y[no_jump_4y]),
           "mediane Sharpe over 4 jaar, met sprong": np.median(sr_4y[~no_jump_4y])}).round(3)
Sharpe-ratio (populatie, alle paden) 0.584
volatiliteit per jaar 0.017
scheefheid dagrendement -21.496
fractie 4-jaarsrecords zonder sprong 0.273
mediane Sharpe over 4 jaar, zonder sprong 0.880
mediane Sharpe over 4 jaar, met sprong 0.660
dtype: float64De trade heeft een Sharpe-ratio van 0,58, maar de scheefheid van de dagrendementen is -21, zodat er bijna altijd een beetje winst is en zelden een groot verlies. In 27% van de vierjaarsperiodes komt geen sprong voor, en daar is de mediane Sharpe-ratio met 0,88 veel hoger. Een fonds met vier goede jaren achter de rug, zoals LTCM in 1994–1997, kan dus met reden denken dat zijn trade beter is dan ze is.
De functie hieronder laat het fonds elke dag zijn vermogen bijwerken, verkopen zodra het vermogen onder de haircut zakt en elke maand de hefboom herstellen. We draaien de functie eerst zonder prijsdruk.
def run_fund(leverage, kappa):
    """Simulate a levered convergence-trade fund with margin constraint E >= H X and fire-sale impact."""
    E = np.ones(N_FUND)
    X = leverage * E
    impact = np.zeros(N_FUND)
    alive = np.ones(N_FUND, bool)
    called = np.zeros(N_FUND, bool)
    for t in range(T_FUND):
        d_impact = (PHI - 1) * impact
        impact += d_impact
        E = np.where(alive, E + X * (CARRY / 252 - D * (dx_spread[t] + d_impact) / 1e4), E)
        for _ in range(100):                                  # forced sales until the constraint holds
            breach = alive & (X > E / H + 1e-12)
            if not breach.any():
                break
            called |= breach
            X_new = np.where(breach, np.maximum(E, 0.0) / H, X)
            widening = kappa * (X - X_new)                    # bp
            impact += widening
            E = E - X_new * D * widening / 1e4
            X = X_new
            alive &= E > 0
            X = np.where(alive, X, 0.0)
        if (t + 1) % 21 == 0:
            X = np.where(alive, leverage * E, 0.0)
    return {"P(margin call)": called.mean(), "P(ruïne)": 1 - alive.mean(),
            "mediaan eindvermogen": np.median(np.where(alive, E, 0.0))}


LEVERAGES = [1, 5, 10, 15, 20, 25, 30]
fund_no_fs = pd.DataFrame({L: run_fund(L, 0.0) for L in LEVERAGES}).T
fund_no_fs.round(3)Zonder prijsdruk stijgt de kans op ruïne binnen vijf jaar van 0,2% bij hefboom 10 naar 11,3% bij hefboom 25, terwijl de mediane eindwaarde stijgt van 1,57 naar 2,56 keer het beginvermogen. Het typische pad beloont de hefboom dus, en de staart straft hem. In de tweede run laat elke gedwongen verkoop van één eenheid beginvermogen de spread met 2 basispunten verbreden, een fire sale (een gedwongen verkoop die de prijs drukt) waarvan de druk even snel wegebt als de rest van de spread.
fund_fs = pd.DataFrame({L: run_fund(L, KAPPA_FS) for L in LEVERAGES}).T
pd.concat({"zonder fire sale": fund_no_fs, "met fire sale": fund_fs}, axis=1).round(3)Met prijsdruk blijft de kans op een margin call gelijk, want de eerste call komt vóór elke gedwongen verkoop. De kans op ruïne stijgt bij hefboom 25 wel, van 11,3% naar 23,6%, terwijl er bij hefboom 10 of minder geen verschil is. Dezelfde trade gaat dus bij een hogere hefboom vaker failliet, en met eigen prijsdruk nog vaker, zoals we verwachtten.
Waarom de prijsdruk pas bij hoge hefboom telt, volgt uit in Proposition 4. De prijsimpact is hier 2 basispunten per eenheid beginvermogen, twee keer die van het toy-voorbeeld, waar een verkoop van 100 bij vermogen 100 de spread 1 basispunt verbreedde. Bij een call is de positie ongeveer keer het beginvermogen, zodat . Bij hefboom 10 is dus 0,5 en komt het fonds bovendien zelden aan zijn limiet, want de kans op een margin call is daar 0,9%. Bij hefboom 20 is precies 1 en bij hefboom 25 al groter dan 1, zodat de spiraal volgens de propositie divergeert. In de figuur is dat de afstand tussen de twee ruïnelijnen boven hefboom 20.
Source
fig, ax = plt.subplots()
ax.plot(LEVERAGES, fund_no_fs["P(ruïne)"], "o-", color=hap.plotting.COLORS[0], label="ruïne, zonder fire sale")
ax.plot(LEVERAGES, fund_fs["P(ruïne)"], "o-", color=hap.plotting.COLORS[1], label="ruïne, met fire sale")
ax.plot(LEVERAGES, fund_no_fs["P(margin call)"], "s--", color=hap.plotting.COLORS[7], label="margin call (beide)")
ax.set_title(f"Zelfde trade, zelfde Sharpe-ratio ({sr_true:.2f}), andere hefboom")
ax.set_xlabel("Hefboom L (positie / eigen vermogen)")
ax.set_ylabel("Kans binnen vijf jaar")
ax.legend()
plt.show()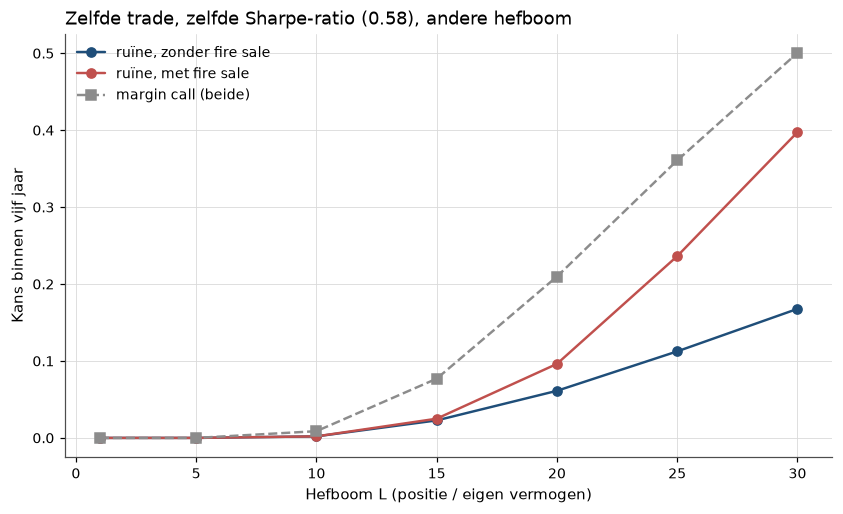
Figure 2:De Sharpe-ratio van de trade is bij elke hefboom dezelfde, maar de kans op een margin call en op ruïne binnen vijf jaar stijgt steil met de hefboom. Vanaf hefboom 25 verdubbelt de eigen prijsdruk de kans op ruïne ruimschoots, terwijl ze tot hefboom 10 geen rol speelt.
6Replicatie op echte data¶
6.1VaR-backtest 1990–2026¶
We bouwen de vier VaR-reeksen, elk met alleen informatie tot en met de dag ervoor, en schatten GARCH op de jaren vóór 1990.
market = hap_data.market_daily()["Mkt"].loc["1963-07-01":]
z01 = stats.norm.ppf(0.01)

var_bt = pd.DataFrame(index=market.index)
var_bt["normaal, constant"] = -(market.expanding(250).mean() + z01 * market.expanding(250).std()).shift(1)
var_bt["historisch 250d"] = -market.rolling(250).quantile(0.01).shift(1)
var_bt["EWMA 0,94"] = -z01 * np.sqrt((market**2).ewm(alpha=0.06, adjust=False).mean().shift(1))

garch = arch_model(100 * market, mean="Constant", vol="GARCH", p=1, q=1, dist="normal")
garch_fit = garch.fit(last_obs="1990-01-01", disp="off")
garch_fc = garch_fit.forecast(start="1990-01-01", horizon=1, reindex=False)
var_bt["GARCH(1,1)"] = (-(garch_fit.params["mu"] + z01 * np.sqrt(garch_fc.variance["h.1"])) / 100).shift(1)

var_bt = var_bt.loc["1990-01-01":].dropna()
loss_bt = -market.loc[var_bt.index]
hits_bt = var_bt.lt(loss_bt, axis=0).astype(int)
garch_fit.params.round(4)
mu 0.0634
omega 0.0057
alpha[1] 0.0921
beta[1] 0.9047
Name: params, dtype: float64Het GARCH-model heeft en , een persistentie van 0,997, en ligt dus dicht bij de EWMA van RiskMetrics, waarvoor precies 1 is. Daarna tellen we per model de overschrijdingen, de toetsen en de zones per volledig jaar.
full_years = hits_bt.loc[:"2025"]
by_year = full_years.groupby(full_years.index.year)
summary_bt = {}
for name in hits_bt:
    lr_ind, lr_cc = christoffersen_lr(hits_bt[name].to_numpy())
    lr_pof = kupiec_lr(hits_bt[name].to_numpy())
    yearly_counts = by_year[name].sum()
    yearly_cc = by_year[name].apply(lambda h: christoffersen_lr(h.to_numpy())[1])
    summary_bt[name] = {"dagen": len(hits_bt), "overschrijdingen": hits_bt[name].sum(),
                        "fractie (%)": 100 * hits_bt[name].mean(),
                        "LR_pof": lr_pof, "LR_ind": lr_ind, "LR_cc": lr_cc,
                        "p-waarde cc": stats.chi2.sf(lr_cc, 2),
                        "dagen met twee op rij": int((hits_bt[name] * hits_bt[name].shift(1)).sum()),
                        "jaren groen": (yearly_counts <= 4).sum(), "jaren geel": yearly_counts.between(5, 9).sum(),
                        "jaren rood": (yearly_counts >= 10).sum(),
                        "jaren cc verworpen": (yearly_cc > stats.chi2.ppf(0.95, 2)).sum()}
pd.DataFrame(summary_bt).T.round(3)De tabel hieronder zet de kern van die uitkomst naast een juist model, dat op 1% van de dagen wordt overschreden.
| model | overschrijdingen hier (%) | juist model (%) | rode jaren (van 36) | (kritiek 3,84) |
|---|---|---|---|---|
| statisch normaal | 3,26 | 1 | 11 | 27,3 |
| historisch 250 dagen | 1,63 | 1 | 2 | 23,9 |
| EWMA 0,94 | 1,98 | 1 | 2 | 6,0 |
| GARCH(1,1) | 2,15 | 1 | 1 | 4,2 |
Geslaagd. Teken en rangorde kloppen met wat we vooraf verwachtten. Het statische model wordt ruim drie keer zo vaak overschreden als het hoort, en het heeft 29 keer twee overschrijdingen op rij, waar bij zijn eigen frequentie te verwachten zijn. De aanpassende modellen zitten dichter bij 1%, maar erboven. Over 36 jaar verwerpt Christoffersen alle vier, omdat de toets met 9211 dagen de kracht heeft die hij met 250 mist. Voor de crisisjaren zetten we de overschrijdingen per jaar naast elkaar.
yearly = hits_bt.groupby(hits_bt.index.year).sum()
yearly.loc[[1997, 1998, 1999, 2000, 2002, 2007, 2008, 2009, 2011, 2020, 2022]]In 1998 is alleen het statische model rood, omdat de andere zich binnen weken aanpasten. In 2008 zijn het statische en het historische model rood, en in 2020 worden ook EWMA en GARCH rood, terwijl het statische model met 23 overschrijdingen nog ver boven hen uitkomt. In 2008 bouwde de volatiliteit zich namelijk over maanden op, zodat EWMA en GARCH konden meelopen, terwijl de volatiliteit in februari 2020 sprong vanuit een van de rustigste periodes van de steekproef. Een model dat van gisteren leert, ziet zo’n sprong niet aankomen. De eerste figuur toont de overschrijdingen per jaar als staven, met de grenzen van geel en rood als lijnen.
Source
fig, ax = plt.subplots(figsize=(11, 4.5))
years = yearly.loc[:2025].index
width = 0.2
for i, name in enumerate(yearly):
    ax.bar(years + (i - 1.5) * width, yearly.loc[:2025, name], width=width, color=hap.plotting.COLORS[i], label=name)
ax.axhline(4.5, color="black", lw=0.8, ls="--")
ax.axhline(9.5, color="black", lw=0.8)
ax.text(years[-1] + 0.5, 4.8, "geel", fontsize=8)
ax.text(years[-1] + 0.5, 9.8, "rood", fontsize=8)
ax.set_title("Overschrijdingen van de 99%-VaR per jaar, Amerikaanse aandelenmarkt")
ax.set_xlabel("Jaar")
ax.set_ylabel("Aantal overschrijdingen (verwacht 2,5)")
ax.legend(ncol=4)
plt.show()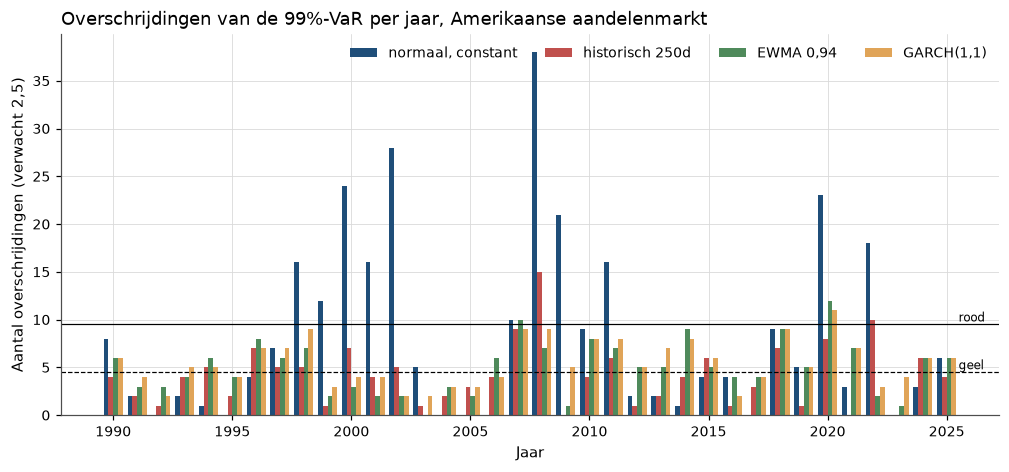
Figure 3:Het statische normale model is rood in elf van de 36 jaren, vooral rond 2000, rond 2008 en in 2020 en 2022, en in de rustige jaren meestal groen, omdat zijn overschrijdingen clusteren. De aanpassende modellen zijn meestal groen of geel, maar het historische model is rood in 2008 en 2022, EWMA in 2007 en 2020 en GARCH in 2020.
De tweede figuur zoomt in op 2008 en 2020, en laat zien hoe snel elke VaR-lijn de verliezen volgt.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3), sharey=True)
for ax, (start_c, end_c, title) in zip(axes, [("2008-06-01", "2009-06-30", "(a) 2008–2009"),
                                              ("2019-12-01", "2020-12-31", "(b) 2020")], strict=True):
    loss_c = 100 * loss_bt.loc[start_c:end_c]
    ax.plot(loss_c.index, loss_c, color=hap.plotting.COLORS[7], lw=0.7, label="verlies")
    for i, name in enumerate(var_bt):
        ax.plot(loss_c.index, 100 * var_bt.loc[start_c:end_c, name], color=hap.plotting.COLORS[i], lw=1.2, label=name)
    ax.set_title(title)
    ax.set_xlabel("Datum")
    ax.tick_params(axis="x", rotation=30)
axes[0].set_ylabel("Dagverlies en 99%-VaR (%)")
axes[0].legend(fontsize=8)
fig.tight_layout()
plt.show()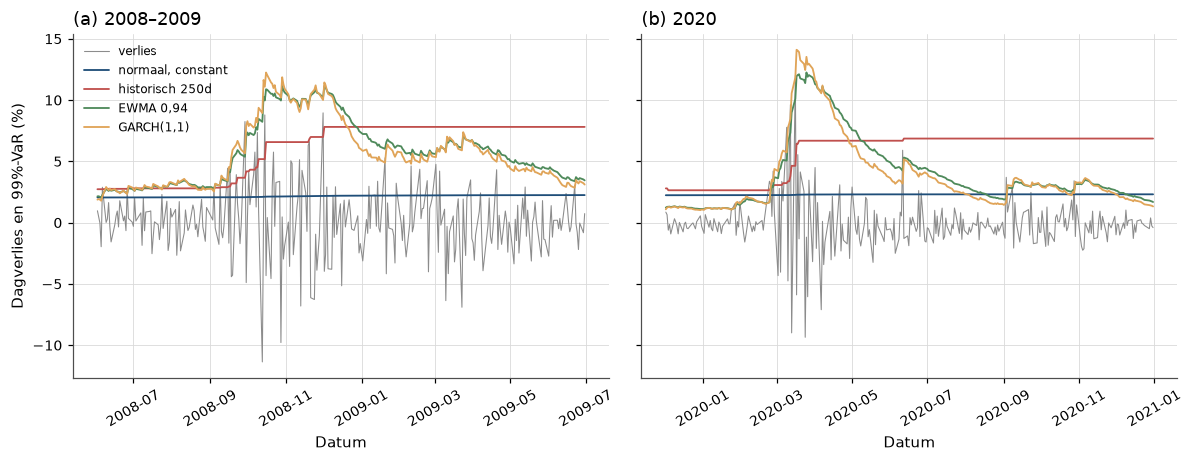
Figure 4:In 2008 liep de volatiliteit in weken op en liepen EWMA en GARCH mee, terwijl het historische model in trappen steeg en daarna een jaar te hoog bleef. In februari 2020 stond de VaR van alle modellen laag toen de eerste grote verliezen kwamen.
6.2De spreads van 1998¶
We meten de verbreding vanaf 14 augustus tot het extreem in de drie maanden erna, en drukken die uit in de dagschommelingen van 1997.
spreads = pd.concat([hap_data.fred(s)[s] for s in ["BAA10Y", "AAA10Y", "TEDRATE", "DGS10"]], axis=1, sort=True)
spreads = spreads.loc["1997-01-01":"1999-12-31"].dropna()
before = spreads.loc[:"1998-08-14"].iloc[-1]
crisis = spreads.loc["1998-08-17":"1998-10-31"]
extreme = pd.concat([crisis[["BAA10Y", "AAA10Y", "TEDRATE"]].max(), crisis[["DGS10"]].min()])
extreme_date = pd.concat([crisis[["BAA10Y", "AAA10Y", "TEDRATE"]].idxmax(), crisis[["DGS10"]].idxmin()])
n_days_move = pd.Series({s: len(spreads.loc["1998-08-15":extreme_date[s]]) for s in spreads})
sd_1997 = spreads.loc["1997"].diff().std()
pd.DataFrame({"14 aug 1998 (%)": before, "extreem aug-okt (%)": extreme, "datum": extreme_date.dt.date,
              "verandering (bp)": 100 * (extreme - before),
              "SD dagverandering 1997 (bp)": 100 * sd_1997,
"in SD's (sqrt-tijd)": (extreme - before) / (sd_1997 * np.sqrt(n_days_move))}).round(2)Geslaagd. De bedrijfsobligatiespreads verbreedden met 84 (Aaa) en 103 basispunten (Baa), terwijl de tienjaarsrente daalde. Een getal uit het origineel staat er niet naast, omdat het rapport de verbreding alleen beschrijft en wij laten zien dat dit soort spreads meebewoog. Opgeschaald met de wortel uit het aantal handelsdagen zijn de bewegingen van de bedrijfsobligatiespreads ruim zes standaarddeviaties van 1997. De TED-spread schommelde in 1997 al sterk en blijft onder drie. Zes standaarddeviaties bewijzen niet dat de wereld niet normaal is, want 1997 was rustig, maar ze laten wel zien wat een model ziet dat in een rustige periode is geschat. De figuur toont de sprong na de lijn van 17 augustus.
Source
fig, ax = plt.subplots()
window = spreads.loc["1998-01-01":"1999-06-30"]
for i, s in enumerate(["BAA10Y", "AAA10Y", "TEDRATE"]):
    ax.plot(window.index, 100 * window[s], color=hap.plotting.COLORS[i], label=s)
for date, text, align in [("1998-08-17", "Rusland ", "right"), ("1998-09-23", " LTCM-consortium", "left")]:
    ax.axvline(pd.Timestamp(date), color="black", lw=0.8, ls="--")
    ax.text(pd.Timestamp(date), 0.03, text, fontsize=8, ha=align, transform=ax.get_xaxis_transform())
ax.set_title("Credit- en liquiditeitsspreads rond de crisis van 1998")
ax.set_xlabel("Datum")
ax.set_ylabel("Spread (basispunten)")
ax.legend(loc="upper left")
plt.show()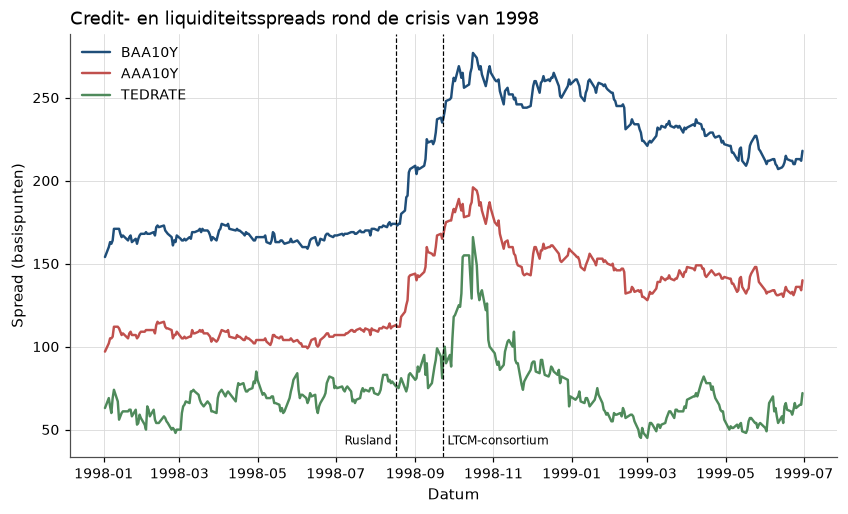
Figure 5:Na 17 augustus verbreedden de bedrijfsobligatiespreads en de TED-spread in weken met meer dan tachtig basispunten. De piek viel pas in oktober, na de redding van LTCM, en begin 1999 waren de bedrijfsobligatiespreads nog niet terug op hun niveau van juli 1998.
Die beweging is groot naast de drempels uit toy-deel (c). Een fonds met hefboom 25 krijgt zijn margin call na 40 basispunten en is failliet na 80, zodat een beweging als die van de Aaa-spread genoeg is. Met hefboom 10 had hetzelfde fonds niet eens een margin call gekregen. De werkelijke posities en haircuts van LTCM kennen we niet, maar het rapport beschrijft wel de afloop (p. 12–14):
op 31 juli had het fonds 4,1 miljard dollar kapitaal
in augustus verloor het 1,8 miljard
op 23 september nam een consortium van veertien instellingen, bijeengebracht door de Federal Reserve Bank of New York, voor ongeveer 3,6 miljard dollar 90% van het fonds over.
7Wat er brak, en wat daarna kwam¶
Wat het model verklaart. VaR gaf risicobeheer een gemeenschappelijke taal en één getal voor limieten en kapitaal. Het gebruikt wat goed meetbaar is, het tweede moment, en laat weg wat dat niet is. In onze backtest werkt dat redelijk, want de aanpassende modellen liggen op 1,6 tot 2,2% overschrijdingen tegen 3,3% voor een statisch model. Kupiec en Christoffersen maakten een risicomodel weerlegbaar, en de coherentie-axioma’s kwamen in 2016 in de regels.
Waar het breekt. Het breekt op de dagen waarover het getal niets zegt. Een 99%-VaR die in 2020 twaalf keer wordt overschreden, is geen goed model met pech. De spreads waarop LTCM wedde, bewogen in twee maanden ruim zes standaarddeviaties, en volgens het rapport waren de verliezen veel groter dan modellen uit rustiger tijden waarschijnlijk vonden (p. 12). Het diepste gebrek was de aanname dat een positie tegen de marktprijs kan worden gesloten. In onze simulatie heeft dezelfde trade daardoor een kans op ruïne van bijna nul of bijna een op vier, afhankelijk van hefboom en eigen prijsdruk.
Risico of vergissing? De Chicago-lezing ziet in de spreads van 1997 een beloning voor liquiditeits- en crashrisico, en in augustus 1998 de slechte toestand waarvoor die beloning werd betaald. LTCM droeg dan risico met een premie, alleen met te weinig kapitaal. De Yale-lezing van Shleifer & Vishny (1997) ziet spreads die groter werden dan hun fundamentele waarde omdat arbitrageurs moesten verkopen. De posities en verkopen van arbitrageurs zouden de lezingen kunnen scheiden, maar die data zijn niet publiek, en één episode is geen steekproef. Wel zegt Santa-Clara’s onderscheid tussen premie en vermeend inzicht iets over het fonds. Het rendement kwam uit risico met een premie, en het verlies uit het geloof dat de hefboom veilig was.
Wat er daarna kwam. Als arbitrageurs een mispricing niet kunnen wegwerken omdat hun financiering verdwijnt, wordt de vraag wie de prijzen dan zet en waarom beleggers zich vergissen. Daarover gaat het college over gedrag en de grenzen van arbitrage.
8Oefeningen¶
Solution to Exercise 1
(1) Bij hefboom 20 komt de margin call na , dus 60 basispunten, en de ruïne na , dus 100 basispunten. Bij hefboom 15 is dat , dus 93,3 basispunten, en , dus 133,3 basispunten.
(2) Geen margin call betekent , dus , en .
def thresholds_bp(leverage, duration=D, haircut=H):
    """Spread widening in basis points at which the margin call and ruin arrive."""
    call = (1 - haircut * leverage) / (leverage * duration)
    ruin = 1 / (leverage * duration)
    return 1e4 * call, 1e4 * ruin


max_leverage = 1 / (H + 0.0084 * D)
print(f"hoogste hefboom zonder margin call bij 84 bp: {max_leverage:.1f}")
pd.DataFrame({L: thresholds_bp(L) for L in (10, 15, 20, 25)},
             index=["margin call (bp)", "ruïne (bp)"]).T.round(1)
hoogste hefboom zonder margin call bij 84 bp: 16.1
Van hefboom 10 naar 20 daalt de afstand tot de margin call van 160 naar 60 basispunten, dus met meer dan de helft. Een hogere hefboom verhoogt namelijk zowel het verlies per basispunt als het vereiste onderpand.
:::{exercise}
:label: ex-risk-management-2

**ES en VaR bij dikke staarten.** Laat $L = \sigma T_\nu\sqrt{(\nu-2)/\nu}$ met $T_\nu$
Student-$t$. Dan is $\SD(L) = \sigma$, zodat alleen de staart verandert.

1. Laat zien dat $\mathrm{ES}_\alpha(T_\nu) = \dfrac{f_\nu(t_\alpha)}{1-\alpha}\cdot\dfrac{\nu + t_\alpha^2}{\nu-1}$,
   met $f_\nu$ de dichtheid en $t_\alpha$ het $\alpha$-kwantiel van $T_\nu$.
2. Bereken voor $\nu \in \{4, 6, 10, \infty\}$ de verhouding $\mathrm{ES}_{0{,}975}/\mathrm{VaR}_{0{,}99}$.
3. Wat betekent dat voor het kapitaal onder de regels van 2016 tegenover die van 1996?
Solution to ex-risk-management-2
(1) Differentieer . Dan is , dus . Deel door .
def t_scaled(alpha, nu):
    """Standardised (unit variance) Student-t VaR and ES at level alpha."""
    if np.isinf(nu):
        z = stats.norm.ppf(alpha)
        return z, stats.norm.pdf(z) / (1 - alpha)
    q = stats.t.ppf(alpha, nu)
    es = stats.t.pdf(q, nu) / (1 - alpha) * (nu + q**2) / (nu - 1)
    scale = np.sqrt((nu - 2) / nu)
    return q * scale, es * scale


es_check = stats.t.expect(lambda x: x, args=(6,), lb=stats.t.ppf(0.975, 6)) / 0.025
print(f"controle nu = 6: formule {t_scaled(0.975, 6)[1] / np.sqrt(4 / 6):.4f}, numeriek {es_check:.4f}")
pd.DataFrame({nu: {"VaR 99%": t_scaled(0.99, nu)[0], "ES 97,5%": t_scaled(0.975, nu)[1],
                   "ES 97,5% / VaR 99%": t_scaled(0.975, nu)[1] / t_scaled(0.99, nu)[0]}
              for nu in (4, 6, 10, np.inf)}).T.round(3)
controle nu = 6: formule 3.2562, numeriek 3.2562
(2) en (3) De verhouding stijgt van 1,005 bij normaliteit naar 1,066 bij . Bij gelijke volatiliteit ligt de 99%-VaR van een dikstaartige verdeling al hoger, 2,65 tegen 2,33 bij , en de ES stijgt nog iets meer. De overstap laat het kapitaal onder normaliteit dus gelijk en maakt dikke staarten duurder, precies waar Santa-Clara de zwakte van VaR zag.
:::{exercise}
:label: ex-risk-management-3

**Filtered historical simulation.** Voeg aan de backtest van 1990–2026 twee modellen toe. Het
eerste is GARCH(1,1) met gestandaardiseerde Student-$t$-schokken, geschat op 1963–1989. Het
tweede is filtered historical simulation, die de rendementen deelt door de EWMA-volatiliteit en
het 1%-kwantiel over 1000 dagen vermenigvuldigt met de EWMA-volatiliteit van morgen. Rapporteer
overschrijdingen, rode jaren en de aantallen in 1998, 2008 en 2020.
Solution to ex-risk-management-3
garch_t = arch_model(100 * market, mean="Constant", vol="GARCH", p=1, q=1, dist="t")
garch_t_fit = garch_t.fit(last_obs="1990-01-01", disp="off")
nu_hat = garch_t_fit.params["nu"]
q01_t = stats.t.ppf(0.01, nu_hat) * np.sqrt((nu_hat - 2) / nu_hat)
fc_t = garch_t_fit.forecast(start="1990-01-01", horizon=1, reindex=False)
var_garch_t = (-(garch_t_fit.params["mu"] + q01_t * np.sqrt(fc_t.variance["h.1"])) / 100).shift(1)

ewma_sd = np.sqrt((market**2).ewm(alpha=0.06, adjust=False).mean())
standardised = market / ewma_sd.shift(1)
var_fhs = -(standardised.rolling(1000).quantile(0.01) * ewma_sd).shift(1)

extra = pd.DataFrame({"GARCH-t": var_garch_t, "FHS (EWMA)": var_fhs}).reindex(var_bt.index)
hits_extra = extra.lt(loss_bt, axis=0).astype(int)
yearly_extra = hits_extra.groupby(hits_extra.index.year).sum()
pd.DataFrame({name: {"nu": nu_hat if name == "GARCH-t" else np.nan,
                     "overschrijdingen": hits_extra[name].sum(),
                     "fractie (%)": 100 * hits_extra[name].mean(),
                     "jaren rood (t/m 2025)": (yearly_extra.loc[:2025, name] >= 10).sum(),
                     "1998": yearly_extra.loc[1998, name], "2008": yearly_extra.loc[2008, name],
"2020": yearly_extra.loc[2020, name]} for name in extra}).T.round(3)Met -schokken () daalt het aantal GARCH-overschrijdingen van 198 naar 156, maar 2020 blijft rood. FHS komt met 1,16% het dichtst bij 1%, zonder rood jaar, omdat het de staart uit de data haalt en het niveau uit EWMA. Ook FHS wordt in 2020 iets vaker overschreden dan verwacht, maar blijft daar groen. De meeste fouten van VaR komen dus niet uit het idee zelf, maar uit de normale staart en de trage aanpassing.
- J.P. Morgan/Reuters. (1996). RiskMetrics — Technical Document (4th ed.) [Techreport]. Morgan Guaranty Trust Company of New York. https://www.msci.com/documents/10199/5915b101-4206-4ba0-aee2-3449d5c7e95a
- Basle Committee on Banking Supervision. (1996). Amendment to the Capital Accord to Incorporate Market Risks [Techreport]. Bank for International Settlements. https://www.bis.org/publ/bcbs24.htm
- Basle Committee on Banking Supervision. (1996). Supervisory Framework for the Use of “Backtesting” in Conjunction with the Internal Models Approach to Market Risk Capital Requirements [Techreport]. Bank for International Settlements. https://www.bis.org/publ/bcbs22.htm
- Kupiec, P. H. (1995). Techniques for Verifying the Accuracy of Risk Measurement Models. The Journal of Derivatives, 3(2), 73–84. 10.3905/jod.1995.407942
- Christoffersen, P. F. (1998). Evaluating Interval Forecasts. International Economic Review, 39(4), 841–862. 10.2307/2527341
- Artzner, P., Delbaen, F., Eber, J.-M., & Heath, D. (1999). Coherent Measures of Risk. Mathematical Finance, 9(3), 203–228. 10.1111/1467-9965.00068
- Basel Committee on Banking Supervision. (2016). Minimum Capital Requirements for Market Risk [Techreport]. Bank for International Settlements. https://www.bis.org/bcbs/publ/d352.htm
- Jorion, P. (2006). Value at Risk: The New Benchmark for Managing Financial Risk (3rd ed.). McGraw-Hill.
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Lowenstein, R. (2000). When Genius Failed: The Rise and Fall of Long-Term Capital Management. Random House.
- President’s Working Group on Financial Markets. (1999). Hedge Funds, Leverage, and the Lessons of Long-Term Capital Management [Techreport]. U.S. Department of the Treasury. https://home.treasury.gov/system/files/236/hedgfund.pdf
- Acerbi, C., & Tasche, D. (2002). Expected Shortfall: A Natural Coherent Alternative to Value at Risk. Economic Notes, 31(2), 379–388. 10.1111/1468-0300.00091
- Hull, J., & White, A. (1998). Incorporating Volatility Updating into the Historical Simulation Method for Value-at-Risk. The Journal of Risk, 1(1), 5–19. 10.21314/JOR.1998.001
- Barone-Adesi, G., Giannopoulos, K., & Vosper, L. (1999). VaR without Correlations for Portfolios of Derivative Securities. Journal of Futures Markets, 19(5), 583–602. https://doi.org/10.1002/(SICI)1096-9934(199908)19:5<;583::AID-FUT5>3.0.CO;2-S
- Engle, R. F. (1982). Autoregressive Conditional Heteroscedasticity with Estimates of the Variance of United Kingdom Inflation. Econometrica, 50(4), 987–1007. 10.2307/1912773
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD