

Roll: de kritiek en de R²
1Overzicht
Wat toetst een toets van het CAPM? Alleen of de gebruikte index mean-variance-efficiënt is, en niet het model. Een lineaire relatie tussen verwacht rendement en bèta is wiskundig hetzelfde als efficiëntie van de portefeuille waartegen de bèta’s gemeten zijn. Efficiënt heet in dit college elke portefeuille op de minimum-variantierand, ook op de onderste tak met een lager verwacht rendement, zodat de efficiënte grens hier de hele minimum-variantierand is. Omdat de ware marktportefeuille niet waarneembaar is, toetst elke toets met een proxy alleen de proxy. In dit college:
leiden we Rolls stelling af: de lijn geldt dan en slechts dan als de portefeuille op de minimum-variantierand ligt, en dat geldt ook in elke steekproef;
laten we met Roll en Ross zien dat een proxy die duidelijk met de markt correleert, toch een helling van nul kan geven;
simuleren we een wereld waarin het CAPM exact geldt, en vragen we of een onderzoeker met vijftig jaar data ziet dat zijn proxy scheef ligt;
repliceren we de tautologie op de 25 size/BM-portefeuilles van French, en Rolls uit 1988 op portefeuilles en op vijftig grote aandelen.
In maart 1977 publiceerde Richard Roll een kritiek van bijna vijftig pagina’s op de toetsen van het CAPM Roll (1977). Hij beweerde niet dat het CAPM onjuist is, maar dat de toetsen er niets over zeiden.
Met dat werk begint een nieuw tijdvak, omdat het de status van het CAPM verandert. Tot 1977 was het CAPM een toetsbare theorie, daarna een theorie waarvan de centrale grootheid niet te meten is. Roll & Ross (1994) en Kandel & Stambaugh (1995) maakten het argument scherper.
Daarna vroeg Roll wat prijzen eigenlijk beweegt. Het weer in Florida verklaarde weinig van de prijs van sinaasappelsap Roll (1984), en markt en industrie verklaarden weinig van de rendementen van losse aandelen Roll (1988).
2Intuïtie: waarom zou dit waar zijn?
Neem een portefeuille op de minimum-variantierand. Wat maakt die portefeuille efficiënt? Geen enkele verschuiving van geld tussen twee activa verhoogt het verwachte rendement zonder ook het risico te verhogen. In het optimum levert elk activum dus evenveel extra rendement per eenheid risico die het toevoegt. Dat toegevoegde risico is zijn covariantie met de portefeuille, en die covariantie is, geschaald, zijn bèta.
In dat argument komen geen evenwicht, beleggers of voorkeuren voor. Het volgt uit de optimalisatie alleen, en daarom geldt het ook in een steekproef. Wie achteraf de portefeuille kiest die in de data efficiënt was, vindt dat alle gemiddelde rendementen exact op een lijn liggen, maar dat bewijst niets over het CAPM.
Het CAPM voegt daar één bewering aan toe, namelijk dat de marktportefeuille (alle vermogenstitels, gewogen naar hun waarde) een van die efficiënte portefeuilles is. De ware markt bevat ook obligaties, vastgoed, private ondernemingen en het menselijk kapitaal van iedereen die werkt. Het rendement van die markt kent niemand.
Een onderzoeker met een aandelenindex toetst dus alleen of die index efficiënt is. Verwerpt hij die efficiëntie, dan weet hij niet of het CAPM fout is of de index de verkeerde portefeuille. Verwerpt hij de efficiëntie niet, dan kan de index toevallig efficiënt zijn terwijl het CAPM onjuist is.
Geeft een index die bijna de markt is dan niet bijna de goede lijn? Nee, want het gaat om de richting waarin de proxy (de waarneembare vervanger van de markt) afwijkt, niet om de afstand. Een proxy die iets minder belegt in de activa met een hoog verwacht rendement, blijft sterk met de markt gecorreleerd. Toch verklaren de bèta’s ten opzichte van die proxy de rendementen niet meer.
Als een toets van het CAPM alleen de proxy toetst, wat kan een systematische factor dan wel verklaren? Roll stelde die vraag later over varianties, en vroeg welk deel van de beweging van een aandeel volgt uit wat de markt of de industrie doet. Als het meeste nieuws over het bedrijf zelf gaat, is dat deel klein.
Uit dit alles volgen drie verwachtingen. Tegenover een efficiënte portefeuille ligt de lijn exact, ook in de data. Een kleine afwijking in de verkeerde richting kan de helling tot nul drukken, en het grootste deel van de beweging van een los aandeel is niet systematisch.
3Toy-voorbeeld: drie activa en twee portefeuilles
We nemen de drie activa uit Markowitz, Roy en Tobin, zonder risicovrij activum, en vergelijken een efficiënte met een inefficiënte portefeuille. De eerste codecel laadt de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Verwachte rendementen per jaar en de covariantiematrix :
| activum | ||||
|---|---|---|---|---|
| 1 aandelen | 0,10 | 0,04 | 0,02 | 0 |
| 2 kleine aandelen | 0,14 | 0,02 | 0,09 | 0 |
| 3 obligaties | 0,04 | 0 | 0 | 0,01 |
Uit Markowitz, Roy en Tobin kennen we de vier getallen die de minimum-variantierand vastleggen ((7)): , , en . Daar zagen we ook dat een grensportefeuille gewichten heeft ((6)), zodat de covariantie van activum met gelijk is aan .
Het recept. Tegenover een grensportefeuille ligt elk activum op de lijn , met . De theorie leidt dit als eerste af.
Stap 1: de multiplicatoren. en zijn de Lagrange-multiplicatoren van het minimum-variantieprobleem; Markowitz, Roy en Tobin leidt hun formules af uit (6) en de twee restricties. Kies op de grens met . Dan is en .
Stap 2: de bèta’s. De covarianties met zijn , en de variantie van is . Delen geeft de bèta’s . Aandelen hebben bèta 1, omdat ze hetzelfde verwachte rendement hebben als .
Stap 3: de lijn. en de helling is . Kleine aandelen: . Obligaties: . Alle drie liggen exact op de lijn.
Stap 4: een inefficiënte portefeuille. De gelijkgewogen portefeuille heeft verwacht rendement 9,33%. De covarianties met die portefeuille zijn de rijgemiddelden van , , en de variantie van de portefeuille zelf is 0,02. De bèta’s zijn dus .
Stap 5: de OLS-lijn. De afwijkingen van het gemiddelde zijn in bèta en procentpunt in rendement. De helling is en het intercept . De residuen zijn procentpunt. De is één min de kwadratensom van de residuen gedeeld door die van de rendementsafwijkingen: .
Dezelfde getallen rekenen we nu in code na.
mu = np.array([0.10, 0.14, 0.04])          # aandelen, kleine aandelen, obligaties
Sigma = np.array([[0.04, 0.02, 0.00],
                  [0.02, 0.09, 0.00],
                  [0.00, 0.00, 0.01]])
ones = np.ones(3)
Sinv_1, Sinv_mu = np.linalg.solve(Sigma, ones), np.linalg.solve(Sigma, mu)
A, B, C = ones @ Sinv_1, ones @ Sinv_mu, mu @ Sinv_mu
D = A * C - B**2


def sml_fit(betas, means):
    """Cross-sectional OLS of mean returns on betas: intercept, slope, residuals, R^2."""
    X = np.column_stack([np.ones(len(betas)), betas])
    coef = np.linalg.lstsq(X, means, rcond=None)[0]
    resid = means - X @ coef
    return coef[0], coef[1], resid, 1 - resid.var() / means.var()


mu_p = 0.10
lam, delta = (A * mu_p - B) / D, (C - B * mu_p) / D
w_eff = lam * Sinv_mu + delta * Sinv_1
beta_eff = Sigma @ w_eff / (w_eff @ Sigma @ w_eff)
_, slope_eff, resid_eff, _ = sml_fit(beta_eff, mu)
w_equal = ones / 3
beta_equal = Sigma @ w_equal / (w_equal @ Sigma @ w_equal)
intercept_equal, slope_equal, _, r2_equal = sml_fit(beta_equal, mu)

hand = {"lambda": 0.368, "delta": -0.01248, "efficiënt: bèta kleine aandelen": 1.6053,
        "efficiënt: bèta obligaties": 0.0921, "efficiënt: mu_z": 0.0339,
        "efficiënt: helling": 0.0661, "efficiënt: grootste |residu|": 0.0,
        "gelijkgewogen: bèta kleine aandelen": 1.8333, "gelijkgewogen: helling": 0.06,
        "gelijkgewogen: intercept": 0.0333, "gelijkgewogen: R²": 0.9868}
code = {"lambda": lam, "delta": delta, "efficiënt: bèta kleine aandelen": beta_eff[1],
        "efficiënt: bèta obligaties": beta_eff[2], "efficiënt: mu_z": -delta / lam,
        "efficiënt: helling": slope_eff, "efficiënt: grootste |residu|": np.abs(resid_eff).max(),
        "gelijkgewogen: bèta kleine aandelen": beta_equal[1],
        "gelijkgewogen: helling": slope_equal, "gelijkgewogen: intercept": intercept_equal,
        "gelijkgewogen: R²": r2_equal}
pd.DataFrame({"met de hand": hand, "code": code}).round(4)De twee kolommen zijn gelijk. Tegenover de efficiënte portefeuille zijn de residuen nul, tegenover de gelijkgewogen niet. Toch oogt een van 0,9868 als een bijna perfecte lijn. De van een cross-sectionele regressie zegt dus niet hoe ver de proxy van de grens ligt.
4Theorie
We leiden eerst Rolls stelling af: een exacte lijn tussen verwacht rendement en bèta bestaat dan en slechts dan als de portefeuille op de minimum-variantierand ligt, ook met steekproefmomenten. Dat is de kern. Daarna volgen drie gevolgen voor de toetsen. Een lemma over Sharpe-ratio’s en een propositie in de geest van Roll en Ross laten zien dat een proxy met een hoge correlatie met de markt toch een helling van nul kan geven, en dat rekenen we na in een modelwereld. Ten slotte behandelen we Rolls tweede vraag, namelijk welk deel van de variantie systematisch is.
4.1Opzet
Er zijn risicovolle activa met netto rendementen , verwachting en positief definiete covariantiematrix , zoals in Opzet, data en conventies. Een portefeuille heeft gewichten met en rendement . De bèta van activum ten opzichte van is . Omdat , is de vector van bèta’s
De bèta van een activum is dus zijn covariantie met de portefeuille, gemeten in eenheden van de variantie van die portefeuille. In het toy-voorbeeld gaf dat .
De minimum-variantierand (per verwacht rendement de portefeuille met de laagste variantie) is de oplossing van (4). De grensportefeuille met verwacht rendement heeft gewichten , met en . Zoals afgesproken in het Overzicht heet elke portefeuille op de minimum-variantierand efficiënt, ook het deel onder de minimum-variantieportefeuille, zodat de grens de hele parabool is. Het subscript staat in dit college voor de marktportefeuille, niet voor de SDF.
4.2Het kernresultaat: Rolls stelling
Waarom zou dit waar zijn? Een belegger op de grens schuift een euro van obligaties naar kleine aandelen. Zijn verwachte rendement stijgt, maar zijn variantie ook, met de covariantie van kleine aandelen met zijn portefeuille. Op de grens wegen die twee voor elk paar activa tegen elkaar op, zodat het verwachte rendement van een activum met een vaste hoeveelheid per eenheid bèta stijgt. Omgekeerd levert geen enkele verschuiving iets op als die vaste verhouding overal geldt, en dan ligt de portefeuille op de grens.
Tegenover een grensportefeuille ligt elk activum dus op een rechte lijn door het zero-beta-rendement en door zelf. In het toy-voorbeeld was en de helling 6,61%. Nergens in de stelling speelt een belegger of een voorkeur een rol, zoals de intuïtie al deed vermoeden.
Het bewijsidee is kort. Op de grens is de covariantie van elk activum met gelijk aan . Delen door de variantie van geeft de lijn in bèta. Omgekeerd geeft een exacte lijn gewichten van de grensvorm, en die voldoen aan de eerste-ordevoorwaarde.
Proof 1
Stap 1: van de grens naar de lijn. Op de grens geldt , dus . Vermenigvuldigen met geeft . Aftrekken en delen door :
Omdat is . Met volgt . De relatie is lineair in de gewichten, dus een portefeuille met bèta nul heeft verwacht rendement .
Stap 2: van de lijn naar de grens. Stapel de relaties met (1): , dus met en . Die voldoet aan de eerste-ordevoorwaarde van (4). Het probleem is strikt convex, omdat positief definiet is, en heeft lineaire restricties, dus die voorwaarde is voldoende: ligt op de minimum-variantierand.
Daarmee klopt de eerste voorspelling uit de intuïtie, want ook in de data ligt de lijn exact.
Het bewijs gebruikt alleen dat positief definiet is en dat . Beide gelden voor steekproefmomenten zodra , en de OLS-bèta van op is .
Met een risicovrij activum is dit Proposition 1: in overrendementen gaat de lijn door de oorsprong dan en slechts dan als de tangentportefeuille is. Zonder risicovrij activum is het de kern van Theorem 2: dan loopt de lijn door het rendement van een portefeuille met bèta nul ten opzichte van de markt. Men las het zero-beta-CAPM als een implicatie (als de markt efficiënt is, geldt de lijn), terwijl Roll het las als een equivalentie: de lijn is niets anders dan efficiëntie.
4.3Wat het voorspelt: drie gevolgen voor de toetsen
Roll trok uit de equivalentie drie conclusies Roll (1977).
Eén toetsbare hypothese. Lijn en efficiëntie zijn hetzelfde, dus het CAPM heeft geen aparte implicatie over lineariteit. De enige toetsbare hypothese is dat de marktportefeuille mean-variance-efficiënt is.
Een tautologie in elke steekproef. Volgens Corollary 1 is er in elke dataset een portefeuille, de achteraf efficiënte, waartegen alle gemiddelde rendementen exact op een lijn liggen. Een gevonden lijn zegt alleen iets als de proxy vooraf vastlag. Een ontbrekende lijn zegt alleen dat de proxy in de steekproef niet op de grens ligt.
De ware markt is niet waarneembaar. Een aandelenindex laat obligaties, vastgoed, private ondernemingen en menselijk kapitaal weg. Elke toets wordt zo een joint hypothesis (gezamenlijke hypothese, waarbij een verwerping aan elk onderdeel kan liggen), namelijk dat het CAPM waar is én de proxy efficiënt. Met de data van 1977 was zo’n toets volgens Roll niet uitvoerbaar.
4.4Bijna-efficiënte proxy’s
Hoe dicht moet een proxy bij de markt liggen om de goede lijn te geven? Dichter dan zijn correlatie doet vermoeden. Vanaf hier is er een risicovrij activum met rente . We werken met overrendementen met verwachting , en het CAPM geldt exact, zodat de ware markt de tangentportefeuille is.
Kijk eerst naar een belegger met een portefeuille die deels met de markt meebeweegt en deels niet. In een CAPM-wereld hangt elke premie af van de covariantie met de markt, zodat hij alleen beloond wordt voor het deel dat meebeweegt. Hoe lager de correlatie, hoe meer onbeloond risico hij draagt, en hoe lager zijn Sharpe-ratio.
In woorden: een proxy met correlatie 0,9 met de ware markt haalt 90% van de Sharpe-ratio van die markt. De vragen hoe inefficiënt een proxy is en hoe sterk hij met de markt correleert, zijn daarmee één vraag.
Waarom kan een bijna-efficiënte proxy dan toch een vlakke lijn geven? Een onderzoeker regresseert verwachte rendementen op bèta’s. De helling is positief zolang activa met een hoge premie ook een hoge bèta hebben. Neem nu een proxy die iets minder belegt in activa met een hoge premie en iets meer in activa met een lage. De bèta’s van de activa met een hoge premie dalen en die met een lage premie stijgen. Omdat ook de spreiding van de bèta’s krimpt, kan de helling eerst zelfs stijgen. Bij een grotere dosis valt ze naar nul, terwijl de proxy nog grotendeels met de markt meebeweegt.
Roll & Ross (1994) lieten zien dat proxy’s met helling nul binnen de grens liggen, maar er dicht bij kunnen liggen. Volgens Kandel & Stambaugh (1995) kunnen de OLS-helling en de bij een inefficiënte proxy in wezen elke waarde aannemen. De propositie vat de meetkunde samen in onze notatie.
Proof 3
Stap 1 (propositie): de helling is een covariantie. De teller van de OLS-helling is , omdat . Met (1) is dat . De noemer is positief zolang niet alle bèta’s gelijk zijn.
Stap 2 (gevolg): de beste proxy is een projectie. Om de proxy met de hoogste correlatie als projectie te herkennen, meten we lengtes en hoeken met covarianties, via het inproduct . Ontbind met ; dan is . Voor elke met geeft Cauchy-Schwarz , dus , met gelijkheid voor . Ten slotte is .
De proxy wijkt dus van de markt af door minder te beleggen in activa met een hoge premie. Volgens het lemma haalt hij een fractie van de Sharpe-ratio van de markt. Een even grote afwijking in een willekeurige andere richting verandert de helling nauwelijks.
Hoe groot is ? Dat hangt af van . Veel activa met veel eigen ruis en weinig spreiding in premies maken vooral ruis. Dan daalt die correlatie en stijgt naar één, zodat de nulhelling vlak naast de markt ligt. Meer spreiding in premies werkt de andere kant op. In het toy-voorbeeld met een risicovrije rente is (oefening 1).
4.5Numerieke uitwerking: een wereld van honderd activa
Hoe dicht ligt de nulhelling bij de markt in een wereld met realistische getallen? We bouwen een wereld met activa waarin het CAPM per constructie exact geldt. De overrendementen volgen één factor met volatiliteit 4,5% per maand. De factorbèta’s liggen rond 1 met standaarddeviatie 0,30, en de idiosyncratische volatiliteiten tussen 8% en 12% per maand. De marktgewichten zijn lognormaal, zoals marktkapitalisaties. De premies zijn met , dus de ware markt is de tangentportefeuille.
def make_world(n_assets, kappa=3.0):
    """One-factor world in which the CAPM holds exactly for the value-weighted market."""
    betas = 1.0 + 0.30 * rng.standard_normal(n_assets)
    sd_eps = 0.08 + 0.04 * rng.random(n_assets)
    cov = 0.045**2 * np.outer(betas, betas) + np.diag(sd_eps**2)
    caps = rng.lognormal(0.0, 1.0, n_assets)
    w_m = caps / caps.sum()
    mu_e = kappa * cov @ w_m
    return {"cov": cov, "w_m": w_m, "mu_e": mu_e, "d": mu_e - mu_e.mean(),
            "chol": np.linalg.cholesky(cov)}


def corr_with_market(world, w):
    cov, w_m = world["cov"], world["w_m"]
    return (w @ cov @ w_m) / np.sqrt((w @ cov @ w) * (w_m @ cov @ w_m))


def population_sml(world, w):
    """Intercept and slope of the cross-sectional OLS of true expected returns on true betas."""
    cov = world["cov"]
    intercept, slope, _, r2 = sml_fit(cov @ w / (w @ cov @ w), world["mu_e"])
    return intercept, slope, r2


world = make_world(100)
premium_m = world["w_m"] @ world["mu_e"]
sd_m = np.sqrt(world["w_m"] @ world["cov"] @ world["w_m"])
pd.Series({"marktpremie (% per maand)": 100 * premium_m, "marktvolatiliteit (% per maand)": 100 * sd_m,
           "Sharpe-ratio markt (per jaar)": np.sqrt(12) * premium_m / sd_m,
           "rho* uit de propositie": np.sqrt(1 - corr_with_market(world, world["d"])**2)}).round(4)
marktpremie (% per maand) 0.6608
marktvolatiliteit (% per maand) 4.6931
Sharpe-ratio markt (per jaar) 0.4877
rho* uit de propositie 0.6225
dtype: float64De marktpremie is 0,66% per maand bij een volatiliteit van 4,69%, een Sharpe-ratio van 0,49 per jaar. De beste proxy met helling nul heeft , zodat “bijna efficiënt” hier ruim gelezen moet worden. Hij haalt 62% van de Sharpe-ratio van de markt, en toch verklaart bèta ten opzichte van hem niets van de premies. Om te zien hoe de helling verloopt, lopen we nu het pad af, van de markt tot voorbij , en meten we langs dat pad de helling van de SML.
c_star = (world["d"] @ world["cov"] @ world["w_m"]) / (world["d"] @ world["cov"] @ world["d"])
path = []
for c in np.linspace(0.0, 1.15 * c_star, 200):
    w = world["w_m"] - c * world["d"]
    _, slope, _ = population_sml(world, w)
    path.append({"correlatie": corr_with_market(world, w), "helling / premie": slope / premium_m})
path = pd.DataFrame(path)

steepest = path.loc[path["helling / premie"].idxmax()]
pd.Series({"hoogste helling / premie": steepest["helling / premie"],
           "correlatie bij de hoogste helling": steepest["correlatie"],
           "correlatie bij helling nul": corr_with_market(world, world["w_m"] - c_star * world["d"])
           }).round(3)
hoogste helling / premie 1.715
correlatie bij de hoogste helling 0.748
correlatie bij helling nul 0.623
dtype: float64Het pad is niet monotoon, want de teller van de helling, , daalt lineair in , maar ook de spreiding van de bèta’s in de noemer krimpt. Let op de rode lijn tussen correlatie 1 en de plek waar ze de nullijn kruist.
Source
fig, ax = plt.subplots()
ax.plot(path["correlatie"], path["helling / premie"], color=hap.plotting.COLORS[1],
        lw=1.8, label="ongunstige kanteling")
ax.axhline(1.0, color="black", lw=0.8, ls="--")
ax.axhline(0.0, color="black", lw=0.8)
ax.set_xlim(1.01, 0.45)
ax.set_ylim(-2, 4)
ax.set_xlabel("Correlatie van de proxy met de ware markt (= relatieve Sharpe-ratio)")
ax.set_ylabel("Helling van de SML / ware marktpremie")
ax.set_title("Hoe dicht moet een proxy bij de markt liggen? (populatie)")
ax.legend()
plt.show()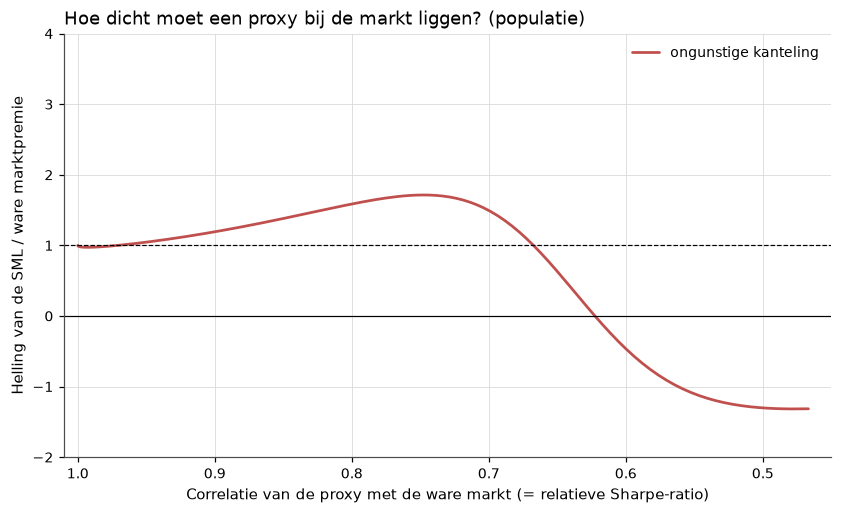
Figure 1:De helling van de populatie-SML, als fractie van de ware marktpremie, tegen de correlatie van de proxy met de ware markt, langs de ongunstige kanteling. De helling stijgt eerst boven de premie en zakt dan door nul, terwijl de proxy nog een groot deel van de Sharpe-ratio van de markt haalt.
De lijn wordt eerst steiler, tot 1,7 keer de ware premie bij correlatie 0,75. Daarna valt de helling snel naar nul bij correlatie 0,62, en verder naar negatieve waarden. De OLS-helling kan dus in wezen elke waarde hebben, zoals Kandel en Stambaugh zeiden. Correlatie met de markt, de enige maat die een onderzoeker zou kunnen begrenzen, legt de lijn niet vast. Beide bewegingen volgen uit de redenering bij de bijna-efficiënte proxy’s, want eerst krimpt vooral de spreiding van de bèta’s, en daarna verdwijnt de covariantie met de premies.
4.6De tweede vraag: welk deel van de variantie is systematisch?
Als de lijn niet te toetsen is, wat verklaren markt en industrie dan wel? In zijn rede van 1987 stelde Roll die vraag over varianties, en vroeg welk deel van de beweging van een aandeel het met markt en industrie deelt.
Waarom zou dit waar zijn? Beleggers kopen en verkopen op nieuws. Gaat het meeste nieuws over de conjunctuur of de sector, dan handelen ze in veel aandelen tegelijk, en bewegen die grotendeels samen. Gaat het meeste nieuws over het bedrijf zelf, dan beweegt elk aandeel vooral op eigen houtje, en krimpt het gedeelde deel. Op dagen zonder bedrijfsnieuws zou het eigen deel dan kleiner moeten zijn.
Schrijf voor aandeel , met het marktrendement en het industrierendement ,
met ongecorreleerd met beide regressoren. In woorden: de variantie van een aandeel valt uiteen in een deel dat met markt en industrie meebeweegt en een bedrijfsspecifiek deel. De van de regressie is het systematische aandeel. In de wereld van honderd activa is de eigen volatiliteit van een activum, 8 tot 12% per maand, groter dan die van de markt. Daardoor is de van een los activum op de markt daar ongeveer , dus tussen 0,13 en 0,26. Met waarnemingen en regressoren gebruiken we de gecorrigeerde .
Roll schatte dit voor grote Amerikaanse aandelen, met markt, industrie en publiek bedrijfsnieuws als verklarende variabelen. Volgens zijn samenvatting is de gemiddelde gecorrigeerde ongeveer 0,35 met maanddata en 0,20 met dagdata Roll (1988). Het weglaten van dagen met nieuws in de financiële pers verhoogt de nauwelijks. Het grootste deel van de variantie is dus niet systematisch, zoals verwacht, en komt ook niet uit publiek nieuws. Het komt uit private informatie die via de handel in de prijs komt, of uit beweging zonder aanleiding.
Ook het weer in Florida verklaarde weinig van de prijs van sinaasappelsap-futures Roll (1984). Een deel van de dagelijkse beweging is zelfs mechanisch, want de waargenomen koers is de efficiënte prijs plus microstructuurruis, zoals de bid-ask bounce van transacties die afwisselend tegen de bied- en de laatkoers plaatsvinden. Roll schatte de spread als Roll (1984).
Bij varianties ligt het andersom dan bij de standaardfout van 2%, want gemiddelde rendementen zijn slecht gemeten en varianties goed. Rolls eerste punt, de lijn, hangt af van gemiddelden en is daardoor ook empirisch zwak, terwijl zijn tweede punt, de , van varianties afhangt en daarom scherp vast te stellen is.
5Simulatie: een onvolmaakte proxy in een CAPM-wereld
We gebruiken dezelfde wereld van honderd activa. De onderzoeker kent de markt niet en gebruikt een proxy met correlatie met de ware markt. We vragen of hij met vijftig jaar data kan zien of zijn proxy in een willekeurige dan wel in de ongunstige richting afwijkt.
We bouwen twee soorten proxy’s met dezelfde correlatie. De willekeurige kanteling is , met een willekeurige richting die optelt tot nul, in elke steekproef een nieuwe. De ongunstige kanteling is uit Corollary 2. We kiezen zo dat de correlatie is, zodat beide volgens het lemma dezelfde Sharpe-ratio halen. De eis is een kwadratische vergelijking in , waarvan we de kleinste positieve wortel nemen.
def tilt_to_corr(world, direction, rho):
    """Weights w_m + c * direction (direction sums to zero) with correlation rho to the market."""
    cov, w_m = world["cov"], world["w_m"]
    if rho >= 1.0:
        return w_m.copy()
    s, a, b = w_m @ cov @ w_m, direction @ cov @ w_m, direction @ cov @ direction
    # Corr(w_m + c * direction, w_m)^2 = rho^2, written as a quadratic in c
    roots = np.roots([a**2 - rho**2 * s * b, 2 * s * a * (1 - rho**2), s**2 * (1 - rho**2)])
    real_roots = roots[np.abs(roots.imag) < 1e-12].real
    admissible = real_roots[(real_roots > 0) & (s + real_roots * a > 0)]
    return w_m + admissible.min() * direction
We kiezen correlaties van 0,90 en hoger, want zulke proxy’s zou een onderzoeker als goed beschouwen. Langs het pad ligt de ware helling daar dicht bij of boven de premie. De nulhelling ligt pas bij 0,62, dus in dit bereik zit de schade niet in de helling maar in het intercept. Elke steekproef heeft 600 maanden normaal verdeelde overrendementen. De onderzoeker schat de bèta’s met OLS en regresseert de gemiddelde rendementen erop.
n_months, n_samples = 600, 400
rhos = [1.0, 0.99, 0.95, 0.90]
records = []
for sample in range(n_samples):
    R = rng.standard_normal((n_months, 100)) @ world["chol"].T + world["mu_e"]
    means, centred = R.mean(axis=0), R - R.mean(axis=0)
    for kind in ["willekeurig", "ongunstig"]:
        for rho in rhos:
            if kind == "willekeurig":
                e = rng.standard_normal(100)
                w = tilt_to_corr(world, e - e.mean(), rho)
            else:
                w = tilt_to_corr(world, -world["d"], rho)
            r_p = centred @ w
            beta_hat = r_p @ centred / (r_p @ r_p)
            intercept, slope, _, _ = sml_fit(beta_hat, means)
            pop_intercept, pop_slope, _ = population_sml(world, w)
            records.append({"kanteling": kind, "rho": rho, "intercept": intercept,
                            "helling": slope, "populatie: intercept": pop_intercept,
                            "populatie: helling": pop_slope})
sims = pd.DataFrame(records)
De tabel vat de 400 steekproeven samen per proxy, in procenten per maand, naast de populatiewaarden.
def quantile_05(x):
    return x.quantile(0.05)


def quantile_95(x):
    return x.quantile(0.95)


table = sims.groupby(["kanteling", "rho"], sort=False).agg(
    **{"populatie: helling": ("populatie: helling", "median"),
       "helling: 5%-kwantiel": ("helling", quantile_05),
       "helling: mediaan": ("helling", "median"),
       "helling: 95%-kwantiel": ("helling", quantile_95),
       "populatie: intercept": ("populatie: intercept", "median"),
       "intercept: mediaan": ("intercept", "median"),
       "intercept: standaarddeviatie": ("intercept", "std")})
(100 * table).round(3)De populatiekolommen tonen wat de propositie voorspelde. Een willekeurige kanteling verschuift de ware lijn weinig, want bij correlatie 0,90 is het intercept 0,08% per maand. De ongunstige kanteling met dezelfde correlatie geeft een intercept van −0,34% per maand. Dat is per jaar aan negatieve alpha voor een activum met bèta nul, in een wereld waarin het CAPM exact geldt.
In de geschatte waarden verdwijnt dat verschil in de ruis. De 90%-band van de geschatte helling loopt in elke rij van ongeveer 0,22% tot 1,0% per maand. De helling is in wezen het gemiddelde rendement van een portefeuille met bèta één, en zo’n gemiddelde is slecht gemeten, met een standaardfout van per maand. De mediaan ligt bovendien onder de populatiewaarde, door de attenuatie van geschatte bèta’s uit Het CAPM, waarbij meetfout in de bèta’s de helling naar nul trekt.
Het intercept is scherper gemeten, met een standaarddeviatie van 0,14 tot 0,20% per maand. Over 400 steekproeven is de ongunstige kanteling daar wel zichtbaar, want de mediaan daalt van 0,05% bij correlatie 1 naar −0,11% bij 0,90. Bij een willekeurige kanteling stijgt ze bij 0,90 naar 0,14%. Let in de figuur op hoe sterk de histogrammen van de verschillende correlaties overlappen.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3), sharey=True)
bins = np.linspace(-0.6, 2.0, 60)
for ax, kind in zip(axes, ["willekeurig", "ongunstig"]):
    for rho in rhos:
        subset = sims[(sims["kanteling"] == kind) & (sims["rho"] == rho)]
        ax.hist(100 * subset["helling"], bins=bins, histtype="step", lw=1.5,
                label=f"correlatie {rho:.2f}")
    ax.axvline(100 * premium_m, color="black", lw=1.2, ls="--", label="ware marktpremie")
    ax.set_xlabel("Geschatte helling van de SML (% per maand)")
    ax.set_title(f"{kind.capitalize()} gekantelde proxy, 400 steekproeven")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].legend()
plt.show()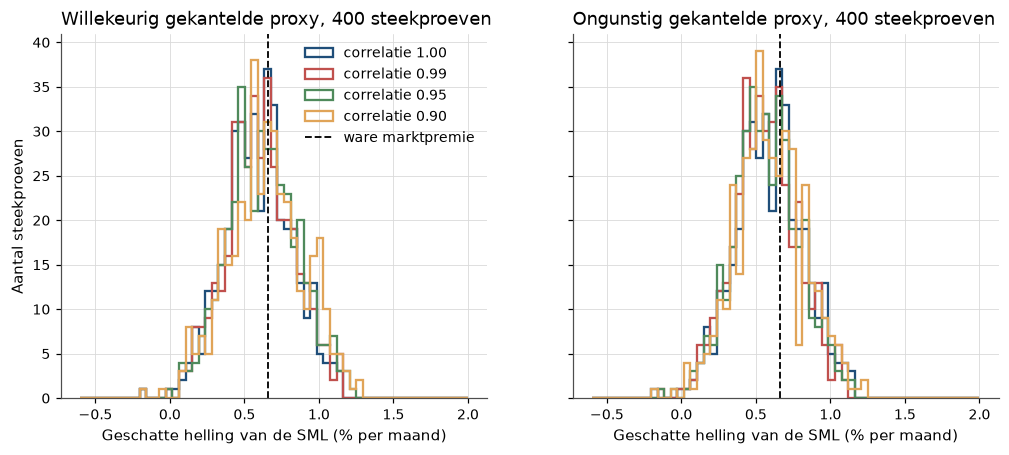
Figure 2:Verdeling van de geschatte helling van de SML over 400 steekproeven van vijftig jaar, in een wereld waarin het CAPM exact geldt. Links wijkt de proxy in een willekeurige richting van de markt af, rechts in de ongunstige richting. In beide panelen overstemt de steekproefruis het verschil tussen de proxy’s.
Met vijftig jaar data ziet de onderzoeker dus niet welke proxy hij heeft, want de helling verraadt het verschil niet. Een intercept van −0,11% per maand ligt binnen één standaarddeviatie van nul, zodat ook het intercept de proxy in één steekproef niet verraadt. Het toy-voorbeeld liet hetzelfde in het klein zien. Daar lag de gelijkgewogen portefeuille niet op de grens, en toch gaf de lijn ertegen een van 0,9868.
6Replicatie op echte data
6.1De tautologie op de 25 size/BM-portefeuilles
We vergelijken vier proxy’s: de tangentportefeuille van de 25 in de steekproef, de proxy met helling nul die volgens Corollary 2 het sterkst met die tangentportefeuille correleert, de gelijkgewogen portefeuille en de CRSP-index. Eerst bouwen we de proxy’s uit de steekproefmomenten.
market = hap_data.market_monthly()
ff25 = hap_data.french("25_Portfolios_5x5").sub(market["RF"], axis=0).loc["1963-07":].dropna()
mkt_excess = market["Mkt-RF"].loc[ff25.index]

mu_hat, Sigma_hat = ff25.mean().to_numpy(), ff25.cov().to_numpy()
w_tan = np.linalg.solve(Sigma_hat, mu_hat)
w_tan /= w_tan.sum()
d_hat = mu_hat - mu_hat.mean()
c_hat = (d_hat @ Sigma_hat @ w_tan) / (d_hat @ Sigma_hat @ d_hat)
w_zero = w_tan - c_hat * d_hat

proxies = {
    "tangentportefeuille in de steekproef": ff25 @ w_tan,
    "helling nul, maximale correlatie": ff25 @ w_zero,
    "gelijkgewogen 25": ff25.mean(axis=1),
    "CRSP-marktindex": mkt_excess,
}
tangent = proxies["tangentportefeuille in de steekproef"]
print(f"{len(ff25)} maanden, {ff25.index[0]:%Y-%m} t/m {ff25.index[-1]:%Y-%m}; "
      f"som |gewichten| tangentportefeuille = {np.abs(w_tan).sum():.2f}")
757 maanden, 1963-07 t/m 2026-07; som |gewichten| tangentportefeuille = 13.81
De steekproef loopt van 1963-07 tot 2026-07. Nu schatten we voor elke proxy de bèta’s van de 25 portefeuilles en de lijn door hun gemiddelde overrendementen.
tautology, fitted = {}, {}
for name, proxy in proxies.items():
    betas = ff25.apply(lambda col: col.cov(proxy) / proxy.var())
    intercept, slope, resid, r2 = sml_fit(betas.to_numpy(), mu_hat)
    fitted[name] = (betas, intercept, slope)
    tautology[name] = {
        "correlatie met tangentportefeuille": proxy.corr(tangent),
        "Sharpe-ratio (per jaar)": np.sqrt(12) * proxy.mean() / proxy.std(),
        "gemiddeld overrendement (% per maand)": 100 * proxy.mean(),
        "standaardfout gemiddelde (% per maand)": 100 * proxy.std() / np.sqrt(len(proxy)),
        "intercept (% per maand)": 100 * intercept,
        "helling (% per maand)": 100 * slope,
        "grootste |residu| (% per maand)": 100 * np.abs(resid).max(),
        "R²": r2,
    }
pd.DataFrame(tautology).T.round(4)De eerste rij is Rolls tautologie op echte data: intercept nul, helling gelijk aan het gemiddelde overrendement van de tangentportefeuille, en geen residu. Die portefeuille is een extreme long-short-positie (zie de som van absolute gewichten boven de tabel), die niemand houdt. De tweede rij is de proxy van Roll en Ross, waarvan de correlatie met de tangentportefeuille tegelijk de fractie is die hij van de Sharpe-ratio van die portefeuille haalt. Toch is de helling nul.
De gelijkgewogen portefeuille weegt kleine en goedkope aandelen zwaarder dan de index, dus de activa met een hoge premie, en geeft daardoor een iets positieve helling. De laatste rij is de te vlakke, hier zelfs licht dalende lijn van Het CAPM. Of die komt doordat het CAPM faalt of doordat de index de markt niet is, zegt de tabel niet. De kolom met standaardfouten laat zien dat de gemiddelden zelf ook slecht gemeten zijn. Let in de figuur op de spreiding rond de lijn in het rechterpaneel.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3), sharey=True)
for ax, name in zip(axes, ["tangentportefeuille in de steekproef", "CRSP-marktindex"]):
    betas, intercept, slope = fitted[name]
    grid = np.linspace(0, 1.05 * betas.max(), 20)
    ax.scatter(betas, 100 * mu_hat, color=hap.plotting.COLORS[0], zorder=3,
               label="25 size/BM-portefeuilles")
    ax.plot(grid, 100 * (intercept + slope * grid), color=hap.plotting.COLORS[1],
            label="cross-sectionele OLS-lijn")
    ax.set_xlabel(f"Bèta ten opzichte van: {name}")
    ax.set_title(f"{name}: $R^2$ = {tautology[name]['R²']:.3f}".replace(".", ","))
axes[0].set_ylabel("Gemiddeld overrendement (% per maand)")
axes[0].legend(loc="upper left")
plt.show()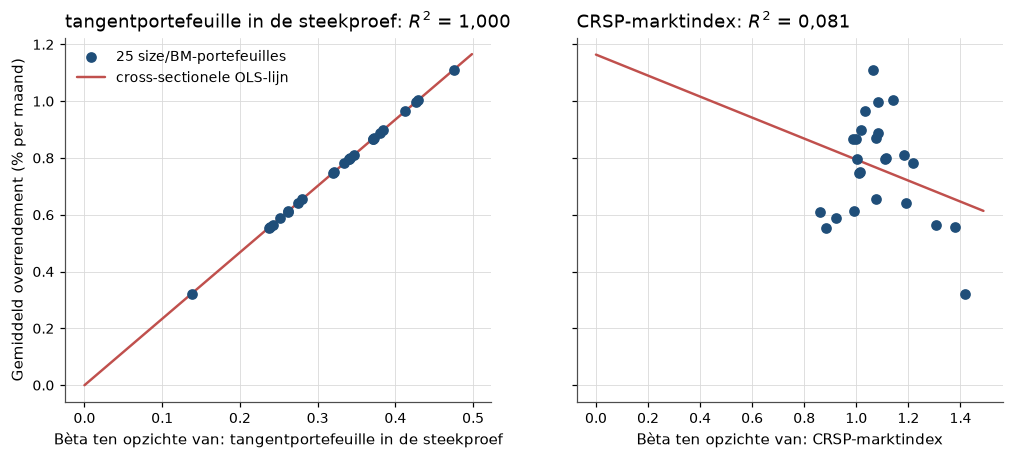
Figure 3:Links: tegenover de achteraf efficiënte portefeuille liggen de 25 portefeuilles exact op een lijn door de oorsprong. Dat is Rolls tautologie, geen eigenschap van de data. Rechts: tegenover de marktindex is er nauwelijks een lijn. Uit de rechterfiguur volgt alleen dat de index ten opzichte van deze 25 portefeuilles niet efficiënt is.
6.2De van portefeuilles en aandelen
We beginnen met de portefeuilles, met de markt als enige regressor.
def adjusted_r2(frame):
    """Adjusted R^2 of the first column of `frame` on the remaining columns (with intercept)."""
    values = frame.dropna().to_numpy()
    y, X = values[:, 0], np.column_stack([np.ones(len(values)), values[:, 1:]])
    resid = y - X @ np.linalg.lstsq(X, y, rcond=None)[0]
    n, k = X.shape
    r2 = 1 - resid.var() / y.var()
    return 1 - (1 - r2) * (n - 1) / (n - k)


ind49 = hap_data.french("49_Industry_Portfolios")
ind10 = hap_data.french("10_Industry_Portfolios")
ind10_daily = hap_data.french("10_Industry_Portfolios", "daily")

portfolio_sets = {
    "25 size/BM": ff25,
    "49 industrieën": ind49.sub(market["RF"], axis=0).loc["1963-07":].dropna(axis=1),
    "10 industrieën": ind10.sub(market["RF"], axis=0).loc["1963-07":],
}
portfolio_r2, portfolio_summary = {}, {}
for name, panel in portfolio_sets.items():
    r2_per_portfolio = {}
    for col in panel.columns:
        pair = pd.concat([panel[col], mkt_excess], axis=1, join="inner")
        r2_per_portfolio[col] = adjusted_r2(pair)
    r2 = pd.Series(r2_per_portfolio)
    portfolio_r2[name] = r2
    portfolio_summary[name] = {"aantal portefeuilles": len(r2), "gemiddelde R²": r2.mean(),
                               "mediaan R²": r2.median(), "minimum": r2.min(),
                               "maximum": r2.max()}
pd.DataFrame(portfolio_summary).T.round(3)Voor elke groep portefeuilles verklaart de markt alleen al gemiddeld meer dan de helft van de variantie (kolom “gemiddelde R²”), omdat spreiding over honderden aandelen het bedrijfsspecifieke deel weghaalt.
Daarna komen de vijftig aandelen aan de beurt. Elk aandeel is met de hand bij een industrie ingedeeld, op grond van zijn hoofdactiviteit. Bij een paar conglomeraten, zoals Berkshire Hathaway, is die keuze discutabel.
Source
INDUSTRY_49 = {
    "AAPL": "Hardw", "ADBE": "Softw", "AMZN": "Rtail", "ANET": "Hardw", "APH": "ElcEq",
    "AVGO": "Chips", "BAC": "Banks", "BRK-B": "Insur", "CMG": "Meals", "CPRT": "BusSv",
    "CRM": "Softw", "CSX": "Trans", "CTAS": "BusSv", "CVX": "Oil", "DE": "Mach",
    "DHR": "LabEq", "DXCM": "MedEq", "EW": "MedEq", "FAST": "Whlsl", "FTNT": "Softw",
    "GILD": "Drugs", "GOOGL": "Softw", "IDXX": "LabEq", "ISRG": "MedEq", "KO": "Soda",
    "LRCX": "Chips", "MA": "BusSv", "MNST": "Soda", "NFLX": "Fun", "NKE": "Clths",
    "NOW": "Softw", "NVDA": "Chips", "ODFL": "Trans", "ORLY": "Rtail", "PANW": "Softw",
    "PG": "Hshld", "QCOM": "Chips", "ROST": "Rtail", "SBUX": "Meals", "SHW": "Chems",
    "SMCI": "Hardw", "TJX": "Rtail", "TSCO": "Rtail", "TSLA": "Autos", "UNH": "Hlth",
    "UNP": "Trans", "V": "BusSv", "WFC": "Banks", "WMT": "Rtail", "WRB": "Insur",
}
INDUSTRY_10 = {
    "AAPL": "HiTec", "ADBE": "HiTec", "AMZN": "Shops", "ANET": "HiTec", "APH": "HiTec",
    "AVGO": "HiTec", "BAC": "Other", "BRK-B": "Other", "CMG": "Shops", "CPRT": "Shops",
    "CRM": "HiTec", "CSX": "Other", "CTAS": "Other", "CVX": "Enrgy", "DE": "Manuf",
    "DHR": "Hlth", "DXCM": "Hlth", "EW": "Hlth", "FAST": "Shops", "FTNT": "HiTec",
    "GILD": "Hlth", "GOOGL": "HiTec", "IDXX": "Hlth", "ISRG": "Hlth", "KO": "NoDur",
    "LRCX": "HiTec", "MA": "HiTec", "MNST": "NoDur", "NFLX": "HiTec", "NKE": "NoDur",
    "NOW": "HiTec", "NVDA": "HiTec", "ODFL": "Other", "ORLY": "Shops", "PANW": "HiTec",
    "PG": "NoDur", "QCOM": "HiTec", "ROST": "Shops", "SBUX": "Shops", "SHW": "Manuf",
    "SMCI": "HiTec", "TJX": "Shops", "TSCO": "Shops", "TSLA": "Durbl", "UNH": "Hlth",
    "UNP": "Other", "V": "HiTec", "WFC": "Other", "WMT": "Shops", "WRB": "Other",
}
Per aandeel schatten we vijf regressies: maandelijks en dagelijks, op de markt alleen en op markt plus industrie.
tickers = sorted(INDUSTRY_49)
prices = hap_data.yahoo(tickers, start="2002-01-01", end="2026-08-01")
market_daily = hap_data.market_daily()

stock_daily = prices.pct_change(fill_method=None).loc["2002-01-03":"2026-07-31"]
stock_monthly = prices.resample("ME").last().pct_change(fill_method=None).loc["2002-02":"2026-07"]


def stock_r2(stock, *regressors):
    return adjusted_r2(pd.concat([stock, *regressors], axis=1, join="inner"))


rows = {}
for t in tickers:
    rows[t] = {
        "maand: markt": stock_r2(stock_monthly[t], market["Mkt"]),
        "maand: markt + 10 industrieën": stock_r2(stock_monthly[t], market["Mkt"],
                                                  ind10[INDUSTRY_10[t]]),
        "maand: markt + 49 industrieën": stock_r2(stock_monthly[t], market["Mkt"],
                                                  ind49[INDUSTRY_49[t]]),
        "dag: markt": stock_r2(stock_daily[t], market_daily["Mkt"]),
        "dag: markt + 10 industrieën": stock_r2(stock_daily[t], market_daily["Mkt"],
                                                ind10_daily[INDUSTRY_10[t]]),
    }
stock_r2_table = pd.DataFrame(rows).T

summary_r2 = stock_r2_table.agg(["mean", "median", "min", "max"]).T
summary_r2["standaardfout gemiddelde"] = stock_r2_table.std() / np.sqrt(len(stock_r2_table))
summary_r2.columns = ["gemiddelde", "mediaan", "minimum", "maximum", "standaardfout gemiddelde"]
summary_r2.round(3)Ook met de industrie erbij blijft gemiddeld meer dan de helft van de variantie van een aandeel bedrijfsspecifiek, maandelijks en dagelijks (kolom “gemiddelde”). De standaardfouten in de laatste kolom zijn klein, want anders dan een gemiddeld rendement is de scherp gemeten. Let in de figuur op de afstand tussen aandelen en portefeuilles.
Source
fig, ax = plt.subplots()
groups = {
    "aandelen, dag\n(markt + industrie)": stock_r2_table["dag: markt + 10 industrieën"],
    "aandelen, maand\n(markt + industrie)": stock_r2_table["maand: markt + 49 industrieën"],
    "49 industrieën\n(markt)": portfolio_r2["49 industrieën"],
    "25 size/BM\n(markt)": portfolio_r2["25 size/BM"],
}
ax.boxplot(list(groups.values()), tick_labels=list(groups.keys()), widths=0.5)
for x, values in enumerate(groups.values(), start=1):
    ax.scatter(np.full(len(values), x) + rng.uniform(-0.12, 0.12, len(values)), values,
               s=8, alpha=0.5, color=hap.plotting.COLORS[0])
ax.axhline(0.35, color=hap.plotting.COLORS[1], ls="--", lw=1.2, label="Roll 1988, maand (0,35)")
ax.axhline(0.20, color=hap.plotting.COLORS[3], ls="--", lw=1.2, label="Roll 1988, dag (0,20)")
ax.set_ylim(0, 1)
ax.set_ylabel("Gecorrigeerde $R^2$")
ax.set_xlabel("")
ax.set_title("Welk deel van de variantie is systematisch?")
ax.legend(loc="upper left")
plt.show()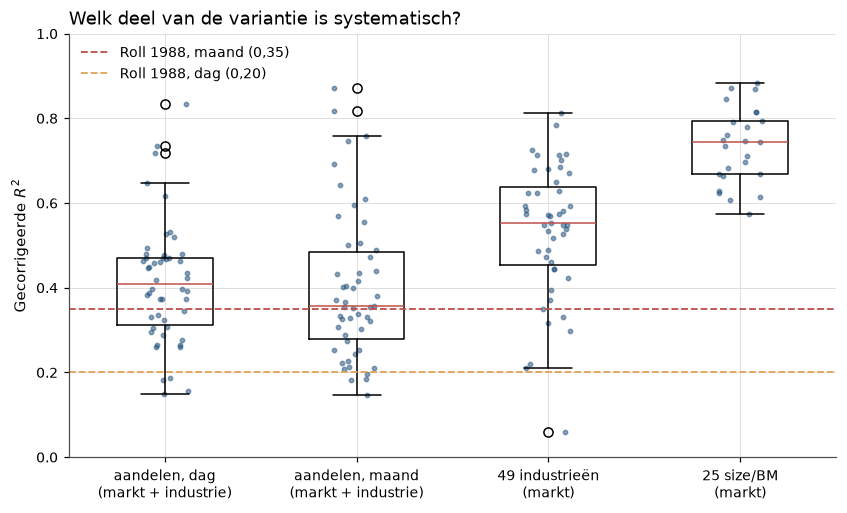
Figure 4:Gecorrigeerde van regressies op markt (en industrie) voor losse aandelen en voor portefeuilles. Bij aandelen is het grootste deel van de variantie bedrijfsspecifiek. Bij portefeuilles is het weggediversifieerd. De stippellijnen zijn de gemiddelden uit de samenvatting van Roll (1988).
Tot slot vergelijken we de twee replicaties met wat de stelling en Roll lieten verwachten.
tangent_row = tautology["tangentportefeuille in de steekproef"]
pd.DataFrame(
    {"origineel": [1.0, 0.0, 0.35, 0.20],
     "hier": [tangent_row["R²"], abs(tangent_row["intercept (% per maand)"]),
              summary_r2.loc["maand: markt + 10 industrieën", "gemiddelde"],
              summary_r2.loc["dag: markt + 10 industrieën", "gemiddelde"]]},
    index=["(a) R² tegen de tangentportefeuille", "(a) |intercept| (% per maand)",
           "(b) R² aandelen, maand, markt + industrie",
           "(b) R² aandelen, dag, markt + industrie"],
).round(3)Geslaagd voor de tautologie, gedeeltelijk geslaagd voor de . Tegenover de tangentportefeuille van de steekproef is en het intercept nul, precies zoals de stelling voorspelt. De maandelijkse van aandelen, 0,35, valt samen met Rolls waarde, maar de dagelijkse, 0,41, ligt ruim boven zijn 0,20, zodat de rangorde van dag en maand omgekeerd is.
Die rangorde hadden we vooraf al onzeker genoemd, want onze aandelen behoren tot de meest
verhandelde ter wereld, zodat niet-synchrone handel (slotkoersen van
verschillende momenten, wat dagelijkse covarianties drukt) nauwelijks speelt. Bovendien
bevat de periode meerdere crisisjaren waarin aandelen sterker samen bewegen
(oefening 2). Rolls vondst over nieuwsdagen repliceren we niet, omdat hap.data geen
datums van bedrijfsnieuws heeft.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Roll maakte niet het CAPM kapot, maar een manier van lezen. Zijn stelling is een van de schoonste resultaten in het vak. Een lijn tussen verwacht rendement en bèta is niets meer dan efficiëntie van de gekozen portefeuille, in de populatie en in elke steekproef. De -analyse van 1988 is even robuust, want ze vraagt alleen om varianties. Op vijftig aandelen uit 2002–2026 vinden we dezelfde orde van grootte als Roll.
Waar het breekt. Op de 25 size/BM-portefeuilles geeft de achteraf efficiënte portefeuille een van 1 en de CRSP-index een van 0,08. De data kunnen niet zeggen of dat komt doordat het CAPM onjuist is of doordat de index de markt niet is. Op de vraag theorie of feit is het antwoord nu dat het CAPM geen getoetste theorie meer is, want zijn centrale grootheid is niet waarneembaar. Er blijft een feit over dat op een verklaring wacht, namelijk dat de lijn vlak is voor elke gangbare marktindex. Daarnaast verklaren markt en industrie maar 35 tot 40% van de maandelijkse variantie van grote aandelen.
Risico of vergissing? Voor de vlakke lijn zegt de Chicago-lezing dat de index de verkeerde portefeuille is. Wie menselijk kapitaal meetelt, zoals Jagannathan & Wang (1996) met de groei van arbeidsinkomen, verklaart meer van de cross-sectie als beloning voor risico. De Yale-lezing wijst op Shanken (1987), die liet zien dat de ware markt opvallend weinig op aandelen en obligaties lijkt als het CAPM geldt. Ook de lage heeft twee lezingen. Morck et al. (2000) lezen bedrijfsspecifieke beweging als informatie die via de handel in de prijs komt. De andere lezing ziet er ruis in. De data die de lezingen zouden scheiden, het rendement van de ware markt of alle private informatie, bestaan niet.
Wat er daarna kwam. Als losse koersen meer bewegen dan publiek nieuws verklaart, is de volgende vraag of dat ook voor de markt als geheel geldt. Dat onderzochten Shiller en LeRoy en Porter, in Shiller en LeRoy-Porter: excess volatility.
8Oefeningen
Solution to Exercise 1
(1) Het gemiddelde van de premies is , dus . Dat zijn dezelfde afwijkingen als in stap 5 van het toy-voorbeeld, want een constante rente verschuift alle premies gelijk. Rij voor rij is .
(2) De code rekent de rest uit en controleert helling en Sharpe-ratio.
mu_e_toy = mu - 0.02
w_m_toy = np.array([1 / 3, 2 / 9, 4 / 9])
d_toy = mu_e_toy - mu_e_toy.mean()
cov_md, var_d = w_m_toy @ Sigma @ d_toy, d_toy @ Sigma @ d_toy
var_m_toy = w_m_toy @ Sigma @ w_m_toy
c_toy = cov_md / var_d
w_star = w_m_toy - c_toy * d_toy
intercept_star, slope_star, _, _ = sml_fit(Sigma @ w_star / (w_star @ Sigma @ w_star), mu_e_toy)

pd.Series({
    "Var(R_d)": var_d, "Cov(r_m, R_d)": cov_md, "c*": c_toy,
    "rho*": np.sqrt(1 - cov_md**2 / (var_m_toy * var_d)),
    "w* aandelen": w_star[0], "w* kleine aandelen": w_star[1], "w* obligaties": w_star[2],
    "som w*": w_star.sum(), "OLS-helling": slope_star, "intercept": intercept_star,
    "gemiddelde premie": mu_e_toy.mean(),
    "S_w* / S_m": (w_star @ mu_e_toy / np.sqrt(w_star @ Sigma @ w_star))
                  / (w_m_toy @ mu_e_toy / np.sqrt(var_m_toy)),
}).round(6)
Var(R_d) 0.000239
Cov(r_m, R_d) 0.001126
c* 4.717567
rho* 0.784764
w* aandelen 0.301883
w* kleine aandelen 0.002069
w* obligaties 0.696048
som w* 1.000000
OLS-helling -0.000000
intercept 0.073333
gemiddelde premie 0.073333
S_w* / S_m 0.784764
dtype: float64De tabel geeft en . De proxy heeft gewichten , zodat bijna al het gewicht van kleine aandelen, het activum met de hoogste premie, naar obligaties is verschoven. De helling is nul en de Sharpe-ratio is 78,5% van die van de markt. Het intercept is de gemiddelde premie, , want een OLS-lijn met helling nul gaat door het gemiddelde. Wat dit leert: de vlakst mogelijke lijn hoort hier bij een proxy die ruim driekwart van de maximale Sharpe-ratio haalt.
:::{exercise}
:label: ex-roll-2

**Afleiding: wanneer is de $R^2$ hoog?**

1. Laat zien dat de $R^2$ van een regressie van $r_i$ op alleen $r_m$ gelijk is aan
   $\beta_{i,m}^2\sigma_m^2/(\beta_{i,m}^2\sigma_m^2 + \sigma_{\varepsilon,i}^2)$. Wat
   gebeurt er met de $R^2$ als $\sigma_m$ stijgt en de rest gelijk blijft?
2. Bereken per kalenderjaar 2002–2025 de gemiddelde gecorrigeerde $R^2$ van de vijftig
   aandelen op de dagelijkse markt (alleen aandelen met minstens 200 waarnemingen in
   dat jaar), en de correlatie met de marktvolatiliteit van dat jaar.
Solution to ex-roll-2
(1) Met en ongecorreleerd met is . De is het verklaarde deel, . Stijgt bij gelijke en , dan stijgt de .
(2) We rekenen per jaar de gemiddelde en de marktvolatiliteit uit.
yearly = {}
for year in range(2002, 2026):
    daily = stock_daily.loc[str(year)]
    mkt_year = market_daily["Mkt"].loc[str(year)]
    values = [stock_r2(daily[t], mkt_year) for t in tickers if daily[t].notna().sum() >= 200]
    yearly[year] = {"gemiddelde R²": np.mean(values), "aantal aandelen": len(values),
                    "marktvolatiliteit (% per jaar)": 100 * np.sqrt(252) * mkt_year.std()}
yearly = pd.DataFrame(yearly).T
yearly.round(3)De tabel toont een die meebeweegt met de marktvolatiliteit. De samenvatting maakt dat concreet.
pd.Series({
    "hoogste jaar": int(yearly["gemiddelde R²"].idxmax()),
    "laagste jaar": int(yearly["gemiddelde R²"].idxmin()),
    "correlatie R² met marktvolatiliteit": yearly["gemiddelde R²"].corr(
        yearly["marktvolatiliteit (% per jaar)"]),
}).round(3)
hoogste jaar 2020.000
laagste jaar 2017.000
correlatie R² met marktvolatiliteit 0.815
dtype: float64De gemiddelde loopt van 0,15 in 2017 tot 0,56 in 2020. De hoogste jaren, 2020, 2011, 2022 en 2008, zijn jaren van marktbrede onrust, met een marktvolatiliteit van 24 tot 40% per jaar. Over de 24 jaren is de correlatie tussen en marktvolatiliteit 0,82, zoals deel 1 voorspelt. Wat dit leert: wie leest als maat voor bedrijfsspecifieke informatie, zoals Morck et al. (2000), moet rekening houden met de marktvolatiliteit. Anders zegt een vergelijking tussen periodes of landen vooral iets over de noemer.
:::{exercise}
:label: ex-roll-3

**De tautologie buiten de steekproef.** Schat de tangentportefeuille van de 25
size/BM-portefeuilles op 1963-07 t/m 1994-12 en houd de gewichten vast.

1. Bereken over 1995-01 t/m 2026-07 de bèta's van de 25 portefeuilles ten opzichte van
   die vaste portefeuille, en de cross-sectionele OLS-lijn door hun gemiddelde
   overrendementen: intercept, helling en $R^2$.
2. Vergelijk met de CRSP-index en met de tangentportefeuille die op 1995–2026 zelf is
   geschat.
Solution to ex-roll-3
We schatten de gewichten op de eerste helft en passen ze toe op de tweede.
first, second = ff25.loc[:"1994-12"], ff25.loc["1995-01":]
w_first = np.linalg.solve(first.cov().to_numpy(), first.mean().to_numpy())
w_first /= w_first.sum()
w_second = np.linalg.solve(second.cov().to_numpy(), second.mean().to_numpy())
w_second /= w_second.sum()

oos = {}
for name, proxy in {"tangentportefeuille 1963-1994, vast": second @ w_first,
                    "tangentportefeuille 1995-2026, in de steekproef": second @ w_second,
                    "CRSP-marktindex": mkt_excess.loc[second.index]}.items():
    betas = second.apply(lambda col: col.cov(proxy) / proxy.var())
    intercept, slope, _, r2 = sml_fit(betas.to_numpy(), second.mean().to_numpy())
    oos[name] = {"intercept (% per maand)": 100 * intercept,
                 "helling (% per maand)": 100 * slope,
                 "gemiddeld overrendement proxy (% per maand)": 100 * proxy.mean(),
                 "R²": r2, "Sharpe-ratio (per jaar)": np.sqrt(12) * proxy.mean() / proxy.std()}
pd.DataFrame(oos).T.round(3)Met de vaste gewichten verklaren de bèta’s over 1995–2026 nog 37% van de spreiding in gemiddelde rendementen. Het intercept is 0,74% per maand en de helling 0,98%, tegen een gemiddeld overrendement van die portefeuille van 2,55%. De lijn gaat dus niet meer door de oorsprong en is veel te vlak. De tangentportefeuille die op 1995–2026 zelf is geschat, geeft opnieuw met intercept nul, en de CRSP-index met een negatieve helling.
De vaste portefeuille haalt buiten de steekproef nog een Sharpe-ratio van 0,88 per jaar, tegen 0,62 voor de index. Dat wijst erop dat het overwegen van goedkope aandelen (value) ook na 1994 loonde. Of dat ook voor kleine aandelen (small) bleef gelden, is een vraag die Fama-French 1992/1993 stelt. De perfecte lijn blijkt dus een eigenschap van de steekproef waarin de portefeuille is gekozen, en geen toets van een theorie.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Roll, R. (1977). A Critique of the Asset Pricing Theory’s Tests Part I: On Past and Potential Testability of the Theory. Journal of Financial Economics, 4(2), 129–176. 10.1016/0304-405X(77)90009-5
- Roll, R., & Ross, S. A. (1994). On the Cross-Sectional Relation between Expected Returns and Betas. The Journal of Finance, 49(1), 101–121. 10.1111/j.1540-6261.1994.tb04422.x
- Kandel, S., & Stambaugh, R. F. (1995). Portfolio Inefficiency and the Cross-Section of Expected Returns. The Journal of Finance, 50(1), 157–184. 10.1111/j.1540-6261.1995.tb05170.x
- Roll, R. (1984). Orange Juice and Weather. The American Economic Review, 74(5), 861–880.
- Roll, R. (1988). R2. The Journal of Finance, 43(3), 541–566. 10.1111/j.1540-6261.1988.tb04591.x
- Roll, R. (1984). A Simple Implicit Measure of the Effective Bid-Ask Spread in an Efficient Market. The Journal of Finance, 39(4), 1127–1139. 10.1111/j.1540-6261.1984.tb03897.x
- Jagannathan, R., & Wang, Z. (1996). The Conditional CAPM and the Cross-Section of Expected Returns. The Journal of Finance, 51(1), 3–53. 10.1111/j.1540-6261.1996.tb05201.x
- Shanken, J. (1987). Multivariate Proxies and Asset Pricing Relations: Living with the Roll Critique. Journal of Financial Economics, 18(1), 91–110. 10.1016/0304-405X(87)90062-6
- Morck, R., Yeung, B., & Yu, W. (2000). The Information Content of Stock Markets: Why Do Emerging Markets Have Synchronous Stock Price Movements? Journal of Financial Economics, 58(1–2), 215–260. 10.1016/S0304-405X(00)00071-4
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD