

Opzet, data en conventies
1Overzicht
Dit college laat zien hoe de reeks in elkaar zit en doet meteen de eerste meting, namelijk hoe precies een eeuw data het gemiddelde rendement op aandelen vastlegt. Dat valt tegen, want over honderd jaar is het rekenkundig gemiddelde marktrendement 11,6% per jaar, met een standaardfout van 1,8 procentpunt. In dit college:
beschrijven we de drie motieven die door de reeks lopen, en de vaste opbouw van elk college;
leggen we de notatie vast die in alle colleges geldt;
laden en tekenen we elk van de acht gratis databronnen van
hap.dataéén keer, en zeggen we welke data ontbreekt;laten we de schatters en figuurhulpjes van het
hap-pakket zien, en hoe alles offline draait;schatten we het gemiddelde marktrendement met zijn standaardfout, en simuleren we hoe slecht een eeuw het gemiddelde meet en hoe goed de volatiliteit.
De reeks volgt de terugblik van Pedro Santa-Clara op zijn loopbaan in asset pricing Santa-Clara (2026) en werkt die uit tot op de vergelijking, de data en de code. De vorm komt van Advanced Quantitative Economics with Python Sargent & Stachurski (n.d.), een tekst waarin elke belangrijke bewering ook wordt uitgerekend, op data die iedereen kan downloaden. Dit college repliceert zelf niets, maar is de gereedschapskist waarmee de andere negenendertig colleges hun beweringen toetsen.
2De rode draad, en hoe een lecture is opgebouwd
Het vak is chronologisch geordend, maar niet cumulatief, want een oud model verdwijnt niet als er een nieuw bij komt, zoals het CAPM nog dagelijks naast de factor zoo wordt gebruikt. Wel volgt elk tijdvak hetzelfde patroon. Iemand formuleert een theorie, en daarna komt er een bron van data waarmee die theorie voor het eerst te toetsen is: de CRSP-tape in 1964, de optiebeurs in 1973, de open datasets van nu. Vervolgens blijkt er een feit te zijn dat het model niet aankan. Dat feit is de barst, en de barst opent het volgende hoofdstuk.
Drie motieven lopen door de hele reeks, en waar ze spelen, komen ze onder deze namen terug. De standaardfout van 2% gaat over wat data kunnen meten, risico of vergissing over twee lezingen van hetzelfde feit, en theorie of feit over de status van een model, dat getoetst is of nog op een verklaring wacht.
De standaardfout van 2%. Het gemiddelde rendement van de aandelenmarkt is met een eeuw data nog steeds slecht gemeten. De naam komt van een rond getal, want bij 20% volatiliteit per jaar en honderd jaar data is de standaardfout van het gemiddelde procentpunt. De variantie is daarentegen goed meetbaar, met dagdata zelfs bijna precies. Uit die asymmetrie volgen drie dingen.
Volatiliteit is voorspelbaar en rendement nauwelijks. Omdat de volatiliteit per maand scherp te meten is, zijn de schommelingen van de volatiliteit zichtbaar, terwijl een schommeling van een paar procentpunt in het verwachte rendement in de ruis verdrinkt.
De equity premium puzzle verdwijnt niet met meer data. De puzzel is dat de gemeten premie op aandelen veel hoger is dan modellen met een redelijke risicoaversie kunnen verklaren, met 6,18% per jaar bij Mehra & Prescott (1985) en 8,3% in de French-data van dit college. Omdat die premie maar op 2 procentpunt na bekend is, wordt ze pas scherper met eeuwen extra data.
Er verschijnen honderden factoren die significant lijken, omdat van twintig nutteloze factoren er gemiddeld één toevallig een -waarde haalt die in absolute waarde boven 1,96 ligt. Een onderzoeker die honderden kenmerken probeert, vindt er dus tientallen.
Aan het eind van dit college rekenen we het getal na. Dan blijkt dat de ronde rekensom dicht bij de standaardfout ligt die de data zelf geven.
Risico of vergissing. Na een crash zijn aandelen goedkoop, in de zin dat de prijs laag is ten opzichte van het dividend. Chicago, met Fama, leest dat als een hogere vergoeding die beleggers dan eisen, omdat de discontovoet is gestegen. Yale, met Shiller, leest hetzelfde feit als angst, waardoor de prijs ernaast zit. Beide kampen zijn het eens over de metingen, maar oneens over de uitleg. In 2013 kregen Fama en Shiller samen de Nobelprijs, en dat gaf de stand van het vak goed weer. Waar deze tegenstelling speelt, geven we beide lezingen en kiezen we niet.
Theorie of feit. Het vak begon met één model dat werd getoetst, het CAPM, en het eindigt met een verzameling robuuste feiten waarvoor meerdere modellen zich aandienen. Bij elk model staat daarom welke status het heeft: een theorie die aan data wordt onderworpen, of een feit dat op een verklaring wacht.
Naast de drie motieven staat een praktische les van Santa-Clara zelf. Die les is geen vierde motief, maar dezelfde tweedeling tussen risico en vergissing, zoals een belegger die zelf voelt. Santa-Clara verdiende blijvend aan risico waarvoor de markt een premie betaalde, en hij verloor telkens wanneer hij dacht iets te weten wat nog niet in de prijs zat.
Everything I made that lasted came from bearing risk that was priced. Everything I lost came from thinking I knew something the price did not.
Waar een college over een handelsstrategie gaat, stellen we die vraag hardop. Is de winst van de strategie een risicopremie, of een vermeend inzicht?
2.1De didactische trap
Elk inhoudelijk college heeft dezelfde opbouw, in deze volgorde: Waar we zijn in het verhaal, Overzicht, Intuïtie, Toy-voorbeeld, Theorie, Simulatie, Replicatie op echte data, Wat er brak, en wat daarna kwam en Oefeningen. Het Overzicht stelt de vraag en geeft het antwoord, waarna de Intuïtie het mechanisme in gewone taal vertelt. Toy-voorbeeld, simulatie en replicatie vormen samen de didactische trap, drie treden van klein naar echt:
Toy-voorbeeld. Het toy-voorbeeld is het kleinste geval waarin het mechanisme al zichtbaar is, bijvoorbeeld twee toestanden en drie activa. We rekenen het eerst met de hand uit en daarna in een codecel die dezelfde getallen moet geven. Omdat de twee uitkomsten overeenkomen, durven we de rest van de code te vertrouwen. De cel die de bibliotheken laadt, staat aan het begin van het toy-voorbeeld.
Simulatie. De simulatie draait hetzelfde model op schaal, in duizenden steekproeven. Daar zien we niet wat waar is, maar wat meetbaar is: schattingsfout, bias, datamining. Daarom komt hier bijna altijd de grote onzekerheid over gemiddelde rendementen terug.
Replicatie op echte data. Pas hier verschijnt
hap.data, met een replicatieblok dat zegt welk resultaat we nabouwen, met welke data, wat anders is dan in het origineel, en welke afwijking we verwachten. Zonder verwachte afwijking valt er niets te toetsen.
De Theorie staat tussen de eerste en de tweede trede. Ze begint met een routekaart en eindigt met een blok Samengevat. Elke afleiding opent met de cursieve vraag Waarom zou dit waar zijn? en een economisch argument, zodat wie de wiskunde overslaat, het resultaat nog kan navertellen.
De volgorde is een bewuste keuze. Een student die meteen een regressie op French-data draait, leert een procedure, maar wie eerst het toy-voorbeeld narekent, leert een mechanisme.
Elk college sluit met Wat er brak, en wat daarna kwam: wat het model verklaart, waar het breekt, hoe beide kampen die barst lezen, en welk college daarom volgt. Daarna komen twee tot vier oefeningen op het niveau van een problem set, elk met een uitwerking in een opklapbaar blok.
3Notatie
De hele reeks deelt één notatie. Wijkt een origineel artikel daarvan af, dan vertalen we het naar de tabel hieronder en zeggen dat in één zin, zodat de tabel verder nergens herhaald hoeft te worden.
| Symbool | Betekenis |
|---|---|
| prijs op tijdstip | |
| payoff op ; per definitie | |
| bruto rendement, | |
| netto simpel rendement (8% is 0,08) | |
| risicovrije rente, netto (2% is 0,02), al bekend op | |
| overrendement, | |
| stochastic discount factor, | |
| , | dividend, consumptie |
| , , | nutsfunctie, relatieve risicoaversie, subjectieve discontofactor |
| bèta van activum op factor , altijd met twee indices | |
| prijs van risico van factor | |
| pricing error, oftewel Jensen-alpha | |
| factorrendement | |
| prijs-dividend-ratio; is het omgekeerde | |
| verwachting en standaarddeviatie van rendementen | |
| verwachting gegeven de informatie op | |
| variantie, covariantie, correlatie, standaarddeviatie |
Twee conventies staan bewust naast elkaar in de tabel, want een rendement is bruto (1,08 bij 8%), terwijl de risicovrije rente netto is (0,02 bij 2%). Het bruto risicovrije rendement is dus . Het overrendement is in beide schrijfwijzen toch hetzelfde getal.
Drie afspraken gaan in de praktijk vaak mis. Ze gaan over de tijdsindex, over het lettertype van symbolen en over de taal van de vaktermen.
Tijdsindexering. Prijzen en informatie krijgen index , payoffs en rendementen index . De centrale vergelijking van de reeks is dus
en nooit . De prijs van vandaag is de verwachte payoff van morgen, gewogen met de discontofactor van morgen. Een rendement met index wordt verdiend tussen en en is op nog onbekend, zodat een schatting die deze regel overtreedt, in de toekomst kijkt. Veel te mooie resultaten in de empirische financiële economie komen daarvandaan.
Vet en cursief. Vectoren zijn vet en klein (, ), matrices vet en groot (, ), scalairen gewoon cursief. Zonder aankondiging zijn alle grootheden niveaus, en is het netto simpele rendement. Een logrendement krijgt daarom een eigen symbool, bijvoorbeeld . Een college dat met logs van prijzen en dividenden werkt, zegt dat met één zin: “vanaf hier zijn kleine letters logs”.
Nederlands en Engels. De tekst is Nederlands en de code Engels. Vaktermen blijven Engels waar een vertaling gekunsteld is, zoals stochastic discount factor of factor zoo, en ze staan de eerste keer in elk college cursief, met een korte uitleg erbij.
4De data
Alle data in deze reeks is gratis en publiek, en komt in de regel binnen via
hap.data. Alleen twee colleges halen zelf een klein bestand op, en ze zeggen dat ter
plekke. Elke loader schrijft een
parquet-snapshot naar data/cache/, en die snapshots staan in de repository.
Daardoor draait een verse kopie van het project elk college zonder
netwerkverbinding.
Twee conventies gelden voor alle loaders. Elke tabel heeft een DatetimeIndex
met naam date, met maanddata op het maandeinde en dagdata op de handelsdatum. Daarnaast
zijn
rendementen en yields decimalen en geen procenten, zodat 1,5% als 0.015 staat. De
uitzondering is hap.fred, dat de conventies van FRED volgt en dus maanddata op het
begin van de maand zet en rentes in procenten geeft.
| Bron | Wat | Loader |
|---|---|---|
| Kenneth French Data Library | factoren en portefeuilles, 1926– | hap.french(name, freq, table) |
| Robert Shiller | S&P-prijs, dividend, winst, CAPE, 1871– | hap.shiller() |
| Goyal-Welch | voorspellers van de aandelenpremie, 1871– | hap.goyal_welch(freq) |
| FRED | macro, rentes, VIX, wisselkoersen | hap.fred(series) |
| Gürkaynak-Sack-Wright | zero-coupon yieldcurve, 1961– | hap.gsw() |
| Open Source Asset Pricing | 212 anomalieportefeuilles + documentatie | hap.osap(kind) |
| He-Kelly-Manela | intermediary capital ratio, 1970– | hap.hkm(freq) |
| Yahoo Finance | recente koersen en optieketens | hap.yahoo(...), hap.yahoo_options(...) |
Elk college laadt eerst dezelfde bibliotheken in één cel, en daarna wordt
nergens meer geïmporteerd. De loaders zijn bereikbaar als hap_data.french en
als hap.french, de schatters als hap.newey_west en als hap.stats.newey_west.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)


def number_nl(x, decimals=1):
    """Format a number with a Dutch decimal comma, e.g. 83.65 -> '83,7'."""
    return f"{x:.{decimals}f}".replace(".", ",")
De cel zet ook de figuurstijl en een vaste toevalsgenerator, zodat elke simulatie
bij elke uitvoering dezelfde getallen geeft. De hulpfunctie number_nl schrijft
getallen in figuren met een decimale komma.
4.1Kenneth French: de factoren, 1926–
De Data Library van Kenneth French is het werkpaard van de empirische asset pricing. Ze bevat de marktfactor, de factoren van het driefactormodel Fama & French (1993) en de vijffactoruitbreiding, momentum en reversal, en daarnaast tientallen portefeuilles, gesorteerd op grootte, boek-marktwaarde en industrie. De reeksen lopen vanaf juli 1926, zowel maandelijks als dagelijks.
hap.market_monthly() geeft de marktfactor Mkt-RF (het overrendement op de
markt), de risicovrije rente RF en hun som Mkt. We tonen er meteen de
samenvattende statistieken bij, omdat in deze reeks geen gemiddeld rendement in
een tabel staat zonder zijn standaardfout.
columns_nl = {
    "nobs": "waarnemingen",
    "mean_ann": "gemiddelde (per jaar)",
    "std_ann": "volatiliteit (per jaar)",
    "se_mean_ann": "standaardfout gemiddelde",
    "sharpe_ann": "Sharpe-ratio",
}

market = hap_data.market_monthly()
market_stats = hap.summary_stats(market, "monthly")
market_stats[list(columns_nl)].rename(columns=columns_nl).round(4)Alle kolommen staan per jaar, dat wil zeggen het maandgemiddelde maal twaalf en de
maandvolatiliteit maal . Al de eerste tabel van de reeks laat zien hoe
slecht een gemiddeld rendement gemeten is. Het gemiddelde
marktrendement (Mkt) over 1201 maanden is 11,6% per jaar, met een
standaarddeviatie van 18,3%, en de standaardfout van dat gemiddelde is 1,8
procentpunt.
Een tweezijdig 95%-interval loopt dus van ongeveer 8% tot 15%, terwijl de risicovrije rente tot op een tiende procentpunt bekend is. De figuur hieronder toont wat die 11,6% over een eeuw oplevert, op een logaritmische verticale as.
Source
wealth = hap.drawdowns(market["Mkt"])
worst_date = wealth["drawdown"].idxmin()
worst_drop = -wealth["drawdown"].min()

fig, ax = plt.subplots()
ax.plot(wealth.index, wealth["wealth"])
ax.annotate(
    f"diepste terugval: {number_nl(100 * worst_drop)}% ({worst_date:%m-%Y})",
    xy=(worst_date, wealth.loc[worst_date, "wealth"]),
    xytext=(40, 30), textcoords="offset points",
    arrowprops={"arrowstyle": "->"},
)
ax.set_yscale("log")
ax.set_title("Eén dollar in de Amerikaanse aandelenmarkt, 1926-2026")
ax.set_xlabel("Jaar")
ax.set_ylabel("Waarde (log-schaal)")
hap.plotting.timeline_axis(ax)
plt.show()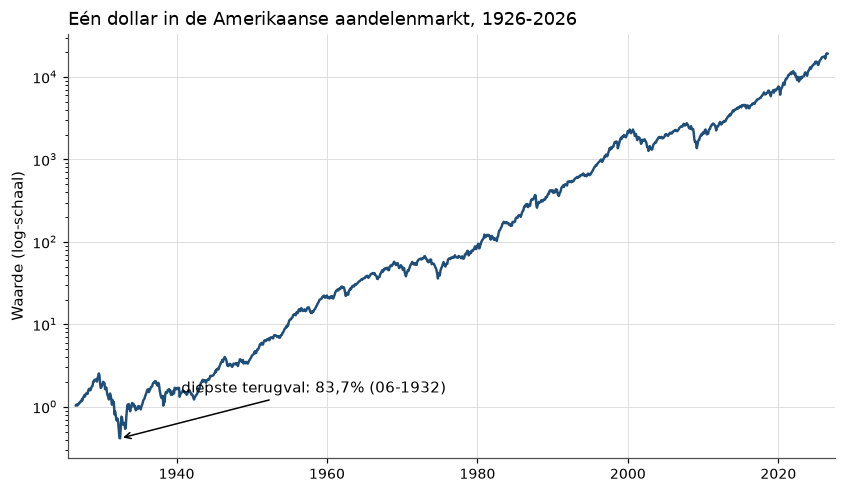
Figure 1:Cumulatieve waarde van één dollar, herbelegd in de waardegewogen markt. Op een log-schaal zijn gelijke procentuele bewegingen even groot, terwijl op een lineaire schaal alles vóór 1980 een vlakke lijn zou zijn. De diepste terugval is 83,7%, met het dieptepunt in juni 1932.
4.2Robert Shiller: prijzen en dividenden, 1871–
De maandreeks van Shiller gaat een halve eeuw verder terug dan French en bevat naast de prijs ook het dividend, de winst, de consumentenprijsindex en de lange rente Shiller (2000). Daarmee koppelen we prijzen aan fundamentals (dividenden en winsten) en niet alleen aan elkaar, wat nodig is voor alles wat met waardering en voorspelbaarheid te maken heeft. De bekendste afgeleide reeks is de CAPE: de prijs gedeeld door het tienjaarsgemiddelde van de reële winst.
We tonen de eerste en de laatste maand waarin alle vijf kolommen bekend zijn, zodat de twee uitersten van de reeks naast elkaar staan.
shiller = hap_data.shiller()
shiller[["price", "dividend", "earnings", "cape", "dp"]].dropna().iloc[[0, -1]].round(3)Tussen 1881 en 2026 steeg de CAPE van 18,5 naar 40,2, en het dividendrendement
(kolom dp, hier als gewone verhouding en niet in logs) daalde van 4,3% naar 1,1%.
De figuur toont
de hele CAPE-reeks met het gemiddelde als stippellijn, en laat zien dat de reeks
soms tientallen jaren boven of onder die lijn blijft.
Source
cape = shiller["cape"].dropna()

fig, ax = plt.subplots()
ax.plot(cape.index, cape)
ax.axhline(cape.mean(), color=hap.plotting.COLORS[1], ls="--", lw=1.2,
           label=f"gemiddelde ({cape.mean():.1f})")
ax.set_title("Cyclisch gecorrigeerde koers-winstverhouding (CAPE), 1881-2026")
ax.set_xlabel("Jaar")
ax.set_ylabel("CAPE")
ax.legend()
hap.plotting.timeline_axis(ax)
plt.show()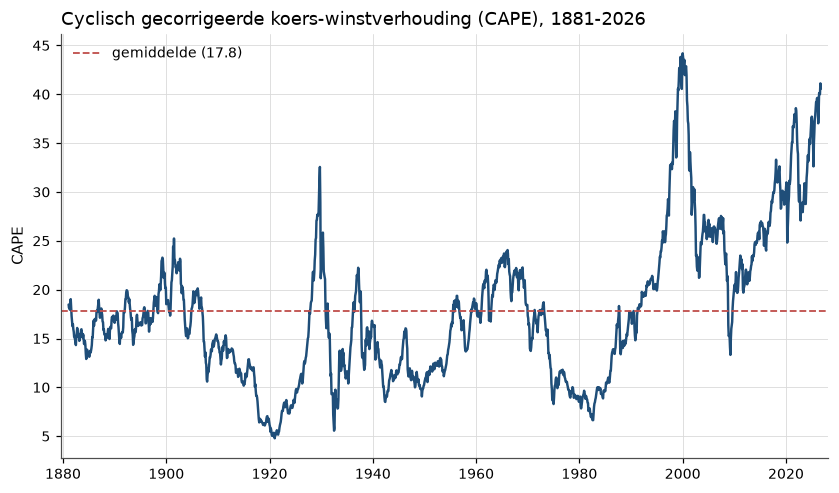
Figure 2:De CAPE schommelt over decennia rond een gemiddelde van ongeveer 17,8 en staat aan het eind van de steekproef op ruim 40. Betekent zo’n hoge waarde een lage discontovoet of een te hoge prijs? Over die vraag werden Fama en Shiller het niet eens.
4.3Goyal-Welch: de voorspellers
Welch en Goyal verzamelden de variabelen waarmee de literatuur de aandelenpremie probeerde te voorspellen, zoals het dividendrendement, de termijnspread en de netto aandelenuitgifte. Ze toonden dat vrijwel geen ervan buiten de steekproef beter voorspelt dan het historisch gemiddelde Welch & Goyal (2008). Hun dataset wordt nog altijd bijgehouden en loopt vanaf 1871.
De laatste drie jaarrijen laten zien hoe de kolommen heten en in welke eenheden ze staan.
gw = hap_data.goyal_welch("annual")
gw[["Index", "D12", "E12", "tbl", "dp", "tms", "equity_premium"]].tail(3).round(4)Anders dan bij Shiller is dp in deze dataset het log dividendrendement, , en
dus
een negatief getal rond . De kolommen D12 en E12 zijn dividend en winst over
twaalf maanden, tbl is de rente op schatkistpapier en tms de termijnspread, terwijl
equity_premium het overrendement op de markt in dat jaar is. De figuur laat
zien of dp over jaren of over decennia beweegt.
Source
fig, ax = plt.subplots()
ax.plot(gw.index, gw["dp"])
ax.set_title("Log dividendrendement, jaarlijks 1871-2025")
ax.set_xlabel("Jaar")
ax.set_ylabel("$\\log(D/P)$")
hap.plotting.timeline_axis(ax)
plt.show()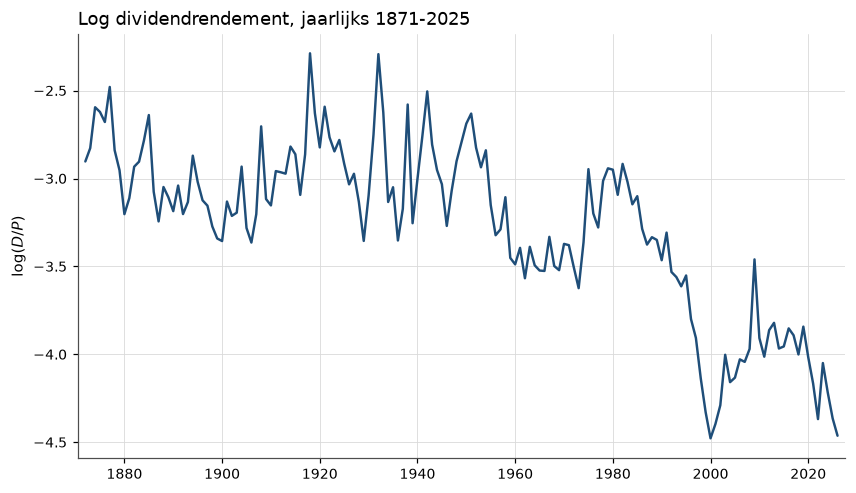
Figure 3:Het log dividendrendement is extreem persistent, want het beweegt over decennia en niet over jaren. Daardoor lijdt een regressie met deze voorspeller aan de Stambaugh-bias Stambaugh (1999), omdat een stijgende koers het rendement verhoogt en tegelijk verlaagt. Door die tegengestelde beweging valt de geschatte helling juist te hoog uit in steekproeven waarin de persistentie te laag uitvalt. Omdat dat in een korte steekproef gemiddeld gebeurt, is de helling naar boven vertekend en de -waarde te groot. Die vertekening geldt ook voor de regressie verderop in dit college.
4.4FRED: de macrocontext
FRED, van de Federal Reserve Bank of St. Louis, levert alles wat de markt
omringt: consumptie, inflatie, rentes, wisselkoersen, credit spreads en de VIX.
Ook de NBER-recessie-indicator komt uit FRED, en hap.plotting.recession_shading
tekent daarmee grijze banden in een figuur. De loader haalt één serie per
aanroep, in de eenheden van FRED.
Als voorbeeld laden we de VIX, de door de optiemarkt verwachte volatiliteit van de S&P 500 over de komende maand, in procenten per jaar.
vix = hap_data.fred("VIXCLS")
vix.describe().round(2)Over 9266 handelsdagen sinds 1990 ligt de mediaan van de VIX op 17,6, maar het maximum op 82,7. De figuur laat zien of die pieken samenvallen met de grijze recessiebanden.
Source
series = vix["VIXCLS"].dropna()

fig, ax = plt.subplots()
ax.plot(series.index, series, lw=1.0)
ax.set_title("VIX en NBER-recessies, 1990-2026")
ax.set_xlabel("Jaar")
ax.set_ylabel("Impliciete volatiliteit (procenten per jaar)")
hap.plotting.timeline_axis(ax)
hap.plotting.recession_shading(ax)
plt.show()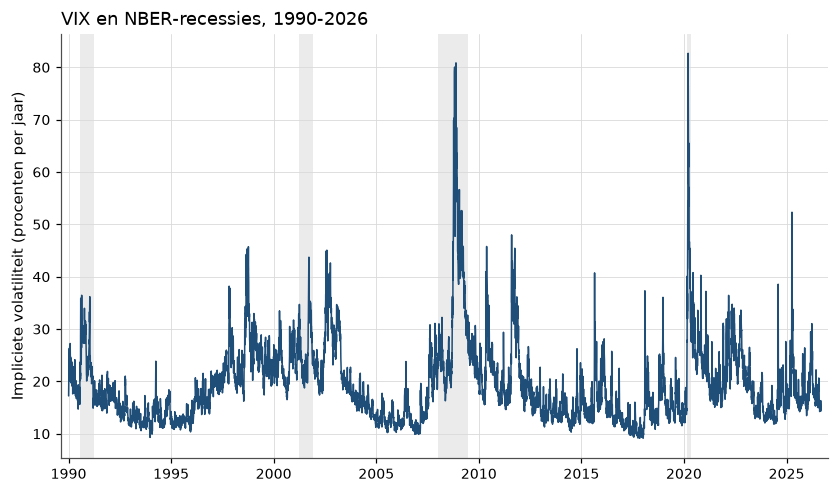
Figure 4:De VIX piekt in recessies (grijs), maar niet alleen daar. Oktober 2008 en maart 2020 springen eruit, en 1998 en 2018 zijn ook zichtbaar. Anders dan het gemiddelde rendement clustert volatiliteit zichtbaar, en daarom is ze voorspelbaar.
4.5Gürkaynak-Sack-Wright: de yieldcurve
De Federal Reserve publiceert dagelijks een geschatte zero-coupon yieldcurve,
terug tot 1961 Gürkaynak et al. (2007). De loader hap.gsw() geeft de kolommen
SVENYnn (zero-coupon yield op jaar), SVENFnn (instantane forward) en de
onderliggende parameters, alles als decimalen.
We kiezen drie dagen die het bereik van de reeks laten zien en tonen de yield op één, vijf en tien jaar.
gsw = hap_data.gsw()
gsw.loc[["1981-09-30", "2020-08-04", "2026-08-28"], ["SVENY01", "SVENY05", "SVENY10"]].round(4)In september 1981 was de eenjaarsrente 15,7%, terwijl ze in augustus 2020 op 0,13% stond. De figuur tekent voor dezelfde drie dagen de curve over alle geschatte looptijden, tot dertig jaar in 2020 en 2026 maar tot twintig jaar in 1981, zodat te zien is of de curve met de looptijd daalt, stijgt of afvlakt.
Source
maturities = [f"SVENY{n:02d}" for n in range(1, 31)]

fig, ax = plt.subplots()
for date, label in [("1981-09-30", "30 sep. 1981"),
                    ("2020-08-04", "4 aug. 2020"),
                    ("2026-08-28", "28 aug. 2026")]:
    curve = gsw.loc[date, maturities].dropna()
    years = [int(name[-2:]) for name in curve.index]
    ax.plot(years, curve.to_numpy() * 100, marker="o",
            ms=3, label=label)
ax.set_title("De Amerikaanse zero-coupon yieldcurve op drie dagen")
ax.set_xlabel("Looptijd (jaren)")
ax.set_ylabel("Yield (procenten per jaar)")
ax.legend()
plt.show()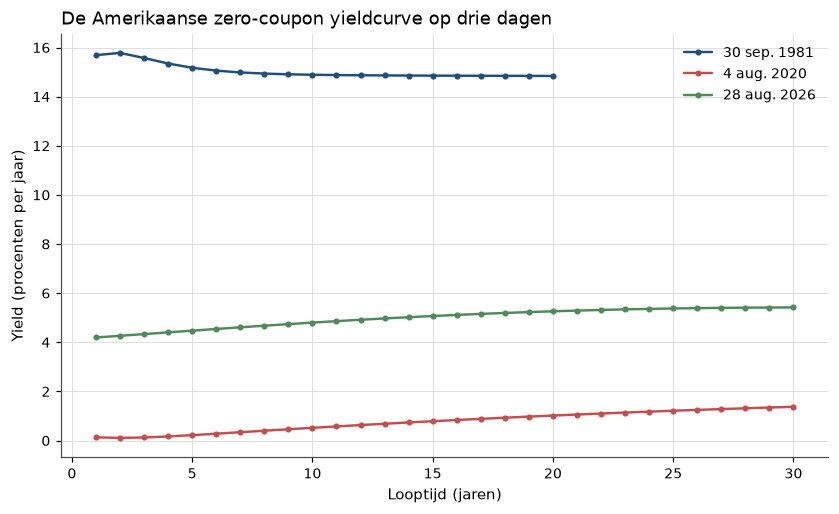
Figure 5:In 1981 daalt de curve met de looptijd, in 2020 stijgt ze vanaf bijna nul, en in 2026 loopt ze licht op. Een steile curve gaat vaak vooraf aan hoge rendementen op lange obligaties, maar ook daar is de vraag of die rendementen een beloning voor risico zijn of het gevolg van een vergissing van beleggers.
4.6Open Source Asset Pricing: de factor zoo, gedocumenteerd
Chen en Zimmermann bouwden de gepubliceerde cross-sectionele anomalieën na volgens de recepten van de originele artikelen Chen & Zimmermann (2022). Een anomalie, in de data een signaal of voorspeller genoemd, is een kenmerk van aandelen dat gemiddelde rendementen lijkt te voorspellen, bijvoorbeeld de accruals van een bedrijf. Per signaal publiceerden Chen en Zimmermann het long-short-rendement, het rendement van de portefeuille met de hoogste waarden van het kenmerk min dat van de portefeuille met de laagste. Een documentatiebestand geeft per signaal de auteurs, het publicatiejaar en de gerapporteerde -waarde, zodat na te gaan is of factoren na publicatie blijven werken.
We laden het documentatiebestand en tonen de eerste vijf voorspellers.
signaldoc = hap_data.osap("signaldoc")
predictors = signaldoc[signaldoc["Cat.Signal"] == "Predictor"]
predictors[["signal", "Authors", "Year", "Journal", "T-Stat"]].head(5)Elke rij is één gepubliceerd signaal, met de -waarde uit het originele artikel. De figuur telt de signalen cumulatief per publicatiejaar, en de legenda geeft de mediane gepubliceerde -waarde. Rond welk jaar wordt de lijn steil?
Source
per_year = predictors.index.year.value_counts().sort_index()
median_t = predictors["T-Stat"].median()

fig, ax = plt.subplots()
ax.step(per_year.index, per_year.cumsum(), where="post",
        label=f"{len(predictors)} signalen, mediane t-waarde {number_nl(median_t)}")
ax.set_title("Cumulatief aantal gepubliceerde voorspellers van de cross-sectie")
ax.set_xlabel("Publicatiejaar")
ax.set_ylabel("Aantal signalen")
ax.legend()
plt.show()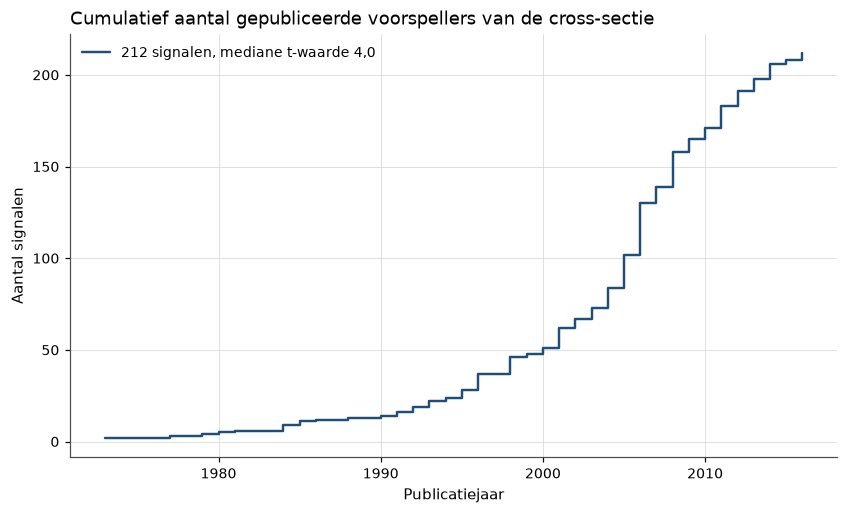
Figure 6:Het aantal groeit van een handvol anomalieën in de jaren zeventig naar 212 gereproduceerde signalen. De mediane gepubliceerde -waarde is 4,0, ruim boven de gebruikelijke drempel van 1,96. Die hoge mediaan is geen toeval maar een selectie-effect, omdat wat niet significant was, niet werd gepubliceerd Harvey et al. (2016).
4.7He-Kelly-Manela: het kapitaal van de tussenpersoon
Na 2008 kwam er een klasse modellen waarin niet de gemiddelde belegger de prijzen zet, maar de gefinancierde tussenpersoon: de dealer, de hedgefondsdesk, de bank. He, Kelly en Manela construeerden de kapitaalratio van de primary dealers, de grote banken die rechtstreeks met de Federal Reserve handelen. Ze lieten zien dat schokken in die ratio de gemiddelde rendementen in veel activaklassen tegelijk verklaren He et al. (2017).
We tonen de laatste drie maanden van de vier kolommen.
hkm = hap_data.hkm("monthly")
hkm.tail(3).round(4)De kapitaalratio stond in het voorjaar van 2025 rond 7,5%. De figuur toont de hele reeks sinds 1970, met een pijl bij het laagste punt, dat midden in een recessie valt.
Source
ratio = hkm["intermediary_capital_ratio"]
low_date = ratio.idxmin()

fig, ax = plt.subplots()
ax.plot(ratio.index, ratio * 100)
ax.annotate(
    f"laagste punt: {number_nl(100 * ratio.min())}% ({low_date:%m-%Y})",
    xy=(low_date, ratio.min() * 100),
    xytext=(30, 20), textcoords="offset points",
    arrowprops={"arrowstyle": "->"},
)
ax.set_title("Kapitaalratio van de primary dealers, 1970-2025")
ax.set_xlabel("Jaar")
ax.set_ylabel("Kapitaal / activa (procenten)")
hap.plotting.timeline_axis(ax)
hap.plotting.recession_shading(ax)
plt.show()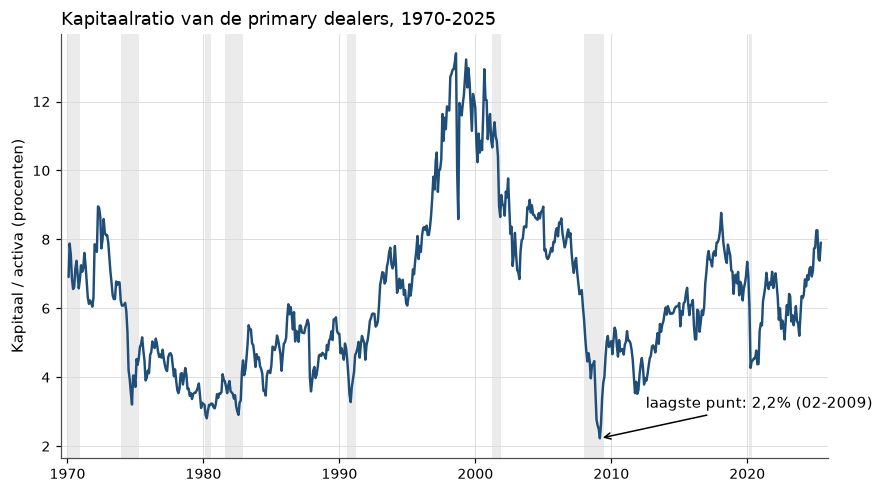
Figure 7:De kapitaalratio van de tussenpersonen bereikt het laagste punt in februari 2009, op 2,2%. In modellen van intermediary asset pricing is die ratio de toestandsvariabele. Als het kapitaal van de dealer daalt ten opzichte van zijn activa, stijgt de vergoeding die hij eist voor elk risico dat hij draagt. In die lezing is een crash een moment waarop risico duurder wordt, terwijl Shiller in dezelfde lage prijzen paniek ziet.
4.8Yahoo Finance: recente koersen en optieketens
Voor dagkoersen van afzonderlijke effecten, zoals in event studies en bij
optieketens, gebruiken we Yahoo Finance via yfinance. De cache bevat voor
splitsingen en dividenden gecorrigeerde slotkoersen van de vijf ETF’s hieronder,
van vijftig afzonderlijke aandelen, van twee groepen beleggingsfondsen (59 en 8
fondsen), van enkele indexreeksen,
en twee momentopnamen van de optieketen van SPY. Yahoo is de enige onbetrouwbare bron in
de lijst, omdat downloads soms leeg terugkomen. Een college vraagt daarom alleen op
wat al in de cache staat.
De ETF-reeks begint in 1993, maar pas vanaf eind 2004 bestaan alle vijf de ETF’s. We nemen daarom 2005 en later, en tonen per ETF het gemiddelde rendement per jaar, berekend uit dagrendementen, met zijn standaardfout.
etf = hap_data.yahoo(["SPY", "TLT", "GLD", "QQQ", "IWM"], "1993-01-01")
recent = etf.loc["2005-01-01":].dropna()
daily_returns = recent.pct_change().dropna()

etf_stats = hap.summary_stats(daily_returns, "daily")
etf_stats[["mean_ann", "std_ann", "se_mean_ann"]].rename(columns=columns_nl).round(3)De standaardfouten liggen tussen 3 en 5 procentpunt. De gemiddelden van SPY, GLD en IWM liggen minder dan één procentpunt uit elkaar, terwijl QQQ en TLT 12,5 procentpunt uit elkaar liggen. De figuur zet elke reeks op 1 in 2005, zodat te zien is welke verschillen tussen de lijnen boven die standaardfouten uitsteken.
Source
normalised = recent / recent.iloc[0]

fig, ax = plt.subplots()
for column in normalised.columns:
    ax.plot(normalised.index, normalised[column], label=column)
ax.set_yscale("log")
ax.set_title("Vijf ETF's, geïndexeerd op 1 in 2005 (log-schaal)")
ax.set_xlabel("Jaar")
ax.set_ylabel("Waarde ten opzichte van 2005")
ax.legend(ncols=5)
hap.plotting.timeline_axis(ax)
plt.show()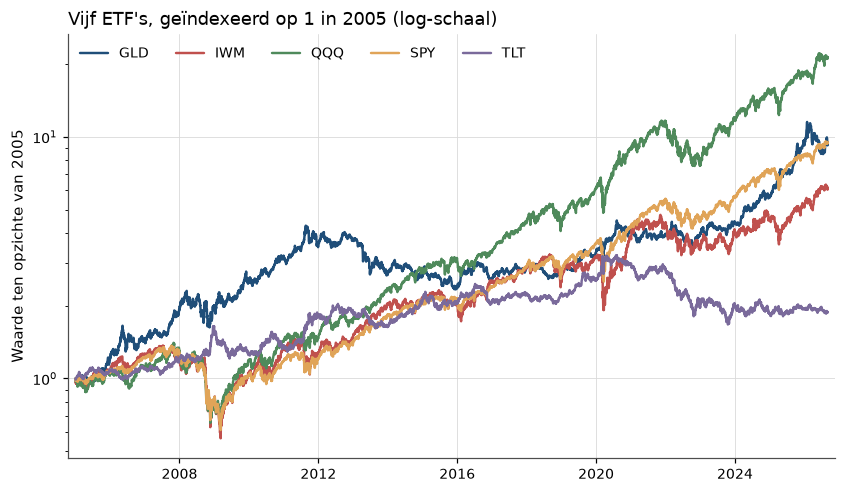
Figure 8:Aandelen (SPY, QQQ, IWM), langlopende staatsobligaties (TLT) en goud (GLD) vanaf 2005. Na twintig jaar is de standaardfout van elk gemiddelde 3 tot 5 procentpunt. Alleen grote verschillen, zoals QQQ tegen TLT (12,5 procentpunt), steken daar bovenuit. SPY, GLD en IWM eindigen verschillend, maar hun gemiddelden liggen binnen één procentpunt, zodat dat verschil in de ruis verdwijnt.
4.9Wat we niet hebben: CRSP en Compustat
Twee databanken komen in deze reeks voortdurend voor, zonder dat we ze ooit openen. Omdat bijna elk artikel dat we bespreken erop steunt, beschrijven we ze toch kort.
CRSP is het Center for Research in Security Prices van de Universiteit van Chicago. Vanaf 1960 bouwde het, met geld van Merrill Lynch, de eerste machineleesbare reeks maandrendementen van alle aandelen op de New York Stock Exchange, terug tot 1926. De reeks bevat dividenden en splitsingen, en ook de aandelen die van de beurs verdwenen, want zonder die laatste groep meet een onderzoeker alleen de overlevenden. De eerste publicatie op die tape Fisher & Lorie (1964) was de eerste betrouwbare meting van het gemiddelde rendement op Amerikaanse aandelen over een lange periode. De databank Compustat doet hetzelfde voor de boekhouding, met balans en resultatenrekening per bedrijf per kwartaal, en levert daarmee de noemer van elke waarderingsratio.
Beide zijn commercieel en duur en meestal alleen via een universiteitsabonnement toegankelijk, en daarom gebruikt deze reeks ze niet. Dat heeft een prijs, want we kunnen niets doen op het niveau van het individuele aandeel. We maken dus geen eigen sorteringen en geen eigen portefeuilles, en ook geen event study op een brede steekproef. In ruil draait elk college op een laptop zonder abonnement.
De belangrijkste bewerkingen zijn gelukkig al voor ons gedaan, want Kenneth French publiceert de portefeuilles die uit CRSP en Compustat zijn gebouwd, en Chen en Zimmermann publiceren de long-short-rendementen van de anomalieën. We erven daarmee wel hun constructiekeuzes, en waar die uitmaken, staat dat in het replicatieblok. Waar zelfs die portefeuilles niet volstaan, simuleren we, en dan staat erbij welke eigenschap van de echte data de simulatie nabootst.
Uit de acht figuren nemen we drie dingen mee. Gemiddelde rendementen zijn slecht bekend, over een eeuw (French) en zeker over twintig jaar (Yahoo). De traag bewegende grootheden, zoals de CAPE, het dividendrendement en de kapitaalratio, zijn de voorspellers waarover Chicago en Yale van mening verschillen. De factor zoo is ten slotte voor een deel een selectie-effect, omdat toeval bij zulke onzekere gemiddelden al snel significant lijkt.
5De gereedschapskist: hap.stats en hap.plotting
Naast de loaders bevat hap twee kleine modules. In hap.stats staan de
standaardschatters van deze literatuur: newey_west (OLS met standaardfouten die
autocorrelatie toelaten), fama_macbeth, grs_test, long_horizon_regression,
variance_ratio, hansen_jagannathan_bound, sharpe, drawdowns en
summary_stats. Ze werken op gewone pandas-objecten en verwachten rendementen als
decimalen per periode.
Als voorbeeld nemen we de vraag of het log dividendrendement het rendement van het volgende jaar voorspelt. Daarvoor regresseren we de aandelenpremie van jaar op , met Newey-West-standaardfouten en één lag.
panel = pd.DataFrame(
    {"ep_next": gw["equity_premium"].shift(-1), "dp": gw["dp"]}
).dropna()
fit = hap.newey_west(panel["ep_next"], panel[["dp"]], lags=1)

pd.DataFrame(
    {"coëfficiënt": fit.params, "standaardfout": fit.bse, "t-waarde": fit.tvalues}
).round(4)De helling is 0,042 en positief, zodat een hoog dividendrendement samengaat met een
hoger rendement daarna. Dat teken voorspelt de theorie van discontovoeten die in
de tijd variëren, want een hoog is een lage prijs ten opzichte van het dividend,
en een lage prijs betekent een hoog verwacht rendement. Toch bewijst de regressie met een
-waarde
van 0,95 niets. Er zijn honderd jaarwaarnemingen en niet 155,
omdat equity_premium pas in 1926 begint. Die spanning tussen een teken dat klopt en een
standaardfout
die te groot is komt in een groot deel van de reeks terug.
hap.plotting is kleiner. setup() zet de projectstijl en staat in de
eerste codecel van elk college. timeline_axis(ax) maakt van een datum-as een as in
kalenderjaren.
recession_shading(ax) zet de NBER-recessies als grijze banden achter een
figuur, en COLORS is het vaste kleurenpalet. Elke figuur heeft een titel en
aslabels in het Nederlands.
6Werken met de code
Het project wordt beheerd met uv. Alle Python-commando’s lopen via uv run,
dat de virtuele omgeving en de afhankelijkheden uit pyproject.toml op orde
houdt. De testsuite draait offline:
uv run pytest -qElk college bestaat twee keer, als MyST-markdown (lectures/00_00_setup.md) en
als notebook (lectures/00_00_setup.ipynb), en Jupytext houdt de twee gepaard. De
markdown is de bron voor de tekst, terwijl het notebook de plek is om code uit te proberen.
Na werk in het notebook synchroniseren we terug en voeren we het college opnieuw uit:
uv run jupytext --sync lectures/00_00_setup.md
uv run jupytext --execute --to ipynb lectures/00_00_setup.md
Voor de data zijn er twee omgevingsvariabelen. HAP_OFFLINE=1 verbiedt elke
download, zodat de loaders alleen uit data/cache/ lezen en een ontbrekende snapshot
een hap.CacheMissError geeft in plaats van stilzwijgend nieuwe data. Zo
draait de testsuite, en zo is elk college uitgevoerd. HAP_REFRESH=1 doet het
omgekeerde en haalt een verse snapshot op. Zonder een van beide wordt alleen
gedownload als het parquet-bestand ontbreekt. Snapshots verlopen dus nooit
vanzelf, en een figuur van vandaag ziet er morgen hetzelfde uit.
7Een eerste meting: het gemiddelde en zijn standaardfout
Waarom zou een eeuw data zo weinig zeggen? Een onderzoeker die een eeuw jaarrendementen middelt, heeft honderd trekkingen uit een verdeling met een klein midden en een grote spreiding. Een typisch jaar wijkt ongeveer 20 procentpunt af van het midden, terwijl dat midden, het overrendement, maar ongeveer 8% is. Meer jaren maken de schatting beter, maar traag, omdat de fout met de wortel van het aantal jaren daalt. Voor het gemiddelde helpt het niet om binnen een jaar vaker te meten. We verwachten dus een standaardfout die na een eeuw nog een flink deel van het gemiddelde zelf is.
De formule achter die verwachting is de standaardfout van een steekproefgemiddelde van onafhankelijke trekkingen met standaarddeviatie : . Met en is dat 2 procentpunt, een kwart van een premie van 8%. Voor de geschatte volatiliteit geldt bij normale rendementen , dus 1,4 procentpunt, en oefening 2 leidt die formule af.
We simuleren een markt met een werkelijk gemiddeld overrendement van 8% en een
werkelijke volatiliteit van 20% per jaar, honderd jaar lang. De 8% ligt dicht
bij de 8,3% van Mkt-RF in de eerste tabel, terwijl de 20% een ronde kalibratie is, iets
boven de gemeten 18,4%. Eerst kijken we wat
één zo’n eeuw schat.
mu_true, sigma_true, n_years = 0.08, 0.20, 100
one_century = rng.normal(mu_true, sigma_true, n_years)

mean_hat = one_century.mean()
se_hat = one_century.std(ddof=1) / np.sqrt(n_years)

pd.DataFrame(
    {
        "waarde": [mu_true, mean_hat, se_hat, mean_hat - 1.96 * se_hat,
                   mean_hat + 1.96 * se_hat],
    },
    index=["werkelijk gemiddelde", "geschat gemiddelde", "standaardfout",
           "ondergrens 95%", "bovengrens 95%"],
).round(4)Deze gesimuleerde eeuw schat 8,5% met een standaardfout van 2,0 procentpunt. Het 95%-interval loopt van 4,5% tot 12,4% en bevat dus het werkelijke gemiddelde.
Omdat één steekproef weinig zegt, simuleren we daarna tienduizend eeuwen en zetten we de spreiding van beide schatters naast de formules.
n_sim = 10_000
samples = rng.normal(mu_true, sigma_true, size=(n_sim, n_years))
means = samples.mean(axis=1)
sds = samples.std(axis=1, ddof=1)

se_mean_formula = sigma_true / np.sqrt(n_years)
se_sd_formula = sigma_true / np.sqrt(2 * n_years)

pd.DataFrame(
    {
        "formule": [se_mean_formula, se_sd_formula],
        "simulatie": [means.std(ddof=1), sds.std(ddof=1)],
        "relatieve fout (simulatie)": [means.std(ddof=1) / mu_true,
                                       sds.std(ddof=1) / sigma_true],
    },
    index=["standaardfout gemiddelde", "standaardfout volatiliteit"],
).round(4)Formule en simulatie komen overeen: 2,0 procentpunt voor het gemiddelde, 1,4 voor de volatiliteit. Relatief is het verschil toch groot, want het gemiddelde heeft een relatieve fout van ongeveer 25% en de volatiliteit van ongeveer 7%. Na een eeuw is de volatiliteit dus op een paar procent na bekend, maar het gemiddelde pas op een kwart na. De figuur toont de hele verdeling van het geschatte gemiddelde, met de 95%-grenzen als stippellijnen.
Source
fig, ax = plt.subplots()
ax.hist(means * 100, bins=60, edgecolor="white")
ax.axvline(mu_true * 100, color=hap.plotting.COLORS[1], lw=1.6,
           label="werkelijk gemiddelde (8%)")
for side in (-1, 1):
    ax.axvline((mu_true + side * 1.96 * sigma_true / np.sqrt(n_years)) * 100,
               color="black", ls="--", lw=1.0)
ax.set_title("Geschat gemiddeld rendement uit 10 000 gesimuleerde eeuwen")
ax.set_xlabel("Geschat gemiddelde (procenten per jaar)")
ax.set_ylabel("Aantal steekproeven")
ax.legend()
plt.show()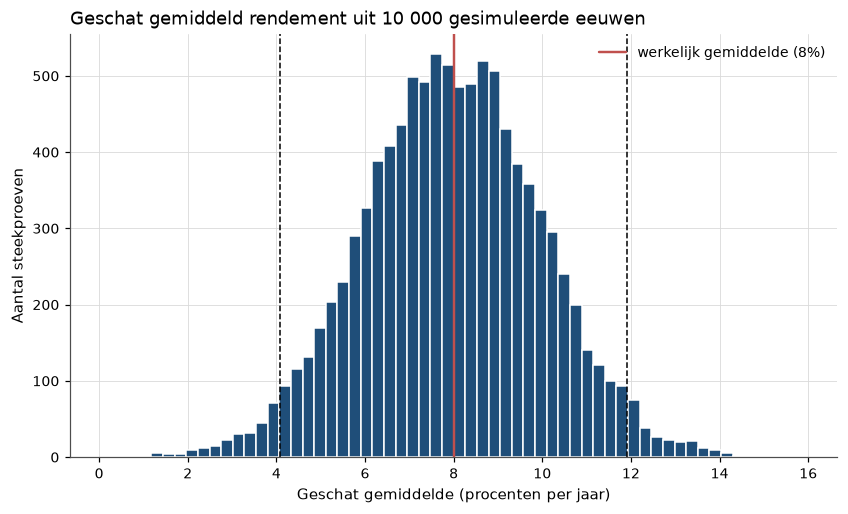
Figure 9:De verdeling van het gemiddelde rendement over tienduizend gesimuleerde eeuwen. De stippellijnen liggen twee standaardfouten van de waarheid af, op ongeveer 4% en 12%. Een onderzoeker met honderd jaar data en een perfect gespecificeerd model weet dus nog steeds niet of de premie 4% of 12% is.
Zoals verwacht is het gemiddelde na een eeuw nog slecht bekend en de volatiliteit goed. De asymmetrie komt uit de verhouding , want bij 20% tegen 8% is de ruis van één jaar 2,5 keer zo groot als het signaal. Meer jaren helpen beide, maar fijnere data helpt alleen de variantie. Voor het gemiddelde logrendement is de reden precies aan te wijzen. Dat gemiddelde is het logverschil tussen eind- en beginkoers, gedeeld door de lengte van de periode, zodat de koersen daartussen niet meetellen. Het rekenkundig gemiddelde ligt ongeveer een halve variantie hoger en is dus even slecht gemeten. De variantie daarentegen is een gemiddelde van gekwadrateerde rendementen en wordt scherper met elke extra waarneming.
De regressie in de gereedschapskist liet dezelfde asymmetrie zien, want de helling van 0,042 had een standaardfout van 0,044. Het teken klopte, maar de helling zelf was nauwelijks van nul te onderscheiden.
We zetten simulatie en data naast elkaar, en voor de data berekenen we de standaardfout op twee manieren, met de formule en met Newey-West over twaalf maanden, die autocorrelatie toelaat.
excess_monthly = market["Mkt-RF"]
excess_stats = market_stats.loc["Mkt-RF"]

constant = pd.Series(1.0, index=excess_monthly.index, name="gemiddelde")
nw_fit = hap.newey_west(excess_monthly, constant, lags=12, add_constant=False)
se_newey_west = 12 * nw_fit.bse["gemiddelde"]  # monthly to annual

pd.DataFrame(
    {
        "simulatie (8%, 20%)": [mu_true, sigma_true, se_mean_formula,
                                means.std(ddof=1), np.nan],
        "data (Mkt-RF)": [excess_stats["mean_ann"], excess_stats["std_ann"],
                          excess_stats["se_mean_ann"], np.nan, se_newey_west],
    },
    index=["gemiddelde", "volatiliteit", "standaardfout, formule",
           "standaardfout, spreiding over simulaties", "standaardfout, Newey-West"],
).round(4)Geslaagd. Op de data geeft de formule 1,8 procentpunt en Newey-West 2,0,
binnen de verwachte afwijking van enkele tienden. Het gemiddelde overrendement is
dus na een eeuw maar op ongeveer 2 procentpunt na bekend, en voor het totale
marktrendement Mkt geldt hetzelfde, omdat de risicovrije rente nauwelijks
schommelt. Die onzekerheid is geen metafoor, maar een uitkomst die we hier drie keer
hebben gevonden: met de formule, in de simulatie en op de data.
8Wat er daarna komt
De gereedschapskist staat klaar: acht databronnen die offline draaien, een notatie voor de hele reeks, en een handvol schatters. Er ontbreekt nog het begrip waar alles op rust, want in dit college hebben we rendementen opgeteld, gemiddeld en geannualiseerd zonder te zeggen wat een rendement is. Ook bleef open of het meetkundig of het rekenkundig gemiddelde de gestelde vraag beantwoordt, en de bewering dat dagdata de variantie scherper maken en het gemiddelde niet, staat hier nog zonder bewijs.
Die vragen beantwoordt Rendementen en hun statistiek, met logrendementen en simpele rendementen, annualisatie, de standaardfout van het gemiddelde in volle vorm, autocorrelatie en dikke staarten. Daarna begint het verhaal in 1863, bij een man in Parijs die zag dat de koersuitslag met de wortel van de tijd toenam.
9Oefeningen
Solution to Exercise 1
We rekenen eerst de statistieken per industrie uit, gesorteerd van hoog naar laag gemiddelde.
industries = hap_data.french("10_Industry_Portfolios", "monthly").loc["1970":]
table = hap.summary_stats(industries, "monthly")[
    ["nobs", "mean_ann", "std_ann", "se_mean_ann"]
]
table.sort_values("mean_ann", ascending=False).rename(columns=columns_nl).round(4)Energie staat bovenaan en telecom onderaan. Voor dat verschil berekenen we twee standaardfouten: een zonder correlatie, en een uit de verschilreeks.
best, worst = table["mean_ann"].idxmax(), table["mean_ann"].idxmin()
gap = table.loc[best, "mean_ann"] - table.loc[worst, "mean_ann"]
se_uncorrelated = np.sqrt(
    table.loc[best, "se_mean_ann"] ** 2 + table.loc[worst, "se_mean_ann"] ** 2
)

monthly_gap = (industries[best] - industries[worst]).rename("verschil")
se_paired = float(hap.summary_stats(monthly_gap, "monthly").loc["verschil", "se_mean_ann"])

pd.DataFrame(
    {"waarde": [gap, se_uncorrelated, gap / se_uncorrelated, se_paired, gap / se_paired]},
    index=[
        f"verschil {best} - {worst}",
        "standaardfout, ongecorreleerd",
        "t-waarde, ongecorreleerd",
        "standaardfout, uit de verschilreeks",
        "t-waarde, uit de verschilreeks",
    ],
).round(4)Het verschil tussen de beste en de slechtste industrie is 2,7 procentpunt per jaar, en zonder correlatie is de standaardfout 3,7 procentpunt. De twee reeksen zijn echter positief gecorreleerd, zodat de gemeenschappelijke marktbeweging uit het verschil wegvalt. Daardoor is de standaardfout uit de verschilreeks kleiner, 2,8 procentpunt, maar ook dan blijft de -waarde net onder één.
Zelfs de uitersten van tien portefeuilles zijn over een halve eeuw niet van elkaar te onderscheiden. Een rangorde van gemiddelde rendementen weerspiegelt dus vooral ruis.
:::{exercise}
:label: ex-setup-2

**Hoeveel data is genoeg?** Gebruik `hap_data.market_monthly()`. Alle drie de
deelvragen gaan over het overrendement `Mkt-RF`.

1. Splits de steekproef in 1926–1975 en 1976–2026 en bereken voor beide helften
   het geannualiseerde gemiddelde overrendement met standaardfout. Verschilt
   het gemiddelde significant tussen de twee helften?
2. Hoeveel jaar data is nodig om het gemiddelde overrendement tot op 0,5
   procentpunt nauwkeurig te kennen, bij de waargenomen volatiliteit?
3. Laat zien dat bij normale rendementen $\SD(\hat\sigma) \approx
   \sigma/\sqrt{2T}$, met $\Var(\hat\sigma^2) = 2\sigma^4/T$ en de deltamethode.
   Herhaal (2) voor de standaarddeviatie, met jaardata en met maanddata.
Solution to ex-setup-2
We berekenen eerst de statistieken per helft.
excess = hap_data.market_monthly()["Mkt-RF"]
halves = pd.concat(
    [
        hap.summary_stats(excess.loc[:"1975"].rename("1926-1975"), "monthly"),
        hap.summary_stats(excess.loc["1976":].rename("1976-2026"), "monthly"),
    ]
)[["nobs", "mean_ann", "std_ann", "se_mean_ann"]]
halves.rename(columns=columns_nl).round(4)De gemiddelden liggen dicht bij elkaar, met standaardfouten van 3,0 en 2,2 procentpunt. De volgende cel toetst het verschil en rekent uit hoeveel jaren nodig zijn voor een standaardfout van 0,5 procentpunt.
diff = halves.loc["1926-1975", "mean_ann"] - halves.loc["1976-2026", "mean_ann"]
se_diff = np.sqrt(
    halves.loc["1926-1975", "se_mean_ann"] ** 2 + halves.loc["1976-2026", "se_mean_ann"] ** 2
)

sigma = float(hap.summary_stats(excess, "monthly").loc["Mkt-RF", "std_ann"])
years_mean = (sigma / 0.005) ** 2
years_sd = sigma**2 / (2 * 0.005**2)
years_sd_monthly = years_sd / 12  # twelve independent observations per year

pd.DataFrame(
    {"waarde": [diff, se_diff, diff / se_diff, years_mean, years_sd, years_sd_monthly]},
    index=[
        "verschil tussen de helften",
        "standaardfout van het verschil",
        "t-waarde",
        "jaren nodig voor SE(gemiddelde) = 0,5pp",
        "jaren nodig voor SE(std.dev.) = 0,5pp",
        "idem, met maanddata",
    ],
).round(3)Voor de afleiding geeft de deltamethode . De twee helften van de eeuw verschillen met een -waarde van . Uit de data valt dus niet op te maken of de aandelenpremie tussen de eerste en de tweede halve eeuw is veranderd. Om het gemiddelde tot op een half procentpunt te kennen, zijn ongeveer 1350 jaar nodig, meer dan er beurzen bestaan. Voor de standaarddeviatie volstaan met jaardata ongeveer 675 jaar, de helft. Met onafhankelijke maandrendementen is dat ongeveer 56 jaar, want de variantie profiteert van metingen binnen het jaar en het gemiddelde niet.
Het gemiddelde rendement blijft met elke denkbare hoeveelheid beursgeschiedenis slecht bekend, terwijl de volatiliteit met ruim een halve eeuw maanddata al tot op een half procentpunt te meten is. Waarom fijnere data alleen de variantie helpt, staat in Rendementen en hun statistiek.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Sargent, T. J., & Stachurski, J. (n.d.). Advanced Quantitative Economics with Python. Online lecture series, QuantEcon. https://python-advanced.quantecon.org
- Mehra, R., & Prescott, E. C. (1985). The Equity Premium: A Puzzle. Journal of Monetary Economics, 15(2), 145–161. 10.1016/0304-3932(85)90061-3
- Fama, E. F., & French, K. R. (1993). Common Risk Factors in the Returns on Stocks and Bonds. Journal of Financial Economics, 33(1), 3–56. 10.1016/0304-405X(93)90023-5
- Shiller, R. J. (2000). Irrational Exuberance. Princeton University Press.
- Welch, I., & Goyal, A. (2008). A Comprehensive Look at the Empirical Performance of Equity Premium Prediction. Review of Financial Studies, 21(4), 1455–1508. 10.1093/rfs/hhm014
- Stambaugh, R. F. (1999). Predictive Regressions. Journal of Financial Economics, 54(3), 375–421. 10.1016/S0304-405X(99)00041-0
- Gürkaynak, R. S., Sack, B., & Wright, J. H. (2007). The U.S. Treasury Yield Curve: 1961 to the Present. Journal of Monetary Economics, 54(8), 2291–2304. 10.1016/j.jmoneco.2007.06.029
- Chen, A. Y., & Zimmermann, T. (2022). Open Source Cross-Sectional Asset Pricing. Critical Finance Review, 11(2), 207–264. 10.1561/104.00000112
- Harvey, C. R., Liu, Y., & Zhu, H. (2016). \ldots and the Cross-Section of Expected Returns. The Review of Financial Studies, 29(1), 5–68. 10.1093/rfs/hhv059
- He, Z., Kelly, B., & Manela, A. (2017). Intermediary Asset Pricing: New Evidence from Many Asset Classes. Journal of Financial Economics, 126(1), 1–35. 10.1016/j.jfineco.2017.08.002
- Fisher, L., & Lorie, J. H. (1964). Rates of Return on Investments in Common Stocks. The Journal of Business, 37(1), 1–21. 10.1086/294647
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD