

Behavioral finance en limits of arbitrage
1Overzicht
Kunnen vergissingen van beleggers prijzen blijvend verschuiven als er ook rationele arbitrageurs zijn? Ja, omdat tegenhandelen zelf riskant is en kapitaal vraagt, maar prijzen en rendementen alleen kunnen niet uitmaken of een voorspelbaar rendement een vergissing is of een beloning voor risico. In dit college:
rekenen we na waarom een verliesaverse belegger een gok weigert die hij in een bundel wel aanneemt;
leiden we af welke aandelenpremie zo’n belegger eist als hij zijn portefeuille elk jaar bekijkt;
bewijzen we in twee modellen waarom arbitrageurs een verkeerde prijs niet wegdrukken, en dat risico en vergissing dezelfde prijzen kunnen opleveren;
simuleren we hoe slecht de evaluatieperiode van zo’n belegger te meten is;
repliceren we de lange-termijnomkering van De Bondt en Thaler en de evaluatieperiode van Benartzi en Thaler, en vatten we de handelsstudies van Odean en Barber samen.
De efficiënte-marktenhypothese rustte op twee stappen. Beleggers zijn rationeel, en voor zover ze dat niet zijn, handelen arbitrageurs hun fouten weg. Kahneman en Tversky vielen de eerste stap aan met experimenten waarin mensen systematisch afweken van verwacht nut Kahneman & Tversky (1979)Tversky & Kahneman (1992). De tweede stap viel toen bleek dat arbitrage zelf riskant is en kapitaal vraagt, zodat er limits of arbitrage zijn (grenzen aan wat arbitrageurs kunnen wegdrukken) De Long et al. (1990)Shleifer & Vishny (1997). Intussen vonden De Bondt en Thaler dat de verliezers van de afgelopen jaren later de winnaars verslaan De Bondt & Thaler (1985). Benartzi en Thaler verklaarden de aandelenpremie uit verliesaversie Benartzi & Thaler (1995), en Odean en Barber zagen particulieren te veel handelen Odean (1998)Barber & Odean (2000)Barber & Odean (2001). Het tijdvak sluit af met het overzicht van Barberis en Thaler Barberis & Thaler (2003). Wat theorie of feit betreft, zijn dit geen modellen die een toets kan verwerpen, maar concurrerende verklaringen voor feiten die al bekend waren.
2Intuïtie: waarom zou dit waar zijn?
Bied iemand een munt aan waarbij hij bij kop 150 euro wint en bij munt 100 euro verliest. De verwachte winst is 25 euro, en toch weigeren de meeste mensen. Kahneman en Tversky verklaarden dat met drie eigenschappen. Mensen beoordelen uitkomsten als winst of verlies ten opzichte van een referentiepunt, en een verlies doet ongeveer twee keer zoveel pijn als een even grote winst plezier doet (loss aversion, verliesaversie). Bovendien neemt de gevoeligheid af naarmate winst of verlies groter wordt.
Dezelfde persoon neemt de gok vaak wel aan als hij hem een paar keer mag spelen en alleen het eindresultaat telt. Benartzi en Thaler zagen daarin een verklaring voor de hoge aandelenpremie, omdat aandelen over twintig jaar zelden verlies opleveren en over één jaar vaak. Een belegger die elk jaarverlies als verlies voelt (myopic loss aversion), eist daarom een hoge premie. Dezelfde neiging om rekeningen apart bij te houden verklaart waarom beleggers winnaars te vroeg verkopen en verliezers te lang vasthouden Thaler (1985)Thaler (1999)Shefrin & Statman (1985).
Vergissingen alleen verplaatsen nog geen prijzen, want als een groep te optimistisch is, kopen rationele beleggers minder. Dat verandert als tegenhandelen zelf riskant is. Het sentiment van morgen kan nog extremer zijn dan dat van vandaag, en dat herverkooprisico bestaat alleen door de noise traders (beleggers die op sentiment handelen in plaats van op informatie). Rationele beleggers vragen er een premie voor, zodat noise traders gemiddeld meer kunnen verdienen, omdat ze meer dragen van het risico dat ze zelf veroorzaken.
Arbitrageurs beleggen bovendien andermans geld. Als een prijs verder wegdrijft, trekken inleggers geld terug, zodat de arbitrageurs moeten verkopen en de prijs nog verder wegdrijft. Royal Dutch en Shell verdeelden hun winst sinds 1907 in de verhouding 60 tegen 40, en toch weken hun koersen daar tussen 1980 en 1995 soms 30% of meer van af Froot & Dabora (1999).
We verwachten daarom dat de premie van een verliesaverse belegger daalt naarmate hij minder vaak kijkt, en dat noise traders meer kunnen verdienen en toch slechter af zijn. Verder verwachten we dat een extra schok de prijs harder omlaag duwt naarmate inleggers sneller hun geld terugtrekken. Ten slotte zou een hoog rendement na een lage prijs er hetzelfde uit moeten zien, of de oorzaak nu risico is of een vergissing.
3Toy-voorbeeld: een munt, één keer en twee keer gegooid
Het toy-voorbeeld rekent uit wat de munt waard is voor een verliesaverse belegger, eerst per worp en daarna voor twee worpen samen. We laden eerst de pakketten van het hele college.
from itertools import product

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import optimize, special, stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Tversky en Kahneman schatten in 1992 een waardefunctie met een knik in nul Tversky & Kahneman (1992). Een winst is waard en een verlies . De exponent laat de gevoeligheid afnemen, en de factor laat een verlies zwaarder tellen dan een even grote winst.
| uitkomst | kans | ||
|---|---|---|---|
| +150 | 82,22 | 82,22 | |
| -100 | 57,54 |
Stap 1. Eén worp is waard, dus de belegger weigert.
Stap 2. Twee worpen geven +300, +50 en -200 met kansen , en . Met , en is .
Stap 3. Apart beoordeeld tellen de twee worpen , samen maar .
Tversky en Kahneman wogen ook de kansen, met een formule die pas in de theorie aan bod komt. Een kans van een half telt bij hen als 0,4206 voor een winst en als 0,4540 voor een verlies, zodat één worp waard is. De code rekent dezelfde waarden uit voor één tot vijf worpen, met en zonder kansweging.
ALPHA, LAMBDA, GAMMA_W, DELTA_W = 0.88, 2.25, 0.61, 0.69     # Tversky-Kahneman (1992)


def value(x, lam=LAMBDA):
    """Waardefunctie v(x) van prospect theory."""
    x = np.asarray(x, dtype=float)
    return np.where(x >= 0, np.abs(x) ** ALPHA, -lam * np.abs(x) ** ALPHA)


def weight(p, c):
    """Kansweging w(p) van Tversky en Kahneman (1992)."""
    p = np.clip(p, 0.0, 1.0)
    return p**c / (p**c + (1 - p) ** c) ** (1 / c)


def cpt_equal(x, weighting=True, is_sorted=False, lam=LAMBDA):
    """CPT-waarde van even waarschijnlijke uitkomsten; elke rij van x is één loterij."""
    x = np.atleast_2d(x)
    x = x if is_sorted else np.sort(x, axis=1)
    n = x.shape[1]
    k = np.arange(n)
    if weighting:
        w_loss = weight((k + 1) / n, DELTA_W) - weight(k / n, DELTA_W)            # rangorde van onderen
        w_gain = weight((n - k) / n, GAMMA_W) - weight((n - k - 1) / n, GAMMA_W)  # rangorde van boven
    else:
        w_loss = w_gain = np.full(n, 1 / n)
    return (np.where(x < 0, w_loss, w_gain) * value(x, lam)).sum(axis=1)


def repeated_bet(n_plays, win=150.0, lose=-100.0):
    """Alle 2**n even waarschijnlijke totaaluitkomsten van n onafhankelijke worpen."""
    return np.array([sum(s) for s in product([win, lose], repeat=n_plays)])


toy_pt = pd.DataFrame(
    {"zonder weging, code": [cpt_equal(repeated_bet(n), weighting=False).item() for n in range(1, 6)],
     "met weging, code": [cpt_equal(repeated_bet(n)).item() for n in range(1, 6)]},
    index=pd.Index(range(1, 6), name="aantal worpen samen beoordeeld"),
)
print(f"w+(1/2) = {weight(0.5, GAMMA_W):.4f}, w-(1/2) = {weight(0.5, DELTA_W):.4f}")
print("code == handberekening:",
      np.allclose(toy_pt.iloc[:2, 0], [-23.63, -6.11], atol=0.005),
      np.isclose(toy_pt.iloc[0, 1], -24.20, atol=0.005))
by_hand = pd.DataFrame({"zonder weging, met de hand": [-23.63, -6.11, np.nan, np.nan, np.nan],
                        "met weging, met de hand": [-24.20, np.nan, np.nan, np.nan, np.nan]},
                       index=toy_pt.index)
pd.concat([by_hand, toy_pt], axis=1).iloc[:, [0, 2, 1, 3]].round(2)
w+(1/2) = 0.4206, w-(1/2) = 0.4540
code == handberekening: True True
De handberekening en de code geven dezelfde getallen. Zonder weging is een bundel van vier worpen positief, en met weging pas een bundel van vijf. Rekent de belegger de twee worpen in één keer af, dan weegt hetzelfde risico dus bijna acht keer zo licht. Hoe vaak hij afrekent, bepaalt in de theorie de aandelenpremie.
4Theorie
De theorie bouwt het argument in drie stappen op. Eerst leiden we uit prospect theory af welke aandelenpremie een belegger eist die vaak kijkt. Daarna laten twee modellen zien waarom arbitrageurs een verkeerde prijs niet wegdrukken, het herverkooprisico van De Long, Shleifer, Summers en Waldmann (DSSW) en de fondsuitstroom van Shleifer en Vishny. Ten slotte bewijzen we dat risico en vergissing dezelfde prijzen en rendementen opleveren.
4.1Prospect theory
Waarom zou dit waar zijn? Een zintuig meet veranderingen en geen niveaus, en Kahneman en Tversky namen aan dat waardering net zo werkt. Een belegger die een kleine gok krijgt aangeboden, vergelijkt de uitkomsten met wat hij nu heeft. Hij voelt het mogelijke verlies scherper dan de even grote winst en weigert daarom.
Een prospect is een loterij met uitkomsten en kansen . Onder cumulative prospect theory (CPT) is de waarde
De waarde is dus een gewogen som waarin een verlies keer zwaarder telt dan een even grote winst. De beslisgewichten wegen niet de kansen zelf maar de cumulatieve kansen,
Een winst krijgt zo het gewicht van de kans op een minstens zo goede uitkomst min de kans op een betere. De weegfunctie overschat kleine kansen, en omdat ze op cumulatieve kansen werkt, schendt ze geen stochastische dominantie.
Tversky en Kahneman rapporteerden als medianen en , de waarden uit het toy-voorbeeld Tversky & Kahneman (1992). Voor vonden ze 0,61 bij winst en 0,69 bij verlies. Die noemen we en , om verwarring met de risicoaversie te voorkomen.
De risicoaversie bij de knik is van eerste orde. Een gok van plus of min kost een belegger met verwacht nut iets in de orde van , maar een verliesaverse belegger iets in de orde van . Daarom weigert die laatste de munt ook als de bedragen klein zijn.
4.2Myopic loss aversion en de aandelenpremie
Een verliesaverse belegger eist een premie die daalt naarmate hij minder vaak kijkt. Het verwachte rendement groeit lineair met de horizon en de standaarddeviatie met de wortel. Over een maand is de kans op verlies dus bijna een half, en over twintig jaar klein. Een belegger die elk jaar afrekent, ziet vaak een verlies en koopt pas aandelen als de premie hem daarvoor schadeloosstelt.
We nemen de eenvoudigste versie, met en zonder kansweging. Het risicovrije alternatief levert over jaar, en het aandelenrendement over die horizon is . Hier is de aandelenpremie per jaar, in de orde van 6%. De prospect-waarde is dan , met het verlies.
Het bewijs rekent het verwachte verlies van een normale verdeling uit. Voor kleine vervangen we en door hun waarden in nul.
Proof 1
Volgens (4) daalt de premie met de wortel van de evaluatieperiode, en daalt de evaluatieperiode met het kwadraat van de premie. Met , en geeft de benadering bij een jaar . De exacte oplossing geeft 6,14%.
Een belegger die vaker kijkt, eist dus een hogere premie, zoals de munt al deed vermoeden. Daarmee verdwijnt de puzzel van Mehra-Prescott en Hansen-Jagannathan, waar zo’n premie bij gewoon verwacht nut een risicoaversie van tientallen vroeg. Daar staat wel een nieuwe vrije parameter tegenover, de evaluatieperiode . De code lost (3) numeriek op en zet de benadering ernaast.
def bt_premium_exact(h, lam=LAMBDA, sigma=0.20, rf=0.01):
    """Los eq-behavioral-bt-exact op naar de premie mu_e bij horizon h (jaar)."""
    def gap(mu_e):
        m, s = (rf + mu_e) * h, sigma * np.sqrt(h)
        return mu_e * h - (lam - 1) * (s * stats.norm.pdf(m / s) - m * stats.norm.cdf(-m / s))
    return optimize.brentq(gap, -0.5, 1.0)


def bt_premium_approx(h, lam=LAMBDA, sigma=0.20, rf=0.01):
    """Benadering voor kleine z, eq-behavioral-bt."""
    return (lam - 1) / (lam + 1) * (sigma * np.sqrt(2 / (np.pi * h)) - rf)


horizons = [1 / 12, 0.5, 1, 2, 5, 10, 20]
pd.DataFrame({"premie exact": [bt_premium_exact(h) for h in horizons],
              "premie benadering": [bt_premium_approx(h) for h in horizons]},
index=pd.Index(horizons, name="evaluatieperiode (jaar)")).round(4)Beide kolommen dalen van ruim 20% bij een maand naar ongeveer 1% bij twintig jaar. Benartzi en Thaler Benartzi & Thaler (1995) rekenden met de volledige CPT op historische rendementen en vonden 6,5% bij één jaar en 1,4% bij twintig jaar, en de exacte kolom ligt bij beide horizonnen minder dan een half procentpunt onder die waarden.
4.3Noise trader risk: het model van De Long, Shleifer, Summers en Waldmann
Noise traders kunnen een prijs blijvend van zijn waarde wegduwen, omdat een arbitrageur die morgen verkoopt, verkoopt aan een generatie met een nieuw sentiment. Risicomijdende arbitrageurs nemen daarom een beperkte positie. De prijs blijft zo naast zijn waarde liggen, en de dragers van het risico krijgen er een premie voor.
Opzet. Generaties leven twee perioden. Het veilige activum levert een dividend en is in elastisch aanbod, zodat zijn prijs 1 is. Het onveilige activum levert hetzelfde dividend en is er in hoeveelheid 1, dus ook zijn fundamentele waarde is 1. Een fractie van elke generatie is noise trader, en de rest is sophisticated (rationeel, met juiste verwachtingen).
Jongeren kiezen hun positie in het onveilige activum om te maximaliseren, met . Noise traders () overschatten de prijs van morgen met , onafhankelijk over de tijd, en sophisticated beleggers () niet. In dit model is dus een positie en niet de verliesaversie van hierboven, en is het dividend, dat gelijk is aan de risicovrije rente, en geen rendement. Anders dan in de notatietabel is hier de coëfficiënt van absolute risicoaversie, 2,5 in het voorbeeld hieronder en 120 in de simulatie, en is het aandeel noise traders in elke generatie. De vraagfuncties volgen uit de eerste-ordevoorwaarde,
Een sophisticated belegger koopt dus meer naarmate de verwachte winst groter en het prijsrisico kleiner is. Een noise trader koopt daarbovenop een hoeveelheid die evenredig is met zijn optimisme .
Het bewijs vult de vraagfuncties in de evenwichtsvoorwaarde in. Een prijs die lineair is in het sentiment van vandaag lost die voorwaarde op.
Proof 2
Volgens (6) bestaat de prijs uit de waarde 1, het sentiment van vandaag, het gemiddelde optimisme en een korting voor herverkooprisico. Die korting blijft ook als noise traders gemiddeld gelijk hebben (). Het activum is dan goedkoper dan zijn waarde, alleen omdat morgen iemand anders handelt.
Een voorbeeld van één periode laat zien hoe dat uitpakt. Het activum keert nu geen dividend uit, en het veilige activum heeft rendement nul. Morgen verkoopt de belegger tegen 1,2 of 0,8, elk met kans een half, zodat de verwachte prijs 1 is en de variantie 0,04. Met koopt elke belegger zijn verwachte winst per stuk gedeeld door .
Een kwart van de beleggers is noise trader () en denkt dat de prijs morgen 0,2 hoger ligt. Vraag gelijk aan aanbod, , geeft , tegen 0,90 zonder noise traders. De code lost dat evenwicht op en zet per type de positie, de winst en de doelfunctie op een rij.
mu_n, rho_t, two_gamma = 0.25, 0.20, 2.5
p_next = np.array([1.2, 0.8])
e_next, var_next = p_next.mean(), p_next.var()


def excess_demand(p):
    """Totale vraag naar het risicovolle activum min het aanbod van 1."""
    lam_i = (e_next - p) / (two_gamma * var_next)
    lam_n = (e_next + rho_t - p) / (two_gamma * var_next)
    return (1 - mu_n) * lam_i + mu_n * lam_n - 1


p_t = optimize.brentq(excess_demand, 0.0, 2.0)
p_no_noise = e_next - two_gamma * var_next
lam = {"sophisticated": (e_next - p_t) / (two_gamma * var_next),
       "noise": (e_next + rho_t - p_t) / (two_gamma * var_next)}
toy_dssw = pd.DataFrame(
    {name: {"stuks": l, "winst als p=1.2": l * (1.2 - p_t), "winst als p=0.8": l * (0.8 - p_t),
            "verwachte winst": l * (e_next - p_t), "SD winst": l * np.sqrt(var_next),
            "E - gamma Var": l * (e_next - p_t) - two_gamma / 2 * l**2 * var_next}
     for name, l in lam.items()}
).T
print(f"p_t = {p_t:.4f}, zonder noise traders {p_no_noise:.4f}")
print("code == handberekening:", np.allclose([p_t, lam["sophisticated"], lam["noise"]], [0.95, 0.5, 2.5]))
toy_dssw.round(4)
p_t = 0.9500, zonder noise traders 0.9000
code == handberekening: True
Noise traders kopen 2,5 stuks en verdienen gemiddeld 0,125, vijf keer zoveel als sophisticated beleggers, omdat ze vijf keer zoveel risico dragen. Hun doelfunctie is echter tegen . Zoals verwacht verdienen ze dus meer en zijn ze toch slechter af, omdat de variantie van hun winst met het kwadraat van hun positie groeit.
Het bewijs vermenigvuldigt het verschil in posities met het verwachte overrendement uit de evenwichtsvoorwaarde. Daarna nemen we de onvoorwaardelijke verwachting.
Proof 3
De eerste term van (8) is het extra rendement omdat noise traders meer van het activum houden, en de tweede het verlies omdat ze duur kopen en goedkoop verkopen. Noise traders verdienen daarom alleen meer bij gematigd optimisme. Een hogere , door meer noise traders of meer risicoaversie, verbreedt dat venster, omdat sophisticated beleggers dan voorzichtiger tegenhandelen.
Meer verdienen is nog niet overleven, want een vermogen dat elke generatie wordt herbelegd, groeit met het meetkundige gemiddelde van de rendementen. Dat gemiddelde ligt lager naarmate de rendementen meer schommelen, en noise traders dragen juist meer risico. We laten elk type zo’n dynastie vormen, met bruto rendement per generatie. De prijs volgt (6) met vaste , zoals bij De Long et al. (1991), dus zonder terugkoppeling van vermogen naar prijs. Dat overleven en invloed op de prijs twee vragen zijn, lieten Kogan et al. (2006) zien.
We nemen per generatie (ongeveer 3,5% per jaar over twintig jaar), zoals in het voorbeeld, en . Dan is , zodat noise traders volgens Proposition 3 meer verdienen voor tussen 0,183 en 0,492. De code volgt vier waarden van over honderd generaties.
R_GEN, MU_NOISE, SIGMA_RHO, GAMMA_CARA = 1.0, 0.25, 0.30, 60.0
KAPPA = 2 * GAMMA_CARA * MU_NOISE * SIGMA_RHO**2 / (1 + R_GEN) ** 2
N_GEN, N_PATHS = 100, 2000


def dssw_price(rho, rho_star):
    """Stationaire DSSW-prijs, eq-behavioral-dssw-prijs."""
    return (1 + MU_NOISE * (rho - rho_star) / (1 + R_GEN) + MU_NOISE * rho_star / R_GEN
            - 2 * GAMMA_CARA * MU_NOISE**2 * SIGMA_RHO**2 / (R_GEN * (1 + R_GEN) ** 2))


def dssw_dynasties(rho_star):
    """Rendementsverschil, bruto rendementen en vermogensaandeel van noise traders over N_GEN generaties."""
    rho = rho_star + SIGMA_RHO * rng.standard_normal((N_GEN + 1, N_PATHS))
    p = dssw_price(rho, rho_star)
    gap = rho[:-1] / (2 * GAMMA_CARA * (MU_NOISE * SIGMA_RHO / (1 + R_GEN)) ** 2)   # lambda_n - lambda_i
    lam_i = 1 - MU_NOISE * gap
    excess = R_GEN + p[1:] - (1 + R_GEN) * p[:-1]
    g_i = 1 + R_GEN + lam_i * excess / p[:-1]
    g_n = 1 + R_GEN + (lam_i + gap) * excess / p[:-1]
    # Een bruto rendement <= 0 is faillissement; de kleine ondergrens maakt dat (vrijwel) absorberend.
    log_gap = np.log(np.maximum(g_n, 1e-300)) - np.log(np.maximum(g_i, 1e-300))
    share = special.expit(np.cumsum(log_gap, axis=0))                           # gelijk vermogen bij de start
    return {"dR": gap * excess, "log_gap": log_gap, "share": share, "min_price": p.min(),
            "bankrupt_n": (g_n <= 0).any(axis=0).mean(), "bankrupt_i": (g_i <= 0).any(axis=0).mean()}


rho_stars = [0.0, 0.10, KAPPA / 2, 0.60]
dyn = {rs: dssw_dynasties(rs) for rs in rho_stars}
pd.DataFrame(
    {f"rho* = {rs:.3f}": {
        "E[dR] theorie": rs - (rs**2 + SIGMA_RHO**2) / KAPPA,
        "gem. dR simulatie": d["dR"].mean(),
        "SE van gem. dR, 1 pad van 100 gen.": d["dR"].std() / np.sqrt(N_GEN),
        "mediaan verschil log-groei": np.median(d["log_gap"]),
        "P(aandeel > 1/2) na 5 gen.": (d["share"][4] > 0.5).mean(),
        "P(aandeel > 1/2) na 100 gen.": (d["share"][-1] > 0.5).mean(),
        "fractie paden: noise failliet": d["bankrupt_n"],
        "fractie paden: sophisticated failliet": d["bankrupt_i"],
        "laagste prijs": d["min_price"]}
     for rs, d in dyn.items()}
).round(4)Het gesimuleerde rendementsverschil ligt steeds binnen een honderdste van (8), en faillissementen treffen alleen noise traders. In de figuur valt de lijn van op, als enige die boven de helft uitkomt.
Source
fig, ax = plt.subplots()
gens = np.arange(1, N_GEN + 1)
for i, (rs, d) in enumerate(dyn.items()):
    ax.plot(gens, np.median(d["share"], axis=1), color=hap.plotting.COLORS[i], label=f"$\\rho^* = {rs:.2f}$")
    ax.fill_between(gens, *np.percentile(d["share"], [10, 90], axis=1), color=hap.plotting.COLORS[i], alpha=0.15)
ax.axhline(0.5, color="black", lw=0.8, ls="--")
ax.set_xlabel("Generatie")
ax.set_ylabel("Aandeel noise traders in het vermogen")
ax.set_title("Noise traders overleven alleen bij gematigd optimisme")
ax.legend()
plt.show()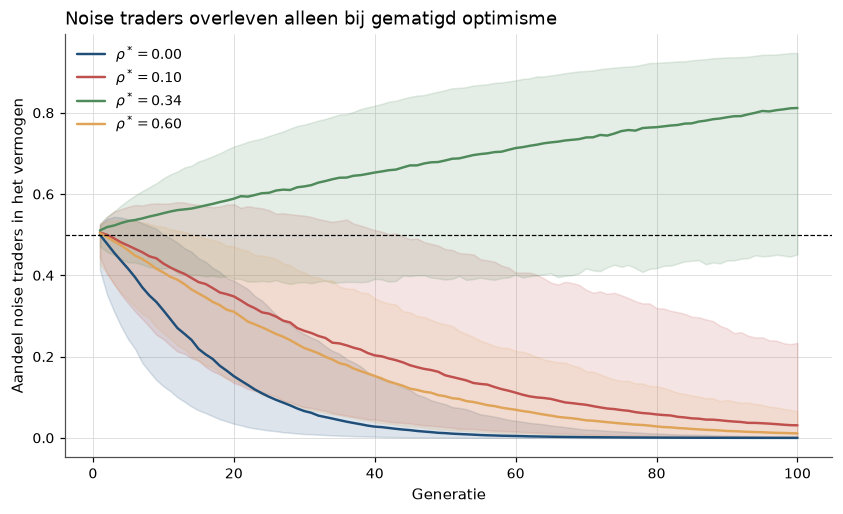
Figure 1:Mediaan en 10e tot 90e percentiel van het vermogensaandeel van een noise-trader-dynastie die met gelijk vermogen begint. Zonder optimisme en met te veel optimisme verdwijnen noise traders, terwijl ze bij in de meeste paden een meerderheid worden.
Na honderd generaties heeft bij 87% van de paden een noise-traderaandeel boven de helft. Na vijf generaties, ongeveer een eeuw, ligt dat aandeel in de vier werelden nog tussen 20% en 69%. Om te zien of irrationele beleggers worden weggeselecteerd, is dus meer geschiedenis nodig dan er bestaat.
4.4Performance-based arbitrage: het model van Shleifer en Vishny
Arbitrage is het zwakst wanneer een prijs het verst van zijn waarde ligt, omdat arbitrageurs met andermans geld werken. Shleifer en Vishny noemen dat performance-based arbitrage (arbitrage waarvan het budget afhangt van het recente rendement van de arbitrageur). Omdat inleggers niet zien of een verlies een fout was of een nog betere kans, trekken ze geld terug, zodat een arbitrageur die te laag kocht, moet verkopen als de prijs nog verder daalt.
Opzet. Er zijn drie data, en het activum is op zeker waard. Noise traders drukken de prijs op met . Op wordt de schok met kans groter, , en anders verdwijnt hij. Arbitrageurs beheren fondsen en beleggen daarvan , zodat . Hun fondsen op reageren op het rendement,
Na een verlies krimpt het fonds dus met keer het verlies op de positie. Shleifer & Vishny (1997) laten die reactie concaaf zijn, en wij nemen die lineair. In de slechte toestand beleggen de arbitrageurs alles, zodat . Ze nemen prijzen als gegeven en maximaliseren het verwachte fondsvermogen op .
Het bewijs vult de fondsregel in de prijs van de slechte toestand in. De voorwaarde voor is de afgeleide van het verwachte eindvermogen, dat bij gegeven prijzen lineair is in .
Proof 4
Vul (9) in in, wat geeft, en los op naar . De afgeleide naar volgt direct. Het fondsvermogen op is in de goede toestand , omdat de prijs dan is, en in de slechte toestand . De afgeleide van het verwachte vermogen naar , bij gegeven prijzen, is maal het linkerlid van (11). Omdat het doel bij gegeven prijzen lineair is in , is in evenwicht ofwel die afgeleide nul ofwel .
(10) is LTCM in het klein. Een arbitrageur die zijn fonds volledig inzet, verdiept de volgende daling via de uitstroom van zijn eigen inleggers. Omdat hij dat voorziet, belegt hij minder, zodat verder van blijft. De code lost het evenwicht op voor drie waarden van en twee van , met , , en .
def sv_equilibrium(a, q, V=1.0, S1=0.2, S=0.5, F1=0.2):
    """Shleifer-Vishny (1997): evenwichtsbelegging op t=1, prijzen en versterking."""
    def prices(D1):
        p1 = V - S1 + D1
        return p1, (V - S + F1 - a * D1) / (1 - a * D1 / p1)

    def foc(D1):
        p1, p2 = prices(D1)
        return (1 - q) * (V / p1 - 1) + q * V / p2 * (p2 / p1 - 1)

    D1 = F1 if foc(F1) >= 0 else optimize.brentq(foc, 0.0, F1)
    p1, p2 = prices(D1)
    F2 = F1 + a * D1 * (p2 / p1 - 1)
    return {"D1/F1": D1 / F1, "p1": p1, "p2 (slecht)": p2, "F2/F1 (slecht)": F2 / F1,
            "versterking dp2/dS": 1 / (1 - a * D1 / p1)}


sv_grid = {(a, q): sv_equilibrium(a, q) for a, q in product([1.0, 1.5, 2.0], [0.2, 0.4])}
sv_table = pd.DataFrame(sv_grid).T.rename_axis(["a", "q"])
sv_table.round(3)Arbitrageurs beleggen bij ongeveer de helft van hun fondsen en bij een kwart. Als inleggers gevoeliger zijn, beleggen arbitrageurs minder, ligt de prijs in de slechte toestand lager en is de versterking groter. Bij stijgt die van 1,14 naar 1,29 als van 1 naar 2 gaat. Een extra schok duwt de prijs dus harder omlaag naarmate inleggers sneller vluchten, de versterking die we aan het begin vermoedden, en anomalieën overleven het langst in volatiele markten met trage convergentie Shleifer & Vishny (1997).
4.5Onder- en overreactie: drie modellen
DSSW en Shleifer en Vishny verklaren dat vergissingen prijzen verschuiven, maar niet in welke richting. Drie modellen leidden momentum (Jegadeesh-Titman, Carhart en momentum crashes) en de omkering op lange termijn af uit psychologie.
In Barberis et al. (1998) gelooft een belegger ten onrechte dat winstgroei wisselt tussen terugvallen en trends, zodat hij te zwak reageert op één verrassing en te sterk op een reeks.
In Daniel et al. (1998) zijn geïnformeerde beleggers overmoedig en schrijven ze goed nieuws toe aan hun eigen kunde, zodat de koers doorschiet en later terugkeert.
In Hong & Stein (1999) verspreidt nieuws zich langzaam, en beleggers die alleen naar de koers kijken, duwen hem voorbij de waarde.
Alle drie voorspellen voortzetting op middellange en omkering op lange termijn, met een of twee vrije parameters voor twee feiten. Dat maakt ze plausibel en tegelijk moeilijk te verwerpen.
4.6De joint hypothesis: waarom risico en vergissing hetzelfde patroon geven
Elke toets van efficiëntie is tegelijk een toets van een model voor het verwachte rendement Fama (1970). Als een prijs laag is en het rendement daarna hoog, zegt de gedragseconoom dat de prijs te laag was, en de rationele econoom dat het verwachte rendement hoog was. Dat zijn echter twee beschrijvingen van hetzelfde getal.
We werken dat uit in de log-lineaire notatie van Voorspelbaarheid van rendementen. Vanaf hier zijn kleine letters logs, zodat het log rendement is en de log dividend-prijsratio. Dividendgroei is i.i.d., en , een getal iets onder 1, is de linearisatieconstante van Campbell en Shiller. We schrijven om verwarring met het sentiment te voorkomen.
Het bewijs laat zien dat in beide economieën dezelfde lineaire functie is van dezelfde toestand. Via de Campbell-Shiller-identiteit vallen dan ook de rendementen samen.
Proof 5
In R geeft de Campbell-Shiller-identiteit . In M is constant, dus , en geeft . Met is in beide economieën dezelfde lineaire functie van dezelfde AR(1)-toestand, en zijn de rendementen via de identiteit dezelfde functie van en .
Volgens (12) voorspelt een hoge dividend-prijsratio in beide economieën een hoog rendement, met dezelfde coëfficiënt. Met de jaarschattingen van Cochrane, en , is die coëfficiënt Cochrane (2008), dezelfde waarde als in Voorspelbaarheid van rendementen. Prijzen, dividenden en rendementen scheiden de twee dus nooit, zodat een hoog rendement na een lage prijs er bij risico en bij vergissing hetzelfde uitziet, en het vermoeden van het begin houdt stand. Alleen een reeks van buiten kan het, zoals marginaal nut (de stochastische discontofactor uit Lucas, Breeden en de SDF) of gemeten fouten in verwachtingen.
5Simulatie: hoe goed is de evaluatieperiode te meten?
Volgens (4) daalt met het kwadraat van de premie, en die premie is slecht gemeten. Bij een volatiliteit van 20% heeft een gemiddeld rendement over een eeuw een standaardfout van ongeveer twee procentpunt, de standaardfout van 2%. Hoe ver kan een geschatte daardoor afwijken?
We laten maandelijkse log-rendementen van aandelen en obligaties normaal verdeeld zijn, met het gemiddelde en de volatiliteit van de S&P 500 en de langlopende staatsobligaties in de Goyal-Welch-data over 1926–1990, dezelfde reeksen als in de replicatie. De CPT-waarde rekenen we uit op 400 kwantielen, voor horizonnen tot 60 maanden, en we zoeken de horizon waarop aandelen obligaties inhalen. De eerste cel doet dat als functie van de ware premie.
N_GRID, H_MAX = 400, 60
Z_GRID = stats.norm.ppf((np.arange(N_GRID) + 0.5) / N_GRID)
H_MONTHS = np.arange(1, H_MAX + 1)
MOMENTS_1926_1990 = {"m_s": 0.0935 / 12, "s_s": 0.2032 / np.sqrt(12), "m_b": 0.0448 / 12, "s_b": 0.0753 / np.sqrt(12)}


def cpt_lognormal(m, s):
    """CPT-waarde (rijen: parametersets, kolommen: horizonnen) van exp(m h + s sqrt(h) z) - 1."""
    m, s = np.broadcast_arrays(np.atleast_1d(m), np.atleast_1d(s))
    out = []
    for i in range(0, len(m), 50):  # blokken van 50 parametersets houden het geheugengebruik klein
        mi, si = m[i:i + 50, None, None], s[i:i + 50, None, None]
        # x heeft de vorm (parametersets, horizonnen, kwantielen): het rendement over h maanden per kwantiel
        x = np.expm1(mi * H_MONTHS[None, :, None] + si * np.sqrt(H_MONTHS)[None, :, None] * Z_GRID)
        out.append(cpt_equal(x.reshape(-1, N_GRID), is_sorted=True).reshape(x.shape[0], H_MAX))
    return np.concatenate(out)


def crossing_horizon(v_stock, v_bond):
    """Eerste horizon (maanden, lineair geïnterpoleerd) waarop de CPT-waarde van aandelen die van obligaties haalt."""
    diff = v_stock - v_bond
    out = np.full(diff.shape[0], np.nan)
    for row, d in enumerate(diff):
        idx = np.flatnonzero((d[:-1] < 0) & (d[1:] >= 0))
        if len(idx):
            k = idx[0]
            out[row] = H_MONTHS[k] + d[k] / (d[k] - d[k + 1])
    return out


premia = np.linspace(0.02, 0.10, 17)                         # jaarlijkse log-premie van aandelen boven obligaties
mom = MOMENTS_1926_1990
v_bond = cpt_lognormal(mom["m_b"], mom["s_b"])
v_stock = cpt_lognormal(mom["m_b"] + premia / 12, np.full_like(premia, mom["s_s"]))
h_star_premium = crossing_horizon(v_stock, np.repeat(v_bond, len(premia), axis=0))
print(f"premie 1926-1990: {12 * (mom['m_s'] - mom['m_b']):.2%}, h* = "
      f"{np.interp(12 * (mom['m_s'] - mom['m_b']), premia, h_star_premium):.1f} maanden")
premie 1926-1990: 4.87%, h* = 6.8 maanden
Bij de premie van 1926–1990, in logs 4,87% per jaar, is maanden. Rekenkundig geven dezelfde reeksen in de replicatie 6,7%, iets meer dan in het rekenvoorbeeld van de theorie, en toch is hier korter dan het jaar dat daar uitkwam. Dat komt door twee verschillen met de theorie. Aandelen moeten hier obligaties inhalen die zelf ook verliezen kennen, en geen risicovrije belegging, en de belegger rekent met de volledige CPT, met kansweging en een gebogen waardefunctie.
Om te zien hoe goed te meten is, trekken we 1000 steekproeven van 65 jaar en schatten we in elke steekproef de momenten opnieuw.
N_SAMPLES, N_MONTHS = 1000, 65 * 12
draw_s = mom["m_s"] + mom["s_s"] * rng.standard_normal((N_SAMPLES, N_MONTHS))
draw_b = mom["m_b"] + mom["s_b"] * rng.standard_normal((N_SAMPLES, N_MONTHS))
h_star_samples = crossing_horizon(cpt_lognormal(draw_s.mean(axis=1), draw_s.std(axis=1, ddof=1)),
                                  cpt_lognormal(draw_b.mean(axis=1), draw_b.std(axis=1, ddof=1)))
premium_hat = 12 * (draw_s.mean(axis=1) - draw_b.mean(axis=1))
pd.Series({"SD geschatte premie (%-punt)": 100 * premium_hat.std(),
           "h* mediaan (maanden)": np.nanmedian(h_star_samples),
           "h* 10e percentiel": np.nanpercentile(h_star_samples, 10),
           "h* 90e percentiel": np.nanpercentile(h_star_samples, 90),
           "fractie zonder kruising binnen 60 maanden": np.isnan(h_star_samples).mean()}).round(3)
SD geschatte premie (%-punt) 2.746
h* mediaan (maanden) 6.843
h* 10e percentiel 3.070
h* 90e percentiel 20.010
fractie zonder kruising binnen 60 maanden 0.018
dtype: float64De geschatte premie heeft een standaarddeviatie van 2,7 procentpunt. De mediaan van de geschatte blijft 6,8 maanden, maar het 10e en 90e percentiel liggen op 3,1 en 20 maanden. Links in de figuur is te zien hoe steil de lijn door de grijze band loopt, en rechts hoe breed de verdeling rond de stippellijn van één jaar is.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
axes[0].plot(100 * premia, h_star_premium, color=hap.plotting.COLORS[0])
true_premium = 12 * (mom["m_s"] - mom["m_b"])
axes[0].axvspan(100 * (true_premium - 2 * premium_hat.std()), 100 * (true_premium + 2 * premium_hat.std()),
                color=hap.plotting.COLORS[7], alpha=0.25, label="$\\pm 2$ SE rond de premie van 1926-1990")
axes[0].axhline(12, color="black", lw=0.8, ls="--")
axes[0].set_xlabel("Ware premie aandelen boven obligaties (%/jaar, log)")
axes[0].set_ylabel("Evaluatieperiode $h^*$ (maanden)")
axes[0].set_title("(a) $h^*$ als functie van de premie")
axes[0].legend()
axes[1].hist(h_star_samples[~np.isnan(h_star_samples)], bins=np.arange(0, 61, 2), color=hap.plotting.COLORS[0], alpha=0.7)
axes[1].axvline(12, color="black", lw=0.8, ls="--")
axes[1].set_xlabel("Geschatte $h^*$ (maanden)")
axes[1].set_ylabel("Aantal steekproeven van 65 jaar")
axes[1].set_title("(b) $h^*$ over steekproeven")
fig.tight_layout()
plt.show()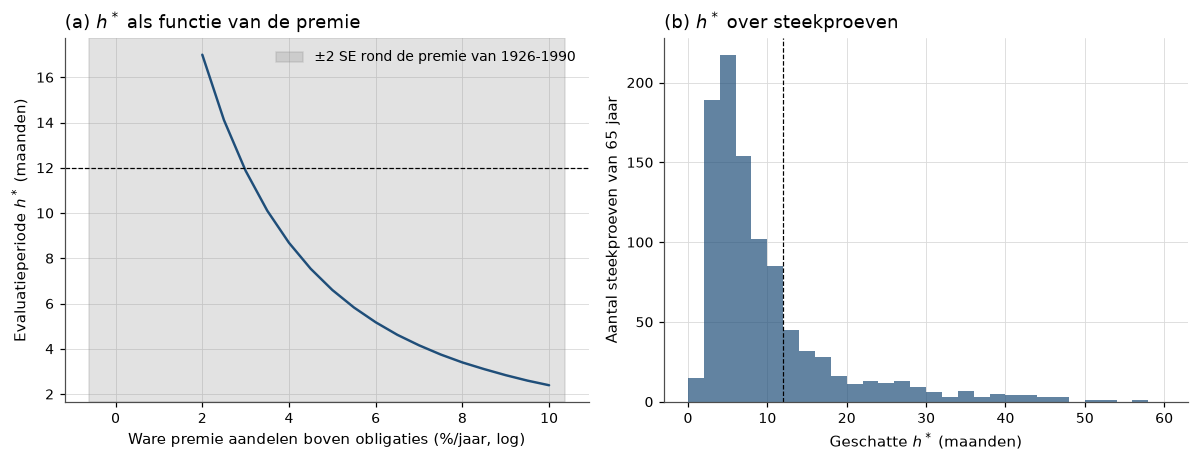
Figure 2:Links daalt de evaluatieperiode steil met de premie, en de grijze band van twee standaardfouten rond de premie van 1926–1990 beslaat het hele getoonde bereik. Rechts staat dezelfde onzekerheid als verdeling van de schatter over 1000 steekproeven van 65 jaar.
Een belegger die ongeveer eens per jaar kijkt, past dus bij de data, maar een kwartaal of anderhalf jaar past evengoed. In 1,8% van de steekproeven halen aandelen obligaties binnen vijf jaar zelfs helemaal niet in.
6Replicatie op echte data
6.1De Bondt-Thaler: lange-termijnomkering
We laden de factor, de decielen en de zes portefeuilles waaruit French de factor bouwt, en controleren dat de factor uit die zes volgt.
ff3 = hap_data.french("F-F_Research_Data_Factors")
lt_rev = hap_data.french("F-F_LT_Reversal_Factor")["LT_Rev"]
dec_vw = hap_data.french("10_Portfolios_Prior_60_13")
dec_ew = hap_data.french("10_Portfolios_Prior_60_13", table="Equal Weight")
six = hap_data.french("6_Portfolios_ME_Prior_60_13")

rev_from_six = 0.5 * (six["SMALL LoPRIOR"] + six["BIG LoPRIOR"]) - 0.5 * (six["SMALL HiPRIOR"] + six["BIG HiPRIOR"])
print(f"max |LT_Rev uit zes portefeuilles - LT_Rev| = {(rev_from_six - lt_rev).abs().max():.5f}")
reversal = {"LT_Rev (French)": lt_rev,
            "deciel 1-10 gelijkgewogen": dec_ew["Lo PRIOR"] - dec_ew["Hi PRIOR"],
            "deciel 1-10 waardegewogen": dec_vw["Lo PRIOR"] - dec_vw["Hi PRIOR"]}
max |LT_Rev uit zes portefeuilles - LT_Rev| = 0.00010
Het grootste verschil is 0,0001, dus de factor volgt tot op afronding uit de zes portefeuilles. De volgende cel schat per periode het gemiddelde en de CAPM- en FF3-alpha, met Newey-West--waarden die autocorrelatie in de residuen toelaten.
def alpha_row(y, start, end, lags=6):
    """Gemiddelde, CAPM- en FF3-alpha (% per maand) met Newey-West-t-waarden over [start, end]."""
    frame = pd.concat([y.rename("y"), ff3], axis=1, sort=True).loc[start:end].dropna()
    fits = {name: hap.stats.newey_west(frame["y"], frame[cols], lags=lags)
            for name, cols in {"gem.": [], "CAPM": ["Mkt-RF"], "FF3": ["Mkt-RF", "SMB", "HML"]}.items()}
    return {"gem. (%/mnd)": 100 * fits["gem."].params.iloc[0], "t": fits["gem."].tvalues.iloc[0],
            "CAPM-alpha": 100 * fits["CAPM"].params.iloc[0], "t(CAPM)": fits["CAPM"].tvalues.iloc[0],
            "FF3-alpha": 100 * fits["FF3"].params.iloc[0], "t(FF3)": fits["FF3"].tvalues.iloc[0],
            "bèta HML": fits["FF3"].params["HML"], "bèta SMB": fits["FF3"].params["SMB"], "maanden": len(frame)}


periods = {"1933-1980 (DBT)": ("1933-01", "1980-12"), "1963:07-1980": ("1963-07", "1980-12"),
           "1981-2026": ("1981-01", "2026-12"), "1933-2026": ("1933-01", "2026-12")}
pd.DataFrame({(p, name): alpha_row(y, a, b) for p, (a, b) in periods.items() for name, y in reversal.items()}).T.round(3)Over 1933–1980 verdient het gelijkgewogen decielverschil ruim drie keer zoveel als de factor, en de factor haalt maar . Bij die -waarde hoort een standaardfout van ongeveer 2,3 procentpunt per jaar, zodat ook deze bekende anomalie maar net boven de ruis uitkomt.
Verliezers hebben een hogere marktbèta, zodat de CAPM-alpha’s kleiner zijn dan de gemiddelden, en het driefactormodel neemt de rest over. De FF3-alpha van de factor is bij een HML-lading van 0,78. Om met het origineel te vergelijken, stellen we de maandrendementen samen over dezelfde zestien driejaarsperioden.
months = pd.period_range("1933-01", "1980-12", freq="M")
window = np.asarray((months.year - 1933) // 3)                  # driejaarsperiode 0 t/m 15 per maand


def compound(x):
    """Samengesteld rendement over een periode."""
    return (1 + x).prod() - 1


three_year = pd.DataFrame({name: y.loc["1933-01":"1980-12"].groupby(window).apply(compound)
                           for name, y in reversal.items()})
dbt_table = pd.DataFrame({"gem. 36-maandsrendement (%)": 100 * three_year.mean(),
                          "t over 16 perioden": three_year.mean() / (three_year.std() / np.sqrt(len(three_year))),
                          "fractie perioden > 0": (three_year > 0).mean()}).T
dbt_table.insert(0, "origineel (35 verliezers min 35 winnaars)", [24.6, 2.20, np.nan])
dbt_table.round(3)Geslaagd. We oordelen op het gelijkgewogen decielverschil, omdat De Bondt en Thaler hun portefeuilles ook gelijk wogen. Het levert over de zestien perioden gemiddeld 81% op met , toevallig hun -waarde, en alle tekens zijn zoals verwacht, ook dat de waardegewogen factor minder haalt. De omvang is niet vergelijkbaar, omdat het om een samengesteld rendement van decielen gaat en niet om een marktgecorrigeerd residu van extreme aandelen.
De figuur zet de factor zelf (blauw) naast de factor na aftrek van zijn blootstelling aan markt, SMB en HML (rood).
Source
frame = pd.concat([lt_rev.rename("y"), ff3], axis=1, sort=True).dropna()
fit = hap.stats.newey_west(frame["y"], frame[["Mkt-RF", "SMB", "HML"]])
hedged = frame["y"] - frame[["Mkt-RF", "SMB", "HML"]] @ fit.params[["Mkt-RF", "SMB", "HML"]]
fig, ax = plt.subplots()
ax.plot(frame.index, 100 * frame["y"].cumsum(), color=hap.plotting.COLORS[0], label="LT_Rev")
ax.plot(frame.index, 100 * hedged.cumsum(), color=hap.plotting.COLORS[1], label="LT_Rev min FF3-blootstelling")
ax.axvspan(pd.Timestamp("1933-01-01"), pd.Timestamp("1980-12-31"), color=hap.plotting.COLORS[7], alpha=0.15,
           label="steekproef De Bondt-Thaler")
hap.plotting.timeline_axis(ax)
ax.set_xlabel("Jaar")
ax.set_ylabel("Cumulatief rendement (%, opgeteld)")
ax.set_title("Lange-termijnomkering, en wat er na FF3 van overblijft")
ax.legend()
plt.show()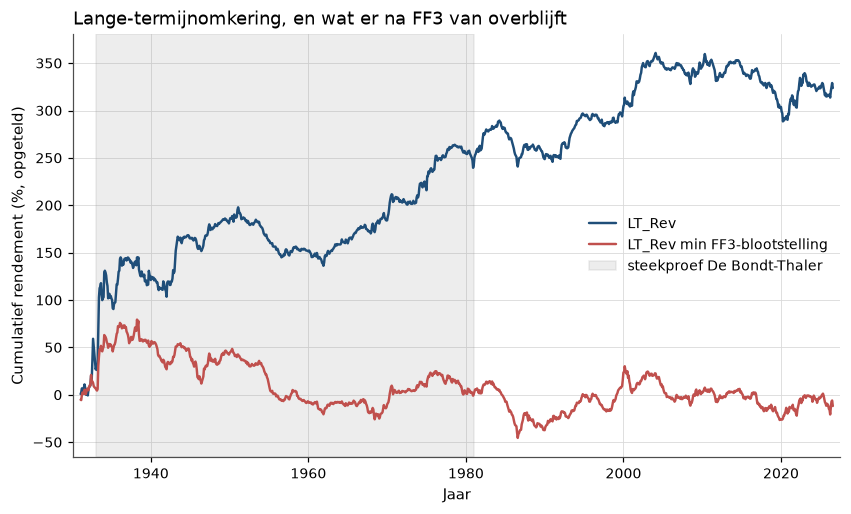
Figure 3:De lange-termijnomkering (blauw) levert tot 1980 gestaag op en daarna nauwelijks. Zonder de blootstelling aan markt, SMB en HML (rood) blijft er over de hele eeuw niets over, zodat wat De Bondt en Thaler als overreactie lazen, statistisch grotendeels de waardepremie is.
Na 1980 levert de factor nog 0,15% per maand op (), en omdat de rode lijn over de hele eeuw vlak is, neemt HML de omkering ook buiten de steekproef van De Bondt en Thaler over.
6.2Benartzi-Thaler: de evaluatieperiode op historische rendementen
De code trekt voor elke horizon dezelfde 20 000 reeksen maanden, stelt ze samen en zoekt de kruising, nominaal en reëel, en met de premie twee standaardfouten lager of hoger. De getrokken getallen zijn groot en worden modulo het aantal maanden van de periode genomen, zodat een korte en een lange periode hetzelfde toeval gebruiken en de kolommen alleen door de data verschillen.
gw = hap_data.goyal_welch("monthly")
N_BOOT = 20_000


boot_idx = rng.integers(0, 10**9, size=(N_BOOT, H_MAX))       # modulo len(data) dezelfde trekkingen voor elke periode


def bootstrap_h_star(start, end, real=False, shift=0.0, lam=LAMBDA):
    """h* zoals bij BT: trek maanden, stel samen tot h maanden, vergelijk de CPT-waarden van aandelen en obligaties."""
    data = gw.loc[start:end, ["CRSP_SPvw", "ltr", "infl"]].dropna()
    deflate = (1 + data["infl"]) if real else 1.0
    stock = ((1 + data["CRSP_SPvw"] + shift / 12) / deflate).to_numpy()
    bond = ((1 + data["ltr"]) / deflate).to_numpy()
    idx = boot_idx % len(data)
    v_s = cpt_equal((np.cumprod(stock[idx], axis=1) - 1).T, lam=lam)       # rijen = horizonnen
    v_b = cpt_equal((np.cumprod(bond[idx], axis=1) - 1).T, lam=lam)
    return v_s, v_b, crossing_horizon(v_s[None], v_b[None]).item()


v_s_bt, v_b_bt, h_bt = bootstrap_h_star("1926-01", "1990-12")
diff = gw.loc["1926":"1990", "CRSP_SPvw"] - gw.loc["1926":"1990", "ltr"]
se_premium = np.sqrt(12) * diff.std() / np.sqrt(len(diff) / 12)
rows = {}
for label, (a, b) in {"1926-1990": ("1926-01", "1990-12"), "1926-2025": ("1926-01", "2025-12")}.items():
    for real in (False, True):
        rows[(label, "reëel" if real else "nominaal")] = {
            "h* origineel (maanden)": "9-13" if label == "1926-1990" else "-",
            "premie (%/jaar)": 1200 * (gw.loc[a:b, "CRSP_SPvw"] - gw.loc[a:b, "ltr"]).mean(),
            "h* (maanden)": bootstrap_h_star(a, b, real)[2],
            "h*, premie - 2 SE": bootstrap_h_star(a, b, real, shift=-2 * se_premium)[2],
            "h*, premie + 2 SE": bootstrap_h_star(a, b, real, shift=+2 * se_premium)[2],
            "h*, lambda = 2.5": bootstrap_h_star(a, b, real, lam=2.5)[2]}
print(f"SE van de premie 1926-1990: {se_premium:.2%} per jaar")
pd.DataFrame(rows).T.infer_objects().round(2)
SE van de premie 1926-1990: 2.55% per jaar
Gedeeltelijk geslaagd. Over 1926–1990 halen nominale aandelen de obligaties na 7,5 maanden in en reële na 5,7, iets eerder dan bij Benartzi en Thaler, zoals de volatielere obligatiereeks doet verwachten. Daarmee ligt de reële waarde net onder de verwachte ondergrens van een half jaar, en pas een iets hogere verliesaversie (, laatste kolom) tilt die waarde boven die grens.
De premie heeft een standaardfout van 2,55 procentpunt per jaar, en twee standaardfouten lager of hoger geeft een nominale evaluatieperiode van 41 of 2,5 maanden. Een schatting van is dus vooral een schatting van de premie. De figuur laat voor nominale rendementen zien waar de twee CPT-waarden elkaar kruisen.
Source
fig, ax = plt.subplots()
ax.plot(H_MONTHS, v_s_bt, color=hap.plotting.COLORS[0], label="aandelen (CRSP S&P 500)")
ax.plot(H_MONTHS, v_b_bt, color=hap.plotting.COLORS[1], label="langlopende staatsobligaties")
ax.axvline(h_bt, color="black", lw=0.8, ls="--")
ax.axhline(0, color="black", lw=0.6)
ax.set_xlabel("Evaluatieperiode (maanden)")
ax.set_ylabel("CPT-waarde van een belegging van 1 dollar")
ax.set_title("Myopic loss aversion op nominale rendementen, 1926-1990")
ax.legend()
plt.show()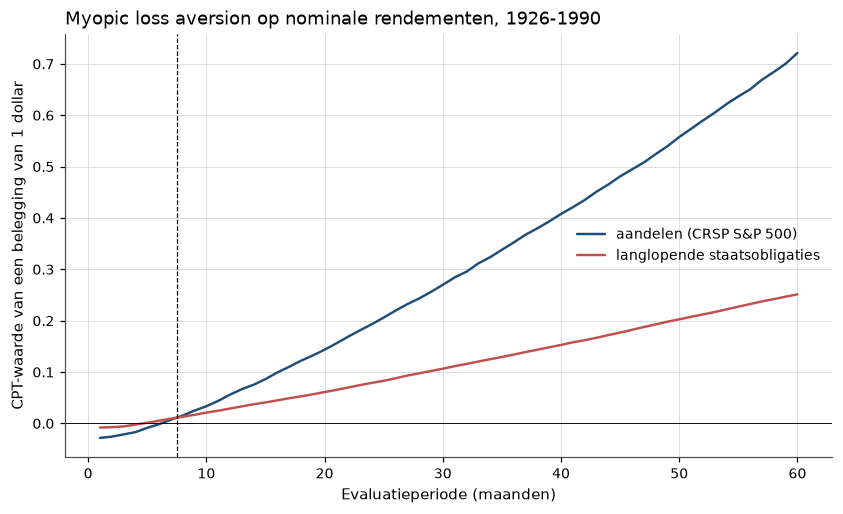
Figure 4:Bij korte evaluatieperioden zijn aandelen minder waard dan obligaties, omdat verliezen vaak voorkomen en 2,25 keer tellen. Bij langere perioden halen aandelen obligaties in, en de stippellijn markeert de periode waarbij de belegger onverschillig is.
De rekeninggegevens achter het handelsgedrag van particulieren zijn niet gratis, dus die bevindingen repliceren we niet. De tabel vat de gepubliceerde getallen samen.
| studie | steekproef | bevinding |
|---|---|---|
| Odean (1998) | 10 000 rekeningen, 1987–1993 | 14,8% van de papieren winsten gerealiseerd (PGR), tegen 9,8% van de papieren verliezen (PLR) |
| Barber & Odean (2000) | 66 465 huishoudens, 1991–1996 | actiefste handelaren 11,4% per jaar, de markt 17,9% |
| Barber & Odean (2001) | ruim 35 000 huishoudens, februari 1991 tot januari 1997 | mannen handelen 45% meer dan vrouwen en verliezen daardoor 2,65 procentpunt per jaar, vrouwen 1,72 |
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Het gedragsonderzoek gaf de feiten uit de vorige colleges een mechanisme. Traag sentiment verklaart de te grote beweeglijkheid van koersen, drie modellen verklaren momentum en omkering, en myopic loss aversion verklaart de aandelenpremie. Limits of arbitrage verklaren waarom Royal Dutch en Shell zo lang naast hun waarde lagen. Bovendien verdwijnen irrationele beleggers niet vanzelf, en is arbitrage het zwakst wanneer ze het meest nodig is, zoals LTCM in 1998 liet zien (VaR, RiskMetrics en LTCM).
Waar het breekt. Het gedragsonderzoek loopt vast bij de toets. Onze replicatie vindt de omkering van De Bondt en Thaler terug, maar het driefactormodel slokt die grotendeels op, en na 1980 is de omkering zwak. De laatste oefening laat bovendien zien dat de factor vrijwel alleen in januari verdient. Schuift de premie twee standaardfouten op, dan loopt de evaluatieperiode van Benartzi en Thaler uiteen van 2,5 tot 41 maanden. Een gedragsmodel met een vrije parameter per feit verklaart dus veel en verbiedt weinig.
Risico of vergissing? In de Chicago-lezing zijn de verliezers van vijf jaar bedrijven in financiële nood, is de omkering de waardepremie, en betaalt HML voor een risico dat in slechte tijden uitkomt Fama & French (1996). De aandelenpremie vraagt dan een beter model van marginaal nut, het onderwerp van Habit, long-run risk en rampen. In de Yale-lezing is de waardepremie juist de overreactie, omdat beleggers groei extrapoleren Lakonishok et al. (1994). Proposition 5 laat zien waarom prijzen en rendementen dit niet beslissen. Voor een belegger in verliezers blijft de vraag van Santa-Clara: draagt hij risico waarvoor een premie wordt betaald, of denkt hij de vergissing van anderen te zien Santa-Clara (2026)?
Wat er daarna kwam. Noise traders bleven, maar als bouwsteen. In het model van Kyle maken zij geïnformeerde handel mogelijk, en de vraag verschuift naar hoe informatie via orders in prijzen terechtkomt, zie Kyle, Glosten-Milgrom en liquiditeit.
8Oefeningen
Solution to Exercise 1
(1) Eén worp is waard. Twee worpen samen zijn waard.
(2) Neutraal betekent , dus .
print(f"neutrale lambda: {float(value(150.0) / -value(-100.0, lam=1.0)):.3f}")
pd.DataFrame({"lambda = 1.5": [cpt_equal(repeated_bet(n), weighting=False, lam=1.5).item() for n in (1, 2)],
              "lambda = 2.25": [cpt_equal(repeated_bet(n), weighting=False).item() for n in (1, 2)]},
             index=pd.Index([1, 2], name="aantal worpen samen")).round(2)
neutrale lambda: 1.429
Met minder verliesaversie weigert de belegger één worp nog net, maar neemt hij twee worpen samen al aan. Hoe dicht bij het neutrale punt ligt, bepaalt hoeveel worpen nodig zijn. In het klein verklaart dat waarom de evaluatieperiode zo gevoelig is voor de premie.
Solution to Exercise 2
(1) De wortels van met en zijn 0,183 en 0,492. Het maximum in is .
(2) Er is een interval als , dus als . Weinig noise traders veroorzaken weinig herverkooprisico (), zodat sophisticated beleggers bijna al het risico overnemen. Voor de noise traders blijft dan vooral het duur kopen en goedkoop verkopen over.
disc = np.sqrt(KAPPA**2 - 4 * SIGMA_RHO**2)
print(f"interval: ({(KAPPA - disc) / 2:.3f}, {(KAPPA + disc) / 2:.3f}), "
      f"max E[dR] = {KAPPA / 2 - (KAPPA**2 / 4 + SIGMA_RHO**2) / KAPPA:.4f}")
print(f"minimale mu: {(1 + R_GEN) ** 2 / (GAMMA_CARA * SIGMA_RHO):.3f}")
pd.Series({rs: dssw_dynasties(rs)["dR"].mean() for rs in [0.15, 0.20, 0.45, 0.55]},
          name="gem. dR (simulatie)").round(4)
interval: (0.183, 0.492), max E[dR] = 0.0354
minimale mu: 0.222
0.15   -0.0163
0.20    0.0085
0.45    0.0175
0.55   -0.0323
Name: gem. dR (simulatie), dtype: float64
Binnen het interval is het gesimuleerde verschil positief en erbuiten negatief. Dat noise traders meer verdienen, geldt dus alleen bij genoeg noise traders en gematigd optimisme.
Solution to Exercise 3
(1) Met is , zolang . Dat volgt door (4) op te lossen naar .
(2) Met is , dus . Een premie die 10% hoger is, geeft een evaluatieperiode die ongeveer 20% korter is.
sigma, rf = 0.20, 0.01
for h in (1, 5):
    c = sigma * np.sqrt(2 / (np.pi * h)) - rf
    print(f"h = {h}: lambda = {(c + 0.06) / (c - 0.06):.2f}" if c > 0.06 else f"h = {h}: geen lambda (c = {c:.4f} <= 0.06)")
h_of = lambda mu_e, lam=LAMBDA: 2 * sigma**2 / np.pi / (rf + mu_e * (lam + 1) / (lam - 1)) ** 2
print("h* (maanden) bij premie 4%, 6%, 8%:", np.round([12 * h_of(m) for m in (0.04, 0.06, 0.08)], 1))
h = 1: lambda = 2.34
h = 5: lambda = 88.91
h* (maanden) bij premie 4%, 6%, 8%: [23.5 11.1 6.4]
Bij een jaar volstaat , terwijl bij vijf jaar nodig is.
(3) Volgens (2) is , dus een twee keer zo hoge premie geeft een vier keer zo korte evaluatieperiode. Bij geeft de benadering 23,5, 11,1 en 6,4 maanden bij een premie van 4%, 6% en 8%, een factor 3,7, iets minder omdat . De theorie is zo flexibel omdat het gemiddelde rendement slecht gemeten is.
Solution to Exercise 4
rows = {}
for p, (a, b) in {"1933-1980": ("1933-01", "1980-12"), "1981-2026": ("1981-01", "2026-12")}.items():
    for name in ("LT_Rev (French)", "deciel 1-10 gelijkgewogen"):
        y = reversal[name].loc[a:b]
        jan = y.index.month == 1
        for label, mask in (("januari", jan), ("overige maanden", ~jan)):
            fit = hap.stats.newey_west(y[mask], pd.DataFrame(index=y[mask].index), lags=6)
            rows[(p, name, label)] = {"gem. (%/mnd)": 100 * fit.params.iloc[0], "t": fit.tvalues.iloc[0]}
        rows[(p, name, "overige maanden, FF3-alpha")] = {
            k: v for k, v in alpha_row(y[~jan], a, b).items() if k in ("FF3-alpha", "t(FF3)")}
pd.DataFrame(rows).T.round(3)Over 1933–1980 verdient de factor in januari gemiddeld 3,35% () en in de andere elf maanden 0,11% (). Na 1980 blijft het januari-effect bestaan, terwijl de overige maanden rond nul liggen en hun FF3-alpha’s nergens significant zijn. Het is moeilijk te zien waarom de correctie van een overreactie op januari zou wachten. Belastingverkopen van verliezers in december passen beter, zodat achter één patroon meer dan één soort gedrag kan zitten.
- Kahneman, D., & Tversky, A. (1979). Prospect Theory: An Analysis of Decision under Risk. Econometrica, 47(2), 263–291. 10.2307/1914185
- Tversky, A., & Kahneman, D. (1992). Advances in Prospect Theory: Cumulative Representation of Uncertainty. Journal of Risk and Uncertainty, 5(4), 297–323. 10.1007/BF00122574
- De Long, J. B., Shleifer, A., Summers, L. H., & Waldmann, R. J. (1990). Noise Trader Risk in Financial Markets. Journal of Political Economy, 98(4), 703–738. 10.1086/261703
- Shleifer, A., & Vishny, R. W. (1997). The Limits of Arbitrage. Journal of Finance, 52(1), 35–55. 10.1111/j.1540-6261.1997.tb03807.x
- De Bondt, W. F. M., & Thaler, R. (1985). Does the Stock Market Overreact? Journal of Finance, 40(3), 793–805. 10.1111/j.1540-6261.1985.tb05004.x
- Benartzi, S., & Thaler, R. H. (1995). Myopic Loss Aversion and the Equity Premium Puzzle. Quarterly Journal of Economics, 110(1), 73–92. 10.2307/2118511
- Odean, T. (1998). Are Investors Reluctant to Realize Their Losses? Journal of Finance, 53(5), 1775–1798. 10.1111/0022-1082.00072
- Barber, B. M., & Odean, T. (2000). Trading Is Hazardous to Your Wealth: The Common Stock Investment Performance of Individual Investors. The Journal of Finance, 55(2), 773–806. 10.1111/0022-1082.00226
- Barber, B. M., & Odean, T. (2001). Boys Will Be Boys: Gender, Overconfidence, and Common Stock Investment. The Quarterly Journal of Economics, 116(1), 261–292. 10.1162/003355301556400
- Barberis, N., & Thaler, R. (2003). A Survey of Behavioral Finance. In G. M. Constantinides, M. Harris, & R. M. Stulz (Eds.), Handbook of the Economics of Finance (Vol. 1B, pp. 1053–1128). Elsevier. 10.1016/S1574-0102(03)01027-6
- Thaler, R. H. (1985). Mental Accounting and Consumer Choice. Marketing Science, 4(3), 199–214. 10.1287/mksc.4.3.199
- Thaler, R. H. (1999). Mental Accounting Matters. Journal of Behavioral Decision Making, 12(3), 183–206. https://doi.org/10.1002/(SICI)1099-0771(199909)12:3<;183::AID-BDM318>3.0.CO;2-F
- Shefrin, H., & Statman, M. (1985). The Disposition to Sell Winners Too Early and Ride Losers Too Long: Theory and Evidence. The Journal of Finance, 40(3), 777–790. 10.1111/j.1540-6261.1985.tb05002.x
- Froot, K. A., & Dabora, E. (1999). How Are Stock Prices Affected by the Location of Trade? Journal of Financial Economics, 53(2), 189–216. 10.1016/S0304-405X(99)00020-3
- De Long, J. B., Shleifer, A., Summers, L. H., & Waldmann, R. J. (1991). The Survival of Noise Traders in Financial Markets. The Journal of Business, 64(1), 1–19. 10.1086/296523
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD