

Fama-Bliss, Cochrane-Piazzesi en het string-model
1Overzicht
Is het extra rendement op lange obligaties constant, zodat de rentecurve alleen verwachte toekomstige rentes weerspiegelt? Het antwoord is nee. Een steile curve voorspelt geen stijgende rente maar een hoog extra rendement, en één tentvormige combinatie van forward rates voorspelt dat rendement voor alle looptijden tegelijk. In dit college:
leiden we af dat de expectations hypothesis gelijkstaat aan een constant verwacht extra rendement, en dat één identiteit de regressies van Fama en Bliss en van Campbell en Shiller verbindt;
laten we zien waarom een factor die de curve nauwelijks beweegt toch het rendement voorspelt, en waarom de prijs van een swaption afhangt van de correlaties tussen looptijden;
simuleren we hoe vaak veertig jaar data een voorspelbaarheid tonen die er niet is;
repliceren we op de GSW-curve de hellingen van Fama en Bliss en van Campbell en Shiller, de tent van Cochrane en Piazzesi en de correlaties tussen looptijden.
De expectations hypothesis (verwachtingenhypothese: een lange rente is het gemiddelde van de verwachte korte rentes, plus hooguit een constante) gaat terug op Fisher (1896), Hicks (1939) en Lutz (1940). Twee regressies, van Fama & Bliss (1987) en van Campbell & Shiller (1991), lieten zien dat ze niet opgaat. Daarna vonden Cochrane & Piazzesi (2005) één factor voor de extra rendementen van alle looptijden, en Ludvigson & Ng (2009), Duffee (2011) en Bauer & Hamilton (2018) debatteren nog over hoe robuust die factor is. Santa-Clara rekent een bewegende, voorspelbare premie op lange obligaties tot wat we weten Santa-Clara (2026), en zijn eigen string-model Santa-Clara & Sornette (2001) geeft elke looptijd een eigen schok. Sindsdien staat vast dat de termijnpremie beweegt, maar waarom ze beweegt, is nog open.
2Intuïtie: waarom zou dit waar zijn?
Een belegger die vijf jaar wil beleggen, kan een obligatie van vijf jaar kopen of vijf keer achter elkaar een obligatie van één jaar. Als beleggers alleen om verwachte opbrengst geven, leveren beide routes gemiddeld hetzelfde op. Een stijgende curve betekent dan dat de markt stijgende rentes verwacht. Toch is de lange route riskanter, want een belegger die de lange obligatie na een jaar verkoopt, kent die prijs vandaag nog niet.
Stel dat beleggers voor dat risico een vergoeding vragen die met de conjunctuur meebeweegt. Een steile curve betekent dan deels dat de vergoeding hoog is, en niet alleen dat de rente gaat stijgen. Wie bij een steile curve de lange obligatie koopt, verdient dan meer dan de korte rente, terwijl de lange rente minder stijgt dan de curve aangaf.
Rentes van verschillende looptijden bewegen bijna volledig samen. Een verschuiving, een kanteling en een buiging verklaren meer dan 99% van hun variantie. Een vergoeding die stijgt terwijl de verwachte rente daalt, verandert de curve echter nauwelijks, zodat de informatie over het rendement kan zitten in een vorm die in die variantie amper meetelt.
Het string-model kijkt naar dezelfde curve vanuit optieprijzen. Als elke looptijd een eigen schok krijgt, hangen buren sterk samen en verre looptijden minder, terwijl een model met één factor alle correlaties op één zet. Een swaption, een optie op een gemiddelde van rentes, is duurder naarmate die rentes sterker samen bewegen. Een model met te hoge correlaties maakt swaptions daarom te duur.
We verwachten dus dat een steile curve samengaat met een hoog extra rendement en met een lange rente die eerder daalt dan stijgt. Ook verwachten we dat een deel van de informatie over dat rendement zit in een vorm van de curve die nauwelijks variantie draagt, en dat de correlatie tussen twee looptijden kleiner wordt naarmate ze verder uit elkaar liggen.
3Toy-voorbeeld: drie looptijden op twee datums
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import statsmodels.api as sm

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Op datum kosten nulcouponobligaties die over één, twee en drie jaar één euro uitkeren de prijzen in de tabel. Een jaar later is de obligatie die drie jaar liep een tweejaarsobligatie geworden. De tabel geeft ook de log-prijzen en de yields .
| looptijd | ||||||
|---|---|---|---|---|---|---|
| 1 | 0,95 | −0,051293 | 5,1293% | 0,94 | −0,061875 | 6,1875% |
| 2 | 0,90 | −0,105361 | 5,2680% | 0,88 | −0,127833 | 6,3916% |
| 3 | 0,84 | −0,174353 | 5,8118% | – | – | – |
Het recept. De forward spread splitst zich exact in een extra rendement en een renteverandering, .
Stap 1. Een forward rate is het verschil van twee log-prijzen, dus en . Wie op de driejaars- tegen de tweejaarsobligatie ruilt, legt die rente vast voor het derde jaar.
Stap 2. De driejaarsobligatie levert over het eerste jaar op. Boven de éénjaarsrente is dat .
Stap 3. De tweejaarsrente steeg met procentpunt. Op de onafgeronde getallen is , precies de spread, zodat de identiteit sluit. Met de afgeronde getallen hierboven wijkt de som alleen in de vierde decimaal af.
Stap 4. Als het verwachte extra rendement nul is, zoals de pure hypothese zegt, komt de spread volledig in de renteverandering terecht. De tweejaarsrente stijgt dan naar verwachting met procentpunt tot , en de obligatie kost op dan .
De code rekent dezelfde getallen uit en zet ze naast de handberekening.
prices_t = {1: 0.95, 2: 0.90, 3: 0.84}      # zero-coupon prices on t, maturity in years
prices_t1 = {1: 0.94, 2: 0.88}              # prices one year later
p_t = {n: np.log(v) for n, v in prices_t.items()}
p_t1 = {n: np.log(v) for n, v in prices_t1.items()}
y_t = {n: -p_t[n] / n for n in p_t}
y_t1 = {n: -p_t1[n] / n for n in p_t1}

fwd_toy = {2: p_t[1] - p_t[2], 3: p_t[2] - p_t[3]}
rx3_toy = p_t1[2] - p_t[3] - y_t[1]
spread_toy = fwd_toy[3] - y_t[1]
change_y2_toy = y_t1[2] - y_t[2]
eh_y2 = y_t[2] + spread_toy / 2
assert np.isclose(spread_toy, rx3_toy + 2 * change_y2_toy)

code = pd.Series({
    "y1 op t (%)": 100 * y_t[1], "y2 op t (%)": 100 * y_t[2], "y3 op t (%)": 100 * y_t[3],
    "f2 (%)": 100 * fwd_toy[2], "f3 (%)": 100 * fwd_toy[3],
    "rx3 (%)": 100 * rx3_toy, "verandering y2 (pp)": 100 * change_y2_toy,
    "f3 - y1 (%)": 100 * spread_toy,
    "EH: y2 op t+1 (%)": 100 * eh_y2, "EH: prijs op t+1": np.exp(-2 * eh_y2),
})
hand = pd.Series([5.1293, 5.2680, 5.8118, 5.4067, 6.8993, -0.4773, 1.1236, 1.7700, 6.1530, 0.8842],
                 index=code.index)
pd.DataFrame({"met de hand": hand, "code": code}).round(4)De twee kolommen zijn gelijk, en de identiteit sluit op machineprecisie omdat ze uit de definities volgt en niet uit een model. Onder de hypothese hoorde bij de spread van 1,77 procentpunt een prijs van 0,8842 op . De obligatie kostte 0,88 omdat de rente meer steeg dan voorspeld, en dat verschil verscheen als een negatief extra rendement. Eén jaar zegt niets over de hypothese, want het gaat erom welk deel van de spread gemiddeld premie is.
4Theorie
De kern is een exacte identiteit die de forward spread splitst in een extra rendement en een renteverandering. Daaruit volgt dat de expectations hypothesis hetzelfde zegt als een constant verwacht extra rendement, en dat de regressies van Fama en Bliss en van Campbell en Shiller één feit meten. Daarna volgen de factor van Cochrane en Piazzesi, die de curve nauwelijks beweegt, en het string-model, dat de prijs van swaptions aan de correlaties tussen looptijden koppelt.
4.1Opzet en notatie
Vanaf hier zijn kleine letters logs. Het superscript tussen haakjes is de looptijd in jaren, en de tijdstap is één jaar, ook bij maandelijkse waarnemingen. Het extra rendement heet , zoals bij Cochrane en Piazzesi.
Als beleggers risiconeutraal zijn, levert elke manier om een jaar te beleggen in verwachting hetzelfde op. Hicks voegde daar een vaste vergoeding voor prijsrisico aan toe, zodat de hypothese staat of valt met de vraag of die vergoeding constant is.
4.2Het kernresultaat: de spread is premie plus renteverandering
Een forward spread boven nul komt terecht in een extra rendement of in een stijgende rente. Een belegger die de lange obligatie koopt terwijl de forward rate boven de korte rente ligt, strijkt dat verschil op, tenzij de rente stijgt en de obligatie koers verliest.
Het verschil tussen forward en korte rente is dus een extra rendement plus keer de stijging van een rente die een jaar korter loopt. In het toy-voorbeeld was de spread 1,77 procentpunt, waarvan extra rendement en renteverandering.
Fama & Bliss (1987) regresseerden het extra rendement op de forward spread,
en onder de EH is de helling nul. Bij is de spread volledig premie en beweegt de lange rente gemiddeld niet. Een helling boven één betekent dat de rente zelfs tegen de spread in beweegt. Dat deze helling de EH toetst, volgt uit de volgende stelling, want de hypothese over yields zegt hetzelfde als een constant verwacht extra rendement.
Proof 2
Uit de definitie van volgt voor elke de exacte recursie . Neem de verwachting op en herhaal de substitutie voor , , tot :
Uit (3) volgt (1). Zijn de verwachte extra rendementen constant, dan is de tweede som constant, en delen door geeft (1).
Uit (1) volgt (3). Trek de identiteit voor , geschoven naar en in verwachting op , af van die voor . Er blijft over.
(1) en (2) zijn gelijkwaardig. Vul (1) in in. Van de sommen blijft over, plus .
Onder de EH kan dus geen enkele variabele die op bekend is het extra rendement van een obligatie voorspellen. Die uitspraak is de obligatieversie van het constante verwachte rendement uit Voorspelbaarheid van rendementen.
4.3Campbell en Shiller: hetzelfde feit, het andere stuk
Campbell en Shiller keken naar de andere term van de identiteit, de verandering van de lange rente, en vonden hellingen die negatief zijn in plaats van één. Als de EH klopt, stijgt de lange rente bij een steile curve precies genoeg om het hogere rendement van de lange obligatie weg te nemen. Hun regressie meet hoeveel daarvan gebeurt:
met onder de EH , zodat de lange rente de yield spread één op één volgt.
Proof 3
Uit de definities volgt exact , want de rechterkant is uitgewerkt . De linkerkant van (5) is dus en de regressor is . De factor valt uit de helling, en de helling van op is . Voor is .
Een Fama-Bliss-helling van één voor geeft dus , zodat elke procentpunt spread samengaat met een daling van de lange rente. De negatieve Campbell-Shiller-hellingen en de positieve Fama-Bliss-hellingen zijn daarmee één anomalie, en het teken dat de intuïtie voor beide verwachtte, komt uit. Campbell en Shiller vonden over 1952–1987 hellingen van bij 24 maanden tot bij 120 maanden.
4.4Cochrane en Piazzesi: één factor voor alle looptijden
Cochrane en Piazzesi vonden dat één combinatie van forward rates de extra rendementen van alle looptijden voorspelt, telkens met een andere schaal. Als er één bron van tijdvariërend risico is, bewegen de verwachte extra rendementen van alle looptijden met die ene toestandsvariabele mee, en reageren langere obligaties alleen sterker.
Ze regresseerden elk extra rendement op alle vijf forwards, , en zagen dat de vier vectoren van coëfficiënten dezelfde vorm hebben, alleen geschaald. Dat levert de beperking
Het extra rendement van elke looptijd is dus een vast veelvoud van één factor , en gemiddeld over de looptijden is dat veelvoud één. Cochrane en Piazzesi schrijven voor deze gewichten; hier heet de vector , omdat in dit boek de risicoaversie is.
In hun tabel 1 zijn de gewichten negatief op de éénjaarsrente, hoog op de derde forward en weer negatief op de vijfde. Die tentvorm verklaart 35% van de variantie van het gemiddelde extra rendement, terwijl geen enkele afzonderlijke Fama-Bliss-regressie boven 18% komt.
4.5Waarom de premie niet in de PCA hoeft te zitten
Een factor die nauwelijks bijdraagt aan de variantie van de curve, kan toch een groot deel van de premie voorspellen. Een PCA rangschikt bewegingen van de curve naar hun variantie, een regressie naar hun samenhang met latere rendementen. Denk aan een recessie die de premie verhoogt en tegelijk renteverlagingen doet verwachten. De twee effecten op de forward rates heffen elkaar dan op, zodat de curve per saldo niet verandert.
Deel (i) beschrijft de situatie van Cochrane en Piazzesi. In hun tabel 4 halen level, slope en curvature (verschuiving, kanteling en buiging, de eerste drie principale componenten) samen een van 0,26, tegen 0,35 voor alle vijf forwards. Deel (ii) maakt het recessievoorbeeld exact. Stijgt de premie op de vijfjaarsobligatie, en daalt de verwachte stijging van de vierjaarsrente met een kwart daarvan, dan blijft de vijfde forward staan. Volgens Duffee (2011) is bijna de helft van de variatie in de premies op obligaties zo onzichtbaar in de rentes. Zo’n factor is alleen te vinden met variabelen van buiten de curve, zoals de macrofactoren van Ludvigson & Ng (2009).
4.6Van eindig veel factoren naar een string
Regressies op jaarrendementen zijn niet genoeg om een renteoptie te prijzen, want ze geven alleen een verwachting. De prijs van een optie hangt af van hoe de hele curve tot de uitoefendatum kan bewegen, en daarvoor moet het model die curve in continue tijd beschrijven. Het string-model geeft daarvoor elke looptijd een eigen schok en legt alleen vast hoe sterk die schokken samenhangen. Het past in de benadering van Heath et al. (1992) (HJM), die de dynamiek van de hele forwardcurve kiest. Laat de instantane forward rate op voor looptijd zijn. Een HJM-model met factoren schrijft onder de risiconeutrale maat
Santa-Clara & Sornette (2001) vervingen de schokken door een stochastic string, een willekeurig veld dat in een Brownse beweging is en in continu. Voor ons volstaat de covariantiestructuur:
Elke forward krijgt dus zijn eigen schok, en de kern bepaalt hoe sterk twee looptijden samen bewegen. Een model met factoren is het geval waarin de covariantiematrix van de forwards rang heeft, en het eenfactormodel heeft . Een eenvoudige string heeft , zodat buren bijna samen bewegen en verre looptijden steeds minder. Met is de correlatie tussen looptijden die negen jaar uit elkaar liggen .
Zodra de schokken gekozen zijn, ligt de drift van elke forward onder vast, want anders zou een handelaar met obligaties van alle looptijden arbitrage vinden. Net als bij Black-Scholes is dus geen marktprijs van risico nodig.
4.7Caps en swaptions: de prijs van een verkeerde correlatie
Een model met te weinig factoren zet de correlaties tussen looptijden te hoog en maakt daardoor swaptions te duur. Een optie op één forward rate hangt alleen af van de volatiliteit van die rente. Een optie op een gemiddelde van forwards hangt ook af van hun correlaties, omdat een gemiddelde van rentes die niet volledig samen bewegen minder schommelt.
Een cap is een reeks calls op de korte rente van opeenvolgende perioden, dus op afzonderlijke forward rates. Een swaption is een optie om een renteswap aan te gaan, en de swaprente is bij benadering een gewogen gemiddelde van de forwards, met . In het normale model van Bachelier zijn renteveranderingen normaal verdeeld, zodat ook de swaprente normaal verdeeld is. De prijs van een at-the-money swaption is dan evenredig met de standaardafwijking van de swaprente,
met gelijkheid dan en slechts dan als alle . De volatiliteit van de swaprente daalt dus met de correlaties tussen de forwards. Een eenfactormodel dat aan caps is gekalibreerd, geeft elke swaption de bovengrens als volatiliteit. In oefening 4 maakt dat een swaption 6,4% duurder dan in een string met dezelfde capprijzen.
Longstaff et al. (2001) haalden met een string-model de correlaties uit swaptionprijzen. Ze vonden vier factoren en geïmpliceerde correlaties die lager lagen dan de historische.
4.8Hoe het getoetst wordt: overlappende waarnemingen
De gewone standaardfouten van de regressies van Fama en Bliss, Campbell en Shiller en Cochrane en Piazzesi zijn te klein. Een jaarrendement dat elke maand wordt gemeten, deelt immers elf maanden met zijn buren. Hansen en Hodrick Hansen & Hodrick (1980) tellen daarom de autocovarianties van de residuen tot lag 12 volledig mee, en Newey & West (1987) laten de gewichten lineair dalen, wat altijd een positieve variantie geeft.
5Simulatie: veertig jaar overlappende jaarrendementen
Hoe vaak vinden veertig jaar maanddata een voorspelbaarheid die er niet is, en hoe ver zit een geschatte helling naast de ware als de premie wel beweegt? We bouwen het kleinste model waarin de EH exact geldt of exact faalt, een Gaussisch affien model in maandtijd met drie factoren. Onder is , met persistenties 0,995, 0,96 en 0,85 voor level, slope en een snelle factor. De korte rente schommelt rond 5%, zoals in het toy-voorbeeld.
De prijs van risico is , zodat onder de matrix geldt. De log-prijzen zijn dan affien in de toestand, zoals in Theorem 2, en we vergelijken twee versies:
EH: , zodat het verwachte extra rendement exact constant is en alle voorspelbaarheid in een steekproef ruis is.
Tijdvariërende premie: heeft in de eerste rij 0,04 op de slope-factor en 0,10 op de snelle factor. De schokken in de toestand zijn identiek, maar via veranderen de prijzen en daarmee ook hoe sterk elke yield op die schokken reageert.
Op de yields zetten we een meetfout van 1 basispunt, omdat vijf forwards in een driefactormodel zonder ruis exact collineair zijn. Elke steekproef heeft 468 maanden, zoals 1964–2003, en de populatiewaarden komen uit één pad van 120.000 maanden.
PHI_P = np.diag([0.995, 0.96, 0.85])          # monthly persistence: level, slope, fast factor
SIGMA = np.diag([0.0025, 0.0030, 0.0030])     # monthly shocks, annualised rate units
DELTA0, DELTA1 = 0.05 / 12, np.ones(3) / 12   # monthly rate r_t = (5% + x1 + x2 + x3) / 12
MATURITIES = np.array([12, 24, 36, 48, 60])   # months
NOISE_BP = 0.0001
N_OBS_CP = 468


def price_of_risk(on_slope, on_fast):
    """Sigma * lambda_1: the difference Phi^P - Phi^Q (only the level row is shifted)."""
    D = np.zeros((3, 3))
    D[0, 1], D[0, 2] = on_slope, on_fast
    return D


def bond_loadings(phi_q, n_max=60):
    """A_n, B_n with log price p^(n) = A_n + B_n' X for n = 0..n_max months."""
    A, B = np.zeros(n_max + 1), np.zeros((n_max + 1, 3))
    for n in range(n_max):
        A[n + 1] = A[n] + 0.5 * B[n] @ SIGMA @ SIGMA.T @ B[n] - DELTA0
        B[n + 1] = phi_q.T @ B[n] - DELTA1
    return A, B


def simulate_log_prices(n_samples, n_months, D, noise=NOISE_BP, burn_in=600):
    """Log prices of 1..5-year zeros, shape (n_samples, n_months, 5), with yield measurement error."""
    A, B = bond_loadings(PHI_P - D)
    state = np.zeros((n_samples, 3))
    states = np.empty((n_samples, n_months, 3))
    for t in range(-burn_in, n_months):
        state = state @ PHI_P.T + rng.standard_normal((n_samples, 3)) @ SIGMA.T
        if t >= 0:
            states[:, t] = state
    log_p = A[MATURITIES] + states @ B[MATURITIES].T
    return log_p - (MATURITIES / 12) * rng.normal(0.0, noise, log_p.shape)


def bond_regressions(log_p, hh_lags=12):
    """Per sample: Fama-Bliss slope, R2 and Hansen-Hodrick t (n = 5); CP gamma and R2."""
    y1 = -log_p[..., 0]
    fwd = np.concatenate([y1[..., None], log_p[..., :-1] - log_p[..., 1:]], axis=-1)[:, :-12]
    rx = log_p[:, 12:, :-1] - log_p[:, :-12, 1:] - y1[:, :-12, None]      # n = 2..5

    x = fwd[..., 4] - fwd[..., 0]
    y = rx[..., 3]
    xd, yd = x - x.mean(1, keepdims=True), y - y.mean(1, keepdims=True)
    slope = (xd * yd).sum(1) / (xd**2).sum(1)
    resid = yd - slope[:, None] * xd
    r2_fb = 1 - (resid**2).sum(1) / (yd**2).sum(1)
    g = resid * xd
    long_run = (g**2).sum(1)
    for j in range(1, hh_lags + 1):
        long_run += 2 * (g[:, j:] * g[:, :-j]).sum(1)
    t_hh = slope * (xd**2).sum(1) / np.sqrt(np.where(long_run > 0, long_run, np.nan))

    design = np.concatenate([np.ones((*fwd.shape[:2], 1)), fwd], axis=-1)
    avg_rx = rx.mean(-1)
    gamma = np.linalg.solve(np.einsum("stk,stl->skl", design, design),
                            np.einsum("stk,st->sk", design, avg_rx)[..., None])[..., 0]
    fitted = np.einsum("stk,sk->st", design, gamma)
    demeaned = avg_rx - avg_rx.mean(1, keepdims=True)
    r2_cp = 1 - ((avg_rx - fitted) ** 2).sum(1) / (demeaned**2).sum(1)
    return {"slope": slope, "r2_fb": r2_fb, "t_hh": t_hh, "gamma": gamma, "r2_cp": r2_cp}


models = {"EH": price_of_risk(0.0, 0.0), "tijdvariërende premie": price_of_risk(0.04, 0.10)}
samples, population = {}, {}
for name, D in models.items():
    samples[name] = bond_regressions(simulate_log_prices(2000, N_OBS_CP + 12, D))
    population[name] = bond_regressions(simulate_log_prices(1, 120_000, D))

rows = {}
for name in models:
    s, pop = samples[name], population[name]
    rows[name] = {
        "FB-helling: populatie": pop["slope"][0],
        "FB-helling: mediaan": np.median(s["slope"]),
        "FB-helling: 2.5%": np.percentile(s["slope"], 2.5),
        "FB-helling: 97.5%": np.percentile(s["slope"], 97.5),
        "FB R2: populatie": pop["r2_fb"][0],
        "FB R2: mediaan": np.median(s["r2_fb"]),
        "P(|t HH| > 1.96)": np.nanmean(np.abs(s["t_hh"]) > 1.96),
        "CP R2: populatie": pop["r2_cp"][0],
        "CP R2: mediaan": np.median(s["r2_cp"]),
        "CP R2: 2.5%": np.percentile(s["r2_cp"], 2.5),
        "CP R2: 97.5%": np.percentile(s["r2_cp"], 97.5),
    }
sim_table = pd.DataFrame(rows).round(3)
sim_tableDe tabel zet voor elk model de populatiewaarde naast de verdeling over 2.000 steekproeven, voor de Fama-Bliss-regressie op de vijfjaarsobligatie en voor die van Cochrane en Piazzesi. Let links op hoe ver de blauwe verdeling van nul af ligt, en rechts op waar de 0,35 van Cochrane en Piazzesi valt ten opzichte van de blauwe verdeling.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
colours = {"EH": hap.plotting.COLORS[0], "tijdvariërende premie": hap.plotting.COLORS[1]}
for name, colour in colours.items():
    axes[0].hist(samples[name]["slope"], bins=np.linspace(-4, 5, 61), histtype="step", lw=1.6,
                 color=colour, label=f"{name} (steekproeven)")
    axes[0].axvline(population[name]["slope"][0], color=colour, ls="--", lw=1.2)
    axes[1].hist(samples[name]["r2_cp"], bins=np.linspace(0, 0.7, 57), histtype="step", lw=1.6,
                 color=colour, label=f"{name} (steekproeven)")
    axes[1].axvline(population[name]["r2_cp"][0], color=colour, ls="--", lw=1.2)
axes[0].axvline(1.27, color="black", lw=1.0, label="Cochrane-Piazzesi tabel 2 (n = 5)")
axes[0].set_title("Fama-Bliss-helling, vijfjaarsobligatie, T = 468 maanden")
axes[0].set_xlabel("Geschatte helling op de forward spread")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].legend(loc="upper left")
axes[1].axvline(0.35, color="black", lw=1.0, label="Cochrane-Piazzesi tabel 1 (0,35)")
axes[1].axvspan(0.0, 0.17, color="grey", alpha=0.15, lw=0, label="hun 95%-interval onder de EH")
axes[1].set_title("R² van het gemiddelde extra rendement op vijf forwards")
axes[1].set_xlabel("$R^2$")
axes[1].set_ylabel("Aantal steekproeven")
axes[1].legend(loc="upper right")
plt.show()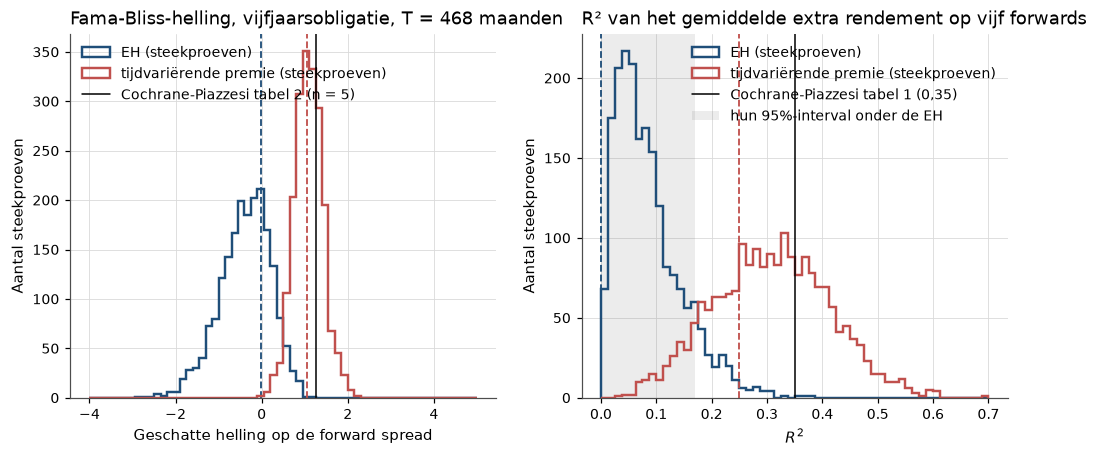
Figure 1:Links is de ware helling onder de EH (blauw) nul, maar in 95% van de steekproeven ligt de schatting tussen en . Rechts halen vijf forwards zonder enige voorspelbaarheid een tot 0,23. De grijze band is het interval van Cochrane en Piazzesi onder de EH, en hun 0,35 ligt erbuiten.
Onder de EH ligt de 97,5%-grens van de op 0,23, iets boven de 0,17 van Cochrane en Piazzesi. Vijf regressoren, persistente forwards en elf maanden overlap blazen de op tot een waarde die in een aandelenregressie als ontdekking zou gelden.
De Hansen-Hodrick-toets verwerpt de ware nulhypothese in 14% van de steekproeven in plaats van 5%. Een -waarde van 2 à 3 overtuigt dus minder dan hij lijkt.
Met een echte premie ligt de helling in 95% van de steekproeven tussen 0,45 en 1,76, rond de populatiewaarde van 1,05 uit de tabel. Onder de EH ligt de mediane helling juist onder nul, want de spread is persistent en zijn schokken hangen samen met het gerealiseerde rendement, zodat de vertekening van Stambaugh uit (13) de schatting in een korte steekproef omlaag trekt.
Het probleem van de standaardfout van 2%, dat een gemiddeld rendement na een eeuw nog twee procentpunt onzeker is, speelt hier minder sterk. Extra rendementen op obligaties van twee tot vijf jaar schommelen immers veel minder dan die op aandelen. Toch blijft de helling na veertig jaar onnauwkeurig, want de band uit de vorige alinea is breder dan de ware helling zelf.
6Replicatie op echte data
6.1De data
We laden de GSW-curve, nemen de laatste waarneming van elke maand en bouwen daaruit log-prijzen, forwards en extra rendementen over een jaar.
gsw_month = hap_data.gsw().resample("ME").last()
yields = pd.DataFrame({n: gsw_month[f"SVENY{n:02d}"] for n in range(1, 11)})
log_prices = -yields * yields.columns
forwards = pd.DataFrame({1: yields[1], **{n: log_prices[n - 1] - log_prices[n] for n in range(2, 11)}})
excess = pd.DataFrame({n: log_prices[n - 1].shift(-12) - log_prices[n] - yields[1] for n in range(2, 11)})

# forecast dates t; the last one-year return ends in 2026-08
SAMPLES = {"1964-1985": ("1964-01", "1984-12"), "1964-2003": ("1964-01", "2002-12"),
           "1964-2026": ("1964-01", "2025-08")}
(100 * yields[[1, 2, 5, 10]]).describe().round(2)De gemiddelde yield loopt op van 4,81% bij één jaar naar 5,96% bij tien jaar. De curve stijgt dus gemiddeld, maar dat zegt nog niets over de vraag of de premie beweegt.
6.2Fama en Bliss: de spread voorspelt het rendement, niet de rente
De eerste regressie is die van Fama en Bliss, met standaardfouten volgens Hansen-Hodrick, in drie steekproeven en naast de gepubliceerde waarden.
def ols_hac(y, X, lags, kernel="bartlett"):
    """OLS with an intercept and HAC standard errors (kernel 'uniform' = Hansen-Hodrick)."""
    frame = pd.concat([y.rename("y"), X], axis=1).dropna()
    return sm.OLS(frame["y"], sm.add_constant(frame.drop(columns="y"))).fit(
        cov_type="HAC", cov_kwds={"maxlags": lags, "kernel": kernel})


def fama_bliss_table(start, end):
    """Fama-Bliss (1987) regressions of rx^(n) on f^(n) - y^(1), Hansen-Hodrick SEs with 12 lags."""
    rows = {}
    for n in range(2, 6):
        spread = (forwards[n] - yields[1]).rename("spread").loc[start:end]
        fit = ols_hac(excess[n].loc[start:end], spread, lags=12, kernel="uniform")
        rows[n] = {"helling": fit.params["spread"], "SE (HH)": fit.bse["spread"],
                   "t (helling = 0)": fit.tvalues["spread"], "R2": fit.rsquared, "nobs": int(fit.nobs)}
    return pd.DataFrame(rows).T.rename_axis("n")


fb_tables = {label: fama_bliss_table(*period) for label, period in SAMPLES.items()}
fb_view = pd.concat({label: table[["helling", "SE (HH)", "t (helling = 0)", "R2"]]
                     for label, table in fb_tables.items()}, axis=1)
fb_view[("CP tabel 2", "helling")] = [0.99, 1.35, 1.61, 1.27]
fb_view[("CP tabel 2", "R2")] = [0.16, 0.17, 0.18, 0.09]
fb_view.round(3)Geslaagd. Alle hellingen zijn positief en liggen, op de tweejaarsobligatie tot 2026 na, binnen één standaardfout van één, ver van de waarde nul die de EH voorspelt. Over 1964–2003 liggen ze bij twee tot vier jaar iets onder die van Cochrane en Piazzesi en bij vijf jaar erboven. Tot 2026 blijft het patroon staan, met hellingen van 0,72 tot 1,20 en -waarden tegen nul van 2,6 tot 2,9.
Een standaardfout rond 0,4 betekent wel dat hellingen van 0,4 tot 2,0 evengoed passen, en de simulatie liet zien dat de toets hier te vaak verwerpt. Het teken is robuust, de precieze grootte niet.
6.3Cochrane en Piazzesi: de tent op een gladde curve
Daarna schatten we de tent in twee stappen, over de periode van Cochrane en Piazzesi en over de hele steekproef, en zetten we de gewichten naast hun tabel 1.
def cochrane_piazzesi(start, end):
    """Two-step Cochrane-Piazzesi (2005) estimates on 1..5-year forwards."""
    data = pd.concat([excess[[2, 3, 4, 5]], forwards[[1, 2, 3, 4, 5]].add_prefix("f")], axis=1)
    data = data.loc[start:end].dropna()
    regressors = data[[f"f{k}" for k in range(1, 6)]]
    avg_rx = data[[2, 3, 4, 5]].mean(axis=1).rename("avg")
    step1 = ols_hac(avg_rx, regressors, lags=18)
    factor = sm.add_constant(regressors) @ step1.params
    per_n = {}
    for n in range(2, 6):
        b_n = float((factor * data[n]).sum() / (factor**2).sum())      # no intercept, as in CP
        unrestricted = sm.OLS(data[n], sm.add_constant(regressors)).fit()
        per_n[n] = {"b_n": b_n, "R2 beperkt": data[n].corr(factor) ** 2, "R2 onbeperkt": unrestricted.rsquared}
    return step1, factor, pd.DataFrame(per_n).T.rename_axis("n")


cp_fits = {label: cochrane_piazzesi(*SAMPLES[label]) for label in ["1964-2003", "1964-2026"]}
gamma_names = ["const (%)", "y1", "f2", "f3", "f4", "f5"]
gamma_view = pd.DataFrame(
    {label: np.append(100 * fit[0].params.iloc[0], fit[0].params.iloc[1:]) for label, fit in cp_fits.items()},
    index=gamma_names)
gamma_view["CP tabel 1"] = [-3.24, -2.14, 0.81, 3.00, 0.80, -2.08]
gamma_view.loc["R2 gemiddeld rx"] = [cp_fits["1964-2003"][0].rsquared, cp_fits["1964-2026"][0].rsquared, 0.35]
gamma_view.loc["Wald chi2(5), NW 18"] = [float(fit[0].wald_test(np.eye(6)[1:], scalar=True).statistic)
                                         for fit in cp_fits.values()] + [105.5]
gamma_view.round(2)Over 1964–2003 is het gewicht op de éénjaarsrente negatief en dat op en positief, maar over de hele steekproef wisselen de gewichten sterk van teken. De volgende tabel zet per looptijd de lading en de met en zonder de beperking naast het artikel.
per_maturity = pd.concat({label: fit[2] for label, fit in cp_fits.items()}, axis=1)
per_maturity[("CP tabel 1", "b_n")] = [0.47, 0.87, 1.24, 1.43]
per_maturity[("CP tabel 1", "R2 beperkt")] = [0.31, 0.34, 0.37, 0.34]
per_maturity.round(3)Gedeeltelijk geslaagd. De ladingen liggen vrijwel op de gepubliceerde, en de onbeperkte regressies komen nauwelijks hoger uit, zodat de structuur met één factor overeind blijft. De factor verklaart op GSW over 1964–2003 echter 24% van de variantie van het gemiddelde extra rendement, tegen 35% in het artikel. De figuur legt de zwarte tent van het artikel naast de blauwe lijn voor dezelfde periode, en daarbij telt vooral de vorm.
Source
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.plot(range(1, 6), [-2.14, 0.81, 3.00, 0.80, -2.08], marker="o", color="black",
        label="Cochrane-Piazzesi 1964-2003 (CRSP)")
ax.plot(range(1, 6), cp_fits["1964-2003"][0].params.iloc[1:].to_numpy(), marker="s",
        color=hap.plotting.COLORS[0], label="GSW 1964-2003")
ax.plot(range(1, 6), cp_fits["1964-2026"][0].params.iloc[1:].to_numpy(), marker="^",
        color=hap.plotting.COLORS[1], label="GSW 1964-2026")
ax.axhline(0, color="grey", lw=0.8)
ax.set_xticks(range(1, 6), ["$y^{(1)}$", "$f^{(2)}$", "$f^{(3)}$", "$f^{(4)}$", "$f^{(5)}$"])
ax.set_title("De return-forecasting factor: gewichten op de forward rates")
ax.set_xlabel("Forward rate")
ax.set_ylabel("Gewicht $\\omega$")
ax.legend()
plt.show()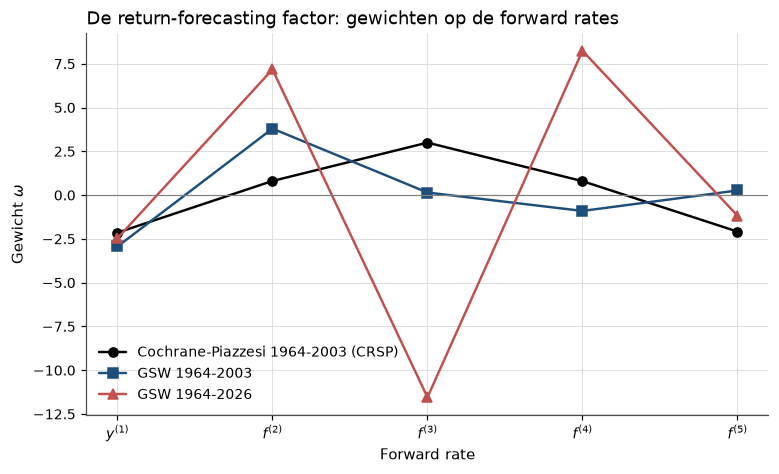
Figure 2:De tent van Cochrane en Piazzesi (zwart) naast dezelfde regressie op de gladde GSW-curve. Over 1964–2003 (blauw) blijven het negatieve gewicht op de éénjaarsrente en het positieve midden staan, maar de top schuift naar en de rechterpoot verdwijnt. Tot 2026 (rood) wisselen de gewichten sterk van teken, omdat de forwards van een gladde curve bijna collineair zijn.
Tot 2026 zakt de naar 0,15 en is de tent niet meer te herkennen, wat past bij een curve die de kleine bewegingen per looptijd maar beperkt weergeeft. Hoeveel van de voorspelling zit dan in level, slope en curvature? We herhalen tabel 4 van Cochrane en Piazzesi met de van het gemiddelde extra rendement op slope alleen, op de eerste twee en drie principale componenten en op alle vijf.
def pca_regressions(start, end):
    """R2 of average excess returns on the first k principal components of 1-5 year yields."""
    data = pd.concat([excess[[2, 3, 4, 5]].mean(axis=1).rename("avg"), yields[[1, 2, 3, 4, 5]]], axis=1)
    data = data.loc[start:end].dropna()
    levels = data[[1, 2, 3, 4, 5]]
    eigval, eigvec = np.linalg.eigh(np.cov(levels.to_numpy().T))
    order = np.argsort(eigval)[::-1]
    scores = pd.DataFrame((levels - levels.mean()).to_numpy() @ eigvec[:, order],
                          index=levels.index, columns=[f"pc{k}" for k in range(1, 6)])
    out = {}
    for label, cols in {"slope (pc2)": ["pc2"], "level, slope": ["pc1", "pc2"],
                        "level, slope, curvature": ["pc1", "pc2", "pc3"],
                        "alle vijf": [f"pc{k}" for k in range(1, 6)]}.items():
        out[label] = sm.OLS(data["avg"], sm.add_constant(scores[cols])).fit().rsquared
    out["variantie-aandeel pc4 + pc5 (miljoensten)"] = 1e6 * eigval[order][3:].sum() / eigval.sum()
    return pd.Series(out)


pd.DataFrame({"GSW 1964-2003": pca_regressions(*SAMPLES["1964-2003"]),
              "GSW 1964-2026": pca_regressions(*SAMPLES["1964-2026"]),
"CP tabel 4": [0.22, 0.24, 0.26, 0.35, np.nan]}).round(4)Niet geslaagd voor het deel buiten level, slope en curvature. Op GSW voegen de vierde en vijfde component over 1964–2003 niets toe aan de van 0,24. Bij Cochrane en Piazzesi stijgt de van 0,26 naar 0,35 door precies die componenten. Het deel van de premie dat volgens Proposition 3 klein is voor rentes en groot voor rendementen, en waar we bij de intuïtie de informatie over het rendement verwachtten, is in de gladde curve weggestreken. Of dat deel robuust is, zoals Bauer en Hamilton vragen, is met deze data dus niet te beantwoorden.
6.4Campbell en Shiller: de lange rente beweegt de verkeerde kant op
We schatten (5) eerst met een horizon van een jaar voor looptijden van 2 tot 10 jaar, zoals de Fama-Bliss-regressie. Daarna volgt een horizon van een maand voor 24, 60 en 120 maanden, zoals in tabel 1b van Campbell en Shiller.
def svensson_yield(params, tau):
    """Continuously compounded Svensson (1994) zero yield at maturity tau (years), row-wise."""
    b3 = params["BETA3"].fillna(0.0)
    t1, t2 = params["TAU1"], params["TAU2"].fillna(1.0)
    x1, x2 = tau / t1, tau / t2
    hump1 = (1 - np.exp(-x1)) / x1
    return (params["BETA0"] + params["BETA1"] * hump1 + params["BETA2"] * (hump1 - np.exp(-x1))
            + b3 * ((1 - np.exp(-x2)) / x2 - np.exp(-x2)))


svensson = gsw_month[["BETA0", "BETA1", "BETA2", "BETA3", "TAU1", "TAU2"]].dropna(subset=["BETA0", "TAU1"])
check = (svensson_yield(svensson, 5.0) - gsw_month.loc[svensson.index, "SVENY05"]).abs().max()
print(f"grootste afwijking Svensson-formule t.o.v. SVENY05: {check:.2e}")


def campbell_shiller(n_years, horizon_years, start, end):
    """Campbell-Shiller (1991) slope: change in the (n-h)-yield over h on h/(n-h) times the (n,h) spread."""
    h, n = horizon_years, n_years
    long_now, long_next = svensson_yield(svensson, n), svensson_yield(svensson, n - h)
    short_now = svensson_yield(svensson, h)
    steps = int(round(12 * h))
    lhs = (long_next.shift(-steps) - long_now).rename("lhs")
    x = (h / (n - h) * (long_now - short_now)).rename("spread")
    fit = ols_hac(lhs.loc[start:end], x.loc[start:end], lags=steps, kernel="uniform")
    return fit.params["spread"], fit.bse["spread"], int(fit.nobs)


annual_rows = {}
for n in range(2, 11):
    first = "1964-01" if n <= 7 else "1971-08"      # GSW reports 8-10 year yields from 1971-08
    b_03, se_03, _ = campbell_shiller(n, 1.0, first, "2002-12")
    b_26, se_26, _ = campbell_shiller(n, 1.0, first, "2025-08")
    annual_rows[n] = {"b t/m 2003": b_03, "t (b = 1) t/m 2003": (b_03 - 1) / se_03,
                      "b t/m 2026": b_26, "t (b = 1) t/m 2026": (b_26 - 1) / se_26}
pd.DataFrame(annual_rows).T.rename_axis("n (jaren)").round(3)
grootste afwijking Svensson-formule t.o.v. SVENY05: 5.00e-07
Met een horizon van een jaar zijn alle hellingen negatief en dalen ze met de looptijd, tot 2003 van bij twee jaar tot bij tien jaar. De EH voorspelt één, en daar liggen ze ver onder.
De -waarden tegen die één liggen tussen en , en oefening 2 laat zien dat de hellingen exact gelijk zijn aan . De volgende cel zet de maandhorizon naast tabel 1b.
monthly_rows = {}
for months, published in [(24, -1.815), (60, -3.099), (120, -5.024)]:
    first = "1961-07" if months <= 84 else "1971-08"
    b_87, se_87, n_87 = campbell_shiller(months / 12, 1 / 12, first, "1987-01")
    b_26, se_26, n_26 = campbell_shiller(months / 12, 1 / 12, first, "2026-07")
    monthly_rows[months] = {"b t/m 1987": b_87, "SE t/m 1987": se_87, "nobs": n_87,
                            "b t/m 2026": b_26, "SE t/m 2026": se_26, "CS tabel 1b (1952-1987)": published}
pd.DataFrame(monthly_rows).T.rename_axis("looptijd (maanden)").round(3)Gedeeltelijk geslaagd. Bij een horizon van een maand kloppen teken en rangorde met tabel 1b, maar tot 1987 zijn de hellingen in absolute waarde veel kleiner. De waarschijnlijke oorzaak is de éénmaandsrente, die bij GSW een extrapolatie van de curve is. Een meetfout in de korte rente zit volledig in de regressor en trekt de helling naar nul, en onze steekproef begint bovendien in 1961 in plaats van 1952.
6.5Forward-veranderingen: de correlatie daalt met de afstand
Tot slot toetsen we de voorspelling van het string-model met de correlaties tussen maandelijkse veranderingen van de GSW-forwards van 1 tot 10 jaar. De kern passen we aan met kleinste kwadraten op .
TAU = np.arange(1, 11)
inst_fwd = pd.DataFrame({n: gsw_month[f"SVENF{n:02d}"] for n in range(1, 11)}).dropna()
fwd_changes = inst_fwd.diff().dropna()
corr_data = fwd_changes.corr()

distance = np.abs(TAU[:, None] - TAU[None, :])
off_diag = distance > 0
minus_log_corr = -np.log(corr_data.to_numpy()[off_diag])
kappa_fit = float((distance[off_diag] * minus_log_corr).sum() / (distance[off_diag] ** 2).sum())
eig_data = np.sort(np.linalg.eigvalsh(fwd_changes.cov().to_numpy()))[::-1]

print(f"steekproef {fwd_changes.index[0]:%Y-%m} t/m {fwd_changes.index[-1]:%Y-%m}, {len(fwd_changes)} maanden")
print(f"gefitte kappa in exp(-kappa |dtau|): {kappa_fit:.3f}")
print(f"aandeel eerste drie componenten: {eig_data[:3].sum() / eig_data.sum():.3f}")
corr_data.round(2)
steekproef 1971-09 t/m 2026-08, 660 maanden
gefitte kappa in exp(-kappa |dtau|): 0.075
aandeel eerste drie componenten: 0.990
Geslaagd. Elke rij daalt monotoon met de afstand, zoals we bij de intuïtie al verwachtten. De correlatie tussen de 1- en de 10-jaarsforward is 0,47, terwijl buren met 0,92 of meer samenhangen en een eenfactormodel overal één zou geven.
De gefitte van 0,075 ligt dicht bij de 0,08 die de Theorie ter illustratie koos, zodat dat voorbeeld een realistische orde van grootte had. Links in de figuur daalt de correlatie naarmate een cel verder van de diagonaal ligt, en rechts dalen de twee rijen van de tabel met de afstand zoals de gestippelde string, terwijl het eenfactormodel op één blijft.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
image = axes[0].imshow(corr_data.to_numpy(), vmin=0.3, vmax=1.0, cmap="viridis", origin="lower",
                       extent=(0.5, 10.5, 0.5, 10.5))
fig.colorbar(image, ax=axes[0], shrink=0.85, label="Correlatie")
axes[0].set_title("Maandelijkse veranderingen van GSW-forwards")
axes[0].set_xlabel("Looptijd (jaren)")
axes[0].set_ylabel("Looptijd (jaren)")

for start, colour in [(1, hap.plotting.COLORS[0]), (5, hap.plotting.COLORS[2])]:
    axes[1].plot(TAU[start - 1:] - start, corr_data.loc[start, start:].to_numpy(), marker="o", color=colour,
                 label=f"vanaf {start} jaar")
d_grid = np.linspace(0, 9, 50)
axes[1].plot(d_grid, np.exp(-kappa_fit * d_grid), color="black", ls="--", label=f"string, kappa = {kappa_fit:.2f}")
axes[1].axhline(1.0, color=hap.plotting.COLORS[1], lw=1.2, label="eenfactormodel")
axes[1].set_title("Correlatie tegen looptijdverschil")
axes[1].set_xlabel("Verschil in looptijd (jaren)")
axes[1].set_ylabel("Correlatie")
axes[1].legend()
plt.show()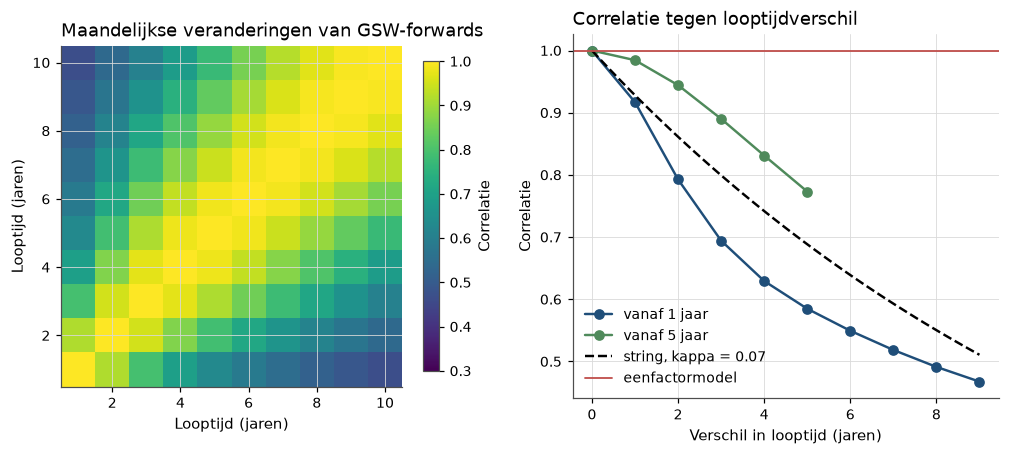
Figure 3:Links staan, over 1971–2026, de correlaties van maandelijkse veranderingen in de GSW-forwards van 1 tot 10 jaar. Rechts staat de correlatie vanaf de 1- en de 5-jaarsforward tegen het looptijdverschil, naast een string met de gefitte en het eenfactormodel. Aan de lange kant blijven buren sterker gecorreleerd dan aan de korte kant.
De correlatie hangt dus niet alleen van de afstand af, en het string-model laat die vrijheid omdat van beide looptijden mag afhangen. De eerste drie componenten dragen hier 99,0% van de variantie, maar dat zegt vooral iets over GSW, want een Svensson-curve heeft maar weinig vrijheidsgraden. De correlaties zelf zijn goed gemeten. Met 660 maanden is de standaardfout van een correlatie rond 0,5 ongeveer .
7Wat er brak, en wat daarna kwam
Wat het model verklaart. De expectations hypothesis maakt van de rentecurve een toetsbare voorspelling over latere rentes. De identiteit (2) laat zien waarom ze zo lang overeind bleef. Een forward spread komt terecht in renteveranderingen of in extra rendementen, en zolang niemand naar het tweede keek, leek het eerste vanzelfsprekend.
Waar het breekt. Drie bevindingen staan stevig. Van 1964 tot 2026 liggen de Fama-Bliss-hellingen op GSW-data rond één in plaats van nul, terwijl de Campbell-Shiller-hellingen negatief zijn in plaats van één. Bovendien bewegen de forwards op één en tien jaar maar met een correlatie van 0,47 samen, wat een eenfactormodel niet kan weergeven.
Minder robuust zijn de vorm van de tent en de hoogte van de . Onder de EH halen vijf forwards met overlap al een tot 0,23, op GSW voegen de componenten buiten level, slope en curvature niets toe, en buiten de steekproef faalt de factor.
Risico of vergissing? Volgens de Chicago-lezing vergoedt de premie renterisico dat in slechte tijden toeslaat. Cochrane en Piazzesi noemen hun factor contracyclisch, en Ludvigson en Ng vinden contracyclische macrofactoren in de premie, zoals een SDF met een tijdvariërende prijs van risico uit Habit, long-run risk en rampen vraagt. Volgens de Yale-lezing zijn de markten gesegmenteerd, omdat pensioenfondsen en centrale banken lange looptijden ongeacht de prijs kopen en arbitrageurs weinig kapitaal hebben. De data scheiden de lezingen niet, want beide voorspellen een contracyclische premie. Een belegger die lange obligaties koopt als de factor hoog staat, draagt dus een risico met een premie, of denkt iets te weten wat de prijs niet weet.
Wat er daarna kwam. Als de prijs van risico in obligaties voorspelbaar varieert, is de volgende vraag wat optieprijzen op aandelen zeggen over de prijs van crashrisico. Dat onderzoekt Opties en crashrisico.
8Oefeningen
Solution to Exercise 1
(1) De log-prijs wordt , zodat . De tweejaarsrente daalt met procentpunt, en de identiteit sluit, want op de onafgeronde getallen is . Net als in het toy-voorbeeld scheelt de afronding alleen in de vierde decimaal, en de code rekent het na.
p2_t1_alt = np.log(0.91)
rx3_alt = p2_t1_alt - p_t[3] - y_t[1]
change_y2_alt = -p2_t1_alt / 2 - y_t[2]
pd.Series({"rx3 (%)": 100 * rx3_alt, "verandering y2 (pp)": 100 * change_y2_alt,
           "rx3 + 2 x verandering (%)": 100 * (rx3_alt + 2 * change_y2_alt),
           "f3 - y1 (%)": 100 * spread_toy}).round(4)
rx3 (%) 2.8749
verandering y2 (pp) -0.5525
rx3 + 2 x verandering (%) 1.7700
f3 - y1 (%) 1.7700
dtype: float64(2) Het extra rendement is nu groter dan de hele spread, omdat de rente daalde in plaats van steeg. De identiteit sluit in elk jaar, welke kant de rente ook op gaat, maar in één jaar is een premie niet te scheiden van een onverwachte renteverandering. Pas een gemiddelde over veel jaren zegt welk deel van de spread premie is.
Solution to Exercise 2
(1) Als en de projectie van op dus helling één heeft, is , zodat de lange rente gemiddeld niet beweegt. Voor is de forward spread , dus een Fama-Bliss-helling van één betekent en .
(2) en (3) De code schat beide hellingen per looptijd en vergelijkt ze.
start, end = SAMPLES["1964-2003"]
rows_ex2 = {}
for n in range(2, 6):
    spread_n = (yields[n] - yields[1]).rename("s")
    lhs_cs = ((yields[n - 1].shift(-12) - yields[n]).rename("lhs"))
    beta_s = sm.OLS(excess[n].loc[start:end], sm.add_constant(spread_n.loc[start:end]), missing="drop").fit().params["s"]
    b_cs = sm.OLS(lhs_cs.loc[start:end], sm.add_constant(spread_n.loc[start:end] / (n - 1)),
                  missing="drop").fit().params["s"]
    rows_ex2[n] = {"beta^s": beta_s, "b_CS": b_cs, "1 - beta^s": 1 - beta_s}
table_ex2 = pd.DataFrame(rows_ex2).T.rename_axis("n")
assert np.allclose(table_ex2["b_CS"], table_ex2["1 - beta^s"])
print(f"n = 2: 1 - 2 * FB-helling = {1 - 2 * fb_tables['1964-2003'].loc[2, 'helling']:.4f}")
table_ex2.round(4)
n = 2: 1 - 2 * FB-helling = -0.9300
De identiteit sluit exact, en voor is gelijk aan . De negatieve Campbell-Shiller-hellingen en de positieve Fama-Bliss-hellingen zijn dus één feit, namelijk dat de spread vooral premie en weinig renteverwachting bevat.
Solution to Exercise 3
De code schat beide varianten en de voorspelling buiten de steekproef.
fwd_cols = [1, 2, 3, 4, 5]
avg_excess = excess[[2, 3, 4, 5]].mean(axis=1).rename("avg")
start, end = SAMPLES["1964-2003"]

r2_by_lag = {}
for lags in (0, 3):
    smoothed = forwards[fwd_cols].rolling(lags + 1).mean().add_prefix("f")
    r2_by_lag[f"forwards t..t-{lags}"] = ols_hac(avg_excess.loc[start:end], smoothed.loc[start:end], lags=18).rsquared

gamma_in = cp_fits["1964-2003"][0].params.to_numpy()
oos = pd.concat([avg_excess, forwards[fwd_cols]], axis=1).loc["2003-01":"2025-08"].dropna()
forecast = gamma_in[0] + oos[fwd_cols].to_numpy() @ gamma_in[1:]
benchmark = avg_excess.loc[start:end].mean()
r2_oos = 1 - ((oos["avg"] - forecast) ** 2).sum() / ((oos["avg"] - benchmark) ** 2).sum()

pd.Series({**r2_by_lag, "CP tabel 5 (0 en 3 lags)": "0.35 / 0.44",
           "OOS R2 2003-2025 met gamma uit 1964-2003": r2_oos,
           "gemiddelde voorspelling 2003-2025 (%)": 100 * forecast.mean(),
           "gemiddeld gerealiseerd 2003-2025 (%)": 100 * oos["avg"].mean(),
           "gemiddelde 1964-2003 (%)": 100 * benchmark}).apply(lambda v: round(v, 3) if isinstance(v, float) else v)
forwards t..t-0 0.243
forwards t..t-3 0.258
CP tabel 5 (0 en 3 lags) 0.35 / 0.44
OOS R2 2003-2025 met gamma uit 1964-2003 -1.173
gemiddelde voorspelling 2003-2025 (%) -1.947
gemiddeld gerealiseerd 2003-2025 (%) 0.606
gemiddelde 1964-2003 (%) 0.849
dtype: objectMet een gemiddelde over vier maanden stijgt de op GSW van 0,24 naar 0,26, veel minder dan de stap naar 0,44 bij Cochrane en Piazzesi. Een gladde curve bevat immers al minder meetruis.
Buiten de steekproef, over 2003–2025, faalt de factor met een van . Hij voorspelde gemiddeld per jaar tegen een gerealiseerde , omdat de constante en de gewichten niet neutraal zijn voor het renteniveau. In de steekproef is de factor dus sterk, maar daarbuiten is hij instabiel.
Solution to Exercise 4
De code bouwt de drie correlatiematrices, trekt de steekproef en rekent de swaprente uit.
TAU = np.arange(1, 11)
KAPPA_STRING = 0.08
VOL_FWD = 0.0030                                   # monthly forward-rate change volatility

corr_string = np.exp(-KAPPA_STRING * np.abs(TAU[:, None] - TAU[None, :]))


def rank_k_correlation(corr, k):
    """Best rank-k approximation of a correlation matrix, rescaled to a unit diagonal."""
    eigval, eigvec = np.linalg.eigh(corr)
    top = eigvec[:, -k:] * np.sqrt(eigval[-k:])
    approx = top @ top.T
    scale = np.sqrt(np.diag(approx))
    return approx / np.outer(scale, scale)


shocks = rng.standard_normal((600, len(TAU))) @ np.linalg.cholesky(corr_string).T * VOL_FWD
corr_sample = np.corrcoef(shocks.T)

eig_pop = np.sort(np.linalg.eigvalsh(corr_string))[::-1]
eig_sample = np.sort(np.linalg.eigvalsh(np.cov(shocks.T)))[::-1]

weights = np.full(5, 0.2)                          # swap rate ~ average of forwards 6..10 years
correlations = {"eenfactor": np.ones((10, 10)), "drie factoren": rank_k_correlation(corr_string, 3),
                "string": corr_string}
swaption_vol = {}
for label, corr in correlations.items():
    block = corr[5:, 5:] * VOL_FWD**2
    swaption_vol[label] = np.sqrt(weights @ block @ weights)

print("aandeel eerste drie componenten, populatie: "
      f"{eig_pop[:3].sum() / eig_pop.sum():.3f}; steekproef: {eig_sample[:3].sum() / eig_sample.sum():.3f}")
print(f"correlatie 1 en 10 jaar: populatie {corr_string[0, -1]:.3f}, steekproef {corr_sample[0, -1]:.3f}")
pd.DataFrame(
    {"swaprente-vol (bp/maand)": {k: 1e4 * v for k, v in swaption_vol.items()},
     "prijs t.o.v. string": {k: v / swaption_vol["string"] for k, v in swaption_vol.items()}}
).round(3)
aandeel eerste drie componenten, populatie: 0.942; steekproef: 0.944
correlatie 1 en 10 jaar: populatie 0.487, steekproef 0.432
(1) Met dezelfde capprijzen maakt het eenfactormodel de swaption 6,4% duurder dan de string, en het driefactormodel 2,9%. Een benadering met lage rang overschat de correlaties tussen verre looptijden.
(2) Toch dragen de eerste drie componenten van de string 94% van de variantie, zodat een PCA met drie dominante componenten geen bewijs is voor drie factoren. De kleine componenten die een PCA weggooit, bepalen juist de prijs van een swaption.
- Fisher, I. (1896). Appreciation and Interest. Macmillan, for the American Economic Association.
- Hicks, J. R. (1939). Value and Capital. Clarendon Press.
- Lutz, F. A. (1940). The Structure of Interest Rates. The Quarterly Journal of Economics, 55(1), 36–63. 10.2307/1881665
- Fama, E. F., & Bliss, R. R. (1987). The Information in Long-Maturity Forward Rates. American Economic Review, 77(4), 680–692.
- Campbell, J. Y., & Shiller, R. J. (1991). Yield Spreads and Interest Rate Movements: A Bird’s Eye View. The Review of Economic Studies, 58(3), 495–514. 10.2307/2298008
- Cochrane, J. H., & Piazzesi, M. (2005). Bond Risk Premia. American Economic Review, 95(1), 138–160. 10.1257/0002828053828581
- Ludvigson, S. C., & Ng, S. (2009). Macro Factors in Bond Risk Premia. Review of Financial Studies, 22(12), 5027–5067. 10.1093/rfs/hhp081
- Duffee, G. R. (2011). Information in (and not in) the Term Structure. Review of Financial Studies, 24(9), 2895–2934. 10.1093/rfs/hhr033
- Bauer, M. D., & Hamilton, J. D. (2018). Robust Bond Risk Premia. Review of Financial Studies, 31(2), 399–448. 10.1093/rfs/hhx096
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Santa-Clara, P., & Sornette, D. (2001). The Dynamics of the Forward Interest Rate Curve with Stochastic String Shocks. Review of Financial Studies, 14(1), 149–185. 10.1093/rfs/14.1.149
- Heath, D., Jarrow, R., & Morton, A. (1992). Bond Pricing and the Term Structure of Interest Rates: A New Methodology for Contingent Claims Valuation. Econometrica, 60(1), 77–105. 10.2307/2951677
- Longstaff, F. A., Santa-Clara, P., & Schwartz, E. S. (2001). The Relative Valuation of Caps and Swaptions: Theory and Empirical Evidence. The Journal of Finance, 56(6), 2067–2109. 10.1111/0022-1082.00399
- Hansen, L. P., & Hodrick, R. J. (1980). Forward Exchange Rates as Optimal Predictors of Future Spot Rates: An Econometric Analysis. Journal of Political Economy, 88(5), 829–853. 10.1086/260910
- Newey, W. K., & West, K. D. (1987). A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix. Econometrica, 55(3), 703–708. 10.2307/1913610
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD