

Shiller en LeRoy-Porter: excess volatility
1Overzicht
Shillers antwoord op die vraag was ja, en met een factor vijf tot dertien, want een rationele prijs is een voorspelling en beweegt hoogstens zo veel als wat hij voorspelt. Die factor hangt echter sterk af van keuzes die de stelling niet voorschrijft. Er blijft een kleinere overschrijding over, en die is hetzelfde feit als voorspelbare rendementen. In dit college:
rekenen we met drie dividenden na dat een rationele prijs over alle mogelijke toestanden minder varieert dan de ex-post rationele prijs, en dat die volgorde langs één pad kan omdraaien,
bewijzen we de variantiegrens en lezen we Shillers tabel,
behandelen we drie kritieken, over kleine steekproeven Flavin (1983), niet-stationaire dividenden Kleidon (1986)Marsh & Merton (1986), en het antwoord in logs Campbell & Shiller (1988)West (1988),
simuleren we hoe vaak Shillers toets alarm slaat in economieën met exact rationele prijzen,
repliceren we Shillers figuur 1 en zijn variantieratio op
hap.data.shiller(), en meten we hoe sterk die ratio van zulke keuzes afhangt.
In juni 1981 publiceerde Robert Shiller in de American Economic Review een artikel met een vraag als titel: Do Stock Prices Move Too Much to be Justified by Subsequent Changes in Dividends? Shiller (1981). Een maand eerder had Econometrica het artikel van Stephen LeRoy en Richard Porter geplaatst, dat onafhankelijk hetzelfde idee uitwerkte LeRoy & Porter (1981). In Shillers tabel 2 bewoog de reële S&P-koers over 1871–1979 5,6 keer zo veel als het model toestaat, de Dow Jones over 1928–1979 13,3 keer. Met dit werk begon een nieuw tijdvak, omdat het de discussie over efficiënte markten verlegde. Die discussie ging tot dan over voorspelbare rendementen op korte termijn, waar de data weinig tegen de theorie inbrachten. Shiller keek naar het niveau van prijzen, waar de afwijking groot en zichtbaar was.
Bij elk model stellen we de vraag theorie of feit. Is het een theorie die getoetst wordt, of een feit dat op een verklaring wacht? Het contante-waardemodel van Williams, met een constante discontovoet, was een theorie die getoetst werd. Na Shiller is excess volatility (overmatige beweeglijkheid, oftewel koersen die meer bewegen dan hun fundamentele waarde) een feit met twee concurrerende verklaringen. Ofwel bewegen de discontovoeten, ofwel reageren prijzen te sterk.
2Intuïtie: waarom zou dit waar zijn?
Denk aan een weersvoorspeller. Elke ochtend noemt hij de temperatuur van vanmiddag, en achteraf leggen we zijn voorspellingen naast de metingen. Werkt hij goed, dan zijn zijn fouten onvoorspelbaar, want uit zijn eigen getal valt niet af te leiden of hij te hoog of te laag zit. De gemeten temperatuur is dan de voorspelling plus een fout die er los van staat. Omdat twee losstaande bronnen van variatie optellen, schommelen de metingen minstens zo veel als de voorspellingen.
Shiller paste dat toe op de beurs. Onder het model van Williams is de koers van vandaag de beste voorspelling van één getal, namelijk de contante waarde van alle dividenden die het aandeel daarna werkelijk uitkeert. Dat getal kennen we pas achteraf, maar met een eeuw data is het voor elk jaar bij benadering uit te rekenen. Shiller noemde het de ex-post rationele prijs (de prijs die een belegger met volledige kennis van de toekomstige dividenden had betaald). Zijn koersen goede voorspellingen daarvan, dan bewegen ze niet meer dan de ex-post rationele prijs.
Zijn figuur maakte meer indruk dan de ongelijkheid. Daarin schiet de koers op en neer, terwijl de ex-post rationele prijs als een rustige lijn door het midden loopt. Dividenden schommelen weinig rond hun groeipad, en een contante waarde middelt die schommelingen uit over decennia. De crash van 1929–1932 is in de ex-post rationele prijs nauwelijks te zien, want de dividenden lagen in de jaren dertig maar enkele jaren onder hun trend. Volgens Shiller was de daling vanaf 1929 niet te verklaren uit latere dividenden.
Toch zit er een addertje onder het gras, en daarover ging het debat van de jaren tachtig. De ongelijkheid gaat over de spreiding over alle toestanden die hadden kunnen gebeuren, maar gemeten wordt de spreiding langs de tijd, over het ene pad dat wel gebeurde. Die twee zijn alleen gelijk als de wereld stationair is, want alleen dan lijkt een eeuw uit één pad op honderd trekkingen uit dezelfde verdeling. Volgen dividenden een random walk (elk jaar een blijvende schok), dan kan een volkomen rationele koers langs de tijd wilder bewegen dan de ex-post rationele prijs.
Wat verwachten we dus? Uit het beeld van de weersvoorspeller en uit dit addertje volgen drie verwachtingen, die de theorie hierna een voor een nagaat.
Over toestanden varieert een rationele prijs hoogstens zo veel als de ex-post rationele prijs. Meer informatie maakt de prijs beweeglijker, maar nooit boven dat plafond.
Langs de tijd kan een rationele prijs meer bewegen, vooral als dividenden blijvende schokken krijgen.
Beweegt de koers toch te veel, dan beweegt de discontovoet of reageert de koers te sterk. Een prijs-dividend-ratio die te veel beweegt, voorspelt dan latere rendementen.
3Toy-voorbeeld: drie dividenden en twee informatiestructuren
De eerste cel laadt de bibliotheken en zet een vaste toevalsgenerator voor de simulatie.
import itertools

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Een aandeel keert op een dividend uit en is daarna niets meer waard. De tabel hieronder geeft de rest van de opzet.
| grootheid | waarde |
|---|---|
| dividenden | onafhankelijk 5 of 15, elk met kans : verwachting 10, variantie 25 |
| discontovoet | : een euro één periode later is waard |
| gerealiseerd pad | |
| informatie A | niemand weet iets vooruit |
| informatie B | het volgende dividend is één periode vooruit bekend |
Het recept luidt als volgt. De ex-post rationele prijs is de contante waarde van de dividenden die werkelijk kwamen, en achterwaarts uitgerekend is dat , met . In zes stappen rekenen we daarmee alles uit.
langs het pad. , en .
Prijs onder A. Elk dividend is 10 in verwachting, dus in elke toestand, en .
Prijs onder B. , dus .
over de acht toestanden. , dus .
Voorspelfout onder B. hangt niet af van en hangt dus ook niet samen met . De variantie van is , en .
Langs de tijd. Op het pad is met variantie , en prijs B met variantie .
De cel hieronder rekent de zes stappen na, met de acht even waarschijnlijke paden als toestanden.
discount = 0.8                                     # 1 / (1 + 0.25)
weights = discount ** np.arange(1, 4)              # 0.8, 0.64, 0.512
states = np.array(list(itertools.product([5.0, 15.0], repeat=3)))   # 8 equally likely paths

path = np.array([15.0, 5.0, 15.0])                               # step 1, backward
pstar_2 = discount * path[2]
pstar_1 = discount * (path[1] + pstar_2)
pstar_path = np.array([discount * (path[0] + pstar_1), pstar_1, pstar_2])
price_A = np.full(8, 10.0 * weights.sum())                       # step 2
price_B = discount * states[:, 0] + 10.0 * weights[1:].sum()     # step 3
pstar_0 = states @ weights                                       # step 4
error_B = pstar_0 - price_B                                      # step 5
cov_B = np.mean((price_B - price_B.mean()) * error_B)
price_B_path = discount * path + 10.0 * np.array([0.64 + 0.512, 0.64, 0.0])   # step 6

pd.DataFrame(
    {
        "met de hand": [22.88, 13.6, 12.0, 0.0, 16.0, 32.79, 16.79, 0.0, 23.01, 34.16],
        "code": [*pstar_path, price_A.var(), price_B.var(), pstar_0.var(),
                 error_B.var(), cov_B, pstar_path.var(), price_B_path.var()],
    },
    index=["p*_0 langs het pad", "p*_1 langs het pad", "p*_2 langs het pad",
           "Var(p_0) onder A", "Var(p_0) onder B", "Var(p*_0)",
           "Var(u_0) onder B", "Cov(p_0, u_0) onder B",
           "Var langs de tijd, p*", "Var langs de tijd, B"],
).round(2)Code en hand geven dezelfde getallen, ook de covariantie van nul tussen prijs en voorspelfout. Over toestanden geldt , zodat meer informatie de prijs beweeglijker maakt, maar nooit beweeglijker dan . Langs het ene pad is prijs B wél beweeglijker dan , zonder dat er iets fout is.
4Theorie
We leiden eerst de variantiegrens af, die zegt dat een rationele prijs een voorspelling van is en daarom minder varieert. Daarna lezen we wat Shiller mat, en welke keuze de berekening van vraagt. Dan volgen de drie kritieken, over kleine steekproeven, over niet-stationaire dividenden en het antwoord daarop in logs. De kern is dat de grens over toestanden gaat en de meting over de tijd.
4.1Opzet: de ex-post rationele prijs
De rationele prijs is de verwachting van de ex-post rationele prijs. De notatie is die van Opzet, data en conventies: is de reële prijs ex dividend op en het dividend tussen en , beide niveaus. De discontovoet is constant, en is de constante discontofactor: in het toy-voorbeeld, bij Shillers . Shiller schrijft hoofdletters en voor ; in deze reeks is de risicoaversie. Onder de transversaliteitsvoorwaarde (de verdisconteerde prijs in de verre toekomst gaat naar nul, en bij weegt een prijs over honderd jaar nog minder dan 1% mee) geldt, zoals in Williams en het dividend discount model,
De prijs is dus de verwachte som van alle toekomstige dividenden, elk verdisconteerd met per jaar. Als we de verwachting weglaten, ontstaat de ex-post rationele prijs (bij Shiller de perfect-foresight price):
Links staat de som van wat werkelijk kwam, rechts dezelfde som achterwaarts, zoals in stap 1 van het toy-voorbeeld. Samen zeggen (1) en (2) dat , oftewel dat de prijs de beste voorspelling van is met de informatie van .
4.2De variantiegrens
Een rationele prijs varieert hoogstens zo veel als , en het verschil is de variantie van de voorspelfout. Stel namelijk dat de fout positief samenhangt met de prijs, zodat hoge prijzen achteraf nog te laag blijken. Een belegger die dat ziet, koopt als de prijs hoog is, en drijft hem op tot de samenhang weg is. In evenwicht staat de fout dus los van de prijs. Een losstaande fout voegt variantie toe aan de uitkomst en kan er niets van afhalen, zodat meer varieert dan .
Het bewijs gebruikt alleen dat de voorspelfout gemiddeld nul is gegeven . Daardoor is de covariantie van met alles wat op bekend is nul, ook met , en tellen de varianties op.
Proof 1
Wat de dividenden achteraf waard bleken, varieert dus zo veel als de prijs plus de voorspelfout, en in het toy-voorbeeld is dat . Hetzelfde argument geeft de ondergrens van LeRoy en Porter, want een voorspelling met minder informatie, bijvoorbeeld alleen de dividendhistorie, varieert minder dan de marktprijs. In het toy-voorbeeld is A de kleinste informatieverzameling en B de grotere, en daar geldt . Meer informatie maakt de prijs dus beweeglijker, maar nooit beweeglijker dan , en daarmee komt de eerste verwachting uit de intuïtie uit.
De stelling gaat over de variantie over toestanden op één datum , maar Shiller mat de variantie langs de tijd. Die twee vallen samen als de reeksen stationair zijn, want dan hangen de momenten niet van af en schat het tijdgemiddelde het gemiddelde over toestanden. Onder die aanname luidt de grens .
4.3Wat Shiller mat
Shiller vond op de S&P een koers die ruim vijf keer zo veel beweegt als , en op de Dow dertien keer. Omdat koersen en dividenden over een eeuw exponentieel groeien, verwijderde hij bij beide eerst de trend. Hij regresseerde op een constante en de tijd, met helling (bij hem 0,0148, dus ongeveer 1,5% groei per jaar), en deelde koers en dividend door , met als basisjaar. Voor de gedetrendeerde reeksen is de passende discontovoet . Dat volgt uit (1) met onvoorwaardelijke verwachtingen, want . De statistiek is de verhouding van de gedetrendeerde niveaus. In tabel 2 van het artikel is dat 50,12 gedeeld door 8,968, dus 5,59 voor de S&P over 1871–1979. De replicatie zet zijn getallen naast de onze.
Shiller gaf ook een grens voor prijsveranderingen: . Hoe beweeglijker het dividend en hoe lager de discontovoet, hoe meer de koers van jaar op jaar mag bewegen, maar niet meer dan dat. Die grens is het maximum van over alle informatiestructuren bij gegeven . In tabel 2 werd hij voor de S&P ruim vijf keer en voor de Dow ruim zeven keer overschreden.
4.4Hoe het getoetst wordt: de eindwaarde
Elke meting van hangt af van een gekozen eindwaarde, want de som in (2) loopt tot oneindig en de data houden op. Een onderzoeker die voor 1871 uitrekent, telt de dividenden tot 1979 op en moet voor de rest iets invullen. Voor 1871 weegt die rest nauwelijks, want hij ligt ver weg en wordt zwaar verdisconteerd. Voor 1975 is de rest bijna alles. Hoe dichter bij het eind van de steekproef, hoe meer de keuze bepaalt. Kiest hij een beweeglijke eindwaarde, dan stijgt de gemeten variantie van , en daalt de ratio.
Met een steekproef tot is de berekenbare versie
de dividenden tot plus een eindwaarde , over jaar verdisconteerd. Shiller nam het steekproefgemiddelde van de gedetrendeerde prijs. Met is , zodat die keuze in 1871 nauwelijks meeweegt. Er zijn twee alternatieven, elk met een eigen gevolg:
De werkelijke eindprijs, . Dan geldt de stelling exact bij een eindige horizon, want volgt uit dezelfde iteratie als in Williams en het dividend discount model. De keerzijde is dat aan het eind van de steekproef de beweeglijkheid van erft, zodat de gemeten variantie van stijgt.
Het gemiddelde of een extrapolatie, . Dan staat de voorspelfout niet meer exact los van , want gebruikt de hele steekproef. Shiller liet in zijn Nobellezing zien dat die keuze vóór 1980 nauwelijks doorwerkt Shiller (2014).
De replicatie laat zien dat de ratio over 1871–2025 met ruim een derde daalt als we van de gemiddelde naar de werkelijke eindwaarde overstappen. Het getal 5,59 bevat dus meer dan de ongelijkheid alleen.
4.5Kritiek 1: kleine steekproeven (Flavin)
In een eindige steekproef valt de gemeten variantie van te laag uit, en daardoor slaat de toets te vaak alarm. Een steekproefvariantie meet namelijk de spreiding rond het steekproefgemiddelde. Een reeks die langzaam rond zijn gemiddelde schommelt, trekt dat steekproefgemiddelde met zich mee, zodat de gemeten spreiding daalt. Hoe persistenter de reeks, hoe groter de onderschatting. Omdat een gewogen som over decennia is, is het persistenter dan . De gemeten zakt dus sterker dan , en de ratio stijgt.
Flavin (1983) liet zien dat toetsen op variantiegrenzen in kleine steekproeven daardoor vaak sterk naar verwerping vertekend zijn. Na correctie verdwijnt een groot deel van de excess volatility. Neem een AR(1)-reeks, waarin elke waarde maal de vorige plus een schok is. Over waarnemingen is de verwachte steekproefvariantie dan ongeveer
Bij en is de correctieterm , zodat de variantie 39% te laag uitvalt, en is nog persistenter dan zo’n reeks. Dit is dezelfde les als die van de standaardfout van 2% uit Rendementen en hun statistiek, in een andere gedaante. Een gemiddelde is slecht te meten, en hier bederft die onzekerheid ook een tweede moment. Een variantie is doorgaans goed te schatten, maar niet rond het gemiddelde van een zeer persistente reeks.
4.6Kritiek 2: niet-stationaire dividenden (Kleidon; Marsh en Merton)
Volgen dividenden een random walk, dan beweegt een volkomen rationele prijs langs de tijd meer dan , terwijl de grens over toestanden blijft gelden. Bij een random walk verhoogt een dividendschok de verwachting van alle toekomstige dividenden. Beleggers passen de prijs daarom in één keer volledig aan. De ex-post rationele prijs bevatte de schok al voordat die kwam, want is opgebouwd uit de latere dividenden en laat de schok geleidelijk binnenlopen naarmate die dichterbij komt. Langs de tijd springt de rationele prijs dus, en glijdt .
Kleidon (1986) betoogde daarom dat Shillers figuur geen bewijs is, omdat ook bij rationele prijzen en een constante discontovoet gladder is. Grenzen die wel gelden bij niet-stationaire dividenden werden voor de S&P volgens hem niet geschonden. De volgende propositie maakt het mechanisme exact.
Het bewijs splitst in de rationele prijs plus een voorspelfout die alleen uit toekomstige schokken bestaat. Een verandering in is één schok gedeeld door . Een verandering in is een verdisconteerde som van latere schokken, en die is kleiner.
Proof 2
Stap 1: de prijs. , dus .
Stap 2: de voorspelfout bestaat uit toekomstige schokken. Met en verwisselen van de sommen is .
Stap 3: de grens over toestanden blijft gelden. Gegeven de informatie op 0 heeft variantie . De schokken in liggen na , dus .
Stap 4: de veranderingen. . Uit volgt , omdat . Met is , dus .
Stap 5: de verhouding. De varianties zijn en . Hun quotiënt is .
Hoe lager de discontovoet, hoe sterker de rationele prijs dus reageert op een blijvende schok, terwijl die schok over meer jaren uitsmeert. Bij Shillers is de verhouding , zodat een volkomen rationele prijs van jaar op jaar zes en een half keer zo veel beweegt als , zoals de tweede verwachting uit de intuïtie zei. Dat is een verhouding van veranderingen, terwijl Shillers 5,59 een verhouding van gedetrendeerde niveaus is. De orde van grootte is dus gelijk, de statistiek niet. Bij een hogere daalt de verhouding, maar bij is hij nog .
De propositie zegt niet dat Shiller ongelijk heeft, maar wel dat zijn statistiek niets onderscheidt als dividenden een eenheidswortel hebben (schokken die blijvend zijn, zoals bij een random walk). De variantie langs de tijd groeit dan met de lengte van de steekproef en schat geen vaste grootheid. Shiller nam aan dat dividenden stationair rond een bekende trend schommelen. In dat geval geldt de stelling, en de simulatie laat zien dat de toets dan werkt, mits de afwijkingen van de trend snel uitdoven. Welke van de twee werelden de onze is, valt met honderd jaar data nauwelijks te beslissen.
Marsh & Merton (1986) gaven de niet-stationariteit een economische reden: dividend smoothing (managers passen het dividend langzaam aan hun inschatting van de blijvende winst aan, en verlagen het liever niet). Het dividend wordt dan een gewogen som van vroegere koersen. Onder zo’n beleid zijn rationele koersen niet-stationair, en wijst de steekproefversie van Shillers ongelijkheid de verkeerde kant op. Shiller antwoordde dat de dividendreeks er over een eeuw stationair rond een trend uitziet. Het debat liep vast op de vraag welk proces een onderzoeker mag veronderstellen.
4.7Het antwoord: een grens in logs
Een grens op de log-prijs-dividend-ratio ontloopt de discussie over trends, en een overschrijding van die grens betekent dat rendementen voorspelbaar zijn. De bezwaren van Kleidon en van Marsh en Merton gaan immers over niveaus die groeien, terwijl de verhouding van prijs en dividend niet groeit. Stijgt het dividend blijvend en de koers mee, dan blijft de verhouding gelijk. Delen beide dezelfde trend, dan schommelt de verhouding rond een vast niveau, ook als elk van beide een random walk volgt. Een onderzoeker die de verhouding gebruikt in plaats van de niveaus, hoeft dus geen trend te verwijderen.
Vanaf hier zijn kleine letters logs: is de log van de prijs, de log van het dividend, en de log-prijs-dividend-ratio. Het logrendement is . Campbell en Shiller Campbell & Shiller (1988) loglineariseerden het rendement, dat wil zeggen dat ze het logrendement benaderden door een lineaire functie van de log-ratio rond het gemiddelde . Met , ongeveer bij een gemiddelde prijs-dividend-ratio van 25, en een constante geeft dat
Een hoge ratio vandaag betekent dus hoge dividendgroei later, of lage rendementen later. Dat is een identiteit die achteraf geldt, en dus ook in verwachting op . Bij constante verwachte rendementen is , met de ex-post rationele log-ratio . Theorem 1 geeft dan , nu voor grootheden die stationair kunnen zijn.
Campbell en Shiller Campbell & Shiller (1987) werkten dit uit met vectorautoregressies (VAR’s, waarin elke reeks wordt geregresseerd op de vorige waarden van alle reeksen). Voor aandelen bewoog de werkelijke verhouding van koers en dividend veel meer dan de verhouding die hun VAR met constante discontovoet voorspelde. West West (1988) leidde een grens af die ook geldt als koers en dividend een eenheidswortel hebben. Onverwachte koersveranderingen mogen volgens die grens niet meer variëren dan bij een voorspeller die alleen de dividendhistorie kent, want meer informatie maakt het nieuws kleiner. Op de lange S&P-reeks was het omgekeerd, en die schending was significant.
Vermenigvuldig de tweede vorm van (8) met en neem verwachtingen. Links ontstaat . Rechts valt de constante weg, omdat , en wordt elke som een covariantie met :
In woorden: alle beweging van de ratio komt terug als voorspelling van latere dividendgroei, of als voorspelling van latere rendementen met een minteken. Varieert meer dan dividendnieuws kan dragen, dan zit het verschil in de tweede covariantie. Een ratio die te veel beweegt, voorspelt dus rendementen, en dat was ook de derde verwachting uit de intuïtie. Voor Cochrane (1992) en Cochrane (2011) werd dat het centrale punt, want excess volatility en voorspelbare rendementen zijn volgens hen één feit, twee keer gemeten. In Voorspelbaarheid van rendementen wordt deze decompositie geschat.
5Simulatie: hoe vaak slaat Shillers toets alarm?
Shillers toets werkt als dividenden rond een bekende trend schommelen en afwijkingen snel uitdoven, slaat bij persistente afwijkingen geregeld vals alarm, en altijd als dividenden een random walk volgen. We passen zijn procedure van 1981 toe op drie kunstmatige economieën waarin de prijs per constructie de rationele verwachting van is. De discontovoet is 7% op de gedetrendeerde dividenden (op de dividenden met trend ), en de steekproef telt 109 jaar, zo lang als Shillers S&P-reeks. Die getallen wijken af van de 25% en de drie perioden van het toy-voorbeeld, omdat de kunstmatige data hier op een eeuw jaarcijfers moeten lijken. We willen weten hoe vaak boven één valt terwijl de prijzen rationeel zijn.
We beginnen met een hulpfunctie die achterwaarts oplost met het recept van het toy-voorbeeld, (2), op één pad of op een matrix van paden tegelijk.
def ex_post_price(div, gross_rate, terminal):
    """Ex-post rational price p*_t = (d_{t+1} + p*_{t+1}) / R_{t+1}, solved backward.

    ``div[..., i]`` is the dividend received at the end of period ``i`` (so it
    belongs to the price at the start of ``i``); ``gross_rate`` broadcasts
    against ``div``; ``terminal`` is p* after the last period.
    """
    div = np.asarray(div, dtype=float)
    rate = np.broadcast_to(np.asarray(gross_rate, dtype=float), div.shape)
    out = np.empty_like(div)
    nxt = np.asarray(terminal, dtype=float)
    for i in range(div.shape[-1] - 1, -1, -1):
        nxt = (div[..., i] + nxt) / rate[..., i]
        out[..., i] = nxt
    return out
Met ex_post_price(path, 1.25, 0.0) geeft die functie de 22,88, 13,6 en 12 uit de eerste
stap.
De hulpfunctie log_trend schat per pad de helling van de log-reeks, en shiller_test
volgt daarna Shillers stappen, met die trend op de log-koers, ,
het gemiddelde als eindwaarde en dan de ratio. Dezelfde
functie gebruiken we straks op de echte data.
def log_trend(x):
    """OLS slope of log(x) on the year, per row."""
    t = np.arange(x.shape[1]) - (x.shape[1] - 1)
    b = np.empty(x.shape[0])
    for i in range(x.shape[0]):
        b[i] = np.polyfit(t, np.log(x[i]), deg=1)[0]
    return b


def shiller_test(P, D, terminal="mean", detrend="price", rate=None):
    """Shiller (1981) variance-bound statistic, vectorised over rows.

    ``P[:, i]`` is the real price at the start of year ``i``, ``D[:, i]`` the
    real dividend paid during year ``i``.  Both are detrended by an exponential
    trend fitted to log prices (or log dividends), p* is solved backward with
    discount rate mean(d)/mean(p) unless ``rate`` is given, and the terminal
    value is the sample mean of detrended prices (or the last price).
    """
    P, D = np.atleast_2d(P), np.atleast_2d(D)
    n_paths, T = P.shape
    t = np.arange(T) - (T - 1)                 # years relative to the last year
    b = log_trend(P if detrend == "price" else D)
    trend = np.exp(b)[:, None]
    p = P / trend**t                           # detrended price
    d = D / trend ** (t + 1)                   # detrended dividend

    if rate is None:
        rbar = d.mean(axis=1) / p.mean(axis=1)
    else:
        rbar = np.full(n_paths, rate)
    if terminal == "mean":
        end = p.mean(axis=1)
    else:
        end = p[:, -1]
    pstar = ex_post_price(d, 1 + rbar[:, None], end)

    ratio = p.std(axis=1) / pstar.std(axis=1)
    corr = np.empty(n_paths)
    for i in range(n_paths):
        corr[i] = np.corrcoef(p[i], pstar[i])[0, 1]
    return {"ratio": ratio, "corr": corr, "rbar": rbar, "b": b, "p": p, "pstar": pstar}
De functie geeft naast de ratio ook de correlatie, , de trendgroei en de gedetrendeerde reeksen terug, voor de replicatie. De drie economieën hebben alle een trendgroei van 1,5% per jaar, dicht bij Shillers :
(a) Kleidon. Log-dividenden volgen een random walk met drift 1,5% en volatiliteit 12% per jaar. Met is de rationele prijs .
(b) Shiller. Dividenden schommelen stationair rond een bekende trend. De afwijkingen volgen een AR(1) met , en de prijs is .
(c) Flavin. Hetzelfde als (b), maar met , zodat de dividenden stationair maar zeer persistent zijn.
De eerste cel bouwt economie (a), met 5 000 paden.
n_sim, T_sim, r_sim = 5_000, 109, 0.07
delta_sim = 1 / (1 + r_sim)
years = np.arange(T_sim)

# (a) log random walk dividends
mu_d, sigma_d = 0.015, 0.12
G = np.exp(mu_d + sigma_d**2 / 2)
level = np.exp(np.cumsum(rng.normal(mu_d, sigma_d, size=(n_sim, T_sim + 1)), axis=1))
P_rw = level[:, :-1] * delta_sim * G / (1 - delta_sim * G)
D_rw = level[:, 1:]
De rij level is het dividendniveau, en de koers is er een vast veelvoud van. De
volgende cel bouwt (b) en (c) met één functie voor de stationaire economie.
def stationary_economy(phi, sigma=0.05, dbar=1.0, trend=1.015):
    x = np.empty((n_sim, T_sim + 1))
    x[:, 0] = rng.normal(0.0, sigma / np.sqrt(1 - phi**2), n_sim)
    shocks = rng.normal(0.0, sigma, size=(n_sim, T_sim + 1))
    for i in range(1, T_sim + 1):
        x[:, i] = phi * x[:, i - 1] + shocks[:, i]
    price = dbar * delta_sim / (1 - delta_sim) + x[:, :-1] * delta_sim * phi / (1 - delta_sim * phi)
    return price * trend**years, (dbar + x[:, 1:]) * trend ** (years + 1)


economies = {
    "(a) random walk": (P_rw, D_rw),
    "(b) stationair, phi=0.5": stationary_economy(0.5),
    "(c) stationair, phi=0.9": stationary_economy(0.9),
}
De lus maakt de AR(1)-afwijkingen jaar na jaar aan. Nu passen we de toets toe op elk pad en vatten we de verdeling van de ratio samen.
ratios = {}
summary = pd.DataFrame(columns=["aandeel ratio > 1", "5e percentiel", "mediaan", "95e percentiel"])
for name, (P, D) in economies.items():
    ratio = shiller_test(P, D)["ratio"]
    ratios[name] = ratio
    summary.loc[name] = [np.mean(ratio > 1), np.percentile(ratio, 5),
                         np.median(ratio), np.percentile(ratio, 95)]
summary.astype(float).round(3)In (b) valt de ratio in geen enkele steekproef boven één, dus daar doet de toets waarvoor hij ontworpen is. In (c) slaat hij in bijna een op de vijf steekproeven vals alarm, en in (a) ligt de ratio in elke steekproef boven één. De figuur toont de drie verdelingen, met een zwarte lijn bij één, Shillers S&P-waarde 5,59 gestreept en zijn Dow-waarde 13,28 gestippeld.
Source
fig, ax = plt.subplots(figsize=(9, 4))
bins = np.logspace(np.log10(0.1), np.log10(20), 70)
for name, values in ratios.items():
    ax.hist(values, bins=bins, histtype="step", lw=1.6, label=name)
ax.axvline(1.0, color="black", lw=1.2)
for value, style in [(5.59, "--"), (13.28, ":")]:
    ax.axvline(value, color="grey", lw=1.0, ls=style)
ax.set_xscale("log")
ax.set_xlabel(r"$\sigma(p)/\sigma(p^*)$ volgens Shillers procedure (log-schaal)")
ax.set_ylabel("Aantal steekproeven")
ax.set_title("Rationele prijzen, 109 jaar: waar valt Shillers statistiek?")
ax.legend()
plt.show()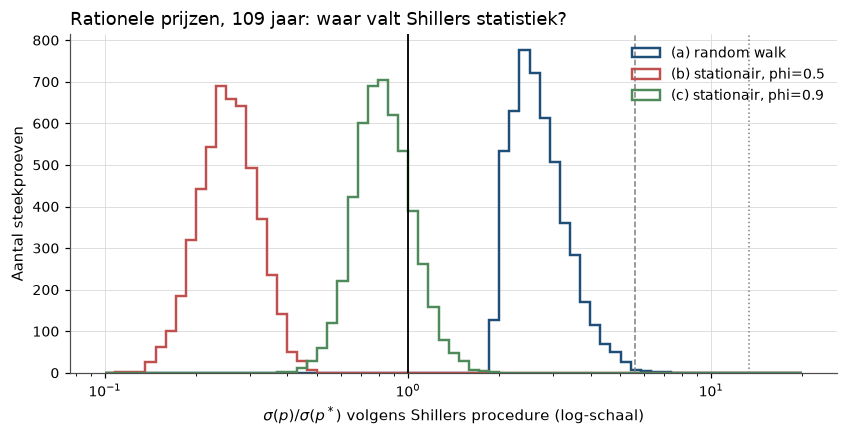
Figure 1:In alle drie de economieën zijn prijzen exact rationeel. Rechts van de zwarte lijn liggen dus alleen schendingen die de toets verzint, en de grijze lijnen markeren Shillers 5,59 (S&P) en 13,28 (Dow, kortere steekproef). Bij random-walk-dividenden (a) ligt de hele verdeling rechts, rond een factor 2,6. Bij weinig persistente dividenden (b) werkt de toets zoals bedoeld. Bij persistente dividenden (c) schuift de verdeling op naar de grens, en dat is de onderschatting van Flavin.
Persistentie maakt de toets onbetrouwbaar zonder dat er een eenheidswortel nodig is, want in (c) slokt het steekproefgemiddelde van een persistente een groot deel van zijn variantie op. In (a) werkt het mechanisme van Proposition 1, waarin de rationele prijs springt en glijdt. De formule geldt hier niet letterlijk, omdat de dividenden geometrisch met drift groeien en de toets gedetrendeerde niveaus meet in plaats van veranderingen. Daarom ligt de mediaan van 2,6 onder . Shillers 5,59 ligt wel boven het 95e percentiel van (a), 4,04, zodat de simulatie Shiller niet weerlegt. Zijn getal bewijst alleen iets voor wie gelooft dat dividenden rond een bekende trend schommelen en snel naar die trend terugkeren.
Als laatste controleren we de stelling zelf, want over toestanden en op een vaste datum moet de grens ook in (a) gelden. We rekenen uit met de ware en de rationele eindprijs, en vergelijken de variantie over de 5 000 paden op drie data.
P_T = level[:, -1] * delta_sim * G / (1 - delta_sim * G)
pstar_rw = ex_post_price(D_rw, 1 + r_sim, P_T)

check = pd.DataFrame(
    {
        "Var(p_t) over paden": [P_rw[:, t].var() for t in (10, 50, 100)],
        "Var(p*_t) over paden": [pstar_rw[:, t].var() for t in (10, 50, 100)],
    },
    index=pd.Index([10, 50, 100], name="datum t"),
)
check["grens geldt"] = check.iloc[:, 0] <= check.iloc[:, 1]
check.round(2)Op elke datum is over de paden, zoals Theorem 1 zegt, terwijl dezelfde paden langs de tijd allemaal het omgekeerde laten zien. Zo keren stap 4 en stap 6 van het toy-voorbeeld terug, maar dan op grote schaal.
6Replicatie op echte data
De eerste cel bouwt een jaarreeks met de januarikoers, het decemberdividend, het reële rendement uit de totaalrendementsindex en de reële korte rente.
shiller_raw = hap_data.shiller()
jan = shiller_raw[shiller_raw.index.month == 1]
dec = shiller_raw[shiller_raw.index.month == 12]

annual = pd.DataFrame(
    {
        "P": jan["real_price"].to_numpy(),
        "TR": jan["real_total_return_price"].to_numpy(),
        "cpi": jan["cpi"].to_numpy(),
    },
    index=jan.index.year,
).join(pd.Series(dec["real_dividend"].to_numpy(), index=dec.index.year, name="D"))

rf_nominal = hap_data.goyal_welch("annual")["Rfree"]
annual["rf_real"] = (1 + pd.Series(rf_nominal.to_numpy(), index=rf_nominal.index.year)) / (
    annual["cpi"].shift(-1) / annual["cpi"]
) - 1
annual["R"] = annual["TR"].shift(-1) / annual["TR"] - 1

data = annual.loc[1871:2025]
print(f"steekproef {data.index[0]}–{data.index[-1]}, {len(data)} jaren; "
      f"ontbrekend: {int(data[['P', 'D', 'R', 'rf_real']].isna().sum().sum())}")
columns = ["P", "D", "R", "rf_real"]
overview = pd.DataFrame(
    {
        "gemiddelde": data[columns].mean(),
        "standaarddeviatie": data[columns].std(),
        "minimum": data[columns].min(),
        "maximum": data[columns].max(),
    }
)
overview.index = ["reële koers", "reëel dividend", "reëel rendement", "reële korte rente"]
overview.round(4)
steekproef 1871–2025, 155 jaren; ontbrekend: 0
De steekproef telt 155 jaren zonder ontbrekende waarden. Het gemiddelde reële rendement is 8,6% per jaar en de gemiddelde reële rente 1,7%. We beginnen met de originele steekproef en Shillers conventies.
def run(start, end, **kwargs):
    sub = data.loc[start:end]
    out = shiller_test(sub["P"].to_numpy(), sub["D"].to_numpy(), **kwargs)
    return {key: value[0] for key, value in out.items()}


orig = run(1871, 1979)
short = run(1928, 1979)
pd.DataFrame(
    {
        "hier (S&P)": [orig["ratio"], orig["corr"], orig["b"], orig["rbar"], short["ratio"]],
        "Shiller 1981, tabel 2": [50.12 / 8.968, 0.3918, 0.0148, 0.0480, 13.28],
        "verwachting": ["3 tot 7", "onder 0,5", "enkele tienden pp", "enkele tienden pp",
                        "boven de eerste rij"],
    },
    index=["sigma(p)/sigma(p*), 1871–1979", "Corr(p, p*), 1871–1979",
           "trendgroei b, 1871–1979", "r-streep, 1871–1979",
           "sigma(p)/sigma(p*), 1928–1979 (Shiller: Dow)"],
).round(4)Geslaagd. Elke rij valt binnen wat we verwachtten, en de kortere steekproef geeft ook hier de hogere ratio. Dat onze ratio’s lager uitvallen dan die van Shiller, kan aan de deflator liggen, want een beweeglijker prijsindex zoals de WPI maakt een reële prijsreeks beweeglijker. Met de data hier is dat niet na te gaan.
Voor de figuur rekenen we ook twee niet-gedetrendeerde versies van uit, met de koers van januari 2025 als eindwaarde. De eerste verdisconteert tegen het gemiddelde reële rendement. De tweede verdisconteert tegen de reële korte rente plus een constante premie, en heeft dus elk jaar een andere discontovoet.
full = run(1871, 2025)
sub = data.loc[1871:2024]
r_const = data["R"].mean()
premium = r_const - data["rf_real"].mean()
pstar_const = ex_post_price(sub["D"].to_numpy(), 1 + r_const, data.loc[2025, "P"])
pstar_rates = ex_post_price(
    sub["D"].to_numpy(), 1 + sub["rf_real"].to_numpy() + premium, data.loc[2025, "P"]
)
De premie is het verschil tussen gemiddeld rendement en gemiddelde rente, , vrijwel de die Mehra-Prescott en Hansen-Jagannathan tot 2024 vindt. Let in de figuur links op de afstand tussen koers en , en rechts op de momenten waarop de lijnen bewegen.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
yrs = data.index
axes[0].plot(yrs, full["p"], lw=1.4, label="koers $p$")
axes[0].plot(yrs, full["pstar"], lw=1.6, ls="--", label="ex-post rationele prijs $p^*$")
axes[0].axvline(1979, color="grey", lw=0.8)
axes[0].set_xlabel("Jaar")
axes[0].set_ylabel("Gedetrendeerd reëel niveau")
axes[0].set_title("Shillers figuur 1, bijgewerkt tot 2025")
axes[0].legend()

axes[1].plot(sub.index, sub["P"], lw=1.4, label="koers $p$")
axes[1].plot(sub.index, pstar_const, lw=1.6, ls="--", label="$p^*$, constante $r$")
axes[1].plot(sub.index, pstar_rates, lw=1.2, ls=":", label="$p^*$, reële rente + premie")
axes[1].set_yscale("log")
axes[1].set_xlabel("Jaar")
axes[1].set_ylabel("Reëel niveau (log-schaal)")
axes[1].set_title("Niet gedetrendeerd, twee discontovoeten")
axes[1].legend()
plt.show()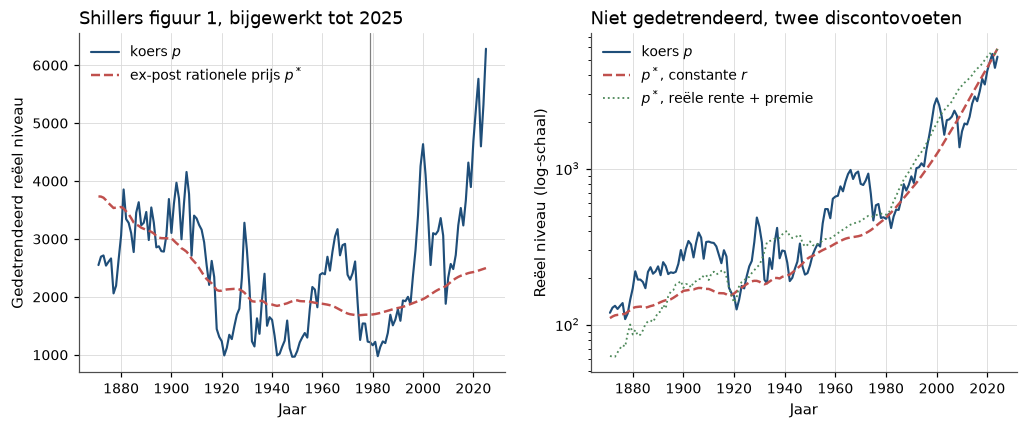
Figure 2:Links staan de gedetrendeerde reële S&P-koers en met Shillers conventies, en de verticale lijn markeert het einde van zijn steekproef. Het beeld van 1981 blijft overeind, want kabbelt en de koers niet. Rechts staan dezelfde data, niet gedetrendeerd, met tegen een constant rendement en tegen de reële rente plus premie. Tijdvariërende rentes maken beweeglijker, maar ook dan volgt de grote bewegingen van de koers maar deels.
Nu kijken we naar de gevoeligheid. Elke rij van de tabel hieronder is een verdedigbare keuze die in de stelling niet voorkomt. De log-lineaire rijen gebruiken als ratio de log van de januarikoers min de log van het dividend van het jaar ervoor, en uit (8) met de dividendgroei min het gemiddelde ervan, zonder de trend te verwijderen. De eerste cel definieert die log-lineaire grens.
def loglinear_bound(start, end, terminal="last"):
    """Campbell-Shiller variance bound on log price-dividend ratios."""
    yrs = np.arange(start, end + 1)
    pd_ratio = np.log(data.loc[yrs, "P"].to_numpy() / data.loc[yrs - 1, "D"].to_numpy())
    growth = np.log(data.loc[yrs, "D"].to_numpy() / data.loc[yrs - 1, "D"].to_numpy())
    rho = np.exp(pd_ratio.mean()) / (1 + np.exp(pd_ratio.mean()))
    x = pd_ratio - pd_ratio.mean()
    end_value = x[-1] if terminal == "last" else 0.0
    # pd*_t = (g_{t+1} - mean g) + rho * pd*_{t+1}: ex_post_price with R = 1/rho and scaled growth
    xstar = ex_post_price((growth - growth.mean()) / rho, 1 / rho, end_value)
    return x.std() / xstar.std(), np.corrcoef(x, xstar)[0, 1]
De functie lost achterwaarts op met dezelfde ex_post_price, met
in de rol van . De volgende cel draait Shillers toets met andere
steekproeven, eindwaarden, trends en discontovoeten.
se_mean_R = data["R"].std() / np.sqrt(len(data))
rows = {
    "1871–1979, Shiller-conventies": run(1871, 1979),
    "1928–1979, Shiller-conventies": run(1928, 1979),
    "1871–2025, Shiller-conventies": full,
    "1871–2025, eindwaarde = laatste koers": run(1871, 2025, terminal="last"),
    "1871–2025, trend op dividenden": run(1871, 2025, detrend="dividend"),
    "1871–2025, r-streep − 2 SE": run(1871, 2025, rate=full["rbar"] - 2 * se_mean_R),
    "1871–2025, r-streep + 2 SE": run(1871, 2025, rate=full["rbar"] + 2 * se_mean_R),
}
table = pd.DataFrame(columns=["sigma(p)/sigma(p*)", "Corr(p, p*)"])
for label, result in rows.items():
    table.loc[label] = [result["ratio"], result["corr"]]
print(f"SE van het gemiddelde reële rendement: {se_mean_R:.4f}")
SE van het gemiddelde reële rendement: 0.0143
De standaardfout van het gemiddelde rendement is 1,4 procentpunt, en de twee laatste rijen verschuiven met twee keer dat bedrag. De laatste cel voegt de rente-variant uit de figuur toe, gedetrendeerd met dezelfde trend, en de drie log-lineaire rijen.
b_sub = shiller_test(sub["P"].to_numpy(), sub["D"].to_numpy())["b"][0]
trend_sub = np.exp(b_sub) ** (np.arange(len(sub)) - (len(sub) - 1))
p_detrended = sub["P"].to_numpy() / trend_sub
pstar_rates_detrended = pstar_rates / trend_sub
table.loc["1871–2024, reële rente + premie"] = [
    p_detrended.std() / pstar_rates_detrended.std(),
    np.corrcoef(p_detrended, pstar_rates_detrended)[0, 1],
]
for label, (start, end, term) in {
    "log-lineair 1872–2024, eindwaarde = laatste": (1872, 2024, "last"),
    "log-lineair 1872–2024, eindwaarde = gemiddelde": (1872, 2024, "mean"),
    "log-lineair 1872–1979": (1872, 1979, "last"),
}.items():
    table.loc[label] = loglinear_bound(start, end, term)

table.astype(float).round(3)Geslaagd, ook voor de verwachte spreiding over keuzes. Op dezelfde data en met dezelfde stelling loopt de ratio van 0,55 (1871–2025, lage discontovoet) tot 9,8 (1928–1979), veel meer dan de verwachte factor vijf. De keuzes met het grootste effect zijn die welke Kleidon en Marsh en Merton aanwezen:
Trend. Een trend op de dividenden in plaats van op de koers maakt de ratio over 1871–2025 vijf keer zo groot. De dividenden groeiden langzamer dan de koers, zodat de koers na 1980 ver boven zijn trend komt te liggen.
Eindwaarde. De werkelijke koers als eindwaarde laat de ratio zakken naar 1,1, omdat na 1990 de koersstijging erft.
Steekproef. De keuze van de steekproef bepaalt of de jaren negentig erin zitten.
Discontovoet. Met de reële korte rente plus een constante premie is de gedetrendeerde beweeglijker dan de koers (ratio 0,83), zodat de grens voor de niveaus dan niet geschonden is. Wel bewegen en de koers maar deels samen (correlatie 0,59).
Ook hier zien we de standaardfout van 2% uit Rendementen en hun statistiek terug, want een gemiddeld rendement is slecht meetbaar. De discontovoet is zo’n gemiddelde, en twee standaardfouten verschuiven de ratio van 0,55 naar 2,36. Met een discontovoet twee standaardfouten lager is de grens niet eens geschonden. Een tweede moment is goed meetbaar, maar deze statistiek bouwt de variantie van op uit een gemiddelde, en dat is slecht meetbaar.
De log-lineaire grens is het robuuste antwoord, maar die zegt iets bescheideners. De log-prijs-dividend-ratio beweegt 1,1 tot 1,9 keer zo veel als de dividendgroei kan rechtvaardigen, afhankelijk van de eindwaarde. Dat is geen factor dertien, maar het ligt wel boven één. Het deel boven één moet volgens (9) uit voorspelbare rendementen komen, en dat past bij Williams en het dividend discount model, waar de prijs-dividend-ratio het tienjaarsrendement voorspelde en niet de tienjaarsgroei van dividenden.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. De variantiegrens is een van de weinige resultaten in het vak die uit bijna niets volgen, want er is alleen voor nodig dat een voorspelling nooit meer beweegt dan wat hij voorspelt. De grens verlegde de toets van efficiëntie naar de vraag of koersniveaus bij de fundamentele waarde passen, terwijl die toets tot dan toe vroeg of iemand morgen rijk kon worden, wat nooit bleek te lukken. Bovendien leverde hij een beeld op, de koers tegen , dat een generatie economen overtuigde. Dat rendementen op korte termijn onvoorspelbaar zijn, zoals in Fama en de efficiënte markt, betekent nog niet dat prijzen juist zijn.
Waar het breekt. Het model breekt niet in de ongelijkheid, maar in de meting ervan. Onze replicatie geeft 3,9 op Shillers steekproef, en tussen 0,55 en 9,3 over 1871–2025, afhankelijk van keuzes die de stelling niet voorschrijft. Een random-walk-economie met exact rationele prijzen schendt de gedetrendeerde toets in elke steekproef. De robuuste log-lineaire versie blijft boven één, maar is geen factor vijf tot dertien. Overeind blijft het kwalitatieve feit dat de prijs-dividend-ratio meer beweegt dan dividendnieuws kan dragen, en dat surplus is hetzelfde als voorspelbare rendementen.
Risico of vergissing? Volgens de Chicago-lezing, met Cochrane Cochrane (1992)Cochrane (2011) als woordvoerder, varieert de discontovoet. Verworpen is dan de constante van Williams, niet de rationaliteit van beleggers. In recessies eisen beleggers meer, dus zijn prijzen dan laag en rendementen daarna hoog. De Yale-lezing komt van Shiller zelf Shiller (2014), die opmerkt dat de benodigde discontovoet wild beweegt op momenten dat geen gemeten rente beweegt. Ook hier volgt de rente-variant van de koers maar matig (correlatie 0,59). Koersen reageren volgens Shiller eerder op wisselende stemmingen, animal spirits. Beide lezingen voorspellen een grote rendementscovariantie in (9). Alleen een onafhankelijke meting van de discontovoet kan de twee scheiden, en zo’n meting bestaat nog altijd nauwelijks.
Wat er daarna kwam. Als de markt als geheel te veel beweegt, zouden ook aandelen die goedkoop zijn ten opzichte van winst of boekwaarde later meer moeten opbrengen. Dat vonden Basu, Banz en Rosenberg in de cross-sectie, Basu, Banz en Rosenberg.
8Oefeningen
Solution to Exercise 1
(1) , dus .
(2) De code rekent de keten en de decompositie na.
price_C = 0.8 * states[:, 0] + 0.64 * states[:, 1] + 0.512 * 10
chain = [price_A.var(), price_B.var(), price_C.var(), pstar_0.var()]
print("A, B, C, p* :", np.round(chain, 4), "  oplopend:", bool(np.all(np.diff(chain) >= 0)))
print("Var(p*) - Var(p_C) - Var(u_C) =",
      round(pstar_0.var() - price_C.var() - (pstar_0 - price_C).var(), 12))
A, B, C, p* : [ 0. 16. 26.24 32.7936] oplopend: True
Var(p*) - Var(p_C) - Var(u_C) = 0.0
De keten loopt op en de decompositie sluit op nul. Elke stap naar meer informatie voegt dus variantie toe aan de prijs en haalt evenveel weg uit de voorspelfout.
(3) Bij volledige kennis van is en de voorspelfout overal nul. Elke extra informatie maakt de rationele prijs dus beweeglijker, en is het plafond dat bij volledige informatie hoort. Een koers boven dat plafond kan daarom niet uit meer informatie komen.
:::{exercise}
:label: ex-shiller-excess-volatility-2

**Twee grenzen.** Gebruik [](#thm-shiller-excess-volatility-kleidon) en
[](#thm-shiller-excess-volatility-bound).

1. Bereken $\sigma(\Delta p)/\sigma(\Delta p^*)$ voor
   $r \in \{0{,}02;\ 0{,}048;\ 0{,}10\}$.
2. Simuleer één pad van 200 000 jaar met $d_{t+1} = d_t + \varepsilon_{t+1}$,
   $\varepsilon \sim N(0,1)$ en $r = 0{,}048$. Benader $p^*_t$ met 400 termen plus
   de rationele eindprijs, en vergelijk de gemeten ratio met de formule.
3. Bewijs de ondergrens van LeRoy en Porter: voor een kleinere
   informatieverzameling $\mathcal H_t \subseteq \mathcal I_t$ is
   $\Var(\E[p^*_t \mid \mathcal H_t]) \le \Var(p_t)$.
Solution to ex-shiller-excess-volatility-2
(1) en (2) De formule is : , en . De code rekent die na en meet de ratio op het lange pad.
for r_val in (0.02, 0.048, 0.10):
    print(f"r = {r_val:5.3f}: formule {np.sqrt(1 + 2 / r_val):6.2f}")

r_ex, n_long, horizon = 0.048, 200_000, 400
delta_ex = 1 / (1 + r_ex)
d_long = np.cumsum(rng.normal(0.0, 1.0, n_long))
p_long = d_long / r_ex
m = n_long - horizon
pstar_long = delta_ex**horizon * p_long[horizon:]            # rational terminal price
for j in range(1, horizon + 1):                               # p*_t = sum_j delta^j d_{t+j}
    pstar_long = pstar_long + delta_ex**j * d_long[j:j + m]
print(f"gesimuleerd (r = 0.048): "
      f"{np.diff(p_long[:m]).std() / np.diff(pstar_long).std():.2f}")
r = 0.020: formule 10.05
r = 0.048: formule 6.53
r = 0.100: formule 4.58
gesimuleerd (r = 0.048): 6.54
De gesimuleerde ratio van 6,54 ligt vlak bij de 6,53 uit de formule. Op zo’n lang pad speelt de onderschatting van Flavin geen rol meer.
(3) Omdat , geeft de wet van iteratieve verwachtingen . Pas nu de variantiegrens toe met in de rol van en in de rol van : .
Wat dit leert: juist bij de lage discontovoeten waarmee Shiller rekende, is de tijdreeks van een rationele prijs het beweeglijkst ten opzichte van . Bovendien heeft de grens twee kanten, want minder informatie geeft een rustiger prijs.
:::{exercise}
:label: ex-shiller-excess-volatility-3

**De naoorlogse steekproef.** Herhaal de gevoeligheidstabel voor 1950–2025:
Shillers conventies, de laatste koers als eindwaarde, de trend op dividenden, en
de log-lineaire grens met beide eindwaarden. Is de conclusie "de prijs beweegt
te veel" in alle vijf varianten dezelfde?
Solution to ex-shiller-excess-volatility-3
De functies run en loglinear_bound doen het werk.
post = {
    "Shiller-conventies": run(1950, 2025)["ratio"],
    "eindwaarde = laatste koers": run(1950, 2025, terminal="last")["ratio"],
    "trend op dividenden": run(1950, 2025, detrend="dividend")["ratio"],
    "log-lineair, laatste": loglinear_bound(1950, 2024, "last")[0],
    "log-lineair, gemiddelde": loglinear_bound(1950, 2024, "mean")[0],
}
pd.Series(post, name="sigma(p)/sigma(p*), 1950–2025").round(3)
Shiller-conventies 3.002
eindwaarde = laatste koers 2.050
trend op dividenden 12.135
log-lineair, laatste 1.341
log-lineair, gemiddelde 2.074
Name: sigma(p)/sigma(p*), 1950–2025, dtype: float64De ratio ligt in alle varianten boven één, maar de omvang verschilt met ruim een factor negen, van 1,34 (log-lineair, laatste eindwaarde) tot 12,1 (trend op dividenden). Het teken van excess volatility is dus robuust over steekproeven en conventies, de omvang niet. Bij ruim zeventig jaar zeer persistente data hadden Flavin en Kleidon precies dat voorspeld.
- Flavin, M. A. (1983). Excess Volatility in the Financial Markets: A Reassessment of the Empirical Evidence. Journal of Political Economy, 91(6), 929–956. 10.1086/261194
- Kleidon, A. W. (1986). Variance Bounds Tests and Stock Price Valuation Models. Journal of Political Economy, 94(5), 953–1001. 10.1086/261419
- Marsh, T. A., & Merton, R. C. (1986). Dividend Variability and Variance Bounds Tests for the Rationality of Stock Market Prices. The American Economic Review, 76(3), 483–498.
- Campbell, J. Y., & Shiller, R. J. (1988). The Dividend-Price Ratio and Expectations of Future Dividends and Discount Factors. Review of Financial Studies, 1(3), 195–228. 10.1093/rfs/1.3.195
- West, K. D. (1988). Dividend Innovations and Stock Price Volatility. Econometrica, 56(1), 37–61. 10.2307/1911841
- Shiller, R. J. (1981). Do Stock Prices Move Too Much to Be Justified by Subsequent Changes in Dividends? The American Economic Review, 71(3), 421–436.
- LeRoy, S. F., & Porter, R. D. (1981). The Present-Value Relation: Tests Based on Implied Variance Bounds. Econometrica, 49(3), 555–574. 10.2307/1911512
- Shiller, R. J. (2014). Speculative Asset Prices. American Economic Review, 104(6), 1486–1517. 10.1257/aer.104.6.1486
- Campbell, J. Y., & Shiller, R. J. (1987). Cointegration and Tests of Present Value Models. Journal of Political Economy, 95(5), 1062–1088. 10.1086/261502
- Cochrane, J. H. (1992). Explaining the Variance of Price-Dividend Ratios. Review of Financial Studies, 5(2), 243–280. 10.1093/rfs/5.2.243
- Cochrane, J. H. (2011). Presidential Address: Discount Rates. Journal of Finance, 66(4), 1047–1108. 10.1111/j.1540-6261.2011.01671.x
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD