

Opties en crashrisico
1Overzicht
Wat kost verzekering tegen een crash, en wat zegt die prijs over de aandelenpremie? Optieprijzen geven een crash een risiconeutrale kans die een veelvoud is van de werkelijke, zodat een flink deel van de aandelenpremie crashpremie is. De winst van wie die verzekering verkoopt, is in rendementsdata echter niet te meten. In dit college:
lezen we uit de kromming van optieprijzen de risiconeutrale verdeling af;
leiden we af waarom de variance risk premium positief is, hoe sprongen de smirk maken en welk deel van de aandelenpremie crashpremie is;
simuleren we een verkoper van puts en vragen we welke Sharpe-ratio twintig jaar data hem laten zien;
repliceren we de linksscheve risiconeutrale verdeling van SPY, de voorspelregressie van Bollerslev, Tauchen en Zhou Bollerslev et al. (2009) en het rendement van de Cboe PutWrite-index.
Merton gaf in 1976 een prijsformule voor opties op een koers die kan springen Merton (1976), en twee jaar later lieten Breeden en Litzenberger zien dat optieprijzen de hele risiconeutrale verdeling bevatten Breeden & Litzenberger (1978). In 2010 haalden Pedro Santa-Clara en Shu Yan uit dagelijkse optieprijzen de aandelenpremie die beleggers op elk moment eisen, met een model waarin volatiliteit en crashintensiteit in de tijd variëren Santa-Clara & Yan (2010). Daarmee verschoof de vraag uit Mehra-Prescott en Hansen-Jagannathan van een gerealiseerd gemiddelde naar een prijs die de optiemarkt elke dag vaststelt. Rond dezelfde tijd toonden Saretto en Santa-Clara dat puts verkopen op papier uitstekend rendeert, maar dat marge-eisen de verkoper dwingen te sluiten juist wanneer de verzekering uitbetaalt Saretto & Santa-Clara (2009). Dat puts duur zijn, betwist niemand, maar of die prijs een beloning voor risico is of een fout die arbitrageurs zonder kapitaal laten bestaan, daarover heeft nog geen theorie het laatste woord.
2Intuïtie: waarom zou dit waar zijn?
Op 19 oktober 1987 verloor de S&P 500 ruim twintig procent op één dag. Bij een dagvolatiliteit van ongeveer één procent is dat onder Black-Scholes een uitschieter van twintig standaarddeviaties, met een kans die praktisch nul is. Sinds die dag zijn puts ver onder de koers duur, gemeten in volatiliteit. Dat patroon, te zien in Figuur 2, heet de smirk (een implied volatility die daalt naarmate de uitoefenprijs stijgt), en Bates zag erin de angst voor een nieuwe crash Bates (2000).
Waarom is die angst wel in optieprijzen te zien en nauwelijks in rendementen? Een optieprijs weegt hoe waarschijnlijk een toestand is en hoeveel een dollar in die toestand waard is. In een crash is iedereen tegelijk armer, zodat een dollar die dan wordt uitbetaald veel waard is. Daarom kost een put zoveel als hij zou kosten bij een veel grotere crashkans. Die opgeblazen kans heet de risiconeutrale kans (de kans waaronder elke belegging gemiddeld de rente oplevert), en het verschil met de werkelijke kans is de prijs van crashrisico.
Een verkoper van die verzekering verdient meestal een beetje en verliest zelden veel. Zijn gemiddelde hangt dus af van gebeurtenissen die in twintig jaar één keer of nooit voorkomen. Verkoopt hij met geleend geld, dan moet hij bovendien onderpand bijstorten zodra de markt daalt, zodat hij gedwongen stopt op het slechtste moment.
We verwachten daarom dat puts gemiddeld minder opleveren dan de rente, en dat de verwachte variantie onder risiconeutrale kansen hoger is dan de werkelijke. Een verkoper van puts verdient dan een positieve premie, maar in een korte steekproef zonder crash lijkt die premie veel groter dan ze is. In de termen van Santa-Clara draagt de verkoper risico waarvoor een premie wordt betaald, maar een onderzoeker die de hoge Sharpe-ratio van een rustige periode als bewijs neemt, denkt meer te weten dan de markt die de optieprijs vaststelt Santa-Clara (2026).
3Toy-voorbeeld: normaal op, normaal neer, crash
We laden eerst de pakketten die de rest van het college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from math import factorial
from scipy import optimize, special, stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
We nemen een Lucas-boom als in Lucas, Breeden en de SDF, waarin de markt een claim op consumptie is, zodat het bruto rendement van de markt gelijk is aan de consumptiegroei . Er zijn drie toestanden, en de representatieve belegger heeft CRRA-nut met en .
| toestand | groei | kans |
|---|---|---|
| op | ||
| neer | ||
| crash |
Het recept. De stochastische discontofactor (SDF: de toestandsafhankelijke factor waarmee payoffs worden verdisconteerd) is , en de prijs van een payoff is . De risiconeutrale kans van toestand is . Die kansen tellen op tot één, en elke prijs is de verwachte payoff onder gedeeld door het bruto ( in de setup).
Stap 1, de SDF. Per toestand is , en . In de crash is een dollar dus ruim elf keer zoveel waard als in de goede toestand.
Stap 2, de rente. De verwachte SDF is . De rente is dan .
Stap 3, de risiconeutrale kansen. , en op dezelfde manier is en . De crash krijgt dus keer zijn werkelijke kans.
Stap 4, de markt. De prijs is en de verwachte payoff is . Het verwachte rendement is dan en de aandelenpremie . Zonder crashtoestand, met de kansen herschaald tot en , geeft dezelfde rekensom .
Stap 5, een put en een call. Een put met uitoefenprijs betaalt alleen in de crash uit, en wel . Hij kost en betaalt gemiddeld uit, een bruto rendement van en dus een gemiddeld verlies van . Een call met uitoefenprijs kost en betaalt gemiddeld uit, een bruto rendement van en dus een gemiddelde winst van .
Stap 6, de variantie. Neem als gerealiseerde variantie , dus , en . Onder is de verwachting , onder is ze , en het verschil van komt vrijwel geheel uit de crash.
De code rekent de zes stappen na en zet de uitkomsten naast de handberekening.
beta_toy, gamma_toy = 0.97, 4.0
growth = np.array([1.10, 0.95, 0.60])          # gross market return = consumption growth
prob = np.array([0.65, 0.33, 0.02])            # physical probabilities: up, down, crash

m_toy = beta_toy * growth ** (-gamma_toy)      # step 1: SDF per state
Em = prob @ m_toy                              # step 2
Rf_toy = 1 / Em
q_toy = prob * m_toy / Em                      # step 3: risk-neutral probabilities


def expected_return(x, p=prob, m=m_toy):
    """Expected gross return E[x] / E[m x] of a payoff x."""
    return (p @ x) / (p @ (m * x))


premium = expected_return(growth) - Rf_toy                        # step 4
p_no_crash = prob[:2] / prob[:2].sum()                            # same economy without the crash
premium_no_crash = expected_return(growth[:2], p_no_crash, m_toy[:2]) - 1 / (p_no_crash @ m_toy[:2])
put_toy = np.maximum(0.90 - growth, 0.0)                          # step 5
call_toy = np.maximum(growth - 1.05, 0.0)
rv_toy = np.log(growth) ** 2                                      # step 6
vrp_toy = q_toy @ rv_toy - prob @ rv_toy

hand = {"m crash": 7.4846, "E[m]": 0.9733, "R^f": 1.0274, "q crash": 0.1538,
        "aandelenpremie": 0.0832, "premie zonder crash": 0.0244, "prijs put 0,90": 0.0449,
        "E[R] put 0,90": 0.1336, "E[R] call 1,05": 1.5094, "variance risk premium": 0.0332}
code = {"m crash": m_toy[2], "E[m]": Em, "R^f": Rf_toy, "q crash": q_toy[2],
        "aandelenpremie": premium, "premie zonder crash": premium_no_crash,
        "prijs put 0,90": prob @ (m_toy * put_toy), "E[R] put 0,90": expected_return(put_toy),
        "E[R] call 1,05": expected_return(call_toy), "variance risk premium": vrp_toy}
pd.DataFrame({"met de hand": hand, "code": code}).round(4)De code en de handberekening komen overeen. Omdat de markt de crash waardeert alsof hij bijna acht keer zo vaak voorkomt als hij doet, verliest de put gemiddeld 86,6%, komt ruim twee derde van de aandelenpremie uit de crash en vrijwel de hele premie op variantie.
4Theorie
De theorie gaat van optieprijzen naar de prijs van crashrisico. De kromming van optieprijzen geeft de risiconeutrale dichtheid, en daaruit volgen de momenten en het teken van de variance risk premium. Mertons sprongmodel verklaart de smirk en splitst de aandelenpremie in een diffusiedeel en een crashdeel. Tot slot volgen de rendementen van opties en de verkopers met hefboom.
4.1Opzet en notatie
De notatie volgt Black-Scholes-Merton en de CBOE. De indexprijs heet , en en zijn de prijzen van Europese calls en puts met uitoefenprijs , expiratie en looptijd . De rente is continu samengesteld en constant, in de simulatie 3% per jaar, en is de termijnkoers bij dividendrendement . De werkelijke kansmaat heet en de risiconeutrale , met dichtheden en voor . Zoals in het toy-voorbeeld krijgt elke toestand onder het gewicht van de SDF ,
4.2Breeden-Litzenberger: de verdeling zit in de kromming
Uit de prijzen van calls bij alle uitoefenprijzen volgt de hele risiconeutrale verdeling. Een handelaar die een call met uitoefenprijs koopt, er twee met verkoopt en een met koopt, heeft een butterfly (een driehoekige payoff rond ). Gedeeld door betaalt die één dollar als de koers bij eindigt, zoals een Arrow-Debreu-effect uit Ross, APT en de fundamentele stelling. Zijn prijs is dus de verdisconteerde kans op die toestand Breeden & Litzenberger (1978).
De helling van de callprijs is dus min de verdisconteerde kans dat de call uitbetaalt, en de kromming is de verdisconteerde dichtheid. Met ook in handen volgt de SDF als functie van de index, , de continue vorm van de factor uit het toy-voorbeeld. Jackwerth schatte zo de risicoaversie uit S&P 500-opties over 1986–1995 Jackwerth (2000). Na de crash van 1987 vond hij op een deel van de index negatieve waarden, dus een SDF die daar stijgt in plaats van daalt. Hij schreef dat vooral aan mispricing toe, en het verschijnsel heet sindsdien de pricing kernel puzzle.
Een praktisch bezwaar is dat een tweede afgeleide ruis versterkt, omdat een prijsfout een fout in de dichtheid van orde wordt. De numerieke oplossing hieronder laat zien hoe snel dat misgaat.
4.3Modelvrije momenten
Omdat elke butterfly een toestand is, is elke payoff die alleen van afhangt een portefeuille van opties. De risiconeutrale verwachting van zo’n payoff is daardoor in de markt af te lezen, en dat geldt ook voor de momenten van het rendement.
Het bewijs is een Taylorontwikkeling van rond met integraalrestterm, waarin elke restterm de payoff van een optie buiten het geld is. Het eerste moment levert de VIX-formule uit Theorem 4 op, want zonder sprongen is de risiconeutrale verwachte variantie min tweemaal . Met het tweede en derde moment vonden Bakshi, Kapadia en Madan dat afzonderlijke aandelen veel minder linksscheef zijn dan de index Bakshi et al. (2003). De linkerstaart is dus een eigenschap van het marktrisico, dat niet weg te diversifiëren valt.
4.4De variance risk premium
Opties zijn gemiddeld duur, omdat de variantie hoog is op de momenten dat een dollar veel waard is. Een variance swap betaalt op de gerealiseerde variantie min een vaste prijs uit. Het contract kost niets om aan te gaan, zodat die vaste prijs de risiconeutrale verwachting van de variantie is. Met de gerealiseerde variantie over definiëren we
De premie is dus het bedrag waarmee de risiconeutrale verwachte variantie boven de werkelijke ligt. Carr en Wu gebruiken het omgekeerde teken Carr & Wu (2009), maar wij volgen Bollerslev, Tauchen en Zhou, zodat het getal positief is als opties duur zijn.
De SDF is hoog als de markt daalt, en de variantie ook, door het leverage effect (volatiliteit stijgt na dalingen) uit ARCH, GARCH, realized volatility en de VIX. Samen maken ze de premie positief, wat de verwachting uit het begin van het college bevestigt. In het toy-voorbeeld is ze , en op echte data lag ze in Figuur 3 gemiddeld rond vier volatiliteitspunten. Bollerslev, Tauchen en Zhou vonden bovendien dat een hoge premie na 1990 hoge latere marktrendementen voorspelde Bollerslev et al. (2009).
4.5Sprongen: het model van Merton
Een sprong in de koers maakt vooral diepe puts duur, omdat hij de linkerstaart dikker maakt en omdat een optieverkoper zich er niet tegen kan hedgen. De delta-hedge uit Black-Scholes-Merton en de CBOE werkt alleen als de koers continu beweegt. Een sprong laat geen tijd om bij te stellen, zodat de optieprijs afhangt van hoe beleggers sprongrisico waarderen. Merton schreef onder
Hier telt de sprongen, met intensiteit (in de simulatie per jaar, ongeveer eens in de zes jaar). De factor is de koers na een sprong gedeeld door de koers ervoor, in de simulatie gemiddeld , en is de gemiddelde relatieve sprong. De term compenseert de verwachte sprong, zodat de index onder de rente blijft verdienen Merton (1976).
Het bewijs conditioneert op het aantal sprongen . Gegeven is normaal, met dezelfde verwachting en variantie als onder Black-Scholes met en , en middelen over de Poisson-kansen geeft de formule. De optieprijs is dus een gewogen gemiddelde van Black-Scholes-prijzen in werelden met nul, één of meer sprongen. Zo’n mengsel van normale verdelingen heeft dikke staarten, met vooral links, zodat diepe puts een hoge implied volatility krijgen, het sterkst bij korte looptijden.
Merton nam aan dat sprongrisico diversifieerbaar is, zodat sprongen onder even vaak voorkomen als onder , maar de data spreken dat tegen. Bates vond op S&P 500-futuresopties dat stochastische volatiliteit zonder sprongen de scheefheid alleen met onplausibele parameters verklaart Bates (2000). Pan schatte de index en de optieprijzen in één model en vond een premie op sprongrisico die stijgt als de markt volatiel wordt Pan (2002).
4.6Hoeveel van de aandelenpremie is crashpremie?
Als crashes onder vaker of dieper zijn dan onder , betalen beleggers voor crashrisico een eigen premie, naast de premie voor gewone schommelingen. Het deel van de drift dat de verwachte sprong compenseert, verschilt daardoor tussen de twee maten, en dat verschil is het extra rendement voor sprongen.
De aandelenpremie bestaat dus uit een vergoeding voor gewone schommelingen (in de kalibratie hieronder bij ) en een crashpremie. Santa-Clara en Yan schatten beide dagelijks uit S&P 500-opties van 1996 tot en met 2002 Santa-Clara & Yan (2004). De tabel zet hun hoofdgetallen uit de werkdocumentversie naast onze kalibratie.
| grootheid | Santa-Clara en Yan | onze kalibratie |
|---|---|---|
| volatiliteit | diffusie | diffusie, met sprongen |
| sprongintensiteit onder (per jaar) | ||
| sprongintensiteit onder (per jaar) | ||
| gemiddelde sprong onder | ||
| aandelenpremie | ||
| waarvan crashpremie |
Crashes zijn bij Santa-Clara en Yan onder twee keer zo waarschijnlijk als onder , zodat beleggers crashes zwaarder wegen dan hun kans. Het crashdeel is iets minder dan een derde van de premie en schommelt tussen nul en bijna twee derde. De gepubliceerde versie meldt bovendien dat de uit opties afgeleide premie latere marktrendementen voorspelt Santa-Clara & Yan (2010).
In hun steekproef was het gerealiseerde overrendement van de S&P 500 per jaar, zodat zeven jaar rendementen niets over de premie zeggen en zeven jaar optieprijzen wel. Over zo’n korte horizon speelt de standaardfout van 2% in versterkte vorm, want bij een volatiliteit van heeft een gemiddeld rendement over zeven jaar een standaardfout van procentpunt.
4.7Verwachte optierendementen
Een verkoper van puts ontvangt precies wat de koper gemiddeld verliest, dus voordat we de verkoper bekijken, ordenen we de verwachte rendementen van opties. Als de SDF daalt in de index, leveren calls meer op dan de index en puts minder dan de rente. Het effect is sterker naarmate de optie verder in de staart ligt. Een call is namelijk een gehefboomde claim op de goede toestanden en een put op de slechte, en goede toestanden zijn goedkoop terwijl slechte duur zijn.
Het bewijs schrijft elke optie als de vorige payoff maal een monotone functie van , bijvoorbeeld . Twee functies van met tegengestelde monotonie hebben een negatieve covariantie, zodat een factor die stijgt in het verwachte rendement verhoogt en een factor die daalt het verlaagt.
Het toy-voorbeeld laat de ordening al zien. De call met uitoefenprijs levert op, ruim boven de van de markt, en de put met verliest gemiddeld . Coval en Shumway vonden dat S&P 500-opties deze ordening consequent vertonen Coval & Shumway (2001). Een straddle (een call plus een put met dezelfde uitoefenprijs en looptijd) met bèta nul verloor bij hen ongeveer drie procent per week, terwijl zo’n positie onder het CAPM de rente zou moeten verdienen. Broadie, Chernov en Johannes relativeerden die verliezen, omdat het gemiddelde rendement van een put zo onzeker is dat zulke verliezen met Black-Scholes verenigbaar blijven Broadie et al. (2009).
4.8Marges en de verkoper van puts
Een verkoper van puts met hefboom gaat al failliet bij een crash die veel kleiner is dan de daling waarbij hij het volle notionele bedrag moet betalen. Deze verkoper is de gehefboomde arbitrageur uit VaR, RiskMetrics en LTCM, maar dan met een verlies dat in één sprong komt. Laat een belegger met eigen vermogen een aantal puts verkopen met uitoefenprijs tegen premie , en noem zijn notionele hefboom (de nominale verplichting per dollar eigen vermogen).
De drempel daalt dus met , net als de verbreding waarbij het gehefboomde fonds in Proposition 3 moet stoppen, terwijl de Sharpe-ratio niet van afhangt. De margin call (de eis om onderpand bij te storten, op straffe van gedwongen sluiting) komt nog eerder, omdat de beurs een buffer boven de intrinsieke waarde eist. Saretto en Santa-Clara namen die regels mee voor opties op de S&P 500 van 1985 tot 2002 Saretto & Santa-Clara (2009). In hun werkdocumentversie verdient een verkochte put op 10% onder de koers gemiddeld van de ontvangen premie per maand, met een scheefheid van . Die scheefheid is het mechanisme van de propositie, want één crash vaagt in één keer jaren premie weg.
Als transactiekosten en margin calls worden meegenomen, wordt de Sharpe-ratio van sommige van de beste strategieën negatief. De auteurs concluderen dat optiemarkten grote mispricings bevatten die door die kosten en marge-eisen niet weg te arbitreren zijn. Die conclusie volgt de logica van Shleifer en Vishny uit Behavioral finance en limits of arbitrage en de verliesspiraal uit (14), waarin een arbitrageur die verliest moet verkopen, zodat de prijs verder van zijn waarde raakt.
4.9Numerieke oplossing: een gekalibreerd sprongmodel
Een concrete kalibratie laat zien dat één crashtoestand genoeg is voor een steile smirk en een crashpremie van ruim twee procentpunt. We kiezen de orde van grootte van Santa-Clara en Yan:
een diffusievolatiliteit van 15% en een rente van 3% per jaar;
een gemiddelde sprong van met spreiding ;
een sprongintensiteit van per jaar onder en onder ;
een diffusiepremie van 3,5%.
De code rekent Theorem 2 uit met de Black-formule voor opties op een termijnkoers, zodat dezelfde functies straks ook op SPY-opties werken.
def black_price(F, K, T, sigma, DF, kind="call"):
    """Black (1976) price of a European option on a forward F with discount factor DF."""
    s = sigma * np.sqrt(T)
    d1 = (np.log(F / K) + 0.5 * s**2) / s
    call = DF * (F * special.ndtr(d1) - K * special.ndtr(d1 - s))
    return np.where(np.asarray(kind) == "call", call, call - DF * (F - K))


def implied_vol(price, F, K, T, DF, kind="call", n_iter=80):
    """Invert black_price for sigma by vectorised bisection."""
    lo, hi = np.full(np.shape(price), 1e-4), np.full(np.shape(price), 5.0)
    for _ in range(n_iter):
        mid = 0.5 * (lo + hi)
        below = black_price(F, K, T, mid, DF, kind) < price
        lo, hi = np.where(below, mid, lo), np.where(below, hi, mid)
    return 0.5 * (lo + hi)


def merton_price(S, K, T, r, sigma, lam, mu_j, delta_j, kind="call", n_max=40):
    """Merton (1976) jump-diffusion price as a Poisson mixture of Black-Scholes prices."""
    T = np.maximum(T, 1e-8)
    kappa = np.exp(mu_j + 0.5 * delta_j**2) - 1
    lam_prime = lam * (1 + kappa) * T
    price = 0.0
    for n in range(n_max):
        sigma_n = np.sqrt(sigma**2 + n * delta_j**2 / T)
        r_n = r - lam * kappa + n * np.log1p(kappa) / T
        weight = np.exp(-lam_prime) * lam_prime**n / factorial(n)
        price = price + weight * black_price(S * np.exp(r_n * T), K, T, sigma_n, np.exp(-r_n * T), kind)
    return price


def merton_log_density(x, T, r, sigma, lam, mu_j, delta_j, n_max=40):
    """Risk-neutral density of log(S_T / S_0) in the Merton model."""
    kappa = np.exp(mu_j + 0.5 * delta_j**2) - 1
    dens = 0.0
    for n in range(n_max):
        mean = (r - lam * kappa - 0.5 * sigma**2) * T + n * mu_j
        dens = dens + stats.poisson.pmf(n, lam * T) * stats.norm.pdf(x, mean, np.sqrt(sigma**2 * T + n * delta_j**2))
    return dens


R_SIM, SIGMA_SIM, DELTA_J = 0.03, 0.15, 0.10
MU_J = np.log(0.70) - 0.5 * DELTA_J**2          # mean jump E[J - 1] = -30%
LAM_Q, LAM_P, ETA_SIGMA = 0.165, 0.078, 0.035    # jump intensities per year; diffusive premium
KAPPA = np.exp(MU_J + 0.5 * DELTA_J**2) - 1
jump_premium = (LAM_P - LAM_Q) * KAPPA
qv_q = SIGMA_SIM**2 + LAM_Q * (MU_J**2 + DELTA_J**2)
qv_p = SIGMA_SIM**2 + LAM_P * (MU_J**2 + DELTA_J**2)
print(f"kappa = {KAPPA:.4f}; sprongpremie = {jump_premium:.4f}; diffusiepremie = {ETA_SIGMA:.4f}; "
      f"equity premium = {jump_premium + ETA_SIGMA:.4f}")
print(f"verwachte variantie Q: {qv_q:.4f} (vol {np.sqrt(qv_q):.4f}); P: {qv_p:.4f} (vol {np.sqrt(qv_p):.4f})")

moneyness = np.array([0.80, 0.85, 0.90, 0.95, 1.00, 1.05, 1.10])
smirk_table = pd.DataFrame(
    {
        f"T = {label}": implied_vol(
            merton_price(100.0, 100.0 * moneyness, T, R_SIM, SIGMA_SIM, LAM_Q, MU_J, DELTA_J),
            100.0 * np.exp(R_SIM * T), 100.0 * moneyness, T, np.exp(-R_SIM * T))
        for label, T in (("1 maand", 1 / 12), ("3 maanden", 0.25), ("1 jaar", 1.0))
    },
    index=pd.Index(moneyness, name="K / S"),
)
(100 * smirk_table).round(2)
kappa = -0.3000; sprongpremie = 0.0261; diffusiepremie = 0.0350; equity premium = 0.0611
verwachte variantie Q: 0.0457 (vol 0.2139); P: 0.0335 (vol 0.1830)
Volgens Proposition 3 is de crashpremie , ruim twee vijfde van een aandelenpremie van . De risiconeutrale volatiliteit is en de werkelijke , een variance risk premium van ruim drie volatiliteitspunten. In de tabel daalt de implied volatility bij één maand van op 80% van de spot naar at-the-money, terwijl ze bij een jaar veel vlakker loopt. De diffusiespreiding groeit namelijk met de looptijd, terwijl één sprong even groot blijft, zodat een sprong van over een jaar veel minder uitsteekt en het mengsel (6) dichter bij een normale verdeling komt.
Daarna gaan we de omgekeerde weg. We simuleren twee miljoen koersen op één maand onder en nemen de tweede differentie uit Theorem 1 van de gesimuleerde, de exacte en de afgeronde callprijzen.
T_BL, N_MC = 1 / 12, 2_000_000
n_jumps = rng.poisson(LAM_Q * T_BL, N_MC)
log_ret = ((R_SIM - LAM_Q * KAPPA - 0.5 * SIGMA_SIM**2) * T_BL
           + SIGMA_SIM * np.sqrt(T_BL) * rng.standard_normal(N_MC)
           + n_jumps * MU_J + np.sqrt(n_jumps) * DELTA_J * rng.standard_normal(N_MC))
S_T = 100.0 * np.exp(log_ret)
DF_BL = np.exp(-R_SIM * T_BL)


def breeden_litzenberger(K, C, DF):
    """Density of S_T from call prices on an equally spaced strike grid (central second difference)."""
    dK = K[1] - K[0]
    return K[1:-1], (C[2:] - 2 * C[1:-1] + C[:-2]) / (dK**2 * DF)


bl_rows, bl_curves = [], {}
for dK in (2.0, 1.0, 0.25):
    K_grid = np.arange(50.0, 125.0 + dK / 2, dK)
    C_exact = merton_price(100.0, K_grid, T_BL, R_SIM, SIGMA_SIM, LAM_Q, MU_J, DELTA_J)
    C_mc = DF_BL * np.array([np.maximum(S_T - k, 0.0).mean() for k in K_grid])
    C_quote = C_exact + rng.uniform(-0.005, 0.005, len(K_grid))      # half-cent quote rounding
    K_mid, _ = breeden_litzenberger(K_grid, C_exact, DF_BL)
    true = merton_log_density(np.log(K_mid / 100.0), T_BL, R_SIM, SIGMA_SIM, LAM_Q, MU_J, DELTA_J) / K_mid
    for label, C in (("exacte prijzen", C_exact), ("Monte Carlo, 2 mln paden", C_mc),
                     ("exact + afronding 0,5 cent", C_quote)):
        _, dens = breeden_litzenberger(K_grid, C, DF_BL)
        bl_rows.append({"Delta K": dK, "prijzen": label,
                        "RMSE dichtheid": np.sqrt(np.mean((dens - true) ** 2)),
                        "max |fout|": np.abs(dens - true).max(),
                        "massa": np.sum(dens) * dK})
        bl_curves[(dK, label)] = (K_mid, dens, true)
pd.DataFrame(bl_rows).set_index(["Delta K", "prijzen"]).round(5)Met exacte prijzen daalt de fout met , en met Monte Carlo-prijzen blijft ze door simulatieruis steken. Een afronding op een halve cent laat de fout daarentegen exploderen, want bij is de RMSE , 57 keer zoveel als bij . Dichtere uitoefenprijzen maken het dus erger, en daarom fitten we in de replicatie eerst een gladde smile.
De figuur toont links de smirk per looptijd en rechts de tweede bult in de dichtheid rond een koers van 70.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
for i, col in enumerate(smirk_table.columns):
    axes[0].plot(100 * smirk_table.index, 100 * smirk_table[col], "o-", color=hap.plotting.COLORS[i], label=col)
axes[0].axhline(100 * SIGMA_SIM, color="black", lw=0.8, ls="--", label="diffusievolatiliteit")
axes[0].set_title("(a) Implied volatility in het Merton-model")
axes[0].set_xlabel("Uitoefenprijs (% van de spot)")
axes[0].set_ylabel("Implied volatility (%)")
axes[0].legend()

K_mid, dens_mc, true = bl_curves[(1.0, "Monte Carlo, 2 mln paden")]
_, dens_noise, _ = bl_curves[(0.25, "exact + afronding 0,5 cent")]
lognormal = stats.lognorm.pdf(K_mid, s=smirk_table.loc[1.00, "T = 1 maand"] * np.sqrt(T_BL),
                              scale=100.0 * np.exp((R_SIM - 0.5 * smirk_table.loc[1.00, "T = 1 maand"] ** 2) * T_BL))
axes[1].plot(K_mid, true, color="black", lw=1.6, label="ware Q-dichtheid")
axes[1].plot(K_mid, dens_mc, ".", ms=4, color=hap.plotting.COLORS[0], label="Breeden-Litzenberger uit Monte Carlo (ΔK = 1)")
axes[1].plot(K_mid, lognormal, color=hap.plotting.COLORS[1], ls="--", label="lognormaal bij ATM-volatiliteit")
axes[1].set_yscale("log")
axes[1].set_ylim(1e-5, 0.2)
axes[1].set_title("(b) Risiconeutrale dichtheid, looptijd 1 maand")
axes[1].set_xlabel("Koers op expiratie $S_T$")
axes[1].set_ylabel("Dichtheid (log-schaal)")
axes[1].legend(fontsize=8)
fig.tight_layout()
plt.show()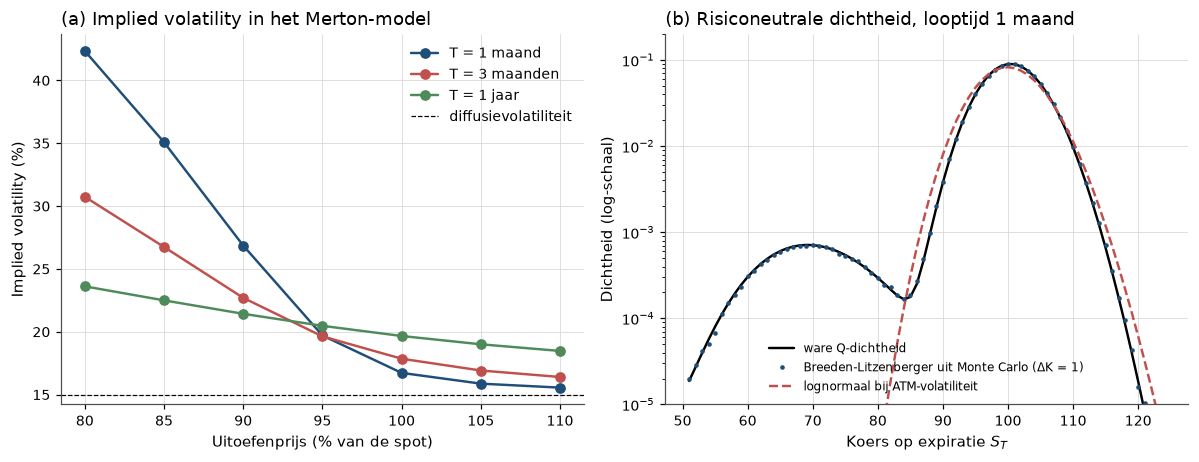
Figure 1:Links: één crashtoestand volstaat voor een smirk die steil is bij korte en vlak bij lange looptijden. Rechts: de risiconeutrale dichtheid heeft een tweede bult rond 70, de crash, die de lognormale verdeling met dezelfde at-the-money-volatiliteit volledig mist.
De risiconeutrale dichtheid is dus tweetoppig, en Breeden-Litzenberger vindt de tweede top uit gesimuleerde prijzen terug. Een belegger die alleen de at-the-money-volatiliteit kent, ziet de crash niet.
5Simulatie: dertig jaar puts verkopen
We willen weten welke Sharpe-ratio een onderzoeker met twintig jaar data ziet bij het verkopen van puts, terwijl de crashpremie uit de numerieke oplossing werkelijk bestaat. Een belegger verkoopt elke maand een put op 5% onder de koers, en in een tweede variant at-the-money, zoals de Cboe PutWrite-index. In de gecollateraliseerde variant staat de uitoefenprijs in kas, zodat hij niet failliet kan gaan.
In de gehefboomde variant stort hij een veelvoud van een gestileerde marge-eis en wordt hij dagelijks gewaardeerd met (6). Zakt zijn vermogen onder de eis, dan wordt hij uitgeschud, wat betekent dat hij tegen de dagprijs moet terugkopen en stoppen. We simuleren tweeduizend paden van dertig jaar, met prijzen uit en koersen uit , en noemen een sprong van meer dan een crash.
def merton_put_fast(S, K, tau):
    """Merton put price with the simulation parameters, truncated at 8 jumps (enough for tau <= 1 month)."""
    return merton_price(S, K, tau, R_SIM, SIGMA_SIM, LAM_Q, MU_J, DELTA_J, kind="put", n_max=8)


def margin_requirement(S, K, P):
    """Stylised naked short-put margin: premium plus max(15% of spot minus OTM amount, 10% of strike)."""
    return P + np.maximum(0.15 * S - np.maximum(S - K, 0.0), 0.10 * K)


N_PATHS, YEARS, DAYS_M, OTM = 2000, 30, 21, 0.05
DT, TAU = 1 / 252, 21 / 252
MULTIPLES = np.array([10.0, 5.0, 3.0, 2.0, 1.5])[:, None]      # capital as multiple of initial margin
MU_P = R_SIM + ETA_SIGMA + jump_premium                        # physical expected return


def step(S):
    """One trading day of the physical jump-diffusion; returns new price and a crash flag (jump below -15%)."""
    n = rng.poisson(LAM_P * DT, len(S))
    jump = n * MU_J + np.sqrt(n) * DELTA_J * rng.standard_normal(len(S))
    diffusion = (MU_P - LAM_P * KAPPA - 0.5 * SIGMA_SIM**2) * DT + SIGMA_SIM * np.sqrt(DT) * rng.standard_normal(len(S))
    return S * np.exp(diffusion + jump), (n > 0) & (jump < np.log(0.85))


S = np.full(N_PATHS, 100.0)
equity = np.ones((len(MULTIPLES), N_PATHS))
alive = np.ones_like(equity, dtype=bool)
put_ret, atm_ret, mkt_ret, crash, notional = [], [], [], [], []
for month in range(12 * YEARS):
    S0 = S.copy()
    K, K_atm = (1 - OTM) * S0, S0
    P0, P0_atm = merton_put_fast(S0, K, TAU), merton_put_fast(S0, K_atm, TAU)
    contracts = equity / (MULTIPLES * margin_requirement(S0, K, P0))
    cash = equity + contracts * P0
    notional.append(np.where(alive, contracts * K / np.maximum(equity, 1e-12), np.nan))
    crashed = np.zeros(N_PATHS, dtype=bool)
    for day in range(1, DAYS_M + 1):
        S, flag = step(S)
        crashed |= flag
        cash = cash * np.exp(R_SIM * DT)
        P_t = merton_put_fast(S, K, TAU - day * DT) if day < DAYS_M else np.maximum(K - S, 0.0)
        marked = cash - contracts * P_t
        if day < DAYS_M:
            # during the month: a margin call forces a close-out at today's price
            call = alive & (marked < contracts * margin_requirement(S, K, P_t))
        else:
            # expiry: the seller is ruined only if the payout exceeds his cash
            call = alive & (marked <= 0)
            # expiry without ruin: the marked-to-market equity funds next month
            equity = np.where(alive & ~call, marked, equity)
        # close-out: equity is what is left after buying back, floored at zero
        equity = np.where(call, np.maximum(marked, 0.0), equity)
        alive &= ~call
    growth_rf = np.exp(R_SIM * TAU)
    put_ret.append(((K + P0) * growth_rf - np.maximum(K - S, 0.0)) / K - 1)
    atm_ret.append(((K_atm + P0_atm) * growth_rf - np.maximum(K_atm - S, 0.0)) / K_atm - 1)
    mkt_ret.append(S / S0 - 1)
    crash.append(crashed)

put_ret, atm_ret, mkt_ret, crash = map(np.array, (put_ret, atm_ret, mkt_ret, crash))
rf_month = np.exp(R_SIM * TAU) - 1
p0_start = float(merton_put_fast(100.0, 95.0, TAU))
print(f"{N_PATHS} paden x {YEARS} jaar; crashes per jaar: {crash.mean() * 12:.4f}")
print(f"put 5% OTM bij S = 100: premie {p0_start:.4f}, initiële marge "
      f"{float(margin_requirement(100.0, 95.0, p0_start)):.4f}")
2000 paden x 30 jaar; crashes per jaar: 0.0762
put 5% OTM bij S = 100: premie 0.5113, initiële marge 10.5113
Crashes komen keer per jaar voor, dicht bij de kalibratie. De put op 5% onder de koers kost bij een index van 100 een premie van , tegen een marge-eis van .
Voor de gecollateraliseerde strategieën berekenen we de Sharpe-ratio, de scheefheid en de maximale drawdown, per pad en over alle paden samen.
def path_stats(returns):
    """Annualised Sharpe ratio, monthly skewness and maximum drawdown per path (columns)."""
    excess = returns - rf_month
    wealth = np.cumprod(1 + returns, axis=0)
    return {"Sharpe": np.sqrt(12) * excess.mean(0) / excess.std(0, ddof=1),
            "scheefheid": stats.skew(returns, axis=0),
            "max drawdown": (wealth / np.maximum.accumulate(wealth, axis=0) - 1).min(0)}


strategies = {"markt": mkt_ret, "short put ATM, gecollateraliseerd": atm_ret,
              "short put 5% OTM, gecollateraliseerd": put_ret}
pooled = {name: np.sqrt(12) * (r - rf_month).mean() / (r - rf_month).std() for name, r in strategies.items()}
sim_summary = pd.DataFrame(
    {name: {"Sharpe (populatie)": pooled[name],
            "Sharpe, mediaan per 30 jaar": np.median(path_stats(r)["Sharpe"]),
            "Sharpe, 5%-kwantiel": np.quantile(path_stats(r)["Sharpe"], 0.05),
            "Sharpe, 95%-kwantiel": np.quantile(path_stats(r)["Sharpe"], 0.95),
            "scheefheid (mediaan)": np.median(path_stats(r)["scheefheid"]),
            "max drawdown (mediaan)": np.median(path_stats(r)["max drawdown"])}
     for name, r in strategies.items()}
).T
sim_summary.round(3)Over alle paden samen heeft de verkoper van puts op 5% onder de koers een Sharpe-ratio van , tegen voor de markt. Omdat in dit model alleen de sprongen onder duurder zijn en de gewone schommelingen niet, is die Sharpe-ratio een ondergrens voor wat een verkoper haalt in een markt waarin ook schommelingen in de volatiliteit een premie dragen. De maandelijkse scheefheid van de verkochte put is , dicht bij de waarde van Saretto en Santa-Clara. Per pad van dertig jaar loopt de Sharpe-ratio van de verkoper tussen het 5%- en het 95%-kwantiel van nul tot .
De tweede tabel geeft voor de gehefboomde verkoper de notionele hefboom en de kans om binnen dertig jaar uitgeschud te worden.
margin_summary = pd.DataFrame(
    {"kapitaal / initiële marge": MULTIPLES.ravel(),
     "notionele hefboom (gem.)": np.nanmean(np.array(notional), axis=(0, 2)),
     "P(uitgeschud binnen 30 jaar)": 1 - alive.mean(1)}
).set_index("kapitaal / initiële marge")
margin_summary.round(3)Een verkoper die tien keer de marge stort, heeft een hefboom onder één en wordt in een half procent van de paden uitgeschud. Bij vijf keer de marge, een hefboom van , gebeurt dat al in 80% van de paden. Ruïne vraagt bij die hefboom volgens Proposition 4 een crash van ruim 58%, maar de margin call komt veel eerder, omdat een sprong van de put diep in het geld brengt. Uitgeschud worden is hier dus bijna hetzelfde als de eerste crash meemaken.
Welke Sharpe-ratio ziet dan een onderzoeker met twintig jaar data? We knippen elk pad na 240 maanden af en splitsen de steekproeven naar de vraag of er een crash in zat.
window = 240
ex20 = put_ret[:window] - rf_month
sharpe20 = np.sqrt(12) * ex20.mean(0) / ex20.std(0, ddof=1)
no_crash = crash[:window].sum(0) == 0
p_theory = np.exp(-window * crash.mean())
pd.DataFrame(
    {"fractie steekproeven": [no_crash.mean(), 1 - no_crash.mean()],
     "Sharpe mediaan": [np.median(sharpe20[no_crash]), np.median(sharpe20[~no_crash])],
     "Sharpe 90%-kwantiel": [np.quantile(sharpe20[no_crash], 0.9), np.quantile(sharpe20[~no_crash], 0.9)],
     "fractie Sharpe > 2 x populatie": [np.mean(sharpe20[no_crash] > 2 * pooled["short put 5% OTM, gecollateraliseerd"]),
                                        np.mean(sharpe20[~no_crash] > 2 * pooled["short put 5% OTM, gecollateraliseerd"])]},
    index=["geen crash in 20 jaar", "minstens één crash"],
).round(3)Zonder crash ligt de mediane Sharpe-ratio van de verkoper op , met minstens één crash op . Links in de figuur liggen de twee histogrammen ver uit elkaar, en rechts stijgt de kans op uitschudden steil met de hefboom.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
bins = np.linspace(-0.5, 4.0, 46)
axes[0].hist(sharpe20[no_crash], bins=bins, alpha=0.6, color=hap.plotting.COLORS[0], label="geen crash in de steekproef")
axes[0].hist(sharpe20[~no_crash], bins=bins, alpha=0.6, color=hap.plotting.COLORS[1], label="minstens één crash")
axes[0].axvline(pooled["short put 5% OTM, gecollateraliseerd"], color="black", lw=1.2, label="populatie")
axes[0].set_title("(a) Sharpe-ratio van short puts over 20 jaar")
axes[0].set_xlabel("Geannualiseerde Sharpe-ratio")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].legend()
axes[1].plot(margin_summary["notionele hefboom (gem.)"], margin_summary["P(uitgeschud binnen 30 jaar)"], "o-")
for mult, row in margin_summary.iterrows():
    axes[1].annotate(f"{mult:g}x marge", (row["notionele hefboom (gem.)"], row["P(uitgeschud binnen 30 jaar)"]),
                     textcoords="offset points", xytext=(6, -10), fontsize=8)
axes[1].set_title("(b) Kans om binnen 30 jaar uitgeschud te worden")
axes[1].set_xlabel("Notionele hefboom (strike x contracten / eigen vermogen)")
axes[1].set_ylabel("Fractie paden")
fig.tight_layout()
plt.show()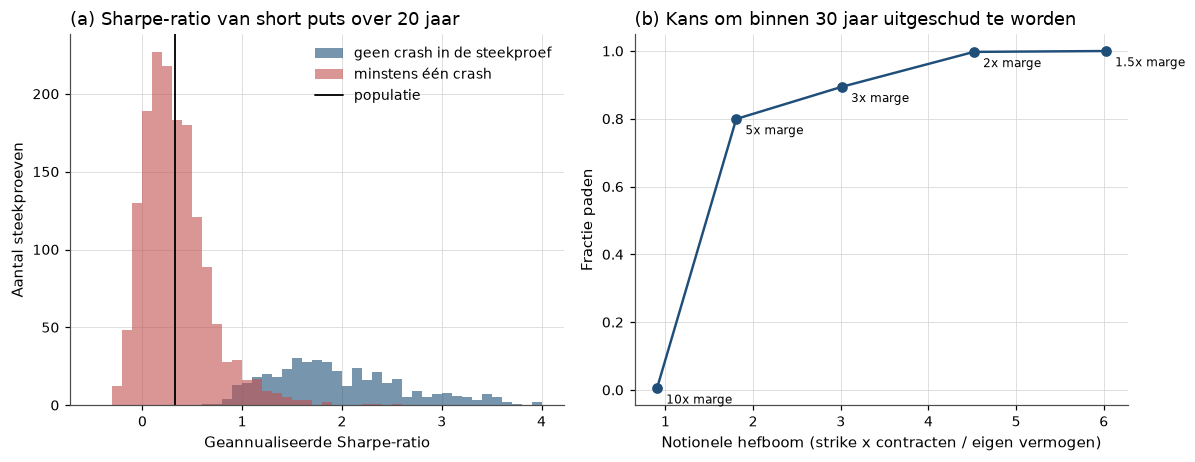
Figure 2:Links: twintig jaar verkochte puts zonder crash geven een Sharpe-ratio rond de twee, met één crash rond de populatiewaarde van een derde. Rechts: de kans om uitgeschud te worden stijgt steil met de hefboom, lang voordat het vermogen op nul staat.
De twee verdelingen overlappen nauwelijks, zodat de Sharpe-ratio van een steekproef vooral meet of er een crash in zat. In 21,4% van de steekproeven komt geen crash voor, zoals een Poisson-proces voorspelt, want . In elk van die steekproeven is de Sharpe-ratio meer dan het dubbele van de populatiewaarde.
Een onderzoeker met zo’n steekproef rapporteert een significante anomalie. De gebruikelijke standaardfout van een Sharpe-ratio over twintig jaar is , zodat hij een -waarde rond vijf vindt, maar die formule veronderstelt dunne staarten. Net als een gemiddeld rendement over enkele decennia is ook de Sharpe-ratio dus slecht gemeten zodra het rendement van zeldzame crashes afhangt. Dat een rustige steekproef de premie overdrijft, verwachtten we al, maar niet dat de overdrijving zo groot zou zijn.
6Replicatie op echte data
6.1De risiconeutrale verdeling van SPY
We laden de optieketen en de rente, en bepalen per expiratie de termijnkoers uit put-call-pariteit en de implied volatility van de opties buiten het geld.
chain = hap_data.yahoo_options("SPY", 28)
spot = float(chain["spot"].iloc[0])
valuation = pd.Timestamp(chain.index.max().date()) + pd.Timedelta(hours=16)
r_cc = float(np.log1p(hap_data.fred("DGS3MO")["DGS3MO"].dropna().loc[:valuation].iloc[-1] / 100))

quotes = chain.reset_index()
quotes = quotes[(quotes["bid"] > 0) & (quotes["ask"] > quotes["bid"])].copy()
quotes["mid"] = 0.5 * (quotes["bid"] + quotes["ask"])
quotes["T"] = (quotes["expiry"] + pd.Timedelta(hours=16) - valuation).dt.total_seconds() / (365.25 * 86400)


def smile_for_expiry(target_T):
    """OTM quotes, parity forward and implied vols for the expiry closest to target_T."""
    expiry_T = quotes.groupby("expiry")["T"].first()
    expiry = expiry_T.index[np.argmin(np.abs(expiry_T.to_numpy() - target_T))]
    g = quotes[quotes["expiry"] == expiry]
    T, DF = float(g["T"].iloc[0]), float(np.exp(-r_cc * g["T"].iloc[0]))
    wide = g.pivot_table(index="strike", columns="kind", values="mid").dropna()
    near = wide[np.abs(np.log(wide.index / spot)) < 0.05]
    F = float(np.median(near.index + (near["call"] - near["put"]) / DF))
    otm = g[((g["kind"] == "put") & (g["strike"] < F)) | ((g["kind"] == "call") & (g["strike"] >= F))]
    otm = otm[otm["bid"] >= 0.05].sort_values("strike").copy()
    otm["iv"] = implied_vol(otm["mid"].to_numpy(), F, otm["strike"].to_numpy(), T, DF, otm["kind"].to_numpy())
    otm["k"] = np.log(otm["strike"] / F)
    atm = float(np.interp(0.0, otm["k"], otm["iv"]))
    otm = otm[otm["k"].between(-5 * atm * np.sqrt(T), 3 * atm * np.sqrt(T))]
    return {"expiry": expiry, "T": T, "DF": DF, "F": F, "atm": atm, "otm": otm}


def svi_total_variance(k, a, b, rho, m, s):
    """Gatheral's raw SVI parametrisation of total implied variance w(k) = sigma^2 T."""
    return a + b * (rho * (k - m) + np.sqrt((k - m) ** 2 + s**2))


def rn_density(sm, n_grid=2001):
    """Breeden-Litzenberger density of log(S_T/F) from an SVI smile, inside the quoted strike range."""
    otm, T = sm["otm"], sm["T"]
    k_obs, w_obs = otm["k"].to_numpy(), otm["iv"].to_numpy() ** 2 * T
    fit = optimize.least_squares(lambda p: svi_total_variance(k_obs, *p) - w_obs,
                                 x0=[w_obs.min(), 0.1, -0.5, 0.0, 0.1],
                                 bounds=([-1, 0, -0.999, -1, 1e-4], [1, 5, 0.999, 1, 2]))

    def smile(kk):
        return np.sqrt(np.maximum(svi_total_variance(kk, *fit.x), 1e-10) / T)

    k = np.linspace(k_obs.min(), k_obs.max(), n_grid)
    K = sm["F"] * np.exp(k)
    C = black_price(sm["F"], K, T, smile(k), sm["DF"])
    dens_K = np.gradient(np.gradient(C, K), K) / sm["DF"]
    rmse = np.sqrt(np.mean((smile(k_obs) - otm["iv"].to_numpy()) ** 2))
    inner = slice(3, -3)                                         # one-sided differences at the grid edges
    return k[inner], (dens_K * K)[inner], smile, rmse            # density of k = log(S_T / F)


def moments(x, f):
    """Mass, mean, annualisable s.d., skewness and excess kurtosis of a density on a grid."""
    mass = np.trapezoid(f, x)
    f = f / mass
    mu = np.trapezoid(x * f, x)
    sd = np.sqrt(np.trapezoid((x - mu) ** 2 * f, x))
    return {"massa binnen strikes": mass, "sd": sd,
            "scheefheid": np.trapezoid((x - mu) ** 3 * f, x) / sd**3,
            "exces-kurtosis": np.trapezoid((x - mu) ** 4 * f, x) / sd**4 - 3}


smiles = {label: smile_for_expiry(T) for label, T in (("1 maand", 1 / 12), ("3 maanden", 0.25))}
print(f"waarderingsmoment {valuation}, spot {spot:.2f}, r = {r_cc:.4f}")
waarderingsmoment 2026-09-11 16:00:00, spot 764.29, r = 0.0382
De koers was op het waarderingsmoment en de rente . Voor beide looptijden fitten we nu de smile, nemen de tweede afgeleide en vergelijken de momenten met die van historische rendementen over dezelfde horizon.
daily_log = np.log1p(hap_data.market_daily()["Mkt"])
rn_rows, densities = {}, {}
for label, sm in smiles.items():
    k, dens, smile, rmse = rn_density(sm)
    densities[label] = (k, dens, smile)
    mom = moments(k, dens)
    h = int(round(sm["T"] * 252))
    rn_rows[f"Q, {label} ({sm['expiry'].date()})"] = {
        "T (jaar)": sm["T"], "aantal opties": len(sm["otm"]), "fitfout (vol)": rmse,
        "massa binnen strikes": mom["massa binnen strikes"],
        "min. dichtheid": dens.min(), "vol (jaarbasis)": mom["sd"] / np.sqrt(sm["T"]),
        "scheefheid": mom["scheefheid"], "exces-kurtosis": mom["exces-kurtosis"]}
    for period, sample in (("1926-2026", daily_log), ("1990-2026", daily_log.loc["1990":])):
        agg = sample.rolling(h).sum().iloc[h - 1::h]
        rn_rows[f"P, {label}, {period}"] = {
            "T (jaar)": h / 252, "aantal opties": np.nan, "fitfout (vol)": np.nan,
            "massa binnen strikes": np.nan, "min. dichtheid": np.nan,
            "vol (jaarbasis)": agg.std() * np.sqrt(252 / h), "scheefheid": agg.skew(), "exces-kurtosis": agg.kurt()}
pd.DataFrame(rn_rows).T.round(4)De tabel hieronder zet de risiconeutrale en de historische momenten naast de verwachting.
| grootheid | verwachting | 1 maand | 3 maanden |
|---|---|---|---|
| scheefheid onder | negatief | ||
| historische scheefheid, 1926–2026 | minder negatief | ||
| laagste waarde van de dichtheid | niet negatief |
Geslaagd. Het teken klopt voor beide looptijden, en de optiemarkt maakt de linkerstaart ongeveer twee keer zo scheef als een eeuw data. De grootte is minder robuust, want over 1990–2026 is de historische kwartaalscheefheid , even negatief als de risiconeutrale, terwijl de momenten rechtstreeks uit de prijzen met Proposition 1 een scheefheid van en geven (oefening 3). De eeuw blijft de maatstaf, omdat een scheefheid uit ruim drie decennia kwartalen vooral meet hoeveel crisiskwartalen erin vielen.
Rechts in de figuur ligt de linkerstaart ver boven de normale verdeling met dezelfde at-the-money-volatiliteit.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
for i, (label, sm) in enumerate(smiles.items()):
    k, dens, smile = densities[label]
    otm = sm["otm"]
    axes[0].plot(otm["k"], 100 * otm["iv"], ".", ms=4, color=hap.plotting.COLORS[i], alpha=0.6)
    axes[0].plot(k, 100 * smile(k), color=hap.plotting.COLORS[i], label=f"{label}, SVI-fit")
    x = np.linspace(k.min(), k.max(), 400)
    normal = stats.norm.pdf(x, -0.5 * sm["atm"] ** 2 * sm["T"], sm["atm"] * np.sqrt(sm["T"]))
    axes[1].plot(k, dens, color=hap.plotting.COLORS[i], label=f"Q-dichtheid, {label}")
    axes[1].plot(x, normal, color=hap.plotting.COLORS[i], ls="--", lw=1, label=f"normaal bij ATM-vol, {label}")
axes[0].set_title("(a) Implied volatility van SPY-opties")
axes[0].set_xlabel(r"Log-moneyness $\log(K/F)$")
axes[0].set_ylabel("Implied volatility (%)")
axes[0].legend()
axes[1].set_yscale("log")
axes[1].set_ylim(1e-3, None)
axes[1].set_title("(b) Breeden-Litzenberger-dichtheid van $\\log(S_T/F)$")
axes[1].set_xlabel(r"$\log(S_T/F)$")
axes[1].set_ylabel("Dichtheid (log-schaal)")
axes[1].legend(fontsize=8)
fig.tight_layout()
plt.show()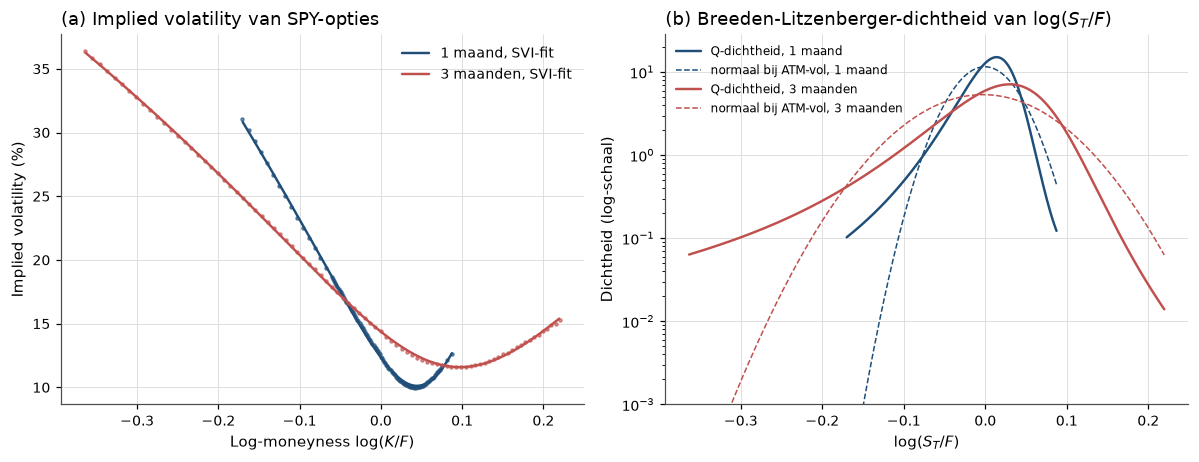
Figure 3:Links: de SVI-fit volgt de genoteerde implied volatilities op ongeveer een tiende volatiliteitspunt. Rechts: de risiconeutrale dichtheid van SPY heeft een linkerstaart die ordes van grootte dikker is dan de normale verdeling, en een rechterstaart die dunner is.
Binnen de genoteerde uitoefenprijzen ligt (één maand) en (drie maanden) van de massa, zodat de fit weinig mist. De dikke linkerstaart is de crash uit de numerieke oplossing, nu in marktprijzen.
6.2De variance risk premium als voorspeller
We bouwen de premie uit de VIX en de gerealiseerde variantie en schatten de regressie voor drie perioden en zes horizonnen.
vix = hap_data.fred("VIXCLS")["VIXCLS"].dropna()
implied_var = (vix.resample("ME").last() ** 2 / 12).rename("IV")            # monthly, %^2
realized_var = ((100 * daily_log) ** 2).resample("ME").sum().rename("RV")   # monthly, %^2
market_m = hap_data.market_monthly()
excess_log = (np.log1p(market_m["Mkt"]) - np.log1p(market_m["RF"])).rename("rx")
btz = implied_var.to_frame().join(realized_var, how="inner").join(excess_log, how="inner").dropna()
btz["VRP"] = btz["IV"] - btz["RV"]

btz_rows = []
for period, sl in (("1990-2007", slice("1990", "2007")), ("1990-2026", slice("1990", None)),
                   ("2008-2026", slice("2008", None))):
    sample = btz.loc[sl]
    res = hap.long_horizon_regression(1200 * sample["rx"], sample["VRP"], horizons=(1, 2, 3, 4, 6, 12),
                                      method="newey-west")
    res["helling (BTZ-schaal)"] = res["beta"] / res.index   # annualised % return averaged over h months
    res["adj. R2"] = 1 - (1 - res["r2"]) * (res["nobs"] - 1) / (res["nobs"] - 2)
    res["periode"] = period
    btz_rows.append(res.reset_index())
btz_table = pd.concat(btz_rows).set_index(["periode", "horizon"])
print(f"{btz.index[0]:%Y-%m} t/m {btz.index[-1]:%Y-%m}: gemiddelde IV {btz['IV'].mean():.2f}, "
      f"RV {btz['RV'].mean():.2f}, VRP {btz['VRP'].mean():.2f} (maand-%^2); VRP > 0 in "
      f"{(btz['VRP'] > 0).mean():.1%} van de maanden")
btz_table.rename(columns={"beta": "helling", "se": "standaardfout", "tstat": "t-waarde",
                          "r2": "R2", "nobs": "waarnemingen"}).round(3)
1990-01 t/m 2026-07: gemiddelde IV 36.12, RV 27.29, VRP 8.83 (maand-%^2); VRP > 0 in 86.6% van de maanden
De schattingen over 1990–2007 staan hieronder naast die uit tabel 2 van het origineel. De -waarden zijn niet één op één vergelijkbaar, omdat de twee methoden verschillen.
| horizon (maanden) | helling origineel | helling hier | origineel (Hodrick) | hier (Newey-West) | aangepaste origineel | aangepaste hier |
|---|---|---|---|---|---|---|
| 1 | ||||||
| 3 | ||||||
| 6 | ||||||
| 12 |
Geslaagd voor 1990–2007. De hellingen hebben het goede teken en de gepubliceerde orde van grootte, de -waarde bij drie maanden ligt ruim boven twee en de hoogste valt bij zes maanden. Daarna houdt het verband op, want over 1990–2026 is geen enkele helling significant ().
Het linkerpaneel toont de diep negatieve maanden, het rechter de -waarden die na 2007 wegzakken.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
axes[0].bar(btz.index, btz["VRP"], width=25,
            color=np.where(btz["VRP"] > 0, hap.plotting.COLORS[0], hap.plotting.COLORS[1]))
axes[0].set_ylim(-80, 90)
axes[0].axvline(pd.Timestamp("2007-12-31"), color="black", lw=0.8, ls="--")
axes[0].set_title("(a) Variance risk premium, VIX$^2$/12 min gerealiseerde variantie")
axes[0].set_xlabel("Jaar")
axes[0].set_ylabel("Maandvariantie (%$^2$), afgekapt op -80")
for i, period in enumerate(["1990-2007", "1990-2026", "2008-2026"]):
    axes[1].plot(btz_table.loc[period].index, btz_table.loc[period, "tstat"], "o-",
                 color=hap.plotting.COLORS[i], label=period)
axes[1].axhline(1.96, color="black", lw=0.8, ls="--")
axes[1].set_title("(b) Voorspelt de VRP het overrendement?")
axes[1].set_xlabel("Horizon (maanden)")
axes[1].set_ylabel("Newey-West $t$-waarde van de helling")
axes[1].legend()
fig.tight_layout()
plt.show()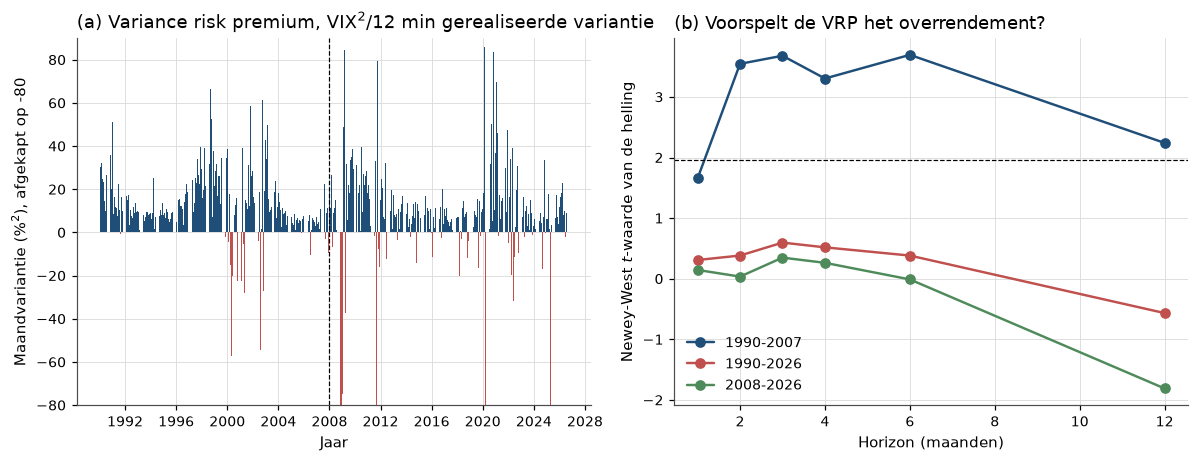
Figure 4:Links: de variance risk premium is meestal positief, en de negatieve maanden zijn crisismaanden waarin de gerealiseerde variantie de VIX inhaalt (de twee diepste zijn afgekapt). Rechts: de voorspelkracht van vóór 2007 is daarna verdwenen.
De premie is in 87% van de maanden positief. In oktober 2008 en maart 2020 schoot de gerealiseerde variantie echter ver boven de VIX en werd de premie diep negatief. Na oktober 2008 volgden nog verdere verliezen, maar na maart 2020 juist hoge rendementen. Een voorspeller die de crash zelf als lage premie meet, kan dus ver naast zitten op de momenten die het gemiddelde bepalen. Dat weerlegt niet dat de premie positief is omdat de SDF en de variantie samen stijgen (Proposition 2), maar het laat zien hoe dun achttien jaar bewijs is, net als bij de voorspellers uit Voorspelbaarheid van rendementen die buiten de steekproef faalden.
6.3Verkopers van puts in het echt: de Cboe PutWrite-index
We berekenen de overrendementen, de samenvattende statistieken, de verliezen in de twee crises en een regressie van elke strategie op de index.
levels = hap_data.yahoo(["^GSPC", "^PUT", "^BXM"], "1986-01-01").join(hap_data.yahoo("^SP500TR", "1986-01-01"))
monthly = levels[["^SP500TR", "^PUT", "^BXM"]].resample("ME").last().pct_change()
monthly.columns = ["S&P 500 (total return)", "PutWrite (PUT)", "BuyWrite (BXM)"]
cboe = monthly.join(market_m["RF"], how="inner").loc["1996-09":"2026-06"].dropna()
cboe_excess = cboe.drop(columns="RF").sub(cboe["RF"], axis=0)

stats_cboe = hap.summary_stats(cboe_excess).drop(columns=["start", "end"]).astype(float)
stats_cboe["SE Sharpe"] = np.sqrt((1 + stats_cboe["sharpe_ann"] ** 2 / 2) / (stats_cboe["nobs"] / 12))
for name in cboe_excess:
    dd = hap.drawdowns(cboe[name])
    fit = hap.newey_west(cboe_excess[name], cboe_excess["S&P 500 (total return)"], lags=3)
    stats_cboe.loc[name, "max drawdown"] = dd.attrs["max_drawdown"]
    stats_cboe.loc[name, "nov 2007 - feb 2009"] = (1 + cboe[name].loc["2007-11":"2009-02"]).prod() - 1
    stats_cboe.loc[name, "feb - mrt 2020"] = (1 + cboe[name].loc["2020-02":"2020-03"]).prod() - 1
    stats_cboe.loc[name, "alpha (jaar)"] = 12 * fit.params.iloc[0]
    stats_cboe.loc[name, "t(alpha)"] = fit.tvalues.iloc[0]
    stats_cboe.loc[name, "beta"] = fit.params.iloc[1]
print(f"{cboe.index[0]:%Y-%m} t/m {cboe.index[-1]:%Y-%m}, {len(cboe)} maanden")
labels_nl = {"mean_ann": "gem. overrendement (jaar)", "std_ann": "volatiliteit (jaar)",
             "sharpe_ann": "Sharpe-ratio (jaar)", "SE Sharpe": "standaardfout Sharpe",
             "skew": "scheefheid", "kurtosis": "exces-kurtosis", "beta": "bèta"}
stats_cboe[["mean_ann", "std_ann", "sharpe_ann", "SE Sharpe", "skew", "kurtosis", "max drawdown",
            "nov 2007 - feb 2009", "feb - mrt 2020", "alpha (jaar)", "t(alpha)", "beta"]].rename(
    columns=labels_nl).T.round(3)
1996-09 t/m 2026-06, 358 maanden
Over 358 maanden haalde PUT een iets hogere Sharpe-ratio dan de index, bij een veel lagere volatiliteit. De tabel hieronder zet de verwachtingen naast de uitkomsten.
| grootheid | verwachting | S&P 500 | PUT |
|---|---|---|---|
| volatiliteit per jaar | PUT lager | ||
| scheefheid | PUT negatiever | ||
| scheefheid, één put 10% onder de koers (origineel) | veel negatiever dan PUT | ||
| exces-kurtosis | PUT hoger | ||
| Sharpe-ratio (standaardfout) | verschil onder één standaardfout | () | () |
| november 2007 – februari 2009 | groot deel van de index | ||
| februari – maart 2020 | groot deel van de index | ||
| bèta op de index | ver onder één | 1 |
Geslaagd. Alle verwachtingen komen uit. Het verschil in Sharpe-ratio is een vijfde van één standaardfout, zodat dertig jaar data de twee strategieën niet kunnen onderscheiden, terwijl de staart van PUT wel duidelijk meetbaar is. Bij Saretto en Santa-Clara is de scheefheid ruim zes keer zo extreem, omdat PUT at-the-money verkoopt en het rendement op het volle onderpand meet in plaats van op de premie. Tegen de index geregresseerd heeft PUT een alpha van 1,3% per jaar met .
De figuur laat zien dat de PutWrite-index in 2020 even diep valt als de S&P 500 en in 2008 ongeveer twee derde zo diep.
Source
fig, axes = plt.subplots(2, 1, figsize=(10, 6.2), sharex=True, height_ratios=[2, 1])
for i, name in enumerate(cboe_excess):
    dd = hap.drawdowns(cboe[name])
    axes[0].plot(dd.index, dd["wealth"], color=hap.plotting.COLORS[i], label=name)
    axes[1].plot(dd.index, 100 * dd["drawdown"], color=hap.plotting.COLORS[i], lw=1.2)
axes[0].set_yscale("log")
axes[0].set_title("Verkopers van indexopties tegen de S&P 500, 1996-2026")
axes[0].set_ylabel("Waarde van 1 dollar (log-schaal)")
axes[0].legend()
axes[1].set_title("Drawdown")
axes[1].set_xlabel("Jaar")
axes[1].set_ylabel("Drawdown (%)")
plt.show()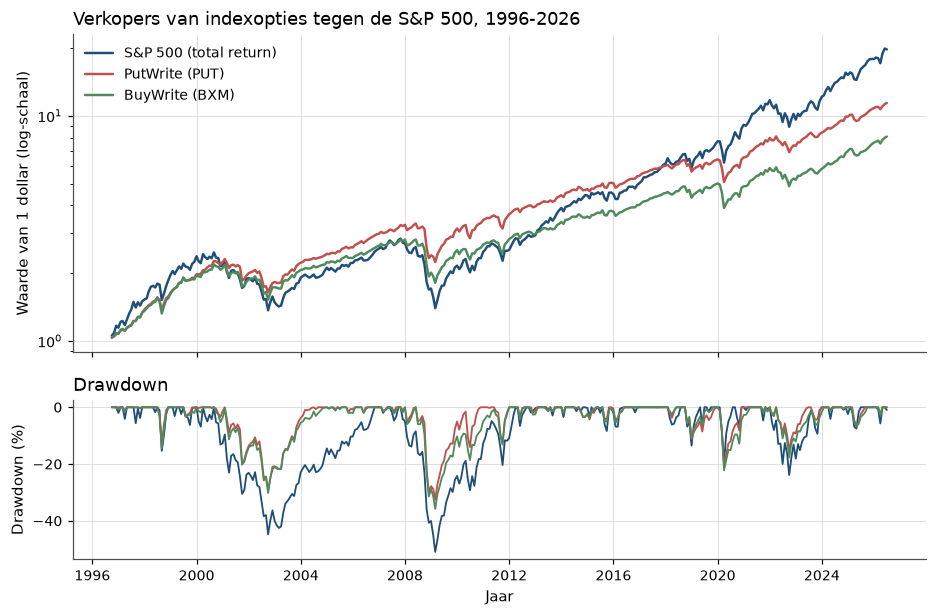
Figure 5:De PutWrite-index loopt tot 2020 gelijk op met de S&P 500 bij twee derde van de volatiliteit, en valt in 2020 even diep en in 2008 ongeveer twee derde zo diep. Het onderste paneel toont hoe diep, gemeten vanaf de vorige top.
Na 2020 blijft de PutWrite-index achter, omdat een verkoper van verzekering niet meedoet met een sterk stijgende markt. Israelov en Nielsen vonden in de BuyWrite-strategie dat de verkochte volatiliteit een Sharpe-ratio van bijna één had, maar slechts 10% van het risico droeg Israelov & Nielsen (2015). De premie is dus reëel, maar in een indexproduct verdund door aandelenrisico.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Sprongen verklaren de smirk, de ordening van Coval en Shumway volgt uit een dalende SDF, en de variance risk premium heeft het teken dat het leverage effect voorspelt. Santa-Clara en Yan haalden uit zeven jaar optieprijzen een aandelenpremie van tien procent, waarvan bijna een derde crashpremie, in een steekproef met een negatief gerealiseerd overrendement. Op echte data vonden we de linksscheve risiconeutrale verdeling terug, net als de voorspelkracht van de premie over 1990–2007.
Waar het breekt. Twee meetbare feiten passen niet in dit beeld. De voorspelkracht van de variance risk premium verdwijnt na 2007, zodat de -waarde bij drie maanden over 1990–2026 nog maar is. Daarnaast is de hoge beloning voor het verkopen van puts in dertig jaar indexdata niet te meten, omdat de Sharpe-ratio’s van en minder dan een standaardfout verschillen. De optiemarkt meet de prijs van crashrisico dus goed, maar levert geen bewijs dat die prijs te hoog is.
Risico of vergissing? In de Chicago-lezing zijn crashes de toestanden waarin een dollar het meest waard is, en beloont de premie een risico dat niet te hedgen is en in crises duurder wordt, zoals Pan vond. In de Yale-lezing wijst de stijgende SDF van Jackwerth op mispricing. Saretto en Santa-Clara lazen hun resultaten als mispricings die kosten en marges in stand houden, limits of arbitrage (de grenzen aan wat arbitrageurs met beperkt kapitaal kunnen corrigeren) in zuivere vorm. Om de lezingen te scheiden is de SDF in crashtoestanden nodig, en die toestanden zijn zeldzaam, zodat de data van dit college geen uitsluitsel geven. Santa-Clara zelf staat met één been in elk kamp, want hij schatte de premie als beloning voor risico en liet zien dat marges die premie onbereikbaar maken.
Wat er daarna kwam. Hetzelfde patroon, vaak een beetje winnen en zelden veel verliezen, bleek ook in de valutamarkt te bestaan. Daar verdient de carry trade (lenen in een valuta met lage rente en beleggen in een valuta met hoge rente) een premie die in crises in één keer verdampt, zoals Wisselkoersen: risk sharing, carry, momentum, value laat zien.
8Oefeningen
Solution to Exercise 1
De SDF hangt niet van de kansen af, dus en . De put kost en verwacht terug, zodat zijn verwachte bruto rendement weer is.
prob_rare = np.array([0.66, 0.33, 0.01])
Em_rare = prob_rare @ m_toy
put_price_rare = prob_rare @ (m_toy * put_toy)
pd.Series({"E[m]": Em_rare, "q crash": prob_rare[2] * m_toy[2] / Em_rare,
           "prijs put 0,90": put_price_rare, "E[R] put 0,90": (prob_rare @ put_toy) / put_price_rare,
           "1 / m crash": 1 / m_toy[2]}).round(4)
E[m] 0.9051
q crash 0.0827
prijs put 0,90 0.0225
E[R] put 0,90 0.1336
1 / m crash 0.1336
dtype: float64De code bevestigt de handberekening. Het verwachte rendement van een put die alleen in de crash uitbetaalt, meet hoeveel een dollar in de crash waard is. Hoe vaak de crash voorkomt, doet er niet toe.
Solution to Exercise 2
(1) De risiconeutrale kans op een sprong ter grootte is de werkelijke kans maal , de sprong in de SDF, dus . Integreren geeft , en met geeft het kwadraat afmaken in een normale dichtheid met gemiddelde .
(2) We lossen de vergelijking voor numeriek op.
ratio = LAM_Q / LAM_P
gamma_jump = optimize.brentq(lambda g: -g * MU_J + 0.5 * g**2 * DELTA_J**2 - np.log(ratio), 0.0, 20.0)
mean_jump_q = np.exp(MU_J - gamma_jump * DELTA_J**2 + 0.5 * DELTA_J**2) - 1
print(f"lambda^Q / lambda^P = {ratio:.3f}  ->  gamma = {gamma_jump:.3f}")
print(f"gemiddelde sprong onder P: {KAPPA:.4f}, onder Q: {mean_jump_q:.4f}")
lambda^Q / lambda^P = 2.115 -> gamma = 2.015
gemiddelde sprong onder P: -0.3000, onder Q: -0.3140
Een risicoaversie van ongeveer twee verdubbelt de intensiteit en maakt de gemiddelde crash iets dieper, tegen , dicht bij de van Santa-Clara en Yan. Een crashpremie van deze omvang vraagt dus geen extreme risicoaversie, alleen grote crashes die met de consumptie samenvallen, zoals bij Rietz en Barro in Habit, long-run risk en rampen.
Solution to Exercise 3
bkm_rows = {}
for label, sm in smiles.items():
    otm, T, F = sm["otm"], sm["T"], sm["F"]
    K, Q_price = otm["strike"].to_numpy(), otm["mid"].to_numpy()
    x, growth_T = np.log(K / F), np.exp(r_cc * T)
    mean_r = -growth_T * np.trapezoid(Q_price / K**2, K)
    second = growth_T * np.trapezoid(2 * (1 - x) * Q_price / K**2, K)
    third = growth_T * np.trapezoid((6 * x - 3 * x**2) * Q_price / K**2, K)
    var = second - mean_r**2
    bkm_rows[label] = {"vol modelvrij": np.sqrt(var / T),
                       "scheefheid modelvrij": (third - 3 * mean_r * second + 2 * mean_r**3) / var**1.5,
                       "vol BL-dichtheid": moments(*densities[label][:2])["sd"] / np.sqrt(T),
                       "scheefheid BL-dichtheid": moments(*densities[label][:2])["scheefheid"]}
pd.DataFrame(bkm_rows).T.round(4)De modelvrije momenten zijn allebei extremer. De volatiliteit is bij één maand tegen voor de dichtheid. De scheefheid heeft hetzelfde teken, maar is met en veel negatiever dan de en van de dichtheid. De dichtheid houdt op bij de laagste genoteerde put, terwijl in (3) de prijs van die put nog de waarde van alle toestanden daaronder bevat. Afkappen onderschat dus beide momenten en vooral het derde, maar de randnoteringen hebben ook de breedste marge tussen bied en laat. De linkerstaart is daardoor ook in optieprijzen het slechtst gemeten deel van de verdeling.
- Bollerslev, T., Tauchen, G., & Zhou, H. (2009). Expected Stock Returns and Variance Risk Premia. The Review of Financial Studies, 22(11), 4463–4492. 10.1093/rfs/hhp008
- Merton, R. C. (1976). Option Pricing When Underlying Stock Returns Are Discontinuous. Journal of Financial Economics, 3(1–2), 125–144. 10.1016/0304-405X(76)90022-2
- Breeden, D. T., & Litzenberger, R. H. (1978). Prices of State-Contingent Claims Implicit in Option Prices. The Journal of Business, 51(4), 621–651. 10.1086/296025
- Santa-Clara, P., & Yan, S. (2010). Crashes, Volatility, and the Equity Premium: Lessons from S&P 500 Options. The Review of Economics and Statistics, 92(2), 435–451. 10.1162/rest.2010.11549
- Saretto, A., & Santa-Clara, P. (2009). Option Strategies: Good Deals and Margin Calls. Journal of Financial Markets, 12(3), 391–417. 10.1016/j.finmar.2009.01.002
- Bates, D. S. (2000). Post-’87 Crash Fears in the S&P 500 Futures Option Market. Journal of Econometrics, 94(1–2), 181–238. 10.1016/S0304-4076(99)00021-4
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Jackwerth, J. C. (2000). Recovering Risk Aversion from Option Prices and Realized Returns. The Review of Financial Studies, 13(2), 433–451. 10.1093/rfs/13.2.433
- Bakshi, G., Kapadia, N., & Madan, D. (2003). Stock Return Characteristics, Skew Laws, and the Differential Pricing of Individual Equity Options. The Review of Financial Studies, 16(1), 101–143. 10.1093/rfs/16.1.0101
- Carr, P., & Wu, L. (2009). Variance Risk Premiums. The Review of Financial Studies, 22(3), 1311–1341. 10.1093/rfs/hhn038
- Pan, J. (2002). The Jump-Risk Premia Implicit in Options: Evidence from an Integrated Time-Series Study. Journal of Financial Economics, 63(1), 3–50. 10.1016/S0304-405X(01)00088-5
- Santa-Clara, P., & Yan, S. (2004). Jump and Volatility Risk and Risk Premia: A New Model and Lessons from S&P 500 Options (NBER Working Paper No. 10912). National Bureau of Economic Research. 10.3386/w10912
- Coval, J. D., & Shumway, T. (2001). Expected Option Returns. The Journal of Finance, 56(3), 983–1009. 10.1111/0022-1082.00352
- Broadie, M., Chernov, M., & Johannes, M. (2009). Understanding Index Option Returns. The Review of Financial Studies, 22(11), 4493–4529. 10.1093/rfs/hhp032
- Israelov, R., & Nielsen, L. N. (2015). Covered Calls Uncovered. Financial Analysts Journal, 71(6), 44–57. 10.2469/faj.v71.n6.1
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD