

Ross, APT en de fundamentele stelling
1Overzicht
Wat volgt er uit de aanname dat er geen arbitrage bestaat (een strategie die niets kost, nooit verlies geeft en soms winst)? Het antwoord heeft twee delen. Ten eerste is geen arbitrage hetzelfde als het bestaan van een positieve stochastic discount factor (SDF, de willekeurige variabele waarmee payoffs van morgen worden verdisconteerd). Ten tweede zijn verwachte rendementen lineair in de factorbèta’s als de rendementen een factorstructuur hebben, en daarvoor zijn evenwicht noch nutsfunctie nodig. Die algemeenheid heeft een prijs, want de stelling zegt niet welke discontofactor het is, en de APT zegt niet welke factoren. In dit college:
waarderen we in een markt met twee toestanden een call op twee manieren, en bouwen we de arbitrage die ontstaat als de call te duur is.
bewijzen we de fundamentele stelling: geen arbitrage dan en slechts dan als er positieve toestandsprijzen bestaan.
leiden we de arbitrageprijstheorie (APT) van Ross af, eerst exact en dan met eigen ruis per aandeel.
simuleren we waarom een verkeerd gewaardeerd aandeel met tien jaar data onzichtbaar blijft, terwijl een gespreide portefeuille vrijwel juist gewaardeerd is.
repliceren we de vraag van Roll en Ross Roll & Ross (1980), hoeveel factoren een premie dragen, met principale componenten van de 25 portefeuilles van French, gesorteerd op omvang en boekwaarde/marktwaarde.
Pedro Santa-Clara noemt het idee dat twee dingen met dezelfde payoffs dezelfde prijs hebben het derde grote idee van het vak, na efficiëntie en evenwicht Santa-Clara (2026). Stephen Ross maakte er in 1976 een theorie van verwachte rendementen van Ross (1976), en Philip Dybvig en Ross gaven het geheel in 1987 zijn naam, de fundamentele stelling van asset pricing Dybvig & Ross (1987). Met dit werk begint een nieuw tijdvak, omdat het prijzen losmaakt van voorkeuren.
Of iets theorie of feit is, hangt hier af van het soort uitspraak. Het CAPM is een theorie die getoetst wordt en kan falen, maar de fundamentele stelling is een wiskundige equivalentie en kan dat niet. De APT zit ertussen, want ze zegt meer dan de stelling (er is een factorstructuur), maar minder dan het CAPM (welke factoren en hoeveel, zegt ze niet). Over die leegte ging het debat van de jaren tachtig.
2Intuïtie: waarom zou dit waar zijn?
Denk aan een markt waarin het morgen alleen goed of slecht kan gaan. Een obligatie keert in beide gevallen hetzelfde uit, een aandeel veel als het goed gaat en weinig als het slecht gaat. Met die twee is elke uitkering van morgen na te maken, want wie alleen iets wil in de goede toestand, koopt aandelen en verkoopt zoveel obligaties dat de slechte toestand op nul uitkomt.
Een derde activum, zoals een optie, voegt dan niets toe, en zijn prijs ligt vast omdat het evenveel moet kosten als het pakket dat hetzelfde uitkeert. Kost het meer, dan verkoopt een handelaar het en koopt hij het pakket, zodat hij vandaag geld ontvangt en morgen niets hoeft te betalen. Die verkoopdruk duwt de prijs omlaag tot het verschil weg is.
Het argument werkt ook andersom. Als alle prijzen onderling kloppen, bestaat er een lijstje van twee getallen, namelijk de prijs van een euro die alleen komt als het goed gaat en de prijs van een euro die alleen komt als het slecht gaat. Elke prijs is dan uitkering maal die toestandsprijzen. Beide getallen moeten positief zijn, want kostte een euro in de slechte toestand niets, dan kocht iedereen er onbeperkt van en steeg de prijs.
Ross zag dat hetzelfde argument werkt met factoren in plaats van toestanden. Aandelen bewegen samen omdat een handvol grote krachten ze allemaal raakt, zoals de conjunctuur, de rente en de olieprijs, maar daarnaast beweegt elk aandeel om eigen redenen. Met honderden aandelen is een portefeuille te bouwen die niet blootstaat aan de grote krachten en waarin de eigen bewegingen elkaar uitmiddelen, zodat hij bijna risicovrij is. Lag zijn verwachte rendement toch boven de rente, dan kochten handelaars die portefeuille tot het verschil verdween.
Uit deze redenering volgen drie verwachtingen. De optie kost exact wat het pakket kost, en elke andere prijs geeft een arbitrage. Verwachte rendementen stijgen lineair met de blootstelling aan de grote krachten, en alleen daarmee. Dat laatste geldt echter voor gespreide portefeuilles en niet voor elk los aandeel, want een enkel aandeel kan fors verkeerd gewaardeerd zijn zonder dat er gratis geld ligt.
3Toy-voorbeeld: twee toestanden, drie activa en een arbitrage
We laden eerst de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import optimize

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Morgen is de toestand goed (fysieke kans 0,6) of slecht (kans 0,4). Obligatie en aandeel worden verhandeld tegen de prijzen hieronder, en het derde activum is een call op het aandeel met uitoefenprijs 1. Wat moet de call kosten?
| activum | payoff goed | payoff slecht | prijs |
|---|---|---|---|
| obligatie | 1{,}00 | 1{,}00 | 0{,}90 |
| aandeel | 1{,}40 | 0{,}60 | 0{,}86 |
| call (uitoefenprijs 1) | 0{,}40 | 0{,}00 | ? |
Het recept. Een toestandsprijs is de prijs van één euro die alleen in één toestand wordt uitbetaald. Elke prijs is dan de som van uitkering maal toestandsprijs, , en dat recept leidt de theorie als eerste af.
Stap 1: toestandsprijzen. Voor de obligatie geldt en voor het aandeel . Trekken we keer de eerste vergelijking van de tweede af, dan blijft over, dus en .
Stap 2: de rente. De obligatie kost en keert in beide toestanden één euro uit. Daarom is en .
Stap 3: de call. De call keert alleen in de goede toestand iets uit. Daarom is .
Stap 4: replicatie. Zoek obligaties en aandelen met en . Dat geeft en , en het pakket kost .
Stap 5: een arbitrage. Noteert de call , dan verkopen we de call en kopen we het pakket uit stap 4. Vandaag ontvangen we , terwijl de payoff morgen in beide toestanden nul is.
De cel rekent dezelfde stappen na en zet hand en code naast elkaar.
prob = np.array([0.6, 0.4])                  # physical probabilities (good, bad)
X = np.array([[1.00, 1.40, 0.40],            # payoffs in state 'goed': bond, stock, call
              [1.00, 0.60, 0.00]])           # payoffs in state 'slecht'
p_traded = np.array([0.90, 0.86])            # prices of bond and stock

q = np.linalg.solve(X[:, :2].T, p_traded)    # state prices: p = X'q
gross_rf = 1 / q.sum()                       # 1 + R^f
theta = np.linalg.solve(X[:, :2], X[:, 2])   # replicating portfolio: bond, stock

p_quoted = np.array([0.90, 0.86, 0.20])      # the call is overpriced
holdings = np.array([theta[0], theta[1], -1.0])  # sell the call, buy the replica

hand = {"q goed": 0.40, "q slecht": 0.50, "1 + R^f": 1.1111, "call via q'x": 0.16,
        "call via replicatie": 0.16, "obligaties in replicatie": -0.3,
        "aandelen in replicatie": 0.5, "arbitrage: kasstroom vandaag": 0.04,
        "arbitrage: payoff goed": 0.0, "arbitrage: payoff slecht": 0.0}
code = [q[0], q[1], gross_rf, q @ X[:, 2], theta @ p_traded, theta[0], theta[1],
        -holdings @ p_quoted, X[0] @ holdings, X[1] @ holdings]
pd.DataFrame({"met de hand": list(hand.values()), "code": code}, index=hand.keys()).round(4)De twee kolommen zijn gelijk, terwijl de kansen 0,6 en 0,4 in geen enkele stap voorkwamen. Op die observatie bouwden Cox & Ross (1976) hun risiconeutrale waardering. Twee verhandelde activa leggen dus de prijs van de call vast, en elke andere prijs levert gratis geld op.
4Theorie
Alles in deze sectie steunt op de fundamentele stelling, die zegt dat er geen arbitrage is dan en slechts dan als er positieve toestandsprijzen zijn, en waaruit het recept van het toy-voorbeeld volgt. Daarop bouwen we verder met de vraag wanneer die prijzen uniek zijn en hoe de stelling over veel perioden werkt. Het belangrijkste gevolg is de APT van Ross, die zegt wat de stelling voor verwachte rendementen betekent, eerst exact en dan met ruis, en we sluiten af met de manier waarop factoren en hun premies geschat worden.
4.1Opzet en aannames
Er is één periode met toestanden en activa. Prijzen gelden op en payoffs op , maar omdat er maar één periode is, laten we de tijdsindex weg. De payoffs staan in een -matrix , waarin element de uitkering van activum in toestand is. De payoff is de toevalsvariabele die in toestand de waarde aanneemt. In het toy-voorbeeld is en . Een portefeuille (negatieve elementen zijn short) kost en keert uit. De fysieke kansen zijn . We schrijven als elk element niet-negatief is en als elk element strikt positief is.
“Equivalent” betekent hier dat in elke toestand waarin . Toestandsprijzen, SDF en risiconeutrale kansen zijn vertalingen van elkaar:
In woorden: een prijs is uitkering maal toestandsprijs, of verwachte uitkering gewogen met de SDF, of risiconeutraal verwachte uitkering verdisconteerd tegen de rente. De SDF is de toestandsprijs per eenheid kans, en de risiconeutrale kans is de toestandsprijs per euro van de obligatie. In het toy-voorbeeld:
De SDF is hoog in slecht, omdat een euro daar meer waard is. De risiconeutrale kans op slecht ligt daarom boven de fysieke kans van 0,4, en daarin zit de risicopremie van het aandeel.
4.2Het kernresultaat: de fundamentele stelling
Waarom zou dit waar zijn? Stel dat een claim op een euro alleen in de slechte toestand niets kost. Een handelaar koopt er dan onbeperkt van, want hij kan er alleen aan verdienen. Die vraag drijft de prijs op tot ze positief is. Omgekeerd kost elk pakket dat nergens verlies en ergens winst geeft een positief bedrag, zolang elke toestandsprijs positief is. Een markt zonder arbitrage en positieve toestandsprijzen horen dus bij elkaar.
Het bewijs loopt in twee richtingen. Dat (2) arbitrage uitsluit, volgt al uit de laatste stap van de redenering hierboven. Voor de omgekeerde richting kijken we naar alle combinaties van kasstroom vandaag en payoffs morgen die de markt kan maken. Zonder arbitrage is geen daarvan overal niet-negatief en ergens positief. Een scheidend hypervlak tussen die combinaties en de positieve payoffs heeft dan een normaalvector met positieve elementen, en die elementen zijn de toestandsprijzen. De equivalentie met (3) en (4) is (1).
Proof 1
Stap 1: positieve toestandsprijzen sluiten arbitrage uit. Stel met en . Dan is , met gelijkheid alleen als . Er is dus geen arbitrage.
Stap 2: de haalbare kasstromen raken het positieve orthant niet. We verzamelen alle kasstromen die de markt kan maken. Laat
Het eerste element is de kasstroom vandaag, de overige die van morgen. Geen arbitrage betekent . Laat de simplex zijn. Dan is een gesloten deelruimte, compact en convex, en .
Stap 3: een scheidend hypervlak. De scheidingsstelling voor een gesloten en een compacte convexe verzameling geeft een en met op en op . Een lineaire functie die op een deelruimte naar boven begrensd is, is daar nul. Dus en . De eenheidsvectoren liggen in , dus voor elke .
Stap 4: de normaalvector geeft de toestandsprijzen. Schrijf . Loodrecht op staan betekent . Dan is met .
Stap 5: de drie namen. Volgens (1) is strikt positief als dat is. Met een risicovrij activum is een strikt positieve kansvector, en omgekeerd.
In het toy-voorbeeld is , dus is de markt met de call op 0,16 arbitragevrij. Bij 0,20 waardeert geen enkele alle drie de activa juist, en dan belooft de stelling een arbitrage, namelijk die van stap 5. De optieprijs ligt dus vast zodra de toestandsprijzen vastliggen, en daarmee komt de eerste verwachting uit de intuïtie uit.
4.3Uniciteit: complete en incomplete markten
Toestandsprijzen liggen alleen vast als elke payoff na te maken is. Neem een markt met drie toestanden maar alleen obligatie en aandeel. Een handelaar die een euro alleen in de middelste toestand wil, kan die niet namaken, en dus zegt geen enkele waargenomen prijs wat zo’n euro kost. De toestandsprijzen kunnen in die richting schuiven, zodat een claim die daarvan afhangt een bandbreedte van prijzen heeft in plaats van één prijs.
Proof 2
De oplossingen van vormen de verzameling . Die kern is dan en slechts dan als rang heeft. Bij rang is er hoogstens één oplossing, en volgens Theorem 1 precies één strikt positieve. Bij lagere rang nemen we een in de kern, en dan is voor kleine ook strikt positief en waardeert die vector alle activa juist.
Voor de grenzen: voeg met prijs toe. Volgens de stelling is de uitgebreide markt arbitragevrij dan en slechts dan als een ook haalt. De haalbare waarden zijn het lineaire beeld van een relatief open convexe verzameling, dus een open interval.
De grenzen in (4) zijn het laagste en het hoogste bedrag over alle toestandsprijzen die de markt toelaat. Volgens de dualiteitsstelling van lineaire programmering is de bovengrens de prijs van het goedkoopste pakket dat overal minstens uitkeert, en de eerste oefening laat dat met getallen zien. Omdat echte markten incompleet zijn, garandeert de stelling daar wel een positieve SDF, maar niet welke.
4.4Veel perioden: de binomiale knoop
Een boom met veel perioden is een reeks één-periodemarkten, en Harrison en Kreps bewezen dat de stelling dan per knoop geldt Harrison & Kreps (1979). Harrison en Pliska brachten dat naar continue tijd Harrison & Pliska (1981). Met de waarde van een doorgerolde spaarrekening en het dividend luidt de stelling
Zonder dividend is de prijs, gemeten in spaarrekeningen, dus een martingaal onder , en met dividend geldt dat voor de waarde van het aandeel plus herbelegde dividenden. Bij zo’n reeks is de beste voorspelling van morgen, onder die kansen, de waarde van vandaag.
In de binomiale boom van Cox, Ross en Rubinstein Cox et al. (1979), uit Black-Scholes-Merton en de CBOE, is elke knoop een kopie van ons toy-voorbeeld. Het aandeel gaat met factor omhoog of met factor omlaag, waarbij hier de daalfactor is en niet het dividend. De risiconeutrale kans op omhoog is dan
Die kans ligt tussen nul en één, en de knoop is dus arbitragevrij, dan en slechts dan als . In het toy-voorbeeld is per euro aandeel en , en dat geeft
de risiconeutrale kans die hierboven uit (1) volgde.
4.5Wat het voorspelt: de APT met een exacte factorstructuur
Ross paste het argument van het toy-voorbeeld toe op factoren in plaats van toestanden. Daar was de call een combinatie van obligatie en aandeel, en had ze daardoor geen vrije prijs. Hangen alle rendementen alleen af van gemeenschappelijke schokken, dan kan een handelaar een portefeuille maken die niets kost en geen risico draagt, door factorbèta’s en het budget op nul te zetten. Dat zijn voorwaarden, zodat er vanaf activa zo’n portefeuille overblijft. Heeft die een positief verwacht rendement, dan koopt de handelaar er onbeperkt van tot dat rendement nul is. Daarom stijgt het verwachte rendement lineair met de bèta op elke factor.
We maken dit argument nu formeel. Laat de bruto rendementen voldoen aan
Het rendement bestaat dus uit een verwachting , plus factorbèta’s (in de literatuur factor loadings) maal schokken die alle aandelen raken, plus een eigen schok . Een factorschok is bijvoorbeeld de onverwachte groei van de industriële productie. In matrixvorm is , met de -matrix van factorbèta’s. In deze sectie zijn de schokken met verwachting nul, terwijl het in de replicatie factorrendementen zijn met een premie als verwachting. Een portefeuille met kost niets, omdat hij evenveel leent als hij belegt.
In woorden: verwachte rendementen liggen op een vlak in de factorbèta’s. Met een risicovrij activum is , want dat heeft bèta nul. Dan is de prijs van risico van factor : het extra verwachte rendement per eenheid bèta. In overrendementen staat er . Alleen de factorbèta’s tellen dus mee, precies zoals de tweede verwachting uit de intuïtie zei.
Het toy-voorbeeld is een exacte APT met één factor, namelijk de schok in het rendement van het aandeel. Omdat het aandeel op zijn eigen schok bèta 1 heeft, is zijn verwachte rendement min . De bèta van de call is de afwijking van de call ten opzichte van de eigen verwachting, gedeeld door die van het aandeel in dezelfde toestand.
| rendement goed | verwacht rendement | afwijking goed | |
|---|---|---|---|
| aandeel | |||
| call |
Daarmee is en , en de APT voorspelt het verwachte rendement van de call exact:
4.6De APT met ruis: de grens van Huberman
Met eigen ruis per aandeel is de portefeuille niet meer risicovrij, maar eigen ruis middelt uit, want bij gewichten van orde daalt de eigen variantie met . De pricing errors zijn het deel van het verwachte rendement dat de factoren niet verklaren, in de formules . Zijn die groot en talrijk, dan bundelt een handelaar ze tot een portefeuille die steeds meer opbrengt en steeds minder risico draagt naarmate groeit. Wie dat uitsluit, laat dus toe dat één aandeel fors verkeerd gewaardeerd is, maar niet dat veel aandelen het tegelijk zijn.
We bekijken een rij economieën met de eerste activa uit een oneindige rij. We nemen aan dat de covariantiematrix van de eigen ruis een begrensde grootste eigenwaarde heeft: , met de grootste eigenwaarde. In de strikte factorstructuur van Ross is diagonaal, terwijl in de benaderende factorstructuur van Chamberlain & Rothschild (1983) aandelen in dezelfde bedrijfstak ook samen mogen bewegen, zolang geen richting onbegrensd veel eigen variantie verzamelt.
De som van de gekwadrateerde pricing errors blijft dus begrensd, hoeveel aandelen er ook bijkomen. Huberman (1982) bewijst dat door te schalen tot een portefeuille waarvan het verwachte rendement groeit en de variantie krimpt zodra die som onbegrensd is.
Proof 4
Stel dat langs een deelrij naar oneindig gaat. Kies dan .
Kosten nul. omdat . Geen factorrisico. omdat .
Verwachting groeit. . Variantie krimpt. . Samen vormen deze eigenschappen een asymptotische arbitrage, en dat is in strijd met de aanname.
De grens heeft twee gevolgen die in tegengestelde richting wijzen. Het eerste gaat over portefeuilles, het tweede over losse aandelen.
Gespreide portefeuilles worden juist gewaardeerd. Een portefeuille met heeft pricing error . Volgens Cauchy-Schwarz is die hoogstens , en voor de gelijkgewogen portefeuille is dat . Met de uit de simulatie hierna en is dat hoogstens per maand.
Losse aandelen niet noodzakelijk. Het aantal aandelen met is hoogstens . Dat is een vast getal, dus een verdwijnende fractie als groeit, maar elk van die aandelen mag fors verkeerd gewaardeerd zijn.
Daarmee komt ook de derde verwachting uit de intuïtie uit, want portefeuilles zijn juist gewaardeerd en losse aandelen niet noodzakelijk. Over één aandeel zegt de APT daardoor bijna niets, maar over een gespreide portefeuille bijna alles.
4.7Hoe het getoetst wordt: factoren en premies schatten
Factoren zijn uit de covarianties te halen. Raakt een factor veel aandelen, dan groeit de variantie die hij in de cross-sectie veroorzaakt mee met het aantal aandelen, terwijl de eigen ruis niet meegroeit. Een onderzoeker die de covariantiematrix ontbindt, ziet bij veel aandelen dus richtingen boven de rest uitsteken, en die richtingen zijn de factoren.
Chamberlain en Rothschild bewezen dat bij een benaderende factorstructuur met factoren de covariantiematrix eigenwaarden heeft die met groeien Chamberlain & Rothschild (1983). De bijbehorende eigenvectoren, de principale componenten (de portefeuilles met de grootste variantie, elk loodrecht op de vorige), schatten de factorbèta’s op een rotatie na.
De premies volgen in twee stappen. Eerst geeft een tijdreeksregressie van elk testactivum (in de replicatie een van de 25 portefeuilles) op de factoren de bèta’s. Daarna regresseren we elke maand de rendementen op die bèta’s, zodat het gemiddelde van de hellingen de premies schat. Met die methode toetsten Fama en MacBeth het CAPM Fama & MacBeth (1973), en in essentie deden Roll en Ross hetzelfde Roll & Ross (1980).
5Simulatie: pricing errors van losse aandelen en portefeuilles
Kan een onderzoeker met tien jaar maanddata een verkeerd gewaardeerd aandeel herkennen, en een verkeerd gewaardeerde portefeuille? We bouwen een wereld die aan (11) voldoet. In de simulatie heet de pricing error zoals gebruikelijk of alpha (de van de theorie). Twintig aandelen hebben een alpha van 1% per maand en alle andere een alpha van nul, ongeacht . De som blijft dus begrensd.
| grootheid | waarde |
|---|---|
| factoren | 3; maandvolatiliteit 4,5%, 3% en 3%; premie 0,5%, 0,3% en 0,3% per maand |
| bèta’s | , |
| eigen ruis | 8% per maand, onafhankelijk |
| verkeerd gewaardeerd | 20 aandelen met alpha 1% per maand (12% per jaar) |
| steekproef | maanden, 100 steekproeven per |
De functie schat per steekproef de alpha’s met tijdreeksregressies op de drie factoren en telt hoe vaak .
sim = {
    "premium": np.array([0.005, 0.003, 0.003]),     # factor premia per month
    "volatility": np.array([0.045, 0.030, 0.030]),  # factor volatility per month
    "sigma_eps": 0.08,                              # idiosyncratic volatility per month
    "n_bad": 20,                                    # number of mispriced stocks
    "alpha_bad": 0.01,                              # their alpha per month
}


def simulate_pricing_errors(N, T=120, n_rep=100):
    """Estimate alphas of N stocks, sim["n_bad"] of them mispriced, on T months of data.

    Returns the rejection rates of individual alphas and the true and estimated
    alpha of the equal-weighted portfolio across n_rep samples.
    """
    lam, vol, sigma_eps = sim["premium"], sim["volatility"], sim["sigma_eps"]
    n_bad, alpha_bad = sim["n_bad"], sim["alpha_bad"]
    B = np.column_stack([rng.normal(1.0, 0.3, N), rng.normal(0.0, 0.5, (N, 2))])
    alpha = np.zeros(N)
    alpha[:n_bad] = alpha_bad
    reject_bad, reject_good, alpha_ew_hat = [], [], []
    for _ in range(n_rep):
        f = lam + vol * rng.standard_normal((T, 3))
        excess = alpha + f @ B.T + sigma_eps * rng.standard_normal((T, N))
        design = np.column_stack([np.ones(T), f])
        coef, *_ = np.linalg.lstsq(design, excess, rcond=None)
        resid = excess - design @ coef
        se = np.sqrt((resid**2).sum(axis=0) / (T - 4) * np.linalg.inv(design.T @ design)[0, 0])
        t_alpha = coef[0] / se
        reject_bad.append(np.mean(np.abs(t_alpha[:n_bad]) > 1.96))
        reject_good.append(np.mean(np.abs(t_alpha[n_bad:]) > 1.96))
        alpha_ew_hat.append(coef[0].mean())
    return {
        "N": N,
        "som alpha^2": float(alpha @ alpha),
        "RMS alpha": float(np.sqrt(alpha @ alpha / N)),
        "alpha gelijkgewogen (waar)": float(alpha.mean()),
        "SD geschatte alpha gelijkgewogen": float(np.std(alpha_ew_hat)),
        "SE alpha per aandeel": float(se.mean()),
        "verworpen, verkeerd gewaardeerd": float(np.mean(reject_bad)),
        "verworpen, juist gewaardeerd": float(np.mean(reject_good)),
    }


N_grid = [25, 50, 100, 200, 400, 800, 1600, 3200]
pricing = pd.DataFrame([simulate_pricing_errors(N) for N in N_grid]).set_index("N")
pricing.round(4)De tabel laat zien dat de standaardfout van één alpha rond 0,75% per maand blijft, welke ook, zodat een alpha van 12% per jaar maar in ruim een kwart van de steekproeven wordt gevonden. Bij de gelijkgewogen portefeuille krimpen daarentegen de ware alpha en de spreiding van de geschatte alpha allebei naarmate groeit.
De figuur zet die twee kanten van de Huberman-grens naast elkaar, met bovenaan twee lijnen die vlak blijven en onderaan twee die dalen.
Source
fig, ax = plt.subplots()
ax.plot(pricing.index, np.full(len(pricing), 0.01) * 100, ls="--",
        label="alpha van een verkeerd gewaardeerd aandeel (waar)")
ax.plot(pricing.index, pricing["SE alpha per aandeel"] * 100, marker="o",
        label="standaardfout van de alpha van één aandeel")
ax.plot(pricing.index, pricing["alpha gelijkgewogen (waar)"] * 100, ls="--",
        label="alpha van de gelijkgewogen portefeuille (waar)")
ax.plot(pricing.index, pricing["SD geschatte alpha gelijkgewogen"] * 100, marker="o",
        label="steekproefspreiding van de geschatte alpha, gelijkgewogen")
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel("Aantal aandelen N (log-schaal)")
ax.set_ylabel("Procent per maand (log-schaal)")
ax.set_title("Pricing errors: een aandeel blijft groot, de portefeuille verdwijnt")
ax.legend()
plt.show()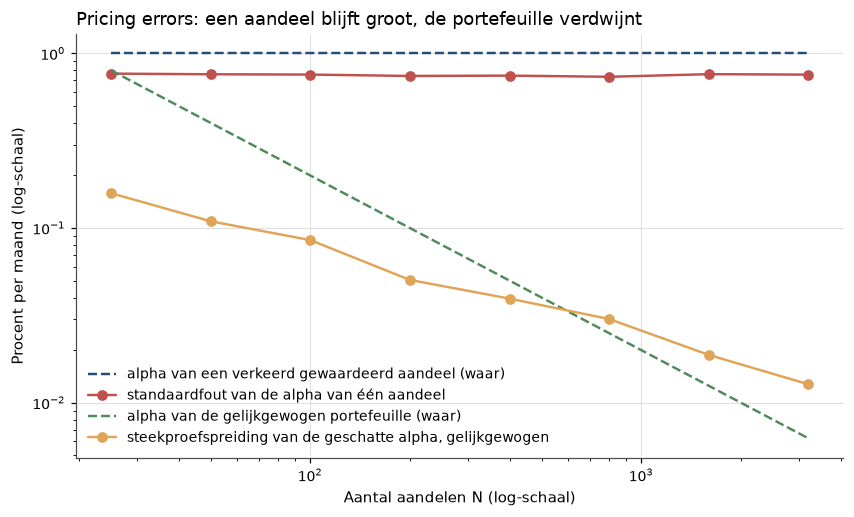
Figure 1:De bovenste twee lijnen laten zien dat de twintig verkeerd gewaardeerde aandelen hun alpha van 1% per maand houden, terwijl de standaardfout van die alpha met tien jaar data 0,75% is, hoe groot ook is. Volgens de onderste twee lijnen daalt de ware alpha van de gelijkgewogen portefeuille, , met en de schattingsfout met . Voor gespreide portefeuilles zijn de pricing error en de onzekerheid erover dus allebei klein, maar voor een los aandeel allebei groot.
Een los aandeel blijft onherkenbaar, want meer aandelen helpen het niet. Zijn standaardfout hangt alleen af van het aantal maanden :
Dat is de standaardfout van 2% in een andere gedaante. Ook hier wordt een gemiddelde alleen nauwkeuriger met de wortel van het aantal maanden, en niet met het aantal aandelen.
De juist gewaardeerde aandelen worden in ongeveer 5% van de steekproeven verworpen, zoals het hoort, maar bij 3200 aandelen zijn dat er veel meer dan de echte vondsten:
Voor portefeuilles is het beeld omgekeerd. De som van de gekwadrateerde pricing errors blijft 0,002, maar hun RMS (wortel van het gemiddelde kwadraat) zakt van 0,89% bij 25 aandelen naar 0,08% bij 3200, zoals (11) toestaat. De APT verbiedt dus niet dat er aan één aandeel iets te verdienen valt, maar wel dat het zonder risico kan.
6Replicatie op echte data
We laden de portefeuilles en de factoren en maken overrendementen.
ports = hap_data.french("25_Portfolios_5x5")
ff3 = hap_data.french("F-F_Research_Data_Factors")
sample = ports.join(ff3, how="inner").loc["1963-07":]
excess = sample[ports.columns].sub(sample["RF"], axis=0)
factors = sample[["Mkt-RF", "SMB", "HML"]]
assert excess.notna().all().all()

pd.Series({"begin": f"{excess.index[0]:%Y-%m}", "eind": f"{excess.index[-1]:%Y-%m}",
           "T (maanden)": len(excess), "N (portefeuilles)": excess.shape[1]})
begin 1963-07
eind 2026-07
T (maanden) 757
N (portefeuilles) 25
dtype: objectDe steekproef loopt van 1963-07 tot 2026-07 en telt 757 maanden. Nu ontbinden we de covariantiematrix van de 25 overrendementen. Omdat een eigenvector maar op een schaalfactor na vastligt, schalen we de eerste zo dat de gewichten optellen tot één, en de hogere zo dat er één euro long en één euro short staat. Het teken kiezen we zo dat de eerste component positief correleert met de markt, de andere met HML.
eigval, eigvec = np.linalg.eigh(np.cov(excess.to_numpy(), rowvar=False))
order = np.argsort(eigval)[::-1]
eigval, eigvec = eigval[order], eigvec[:, order]

n_pc = 5
pc_names = [f"PC{k}" for k in range(1, n_pc + 1)]
first = eigvec[:, 0] / eigvec[:, 0].sum()                    # long-only: weights sum to one
long_short = np.abs(eigvec[:, 1:n_pc]).sum(axis=0) / 2        # size of the long (= short) leg
higher = eigvec[:, 1:n_pc] / long_short                       # one euro long, one euro short
weights = np.column_stack([first, higher])
pcs = pd.DataFrame(excess.to_numpy() @ weights, index=excess.index, columns=pc_names)
for k, name in enumerate(pc_names):
    anchor = factors["Mkt-RF"] if k == 0 else factors["HML"]
    if pcs[name].corr(anchor) < 0:
        pcs[name] *= -1
        weights[:, k] *= -1
De tabel hieronder zet de eigenwaarden en hun aandeel in de variantie op een rij.
pd.DataFrame(
    {"eigenwaarde": eigval[:n_pc], "aandeel variantie": eigval[:n_pc] / eigval.sum(),
     "cumulatief": np.cumsum(eigval[:n_pc]) / eigval.sum()},
    index=pc_names,
).round(4)De eerste component verklaart 83% van de variantie en de eerste drie samen 93%. De figuur toont de gewichten over het 5×5-raster, en daarin valt vooral de richting op waarin de kleuren van de tweede en derde component verlopen.
Source
fig, axes = plt.subplots(1, 3, figsize=(12, 3.8), layout="constrained")
for k, ax in enumerate(axes):
    grid = weights[:, k].reshape(5, 5)
    bound = np.abs(grid).max()
    image = ax.imshow(grid, cmap="RdBu", vmin=-bound, vmax=bound)
    ax.set_xticks(range(5), ["laag", "2", "3", "4", "hoog"])
    ax.set_yticks(range(5), ["klein", "2", "3", "4", "groot"])
    ax.grid(False)
    ax.set_title(f"Gewichten van PC{k + 1}")
    ax.set_xlabel("Boekwaarde/marktwaarde")
    ax.set_ylabel("Omvang")
    fig.colorbar(image, ax=ax, shrink=0.8)
plt.show()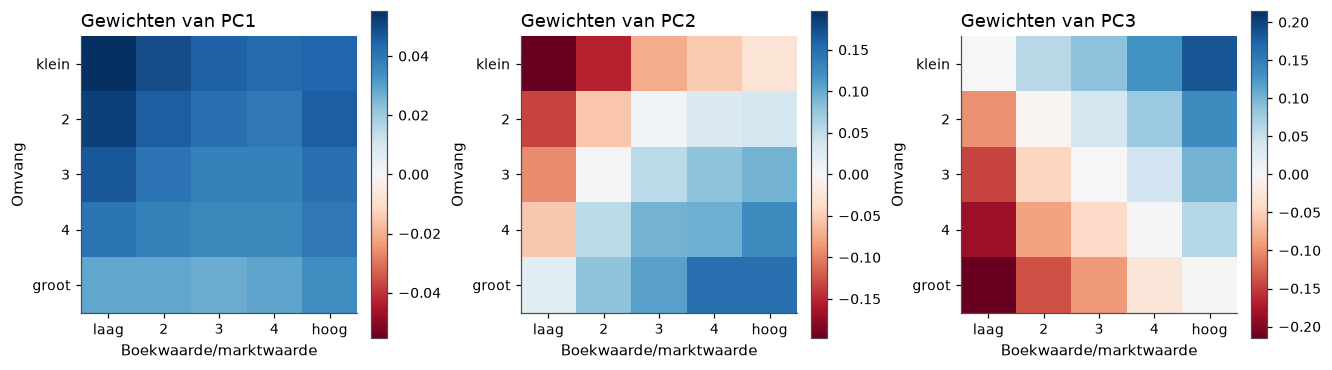
Figure 2:De eerste component is long in alle 25 portefeuilles, iets zwaarder in kleine aandelen, en is dus een marktportefeuille. De tweede is short in klein-groei en long in groot-waarde, de derde long in klein-waarde en short in groot-groei. Hun gradiënten lopen langs de diagonalen van het raster, zodat het mengsels van waarde en omvang zijn en geen zuivere SMB of HML.
De correlaties maken dat mengsel zichtbaar.
pd.concat([pcs.iloc[:, :3], factors], axis=1).corr().loc[pc_names[:3], factors.columns].round(3)PC1 correleert 0,93 met de markt, terwijl PC2 en PC3 elk samenhangen met zowel SMB als HML. De van de ene set op de andere laat zien of beide sets dezelfde ruimte opspannen.
def r_squared(y, X):
    """R^2 of an OLS regression of y on X with an intercept."""
    design = np.column_stack([np.ones(len(X)), X])
    coef, *_ = np.linalg.lstsq(design, y, rcond=None)
    resid = y - design @ coef
    return 1 - resid @ resid / ((y - y.mean()) @ (y - y.mean()))


pcs3 = pcs.iloc[:, :3]
r2 = {}
for c in factors.columns:
    r2[f"{c} op PC1, PC2, PC3"] = r_squared(factors[c].to_numpy(), pcs3.to_numpy())
for c in pcs3.columns:
    r2[f"{c} op Mkt-RF, SMB, HML"] = r_squared(pcs3[c].to_numpy(), factors.to_numpy())
pd.Series(r2, name="R-kwadraat").round(3)
Mkt-RF op PC1, PC2, PC3 0.967
SMB op PC1, PC2, PC3 0.920
HML op PC1, PC2, PC3 0.943
PC1 op Mkt-RF, SMB, HML 0.988
PC2 op Mkt-RF, SMB, HML 0.893
PC3 op Mkt-RF, SMB, HML 0.919
Name: R-kwadraat, dtype: float64Alle zes de ’s liggen boven 0,89, hoewel de componenten niets weten van boekwaarden of marktkapitalisaties. Ze zien alleen covarianties, en daarin zitten drie dominante richtingen die grotendeels de ruimte opspannen van de factoren die Fama en French in 1993 met de hand bouwden.
Omdat de componenten zelf portefeuilles van overrendementen zijn, is hun gemiddelde direct een schatting van de premie.
ts = hap.summary_stats(pd.concat([pcs, factors], axis=1))[["mean", "se_mean"]].astype(float)
ts["t"] = ts["mean"] / ts["se_mean"]
(ts[["mean", "se_mean"]] * 100).assign(t=ts["t"]).rename(
columns={"mean": "gemiddelde (%/mnd)", "se_mean": "SE (%/mnd)", "t": "t-waarde"}).round(3)De tabel laat zien dat PC1 tot en met PC3 een significant gemiddelde hebben en PC4 en PC5 niet. De standaardfout van PC1 is maal twaalf ruim 2% per jaar, zodat de premie ook met de volle steekproef niet tot op het procentpunt bekend is.
De tweede schatting volgt Roll en Ross, met eerst de bèta’s van de 25 portefeuilles op de componenten en dan per maand een cross-sectionele regressie op die bèta’s. De functie toont die maandelijkse regressies als lus. Daarnaast vragen we of de factoren alpha’s overlaten, en daarom zet de tabel het model met drie componenten naast het driefactormodel, met de GRS-toets van Gibbons, Ross en Shanken (of alle alpha’s samen nul zijn).
def two_pass(test_excess, factor_returns):
    """Full-sample betas, then one cross-sectional OLS regression per month.

    Same estimates as hap.fama_macbeth(..., lags=0) with constant betas, without
    statsmodels; TODO: naar hap.stats.
    """
    R = test_excess.to_numpy()
    F = factor_returns.to_numpy()
    coef, *_ = np.linalg.lstsq(np.column_stack([np.ones(len(F)), F]), R, rcond=None)
    Z = np.column_stack([np.ones(R.shape[1]), coef[1:].T])   # N x (K+1): constant and betas
    gammas = []
    for month in range(len(R)):                               # one regression per month
        slopes, *_ = np.linalg.lstsq(Z, R[month], rcond=None)
        gammas.append(slopes)
    gammas = np.array(gammas)                                 # T x (K+1): monthly slopes
    estimate = gammas.mean(axis=0)
    se = gammas.std(axis=0, ddof=1) / np.sqrt(len(gammas))
    return pd.DataFrame({"estimate": estimate, "se": se, "tstat": estimate / se},
                        index=["constante", *factor_returns.columns])


fm_pc3 = two_pass(excess, pcs.iloc[:, :3])
fm_ff3 = two_pass(excess, factors)
alpha_tests = {name: hap.grs_test(excess, f) for name, f in
               [("PC1-3", pcs.iloc[:, :3]), ("Mkt, SMB, HML", factors)]}

pd.DataFrame({
    "PC1-3": [*(fm_pc3["estimate"] * 100), alpha_tests["PC1-3"]["mean_abs_alpha"] * 100,
              alpha_tests["PC1-3"]["grs"], alpha_tests["PC1-3"]["pvalue"]],
    "Mkt, SMB, HML": [*(fm_ff3["estimate"] * 100), alpha_tests["Mkt, SMB, HML"]["mean_abs_alpha"] * 100,
                      alpha_tests["Mkt, SMB, HML"]["grs"], alpha_tests["Mkt, SMB, HML"]["pvalue"]],
}, index=["constante (%/mnd)", "premie factor 1 (%/mnd)", "premie factor 2 (%/mnd)",
"premie factor 3 (%/mnd)", "gem. |alpha| (%/mnd)", "GRS", "p-waarde GRS"]).round(3)De tabel laat zien dat geen van beide modellen de premies goed vangt. Beide laten een constante ver boven nul over, het driefactormodel zelfs met een negatieve marktpremie, en de GRS-toets verwerpt beide. Met drie componenten draagt alleen PC3 een significante premie.
Dat lijkt de simulatie tegen te spreken, waar gespreide portefeuilles vrijwel juist gewaardeerd waren, maar het is geen tegenspraak. Voor een gelijkgewogen portefeuille van aandelen staat de Huberman-grens een pricing error tot toe, en de constante is onbekend. Voor 25 portefeuilles verbiedt de grens daarom geen enkele alpha van eindige grootte. Zelfs de kleine uit de simulatie laat een alpha van 0,09% per maand toe tot portefeuilles van
aandelen elk. Met 757 maanden data is zo’n alpha wel meetbaar, maar de APT verbiedt hem niet.
Eerst toetsen we de vier drempels die we vooraf stelden. Roll en Ross rapporteerden geen principale componenten en geen Fama-French-factoren, zodat er hiervoor geen origineel bestaat en alleen onze verwachting telt.
r2_smb_hml_on_pcs = min(r2["SMB op PC1, PC2, PC3"], r2["HML op PC1, PC2, PC3"])
r2_pcs_on_ff3 = min(r2[f"{c} op Mkt-RF, SMB, HML"] for c in pcs3.columns)

pd.DataFrame({
    "verwacht (ondergrens)": [0.75, 0.9, 0.85, 0.85],
    "hier": [eigval[0] / eigval.sum(), pcs["PC1"].corr(factors["Mkt-RF"]),
             r2_smb_hml_on_pcs, r2_pcs_on_ff3],
}, index=["aandeel variantie PC1", "correlatie PC1 met Mkt-RF",
          "laagste R2 van SMB en HML op PC1-3",
"laagste R2 van PC1-3 op Mkt-RF, SMB, HML"]).round(3)Alle vier liggen boven hun ondergrens, dus vergelijken we nu met het origineel hoeveel factoren een premie dragen.
priced_ts = int((ts.loc[pc_names, "t"].abs() > 1.96).sum())
priced_cs = int((fm_pc3.loc[pc_names[:3], "tstat"].abs() > 1.96).sum())

pd.DataFrame({"origineel (Roll en Ross)": ["3 à 4", "3 à 4"],
              "hier": [priced_ts, priced_cs]},
             index=["componenten met een premie, tijdreeks",
"componenten met een premie, cross-sectie (K = 3)"])Gedeeltelijk geslaagd. De vier vooraf gestelde drempels worden gehaald, want de eerste component is de markt en drie componenten spannen vrijwel dezelfde ruimte op als Mkt, SMB en HML. Het aantal componenten met een premie wijkt af, zoals we vooraf al mogelijk achtten. In de tijdreeks zijn het er drie, maar in de cross-sectie met drie componenten maar één, tegen drie à vier bij Roll en Ross. Bij andere verschuift dat getal weer, zoals de derde oefening laat zien. Critici van Roll en Ross voerden precies aan dat het aantal factoren met een premie van de toets en de testactiva afhangt.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. De fundamentele stelling is geen model dat kan breken, maar de grammatica van elk later model. Ze verklaart waarom een optie een prijs heeft zonder nutsfunctie, waarom risiconeutraal rekenen werkt, en waarom met een positieve volgt uit het ontbreken van gratis geld. De APT voegt een voorspelling toe die in de data overeind blijft, namelijk dat een paar richtingen van covariantie de cross-sectie domineren en dat principale componenten ze terugvinden. In onze 25 portefeuilles zijn dat markt, omvang en waarde. Factorbèta’s werden de taal van risicomodellen.
Waar het breekt. Het model breekt op twee plekken. Shanken liet zien dat de Huberman-grens niet bestand is tegen herverpakken Shanken (1982), want dezelfde economie kan in de ene set testactiva aan de grens voldoen en in een lineaire combinatie ervan niet. Een grens op een oneindige som is met eindige data bovendien niet te toetsen. Dybvig en Ross antwoordden Dybvig & Ross (1985) dat het CAPM er niet beter voor staat, omdat de marktportefeuille waarop het steunt niet waarneembaar is Roll (1977). De tweede plek is onze replicatie, waarin drie componenten 93% van de variantie verklaren maar een constante van 0,84% per maand en alpha’s overlaten die de GRS-toets verwerpt.
Risico of vergissing? De APT kiest geen kant. Volgens de Chicago-lezing, die prijzen als rationeel ziet, zijn SMB en HML dominante richtingen van covariantie en dus risico dat niet weg te diversifiëren is, zodat de APT er een premie op voorspelt. Volgens de Yale-lezing, die ruimte laat voor vergissingen van beleggers, ontstaat ook een factor als beleggers systematisch te enthousiast zijn over groeiaandelen, omdat die vergissing alle groeiaandelen tegelijk beweegt. Wie zo’n gemeenschappelijke verkeerde prijs wegarbitreert, draagt het factorrisico, en daar gelden de limits of arbitrage (de grenzen aan wat arbitrageurs met beperkt kapitaal kunnen rechtzetten). De kampen zouden alleen te scheiden zijn met een premie zonder covariantie, en zulke data zijn schaars.
Wat er daarna kwam. De fundamentele stelling garandeert een positieve SDF maar wijst er geen aan. Lucas en Breeden gaven een economische inhoud door de SDF aan consumptie te binden, in Lucas, Breeden en de SDF.
8Oefeningen
Solution to Exercise 1
(1) De voorwaarden zijn en . Trek de eerste van de tweede af: , dus . Invullen in de eerste geeft . Strikte positiviteit vraagt . De toestandsprijzen vormen het open lijnstuk van naar . De callprijs is en ligt dus in .
(2)
X3 = np.array([[1.00, 1.40],
               [1.00, 1.00],
               [1.00, 0.60]])
p3 = np.array([0.90, 0.86])
call3 = np.array([0.40, 0.00, 0.00])

bounds = [optimize.linprog(sign * call3, A_eq=X3.T, b_eq=p3, bounds=[(0, None)] * 3)
          for sign in (1, -1)]
lower, upper = bounds[0].fun, -bounds[1].fun
super_rep = np.linalg.solve(np.array([[1.00, 1.40], [1.00, 0.60]]), np.array([0.40, 0.00]))

pd.Series({"ondergrens": lower, "bovengrens": upper,
           "q bij bovengrens (goed)": bounds[1].x[0], "q bij bovengrens (midden)": bounds[1].x[1],
           "q bij bovengrens (slecht)": bounds[1].x[2],
           "payoff super-replicatie (midden)": X3[1] @ super_rep,
           "kosten super-replicatie": p3 @ super_rep}).round(4)
ondergrens 0.00
bovengrens 0.16
q bij bovengrens (goed) 0.40
q bij bovengrens (midden) 0.00
q bij bovengrens (slecht) 0.50
payoff super-replicatie (midden) 0.20
kosten super-replicatie 0.16
dtype: float64De grenzen zijn 0 en 0,16. De bovengrens is de prijs van het pakket uit stap 4 van het toy-voorbeeld, want dat pakket maakt de call in goed en slecht na en keert in midden 0,20 extra uit. In een incomplete markt legt arbitrage dus geen prijs vast maar een interval, en elke prijs daarbinnen hoort bij een andere SDF.
:::{exercise}
:label: ex-apt-no-arbitrage-2

**Afleiding: de één-stapsboom.** Een aandeel kost 1 en keert morgen $u$ of $d$ uit, met
$u > d$. Een obligatie kost 1 en keert $1 + R^{f}$ uit.

1. Leid [](#eq-apt-no-arbitrage-crr-q) af uit [](#eq-apt-no-arbitrage-drie-namen).
2. Laat met [](#thm-apt-no-arbitrage-fundamenteel) zien dat de markt arbitragevrij is
   dan en slechts dan als $d < 1 + R^{f} < u$. Geef voor $1 + R^{f} \geq u$ een
   expliciete arbitrage.
Solution to ex-apt-no-arbitrage-2
(1) Onder verdient het aandeel de rente: . Oplossen naar geeft (6).
(2) Toestandsprijzen lossen en op. Dat geeft
Beide zijn strikt positief dan en slechts dan als . Volgens de stelling is dat equivalent met geen arbitrage. Is , dan verkopen we één aandeel short en beleggen we de opbrengst in de obligatie. Vandaag kost dat niets, en morgen levert het op in de goede toestand en in de slechte. De voorwaarde voor een zinnige binomiale boom is dus de fundamentele stelling in de kleinste vorm.
Solution to Exercise 2
industries = hap_data.french("49_Industry_Portfolios")
ind = industries.join(ff3, how="inner").loc["1969-07":]
ind_excess = ind[industries.columns].dropna(axis=1).sub(ind["RF"], axis=0)
ind_factors = ind[["Mkt-RF", "SMB", "HML"]]

val, vec = np.linalg.eigh(np.cov(ind_excess.to_numpy(), rowvar=False))
val, vec = val[::-1], vec[:, ::-1]
ind_pcs = ind_excess.to_numpy() @ vec[:, :3]

pd.Series({
    "aantal bedrijfstakken": ind_excess.shape[1],
    "aandeel variantie PC1": val[0] / val.sum(),
    "aandeel variantie PC1-3": val[:3].sum() / val.sum(),
    **{f"R2 {c} op PC1-3": r_squared(ind_factors[c].to_numpy(), ind_pcs)
       for c in ind_factors.columns},
}).round(3)
aantal bedrijfstakken 49.000
aandeel variantie PC1 0.552
aandeel variantie PC1-3 0.655
R2 Mkt-RF op PC1-3 0.917
R2 SMB op PC1-3 0.170
R2 HML op PC1-3 0.027
dtype: float64De eerste component is ook hier de markt, want de van Mkt-RF op de eerste drie componenten is 0,92. Toch verklaart die component maar 55% van de variantie, tegen 83% bij de size/BM-portefeuilles. De eerste drie componenten verklaren SMB voor 17% en HML voor 3%. Bedrijfstakken zijn niet op omvang en boekwaarde gesorteerd, zodat hun dominante richtingen andere zijn, vermoedelijk sectorcontrasten. Welke factoren een principale-componentenanalyse vindt, is dus een eigenschap van de testactiva, en dat is de empirische kant van de kritiek van Shanken (1982).
(4)
t_values = pd.DataFrame({f"K = {K}": two_pass(excess, pcs.iloc[:, :K])["tstat"]
                         for K in range(1, n_pc + 1)}).reindex(["constante", *pc_names])
t_values.round(2)Het aantal significante premies is achtereenvolgens 0, 2, 1, 1 en 3. Met alleen PC1 is de constante significant en de premie op PC1 nul, zodat de security market line van Het CAPM, de lijn van gemiddeld rendement tegen bèta, ook hier vlak is. Het aantal factoren met een premie hangt dus ook af van hoeveel componenten de onderzoeker in de regressie opneemt.
- Roll, R., & Ross, S. A. (1980). An Empirical Investigation of the Arbitrage Pricing Theory. The Journal of Finance, 35(5), 1073–1103. 10.1111/j.1540-6261.1980.tb02197.x
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Ross, S. A. (1976). The Arbitrage Theory of Capital Asset Pricing. Journal of Economic Theory, 13(3), 341–360. 10.1016/0022-0531(76)90046-6
- Dybvig, P. H., & Ross, S. A. (1987). Arbitrage. In The New Palgrave Dictionary of Economics. Palgrave Macmillan. 10.1057/978-1-349-95121-5_449-1
- Cox, J. C., & Ross, S. A. (1976). The Valuation of Options for Alternative Stochastic Processes. Journal of Financial Economics, 3(1–2), 145–166. 10.1016/0304-405X(76)90023-4
- Harrison, J. M., & Kreps, D. M. (1979). Martingales and Arbitrage in Multiperiod Securities Markets. Journal of Economic Theory, 20(3), 381–408. 10.1016/0022-0531(79)90043-7
- Harrison, J. M., & Pliska, S. R. (1981). Martingales and Stochastic Integrals in the Theory of Continuous Trading. Stochastic Processes and Their Applications, 11(3), 215–260. 10.1016/0304-4149(81)90026-0
- Cox, J. C., Ross, S. A., & Rubinstein, M. (1979). Option Pricing: A Simplified Approach. Journal of Financial Economics, 7(3), 229–263. 10.1016/0304-405X(79)90015-1
- Chamberlain, G., & Rothschild, M. (1983). Arbitrage, Factor Structure, and Mean-Variance Analysis on Large Asset Markets. Econometrica, 51(5), 1281–1304. 10.2307/1912275
- Huberman, G. (1982). A Simple Approach to Arbitrage Pricing Theory. Journal of Economic Theory, 28(1), 183–191. 10.1016/0022-0531(82)90098-9
- Fama, E. F., & MacBeth, J. D. (1973). Risk, Return, and Equilibrium: Empirical Tests. Journal of Political Economy, 81(3), 607–636. 10.1086/260061
- Fama, E. F., & French, K. R. (1993). Common Risk Factors in the Returns on Stocks and Bonds. Journal of Financial Economics, 33(1), 3–56. 10.1016/0304-405X(93)90023-5
- Connor, G., & Korajczyk, R. A. (1995). The Arbitrage Pricing Theory and Multifactor Models of Asset Returns. In R. A. Jarrow, V. Maksimovic, & W. T. Ziemba (Eds.), Finance (pp. 87–144). 10.1016/S0927-0507(05)80048-9
- Shanken, J. (1982). The Arbitrage Pricing Theory: Is It Testable? The Journal of Finance, 37(5), 1129–1140. 10.1111/j.1540-6261.1982.tb03607.x
- Dybvig, P. H., & Ross, S. A. (1985). Yes, The APT Is Testable. The Journal of Finance, 40(4), 1173–1188. 10.1111/j.1540-6261.1985.tb02370.x
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD