

Basu, Banz en Rosenberg
1Overzicht
In de steekproeven van de eerste onderzoekers voorspelden de winst-koersverhouding, de marktwaarde en de boekwaarde het rendement beter dan bèta: goedkope en kleine aandelen hadden een positieve CAPM-alpha (het deel van het gemiddelde rendement dat bèta niet verklaart). Maar hetzelfde patroon past bij een gemist risico, bij een vergissing van de markt en bij toeval.
In dit college:
rekenen we met vijf aandelen na hoe een sortering een alpha oplevert;
laten we zien dat een sortering een regressie zonder vorm is, en een Fama-MacBeth-helling op een kenmerk een long-short-portefeuille;
bewijzen we met Berk dat marktwaarde het verwachte rendement voorspelt, ook als elke prijs klopt, en hoe een gezocht kenmerk een grote -waarde maakt;
simuleren we een echte premie die onzichtbaar blijft, en een zichtbare premie die niet bestaat;
repliceren we de CAPM-alpha’s van E/P-, B/M- en size-portefeuilles in de oorspronkelijke steekproeven en daarna, en het januari-effect van Keim.
Tussen 1977 en 1985 verschenen vier artikelen die telkens één kenmerk naast bèta legden, met een voorloper en twee vervolgen eromheen:
| jaar | artikel | kenmerk naast bèta |
|---|---|---|
| 1977 | Basu (1977) | koers-winstverhouding |
| 1980 | Stattman (1980) | boekwaarde tot marktwaarde (voorloper) |
| 1981 | Banz (1981) | marktwaarde |
| 1981 | Reinganum (1981) | koers-winstverhouding en marktwaarde tegelijk |
| 1983 | Keim (1983) | marktwaarde, met een groot deel van het effect in januari |
| 1985 | Rosenberg et al. (1985) | boekwaarde tot marktwaarde |
| 1988 | Bhandari (1988) | schuldgraad, vooral in januari |
Het woord anomalie (een regelmaat in gemiddelde rendementen die het heersende model niet verklaart) kreeg in deze jaren zijn betekenis. Aan het eind van het tijdvak kwamen de eerste waarschuwingen tegen datamining Lo & MacKinlay (1990)Black (1993).
Met deze artikelen begint een nieuw tijdvak, omdat ze het antwoord op de vraag theorie of feit verschoven. Het CAPM bleef een getoetste theorie, maar kreeg er een lijst afwijkingen bij: feiten zonder een model dat ze vooraf had voorspeld.
2Intuïtie: waarom zou dit waar zijn?
In juli 1960 vroeg S. Francis Nicholson analisten en zakenmensen welke aandelen het over drie tot tien jaar beter zouden doen: die met een koers boven 25 keer de winst, of die onder 12 keer Nicholson (1960). Bijna tien tegen één verwachtten ze meer van de dure aandelen. Meer stelde zijn enquête niet vast, ook al citeert de latere literatuur Nicholson als vroeg bewijs dat juist de goedkope het beter deden. Er was toen ook nog geen model waaraan beter te meten viel. Zeventien jaar later stelde Basu dezelfde vraag opnieuw, met de bèta’s van het CAPM als maatstaf.
Waarom zou een goedkoop aandeel meer opleveren? Het eerste verhaal is een rekensom. De koers is de contante waarde van de toekomstige kasstromen. Van twee bedrijven met dezelfde verwachte winst is het riskantere goedkoper, omdat beleggers er meer rendement voor eisen. Een lage koers ten opzichte van de winst is dan een hoge discontovoet. Ziet het CAPM dat risico niet, dan verschijnt het als alpha.
Het tweede verhaal is psychologie. Beleggers extrapoleren: bedrijven met slechte recente winsten worden te somber gewaardeerd, bedrijven met mooie groeiverhalen te optimistisch. De koers-winstverhouding meet dan de vergissing, en het hogere rendement van goedkope aandelen is de trage correctie. De verwachting van Nicholsons analisten past in dat beeld, net als het werk van De Bondt en Thaler in Behavioral finance en limits of arbitrage.
Beide verhalen voorspellen hetzelfde feit, zodat een sortering ze niet kan scheiden. Ze kan hooguit laten zien dat er iets is, en zelfs dat is onzeker, want gemiddelde rendementen zijn slecht gemeten. We verwachten daarom een positieve CAPM-alpha voor goedkope en kleine aandelen, ook als hun bèta niet hoger is. Omdat het eerste verhaal geen vergissing nodig heeft, zou een kenmerk dat met de koers is berekend het verwachte rendement ook moeten voorspellen als elke prijs klopt. Een kenmerk dat juist in de data is gezocht, zal in die data een grote -waarde hebben en daarbuiten niet.
3Toy-voorbeeld: vijf aandelen, twee portefeuilles
Het toy-voorbeeld laat zien hoe een sortering op E/P een alpha oplevert. We laden eerst de pakketten voor het hele college.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. We nemen vijf aandelen en één periode. Van elk aandeel kennen we de bèta, de winst-koersverhouding E/P (winst gedeeld door koers, het omgekeerde van de koers-winstverhouding), de marktwaarde ME aan het begin van de periode en het gerealiseerde netto rendement . De risicovrije rente is . Het subscript staat voor de marktportefeuille, niet voor de SDF.
| aandeel | E/P | ME | ||
|---|---|---|---|---|
| A | 1,10 | 3% | 500 | 5,0% |
| B | 1,00 | 5% | 250 | 6,1% |
| C | 0,90 | 6% | 125 | 7,0% |
| D | 0,80 | 9% | 75 | 8,0% |
| E | 0,55 | 12% | 50 | 10,0% |
Het recept. De gerealiseerde Jensen-alpha over één periode is het overrendement min bèta maal het overrendement van de markt: , het CAPM uit Het CAPM met een restterm. Een positieve alpha betekent dat het aandeel meer opleverde dan zijn bèta rechtvaardigt.
Stap 1, de markt. De marktgewichten zijn ME gedeeld door 1000: . Het marktrendement is , het overrendement van de markt dus . De marktgewogen bèta is , zoals het hoort.
Stap 2, de alpha per aandeel. , , , en . Marktgewogen tellen ze op tot nul, want de markt heeft ten opzichte van zichzelf geen alpha.
Stap 3, de sortering. Portefeuille H bevat de twee aandelen met de hoogste E/P (D en E), portefeuille L de twee met de laagste (A en B), elk gelijkgewogen. C valt tussen de breekpunten. De long-short-portefeuille H − L koopt H en verkoopt L short, en kost dus niets.
| bèta | overrendement | CAPM-voorspelling | alpha | |
|---|---|---|---|---|
| H = (D, E) | 0,675 | 8,00% | 3,375% | 4,625% |
| L = (A, B) | 1,050 | 4,55% | 5,250% | −0,700% |
| H − L | −0,375 | 3,45% | −1,875% | 5,325% |
Stap 4, de alpha van H − L. Het overrendement van H − L is en de bèta . De alpha is dan , het verschil van de twee alpha’s. Het ruwe rendementsverschil van 3,45% onderschat de alpha, omdat het CAPM voor H − L een negatief rendement voorspelt: de goedkope aandelen hebben een lagere bèta.
De code hieronder rekent hetzelfde na. Ze kijkt ook welke aandelen een sortering op marktwaarde zou kiezen.
toy = pd.DataFrame(
    {"beta": [1.10, 1.00, 0.90, 0.80, 0.55],
     "E/P": [0.03, 0.05, 0.06, 0.09, 0.12],
     "ME": [500.0, 250.0, 125.0, 75.0, 50.0],
     "r": [0.050, 0.061, 0.070, 0.080, 0.100]},
    index=list("ABCDE"),
)
rf_toy = 0.01
weights = toy["ME"] / toy["ME"].sum()
r_market = weights @ toy["r"]
toy["alpha"] = toy["r"] - rf_toy - toy["beta"] * (r_market - rf_toy)

def toy_portfolio(stocks):
    """Equal-weighted beta, excess return, CAPM prediction and alpha."""
    g = toy.loc[stocks]
    beta, excess = g["beta"].mean(), g["r"].mean() - rf_toy
    return pd.Series({"bèta": beta, "overrendement": excess,
                      "CAPM": beta * (r_market - rf_toy), "alpha": g["alpha"].mean()})

high_ep, low_ep = toy.nlargest(2, "E/P").index, toy.nsmallest(2, "E/P").index
sorted_toy = pd.DataFrame({"H": toy_portfolio(high_ep), "L": toy_portfolio(low_ep)}).T
sorted_toy.loc["H - L"] = sorted_toy.loc["H"] - sorted_toy.loc["L"]
same_as_me = float(set(toy.nsmallest(2, "ME").index) == set(high_ep))      # 1 = yes
pd.DataFrame(
    {"met de hand": [0.06, 1.0, 0.0, 0.04625, -0.007, -0.375, 0.0345, 0.05325, 1.0],
     "code": [r_market, weights @ toy["beta"], weights @ toy["alpha"], *sorted_toy["alpha"].iloc[:2],
              *sorted_toy.loc["H - L", ["bèta", "overrendement", "alpha"]], same_as_me]},
    index=["marktrendement", "marktbèta", "marktgewogen alpha", "alpha H", "alpha L",
           "bèta H - L", "overrendement H - L", "alpha H - L", "zelfde H en L bij ME-sortering (1 = ja)"],
).round(5)De code en de handberekening geven dezelfde getallen. Volgens de laatste rij kiest een sortering op marktwaarde dezelfde twee portefeuilles, want de goedkoopste aandelen zijn ook de kleinste. Of dit een E/P- of een size-effect is, was de vraag van Reinganum (1981). Een sortering meet dus de alpha van een kenmerk, maar zegt niet welk kenmerk het werk doet. Of 5,3% toeval is, valt uit één periode niet af te leiden, want daarvoor is een tijdreeks nodig.
4Theorie
We leiden vier dingen af. Eerst laten we zien dat een portefeuillesortering een regressie zonder vorm is, met voor hoog min laag een Jensen-alpha en een eigen standaardfout. Daarna blijkt een Fama-MacBeth-helling op een kenmerk een long-short-portefeuille te zijn. De kern volgt daarna: volgens Berk voorspelt marktwaarde het verwachte rendement zodra verwachte rendementen verschillen. Tot slot laten we zien hoe een kenmerk dat in de data is gezocht een grote -waarde maakt.
4.1Opzet: sorteren als regressie zonder vorm
Een portefeuillesortering schat het verwachte rendement als functie van een kenmerk, zonder die functie een vorm op te leggen. We schrijven voor een kenmerk van aandeel dat op bekend is, zoals E/P, of B/M, en voor het overrendement daarna.
Stel dat een onderzoeker wil weten of aandelen met een hoge E/P later meer opleveren. Hij zet de aandelen op volgorde van E/P, deelt de rij in tien groepen en neemt per groep het gemiddelde rendement. Stijgt dat gemiddelde van groep tot groep, dan stijgt het verwachte rendement met E/P, welke vorm het verband ook heeft.
Laat het verwachte overrendement bij kenmerk zijn, en de breekpunten, bijvoorbeeld de decielen van op . Met aandelen in vakje is het gelijkgewogen rendement van portefeuille
In woorden: portefeuille verdient gemiddeld de waarde van op vakje , dus het tijdgemiddelde schat vakje voor vakje, als een histogram. Meer vakjes geven minder vertekening en meer ruis. Met tien decielen kiezen we voor weinig ruis. Het nadeel is dat een effect bij de kleinste paar procent van de aandelen, zoals dat van Banz, over het hele eerste deciel wordt uitgesmeerd.
4.2De alpha van een long-short-portefeuille
Of een kenmerk iets toevoegt aan het CAPM, blijkt uit de alpha van hoog min laag. De standaardfout van die alpha is ongeveer de residuele volatiliteit gedeeld door .
Denk aan een belegger die de hoogste portefeuille koopt en de laagste short verkoopt. Levert dat meer op dan het verschil in bèta rechtvaardigt, dan voegt het kenmerk iets toe, en hoe langer hij de positie volgt, hoe kleiner de toevalsfout in zijn gemiddelde.
Laat het rendement zijn van de hoogste min de laagste portefeuille. Over maanden schatten we
Hoog min laag verdient een alpha plus bèta maal het overrendement van de markt. Het is de CAPM-regressie uit (5), toegepast op één reeks. Omdat OLS lineair is in de afhankelijke variabele, is , zoals in stap 4 van het toy-voorbeeld. Zijn de residuen onafhankelijk van de markt, met variantie , dan is de variantie van het -element van , met een kolom enen naast de marktrendementen:
met en het steekproefgemiddelde en de standaarddeviatie van het overrendement van de markt. De standaardfout is dus de residuele volatiliteit gedeeld door , met een kleine correctie voor de Sharpe-ratio van de markt.
Met de marktpremie van de simulatie hieronder, 0,5% per maand bij 4,5% volatiliteit, is die Sharpe-ratio 0,11 en de correctieterm 1,01. Bij een residuele volatiliteit van 5% per maand en veertig jaar data is de standaardfout per maand, bijna 3% per jaar. Voor een alpha is dat de standaardfout van 2% uit Rendementen en hun statistiek, want ook veertig jaar data meten een gemiddelde maar grof. De steekproeven van Basu (veertien jaar) en van Rosenberg, Reid en Lanstein (twaalf jaar) konden dus alleen grote effecten significant maken.
4.3Fama-MacBeth met kenmerken
Een Fama-MacBeth-regressie op een kenmerk doet hetzelfde als een sortering, maar met rechte lijnen als gewichten in plaats van stapfuncties. In Het CAPM was de maandelijkse Fama-MacBeth-helling op bèta het rendement van een portefeuille die niets kost en bèta één heeft. Een onderzoeker die bèta door E/P vervangt, krijgt als helling het rendement van een portefeuille die hoge E/P koopt en lage E/P short verkoopt. De gewichten stijgen lineair met E/P, zodat de uitersten zwaarder wegen dan in een sortering met dezelfde blootstelling. Per maand draaien we over de aandelen de regressie
De helling meet wat een eenheid kenmerk die maand opleverde, bij
gegeven bèta. We rapporteren het tijdgemiddelde met de standaardfout
uit de tijdreeks van de hellingen. In de code is dat hap.stats.fama_macbeth.
De index staat voor het kenmerk. In (4) is dat de helling . Staat bèta in de regressie, dan heeft de portefeuille bèta nul. Het bewijs berust erop dat een helling een covariantie gedeeld door een variantie is, en die breuk is een gewogen som van rendementen.
Proof 1
Voor een regressie op een constante en één variabele is . De gewichten tellen op tot nul omdat , en geeft blootstelling één. Met meer regressoren is . De rijen van zijn de gewichten, en zegt dat rij blootstelling één heeft aan regressor en nul aan de rest.
In het toy-voorbeeld is de gemiddelde E/P 7%. De afwijkingen zijn en hun kwadratensom is , dus de gewichten zijn . Dat is de richting van H − L, maar met C erbij en zwaardere uitersten. H en L verschillen procentpunt in E/P, zodat H − L bij dezelfde blootstelling één elk van zijn vier aandelen geeft, tegen 10 voor E in de regressie. De cel haalt de gewichten uit de OLS-matrix.
z_toy = toy["E/P"]
X_toy = np.column_stack([np.ones(5), z_toy])
fm_weights = np.linalg.solve(X_toy.T @ X_toy, X_toy.T)[1]      # second row of (X'X)^-1 X'
deviation = z_toy - z_toy.mean()
print(f"som w = {fm_weights.sum():.4f}, som w z = {fm_weights @ z_toy:.4f}")
pd.DataFrame({"gewicht uit OLS": fm_weights, "formule": deviation / (deviation**2).sum()},
             index=toy.index).round(4)
som w = 0.0000, som w z = 1.0000
De gewichten uit OLS en uit de formule zijn gelijk, tellen op tot nul en geven blootstelling één aan E/P. Met twee kenmerken tegelijk beantwoordt Fama-MacBeth de vraag van Reinganum, E/P of size, in één regressie. Daar staat tegenover dat de regressie lineair is, zodat extreme kenmerkwaarden extreme gewichten krijgen.
Rosenberg gebruikte dezelfde regressie voor een risicomodel Rosenberg & McKibben (1973)Rosenberg (1974). Zijn bedrijf Barra bracht in 1975 het eerste commerciële multifactor-risicomodel voor Amerikaanse aandelen uit. Het nam van de maandelijkse hellingen op bedrijfstak, omvang, B/M en schuldgraad niet het slecht gemeten gemiddelde, maar de goed gemeten covariantiematrix. Zo omzeilde Barra het probleem van de slecht gemeten gemiddelden, want covarianties zijn met maanddata wel nauwkeurig te schatten.
4.4Het kernresultaat: marktwaarde voorspelt verwacht rendement
Verschillen verwachte rendementen tussen bedrijven, om welke reden ook, dan voorspelt marktwaarde ze, ook als elke prijs klopt Berk (1995). Neem twee bedrijven met dezelfde verwachte kasstroom. Beleggers eisen van het ene een hoger rendement en betalen er daarom minder voor. Wie op marktwaarde sorteert, sorteert dus deels op verwacht rendement, zonder dat iemand zich vergist. Mist het toetsmodel het risico dat die rendementen drijft, dan verschijnt het gemiste deel als alpha van kleine bedrijven. Het omgekeerde, een wereld waarin marktwaarde niet met verwacht rendement correleert, zou volgens Berk de anomalie zijn.
Het eenvoudigste model is het Gordon-model uit Williams en het dividend discount model: het dividend van volgend jaar gedeeld door discontovoet min groei. Hier heeft bedrijf een verwachte kasstroom volgend jaar, een gemeenschappelijke groeivoet en een eigen discontovoet , gelijk aan het verwachte rendement van het aandeel:
In woorden: de log marktwaarde is de log kasstroom min de log van het verschil tussen discontovoet en groei. Een hogere maakt het bedrijf kleiner.
Geeft het model elk aandeel hetzelfde verwachte rendement, dan zegt de stelling dat marktwaarde en verwacht rendement negatief correleren. Het bewijs berust erop dat de marktwaarde bij gegeven daalt in , terwijl de kasstroom alleen ruis toevoegt.
Proof 2
Schrijf , strikt stijgend op . Omdat onafhankelijk is van , is .
Stap 1: een stijgende functie correleert positief met het argument. Voor een strikt stijgende en een onafhankelijke kopie van is , want de integrand is nooit negatief en positief zodra .
Stap 2: conditioneren op het model. Gegeven is strikt stijgend, dus stap 1 geeft . De wet van de totale covariantie voegt toe, en die is nul omdat constant is.
Hoe sterk is de correlatie? Een lineaire benadering rond het gemiddelde geeft , uitgewerkt in de tweede oefening. In de simulatie hieronder is de correlatie maar , omdat bedrijven vooral in de omvang van hun kasstromen verschillen. Size is dus een ruisige thermometer van verwacht rendement. E/P en B/M zijn betere thermometers, want hun teller (winst, boekwaarde) schaalt mee met het kasstroomniveau en haalt zo een deel van die ruis weg.
Een kenmerk dat met de koers is berekend, voorspelt het verwachte rendement dus ook bij correcte prijzen, zoals het eerste verhaal uit de intuïtie deed vermoeden. De stelling geldt echter voor elke , ook voor een alpha die ontstaat doordat beleggers kasstromen te zwaar verdisconteren. Een correlatie tussen marktwaarde en alpha bewijst dus risico noch vergissing.
4.5Data snooping: Lo en MacKinlay
Een kenmerk dat in de data is gezocht, geeft in diezelfde data een grote -waarde, ook als er niets is. Kiest een onderzoeker een kenmerk omdat het in de data iets leek te doen, dan sorteert hij deels op de toevalsfout in de rendementen die hij daarna toetst. De aandelen met de grootste positieve fout komen in de hoogste portefeuille, die met de grootste negatieve in de laagste. Daardoor stijgt de -waarde van hoog min laag, terwijl ze buiten de steekproef terugvalt naar nul.
Het artikel van Lo & MacKinlay (1990) liet met berekeningen, simulaties en twee empirische voorbeelden zien dat dit effect groot kan zijn. Hieronder staat een eigen, eenvoudiger versie van hetzelfde mechanisme.
Het bewijs berust erop dat de sortering aandelen kiest met een die gemiddeld standaarddeviaties boven nul ligt, en in de korte poot evenveel eronder. Het verschil tussen de twee poten ligt dan tweemaal zo ver van nul, en gedeeld door de standaardfout van dat verschil, in dezelfde eenheid, geeft dat de -waarde.
Proof 3
Omdat OLS lineair is, is de long-short-alpha het verschil van de gemiddelde in de twee groepen. Voor gezamenlijk normale met correlatie is , en , de verwachting van een afgeknotte standaardnormale. De verwachte alpha is dus , met . De residuele variantie van de long-short-portefeuille is , zodat de alpha ervan standaardfout heeft. De correctie uit (3) is verwaarloosbaar. Delen geeft (7). Buiten de steekproef zijn de residuen onafhankelijk van , dus de verwachte alpha is nul.
De verwachte -waarde is evenredig met de correlatie tussen kenmerk en steekproeffout, en ze groeit met de wortel van het aantal aandelen per poot. Met en decielen is , en , dus . Bestaat één procent van de variantie van het kenmerk uit steekproeffout (, dus ), dan is de verwachte al 2,5. Wie een kenmerk overneemt uit eerder onderzoek op dezelfde jaren, sorteert net zo goed deels op die steekproeffout.
De grovere vorm is veel kenmerken proberen. Met onafhankelijke kandidaten zonder effect haalt minstens één een boven 1,96 met kans (eenzijdig), bij al 40%. Daarom las Black (1993) de size- en waarde-effecten als waarschijnlijke datamining: regelmaten zonder een theorie die ze vooraf voorspelde. Een gezocht kenmerk heeft in de eigen steekproef dus een grote en daarbuiten geen, wat we in de intuïtie al vermoedden. De systematische versie van het argument is De factor zoo.
5Simulatie: een size-effect zonder anomalie, en een anomalie zonder effect
Hoe vaak vindt een onderzoeker een significante kenmerk-alpha in een wereld zonder vergissingen? In de eerste wereld zijn alle prijzen correct, maar toetst hij met het CAPM terwijl er een tweede risico is. In de tweede geldt het CAPM exact, maar kiest hij zijn kenmerk op basis van de steekproef. De echte premie in de eerste wereld ziet hij in minder dan een op de vijf steekproeven, terwijl hij in de tweede in ruim negen op de tien een premie ziet die niet bestaat.
5.1(a) Een wereld met twee risico’s
Er zijn 1000 aandelen. Elk heeft een CAPM-bèta en een blootstelling aan een tweede factor met een risicopremie, onafhankelijk van de markt, bijvoorbeeld een faillissements- of recessierisico:
| symbool | betekenis | waarde |
|---|---|---|
| CAPM-bèta | , begrensd op | |
| blootstelling aan | uniform op | |
| , | premie en volatiliteit van de markt | 0,5% en 4,5% per maand |
| , | premie en volatiliteit van | 0,4% en 3% per maand |
| eigen volatiliteit van een aandeel | 10% per maand | |
| verwacht rendement per jaar | ||
| groei van de kasstroom | 2% per jaar | |
| kasstroomniveau, los van risico |
Hier is het overrendement van de markt, dat in (2) heette, en dat van . Op het ware tweefactormodel is er geen alpha. De marktwaarde volgt uit (6), met een gemiddeld verwacht rendement van per jaar. We sorteren eenmalig op marktwaarde in tien portefeuilles van honderd aandelen. De eerste cel bouwt de aandelen en meet hoe sterk marktwaarde met verwacht rendement correleert.
def alpha_t(returns, factors):
    """OLS intercepts and t-statistics of every column of `returns` (T x K) on `factors` (T or T x L)."""
    X = np.column_stack([np.ones(len(returns)), factors])
    coef, *_ = np.linalg.lstsq(X, returns, rcond=None)
    resid = returns - X @ coef
    s2 = (resid**2).sum(axis=0) / (len(returns) - X.shape[1])
    se = np.sqrt(s2 * np.linalg.inv(X.T @ X)[0, 0])
    return coef[0], coef[0] / se


n_stocks, n_groups, T_sim, n_samples = 1000, 10, 480, 1000
sim = {"lam_m": 0.005, "sd_m": 0.045,      # market premium and volatility per month
       "lam_h": 0.004, "sd_h": 0.030,      # premium and volatility of the second factor h
       "sd_eps": 0.10}                     # idiosyncratic volatility per month

beta_i = np.clip(1.0 + 0.3 * rng.standard_normal(n_stocks), 0.2, 1.8)
delta_i = rng.uniform(0.0, 1.5, n_stocks)
k_i = 0.03 + 12 * (sim["lam_m"] * beta_i + sim["lam_h"] * delta_i)      # expected return per year
log_me = rng.normal(0.0, 1.5, n_stocks) - np.log(k_i - 0.02)

group = pd.qcut(log_me, n_groups, labels=False)           # size decile, 0 = smallest
count = np.bincount(group)
beta_p = pd.Series(beta_i).groupby(group).mean().to_numpy()
delta_p = pd.Series(delta_i).groupby(group).mean().to_numpy()

pd.DataFrame(
    {"correlatie met log ME": [np.corrcoef(log_me, x)[0, 1] for x in (k_i, beta_i, delta_i)]},
    index=["verwacht rendement k", "bèta", "delta"],
).round(3)De correlatie tussen en het verwachte rendement is met zwak, want het kasstroomniveau bepaalt de meeste spreiding in marktwaarde, maar ze heeft het teken van Theorem 1. De volgende cel trekt 1000 steekproeven van veertig jaar en schat telkens de alpha van klein min groot, op het CAPM en op het ware model.
berk = {"CAPM": [], "tweefactor": []}
for _ in range(n_samples):
    f_m = sim["lam_m"] + sim["sd_m"] * rng.standard_normal(T_sim)
    f_h = sim["lam_h"] + sim["sd_h"] * rng.standard_normal(T_sim)
    noise = sim["sd_eps"] / np.sqrt(count) * rng.standard_normal((T_sim, n_groups))
    port = np.outer(f_m, beta_p) + np.outer(f_h, delta_p) + noise
    smb = port[:, 0] - port[:, -1]
    berk["CAPM"].append(alpha_t(smb, f_m))
    berk["tweefactor"].append(alpha_t(smb, np.column_stack([f_m, f_h])))
berk = {k: np.array(v) for k, v in berk.items()}          # (n_samples, 2): alpha, t

pd.DataFrame(
    {model: {"gem. alpha klein - groot (% p.m.)": 100 * v[:, 0].mean(),
             "theorie (% p.m.)": 100 * (delta_p[0] - delta_p[-1]) * sim["lam_h"] if model == "CAPM" else 0.0,
             "gem. t": v[:, 1].mean(),
             "fractie t > 1.96": np.mean(v[:, 1] > 1.96)}
     for model, v in berk.items()}
).T.round(3)Zoals in stap 4 van het toy-voorbeeld, waar H − L 5,325% alpha had bij een negatieve bèta, is de alpha van klein min groot hier het verschil van twee alpha’s. Op het CAPM is ze gemiddeld 0,076% per maand, tegen 0,079% volgens de theorie: het verschil in tussen de uiterste portefeuilles maal de premie van . Die alpha haalt maar in 18,6% van de steekproeven. Op het ware model haalt ze de drempel in 2,4%, zoals bij een eenzijdige toets hoort.
Een correcte risicopremie van bijna een procentpunt per jaar blijft na veertig jaar meestal onzichtbaar. Ook veertig jaar data meten een gemiddeld rendement te grof om zo’n verschil van nul te onderscheiden.
5.2(b) Kiezen wat werkt
Nu geldt het CAPM exact, met dezelfde marktpremie van 0,5% en volatiliteit van 4,5% per maand. Er zijn 500 aandelen zonder alpha en 100 kandidaat-kenmerken die pure ruis zijn. Voor elk kenmerk vormt de onderzoeker een long-short-portefeuille van de 50 hoogste en de 50 laagste aandelen en schat hij de CAPM-alpha over twintig jaar. Hij rapporteert het kenmerk met de hoogste . Ter vergelijking volgt de cel ook één kenmerk dat vooraf is gekozen, en ze meet beide ook in de twintig jaar erna.
n_sn, n_leg, T_in, T_out, n_cand, n_rep = 500, 50, 240, 240, 100, 400


def long_short_weights(z, n_leg):
    """Weights +1/n_leg on the n_leg highest and -1/n_leg on the n_leg lowest values in each row of z."""
    rank = stats.rankdata(z, axis=-1) - 1                  # 0 = lowest value
    n = z.shape[-1]
    weights = np.zeros(z.shape)
    weights[rank >= n - n_leg] = 1 / n_leg
    weights[rank < n_leg] = -1 / n_leg
    return weights


snoop = []
for _ in range(n_rep):
    beta = 1.0 + 0.3 * rng.standard_normal(n_sn)
    f = sim["lam_m"] + sim["sd_m"] * rng.standard_normal(T_in + T_out)
    R = np.outer(f, beta) + sim["sd_eps"] * rng.standard_normal((T_in + T_out, n_sn))
    candidates = rng.standard_normal((n_cand, n_sn))       # 100 pure-noise characteristics
    P = R @ long_short_weights(candidates, n_leg).T
    _, t_in = alpha_t(P[:T_in], f[:T_in])
    _, t_out = alpha_t(P[T_in:], f[T_in:])
    best = np.argmax(t_in)                                 # the characteristic that "works" best
    snoop.append((t_in[0], t_in[best], t_out[best]))       # candidate 0 plays the pre-chosen one
snoop = pd.DataFrame(snoop, columns=["één kenmerk", "beste van 100, in de steekproef",
                                     "beste van 100, erna"])

snoop.describe().loc[["mean", "std"]].T.assign(
    **{"fractie t > 1.96": (snoop > 1.96).mean(), "fractie t > 3": (snoop > 3).mean()}
).round(3)Eén vooraf gekozen kenmerk gedraagt zich zoals het hoort, met een gemiddelde rond nul en een standaarddeviatie rond één. Het beste van honderd haalt in de steekproef in 93,2% van de gevallen en in 13,8% zelfs . In de twintig jaar erna is er niets van over. Dit is geen anomalie die na publicatie verdwijnt, maar een die nooit heeft bestaan.
De propositie van Lo en MacKinlay verbindt de twee. Met vijftig in plaats van honderd aandelen per poot is de voorfactor in (7) kleiner dan de 24,8 bij decielen, zodat de gemiddelde van 2,5 van het beste kenmerk past bij één kenmerk met . Het zoeken maakt van ruis zo een kenmerk dat met de steekproeffout correleert. In de figuur gaat het links om de afstand tussen de twee verdelingen en rechts om de plek van het beste kenmerk, in en na de steekproef.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
bins = np.linspace(-4, 7, 45)
axes[0].hist(berk["CAPM"][:, 1], bins=bins, alpha=0.65, label="t(alpha), CAPM")
axes[0].hist(berk["tweefactor"][:, 1], bins=bins, alpha=0.65, label="t(alpha), ware tweefactormodel")
axes[0].axvline(1.96, color="black", lw=1, ls="--")
axes[0].set_title("(a) Klein min groot in een wereld zonder vergissingen")
axes[0].set_xlabel("t-waarde van de alpha (1000 steekproeven van 40 jaar)")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].legend()

bins = np.linspace(-4, 6, 45)
for column in snoop.columns:
    axes[1].hist(snoop[column], bins=bins, alpha=0.55, label=column)
axes[1].axvline(1.96, color="black", lw=1, ls="--")
axes[1].set_title("(b) Het beste van 100 ruiskenmerken")
axes[1].set_xlabel("t-waarde van de CAPM-alpha (400 steekproeven)")
axes[1].set_ylabel("Aantal steekproeven")
axes[1].legend()
fig.tight_layout()
plt.show()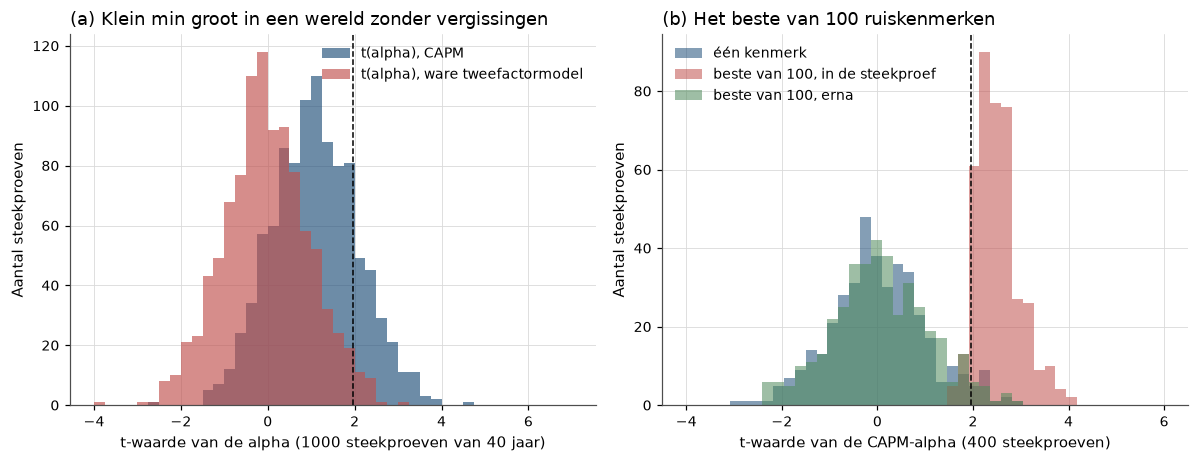
Figure 1:Links: bij correcte prijzen geeft een sortering op marktwaarde een CAPM-alpha, omdat marktwaarde de gemiste risicofactor meet. Op het ware model verdwijnt ze. Dat de CAPM-verdeling meestal onder de stippellijn valt, is de standaardfout van 2% uit Rendementen en hun statistiek. Rechts: een wereld zonder alpha. Het beste kenmerk ligt in de steekproef ver rechts van nul en valt daarna terug op de verdeling van een willekeurig kenmerk. Samen tonen de panelen het dilemma van dit tijdvak: een echte premie kan onzichtbaar zijn, en een zichtbare premie onecht.
6Replicatie op echte data
De eerste cel laadt de decielen en bouwt daaruit de long-short-portefeuilles. Voor E/P en B/M is dat hoog min laag, voor size klein min groot.
market = hap_data.market_monthly()
rf_month, mkt_excess = market["RF"], market["Mkt-RF"]
deciles = ["Lo 10", "2-Dec", "3-Dec", "4-Dec", "5-Dec", "6-Dec", "7-Dec", "8-Dec", "9-Dec", "Hi 10"]
datasets = {"E/P": "Portfolios_Formed_on_E-P", "B/M": "Portfolios_Formed_on_BE-ME",
            "size": "Portfolios_Formed_on_ME"}


def excess_deciles(name, weighting):
    """Decile excess returns; value- (table 0) or equal-weighted."""
    table = 0 if weighting == "VW" else "Equal-Weight"
    return hap_data.french(name, table=table)[deciles].sub(rf_month, axis=0).dropna()


panels = {}
for sort, name in datasets.items():
    for w in ("VW", "EW"):
        panels[(sort, w)] = excess_deciles(name, w)


def long_short(sort, weighting):
    """High-minus-low for E/P and B/M, small-minus-big for size."""
    p = panels[(sort, weighting)]
    return p["Lo 10"] - p["Hi 10"] if sort == "size" else p["Hi 10"] - p["Lo 10"]
De tweede cel schat per kenmerk, periode en weging de CAPM-alpha met -waarde, bèta, gemiddelde en de standaardfout van dat gemiddelde, in procent per maand.
def capm_row(series):
    """CAPM alpha, t, beta, mean and SE of one excess or long-short return series (% per month)."""
    series = series.dropna()
    alpha, t = alpha_t(series.to_numpy(), mkt_excess.loc[series.index].to_numpy())
    beta = np.polyfit(mkt_excess.loc[series.index], series, 1)[0]
    return {"alpha (% p.m.)": 100 * alpha, "t(alpha)": t, "bèta": beta,
            "gem. (% p.m.)": 100 * series.mean(),
            "SE gem.": 100 * series.std() / np.sqrt(len(series)), "maanden": len(series)}


periods = {
    "E/P": {"Basu 1957-04/1971-03": ("1957-04", "1971-03"), "na publicatie 1978/2026": ("1978-01", "2026-07"),
            "volledig 1951/2026": ("1951-07", "2026-07")},
    "B/M": {"RRL 1973-01/1984-09": ("1973-01", "1984-09"), "na publicatie 1985/2026": ("1985-01", "2026-07"),
            "volledig 1926/2026": ("1926-07", "2026-07")},
    "size": {"Banz 1936/1975": ("1936-01", "1975-12"), "na publicatie 1982/2026": ("1982-01", "2026-07"),
             "volledig 1926/2026": ("1926-07", "2026-07")},
}
rows = {}
for sort, spans in periods.items():
    for label, (a, b) in spans.items():
        for w in ("VW", "EW"):
            rows[(sort, label, w)] = capm_row(long_short(sort, w).loc[a:b])
ls_table = pd.DataFrame(rows).T
ls_table.index.names = ["sortering", "periode", "weging"]
ls_table.round(3)De tabel hieronder zet de bevindingen van de auteurs, in hun eigen woorden, naast de alpha’s uit de cel, in procent per maand met de -waarde tussen haakjes.
| origineel | hier, oorspronkelijke steekproef | hier, na publicatie | |
|---|---|---|---|
| E/P, Basu 1957–1971 | lage koers-winstverhouding: hoger rendement, ook na correctie voor risico | VW 0,46 (1,76), EW 0,89 (4,53) | VW 0,29 (1,58), EW 0,60 (4,64) |
| B/M, RRL 1973–1984 | hoge boekwaarde-koersverhouding: significant abnormaal rendement | VW 1,42 (3,31), EW 1,49 (4,07) | VW 0,09 (0,40), EW 1,12 (5,98) |
| size, Banz 1936–1975 | kleine bedrijven: hoger rendement na correctie voor risico, vooral de allerkleinste | VW 0,23 (0,72), EW 0,59 (1,64) | VW −0,14 (−0,68), EW −0,02 (−0,11) |
Geslaagd. Het teken is in alle zes combinaties van kenmerk en weging positief: goedkope en kleine aandelen hadden in de oorspronkelijke steekproeven een positieve CAPM-alpha. Na publicatie zijn de waardegewogen alpha’s kleiner en nergens significant. Gelijkgewogen blijven E/P en B/M wel ( en ), omdat alle drie de kenmerken het sterkst zijn bij kleine aandelen en die bij gelijke weging zwaarder tellen. De long-short-bèta van E/P en B/M is in de oorspronkelijke steekproef negatief, zodat goedkope aandelen in CAPM-zin niet riskanter waren.
Waardegewogen is alleen de B/M-alpha in de oorspronkelijke steekproef significant. Met ongeveer 17% per jaar was ze groot genoeg om in twaalf jaar boven de ruis uit te komen, terwijl de kleinere effecten van Basu en Banz dat bij deze weging niet haalden.
Voor size in Banz’ periode is de alpha op French’ brede eerste deciel niet significant, omdat Banz’ effect in een kleinere groep bedrijven zat. Ook Asness et al. (2018) vinden op de huidige CRSP-data een zwakker decielverschil dan Banz, met . Zij wijten dat aan datafouten die CRSP na zijn artikel heeft gecorrigeerd.
De figuur toont dezelfde alpha’s per deciel. Let op de vorm: stijgt de alpha van deciel 1 naar deciel 10, en is het profiel na publicatie vlakker?
Source
decile_periods = {"E/P": list(periods["E/P"].items())[:2], "B/M": list(periods["B/M"].items())[:2],
                  "size": list(periods["size"].items())[:2]}
fig, axes = plt.subplots(1, 3, figsize=(12, 4.0), sharey=True)
for ax, (sort, spans) in zip(axes, decile_periods.items()):
    for (label, (a, b)), color, shift in zip(spans, hap.plotting.COLORS, (-0.12, 0.12)):
        table = pd.DataFrame({d: capm_row(panels[(sort, "VW")][d].loc[a:b]) for d in deciles}).T
        se_alpha = table["alpha (% p.m.)"] / table["t(alpha)"]
        ax.errorbar(np.arange(1, 11) + shift, table["alpha (% p.m.)"], yerr=2 * se_alpha,
                    fmt="o", capsize=2, color=color, label=label)
    ax.axhline(0, color="black", lw=0.8)
    ax.set_title(f"CAPM-alpha per {sort}-deciel (waardegewogen)")
    ax.set_xlabel("Deciel (1 = laagste kenmerk)")
    ax.set_xticks(range(1, 11))
    ax.legend(loc="upper left")
axes[0].set_ylabel("Alpha (% per maand, ± 2 SE)")
fig.tight_layout()
plt.show()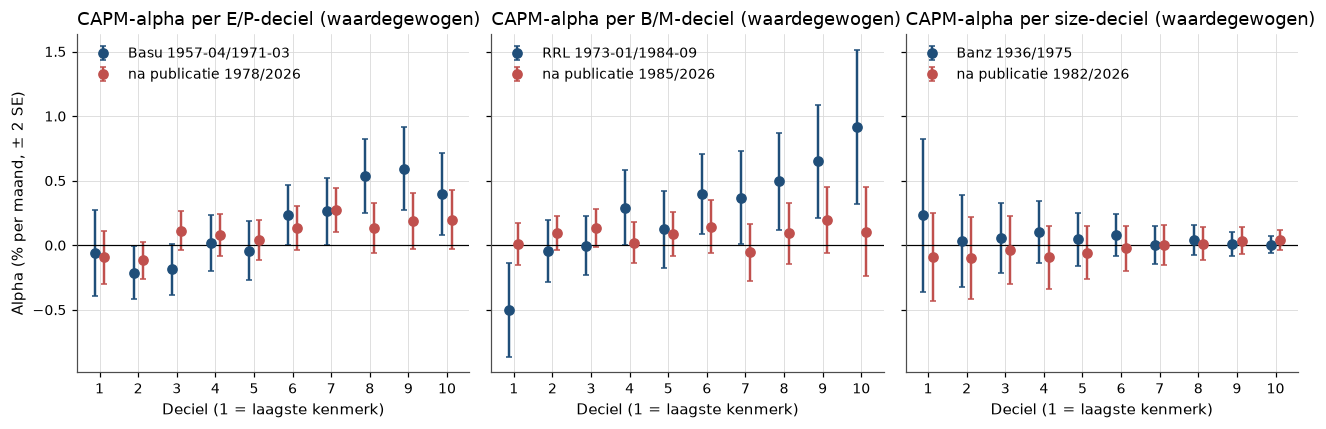
Figure 2:CAPM-alpha’s per deciel in de oorspronkelijke steekproef en na publicatie. Voor E/P lopen de alpha’s in Basu’s periode op van rond nul in de laagste decielen naar duidelijk positief in de hoogste. Voor B/M lopen ze in de periode van Rosenberg, Reid en Lanstein vrijwel monotoon van negatief naar positief. Voor size springt alleen het kleinste deciel eruit, met een foutbalk die nul bevat. Na publicatie zijn alle drie de profielen vlakker.
6.1Het januari-effect
Keim vond over 1963–1979 dat bijna vijftig procent van het size-effect in januari zat, waarvan meer dan de helft in de eerste handelsweek. De cel splitst klein min groot naar januari en de overige maanden. De bijdrage van januari is het januarigemiddelde gedeeld door de som van de twaalf maandgemiddelden, alleen gerapporteerd als beide delen niet negatief zijn.
def january_split(series):
    """Mean and t of January versus February-December returns, and January's share of the annual sum."""
    jan, rest = series[series.index.month == 1], series[series.index.month != 1]
    annual = jan.mean() + 11 * rest.mean()
    both_positive = min(jan.mean(), rest.mean()) >= 0
    return {"januari (% p.m.)": 100 * jan.mean(), "t januari": jan.mean() / (jan.std() / np.sqrt(len(jan))),
            "feb-dec (% p.m.)": 100 * rest.mean(), "t feb-dec": rest.mean() / (rest.std() / np.sqrt(len(rest))),
            "jaarpremie (%)": 100 * annual, "bijdrage januari": jan.mean() / annual if both_positive else np.nan,
            "jaren": len(jan)}


january_periods = {"Keim 1963-1979": ("1963-01", "1979-12"), "1926-1962": ("1926-07", "1962-12"),
                   "na 1980": ("1980-01", "2026-07")}
january_rows = {}
for label, (a, b) in january_periods.items():
    for w in ("VW", "EW"):
        january_rows[(label, w)] = january_split(long_short("size", w).loc[a:b])
january = pd.DataFrame(january_rows).T
january.round(3)Geslaagd. In Keims periode valt in beide wegingen ongeveer vier vijfde van de jaarpremie in januari (kolom bijdrage januari), meer dan de bijna vijftig procent van Keim, die met voor risico gecorrigeerde dagrendementen werkte. Over 1926–1962 draagt januari eveneens het grootste deel. Na 1980 is januari nog positief, maar doen kleine aandelen het in de andere maanden slechter dan grote, zodat de jaarpremie vrijwel verdwijnt.
Een premie die alleen in januari wordt betaald, is moeilijk als risicopremie te verdedigen. De gangbare verklaringen zijn institutioneel: verkopen in december om fiscale verliezen te nemen, en window dressing (fondsbeheerders die verliezers verkopen vóór ze hun portefeuille rapporteren).
7Wat er brak, en wat daarna kwam
Wat het CAPM verklaart. Het CAPM houdt nog steeds veel overeind. Over de volle eeuw verklaart het de waardegewogen B/M-premie grotendeels, met een alpha van 0,14% () bij een long-short-bèta van 0,44. De anomalieën zijn verschillen van enkele tienden van een procent per maand, met standaardfouten van dezelfde orde. Geen van de vier artikelen stelde een ander model voor. Reinganum las zijn resultaten zelfs als een verkeerd gespecificeerd evenwichtsmodel, niet als inefficiëntie, omdat de abnormale rendementen minstens twee jaar aanhielden.
Waar het breekt. Goedkope aandelen hadden in de oorspronkelijke steekproeven positieve CAPM-alpha’s, terwijl hun long-short-bèta rond nul of negatief lag. Het scherpste feit uit onze replicatie is de waardegewogen B/M-alpha van 1,42% per maand () in de twaalf jaar van Rosenberg, Reid en Lanstein. Keims seizoenspatroon is een barst van een andere soort: ongeveer vier vijfde van de size-premie in één maand.
Risico of vergissing? Rosenberg, Reid en Lanstein kozen in hun titel de vergissing: een goedkoop aandeel is een fout van de markt. De andere lezing kwam van Reinganum (1981) en later Berk (1995): een lage koers ten opzichte van winst, boekwaarde of omvang is een hoge discontovoet. De simulatie laat zien dat beide lezingen hetzelfde patroon geven. Scheiden kan alleen met een maat voor het gemiste risico die niet uit prijzen komt, en die had niemand. Een premie die vooral in januari valt, past slecht bij een risicopremie, maar evenmin bij datamining, want het patroon staat ook in 1926–1962, vóór Keims steekproef. Het verdwijnen van de waardegewogen premies na publicatie past wel bij datamining, terwijl de gelijkgewogen waarde-alpha die na 1985 bleef daar weer tegen pleit. Voor een belegger is het de vraag van Santa-Clara uit Opzet, data en conventies: droeg wie in 1985 value kocht een risico waarvoor de markt een premie betaalt, of dacht hij iets te weten wat de prijs niet wist? Dezelfde transactie kan beide zijn geweest.
Wat er daarna kwam. Zeven jaar later zouden Fama en French al deze kenmerken in één regressie zetten en er twee overhouden. Eerst wendde de theorie zich naar een ander prijsprobleem, waarin toestandsvariabelen de rol van kenmerken overnemen: de rente en de waarde van flexibiliteit, in Brennan-Schwartz, Vasicek, CIR en Longstaff-Schwartz.
8Oefeningen
Solution to Exercise 1
(1) H heeft bèta , overrendement en alpha . H − L heeft bèta , overrendement en alpha , gelijk aan .
broad = pd.DataFrame({"H": toy_portfolio(["C", "D", "E"]), "L": toy_portfolio(low_ep)}).T
broad.loc["H - L"] = broad.loc["H"] - broad.loc["L"]
broad.round(5)(2) C heeft een kleinere alpha (1,50%) dan D en E en verdunt zo het gemiddelde van H. Wat dit leert: een brede uiterste portefeuille smeert een effect in de uitersten uit, zoals het effect van Banz in French’ brede eerste deciel.
:::{exercise}
:label: ex-vroege-anomalieen-2

**De orde van grootte van Berk.** Neem het model van
{prf:ref}`thm-vroege-anomalieen-berk` met de parameters uit simulatie (a).

1. Leid met een eerste-ordebenadering van $\log(k - g)$ rond $\bar k$ af dat
   $\Cov(\log \mathrm{ME}, k) \approx -\Var(k)/(\bar k - g)$ en
   $\Corr(\log \mathrm{ME}, k) \approx -\SD(k)/\left((\bar k - g)\,\SD(\log \mathrm{ME})\right)$.
2. Bereken beide benaderingen voor `k_i` en `log_me` en vergelijk ze met de
   steekproefwaarden.
3. Hoe verandert de correlatie als de spreiding van $\log C_i$ halveert?
4. Simuleer veertig jaar maandrendementen van de 1000 losse aandelen en draai
   Fama-MacBeth met de ware bèta en de gestandaardiseerde $\log \mathrm{ME}$, met en
   zonder $\delta$. Wat moet de coëfficiënt op $\log \mathrm{ME}$ met $\delta$ erbij
   zijn?
Solution to ex-vroege-anomalieen-2
(1) Met en de onafhankelijkheid van is . Delen door geeft de correlatie.
(2) en (3)
def berk_approximation(log_cash_sd):
    log_me_alt = log_cash_sd / 1.5 * (log_me + np.log(k_i - 0.02)) - np.log(k_i - 0.02)
    cov_approx = -k_i.var() / (k_i.mean() - 0.02)
    return {"cov steekproef": np.cov(log_me_alt, k_i)[0, 1], "cov benadering": cov_approx,
            "corr steekproef": np.corrcoef(log_me_alt, k_i)[0, 1],
            "corr benadering": cov_approx / (k_i.std() * log_me_alt.std())}


pd.DataFrame({"SD log C = 1.5": berk_approximation(1.5), "SD log C = 0.75": berk_approximation(0.75)}).round(4)De benadering ligt dicht bij de steekproefwaarden. Het verschil komt van de kromming van de logaritme. Bij een halvering van de kasstroomspreiding wordt de correlatie bijna twee keer zo sterk. Hoe minder ruis er in het kasstroomniveau zit, hoe beter marktwaarde het verwachte rendement meet, en daarom meten B/M en E/P het beter dan marktwaarde alleen.
(4)
f_m = sim["lam_m"] + sim["sd_m"] * rng.standard_normal(T_sim)
f_h = sim["lam_h"] + sim["sd_h"] * rng.standard_normal(T_sim)
stock_returns = pd.DataFrame(np.outer(f_m, beta_i) + np.outer(f_h, delta_i)
                             + sim["sd_eps"] * rng.standard_normal((T_sim, n_stocks)))


def as_panel(values):
    """One-row characteristic frame, broadcast over all periods by fama_macbeth."""
    return pd.DataFrame([values], columns=stock_returns.columns)


size_z = (log_me - log_me.mean()) / log_me.std()
specs = {"bèta + log ME": {"bèta": as_panel(beta_i), "log ME": as_panel(size_z)},
         "bèta + delta + log ME": {"bèta": as_panel(beta_i), "delta": as_panel(delta_i),
                                   "log ME": as_panel(size_z)}}
fm_sim = {}
for name, chars in specs.items():
    out = hap.stats.fama_macbeth(stock_returns, chars, lags=0)
    out.attrs = {}                                   # drop metadata so pd.concat accepts the tables
    fm_sim[name] = out[["estimate", "tstat"]].assign(estimate=lambda d: 100 * d["estimate"])
pd.concat(fm_sim).round(3)Met erbij is de ware coëfficiënt op nul, want het verwachte rendement is lineair in bèta en . In deze steekproef is hij zonder negatief, per maand per standaarddeviatie (), en met vrijwel nul (). Zonder neemt marktwaarde een deel van de rol van de gemiste factor over, maar na veertig jaar niet significant. Een kenmerk vangt zo rendementen op die bèta mist zolang de blootstelling aan de factor met een premie in de regressie ontbreekt, maar ook dat effect is een gemiddelde met een grote standaardfout.
:::{exercise}
:label: ex-vroege-anomalieen-3

**Is value ook een januari-effect?** {cite:t}`Bhandari1988` vond zijn
schuldgraad-effect vooral in januari, net als Keim voor de size-premie.
Geldt dat ook voor de waarde-premie?

1. Pas `january_split` toe op de hoog-min-laag-portefeuilles van E/P en B/M,
   gelijkgewogen en waardegewogen, voor 1963–1984 en voor 1985–2026.
2. Zit de waarde-premie net zo sterk in januari als de size-premie?
3. Wat zegt het verschil over de vraag van {cite:t}`Reinganum1981`: zijn E/P en B/M
   gewoon size?
Solution to ex-vroege-anomalieen-3
value_periods = {"1963-1984": ("1963-07", "1984-12"), "1985-2026": ("1985-01", "2026-07")}
value_rows = {}
for sort in ("E/P", "B/M"):
    for label, (a, b) in value_periods.items():
        for w in ("VW", "EW"):
            value_rows[(sort, label, w)] = january_split(long_short(sort, w).loc[a:b])
pd.DataFrame(value_rows).T.round(3)(2) In 1963–1984 zit de waardegewogen waarde-premie voor ongeveer twee derde in januari (65% voor E/P en 67% voor B/M), minder dan de vier vijfde van de size-premie in Keims periode. Gelijkgewogen is dat 24% en 45%, met significante premies in de overige maanden.
(3) Na 1985 verdient de gelijkgewogen B/M-portefeuille 0,78% per maand buiten januari (), terwijl de size-premie buiten januari verdween. Een effect buiten januari is niet simpelweg size, al is één sortering daarvoor geen definitief bewijs. Het seizoenspatroon is zo een tweede dimensie waarop anomalieën verschillen, en jaargemiddelden verbergen die.
:::{exercise}
:label: ex-vroege-anomalieen-4

**Voegt size iets toe naast bèta?** Banz stelde zijn vraag in de vorm van
[](#eq-vroege-anomalieen-fm). Hij legde de relatieve marktwaarde als kenmerk naast
bèta.

1. Draai Fama-MacBeth op de tien waardegewogen size-decielen, met per deciel een
   rollende bèta uit de voorgaande 60 maanden en de log van zijn gemiddelde
   bedrijfsgrootte ten opzichte van het decielgemiddelde, beide bekend vóór de maand.
   Doe dat voor 1936–1975, met en zonder size, en na 1982.
2. Kan deze cross-sectie bèta en omvang scheiden?
Solution to ex-vroege-anomalieen-4
size_vw = panels[("size", "VW")]
avg_size = hap_data.french("Portfolios_Formed_on_ME", table=5)[deciles]
log_rel_size = np.log(avg_size).sub(np.log(avg_size).mean(axis=1), axis=0).shift(1)
rolling_beta = (size_vw.rolling(60).cov(mkt_excess.loc[size_vw.index])
                .div(mkt_excess.loc[size_vw.index].rolling(60).var(), axis=0).shift(1))


def fm_size(a, b, with_size=True):
    """Fama-MacBeth on the ten size deciles over [a, b] (estimates in % per month)."""
    chars = {"bèta": rolling_beta.loc[a:b]}
    if with_size:
        chars["log relatieve size"] = log_rel_size.loc[a:b]
    out = hap.stats.fama_macbeth(size_vw.loc[a:b], chars, lags=0)
    out.attrs = {}                     # drop metadata so pd.concat accepts the tables
    return out[["estimate", "tstat", "n_periods"]].assign(estimate=lambda d: 100 * d["estimate"])


pd.concat({
    ("Banz 1936-1975", "bèta"): fm_size("1936-01", "1975-12", with_size=False),
    ("Banz 1936-1975", "bèta + size"): fm_size("1936-01", "1975-12"),
    ("na 1982", "bèta + size"): fm_size("1982-01", "2026-07"),
}).round(3)(1) In Banz’ periode is de coëfficiënt op de log relatieve omvang negatief, het teken van Banz, maar niet significant. De helling op bèta zakt van positief zonder size naar negatief met size. Na 1982 is de size-coëfficiënt positief en niet significant.
(2) Nee. Tien portefeuilles die op omvang zijn gesorteerd, hebben bèta’s die bijna perfect met hun omvang samenhangen, dus de regressie kan de twee niet uit elkaar houden. Wat dit leert: een cross-sectie die op één kenmerk is gesorteerd, heeft maar één dimensie. Om bèta en omvang te scheiden zijn portefeuilles nodig die op beide tegelijk zijn gesorteerd.
<!-- Referenties verschijnen automatisch onderaan de pagina. -->- Basu, S. (1977). Investment Performance of Common Stocks in Relation to Their Price-Earnings Ratios: A Test of the Efficient Market Hypothesis. The Journal of Finance, 32(3), 663–682. 10.1111/j.1540-6261.1977.tb01979.x
- Stattman, D. (1980). Book Values and Stock Returns. The Chicago MBA: A Journal of Selected Papers, 4, 25–45.
- Banz, R. W. (1981). The Relationship between Return and Market Value of Common Stocks. Journal of Financial Economics, 9(1), 3–18. 10.1016/0304-405X(81)90018-0
- Reinganum, M. R. (1981). Misspecification of Capital Asset Pricing: Empirical Anomalies Based on Earnings’ Yields and Market Values. Journal of Financial Economics, 9(1), 19–46. 10.1016/0304-405X(81)90019-2
- Keim, D. B. (1983). Size-Related Anomalies and Stock Return Seasonality: Further Empirical Evidence. Journal of Financial Economics, 12(1), 13–32. 10.1016/0304-405X(83)90025-9
- Rosenberg, B., Reid, K., & Lanstein, R. (1985). Persuasive Evidence of Market Inefficiency. The Journal of Portfolio Management, 11(3), 9–16. 10.3905/jpm.1985.409007
- Bhandari, L. C. (1988). Debt/Equity Ratio and Expected Common Stock Returns: Empirical Evidence. The Journal of Finance, 43(2), 507–528. 10.1111/j.1540-6261.1988.tb03952.x
- Lo, A. W., & MacKinlay, A. C. (1990). Data-Snooping Biases in Tests of Financial Asset Pricing Models. The Review of Financial Studies, 3(3), 431–467. 10.1093/rfs/3.3.431
- Black, F. (1993). Beta and Return. The Journal of Portfolio Management, 20(1), 8–18. 10.3905/jpm.1993.409462
- Nicholson, S. F. (1960). Price-Earnings Ratios. Financial Analysts Journal, 16(4), 43–45. 10.2469/faj.v16.n4.43
- Rosenberg, B., & McKibben, W. (1973). The Prediction of Systematic and Specific Risk in Common Stocks. The Journal of Financial and Quantitative Analysis, 8(2), 317. 10.2307/2330027
- Rosenberg, B. (1974). Extra-Market Components of Covariance in Security Returns. The Journal of Financial and Quantitative Analysis, 9(2), 263–274. 10.2307/2330104
- Berk, J. B. (1995). A Critique of Size-Related Anomalies. The Review of Financial Studies, 8(2), 275–286. 10.1093/rfs/8.2.275
- Asness, C., Frazzini, A., Israel, R., Moskowitz, T. J., & Pedersen, L. H. (2018). Size Matters, If You Control Your Junk. Journal of Financial Economics, 129(3), 479–509. 10.1016/j.jfineco.2018.05.006
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD