

Lucas, Breeden en de SDF
1Overzicht
Waar komt de discontovoet vandaan? Tussen 1976 en 1983 vonden economen het antwoord in consumptie. Een euro morgen is weinig waard als morgen een goede dag is, en veel op een slechte dag. De stochastic discount factor (SDF, stochastische discontofactor) is de willekeurige variabele waarmee we een toekomstige payoff verdisconteren. In deze modellen is ze de verhouding van marginale nutten, . Een activum verdient dan een premie naar zijn covariantie met consumptiegroei, maar consumptie blijkt te glad om de premies in de data te verklaren. Het college zet vijf stappen.
We lossen een Lucas-boom met twee groeitoestanden met de hand op.
We leiden de Euler-vergelijking af, en daaruit de prijs-dividend-ratio, een gesloten vorm voor rente en premie, en de consumptiebèta.
We leiden de GMM-toets van Hansen af, die de Euler-vergelijking schat zonder de economie op te lossen.
We simuleren hoe nauwkeurig die toets is op zeventig jaar data uit een economie waarin het model waar is.
We repliceren de schattingen van Hansen en Singleton uit 1983 op Amerikaanse kwartaaldata.
Rubinstein gebruikte de weging met marginaal nut in 1976 om onzekere inkomensstromen en opties te waarderen Rubinstein (1976). Lucas maakte er in 1978 een evenwichtsmodel van, met een economie met één boom waarvan het dividend wordt opgegeten Lucas (1978). Breeden liet in 1979 zien dat de toestandsvariabelen van Mertons intertemporele CAPM, zoals de rente, in continue tijd samenvallen in één bèta, namelijk die ten opzichte van consumptie Breeden (1979).
Met dit werk begint een nieuw tijdvak, omdat de discontovoet voor het eerst uit een optimalisatieprobleem volgt en daardoor fout kan zijn. Om die fout op te sporen ontwikkelde Hansen de generalized method of moments (GMM, gegeneraliseerde momentenmethode) Hansen (1982), en Hansen en Singleton toetsten er de Euler-vergelijking mee Hansen & Singleton (1982)Hansen & Singleton (1983). Het model heet het consumptie-CAPM (in de literatuur consumption CAPM: het CAPM met consumptiegroei als enige risicofactor). In de vraag theorie of feit die de reeks doorloopt, is dit model het zuiverste voorbeeld van theorie, want twee parameters moeten alle rendementen verklaren en een toets kan het model verwerpen.
2Intuïtie: waarom zou dit waar zijn?
Denk aan een eiland met één boom, die elk jaar vruchten laat vallen. Die vruchten zijn het enige voedsel en ze bederven, zodat wat niet wordt opgegeten verloren is. Iedereen bezit een deel van de boom, en die aandelen zijn verhandelbaar. Wat is een aandeel waard?
Hoeveel er wordt gegeten, bepaalt de boom en niet de markt, zodat de markt alleen de prijs vastlegt. Die prijs moet zo hoog zijn dat niemand wil kopen of verkopen, want aan de andere kant staat niemand.
De rest volgt uit één afweging: een eilandbewoner die vandaag een vrucht niet opeet maar belegt, geeft vandaag nut op en krijgt er morgen nut voor terug. Een extra vrucht is veel waard voor iemand met honger en weinig voor iemand die verzadigd is. Een belegging die vooral uitbetaalt als het morgen toch al goed gaat, levert dus weinig nut op, terwijl een belegging die uitbetaalt als het misgaat als een verzekering werkt en veel waard is.
Uit die afweging volgen drie voorspellingen. Ten eerste stijgt de rente met de verwachte groei. Een eilandbewoner die verwacht rijker te worden, wil nu lenen om vandaag meer te eten, maar niemand kan lenen, zodat de rente stijgt tot die wens verdwijnt. Ten tweede verdienen aandelen in de boom een positieve premie, omdat ze het meest betalen als de oogst groot is en een extra vrucht dus het minst waard is. Die premie groeit naarmate het rendement sterker met consumptie meebeweegt. Ten derde schommelt consumptie weinig, zodat de premie zonder grote risicoaversie klein blijft, en juist die derde voorspelling maakt het model toetsbaar.
3Toy-voorbeeld: een Lucas-boom met twee groeitoestanden
We rekenen de prijs van de boom, de rente en de premie uit in een economie met twee toestanden. Eerst laden we de pakketten voor het hele college.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import optimize, stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Consumptie is het dividend van de boom, . De groei is hoog () of laag () en volgt een Markov-keten die de neiging heeft in dezelfde toestand te blijven. De voorkeuren zijn CRRA, , met en .
| van \ naar | hoog | laag |
|---|---|---|
| hoog | 0,75 | 0,25 |
| laag | 0,25 | 0,75 |
Het recept. De prijs is de verwachte payoff gewogen met de SDF, met , en die regel is het eerste wat de theorie hieronder afleidt. Omdat de groei de toestand is en niet het niveau, hangt de prijs-dividend-ratio alleen af van de toestand . Vullen we in en delen we door , dan volgt
Stap 1: de gewichten. Bij is , zodat en . Op dezelfde manier is en .
Stap 2: de prijs-dividend-ratio. Met staat er en , oftewel en . Optellen geeft , dus . Invullen in de tweede vergelijking geeft , dus , zodat en .
Stap 3: de rente. Een risicovrije euro kost , dus . De SDF is na hoge groei en na lage groei. Vanuit de hoge toestand weegt de eerste met kans 0,75, dus , en vanuit de lage toestand zijn de kansen omgedraaid.
Stap 4: de premie. Het rendement is vanuit de hoge toestand na hoge groei en na lage groei, en vanuit de lage toestand hetzelfde met 27 in de noemer. Het verwachte rendement weegt die uitkomsten met de rij van de overgangsmatrix, en de premie is het verschil met . Omdat dat verschil maar een paar basispunt is, staan de rendementen in de tabel op vier of vijf decimalen.
| vertrektoestand | premie | ||||
|---|---|---|---|---|---|
| hoog | 0,9261 | 7,98% | 1,0800 | 1,0798 | 2,0 bp |
| laag | 1,0032 | −0,31% | 0,99704 | 0,99687 | 1,7 bp |
De code lost hetzelfde stelsel op en controleert de Euler-vergelijking in beide toestanden.
beta_toy, gamma_toy = 0.96, 2.0
growth = np.array([1.04, 0.96])                 # dividend = consumption growth, states (h, l)
P = np.array([[0.75, 0.25],
              [0.25, 0.75]])

weights = beta_toy * P * growth ** (1 - gamma_toy)             # beta P_ij g_j^(1-gamma)
pd_toy = np.linalg.solve(np.eye(2) - weights, weights @ np.ones(2))
m_toy = beta_toy * growth ** (-gamma_toy)                      # m depends only on the next state j
rf_toy = 1 / (P @ m_toy) - 1                                   # net risk-free rate
R_toy = growth * (1 + pd_toy) / pd_toy[:, None]                # R_ij = g_j (1 + PD_j) / PD_i
premium_bp = ((P * R_toy).sum(axis=1) - (1 + rf_toy)) * 1e4
euler_toy = (P * m_toy * R_toy).sum(axis=1)

pd.DataFrame(
    {
        "met de hand": [25, 27, 0.0798, -0.0031, 2.0, 1.7, 1.0, 1.0],
        "code": [*pd_toy, *rf_toy, *premium_bp, *euler_toy],
    },
    index=["PD hoog", "PD laag", "rente hoog", "rente laag",
           "premie hoog (bp)", "premie laag (bp)", "E[m R] hoog", "E[m R] laag"],
).round(4)De code vindt dezelfde ratio’s, rentes en premies als de hand, en omdat in beide toestanden, halen de prijzen de Euler-vergelijking. In de hoge toestand is de prijs-dividend-ratio lager, hoewel de verwachte groei hoger is, want de rente is daar ruim acht procentpunt hoger en bij wint dat rente-effect van het groei-effect. De ratio beweegt dus omdat de discontovoet beweegt, het patroon uit de replicatie van Williams en het dividend discount model, maar dan met een mechanisme erachter. De premie is maar een paar basispunt, omdat consumptie hier rond het gemiddelde schommelt en zo’n schommeling bij bijna gratis te verzekeren is. Zo laat het toy-voorbeeld zien dat de SDF de boom waardeert en dat een gladde consumptie een premie van bijna niets oplevert.
4Theorie
We leiden eerst de Euler-vergelijking af, die zegt dat de prijs de verwachte payoff is, gewogen met de verhouding van marginale nutten. Daarna leggen we het evenwicht van de Lucas-boom vast en bewijzen we dat de prijs-dividend-ratio uniek is. Dan volgen twee voorspellingen: een gesloten vorm voor rente en premie, en het consumptie-CAPM. Tot slot behandelen we de toets van Hansen, die de Euler-vergelijking schat zonder de economie op te lossen. De kern is de eerste stap, want de rest volgt eruit.
4.1Opzet en aannames
Er is één representatieve belegger met periodenut , waarin de relatieve risicoaversie is en het nut bij gelijk is aan . De subjectieve discontofactor is in het toy-voorbeeld 0,96 en in de simulatie 0,98 per jaar. De belegger handelt in activa. Activum kost en betaalt op de payoff , bij een aandeel . Het bruto rendement is , en de risicovrije rente is netto, zoals in de rest van de reeks.
Hansen en Singleton schrijven hetzelfde nut als en schatten . Hun is dus onze : een geschatte bij hen is bij ons. Die omrekening is van belang bij het lezen van hun tabellen in de replicatie.
4.2Het kernresultaat: de Euler-vergelijking
Stel dat een belegger vandaag een klein extra stukje van activum koopt, daarvoor vandaag iets minder eet en morgen de payoff opeet. Levert dat per saldo nut op, dan koopt hij meer en stijgt de prijs. Kost het juist nut, dan verkoopt hij en daalt de prijs. De prijs staat pas stil als het nutsverlies van vandaag gelijk is aan de verwachte nutswinst van morgen.
Formeel maximeert de belegger onder de budgetrestrictie . Hier is het aantal stukken dat hij van naar houdt en zijn overige inkomen. Elk extra stuk in verlaagt met en verhoogt met , zodat de eerste-ordevoorwaarde luidt
Delen door geeft
De prijs is dus de verwachte payoff, gewogen met wat een euro morgen waard is ten opzichte van een euro vandaag, en dat gewicht is groot als consumptie morgen laag is. Delen door geeft dezelfde uitspraak voor rendementen:
Elk bruto rendement heeft, gewogen met de SDF, verwachting één. Omdat het rendement van de risicovrije claim op al bekend is, volgt daaruit , de berekening uit stap 3 van het toy-voorbeeld.
De vergelijking geldt voor elke belegger die vrij in activum kan handelen, wat er verder ook met zijn inkomen gebeurt Grossman & Shiller (1981), en pas wanneer we geaggregeerde consumptie invullen, nemen we een representatieve belegger aan. De in deze vergelijking is de SDF uit Ross, APT en de fundamentele stelling, maar dan met een naam. Uit het ontbreken van arbitrage volgde alleen dat er een positieve bestaat, terwijl de Euler-vergelijking zegt welke.
4.3De discontovoet krijgt een theorie
De discontovoet van elk activum volgt nu uit , en consumptie, en is daardoor toetsbaar. De Euler-vergelijking zegt namelijk, net als Williams, dat de prijs van vandaag de verdisconteerde prijs plus het dividend van morgen is. Door die stap steeds opnieuw te zetten krijgen we weer een contante waarde, alleen is de discontofactor nu hoog in slechte tijden en laag in goede.
Vul in (3) in, herhaal dat voor , , enzovoort, en neem aan dat de verdisconteerde prijs ver in de toekomst naar nul gaat. Dan is
De prijs is de som van alle toekomstige dividenden, elk gewogen met het marginale nut op het moment van uitkeren. Waar de formule van Williams, (6), schreef, staat hier , zodat de vrije parameter is vervangen door twee voorkeursparameters en een meetbaar consumptieproces. Daarom heet dit een theorie van de discontovoet, want de discontovoet van elk activum op elk moment volgt uit dezelfde en , en een toets op de data kan die theorie verwerpen.
Let wel op het verschil in namen: de SDF is één en dezelfde voor alle activa, terwijl de discontovoet het verwachte rendement is dat beleggers voor één activum eisen. Die discontovoet verschilt per activum, omdat elke payoff anders met samenhangt.
4.4Evenwicht in de Lucas-boom
Zonder een eindige, unieke prijs valt er niets te toetsen. De Lucas-boom heeft zo’n prijs zolang het nut-gewogen dividend niet te snel groeit.
In evenwicht houdt de representatieve belegger de hele boom en eet hij het hele dividend op, zodat consumptiegroei gelijk is aan dividendgroei. Hoeveel hij voor een euro dividend betaalt, hangt dan alleen af van wat hij over de groei van morgen verwacht, en niet van het niveau van vandaag.
Laat de groei afhangen van een Markov-toestand met overgangskans . In het toy-voorbeeld is de rij van de overgangsmatrix bij toestand , en is de integraal hieronder een som over twee toestanden. Zet en in (3) en deel door :
De ratio van vandaag is een gewogen som van één plus de ratio van morgen, met als gewicht de kans maal . De prijs-dividend-functie is dus een vast punt van de Lucas-operator , en in het toy-voorbeeld was stap 2 precies deze vergelijking. Tellen de gewichten in elke toestand op tot minder dan één, in het toy-voorbeeld tot hoogstens 0,98, dan verkleint elk verschil tussen twee kandidaat-ratio’s, en daarop rust de stelling hieronder.
Proof 1
We gebruiken de voldoende voorwaarden van Blackwell Blackwell (1965). Monotonie: als , dan , want het gewicht is niet-negatief. Verdiscontering: voor een constante is . Nu is , dus . Met de rollen verwisseld volgt . De begrensde functies met de supremumnorm vormen een volledige ruimte, dus de contractiestelling van Banach geeft één vast punt en convergentie met snelheid .
De voorwaarde zegt dat het nut-gewogen dividend in geen enkele toestand in verwachting sneller groeit dan . Ze is voldoende maar niet nodig, want één toestand met snellere groei maakt de prijs niet oneindig als de keten die toestand snel weer verlaat. Pas als het nut-gewogen dividend langs de keten in verwachting te snel groeit, is (5) oneindig, zoals het Gordon-model ontploft bij . In het toy-voorbeeld is de grootste rijsom van de gewichten uit stap 1, namelijk .
4.5Wat het voorspelt: rente en premie bij lognormale groei
Als groei onafhankelijk is van het verleden, weet een belegger op nooit meer over morgen dan op een ander moment, zodat de prijs-dividend-ratio geen reden heeft om te bewegen. Een aandeel waarvan het dividend sterker meebeweegt dan consumptie, valt wel harder in slechte tijden en moet daarom meer opleveren.
Laat log-consumptiegroei normaal en onafhankelijk verdeeld zijn, en laat het dividend met een hefboom op consumptie reageren:
Hier is de hefboom van het dividend op consumptie en onafhankelijk dividendrisico. De oorspronkelijke Lucas-boom heeft , en . Het aandeel in de boom speelt de rol van de markt, en zijn bruto rendement heet , waarin het subscript voor markt staat en niet voor de SDF.
Proof 2
Probeer een constante . Dan is , en de Euler-vergelijking wordt . De log van is normaal met verwachting en variantie . Met is , dus . Voor de rente is . Voor de premie is met . Aftrekken van de logs geeft .
In de rente werken twee krachten. De term zegt dat verwachte groei lenen aantrekkelijk maakt, en dat was de eerste voorspelling uit de intuïtie. De term is voorzorgssparen, want meer onzekerheid maakt sparen aantrekkelijk en drukt zo de rente. De groeiterm is lineair in en de voorzorgsterm kwadratisch, zodat de rente eerst met stijgt en het voorzorgssparen wint zodra boven komt. Met en ligt die drempel op . Neem daarbij en , de parameters van de simulatie hierna, dan is , een rente van 8,6%.
De premie is het product van risicoaversie, hefboom en de variantie van consumptiegroei. Met , en is dat per jaar. Daarmee krijgt de derde voorspelling uit de intuïtie een getal, want de premie is klein en kan alleen groeien via of . Hoe klein ze is naast de historische premie, is het onderwerp van Mehra-Prescott en Hansen-Jagannathan.
4.6Wat het voorspelt: het consumptie-CAPM
Als de SDF een functie van consumptie is, wordt alleen risico beloond dat met consumptie samenhangt. Een activum dat slecht rendeert als consumptie daalt, verergert de klap, zodat beleggers het alleen tegen een premie kopen. Een activum dat van consumptie onafhankelijk is, voegt daarentegen niets toe aan het risico waar het om gaat, hoe volatiel het ook is. Breeden liet zien dat dit in continue tijd exact geldt, ook als de beleggingsmogelijkheden veranderen Breeden (1979). In Mertons intertemporele CAPM kopen beleggers extra van een activum dat goed rendeert als de rente daalt, om hun toekomstige beleggingskansen af te dekken. Volgens Breeden zit zo’n hedgemotief al in consumptie, want een belegger die slechtere kansen verwacht, consumeert nu minder.
We zetten eerst een exacte stap. Schrijf en trek (4) voor de risicovrije claim af van die voor activum . Dan is , en delen door geeft
Een activum dat hoog betaalt als hoog is, krijgt dus een lagere premie. Vullen we voor de markt in, dan valt weg:
Het overrendement, gewogen met , heeft dus verwachting nul, en de replicatie gebruikt deze vorm om de te vinden die alleen de premie verklaart. De stelling hieronder vertaalt (9) naar consumptie.
Volgens (11) is de premie de consumptiebèta maal één prijs van risico, die voor alle activa gelijk is. De premie groeit dus met de covariantie, met als factor ervoor, en dat had de intuïtie ook voorspeld. Een hogere of een volatielere consumptie maakt de prijs van risico groter. Met en is , hetzelfde getal als bij de lognormale boom, omdat de bèta van de boom daar één is.
De vorm is die van het CAPM uit Het CAPM, een verwacht overrendement evenredig met een bèta, maar de factor is anders. Omdat consumptie geen verhandelde portefeuille is, is geen gemiddeld rendement maar maal een variantie. In Breedens continue tijd, en voor log-rendementen in de lognormale boom, is de benadering exact.
4.7Hoe het getoetst wordt: GMM
Om (6) op te lossen, moeten we de verdeling van consumptie en dividenden kennen, maar de Euler-vergelijking zegt iets wat van die verdeling onafhankelijk is. Stel dat een onderzoeker de fout uitrekent. Die fout heeft verwachting nul gegeven alles wat op bekend is, zodat ze niet mag samenhangen met wat de belegger toen wist, zoals de consumptiegroei van vorig kwartaal. De onderzoeker kiest en dan zo dat die samenhang in de steekproef zo klein mogelijk is, en toetst of dat lukt.
Zo’n bekende variabele heet een instrument , bijvoorbeeld een constante of het rendement van vorig kwartaal. Met instrumenten, activa en stapelen we de momenten, waarbij het Kronecker-product elke Euler-fout met elk instrument vermenigvuldigt. Bij en , zoals in de simulatie, zijn dat zes momenten:
Elk element van is een Euler-fout maal een instrument, en bij de ware parameters is zijn verwachting nul. Dat levert momentvoorwaarden op, en de GMM-schatter minimaliseert de gewogen afstand met een weegmatrix .
Proof 4
Schets. Een Taylor-ontwikkeling in de eerste-ordevoorwaarde geeft met . De centrale limietstelling geeft normaliteit met variantie . Voor elke met is het verschil met gelijk aan . Met is asymptotisch een projectie van een standaardnormale vector op een ruimte van dimensie , dus .
De toets meet de gewogen afstand van de momenten tot nul. Omdat er twee parameters en momenten zijn, legt het model restricties op die de data hadden kunnen schenden. Een grote betekent dat geen enkel paar tegelijk de rente, het aandelenrendement en hun voorspelbaarheid kan verklaren.
De code volgt de stelling in twee stappen, eerst met en daarna met , en de details van de implementatie staan als commentaar in de code.
def euler_moments(gamma, gc, R, Z):
    """Pieces a_t(gamma), b_t with h_t(beta, gamma) = beta * a_t - b_t.

    gc : (T,) gross consumption growth c_{t+1}/c_t
    R  : (T, N) gross returns R_{t+1}
    Z  : (T, L) instruments known at t
    """
    scaled = gc[:, None] ** (-gamma) * R                       # g^-gamma R, per asset
    a_blocks, b_blocks = [], []
    for n in range(R.shape[1]):                                # Kronecker product: asset n
        a_blocks.append(scaled[:, [n]] * Z)                    # times every instrument
        b_blocks.append(Z)
    return np.hstack(a_blocks), np.hstack(b_blocks)


def gmm_euler(gc, R, Z, gamma_grid=np.linspace(-5, 200, 411)):
    """Two-step GMM for 1 = E[beta g^-gamma R (x) z], beta concentrated out."""
    T = len(gc)
    n_mom = R.shape[1] * Z.shape[1]
    W = np.eye(n_mom)

    def concentrated(gamma, W):
        # the moments are linear in beta, so beta is solved exactly for each gamma
        a_t, b_t = euler_moments(gamma, gc, R, Z)
        a, b = a_t.mean(axis=0), b_t.mean(axis=0)
        beta = (a @ W @ b) / (a @ W @ a)
        g = beta * a - b
        return g @ W @ g, beta

    for _ in range(2):                                    # step 1: W = I, step 2: W = S^-1
        # search gamma on a grid, then refine between the neighbours of the best point
        values = np.array([concentrated(x, W)[0] for x in gamma_grid])
        i = int(np.argmin(values))
        lo, hi = gamma_grid[max(i - 1, 0)], gamma_grid[min(i + 1, len(gamma_grid) - 1)]
        gamma = optimize.minimize_scalar(
            lambda x: concentrated(x, W)[0], bounds=(lo, hi), method="bounded"
        ).x
        beta = concentrated(gamma, W)[1]
        a, b = euler_moments(gamma, gc, R, Z)
        h = beta * a - b
        S = h.T @ h / T                                   # Euler errors are an MDS under H0
        W = np.linalg.inv(S)

    g = h.mean(axis=0)
    J = T * g @ W @ g
    # D: derivative of beta g^-gamma R z to beta (a) and to gamma (-log g * beta * a)
    D = np.column_stack([a.mean(axis=0), (beta * (-np.log(gc))[:, None] * a).mean(axis=0)])
    V = np.linalg.pinv(D.T @ W @ D) / T
    dof = n_mom - 2
    return {
        "beta": beta, "gamma": gamma,
        "se_beta": np.sqrt(V[0, 0]), "se_gamma": np.sqrt(V[1, 1]),
        "J": J, "df": dof, "p": stats.chi2.sf(J, dof) if dof > 0 else np.nan,
    }
De functie gmm_euler geeft , , hun standaardfouten uit de
stelling, en met zijn -waarde. Zowel de simulatie als de replicatie gebruikt deze
ene functie.
5Simulatie: GMM op zeventig jaar uit een Lucas-boom
Hoe nauwkeurig schatten Hansen en Singleton , en hoe vaak verwerpt hun toets een waar model, als ze zeventig jaar data hebben? We bouwen een wereld waarin de Euler-vergelijking exact geldt: de lognormale boom uit Proposition 1, met jaarparameters en . Die is twee keer die van het toy-voorbeeld, zodat de premie groot genoeg is om iets te schatten, en is hoger, zodat de rente niet nog verder oploopt. Consumptie groeit met en , en het dividend heeft hefboom en eigen risico . Zonder die hefboom zou de premie blijven steken op , maar met hefboom drie is ze volgens (8) drie keer zo groot.
De cel rekent de populatiewaarden uit en controleert de Euler-vergelijking op een miljoen gesimuleerde jaren.
tree = {"beta": 0.98, "gamma": 4.0, "mu": 0.018, "sigma": 0.035, "leverage": 3.0, "sigma_d": 0.10}

k_tree = tree["beta"] * np.exp(
    tree["mu"] - tree["gamma"] * tree["mu"]
    + 0.5 * ((tree["leverage"] - tree["gamma"]) ** 2 * tree["sigma"] ** 2 + tree["sigma_d"] ** 2)
)
pd_tree = k_tree / (1 - k_tree)
rf_gross = 1 / (tree["beta"] * np.exp(-tree["gamma"] * tree["mu"] + 0.5 * tree["gamma"] ** 2 * tree["sigma"] ** 2))
premium_tree = np.exp(tree["gamma"] * tree["leverage"] * tree["sigma"] ** 2) - 1   # E[R^m]/(1 + R^f) - 1


def simulate_tree(n_years):
    """Gross consumption growth, gross stock return and gross risk-free return."""
    log_gc = rng.normal(tree["mu"], tree["sigma"], n_years)
    log_gd = tree["mu"] + tree["leverage"] * (log_gc - tree["mu"]) + tree["sigma_d"] * rng.normal(size=n_years)
    stock = (1 + pd_tree) / pd_tree * np.exp(log_gd)
    return np.exp(log_gc), stock, np.full(n_years, rf_gross)


gc_big, rm_big, rf_big = simulate_tree(1_000_000)
m_big = tree["beta"] * gc_big ** -tree["gamma"]
pd.Series(
    {
        "prijs-dividend-ratio": pd_tree,
        "rente R^f": rf_gross - 1,
        "premie E[R^m]/(1+R^f) - 1": premium_tree,
        "SD aandeelrendement": rm_big.std(),
        "E[m R^m] (moet 1 zijn)": np.mean(m_big * rm_big),
        "E[m (1+R^f)] (moet 1 zijn)": np.mean(m_big * rf_big),
    }
).round(4)
prijs-dividend-ratio 14.0851
rente R^f 0.0859
premie E[R^m]/(1+R^f) - 1 0.0148
SD aandeelrendement 0.1607
E[m R^m] (moet 1 zijn) 1.0000
E[m (1+R^f)] (moet 1 zijn) 1.0002
dtype: float64De premie is 1,5% per jaar bij een aandeelvolatiliteit van 16%, en beide Euler-vergelijkingen kloppen op drie decimalen. De rente van 8,6% is absurd hoog, maar dat komt door de term uit (8) en niet door een fout in de code.
Nu schatten we het model 500 keer, elk op zeventig jaar data, met als instrumenten een constante, de consumptiegroei van vorig jaar en het aandeelrendement van vorig jaar. Met twee activa zijn dat zes momenten, zodat vier vrijheidsgraden heeft.
n_years, n_rep = 70, 500
mc_rows = []
for _ in range(n_rep):
    gc, rm, rf = simulate_tree(n_years + 1)
    Z = np.column_stack([np.ones(n_years), gc[:-1], rm[:-1]])
    res = gmm_euler(gc[1:], np.column_stack([rm, rf])[1:], Z, gamma_grid=np.linspace(-20, 60, 41))
    mc_rows.append(res)
mc = pd.DataFrame(mc_rows)

pd.DataFrame(
    {
        "waarheid of nominaal": [tree["gamma"], np.nan, np.nan, np.nan, np.nan, np.nan,
                                 0.05, stats.chi2.ppf(0.95, 4)],
        "simulatie": [
            mc.gamma.median(), mc.gamma.quantile(0.05), mc.gamma.quantile(0.95),
            mc.gamma.std(), mc.se_gamma.median(), (mc.beta > 1).mean(),
            (mc.p < 0.05).mean(), mc.J.quantile(0.95),
        ],
    },
    index=["gamma-dak, mediaan", "gamma-dak, 5e percentiel", "gamma-dak, 95e percentiel",
           "gamma-dak, werkelijke spreiding (SD)", "SE(gamma-dak), mediaan van GMM",
           "aandeel discontofactor-dak > 1 (waarheid 0,98)", "aandeel J verwerpt op 5%",
           "95e percentiel van J"],
).round(3)De tabel laat vier zwakke punten van de schatter zien.
De spreiding van is groot. Tussen het 5e en 95e percentiel loopt van ongeveer -3 tot 12, rond een waarheid van 4. De mediaan van 2,8 ligt onder de waarheid, zodat de schatter ook scheef is.
GMM onderschat die spreiding. De mediane gerapporteerde standaardfout is ongeveer 1,5, terwijl de werkelijke spreiding bijna drie keer zo groot is, want de formule uit Theorem 3 geldt pas bij grote .
De toets verwerpt te vaak. Een waar model wordt in ongeveer één op de tien steekproeven verworpen, twee keer zo vaak als de nominale 5%. Het 95e percentiel van ligt ook boven de kritieke waarde 9,49 van .
komt vaak boven één. Dat gebeurt in 29% van de steekproeven, hoewel de ware 0,98 is. De schatter compenseert een te hoge met een te hoge , zodat een boven één in de replicatie op zich geen teken van een fout model is.
Dat zo slecht gemeten is, volgt uit de standaardfout van 2% uit Rendementen en hun statistiek: een gemiddeld rendement is over een mensenleven nauwelijks te meten. Zonder voorspelbaarheid komt de informatie over vooral uit het gemiddelde overrendement, gedeeld door zijn covariantie met consumptie. Die covariantie is goed gemeten, maar het gemiddelde heeft bij 16% volatiliteit een standaardfout van procentpunt, meer dan de premie zelf.
De figuur zet links de 500 schattingen van uit en rechts de 500 waarden van .
Source
fig, axes = plt.subplots(1, 2, figsize=(10, 3.8))
axes[0].hist(mc.gamma.clip(-20, 30), bins=40, edgecolor="white")
axes[0].axvline(tree["gamma"], color="black", lw=1.4)
axes[0].set_xlabel("Geschatte $\\hat\\gamma$")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].set_title("Risicoaversie uit 70 jaar data (waarheid: 4)")

j_grid = np.linspace(0, 25, 300)
axes[1].hist(mc.J, bins=40, density=True, edgecolor="white", label="gesimuleerde $J$")
axes[1].plot(j_grid, stats.chi2.pdf(j_grid, 4), color="black", lw=1.4, label="$\\chi^2(4)$")
axes[1].axvline(stats.chi2.ppf(0.95, 4), color="black", ls="--", lw=1, label="5%-kritieke waarde")
axes[1].set_xlim(0, 25)
axes[1].set_xlabel("$J$-statistiek")
axes[1].set_ylabel("Dichtheid")
axes[1].set_title("De overidentificatietoets als het model waar is")
axes[1].legend()
plt.show()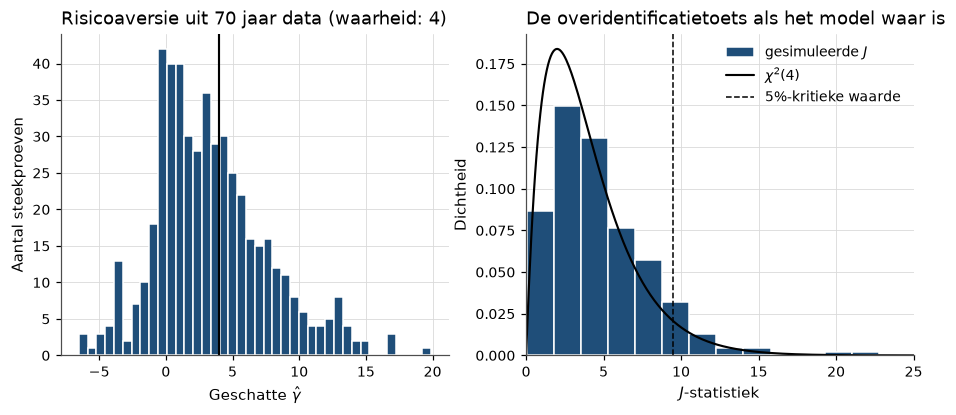
Figure 1:Links: 500 schattingen van uit zeventig jaar data, in een economie waarin waar is. Een onderzoeker met één steekproef kan niet uitsluiten dat beleggers risiconeutraal zijn, en evenmin dat ze drie keer zo risicomijdend zijn. Rechts: de verdeling van ligt verder naar rechts dan , zodat de toets een waar model vaker dan 5% verwerpt.
Een verwerping met op zeventig jaar data zegt dus weinig. Een ver boven het 95e percentiel van 11,7 zegt wel iets, en zulke waarden vinden we in de replicatie.
6Replicatie op echte data
6.1De data
De cel bouwt de reële kwartaalgroei van consumptie, het reële marktrendement en het reële T-bill-rendement, en welke reeksen en welke deflatie we gebruiken, staat in de code.
def fred_series(code):
    return hap_data.fred(code)[code]

cons = pd.DataFrame(
    {
        "nondurables": fred_series("A796RX0Q048SBEA"),   # real per capita, chained 2017 dollars
        "services": fred_series("A797RX0Q048SBEA"),
        "p_nondurables": fred_series("DNDGRD3Q086SBEA"),
        "p_services": fred_series("DSERRD3Q086SBEA"),
    }
)
cons["c"] = cons.nondurables + cons.services              # adding chained dollars is an approximation
cons["deflator"] = (cons.nondurables * cons.p_nondurables
                    + cons.services * cons.p_services) / cons.c
cons.index = cons.index.to_period("Q")

market = hap_data.market_monthly()
market_q = (1 + market[["Mkt", "RF"]]).groupby(market.index.to_period("Q")).prod()

quarterly = cons[["c", "deflator"]].join(market_q, how="inner")
inflation = quarterly.deflator / quarterly.deflator.shift(1)
quarterly["gc"] = quarterly.c / quarterly.c.shift(1)
quarterly["Rm"] = quarterly.Mkt / inflation
quarterly["Rf"] = quarterly.RF / inflation
quarterly = quarterly[["gc", "Rm", "Rf"]].dropna()
main = quarterly.loc[:"2019Q4"]                             # the 2020 lockdown quarters: exercise 3
print(f"steekproef {main.index[0]} t/m {main.index[-1]}, {len(main)} kwartalen")
steekproef 1947Q2 t/m 2019Q4, 291 kwartalen
De hoofdsteekproef loopt tot en met 2019, en de volgende cel vat de drie reeksen en het overrendement samen.
summary = pd.DataFrame(
    {
        "gemiddelde (%/kw)": main.sub([1, 1, 1]).mean() * 100,
        "std.dev. (%/kw)": main.std() * 100,
        "SE gemiddelde (%/kw)": main.std() / np.sqrt(len(main)) * 100,
        "corr. met c-groei": main.corr()["gc"],
    }
)
summary.loc["excess Rm - Rf"] = [
    (main.Rm - main.Rf).mean() * 100,
    (main.Rm - main.Rf).std() * 100,
    (main.Rm - main.Rf).std() / np.sqrt(len(main)) * 100,
    np.corrcoef(main.Rm - main.Rf, main.gc)[0, 1],
]
summary.index = ["consumptiegroei", "reëel marktrendement", "reëel T-bill-rendement", "overrendement"]
summary.round(3)In deze tabel zit het hele probleem: consumptiegroei is glad, het overrendement is zestien keer zo volatiel, en hun correlatie is laag. De covariantie die volgens (11) de premie moet verklaren, is dus minuscuul, terwijl de premie zelf groot is en onnauwkeurig gemeten.
6.2De schattingen
We schatten de drie specificaties op de naoorlogse steekproef en op de steekproef van Hansen en Singleton.
def estimate_table(frame):
    gc, rm, rf = frame.gc.to_numpy(), frame.Rm.to_numpy(), frame.Rf.to_numpy()
    Z = np.column_stack([np.ones(len(gc) - 1), gc[:-1], rm[:-1], rf[:-1]])
    specs = {
        "(a) T-bill": rf[1:, None],
        "(b) markt": rm[1:, None],
        "(c) markt + T-bill": np.column_stack([rm, rf])[1:],
    }
    rows = {name: gmm_euler(gc[1:], R, Z) for name, R in specs.items()}
    return pd.DataFrame(rows).T[["gamma", "se_gamma", "beta", "se_beta", "J", "df", "p"]]


tables = {
    "1947-2019": estimate_table(main),
    "1959-1978": estimate_table(quarterly.loc["1959Q2":"1978Q4"]),
}
gmm_results = pd.concat(tables, names=["steekproef", "activa"]).astype(float)
gmm_results.columns = ["gamma", "SE(gamma)", "beta", "SE(beta)", "J", "vrijheidsgraden", "p-waarde"]
gmm_results.round(4)Het patroon is in beide steekproeven hetzelfde. Met alleen de T-bill is klein en nauwkeurig geschat, en verwerpt de toets het model. Met alleen aandelen is de standaardfout groter dan de schatting, en verwerpt de toets het model niet. Met beide samen verwerpt de toets het ruim, met van 42 en 58 bij zes vrijheidsgraden. Over 1947–2019 gebeurt dat bij en , omdat de schatter de premie verklaart met hoge risicoaversie en boven één zet om de lage rente te halen. Uit de simulatie weten we dat zo’n ook bij een waar model vaak voorkomt, maar de verwerping door weegt zwaarder.
6.3Wat het aandelenrendement alleen vraagt
Welke is nodig om alleen de gemiddelde premie te verklaren? Volgens (10) moet het met gewogen overrendement nul zijn. Bij is dat gewogen rendement gewoon de premie, en naarmate stijgt, wegen kwartalen met lage consumptiegroei zwaarder. Renderen aandelen in die kwartalen slecht, dan daalt de gewogen premie. De cel zoekt in beide steekproeven de waarbij die gewogen premie nul wordt.
gamma_line = np.linspace(0, 300, 601)
samples = {"1947K2–2019K4": main, "1959K2–1978K4": quarterly.loc["1959Q2":"1978Q4"]}
weighted_premium, roots = {}, {}
for label, frame in samples.items():
    gc, excess = frame.gc.to_numpy(), (frame.Rm - frame.Rf).to_numpy()
    weighted_premium[label] = np.array([np.mean(gc ** (-x) * excess) for x in gamma_line]) * 100
    crossing = np.flatnonzero(np.diff(np.sign(weighted_premium[label])))
    if crossing.size:
        lo, hi = gamma_line[crossing[0]], gamma_line[crossing[0] + 1]
        roots[label] = optimize.brentq(lambda x: np.mean(gc ** (-x) * excess), lo, hi)
    else:
        roots[label] = np.nan

pd.Series(roots, name="gamma waarbij de gewogen premie nul is").round(1)
1947K2–2019K4 NaN
1959K2–1978K4 75.2
Name: gamma waarbij de gewogen premie nul is, dtype: float64In 1959–1978 is nodig, terwijl er in 1947–2019 geen tussen 0 en 300 bestaat die de gewogen premie nul maakt. De figuur toont die gewogen premie als functie van .
Source
fig, ax = plt.subplots()
for label, curve in weighted_premium.items():
    ax.plot(gamma_line, curve, label=label)
ax.axhline(0, color="black", lw=0.8)
ax.set_xlabel("Risicoaversie $\\gamma$")
ax.set_ylabel("$E[g^{-\\gamma} R^e]$, procent per kwartaal")
ax.set_title("De gewogen aandelenpremie als functie van $\\gamma$")
ax.legend()
plt.show()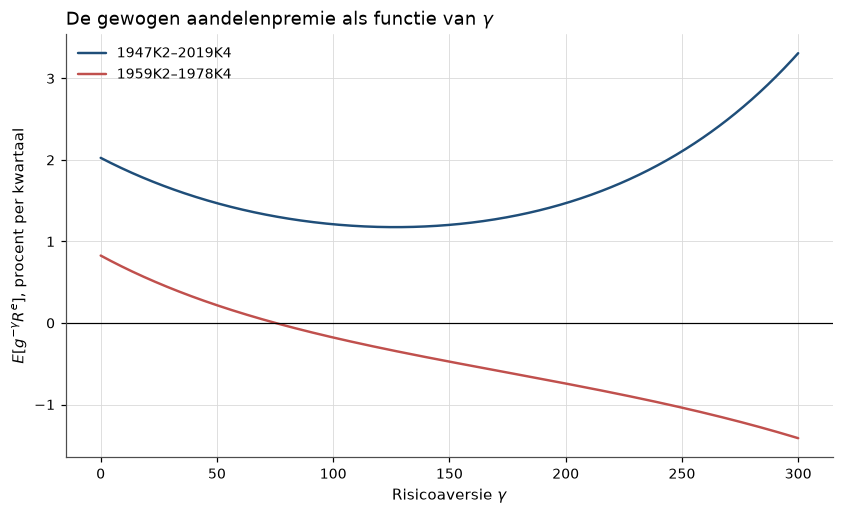
Beide lijnen dalen eerst, zoals het consumptie-CAPM voorspelt. Ze dalen alleen veel te langzaam om de premie bij een redelijke weg te werken.
6.4Vergelijking met 1983
We leggen hun schattingen voor niet-duurzame goederen plus diensten naast onze resultaten voor 1959–1978. Ze komen uit tabel 4 (p. 261, NLAG = 2), tabel 1 (p. 259, model 6, NLAG = 6) en tabel 5 (p. 262, NLAG = 4 en 0) van Hansen & Singleton (1983). Voor (c) nemen we alleen de toets over en geen , zodat die cel leeg blijft. Hun is omgerekend naar onze , en in rij (d) is “hier” het nulpunt uit de figuur, zonder standaardfout.
hs_1959 = gmm_results.loc["1959-1978"]
pd.DataFrame(
    {
        "gamma origineel": [0.931, 1.509, np.nan, 58.25],
        "SE origineel": [0.044, 1.571, np.nan, 66.57],
        "verwerpt origineel": ["ja (chi2(3) = 30,08)", "nee (chi2(11) = 10,93)", "ja (chi2(24) = 366,22)", "exact"],
        "gamma hier": [*hs_1959["gamma"], roots["1959K2–1978K4"]],
        "SE hier": [*hs_1959["SE(gamma)"], np.nan],
        "p-waarde hier": [*hs_1959["p-waarde"], np.nan],
    },
    index=["(a) T-bill", "(b) markt", "(c) markt + T-bill", "(d) alleen de premie"],
).round(4)Geslaagd: het patroon dat we onder “Verwachte afwijking” voorspelden, komt in alle drie de gevallen terug. De T-bill geeft een kleine en een verwerping, al is onze standaardfout groter dan de hunne, omdat kwartaaldata met één lag minder informatie bevatten dan maanddata met twee. Aandelen alleen geven geen verwerping. Het teken van verschilt daar, maar de kolommen met standaardfouten laten zien dat geen van beide schattingen van nul te onderscheiden is. Met beide activa samen verwerpt de toets het model.
De premie alleen vraagt in beide studies een in de tientallen (rij (d)), met bij Hansen en Singleton een standaardfout die groter is dan de schatting. Hier zien we de standaardfout van 2% in zijn scherpste vorm: omdat de premie slecht gemeten is, is de risicoaversie die de premie moet verklaren nog slechter gemeten. Het interval sluit niets uit, zodat er alleen een puntschatting overblijft die onaannemelijk groot is. In de simulatie verwierp de toets een waar model in één op de tien steekproeven, terwijl hij hier ruim verwerpt ().
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Het consumptie-CAPM gaf de discontovoet voor het eerst een theorie. Het verklaart waarom de rente hoog is als groei wordt verwacht, waarom een verzekering een negatief verwacht overrendement heeft, en waarom de prijs-dividend-ratio kan bewegen zonder dat dividenden bewegen. Het bracht bovendien de logica van het CAPM en Mertons hedgemotieven samen in één bèta. De Euler-vergelijking (3) komt terug in elk later model, en GMM is nog altijd de standaard voor elk model dat als momentvoorwaarde te schrijven is.
Waar het breekt. Eén paar kan de rente en het aandelenrendement niet tegelijk verklaren. Met aandelen en T-bill samen verwerpt de toets het model ruim, over 1947–2019 met . De premie alleen vraagt over 1959–1978 een van 75 en is over 1947–2019 met geen onder 300 te verklaren. Een kleine steekproef alleen verklaart zo’n niet, want in de simulatie met een waar model lag het 95e percentiel op 11,7, bij vier vrijheidsgraden tegen zes hier. Tijdsaggregatie, die de simulatie weglaat, maakt wel groter, maar verklaart niet waarom de premie alleen al een in de tientallen vraagt. In de tegenstelling theorie of feit is het consumptie-CAPM dus een theorie die met één toets werd verworpen.
Risico of vergissing? Is de premie een beloning voor risico dat het model slecht meet? Of betalen beleggers een prijs die niets met consumptie te maken heeft? De Chicago-lezing ziet prijzen als rationele beloning voor risico, en volgens die lezing is de theorie juist maar de specificatie te arm. Consumptie is namelijk slecht gemeten, de meeste huishoudens hadden geen aandelen, en CRRA-nut koppelt risicoaversie aan de bereidheid om consumptie te verschuiven. Met gewoontes of zeldzame rampen kan de SDF wel sterk genoeg bewegen.
De Yale-lezing ziet in prijzen ook vergissingen. Prijzen worden in die lezing gezet door beleggers met beperkte aandacht en wisselende stemmingen, en de premie is een vergoeding voor angst. De data die de twee kampen zouden kunnen scheiden, de consumptie van aandeelhouders over een eeuw, bestaan niet.
Wat er daarna kwam. Het vak hield vast en zocht een andere . Mehra en Prescott maakten van de breuk een kwantitatieve puzzel, en Hansen en Jagannathan leidden een grens af die voor elke SDF geldt, zoals Mehra-Prescott en Hansen-Jagannathan laat zien.
8Oefeningen
Solution to Exercise 1
(1) Bij is , dus . Een constante lost dit op, dus . Uniciteit volgt uit Theorem 1 met .
(2) De cel lost het stelsel van stap 2 op voor elke combinatie.
def toy_pd_gap(gamma, pi, beta=0.96, g=np.array([1.04, 0.96])):
    """PD_h - PD_l in the two-state Lucas tree with symmetric persistence pi."""
    trans = np.array([[pi, 1 - pi], [1 - pi, pi]])
    kernel = beta * trans * g ** (1 - gamma)
    pd_states = np.linalg.solve(np.eye(2) - kernel, kernel @ np.ones(2))
    return pd_states[0] - pd_states[1]


gaps = pd.DataFrame(
    {pi: [toy_pd_gap(gm, pi) for gm in (0.5, 1.0, 2.0, 3.0)] for pi in (0.5, 0.75, 0.9)},
    index=pd.Index([0.5, 1.0, 2.0, 3.0], name="gamma"),
)
gaps.columns.name = "pi"
gaps.round(4)De ratio is hoger in de hoge toestand als en , omdat dan het groei-effect wint. Bij wint het rente-effect, en het verschil groeit met de persistentie. Bij is de groei onvoorspelbaar en is het verschil nul. In een Lucas-boom zegt de richting waarin prijzen op goed nieuws reageren dus iets over , want een ratio die met de groei meestijgt, vraagt of een ander model.
:::{exercise}
:label: ex-consumptie-capm-2

**Het consumptie-CAPM voor logrendementen.** Gebruik de simulatie-economie
($\beta = 0{,}98$, $\gamma = 4$, $\mu = 1{,}8\%$, $\sigma = 3{,}5\%$, $\phi = 3$,
$\sigma_d = 10\%$). Schrijf $\ell^m = \log R^m$.

1. Leid uit [](#eq-consumptie-capm-lognormaal) af dat de consumptiebèta van
   $\ell^m$ gelijk is aan $\phi$, en dat
   $\E[\ell^m] - \log(1+R^f) + \tfrac12\Var(\ell^m) = \gamma\,\Cov(\ell^m, \Delta c)$.

2. Controleer beide kanten op de miljoen gesimuleerde jaren.
3. Hoeveel jaar data is nodig om de premie met een $t$-waarde van twee van nul te
   onderscheiden?
Solution to ex-consumptie-capm-2
(1) De ratio is constant, dus . Dan is en de bèta . Voor een lognormale is . Invullen in (8) geeft de gevraagde vorm, met rechterlid .
(2) en (3) De cel rekent beide kanten uit, en het aantal jaren waarbij de -waarde twee is.
log_rm, log_gc = np.log(rm_big), np.log(gc_big)
lhs = log_rm.mean() - np.log(rf_gross) + 0.5 * log_rm.var()
rhs = tree["gamma"] * np.cov(log_rm, log_gc)[0, 1]
beta_c = np.cov(log_rm, log_gc)[0, 1] / log_gc.var()

excess = rm_big - rf_big
years_needed = (2 * excess.std() / excess.mean()) ** 2

pd.Series(
    {
        "consumptiebèta van log R^m (theorie 3)": beta_c,
        "linkerlid": lhs,
        "rechterlid": rhs,
        "rechterlid, theorie": tree["gamma"] * tree["leverage"] * tree["sigma"] ** 2,
        "gemiddeld overrendement": excess.mean(),
        "SD overrendement": excess.std(),
        "jaren nodig voor t = 2": years_needed,
    }
).round(5)
consumptiebèta van log R^m (theorie 3) 2.99999
linkerlid 0.01449
rechterlid 0.01472
rechterlid, theorie 0.01470
gemiddeld overrendement 0.01586
SD overrendement 0.16072
jaren nodig voor t = 2 410.97172
dtype: float64De bèta is 3. Het linkerlid () en het rechterlid () verschillen , en dat is ruim één standaardfout van een gemiddelde over een miljoen jaar, want . Met een excess volatiliteit van 16% en een gemiddeld overrendement van 1,6% is voor ongeveer vierhonderd jaar nodig. De consumptiebèta is dus scherp te meten en de premie niet, zodat de onnauwkeurigheid van de premie erft.
:::{exercise}
:label: ex-consumptie-capm-3

**De replicatie op jaardata en met de coronakwartalen.** Herhaal specificatie (c)
(markt en T-bill, instrumenten: constante en één lag van alle drie de
variabelen)

1. op kwartaaldata tot en met de laatste beschikbare waarneming, dus inclusief
   2020 en later;

2. op jaardata 1948–2019, met consumptie als jaargemiddelde van de kwartaalreeks
   en rendementen samengesteld over het kalenderjaar.

Rapporteer $\hat\gamma$, $\hat\beta$, $J_T$ en de $p$-waarde. Verandert de
conclusie?
Solution to ex-consumptie-capm-3
De cel bouwt de jaarreeks op dezelfde manier als de kwartaalreeks en schat (c) op de drie varianten.
annual_cons = cons.loc[:"2019Q4", ["c", "deflator"]].groupby(lambda q: q.year).mean()
market_a = (1 + market[["Mkt", "RF"]]).groupby(market.index.year).prod()
annual = annual_cons.join(market_a, how="inner")
infl_a = annual.deflator / annual.deflator.shift(1)
annual["gc"] = annual.c / annual.c.shift(1)
annual["Rm"] = annual.Mkt / infl_a
annual["Rf"] = annual.RF / infl_a
annual = annual[["gc", "Rm", "Rf"]].dropna()

variants = {
    "kwartaal 1947-2019": main,
    "kwartaal incl. 2020-": quarterly,
    "jaar 1948-2019": annual,
}
rows_ex3 = {}
for name, frame in variants.items():
    table = estimate_table(frame)
    rows_ex3[name] = table.loc["(c) markt + T-bill"]
pd.DataFrame(rows_ex3).T.astype(float).round(4)De puntschatting van springt van ongeveer 17 naar ongeveer 2 met de coronakwartalen erbij, en wordt negatief op jaardata. In die kwartalen daalde en herstelde consumptie scherp, en via krijgen ze veel gewicht. De verwerping blijft in alle drie de varianten overeind, met een tussen 30 en 42 bij zes vrijheidsgraden. De schatting is dus niet robuust tegen frequentie, steekproef of een paar uitschieters, maar de verwerping wel, zodat de breuk in de restricties zelf zit en niet in een detail van de meting.
- Rubinstein, M. (1976). The Valuation of Uncertain Income Streams and the Pricing of Options. The Bell Journal of Economics, 7(2), 407–425. 10.2307/3003264
- Lucas, Jr., Robert E. (1978). Asset Prices in an Exchange Economy. Econometrica, 46(6), 1429–1445. 10.2307/1913837
- Breeden, D. T. (1979). An Intertemporal Asset Pricing Model with Stochastic Consumption and Investment Opportunities. Journal of Financial Economics, 7(3), 265–296. 10.1016/0304-405X(79)90016-3
- Hansen, L. P. (1982). Large Sample Properties of Generalized Method of Moments Estimators. Econometrica, 50(4), 1029–1054. 10.2307/1912775
- Hansen, L. P., & Singleton, K. J. (1982). Generalized Instrumental Variables Estimation of Nonlinear Rational Expectations Models. Econometrica, 50(5), 1269–1286. 10.2307/1911873
- Hansen, L. P., & Singleton, K. J. (1983). Stochastic Consumption, Risk Aversion, and the Temporal Behavior of Asset Returns. Journal of Political Economy, 91(2), 249–265. 10.1086/261141
- Grossman, S. J., & Shiller, R. J. (1981). The Determinants of the Variability of Stock Market Prices. The American Economic Review, 71(2), 222–227. https://ideas.repec.org/a/aea/aecrev/v71y1981i2p222-27.html
- Blackwell, D. (1965). Discounted Dynamic Programming. The Annals of Mathematical Statistics, 36(1), 226–235. 10.1214/aoms/1177700285
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD