

Fama, Shiller en “Discount Rates”
1Overzicht
Waarom voorspelt een lage prijs een hoog rendement, omdat beleggers dan meer eisen of omdat ze zich vergissen? Koersen kunnen die vraag niet beantwoorden, omdat prijzen alleen het product van overtuigingen en marginaal nut vastleggen. Enquêtes over verwachtingen kunnen het wel, en die geven tot nu toe het teken van de vergissing. In dit college
bewijzen we dat prijzen, dividenden en rendementen in een rationele en in een extrapolerende economie precies dezelfde verdeling kunnen hebben;
leiden we af welk teken een enquête over verwachtingen in elk van beide economieën krijgt;
simuleren we hoeveel jaar koersdata en hoeveel jaar enquêtedata nodig zijn om de twee economieën te scheiden;
repliceren we de decompositie van Cochrane Cochrane (2011) en het enquêteresultaat van Greenwood en Shleifer Greenwood & Shleifer (2014), en werken we Shillers CAPE-voorspelling bij tot nu.
In oktober 2013 deelden Eugene Fama, Lars Peter Hansen en Robert Shiller de Nobelprijs voor hun empirische analyse van activaprijzen Economic Sciences Prize Committee of the Royal Swedish Academy of Sciences (2013). Velen zagen daarin een grap, Santa-Clara juist een goede weergave van het vak Santa-Clara (2026). Beide kampen waren het immers over bijna elk feit eens en over bijna geen interpretatie. Het centrale feit, dat vrijwel alle variatie in de prijs-dividendratio variatie in discontovoeten is, had Cochrane twee jaar eerder in zijn presidentiële rede samengevat. Over de vraag waarom de discontovoet varieert, lopen de Nobellezingen van Fama Fama (2014) en Shiller Shiller (2014) uiteen. Hansen Hansen (2014) maakt er een vraag over modelonzekerheid van.
2Intuïtie: waarom zou dit waar zijn?
Beide kampen zijn het over drie feiten eens. Op korte termijn zijn koersen nauwelijks te voorspellen, en actieve beleggers verslaan de markt na kosten zelden. Op lange termijn voorspellen waarderingsratio’s zoals de dividend-prijsratio en Shillers CAPE de rendementen wel, en vrijwel niets anders. Bovendien beweegt de prijs-dividendratio veel meer dan het dividendnieuws kan verklaren. Die laatste twee feiten zijn één feit, want een ratio die geen dividenden voorspelt, kan alleen bewegen als ze rendementen voorspelt.
Het meningsverschil gaat over de vraag waarom het verwachte rendement hoog is als de prijs laag is. Het Chicago-antwoord luidt dat beleggers dan meer eisen. Na een crash zijn ze armer en banger, of hebben hun intermediairs geen kapitaal meer, zodat ze alleen aandelen willen houden als die goedkoop zijn. Een belegger die dan koopt, verzekert de beleggers die op dat moment het bangst zijn, en wordt daarvoor betaald.
Het Yale-antwoord luidt dat beleggers zich vergissen. Na een reeks goede jaren verwachten ze meer goede jaren en bieden ze de prijs op, zodat de lage rendementen daarna een langzame correctie zijn. Na een crash werkt hetzelfde mechanisme in omgekeerde richting.
Koersen kunnen tussen deze twee antwoorden niet kiezen, omdat een prijs een verwachting maal een weging is. Een lage prijs kan betekenen dat beleggers de toekomst somber inschatten, maar ook dat ze een gegeven toekomst zwaar wegen. Een aandeel dat in slechte tijden weinig uitbetaalt, is even weinig waard voor een belegger die slechte tijden waarschijnlijk vindt als voor een belegger die ze erg vindt. Zo keert de gezamenlijke hypothese uit Fama en de efficiënte markt terug, die zegt dat een toets van efficiëntie altijd ook een toets van een model voor de discontovoet is. Geen hoeveelheid koersdata haalt die twee uit elkaar.
Een aparte meting van de verwachting kan dat wel. Als we beleggers vragen wat ze verwachten, voorspellen de twee lezingen bij dezelfde prijs een tegengesteld teken. Volgens Chicago verwachten beleggers na een crash hoge rendementen, omdat ze weten dat aandelen goedkoop zijn en dat ook eisen. Volgens Yale verwachten ze dan lage rendementen, omdat ze de slechte jaren doortrekken. We verwachten dus dat een enquête in de rationele economie negatief met de prijs-dividendratio samenhangt en in de extrapolerende economie positief, terwijl de koersen in beide hetzelfde zijn.
Een enquête laat bovendien sneller iets zien dan koersen. Een voorspellingsregressie van rendementen heeft rond een eeuw data nodig, omdat de voorspelbare component verdrinkt in twintig procent ruis per jaar. In een regressie van enquêteverwachtingen op de prijs staat links een overtuiging, en die ruis ontbreekt daar. Greenwood en Shleifer vonden in zes enquêtes het teken van Yale, al meet een enquête wat mensen zeggen en niet noodzakelijk wat de belegger denkt die de prijs zet.
3Toy-voorbeeld: twee economieën, één prijspad, drie perioden
We laden eerst de pakketten die het hele college gebruikt.
import io

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import requests
import statsmodels.api as sm
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Vanaf hier zijn kleine letters logs. De log dividend-prijsratio is hoog als de markt goedkoop is, en alle grootheden zijn afwijkingen van hun gemiddelde. We lenen de benadering van Campbell en Shiller uit Voorspelbaarheid van rendementen. Die schrijft het log rendement als de ratio van vandaag, min de verdisconteerde ratio van morgen, plus de dividendgroei:
Hier is , een getal net onder één dat past bij een prijs die gemiddeld 24 keer het dividend is. Beide economieën delen het volgende pad van de ratio en de dividendgroei, en ze verschillen alleen in wie de prijs zet.
| jaar | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 0,10 | 0,00 | −0,10 | 0,05 | |
| – | 0,02 | −0,01 | 0,00 |
De ratio zakt twee jaar lang van hoog naar laag en herstelt in jaar 3 gedeeltelijk, terwijl de dividendgroei klein blijft. In economie (a) eist een rationele belegger een vereiste premie boven het gemiddelde, die met persistentie naar nul terugkeert, zodat er elk jaar naar verwachting de helft van overblijft, terwijl de verwachte dividendgroei constant is. In economie (b) is de vereiste premie constant, maar wijkt de prijs af van de fundamentele prijs , de waarde bij de vaste premie. Dat verschil is het sentiment van extrapolerende beleggers, en het dooft met dezelfde persistentie uit. In een enquête noemt de rationele belegger in (a) zijn premie , en noemen de extrapolatoren in (b) een verwachting , met hun gevoeligheid voor het sentiment, die we in stap 5 vastleggen.
Stap 1, de rendementen. We vullen het pad in de identiteit in. Dat geeft , dan en .
Stap 2, de voorspellingsregressie. De regressor heeft gemiddelde nul en kwadratensom , dus . Deze helling gebruikt alleen prijzen en dividenden en is in beide economieën dezelfde.
Stap 3, economie (a). Het verwachte rendement is hier de premie. Nemen we de verwachting van de identiteit, waarin de verwachte dividendgroei als afwijking van haar gemiddelde nul is, dan is de ratio van vandaag de premie plus maal de verwachte ratio van volgend jaar. Die verwachte ratio is maal de ratio van vandaag, ook al volgt het pad in de tabel die regel niet, omdat er elk jaar een schok bijkomt. Herhaald invullen geeft de meetkundige reeks , met , dus . In jaar 0 is de markt goedkoop omdat beleggers 5,2 procentpunt extra eisen.
Stap 4, economie (b). De fundamentele ratio is constant, dus . Het objectieve verwachte rendement is , precies als in (a), omdat het dezelfde identiteit op hetzelfde pad is.
Stap 5, de enquête. Met , zodat de schaal gelijk is, antwoorden de beleggers in (a) en in (b). De helling van het rendement op de enquête is dan in (a) en in (b).
Omdat de prijs-dividendratio in logs gelijk is aan , hangt de enquête in (a) negatief en in (b) positief samen met de prijs-dividendratio. De codecel rekent de vijf stappen na en zet de uitkomsten naast de handberekening.
RHO_TOY, PHI_TOY = 0.96, 0.50
K_TOY = 1 - RHO_TOY * PHI_TOY                          # 1 - rho * phi = 0.52
dp_toy = np.array([0.10, 0.00, -0.10, 0.05])           # dp_0 .. dp_3
dd_toy = np.array([0.02, -0.01, 0.00])                 # dividend growth in years 1 .. 3
r_toy = dp_toy[:-1] - RHO_TOY * dp_toy[1:] + dd_toy    # Campbell-Shiller returns r_1 .. r_3
dp_start = dp_toy[:-1]                                 # the predictor dp_0 .. dp_2


def ols_slope(y, x):
    """OLS slope of y on x with an intercept."""
    xd = x - x.mean()
    return float((xd * (y - y.mean())).sum() / (xd**2).sum())


survey_a = K_TOY * dp_start      # (a): the rational investor reports the required premium
survey_b = -K_TOY * dp_start     # (b): extrapolators report theta * s_t with s_t = -dp_t

code = {
    "r_1": r_toy[0], "r_2": r_toy[1], "r_3": r_toy[2],
    "helling r op dp, (a) en (b)": ols_slope(r_toy, dp_start),
    "helling enquête op dp, (a)": ols_slope(survey_a, dp_start),
    "helling enquête op dp, (b)": ols_slope(survey_b, dp_start),
    "helling r op enquête, (a)": ols_slope(r_toy, survey_a),
    "helling r op enquête, (b)": ols_slope(r_toy, survey_b),
}
hand = [0.120, 0.086, -0.148, 1.34, 0.52, -0.52, 2.5769, -2.5769]
pd.DataFrame({"met de hand": hand, "code": list(code.values())}, index=list(code)).round(4)De code geeft dezelfde getallen. Niets in de rendementen of in de helling op verraadt welke economie de data maakte, en alleen de enquête scheidt de twee, met een tegengesteld teken.
4Theorie
De theorie gaat van een feit via een onmogelijkheid naar een uitweg. Het feit is de decompositie waarover beide kampen het eens zijn. De onmogelijkheid is dat prijzen alleen het product van overtuigingen en marginaal nut vastleggen, en de uitweg is het teken van een enquête.
4.1Het feit: de decompositie van Cochrane
Een hoge dividend-prijsratio wordt later terugbetaald met hoge rendementen, met lage dividendgroei, of doordat de ratio over jaar nog steeds hoog is. Een belegger die vandaag goedkoop koopt, ontvangt het verschil langs een van die drie wegen, en een vierde weg bestaat niet. Regresseren we elk van de drie toekomstige grootheden op de ratio van vandaag, dan tellen de hellingen dus op tot één. Welke helling het werk doet, is een empirische vraag.
In Voorspelbaarheid van rendementen leidden we die optelling af voor een oneindige horizon ((8)). Cochrane Cochrane (2011) schrijft de versie voor een eindige horizon , met lange-termijncoëfficiënten uit regressies van , van en van op :
De vergelijking verdeelt de hele variantie van de dividend-prijsratio over verwachte rendementen, verwachte dividendgroei en een eindterm, die bij een oneindige horizon alleen een bel kan zijn. Cochranes tabel II vindt over 1947–2009 een rendementsterm rond één en dividend- en eindtermen rond nul, en de replicatie zet die getallen naast de onze. Cochrane merkte op dat men in de jaren zeventig precies het omgekeerde had verwacht. Wat men op nul schatte, bleek één, en wat men op één schatte, bleek nul.
De decompositie zegt met grote precisie dát de discontovoet beweegt, maar niet waarom. De helling is een covariantie tussen een prijs en latere rendementen. Die covariantie is dezelfde als beleggers rationeel meer eisen en als ze zich vergissen. Het toy-voorbeeld liet dat zien met in beide economieën. Cochrane noemde de variatie in discontovoeten daarom de centrale vraag van het vak, en niet het antwoord.
4.2Wat “efficiënt” betekent als discontovoeten variëren
Zolang het verwachte rendement constant werd verondersteld, betekende efficiëntie in de praktijk dat rendementen onvoorspelbaar zijn, en die betekenis verdwijnt zodra de discontovoet mag bewegen. Fama definieerde in 1970 een efficiënte markt als een markt waarin prijzen alle beschikbare informatie weerspiegelen. Dat is pas toetsbaar als erbij staat welk verwacht rendement een correcte prijs oplevert.
In Fama en de efficiënte markt bewezen we dat bij elk patroon van voorspelbaarheid een positieve SDF bestaat die het verklaart (Proposition 2). Een voorspellende dividend-prijsratio weerlegt dus niet de efficiëntie zelf, maar alleen de combinatie van efficiëntie en een constante discontovoet. Fama Fama (1991) schreef daarom dat efficiëntie alleen samen met een evenwichtsmodel te toetsen is, en zijn Nobellezing Fama (2014) noemt die twee de pijlers van de theorie van activaprijzen.
Als discontovoeten variëren, verschuift de inhoud van het woord van rendementen naar verwachtingen. Een markt is dan efficiënt als de verwachtingen in de prijs gelijk zijn aan die van een econometrist met dezelfde informatie. De weging van toestanden is een kwestie van voorkeuren. Aan die voorkeuren stelt de Hansen-Jagannathan-grens van Mehra-Prescott en Hansen-Jagannathan alleen een ondergrens, want de SDF moet minstens zo volatiel zijn als de Sharpe-ratio van de markt vraagt. Die voorwaarde is noodzakelijk, niet voldoende, en sluit alleen te vlakke SDF’s uit. Zo wordt de vraag een meetprobleem, en de volgende twee subsecties laten zien wat er gemeten moet worden.
Tegen de anomalieën uit de gedragseconomie verdedigde Fama zich in 1998 met een ander argument Fama (1998). Overreactie komt volgens hem ongeveer even vaak voor als onderreactie, wat bij toeval past en niet bij een gedeelde vergissing. Dat argument raakt de dividend-prijsratio niet, want die voorspelt over een eeuw steeds met hetzelfde teken.
4.3Het kernresultaat: prijzen zien alleen het product
Een prijs is een som over toestanden van kans maal weging maal uitbetaling. Een belegger die de kans op een recessie verdubbelt en tegelijk de weging van een euro in die recessie halveert, betaalt voor een aandeel precies hetzelfde. Koersen kunnen kans en weging dus nooit uit elkaar halen. Zolang de dividenden volgens de ware kansen worden getrokken, zien ook de gerealiseerde rendementen er in beide gevallen hetzelfde uit.
In deze subsectie is de prijs zelf, niet de log ervan. Laat de objectieve kansmaat zijn en een SDF, zodat voor elke payoff . Een belegger met subjectieve overtuigingen rekent met verwachtingen . Als beide kansmaten dezelfde gebeurtenissen onmogelijk vinden, bestaat er een dichtheid met en voor elke . Die dichtheid is de verhouding tussen subjectieve en ware kans. Een belegger die de kans op een recessie verdubbelt, heeft in die toestand .
De scherpe kant van de propositie is het tweede deel. Welke we ook kiezen, bijvoorbeeld een SDF met een constante prijs van risico, er bestaan overtuigingen die samen met , op de schaalfactor na, de waargenomen prijzen precies verklaren. De rationele econometrist zet vast en schat , terwijl de gedragseconoom een plausibele vastzet en schat. Beide modellen passen perfect, en de data kunnen er niet tussen kiezen.
In het toy-voorbeeld is (a) de economie met en een variërende premie. Economie (b) heeft een constante premie en overtuigingen die met het sentiment meebewegen. Proposition 5 in Behavioral finance en limits of arbitrage was een speciaal geval hiervan in een log-lineaire economie. De propositie raakt ook het thema van Hansen Hansen (2014). Als beleggers zelf niet weten welk model waar is, is geen vergissing maar een uitdrukking van modelonzekerheid, zodat “rationeel” niet meer hetzelfde betekent als .
4.4Wat het voorspelt: het teken van een enquête
Als prijzen alleen het product zien, is een aparte meting van of van nodig, en een enquête levert zo’n meting. Een enquête over verwachtingen meet een moment onder , terwijl gerealiseerde rendementen op den duur hetzelfde moment onder meten. Het verschil tussen beide is de afwijking van rationele verwachtingen.
De enquête wijkt dus alleen van het ware verwachte rendement af als de overtuigingen samenhangen met het rendement zelf. De toets is de nulhypothese van Greenwood en Shleifer. In de log-lineaire wereld van het toy-voorbeeld mogen we het bruto rendement door het log rendement vervangen, omdat het verschil bij constante variantie alleen het intercept raakt, en wordt (4) een voorspelling over tekens. Laat een AR(1) zijn met persistentie en variantie , laat de verwachte dividendgroei constant zijn, en schrijf . In beide economieën is het objectieve verwachte rendement dan .
De enquête is , met een onafhankelijke meetfout met variantie . De gevoeligheid is in economie (a) en in economie (b). Dan geldt
omdat en . Beide hellingen hebben dus het teken van , positief in de rationele economie en negatief in de extrapolerende. Dat is het teken dat de intuïtie verwachtte, want een enquête die positief met samenhangt, hangt negatief samen met de prijs-dividendratio.
In het toy-voorbeeld is , zodat de enquête een helling van op heeft. Zonder meetfout is de helling van het rendement op de enquête in de populatie dan precies +1 in (a) en -1 in (b). De drie gerealiseerde rendementen gaven , omdat drie waarnemingen vooral ruis bevatten.
In de simulatie van de volgende sectie, die op Cochranes VAR is gekalibreerd, is veel kleiner, ongeveer 0,093, en heeft de enquête een meetfout van 4 procentpunt. Daar zakt de tweede helling in (a) naar 0,525, omdat de meetfout bijna evenveel variantie heeft als de verwachting zelf. Hoe groter de meetfout, hoe dichter de tweede helling bij nul komt, terwijl de eerste helling blijft. Daarom is de helling van de enquête op de prijs de robuustere toets. Ook de andere bronnen van extra data meten of apart, elk met een eigen aanname.
Opties. Optieprijzen meten verwachtingen onder de risiconeutrale maat, en dus opnieuw het product van en . Martin Martin (2017) haalt er onder een voorwaarde op de SDF toch een ondergrens voor de premie uit, en die grens liep in de crisis van 2008 op tot boven 20%. Zo’n meting vraagt geen eeuw rendementen, maar wel een aanname over .
Flows. Gegevens over wie koopt en wie verkoopt meten de vraag van afzonderlijke groepen beleggers. Als extrapolatoren kopen na stijgingen en prijzen daarop reageren, is dat een meting van die niet op zelfrapportage steunt. Dat programma van Koijen & Yogo (2019) en Gabaix & Koijen (2021) komt terug in Demand systems en inelastische markten.
Consumptie en intermediairs. Die geven een onafhankelijke meting van , zoals in Lucas, Breeden en de SDF en 2008 en intermediary asset pricing, maar de gemeten bleek daar niet volatiel genoeg.
4.5Middenwegen: vier modellen en hun enquêtetekens
Echte modellen liggen tussen de twee economieën van het toy-voorbeeld in, en ze verschillen vooral in wie de enquête beantwoordt en welk teken die enquête dan krijgt.
Campbell-Cochrane (1999). Het rationele antwoord uit Habit, long-run risk en rampen is economie (a). De premie is daar hoog als de consumptie dicht bij de gewoonte ligt, het niveau waaraan beleggers gewend zijn Campbell & Cochrane (1999). Als deze beleggers de enquête beantwoorden, zijn hun verwachtingen hoog na een crash en hangen ze negatief samen met de prijs-dividendratio.
Extrapolatie met een rationele tegenpartij. In het X-CAPM van Barberis, Greenwood, Jin en Shleifer (BGJS) Barberis et al. (2015) vormen extrapolatoren hun verwachtingen uit recente koersstijgingen. Greenwood en Shleifer verklaren hun enquêtes met hetzelfde mechanisme. Fundamentele beleggers vangen hun vraagschokken op tegen een premie. Greenwood en Shleifer noemen die markt niet efficiënt, ook al gedragen de fundamentele beleggers zich rationeel. Dit is economie (b), met de extrapolatoren als respondenten.
Leren over koerswinsten. Adam, Marcet en Beutel Adam et al. (2017) laten beleggers rationeel optimaliseren gegeven hun overtuigingen over koerswinsten, terwijl ze die overtuigingen uit het verleden leren. Volgens hen zijn enquêteverwachtingen te optimistisch op koerstoppen en te pessimistisch in dalen, en zijn ze formeel niet rationeel. Dat geeft het teken van (b), maar dan met een marginale belegger die geen vergissing maakt die hij zelf zou kunnen zien.
Vervagend geheugen. Nagel en Xu Nagel & Xu (2022) laten een representatieve belegger de gemiddelde groei leren met een geheugen dat vervaagt. In hun model beweegt de objectieve premie sterk tegen de conjunctuur in, terwijl de subjectieve premie nagenoeg vlak blijft. Bovendien voorspelt de dividendgroei uit het verleden zowel latere rendementen als de fouten in enquêteverwachtingen. Dat is een derde patroon naast de tekens van (a) en (b).
| Model | Wie beantwoordt de enquête | ||
|---|---|---|---|
| (a) Tijdvariërende risicoaversie, Campbell-Cochrane | de rationele, marginale belegger | negatief | positief, één zonder meetfout |
| (b) Extrapolatie met rationele tegenpartij, BGJS, Greenwood-Shleifer | extrapolatoren | positief | negatief |
| Leren over koerswinsten, Adam-Marcet-Beutel | de marginale belegger, subjectief | positief | negatief |
| Vervagend geheugen, Nagel-Xu | de representatieve belegger | vrijwel nul, de subjectieve premie is vlak | geen vast teken, de fouten zijn voorspelbaar |
De tabel laat zien dat alle vier de modellen bij dezelfde prijzen passen, maar een ander verband tussen enquête en prijs voorspellen.
5Simulatie: honderd jaar van twee economieën, en hoeveel enquêtejaren nodig zijn
De simulatie beantwoordt één vraag, namelijk hoeveel jaar data nodig is om de rationele en de extrapolerende economie van elkaar te scheiden, met koersen of met een enquête. We schalen het toy-voorbeeld daarvoor op naar de kalibratie van Cochranes VAR uit Voorspelbaarheid van rendementen. De persistentie van wordt , en ligt dicht bij de 0,96 van het toy-voorbeeld.
Schokken in hebben een standaarddeviatie van 15,3% en dividendschokken van 14,0%, met een onderlinge correlatie van 7,5%, en de dividendgroei is niet voorspelbaar. Economie (a) laat de vereiste premie bewegen volgens en zet . Economie (b) laat het sentiment bewegen volgens , met een eigen trekking van de schokken, en zet . In beide volgen de rendementen uit de identiteit van Campbell en Shiller.
De enquête is in (a) en in (b), met zoals in het toy-voorbeeld. De meetfout heeft een standaarddeviatie van 4 procentpunt, en oefening 4 laat zien wat er bij meer of minder meetfout verandert. De eerste cel legt het model vast in twee functies, één die steekproeven uit een economie trekt en één die per steekproef een regressie schat.
RHO, PHI = 0.9638, 0.941
SD_DP, SD_D, CORR_D_DP = 0.153, 0.140, 0.075
K = 1 - RHO * PHI
SD_SURVEY = 0.04
chol = np.linalg.cholesky(np.array([[SD_DP**2, CORR_D_DP * SD_DP * SD_D],
                                    [CORR_D_DP * SD_DP * SD_D, SD_D**2]]))


def simulate_economy(n, T, economy, theta=K, sd_survey=SD_SURVEY):
    """Simulate n samples of T years from economy 'a' (rational) or 'b' (extrapolative).

    Returns dp (n, T+1), log returns r (n, T) with r[:, t] earned after dp[:, t], and the
    survey expectation (n, T+1). Both economies share the dp law of motion and the
    Campbell-Shiller identity; they differ only in who prices and who answers the survey.
    """
    shocks = rng.standard_normal((n, T + 1, 2)) @ chol.T
    state = np.empty((n, T + 1))
    dp0 = rng.normal(0.0, SD_DP / np.sqrt(1 - PHI**2), n)
    if economy == "a":
        state[:, 0] = K * dp0
        for t in range(T):
            state[:, t + 1] = PHI * state[:, t] + K * shocks[:, t + 1, 0]
        dp, belief = state / K, state
    else:
        state[:, 0] = -dp0
        for t in range(T):
            state[:, t + 1] = PHI * state[:, t] - shocks[:, t + 1, 0]
        dp, belief = -state, theta * state
    returns = dp[:, :-1] - RHO * dp[:, 1:] + shocks[:, 1:, 1]
    return dp, returns, belief + rng.normal(0.0, sd_survey, dp.shape)


def ols_rows(y, x):
    """Row-wise OLS slope and conventional t-statistic of y on x (each row one sample)."""
    xd = x - x.mean(axis=1, keepdims=True)
    yd = y - y.mean(axis=1, keepdims=True)
    slope = (xd * yd).sum(axis=1) / (xd**2).sum(axis=1)
    resid = yd - slope[:, None] * xd
    se = np.sqrt((resid**2).sum(axis=1) / (y.shape[1] - 2) / (xd**2).sum(axis=1))
    return slope, slope / se
De tweede cel trekt uit elke economie 10 000 steekproeven van honderd jaar. In elke steekproef schatten we drie regressies, van het rendement op , van de enquête op en van het rendement op de enquête.
sim = {}
for economy in "ab":
    dp_s, r_s, survey_s = simulate_economy(10_000, 100, economy)
    b_r, t_r = ols_rows(r_s, dp_s[:, :-1])
    b_survey, _ = ols_rows(survey_s, dp_s)
    b_on_survey, _ = ols_rows(r_s, survey_s[:, :-1])
    corr_pd = np.array([np.corrcoef(s, -d)[0, 1] for s, d in zip(survey_s[:2000], dp_s[:2000])])
    sim[economy] = {"b_r": b_r, "b_survey": b_survey}
    sim[economy + "_row"] = {
        "gemiddelde b_r": b_r.mean(), "sd b_r": b_r.std(), "P(t_r > 2)": np.mean(t_r > 2),
        "gemiddelde helling enquête op dp": b_survey.mean(), "sd helling enquête": b_survey.std(),
        "mediaan corr(enquête, pd)": np.median(corr_pd),
        "mediaan helling r op enquête": np.median(b_on_survey),
    }

var_dp = SD_DP**2 / (1 - PHI**2)
ks = stats.ks_2samp(sim["a"]["b_r"], sim["b"]["b_r"])
beta_pop = K * K * var_dp / (K**2 * var_dp + SD_SURVEY**2)
print(f"Kolmogorov-Smirnov, verdeling van b_r in (a) en (b): p = {ks.pvalue:.3f}")
print(f"populatie b(r op enquête): (a) {beta_pop:+.3f}, (b) {-beta_pop:+.3f}")
pd.DataFrame({"economie (a)": sim["a_row"], "economie (b)": sim["b_row"]}).round(3)
Kolmogorov-Smirnov, verdeling van b_r in (a) en (b): p = 0.758
populatie b(r op enquête): (a) +0.525, (b) -0.525
De voorspellende helling is in beide economieën gemiddeld 0,132, met dezelfde spreiding, en de Kolmogorov-Smirnov-toets verwerpt niet dat de twee verdelingen gelijk zijn. Het gemiddelde ligt boven de ware waarde . Dat verschil is de Stambaugh-bias uit Voorspelbaarheid van rendementen. Die ontstaat omdat een schok die de ratio verlaagt tegelijk het rendement verhoogt, en is in beide economieën even groot.
De helling van de enquête op ligt daarentegen met een standaarddeviatie van 0,012 rond en , zodat de twee verdelingen niet overlappen. De mediane helling van het rendement op de enquête ligt dicht bij de populatiewaarde uit (5), die de cel ook afdrukt. De volgende cel herhaalt de proef voor steekproeven van vijf tot honderdvijftig jaar en telt hoe vaak elke regressie het juiste teken met vindt.
years = [5, 10, 15, 20, 30, 50, 75, 100, 150]
power_rows = []
for T_years in years:
    dp_a, r_a, s_a = simulate_economy(10_000, T_years, "a")
    dp_b, _, s_b = simulate_economy(10_000, T_years, "b")
    _, t_sa = ols_rows(s_a, dp_a)
    _, t_sb = ols_rows(s_b, dp_b)
    _, t_ra = ols_rows(r_a, dp_a[:, :-1])
    power_rows.append({"jaren": T_years, "enquête (a): t > 2": np.mean(t_sa > 2),
                       "enquête (b): t < -2": np.mean(t_sb < -2),
                       "rendementen: t(b_r) > 2": np.mean(t_ra > 2)})
power = pd.DataFrame(power_rows).set_index("jaren")
power.round(3)Een enquête van dertig jaar vindt het juiste teken in 85% van de steekproeven. De rendementsregressie is na honderd jaar pas in twee van de drie steekproeven significant. De figuur zet de drie resultaten naast elkaar. Let links op de overlap van de verdelingen van , in het midden op de scheiding van de enquêtehellingen en rechts op de afstand tussen de krommen.
Source
fig, axes = plt.subplots(1, 3, figsize=(13, 4.2))
for economy, colour, label in [("a", hap.plotting.COLORS[0], "(a) rationeel"),
                               ("b", hap.plotting.COLORS[1], "(b) extrapolerend")]:
    axes[0].hist(sim[economy]["b_r"], bins=np.linspace(-0.15, 0.40, 56), histtype="step",
                 lw=1.6, color=colour, label=label)
    axes[1].hist(sim[economy]["b_survey"], bins=np.linspace(-0.16, 0.16, 65), histtype="step",
                 lw=1.6, color=colour, label=label)
axes[0].set_title("Rendement op $dp$: niet te onderscheiden")
axes[0].set_xlabel("Geschatte $b_r$ (100 jaar)")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].legend()
axes[1].set_title("Enquête op $dp$: tegengesteld teken")
axes[1].set_xlabel("Geschatte helling van de enquête op $dp$ (100 jaar)")
axes[1].set_ylabel("Aantal steekproeven")
axes[1].legend()
axes[2].plot(power.index, power["enquête (a): t > 2"], marker="o", label="enquête op $dp$")
axes[2].plot(power.index, power["rendementen: t(b_r) > 2"], marker="s", label="rendement op $dp$")
axes[2].axhline(0.8, color="grey", lw=0.8, ls=":")
axes[2].set_xscale("log")
axes[2].set_xticks(years, [str(y) for y in years])
axes[2].set_title("Hoeveel jaar data nodig is")
axes[2].set_xlabel("Lengte van de steekproef (jaren)")
axes[2].set_ylabel("Kans op $|t| > 2$ met het juiste teken")
axes[2].legend()
plt.show()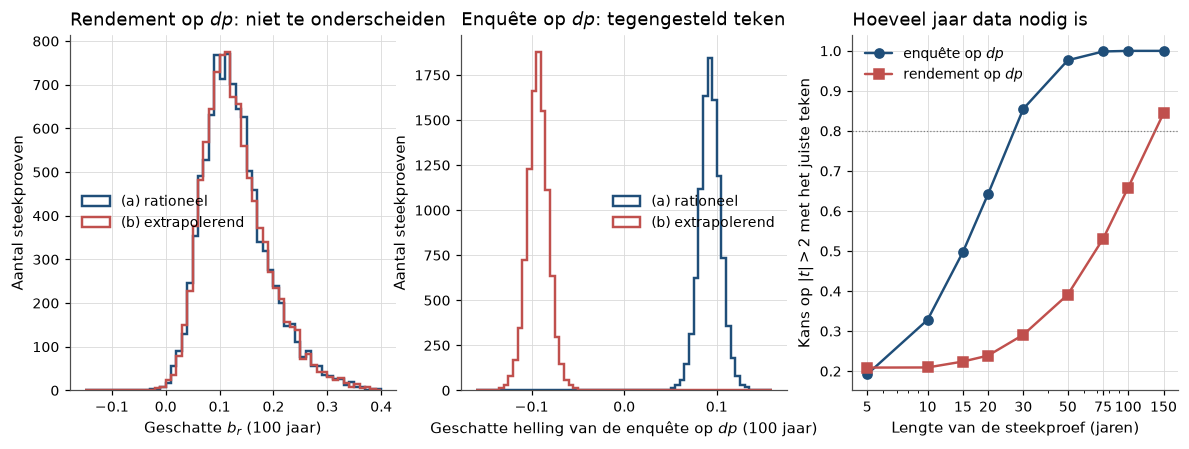
Figure 1:Links is de verdeling van de voorspellende helling over 10 000 steekproeven van honderd jaar in beide economieën dezelfde. Honderd jaar koersen zegt dus niets over wie gelijk heeft. In het midden heeft de helling van de enquête op in de twee economieën een tegengesteld teken, en overlappen de verdelingen niet. Rechts staat de kans om het juiste teken met te zien. Voor de enquête is die na dertig jaar rond 85%, voor de rendementsregressie na honderd jaar twee op de drie.
Een enquête haalt de grens van 80% dus na twintig à dertig jaar en de rendementsregressie pas na meer dan een eeuw, omdat links in de enquêteregressie geen twintig procent rendementsruis staat.
6Replicatie op echte data
6.1(1) De decompositie van Cochrane
Volgens Cochrane verklaart de rendementsterm bijna de hele beweging in . We toetsen dat over zijn periode 1947–2009 en over de naoorlogse steekproef tot 2025, met jaarlijkse log rendementen, dividendgroei en .
gw = hap_data.goyal_welch("annual")
gw.index = gw.index.year
div_yield = (1 + gw["CRSP_SPvw"]) / (1 + gw["CRSP_SPvwx"]) - 1
price_idx = (1 + gw["CRSP_SPvwx"]).cumprod()
annual = pd.DataFrame({"r": np.log1p(gw["CRSP_SPvw"]),
                       "dd": np.log(div_yield * price_idx).diff(),
                       "dp": np.log(div_yield)})


def cochrane_decomposition(first, last, k=15):
    """Cochrane (2011) Tables II-III: one-year VAR and the long-run coefficients of eq. schema."""
    s = annual.loc[first - 1:last]
    rho = np.exp(-s["dp"].mean()) / (1 + np.exp(-s["dp"].mean()))
    one_year = {}
    for col in ["r", "dd", "dp"]:
        f = pd.concat([s[col].rename("y"), s["dp"].shift(1).rename("x")], axis=1).dropna()
        fit = sm.OLS(f["y"], sm.add_constant(f["x"])).fit()
        one_year[col] = (fit.params["x"], fit.tvalues["x"], fit.rsquared)
    b_r, b_d, phi = one_year["r"][0], one_year["dd"][0], one_year["dp"][0]
    a = rho * phi
    weights = rho ** np.arange(k)
    direct = {}
    for col, name in [("r", "b_r"), ("dd", "b_d")]:
        future = sum(weights[j] * s[col].shift(-(j + 1)) for j in range(k))
        f = pd.concat([future.rename("y"), s["dp"].rename("x")], axis=1).dropna()
        direct[name] = sm.OLS(f["y"], sm.add_constant(f["x"])).fit().params["x"]
    f = pd.concat([(rho**k * s["dp"].shift(-k)).rename("y"), s["dp"].rename("x")], axis=1).dropna()
    direct["rho^k b_dp"] = sm.OLS(f["y"], sm.add_constant(f["x"])).fit().params["x"]
    long_run = pd.DataFrame(
        {"direct": direct,
         "VAR, zelfde k": {"b_r": b_r * (1 - a**k) / (1 - a), "b_d": b_d * (1 - a**k) / (1 - a),
                           "rho^k b_dp": a**k},
         "VAR, k=inf": {"b_r": b_r / (1 - a), "b_d": b_d / (1 - a), "rho^k b_dp": 0.0}}
    ).T
    long_run["som"] = long_run["b_r"] - long_run["b_d"] + long_run["rho^k b_dp"]
    return one_year, rho, long_run


one_0909, rho_0909, lr_0909 = cochrane_decomposition(1947, 2009)
_, _, lr_4725 = cochrane_decomposition(1947, 2025)
cochrane_table3 = {"r": (0.13, 2.61, 0.10), "dd": (0.04, 0.92, 0.02), "dp": (0.94, 23.8, 0.91)}
one_year_table = pd.concat(
    {"hier 1947-2009": pd.DataFrame(one_0909, index=["b", "t", "R2"]).T,
     "Cochrane tabel III (1947-2009)": pd.DataFrame(cochrane_table3, index=["b", "t", "R2"]).T},
    axis=1)
print(f"één jaar, regressie op dp van vorig jaar (rho = {rho_0909:.4f}):")
print(one_year_table.round(3).to_string(), "\n")
cochrane_table2 = pd.DataFrame({"b_r": [1.01, 1.05, 1.35], "b_d": [-0.11, 0.27, 0.35],
                                "rho^k b_dp": [-0.11, 0.22, 0.00]}, index=lr_0909.index)
cochrane_table2["som"] = cochrane_table2["b_r"] - cochrane_table2["b_d"] + cochrane_table2["rho^k b_dp"]
pd.concat({"hier 1947-2009": lr_0909, "Cochrane tabel II (k=15)": cochrane_table2,
           "hier 1947-2025": lr_4725}).round(3)
één jaar, regressie op dp van vorig jaar (rho = 0.9669):
hier 1947-2009 Cochrane tabel III (1947-2009)
b t R2 b t R2
r 0.131 2.880 0.120 0.13 2.61 0.10
dd 0.053 1.463 0.034 0.04 0.92 0.02
dp 0.952 23.793 0.903 0.94 23.80 0.91
Geslaagd. De éénjaarshellingen in de eerste tabel liggen binnen één standaardfout van Cochranes tabel III, ruim binnen de verwachte twee standaardfouten. De directe decompositie over vijftien jaar legt in de eerste rij van de tweede tabel de hele beweging bij de verwachte rendementen, met binnen de verwachte band en vrijwel nul. In elke rij tellen de drie termen vrijwel op tot één. De VAR-rijen wijken meer af van Cochrane, omdat ze gevoelig zijn voor . Zo is bij in plaats van 0,90 de factor al ruim een kwart groter.
Tot 2025 verandert het beeld op één punt. De directe zakt naar 0,73 en de eindterm stijgt naar 0,17, zodat een zesde van de beweging in de ratio na vijftien jaar nog niet is terugbetaald. Dat komt door de lage dividend-prijsratio van de laatste decennia, die ook in Voorspelbaarheid van rendementen de voorspellingsregressie verzwakte. Of daarachter een blijvend lagere discontovoet zit, een verschuiving van dividend naar inkoop van eigen aandelen of een trage bel, zegt de decompositie niet.
6.2(2) De CFO-enquête
Volgens Chicago verwachten financieel directeuren een hoog rendement als hoog is, en volgens Yale een laag rendement. We laden hun enquête met een kleine lokale loader en berekenen de correlatie met over de periode van Greenwood en Shleifer en over de hele steekproef.
CFO_URL = ("https://www.richmondfed.org/-/media/RichmondFedOrg/research/national_economy/"
           "cfo_survey/current_historical_cfo_data.xlsx")


@hap.cache.cached("cfo_survey")
def cfo_survey() -> pd.DataFrame:
    """CFO Survey (Duke / Richmond Fed / Atlanta Fed): mean expected S&P 500 return.

    Columns ``sp_1_exp`` (next 12 months) and ``sp_10_exp`` (next 10 years), decimals,
    quarterly from 2001Q4, stamped at the end of the second month of the survey quarter
    (the survey closes early in the third month). Sheet ``through_Q1_2020`` holds the
    Graham-Harvey history, sheet ``CFO_SP500`` the continuation from 2020Q3.
    """  # TODO: naar hap.data
    payload = requests.get(CFO_URL, timeout=180, headers={"User-Agent": "Mozilla/5.0"}).content
    cols = ["year", "quarter", "sp_1_exp", "sp_10_exp"]
    old = pd.read_excel(io.BytesIO(payload), sheet_name="through_Q1_2020")[cols]
    new = pd.read_excel(io.BytesIO(payload), sheet_name="CFO_SP500")[
        ["year", "quarter", "sp_12moexp_2", "sp_10yrexp_2"]].set_axis(cols, axis=1)
    frame = pd.concat([old, new], ignore_index=True).dropna(subset=["sp_1_exp"])
    stamps = [pd.Timestamp(int(y), 3 * int(q) - 1, 1) + pd.offsets.MonthEnd(0)
              for y, q in zip(frame["year"], frame["quarter"])]
    frame.index = pd.DatetimeIndex(stamps, name="date")
    return frame[["sp_1_exp", "sp_10_exp"]] / 100.0


cfo = cfo_survey()
shiller = hap_data.shiller()
mkt = hap_data.market_monthly()
log_excess = np.log1p(mkt["Mkt"]) - np.log1p(mkt["RF"])
survey_panel = pd.concat(
    [cfo["sp_1_exp"].rename("enquete"),
     np.log(shiller["dp"]).rename("log_dp"),
     np.log1p(mkt["Mkt"]).rolling(12).sum().rename("rendement_vorig_jaar"),
     log_excess.rolling(12).sum().shift(-12).rename("excess_volgend_jaar")],
    axis=1, sort=True,
).loc[cfo.index]
print(f"{cfo.index[0]:%Y-%m} t/m {cfo.index[-1]:%Y-%m}: {len(cfo)} kwartalen; "
      f"gemiddelde verwachting {cfo['sp_1_exp'].mean():.2%}, sd {cfo['sp_1_exp'].std():.2%}")

early = survey_panel.loc[:"2011-12"]
pd.DataFrame(
    {"corr(enquête, log D/P)": [early["enquete"].corr(early["log_dp"]),
                                survey_panel["enquete"].corr(survey_panel["log_dp"]), -0.443],
     "N": [len(early[["enquete", "log_dp"]].dropna()),
           len(survey_panel[["enquete", "log_dp"]].dropna()), 42]},
    index=["hier 2001-2011", "hier 2001-2026", "Greenwood-Shleifer tabel 4 (2000-2011)"],
).round(3)
2001-11 t/m 2026-05: 96 kwartalen; gemiddelde verwachting 5.43%, sd 1.42%
De correlatie is in beide periodes negatief, zoals bij Greenwood en Shleifer. De volgende cel schat vier regressies met Newey-West-standaardfouten. De eerste twee verklaren de enquête uit , met en zonder het rendement van het afgelopen jaar, en de laatste twee voorspellen het latere overrendement met de enquête of met .
specs = [("enquete", ["log_dp"], 4), ("enquete", ["rendement_vorig_jaar", "log_dp"], 4),
         ("excess_volgend_jaar", ["enquete"], 6), ("excess_volgend_jaar", ["log_dp"], 6)]
reg_rows = []
for y, xs, lags in specs:
    fit = hap.newey_west(survey_panel[y], survey_panel[xs], lags=lags)
    for x in xs:
        reg_rows.append({"regressie": f"{y} op {' + '.join(xs)}", "regressor": x,
                         "b": fit.params[x], "t": fit.tvalues[x],
                         "R2": fit.rsquared, "N": int(fit.nobs)})
fit_b1 = hap.newey_west(survey_panel["excess_volgend_jaar"], survey_panel[["enquete"]], lags=6)
print(f"toets b = 1 in de voorspellingsregressie: t = "
      f"{(fit_b1.params['enquete'] - 1) / fit_b1.bse['enquete']:.2f}")
pd.DataFrame(reg_rows).set_index(["regressie", "regressor"]).round(3)
toets b = 1 in de voorspellingsregressie: t = -1.61
De eerste rij van de tabel toont het teken van extrapolatie, want de enquête heeft een helling van op met . In de figuur gaat het links om de richting van de puntenwolk en rechts om het verschil tussen de zwarte OLS-lijn en de gestreepte lijn met helling één.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.4))
year_frac = survey_panel.index.year + (survey_panel.index.month - 1) / 12
sc = axes[0].scatter(-survey_panel["log_dp"], 100 * survey_panel["enquete"], c=year_frac,
                     cmap="viridis", s=22)
axes[0].set_xlabel("Log prijs-dividendratio")
axes[0].set_ylabel("Verwacht S&P 500-rendement, 12 maanden (%)")
axes[0].set_title("CFO's verwachten meer als de markt duur is")
fig.colorbar(sc, ax=axes[0], label="Jaar")
ok = survey_panel[["enquete", "excess_volgend_jaar"]].dropna()
line = np.polyfit(ok["enquete"], ok["excess_volgend_jaar"], 1)
grid = np.linspace(ok["enquete"].min(), ok["enquete"].max(), 50)
axes[1].scatter(100 * ok["enquete"], 100 * ok["excess_volgend_jaar"], s=22, color=hap.plotting.COLORS[1])
axes[1].plot(100 * grid, 100 * np.polyval(line, grid), color="black", lw=1.2, label="OLS")
axes[1].plot(100 * grid, 100 * (grid - ok["enquete"].mean() + ok["excess_volgend_jaar"].mean()),
             color="grey", lw=1.0, ls="--", label="rationele verwachtingen: helling 1")
axes[1].set_xlabel("Verwacht S&P 500-rendement, 12 maanden (%)")
axes[1].set_ylabel("Gerealiseerd log overrendement, 12 maanden (%)")
axes[1].set_title("... en die verwachting voorspelt het rendement niet")
axes[1].legend()
plt.show()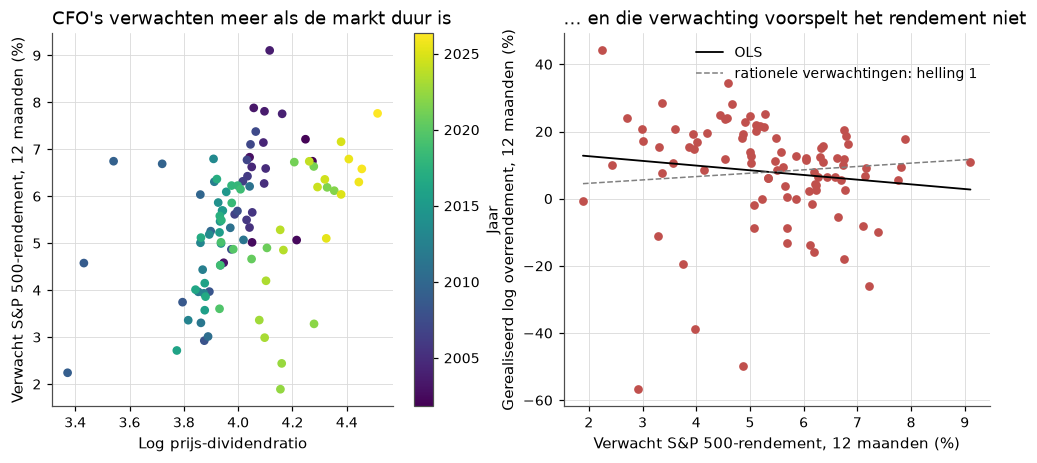
Figure 2:De CFO-enquête, 2001–2026. Links stijgt de verwachting van financieel directeuren met de prijs-dividendratio, het teken van economie (b) en van Greenwood en Shleifer. Rechts is de helling van het latere overrendement op de verwachting negatief en onnauwkeurig, ver van de helling één die rationele verwachtingen vragen. Ruim negentig overlappende kwartalen bevatten vooral ruis.
Geslaagd. Beide tekens kloppen met Greenwood en Shleifer, en beide correlaties in de eerste tabel liggen in de verwachte band van tot , dicht bij hun .
Een markt die een log-punt duurder is, gaat samen met een verwachting die drie procentpunt hoger ligt, terwijl economie (a) het omgekeerde teken voorspelde. Het rendement van het afgelopen jaar komt er met een positief teken bij, zoals bij extrapolatie hoort.
Aan de rendementskant is de helling van het latere overrendement op de verwachting negatief maar niet significant, terwijl in dezelfde steekproef met het juiste teken voorspelt. De nulhypothese verwerpen we met deze ene enquête niet, maar Greenwood en Shleifer deden dat met langere reeksen en meer enquêtes wel.
Aan de enquêtekant is het bewijs dus sterk, want bijna honderd kwartalen volstaan, zoals de simulatie beloofde. Maar de simulatie liet ook zien wat de enquête niet uitsluit. Als financieel directeuren niet de marginale beleggers zijn, zegt hun extrapolatie weinig over de van de beleggers die de prijs zetten. Het teken van de enquête bewijst dat iemand extrapoleert, maar niet dat die iemand de prijs bepaalt.
6.3(3) Shillers CAPE, bijgewerkt
In Williams en het dividend discount model regresseerden we het reële tienjaarsrendement op log CAPE over de hele steekproef tot 2015, en hier werken we de jaren daarna bij zonder vooruit te kijken. We schatten de regressie op beginjaren tot en met 2006, waarvan de uitkomsten in 2016 bekend waren. Daarmee voorspellen we de beginjaren 2007–2015, en voor de huidige CAPE gebruiken we de regressie op alle beginjaren tot en met 2016.
december = shiller[shiller.index.month == 12][["cape", "stock_real_return_10y"]].copy()
december.index = december.index.year
december["log_cape"] = np.log(december["cape"])


def cape_fit(last_start):
    """HAC regression of the annualised 10-year real return on log CAPE, start years up to last_start."""
    d = december.loc[:last_start].dropna()
    return hap.newey_west(d["stock_real_return_10y"], d[["log_cape"]], lags=9)


fit_2006, fit_2016 = cape_fit(2006), cape_fit(2016)
update = december.loc[2007:2015, ["cape", "stock_real_return_10y"]].rename(
    columns={"stock_real_return_10y": "gerealiseerd"})
update["voorspeld (fit t/m 2006)"] = (fit_2006.params["const"]
                                      + fit_2006.params["log_cape"] * np.log(update["cape"]))
cape_now = shiller["cape"].dropna()
forecast_now = fit_2016.params["const"] + fit_2016.params["log_cape"] * np.log(cape_now.iloc[-1])
print(f"helling t/m 2006: {fit_2006.params['log_cape']:.4f} (t = {fit_2006.tvalues['log_cape']:.2f}), "
      f"R2 = {fit_2006.rsquared:.2f}, n = {int(fit_2006.nobs)}")
print(f"helling t/m 2016: {fit_2016.params['log_cape']:.4f} (t = {fit_2016.tvalues['log_cape']:.2f}), "
      f"R2 = {fit_2016.rsquared:.2f}, n = {int(fit_2016.nobs)}")
errors = update["gerealiseerd"] - update["voorspeld (fit t/m 2006)"]
print(f"gemiddelde fout 2007-2015: {errors.mean():+.3f}; correlatie voorspeld-gerealiseerd: "
      f"{update['gerealiseerd'].corr(update['voorspeld (fit t/m 2006)']):.2f}")
print(f"CAPE {cape_now.index[-1]:%Y-%m}: {cape_now.iloc[-1]:.1f} -> voorspeld reëel rendement "
      f"{forecast_now:.2%} per jaar (residu-sd {np.sqrt(fit_2016.scale):.1%})")
update.round(3)
helling t/m 2006: -0.0745 (t = -6.56), R2 = 0.33, n = 126
helling t/m 2016: -0.0632 (t = -4.56), R2 = 0.24, n = 135
gemiddelde fout 2007-2015: +0.071; correlatie voorspeld-gerealiseerd: 0.52
CAPE 2026-09: 40.6 -> voorspeld reëel rendement 0.59% per jaar (residu-sd 4.5%)
Geslaagd. De eerste regel van de uitvoer geeft op beginjaren tot 2006 een negatieve helling met ruim boven de verwachte grens van twee, en ze blijft negatief als we de beginjaren tot 2016 meenemen. Niet voorzien was het niveau. Volgens de tabel lagen de voorspellingen voor 2007–2015 elk jaar te laag, gemiddeld zeven procentpunt per jaar. De rangorde van de jaren klopte wel, het niveau niet.
In september 2026 staat de voorlopige CAPE op 40,6. Van alle decemberwaarden sinds 1881 lag alleen die van 1999 hoger. De regressie voorspelt daarbij een reëel rendement van ongeveer 0,6% per jaar, met een residuele standaarddeviatie van 4,5 procentpunt, en de steekproef bevat maar een dozijn onafhankelijke decennia.
De fout van zeven procentpunt beslist evenmin tussen de twee lezingen. Volgens de Chicago-lezing is de discontovoet na 2008 samen met de reële rente blijvend gedaald. Een hoge CAPE is dan een lage premie en geen overwaardering, zodat een regressie met een constant gemiddelde te laag moest uitkomen. Volgens de Yale-lezing is de markt steeds duurder geworden omdat beleggers de hausse doortrokken, en is de correctie uitgesteld en niet afgeschaft. De lage rendementen na de CAPE-top van 1999 gaven Shiller gelijk, de hoge rendementen na 2009 niet.
7Wat er brak, en wat daarna kwam
Wat het debat opleverde. Het debat leverde een feit en een formulering op die allebei vaststaan. Het feit is dat de variatie in de prijs-dividendratio variatie in verwachte rendementen is, en onze replicatie bevestigt dat op de periode van Cochrane. De formulering is dat elk model van de discontovoet een keuze voor is, terwijl prijzen alleen hun product vastleggen (Proposition 1). Daardoor is het debat een meetprobleem geworden, met als opdracht of apart te meten.
Waar het breekt. Het eerste meetinstrument dat beide kampen serieus namen, geeft het teken van Yale. De CFO-verwachting hangt significant negatief samen met , zoals Greenwood en Shleifer met zes enquêtes vonden, terwijl economie (a) het tegenovergestelde teken voorspelt. Dat verband is het sterkste bewijs tegen de zuiver rationele lezing, want de helling van latere rendementen op de verwachting is hier niet significant. Ondertussen zijn ook de getallen verschoven, want de eindterm van de decompositie is tot 2025 niet meer nul en de CAPE-voorspelling zat sinds 2007 steeds te laag.
Risico of vergissing? Ook hier kiest dit boek niet. Volgens de Chicago-lezing zijn de respondenten van enquêtes niet de marginale beleggers, en voor de beleggers die de risico’s dragen zijn er geen enquêtes. Martins optiegrens en de intermediairfactor zeggen juist dat verwachte rendementen in crises het hoogst zijn, zoals economie (a) voorspelt. Volgens de Yale-lezing is een rationele marginale belegger een postulaat en geen waarneming zolang iedereen die we kunnen vragen het verkeerde teken heeft. Scheiden kan alleen met de verwachtingen en posities van de beleggers die de prijs zetten, op hetzelfde moment gemeten. Die data bestaan pas gedeeltelijk, in flows en bezitsgegevens.
Wat er daarna kwam. Cochranes rede noemde ook een tweede feit zonder theorie, de factor zoo van honderden kenmerken die in de cross-sectie rendementen lijken te voorspellen. Hoeveel daarvan echt zijn, is de vraag van De factor zoo.
8Oefeningen
Solution to Exercise 1
(1) , dus , en de enquête heeft een helling van 0,28 op . (2) De helling verandert niet, omdat ze alleen prijzen en dividenden gebruikt. De helling van het rendement op de enquête wordt .
k_slow = 1 - RHO_TOY * 0.75
survey_slow = k_slow * dp_start
pd.Series({"1 - rho * phi": k_slow, "premie in jaar 0": survey_slow[0],
           "helling r op dp": ols_slope(r_toy, dp_start),
           "helling enquête op dp": ols_slope(survey_slow, dp_start),
           "helling r op enquête": ols_slope(r_toy, survey_slow)}).round(4)
1 - rho * phi 0.2800
premie in jaar 0 0.0280
helling r op dp 1.3400
helling enquête op dp 0.2800
helling r op enquête 4.7857
dtype: float64Een tragere premie verandert welke premie bij hetzelfde prijspad hoort, maar niet de koersstatistiek. Koersen zeggen dus niets over of over de oorzaak, terwijl het teken van de enquête blijft.
Solution to Exercise 2
(1) De enquête is met , dus de helling op is . Het objectieve verwachte rendement is , zodat volgens (5) geldt dat .
(2) Uit volgt . Met is , en met is .
(3) De simulatie gebruikt de functies uit de simulatiesectie.
def simulate_mixture(n, T, w, theta):
    """Economy (a) prices with a survey mixing rational (1 - w) and extrapolative (w) answers."""
    dp, returns, _ = simulate_economy(n, T, "a", sd_survey=0.0)
    belief = (1 - w) * K * dp - w * theta * dp
    return dp, returns, belief + rng.normal(0.0, SD_SURVEY, dp.shape)


rows_mix = {}
for w_mix, theta_mix in [(0.656, K), (0.437, 2 * K)]:
    dp_m, r_m, s_m = simulate_mixture(5000, 100, w_mix, theta_mix)
    a_mix = (1 - w_mix) * K - w_mix * theta_mix
    rows_mix[f"w = {w_mix}, theta = {theta_mix / K:.0f}K"] = {
        "helling enquête op dp (sim)": ols_rows(s_m, dp_m)[0].mean(),
        "helling (formule)": a_mix,
        "helling r op enquête (sim, mediaan)": np.median(ols_rows(r_m, s_m[:, :-1])[0]),
        "helling r op enquête (formule)": a_mix * K * var_dp / (a_mix**2 * var_dp + SD_SURVEY**2),
    }
pd.DataFrame(rows_mix).T.round(3)Beide combinaties geven dezelfde enquêtehelling van ongeveer en dezelfde, zwak negatieve helling van rendementen op de enquête. Een enquête legt dus de netto afwijking van rationele verwachtingen vast, maar niet hoeveel beleggers extrapoleren of hoe sterk. Zo keert de gelijkwaardigheid van Proposition 1 terug in de enquête zelf, want veel mengsels van respondenten geven hetzelfde gemiddelde antwoord.
Solution to Exercise 3
De cel herhaalt de decompositie voor de zes combinaties van steekproef en horizon.
rows_k = {}
for first, last in [(1927, 2025), (1947, 2009), (1947, 2025)]:
    for k in (10, 20):
        rows_k[(f"{first}-{last}", k)] = cochrane_decomposition(first, last, k=k)[2].loc["direct"]
pd.DataFrame(rows_k).T.rename_axis(["steekproef", "k"]).round(3)Over 1947–2009 levert het grootste deel, 0,89 bij en 1,05 bij . Zodra de steekproef tot 2025 doorloopt, en nog meer vanaf 1927, blijft een groter deel van de beweging na jaar in de ratio zelf zitten. Over 1927–2025 is de eindterm bij met 0,47 even groot als , en pas bij zakt hij naar 0,20.
Op een langere steekproef is de dividend-prijsratio persistenter, zodat bij een eindige horizon een deel van de variantie buiten beeld valt. Dat is geen bewijs voor een bel, maar het oordeel over de eindterm hangt wel af van hoe ver we kijken. Daarmee hangt het af van de schatting van , die in Voorspelbaarheid van rendementen al de zwakke plek was.
Solution to Exercise 4
De cel zoekt per meetfout het kleinste aantal jaren dat de grens van 80% haalt.
needed = {}
for sd_eta in (0.02, 0.04, 0.08):
    needed[sd_eta] = np.nan
    for T_years in [5, 10, 15, 20, 30, 50, 75, 100]:
        dp_n, _, s_n = simulate_economy(4000, T_years, "a", sd_survey=sd_eta)
        if np.mean(ols_rows(s_n, dp_n)[1] > 2) >= 0.8:
            needed[sd_eta] = T_years
            break
pd.Series(needed, name="jaren nodig voor 80% kans").rename_axis("meetfout enquête").to_frame()Bij 2, 4 en 8 procentpunt meetfout zijn 15, 30 en 75 jaar nodig. De standaardfout van de helling is ongeveer , met de spreiding van binnen een steekproef van jaar. Bij een vaste zou een verdubbeling van de meetfout vier keer zoveel jaren vragen.
Een langere steekproef ziet echter ook meer van de trage beweging in , zodat met meegroeit. Een verdubbeling van de meetfout vraagt hier daarom maar twee à tweeënhalf keer zoveel jaren. Bij een ruis van 8 procentpunt heeft ook een enquête driekwart eeuw nodig, al blijft ze twee keer zo snel als de rendementsregressie, die de grens van 80% pas na anderhalve eeuw haalt. Hoe goed een enquête meet, is daarom net zo belangrijk als de vraag of de respondenten de prijs zetten.
- Cochrane, J. H. (2011). Presidential Address: Discount Rates. Journal of Finance, 66(4), 1047–1108. 10.1111/j.1540-6261.2011.01671.x
- Greenwood, R., & Shleifer, A. (2014). Expectations of Returns and Expected Returns. Review of Financial Studies, 27(3), 714–746. 10.1093/rfs/hht082
- Economic Sciences Prize Committee of the Royal Swedish Academy of Sciences. (2013). Understanding Asset Prices: Scientific Background on the Sveriges Riksbank Prize in Economic Sciences in Memory of Alfred Nobel 2013. Royal Swedish Academy of Sciences, 14 October 2013. https://www.nobelprize.org/uploads/2013/10/advanced-economicsciences2013.pdf
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Fama, E. F. (2014). Two Pillars of Asset Pricing. American Economic Review, 104(6), 1467–1485. 10.1257/aer.104.6.1467
- Shiller, R. J. (2014). Speculative Asset Prices. American Economic Review, 104(6), 1486–1517. 10.1257/aer.104.6.1486
- Hansen, L. P. (2014). Nobel Lecture: Uncertainty Outside and Inside Economic Models. Journal of Political Economy, 122(5), 945–987. 10.1086/678456
- Fama, E. F. (1991). Efficient Capital Markets: II. The Journal of Finance, 46(5), 1575–1617. 10.1111/j.1540-6261.1991.tb04636.x
- Fama, E. F. (1998). Market Efficiency, Long-Term Returns, and Behavioral Finance. Journal of Financial Economics, 49(3), 283–306. 10.1016/S0304-405X(98)00026-9
- Martin, I. (2017). What Is the Expected Return on the Market? Quarterly Journal of Economics, 132(1), 367–433. 10.1093/qje/qjw034
- Koijen, R. S. J., & Yogo, M. (2019). A Demand System Approach to Asset Pricing. Journal of Political Economy, 127(4), 1475–1515. 10.1086/701683
- Gabaix, X., & Koijen, R. S. J. (2021). In Search of the Origins of Financial Fluctuations: The Inelastic Markets Hypothesis (NBER Working Paper No. 28967). National Bureau of Economic Research. 10.3386/w28967
- Campbell, J. Y., & Cochrane, J. H. (1999). By Force of Habit: A Consumption-Based Explanation of Aggregate Stock Market Behavior. Journal of Political Economy, 107(2), 205–251. 10.1086/250059
- Barberis, N., Greenwood, R., Jin, L., & Shleifer, A. (2015). X-CAPM: An Extrapolative Capital Asset Pricing Model. Journal of Financial Economics, 115(1), 1–24. 10.1016/j.jfineco.2014.08.007
- Adam, K., Marcet, A., & Beutel, J. (2017). Stock Price Booms and Expected Capital Gains. American Economic Review, 107(8), 2352–2408. 10.1257/aer.20140205
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD