

ARCH, GARCH, realized volatility en de VIX
1Overzicht
Hoe is volatiliteit te voorspellen, en maakt een goed gemeten variantie de beloning voor risico zichtbaar? Volatiliteit is met GARCH goed te voorspellen. De beloning voor dat risico is echter zo klein tegenover de ruis in het rendement dat een toets zelfs met de ware variantie in de simulatie meer dan zeventig jaar data nodig heeft. Dat volatiliteit voorspelbaar is en rendementen nauwelijks, rekent Santa-Clara tot de lessen van het vak Santa-Clara (2026). In dit college:
leiden we GARCH af, met de voorspelling van de variantie op elke horizon;
laten we zien hoe asymmetrie, gerealiseerde variantie en de VIX de variantie scherper of vooruitkijkend meten;
simuleren we hoe goed GARCH de variantie volgt en hoeveel jaar data de risicoaversie vraagt;
repliceren we GARCH en GJR-GARCH op een eeuw dagrendementen, HAR-RV tegen GARCH, en de MIDAS-schatting van de relatie tussen risico en rendement, die op onze data niet slaagt.
Robert Engle schreef in 1982 het eerste model waarin de variantie afhangt van de gekwadrateerde schokken van gisteren, ARCH (autoregressive conditional heteroskedasticity, een variantie die voorwaardelijk op het verleden verandert) Engle (1982). Tim Bollerslev voegde er in 1986 één parameter aan toe, en zijn GARCH is nog altijd de maatstaf Bollerslev (1986). Met dat werk kreeg de klontering van volatiliteit een schatbaar model. Daarna maakte de gerealiseerde variantie (realized variance, de som van gekwadrateerde intradagrendementen, met als wortel de realized volatility) de variantie bijna waarneembaar Andersen et al. (2001)Andersen et al. (2003). De beloning voor risico bleef omstreden. French, Schwert en Stambaugh vonden een positief maar zwak verband French et al. (1987), Glosten, Jagannathan en Runkle een negatief Glosten et al. (1993). Ghysels, Santa-Clara en Valkanov concludeerden in 2005 dat er toch een verband is Ghysels et al. (2005). GARCH beschrijft zo een feit, terwijl de relatie tussen risico en rendement een theorie is die nog op een toets wacht.
2Intuïtie: waarom zou dit waar zijn?
Mandelbrot zag in 1963 in katoenprijzen dat op grote prijsveranderingen vaak weer grote volgen, van welk teken ook Mandelbrot (1963). Fama vond hetzelfde in de dagrendementen van de Dow Fama (1965). Of morgen een goede of een slechte dag wordt, is dus niet te voorspellen, maar wel of het een grote dag wordt. In Rendementen en hun statistiek was de autocorrelatie van het dagrendement nul en die van het absolute dagrendement ongeveer 0,30.
Volatiliteit klontert omdat nieuws in golven komt, zoals weken van slecht nieuws in een bankencrisis, en omdat beleggers op elkaar reageren en posities in delen afbouwen. Bovendien verandert een koersdaling het risico zelf, want het bedrijf heeft dan verhoudingsgewijs meer schuld, zodat het eigen vermogen riskanter wordt. Die leverage-hypothese van Black voorspelt dat de volatiliteit meer stijgt na een daling dan na een even grote stijging Black (1976).
Dat de variantie wel voorspelbaar is en het gemiddelde niet, is geen toeval. Een voorspelbaar rendement is geld op straat dat beleggers meteen oprapen, terwijl een voorspelbare variantie niets zegt over de richting en dus geen winst belooft.
Op 19 oktober 1987 verloor de Amerikaanse aandelenmarkt op één dag meer dan een vijfde van de beurswaarde. Een deel van de verkopen kwam van portfolio insurance (portefeuilleverzekering, een put die wordt nagebootst door bij dalende koersen aandelen te verkopen) Rubinstein & Leland (1981). Een model dat de variantie van gisteren gebruikt, ziet zo’n crash in een rustige markt niet aankomen, omdat het pas reageert als de crash er is.
Als beleggers compensatie eisen voor variantie, stijgt het verwachte rendement met de voorspelde variantie. Het rendement van volgende maand heeft echter zoveel ruis dat alleen een grote en precies gemeten spreiding in de variantie een helling zichtbaar maakt, en dan nog pas na tientallen jaren. Bovendien trekt elke meetfout in de variantie die helling naar nul.
We verwachten dus dat de voorspelde variantie na een schok geleidelijk terugzakt naar een vast niveau, en dat ze na een daling meer stijgt dan na een stijging. De helling van het rendement op de variantie is volgens dezelfde redenering positief maar klein.
3Toy-voorbeeld: vier dagen GARCH met de hand
De berekeningen in dit college gebruiken de pakketten hieronder. Alle simulaties delen één vaste seed.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import statsmodels.api as sm
from arch import arch_model
from scipy import optimize, stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
We volgen een GARCH(1,1) voor dagrendementen in procenten, met gemiddelde nul, over vier dagen. Het recept, dat de theorie straks als eerste invoert, maakt de variantie van morgen een vaste bodem plus een deel van het gekwadrateerde rendement van vandaag plus een deel van de variantie van vandaag:
Hier is de variantie van , bekend aan het eind van dag . De vier rendementen zijn:
| dag | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| (%) | +1 | -2 | 0 | -3 |
Het langetermijnniveau is , een dagvolatiliteit van , en daar beginnen we met .
Na dag 1 is .
Na dag 2 is .
Na dag 3 is .
Na dag 4 is , een dagvolatiliteit van .
Voor dag 6 is onbekend, maar , zodat .
De voorspelling zakt dus per dag met factor terug naar 0,5, met een halfwaardetijd van dagen. Het tweedaagse rendement heeft variantie .
De codecel rekent dezelfde recursie na en zet hand en code naast elkaar.
omega, alpha, beta = 0.05, 0.10, 0.80
toy_returns = np.array([1.0, -2.0, 0.0, -3.0])     # percent, days 1-4

h = np.empty(len(toy_returns) + 1)
h[0] = omega / (1 - alpha - beta)                   # h_1 = unconditional variance
for t, r in enumerate(toy_returns):
    h[t + 1] = omega + alpha * r**2 + beta * h[t]

two_step = omega + (alpha + beta) * h[-1]
half_life = np.log(0.5) / np.log(alpha + beta)

by_hand = {"h_1": 0.5, "h_2": 0.55, "h_3": 0.89, "h_4": 0.762, "h_5": 1.5596,
           "E_4[h_6]": 1.4536, "Var_4(r_5 + r_6)": 3.0132, "halfwaardetijd (dagen)": 6.58}
by_code = [*h, two_step, h[-1] + two_step, half_life]
assert np.allclose(list(by_hand.values()), by_code, atol=2e-3)
pd.DataFrame({"met de hand": list(by_hand.values()), "code": by_code},
index=list(by_hand)).round(4)Code en handberekening geven dezelfde getallen. De dag met rendement nul verlaagt de variantie, omdat de oude schok uitsterft zonder dat er een nieuwe bijkomt. Eén dag van brengt de voorspelde variantie op ruim drie keer het langetermijnniveau. Die ene slechte dag bepaalt de voorspelling nog dagenlang, want pas na 6,58 dagen is de helft van het verschil weggewerkt.
4Theorie
De theorie gaat van beschrijving naar toets. Eerst leiden we GARCH af, met de voorspelling op elke horizon en de schatting. Daarna meten asymmetrie, gerealiseerde variantie en de VIX de variantie scherper of vooruitkijkend. De kern komt aan het eind: waarom ruis in het rendement en meetfout in de variantie de beloning voor risico bijna onzichtbaar maken.
4.1Opzet: ARCH en GARCH
Waarom zou dit waar zijn? Als volatiliteit klontert, schat een belegger de variantie van morgen het best met recente gekwadrateerde schokken, en recente dagen wegen daarbij het zwaarst. Zo’n gewogen gemiddelde laat zich schrijven als de oude schatting plus een correctie in de richting van de laatste schok. Met een constante erbij die het geheel naar een langetermijnniveau trekt, is dat de GARCH-vergelijking.
Schrijf met . Hier is het verwachte dagrendement, een onafhankelijke schok met gemiddelde nul en variantie één, en de voorwaardelijke variantie. Engles ARCH laat afhangen van de laatste gekwadrateerde schokken, en Bollerslevs GARCH voegt de variantie van gisteren toe:
Op dagdata is ongeveer 0,1 en ongeveer 0,9, zoals de replicatie laat zien. Herhaald invullen maakt van GARCH een ARCH met gewichten die als afnemen.
Proof 1
. Vervang in (2) door en door en herschik. Een stationaire ARMA(1,1) met autoregressieve coëfficiënt en martingaalverschil-schokken heeft autocorrelaties die vanaf lag 1 meetkundig dalen met die factor. De schokken zelf zijn ongecorreleerd, want , omdat onafhankelijk is van alles wat op bekend is.
Kwadraten met geheugen en schokken zonder geheugen zijn precies het patroon van Mandelbrot en Fama. Omdat de variantie willekeurig is, is de verdeling van bovendien een mengsel van normale verdelingen, met dikkere staarten dan de normale (oefening 2).
4.2Het kernresultaat: persistentie en de meerstapsvoorspelling
Een belegger die de variantie over tien dagen wil weten, kent de tussenliggende schokken niet en vervangt elk kwadraat door zijn verwachting, de variantie zelf. Daardoor vallen en samen tot één factor, en zolang die kleiner is dan één, zakt de voorspelling meetkundig terug naar een vast niveau.
Proof 2
Neem van (2) op met . Omdat , is , een lineaire differentievergelijking met vast punt . Dus , en herhalen tot geeft (5). Voor convergeert de voorspelling naar , en onvoorwaardelijke verwachtingen geven (4). Voor is er geen eindige onvoorwaardelijke variantie. Omdat de schokken ongecorreleerd zijn (Proposition 1), is de variantie van de som de som van de voorwaardelijke varianties, en die volgt door (5) op te tellen met de meetkundige reeks.
De afstand tot het langetermijnniveau krimpt elke dag met factor . Hoe dichter bij één ligt, hoe langer een schok doorwerkt, omdat de oude variantie vasthoudt. In het toy-voorbeeld was , met een halfwaardetijd van 6,58 dagen.
In de replicatie op echte dagrendementen is 0,989, met een halfwaardetijd van 61 handelsdagen. Op een maandhorizon is de voorspelde variantie dan informatief, maar op een jaarhorizon ligt ze al dicht bij het langetermijnniveau. Daarom heeft de langetermijnbelegger uit Merton: continue tijd en het ICAPM weinig aan GARCH, en de risicomanager van het volgende college des te meer.
4.3Schatten met quasi-maximum likelihood
Gegeven de parameters is de hele reeks varianties uit te rekenen, zodat elk rendement een trekking is uit een verdeling met bekende variantie. Met is de Gaussische log-likelihood
Een te grote variantie kost likelihood via en een te kleine via de fout gedeeld door . De schatter werkt ook als de schokken niet normaal zijn.
De score naar een parameter in is evenredig met , en die term heeft verwachting nul welke verdeling ook heeft. Alleen de gelijkheid gaat verloren, en daarom zijn alle standaardfouten in de replicatie sandwich-standaardfouten.
4.4Asymmetrie: GJR-GARCH
Een daling verhoogt de volatiliteit meer dan een even grote stijging. Black verklaarde dat met de hefboom van een vaste schuld Black (1976). De causaliteit kan ook andersom lopen, want als beleggers een hogere volatiliteit verwachten en daarvoor een premie eisen, daalt de prijs vandaag. GARCH is blind voor het teken van , en daarom kozen Glosten, Jagannathan en Runkle een term die alleen bij negatieve schokken aanstaat Glosten et al. (1993):
Na een daling telt het kwadraat met mee, na een stijging met alleen. In het origineel heet de parameter , maar in dit college is de risicoaversie. De persistentie is , omdat de indicator bij symmetrische de helft van de tijd aanstaat. De sterkere reactie op dalingen uit de intuïtie betekent hier . Precies dat vonden de auteurs, samen met een negatief verband tussen het verwachte rendement en de voorwaardelijke variantie.
4.5Gerealiseerde variantie en HAR-RV
In Theorem 3 werd een constante variantie scherper gemeten naarmate we vaker keken, terwijl het gemiddelde niet beter werd. Beweegt de volatiliteit door de tijd, dan is ze binnen een korte periode bijna constant, zodat hetzelfde argument per periode geldt. Laat de log-koers bewegen volgens en deel op in stukken met rendementen . De gerealiseerde variantie is , en de integrated variance is de werkelijke variantie over de periode.
Proof 3
We bewijzen de consistentie, voorwaardelijk op het pad van en (daarvoor is de onafhankelijkheid van nodig). Met is dan normaal met gemiddelde en variantie over het -de stuk, met en . Dus en . Optellen geeft
omdat . Chebyshev geeft convergentie in kans. De variantie is de asymptotische variantie in (8), en de normaliteit volgt uit een centrale limietstelling voor de onafhankelijke termen .
De meetfout daalt dus met . Bij constante volatiliteit is de relatieve standaardfout , en met 21 dagrendementen per maand is dat ongeveer 31%. Intradagrendementen maken de fout veel kleiner, zolang de onderzoeker niet zo vaak meet dat de bid-ask bounce uit Roll: de kritiek en de R² de som opblaast.
Gerealiseerde variantie dooft langzamer uit dan de meetkundige daling van GARCH. Corsi verklaarde dat met partijen die elk op hun eigen horizon handelen, zoals dagtraders, wekelijkse herbalanceerders en pensioenfondsen Corsi (2009). Zijn HAR-RV-model (heterogeneous autoregressive model of realized volatility) regresseert daarom de gerealiseerde variantie op de eigen gemiddelden over de laatste dag, week en maand:
De helling meet hoe snel de variantie op nieuws reageert en hoe lang ze het onthoudt. Zonder intradagdata gebruiken we hieronder een maandversie met gemiddelden over één, drie en twaalf maanden.
4.6De VIX als prijs van een variance swap
Het kwadraat van de VIX, een volatiliteit op jaarbasis in procenten, is de risiconeutrale verwachting van de variantie over de komende dertig dagen, en die verwachting is zonder model uit optieprijzen af te lezen. Volgens het lemma van Itô is het verschil tussen een continu geherbalanceerde belegging in de index en een contract op de logaritme van de koers precies een halve variantie. Het logcontract is met opties over alle uitoefenprijzen na te bouwen, en daarom is een optieportefeuille een weddenschap op de variantie. Sinds 2003 berekent de CBOE de VIX zo, met de formule van Carr en Madan Carr & Madan (2001) en Demeterfi, Derman, Kamal en Zou Demeterfi et al. (1999). De eerste VIX middelde nog Black-Scholes-volatiliteiten Whaley (2000).
Proof 4
Itô geeft , dus . Onder is , en met volgt . Voor elke twee keer differentieerbare geldt . Met , en is . Invullen en delen door .
De formule gebruikt geen Black-Scholes, alleen dat de koers niet springt. Het gewicht laat de dure puts van de smirk (het patroon waarin puts met een lage uitoefenprijs duurder zijn dan Black-Scholes zegt) zwaar meetellen. Het kwadraat van de VIX ligt gemiddeld boven de gerealiseerde variantie van de dertig dagen erna, omdat kopers van variantie een verzekering tegen onrustige markten betalen, en dat verschil is de variance risk premium uit Figuur 3.
4.7Risico en rendement: de meetfout in de variantie
Als de verwachte variantie van de markt stijgt, wil de representatieve belegger minder aandelen, terwijl hij in evenwicht toch de hele markt moet houden. De prijs daalt dan tot het verwachte rendement hem weer overhaalt, en die daling is groter naarmate hij risico slechter verdraagt.
In Merton: continue tijd en het ICAPM legde een belegger met relatieve risicoaversie bij constante beleggingskansen de fractie in de markt, de Merton-portefeuille. Houdt één representatieve belegger de hele markt, dan is die fractie één en is de marktpremie risicoaversie maal variantie, , ofwel 8% bij en . Variëren de beleggingskansen, dan voegt het ICAPM een hedgingterm toe, maar de toetsen hieronder laten die weg en passen de myopische relatie per maand toe:
Hier is het overrendement van de markt over de volgende maand, en de constante is nul in het zuivere model. French, Schwert en Stambaugh schatten met de gerealiseerde variantie van de vorige maand en met GARCH-in-mean, en vonden een positief maar insignificant verband French et al. (1987). In de herberekening van Ghysels, Santa-Clara en Valkanov gaf de schatter met de variantie van de vorige maand over 1928–1984 zelfs Ghysels et al. (2004).
De helling krimpt dus met het deel van de spreiding in dat werkelijk signaal is. Ook zonder meetfout groeit de -waarde pas met de wortel uit het aantal maanden. Zo bevestigt de propositie de kleine, positieve helling uit de intuïtie en zegt ze hoe klein.
Neem een maandrendement met een standaarddeviatie van 5%, en een spreiding van de ware maandvariantie van 0,0015. Een verwachte van twee vraagt dan maanden, bijna zestig jaar, en dat met de ware variantie en normale ruis. Die rekensom is de standaardfout van 2% in een nieuwe gedaante, want het rendement staat links in de regressie en neemt al zijn ruis mee.
Ghysels, Santa-Clara en Valkanov antwoordden met de MIDAS-regressie (mixed data sampling, een maandvariabele op een gewogen som van dagwaarnemingen). Ze schatten de variantie als
met dagen en een factor 22 die een gemiddeld dagkwadraat omzet in een maandvariantie. De gewichten hebben de vorm van een Beta-dichtheid en worden samen met en geschat met QML. Zo kiest de likelihood van het rendement tussen een maand dagdata, vers maar ruisig, en een jaar, precies maar oud. In hun hoofdspecificatie met exponentiële gewichten, waarvan 31% op de eerste maand valt, vonden ze op CRSP-data over 1928–2000 met Ghysels et al. (2004).
5Simulatie: de variantie volgen en γ meten
De simulatie gaat na wat in een realistische steekproef te meten is, de variantie of de prijs ervan. Eerst volgt GARCH tien jaar lang de variantie, daarna tellen we hoeveel jaar data vraagt.
5.1Hoe goed volgt GARCH de variantie?
We simuleren 200 paden van tien jaar dagrendementen uit een GARCH(1,1) in procenten. Het model heeft de van het toy-voorbeeld maar , zodat de persistentie 0,98 is, zoals op echte data. Volgens oefening 2 is de autocorrelatie van bij lag 1 dan .
N_PATHS, N_DAYS = 200, 2520
OMEGA_S, ALPHA_S, BETA_S = 0.02, 0.10, 0.88
PHI_S = ALPHA_S + BETA_S

h_sim = np.empty((N_DAYS + 1, N_PATHS))
r_sim = np.empty((N_DAYS, N_PATHS))
h_sim[0] = OMEGA_S / (1 - PHI_S)
for t in range(N_DAYS):
    r_sim[t] = np.sqrt(h_sim[t]) * rng.standard_normal(N_PATHS)
    h_sim[t + 1] = OMEGA_S + ALPHA_S * r_sim[t] ** 2 + BETA_S * h_sim[t]


def acf_paths(x, lags):
    """Sample autocorrelations per column, averaged over columns."""
    x = x - x.mean(axis=0)
    denom = (x**2).sum(axis=0)
    return np.array([((x[k:] * x[:-k]).sum(axis=0) / denom).mean() for k in lags])


lags = np.arange(1, 31)
acf_r, acf_r2 = acf_paths(r_sim, lags), acf_paths(r_sim**2, lags)
rho1 = ALPHA_S * (1 - ALPHA_S * BETA_S - BETA_S**2) / (1 - 2 * ALPHA_S * BETA_S - BETA_S**2)
acf_theory = rho1 * PHI_S ** (lags - 1)

pd.DataFrame(
    {"autocorr. r": acf_r, "autocorr. r^2": acf_r2, "theorie r^2": acf_theory},
    index=pd.Index(lags, name="lag"),
).loc[[1, 5, 10, 20, 30]].round(3)De rendementen hebben geen autocorrelatie en hun kwadraten wel, al ligt de steekproef bij lag 1 met 0,213 onder de theorie, omdat het vierde moment net eindig is. Voor 100 paden schatten we vervolgens GARCH en zetten we de voorspelling naast de ware , met rollende gemiddelden over 22, 66 en 252 dagen als concurrenten.
N_FIT, BURN = 100, 252
params, mse = [], {"GARCH (geschat)": [], "rollend 22 d": [], "rollend 66 d": [], "rollend 252 d": []}
for i in range(N_FIT):
    fit = arch_model(r_sim[:, i], mean="Zero", vol="GARCH", p=1, q=1).fit(disp="off")
    params.append(fit.params.to_numpy())
    true_h = h_sim[BURN:N_DAYS + 1, i]                       # h_{t+1} for t = BURN-1 .. N_DAYS-1
    garch_h = fit.forecast(horizon=1, start=BURN - 1, reindex=False).variance.to_numpy()[:, 0]
    mse["GARCH (geschat)"].append(np.mean((garch_h - true_h) ** 2))
    sq = pd.Series(r_sim[:, i] ** 2)
    for window in (22, 66, 252):
        rolling = sq.rolling(window).mean().to_numpy()[BURN - 1:N_DAYS]
        mse[f"rollend {window} d"].append(np.mean((rolling - true_h) ** 2))

params = np.array(params)
print("geschat (gem. over paden)  omega, alpha, beta:", params.mean(axis=0).round(3),
      " SD:", params.std(axis=0).round(3))
pd.DataFrame(
    {"MSE t.o.v. ware h": {k: np.mean(v) for k, v in mse.items()},
     "als fractie van Var(h)": {k: np.mean(v) / h_sim[BURN:].var() for k, v in mse.items()}}
).round(4)
geschat (gem. over paden) omega, alpha, beta: [0.021 0.099 0.879] SD: [0.006 0.012 0.015]
Tien jaar dagdata leggen en nauwkeurig vast, en de fout van GARCH is 0,2% van de spreiding van de ware variantie, ruim twintig keer kleiner dan die van het beste rollende venster. In Voorspelbaarheid van rendementen waren zestig jaar niet genoeg om het rendement te voorspellen, terwijl tien jaar hier volstaan om de variantie bijna foutloos te volgen. De figuur zet links de autocorrelaties van en naast elkaar en laat rechts zien hoe het rollende venster achterloopt.
Source
fit0 = arch_model(r_sim[:, 0], mean="Zero", vol="GARCH", p=1, q=1).fit(disp="off")
window = slice(N_DAYS - 750, N_DAYS)
days = np.arange(N_DAYS)[window]

fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
axes[0].bar(lags - 0.2, acf_r, width=0.4, label="rendement $r$")
axes[0].bar(lags + 0.2, acf_r2, width=0.4, label="gekwadrateerd rendement $r^2$")
axes[0].plot(lags, acf_theory, color="black", ls="--", lw=1, label="theorie $r^2$")
axes[0].axhspan(-2 / np.sqrt(N_DAYS), 2 / np.sqrt(N_DAYS), color="grey", alpha=0.2, lw=0)
axes[0].set_title("(a) Autocorrelaties, gemiddeld over 200 paden")
axes[0].set_xlabel("Lag (dagen)")
axes[0].set_ylabel("Autocorrelatie")
axes[0].legend()
axes[1].plot(days, np.sqrt(h_sim[1:][window, 0]), color="black", lw=1.2, label="ware volatiliteit")
axes[1].plot(days, fit0.conditional_volatility[window], lw=1, label="GARCH, geschat")
axes[1].plot(days, np.sqrt(pd.Series(r_sim[:, 0] ** 2).rolling(66).mean().shift(1))[window],
             lw=1, label="rollend venster, 66 dagen")
axes[1].set_title("(b) Eén pad: ware en geschatte volatiliteit")
axes[1].set_xlabel("Dag")
axes[1].set_ylabel("Dagvolatiliteit (%)")
axes[1].legend()
fig.tight_layout()
plt.show()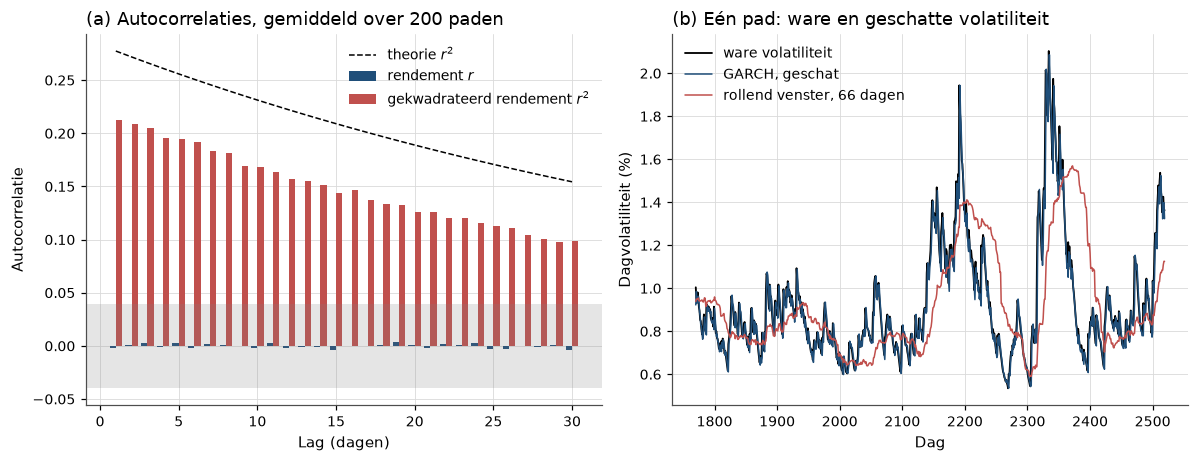
Figure 1:Links hebben rendementen geen geheugen en hun kwadraten wel. Rechts volgt de geschatte GARCH de ware volatiliteit, terwijl het rollende venster achterloopt en de pieken afvlakt.
5.2Hoeveel jaar data vraagt γ?
In deze simulatie geldt (12) per constructie. De dagvariantie is , met een langzame maandcomponent en een snelle GARCH-component , en het dagrendement heeft verwachting . De tabel geeft de keuzes.
| onderdeel | keuze |
|---|---|
| maandcomponent | log-AR(1), persistentie 0,95, standaarddeviatie van 0,6 |
| dagcomponent | GARCH met , en gemiddelde één |
| schokken | Student- met vijf vrijheidsgraden |
| volatiliteit, risicoaversie | 16% per jaar, |
| steekproeven | 1000 paden van 150 jaar |
Zo is de maandvariantie persistent maar ruisig gemeten, en hebben dagrendementen dikke staarten, net als in echte data. We schatten met de ware variantie als maatstaf en met de gerealiseerde variantie van de vorige maand, zoals French, Schwert en Stambaugh. Daarnaast gebruiken we twee exponentieel gewogen sommen van dagkwadraten die MIDAS nabootsen. Die laatste twee leggen 50% en 21% van het gewicht op de laatste maand, rond de 31% van Ghysels, Santa-Clara en Valkanov. De eerste cel legt de parameters en de begintoestand vast.
N_SIM, YEARS_SIM, DAYS_M, GAMMA_TRUE, T_DF = 1000, 150, 22, 2.5, 5
H_BAR = 0.16**2 / 252
PHI_SLOW, SD_LOG_SLOW = 0.95, 0.6
SD_ETA = SD_LOG_SLOW * np.sqrt(1 - PHI_SLOW**2)
MU_LOG_SLOW = -0.5 * SD_LOG_SLOW**2                      # E[s] = 1
A_FAST, B_FAST = 0.04, 0.90
PHI_FAST = A_FAST + B_FAST
T_SCALE = np.sqrt((T_DF - 2) / T_DF)                     # unit-variance Student-t
HALF_LIVES = {"MIDAS-achtig, halfwaarde 22 d": 22, "MIDAS-achtig, halfwaarde 66 d": 66}
lam = {k: 0.5 ** (1 / hl) for k, hl in HALF_LIVES.items()}

n_months = 12 * YEARS_SIM
R_sim = np.zeros((n_months, N_SIM))
V_sim = {k: np.zeros((n_months, N_SIM))
         for k in ["ware variantie", "RV vorige maand (FSS)", *HALF_LIVES]}
log_s = MU_LOG_SLOW + SD_LOG_SLOW * rng.standard_normal(N_SIM)
g = np.ones(N_SIM)
ewma = {k: np.full(N_SIM, H_BAR) for k in lam}
rv_last = np.full(N_SIM, H_BAR * DAYS_M)
geometric = PHI_FAST ** np.arange(DAYS_M)
De tweede cel simuleert maand voor maand 22 handelsdagen en legt aan het eind van elke maand de vier voorspellingen van de variantie van de volgende maand vast. De ware maandvariantie is daarbij de verwachte van de volgende maand maal de som van 22 verwachte dagvarianties, waarin de GARCH-component met dezelfde meetkundige daling als in (5) naar één terugzakt.
for month in range(-24, n_months):                        # 24 burn-in months
    if month >= 0:                                        # forecasts at the end of the previous month
        expected_s = np.exp(MU_LOG_SLOW * (1 - PHI_SLOW) + PHI_SLOW * log_s + 0.5 * SD_ETA**2)
        V_sim["ware variantie"][month] = H_BAR * expected_s * (DAYS_M + (g - 1) * geometric.sum())
        V_sim["RV vorige maand (FSS)"][month] = rv_last
        for k in lam:
            V_sim[k][month] = DAYS_M * ewma[k]
    log_s = MU_LOG_SLOW * (1 - PHI_SLOW) + PHI_SLOW * log_s + SD_ETA * rng.standard_normal(N_SIM)
    s = np.exp(log_s)
    month_return, rv_last = np.zeros(N_SIM), np.zeros(N_SIM)
    for _ in range(DAYS_M):
        h_day = H_BAR * s * g
        z = rng.standard_t(T_DF, N_SIM) * T_SCALE
        shock = np.sqrt(h_day) * z
        month_return += GAMMA_TRUE * h_day + shock
        rv_last += shock**2
        for k in lam:
            ewma[k] = lam[k] * ewma[k] + (1 - lam[k]) * shock**2
        g = (1 - PHI_FAST) + A_FAST * g * z**2 + B_FAST * g
    if month >= 0:
        R_sim[month] = month_return

print(f"gemiddelde maandvariantie {V_sim['ware variantie'].mean():.5f}, "
      f"SD {V_sim['ware variantie'].std():.5f}; "
      f"AR(1) van RV: {np.mean([pd.Series(V_sim['RV vorige maand (FSS)'][:, i]).autocorr() for i in range(100)]):.2f}")
gemiddelde maandvariantie 0.00224, SD 0.00148; AR(1) van RV: 0.45
De ware maandvariantie heeft een spreiding van 0,0015, de waarde uit de vuistregel, en de gerealiseerde variantie een autocorrelatie van 0,45. De volgende cel schat per pad de helling met gewogen kleinste kwadraten, met gewichten zoals QML, en een White-standaardfout.
def wls_slope(y, x):
    """Column-wise WLS slope of y on x with weights 1/x and a White standard error."""
    w = (1 / x) / (1 / x).sum(axis=0)
    x_bar, y_bar = (w * x).sum(axis=0), (w * y).sum(axis=0)
    sxx = (w * (x - x_bar) ** 2).sum(axis=0)
    slope = (w * (x - x_bar) * (y - y_bar)).sum(axis=0) / sxx
    resid = (y - y_bar) - slope * (x - x_bar)
    se = np.sqrt((w**2 * (x - x_bar) ** 2 * resid**2).sum(axis=0)) / sxx
    return slope, slope / se


sample_lengths = (25, 50, 73, 100, 150)
gamma_hat, rows = {}, []
for years in sample_lengths:
    for name, V in V_sim.items():
        slope, tval = wls_slope(R_sim[: 12 * years], V[: 12 * years])
        gamma_hat[(years, name)] = slope
        rows.append({"jaren": years, "variantieschatter": name,
                     "gem. gamma": slope.mean(), "SD gamma": slope.std(),
                     "RMSE": np.sqrt(np.mean((slope - GAMMA_TRUE) ** 2)),
                     "fractie t > 1.96": (tval > 1.96).mean()})
sim_table = pd.DataFrame(rows).set_index(["jaren", "variantieschatter"]).round(3)
sim_table.loc[[73, 150]]De tabel toont 73 jaar, de lengte van de steekproef 1928–2000 in het artikel, en 150 jaar. Links in de figuur staat de verdeling van tegenover de ware 2,5, en rechts de kans op een significante per steekproeflengte.
Source
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
bins = np.linspace(-4, 9, 60)
for name in ["ware variantie", "RV vorige maand (FSS)", "MIDAS-achtig, halfwaarde 66 d"]:
    axes[0].hist(gamma_hat[(73, name)], bins=bins, alpha=0.5, label=name)
axes[0].axvline(GAMMA_TRUE, color="black", lw=1)
axes[0].set_title("(a) Verdeling van de geschatte gamma, 73 jaar")
axes[0].set_xlabel("Geschatte gamma")
axes[0].set_ylabel("Aantal steekproeven")
axes[0].legend()
power = sim_table["fractie t > 1.96"].unstack()
for name in V_sim:
    axes[1].plot(sample_lengths, power[name].loc[list(sample_lengths)], marker="o", label=name)
axes[1].set_title("(b) Kans op een significante gamma")
axes[1].set_xlabel("Lengte van de steekproef (jaren)")
axes[1].set_ylabel("Fractie met t > 1,96")
axes[1].legend()
fig.tight_layout()
plt.show()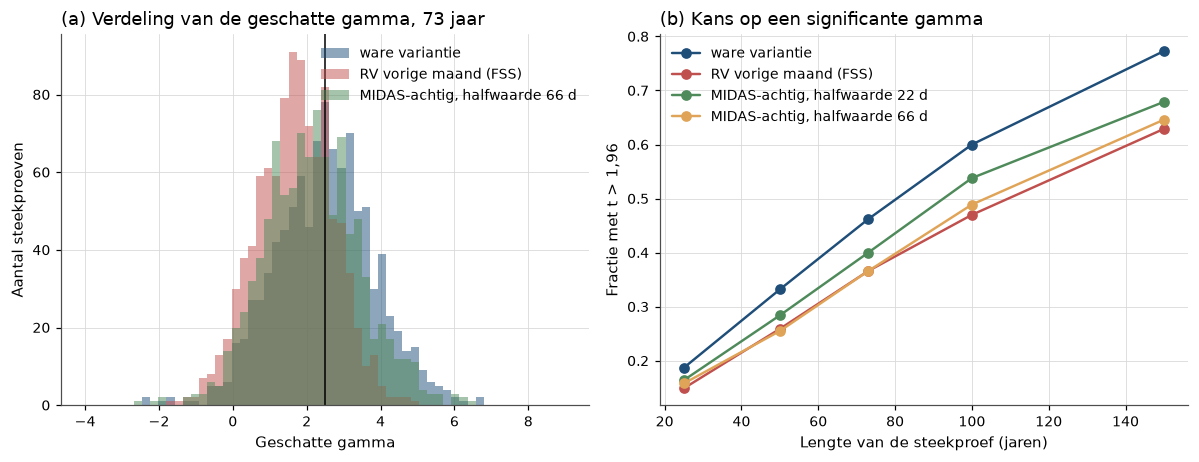
Figure 2:Links ligt met de variantie van één maand duidelijk onder de ware 2,5, en met langere gewichten schuift de verdeling op. Rechts is de kans op een significante na 73 jaar zelfs met de ware variantie kleiner dan een muntworp.
Met de gerealiseerde variantie van de vorige maand komt de gemiddelde na 73 jaar uit op 1,7 in plaats van 2,5, zoals de meetfout uit Proposition 2 voorspelt. De twee MIDAS-achtige schatters komen dichter bij de ware waarde, op 2,0 en 2,2.
Een zuiverder schatter heeft echter niet meer onderscheidend vermogen. De langere gewichten hebben een grotere spreiding, zodat de RMSE voor alle vier ongeveer 1,3 is. Ook de kans op verschilt tussen de haalbare schatters maar enkele procentpunten. MIDAS wint dus in de grootte van en niet in de -waarde.
Zelfs met de ware variantie is na 73 jaar in minder dan de helft van de steekproeven significant en pas na 150 jaar in ruim driekwart. Dat is later dan de bijna zestig jaar van de vuistregel, omdat de spreiding van de ware variantie uit een paar maanden met extreme waarden komt, die de gewogen schatter met juist weinig gewicht geeft. Voor de van 6,7 die het artikel in 73 jaar vond, moet de variantie ongeveer drie keer zo sterk schommelen. Echte data hebben die spreiding wel, maar ze komt uit een handvol episodes, zoals 1929–1933, oktober 1987, 2008 en 2020, zodat de schatting afhangt van die paar maanden.
6Replicatie op echte data
6.1GARCH en GJR-GARCH op een eeuw dagrendementen
De eerste cel schat beide modellen en zet de parameters, de persistentie en de halfwaardetijd naast elkaar.
market = hap_data.market_daily()
excess_pct = 100 * market["Mkt-RF"].dropna()

fits = {
    "GARCH(1,1)": arch_model(excess_pct, mean="Constant", vol="GARCH", p=1, q=1).fit(disp="off"),
    "GJR-GARCH(1,1)": arch_model(excess_pct, mean="Constant", vol="GARCH", p=1, o=1, q=1).fit(disp="off"),
}

rows = {}
for name, res in fits.items():
    p, tv = res.params, res.tvalues
    persistence = p["alpha[1]"] + p["beta[1]"] + 0.5 * p.get("gamma[1]", 0.0)
    rows[name] = {
        "mu": p["mu"], "omega": p["omega"], "alpha": p["alpha[1]"],
        "delta (asymmetrie)": p.get("gamma[1]", np.nan), "t(delta)": tv.get("gamma[1]", np.nan),
        "beta": p["beta[1]"], "persistentie": persistence,
        "halfwaardetijd (dagen)": np.log(0.5) / np.log(persistence),
        "log-likelihood": res.loglikelihood,
    }
pd.DataFrame(rows).T.round(4)Beide modellen vinden een persistentie dicht bij één. De tabel hieronder zet de kernresultaten naast wat het origineel liet verwachten.
| grootheid | origineel | GARCH | GJR |
|---|---|---|---|
| persistentie | tussen 0,97 en 1 | 0,989 | 0,983 |
| halfwaardetijd (dagen) | weken tot maanden | 61 | 41 |
| asymmetrie (-waarde) | positief, vele standaardfouten | – | 0,113 (9,8) |
| symmetrische | in GJR veel kleiner | 0,105 | 0,036 |
Geslaagd, want beide kernresultaten uit de verwachte afwijking komen terug, met een persistentie tussen 0,97 en 1 en een bijna tien standaardfouten boven nul. Een daling telt in GJR met en een stijging met 0,036, zodat een daling de variantie van morgen ruim vier keer zoveel verhoogt. De tweede cel zoomt in op de week rond 19 oktober 1987.
crash = pd.DataFrame({
    "rendement (%)": excess_pct.loc["1987-10-14":"1987-10-23"],
    **{f"vol {name} (%/dag)": res.conditional_volatility.loc["1987-10-14":"1987-10-23"]
       for name, res in fits.items()},
})
crash["z-score GJR"] = fits["GJR-GARCH(1,1)"].std_resid.loc["1987-10-14":"1987-10-23"]
print("hoogste conditionele volatiliteit:",
      {name: f"{res.conditional_volatility.max():.2f}% op {res.conditional_volatility.idxmax().date()}"
       for name, res in fits.items()})
crash.round(2)
hoogste conditionele volatiliteit: {'GARCH(1,1)': '6.49% op 1929-11-07', 'GJR-GARCH(1,1)': '7.14% op 1987-10-20'}
Op de ochtend van 19 oktober 1987 voorspelden GARCH en GJR een dagvolatiliteit van 2,1% en 2,4%, verhoogd na een slechte week maar niet uitzonderlijk. Die dag was het overrendement .
In GJR is dat een gestandaardiseerde schok van , en onder een normale verdeling komt zo’n schok eens in tien miljard jaar voor (oefening 3). Een dag later voorspelde GJR 7,1% per dag, de hoogste waarde van de eeuw. Het onderste paneel van de figuur laat zien op welke dag de voorspellingen omhoogspringen.
Source
gjr_vol = fits["GJR-GARCH(1,1)"].conditional_volatility * np.sqrt(252)
monthly_max = gjr_vol.resample("ME").max()
zoom = slice("1987-08-01", "1987-12-31")

fig, axes = plt.subplots(2, 1, figsize=(10, 7))
axes[0].plot(monthly_max.index, monthly_max, lw=0.9)
axes[0].set_yscale("log")
axes[0].set_title("Conditionele volatiliteit uit GJR-GARCH, hoogste waarde per maand, 1926–2026")
axes[0].set_xlabel("Jaar")
axes[0].set_ylabel("Volatiliteit (% per jaar, log-schaal)")
axes[1].bar(excess_pct.loc[zoom].index, excess_pct.loc[zoom].abs(), width=1.0,
            color=hap.plotting.COLORS[7], label="|overrendement| (%)")
for name, res in fits.items():
    axes[1].plot(res.conditional_volatility.loc[zoom].index, res.conditional_volatility.loc[zoom],
                 lw=1.5, label=f"conditionele volatiliteit, {name} (%/dag)")
axes[1].set_title("Rond de crash van 19 oktober 1987")
axes[1].set_xlabel("Datum")
axes[1].set_ylabel("Procent per dag")
axes[1].legend()
fig.tight_layout()
plt.show()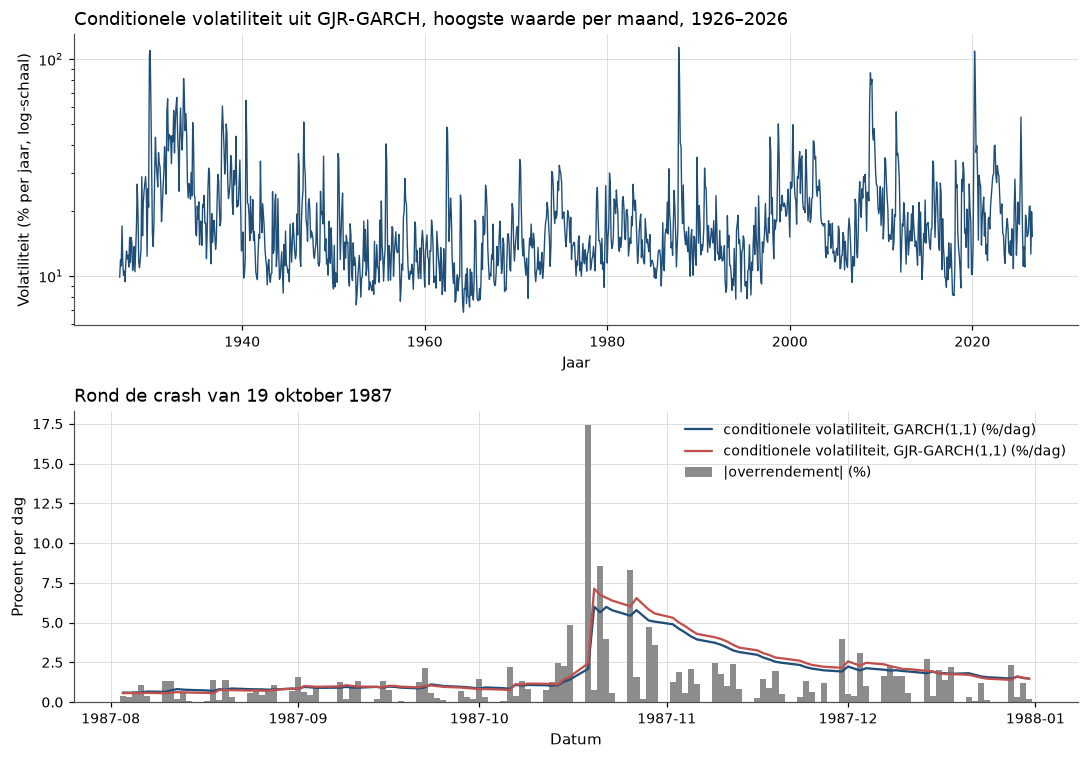
Figure 3:Boven klontert de volatiliteit in episodes, zoals de jaren dertig, 1987, 2008 en 2020, en zakt ze daarna telkens terug. Onder springt de voorspelling pas na de crash in één dag van ongeveer 2% naar 6 à 7%, zodat het model wel reageert maar niet voorziet.
GARCH en GJR zijn daarmee uitstekende modellen voor de tweede dag van een crisis. Voor de eerste dag zijn ze blind, omdat ze alleen het verleden kennen.
6.2HAR-RV tegen GARCH
De eerste cel bouwt de maandvariantie en schat HAR-RV maand voor maand op een uitdijend venster.
daily_ex = market["Mkt-RF"].dropna()
rv = (daily_ex**2).groupby(daily_ex.index.to_period("M")).sum()
rv.index = rv.index.to_timestamp(how="end").normalize()

har = pd.DataFrame({"y": rv.shift(-1), "m1": rv, "m3": rv.rolling(3).mean(),
                    "m12": rv.rolling(12).mean()}).dropna()
SPLIT = pd.Timestamp("1969-12-31")
har_design = sm.add_constant(har[["m1", "m3", "m12"]]).to_numpy()
har_forecast = {}
for position in np.flatnonzero(har.index >= SPLIT):
    coef = np.linalg.lstsq(har_design[:position], har["y"].to_numpy()[:position], rcond=None)[0]
    har_forecast[har.index[position]] = har_design[position] @ coef
har_forecast = pd.Series(har_forecast)

full_har = sm.OLS(har["y"], sm.add_constant(har[["m1", "m3", "m12"]])).fit()
print("HAR-coefficienten, volledige steekproef:", full_har.params.round(3).to_dict(),
      f" R2 = {full_har.rsquared:.3f}")
HAR-coefficienten, volledige steekproef: {'const': 0.001, 'm1': 0.404, 'm3': 0.026, 'm12': 0.356} R2 = 0.337
Het meeste gewicht rust op de vorige maand en op het jaargemiddelde. De tweede cel maakt de GARCH-voorspellingen voor de komende 22 handelsdagen en vergelijkt alle voorspellingen met de gerealiseerde variantie.
forecasts = {"HAR-RV": har_forecast, "RV vorige maand": har.loc[SPLIT:, "m1"]}
for name, kw in (("GARCH(1,1)", dict(p=1, q=1)), ("GJR-GARCH(1,1)", dict(p=1, o=1, q=1))):
    model = arch_model(excess_pct, mean="Constant", vol="GARCH", **kw)
    res = model.fit(last_obs=SPLIT, disp="off")                     # parameters from data up to 1969
    path = res.forecast(horizon=22, start=pd.Timestamp("1969-12-01"), reindex=False)
    month_var = path.variance.sum(axis=1) / 1e4                     # next 22 days, back to decimals
    month_var = month_var.groupby(month_var.index.to_period("M")).last()
    month_var.index = month_var.index.to_timestamp(how="end").normalize()
    forecasts[name] = month_var.loc[SPLIT:]

target = har.loc[SPLIT:, "y"]
prevailing = har["y"].expanding().mean().shift(1).loc[SPLIT:]
evaluation = {}
for name, f in forecasts.items():
    f = f.reindex(target.index)
    evaluation[name] = {
        "R2 (niveaus)": sm.OLS(target, sm.add_constant(f)).fit().rsquared,
        "R2 (logs)": sm.OLS(np.log(target), sm.add_constant(np.log(f))).fit().rsquared,
        "OOS R2 t.o.v. hist. gemiddelde": 1 - ((target - f) ** 2).sum() / ((target - prevailing) ** 2).sum(),
    }
print(f"{target.index[0]:%Y-%m} t/m {target.index[-1]:%Y-%m}: {len(target)} maanden")
pd.DataFrame(evaluation).T.round(3)
1969-12 t/m 2026-06: 679 maanden
Gedeeltelijk geslaagd, want buiten de steekproef, over 1970–2026, verklaren de voorspellingen zoals verwacht 16 tot 24% van de variatie in het niveau van de volgende maandvariantie en 41 tot 48% in de logaritme. Anders dan verwacht haalt “vorige maand” zowel voor het niveau als voor de logaritme een iets hogere dan HAR-RV. Wel verliest die voorspelling als enige van het historische gemiddelde, omdat ze na elke piek overschiet zonder het terugzakken uit Theorem 1.
GJR-GARCH is in alle drie de maten het best. Dat HAR-RV hier niet wint, weerlegt Corsi niet, want zijn voordeel zit in intradagdata, en 21 dagrendementen per maand zijn daarvoor te grof. Bij de pieken in de figuur is te zien hoe ver beide voorspellingen achter de grijze lijn blijven.
Source
fig, ax = plt.subplots(figsize=(10, 4.5))
ax.plot(target.index, np.sqrt(12 * target) * 100, color=hap.plotting.COLORS[7], lw=0.8,
        label="gerealiseerde volatiliteit")
ax.plot(target.index, np.sqrt(12 * forecasts["HAR-RV"].reindex(target.index)) * 100, lw=1.1,
        label="HAR-RV-voorspelling")
ax.plot(target.index, np.sqrt(12 * forecasts["GJR-GARCH(1,1)"].reindex(target.index)) * 100, lw=1.1,
        label="GJR-GARCH-voorspelling")
ax.set_yscale("log")
ax.set_title("Maandelijkse gerealiseerde volatiliteit en twee voorspellingen, 1970–2026")
ax.set_xlabel("Jaar")
ax.set_ylabel("Volatiliteit (% per jaar, log-schaal)")
ax.legend()
plt.show()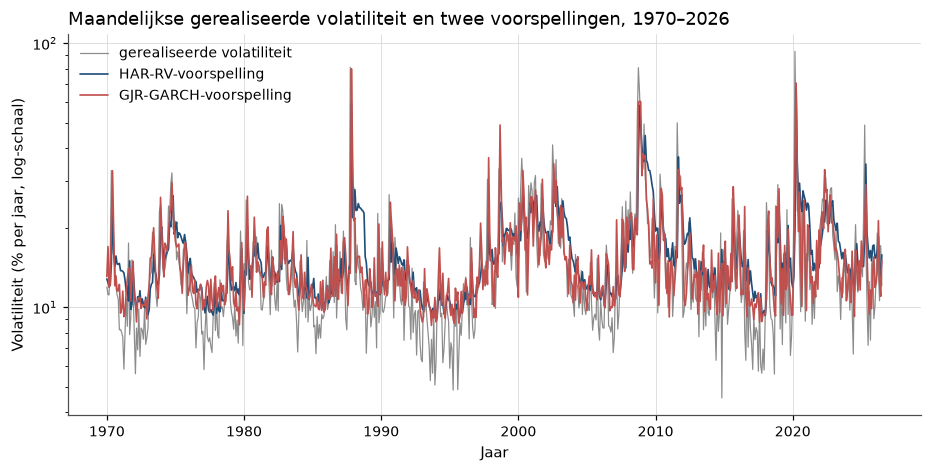
Figure 4:Beide voorspellingen volgen het niveau van de volatiliteit over decennia en lopen bij elke piek één maand achter. Op een lineaire schaal zouden 1987, 2008 en 2020 alles domineren.
In Voorspelbaarheid van rendementen was een van een paar procent op het maandrendement al een prestatie, terwijl het hier met parameters uit 1969 om tientallen procenten gaat. Zo staat de stelling van Santa-Clara in één tabel.
6.3Ghysels, Santa-Clara en Valkanov: is er een risico-rendementsrelatie?
De eerste cel zet voor elk maandeinde de gekwadrateerde dagrendementen van het afgelopen jaar in één rij, naast het overrendement van de volgende maand.
LAGS, DAYS_PER_MONTH = 252, 22
monthly_ex = hap_data.market_monthly()["Mkt-RF"].dropna()

position = pd.Series(np.arange(len(daily_ex)), index=daily_ex.index)
month_end = position.groupby(daily_ex.index.to_period("M")).max()
month_end.index = month_end.index.to_timestamp(how="end").normalize()
month_end = month_end[month_end >= LAGS - 1]
squared = daily_ex.to_numpy() ** 2
lagged_sq = pd.DataFrame(np.stack([squared[p - np.arange(LAGS)] for p in month_end.to_numpy()]),
                         index=month_end.index)          # row t: r^2 at lags 0..251 up to month end t
next_return = monthly_ex.shift(-1).reindex(lagged_sq.index)   # R^e_{t+1}


def sample(first, last, drop=()):
    """R_{t+1} and lagged squares for return months first..last, minus (start, end) ranges in drop."""
    ret_month = lagged_sq.index + pd.offsets.MonthEnd(1)
    keep = (ret_month >= pd.Timestamp(first)) & (ret_month <= pd.Timestamp(last)) & next_return.notna()
    for a, b in drop:
        keep &= ~((ret_month >= pd.Timestamp(a)) & (ret_month <= pd.Timestamp(b)))
    return next_return[keep].to_numpy(), lagged_sq[keep].to_numpy()
De functie sample knipt daaruit elke periode, eventueel zonder een paar crisismaanden.
De tweede cel definieert de gewichten en de QML-schatter van (12) met
Bollerslev-Wooldridge-standaardfouten.
def beta_weights(theta1, theta2, n_lags=LAGS):
    """Normalised Beta lag polynomial w_d for d = 0..n_lags-1."""
    x = np.arange(1, n_lags + 1) / (n_lags + 1)
    log_w = (theta1 - 1) * np.log(x) + (theta2 - 1) * np.log1p(-x)
    w = np.exp(log_w - log_w.max())
    return w / w.sum()


def almon_weights(kappa1, kappa2, n_lags=LAGS):
    """Exponential Almon weights exp(k1 d + k2 d^2), normalised."""
    d = np.arange(n_lags)
    log_w = kappa1 * d + kappa2 * d**2
    w = np.exp(log_w - log_w.max())
    return w / w.sum()


def risk_return_qml(R, variance_of, x0):
    """QML fit of R_{t+1} ~ N(mu + gamma V_t, V_t) with Bollerslev-Wooldridge standard errors.

    theta = (mu, gamma, *extra); variance_of(extra) returns the variance series V_t.
    """  # TODO: naar hap.stats
    def nll_obs(theta):
        V = variance_of(theta[2:])
        return 0.5 * (np.log(2 * np.pi) + np.log(V) + (R - theta[0] - theta[1] * V) ** 2 / V)

    def objective(theta):
        return nll_obs(theta).sum()

    start = optimize.minimize(objective, x0, method="Nelder-Mead",
                              options={"maxiter": 20_000, "xatol": 1e-8, "fatol": 1e-10})
    theta = optimize.minimize(objective, start.x, method="BFGS").x
    k = len(theta)
    step = 1e-5 * np.maximum(np.abs(theta), 1e-2)
    unit = np.eye(k) * step
    scores = np.column_stack([(nll_obs(theta + unit[i]) - nll_obs(theta - unit[i])) / (2 * step[i])
                              for i in range(k)])
    hessian = np.array([[(objective(theta + unit[i] + unit[j]) - objective(theta + unit[i] - unit[j])
                          - objective(theta - unit[i] + unit[j]) + objective(theta - unit[i] - unit[j]))
                         / (4 * step[i] * step[j]) for j in range(k)] for i in range(k)])
    h_inv = np.linalg.inv(hessian)
    se = np.sqrt(np.diag(h_inv @ scores.T @ scores @ h_inv))
    return theta, se, -objective(theta)
Dezelfde schatter werkt op elke variantiereeks, dus ook op rollende vensters. De derde cel schat met Beta-gewichten op de steekproeven van het artikel en tot 2026.
published = {"1928-2000": (2.606, 6.710), "1928-1963": (1.547, 3.382),
             "1964-2000": (3.748, 8.612), "1928-2026": (np.nan, np.nan)}
periods = {"1928-2000": ("1928-01-31", "2000-12-31"), "1928-1963": ("1928-01-31", "1963-12-31"),
           "1964-2000": ("1964-01-31", "2000-12-31"), "1928-2026": ("1928-01-31", "2026-12-31")}

midas_rows, midas_weights = {}, {}
for label, (first, last) in periods.items():
    R, X = sample(first, last)
    theta, se, _ = risk_return_qml(
        R, lambda e: DAYS_PER_MONTH * X @ beta_weights(np.exp(e[0]), np.exp(e[1])),
        np.array([0.005, 2.0, 0.0, np.log(5.0)]))
    midas_weights[label] = beta_weights(np.exp(theta[2]), np.exp(theta[3]))
    midas_rows[label] = {"maanden": len(R), "gamma (Beta)": theta[1], "t": theta[1] / se[1],
                         "gewicht 1e maand": midas_weights[label][:22].sum(),
                         "gamma GSV": published[label][0], "t GSV": published[label][1]}
pd.DataFrame(midas_rows).T.round(3)Over 1928–2000 is de MIDAS- op de French-data 0,19 met , tegen 2,606 met in het artikel. De vierde cel schat de rollende vensters van tabel 4 en de regressie met de gepubliceerde gewichten, met en zonder de Grote Depressie.
R, X = sample("1928-01-31", "2000-12-31")
gsv_table4 = {1: (0.546, 0.441), 2: (1.494, 1.532), 3: (2.171, 1.945), 4: (2.149, 2.212), 6: (1.483, 1.316)}
rolling_rows = {}
for months, (g_pub, t_pub) in gsv_table4.items():
    V_rw = DAYS_PER_MONTH * X[:, : DAYS_PER_MONTH * months].mean(axis=1)
    theta, se, _ = risk_return_qml(R, lambda e: V_rw, np.array([0.005, 1.0]))
    rolling_rows[f"rollend, {months} maand(en)"] = {"gamma": theta[1], "t": theta[1] / se[1],
                                                    "gamma GSV": g_pub, "t GSV": t_pub}

w_gsv = almon_weights(-5.141e-3, -10.580e-5)
for label, drop in (("MIDAS, gewichten GSV vast", ()),
                    ("idem, zonder 1929-09 t/m 1933-06", (("1929-09-30", "1933-06-30"),))):
    R_d, X_d = sample("1928-01-31", "2000-12-31", drop)
    V_gsv = DAYS_PER_MONTH * X_d @ w_gsv
    theta, se, _ = risk_return_qml(R_d, lambda e: V_gsv, np.array([0.005, 1.0]))
    rolling_rows[label] = {"gamma": theta[1], "t": theta[1] / se[1],
                           "gamma GSV": 2.606 if not drop else np.nan, "t GSV": 6.710 if not drop else np.nan}
print(f"gewicht op de eerste 22 dagen met de GSV-gewichten: {w_gsv[:22].sum():.3f}")
pd.DataFrame(rolling_rows).T.round(3)
gewicht op de eerste 22 dagen met de GSV-gewichten: 0.307
Niet geslaagd, want over 1928–2000 klopt alleen het teken van en niet de grootte of de significantie, ook niet met hun eigen gewichten. De rollende vensters geven zoals verwacht een kleinere voor één maand dan voor langere vensters, maar geen enkele -waarde komt boven één, zodat de rangorde er maar zwak is.
In 1964–2000 ligt de schatting dichter bij het artikel maar blijft ze insignificant, en in 1928–1963 is negatief. Hoe steiler een lijn in de figuur begint, hoe meer gewicht de recente maanden krijgen.
Source
lag_axis = np.arange(1, LAGS + 1)
fig, ax = plt.subplots(figsize=(9, 4.5))
ax.plot(lag_axis, np.cumsum(w_gsv), color="black", lw=1.6, label="GSV, gepubliceerde gewichten (1928–2000)")
ax.plot(lag_axis, np.cumsum(midas_weights["1928-2000"]), lw=1.4, label="Beta, French-data (1928–2000)")
ax.plot(lag_axis, np.cumsum(midas_weights["1964-2000"]), lw=1.4, ls="--", label="Beta, French-data (1964–2000)")
ax.plot(lag_axis, lag_axis / LAGS, color="grey", lw=0.8, ls=":", label="gelijke gewichten")
ax.set_title("Cumulatief MIDAS-gewicht op de gekwadrateerde dagrendementen")
ax.set_xlabel("Lag (handelsdagen)")
ax.set_ylabel("Cumulatief gewicht")
ax.legend()
plt.show()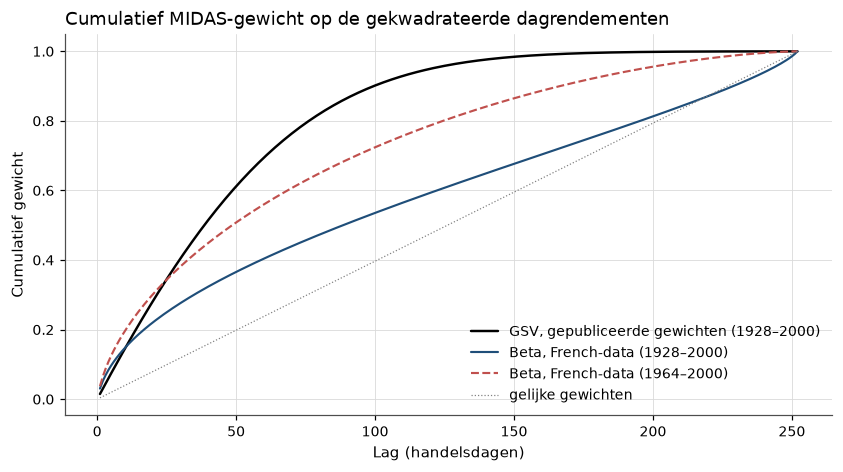
Figure 5:De gepubliceerde gewichten leggen een derde op de eerste maand en driekwart op de eerste drie à vier maanden. Op de French-data kiest de likelihood over 1928–2000 een ander profiel, terwijl dat over 1964–2000 meer op het gepubliceerde lijkt.
Het verschil zit dus niet in de schatter, want met hun gewichten blijft het bestaan, maar in de jaren dertig. Zonder september 1929 tot en met juni 1933 stijgt met dezelfde gewichten naar 1,97 (). Een handvol maanden met extreme variantie bepaalt de hele schatting, en juist in die jaren verschillen onze dagdata het meest van de hunne. Ghysels, Plazzi en Valkanov concludeerden later dat de relatie van Merton standhoudt in steekproeven zonder financiële crises Ghysels et al. (2016).
7Wat er brak, en wat daarna kwam
Wat het model verklaart. GARCH verklaart met drie parameters dat rendementen geen geheugen hebben, hun kwadraten een lang geheugen en de verdeling dikke staarten. Met parameters uit 1969 verklaren de voorspellingen tot 2026 bijna de helft van de variatie in de logaritme van de maandvariantie. Gerealiseerde variantie maakte de variantie meetbaar en de VIX maakte de verwachting ervan verhandelbaar. Mertons wiskunde in Rendementen en hun statistiek liet al zien dat de variantie scherper te meten is dan het gemiddelde. Dat de variantie ook voorspelbaar is en rendementen nauwelijks, is een feit, en in de tegenstelling theorie of feit is GARCH de beschrijving ervan, geen getoetste theorie.
Waar het breekt. Het model schiet twee keer tekort, en beide keren door een handvol extreme dagen of maanden. Op 19 oktober 1987 voorspelde GJR-GARCH een dagvolatiliteit van 2,4% en kwam er , omdat volatiliteitsmodellen van de vorige crisis leren en niet van de volgende. Voor de beloning voor risico geeft MIDAS op de French-data over 1928–2000 , en de uitkomst hangt af van de jaren dertig. Zelfs met de ware variantie is pas na meer dan zeventig jaar vaker wel dan niet significant. Het tweede moment is uitstekend te meten, maar zijn prijs, die in het eerste moment zit, niet.
Risico of vergissing? De Chicago-lezing ziet volatiliteit als risico met een premie. Een schok die de verwachte volatiliteit verhoogt, verhoogt de discontovoet en verlaagt de prijs vandaag. Die lezing verklaart de asymmetrie in GJR en de variance risk premium uit Black-Scholes-Merton en de CBOE. De Yale-lezing ziet in 1987 portefeuilleverzekeraars die mechanisch verkochten en beleggers die zich in paniek vergisten, zodat een koper na een volatiliteitspiek de correctie van een overreactie oogst. De twee lezingen zijn alleen te scheiden met het verwachte rendement in precies de toestanden waarin de variantie extreem is, en die komen in een eeuw maar vier of vijf keer voor.
Wat er daarna kwam. Een voorspelbare volatiliteit met dikke staarten is precies wat een risicomanager nodig heeft. Ze werd het fundament van Value-at-Risk en van de rekensommen die LTCM in 1998 niet overleefde, in VaR, RiskMetrics en LTCM.
8Oefeningen
Solution to Exercise 1
(1) Na een daling is en na een stijging , met als gemiddelde precies 1,5596. (2) De persistentie is , zodat ook het langetermijnniveau is. De code rekent het na.
def gjr_update(h, r, omega=0.05, alpha=0.05, delta=0.10, beta=0.80):
    """One GJR-GARCH(1,1) variance update: h_{t+1} from h_t and r_t."""
    return omega + (alpha + delta * (r < 0)) * r**2 + beta * h


h_4 = 0.762
pd.DataFrame({"met de hand": [2.0096, 1.1096, 1.5596],
              "code": [gjr_update(h_4, -3.0), gjr_update(h_4, 3.0), 0.05 + 0.10 * 9 + 0.80 * h_4]},
index=["GJR, r_4 = -3", "GJR, r_4 = +3", "GARCH (toy-voorbeeld)"]).round(4)De tabel bevestigt de handberekening. De symmetrische GARCH middelt dus de reacties op een daling en een stijging, zodat ze de variantie na een daling onderschat en na een stijging overschat.
:::{exercise}
:label: ex-volatiliteit-2

**Momenten van GARCH(1,1).** Neem [](#eq-volatiliteit-garch) met normale $z$ en
$\phi = \alpha + \beta < 1$. De vragen gaan over onvoorwaardelijke momenten.

1. Laat zien dat, als het vierde moment eindig is, de kurtosis van $\varepsilon$ gelijk is
   aan $\kappa = 3(1-\phi^2)/(1-\phi^2-2\alpha^2)$. Wanneer is het vierde moment eindig?
2. Leid uit [](#eq-volatiliteit-arma) af dat de autocorrelatie van $\varepsilon^2$ bij lag
   1 gelijk is aan $\rho_1 = \alpha(1-\alpha\beta-\beta^2)/(1-2\alpha\beta-\beta^2)$ en bij
   lag $k$ aan $\rho_1\phi^{k-1}$.
3. Controleer beide met een simulatie voor $\alpha = 0{,}05$ en $\beta = 0{,}90$.
Solution to ex-volatiliteit-2
(1) Kwadrateer (2) en neem verwachtingen, met . Omdat en , is , en dat vraagt . De kurtosis is , en die is groter dan 3.
(2) volgt , een ARMA(1,1). Voor zo’n proces is en , en met staat de formule er.
(3) De simulatie trekt 400 paden van 10.000 dagen.
a1, b1, n_paths, n_obs = 0.05, 0.90, 400, 10_000
phi1 = a1 + b1
h1 = np.full(n_paths, 1.0)
eps = np.empty((n_obs, n_paths))
for t in range(n_obs):
    eps[t] = np.sqrt(h1) * rng.standard_normal(n_paths)
    h1 = (1 - phi1) + a1 * eps[t] ** 2 + b1 * h1

pooled = eps.ravel()
kurt_theory = 3 * (1 - phi1**2) / (1 - phi1**2 - 2 * a1**2)
rho1_theory = a1 * (1 - a1 * b1 - b1**2) / (1 - 2 * a1 * b1 - b1**2)
pd.DataFrame(
    {"theorie": [kurt_theory, rho1_theory, rho1_theory * phi1**4],
     "simulatie": [np.mean(pooled**4) / np.mean(pooled**2) ** 2,
                   acf_paths(eps**2, [1])[0], acf_paths(eps**2, [5])[0]]},
    index=["kurtosis", "rho_1 van eps^2", "rho_5 van eps^2"],
).round(3)Met klopt de simulatie, terwijl die som in de simulatie van het college 0,98 is en de steekproefautocorrelatie daar traag convergeert. GARCH maakt dus dikke staarten uit normale schokken, en met realistische parameters ligt het model vlak bij de grens waar momenten ophouden te bestaan.
:::{exercise}
:label: ex-volatiliteit-3

**Hoe onmogelijk was 19 oktober 1987?** Schat GJR-GARCH(1,1) op de French-data opnieuw, nu
met Student-$t$-schokken (`dist="t"`). Vergelijk de log-likelihood en bereken voor beide
verdelingen het verwachte aantal jaren tussen dagen zoals 19 oktober 1987.
Solution to ex-volatiliteit-3
De cel schat het model opnieuw en zet beide verdelingen naast elkaar.
gjr_t = arch_model(excess_pct, mean="Constant", vol="GARCH", p=1, o=1, q=1, dist="t").fit(disp="off")
crash_day = pd.Timestamp("1987-10-19")
comparison = {}
for name, res in (("normaal", fits["GJR-GARCH(1,1)"]), ("Student-t", gjr_t)):
    z_crash = res.std_resid.loc[crash_day]
    if name == "normaal":
        prob = stats.norm.cdf(z_crash)
    else:
        nu = res.params["nu"]
        prob = stats.t.cdf(z_crash * np.sqrt(nu / (nu - 2)), nu)
    comparison[name] = {"log-likelihood": res.loglikelihood, "alpha": res.params["alpha[1]"],
                        "delta": res.params["gamma[1]"], "beta": res.params["beta[1]"],
                        "nu": res.params.get("nu", np.inf), "z op 19-10-1987": z_crash,
                        "kans": prob, "jaren tussen zulke dagen": 1 / (252 * prob)}
pd.DataFrame(comparison).TMet Student--schokken, die ongeveer zes vrijheidsgraden krijgen, stijgt de log-likelihood met ruim achthonderd punten. De kans op de schok van 19 oktober verschuift van eens in tien miljard jaar naar ruwweg eens in een halve eeuw. GARCH vangt dus de klontering, terwijl de staart van de verdeling een aparte keuze is, en in VaR, RiskMetrics en LTCM is juist die keuze van belang.
:::{exercise}
:label: ex-volatiliteit-4

**French, Schwert en Stambaugh terug, en zonder crises.** Ghysels, Santa-Clara en Valkanov
vonden met de schatter van French, Schwert en Stambaugh, de variantie van de vorige maand,
over 1928–1984 zelfs $\gamma = -0{,}349$, terwijl die auteurs zelf een positief verband
rapporteerden.

1. Schat met `risk_return_qml` de rollende vensters van één en vier maanden over 1928–1984.
   Komt het teken terug?
2. Schat de MIDAS-versie over 1952–2026, met en zonder september 2008 tot en met juni 2009
   en maart 2020. Wat doet het weglaten van elf maanden met $\gamma$?
Solution to ex-volatiliteit-4
De cel gebruikt sample en risk_return_qml uit de replicatie.
results = {}
R, X = sample("1928-01-31", "1984-12-31")
for months in (1, 4):
    V_rw = DAYS_PER_MONTH * X[:, : DAYS_PER_MONTH * months].mean(axis=1)
    theta, se, _ = risk_return_qml(R, lambda e: V_rw, np.array([0.005, 1.0]))
    results[f"1928-1984, rollend {months} maand(en)"] = {"gamma": theta[1], "t": theta[1] / se[1], "maanden": len(R)}

crises = (("2008-09-30", "2009-06-30"), ("2020-03-31", "2020-03-31"))
for label, drop in (("1952-2026, MIDAS", ()), ("1952-2026, MIDAS zonder 2008-09 en 2020-03", crises)):
    R, X = sample("1952-01-31", "2026-12-31", drop)
    theta, se, _ = risk_return_qml(
        R, lambda e: DAYS_PER_MONTH * X @ beta_weights(np.exp(e[0]), np.exp(e[1])),
        np.array([0.005, 2.0, 0.0, np.log(5.0)]))
    results[label] = {"gamma": theta[1], "t": theta[1] / se[1], "maanden": len(R)}
pd.DataFrame(results).T.round(3)Over 1928–1984 geeft één maand en vier maanden 0,64, zodat het teken niet terugkomt en de insignificantie wel. Over 1952–2026 is de MIDAS- ongeveer 1,3, en zonder elf crisismaanden stijgt ze naar ongeveer 2,1 met . De geschatte prijs van variantierisico hangt dus af van welke extreme maanden in de steekproef zitten.
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Engle, R. F. (1982). Autoregressive Conditional Heteroscedasticity with Estimates of the Variance of United Kingdom Inflation. Econometrica, 50(4), 987–1007. 10.2307/1912773
- Bollerslev, T. (1986). Generalized Autoregressive Conditional Heteroskedasticity. Journal of Econometrics, 31(3), 307–327. 10.1016/0304-4076(86)90063-1
- Andersen, T. G., Bollerslev, T., Diebold, F. X., & Labys, P. (2001). The Distribution of Realized Exchange Rate Volatility. Journal of the American Statistical Association, 96(453), 42–55. 10.1198/016214501750332965
- Andersen, T. G., Bollerslev, T., Diebold, F. X., & Labys, P. (2003). Modeling and Forecasting Realized Volatility. Econometrica, 71(2), 579–625. 10.1111/1468-0262.00418
- French, K. R., Schwert, G. W., & Stambaugh, R. F. (1987). Expected Stock Returns and Volatility. Journal of Financial Economics, 19(1), 3–29. 10.1016/0304-405X(87)90026-2
- Glosten, L. R., Jagannathan, R., & Runkle, D. E. (1993). On the Relation between the Expected Value and the Volatility of the Nominal Excess Return on Stocks. The Journal of Finance, 48(5), 1779–1801. 10.1111/j.1540-6261.1993.tb05128.x
- Ghysels, E., Santa-Clara, P., & Valkanov, R. (2005). There Is a Risk-Return Trade-off After All. Journal of Financial Economics, 76(3), 509–548. 10.1016/j.jfineco.2004.03.008
- Mandelbrot, B. (1963). The Variation of Certain Speculative Prices. The Journal of Business, 36(4), 394–419. 10.1086/294632
- Fama, E. F. (1965). The Behavior of Stock-Market Prices. The Journal of Business, 38(1), 34–105. 10.1086/294743
- Black, F. (1976). Studies of Stock Price Volatility Changes. Proceedings of the 1976 Meetings of the American Statistical Association, Business and Economic Statistics Section, 177–181.
- Rubinstein, M., & Leland, H. E. (1981). Replicating Options with Positions in Stock and Cash. Financial Analysts Journal, 37(4), 63–72. 10.2469/faj.v37.n4.63
- Bollerslev, T., & Wooldridge, J. M. (1992). Quasi-Maximum Likelihood Estimation and Inference in Dynamic Models with Time-Varying Covariances. Econometric Reviews, 11(2), 143–172. 10.1080/07474939208800229
- Barndorff-Nielsen, O. E., & Shephard, N. (2002). Econometric Analysis of Realized Volatility and Its Use in Estimating Stochastic Volatility Models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 64(2), 253–280. 10.1111/1467-9868.00336
- Corsi, F. (2009). A Simple Approximate Long-Memory Model of Realized Volatility. Journal of Financial Econometrics, 7(2), 174–196. 10.1093/jjfinec/nbp001
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD