

De event study
1Overzicht
Hoe meten we of een prijs nieuws verwerkt vóór of nadat het nieuws bekend wordt? We leggen alle gebeurtenissen op tijd nul, trekken van elk rendement af wat het aandeel normaal zou doen, en middelen de rest. Zo gemeten verwerken prijzen publiek nieuws snel, en grotendeels al vóór de publicatie. In dit college:
leiden we af hoeveel ruis er in een abnormaal rendement zit, inclusief de schattingsfout (de toevallige fout in de geschatte alpha en bèta van het marktmodel);
bouwen we daaruit een toets en een formule voor zijn toetskracht, en zien we dat de toets faalt bij events op dezelfde dag, en over lange horizonnen doordat een modelfout (een verkeerd model voor het normale rendement) zich daar opstapelt;
simuleren we, zoals Brown en Warner, hoe vaak de toets een effect van 1% vindt;
repliceren we de figuur van Fama, Fisher, Jensen en Roll op 102 aandelensplitsingen uit 2004–2025, waarin de koers vóór de ex-datum stijgt en daarna niet meer. Het moment van publicatie zelf meten we daar niet, want dat bewijs komt van Ball en Brown.
Twee artikelen zetten de toon. Ball & Brown (1968) vonden dat 85 tot 90% van de informatie in het jaarcijfer al vóór de publicatie in de koers zat, via snellere kanalen (p. 176). Fama et al. (1969) (FFJR) bouwden bij hun studie van splitsingen het instrument dat sindsdien event study heet, een studie van het koersgedrag in eventtijd, waarin elke gebeurtenis op dag of maand nul ligt, ongeacht de kalenderdatum. Het idee was ouder (MacKinlay (1997) noemt Dolley (1933) als waarschijnlijk eerste studie), maar FFJR voegden de correctie voor de markt en het middelen in eventtijd toe. Daardoor werd de efficiënte-marktheorie toetsbaar op nieuws. De event study is zelf geen theorie die getoetst wordt, maar een meetinstrument dat feiten levert voor de vraag die de hele reeks stelt, theorie of feit. Die feiten zijn altijd afwijkingen van een model.
2Intuïtie: waarom zou dit waar zijn?
Een aandelensplitsing verandert niets. Een bedrijf dat één aandeel van 400 dollar vervangt door vier aandelen van 100 dollar, heeft dezelfde fabrieken, dezelfde winst en dezelfde eigenaren. In een rationele markt verandert de waarde van het bedrijf op de splitsingsdatum dus niet.
Toch is een splitsing niet informatieloos. Bedrijven splitsen vooral nadat de koers flink is gestegen, vaak samen met een hogere dividenduitkering. De aankondiging kan dus iets zeggen, ook al doet ze niets. FFJR zagen daarin een laboratorium, want een splitsing is een gebeurtenis zonder economische inhoud, maar met mogelijke informatie. In een efficiënte markt komt die informatie in de prijs zodra ze bekend wordt, zodat een belegger die het aandeel daarna koopt, er niets bijzonders meer mee verdient.
Om dat te toetsen moeten we eerst weten wat het aandeel zonder het nieuws had gedaan. Stijgt de markt die maand 5% en het aandeel 6%, dan is het nieuws hooguit 1% waard. FFJR schatten daarom over een rustige periode hoe sterk het aandeel met de markt meebeweegt, en dat verband heet het marktmodel. Het werkelijke rendement min wat het marktmodel voorspelt, is het abnormale rendement, en de som daarvan over de dagen rond het event heet het cumulatieve abnormale rendement (CAR).
Eén event zegt weinig, want een aandeel beweegt op een gewone dag 1 à 2% om redenen die niemand kent, en een nieuwsfeit van 1% verdwijnt in die ruis. Daarom middelt een onderzoeker honderd splitsingen, elk op hun eigen dag nul. Omdat de ruis per event onafhankelijk is, krimpt ze in het gemiddelde met de wortel van het aantal events, terwijl het signaal bij elk event op dezelfde dag staat en niet krimpt. Zo vindt een toets een effect van 1% met enkele tientallen events als de dag bekend is, maar niet als het venster weken beslaat.
Dezelfde wortel kennen we uit de standaardfout van 2% in het college over rendementen, waar het gemiddelde rendement bij een volatiliteit van 20% per jaar na honderd jaar data nog op 2 procentpunt onzeker is. Daar werkt de wortel tegen de onderzoeker, hier werkt hij ervoor.
Een premie van 6% per jaar is 0,024% per dag, en tegen een dagelijkse marktruis van 1% geeft dat een verhouding van 0,024 tussen signaal en ruis. Een nieuwsfeit van 1% op een bekende dag staat tegen 2% ruis van één aandeel, zodat de verhouding daar 0,5 is. Die verhouding is ruim twintig keer gunstiger, en daarom zijn er ongeveer vierhonderd keer minder waarnemingen nodig ().
De redenering heeft twee zwakke plekken. De ruis middelt alleen weg als events op verschillende dagen vallen, en het normale rendement komt uit een model dat verkeerd kan zijn. Zo’n modelfout is iets anders dan de toevallige schattingsfout in de bèta, omdat ze niet verdwijnt met meer data. Over drie dagen maakt een kleine modelfout niets uit, maar over drie jaar stapelt ze zich op tot een abnormaal rendement dat er niet is.
Een event study meet ook wanneer een prijs reageert. Met maanddata zagen FFJR alleen dat de reactie binnen een maand lag. Volgens Santa-Clara, die de latere literatuur samenvat, ging de halfwaardetijd van nieuws, de tijd waarin de helft van de prijsreactie binnen is, van dagen in 1969 via uren in 2000 naar seconden nu Santa-Clara (2026). In zijn woorden:
the event-study half-lives that were days in 1969 and hours in 2000 are now seconds for anything in a filing, a transcript or a satellite image.
Een splitsing heeft twee datums, de aankondiging en enkele weken later de ex-datum, de eerste handelsdag waarop het aandeel gesplitst noteert. Omdat het nieuws in de aankondiging zit, verwachten we dat het CAR vóór en rond de aankondiging stijgt, dat het abnormale rendement op de ex-datum nul is en dat het CAR daarna vlak blijft. De replicatie kent alleen de ex-datum, zodat we de stijging daar vóór dag 0 verwachten.
3Toy-voorbeeld: drie aandelen, vijf plus drie dagen
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Drie aandelen, A, B en C, hebben elk een event op dag . We schatten het marktmodel op een schattingsvenster van vijf dagen () en meten abnormale rendementen in een eventvenster van drie dagen (). Alle rendementen staan in procenten.
| -6 | -5 | -4 | -3 | -2 | -1 | 0 | +1 | ||
|---|---|---|---|---|---|---|---|---|---|
| markt | |||||||||
| A | |||||||||
| B | |||||||||
| C |
Op dag 0 daalt de markt 1%, terwijl alle drie de aandelen stijgen, en daar zit dus het event. Hoe groot het is en hoe zeker we dat weten, rekenen we in vijf stappen uit.
Het recept. De variantie van een CAR over dagen is niet , met de restvariantie van het marktmodel, maar
met de lengte van het schattingsvenster. Verder zijn en het gemiddelde van de markt en de kwadratensom rond dat gemiddelde, en is de som van de markt in het eventvenster. De twee extra termen komen van de fout in de geschatte en . Die fout is op elke dag van het eventvenster dezelfde, zodat ze in het CAR keer meetelt en de term van met groeit.
Stap 1: het marktmodel. De markt heeft in het schattingsvenster gemiddelde en . Omdat het gemiddelde nul is, geeft OLS en . Voor A is en .
Stap 2: de restvariantie. De residuen van A zijn , met kwadratensom 1. Gedeeld door geeft dat . Voor alle drie de aandelen ziet de berekening er zo uit:
| aandeel | residuen | |||||
|---|---|---|---|---|---|---|
| A | 10 | |||||
| B | 0 | 5 | 0 | |||
| C | 15 |
Stap 3: abnormale rendementen. Voor A is het abnormale rendement op dag 0 gelijk aan . De tabel geeft ze voor alle drie de aandelen en alle drie de dagen.
| A | ||||
| B | ||||
| C |
Het gemiddelde CAR, het CAAR, is . Of dat meer is dan toeval, hangt af van de ruis in elk CAR, en die volgt uit het recept.
Stap 4: de variantie van een CAR. Met geeft het recept niet 3 maar , en het grootste deel van de extra ruis komt van de fout in (9/5), omdat vijf schattingsdagen weinig zijn tegen drie eventdagen. Voor A en C is de variantie daardoor , voor B .
Stap 5: de toets. De variantie van het CAAR is , zodat . Een onderzoeker die de schattingsfout vergeet, deelt door en vindt .
De code doet dezelfde vijf stappen en zet de uitkomsten naast de handberekening.
m_est = np.array([-2.0, -1.0, 0.0, 1.0, 2.0])   # market, estimation window tau = -6..-2
m_evt = np.array([1.0, -1.0, 1.0])              # market, event window tau = -1..+1
R_est = {"A": [-1.4, -1.4, 0.1, 0.6, 2.6], "B": [-1.0, 0.0, -1.0, 1.0, 1.0],
         "C": [-3.3, -0.8, 0.2, 2.2, 2.7]}
R_evt = {"A": [1.5, 1.0, 1.3], "B": [0.5, 1.5, 0.5], "C": [2.0, 0.5, 1.1]}
L1, L2 = len(m_est), len(m_evt)
S_mm = np.sum((m_est - m_est.mean()) ** 2)
factor = L2 + L2**2 / L1 + (m_evt.sum() - L2 * m_est.mean()) ** 2 / S_mm   # the recipe

toy_fits, car, var_car, var_naive = {}, {}, {}, {}
for name in R_est:
    beta, alpha = np.polyfit(m_est, R_est[name], deg=1)                  # step 1
    resid = np.array(R_est[name]) - alpha - beta * m_est
    toy_fits[name] = (alpha, beta, resid @ resid / (L1 - 2))             # step 2
    car[name] = np.sum(np.array(R_evt[name]) - alpha - beta * m_evt)     # step 3
    var_car[name] = factor * toy_fits[name][2]                           # step 4
    var_naive[name] = L2 * toy_fits[name][2]

N = len(car)
caar = np.mean(list(car.values()))
J1 = caar / np.sqrt(sum(var_car.values()) / N**2)                        # step 5
J1_naive = caar / np.sqrt(sum(var_naive.values()) / N**2)

hand = {"CAR A": 2.5, "CAR B": 2.0, "CAR C": 1.5, "factor": 4.9,
        "CAAR": 2.0, "J1": 2.509, "J1 naief": 3.207}
code = {"CAR A": car["A"], "CAR B": car["B"], "CAR C": car["C"], "factor": factor,
        "CAAR": caar, "J1": J1, "J1 naief": J1_naive}
pd.DataFrame({"met de hand": hand, "code": code}).round(3)De code komt op dezelfde getallen uit als de handberekening. Een abnormaal rendement is dus een rendement min een geschat model, en die schatting voegt ruis toe die de naïeve toets over het hoofd ziet. Met vijf schattingsdagen is de naïeve -waarde daardoor 28% te hoog.
4Theorie
We leiden eerst de verdeling van een abnormaal rendement af, en daaruit de variantie van een CAR. Die variantie is het recept uit het toy-voorbeeld en de kern van dit college. Daarna volgen de toets , zijn toetskracht en de halfwaardetijd van informatie. We sluiten af met de twee plekken waar de toets faalt, bij events op dezelfde dag en over lange horizonnen.
4.1Opzet: eventtijd en het marktmodel
Een event study verandert de tijdas. Voor elk event is de dag van het event, ongeacht de kalenderdatum. Het schattingsvenster heeft dagen, meestal vele malen meer dan het eventvenster. Het eventvenster loopt van tot en heeft dagen, meestal kort rond het event. De vensters overlappen niet, zodat het event de schatting van het normale rendement niet besmet.
In de rest van de reeks loopt de tijd in kalendertijd, met rendementen van naar , maar hier telt de dagen ten opzichte van het event. We schrijven voor het netto rendement, zonder aftrek van de risicovrije rente. MacKinlay (1997) schrijft daarvoor . Een ster markeert het eventvenster, zodat de vector van de eventrendementen is.
Een groot deel van de dagelijkse beweging van een aandeel is marktbeweging. Een onderzoeker die die component weghaalt, houdt een residu over met minder variantie, zodat de toets scherper wordt. Het marktmodel is dus een statistisch filter en geen theorie over verwachte rendementen:
Volgens het model bestaat het rendement van het aandeel uit een vast deel (hier een intercept op netto rendementen, geen afwijking van een evenwichtsmodel zoals de Jensen-alpha), een deel dat via met de markt meebeweegt, en een residu. Bij grote aandelen ligt rond 1. De residuele volatiliteit is in de replicatiesteekproef hieronder (achteraf gekozen grote aandelen) gemiddeld 1,8% per dag. Met , de -matrix met een kolom enen () en de marktrendementen, zijn de OLS-schatters van en van de restvariantie
4.2Het kernresultaat: de ruis in een abnormaal rendement
Waarom zou dit waar zijn? Een onderzoeker die en te hoog schat, trekt op elke eventdag te veel af, en die fout is op alle eventdagen dezelfde. Bij het optellen van de dagen telt de fout dus keer mee, zodat de variantie van het CAR meer dan evenredig met het venster stijgt.
Het abnormale rendement is het werkelijke rendement min wat het geschatte marktmodel voorspelt, zodat het ook de fout in bevat. Over het eventvenster is het
Hier is dezelfde matrix als , maar dan met de marktrendementen van het eventvenster. Onder de nulhypothese dat het event geen effect heeft, is het abnormale rendement dus de ruis van de eventdagen min de schattingsfout.
De variantie bestaat uit de ruis van de eventdagen, de term met , plus de schattingsfout. Omdat die fout op alle eventdagen tegelijk zit, zijn de abnormale rendementen onderling gecorreleerd.
Het CAR is de som over het venster, , met variantie . Voor het marktmodel heeft die variantie een gesloten vorm.
De ruis groeit dus met , de fout in met en de fout in met het kwadraat van wat de markt in het eventvenster van normaal afwijkt. Dit is het recept uit het toy-voorbeeld, waar het gaf in plaats van 3.
Proof 2
Bij en voegt de term 8% toe bovenop de ruisterm , want . Bij het jaarvenster van 250 dagen in de replicatie, met , is dat . Zonder die term zijn de -waarden dus te hoog, en des te meer naarmate het venster langer is.
4.3Wat het voorspelt: de toets en zijn kracht
Middelen over events maakt de toets scherper, en een langer venster maakt hem botter. Een onderzoeker die onafhankelijke events middelt, laat het signaal staan en deelt de variantie van de ruis door , terwijl elke extra dag in het venster ruis toevoegt zonder signaal.
Het gemiddelde CAR (het CAAR) en zijn variantie zijn
waarbij de variantie alleen klopt als de CAR’s onafhankelijk zijn over events. De toetsstatistiek (bij MacKinlay (1997) heet ze ) is
is dus een gewone -waarde, het CAAR gedeeld door zijn standaardfout. In het voorbeeld van MacKinlay, 600 winstaankondigingen van Dow Jones-bedrijven, geeft goed nieuws op dag 0 een abnormaal rendement van 0,965% met (zijn tabel 1).
Omdat de variantie uit het schattingsvenster gebruikt, is die variantie te klein als het event de koers onrustiger maakt, zoals bij een overnamebod, en dan verwerpt te vaak. Boehmer et al. (1991) (BMP) schatten de noemer daarom uit de doorsnede, dus uit hoe sterk de CAR’s van de events in het eventvenster zelf van elkaar verschillen. Ze delen elk CAR eerst door zijn eigen standaardfout, zoals Patell (1976), wat geeft. De toets wordt dan
is een gewone -toets op de gestandaardiseerde CAR’s, zodat een door het event verhoogde variantie vanzelf in verschijnt. Standaardiseren geeft bovendien de zeer volatiele aandelen minder gewicht, terwijl die aandelen in de noemer domineren. Daarom ligt BMP in de replicatie iets hoger, op 4,7 tegen 4,0.
Hoe vaak vindt een echt effect? Stel dat elk event op een abnormaal rendement heeft, dat alle aandelen residuele volatiliteit hebben en dat groot is. Dan is met
met de standaardnormale verdelingsfunctie. De kracht stijgt dus met de wortel van het aantal events en daalt met de wortel van de vensterlengte. Met , , en is en de kracht 61%, maar met een venster van drie dagen zakt naar en de kracht naar 25%. Zo vindt de toets, zoals we in de intuïtie verwachtten, een effect van 1% met enkele tientallen events, zolang de dag bekend is. Een venster van dagen vraagt keer zoveel events voor dezelfde kracht.
De vensterlengte hangt ook samen met de halfwaardetijd van informatie, het aantal perioden na het event waarna de helft van de uiteindelijke prijsreactie binnen is. Die halfwaardetijd is nooit kleiner te meten dan de resolutie van de data, zodat met maanddata “hooguit een maand” het beste antwoord is. Met transactiedata vonden Patell & Wolfson (1984) een eerste reactie op winst- en dividendberichten binnen enkele minuten. Bij aandelen die live op CNBC werden besproken, reageerden koersen binnen seconden, en was positief nieuws binnen een minuut verwerkt Busse & Green (2002). Bij elke verfijning van de meetlat lag de halfwaardetijd onder de nieuwe resolutie. Met de dagdata van de replicatie is “binnen een dag” dus het scherpste antwoord dat we zelf kunnen geven.
4.4Hoe het faalt: events op dezelfde dag
Als events op dezelfde dag vallen, vindt de toets te vaak een effect. Het delen door veronderstelt namelijk dat de ruis van het ene event niets zegt over die van het andere. Vallen honderd bankevents op dezelfde dag, dan delen ze het sectornieuws van die dag, zodat het gemiddelde van die ruis niet meer met krimpt.
Correlatie vergroot de variantie van het gemiddelde dus met factor . Tegelijk verkleint ze de spreiding in de doorsnede met factor , omdat gedeelde ruis alle events dezelfde kant op duwt.
Een toets die negeert, heeft onder de nulhypothese een standaarddeviatie van in plaats van één. Bij en is dat . Een nominale toets van 5% verwerpt dan in van de gevallen, en meer events maken dat erger.
BMP lost het probleem niet op, want de noemer van die toets schat de variantie in de doorsnede. Volgens de tweede formule van de propositie is die variantie een factor te klein, bij dus 0,95 keer de waarde zonder correlatie. Omdat BMP door te weinig deelt, is de -waarde bij niet 1,86 maar keer te breed verdeeld, zodat die toets nog vaker verwerpt. Daarom corrigeerden Kolari & Pynnönen (2010) BMP met beide factoren:
met de gemiddelde correlatie tussen de residuen in het schattingsvenster. De -waarde krimpt dus naarmate de events meer ruis delen. Omdat events op verschillende dagen geen ruis delen, wegen we de correlatie in de replicatie met de kalenderoverlap van de vensters.
4.5Hoe het faalt: de lange horizon
Waarom zou dit waar zijn? Een onderzoeker die het normale rendement elke dag twee basispunten te laag schat, ziet over drie dagen niets. Over drie jaar (750 handelsdagen) loopt die fout op tot 15%, terwijl de ruis maar met de wortel van de horizon groeit, zodat de fout het van de ruis wint.
Mist het model het verwachte rendement elke dag met , de modelfout, dan heeft een CAAR over een eventvenster van dagen een bias . Omdat de standaardfout bij onafhankelijke events is, wordt de verwachte -waarde zonder echt effect
Met per dag, en is dat bij en bij , een “significant” effect dat volledig uit het model komt. Dit bad model problem (een uitkomst die het benchmarkmodel meet in plaats van het event) is de joint hypothesis van het vorige college in de meest concrete vorm. Volgens Barber & Lyon (1997) vallen lange-horizontoetsen tegen een marktindex bovendien scheef uit, en daarom vergeleken zij met bedrijven van dezelfde grootte en boek-marktwaardeverhouding. Kothari & Warner (2007) concluderen dat korte event studies goed werken, maar dat lange gevoelig blijven voor het model.
5Simulatie: toetskracht zoals Brown en Warner
Met een eendaags venster vindt een effect van 1% bij 20 events in 63% van de steekproeven, zoals (12) voorspelt. Met een venster van 21 dagen mist hij hetzelfde effect zelfs bij 100 events in vier van de vijf steekproeven.
Brown & Warner (1980)Brown & Warner (1985) maten hoe goed event-study-methoden werken door in echte rendementen op willekeurige datums een bekend abnormaal rendement te injecteren en te tellen hoe vaak een toets het vond. Met dagdata en 50 aandelen vond het marktmodel een effect van 1% op dag 0 in 80,4% van de steekproeven, maar verspreid over de elf dagen van -5 tot +5 was dat nog 13,2% Brown & Warner (1985). Wij simuleren in plaats daarvan, zodat we elke eigenschap van de data zelf kiezen.
We willen weten hoe vaak de nulhypothese verwerpt, als functie van het aantal events , de vensterlengte en de grootte van het effect. Het datagenererende proces volgt daarvoor de eigenschappen van dagrendementen die voor de toets van belang zijn:
| eigenschap | waarde |
|---|---|
| dagvolatiliteit markt | 1% |
| residuele dagvolatiliteit | 2% (replicatie: 1,8%) |
| verdeling van schokken | met vier vrijheidsgraden, eenheidsvariantie |
| bèta’s | uniform tussen 0,5 en 1,5 |
| schattingsvenster | 250 dagen |
| events | op verschillende kalenderdagen () |
| normaal rendement boven de markt | 0,03% per dag, door de alpha weggefilterd |
De functie hieronder simuleert abnormale rendementen zonder effect, inclusief de
schattingsfout van het marktmodel. De markt heeft vorm (r, 1, T) omdat alle
events van één steekproef dezelfde marktdagen delen. Met rho > 0 delen ze ook
residuele ruis, zoals in Proposition 2, maar hier staat rho op nul.
De replicaties lopen in blokken van 250 om het geheugengebruik te beperken. De tweede
functie voegt een effect toe op dag 0
en berekent volgens (10).
def t_shocks(size, df=4):
    """Unit-variance Student-t draws (fat tails like daily returns)."""
    return rng.standard_t(df, size) * np.sqrt((df - 2) / df)


def simulate_events(reps, n_events, rho=0.0, L1=250, half=10, sig_m=0.01, sig_e=0.02,
                    chunk=250):
    """Null abnormal returns from an estimated market model, in chunks of replications.

    rho is the share of residual variance that all events share (0 = different days).
    Returns event-window abnormal returns (reps, N, 2*half+1) and what Var(CAR) needs.
    """
    T = L1 + 2 * half + 1
    out = {k: [] for k in ("ar", "s2", "m_evt", "m_bar", "s_mm")}
    for start in range(0, reps, chunk):
        r = min(chunk, reps - start)
        market = sig_m * t_shocks((r, 1, T))
        beta = rng.uniform(0.5, 1.5, (1, n_events, 1))
        resid = np.sqrt(1 - rho) * sig_e * t_shocks((r, n_events, T))
        resid += np.sqrt(rho) * sig_e * t_shocks((r, 1, T))
        R = 0.0003 + beta * market + resid   # 0.03% a day of normal return (the alpha)
        m_est, R_est = market[..., :L1], R[..., :L1]
        m_bar = m_est.mean(-1, keepdims=True)
        s_mm = ((m_est - m_bar) ** 2).sum(-1, keepdims=True)
        R_dev = R_est - R_est.mean(-1, keepdims=True)
        b = ((m_est - m_bar) * R_dev).sum(-1, keepdims=True) / s_mm
        a = R_est.mean(-1, keepdims=True) - b * m_bar
        out["ar"].append(R[..., L1:] - a - b * market[..., L1:])
        out["s2"].append(((R_est - a - b * m_est) ** 2).sum(-1) / (L1 - 2))
        out["m_evt"].append(market[:, 0, L1:])
        out["m_bar"].append(m_bar[:, 0, 0])
        out["s_mm"].append(s_mm[:, 0, 0])
    sim = {k: np.concatenate(v) for k, v in out.items()}
    sim.update(L1=L1, half=half)
    return sim


def j1_test(sim, lo, hi, a=0.0, n=None):
    """J1 for event window [lo, hi] over the first n events, with abnormal return a on day 0."""
    h, L1 = sim["half"], sim["L1"]
    n = n or sim["ar"].shape[1]
    window = slice(h + lo, h + hi + 1)
    L2 = hi - lo + 1
    car = sim["ar"][:, :n, window].sum(-1) + (a if lo <= 0 <= hi else 0.0)
    S_m = sim["m_evt"][:, window].sum(-1)
    factor = L2 + L2**2 / L1 + (S_m - L2 * sim["m_bar"]) ** 2 / sim["s_mm"]
    var = sim["s2"][:, :n] * factor[:, None]
    return car.sum(1) / np.sqrt(var.sum(1))
We simuleren 1000 steekproeven van 100 events en gebruiken daarvan de eerste . Per combinatie van , venster en effect tellen we hoe vaak .
sim0 = simulate_events(reps=1000, n_events=100)

sizes_N = [5, 10, 20, 50, 100]
windows = {"[0,0]": (0, 0), "[-1,+1]": (-1, 1), "[-5,+5]": (-5, 5), "[-10,+10]": (-10, 10)}
effects = [0.0, 0.005, 0.01, 0.02]
rows = []
for w, (lo, hi) in windows.items():
    for n in sizes_N:
        for a in effects:
            J1_sim = j1_test(sim0, lo, hi, a, n)
            rows.append({"venster": w, "N": n, "AR dag 0": a,
                         "verwerping": np.mean(np.abs(J1_sim) > 1.96)})
power = pd.DataFrame(rows)
power.pivot_table(index=["venster", "N"], columns="AR dag 0", values="verwerping",
sort=False).round(3)De tabel bevestigt (12). Bij , en een eendaags venster is de kracht 62,9%, tegen 61% uit de formule. Een effect van 2%, zo groot als het CAAR in het toy-voorbeeld, vindt de toets dan in 99,2% van de steekproeven. De schattingsfout die in het toy-voorbeeld de variantie met 63% verhoogde (4,9 tegen 3), is hier met en één dag verwaarloosbaar, want ze voegt maar 0,4% toe.
In de figuur staat elk venster in een eigen paneel, zodat te zien is hoe de lijnen naar rechts verschuiven als het venster langer wordt.
Source
fig, axes = plt.subplots(1, 4, figsize=(11, 3.6), sharey=True)
for ax, w in zip(axes, windows):
    sub = power[power["venster"] == w]
    for a in effects[1:]:
        s = sub[sub["AR dag 0"] == a]
        ax.plot(s["N"], s["verwerping"], marker="o", label=f"AR = {a:.1%}")
    s = sub[sub["AR dag 0"] == 0.0]
    ax.plot(s["N"], s["verwerping"], color="black", ls=":", marker=".", label="geen effect")
    ax.axhline(0.05, color="grey", lw=0.8)
    ax.set_xscale("log")
    ax.set_title(f"Venster {w}")
    ax.set_xlabel("Aantal events N")
axes[0].set_ylabel("Verwerpingsfrequentie (5%-toets)")
axes[-1].legend(loc="lower right")
fig.suptitle("Toetskracht van $J_1$: meer events helpt, een langer venster kost", x=0.01, ha="left")
plt.show()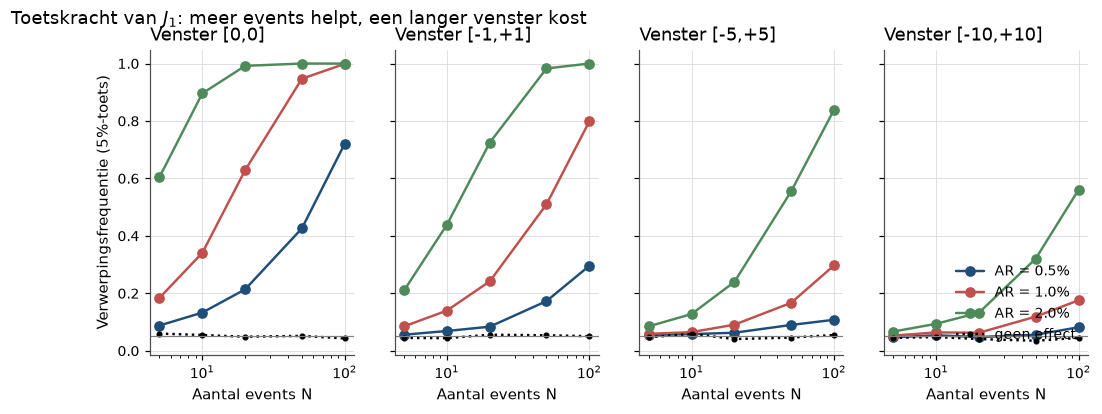
Figure 1:Toetskracht van in 1000 gesimuleerde steekproeven. Met een venster van één dag vindt de toets een effect van 1% al in de meeste steekproeven met 20 events. Met een venster van 21 dagen mist hij datzelfde effect zelfs met 100 events in vier van de vijf steekproeven. De stippellijn (geen effect) blijft rond 5%, wat betekent dat de toets ook met dikke staarten goed gespecificeerd is.
Zonder effect ligt de verwerpingsfrequentie overal tussen 3,5 en 6%. Op één cel na valt dat binnen de simulatieruis van procentpunt, en bij twintig cellen is één uitschieter te verwachten. Bij en een eendaags venster, de opzet van Brown en Warner, vindt onze toets een effect van 1% in 94,7% van de steekproeven, tegen hun 80,4%. Het verschil zit in hun steekproef van willekeurig gekozen aandelen, die gemiddeld volatieler zijn dan de 2% van de simulatie. Met een bekende eventdag is de toets scherp. Is de dag maar op een week bekend, dan zijn vijf keer zoveel events nodig.
6Replicatie op echte data
De code begint met de lijst met splitsingen,
waarin elke regel de vorm ticker:ex-datum:ratio heeft en de ex-datum dag 0 is.
# Ex-dates and ratios (>= 3:2) from the Yahoo Finance split history
# (yfinance.Ticker.splits, retrieved 2026-09-12); hap.data.yahoo returns no corporate
# actions. Spin-off adjustments with ratios such as 1.05 or 1.32 are left out.
SPLITS = """
NFLX:2004-02-12:2/1 APH:2004-03-30:2/1 ODFL:2004-05-21:3/2 DHR:2004-05-21:2/1
PG:2004-06-21:2/1 QCOM:2004-08-16:2/1 BAC:2004-08-30:2/1 GILD:2004-09-07:2/1
CVX:2004-09-13:2/1 AAPL:2005-02-28:2/1 WRB:2005-04-11:3/2 ADBE:2005-05-24:2/1
UNH:2005-05-31:2/1 ORLY:2005-06-16:2/1 MNST:2005-08-09:2/1 SBUX:2005-10-24:2/1
FAST:2005-11-14:2/1 ODFL:2005-12-01:3/2 WRB:2006-04-05:3/2 NVDA:2006-04-07:2/1
MNST:2006-07-10:4/1 WFC:2006-08-14:2/1 CSX:2006-08-16:2/1 APH:2007-04-02:2/1
NKE:2007-04-03:2/1 GILD:2007-06-25:2/1 NVDA:2007-09-11:3/2 IDXX:2007-11-27:2/1
DE:2007-12-04:2/1 UNP:2008-05-29:2/1 BRK-B:2010-01-21:50/1 EW:2010-05-28:2/1
DHR:2010-06-14:2/1 ODFL:2010-08-24:3/2 TSCO:2010-09-03:2/1 FAST:2011-05-23:2/1
FTNT:2011-06-02:2/1 CSX:2011-06-16:3/1 ROST:2011-12-16:2/1 TJX:2012-02-03:2/1
MNST:2012-02-16:2/1 CPRT:2012-03-29:2/1 KO:2012-08-13:2/1 ODFL:2012-09-10:3/2
NKE:2012-12-26:2/1 GILD:2013-01-28:2/1 CRM:2013-04-18:4/1 TSCO:2013-09-27:2/1
MA:2014-01-22:10/1 AAPL:2014-06-09:7/1 UNP:2014-06-09:2/1 APH:2014-10-10:2/1
V:2015-03-19:4/1 SBUX:2015-04-09:2/1 ROST:2015-06-12:2/1 IDXX:2015-06-16:2/1
NFLX:2015-07-15:7/1 EW:2015-12-14:2/1 NKE:2015-12-24:2/1 MNST:2016-11-10:3/1
CPRT:2017-04-11:2/1 ISRG:2017-10-06:3/1 TJX:2018-11-07:2/1 WRB:2019-04-03:3/2
FAST:2019-05-23:2/1 ODFL:2020-03-25:3/2 EW:2020-06-01:3/1 AAPL:2020-08-31:4/1
TSLA:2020-08-31:5/1 APH:2021-03-05:2/1 SHW:2021-04-01:3/1 CSX:2021-06-29:3/1
NVDA:2021-07-20:4/1 ISRG:2021-10-05:3/1 ANET:2021-11-18:4/1 WRB:2022-03-24:3/2
AMZN:2022-06-06:20/1 DXCM:2022-06-13:4/1 FTNT:2022-06-23:5/1 GOOGL:2022-07-18:20/1
TSLA:2022-08-25:3/1 PANW:2022-09-14:3/1 CPRT:2022-11-04:2/1 MNST:2023-03-28:2/1
CPRT:2023-08-22:2/1 WMT:2024-02-26:3/1 ODFL:2024-03-28:2/1 NVDA:2024-06-10:10/1
APH:2024-06-12:2/1 CMG:2024-06-26:50/1 WRB:2024-07-11:3/2 AVGO:2024-07-15:10/1
CTAS:2024-09-12:4/1 SMCI:2024-10-01:10/1 LRCX:2024-10-03:10/1 ANET:2024-12-04:4/1
PANW:2024-12-16:2/1 TSCO:2024-12-20:5/1 FAST:2025-05-22:2/1 ORLY:2025-06-10:15/1
NFLX:2025-11-17:10/1 NOW:2025-12-18:5/1
"""
events = pd.DataFrame([tok.split(":") for tok in SPLITS.split()],
                      columns=["ticker", "ex_date", "ratio"])
events["ex_date"] = pd.to_datetime(events["ex_date"])
tickers = sorted(events["ticker"].unique())
pd.Series({"splitsingen": len(events), "aandelen": len(tickers),
           "eerste ex-datum": f"{events['ex_date'].min():%Y-%m}",
           "laatste ex-datum": f"{events['ex_date'].max():%Y-%m}"})
splitsingen 102
aandelen 50
eerste ex-datum 2004-02
laatste ex-datum 2025-12
dtype: objectEr zijn 102 splitsingen van 50 aandelen. Daarna laden we de koersen en het marktrendement.
prices = hap_data.yahoo(tickers, start="2002-01-01", end="2026-08-01")
market = hap_data.market_daily()["Mkt"].loc["2002-01-03":"2026-07-31"]
returns = prices.pct_change(fill_method=None).reindex(market.index)
pd.Series({"handelsdagen": returns.shape[0], "eerste dag": f"{returns.index[0]:%Y-%m-%d}",
           "laatste dag": f"{returns.index[-1]:%Y-%m-%d}"})
handelsdagen 6183
eerste dag 2002-01-03
laatste dag 2026-07-31
dtype: objectDe reeks beslaat 6183 handelsdagen. Voor echte data hebben we het marktmodel en het recept als functies nodig, omdat elk event een eigen schattingsvenster heeft.
def fit_market_model(r, r_m):
    """OLS market model r = alpha + beta * r_m + e.

    Returns the coefficients, the residuals, the residual variance with L1 - 2
    degrees of freedom and (X'X)^{-1}, which drives the estimation-error term.
    """
    X = np.column_stack([np.ones(len(r_m)), r_m])
    xtx_inv = np.linalg.inv(X.T @ X)
    coef = xtx_inv @ X.T @ r
    resid = r - X @ coef
    return coef, resid, resid @ resid / (len(r) - 2), xtx_inv


def car_variance(s2, xtx_inv, r_m_event):
    """Var(CAR) = s2 * (L2 + g' (X'X)^{-1} g), g = column sums of the event-window X."""
    g = np.array([len(r_m_event), np.sum(r_m_event)])
    return s2 * (len(r_m_event) + g @ xtx_inv @ g)
car_variance is (6) in matrixvorm. Per event schatten we
nu het marktmodel, net als FFJR buiten het eventvenster, met tot 250 dagen ervóór en 250
dagen erna. Een venster alleen vooraf zou de stijging vóór de splitsing als
normaal rendement meetellen, en zo een te hoge alpha geven. Daarna berekenen we de
abnormale rendementen over
.
PRE, POST, EST = 250, 60, 250
tau = np.arange(-PRE, POST + 1)
dates = returns.index
r_m = market.to_numpy()

ar_rows, fits, resid_panel = [], [], np.full((len(dates), len(events)), np.nan)
for k, (ticker, ex_date) in enumerate(events[["ticker", "ex_date"]].itertuples(index=False)):
    r = returns[ticker].to_numpy()
    i0 = dates.searchsorted(ex_date)
    before = np.arange(max(i0 - PRE - EST, 0), i0 - PRE)
    after = np.arange(i0 + POST + 1, min(i0 + POST + 1 + EST, len(dates)))
    est = np.concatenate([before, after])
    est = est[np.isfinite(r[est])]
    coef, resid, s2, xtx_inv = fit_market_model(r[est], r_m[est])
    resid_panel[est, k] = resid
    window = np.arange(i0 - PRE, i0 + POST + 1)
    ar_rows.append(r[window] - coef[0] - coef[1] * r_m[window])
    fits.append({"ticker": ticker, "start": i0 - PRE, "L1": len(est), "beta": coef[1],
                 "sigma": np.sqrt(s2), "s2": s2, "xtx_inv": xtx_inv, "r_m": r_m[window]})

AR = np.array(ar_rows)
fit_table = pd.DataFrame(fits)[["ticker", "L1", "beta", "sigma"]]
fit_table.describe().loc[["mean", "min", "max"]].round(3)Het schattingsvenster telt gemiddeld 495 dagen, de gemiddelde bèta is 1,08 en de gemiddelde residuele volatiliteit 1,8% per dag. Vervolgens berekenen we het CAAR-pad en zijn standaardfout, waarvoor we voor elke dag de variantie van het CAR van -250 tot volgens (6) over de events optellen.
caar_path = AR.mean(axis=0).cumsum()
var_path = np.zeros(len(tau))
for f in fits:
    for k in range(len(tau)):   # Var of CAR(-250, tau_k) for this event
        var_path[k] += car_variance(f["s2"], f["xtx_inv"], f["r_m"][:k + 1])
se_path = np.sqrt(var_path) / len(fits)
caar_table = pd.DataFrame({"CAAR": caar_path, "SE": se_path}, index=pd.Index(tau, name="tau"))
caar_table.loc[[-121, -1, 0, 60]].round(4)Op dag -1 is het CAAR 14,9% met standaardfout 3,7 procentpunt, en de figuur toont het hele pad van dag -250 tot +60.
Source
fig, ax = plt.subplots()
ax.fill_between(tau, caar_path - 1.96 * se_path, caar_path + 1.96 * se_path,
                alpha=0.2, label="95%-band (onafhankelijke events)")
ax.plot(tau, caar_path, label="CAAR, 102 splitsingen 2004–2025")
ax.axvline(0, color="black", lw=0.8)
ax.axhline(0, color="grey", lw=0.8)
ax.set_xlabel("Handelsdagen ten opzichte van de ex-datum")
ax.set_ylabel("Cumulatief gemiddeld abnormaal rendement")
ax.yaxis.set_major_formatter(plt.FuncFormatter(lambda y, _: f"{y:.0%}"))
ax.set_title("Aandelensplitsingen: de koers stijgt vóór de splitsing, daarna niet meer")
ax.legend(loc="upper left")
plt.show()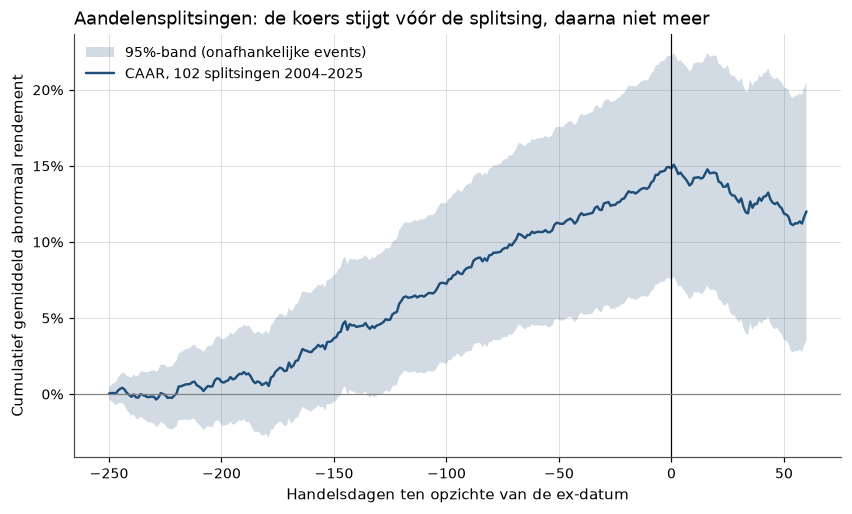
Figure 2:Cumulatief gemiddeld abnormaal rendement rond 102 splitsingen van grote Amerikaanse aandelen. Het patroon is dat van FFJR, met een gestage stijging over het jaar vóór de splitsing en geen voortgezette stijging erna. De band veronderstelt onafhankelijke events, en de tabel hieronder controleert die aanname.
Nu volgen de toetsen per venster. Voor Kolari-Pynnönen schatten we de residuele correlatie tussen elk paar events op de dagen waarop hun schattingsvensters overlappen (minimaal 100). Die correlatie telt alleen voor het deel van het eventvenster dat beide events op dezelfde kalenderdagen hebben, en daarom wegen we de correlatie met dat gedeelde deel. Bij het jaarvenster is dat ruim 90% voor twee events die een maand na elkaar vallen, en nul voor events die jaren uit elkaar liggen.
resid_corr = pd.DataFrame(resid_panel).corr(min_periods=100).to_numpy(copy=True)
np.fill_diagonal(resid_corr, np.nan)
starts = np.array([f["start"] for f in fits])


def split_tests(lo, hi):
    """CAAR and J1 / BMP / Kolari-Pynnonen statistics over event window [lo, hi]."""
    cols = slice(lo + PRE, hi + PRE + 1)
    L2, n = hi - lo + 1, len(fits)
    car = AR[:, cols].sum(axis=1)
    var = np.array([car_variance(f["s2"], f["xtx_inv"], f["r_m"][cols]) for f in fits])
    scar = car / np.sqrt(var)
    first_day, last_day = starts + lo, starts + hi   # event windows in calendar days
    overlap = np.zeros((n, n))
    for i in range(n):   # share of the event window that event i shares with each other event
        shared_days = np.minimum(last_day[i], last_day) - np.maximum(first_day[i], first_day) + 1
        overlap[i] = np.clip(shared_days, 0, None) / L2
    weighted_corr = overlap * np.nan_to_num(resid_corr)
    rho = np.nansum(weighted_corr) / (n * (n - 1))   # average over all pairs
    bmp = scar.mean() / (scar.std(ddof=1) / np.sqrt(n))
    return {"venster": f"[{lo},{hi}]", "CAAR": car.mean(), "SE": np.sqrt(var.sum()) / n,
            "J1": car.mean() / (np.sqrt(var.sum()) / n), "BMP": bmp, "rho": rho,
            "KP": bmp * np.sqrt((1 - rho) / (1 + (n - 1) * rho)), "% positief": (car > 0).mean()}


windows_real = [(-250, -1), (-250, -121), (-120, -1), (-1, 1), (0, 0), (1, 60), (0, 60)]
table = pd.DataFrame([split_tests(lo, hi) for lo, hi in windows_real])
table.set_index("venster").round(4)De tabel heeft de vorm die FFJR vonden. Hieronder staan onze getallen naast hun figuur.
| FFJR (hun figuur) | verwachting hier | hier | correlatie en KP | |
|---|---|---|---|---|
| CAAR over het jaar vóór de splitsing | stijgt gestaag | positief, | 14,9% (SE 3,7), , BMP 4,74 | 0,0012, KP 4,47 |
| abnormaal rendement op de ex-datum | niet apart gemeten (maanddata) | nul | , | 0,0000, KP 0,05 |
| CAAR na de splitsing | vrijwel vlak | over (SE 1,6), , BMP | 0,0003, KP |
Geslaagd. De drie verwachtingen komen uit, want het CAAR is vooraf significant positief, op de ex-datum nul en daarna zonder significante drift. Wie na de splitsing koopt, verdient er dus niets extra mee.
Het CAAR van na de splitsing is het waard om nog eens te bekijken. Het is verenigbaar met geen drift, maar ook met een negatieve drift van enkele procenten, en honderd events zijn te weinig om die twee te onderscheiden. Dat is hetzelfde probleem als de standaardfout van 2% uit het college over rendementen, maar dan in eventtijd. De lange-horizonformule geeft nog een lezing, want een modelfout van per dag, ruim 10% per jaar, zou het hele CAAR verklaren. Of zo’n modelfout plausibel is, komt hieronder terug bij de drift. FFJR vonden alleen een daling na splitsingen zonder dividendverhoging, en concludeerden dat een splitsing op zichzelf geen effect heeft zodra de dividendinformatie is meegenomen:
once the information effects of associated dividends are properly considered, a split per se has no net effect on common stock returns.
Bij onze getallen horen drie kanttekeningen. De eerste gaat over de selectie, de tweede over de datum en de derde over de toets.
De stijging vooraf is deels de reden voor de splitsing en deels onze selectie, want wie in 2026 grote aandelen kiest, kiest aandelen die sterk zijn gestegen.
We meten rond de ex-datum en niet rond de aankondiging, die enkele weken eerder valt, zodat de informatie in zit. Voor aankondigingsdatums bestaat geen gratis bron.
De geschatte correlatie tussen events is klein, omdat de splitsingen over twintig jaar verspreid liggen, zodat Kolari-Pynnönen de -waarden van BMP in de tabel nauwelijks verlaagt.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. De event study is een van de meest succesvolle instrumenten van de empirische financiële economie. Ze maakte de semi-sterke vorm van efficiëntie toetsbaar (prijzen weerspiegelen alle publieke informatie), en de uitkomst was over een halve eeuw opvallend consistent. Op korte horizon reageren prijzen snel en in de goede richting op publiek nieuws, en daarna valt er weinig meer te verdienen. De splitsingen hierboven tonen dat opnieuw, zestig jaar na FFJR. Het instrument verhuisde naar het recht en de macro-economie, en Eisfeldt et al. (2023) maten er zelfs de waarde van generatieve AI mee, met de lancering van ChatGPT als event. Het college over LLM’s pakt die lijn weer op.
Waar het breekt. Het instrument breekt op de lange horizon. Latere studies vonden drift (een abnormaal rendement dat na het event in dezelfde richting doorloopt) na winstaankondigingen, emissies, inkoopprogramma’s en splitsingen, en onze eigen tabel laat na de ex-datum zien, niet significant maar ook niet nul. Daar wreekt de joint hypothesis zich, want de bias van een verkeerd model groeit lineair met de horizon en de ruis alleen met de wortel. Een abnormaal rendement over drie jaar zegt dus evenveel over het model als over de markt.
Risico of vergissing? De drift laat twee lezingen toe. In de Chicago-lezing (de school van Fama, waarin verwachte rendementen met risico variëren) is hij een beloning voor risico dat het marktmodel niet meet, omdat bedrijven die splitsen of hun winst zien stijgen van risicoprofiel veranderen. Een beter model zou de drift dan doen verdwijnen. In de Yale-lezing (de school van Shiller, waarin prijzen ernaast kunnen zitten) is hij een vergissing, want beleggers reageren te traag op nieuws, en arbitrage is te riskant of te duur om de koers in één keer recht te zetten. Beide lezingen voorspellen hetzelfde CAR-patroon. Alleen een onomstreden model voor het verwachte rendement zou ze kunnen scheiden, en zo’n model levert de event study niet.
Wat er daarna kwam. Een kandidaat voor zo’n model bestond al als theorie. Sharpe, Lintner en Mossin leidden het af Sharpe (1964)Lintner (1965)Mossin (1966), en Jensen gebruikte het in 1968 om fondsen te beoordelen Jensen (1968). Of bèta werkelijk het verwachte rendement bepaalt, werd de vraag van het volgende decennium en van het college over het CAPM.
8Oefeningen
Solution to Exercise 1
(1) Met en is de factor . De varianties zijn voor A en C en voor B. Het gemiddelde abnormale rendement is . Dan is .
factor_0 = 1 + 1 / L1 + (m_evt[1] - m_est.mean()) ** 2 / S_mm
ar_0 = [R_evt[name][1] - alpha - beta * m_evt[1] for name, (alpha, beta, _) in toy_fits.items()]
var_0 = [factor_0 * s2 for (_, _, s2) in toy_fits.values()]
J1_day0 = np.mean(ar_0) / np.sqrt(sum(var_0) / N**2)
pd.Series({"factor": factor_0, "gemiddeld AR(0)": np.mean(ar_0), "J1": J1_day0}).round(3)
factor 1.300
gemiddeld AR(0) 1.900
J1 4.628
dtype: float64(2) Het signaal zat op dag 0. De dagen -1 en +1 voegen samen maar 0,1 aan signaal toe, terwijl elk van die dagen een volle dag ruis plus schattingsfout meebrengt. Een kort venster rond een bekende dag is dus de sterkste toets, zoals (12) voorspelt.
:::{exercise}
:label: ex-eventstudies-2

**Afleiding: de prijs van het vergeten van de schattingsfout.** In het toy-voorbeeld was
de naïeve $t$-waarde daardoor te hoog. Deze oefening zoekt de algemene vorm.

1. Leid voor het *constant-mean*-model $r_{i,\tau} = \mu_i + \varepsilon_{i,\tau}$
   (een model zonder markt, alleen een eigen gemiddelde) af dat
   $\Var(\widehat{\text{CAR}}_i) = \sigma^2_{\varepsilon_i}(L_2 + L_2^2/L_1)$.
2. Laat zien dat de naïeve toets, die $L_2\sigma^2$ gebruikt, een werkelijke
   standaarddeviatie van $\sqrt{1 + L_2/L_1}$ heeft. Bereken het werkelijke
   significantieniveau van een nominale 5%-toets voor $L_2 = 21$ en
   $L_1 = 60$, $120$, $250$.
Solution to ex-eventstudies-2
(1) Met alleen een constante is en . Met geeft Theorem 1 . Intuïtief heeft variantie , en die fout wordt keer opgeteld.
(2) De werkelijke variantie gedeeld door de gebruikte is . Het werkelijke significantieniveau is .
level = {L1_: 2 * stats.norm.cdf(-1.96 / np.sqrt(1 + 21 / L1_)) for L1_ in [60, 120, 250]}
pd.Series(level, name="werkelijk significantieniveau").rename_axis("L1").round(3)
L1
60 0.092
120 0.071
250 0.060
Name: werkelijk significantieniveau, dtype: float64Bij is de vertekening klein, maar bij , een venster dat we tegenkomen bij recente beursintroducties, verwerpt de naïeve toets bijna twee keer te vaak. De ruis in een abnormaal rendement is dus niet alleen de ruis van de eventdag, maar ook de onzekerheid over wat normaal was.
:::{exercise}
:label: ex-eventstudies-3

**Brown en Warner op echte data.** Gebruik `returns` en `market` uit de replicatie.
Trek 300 keer een steekproef van 20 pseudo-events, elk een willekeurig aandeel op een
willekeurige handelsdag tussen 2004 en 2025, met 250 schattingsdagen ervóór.
Bereken $J_1$ voor een eendaags venster zonder effect en met een abnormaal
rendement van 1%. Vergelijk met de simulatie ([](#fig-eventstudies-kracht)). Welke
eigenschap van echte data verklaart een verschil?
Solution to ex-eventstudies-3
first = dates.searchsorted(pd.Timestamp("2004-01-01"))
last = dates.searchsorted(pd.Timestamp("2025-12-31"))
J_null, J_alt = [], []
for _ in range(300):
    num, var_sum = 0.0, 0.0
    for _ in range(20):
        while True:   # draw until the stock has a full estimation window and day 0
            r = returns[tickers[rng.integers(len(tickers))]].to_numpy()
            i0 = rng.integers(first, last)
            est = np.arange(i0 - 250, i0)
            if np.isfinite(r[est]).all() and np.isfinite(r[i0]):
                break
        coef, _, s2, xtx_inv = fit_market_model(r[est], r_m[est])
        num += r[i0] - coef[0] - coef[1] * r_m[i0]
        var_sum += car_variance(s2, xtx_inv, r_m[i0:i0 + 1])
    J_null.append(num / np.sqrt(var_sum))
    J_alt.append((num + 20 * 0.01) / np.sqrt(var_sum))
pd.Series({"verwerping zonder effect": np.mean(np.abs(J_null) > 1.96),
           "kracht (AR = 1%)": np.mean(np.abs(J_alt) > 1.96)}).round(3)
verwerping zonder effect 0.043
kracht (AR = 1%) 0.690
dtype: float64De verwerping zonder effect ligt dicht bij 5%, want willekeurige dagen en aandelen geven vrijwel onafhankelijke events. De kracht ligt iets hoger dan de 63% van de simulatie met , omdat de residuele volatiliteit van deze grote aandelen (1,8%) onder de 2% van de simulatie ligt. De spreiding in volatiliteit werkt de andere kant op, want een paar zeer volatiele aandelen (TSLA, SMCI) domineren de noemer van . Per saldo wint de lagere gemiddelde volatiliteit, met 69% tegen 63%. Wat de kracht bepaalt, is dus vooral de volatiliteit van de gekozen aandelen, en die verklaart ook waarom Brown en Warner met willekeurige aandelen minder vonden dan onze simulatie.
- Fama, E. F. (1965). The Behavior of Stock-Market Prices. The Journal of Business, 38(1), 34–105. 10.1086/294743
- Fama, E. F., & Blume, M. E. (1966). Filter Rules and Stock-Market Trading. The Journal of Business, 39(1), 226–241. 10.1086/294849
- Ball, R., & Brown, P. (1968). An Empirical Evaluation of Accounting Income Numbers. Journal of Accounting Research, 6(2), 159–178. 10.2307/2490232
- Fama, E. F., Fisher, L., Jensen, M. C., & Roll, R. (1969). The Adjustment of Stock Prices to New Information. International Economic Review, 10(1), 1–21. 10.2307/2525569
- MacKinlay, A. C. (1997). Event Studies in Economics and Finance. Journal of Economic Literature, 35(1), 13–39. https://www.jstor.org/stable/2729691
- Dolley, J. C. (1933). Characteristics and Procedure of Common Stock Split-Ups. Harvard Business Review, 11, 316–326.
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
- Boehmer, E., Musumeci, J., & Poulsen, A. B. (1991). Event-Study Methodology under Conditions of Event-Induced Variance. Journal of Financial Economics, 30(2), 253–272. 10.1016/0304-405X(91)90032-F
- Patell, J. M. (1976). Corporate Forecasts of Earnings Per Share and Stock Price Behavior: Empirical Test. Journal of Accounting Research, 14(2), 246–276. 10.2307/2490543
- Patell, J. M., & Wolfson, M. A. (1984). The Intraday Speed of Adjustment of Stock Prices to Earnings and Dividend Announcements. Journal of Financial Economics, 13(2), 223–252. 10.1016/0304-405X(84)90024-2
- Busse, J. A., & Green, T. C. (2002). Market Efficiency in Real Time. Journal of Financial Economics, 65(3), 415–437. 10.1016/S0304-405X(02)00148-4
- Kolari, J. W., & Pynnönen, S. (2010). Event Study Testing with Cross-sectional Correlation of Abnormal Returns. The Review of Financial Studies, 23(11), 3996–4025. 10.1093/rfs/hhq072
- Barber, B. M., & Lyon, J. D. (1997). Detecting Long-Run Abnormal Stock Returns: The Empirical Power and Specification of Test Statistics. Journal of Financial Economics, 43(3), 341–372. 10.1016/S0304-405X(96)00890-2
- Kothari, S. P., & Warner, J. B. (2007). Econometrics of Event Studies. In B. E. Eckbo (Ed.), Handbook of Empirical Corporate Finance (Vol. 1, pp. 3–36). Elsevier/North-Holland. 10.1016/B978-0-444-53265-7.50015-9
- Brown, S. J., & Warner, J. B. (1980). Measuring Security Price Performance. Journal of Financial Economics, 8(3), 205–258. 10.1016/0304-405X(80)90002-1
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD