

Jegadeesh-Titman, Carhart en momentum crashes
1Overzicht
Waarom blijven aandelen die het afgelopen jaar beter deden dan andere aandelen, dat nog maanden doen? Het feit zelf staat vast, want winnaars kopen en verliezers verkopen levert ongeveer een procent per maand op en het driefactormodel verklaart daar niets van. Een verklaring ontbreekt nog, maar het risico van de strategie blijkt voorspelbaar, zodat een belegger die de positie terugschaalt als dat risico hoog is, de Sharpe-ratio bijna verdubbelt. In dit college:
rekenen we met vier aandelen uit wat momentum verdient en waarom de bèta na een marktdaling negatief wordt;
splitsen we de winst in drie bronnen, waarvan alleen overreactie een latere omkering voorspelt;
leiden we af wanneer schalen met voorspelde volatiliteit de Sharpe-ratio verhoogt;
simuleren we of 25 jaar data de drie bronnen uit elkaar houden;
repliceren we Jegadeesh en Titman, tabel 3 van Barroso en Santa-Clara en de crashes van 1932 en 2009.
In 1993 publiceerden Narasimhan Jegadeesh en Sheridan Titman de toets waarmee dit onderwerp begint. Ze sorteerden aandelen op hun rendement van de afgelopen drie tot twaalf maanden, kochten de winnaars en verkochten de verliezers Jegadeesh & Titman (1993). Drie jaar later noemden Fama en French deze voortzetting de grootste verlegenheid van hun driefactormodel Fama & French (1996), en Carhart maakte er een vierde factor van om beleggingsfondsen te beoordelen Carhart (1997). Sindsdien heet de strategie momentum (de neiging van relatieve winnaars om winnaars te blijven) en de factor WML (winners minus losers) of UMD (up minus down). Omdat geen evenwichtsmodel momentum voorspelde, is het in dit tijdvak het zuiverste geval van theorie of feit, want de regelmaat is gemeten terwijl de verklaring nog ontbreekt. Met de crashes van 1932 en 2009 Daniel & Moskowitz (2016) en het voorstel van Barroso en Santa-Clara om met volatiliteit te schalen Barroso & Santa-Clara (2015) verschoof de aandacht daarna naar het risico van de strategie.
2Intuïtie: waarom zou dit waar zijn?
Jegadeesh en Titman vroegen niet of een koers die gestegen is blijft stijgen, want die vraag verdrinkt in de schommelingen van de markt als geheel. Ze vroegen of een aandeel dat het beter deed dan andere aandelen, daarna ook beter blijft doen. Doordat winnaars tegen verliezers worden gezet, valt de markt uit de vergelijking. Bekend was al dat relatieve rendementen op een horizon van een maand en van drie tot vijf jaar omkeren De Bondt & Thaler (1985), en op de horizon daartussen vonden zij voortzetting.
Een winnaar kan op drie manieren winnaar blijven, en elk verhaal voorspelt iets anders voor de lange termijn. In het eerste verhaal hebben sommige aandelen gewoon een hoger verwacht rendement, zodat een sortering op vorig rendement ook op verwacht rendement sorteert en de winnaars blijven winnen. In het tweede verhaal verwerken beleggers nieuws langzaam, zodat een koers die op goed nieuws steeg, nog enkele maanden doorstijgt en daarna stilvalt. In het derde verhaal schiet de koers na die trage reactie door, en wordt de overschrijding later gecorrigeerd. Alleen in dat derde verhaal zijn de winnaars van nu over twee tot vijf jaar verliezers.
Het risico van de strategie volgt uit dezelfde sortering. Na een jaar waarin de markt hard daalde, zijn de winnaars de aandelen die het minst meedaalden, meestal met een lage bèta, en de verliezers de aandelen met een hoge bèta. De strategie koopt dus lage bèta en verkoopt hoge bèta, zodat ze per saldo tegen de markt in zit en veel verliest als de markt herstelt. Omdat de verliezers na een crash vaak bijna failliete bedrijven zijn waarvan de aandelen zich als opties gedragen, stijgen juist de verkochte aandelen dan explosief.
Zulke periodes kondigen zich aan, omdat de volatiliteit van momentum dan al hoog is. Een belegger die de positie steeds terugbrengt naar een vaste doelvolatiliteit, stapt dus uit wanneer een crash het waarschijnlijkst is. Omdat volatiliteit veel nauwkeuriger te meten is dan een gemiddeld rendement, werkt zo’n regel beter dan het rendement zelf voorspellen. We verwachten daarom winst in het eerste jaar in alle drie de verhalen, maar een omkering alleen bij overreactie. Verder verwachten we een negatieve bèta van WML na een marktdaling, en een hogere Sharpe-ratio na schalen zolang het verwachte rendement niet met de volatiliteit meestijgt.
3Toy-voorbeeld: vier aandelen, twaalf maanden
Het toy-voorbeeld laat één mechanisme zien: wie op vorig rendement sorteert, sorteert op alles wat dat rendement heeft bepaald, eerst op bedrijfsnieuws en daarna op de markt. We laden eerst de pakketten die het hele college gebruikt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import statsmodels.api as sm
from scipy import signal, stats

import hap
from hap import data as hap_data
hap.plotting.setup()

rng = np.random.default_rng(20240101)
Opzet. Vier aandelen A tot en met D hebben de maandrendementen in de tabel, in procenten, waarbij lege cellen nul zijn. Het signaal voor maand 13 is het samengestelde rendement over maand 1 tot en met 11. Die regel heet de 12-1-regel, omdat hij twaalf maanden terugkijkt en de laatste maand overslaat.
| aandeel | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| A | +10 | +10 | +10 | 0 | +3 | ||||||||
| B | +10 | +10 | −10 | +2 | +1 | ||||||||
| C | −10 | −10 | +40 | −4 | |||||||||
| D | −10 | −10 | +10 | −5 | −2 |
Het recept. Het signaal van een aandeel is het product van over de elf maanden, min één. WML koopt de helft met de hoogste signalen en verkoopt de andere helft, beide gelijkgewogen. In de theorie komt hetzelfde recept terug als formule.
De signalen zijn voor A, voor B, voor C en voor D.
De rangorde is A, B, D, C, dus A en B zijn de winnaars en C en D de verliezers.
In maand 13 verdient WML .
Haal nu het bedrijfsnieuws weg en geef A tot en met D de bèta’s , , en . Daalt de markt in de vormingsperiode met 20%, dan zijn hun rendementen , , en .
De winnaars zijn nu A en B met de laagste bèta’s (gemiddeld ), de verliezers C en D met de hoogste (), zodat WML een bèta van heeft.
Herstelt de markt de maand daarna met 20%, dan is .
Aandeel C sprong in maand 12 met 40%, maar telt door de overgeslagen maand niet als winnaar. De eerste oefening laat zien wat er gebeurt als die maand wel meetelt. We rekenen de zes stappen na in code.
toy = pd.DataFrame(0.0, index=list("ABCD"), columns=range(1, 14))
toy.loc["A", [2, 5, 8]] = 0.10
toy.loc["B", [1, 6]], toy.loc["B", 9] = 0.10, -0.10
toy.loc["C", [3, 7]] = -0.10
toy.loc["D", [4, 10]], toy.loc["D", 11] = -0.10, 0.10
toy[12] = [0.00, 0.02, 0.40, -0.05]
toy[13] = [0.03, 0.01, -0.04, -0.02]


def wml_toy(months):
    """Signaal over `months`, daarna het rendement in maand 13 van de bovenste min de onderste helft."""
    sig = (1 + toy[months]).prod(axis=1) - 1
    ranked = sig.sort_values(ascending=False).index
    return sig, toy.loc[ranked[:2], 13].mean() - toy.loc[ranked[2:], 13].mean()


sig_12_1, wml_12_1 = wml_toy(list(range(1, 12)))

betas = np.array([0.5, 0.8, 1.2, 1.5])
formation = betas * -0.20                     # rendementen bij een marktdaling van 20%
order = np.argsort(formation)                 # van slechtste naar beste
winners, losers = order[2:], order[:2]
beta_wml = betas[winners].mean() - betas[losers].mean()

hand = pd.Series({"signaal A": 0.331, "signaal B": 0.089, "signaal C": -0.190, "signaal D": -0.109,
                  "WML in maand 13": 0.05, "bèta WML na daling": -0.70, "WML bij herstel van 20%": -0.14})
code = pd.Series({"signaal A": sig_12_1["A"], "signaal B": sig_12_1["B"], "signaal C": sig_12_1["C"],
                  "signaal D": sig_12_1["D"], "WML in maand 13": wml_12_1,
                  "bèta WML na daling": beta_wml, "WML bij herstel van 20%": beta_wml * 0.20})
pd.DataFrame({"met de hand": hand, "code": code}).round(3)De code geeft dezelfde getallen als de berekening met de hand. Het verlies van 14% bij herstel komt alleen uit de sortering, want aan het momentumeffect zelf is niets veranderd. Was de markt in de vormingsperiode juist 20% gestegen, dan waren de aandelen met een hoge bèta de winnaars geweest en had WML een bèta van gehad.
4Theorie
We lopen de drie verwachtingen uit de intuïtie na. Na de constructie van WML is het kernresultaat een decompositie van de momentumwinst in drie bronnen, waaruit volgt dat alleen de lange horizon de verklaringen scheidt. Daarna leiden we af waarom de bèta van WML het teken van de markt heeft, en wanneer schalen met volatiliteit loont.
4.1Constructie: J/K-strategieën, UMD en het vierfactormodel
Een momentumstrategie kiest hoe lang ze terugkijkt ( maanden) en hoe lang ze de portefeuille aanhoudt ( maanden). Laat het rendement van aandeel in maand zijn. Het momentumsignaal aan het eind van maand is het samengestelde rendement over de maanden daarvoor, met maand zelf overgeslagen:
Voor is dit de 12-1-regel uit het toy-voorbeeld, waarin de maanden tot en met het rendement in maand voorspellen. French noemt dezelfde sortering prior 12-2, omdat hij terugtelt vanaf de maand waarin de portefeuille wordt aangehouden.
Jegadeesh en Titman. Zij sorteerden alle NYSE- en AMEX-aandelen op hun rendement over de afgelopen maanden en vormden gelijkgewogen decielportefeuilles. Voor en namen ze elk 3, 6, 9 of 12 maanden. Anders dan in (1) sloegen ze maand niet over, en in een tweede variant alleen de laatste week. Omdat de uitkomst niet van één vormingsmaand mocht afhangen, lieten ze de portefeuilles overlappen. De strategie in maand middelt daarom de laatst gevormde portefeuilles:
Hierin zijn en het 90e en het 10e percentiel van de signalen en is het aantal aandelen per deciel. Elke portefeuille koopt dus het bovenste deciel en verkoopt het onderste. Omdat de gewichten optellen tot nul, vraagt WML geen eigen inleg (een zero-cost-portefeuille), en is het rendement een overrendement. Over 1965–1989 was 12/3 in hun tabel I de meest winstgevende combinatie, met 1,31% per maand () Jegadeesh & Titman (1993). De winst viel buiten januari, want hun 6/6-strategie, die gemiddeld ongeveer 0,95% per maand verdiende, verloor in januari gemiddeld ongeveer 7% en verdiende in de andere maanden 1,66% Jegadeesh & Titman (1993).
UMD en Carhart. De momentumfactor van Kenneth French wordt gebouwd zoals de factoren van het driefactormodel, waarin SMB kleine min grote aandelen is en HML value- min groeiaandelen. French sorteert dubbel, op marktwaarde bij de mediaan en op prior 12-2 bij het 30e en 70e NYSE-percentiel, en neemt het verschil tussen de hoge en de lage momentumportefeuilles:
UMD is dus het gemiddelde momentumverschil onder kleine en onder grote aandelen. Carhart gebruikte een verwante factor, die over juli 1963 tot december 1993 gemiddeld 0,82% per maand verdiende () Carhart (1997). Zijn vierfactormodel voor het overrendement van een fonds werd de standaard in de fondsliteratuur:
Het overrendement van een fonds is hier alpha plus de blootstelling aan de markt en aan drie verschilportefeuilles. Carhart concludeerde dat de hot hands van fondsbeheerders (reeksen van goede jaren) grotendeels het momentumeffect zijn. Zijn vierfactormodel is geen evenwichtsmodel, want UMD zit erin omdat de factor werkt, niet omdat een theorie hem voorspelt.
4.2Waar komt momentumwinst vandaan?
Momentumwinst heeft drie mogelijke bronnen. Een strategie die koopt wat relatief is gestegen, verdient als het rendement van een aandeel positief samenhangt met zijn eigen verleden, en ook als aandelen blijvend verschillende verwachte rendementen hebben. Ze verliest als het ene aandeel het andere met vertraging volgt, omdat de achterblijver dan inhaalt. Lo en MacKinlay schreven die drie bronnen uit voor contrarian-strategieën Lo & MacKinlay (1990), en Jegadeesh en Titman gebruikten dezelfde algebra.
Neem de relative-strength-gewichten , die elk aandeel kopen naar rato van zijn voorsprong op het gemiddelde van de aandelen, met winst . Schrijf voor het verwachte rendement en voor de covariantie tussen aandeel nu en aandeel een maand later, beide constant in de tijd. Beide zijn klein, omdat een maandrendement het volgende nauwelijks voorspelt. In de simulatie hieronder spreiden de met een halve procent per maand, en is een eigen autocovariantie ongeveer .
De verwachte winst is dus de eigen autocovariantie van aandelen min hun onderlinge kruis-autocovariantie. Daar komt de spreiding in verwachte rendementen bij, die altijd positief is.
Proof 2
In het factormodel is met en . Invullen in (5) geeft voor de factordelen , en voor de idiosyncratische delen .
Momentumwinst komt dus uit spreiding in verwachte rendementen, uit autocorrelatie van de factor of uit autocorrelatie van het bedrijfsnieuws. Hoe groot elk deel is, laat een gesimuleerde steekproef van 200 aandelen en 20.000 maanden zien. Daarin heeft de factor een autocorrelatie van 0,10 en het bedrijfsnieuws een van 0,05.
n, T = 200, 20_000
mu = 0.005 * rng.standard_normal(n)
b = 1.0 + 0.5 * rng.standard_normal(n)
f = np.zeros(T)
e = np.zeros((T, n))
shock_f, shock_e = 0.045 * rng.standard_normal(T), 0.10 * rng.standard_normal((T, n))
for t in range(1, T):
    f[t] = 0.10 * f[t - 1] + shock_f[t]          # factor autocorrelation 0.10
    e[t] = 0.05 * e[t - 1] + shock_e[t]          # idiosyncratic autocorrelation 0.05
R = mu + np.outer(f, b) + e

w = (R[:-1] - R[:-1].mean(axis=1, keepdims=True)) / n
profit = (w * R[1:]).sum(axis=1)
theory = {
    "sigma2_mu": mu.var(),
    "factor": b.var() * 0.10 * 0.045**2 / (1 - 0.10**2),
    "idiosyncratisch": (n - 1) / n * 0.05 * 0.10**2 / (1 - 0.05**2),
}
pd.Series({**theory, "som (theorie)": sum(theory.values()),
           "gemiddelde winst (simulatie)": profit.mean(),
           "standaardfout": profit.std() / np.sqrt(T - 1)}).mul(1e4).round(3).rename("basispunten per maand")
sigma2_mu 0.243
factor 0.582
idiosyncratisch 4.987
som (theorie) 5.812
gemiddelde winst (simulatie) 5.707
standaardfout 0.067
Name: basispunten per maand, dtype: float64De gesimuleerde winst van 5,71 basispunten per maand ligt binnen twee standaardfouten van de som van de drie termen. Hoewel de idiosyncratische autocorrelatie maar 0,05 is, is die term bijna negen keer zo groot als de factorterm, omdat bedrijfsspecifieke variantie de totale variantie van een aandeel domineert.
Jegadeesh en Titman concludeerden daarom dat de factorterm de winst niet kan verklaren, en wezen op onderreactie op bedrijfsnieuws, een positieve . De spreiding is lastiger uit te sluiten, omdat ze in het eerste jaar net als onderreactie voorspelt dat winnaars blijven winnen, en de twee pas op lange horizon uiteenlopen.
Jegadeesh en Titman voerden die toets in 2001 uit Jegadeesh & Titman (2001). Hun 6/6-strategie verdiende 1,39% per maand in de nieuwe steekproef 1990–1998, zodat de voortzetting geen product van datamining was. In maand 13 tot en met 60 na vorming verloor dezelfde strategie over 1965–1998 gemiddeld 0,26% per maand (, hun tabel V). De winnaars werden dus verliezers, en volgens Corollary 2 kan spreiding in verwachte rendementen dat niet verklaren. Het teken klopt daarmee met de intuïtie, die alleen bij overreactie een omkering verwachtte. De auteurs merkten wel op dat de omkering sterk was over 1965–1981 en veel zwakker over 1982–1998.
4.3Waarom de bèta van WML na een crash negatief is
Na een marktdaling sorteert het momentumsignaal deels op lage bèta, en daardoor krijgt WML een negatieve bèta. Het rendement van een aandeel in de vormingsperiode is namelijk deels zijn bèta maal het marktrendement. Hoe groter de marktbeweging ten opzichte van het bedrijfsnieuws, hoe zuiverder die sortering, maar verder dan de spreiding in bèta’s gaat ze niet Grundy & Martin (2001).
De bèta van WML heeft dus het teken van , stijgt in en nadert als groot wordt. Hij wordt groter naarmate de bèta’s meer spreiden en kleiner naarmate het bedrijfsnieuws het signaal meer bepaalt. Bij decielen en een spreiding in bèta’s van ligt die limiet rond 1,05. Het toy-voorbeeld is het uiterste geval zonder bedrijfsnieuws, en daar zette een daling van 20% de bèta op .
Proof 3
Gegeven zijn gezamenlijk normaal met en , dus . Voor de bovenste fractie is , de verwachting van een afgeknotte normale verdeling, en voor de onderste fractie is het tegengestelde waar. Door de wet van de grote aantallen is de bèta van elk been het conditionele gemiddelde, dus . De eigenschappen volgen omdat oneven en stijgend is met limiet .
Daniel en Moskowitz lieten de vaste bèta’s van de propositie los en vonden daardoor een asymmetrie Daniel & Moskowitz (2016). Na een lange daling zijn de verliezers bedrijven waarvan het eigen vermogen, zoals in het model van Merton, een calloptie op de bezittingen is geworden. Hun bèta stijgt als de markt stijgt, zodat WML zich gedraagt als een geschreven call op de markt. In een bear market, bij hen een negatief cumulatief marktrendement over de afgelopen 24 maanden, is de bèta van WML daarom negatiever in stijgende dan in dalende maanden. De verwachte negatieve bèta komt dus uit, en de asymmetrie maakt het herstel na een crash extra duur.
4.4Schalen met volatiliteit
Schalen met volatiliteit verhoogt de Sharpe-ratio zolang het verwachte rendement niet evenredig met de variantie meestijgt. Stel dat de volatiliteit van volgende maand voorspelbaar is en het verwachte rendement niet meebeweegt. Een belegger die in onrustige maanden minder blootstelling neemt, levert dan een beetje verwacht rendement in maar veel variantie, omdat de variantie met het kwadraat van de blootstelling groeit.
Laat een overrendement zijn met conditionele verwachting en conditionele variantie , beide bekend op . De geschaalde strategie is , met een gewicht dat op bekend is, bijvoorbeeld .
Geen enkele schaling haalt dus een hogere Sharpe-ratio dan de grens toelaat. Het beste gewicht stijgt met en daalt met .
Proof 4
Schrijf . Dan is , stijgend in . Met de wet van de herhaalde verwachtingen is en . Cauchy-Schwarz geeft
dus , met gelijkheid precies als de twee factoren evenredig zijn.
Proof 5
Voor het tweede geval is het bewijs invullen: , en voor is . Het eerste en het derde geval volgen op dezelfde manier uit de voorwaarde voor gelijkheid in (9).
Hoeveel schalen oplevert, hangt af van hoe sterk de volatiliteit schommelt. Is normaal verdeeld met standaarddeviatie , dan verhoogt schalen met in geval 1 de Sharpe-ratio met ongeveer een factor , en optimaal schalen met . In geval 2 is de factor . Voor momentum is ongeveer 0,55, zoals de replicatie laat zien. De tabel geeft de factoren voor vier waarden van .
log_sd = np.array([0.25, 0.40, 0.55, 0.70])
pd.DataFrame(
    {"s = SD(log sigma)": log_sd,
     "winst schalen 1/sigma (geval 1)": np.exp(1.5 * log_sd**2),
     "winst schalen 1/sigma^2 (geval 1)": np.exp(2 * log_sd**2),
     "winst schalen 1/sigma (geval 2)": np.exp(0.5 * log_sd**2)},
).round(3)Bij verhoogt schalen met de Sharpe-ratio met 57% als het verwachte rendement constant is, en met 16% als de conditionele Sharpe-ratio constant is. Voor een verdubbeling is voorspelbare volatiliteit alleen dus niet genoeg. Het verwachte rendement moet ook dalen als de volatiliteit hoog is, en dat vonden Daniel & Moskowitz (2016) in paniektoestanden. Schalen werkt ook al moet geschat worden, omdat een variantie met 126 dagen data goed te meten is, terwijl een gemiddeld rendement met een eeuw data nauwelijks te meten is, zoals al bleek bij de standaardfout van 2%.
Barroso en Santa-Clara schatten de maandvariantie van WML als maal de som van de gekwadrateerde dagrendementen over de 126 handelsdagen tot het eind van de vorige maand Barroso & Santa-Clara (2015). Ze schaalden de positie naar een volatiliteit van 12% per jaar, met op jaarbasis. Moreira en Muir schaalden met de gerealiseerde variantie van de vorige maand en vonden van alle factoren de grootste alpha bij momentum, wat ze met het eerste geval verklaarden Moreira & Muir (2017).
5Simulatie: drie werelden en de lange horizon
Kunnen 25 jaar maanddata, de lengte van de steekproef van Jegadeesh en Titman, de drie verklaringen uit elkaar houden? We bouwen drie werelden met elk 500 aandelen. In alle drie bestaat het rendement uit een marktfactor, bedrijfsnieuws en ruis, met standaarddeviaties van 8% en 6% per maand voor nieuws en ruis. De bèta’s op de marktfactor liggen rond één en spreiden met een standaarddeviatie van 0,4 ongeveer even ver als in het toy-voorbeeld. De werelden verschillen in één opzicht:
spreiding: het nieuws zit direct in de koers, maar elk aandeel heeft een eigen verwacht rendement, met een cross-sectionele standaarddeviatie van 1% per maand;
onderreactie: alle aandelen hebben hetzelfde verwachte rendement, maar 30% van elk nieuwsbericht wordt pas in de twaalf maanden daarna in de koers verwerkt;
overreactie: 25% wordt later verwerkt en daar komt 25% overschrijding bij, die in maand 13 tot en met 48 wordt teruggedraaid.
In termen van (7) heeft de eerste wereld alleen , de tweede alleen positieve idiosyncratische autocovariantie en de derde positieve autocovariantie op korte en negatieve op lange lags. Voor elke vormingsmaand sorteren we met de 12-1-regel uit het toy-voorbeeld, met opgetelde in plaats van samengestelde rendementen. WML koopt de bovenste 50 aandelen en verkoopt de onderste 50, en we volgen die portefeuille zestig maanden.
N_STOCKS, T_MONTHS, BURN, HORIZON, N_LEG, N_SAMPLES = 500, 300, 60, 60, 50, 100


def simulate_panel(sd_mu=0.0, under=0.0, over=0.0, sd_news=0.08, sd_noise=0.06):
    """T x N maandrendementen: vertraagde reactie op nieuws, ruis, een marktfactor, spreiding in gemiddelden."""
    n_t = BURN + 12 + T_MONTHS + HORIZON
    response = np.zeros(49)
    response[0] = 1.0 - under
    response[1:13] += (under + over) / 12
    response[13:49] -= over / 36
    news = sd_news * rng.standard_normal((n_t, N_STOCKS))
    R = signal.lfilter(response, [1.0], news, axis=0)
    R += sd_noise * rng.standard_normal((n_t, N_STOCKS))
    R += np.outer(0.045 * rng.standard_normal(n_t), 1.0 + 0.4 * rng.standard_normal(N_STOCKS))
    R += sd_mu * rng.standard_normal(N_STOCKS)
    return R[BURN:]


def wml_event_returns(R):
    """Gemiddeld WML-rendement in maand 1..HORIZON na vorming, 12-1-signaal, bovenste en onderste N_LEG aandelen."""
    csum = np.vstack([np.zeros(R.shape[1]), np.cumsum(R, axis=0)])
    taus = np.arange(11, len(R) - HORIZON)                 # vormingsmaanden
    signal_12_1 = csum[taus] - csum[taus - 11]              # som over de 11 maanden vóór tau
    ranks = stats.rankdata(signal_12_1, axis=1)             # 1 = laagste signaal
    weights = ((ranks > R.shape[1] - N_LEG).astype(float) - (ranks <= N_LEG)) / N_LEG
    return np.array([(weights * R[taus + k]).sum() / len(taus) for k in range(1, HORIZON + 1)])


worlds = {"spreiding": dict(sd_mu=0.010), "onderreactie": dict(under=0.30),
          "overreactie": dict(under=0.25, over=0.25)}
event = {name: np.array([wml_event_returns(simulate_panel(**kw)) for _ in range(N_SAMPLES)])
         for name, kw in worlds.items()}

pd.DataFrame(
    {name: {"maand 1 (%)": 100 * x[:, 0].mean(),
            "gem. maand 1-12 (%)": 100 * x[:, :12].mean(),
            "gem. maand 13-60 (%)": 100 * x[:, 12:].mean(),
            "SD over steekproeven, 13-60 (%)": 100 * x[:, 12:].mean(axis=1).std(),
            "fractie steekproeven 13-60 < 0": (x[:, 12:].mean(axis=1) < 0).mean()}
     for name, x in event.items()}
).T.round(3)Alle drie de werelden verdienen in het eerste jaar 0,8 tot 1,1% per maand, maar alleen de overreactiewereld verliest daarna. De figuur toont het cumulatieve WML-rendement per wereld, en het gaat vooral om het verloop rechts van de stippellijn bij maand 12.
Source
fig, ax = plt.subplots()
months = np.arange(1, HORIZON + 1)
for i, (name, x) in enumerate(event.items()):
    cum = 100 * x.cumsum(axis=1)
    ax.plot(months, cum.mean(axis=0), color=hap.plotting.COLORS[i], label=name)
    ax.fill_between(months, *np.percentile(cum, [5, 95], axis=0), color=hap.plotting.COLORS[i], alpha=0.2)
ax.axvline(12, color="black", lw=0.8, ls="--")
ax.axhline(0, color="black", lw=0.8)
ax.set_xlabel("Maanden na vorming")
ax.set_ylabel("Cumulatief WML-rendement (%)")
ax.set_title("Drie werelden met momentum, maar slechts één met omkering")
ax.legend()
plt.show()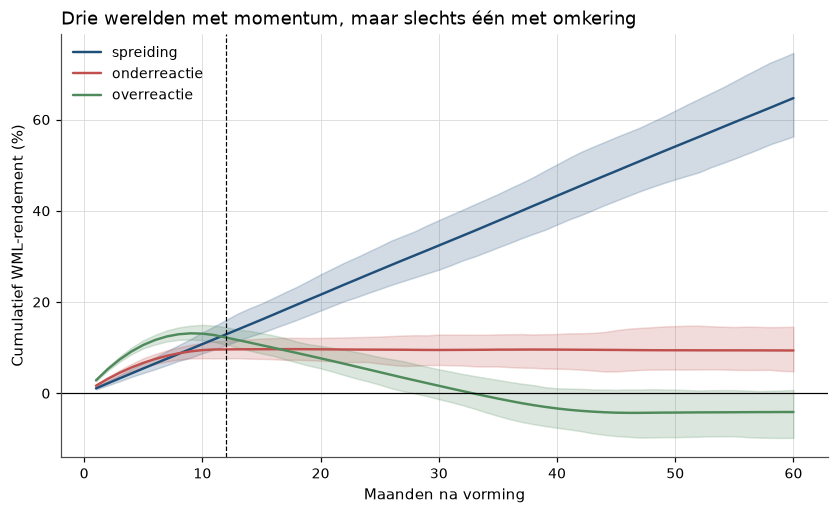
Figure 1:Alle drie de werelden leveren in het eerste jaar ongeveer een procent per maand. Daarna lopen ze uiteen, want bij spreiding in verwachte rendementen blijven de winnaars winnen, bij zuivere onderreactie vlakt de lijn af, en alleen overreactie maakt van winnaars verliezers. De banden zijn het 5e en 95e percentiel over 100 steekproeven van 25 jaar.
In maand 13 tot en met 60 verdient de spreidingswereld even veel als ervoor, 1,08% per maand. De onderreactiewereld blijft op nul en is in 54% van de steekproeven negatief, terwijl de overreactiewereld in elke steekproef verliest. De drie werelden gedragen zich dus zoals Corollary 2 zegt. Alleen vraagt de spreidingswereld een onrealistisch grote spreiding in verwachte rendementen, ongeveer 12% per jaar, terwijl het CAPM bij een spreiding in bèta’s van 0,3 en een marktpremie van 6% niet meer dan 1,8% per jaar toelaat.
Het gemiddelde over maand 13 tot en met 60 schommelt tussen steekproeven met 0,06 tot 0,09 procentpunt, zodat 25 jaar hier ruim genoeg is om de werelden te scheiden. Bij echte WML-rendementen is die standaardfout over een kwarteeuw ongeveer 0,47 procentpunt, zoals de replicatie laat zien. De zwakkere omkering na 1982 kan daarom op een verschuiving van overreactie naar onderreactie wijzen, maar ook op een overreactie die in zeventien jaar niet scherp te zien is.
6Replicatie op echte data
We gebruiken de momentumportefeuilles van French, namelijk de decielen op prior 12-2, maandelijks en dagelijks, de zes size-momentumportefeuilles en UMD zelf, en daarnaast de drie factoren van Fama en French. De cel controleert ook of UMD precies (3) is.
ff3 = hap_data.french("F-F_Research_Data_Factors")
umd = hap_data.french("F-F_Momentum_Factor")["Mom"]
umd_daily = hap_data.french("F-F_Momentum_Factor", "daily")["Mom"]
dec_vw = hap_data.french("10_Portfolios_Prior_12_2")
dec_ew = hap_data.french("10_Portfolios_Prior_12_2", table="Equal Weight")
dec_vw_daily = hap_data.french("10_Portfolios_Prior_12_2", "daily")
six = hap_data.french("6_Portfolios_ME_Prior_12_2")

wml_vw = (dec_vw["Hi PRIOR"] - dec_vw["Lo PRIOR"]).rename("WML vw")
wml_ew = (dec_ew["Hi PRIOR"] - dec_ew["Lo PRIOR"]).rename("WML ew")
wml_vw_daily = dec_vw_daily["Hi PRIOR"] - dec_vw_daily["Lo PRIOR"]
umd_from_six = 0.5 * (six["SMALL HiPRIOR"] + six["BIG HiPRIOR"]) - 0.5 * (six["SMALL LoPRIOR"] + six["BIG LoPRIOR"])

print(f"max |UMD uit zes portefeuilles - UMD| = {(umd_from_six - umd).abs().max():.5f}")
max |UMD uit zes portefeuilles - UMD| = 0.00010
UMD volgt dus op een honderdste procentpunt na uit de formule, en dat verschil is niet meer dan afronding. UMD verschilt van het decielverschil daarom alleen in de opbouw, met de dubbele sortering op grootte en breekpunten bij 30 en 70%, en niet in de data.
6.1Jegadeesh-Titman: 1965–1989 en daarna
De eerste tabel geeft voor drie versies van WML over 1965–1989 het gemiddelde en de alpha’s, met Newey-West--waarden.
def nw_alpha(y, factors=None, lags=6):
    """Intercept (in % per maand), Newey-West t-waarde en hellingen van y op de factoren."""
    X = pd.DataFrame(index=y.index) if factors is None else factors
    fit = hap.stats.newey_west(y, X, lags=lags)
    return 100 * fit.params.iloc[0], fit.tvalues.iloc[0], fit.params.iloc[1:]


def jt_row(y, start, end):
    """Gemiddelde, CAPM- en FF3-alpha met Newey-West t-waarden over [start, end]."""
    y = y.loc[start:end]
    X = ff3.loc[start:end]
    mean, t_mean, _ = nw_alpha(y)
    a_capm, t_capm, b_capm = nw_alpha(y, X[["Mkt-RF"]])
    a_ff3, t_ff3, b_ff3 = nw_alpha(y, X[["Mkt-RF", "SMB", "HML"]])
    return {"gem. (%/mnd)": mean, "t": t_mean, "CAPM-alpha": a_capm, "t(CAPM)": t_capm,
            "bèta markt": b_capm["Mkt-RF"], "FF3-alpha": a_ff3, "t(FF3)": t_ff3,
            "bèta SMB": b_ff3["SMB"], "bèta HML": b_ff3["HML"]}


series = {"deciel 10-1 gelijkgewogen": wml_ew, "deciel 10-1 waardegewogen": wml_vw, "UMD": umd}
pd.DataFrame({name: jt_row(y, "1965-01", "1989-12") for name, y in series.items()}).T.round(3)Het gelijkgewogen decielverschil heeft een marktbèta van −0,03, zodat de CAPM-alpha gelijk is aan het ruwe rendement. De FF3-alpha is met 1,69% per maand zelfs hoger, omdat de winnaars in deze periode vaker grote groeiaandelen waren, zodat WML negatief laadt op SMB en HML. Het driefactormodel legt momentum dus niet uit en vergroot het raadsel zelfs. De tweede tabel splitst het gemiddelde naar periode, en voor 1965–1989 ook naar januari en de overige maanden.
periods = {"1927-1964": ("1927-01", "1964-12"), "1965-1989 (JT)": ("1965-01", "1989-12"),
           "1990-1998 (JT 2001)": ("1990-01", "1998-12"), "1999-2026": ("1999-01", "2026-12")}
rows = {}
for label, (a, b) in periods.items():
    for name, y in series.items():
        mean, t_mean, _ = nw_alpha(y.loc[a:b])
        rows[(label, name)] = {"gem. (%/mnd)": mean, "t": t_mean}
jan = wml_ew.loc["1965":"1989"]
rows[("1965-1989, januari", "deciel 10-1 gelijkgewogen")] = {
    "gem. (%/mnd)": 100 * jan[jan.index.month == 1].mean(), "t": np.nan}
rows[("1965-1989, overige maanden", "deciel 10-1 gelijkgewogen")] = {
    "gem. (%/mnd)": 100 * jan[jan.index.month != 1].mean(), "t": np.nan}
pd.DataFrame(rows).T.round(3)Tot 1998 is het gemiddelde in elke periode positief, en in januari 1965–1989 verloor het gelijkgewogen decielverschil gemiddeld 5,26%. De tabel hieronder zet de uitkomsten naast die van Jegadeesh en Titman.
| origineel | hier | |
|---|---|---|
| WML 1965–1989 (% per maand) | 1,31 (12/3) | 1,33 (gelijkgewogen) |
| -waarde 1965–1989 | 3,74 (12/3) | 5,50 (gelijkgewogen) |
| WML 1990–1998 (% per maand) | 1,39 (6/6) | 1,11 (gelijkgewogen), 1,75 (waardegewogen) |
| januari 1965–1989 (% per maand) | ongeveer −7 (6/6) | −5,26 |
| overige maanden 1965–1989 (% per maand) | 1,66 (6/6) | 1,93 |
| FF3-alpha 1965–1989 (% per maand) | niet verklaard | 1,69 |
Geslaagd. Alle vier de verwachte kenmerken komen uit, namelijk een rendement tussen 1 en 1,5% per maand met , een CAPM-alpha van dezelfde grootte, een hogere FF3-alpha en een verlies in januari. De -waarde van 5,50 ligt boven hun 3,74, zoals bij Newey-West-standaardfouten en niet-overlappende decielen te verwachten was. Na 1999 is het gemiddelde 0,54% per maand met , zodat de standaardfout ongeveer procentpunt is. Een kwarteeuw is dus niet genoeg om een halve procent per maand van nul te onderscheiden, en dat is de standaardfout van 2% in de vorm die momentum aanneemt.
6.2Barroso-Santa-Clara: momentum heeft zijn momenten
De code schat elke maand de volatiliteit uit de 126 voorgaande dagen, schaalt WML naar 12% per jaar en zet onze statistieken naast die van het artikel.
TARGET = 0.12                                                       # doelvolatiliteit per jaar
var_forecast = (wml_vw_daily**2).rolling(126).sum() * 21 / 126
var_forecast = var_forecast.groupby(wml_vw_daily.index.to_period("M")).last().to_timestamp("M")
sigma_hat = np.sqrt(12 * var_forecast)                              # op jaarbasis, bekend aan het eind van de maand
bsc = pd.concat([wml_vw, (TARGET / sigma_hat).shift(1).rename("gewicht"),
                 sigma_hat.shift(1).rename("sigma_hat")], axis=1, sort=True).dropna()
bsc["WML geschaald"] = bsc["gewicht"] * bsc["WML vw"]


def bsc_table(x):
    """Statistieken uit tabel 3 van Barroso en Santa-Clara (2015), plus de maximale drawdown."""
    return {"gemiddelde (%/jaar)": 1200 * x.mean(), "SD (%/jaar)": 100 * np.sqrt(12) * x.std(),
            "Sharpe-ratio": np.sqrt(12) * x.mean() / x.std(), "excess kurtosis": x.kurtosis(),
            "scheefheid": x.skew(), "slechtste maand (%)": 100 * x.min(), "beste maand (%)": 100 * x.max(),
            "max drawdown (%)": 100 * hap.stats.drawdowns(x).attrs["max_drawdown"]}


sample = bsc.loc[:"2011-12"]
ours = {"WML (hier)": bsc_table(sample["WML vw"]), "geschaald (hier)": bsc_table(sample["WML geschaald"]),
        "WML tot 2026": bsc_table(bsc["WML vw"]), "geschaald tot 2026": bsc_table(bsc["WML geschaald"])}
paper = {"WML (BSC)": [14.46, 27.53, 0.53, 18.24, -2.47, -78.96, 26.18, -96.69],
         "geschaald (BSC)": [16.50, 16.95, 0.97, 2.68, -0.42, -28.40, 21.95, -45.20]}
paper = {k: dict(zip(ours["WML (hier)"], v)) for k, v in paper.items()}
table3 = pd.DataFrame({k: {**ours, **paper}[k] for k in
                       ["WML (hier)", "WML (BSC)", "geschaald (hier)", "geschaald (BSC)", "WML tot 2026", "geschaald tot 2026"]})
print(f"steekproef {sample.index[0]:%Y-%m} t/m {sample.index[-1]:%Y-%m}, {len(sample)} maanden; "
      f"gewicht gem. {sample['gewicht'].mean():.2f}, min {sample['gewicht'].min():.2f}, max {sample['gewicht'].max():.2f}; "
      f"SD log sigma_hat {np.log(bsc['sigma_hat']).std():.2f}")
table3.round(2)
steekproef 1927-05 t/m 2011-12, 1016 maanden; gewicht gem. 0.90, min 0.14, max 2.09; SD log sigma_hat 0.55
Geslaagd. De Sharpe-ratio stijgt van 0,54 naar 1,00, tegen 0,53 naar 0,97 in het artikel, en scheefheid, kurtosis en drawdown bewegen zoals verwacht. Met een gemiddeld gewicht van 0,90 neemt de geschaalde strategie gemiddeld iets minder positie dan de ongeschaalde, en tot 2026 blijft het beeld staan. De stijging van de Sharpe-ratio is , veel meer dan de 57% en 16% uit de theorie. Om te zien waarom, regresseren we de gerealiseerde variantie en het WML-rendement op de voorspelde variantie.
realized_var = (wml_vw_daily**2).groupby(wml_vw_daily.index.to_period("M")).sum().to_timestamp("M")
pred = pd.concat([realized_var.rename("RV"), (var_forecast.shift(1) * 12).rename("voorspelling"),
                  wml_vw.rename("WML")], axis=1, sort=True).dropna().loc[:"2011-12"]
pd.DataFrame({
    "R^2 gerealiseerde variantie op voorspelling": [sm.OLS(pred["RV"], sm.add_constant(pred["voorspelling"])).fit().rsquared],
    "R^2 WML-rendement op voorspelling": [sm.OLS(pred["WML"], sm.add_constant(pred["voorspelling"])).fit().rsquared],
    "helling WML op voorspelling": [sm.OLS(pred["WML"], sm.add_constant(pred["voorspelling"])).fit().params.iloc[1]],
    "t (NW)": [hap.stats.newey_west(pred["WML"], pred[["voorspelling"]]).tvalues.iloc[1]],
}, index=["1927-2011"]).T.round(3)De voorspelde variantie verklaart 36,8% van de variatie in de gerealiseerde variantie, tegen slechts 1,6% van de variatie in het rendement. Bovendien is de helling van het rendement op de voorspelde variantie negatief (), zodat het verwachte rendement lager is wanneer momentum riskant is. Die negatieve helling is het tegendeel van geval 3 in Corollary 3 en valt buiten de drie gevallen. Omdat daalt wanneer stijgt, daalt het optimale gewicht dan sneller dan , zodat schalen de Sharpe-ratio meer verhoogt dan in geval 1.
De figuur toont de waarde van een dollar in beide strategieën op een logaritmische schaal, en de stippellijnen markeren de crashes van 1932 en 2009.
Source
fig, ax = plt.subplots()
for column, color in (("WML vw", hap.plotting.COLORS[1]), ("WML geschaald", hap.plotting.COLORS[0])):
    wealth = hap.stats.drawdowns(bsc[column])["wealth"]
    ax.plot(wealth.index, wealth, color=color,
            label="WML, decielen 10-1" if column == "WML vw" else "WML geschaald naar 12% volatiliteit")
ax.set_yscale("log")
for crash in ("1932-08", "2009-05"):
    ax.axvline(pd.Timestamp(crash), color="black", lw=0.8, ls="--")
hap.plotting.timeline_axis(ax)
ax.set_xlabel("Jaar")
ax.set_ylabel("Waarde van 1 dollar (log-schaal)")
ax.set_title("Momentum en risicogestuurd momentum, 1927-2026")
ax.legend()
plt.show()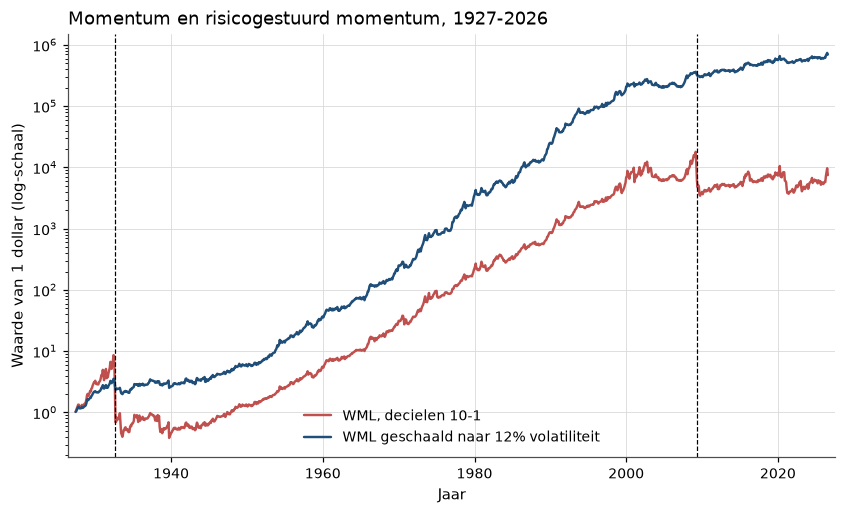
Figure 2:De ongeschaalde strategie verliest in 1932 en in 2009 het grootste deel van de waarde (stippellijnen). De geschaalde strategie had de blootstelling vóór beide crashes al verlaagd, omdat de volatiliteit van momentum toen al hoog was, en eindigt ordes van grootte hoger met een lagere volatiliteit.
6.3Daniel-Moskowitz: de crashes van 1932 en 2009
We beginnen met de twee episodes. De cel berekent het cumulatieve rendement van verliezers, winnaars, WML en de markt, en het marktrendement over de 24 maanden ervoor.
episodes = {"1932-07 t/m 1932-08": ("1932-07", "1932-08"), "2009-03 t/m 2009-05": ("2009-03", "2009-05")}
market = ff3["Mkt-RF"] + ff3["RF"]
pd.DataFrame(
    {label: {"verliezers (deciel 1)": 100 * ((1 + dec_vw["Lo PRIOR"].loc[a:b]).prod() - 1),
             "winnaars (deciel 10)": 100 * ((1 + dec_vw["Hi PRIOR"].loc[a:b]).prod() - 1),
             "WML": 100 * ((1 + wml_vw.loc[a:b]).prod() - 1),
             "markt": 100 * ((1 + market.loc[a:b]).prod() - 1),
             "markt, 24 maanden ervoor": 100 * ((1 + market.loc[:a].iloc[-25:-1]).prod() - 1)}
     for label, (a, b) in episodes.items()}
).round(1)In beide episodes herstelde de markt sterk na een daling van 75% en 45% over twee jaar, en verloor WML 91,6% en 73,8%. Daarna schatten we de regressie van Daniel en Moskowitz, waarin WML op de markt wordt geregresseerd met aparte hellingen in bear markets en in de stijgende maanden daarbinnen.
market_24m = np.expm1(np.log1p(market).rolling(24).sum())     # samengesteld marktrendement over 24 maanden
dm = pd.concat([wml_vw, ff3["Mkt-RF"], market_24m.shift(1).rename("markt 24m")], axis=1, sort=True).dropna()
dm["bear"] = (dm["markt 24m"] < 0).astype(float)
dm["up"] = (dm["Mkt-RF"] > 0).astype(float)
design = pd.DataFrame({"bear": dm["bear"], "markt": dm["Mkt-RF"], "bear x markt": dm["bear"] * dm["Mkt-RF"],
                       "bear x up x markt": dm["bear"] * dm["up"] * dm["Mkt-RF"]})


def dm_betas(end):
    """Regressie van Daniel en Moskowitz: WML op de markt, met interacties voor bear market en stijgende maand."""
    fit = hap.stats.newey_west(dm["WML vw"].loc[:end], design.loc[:end], lags=3)
    p = fit.params
    return {"bèta, geen bear market": p["markt"],
            "bèta, bear market, dalende markt": p["markt"] + p["bear x markt"],
            "bèta, bear market, stijgende markt": p["markt"] + p["bear x markt"] + p["bear x up x markt"],
            "t verschil stijgend-dalend": fit.tvalues["bear x up x markt"],
            "gem. WML in bear market (%/mnd)": 100 * dm["WML vw"].loc[:end][dm["bear"].loc[:end] == 1].mean(),
            "gem. WML buiten bear market (%/mnd)": 100 * dm["WML vw"].loc[:end][dm["bear"].loc[:end] == 0].mean(),
            "maanden in bear market": int(dm["bear"].loc[:end].sum())}


worst = wml_vw.nsmallest(15)
print(f"van de 15 slechtste WML-maanden kwamen er {int((dm.loc[worst.index, 'bear'] == 1).sum())} na een negatief tweejaarsrendement")
pd.DataFrame({"1927-2013:03 (DM)": dm_betas("2013-03"), "1927-2026": dm_betas("2026-12")}).round(3)
van de 15 slechtste WML-maanden kwamen er 11 na een negatief tweejaarsrendement
Buiten bear markets is de bèta van WML nagenoeg nul, en in bear markets is hij −0,70 in dalende en −1,41 in stijgende maanden, met voor het verschil. De tabel hieronder zet de uitkomsten naast die van Daniel en Moskowitz.
| Daniel en Moskowitz | hier | |
|---|---|---|
| verliezers, juli–augustus 1932 (%) | 232 | 239,1 |
| winnaars, juli–augustus 1932 (%) | 32 | 30,8 |
| verliezers, maart–mei 2009 (%) | 163 | 158,5 |
| winnaars, maart–mei 2009 (%) | 8 | 7,2 |
| bèta WML in bear market, dalende maand | −0,70 | −0,70 |
| bèta WML in bear market, stijgende maand | −1,51 | −1,41 |
| slechtste 15 maanden na een bear market | 14 | 11 |
Geslaagd. De episodes liggen binnen enkele procentpunten van het origineel, en de bèta’s hebben het verwachte teken en de verwachte asymmetrie, al is het verschil tussen stijgende en dalende maanden minder scherp. Minder goed klopt de telling, want van de vijftien slechtste maanden vallen er hier 11 na een bear market, tegen 14 bij Daniel en Moskowitz. Vermoedelijk rangschikken de decielen van French die maanden anders dan die van CRSP, of telt onze bear market met de marktfactor van French in plaats van hun index. Teken en asymmetrie zijn die van Proposition 2 en van de optie-lezing.
WML verdient in bear markets bovendien gemiddeld −0,85% per maand, tegen 1,66% daarbuiten, toevallig hetzelfde getal als bij Jegadeesh en Titman buiten januari. In de meest volatiele toestanden is momentum dus ook minder winstgevend, wat past bij de negatieve helling uit de replicatie van Barroso en Santa-Clara.
De figuur zet elke maand uit als punt, met de bear markets in rood. Het gaat om de rode wolk, die rechts van nul steiler daalt dan links, zodat de zwarte lijn bij nul een knik heeft.
Source
fig, ax = plt.subplots()
calm, bear = dm[dm["bear"] == 0], dm[dm["bear"] == 1]
ax.scatter(100 * calm["Mkt-RF"], 100 * calm["WML vw"], s=8, color=hap.plotting.COLORS[7], alpha=0.5,
           label="geen bear market")
ax.scatter(100 * bear["Mkt-RF"], 100 * bear["WML vw"], s=14, color=hap.plotting.COLORS[1], alpha=0.8,
           label="bear market (markt 24 maanden < 0)")
fit = sm.OLS(bear["WML vw"], sm.add_constant(pd.DataFrame(
    {"m": bear["Mkt-RF"], "m_up": bear["Mkt-RF"] * bear["up"]}))).fit()
grid = np.linspace(bear["Mkt-RF"].min(), bear["Mkt-RF"].max(), 100)
ax.plot(100 * grid, 100 * (fit.params["const"] + fit.params["m"] * grid + fit.params["m_up"] * np.maximum(grid, 0)),
        color="black", lw=1.4, label="stuksgewijs lineaire fit, bear market")
for date in ("1932-07-31", "1932-08-31", "2009-04-30"):
    ax.annotate(date[:7], (100 * dm.loc[date, "Mkt-RF"], 100 * dm.loc[date, "WML vw"]), fontsize=8,
                xytext=(4, 0), textcoords="offset points")
ax.set_xlabel("Overrendement van de markt in de maand (%)")
ax.set_ylabel("WML-rendement in de maand (%)")
ax.set_title("Na een bear market gedraagt WML zich als een geschreven call op de markt")
ax.legend()
plt.show()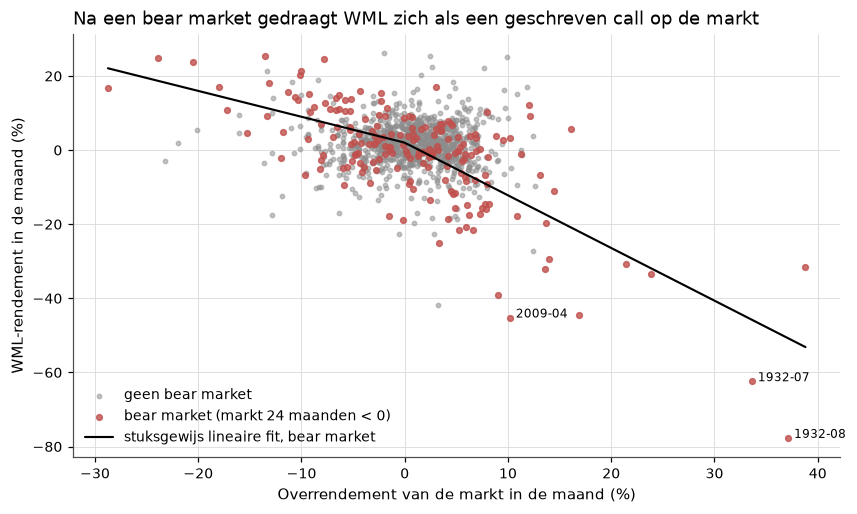
Figure 3:In gewone tijden (grijs) heeft WML nauwelijks marktbèta. Na een negatief tweejaarsrendement van de markt (rood) is de bèta negatief, en in stijgende maanden veel negatiever dan in dalende, wat de knik van een geschreven call is. De drie slechtste maanden in de geschiedenis van momentum liggen rechtsonder.
7Wat er brak, en wat daarna kwam
Wat het model verklaart. Momentum is misschien het best gerepliceerde feit uit dit tijdvak. Het bleef overeind in een nieuwe steekproef Jegadeesh & Titman (2001), in twaalf Europese landen Rouwenhorst (1998) en tussen industrieën Moskowitz & Grinblatt (1999). Asness, Moskowitz en Pedersen vonden het samen met value in acht markten tegelijk, van aandelen tot obligaties, valuta en grondstoffen Asness et al. (2013). Fama en French noemden momentum in de werkversie van Dissecting Anomalies de belangrijkste anomalie Fama & French (2008), en Santa-Clara noemt het in zijn terugblik de anomalie die de efficiënte markt blijft beschamen Santa-Clara (2026).
Waar het breekt. Geen evenwichtsmodel voorspelde momentum, en het driefactormodel maakt het erger, want onze FF3-alpha over 1965–1989 is 1,69% per maand, hoger dan het ruwe rendement. In de praktijk komt de premie met crashes, want WML verloor in 1932 91,6% in twee maanden en in 2009 73,8% in drie maanden. Die crashes zijn te voorspellen uit de stand van de markt en de eigen volatiliteit. Barroso en Santa-Clara noemen risicogestuurd momentum, met een Sharpe-ratio van ongeveer één, zelfs een groter raadsel dan het origineel.
Risico of vergissing? Drie gedragsmodellen voorspellen voortzetting en daarna omkering. Daarin reageren beleggers traag op losse aankondigingen en extrapoleren ze reeksen goed nieuws Barberis et al. (1998), of zijn ze overmoedig over hun eigen informatie Daniel et al. (1998). In het derde model duwen trendvolgers de koers voorbij de juiste waarde nadat nieuws zich langzaam heeft verspreid Hong & Stein (1999). In risicomodellen veranderen de risico’s van een bedrijf voorspelbaar met zijn groeiopties, zodat winnaars tijdelijk riskanter zijn Berk et al. (1999)Johnson (2002). De lange horizon zou de lezingen kunnen scheiden, maar de omkering was na 1982 zwak. De crashes zouden het ook kunnen, maar dan moet een risicoverhaal uitleggen waarom schalen weg van die crashes de premie verhoogt. Een belegger die momentum koopt, draagt dus een risico dat kan crashen of denkt iets te weten wat de prijs niet weet, en de data zeggen niet welke van de twee.
Wat er daarna kwam. Als aandelen ten opzichte van elkaar voorspelbaar zijn, is de volgende vraag of ook de markt als geheel voorspelbaar is, en of dat een tijdvariërende discontovoet of een vergissing weerspiegelt. Die vraag behandelt voorspelbaarheid van rendementen.
8Oefeningen
Solution to Exercise 1
(1) Het signaal van A blijft 33,1%, omdat A in maand 12 niets verdiende. Voor B wordt het , voor C en voor D . De rangorde wordt A, C, B, D.
(2) Nu zijn A en C de winnaars en B en D de verliezers, zodat WML oplevert. De code bevestigt beide stappen.
sig_12_0, wml_12_0 = wml_toy(list(range(1, 13)))
print("12-0-signalen:", sig_12_0.round(4).to_dict())
print(f"WML in maand 13 = {round(wml_12_0, 12) + 0.0:.4f}")
12-0-signalen: {'A': 0.331, 'B': 0.1108, 'C': 0.134, 'D': -0.1535}
WML in maand 13 = 0.0000
De sprong van C in maand 12 maakt van een verliezer een winnaar en wist de hele winst uit. Eén maand rendement bevat veel tijdelijke prijsdruk en bid-ask-ruis die de maand erna omkeert. Door die maand over te slaan houdt de 12-1-regel het signaal van het afgelopen jaar en laat hij de omkering op korte termijn buiten.
:::{exercise}
:label: ex-momentum-1

**Hoe groot moet de marktbeweging zijn?** Neem {prf:ref}`prop-momentum-beta` met
decielen ($p = 0{,}1$) en $\sigma_\beta = 0{,}3$. Het idiosyncratische vormingsrendement
over elf maanden heeft $\sigma_E = 0{,}10\sqrt{11}$.

1. Laat zien dat $\beta_{\mathrm{WML}}$ de helft van zijn limiet bereikt bij
   $|F| = \sigma_E/(\sigma_\beta\sqrt3)$ en bereken die $F$.
2. Bereken $\beta_{\mathrm{WML}}$ voor $F = -0{,}4$ en controleer het met een
   Monte-Carlosimulatie van 100 000 aandelen.
3. Vergelijk met de bèta van WML in bear markets uit de replicatie. Wat zegt het
   verschil over de aannames van de propositie?
Solution to ex-momentum-1
(1) Stel . Kwadrateren geeft , dus . De code rekent de getallen uit en controleert de formule met een simulatie.
p, sd_beta, sd_E = 0.10, 0.30, 0.10 * np.sqrt(11)
factor = 2 * stats.norm.pdf(stats.norm.ppf(1 - p)) / p


def beta_wml(F):
    """Vergelijking eq-momentum-beta."""
    return factor * sd_beta**2 * F / np.sqrt(sd_beta**2 * F**2 + sd_E**2)


n_mc, F = 100_000, -0.4
beta_i = 1.0 + sd_beta * rng.standard_normal(n_mc)
s = beta_i * F + sd_E * rng.standard_normal(n_mc)
top, bottom = s >= np.quantile(s, 1 - p), s <= np.quantile(s, p)
print(f"halve limiet bij |F| = {sd_E / (sd_beta * np.sqrt(3)):.3f}, limiet = {factor * sd_beta:.3f}")
print(f"bèta WML bij F = -0.4: formule {beta_wml(F):.3f}, Monte Carlo {beta_i[top].mean() - beta_i[bottom].mean():.3f}")
halve limiet bij |F| = 0.638, limiet = 1.053
bèta WML bij F = -0.4: formule -0.358, Monte Carlo -0.349
(2)–(3) De halve limiet ligt bij , en bij een marktdaling van 40% geeft de propositie een bèta van −0,36, wat de simulatie bevestigt. De replicatie vindt in bear markets −0,70 in dalende en −1,41 in stijgende maanden. Het model onderschat de bèta omdat bèta’s in de propositie vastliggen, terwijl de bèta van verliezers na een crash juist stijgt door hun hefboom, de optie-lezing van Daniel en Moskowitz. De spreiding in bèta’s is dan ook groter dan 0,3. Het teken van de WML-bèta volgt dus mechanisch uit de sortering, maar de omvang van de crashes niet.
:::{exercise}
:label: ex-momentum-2

**Welke schaling?** Herhaal de replicatie van Barroso en Santa-Clara tot en met 2026.
Gebruik drie schalingsregels op de waardegewogen WML.

1. Schaal met $0{,}12/\hat\sigma_t$ uit 126 dagen.
2. Schaal met $c/\widehat{\mathrm{RV}}_t$, de gerealiseerde variantie van alleen de vorige
   maand (Moreira-Muir), met $c$ zo dat de gemiddelde blootstelling gelijk is aan die van
   regel 1.
3. Gebruik regel 2 met een maximale hefboom van 2.

Rapporteer Sharpe-ratio, scheefheid en maximale drawdown, ook voor UMD met de eigen
dagdata. Is de keuze van $c$ een vorm van *look-ahead* (gebruik van data die op dat moment nog niet
bekend waren)?
Solution to ex-momentum-2
De functie hieronder bouwt de vier versies en rapporteert de drie statistieken.
def scaled_versions(monthly, daily):
    """Ongeschaald, BSC (volatiliteit uit 126 dagen) en Moreira-Muir (variantie van één maand, met en zonder plafond)."""
    by_month = daily.groupby(daily.index.to_period("M"))
    var_126 = (daily**2).rolling(126).sum().groupby(daily.index.to_period("M")).last().to_timestamp("M") * 252 / 126
    rv_1m = (by_month.apply(lambda x: (x**2).sum()) * 12).to_timestamp("M")
    frame = pd.concat([monthly.rename("r"), (0.12 / np.sqrt(var_126)).shift(1).rename("w_bsc"),
                       (1 / rv_1m).shift(1).rename("w_mm")], axis=1, sort=True).dropna()
    frame["w_mm"] *= frame["w_bsc"].mean() / frame["w_mm"].mean()
    out = {"ongeschaald": frame["r"], "BSC 1/sigma": frame["w_bsc"] * frame["r"],
           "MM 1/RV": frame["w_mm"] * frame["r"], "MM 1/RV, hefboom <= 2": frame["w_mm"].clip(upper=2) * frame["r"]}
    return pd.DataFrame({k: {"Sharpe": np.sqrt(12) * v.mean() / v.std(), "scheefheid": v.skew(),
                             "max drawdown": hap.stats.drawdowns(v).attrs["max_drawdown"]}
                         for k, v in out.items()}).T


pd.concat({"WML decielen": scaled_versions(wml_vw, wml_vw_daily), "UMD": scaled_versions(umd, umd_daily)}).round(3)Alle drie de regels verdubbelen ruwweg de Sharpe-ratio van beide reeksen en halen de negatieve scheefheid weg. De regel van Moreira en Muir maakt de scheefheid zelfs positief, en met een maximale hefboom van 2 blijft dat zo. De keuze van gebruikt de hele steekproef, maar voor regel 2 verandert een constante schaalfactor Sharpe-ratio en scheefheid niet, zodat alleen de drawdown ervan afhangt. Bij regel 3 is dat anders, omdat bepaalt hoe vaak het plafond van 2 bindt, en daar zit dus wel een kleine look-ahead in. Het resultaat hangt dus niet af van één volatiliteitsschatter, want waar het om gaat is dat de variantie van momentum voorspelbaar is.
- Jegadeesh, N., & Titman, S. (1993). Returns to Buying Winners and Selling Losers: Implications for Stock Market Efficiency. The Journal of Finance, 48(1), 65–91. 10.1111/j.1540-6261.1993.tb04702.x
- Fama, E. F., & French, K. R. (1996). Multifactor Explanations of Asset Pricing Anomalies. The Journal of Finance, 51(1), 55–84. 10.1111/j.1540-6261.1996.tb05202.x
- Carhart, M. M. (1997). On Persistence in Mutual Fund Performance. The Journal of Finance, 52(1), 57–82. 10.1111/j.1540-6261.1997.tb03808.x
- Daniel, K., & Moskowitz, T. J. (2016). Momentum Crashes. Journal of Financial Economics, 122(2), 221–247. 10.1016/j.jfineco.2015.12.002
- Barroso, P., & Santa-Clara, P. (2015). Momentum Has Its Moments. Journal of Financial Economics, 116(1), 111–120. 10.1016/j.jfineco.2014.11.010
- De Bondt, W. F. M., & Thaler, R. (1985). Does the Stock Market Overreact? Journal of Finance, 40(3), 793–805. 10.1111/j.1540-6261.1985.tb05004.x
- Lo, A. W., & MacKinlay, A. C. (1990). When Are Contrarian Profits Due to Stock Market Overreaction? The Review of Financial Studies, 3(2), 175–205. 10.1093/rfs/3.2.175
- Jegadeesh, N., & Titman, S. (2001). Profitability of Momentum Strategies: An Evaluation of Alternative Explanations. The Journal of Finance, 56(2), 699–720. 10.1111/0022-1082.00342
- Grundy, B. D., & Martin, J. S. (2001). Understanding the Nature of the Risks and the Source of the Rewards to Momentum Investing. The Review of Financial Studies, 14(1), 29–78. 10.1093/rfs/14.1.29
- Moreira, A., & Muir, T. (2017). Volatility-Managed Portfolios. The Journal of Finance, 72(4), 1611–1644. 10.1111/jofi.12513
- Rouwenhorst, K. G. (1998). International Momentum Strategies. The Journal of Finance, 53(1), 267–284. 10.1111/0022-1082.95722
- Moskowitz, T. J., & Grinblatt, M. (1999). Do Industries Explain Momentum? The Journal of Finance, 54(4), 1249–1290. 10.1111/0022-1082.00146
- Asness, C. S., Moskowitz, T. J., & Pedersen, L. H. (2013). Value and Momentum Everywhere. The Journal of Finance, 68(3), 929–985. 10.1111/jofi.12021
- Fama, E. F., & French, K. R. (2008). Dissecting Anomalies. The Journal of Finance, 63(4), 1653–1678. 10.1111/j.1540-6261.2008.01371.x
- Santa-Clara, P. (2026). What I Learned About Asset Pricing. LinkedIn post. https://www.linkedin.com/pulse/what-i-learned-asset-pricing-pedro-santa-clara-apjce/
Deze onafhankelijke site is niet verbonden aan of onderschreven door QuantEcon.
De vormgeving is gebaseerd op het MIT-gelicentieerde
QuantEcon MyST-thema.
Zie THIRD